兩個人隔桌而坐。一句台詞開始,接著兩張嘴都動了起來。反拍鏡頭一出現,聲音就不再附著在臉上。這正是創作者搜尋 Kling 4 對話唇形同步測試 時想避免的失敗情況。
本文先進行版本檢查,接著在已驗證的 Kling 3.0 系列上執行 3 個簡短、可重現的對話測試:單一發言者、2 位發言者輪流發言,以及英文與西班牙文混合交流。每個測試都在生成時使用原生音訊;本文以 GIF 呈現視覺結果,並附上相同的 10 分制評分卡。這些是個別執行結果,並非通用基準。
重點摘要
- Kuaishou 已正式發表 Kling 3.0,並非另行指定的 Kling 4 對話模型。
- 簡短、具名、輪流發言的台詞,能讓審閱者更清楚檢查發言者歸屬。
- GIF 讓面部動作與發言者交接易於瀏覽,但仍需要原始 MP4 來驗證聲音時序。
- 在投入更嚴苛的製作版本前,先將 10 秒執行結果視為腳本檢查。
- 要像檢視說話者一樣仔細檢視沉默的聆聽者。
Kling 4 對話唇形同步測試:首先,版本檢查
「Kling 4」這個詞目前在搜尋結果中會匯集好幾種不同的東西:4K 輸出、Kling 3.0、Kling Video O3、預先發布的用語,以及未經驗證的命名。在本次測試時,我找不到 Kuaishou 針對已發布「Kling 4」對話模型的官方規格。把未經驗證的標籤稱為完成品,會讓測試變得較不實用。
目前可驗證的參考點是 Kling AI 3.0。Kuaishou 於 2026 年 2 月 5 日發表 Video 3.0、Video 3.0 Omni、Image 3.0 與 Image 3.0 Omni 系列。該公告描述跨語言、方言與口音的原生音訊;可控制發言順序的對話場景;多鏡頭執導;以及最長 15 秒的影片長度(Kuaishou Technology,2026 年 2 月)。
該產品聲明設定了有用的測試目標。它並不保證每一個生成的片段都合格。原生音訊意味著模型可以在影片工作中一併生成音訊。它不保證某一張嘴會在每個子音上閉合、聆聽者會保持靜止,或剪接會保留發言者身分。這些就是本測試檢查的細節。
以下 3 次執行會保留視覺結果與評分卡,讓讀者能評估與書面紀錄相同的證據。
我們測試了什麼
此測試協定刻意排除各種藉口。每個場景都採用 16:9 取景、10 秒長度、在測試平台提供該設定時啟用原生音訊或設為 Auto、無音樂,且不進行後製唇形同步。每位可見發言者都有一句簡短台詞。文章中的 GIF 會保留視覺表現;評斷聲音時序時,請另外檢視原始 MP4 檔案。
| 測試 | 模型 | 長度 | 可見角色 | 語言 | 台詞 | 主要評估目標 |
|---|---|---|---|---|---|---|
| 1 | Kling V3.0 Standard T2V | 10 秒 | 1 | 英文 | 1 | 第一個音節、閉唇音、結尾停頓 |
| 2 | Kling V3.0 Standard T2V | 10 秒 | 2 | 英文 | 2 | 正確發言者與安靜聆聽者行為 |
| 3 | Kling V3.0 Pro T2V | 10 秒 | 2 | 英文與西班牙文 | 2 | 語言交接、歸屬與面部連續性 |
評分卡會給每個類別 0、1 或 2 分。2 分表示該行為對於目標 10 秒樣本而言已足夠清楚。1 分表示部分具說服力,但需要再次查看。0 分表示觀看者能明顯看出問題。總分是單一提示下某一次生成結果的紀錄,並非對該模型所有輸出的主張。
| 類別 | 0 分 | 1 分 | 2 分 |
|---|---|---|---|
| 嘴型與詞語時序 | 明顯不符 | 大致跟隨但可見失誤 | 全程時序自然 |
| 正確發言者歸屬 | 錯誤或共用發言者 | 有一刻不確定 | 每句台詞都屬於指定人物 |
| 沉默聆聽者行為 | 聆聽者說話或動嘴 | 輕微多餘嘴部動作 | 聆聽者保持自然專注 |
| 面部表情連續性 | 臉部明顯中斷或轉變 | 小幅不穩定 | 表情保持一致 |
| 剪接前後的音訊連續性 | 聲音脫離或突然改變 | 轉場明顯可察 | 剪接支援同一對話節拍 |
此測試設計也回答了這個搜尋背後可能衍生的問題:Kling 4 是否已發布、目前哪個模型可生成對話、2 個人能否輪流發言、創作者如何避免兩個角色同時說話、混合語言對話是否可行,以及小型測試預算應涵蓋什麼。
Kling 對話測試 #1:單一發言者,一句簡短台詞
單一個人說一句簡短台詞是基準。它隔離出最早有用的檢查點:第一次張嘴、在「p」或「b」音附近的閉唇,以及說話結束後的放鬆節拍。如果這個基準看起來不對,再加入另一個角色、鏡頭剪接或另一種語言,只會讓診斷更困難。
這次執行使用一位虛構的辦公室員工 Maya。場景包含小幅手勢與直接視線,但沒有快速鏡頭運動。這讓嘴部與聲音成為主要證據。
執行設定: 16:9、10 秒、執行時可用的最高測試平台解析度、原生音訊 On 或 Auto、無背景音樂。模型:Kling V3.0 Standard Text-to-Video。
plaintext1A realistic 10-second medium close-up of Maya, a fictional woman in her early thirties wearing a navy blazer, seated at a bright office desk. She looks directly at her colleague just off camera and says exactly: “The report is ready. Please review the blue chart.” Natural conversational pacing, clear English speech, accurate mouth movements, subtle blinking, small hand gesture, quiet office room tone only. Maya is the only visible person and the only speaker. No subtitles, no background music, no narration.
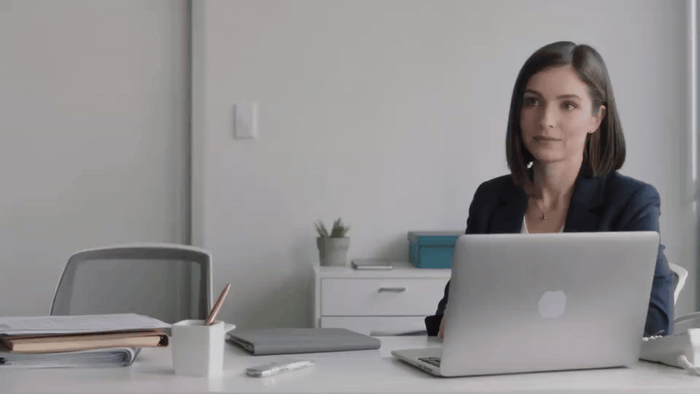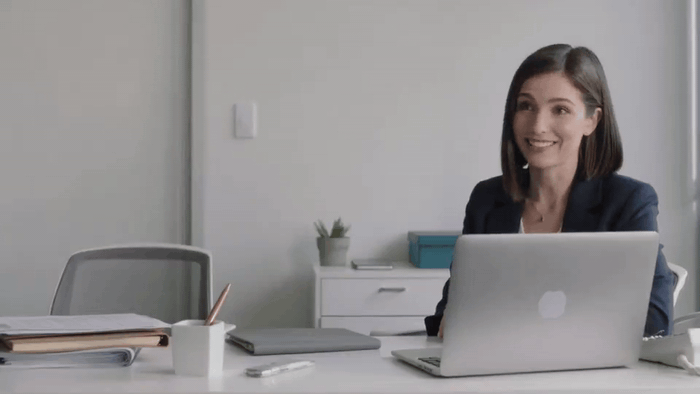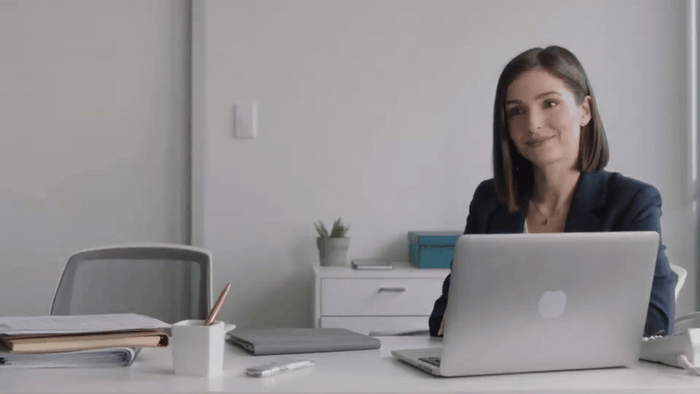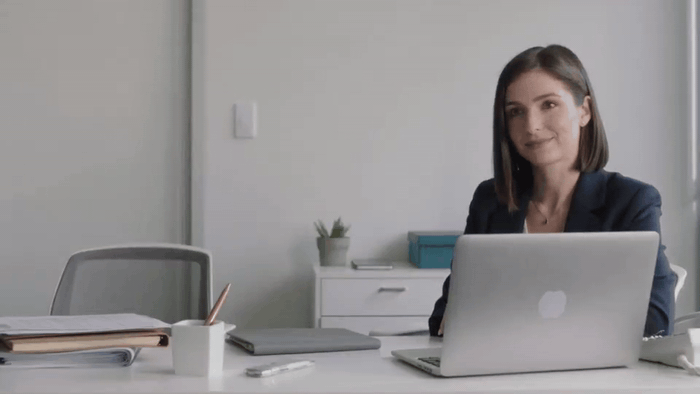
測試 1 視覺結果:Maya 說出一句辦公室台詞
測試 1 視覺結果。觀看 Maya 在「Please」期間的閉唇與台詞後的停頓;使用原始 MP4 判斷音訊時序。
執行狀態: 已於 Atlas 測試平台渲染。視覺 GIF 內嵌於上方。
| 測試 1 視覺結果 | 狀態 | GIF 顯示什麼 |
|---|---|---|
| 單一發言者取景 | 清楚 | Maya 在整個辦公室場景中都是唯一可見人物 |
| 嘴部動作 | 可見 | 特寫取景讓說話動作易於檢視 |
| 面部連續性 | 穩定 | 眨眼、姿勢與光線在片段中保持一致 |
| 聆聽者行為與剪接 | 不適用 | 這個基準場景沒有第二位發言者或反拍鏡頭 |
| 音訊時序 | 檢查原始 MP4 | 內嵌 GIF 沒有聲音 |
如果台詞失去清晰度,重新執行並另行標記時,只改變 1 個變數。第一,縮短說出的句子。第二,移除手勢或任何不必要的鏡頭指示。避免同時改變角色、長度與語言。那會把診斷變成新實驗。
Kling 對話測試 #2:兩個人輪流發言
這正是對話生成需要嚴格檢視的地方。一個可信的場景需要 2 個分開的動作:Maya 說話時 Daniel 聆聽,接著 Daniel 說話時 Maya 聆聽。沉默的人不是無用空間。他們閉合的嘴、眼神接觸、小幅反應與穩定臉部,都是證明的一部分。
提示對每位發言者使用 3 個錨點:姓名、左側或右側位置,以及可見服裝細節。它也說明聆聽者的預期行為。這些不是神奇咒語。它們給模型更明確的場景契約,並給審閱者清楚的失敗條件。
plaintext1A realistic 10-second two-person office dialogue in a sunlit meeting room. Maya, wearing a navy blazer, sits on the left. Daniel, wearing a light gray shirt, sits on the right. Shot 1: medium two-shot. Maya looks at Daniel and says exactly: “The report is ready. Please review the blue chart.” Daniel remains silent and listens naturally with his mouth closed. Shot 2: reverse medium shot on Daniel. Daniel says exactly: “Great. I will check it before lunch.” Maya remains silent and listens naturally with her mouth closed. Clear English speech, precise lip sync, one speaker at a time, no overlapping dialogue, no subtitles, no background music, quiet office room tone.
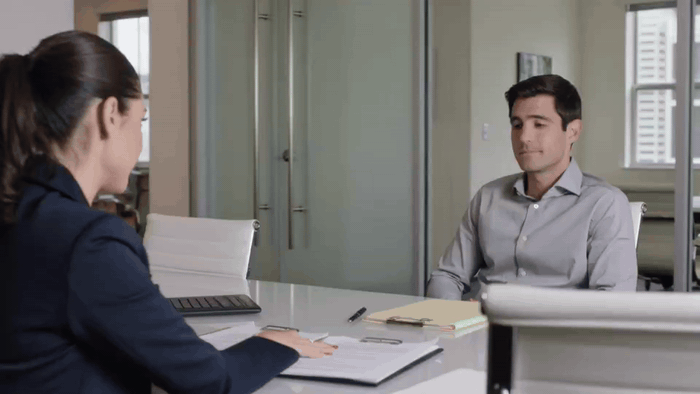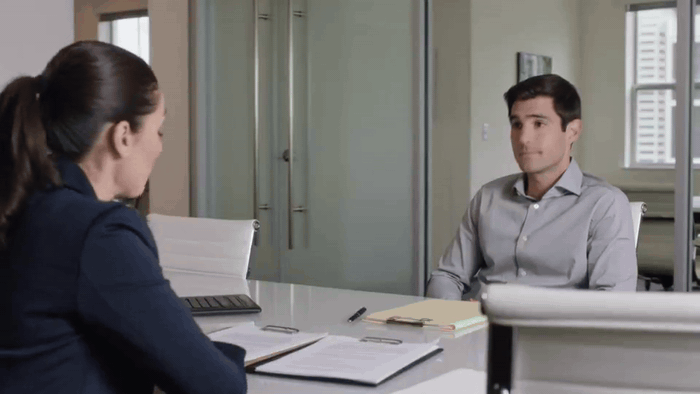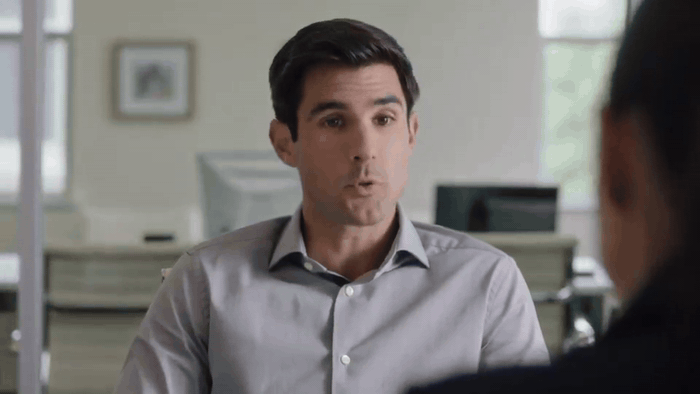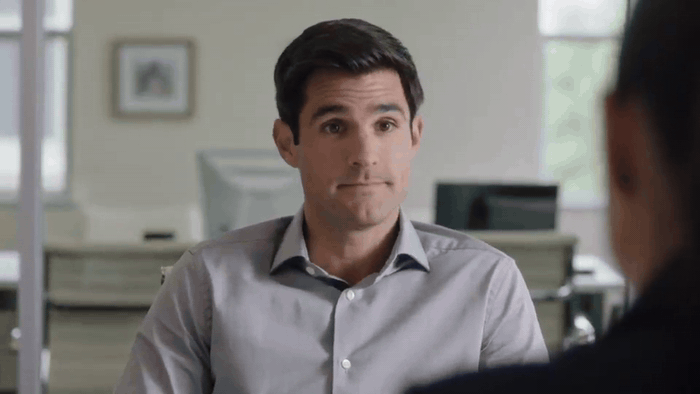
測試 2 視覺結果:Maya 與 Daniel 在辦公室對話中輪流發言
測試 2 視覺結果。觀看每句台詞期間聆聽者的嘴部,以及反拍鏡頭處的發言者交接;使用原始 MP4 判斷音訊時序。
創作者在社群討論中經常描述相反的問題:原本要進行唇形同步的工作可能失去同步,或讓應該安靜的人出現不必要的嘴部動作。那是軼事經驗,而非產品規格,但這是每次執行都檢查聆聽者的好理由(r/KLING,2026 年 9 月)。
執行狀態: 已於 Atlas 測試平台渲染。視覺 GIF 內嵌於上方。
| 測試 2 視覺結果 | 狀態 | GIF 顯示什麼 |
|---|---|---|
| 雙人發言者設定 | 清楚 | Maya 與 Daniel 出現在同一場辦公室對話中 |
| 發言者交接 | 可見 | 場景從 Maya 的回合切換到 Daniel 的反拍鏡頭 |
| 聆聽者行為 | 可檢視 | GIF 讓非說話者保持可見,以供視覺檢查 |
| 面部連續性 | 穩定 | Daniel 的臉部與辦公室設定在反拍鏡頭中保持一致 |
| 音訊時序 | 檢查原始 MP4 | 內嵌 GIF 沒有聲音 |
實務界線並不高:2 個人、依序進行、10 秒的交流可以測試。不應把它當成長場景的現成範本,尤其是包含打斷、群體反應、快速剪輯與多種語言的場景。每次只增加一個維度的難度。
Kling 對話測試 #3:混合語言對話
第三次執行測試 Kuaishou 所述功能的更緊湊版本:一個人說英文,另一個人用西班牙文回覆。其價值不在於新奇。混合語言交流可能揭露單一語言片段所隱藏的發言者歸屬錯誤,尤其是當剪接與不同聲音模式同時出現時。
西班牙文回覆刻意簡短。每個人仍有一句台詞,鏡頭順序保持明確,並告知聆聽者保持沉默。這裡使用 Pro 層級作為另一項更嚴苛的測試,而不是用來替代清楚的提示。
執行設定: 16:9、10 秒、執行時可用的最高解析度與品質、原生音訊 On 或 Auto、無背景音樂。模型:Kling V3.0 Pro Text-to-Video。
plaintext1A realistic 10-second two-person dialogue at a quiet outdoor café in late afternoon. Maya, wearing a navy blazer, is seated on the left. Daniel, wearing a light gray shirt, is seated on the right. Shot 1: Maya smiles and says exactly in English: “The product demo starts in five minutes.” Daniel remains silent and listens with his mouth closed. Shot 2: Daniel replies exactly in Spanish: “Perfecto, ya tengo las notas listas.” Maya remains silent and listens naturally with her mouth closed. One speaker at a time, accurate lip sync for each spoken language, natural pauses, stable faces, no subtitles, no background music, soft café ambience only.
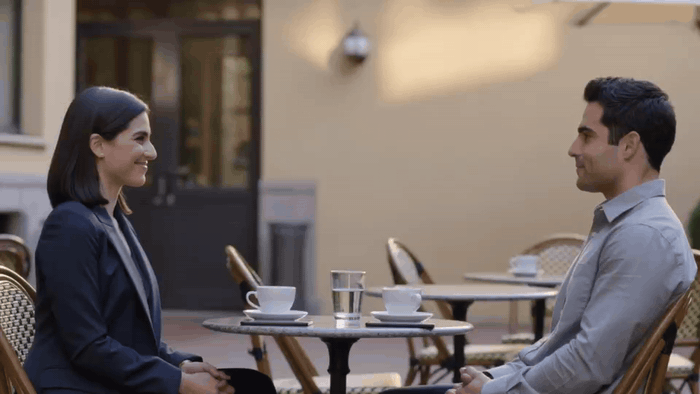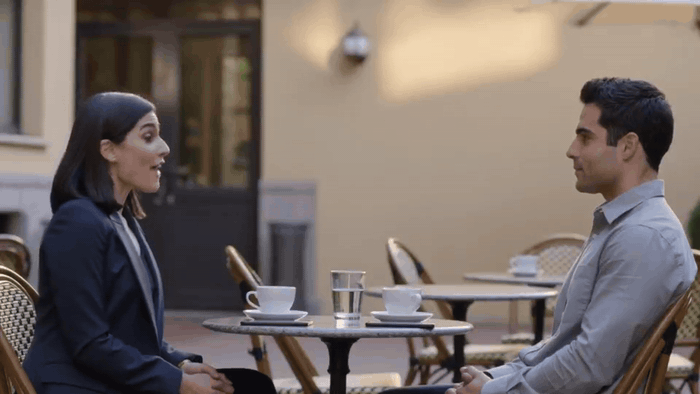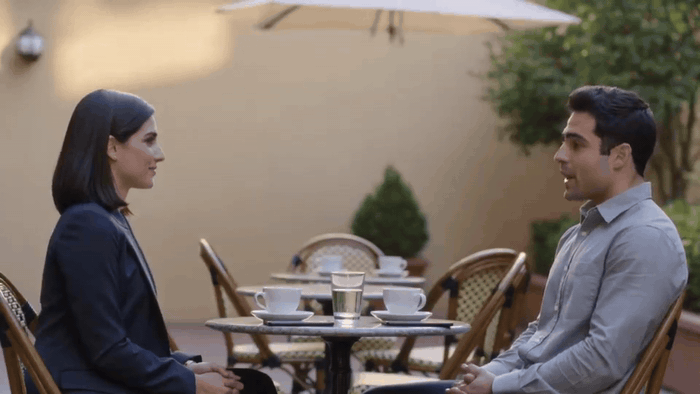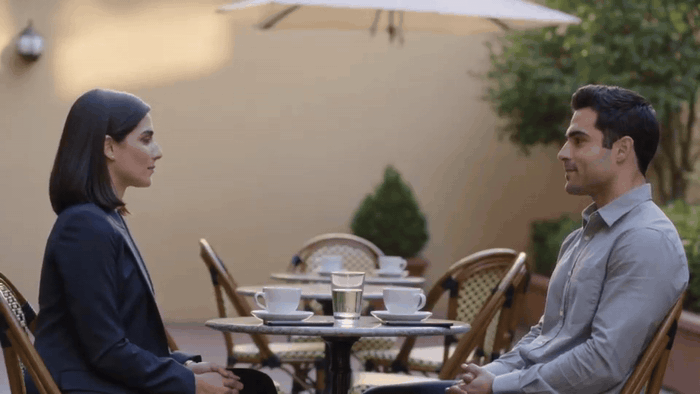
測試 3 視覺結果:兩位發言者在戶外咖啡館交換台詞
測試 3 視覺結果。觀看英文到西班牙文交接過程中,每句台詞由哪張臉負責;使用原始 MP4 判斷音訊時序。
執行狀態: 已於 Atlas 測試平台渲染。視覺 GIF 內嵌於上方。
| 測試 3 視覺結果 | 狀態 | GIF 顯示什麼 |
|---|---|---|
| 雙人咖啡館設定 | 清楚 | 兩人都維持在戶外咖啡館桌旁的位置 |
| 發言者交接 | 可見 | 取景保留了兩個角色之間的交流 |
| 臉部與場景連續性 | 穩定 | 服裝、座位與午後咖啡館光線保持一致 |
更乾淨的 Kling 唇形同步結果
這 3 個提示共用一種結構,能讓失敗顯而易見,並讓重新執行可被解釋。在增加更多修飾之前,請使用這份檢查清單。
- 第一次對話測試中,可見人物不超過 2 人。
- 每個人在每回合只給 1 句台詞。
- 英文台詞盡可能維持在 8 到 12 個字詞左右。
- 以位置、可見特徵與姓名標記發言者。
- 說明另一角色自然聆聽且嘴巴閉合。
- 先以 10 秒樣本建立腳本,再提高細節設定或長度。
- 將唇形時序、發言者歸屬、聆聽者行為、面部連續性與剪接作為分開的檢查項目。
- 第一次執行時,不要結合長篇獨白、群體場景、快速剪輯與語言切換。
| 提示元素 | 測試中的範例 | 協助審閱者隔離什麼 |
|---|---|---|
| 位置 | 「Maya ... 在左側」 | 哪個人應該說話 |
| 外觀錨點 | 「navy blazer」 | 身分是否在剪接後保持一致 |
| 確切台詞 | 「Great. I will check it before lunch.」 | 預期的聲音與嘴部時序 |
| 沉默角色指示 | 「保持沉默 ... 嘴巴閉合」 | 不必要的聆聽者唇部動作 |
| 鏡頭順序 | 「Shot 1 ... Shot 2」 | 音訊在剪接後是否仍附著 |
這種格式不保證完美結果。它讓小型團隊能將原始提示、媒體與決策保存在一起。如果片段需要重新執行,記錄失敗是發生在第一個音節、聆聽者反應期間,還是剪接處。「唇形同步感覺不對」太過模糊,無法改善製作腳本。
預算與模型選擇
使用成本較低的現行層級來驗證腳本,然後把你可能實際呈現的版本留給更高層級的測試。這就是本文中 Standard 與 Pro 的角色。創作者可以在單一 Atlas Cloud 模型工作區 中執行相同提示結構、保留測試紀錄,並進行比較,而不必為了不同介面改寫腳本。
下列數字是價格背景,並非促銷主張。它們是在 2026 年 9 月 28 日對照 Atlas Cloud 模型目錄與模型詳細頁面時查核。審閱時,目錄顯示 15% 降幅。價格與模型參數可能變更,因此在設定客戶預算前請重新查看頁面。
| 本測試使用的模型 | 頁面每秒價格,2026 年 9 月查核 | 預估 10 秒生成 | 在此協定中的最佳用途 |
|---|---|---|---|
| Kling V3.0 Standard T2V | $0.071,原價 $0.084 | $0.71 | 驗證單一發言者與輪流發言的提示結構 |
| Kling V3.0 Pro T2V | $0.095,原價 $0.112 | $0.95 | 執行混合語言或簡報候選版本 |
3 個 10 秒測試的列表總成本為 $2.37,不含任何重新執行。請將其視為簡單的規劃估計。它假設顯示的每秒價格、要求的長度會被實際表單接受,且帳戶適用的價格與公開頁面相符。實際測試平台結構描述才是可用長寬比、品質選項與原生音訊控制的最終依據。
Kling 對話唇形同步常見問題
Kling 4 正式發布了嗎?
我無法驗證 Kuaishou 是否已針對發布的 Kling 4 對話模型提供官方規格。本文使用的正式發布版本是 Kling 3.0。將「4K」或看似未來的標籤附加到 Kling 的搜尋頁面,不應被視為另有「Kling 4」產品的確認。
現在進行 Kling 對話唇形同步測試應使用哪個模型?
若要做簡短腳本檢查,請使用已驗證的現行 Kling V3.0 Standard Text-to-Video 途徑。若要做更嚴苛的後續測試,例如本文的混合語言場景,請使用 Pro。讓設定保持穩定,以便判斷結果變化是因為提示還是模型層級。
Kling 能讓 2 個人一前一後說話嗎?
Kuaishou 表示 Video 3.0 可生成具可控內容與發言順序的多角色對話。實務上,請先執行簡短的輪流發言樣本。為每位發言者命名、錨定其位置與服裝、說明鏡頭順序,並明確指示聆聽者保持沉默。
為什麼我的 Kling 影片中兩個角色都在動嘴?
場景可能讓發言者歸屬過於開放,或模型在該次執行中產生不必要的臉部動作。將測試限制為 2 個人、每人 1 句台詞。然後加入明確的沉默聆聽者指示,並搭配音訊檢視結果。如果問題仍然存在,將其回報為失敗結果,並只改變 1 個變數重新執行。
Kling 是否支援在 1 個片段中使用英文與西班牙文對話?
Kuaishou 將英文與西班牙文都列為 Video 3.0 原生音訊支援的語言。支援語言清單不等同於對任何對話腳本的保證。上方的第三個 Kling 4 對話唇形同步測試 將交流保持簡短,讓你能在同一個檔案中評斷語言交接、嘴部動作與發言者歸屬。
我應該使用 GIF 還是影片來展示唇形同步測試?
當文章需要輕量、可快速瀏覽的面部動作與發言者交接檢視時,請使用 GIF。檢視詞語與聲音時序時,請使用原始 MP4。這裡的 3 個內嵌結果是 GIF,而其原始 MP4 檔案仍留在文章素材資料夾中。


