使用MiniMax H3,如同撰寫一份簡短的製作簡報,而非單一圖像提示。這個可重複使用的結構很簡單:綁定所有參考素材,陳述核心概念,然後將場景寫成一個包含攝影機運動、對話、環境音、音樂和限制條件的計時影音序列,各自獨立成區塊。
本指南反向拆解了45個官方MiniMax H3範例,提煉出一個六部分提示詞公式,說明了end_image該放在哪裡,解釋了原生音訊提示如何改變結果,並提供了一個實用解法來處理生成影片中文字扭曲的問題。
你已經知道如何為影片模型下提示詞了。「電影級燈光、慢速推近、4K。」這些詞彙你已經用了兩年。
然後你把它貼進MiniMax H3,得到一個2K的影片片段,而且它自帶配樂。畫面看起來很棒。但節奏很鬆散。標題中的兩個字母拼錯了。音訊是模型隨機幫你選的某種空間環境音。
問題不在模型。你給它的是一個句子。它需要的是時間表。
所以我讀完了MiniMax隨H3一起發布的全部45個範例提示詞,以及它們產出的完成片段,並逐格分析了畫面。官方提示詞不是描述。好的範例是附帶音樂提示表的拍攝清單。以下是其結構、目前實際可用的參數,以及一個你可以在大約二十分鐘內重現的示範。
關鍵要點
- H3提示詞是時間軸,不是描述。最強的官方範例直接用
[0s-2s]、[2s-4s]標記切割片段,完成的影片精準命中每個節拍。 - 聲音和畫面是同一輪生成的,因此音訊必須存在於提示詞主體中。官方提示詞會給它一個獨立的區塊,詳細到「6秒處加入爵士貝斯律動」。
- 你明確拼寫出來的字,回來時是清晰的。你沒有明確拼寫的字,回來時是形似字母的噪點。 我從一個官方片段中截取了畫面,證明了這兩種情況同時存在。
- 圖像轉影片接受一個**
end_image**。提供第一幀和最後一幀,情感弧線在你花費任何算力之前就被確定了。 - 提示詞長度不是優點。當參考圖像承擔了描述工作時,簡短的官方提示詞就能奏效。提示詞的長度反映了你拒絕交給參考圖像處理的工作量。
左邊是KC Green的原版漫畫,未經修改。右邊是一次圖像轉影片呼叫的結果:輸入第一幀,輸入最後一幀,輸出十秒,火焰的噼啪聲和那句平淡的「this is fine」是模型自己的音軌。沒有人為它配樂。本指南中的所有內容,都是為了幫助你達到右邊的效果。
MiniMax H3提示詞實際上長什麼樣(我讀完了全部45個)
目前搜尋結果第一頁上的每個「MiniMax H3提示詞指南」都是一份規格表:2K、24fps、5到15秒、原生音訊。那是模型卡,不是提示詞。
這裡有一個真實的範例。這是MiniMax黑色電影風格片頭序列的官方提示詞的一部分,從中文原文翻譯而來,大約只有其完整長度的三分之一:
生成一個15秒的16:9輕懸疑犯罪片頭序列。整體風格參考這些圖像的視覺語言:復古日式動畫標題卡、硬邊剪影、漫畫拼貼、不對稱分割畫面、強烈的幾何色塊、英文片頭字幕、一點日文片假名裝飾、爵士犯罪氛圍。情緒是60%懸疑、40%爵士:神秘、酷、靈巧、都市犯罪,不要恐怖,不要沉重,也不要變成歡快的爵士MV。
[...] 英文片頭字幕必須清晰可辨 [...] 不要添加中文,不要產生扭曲的文字,不要拼錯英文。整部影片的規則:每個英文片頭字幕和職位名稱只出現一次。不要重複職位名稱,不要重複人名,不要給一個人多個頭銜。
轉場必須多樣化:圓形黑膠唱片遮罩、垂直車門式划像、人物長影橫掃畫面、紅線切、巨型英文字母遮罩、分割畫面重組、硬色塊切、一格一格貼上的面板。所有轉場都落在鼓點上:清脆、懸疑、靈巧、漫畫拼貼風格。不要軟溶解,不要流暢轉場。
BGM:原創15秒片頭音樂,60%懸疑、40%爵士。由持續的低音、緊張的撥弦弦樂、冷冽的合成器脈衝、大鼓、稀疏的爵士鼓刷、一段行走貝斯片段、短暫的上低音薩克斯風樂句和簡短的銅管重音構成。前2秒以低頻和腳踏鈸建立懸疑,3秒時低音鼓進入,6秒時爵士貝斯律動加入,10秒時出現短暫的薩克斯風/銅管樂句,最後2秒以一個緊張的和弦和鼓點收尾。
看看文字都用在哪些地方了。幾乎沒有用在「漂亮」或「電影感」上。它們用在了一個負面清單、一個轉場清單,以及一個逐秒的音樂提示表上。這就是這份工作的樣貌。
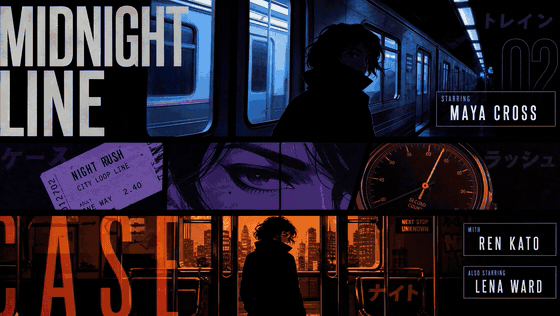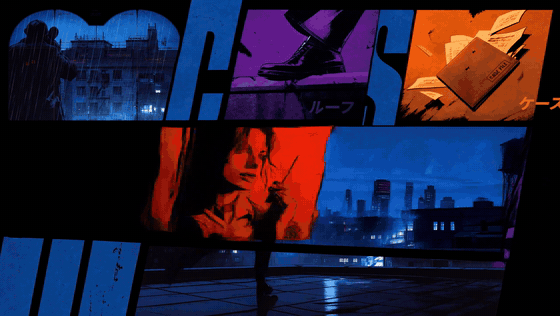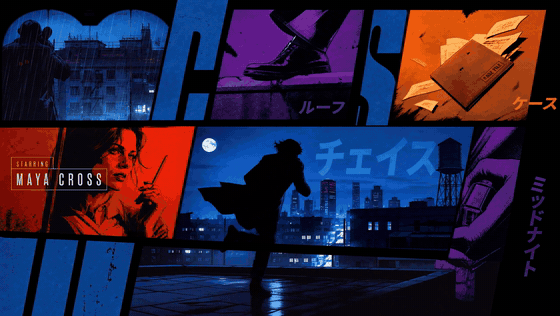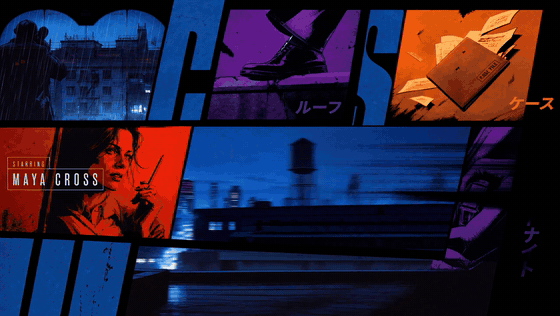 MiniMax H3官方黑色電影風格片頭序列:MIDNIGHT LINE,帶有清晰的STARRING字幕
看看那個片段中的字幕。MIDNIGHT LINE、STARRING、MAYA CROSS、REN KATO、LENA WARD、DIRECTED BY NOAH VOSS。拼寫正確,沒有職位名稱重複使用,片假名裝飾依照要求的位置擺放。提示詞沒有說「做漂亮的標題」。它說了不重複、不拼錯、不加中文,並用五種不同方式指定了美學風格。
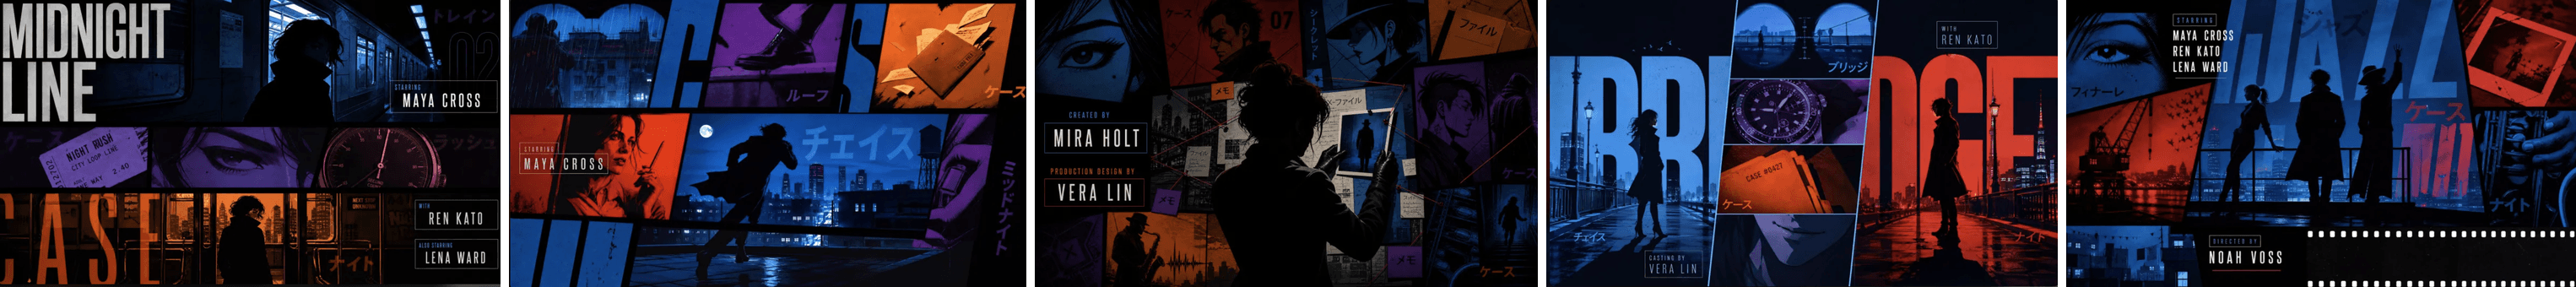 與黑色電影風格片頭提示詞一同提供給MiniMax H3的五張風格參考看板
這五張看板與文字一起輸入。五張圖像加上一份長篇簡報,一次生成。這就是這項工作現在的樣貌。
而這麼多45個提示詞中,有許多都是簡短的,原因就在這張圖裡。在整個集合中,提示詞中位數長度約為130個中文字元,但最長的兩個分別是657和858個字元。短的提示詞之所以短,是因為參考看板承擔了描述工作。長的提示詞之所以長,是因為沒有其他東西能承擔這項工作。
為什麼大部分MiniMax H3提示詞的結果平淡無奇,以及文字扭曲問題的修復
會出錯的地方有三個,而且它們都是「缺失」而非「錯誤」。
- 沒有時間軸。 你要求十秒,但只描述了一個時刻,所以你就得到一個持續十秒的緩慢推近。模型在第七秒沒事可做。
- 沒有音訊區塊。 聲音與畫面是同一輪生成的。如果你什麼都不說,模型仍然會給你一個音軌。它只是隨機選一個。
- 沒有負面清單。 放任不管,模型會傾向於使用軟溶解、發明額外的螢幕文字,並添加沒人要求過的字幕條。
最明顯的證據是官方的遊戲UI提示詞,它由六個帶時間戳的節拍構成:[0s-2s]選單、[2s-4s]右臂面板、[4s-7s]武器網格、[7s-8.5s]確認、[8.5s-10s]載入條、[10s-15s]世界載入。完成的影片按順序、準時地擊中了所有六個節拍。
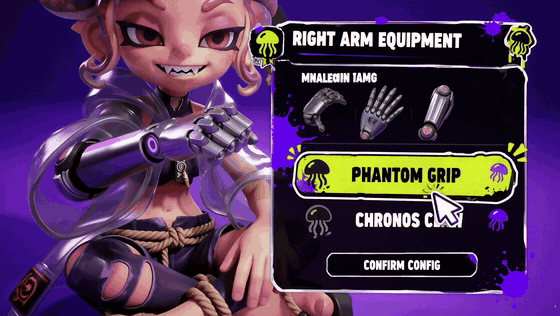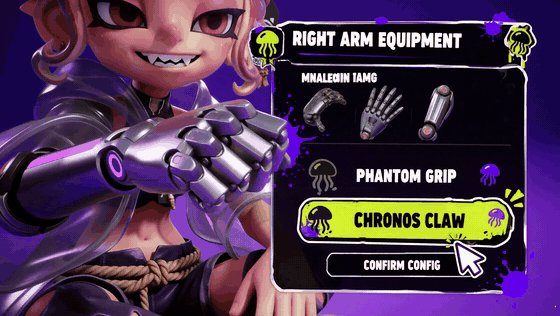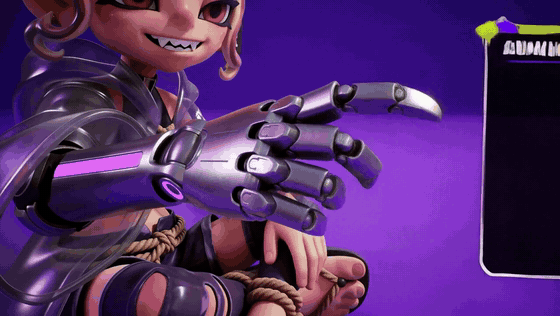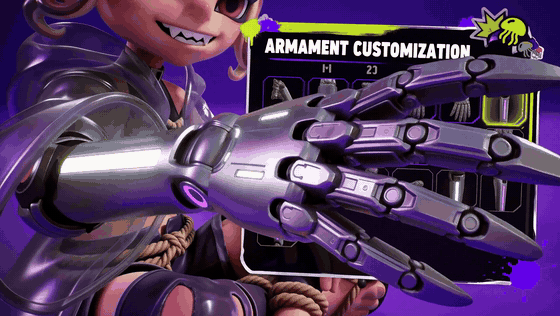 MiniMax H3遊戲UI片段:選單、裝備面板、載入條、世界載入
現在是誠實的一面,來自同一個片段,以完整的2560x1440解析度顯示。
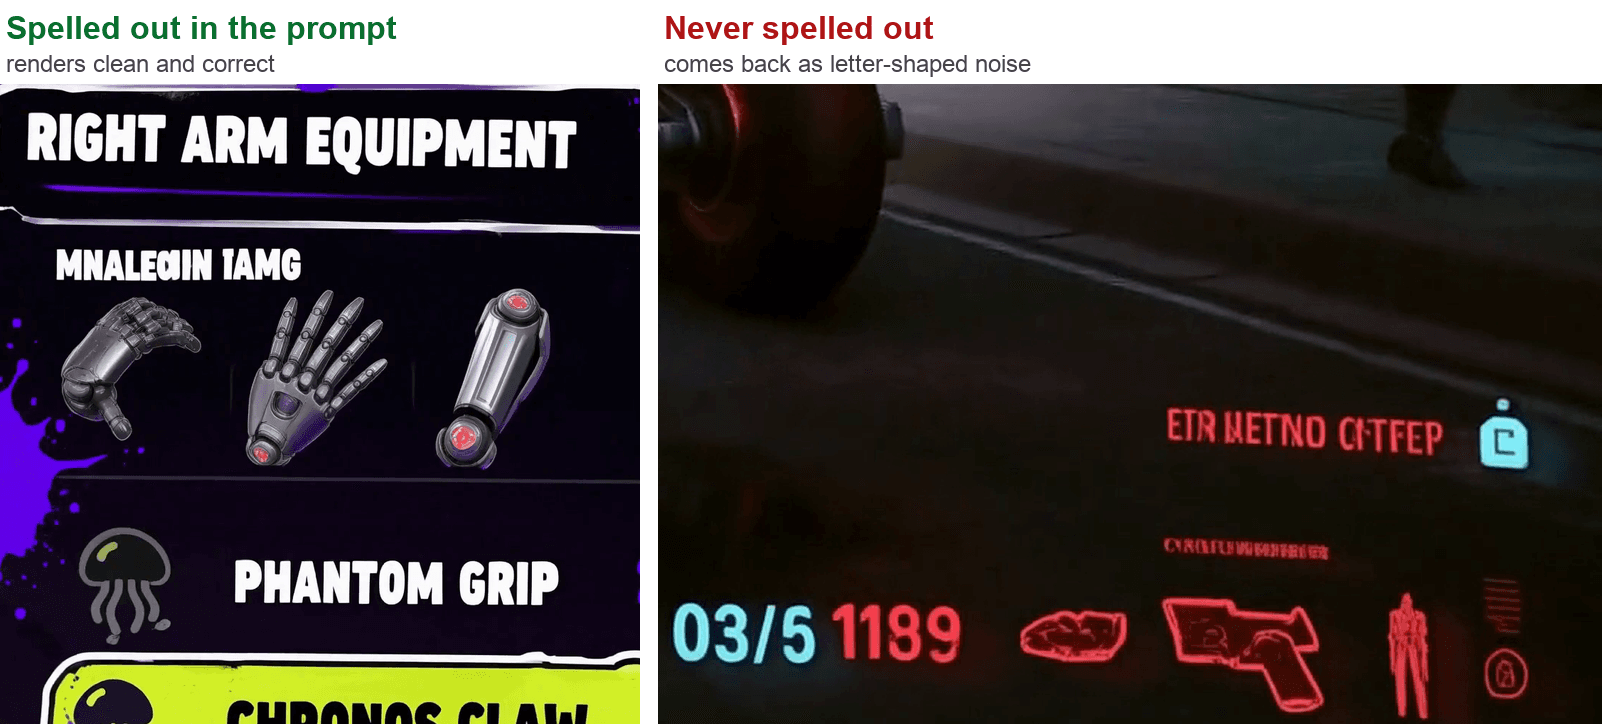 左:提示詞中明確拼寫的文字渲染清晰。右:未明確拼寫的文字渲染成字母形狀的噪點
左邊,提示詞實際打出的每個字串:RIGHT ARM EQUIPMENT、PHANTOM GRIP、CHRONOS CLAW。清晰、正確、字距調整得像真實的遊戲選單。
右邊,最終街景鏡頭中的HUD,提示詞只稱之為「HUD元素」。它顯示為ETR METNO CITFEP。在裝備圖示上方,提示詞沒有提及的地方,你得到的是MNALEαIN IAMG。這不是渲染錯誤。模型正在繪製英文字的紋理,因為它從未被賦予這個字串。
所以修復方法不是設定,而是一種習慣:
如果一個字需要可讀,就把那個字打出來。 然後加上一個負面行:不要拼錯,不要添加其他文字,不要添加字幕。
以下是每個強而有力的官方提示詞都共享的六區塊結構。
| 區塊 | 內容 | 官方提示詞範例 | 跳過它的後果 |
|---|---|---|---|
| 1. 風格合約 | 媒介、質感、色調、時代、你必須保留的外觀 | 「復古日式動畫標題卡、硬邊剪影、漫畫拼貼、強烈的幾何色塊」 | 一個通用的華麗渲染,在第六秒開始偏離 |
| 2. 時間軸 | 字面上的時間片段,每個片段有一個動作 | [2s-4s] 平滑縮放至她的右臂。UI面板從右側滑入 | 一個想法被拉長覆蓋整個持續時間 |
| 3. 攝影機 | 運動,或明確拒絕運動 | 「鎖定、靜止的廣角鏡頭、無推近、無剪輯」 | 你沒要求的預設慢速推軌 |
| 4. 音訊 | 每個聲音,以及它何時進入 | 「6秒時爵士貝斯律動加入,最後2秒以一個緊張的和弦收尾」 | 模型今天喜歡的任何空間環境音 |
| 5. 文字,明確拼寫 | 字面上的字串,加上引號 | 「THIS IS FINE.」 / CONFIRM CONFIG | 如上所述的字母形狀噪點 |
| 6. 負面清單 | 要拒絕的轉場、物體和陳腔濫調 | 「無軟溶解、無流暢轉場、不要添加中文、不要重複職位名稱」 | 軟溶解、發明的文字、詭異的漂移 |
區塊5和6是免費的。它們不需要額外的生成成本,而且大部分品質都來自這裡。
MiniMax H3提示詞工作流程:你的提示詞屬於哪個端點
同樣的認證、提交並輪詢的形狀,三個入口。你選擇哪一個,決定了你的提示詞還需要做什麼。
| 端點 | 你提供的是 | 它為你鎖定了什麼 | 值得知道的參數 | 什麼時候使用它 | 計費方式 |
|---|---|---|---|---|---|
| minimax/h3/text-to-video | 僅提示詞 | 無。文字承載一切 | duration 5-10 (預設8), resolution 2K, ratio 必須明確設定 | 在投入之前測試某個外觀或聲音設計 | 按輸出秒數計費,當前費率見模型頁面 |
| minimax/h3/image-to-video | 提示詞 + 圖像(第一幀),可選 end_image | 影片的起點,以及可選的終點 | end_image, duration 5-10 (預設8), ratio 預設為自適應 | 你有藝術作品,希望它動起來而不被重新繪製 | 按輸出秒數計費 |
| minimax/h3/reference-to-video | 提示詞 + refers[] | 主體身份和風格,在你發明的場景中 | refers[] 混合陣列, duration 5-15, ratio 最高可達21:9 | 相同的角色或產品,新的環境 | 按輸出秒數計費 |
refers\[\] 是在野外文件中真正被低估的一個,所以這裡是它想要的形狀:
json1"refers": [ 2 { "url": "https://.../subject.png", "type": "image" }, 3 { "url": "https://.../style-board.png" }, 4 { "url": "https://.../motion-ref.mp4", "type": "video" }, 5 { "url": "https://.../beat.mp3", "type": "audio" } 6] 7
四個規則,每個都能幫你節省一次浪費的生成:
- 音訊不能單獨存在。 陣列中至少需要一個圖像或影片。單獨的節拍軌會被拒絕。
type是可選的。 它會從URL推斷,但當副檔名不明確時,還是明確聲明它。- 上限是真實存在的。 最多9個圖像、3個影片和3個音訊片段,總共12個檔案,參考影片和音訊的長度各為2到15秒(MiniMax API文檔,2026年7月)。
- 在提示詞文字中,為每個參考素材指定一個任務。 這是這份清單中槓桿作用最高的習慣。官方提示詞以「圖像1是整體情緒和風格參考,圖像2是主角參考」這樣的句子開頭。沒有這句話,模型就必須猜測哪個看板代表什麼意思。
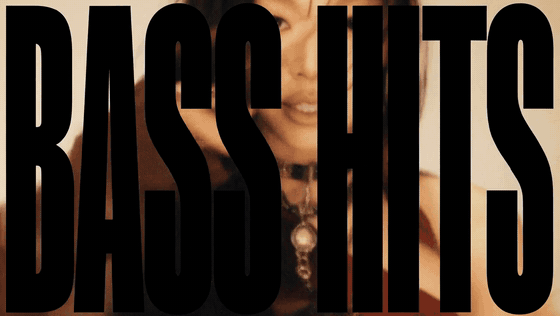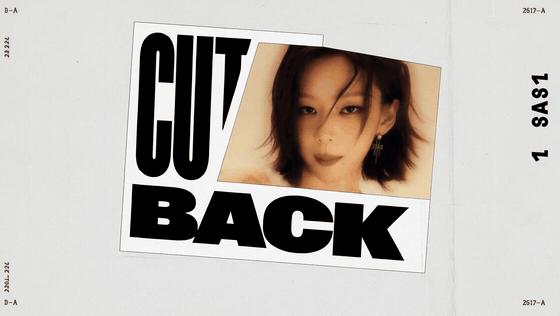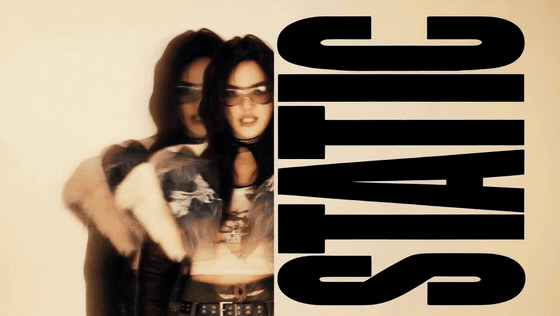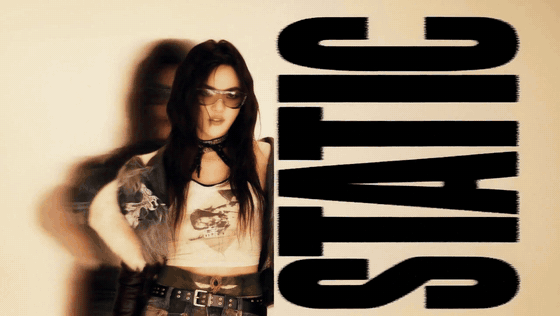 MiniMax H3暗黑流行音樂影片:CUT BACK, ONE LOOK, DETONATE 字體設計
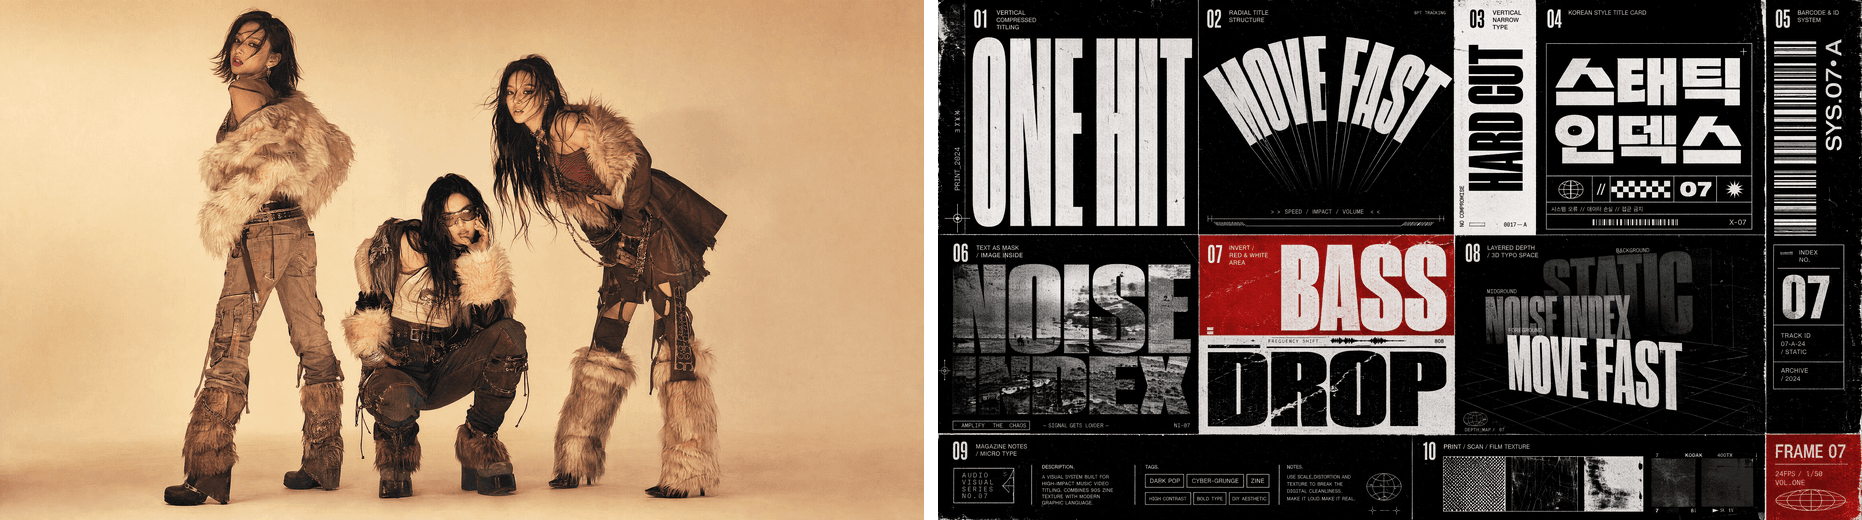 暗黑流行影片背後的兩張字體設計參考看板
那個片段是規則4的論證。它的提示詞從未描述過任何一個字母形狀。它說「文字包裝風格和質感參考這些圖像」,然後交出了兩張看板。佈局之所以出現,是因為它被展示出來,而不是被描述出來。
再來一張表格,因為模型卡和API目前說的內容不一致,而這個差距正是人們浪費一個下午的地方。
| 項目 | MiniMax自己的文檔 | 端點實際接受的內容 | 這對你的提示詞意味著什麼 |
|---|---|---|---|
| 持續時間 | 4 到 15 秒,僅限整數 | text-to-video 和 image-to-video:5 到 10,預設 8。reference-to-video:5 到 15,預設 8 | 一個15秒的拍攝清單目前只適用於 reference-to-video。將較長的看板重寫為10秒以內 |
| 解析度 | 2K | 解析度預設為2K,且目前2K是唯一能執行的值。768p的任務會返回「模型MiniMax-H3不支援解析度768P,支援的解析度:2K」的錯誤,即使768p出現在價格表中 | 以1440px短邊為基準來撰寫。你要求的細節實際上會保留下來 |
| 畫面比例 | 常見比例或自適應 | image-to-video 和 reference-to-video 預設為自適應。純文字端點拒絕自適應,並返回其允許的集合:16:9, 4:3, 1:1, 3:4, 9:16, 21:9 | 在 text-to-video 上,必須明確設定比例,否則任務將驗證失敗 |
| 混合參考 | 9 張圖像、3 個影片、3 個音訊、12 個檔案,音訊不能單獨存在 | refers[] 接受帶有 {url, type} 的內容,type 為 image、video 或 audio,至少需要一個圖像或影片 | 你確實可以將動作同步到提供的節拍。你只是不能只提供節拍 |
| 原生音訊 | 同一輪生成的立體聲音訊 | 我探測的九個官方片段中,每一個都是:2560x1440、24fps、AAC 立體聲、32kHz | 音訊區塊不是裝飾。它是交付物的一半 |
以上所有內容都在 Atlas Cloud 上執行,那裡的三個H3端點都共用同一個金鑰和同一個提交並輪詢迴圈,因此在它們之間切換只需要更改模型字串,其他都不變。
MiniMax H3提示詞教學:讓「This Is Fine」狗在火中燃燒,並附帶聲音
以下是從頭到尾的完整過程。這個笑話之所以有效,是因為狗什麼都沒做。將這種否認延伸為十秒的真實時間,加入真實的火焰,讓最後兩秒到達原始漫畫實際上到達的地方,它會變得更有趣,對你來說也更糟一點。大多數人只看過前兩個面板。
步驟1:下載原始漫畫。不要讓AI重新繪製它。
這條漫畫是六格,兩欄三行,600x887。我們只需要第2格和第6格。
bash1curl -L -o gunshow-648.png https://gunshowcomic.com/comics/20130109.png 2# 600x887, 6 panels, 2 cols x 3 rows 3 4# crop panel 2 (the "THIS IS FINE." panel): x 302-584, y 20-293 5# crop panel 6 (the melting dog): x 302-584, y 595-868 6# upscale each 4x with Lanczos -> 1128x1092 7
說得直白一點:不要要求圖像模型畫「一隻看起來像 This Is Fine 的狗。」 人工智慧重繪的作品在半秒內就會被識破是假的,這個笑話當場就死了。水彩渲染、搖晃的手寫字體和紙張紋理是整個合約。4倍Lanczos放大只是因為原始282像素太薄了;它給模型提供了真實的像素來抓住,而不會發明任何東西。
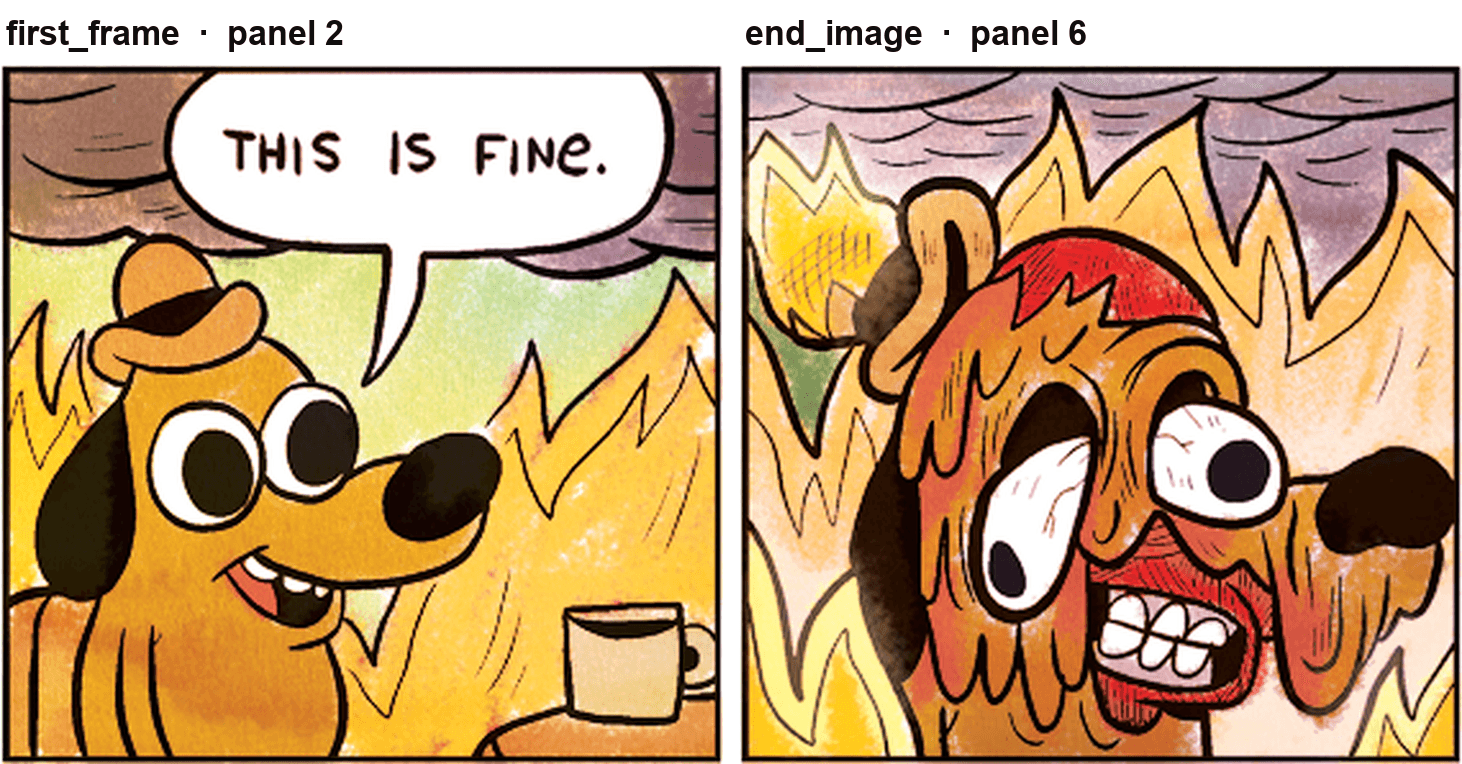 原始漫畫的第2格和第6格,標示為第一幀和結束圖像輸入
步驟2:使用 end_image 在 image-to-video 上執行。
模型:minimax/h3/image-to-video。設定:解析度 2K,image = 第2格,end_image = 第6格,比例 1:1 以匹配近正方形的來源。持續時間設為10;滑桿預設為8,所以拖動它。
text1Hand-painted 2D webcomic panel, brought to life. Keep the original watercolour 2texture, visible ink outlines, off-register paper grain and flat comic palette 3in every frame. Do not smooth, do not re-render in 3D, do not clean up the 4linework, do not add new objects, do not add new text. 5 6[0s-3s] Almost nothing moves. The dog sits perfectly still, holding the mug, 7eyes fixed forward. Only the flames behind him move: slow orange licks climbing 8the wall, one ember drifting up. The speech bubble reading "THIS IS FINE." 9stays exactly where it is, fully legible, unchanged, hand-lettered. 10 11[3s-6s] The dog lifts the mug and takes one small, calm sip. The speech bubble 12fades out after the sip. The fire brightens. The wall behind him begins to warp 13with heat. His hat starts to smoulder at the brim. 14 15[6s-8.5s] The heat reaches him. His ears sag, his outline softens and begins to 16run downward like wet paint. He still does not move his eyes. The mug stays in 17his paw. 18 19[8.5s-10s] Full melt. The face distorts, one eye slides, teeth bared in a fixed 20grin, the fur runs red and orange. He holds the pose. Hold on the final frame 21for the last half second. 22 23Camera: locked off, single static wide shot, no push in, no handheld, no cuts. 24The frame never moves. This is one continuous take inside one comic panel. 25 26Audio: room-tone of an interior fire throughout - low crackle, occasional pop of 27burning wood, a faint structural creak. At 3s, one ceramic mug touching teeth and 28a small swallow. A calm, flat, unbothered male voice says exactly: "This is fine." 29- deadpan, no emotion, slightly too relaxed. From 6s the crackle grows louder and 30the room tone thickens; the last 2 seconds add a low sub-bass swell. No music, 31no laugh track, no sound effects that are not in this list. 32 33Do not add subtitles. Do not add a watermark. Do not spell any word other than 34the words already in the image. Do not change "THIS IS FINE." Do not cut away. 35
那個提示詞就是結構表,活生生的。第一段是風格合約。四個帶括號的片段是時間軸。然後是攝影機,然後是音訊,然後是負面清單。裡面沒有任何裝飾性的內容。
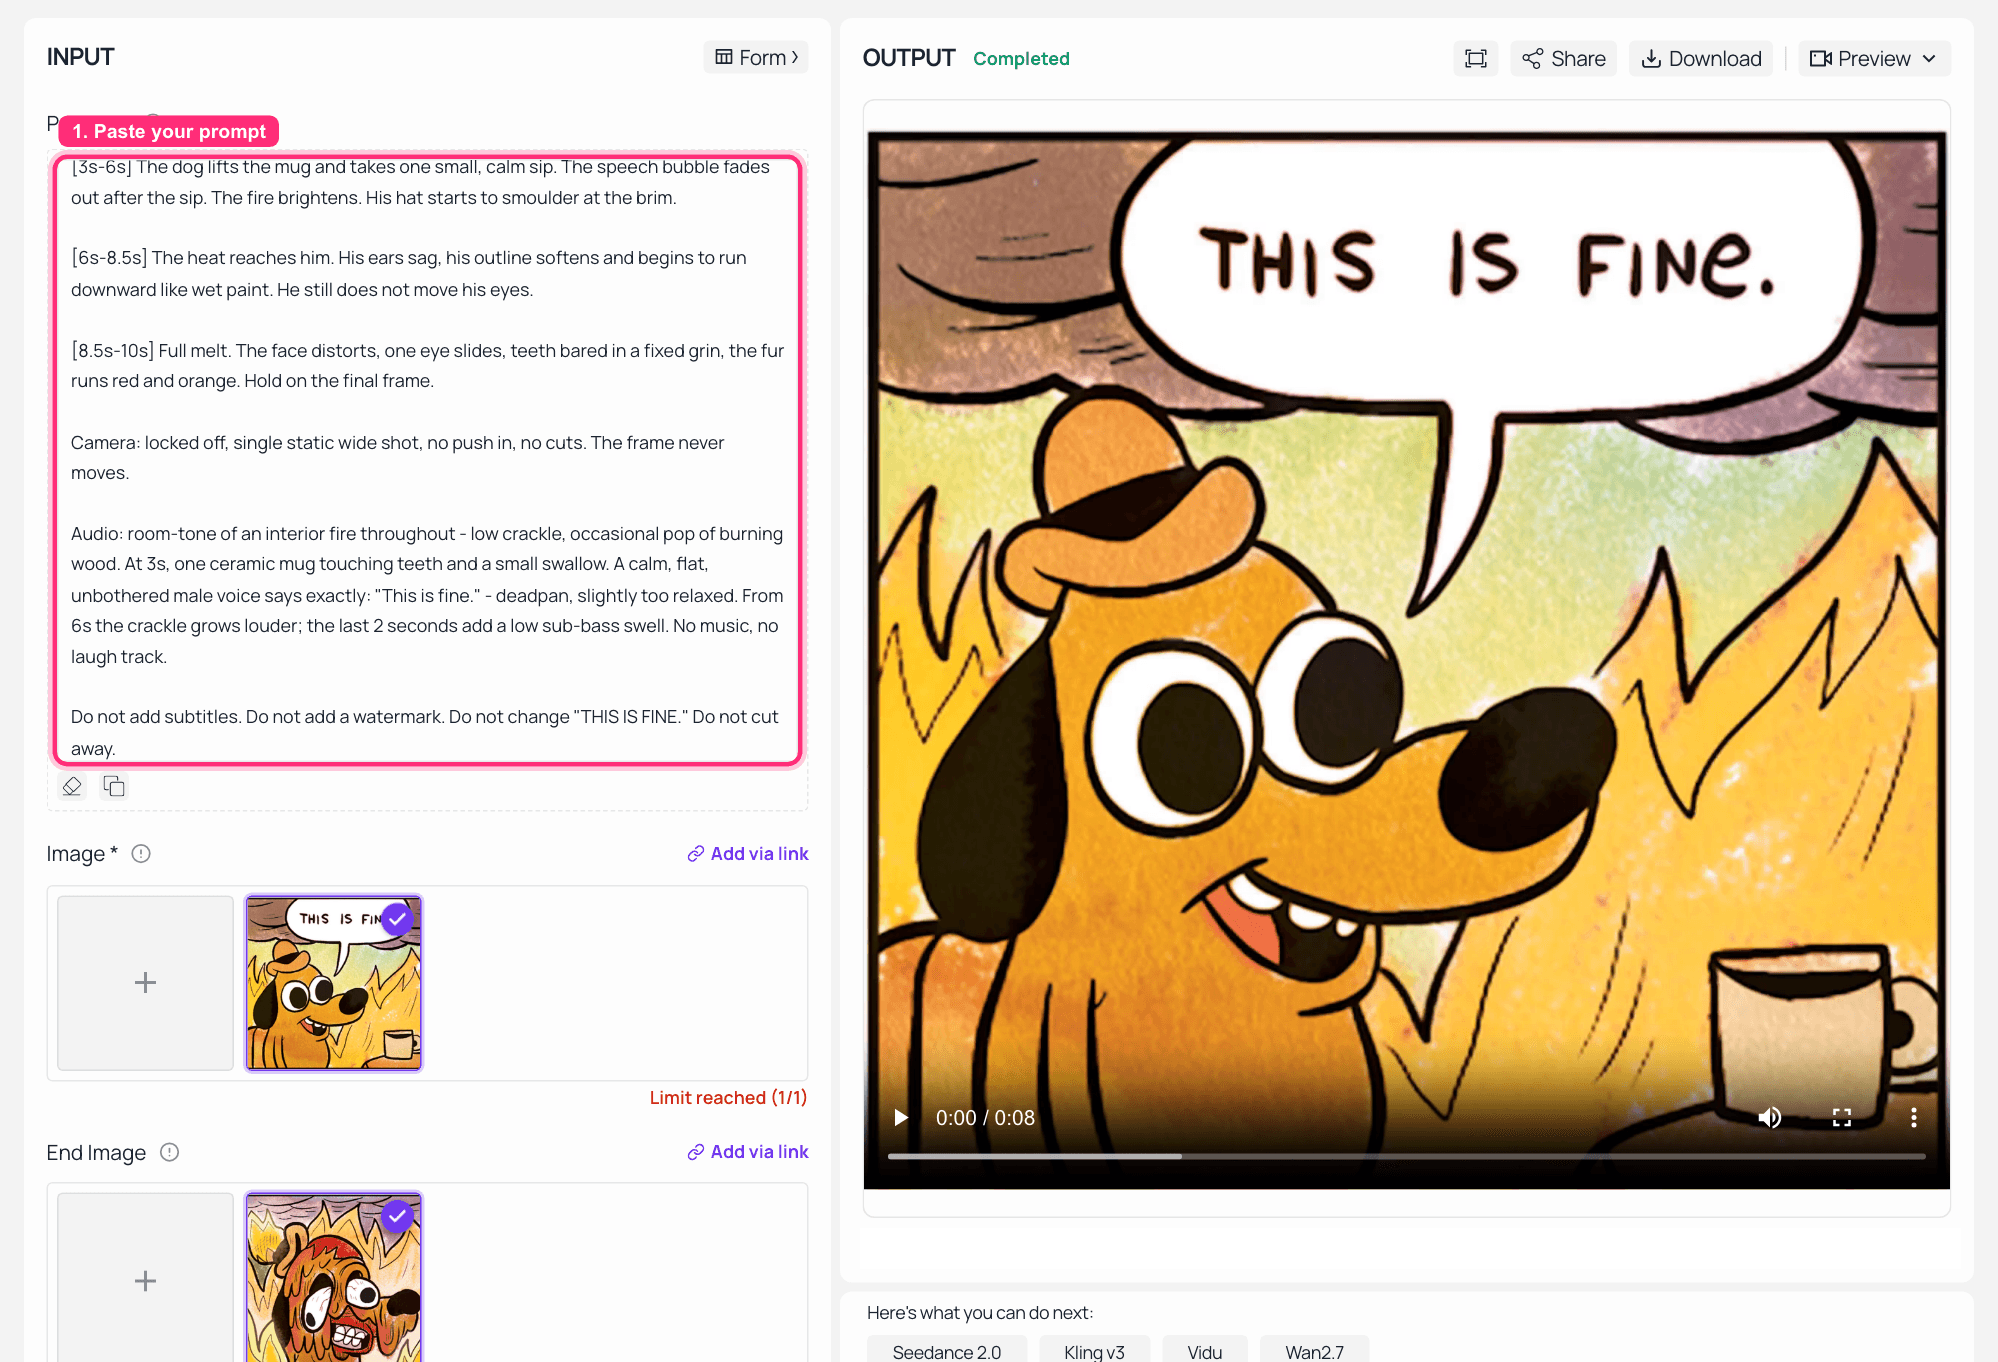 Atlas Cloud 上的 MiniMax H3 image-to-video:已載入第一幀和結束圖像,10秒,2K,輸出面板中的完成片段
步驟3:像 QA 測試一樣閱讀輸出。
四項檢查,每一項測試提示詞的不同區塊。
- 氣泡中的「THIS IS FINE.」是否仍然可讀且拼寫正確?這測試區塊5。
- 線條是否保留下來,還是某些東西將其「改進」成了乾淨的3D?這測試區塊1。
- 音訊是否只包含你列出的聲音?探測容器:它應該返回 h264 加上 AAC 立體聲。
- 最後一幀是否落在第6格的姿勢上?這測試
end_image。
bash1ffprobe -v error -show_entries stream=codec_type,codec_name,width,height,r_frame_rate,channels,sample_rate \ 2 -of default=noprint_wrappers=1 output.mp4 3
我的結果返回為 1472x1440,24fps,h264 加上 AAC 立體聲,10.13秒。值得注意的是:我要求比例 1:1,結果得到 1472x1440,所以在 image-to-video 上,來源幀的形狀勝出。將你的兩個面板匹配到你實際想要的形狀。
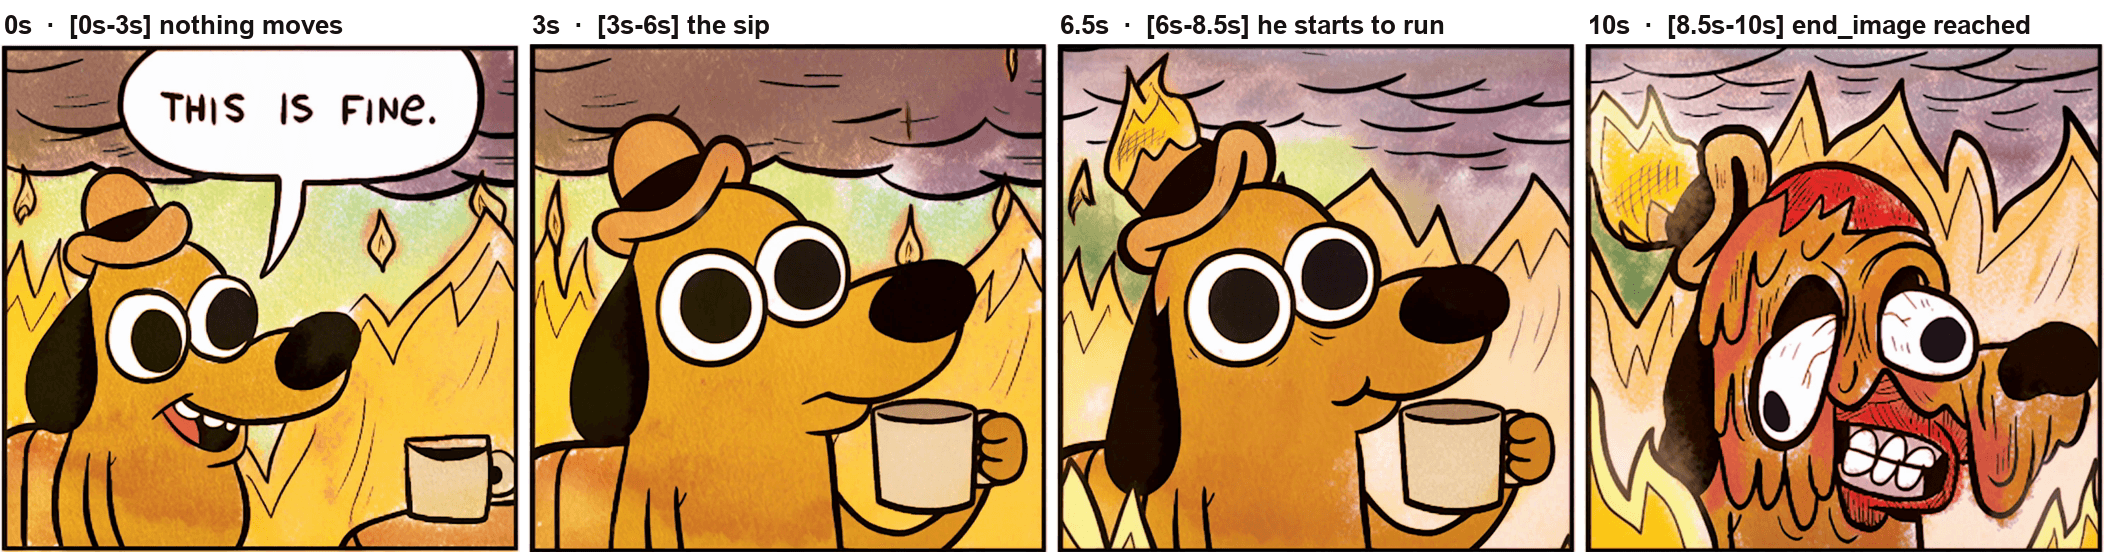 完成片段在0秒、3秒、6.5秒和10秒的四個幀,匹配提示詞中的四個時間片段
步驟4:使用 reference-to-video 將狗移動到新地方。
同一個角色,新房間。模型:minimax/h3/reference-to-video。設定:refers[] = 第2格作為圖像,duration 8,resolution 2K,ratio 16:9。
text1Image 1 is the character and art-style reference: keep this exact hand-painted 22D webcomic look, the same watercolour texture, the same ink outline weight, the 3same dog, the same little hat, the same mug. Do not redraw him in 3D, do not 4change his proportions, do not clean up the linework. 5 6Put him in a different room and keep his composure. A cramped open-plan office at 7night, fluorescent tubes flickering, a wall of monitors all showing a red error 8state, printer paper drifting down through the frame, a small electrical fire in 9the corner. He sits in an office chair at the centre of the frame, mug in paw, 10looking straight at the camera, completely relaxed. 11 12Camera: locked off, static wide shot. No push in, no cuts. 13 14Audio: fluorescent hum, printer grinding, a repeating soft alarm chirp every two 15seconds, distant electrical crackle, one calm sip at 4s. No music. No voice. 16 17Do not add any on-screen text. Do not add subtitles. Do not add other characters. 18
可遷移的規則:refers\[\] 承載身份和風格,文字承載場景。 這種分割是角色一致性背後的整個技巧,也是為什麼提示詞的第一行存在的原因。
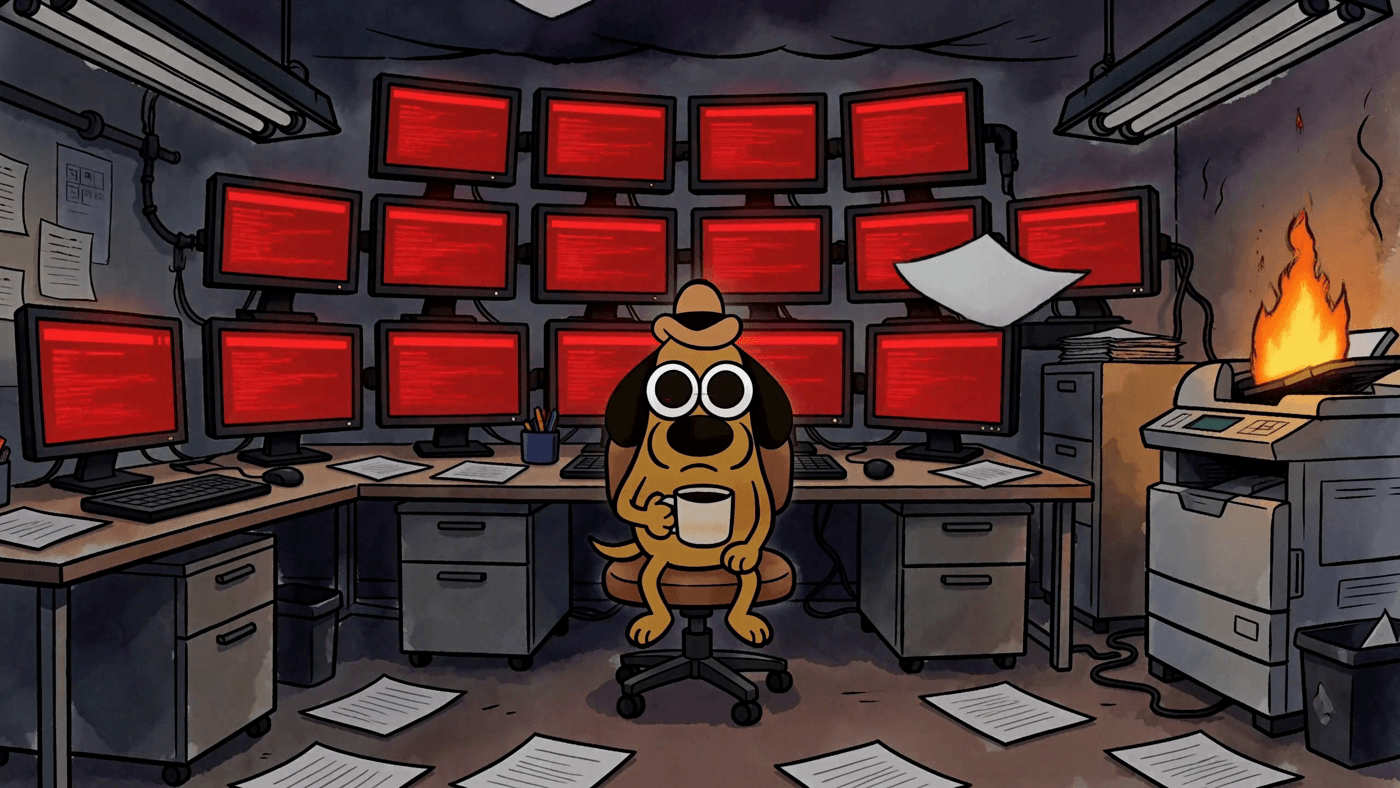 同一隻網路漫畫狗,被重新安置到一個燃燒的夜晚開放式辦公室,由 MiniMax H3 reference-to-video 生成
同樣的帽子,同樣的杯子,同樣的墨水粗細,新的房間。一張參考圖像完成了所有這些。
另外三個值得借鑒的 MiniMax H3 提示詞模式
模式1:動態海報,佈局必須保持不動。
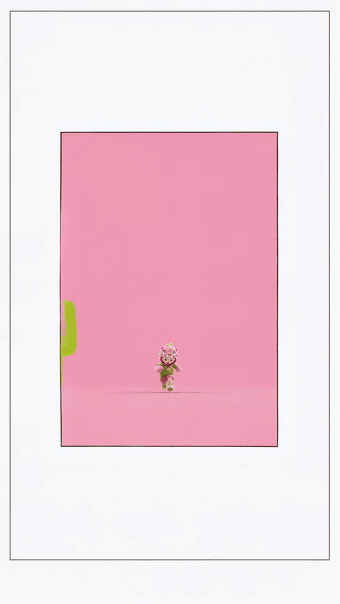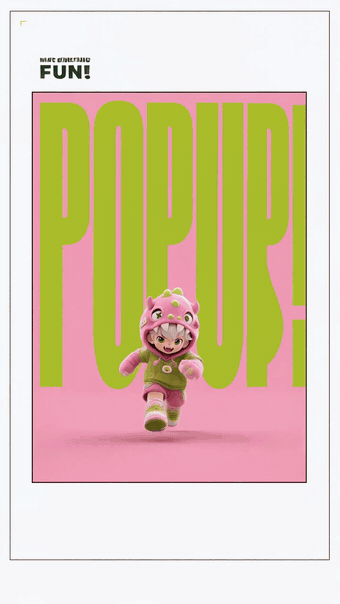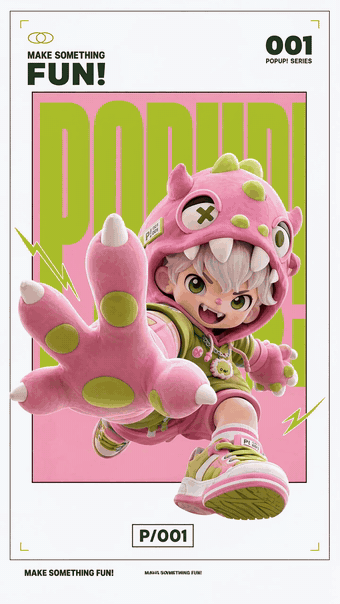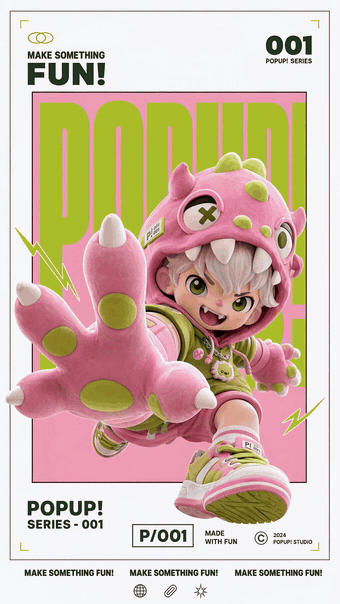 MiniMax H3動態海報:POPUP! 佈局動畫化,而框架和字體保持鎖定
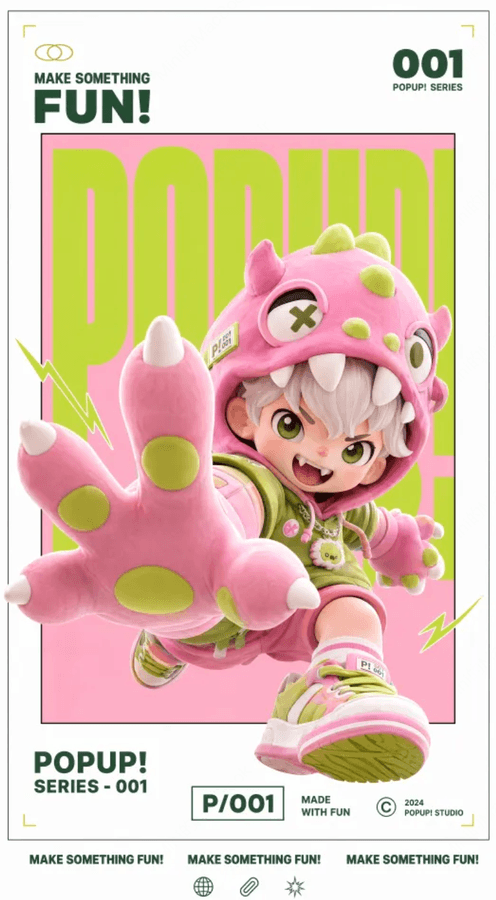 提供給 MiniMax H3 的原始靜態海報
整個提示詞只有兩行:保持畫廊的白色邊框、內框、紅白黑配色、3D 人物感覺和佈局結構不變,並在文字進入時加入一個靈巧的音效。規則:命名必須保留下來的部分。「保持佈局」不是風格說明,而是一個限制條件,模型會將其視為如此。
模式2:介面示範,動詞勝過形容詞。
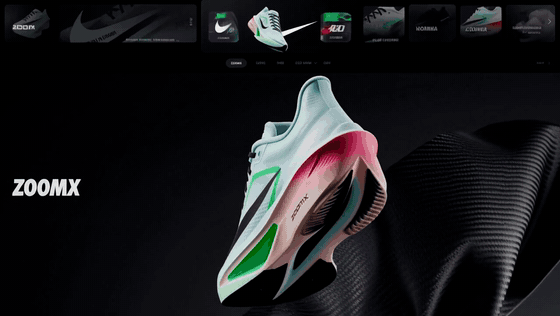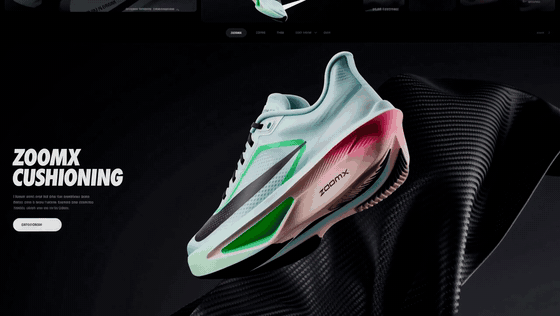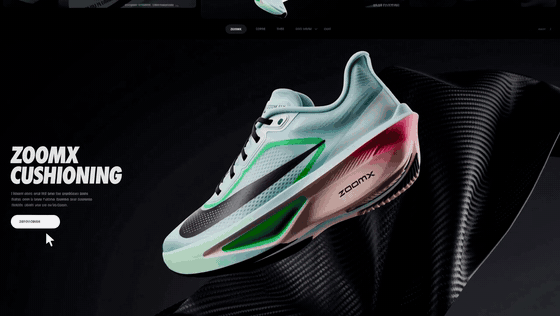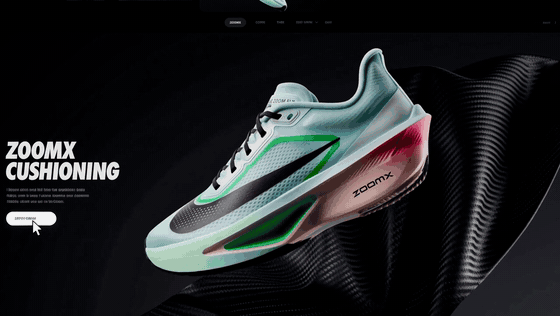 MiniMax H3登陸頁面示範:在產品頁面上滾動、懸停、顏色反轉
 登陸頁面片段背後的單一產品參考圖像
那個提示詞要求向下滾動頁面、一個懸停狀態、一個強烈的放大和一個顏色反轉。四個動詞。它從未說過「現代」或「時尚」。互動是動作,所以把它們寫成動作。 超大斜體字和碳纖維編織背景來自形容詞;讓它讀起來像真實頁面的東西來自動詞。
模式3:真人實拍加上手繪,由拒絕清單維繫。
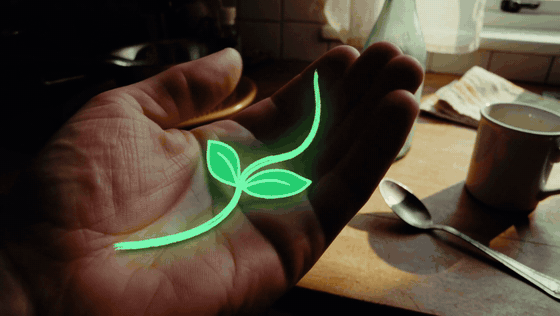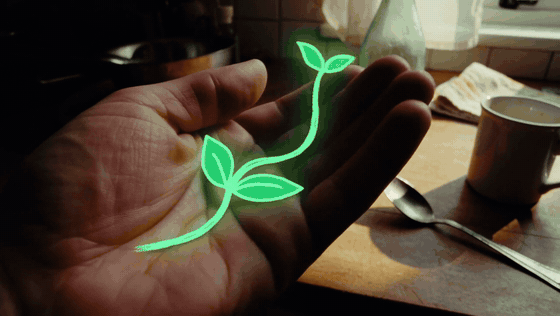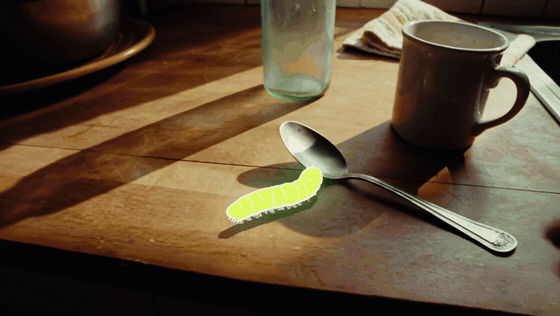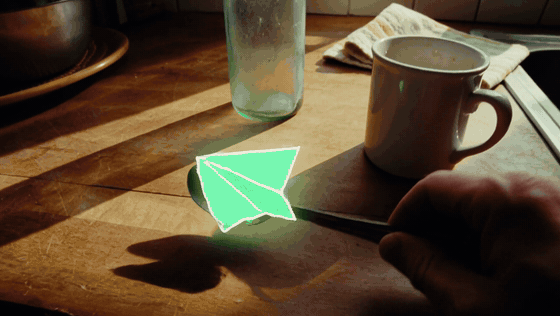 MiniMax H3片段融合了手機拍攝的廚房畫面與手繪發光生物
這是一個用手機拍攝的傍晚廚房,裡面有小小的發光手繪生物,而它之所以能保持迷人而不是變成恐怖短片,是因為一連串的禁令:沒有大眼睛、沒有裂開的嘴、沒有尖牙、沒有威脅性姿勢、沒有撲向鏡頭、沒有突然切到黑畫面、沒有驚嚇效果。負面清單是主要的風格控制,而不是修補。 它也是你編碼品味的地方。
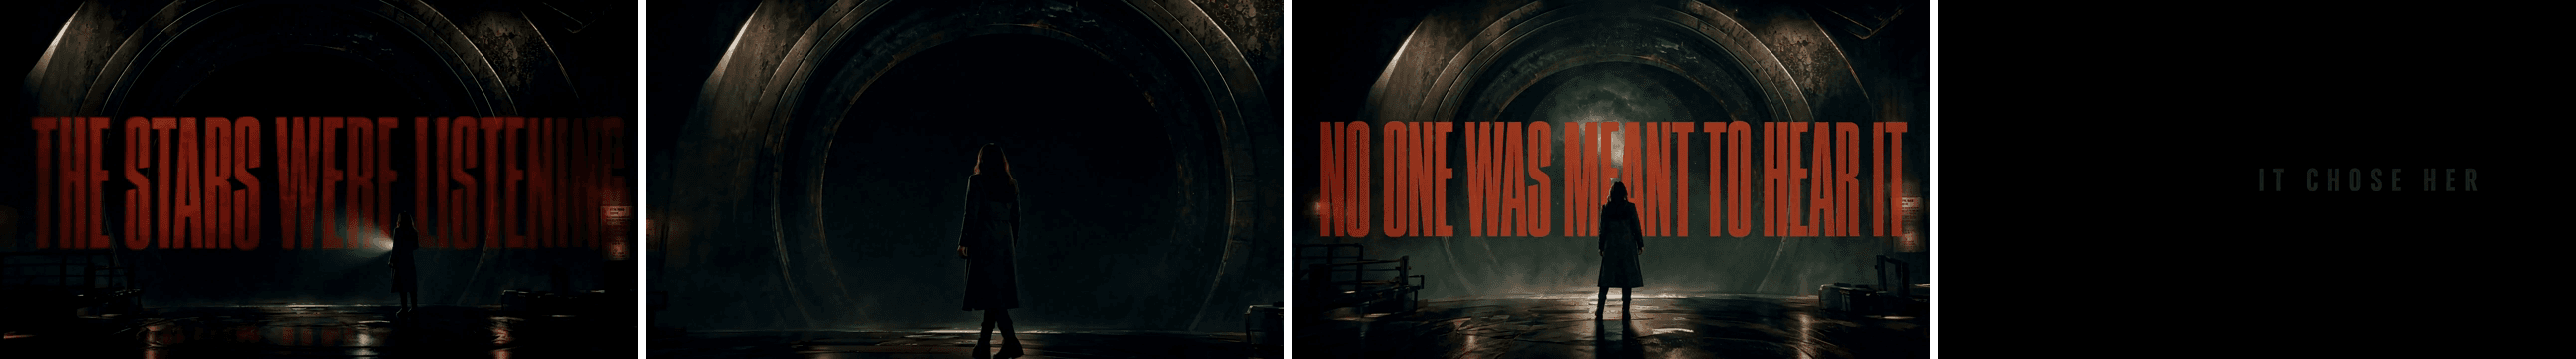 官方科幻預告片中的四個幀:THE STARS WERE LISTENING
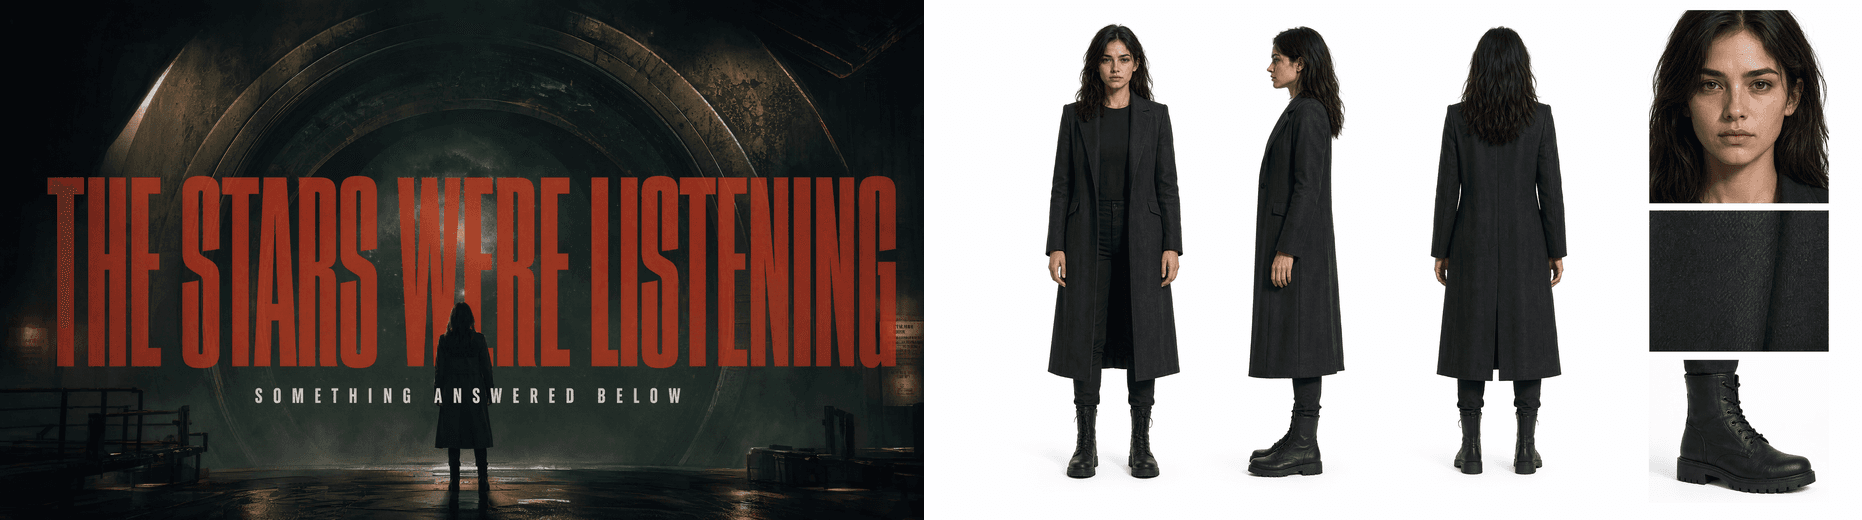 預告片背後的情緒板和角色參考
上面的預告片將這兩個想法串聯起來。提示詞詳細拼寫了一個標題,THE STARS WERE LISTENING:極窄、粗體、全大寫、深紅色混雜鐵鏽色、輕微的顆粒感和霧化邊緣。這一個完全按照要求返回。兩張參考看板處理了情緒和主角,所以文字永遠不需要描述一張臉。分工,從上到下。
執行這些 MiniMax H3 提示詞的成本是多少
H3 按生成影片的秒數和解析度計費,所以成本模型簡單得令人耳目一新:一個15秒的鏡頭成本大約是三個5秒嘗試的總和。其他一切由此衍生。
- 在5秒時迭代,在10或15秒時交付。 構圖、色調和聲音設計在5秒時都能確定。鎖定鏡頭沒有任何需要完整持續時間才能告訴你它錯了的地方。
end_image是成本工具,而不僅僅是創意工具。 大多數重跑是因為結局漂移了。鎖定最後一幀可以在你付費之前消除這個失敗模式。- 負面清單和明確拼寫的文字是免費的。 它們為提示詞增加了字元,但提示詞是按秒計費,而不是按 token 計費。大量使用它們。
- 在撰寫之前,先將持續時間與端點匹配。 建立一個15秒的拍攝清單,然後發現你的端點上限是10秒,這會讓你付出重寫的代價,而不僅僅是重跑。
目前還不應該規劃進去的一件事:價格表列出一個更便宜的768p層級,但截至本文撰寫時,768p的任務會被直接拒絕,2K是唯一能執行的解析度。預算時,假設每一秒都是2K秒。當前每秒費率在模型頁面上,一旦768p層級開放,也會顯示在那裡。
MiniMax H3 提示詞、迷因和版權
這隻狗並非公共領域。This Is Fine 來自 KC Green 的網路漫畫 Gunshow 第648集,於2013年1月9日發布,只有前兩個面板真正走紅(Know Your Meme,2013年1月)。Green 曾公開、相當厭倦地談論過看著這個圖像被無止盡地重複使用,包括被那些他不同意其政治立場的人使用(NPR,2023年1月)。
這個逐步解說屬於評論和教學用途,而非素材庫。如果你想商業化發佈某些東西,請自行繪製你的幀,或者為你使用的素材取得授權。在執行客戶專案之前,請先執行你自己的政策檢查:H3 對可識別的真人以及知名 IP 套用內容規則,在截止日期前發現這個問題可不好玩。
常見問題
MiniMax H3 是否會生成音訊,還是我之後再添加?
同一輪生成。畫面和聲音是一起輸出的,這正是為什麼音訊必須寫入提示詞主體中,而不是之後再附加。為它提供一個獨立的 Audio: 區塊,並說明每個聲音何時進入。我探測的九個官方片段中,每一個都在 2560x1440、24fps 的影片串流旁邊,返回了 32kHz 的 AAC 立體聲。
MiniMax H3 提示詞可以有多長?
根據 MiniMax 文檔,最多 7,000 個字元。在實踐中,官方範例的範圍很廣,中位數約為 130 個中文字元,最長的兩個分別是 657 和 858 個字元。當參考圖像承擔了描述工作時,簡短的提示詞效果很好。如果你沒有參考素材,請預期要撰寫一個拍攝清單。
為什麼我的 MiniMax H3 影片中的文字會扭曲?
因為你沒有打出來。在提示詞中實際出現的字串會清晰渲染;你用泛稱提及的任何東西(「HUD 元素」、「一些標籤」)都會回來成為字母形狀的紋理。拼寫出每個必須可讀的單字,然後加上「不要拼錯,不要添加其他文字,不要添加字幕」。
一個 MiniMax H3 提示詞可以使用多少張參考圖像、影片和音訊片段?
九張圖像、三個影片和三個音訊片段,總共十二個檔案,參考影片和音訊的長度各為 2 到 15 秒。音訊不能是唯一的參考。請注意,模型能力與特定端點暴露的內容是兩回事,因此請檢查模型頁面以了解目前的輸入列表。
MiniMax H3 提示詞能否控制影片的結局,而不僅僅是開頭?
可以,在 image-to-video 上,透過可選的 end_image 參數。提供第一幀和最後一幀,影片會在它們之間進行插值。上面的示範正是如此:漫畫第2格輸入,第6格輸出。保持兩張圖像的畫面比例相似,否則轉場會變得很難看。
我目前實際上可以得到哪些持續時間和解析度?
2K,而且只有 2K。768p 的任務目前會被拒絕,並顯示「支援的解析度:2K」的錯誤,儘管 768p 出現在價格表中。持續時間因端點而異:text-to-video 和 image-to-video 接受 5 到 10 秒,預設為 8,而 reference-to-video 接受 5 到 15 秒。另一個陷阱:在純文字生成端點上,API 拒絕自適應,並要求一個明確的比例。


