

這句台詞是關於想念某人。聲音是以悲傷情緒設定生成,但參考人像卻掛著燦爛笑容。這正是靜態分鏡無法回答的衝突。為了讓 OmniHuman 2.0 情感語音與臉部表情匹配 更具體,我們先固定同一張人像與同一段 9.68 秒語音,然後生成兩段臉部方向相反的影片。另外兩段影片則使用相互匹配的憤怒與悲傷人像、語音語氣和方向。無聲 GIF 讓你檢視可見表情。
有一個重要的版本界線。Atlas Cloud 現在列出 Avatar Omni Human 2.0。我們在 2026 年 10 月 20 日於 Atlas 測試環境執行的請求,在渲染前就回傳上游不支援模型錯誤。本文中四段完成的虛擬人像影片,都是在該環境使用 Avatar Omni Human 1.5 生成。它們展示的是相關的音訊驅動工作流程與實用診斷方法,並非實測的 OmniHuman 2.0 效能。
重點摘要
- 先聆聽提供的音訊。在下方測試中,同一段悲傷錄音在方向改變時,產生了明顯不同的視線、嘴部與手勢選擇。
- 微笑的來源人像可能把表情帶進開場影格,即使提示詞要求克制。
- 第二組透過讓起始人像、語音語氣與方向各自配合情緒,使憤怒與悲傷明顯不同。這並未隔離單一輸入作為原因。
- 在有聲與無聲下比較相同時間戳;描述實際改變了什麼,而不是假設提示詞完全照字面生效。
- 在使用某個版本的結果來說明另一個版本之前,先檢查模型版本與完成的輸出。
音訊、人像與提示詞各自貢獻什麼
Atlas 將 Omni Human 2.0 描述為音訊驅動的虛擬人像模型,可接受參考圖像、WAV 或 MP3 音軌,以及可選的文字提示詞。其公開模型頁面列出 720p 輸出,以及 4 到 300 秒的輸入音訊。頁面表示提示詞可指示手勢、動作、場景細節與攝影機移動。這些是產品頁規格,並非聲稱每個要求的面部節拍都會出現在生成片段中(Atlas Omni Human 2.0 模型頁面)。
較早的 OmniHuman-1 論文將這個研究系列描述為以圖像、音訊、文字與其他訊號為條件的人類動畫。它並未確立後續產品版本的確切控制方式或結果(OmniHuman-1 論文,ICCV 2025)。對準備進行一次測試的創作者而言,更簡單的分工更有用:
| 輸入 | 測試中的工作 | 要檢查什麼 |
|---|---|---|
| 人像 | 錨定人物身分與初始表情 | 臉部是否可見,起始笑容是否與預期情緒衝突? |
| 音訊 | 提供實際詞語、時間、停頓與語氣 | 錄音聽起來是否像腳本暗示的情緒? |
| 提示詞 | 要求錄音周圍的可見行為 | 臉部、視線與手勢是否真的遵循那些方向? |
嘴部動作與情緒表達是分開的檢查。一張臉可以看似在說話,但眼睛與笑容傳達錯誤意義。靜止畫面可以揭示表情,但只有帶原聲的影片能讓你判斷語音與臉部的關係。
真實測試輸入:悲傷台詞與微笑來源圖像
我們刻意使用 Atlas 的微笑範例人像,而不是已經悲傷的臉。臉部清晰且正面,讓生成表情容易檢視,但起始的咧嘴笑為悲傷台詞創造了嚴苛案例。
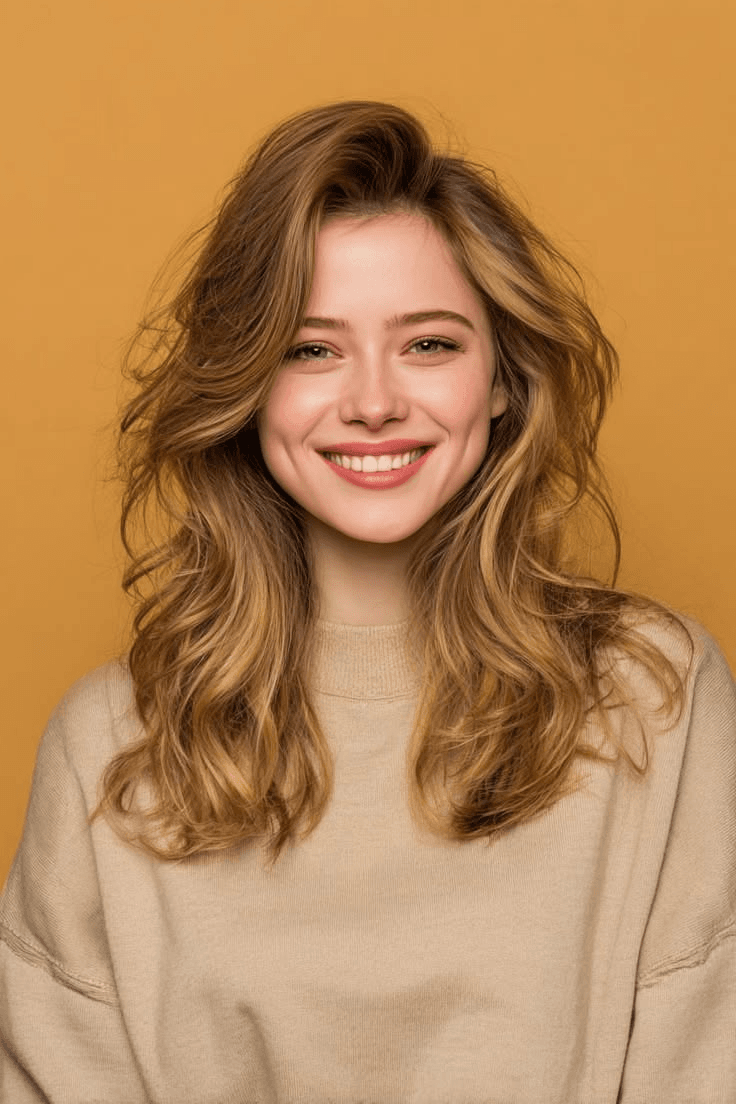 兩段影片的固定輸入圖像。笑容是來源圖像的一部分,因此請將開場數秒與後續表演分開檢視。
音訊方面,我們使用 Atlas 測試環境的 MiniMax Speech 2.6 HD Playground,搭配英文「Upset Girl」聲音與 sad 情緒設定。確切台詞是:「我以為你今天會在這裡。我一直盯著門口,即使大家都走了。我比我能說的更想念你。」產生的 MP3 長 9.68 秒。兩次虛擬人像執行都使用同一個音訊檔與同一張人像;只有可選的方向提示詞改變。兩者都回傳帶有音軌的 9.8 秒 MP4。這是小型實用比較,不是正式模型基準測試。
這項輸入選擇很重要。腳本給說話者理由往下看或忍住笑容,而參考照片則暗示相反。如果臉部一直微笑,先問來源圖像或方向在那次生成中哪個影響更大。不要假設加入更多情感形容詞就能解決衝突。
兩段真實影片結果:相同聲音,不同臉部方向
執行 A:要求克制表情
以下是第一次完成的 Omni Human 1.5 執行所用的方向:
女子安靜而悲傷地對鏡頭說話。她一開始的燦爛笑容在第一個字之前消退。眉毛保持輕微皺起,眼睛濕潤且低垂,嘴部克制。在最後一句時,她回頭看鏡頭但不微笑。頭部與手部動作極少;穩定中近景。
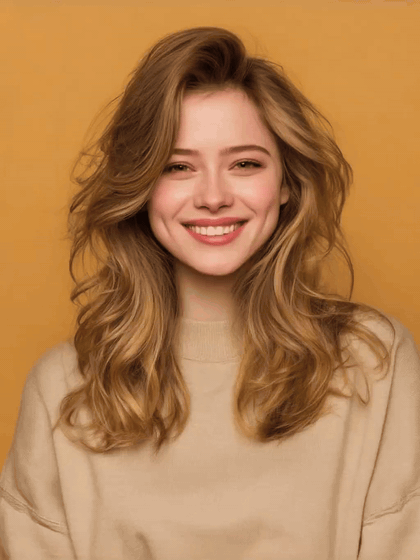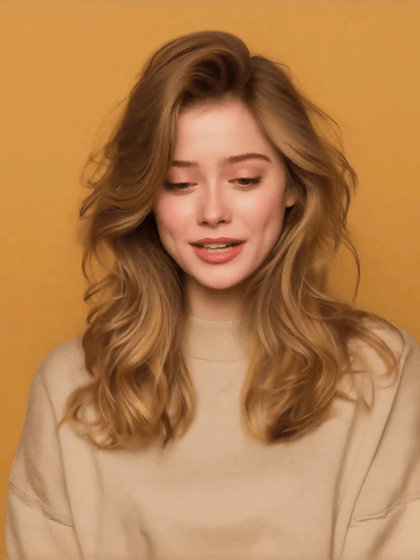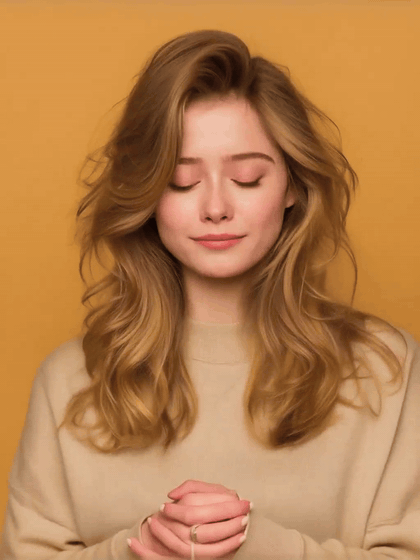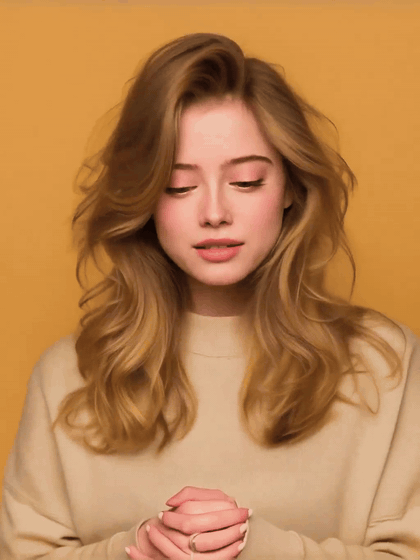
執行 A,Atlas 測試環境,Avatar Omni Human 1.5。此 GIF 無聲。開場影格仍帶有來源笑容;約 2 到 4 秒時視線下垂、嘴部放鬆,接近 6 到 8 秒時眼睛低垂或閉上。提示詞並未完全如要求在第一個字之前移除笑容。
執行 B:要求與台詞衝突的笑容
人像與悲傷 MP3 保持不變。我們只改變方向:
女子開朗地對鏡頭說話,整段音訊都帶著燦爛愉快的笑容。眼睛保持有神,眉毛放鬆;說話時加入輕快的小點頭。不要讓笑容消退,即使在最後一句也一樣。手部動作極少;穩定中近景。
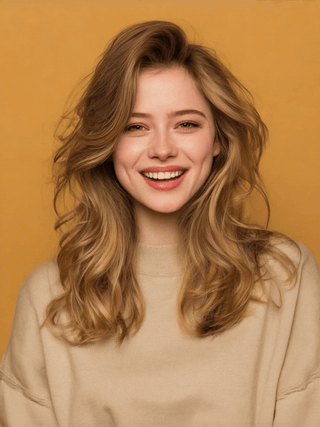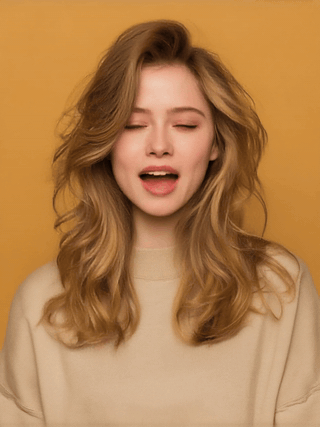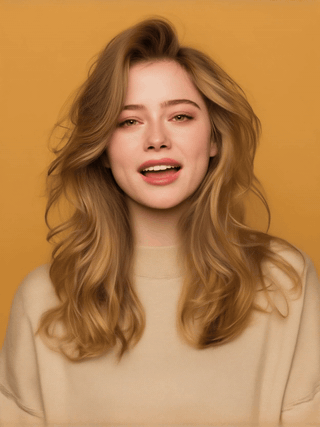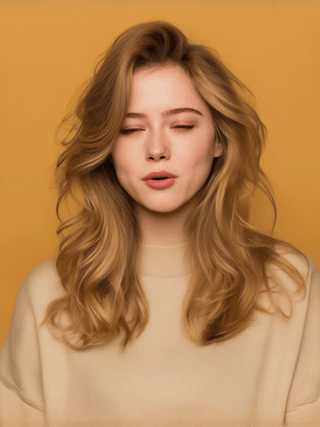
執行 B,Atlas 測試環境,Avatar Omni Human 1.5。在 2 到 6 秒時,她更常看向鏡頭並保持淺笑。笑容在接近結尾時緩和,因此「從頭到尾」並未照字面遵循。與提供的悲傷台詞相比,視覺提示仍比執行 A 更不一致。
這兩個結果比一般「要有情緒」提示詞更清楚回答了標題的實務問題。單靠音訊並未在兩次生成中強制產生相同的可見情緒。文字方向影響了生成的視線與表情,而強烈微笑的輸入在開場仍保持可見。這些觀察適用於這兩次 1.5 執行。它們並未量化 Omni Human 2.0 的表情準確度。
檢查相同時刻,然後做一個改變
下方影格對照來自兩段真實影片約六秒處。左側結果往下看並將雙手靠攏;右側結果面向觀眾並帶著淺笑。這是輸出的視覺比較,不能取代以原聲播放片段。
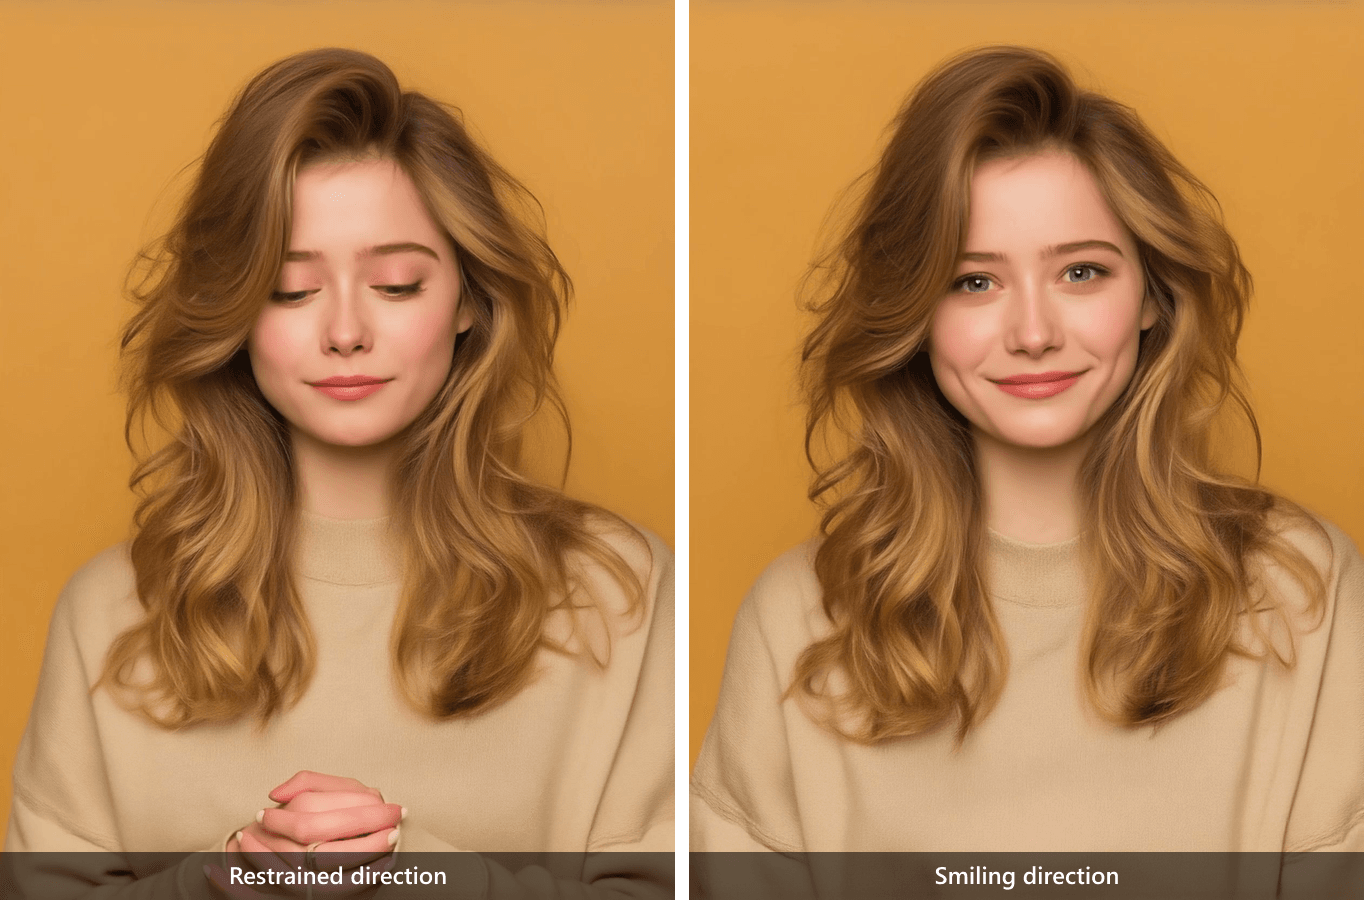 同一人像與悲傷音訊,約 00:06。左:克制方向。右:微笑方向。兩張影格皆來自實際 Omni Human 1.5 輸出。
為自己的片段進行三輪檢查:
- 不觀看,只聆聽。 標記帶有情感的詞語與停頓。在此測試中,關於看著門口與想念某人的台詞,就是需要保護的意義。
- 在那些時刻靜音觀看。 檢查眼睛、嘴角、頭部角度與手勢。說話者可以動嘴唇,卻仍顯得愉快或疏離。
- 同時播放聲音與畫面。 判斷臉部是支持台詞、削弱台詞,還是改變其意義。若失敗,改變一個輸入或指示,然後再次檢視相同時間戳。
| 這兩段片段中的時刻 | 執行 A,克制方向 | 執行 B,微笑方向 | 比較支持什麼 |
|---|---|---|---|
| 開場 | 兩者都繼承來源人像的燦爛笑容 | 兩者都繼承來源人像的燦爛笑容 | 在要求改變生效之前,來源表情就可見 |
| 約 00:04 | 視線下垂,嘴部相對中性 | 視線較靠近攝影機,表情較輕 | 方向改變的不只是嘴部動作 |
| 約 00:06 | 眼睛保持低垂;雙手交握 | 眼睛面向攝影機;仍留有淺笑 | 相同音訊可伴隨明顯不同的可見情感提示 |
| 約 00:08 | 眼睛閉上,表情保持克制 | 直視目光回來,但笑容已緩和 | 兩個提示詞都未從頭到尾逐字遵循 |
這是有用的檢視表,不是數值品質分數。我們執行的樣本不足以將提示詞效果與模型的隨機變異分開。這些影片讓創作者判斷這個特定生成結果是否服務於預期句子。
更廣泛的對比:同一句台詞的憤怒與悲傷
執行 A 與 B 固定人像與錄音,以檢視一次方向變更。為了更明顯的情感對比,我們用同一位說話者與同一份台詞製作了兩段新短片。這次來源表情、語音語氣與影片方向都各自配合預期情緒。目的是展示兩個實用最終結果,而非聲稱單一參數造成差異。
共用的台詞是:你答應過你會在這裡。我等了一整晚,盯著門口。發生這件事後,我不知道該怎麼信任你。 在 Atlas 測試環境中,MiniMax Speech 2.6 HD 以相同的 English_captivating_female1 聲音、英文語言、速度 1、音量 1、音高 0 讀了兩次。我們將第一段錄音的情緒設為 angry(6.73 秒),第二段設為 sad(7.34 秒)。本文未嵌入任何音訊檔;GIF 為無聲。
從上方使用的同一張微笑照片開始,我們用 Seedream v4.7 Edit 製作了兩張參考人像。這些是實際輸入至虛擬人像模型的圖像:
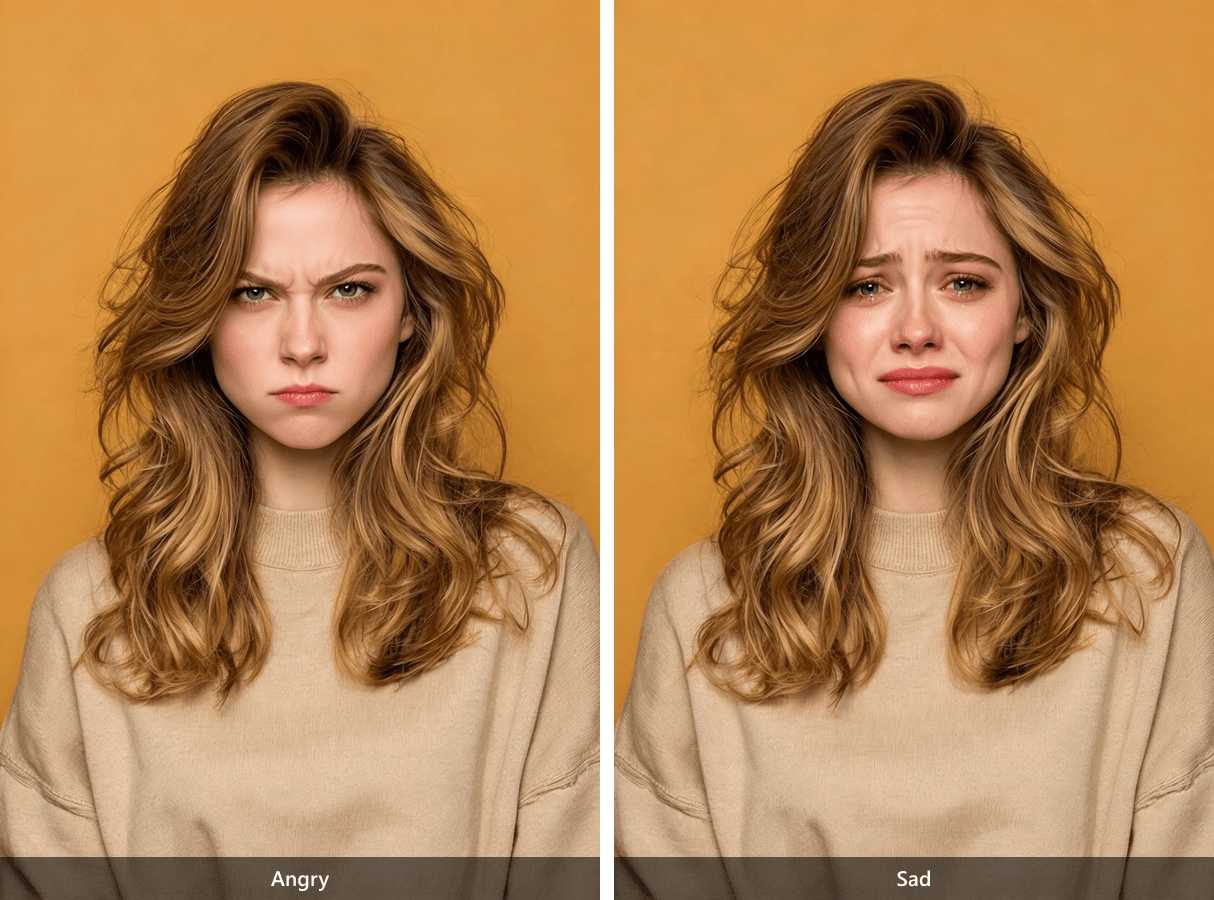
左:眉毛低垂、皺起,嘴巴緊閉。右:內側眉毛上揚、眼睛濕潤、嘴角下彎。兩者都從原始微笑人像編輯而來;編輯也改變了細微臉部細節,因此兩個來源除了表情外並非像素完全相同。
憤怒人像的完整 Seedream 編輯指示為:
將女子的臉編輯成明顯憤怒但克制的表情:眉毛降低並皺在一起,眼睛瞇起成嚴厲直視,下顎緊繃,雙唇緊閉。保留同一位女子的身分、髮型、米色毛衣、橘色背景、光線、攝影風格、攝影角度與中景人像構圖。不要微笑,不要流淚,不要額外人物或物件。
悲傷人像則使用:
將女子的臉編輯成明顯悲傷:內側眉毛上揚並皺在一起,眼睛濕潤且低垂,嘴角向下,雙唇輕閉,肩膀略微下垂。保留同一位女子的身分、髮型、米色毛衣、橘色背景、光線、攝影風格、攝影角度與中景人像構圖。不要微笑,不要憤怒瞪視,不要額外人物或物件。
兩段完成的虛擬人像片段都使用 Avatar Omni Human 1.5、1080p 輸出與種子 20261021。長度為 6.76 與 7.40 秒,接近對應錄音。
執行 C:承諾被打破後的憤怒
憤怒人像與 angry 錄音搭配以下完整影片方向:
她以克制的憤怒直接對鏡頭說話。她的眉毛保持低垂並皺在一起,眼睛瞇起,下顎緊繃,片語之間嘴唇緊閉。在「promised」時,她微微前傾,短暫舉起一隻手指向;最後一句時,她保持強烈直視。不要微笑,不要流淚。保持攝影機穩定,中近景,橘色背景不變。
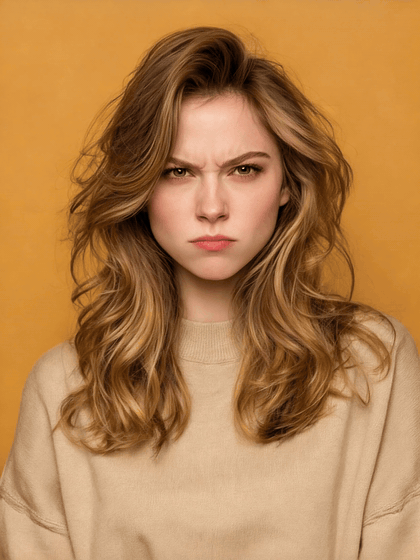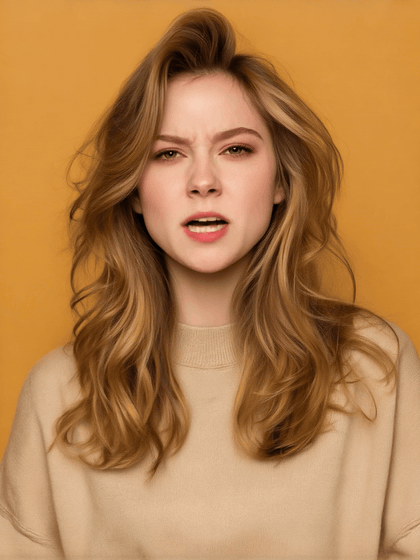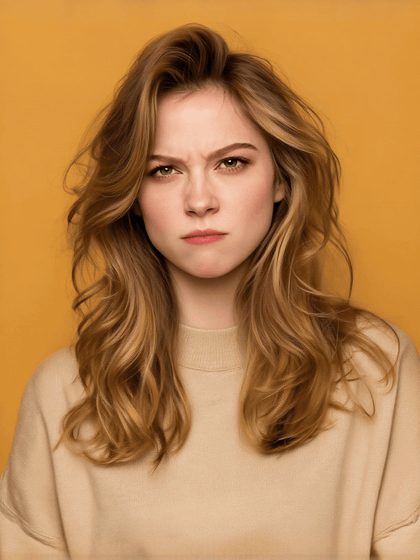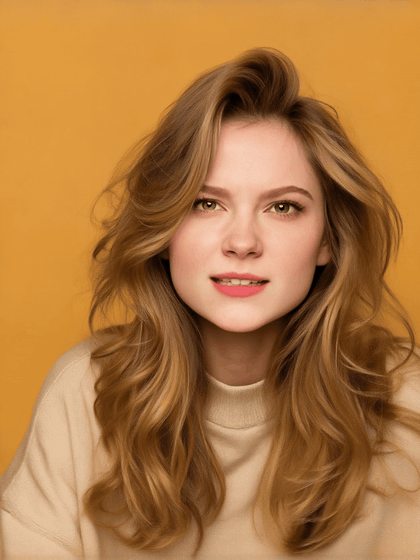
執行 C,Atlas 測試環境,Avatar Omni Human 1.5。開場與中段左右,她以瞇眼與皺眉說話。表情在接近結尾時緩和;要求的指向手勢並不清楚可見。此 GIF 無聲。
執行 D:同一段承諾被打破後的悲傷
悲傷人像與 sad 錄音搭配不同方向:
她帶著悲傷對鏡頭說話。她的內側眉毛上揚並皺在一起,眼睛泛淚且低垂,肩膀下垂,嘴巴放鬆成微微下彎。在「waited all night」時,她往下看並停頓;接近最後一句時,她抬頭但不笑。不要憤怒瞪視或指向手勢。保持攝影機穩定,中近景,橘色背景不變。
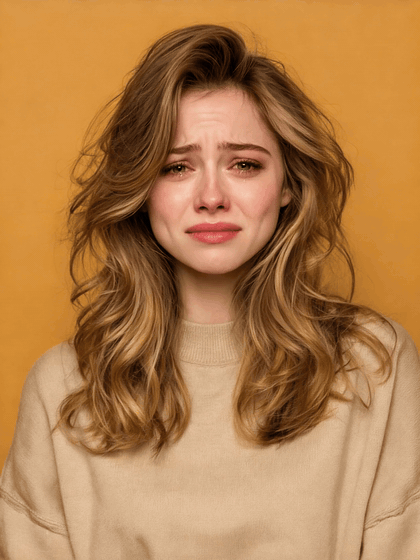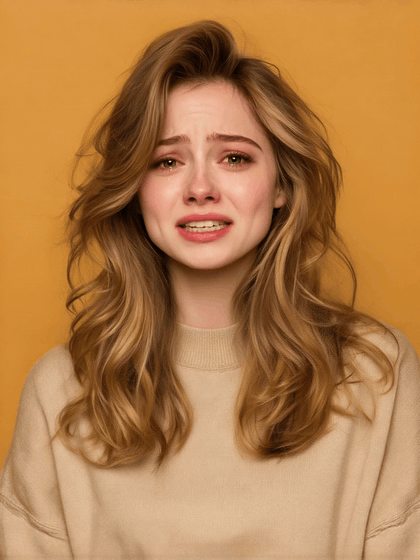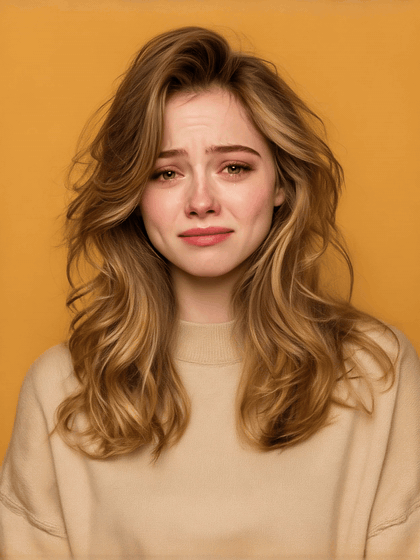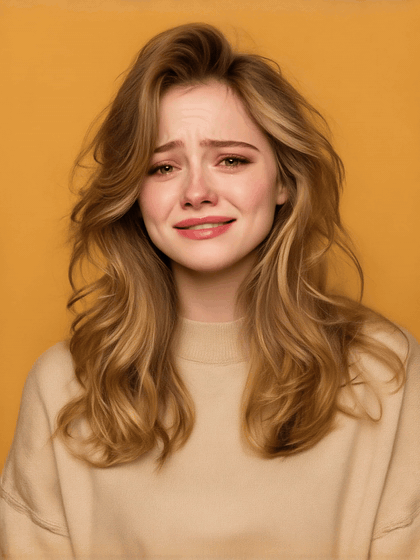
執行 D,Atlas 測試環境,Avatar Omni Human 1.5。濕潤的眼睛、淚水與上揚的內側眉毛在片段中保持可見。她大多面向攝影機,而非在要求的片語處清楚往下看。此 GIF 無聲。
在相同時刻,C 看起來緊張且帶對抗感,而 D 看起來悲痛。差異在完成影片中可見,不只是編輯後的起始影格。由於人像、錄音與方向全都一起改變,這些範例展示的是輸入互相匹配的工作流程,而非僅針對語音情感的受控測試。若要判斷任一張臉是否精確跟隨語氣,請以原聲檢視其原始影片;無聲 GIF 無法建立語音與表情的時間關係。
為說話或歌唱撰寫提示詞,不要與音軌相衝突
先從你希望觀眾注意到的音訊事件開始,然後寫出最小的可見動作。對於安靜台詞,要求視線低垂或嘴部克制,而不是「最大程度的悲傷」。若語氣要真正改變,請在聽得見的停頓之後放置微笑或點頭。如果錄音從頭到尾都悲傷,從頭到尾的愉快表情就是像執行 B 那樣刻意的不匹配。
唱歌也使用相同檢視原則,不過我們並未為本文生成唱歌片段。可測試的方向會是:中近景。歌手看起來專注,在持續音期間短暫閉眼,然後在樂句結束時下壓下巴。保持攝影機穩定。 提供的歌曲仍決定歌詞、音符長度與時間。以開著音樂的方式判斷真實唱歌輸出;靜態分鏡無法確認臉部是否跟隨持續音。
只有在錄音有明確節拍時,才保留「然後」或「最後」等時間詞。避免堆疊衝突方向,例如「固定攝影機」與「環繞攝影機」。如果提示詞漏掉一個節拍,簡化或移動一個提示,而不是同時重寫人像、音訊與方向。
疑難排解平淡或不匹配的表情
| 你注意到什麼 | 可能需檢查的地方 | 下一個最小測試 |
|---|---|---|
| 悲傷台詞以咧嘴笑開場 | 人像本身在微笑 | 在保持音訊與提示詞固定的情況下,嘗試使用開場表情適合場景的來源人像 |
| 臉部在嚴肅句子中保持愉快 | 提示詞要求微笑或輕快語氣 | 移除該指示,並要求一個具體的克制動作 |
| 臉部改變了,但嘴部時間點感覺不對 | 來源錄音、剪輯或生成的結果 | 使用更乾淨、更短的音訊剪輯,並比較相同詞語 |
| 提示詞要求一個從未出現的節拍 | 錄音沒有聽得見的停頓或轉變 | 將方向移到實際停頓處,或移除它 |
| 兩個輸出差異比預期小 | 模型可能未遵循每個表情提示 | 再嘗試生成一次,然後判斷此限制是否對使用案例重要 |
執行 A 與 B 也顯示為什麼「更多提示詞細節」不是萬用修正。兩者都未遵循其方向中的每個字。有用結果是更具體的診斷:來源笑容在開場持續,而後續視線與表情可以不同。這告訴你下一步該改變哪個部分。
OmniHuman 2.0 在 Atlas Cloud 上可用嗎?
是的,目前的英文 Atlas 模型頁面 列出了 Avatar Omni Human 2.0。這更正了本文先前的版本,該版本稱此模型未列於目錄中。列出並不等同於在每個環境都能成功生成。在 2026 年 10 月 20 日,我們透過 Atlas 開發 Playground 提出的 2.0 請求因上游訊息 req_key <realman_avatar_picture_omni20_cv> not supported 而停止;其頁面表示失敗的請求未被收費。該次嘗試未產生 2.0 影片。上方成功片段因此標示為 1.5。
對於實際專案,請開啟確切模型頁面,並用自己的輸入確認一次完成的執行。2.0 頁面列出圖像、4 到 300 秒的 MP3 或 WAV、可選提示詞方向,以及 720p 輸出。1.5 文件有不同限制與解析度選項,因此不要將本文的 1.5 片段視為 2.0 基準測試。請查看目前 Atlas 模型目錄以了解即時可用性與定價。
發布前檢查權利與情境
在分享動畫人物之前,請確認已取得將該人像與聲音用於預期目的的許可。也要針對情境檢視音樂、肖像、聲音與發行權。當觀眾可能誤以為是紀錄片素材或真人當前聲明時,請標示合成或編輯過的影片。將來源圖像、音訊、提示詞與輸出保存在一起,讓協作者能了解實際生成了什麼。
對 OmniHuman 2.0 情感語音與臉部表情匹配 而言,下一個有用步驟是使用完成的 2.0 輸出進行受控測試:選擇起始表情適合錄音的人像,標記一個情感節拍,撰寫一個可見方向,然後在有聲與無聲下比較相同時間戳。上方四段 1.5 影片展示如何進行該檢查,以及衝突笑容可能長什麼樣子。
常見問題
OmniHuman 2.0 會在此工作流程中生成聲音嗎?
Atlas 模型頁面將上傳的音軌描述為必要輸入。在本文中,另一個 MiniMax 語音模型先製作了語音錄音;虛擬人像模型再根據該 MP3 驅動人像。不要將虛擬人像輸出視為它發明口說台詞的證據。
為什麼悲傷聲音仍有笑臉?
起始圖像與可選的輕快提示詞可能傾向笑容,即使詞語是悲傷的。執行 A 與 B 從同一張微笑照片開始,但當方向改變時,後續視線與表情不同。在決定哪個提示主導之前,先以有聲方式檢視自己的片段。
OmniHuman 2.0 能製作唱歌動畫嗎?
Atlas 將唱歌列為 2.0 的使用案例,並由音訊提供表演。我們並未在此完成 2.0 唱歌執行。使用一段簡短、以人聲為主的段落,並在有聲的真實影片中檢查持續音與樂句結尾。
提示詞應重複對白或歌詞嗎?
通常不需要。音訊已提供詞語與時間。請以與錄音一致的用語來指示可見表情、手勢、取景或場景。
本文有生成 OmniHuman 2.0 影片嗎?
沒有。Atlas 測試環境中的 2.0 請求在渲染前失敗。本文以 GIF 顯示的兩個結果是在該環境中使用 Avatar Omni Human 1.5 生成,並已據此標示。





