

你要求角色在畫面中做出手勢,但你的來源是臉部特寫。再巧妙的句子都無法確定還原缺失的肩膀、手部或服裝細節。OmniHuman 2.0 從一張影像生成全身手勢 的最佳做法是協調搭配:給模型一個包含你想移動之身體部位的畫面、帶有明確演出提示的音訊,以及一段描述單一動作的簡短提示詞。
OmniHuman 是一套音訊驅動的人像影片生成系統。其宣傳的工作流程會結合靜態影像與音訊,並可選擇用文字指示動作或鏡頭行為。請將「全身」視為你想要的演出類型,而不是保證每一張肖像都能產生完整、穩定的人物形體。本文引用的公開文件規格是針對 OmniHuman 1.5,因此不應假設它們能描述每一個 OmniHuman 2.0 介面或部署。
重點摘要
- 來源影像決定可見的身體範圍與起始構圖。
- 音訊提供說話或歌唱的時間節奏;提示詞則加入視覺指示。
- 讓裁切範圍配合手勢,並將要求的動作保持在可見畫面內。
- 開始前,請在目前官方產品頁面上確認版本、輸入限制與價格。
OmniHuman 2.0 能為全身手勢做什麼
OmniHuman 2.0 被呈現為一種以影像與音訊驅動、用來建立人物演出影片的方式。靜態影像確立主體與初始視角。音訊為演出提供聲音、節奏與時間參考。可選文字則可描述場景、動作或鏡頭方向。生成的片段會將這些提示結合成動態結果。
這讓任務不再只是讓靜態影像中的嘴巴動起來。一個有用的成品可能包含唇部動作、表情、頭部動作、姿態與手勢。這些部分需要與同一場演出協調一致。以口頭解說為例,在重要語句處做一個小幅張開手掌的手勢,可能比持續擺動手臂更自然。以歌唱為例,身體可以隨著整首歌的樂句與能量起伏。
模型不會從單張照片取得該人物的完整 3D 紀錄。它必須推斷裁切範圍外的內容,以及主體移動時被遮住的表面應該是什麼樣子。因此,當輸入只顯示臉部時,要求全身動作會帶來更多不確定性。實際可控的做法是:圍繞你需要的動作來選擇參考影像,再用文字微調已有視覺依據的部分。
OmniHuman 1.5 的研究專案頁面說明了從單一影像進行音訊驅動動畫,並討論動作與提示詞控制。這對了解此模型系列是有用的背景資訊,但無法證明特定的 OmniHuman 2.0 提示詞每次都會產生特定手勢(OmniHuman 1.5 專案頁面)。
在選擇輸入之前,請用一句話定義預期鏡頭:「半身主講人強調一個重點」、「全身表演者在歌唱時轉移重心」,或「特寫講者平靜地說出一句台詞」。這麼一來,畫面與音訊就能服務這項單一任務。
選擇能為手勢留出空間的來源影像
若要生成全身手勢,請先從仍適合最終構圖的最寬來源影像開始。如果成果是要做成特寫說話頭像影片,緊湊的肖像可能合適。如果觀眾需要看到手部指向某個物件,或主體轉移重心,請在來源影像中包含這些部位。
| 預期結果 | 有用的起始裁切 | 可合理要求的動作 |
|---|---|---|
| 特寫旁白 | 頭部與肩膀 | 表情、轉頭、收斂的肩部動作 |
| 產品說明 | 半身且雙手可見 | 簡短指向、展示或張開手掌強調 |
| 站姿表演 | 全身,且身體周圍留有空間 | 姿態變化、重心轉移與較大幅度手勢 |
這些是製作上的選擇,並非 BytePlus 公布的要求或成功保證。就全身畫面而言,請在手部、手肘和腳部周圍留一些緩衝空間。已經貼齊邊緣的手,一旦移動就可能被裁掉。讓臉部保持足夠清晰可辨,盡可能使用均勻光線,並避免來源中另有他人穿越主體。乾淨的背景也更容易看出不必要的背景動作。
影像應該類似你打算發布的鏡頭。將直式肖像來源放入橫式輸出,可能需要更多被推想出來的背景與身體區域。若站姿角色是要發布為直式社群貼文,直式構圖的來源通常更容易判斷。這些是構圖指引;實際的長寬比或解析度限制,請查看目標工具目前的控制項。
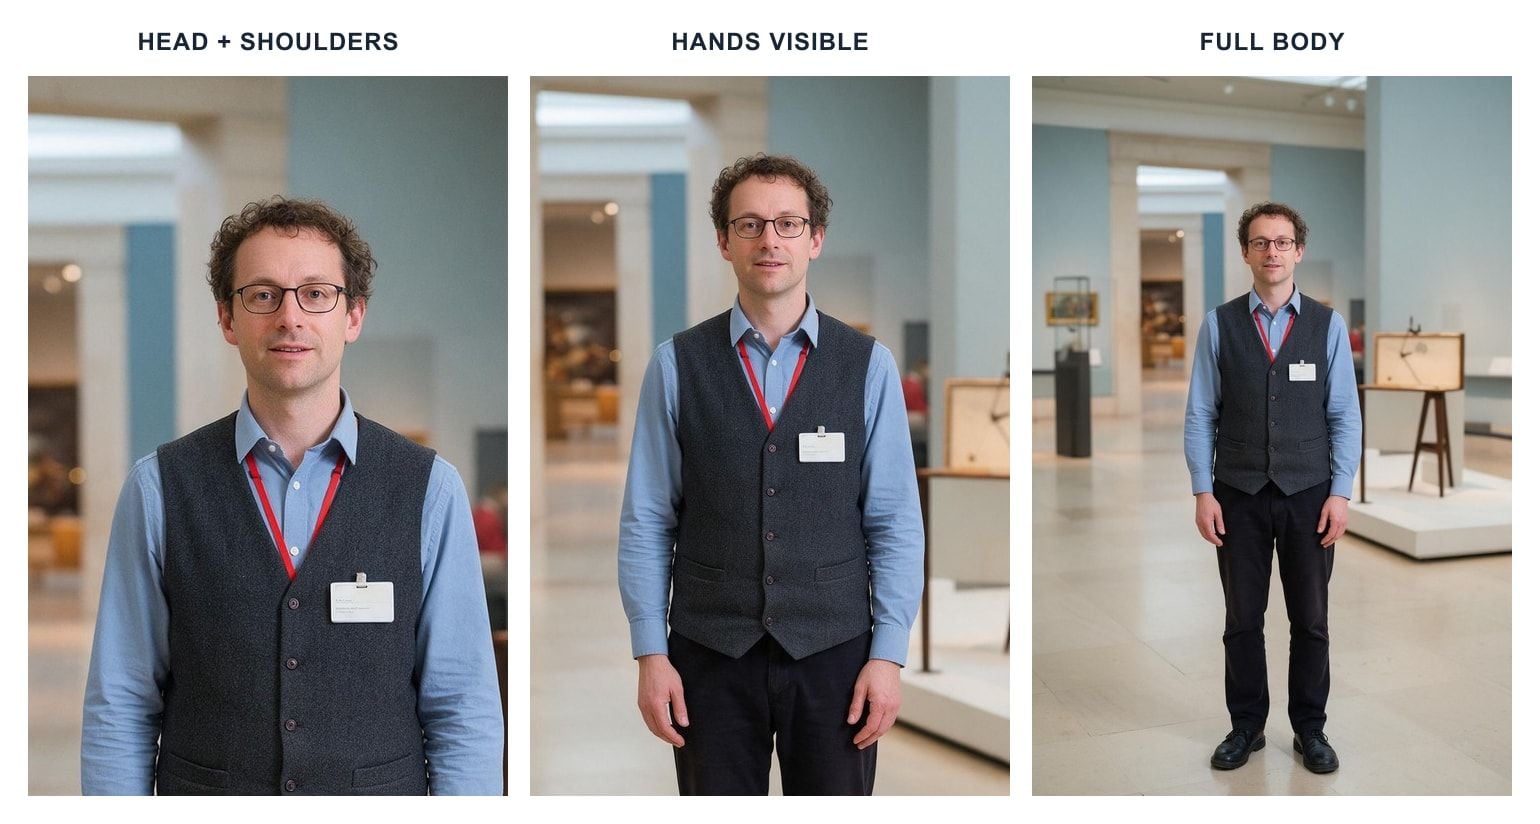
同一張範例來源照片的三種裁切:緊湊畫面適合臉部表情,看得見雙手能讓主講人有空間做手勢,全身則能支援站姿表演。
一個簡單的判斷測試很有幫助:指出成品鏡頭中必須移動的身體部位。如果來源中沒有該部位,就改變影像或降低動作目標。例如,若主講人要強調「三個實用步驟」,請使用雙手可見的半身影像。只有臉部的肖像則更適合簡短問候或特寫旁白。
用音訊與指示建構單一影像演出
把輸入想成三項不同的工作。影像回答誰在畫面上,以及鏡頭如何開始。音訊承載實際字詞、停頓與聲音能量。文字指示則要求符合這些提示的視覺行為。讓各項輸入保持一致;平靜的聲音搭配「狂野、不斷跳舞」會給模型互相衝突的指示,可能產生不自然的演出。
一個實用的首輪工作流程如下:
- 選擇鏡頭。 判斷觀眾需要看見特寫臉部、可見雙手,還是全身。選擇畫面中包含該區域的來源。
- 準備具代表性的音訊。 使用真實旁白或歌曲的一小段,包含手勢應該出現的那句話。測試應能代表最終的節奏與呈現方式。
- 加入一個動作想法。 描述單一手勢,以及它在演出中出現的位置。其他動作與鏡頭要求請保持克制。
- 生成並檢視。 檢查臉部、手部、身體、背景與整體構圖。下一次嘗試時,一次只改變一項輸入。
以產品解說為例,原創測試台詞可以是:「我們會介紹三個實用步驟,接著你可以選擇最適合團隊的做法。」錄音時,在「三個實用步驟」這句話前稍微停頓。使用雙手可見的半身影像。這會給預定的手勢一個清楚的語意提示,以及可見的動作範圍。
此處可查證的 BytePlus 官方文件指的是 OmniHuman 1.5,而非 2.0。就 1.5 而言,它列出影像與音訊為必要輸入、提示詞為選用、支援的提示詞語言,以及 720p 或 1080p 輸出。其總覽也列出 60 秒音訊限制,並建議使用較短音訊以維持品質。這些細節有助於區分已記錄的 1.5 產品;在將它們套用到 2.0 之前,請先確認 2.0 介面或官方文件(BytePlus OmniHuman 影片生成文件,2026 年 10 月更新)。
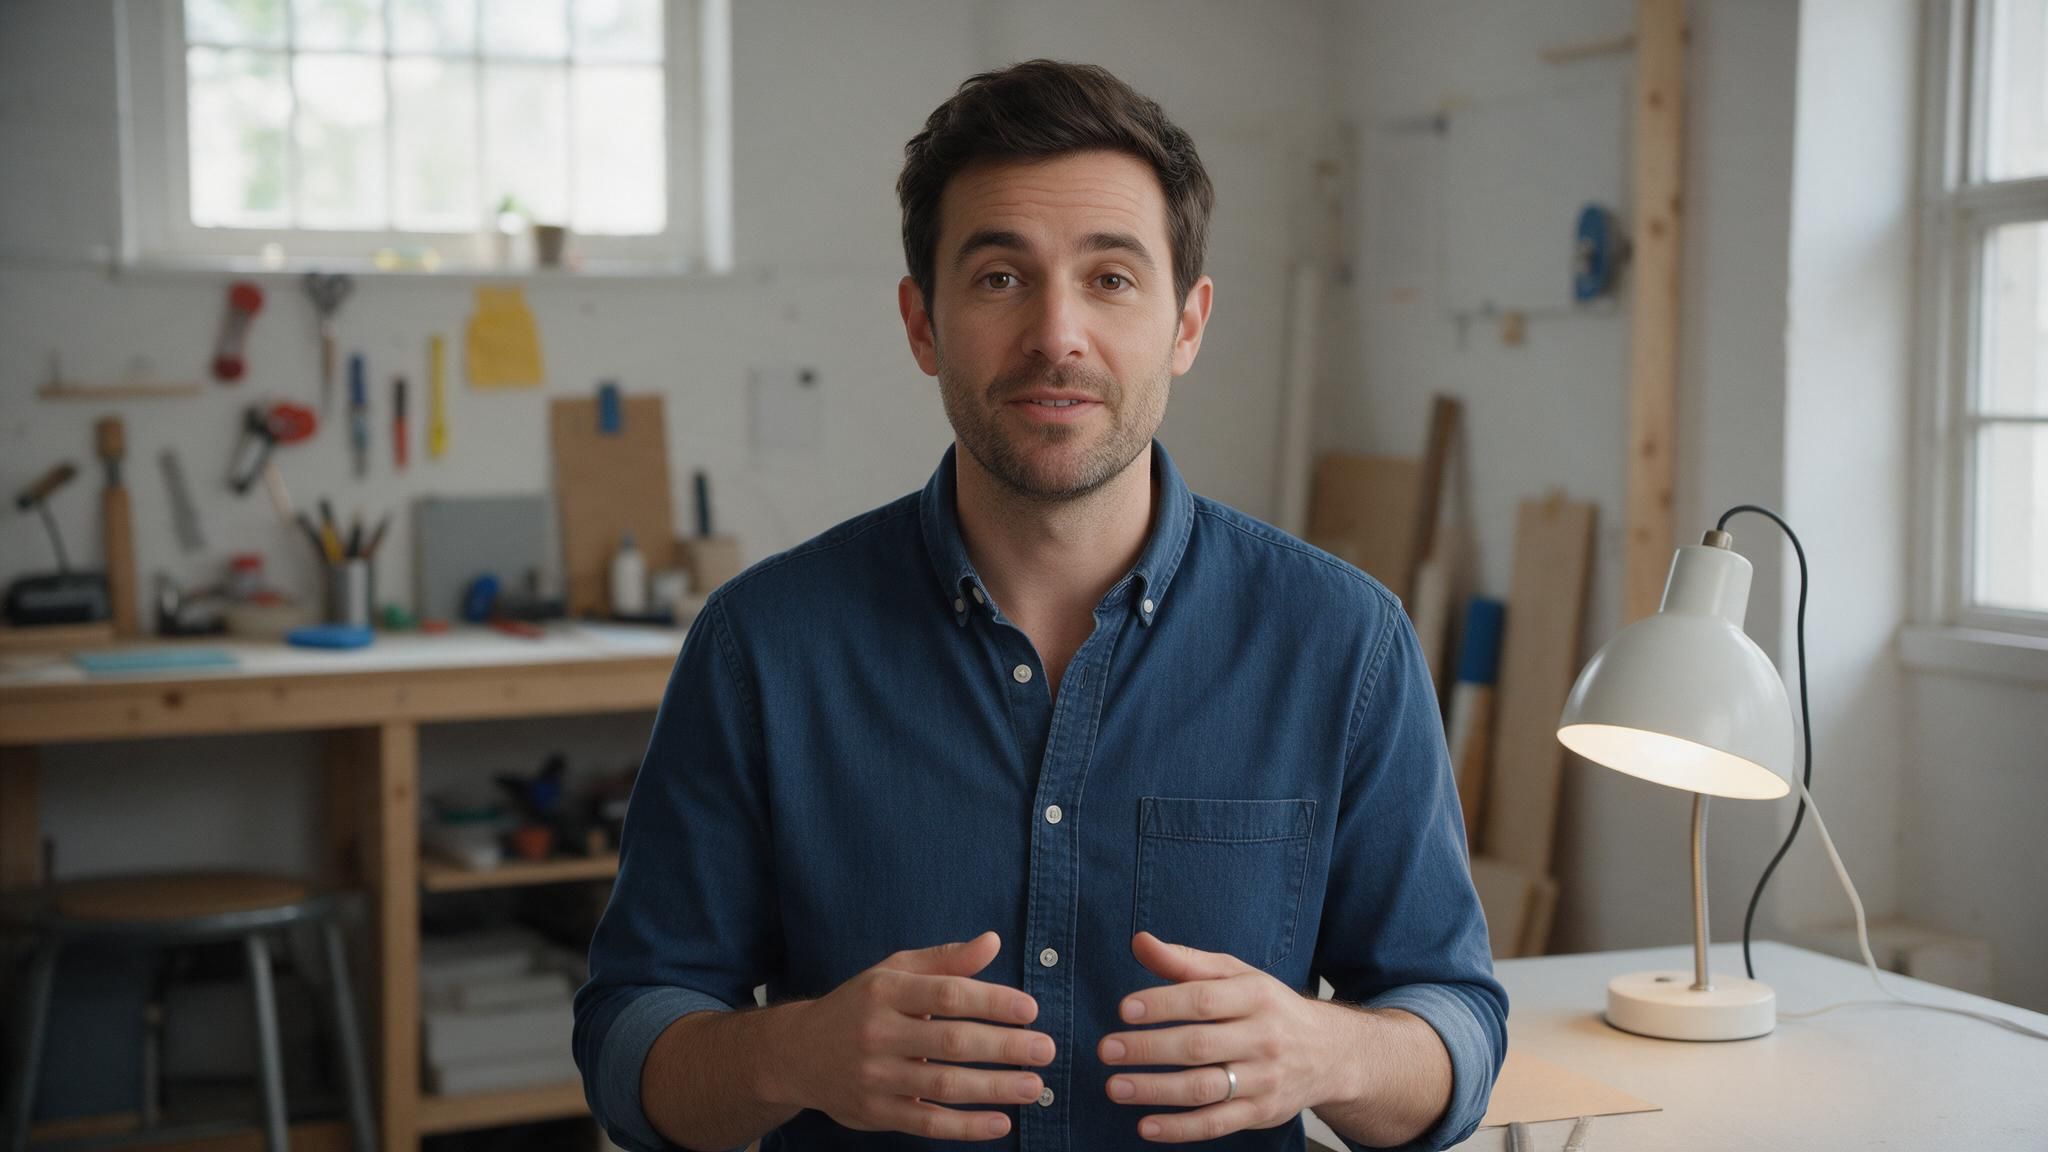
產品解說範例的來源靜態影像:主講人的臉、雙手與檯燈都可見,讓小型且定時的手勢容易評估。這是輸入照片,不是 OmniHuman 輸出。
在準備長時間錄音之前,先使用一個具代表性的樣本。短時間試作能更快發現裁切不符、語句沒有手勢提示,或提示詞要求過多。這是品質控管的選擇,並非對特定 2.0 時長限制的主張。
撰寫帶有明確提示的手勢提示詞
當提示詞指出動作、提示時機、幅度或節奏,以及任何構圖限制時,會更容易評估。像「讓這個人自然又有表情」這類寬泛指令會留下許多未定決策。聚焦的指令則會告訴模型哪個可見動作重要,以及它應該何時發生。
搭配上述範例台詞試試這個例子:
講者以平靜、自信的語氣說出這句台詞。保持鏡頭穩定。當講者說「三個實用步驟」時,短暫舉起一隻手來強調重點,然後自然放下。使用小而放鬆、且保持在可見畫面內的手勢。
引號中的語句會將動作連到音訊中的某個時刻。「短暫舉起一隻手」給出有界線的手勢,而「保持在可見畫面內」可避免要求超出裁切範圍的動作。這是提示詞撰寫範本,不是已測試或保證適用的 OmniHuman 2.0 指令。如果系統無法穩定遵循確切字詞或時機,請將該語句保留為廣泛提示,並判斷生成的動作,而不是假設它能做到逐格精準的編排。
每次嘗試之間只改變一個主要變數。如果手勢出現得太早,調整提示或音訊停頓。如果手部動作太大,降低要求的幅度。如果手臂不穩定或部分是推想出來的,請選擇手臂已經可見的來源。同時改變影像、音訊、動作與鏡頭方向,會讓人很難了解哪一項改變有幫助。
避免堆疊不相關的要求:在一行簡短文字中同時要求揮手、指向、轉身、走路、鏡頭環繞與情緒轉變。每一項都會對同一場演出增加額外需求。先從一個有目的的動作開始;只有在第一個結果仍清晰可讀,且場景需要時,才加入第二個動作。
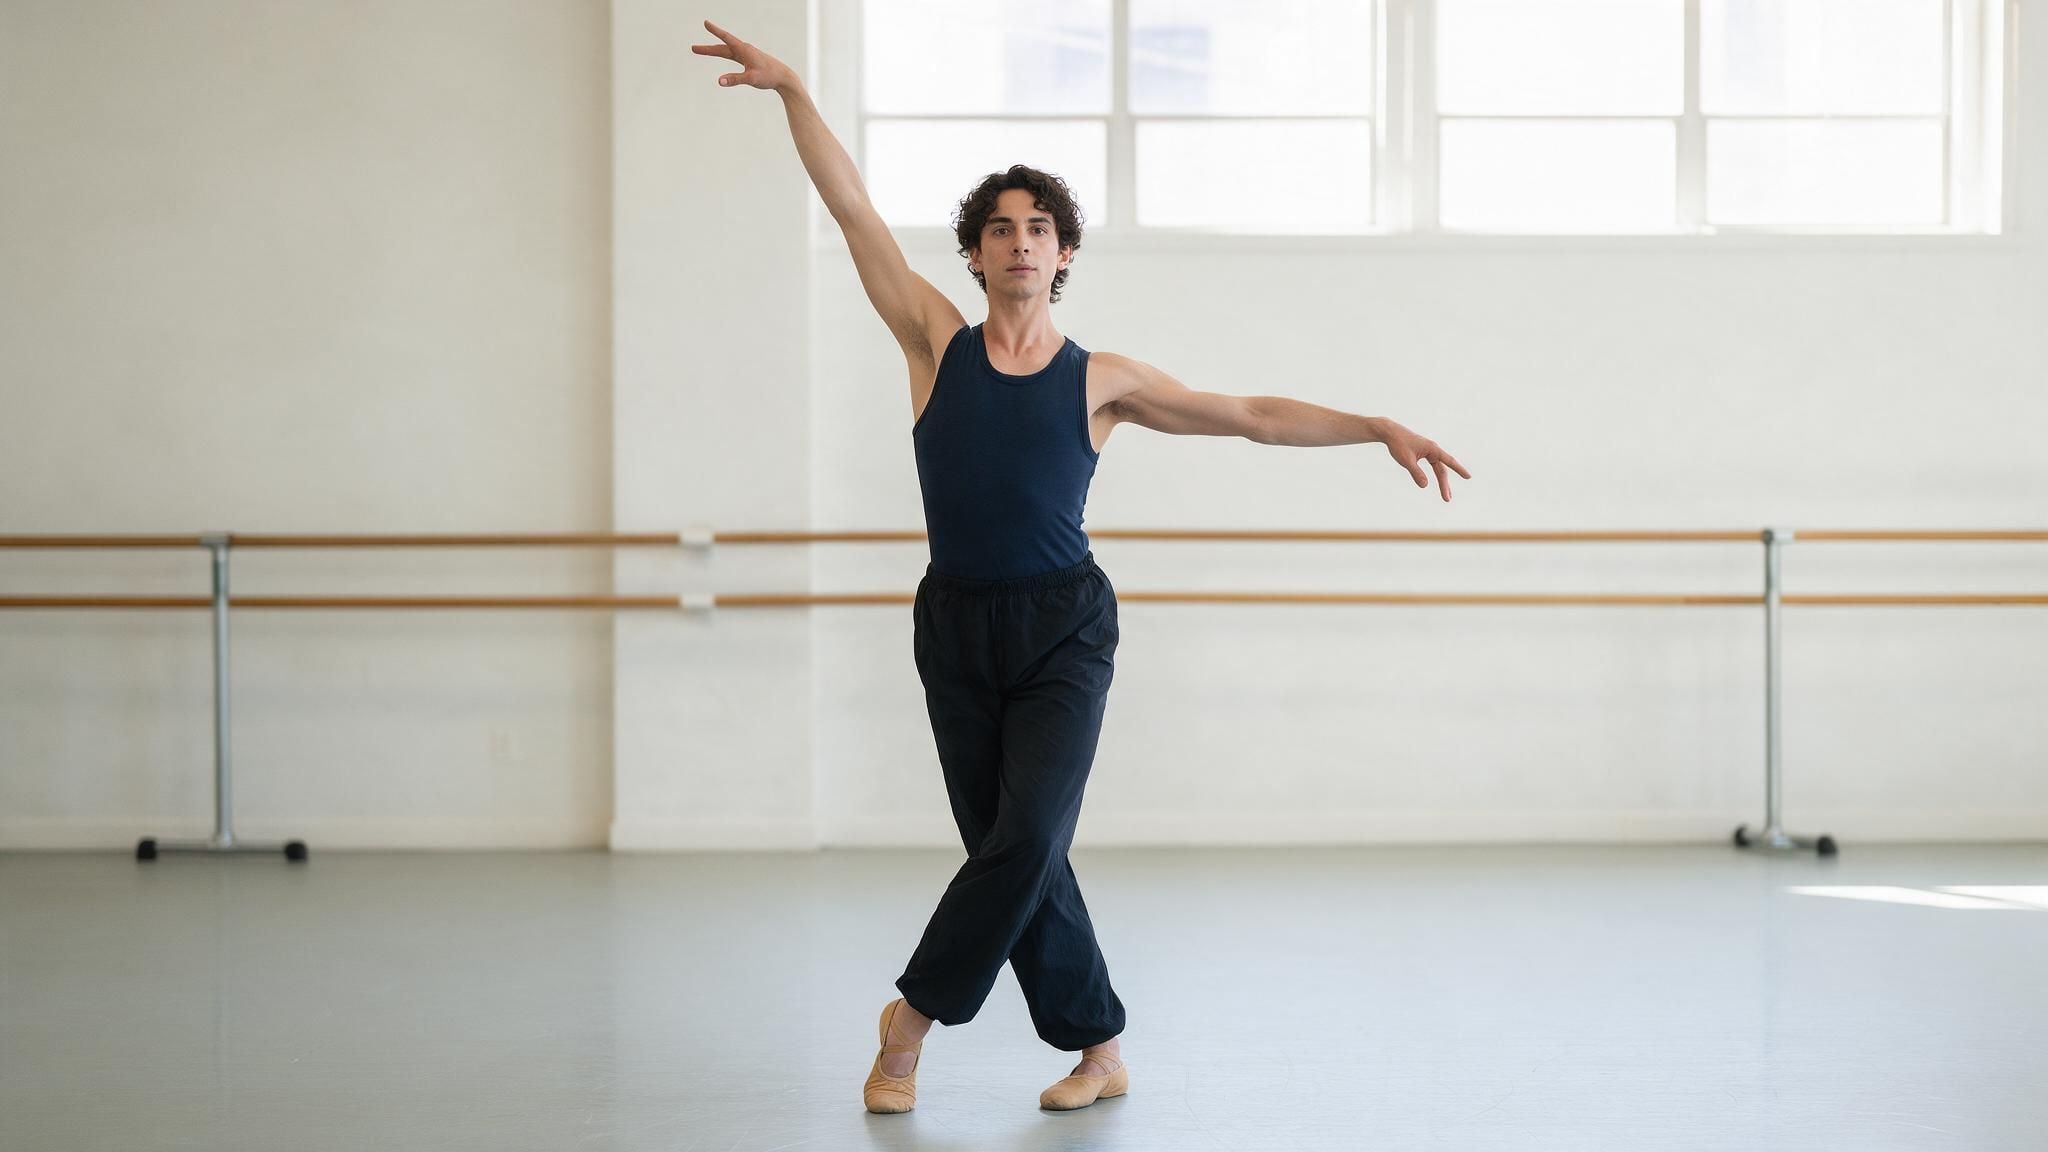
協調全身姿勢的範例來源靜態影像:舉起的手臂、伸出的手臂與跨步的雙腳都保持在畫面內。這是用來規劃手勢的參考影像,不是 OmniHuman 生成的影格。
發布前檢視結果
先看一次結果的整體演出,再看一次特定細節。第二次觀看很有用,因為片段在正常速度下可能感覺合理,但仔細檢查時會顯露手部或背景問題。
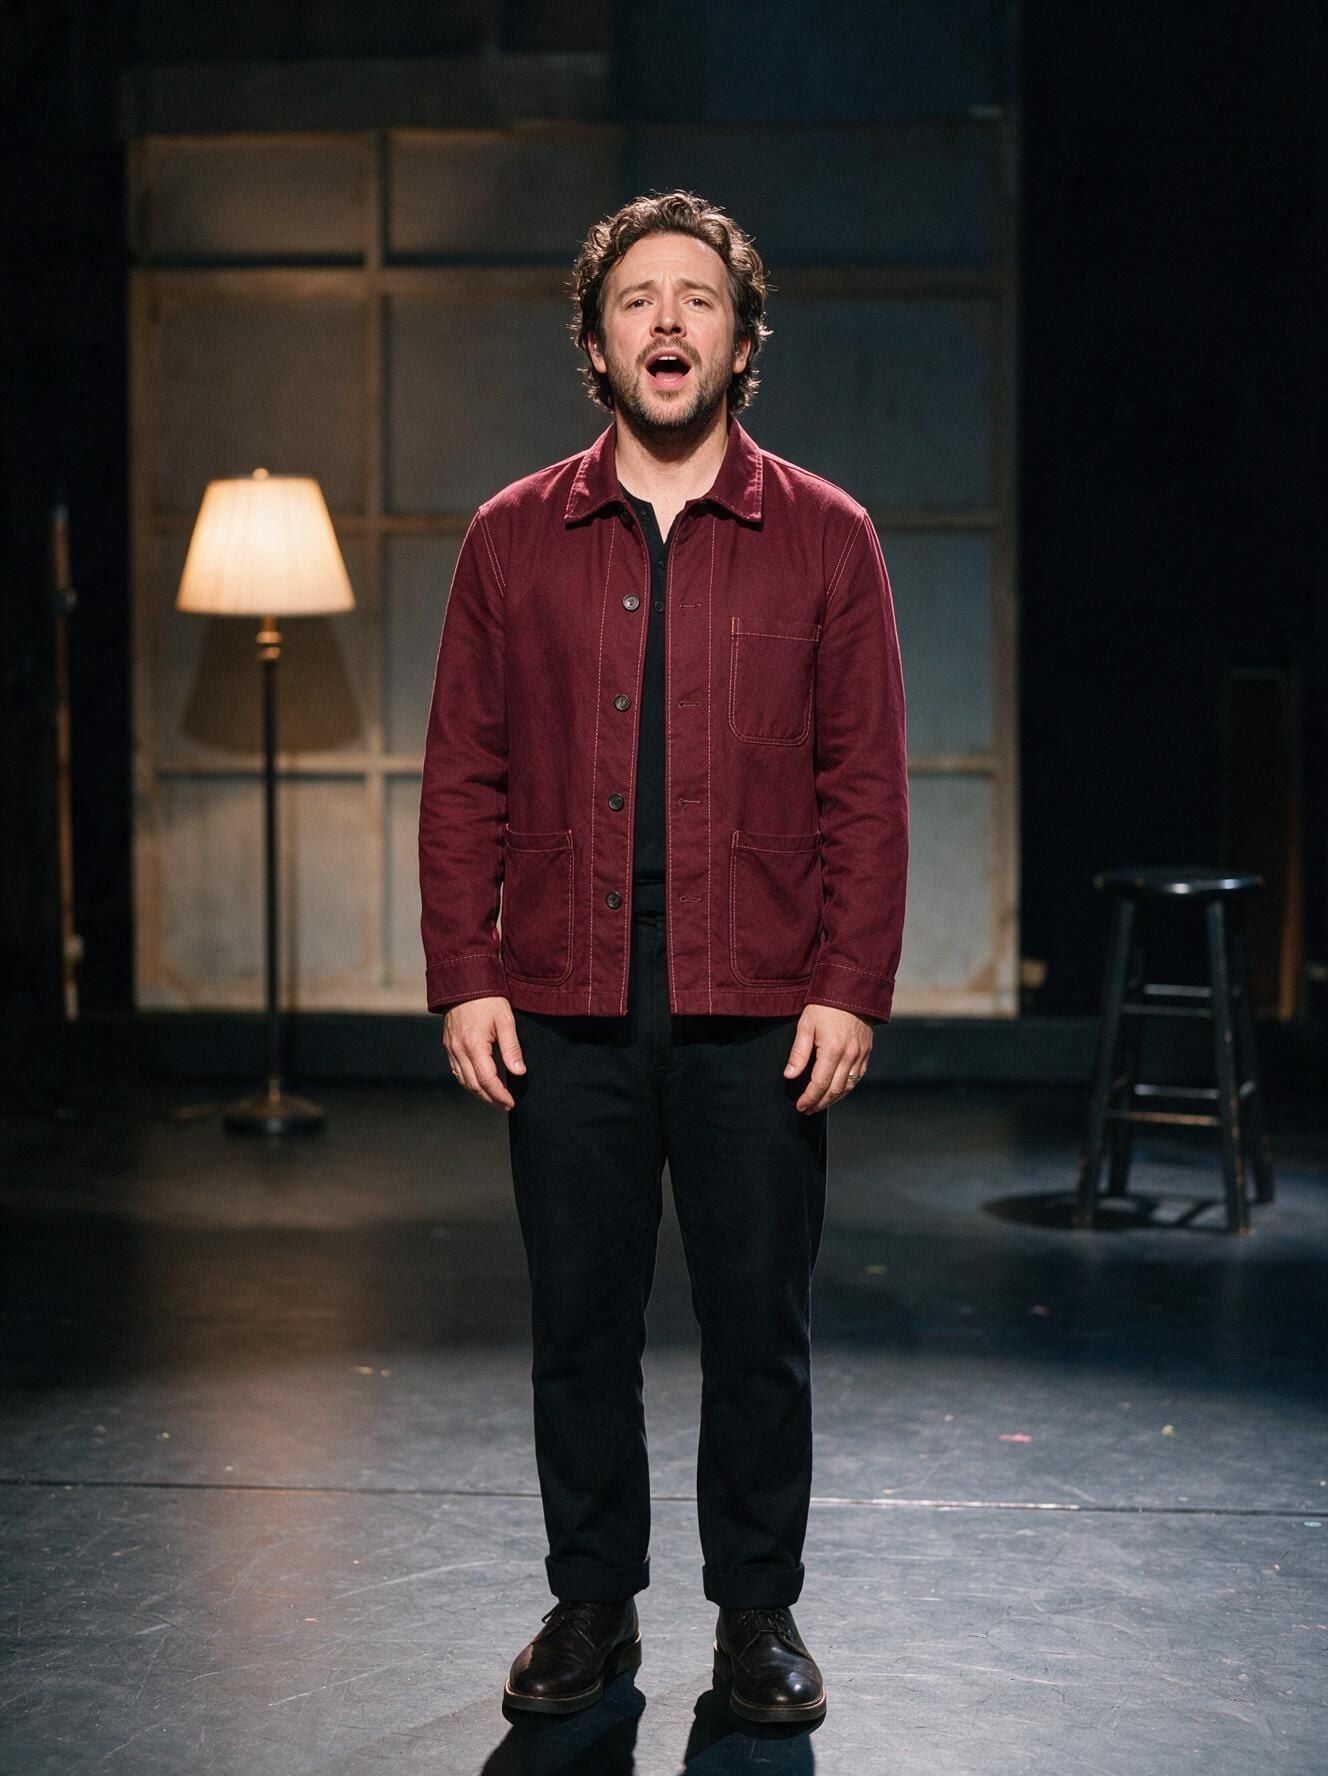
站姿表演的範例來源靜態影像:檢查身分與場景一致性時,請將任何生成的成品與可見的臉部、手部、夾克、鞋子、檯燈和凳子進行比較。這是輸入照片,不是生成的影格。
檢查以下五個區域:
- 說話與表情: 嘴巴是否大致跟隨說出或唱出的語句?表情是否符合聲音呈現?
- 手勢時機: 動作是否出現在預期想法或停頓附近?強調結束時動作是否停止?
- 手部與身體: 留意短暫的手指融合、關節彎曲、袖子變化,或身體比例在影格之間變動。
- 身分與場景: 臉部是否仍可辨識?服裝、背景物件與光線是否保持合理一致?
- 呈現構圖: 手部或腳部是否被裁掉?主體在你需要的長寬比與裁切中是否仍清晰?
當某些地方失敗時,將下一次嘗試與觀察到的原因連結起來。當缺少所需身體區域,或裁切沒有留下動作空間時,更換影像。當關鍵語句太趕、不清楚或情緒不符時,更換或縮短音訊。當動作在錯誤時刻出現或過於寬泛時,改寫指示。如果片段要用於公開活動,也請確認你已獲得授權可將該影像製作成動畫並使用該語音錄音,並取得所代表人物所需的任何同意。
有用的結果不一定就是動作最多的那一個。以課程開頭或產品說明而言,一個能保留人物辨識度並讓主體保持在畫面內的收斂手勢,可能比一個引人注意到視覺錯誤的複雜動作更能有效傳達。保留能支持訊息並符合發布格式的成品,然後將來源影像、音訊、提示詞與選定的輸出一起留存,以供日後修訂。
OmniHuman 2.0 的使用存取、版本與價格
BytePlus 在其影片模型節省方案文件中列出 OmniHuman V2.0。這確認版本名稱出現在 BytePlus 資料中,但並不代表已有公開的 2.0 試用環境、詳細輸入限制或 Atlas Cloud 端點(BytePlus AI Savings Plans)。在建構圍繞它的工作流程之前,請確認確切的模型版本。「OmniHuman 2.0」這個名稱不應與「OmniHuman 1.5」互換使用。本文目前查到的 BytePlus 文件標示為 OmniHuman 1.5。它記錄的是自身的輸入結構與服務限制,若沒有相符的官方來源,不應直接套用到 2.0。
在撰寫本文查核時,Atlas Cloud 的公開模型目錄展示了廣泛的模型型錄,但無法在該處查證到 OmniHuman 2.0 詳細頁面。特定的 Avatar Omni Human 模型頁面 標示的是相鄰的 1.5 產品。其顯示的起始價格在官方資料中報導為每秒 $0.12,但價格與折扣可能變動。在編列預算或發布之前,請重新查看詳細頁面與 Atlas Cloud 模型目錄。不要用 1.5 的價格作為 2.0 的估算。
如果你特別需要 OmniHuman 2.0,請在準備製作素材之前,先向 BytePlus 確認其官方使用途徑、目前輸入要求與價格。如果你願意考慮相鄰版本,Atlas Cloud 的目錄可協助你確認目前列出的影片與虛擬人像模型中,有哪些可從同一個目錄取得。請將這視為另一項產品選擇:執行 1.5 無法驗證 2.0 的提示詞或結果。
常見問題
OmniHuman 2.0 可以從只有臉部的影像生成全身影片嗎?
只有臉部的影像不會顯示引導全身演出所需的身體細節。系統或許能推斷缺失區域,但其外觀與動作較無法直接以來源為依據。若要生成手勢,請使用能看到手部與足夠手臂範圍的來源。若要生成站姿動作,請從全身影像開始。
OmniHuman 2.0 需要音訊嗎?還是單靠文字提示詞就能讓影像動起來?
所述 OmniHuman 工作流程是由影像與音訊驅動,並可選用文字指示。不要假設你打算使用的確切 2.0 服務支援純文字影像動畫。請查看該服務目前的產品頁面,了解其接受的輸入。
OmniHuman 2.0 的音訊輸入可以多長?
我無法查證目前官方的 2.0 音訊時長限制。BytePlus 公布的 1.5 總覽指出限制為 60 秒以下,並建議使用較短輸入以維持品質,但那是 1.5 的規格。在錄製或上傳長音軌之前,請在官方使用入口確認 2.0 的限制。
OmniHuman 2.0 已經在 Atlas Cloud 上提供了嗎?
本文查核時,Atlas Cloud 目錄中無法查證到公開的 OmniHuman 2.0 項目。Atlas Cloud 相鄰的 OmniHuman 頁面是 1.5。使用前請再次查看目錄,因為目錄供應情況可能變動。
在開始下一次 OmniHuman 2.0 從一張影像生成全身手勢 嘗試之前,請先做一個決定:找出成品鏡頭必須顯示的身體區域,然後選擇已經包含該區域的來源。請向你將使用的服務確認確切版本與目前限制,並在準備完整製作成品之前,先測試一段簡短、具代表性的音訊段落。





