

適合你工作的頂尖萬聖節圖像生成器取決於你一開始有什麼。空白提示需要文字轉圖像。你穿新服裝的照片需要能將照片作為參考的編輯器。一張應該看起來像手持自拍的肖像,需要先改變相機角度,再添加精心設計的萬聖節效果。先選擇路徑,提示就會容易寫得多。
重點摘要
- 原創萬聖節藝術從文字轉圖像開始;若要保留真實人物或物件,則從圖像編輯開始。
- 自拍生成器可解決相機取景問題,而通用編輯器讓你更能控制場景。
- 請查看確切產品與帳戶的免費生成條款;一次免費 Playground 嘗試不代表每個生成器都能免費使用。
- 將輸出與你的需求簡報比較,而不是聽信某個模型在每項圖像任務中都勝出的泛泛說法。
萬聖節圖像生成器實際上應該為你做什麼?
搜尋萬聖節圖像生成器的人,可能想製作非常不同的素材:文字可讀的派對邀請函、自己的陰森肖像、手機桌布、服裝模擬圖,或社群貼文。這些任務使用不同輸入。一個能從文字創造出搶眼新城堡的模型,尚未證明它能在上傳照片中保留你的臉孔。一個能把肖像變成自然自拍的工具,也尚未證明它能設計海報標題。
先用一句話說出你的交付成果。「我需要一張 4:5 的肖像,我戴著女巫帽,臉孔不變」給了你來源圖像、長寬比與保留要求。「我需要一張方形邀請函,並有確切文字 OCTOBER 31」需要新構圖與文字檢查。「我需要三個萬聖節桌布點子」則需要變化,而不是身分一致性。
| 你的起點 | 選擇這條路徑 | 匯出前要檢查什麼 |
|---|---|---|
| 沒有來源圖像;你想要原創場景、海報或插畫 | 文字轉圖像 | 主體數量、構圖、可讀文字、裁切 |
| 人物、寵物、產品或房間的照片必須保持可辨識 | 以參考圖為基礎的圖像編輯 | 身分或物件細節、手部、附著點、背景變更 |
| 非自拍的肖像應該變成隨性的手機自拍 | 自拍重新取景,接著可選場景編輯 | 臉部、服裝、手臂伸長視角、第二次編輯是否改變人物 |
這是決策表,不是視覺品質排名。Atlas Cloud 圖像生成器與編輯器 在同一個工作區中提供文字生成、參考圖像建立與目標式編輯。它也提供模型、長寬比與解析度選擇。公開頁面說明了這些可用路徑;但並未告訴我們哪個模型最能準確遵循你特定的萬聖節需求。
Google 的 萬聖節圖像點子 在實務上顯示同樣差異:陰森場景、服裝點子和經過轉換的個人照片都是萬聖節圖像,但每者要求工具保留的資訊各不相同。一份好的候選清單,會從你的成品絕對不能失去的資訊開始。
若要新的萬聖節藝術,從文字轉圖像開始
當沒有真實人物或既有產品必須在轉換後保留下來時,文字轉圖像生成器就是直接路徑。給它一個主體、一個時刻、一個場景、一種相機或插畫風格,以及輸出形狀。一個具體互動會比一堆情緒詞更容易讓場景被評估。「一名孩童伸手去拿門廊燈籠,同時一個友善的紙幽靈隨風升起」有可見動作。「陰森、電影感、超棒的萬聖節」則讓生成器幾乎發明一切。
下方圖像是僅從文字生成:一名虛構人物穿著手工稻草人服裝,在萬聖節街頭市集穿過緞帶。它展示了提示如何控制主體、動作、場景與光線。由於未提供來源肖像,這個結果無法證明身分保留。當你在 AI 萬聖節圖片生成器與照片編輯器之間做選擇時,這項區別很重要。
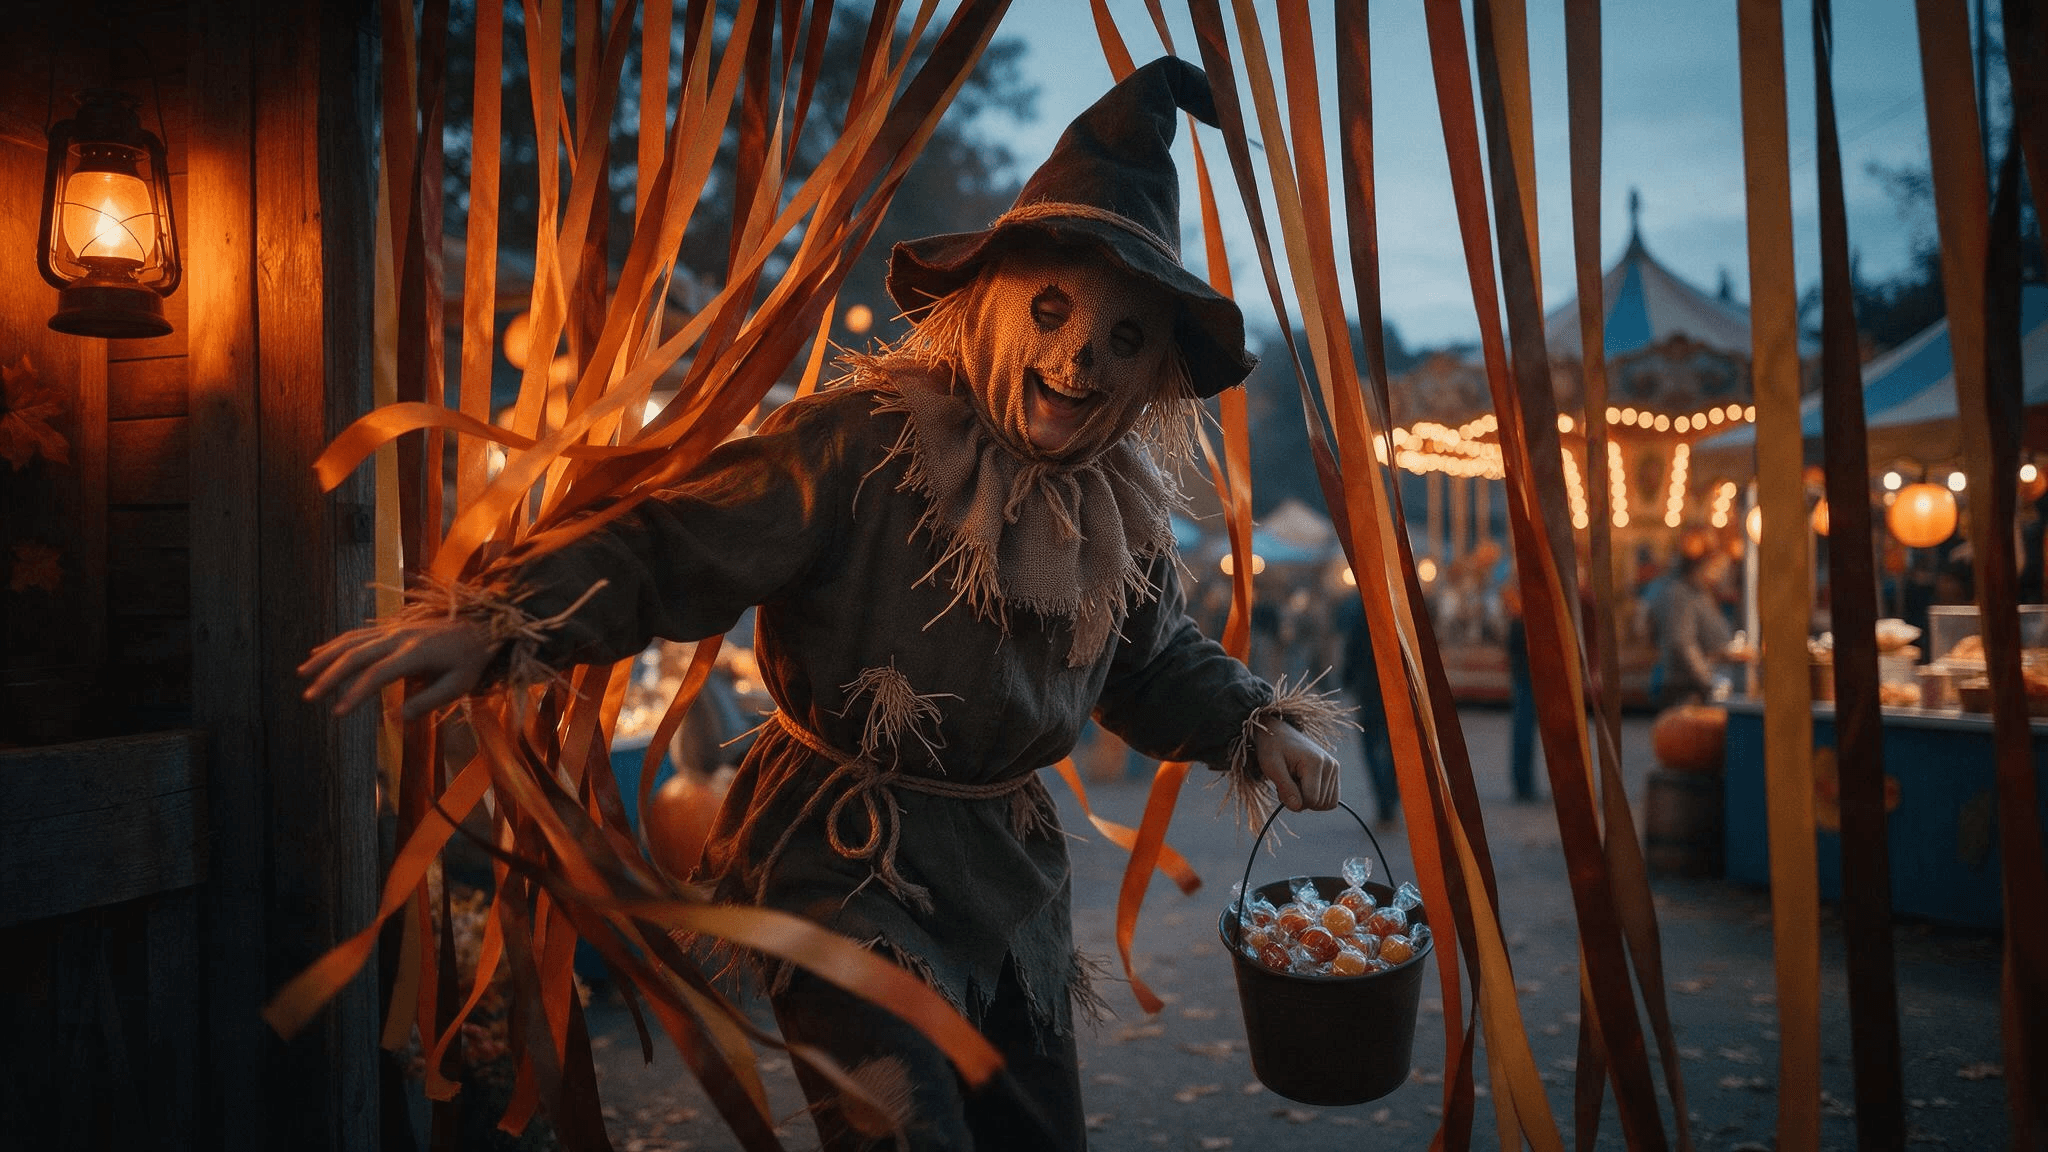
使用者提供的生成結果,來自 Seedream 5.0 Pro Text-to-Image。人物與街頭市集來自文字提示,沒有參考照片。
若是派對海報,請把美術方向與必要文字分開。你可以要求模型設計出確切文字,但要檢查每個字母。如果標題至關重要,而輸出拼錯了,就把生成的藝術用作背景,並在設計編輯器中放置已驗證文字。這對日期、地址與安全資訊特別有用,因為它們絕不應該取決於模型的拼字。
以下是街頭市集範例所用的提示。它要求一名虛構人物與可見動作,並未要求任何人的真實臉孔或受著作權保護的角色:
plaintext1A candid editorial photograph at a small-town Halloween street fair. One young adult wearing a handmade scarecrow costume steps through a curtain of autumn-colored ribbons, laughing as a gust of wind lifts the loose fabric; a bucket of wrapped candy swings naturally from one hand. Food stalls and a carousel are softly visible in the distance. Directional amber lantern light from the left, cool blue-hour ambient light, restrained orange-and-blue palette. Wide 35mm documentary composition with a little foreground blur and generous uncluttered space in the upper right for a headline to be added later. Real fabric weave, worn wood, natural skin texture, slight motion in the ribbons. Exactly one prominent person, believable hands, no lettering, no logos, no watermark. Horizontal 16:9.
要求標題空間並未在此結果中產生完全乾淨的區域:緞帶與市集帳篷穿過右上方。若是邀請函,請在匯出前將已驗證文字加入另一個文字面板,或修改構圖。如果你反而需要桌布,請把畫布改成裝置的比例,並將主要主體移離時鐘或應用程式圖示。這些是輸出決策,不是重寫整個視覺概念的理由。
下方邀請函範例採取第二條路徑。新的萬聖節場景在左側留下一面素牆;「HALLOWEEN NIGHT」與「OCTOBER 31」等字樣之後以已驗證文字排版加入。圖像模型提供場景,而不是文字。
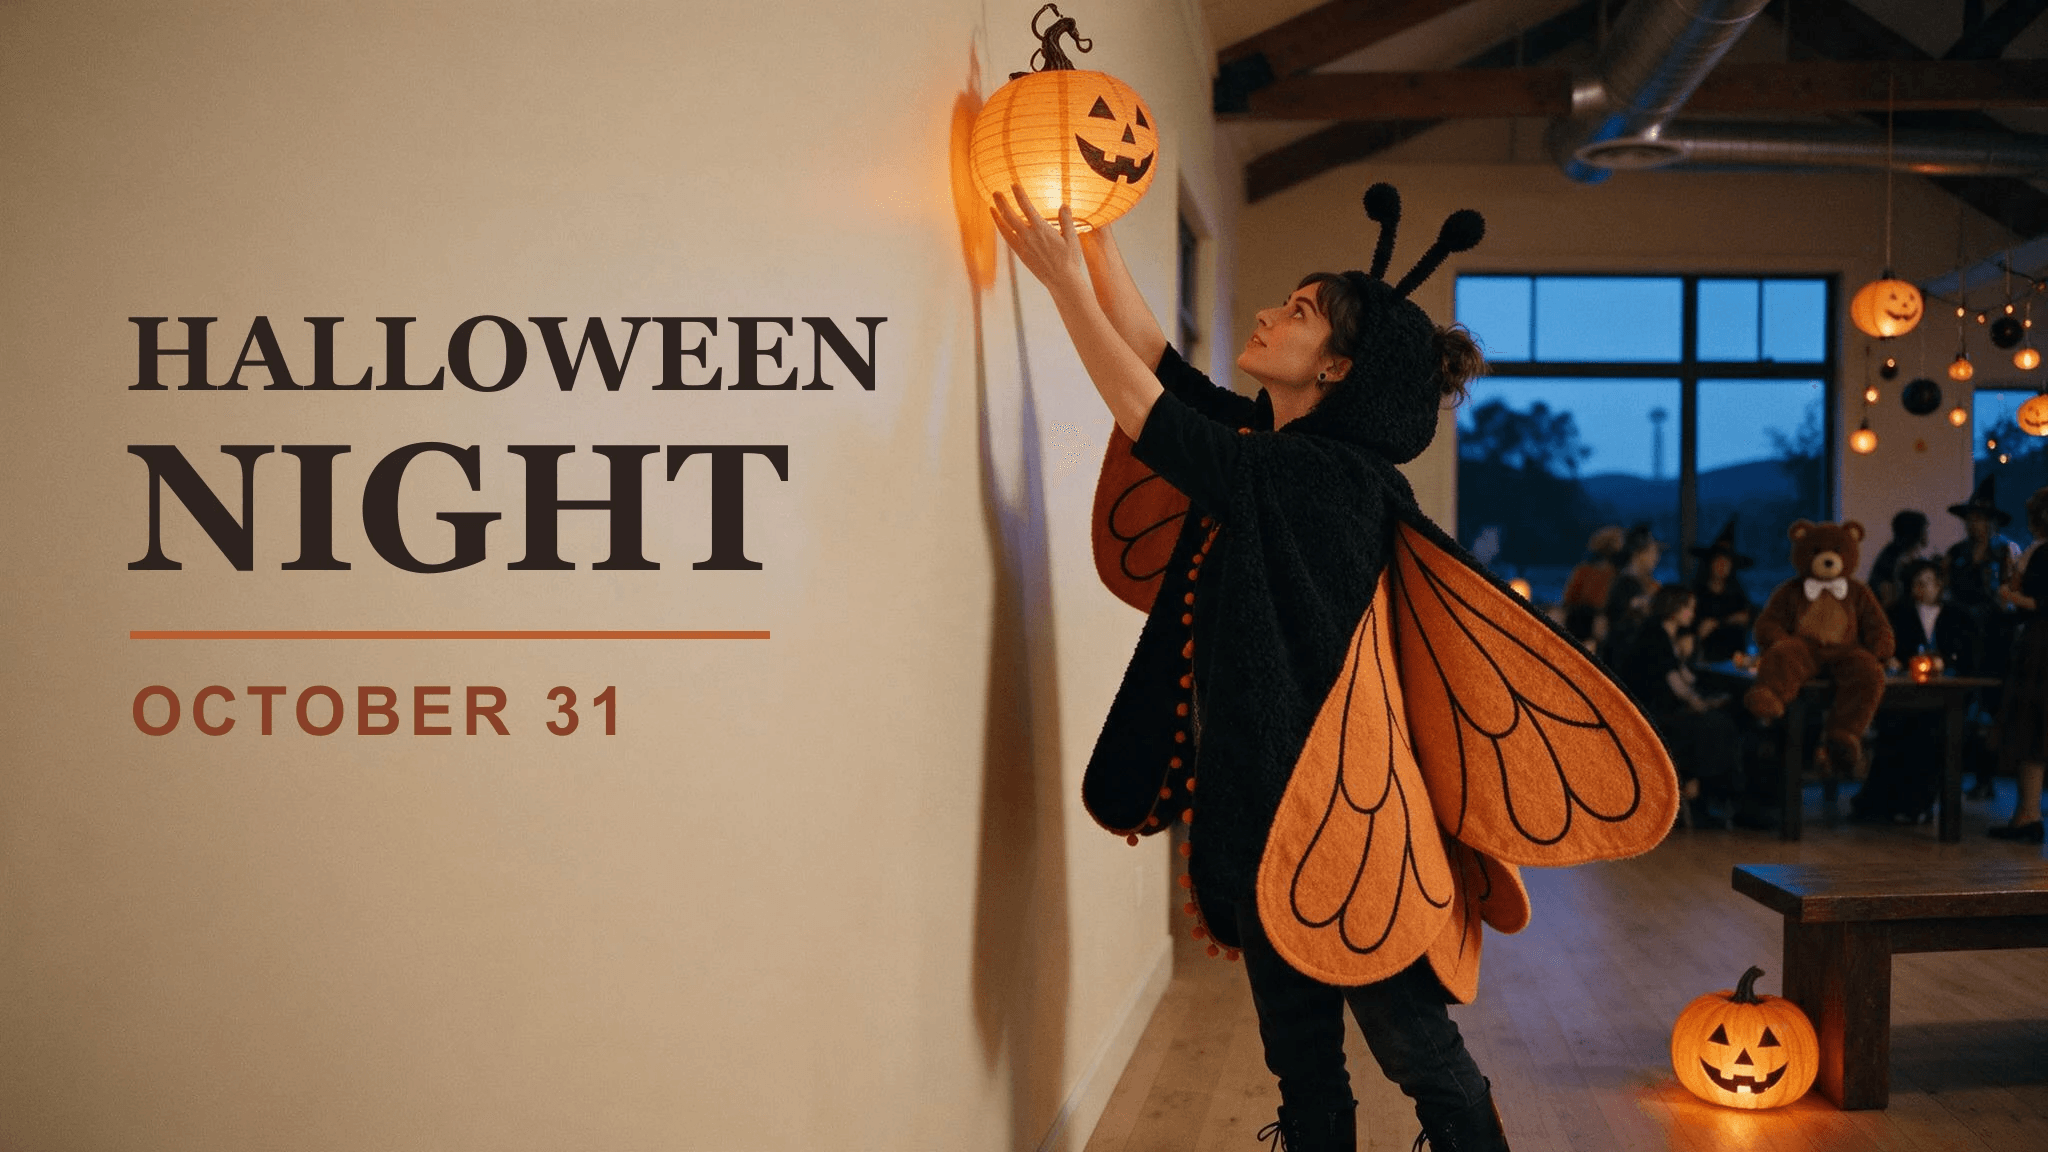
使用者提供的場景以 Seedream 5.0 Pro Text-to-Image 生成;範例邀請函文字另行加入。這是範例版面,不是活動公告。
比較兩個模型時,請在兩者都支援的情況下執行相同提示與設定。保存確切提示、解析度、長寬比與每個結果。如果一個模型主體數量正確,另一個模型做出更吸引人的色彩配置,你就有有意義的取捨可判斷。用不同提示做出的一圖展示,無法確立哪個生成器更適合你的任務。
若要製作自己的萬聖節照片,請選擇編輯
當完成圖像應該顯示你時,AI 萬聖節照片生成器應該接受你的來源照片。尋找參考上傳與編輯模式,不只是有陰森縮圖的風格預設。從一張眼睛、髮際線與服裝都清晰可見的照片開始。如果你想要背景中有幽靈,給模型實際可用的背景空間。如果你想要更換服裝,請顯示足夠的上半身,讓配件或服裝看起來合理。
把提示寫成編輯,並附上明確的保留指示與一項局部變更。要求保留臉部並不保證結果;你仍需要與原圖比較。下方的成對範例從一張新生成的書店肖像開始,接著加入毛氈女巫帽,同時保留人物、外套與場景。它展示的是以虛構人物進行的編輯工作流程,而不是對照真實人物身分進行驗證。
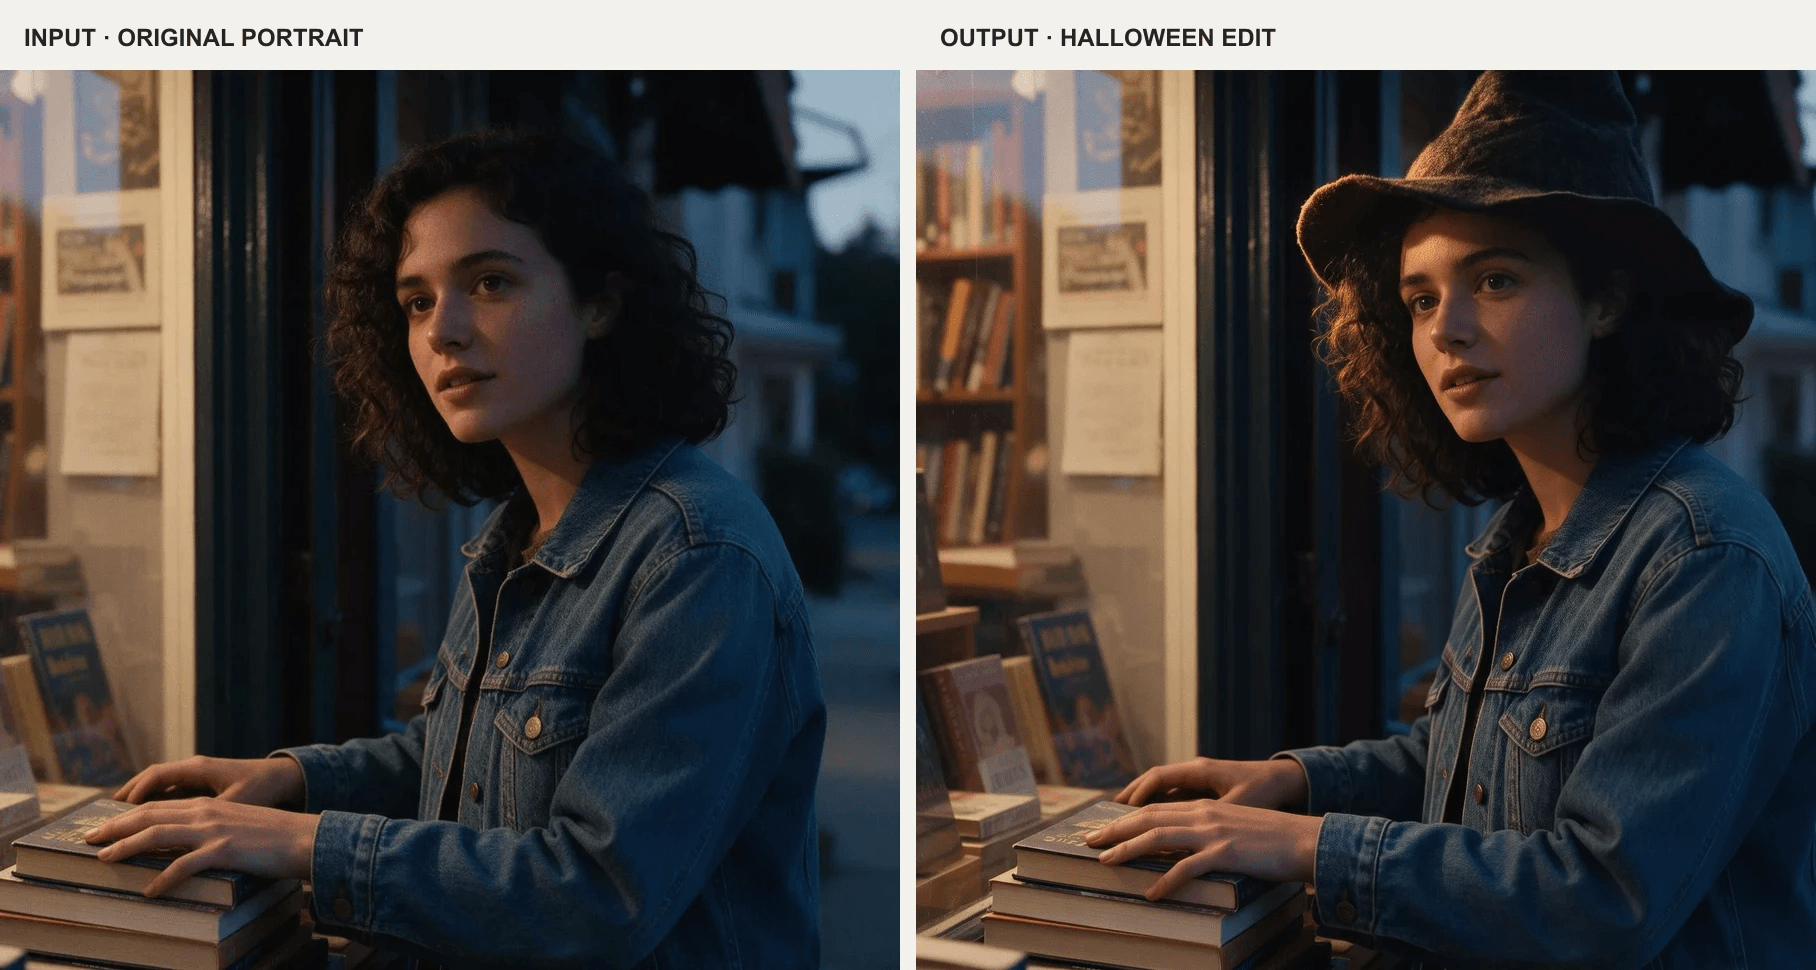
使用者提供的來源肖像以 Seedream 5.0 Pro Text-to-Image 生成;使用者提供的編輯以 Nano Banana 2 Edit 完成。帽子是所要求的變更。
編輯指示如下:
plaintext1Edit the uploaded photograph of the same woman. Preserve her recognizable face, dark curly hair, expression, body proportions, blue denim jacket, bookshop window, camera angle, and the original direction of light. Add one modest Halloween change: a handmade black felt witch hat resting naturally on her hair, with a believable contact shadow. Keep the moment candid and photographic; do not redesign the shop or change her identity. No mask, floating hat, extra fingers, altered face, text, or watermark. Keep the original horizontal 16:9 framing.
為什麼要保留外套與相機角度?每一個額外變更都會給編輯器另一次偏離輸入的機會。如果你首先需要服裝概念,請把它生成為另一張圖像。當你選好真正想要的細節後,再用那一項變更編輯真實照片。好的萬聖節照片生成器讓你進行目標式後續編輯,例如「把帽子降到頭髮上;保持臉部與外套不變」,而不是強迫完全重新生成。
照片編輯也是寵物或房間需要保持可辨識時的正確路徑。說出你想保留的特徵:狗的毛色花紋、雕刻南瓜的實際臉孔、房間的窗戶位置,或產品標籤。避免模糊的「同一張圖像,但換成萬聖節風格」。具體錨點讓你看出結果是真的編輯了來源,還是用相似場景取代了它。
什麼時候自拍生成器是更好的第一步?
有時來源照片是別人拍的肖像,但想要的結果應該看起來像你自己拍的。這先是相機幾何問題,再來才是萬聖節問題。前置鏡頭自拍有手臂伸長視角、合理拿著手機的手臂,而且畫面中通常看不到手機。鏡子自拍通常會顯示手機與物理上一致的反射。把這些指示混在一起,可能產生多出來的手或重複的手機。
Atlas Cloud 免費 AI 自拍生成器 的設計圍繞著一張上傳肖像與可選的簡短氛圍描述。當來源看起來太像擺拍,不適合社群萬聖節貼文時,它就很相關。這個工具的主要工作是自拍取景;複雜服裝、幽靈或海報版面之後可能需要另行進行圖像編輯。
下方範例使用新生成的肖像作為來源,並以另一項參考圖式編輯來示範相機變更。它不是消費者自拍工具的輸出。
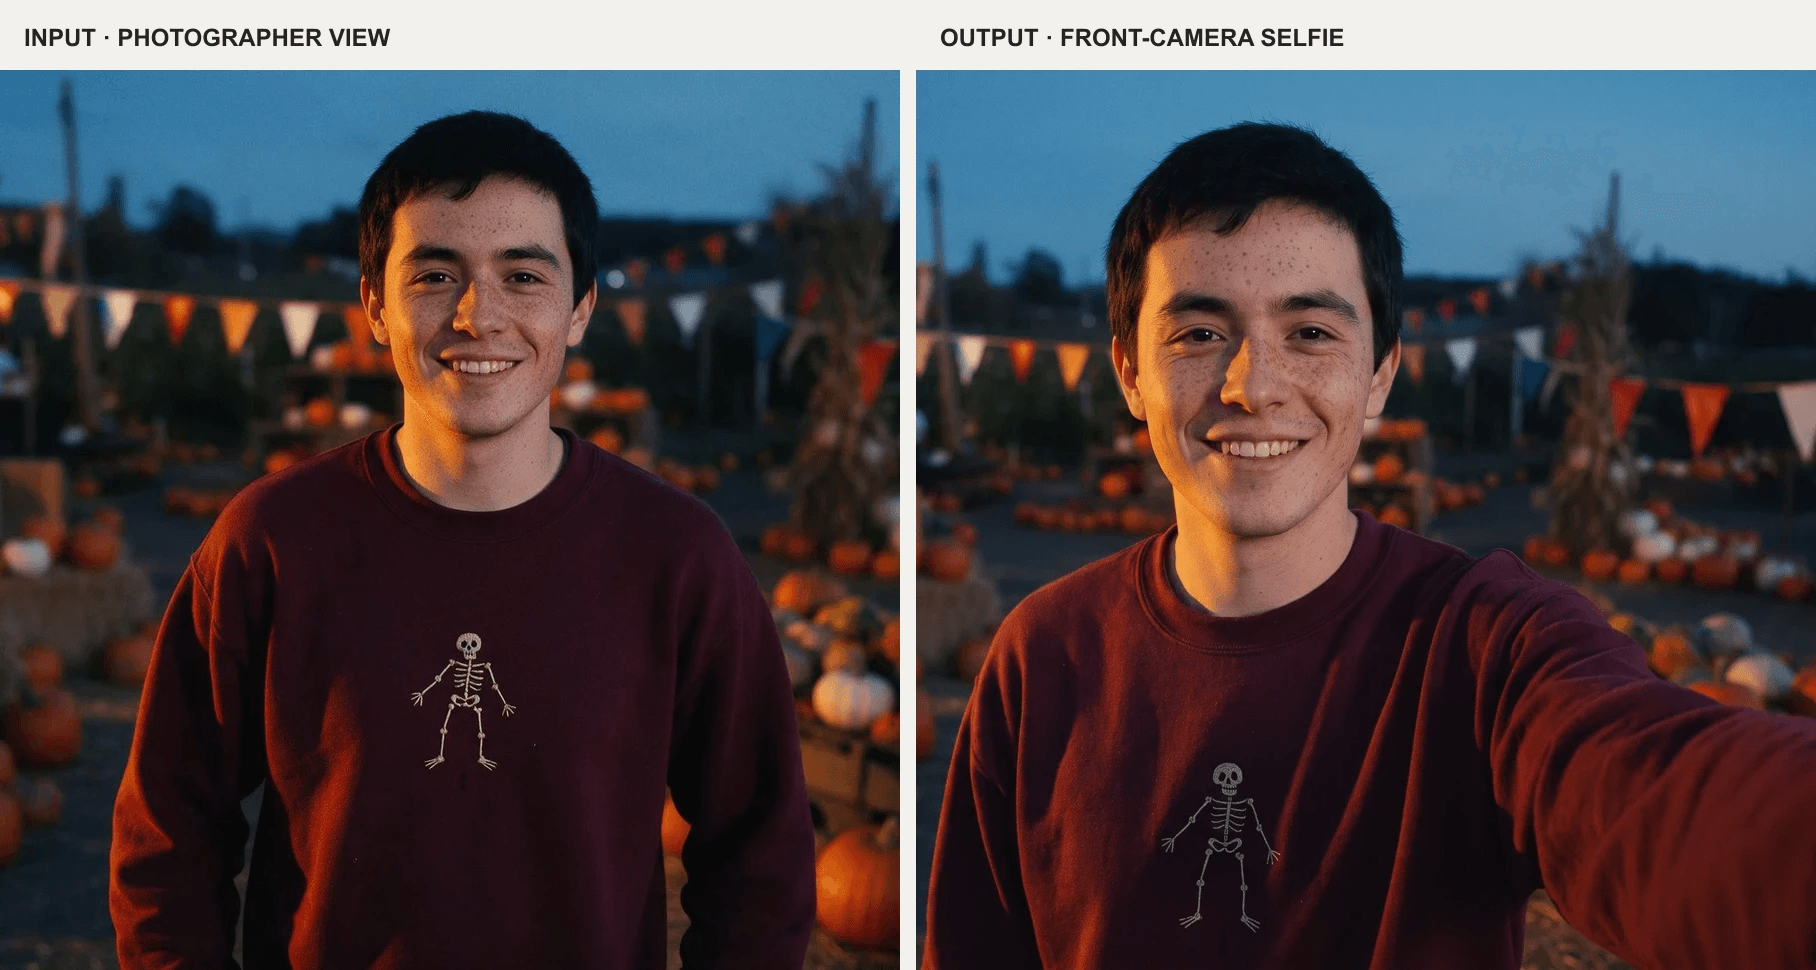
使用者提供的來源肖像以 Seedream 5.0 Pro Text-to-Image 生成;使用者提供的自拍重新取景以 Nano Banana 2 Edit 完成。伸出的手臂與更近的視角是可見的變更。
這個第一步請使用原始肖像。檢查臉部與服裝是否在重新取景後保留下來,然後保存結果。在此範例中,南瓜園場景與骷髏運動衫已經帶有萬聖節主題,所以不需要第二次編輯。如果你之後確實加入了新服裝或道具,請將最終圖像與原始肖像比較,因為每次額外編輯都會產生另一次身分漂移的機會。
如果你已經有一張好的自拍,請略過重新取景。萬聖節圖像編輯器可以直接從你拍的照片開始工作。額外工具只有在解決真正取景問題時才有用。這能讓工作流程更短,也更容易辨識是哪個步驟引入了錯誤。
免費的 AI 萬聖節圖像生成器就夠了嗎?
免費嘗試可以回答一個早期問題:這個工具是否足夠理解需求,值得繼續?它不應被當成每條路徑都免費的證明。Atlas Cloud 的 Free GPT Image 2.5 Playground 頁面 目前表示,參與的模型共享五次免費生成嘗試,且這些適用於 Playground。同一頁面表示 Generator、Model Explorer 與 API 執行另行計費。執行前請檢查你帳戶中的目前額度,因為資格與剩餘嘗試次數可能變動。
把第一次符合資格的嘗試當作受控測試。貼上一個具體提示,保持要求尺寸適中,並以完整解析度檢查結果。如果你在測試海報,檢查確切字母與間距。如果你在測試編輯過的照片,檢查相似度,以及變更部分是否自然融入場景。在決定是否花更多嘗試之前,先保存提示與輸出。
帶有狹隘預設的免費 AI 萬聖節生成器,對快速社群貼文可能很方便,但預設可能隱藏你關心的決策:主體站在哪裡、是否出現第二個人,或來源保留多少。通用編輯器需要多寫一點,但能讓你更清楚地控制這些細節。請根據你需要的圖像做選擇,而不是只看免費這個詞。
投入前先做公平測試
你不需要實驗室基準測試,才能為一項萬聖節素材找到正確工具。你需要一份可重複的需求,以及一份簡短的失敗檢查清單。在路徑允許時,使用相同來源照片或相同文字提示,並保持輸出目標固定。只在生成完成後記錄結果;登陸頁上的藝廊範例是用別人的輸入與提示製作的。
這裡有兩個使用者提供的結果,對應同一個要求的場景:一個人在打翻的糖果桶旁,替一隻狗綁上蝙蝠圖案領巾。在這組結果中,左邊的結果把領巾放在狗頭後方高處,並讓狗的臉部偏暗;右邊的結果讓頸部位置與臉部更容易檢查。來源匯出的像素尺寸不同,所以這是檢查兩個實際輸出,不是同解析度基準測試或一般模型排名。
使用者提供的輸出標示為 Seedream 5.0 Pro Text-to-Image(左)與 GPT Image 2 Text-to-Image(右)。請比較這些結果中指定領巾的位置、主體數量與可見度。
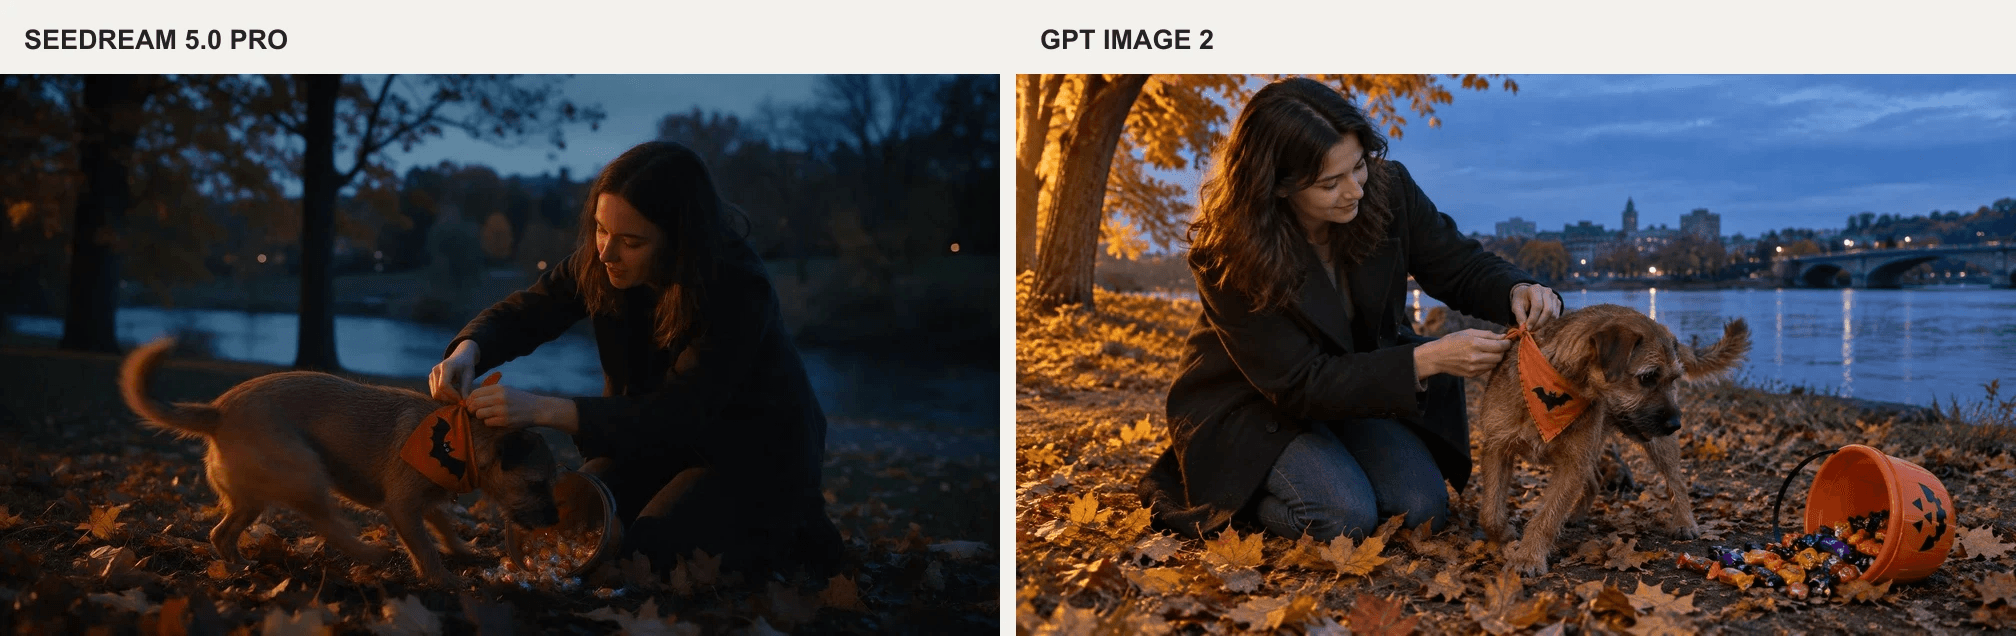
共用提示如下:
plaintext1A candid Halloween photograph in an autumn riverside park at blue hour. Exactly one young adult woman in a simple dark coat kneels to tie a small orange bandana with a stitched black bat motif around the neck of exactly one brown terrier. The dog twists toward a tipped bucket of wrapped candy, while both of the woman's hands visibly and plausibly attach the bandana. No other people or animals. Directional amber light from the left against cool blue shadows, restrained orange-and-blue palette, 35mm documentary photography, foreground leaves, natural skin, fur and fabric texture, slight movement in the dog. Keep both faces, the woman's hands, and the bandana clearly visible with room around them for a horizontal crop. No lettering, logos, or watermark. Horizontal 16:9.
在執行測試前,先把目標具體化。個人檔案圖片需要一張在縮圖尺寸下也能辨識的臉。限時動態圖像需要邊緣附近有空間留給介面疊層。印刷邀請函需要一個在最終實際尺寸下仍有足夠細節的檔案。這些要求可能讓帶有方便預設的生成器,不如一個有合適長寬比與可編輯結果的生成器有用。請檢查下載的檔案,不只是工具中的預覽。
對文字轉圖像需求而言,評估四件事:正確的主體數量、清楚的動作、最終裁切所需空間,以及任何必要文字。對照片編輯而言,把文字檢查換成相似度或來源物件連續性。對自拍而言,檢查手臂、手機位置、臉部,以及服裝是否保持合理。這些檢查簡單到可套用於單一結果,也具體到能顯示該在哪裡修改。
| 檢查項目 | 通過時看起來像 | 目標式修正 |
|---|---|---|
| 主體與身分 | 人物數量正確;所需臉部或物件與來源相符 | 重新上傳原圖,並要求保留指定特徵 |
| 相機幾何 | 一個可信的視角、手臂與手機位置 | 指定直接自拍、鏡子自拍或攝影師視角 |
| 萬聖節元素位置 | 服裝貼合身體;幽靈或道具位於指定區域 | 只移動放錯的元素;其餘保持固定 |
| 匯出適用性 | 重要特徵在預定裁切後仍保留 | 在工具設定中加入負空間或變更長寬比 |
Google 的 圖像提示指南 建議指定主體、構圖、動作、場景、風格與編輯指示。上述檢查清單把那些提示成分轉化為你可以在完成檔案上驗證的事項。修正要求應該說出一個觀察到的缺陷,而不是一份新的情緒板。
例如,如果生成器把南瓜放在臉前面,下一個指示是「把南瓜移到右下背景;保留臉部與光線」。如果帽子漂浮在頭髮上方,請要求它自然置於頭髮上並帶有自然陰影。如果海報日期被拼錯兩次,請停止要求圖像模型排版,改為之後加入已驗證文字。每個決策都應該讓素材更接近其預定用途。
適合你專案的頂尖萬聖節圖像生成器,是能以最少代價高昂的修改通過這些檢查的那一個。從你的輸入所需的路徑開始,執行小型受控測試,並在使用於貼文、邀請函或活動之前檢查匯出檔。
常見問題
哪一款萬聖節圖像生成器最適合我自己的照片?
選擇以參考圖為基礎的圖像編輯器,讓你可以上傳原圖並描述目標式變更。將最終臉部、服裝與背景與來源對照。純文字生成器可以製作萬聖節肖像,但無法驗證新人物就是你。
我可以把 AI 萬聖節圖片生成器用於派對邀請函嗎?
可以。文字轉圖像適合用於場景或插畫背景。如果邀請函包含日期、地址或確切標題,請檢查每個字元,並考慮在生成藝術後於設計編輯器中加入最終文字。
Atlas Cloud 圖像生成器是免費的嗎?
不要假設 Atlas Cloud 某個頁面上的免費優惠適用於每項產品。GPT Image 2.5 頁面目前說明參與的 Playground 模型共享免費嘗試,並表示 Generator、Model Explorer 與 API 執行另行計費。生成前請檢查你已登入帳戶中的目前額度。
我該用哪一種萬聖節藝術生成器來做桌布?
如果你想要新場景,請使用文字轉圖像,然後在工具允許時把畫布設定為你的裝置形狀。讓焦點主體遠離時鐘與應用程式圖示,並檢查最終裁切。如果桌布必須包含你實際的寵物或房間,請改用參考圖式編輯。
如何讓萬聖節自拍看起來像我?
從一張清晰、顯示雙眼與平常髮型的肖像或自拍開始。要求保留這些特徵,一次改變一個萬聖節元素,並將每項輸出與原圖比較。如果照片已經是自拍,直接進行圖像編輯;再次重新取景只會增加不必要的步驟。





