生產級代理管道(agentic pipelines)經常因意外的 schema 違規而崩潰。即使是頂級自迴歸 LLM,在高流量工具呼叫期間仍會出現 JSON 解析失敗,迫使開發人員建立複雜的重試迴圈和自訂錯誤處理器。
TypeSafe Jev 透過完全放棄逐 token 的序列式生成方式來解決此結構性缺陷。Jev 以非自迴歸決策模型運作,在單一平行前向傳遞(parallel forward pass)中攝取應用程式狀態並評估預先宣告的 schema 問題。由於所有可能的輸出選擇在執行前即受到嚴格限制,Jev 從數學上消除了格式錯誤的 JSON、無效的工具名稱以及不符合 schema 的文字。
快速重點:什麼是 TypeSafe Jev AI?效能與速度基準測試
TypeSafe Jev AI 是一個非自迴歸決策模型,專為亞秒級分類、意圖評分和結構化微服務路由而建置。與自迴歸 LLM 不同,Jev 在單一前向傳中評估預先宣告的 schema 選擇。
- 型別層級零幻覺:以受限的狀態 schema 基本單元取代字串解碼迴圈,達成 0% 型別錯誤率。
- 500ms 以下執行:非自迴歸並行取樣可達成 70ms–500ms P95 延遲,比標準 LLM 快上 200 倍。
- 免費輸出 Token:零生成的連續 Token 輸出表示輸出 Token 完全免費,每 100 萬輸入 Token 僅需 $0.042。
- 最適用於:微服務路由、agentic 工具分派、工單分流和意圖門控。
重新思考 AI 架構:系統 1 直覺 vs. 系統 2 推理
在設計可擴充的後端軟體時,將簡單的條件檢查強行塞進沉重的聊天完成端點會造成嚴重的系統延遲。多數微服務並不需要創意散文或多步驟思維鏈生成;它們需要的是在已知選擇中立即且確定性的選取。
將 Kahneman 認知框架應用於軟體架構
TypeSafe 共同創辦人 Diogo Almeida(曾在 OpenAI 共同開發 RLHF 強化學習技術)引入了 TypeSafe Jev 的結構性轉向,以解決此效率問題。此平台直接採用 Kahneman 認知框架,在現代 AI 架構中將處理流程劃分為兩個截然不同的操作層:
- 系統 2 緩慢、慎重的推理:標準自迴歸 LLM,透過逐 token 的流水式生成運作。這些模型擅長草擬長文件、處理模糊推理和撰寫複雜程式碼。
- 系統 1 快速、直覺式決策:一個專屬的 System One AI 模型,透過強化學習進行校準決策(而非傳統 RLHF)訓練。它專為亞秒級分類、意圖評分和無對話開銷的執行路由設計。
Jev vs. LLM 成本與架構:決策模型 vs. 聊天模型
以專門的型別化決策模型取代通用的聊天模型,透過將簡速評估與深度生成分離,從根本上優化微服務工作流程。
| 架構維度 | 自迴歸 LLM(系統 2) | TypeSafe Jev(系統 1) |
| 主要任務 | 開放式文字合成 | 離散選擇與 schema 評估 |
| 執行延遲 | 3,000ms 至 30,000ms+ | 70ms 至 500ms |
| 輸出格式 | 非結構化文字串流 | 嚴格型別化 schema 基本單元 |
| 計算迴圈 | 循序條 Code 解碼認證(sequential token decoding) | 單一前向傳遞評估 |
| 訓練目標 | 人類偏好(RLHF) | 校準決策信心(RLCD) |
將路由、安全護欄和函式分派從標準聊天模型中卸載,可解決自迴歸 LLM 固有的效能瓶頸。納入 System One AI 模型後,可確保只有在真正需要開放式生成時,才會觸發大型推理引擎。
TypeSafe Jev 模型如何達到型別層零幻覺
即使啟用嚴格的 JSON 模式,前端(frontier)LLM 在高並發生產執行時仍會定期回傳不符合 schema 的 key 或幻覺產生的 enum 值,導致 0.5% 至 5% 的管道請求失敗。生產級微服務需要絕對的型別確定性,但自迴歸模型本質上仍容易產生字串生成錯誤。
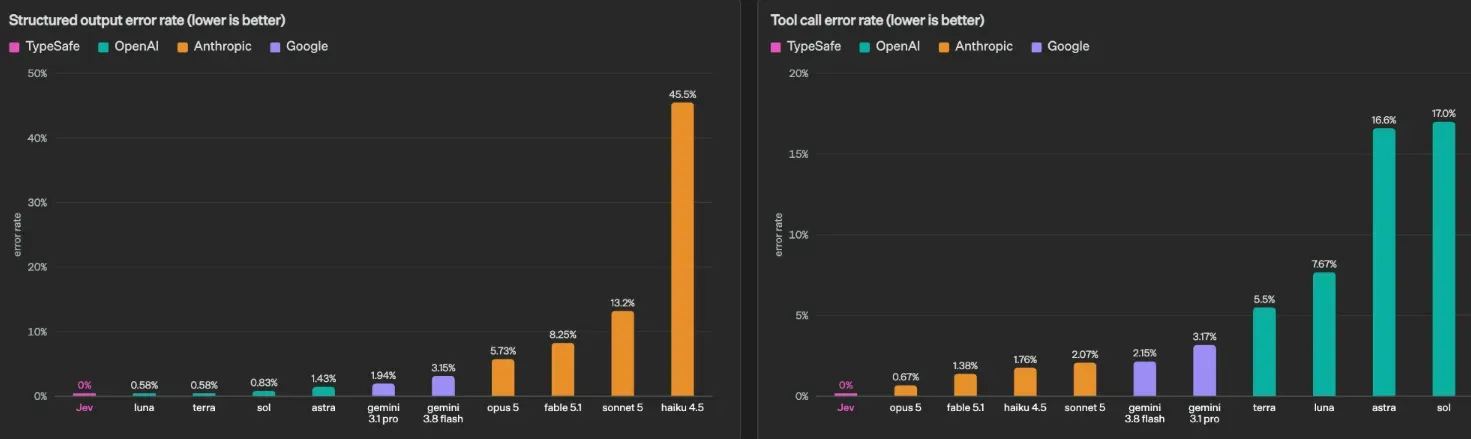
TypeSafe Jev 透過將字串解碼迴圈替換為限界狀態架構來解決此問題。Jev 不是生成任意文字並嘗試強制轉為 JSON 語法,而是在單一前向無效中評估輸入資料對照預設 schema 限制。此結構性轉變在型別層級實現真正的零幻覺 AI,使自動化工作流程達到 0% 型別錯誤。
三個核心 Schema 基本單元
Jev 透過三個明確的基本單元 title 為處理所有輸入問題:
- Choice 基本單元: 需要從最多 255 個類別選擇的預定義清單中選出一個選項,回傳獲勝的標籤以及完整的機率分佈。
- Score 基本單元: 將輸入對照有序的數值尺度或描述性評分進行評估,提供各級別之間的評分與機率離散度。
- Noul 基本單元: 將是/否條件的確切機率計算為介於 0.0 到 1.0 之間的浮點數,消除中間的文字條說明。
因為每個查詢都嚴格對應到這三個基本單元,執行引擎不可能發出無效金鑰、清單外的工具名稱或格式錯誤的訊息。
結構化輸出評估中的型別安全性
傳統聊天模型逐一字符地生成語法,會在後端管道中持續帶來解析風險。
| 評估指標 | 自動迴歸 JSON 模式 | TypeSafe Jev System One |
| 輸出型別強制 | 生成後的字串驗證 | 原生數學限界基本單元 |
| 型別錯誤頻率 | 變動(0.5% 至 5%+ 失敗率) | 0% 型別錯誤(schema 限定) |
| 無效 Enum 風險 | 高(若無自訂重試迴圈) | 零(設計上就不可能) |
將模型執行嚴格限定在有限狀態下,可保證可靠的結構化輸出評估。應用程式可以直接使用 Jev 的輸出,無需撰寫額外的異常處理器處理格式錯誤的 JSON schema。
註:型別確定性 vs. 機率 TypeSafe Jev 保證 0% 的型別錯誤和 schema 匹配是設計上的保證,數學上排除了錯誤語法、缺少的 key 和清單外 enum 值。然而,與所有決策模型一樣,其輸出選擇仍是機率性的。對於本質上模煳的輸入,風險請使用信心分數來控制執行閘,而非假設絕對的語意確定性。
非自迴歸並行取樣如何驅動 500ms 以下的延遲和零輸出成本
使用標準聊天端點執行簡式分類標籤(如 {"category": "billing"}),會在生產微服務中引入不必要的延遲。由於自迴歸模型依賴逐 token 的解碼,後端執行緒在等待單字符生成循環期間會一直被佔用。
單傳遞評估的實現機制
傳統的 transformer 執行自迴歸生成迴圈,其中每個新 token 都要求網路堆疊中的一次獨立傳遞,這種順序依賴性導致高延遲,且基礎架構成本因生成 token 量而膨脹。
TypeSafe Jev 透過非自迴歸並行取樣消除逐 token 生成。如 TypeSafe 發布版所述,Jev 在單一前向傳遞中同時解析上下文 / 背景與所有預先宣告的 schema 選擇。
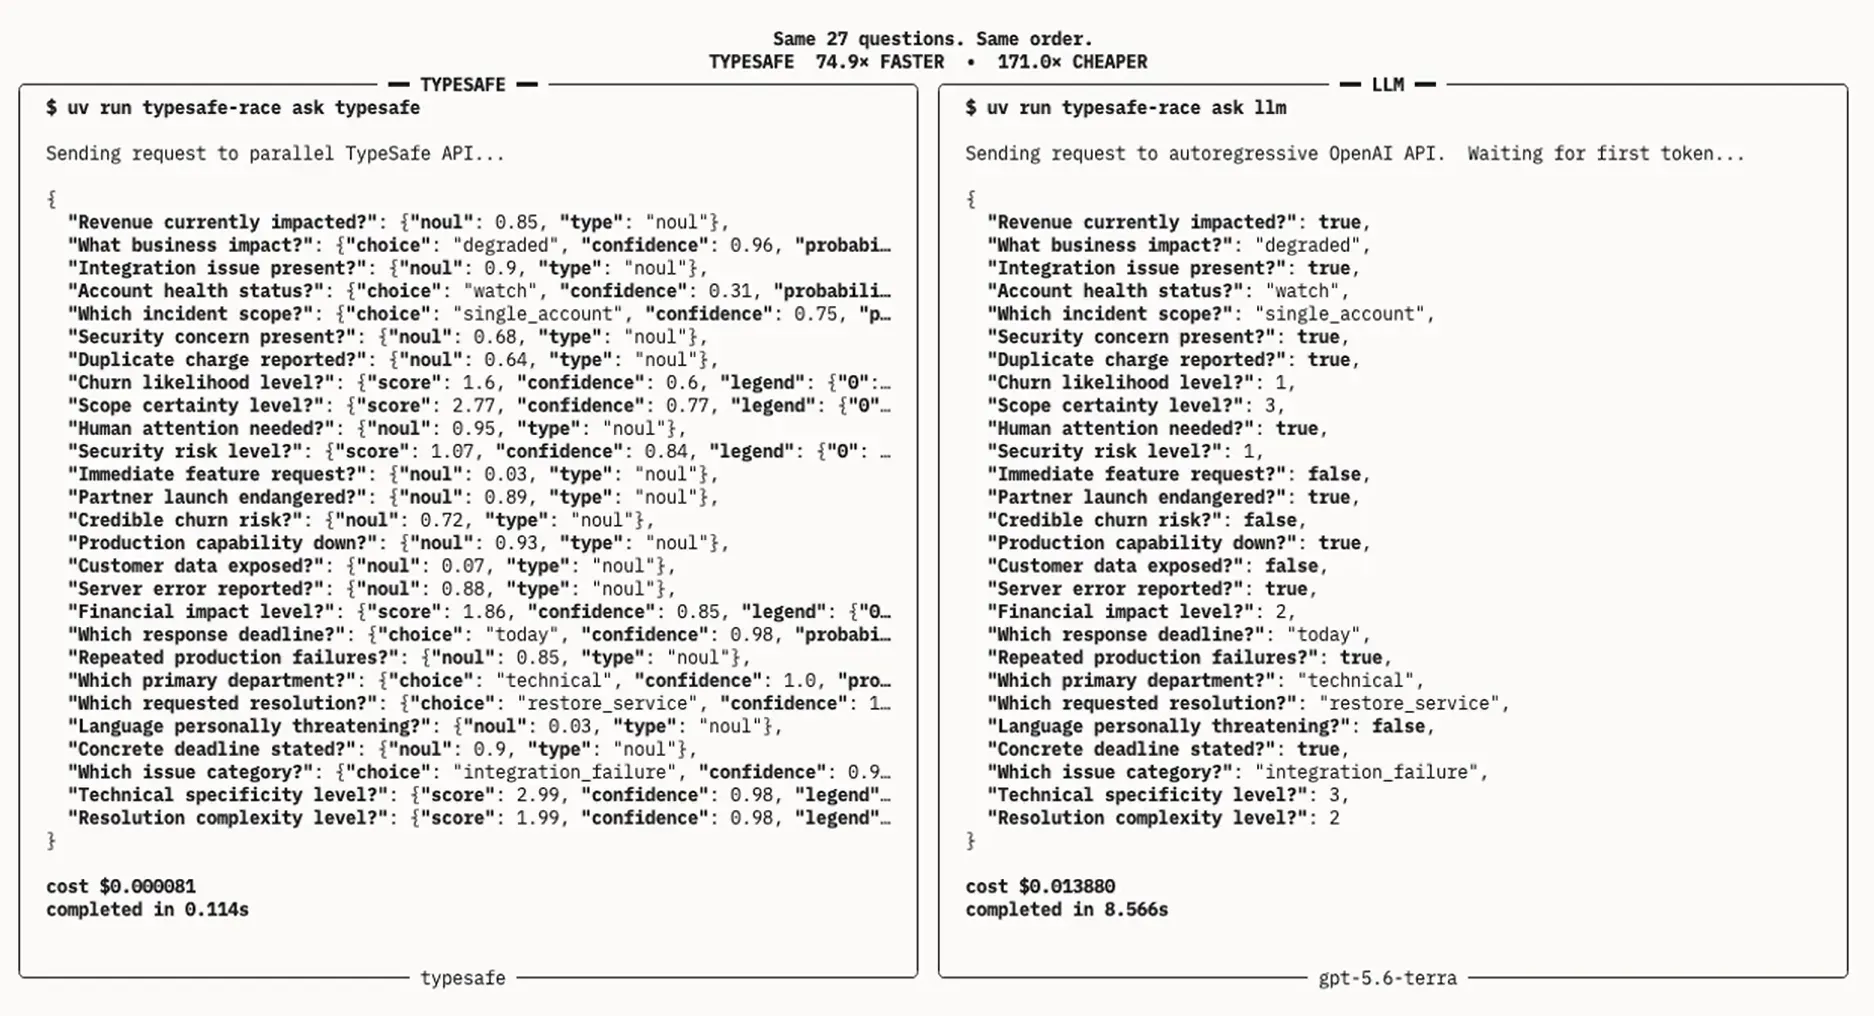
終端基準比較:在 TypeSafe Jev 上執行 27 個並行 schema 評估問題 vs. GPT 5.6 Terra 端點
因為模型是計算預定義輸出上的機率分佈,而非生成自由文字,輸出解碼迴圈完全消失。此結構轉變帶來了三個主要效能提升:
- 免費輸出 Tokens(低到無法計量): 因為 Jev 在單次前向傳中評估選擇,而不產生循序 token,輸出效益幾乎為零的增量計算,因此輸出 token 實際上免費。
- 可預測的定價: 上下文處理成本為每 1M 輸入 tokens 的固定 $0.042 費用。將固定常數 schema 和 Jev 的評估,相較於大型聊天端點的長上下文執行缺點,能處理指數的 API 成本膨脹。
- 亞秒多執行: 公開的 TypeSafe Jev 延遲基準測試展示 P95 反應時間始終維持在 70ms 至 500ms 之間,比前沿聊天模型快 200 倍。
架構效能取得顯著改善
| 指標 / 面向 | 傳統 Autoregressive LLM(系統) | TypeSafe Jev System One 引擎 |
| 執行迴圈 | 逐 token 流水式解碼 | 對預先宣告 schema 的單次並行通過 |
| 輸出型別 | 非結構化文字字串 / JSON 字串 | 定型決策基本單元(Choice, Score, Noul) |
| Schema 錯誤率 | 0.58 至 45%+(取決於模型/示範) | 0% 型別錯誤率(限期數學上) |
| P95 延遲資料集 | 3,000ms 到 30,000ms+ | 70ms 至 500ms |
| 輸出經濟 | 依 token 計價($15 至 $60 / 1M tokens) | 免費(無法估量). 無循序刷新或輸出 token 產生 |
| 主要應用領域 | 引導、生成草稿、開放式綜合 | 分類、工具選擇、基於信心的理解 |
超越記憶體頻寬瓶頸
在標準 LLM 推理中,記憶體頻寬會因為模型權重在每個 token 產生期間都被重新載到記憶體邏輯中而飽和。Jev 在單次前進傳中完成決策評估,完全避開了此記憶瓶頸,即使在高度並發的流量下仍能維持穩定的回應速度。
強化學習以產生校準決策與信心閘
標準聊天模型的輸出往往會以高達 99% 的自報信任度提出錯誤的陳述,因為傳統的模型微調獎賞的是有說服力的措辭,而不是統計事實。在生產微服務中,過度自信的錯誤決策會直接導致資料庫記錄損壞、工具參數錯誤和不可預料的系統停機。
調整模型信心並對齊實證準確度
為了解決這種結構化的過度自信,TypeSafe 引入了 Reinforcement Learning for Calibrated Decisions。與傳統 RLHF 方法不同,RLCD (強化學習校準決策) 不用人類主觀偏好作為優化目標,而是訓練決策的決策產生校準的機率。
透過對齊準確的信心,Jev 輸出的 0.90 機率表示該候選選擇在測試集中有 90% 的時間實驗經驗上是正確的。這種數學校準使開發者可以在不需要撰寫複雜 prompt農法來評估輸出確定性的情況下,進行可靠的機率決策。
在生產環境中實現信心門控路由
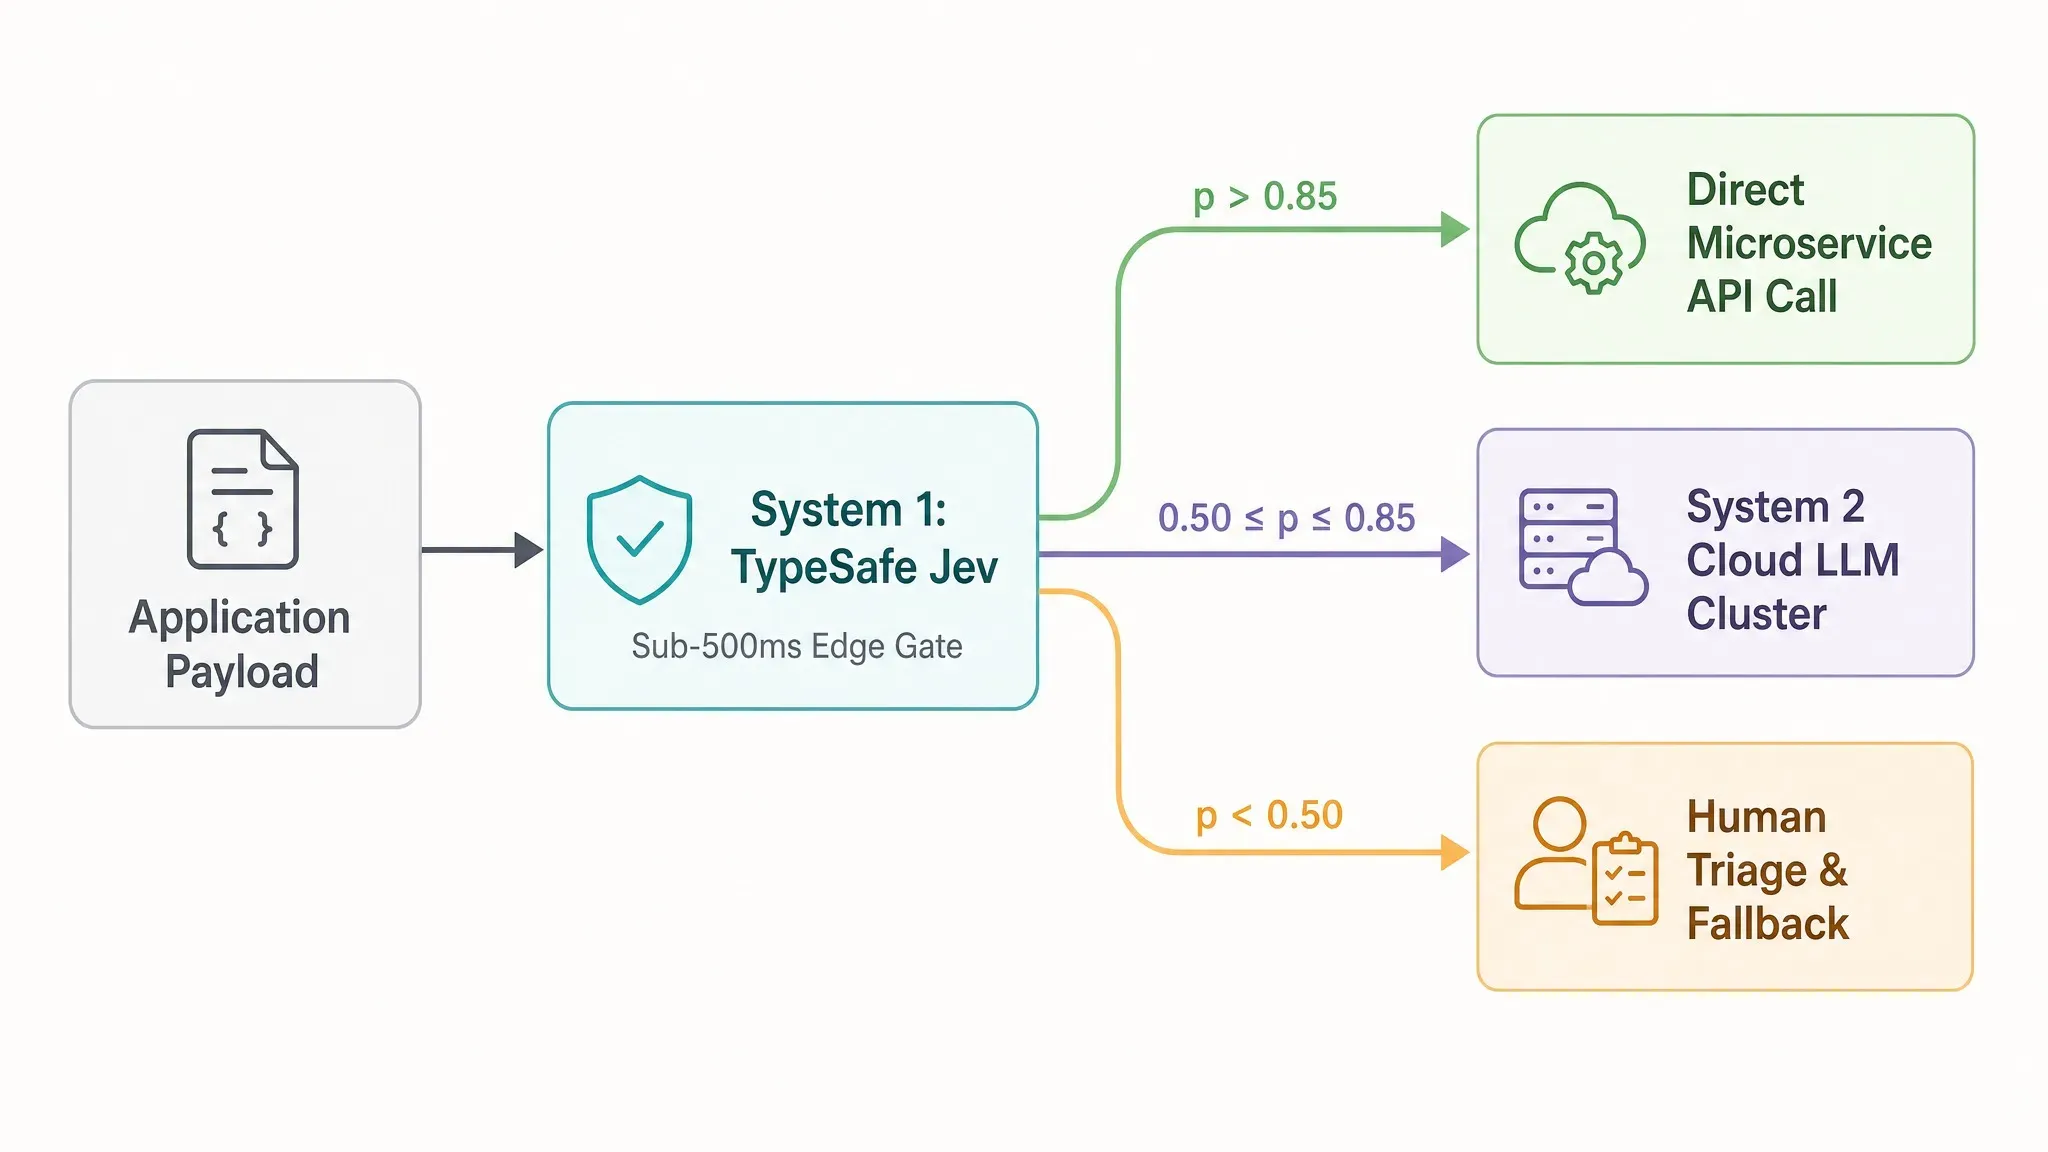
工程人員可以利用這些校準的機率分佈來配置基於閾值的決策選擇。典型生產設定如下:
p > 0.85(快路徑執行): 立即執行在高速路徑中,完全繞過慢速 LLM 端點。0.50 ≤ p ≤ 0.85(系統 2 升級): 將邊界輸出傳遞給負責處理模糊邊界案例的推理 LLM。p < 0.0.50(後退三篩): 觸發安全預設或將請求送入人工審閱佇列。
對於邊界情況(0.50≤ p ≤ 0.85),信任門路由會將 payload 導向企業級推理模式。透過 Atlas Cloud 上的 GPT 5.6 Terra 作為這些升級請求的可靠 fallback 目標,利用其 1,050K 上下文窗口以及 $2/$12 token 定價來執行深入分析,而不會過度膨脹微服務資源成本。
Autoregressive LLM 的 raw logprobs 反覆以惡名遠播,而且只要系統提示變化就會偏移。透過在核心訓練流程中直接整合 RLCD,Jev 讓信心門控路由可立即投入生產效,使軟體團隊可安全自動化高流量管道,同時保留邊界案例的特別處理彈性。
生產設計模式:實際應用中的高效 AI 管道
當 LLM 設計一個不存在的函數簽名(如 get_user_billing_v2())或向內部 API 端點傳入無效的 TYPE 參數時,生產環境的 AI 智能體經常崩潰。如果透過標準 chat 完成流程在管線中多個條件檢查組織會造成延遲疊加,導致面臨客戶的微服務時間延遲。
高流量微服務的核心架構模式
在高生產力的 AI 管道中整合準確的時間決策引擎,使軟體團隊能將不可預測的 prompt 迴圈替換為確定性後端模式:
- Agentic 工具選擇: 在自動化 agent 工作流程中挑選工具時,Jev 將可用函式簽名與當前應用狀態進行評估。由於候選函式在請求 schema 中作為明確選擇進行傳遞,Jev 就無法定義函式名對不對代碼的正常執行,消除了 agentic 工具選擇期間的無聲執行失敗。先進行高速預濾波可在指令傳遞至自主 LLM 編碼 agent 管道 之前,保證 schema payload 的合法完整性。
- 平行多問題評估: 標準聊天重點強迫並以連續方式評估各類訊問,總延遲會因規則數而倍增定義增加。Jev 則可讓數十個獨立的 schema 問題透過單一無效評估在一個並行前向傳中完成。十五項分類檢查只需與單一項相同的 100ms。
- 工單分流自動化: 針對高流量的入站客戶工單微服務,JPC 同時支援客戶情緒解析、技術優先級路由與退款資格檢查。具次秒響應的工單分流自動化可在突發流量時避免佇列堆積。
透過 SDK 實現 System One 決策節點
開發者可將官方規則 typesafe-sdk 整合到現有微服務中,建立低延遲的決策模式。執行 payload 會將應用狀態與預先宣告的 schema 基礎元素提交給 https://api.typesafe.ai}/v1/systemone 端點。
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Customer input: 'I was double-charged $49 on invoice #1092 and need a refund immediately.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
傳統的 tool-call 設定在執行每次函式函式時都要為整個 the entire端點背景重新 tokenize 整個上下文。通過將狀態標表示與決策問題分離,Jev 可以在後端引擎中執行多分支分類流程,而不會使 token 數倍膨脹、減少 API 時間,或犧牲 P95 延遲保證。
TypeSafe Jev Known Limitations 與架構取捨(What JPC 無法執行)
如果部署非自動迴歸決策模型卻期望它撰寫一份有禮貌的電子郵件回覆或摘要發票訊息,在產生中必然會導致程式碼崩潰。工程團隊如果按將 System One 模型視為取代所有通用 LLM,則立刻會遭遇實體的架構限制。
架構邊界分析
在將 Jev 接整合至微服務工作流程前,了解特定 Jev 失敗模式十分關鍵。JPC 的單向前進設計在幾個核心任務上強制建立嚴格邊界:
- 開放式文句生成:Jev 不產生任何交談式文字。它無法撰寫論文、摘要文件或為其選擇生成自然語言的解釋。
- 多步推理限制:此架構立即評估狀態表徵,提取結果。複雜的順序邏輯或須多步推理的任務仍需重新回傳統自詮迴歸。
- 計算相關模型:無法執行數學運算或且可寄望 *注意,請檢查程式碼。**精確計算上下文中的元素個數。計算應保留在標準後端程式碼中。
- 字面解讀性的條件: Jev 只嚴格按照提示規則執行,不推論未指明的商業邏輯。語意模糊的 schema 選項會導致意外的機率分佈。
- 持續準確度受限 : 高度大量且無結構的日誌在 Jev 對片段文本會降低評估準確度。在發送前篩選重複語內容至關重要。
架構映射:System One vs. System Two 能力
| 操作任務 | TypeSafe Jev System One | 自詥歸 LLM System Two |
|---|---|---|
| 離散性分類 | 原生(次於 500ms) | 慢速(順序生成文字) |
| 文字合成 | 不可能(無解碼迴圈) | 原生(開放式文字生成) |
| 數學計算 | 不支援(計算限制) | 變動性(需要執行程式碼) |
| 雜訊容忍度與 | 大狀態下容易上下文腐化 | 更佳上下文視窗彈性 |
將 JPC 作為結果的決策節點而非無所不能的推理引擎,確保生產微服務的設計正確。
未來的雲基礎設施:編排快速決策節點
若將進入的每一個使用者請求直接發送事事務,都在 70 億參數的指機型推理上消耗數千的 GPU 運算,同時讓使用者等待數秒鐘只為完成基本安全驗證與 payload 路由。現代微服務無法把每個進入的 HTTP payload 視為一個開放式思考問題。
THR 除了速度之外, " 節省;只查詢兩個節點與使用者之間的三角路由費用,可能高達每百萬tokens 的 6 倍差價。我們稍候。
朝向混合 AI 架構的轉變
雲端的現有模式正逐漸從一致的 LLM 端點模式,向著端的混合式 AI 架構轉進。在這種新出現的範式中,雲原生控制器在系統邊緣放置快速決策節點,可以立即評估進入的負載。
透過在一般副500ms 的執行時間內處理邊緣 AI 路由、schema 驗證與信心分數,快速決策節點可在流量抵達更重的模型叢集前先行過濾流量。這個t论結構在滿足三大型雲操作層的資源配置優化:
- 邊界安全與路由: 快速決策套在單一前向傳中評估使用者意圖、清理輸入並驗證 schema 合規性。
- 狀態移交與編排: 雲端運作器分析信心中分數,立即執行確定性高的請求,並將複雜的處理轉介至後續。
- 集中式系統 2 推理: 只有當雙回合合成或特定性的開放式生成需求時,大型 LLM 叢集才會集中預先過濾的、結構化的負荷。
規模化部署 System One 模型
隨著雲基礎平台擴展其代管能力,在 AI 基礎架構中進行 TypeSafe Jev 部署將能為邊緣微服務提供高效的設計模式。對離使用者較近的運行非連續決策模型可以大幅降低來回傳輸時間與高流量應用程式的計算成本。
以專屬決策層建立的工作流能確保在重負載下後端網路保持自我調整,並將前沿推理模型強調於那些真正需要深度計算的任務的聚焦。


