最新更新: Wan 3.0 已於 2026 年 8 月 24 日正式上線。
你為一支 15 秒廣告建了一個資料夾。兩個角色靜態圖。客戶寄來的品牌調性影片。一份只存在 PDF 裡的品牌書。以及你真正想要的演員的聲音樣本。
然後你打開你的影片模型,它只要求一張圖片。
於是你做了大家都會做的事。你把資料夾翻譯成一段 800 字的提示詞,然後祈禱。臉在第三個鏡頭偏移了。外套顏色變了。聲音變成了另外一個人。
Wan 3.0 的全參考功能,是第一次有影片模型說:好吧,把整個資料夾給我。單次呼叫最多 20 個素材,橫跨五種輸入類型,透過一個連續的 30 秒鏡頭全部串在一起。
這篇文章只做三件事,其餘跳過。它拆解那 20 個素材到底是什麼,用阿里巴巴自己生成的片段作為證據,並提供一個你今天就能執行的等效工作流程,因為 Wan 3.0 仍在阿里巴巴自家雲端公開測試,尚未能從第三方平台呼叫。
重點摘要
- Wan 3.0 的多模態參考功能可在單次呼叫中接受最多 20 個素材,涵蓋圖片、影片、音訊、文件和即時網頁,並在單一 30 秒鏡頭中保持一致性。
- 它是第一個將 PDF、簡報或 URL 視為創意輸入、而非需要你將它們改寫成提示詞的主流影片模型。
- Wan 3.0 於 2026 年 8 月 6 日在阿里雲模型服務平台與通義千問雲端以
wan3.0-video型號進入公開測試。其權重為封閉狀態。任何告訴你它已經是 Apache 2.0 的人都是在猜測。 - 20 個素材的標題並非它真正領先的地方。你現在就能呼叫的參考轉影片模型,接受的素材數已經超過 20 個。差距在於文件和網頁,而不是數量。
- 你可以透過 Atlas Cloud 的免費 AI 廣告短劇生成器,免費測試雙角色、參考鎖定、完整配音的格式:放入四張產品照片,輸出一個 15 秒的短劇,無需卡片。
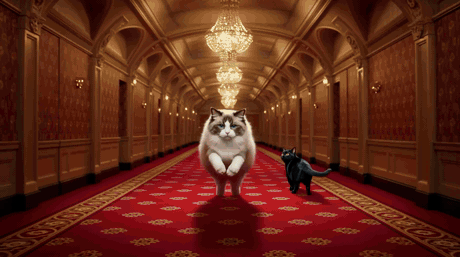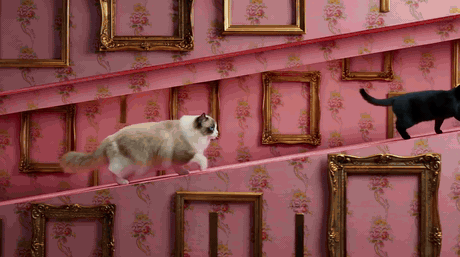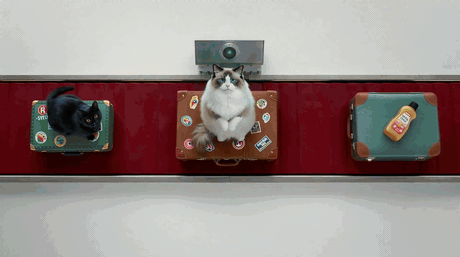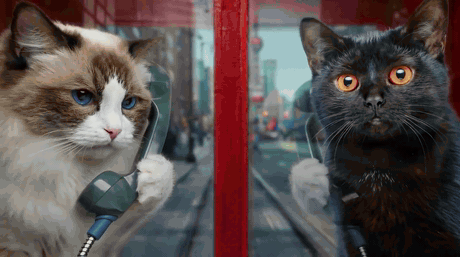
兩隻貓在 Wan 3.0 下穿越五個不同場景,角色無偏移。兩張參考圖片。五個完全不同的場景,從酒店走廊到洗衣機滾筒再到紅色電話亭。沒有一幀偏移。來源:阿里巴巴官方 Wan 3.0 創作者手冊,2026 年 8 月,本文中所有其他 Wan 3.0 片段亦出自此處。
為什麼多參考影片會失敗,以及 Wan 3.0 多模態參考改變了什麼
影片模型在片段之間沒有記憶。每次生成都從零開始。這就是整個問題的關鍵。
因此,一旦你的故事需要多個鏡頭,你就在拼接。第一個鏡頭給你一張你喜歡的臉。第二個鏡頭給你那張臉的遠親。第三個鏡頭悄悄地把外套從梅紅色換成酒紅色,等你發現時,你已經付了十一次渲染的費用。
單一圖片參考有所幫助,但它只能鎖定一件事:一張臉。它無法同時鎖定一張臉、一套服裝、一個道具、一個地點和一個聲音,因為只有一個位置,卻有五項工作。
有兩種解決方法:給模型更多位置,或讓它不再從頭開始。Wan 3.0 同時做到了這兩點,這就是為什麼兩個標題功能實際上是一個功能。原生 30 秒鏡頭意味著沒有剪輯點讓角色偏移。二十個參考素材意味著每個必須保持固定的元素都有自己的專屬位置,而不是爭奪一個位置。
以下是沒有拼接時的樣子。三十秒,一個連續鏡頭,一個坐在購物車裡的小孩,最後嵌入廣告看板,然後又從下面走出來。
一次通過的完整 30 秒,無剪輯,配樂也在同一遍生成。來源:阿里巴巴官方 Wan 3.0 創作者手冊。
Wan 3.0 多模態參考中的「20 個素材」實際上是什麼
二十是一個標題數字。重要的是這二十個並非都是同一類東西。Wan 3.0 的全參考涵蓋五種輸入類型,每一種控制輸出的不同軸向。
圖片控制身份。 角色卡、產品照、地點圖。Wan 3.0 稱之為像素級一致性,在阿里巴巴自己的範例中,鎖定範圍從臉部延伸到服裝:層疊的灰色長袍、繫帶的皮質罩衫、深色腰封,在跨越三個地點的十六秒近身打鬥中全部保持不變。
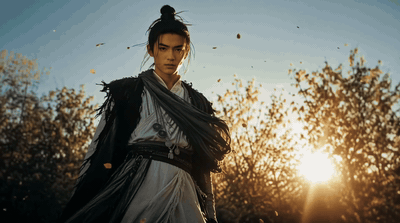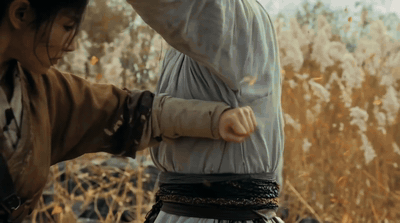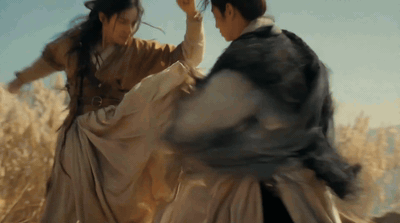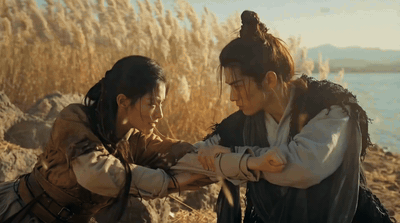
兩張角色卡驅動一場武俠打鬥場景,服裝細節保持幀與幀一致。兩張角色卡加上一張蘆葦岸地點圖。服裝和場景在每一次摔投中保持不變。此處以靜態 GIF 顯示;交付檔案包含 44.1kHz 立體聲混音。來源:阿里巴巴官方 Wan 3.0 創作者手冊。
音訊控制聲音。 這是讓「多模態」不僅僅是行銷話術的部分。你為每個角色附加一個聲音樣本,在提示詞中寫下台詞,對話就會以那種音色回來,並同步唇形,與影像在同一遍生成。兩個人,兩個聲音參考,一個健身房。
兩張人物圖片加上兩個獨立聲音參考片段,對話以那兩種聲音回來。這個值得打開聲音觀看。來源:阿里巴巴官方 Wan 3.0 創作者手冊。
影片控制節奏。 參考影片不是用來複製的。它是用來提供其節奏的:一個節拍持續多久,一個轉場如何移動。在這個範例中,五個關鍵影格提供主體,一個參考影片提供它們之間的水平翻轉節奏。
五個關鍵影格透過參考影片的節奏翻轉。五個關鍵影格圖片作為主體,一個參考影片提供翻轉節奏。來源:阿里巴巴官方 Wan 3.0 創作者手冊。
文件和網頁控制結構。 這是真正新穎的部分。Wan 3.0 接受文件檔案和即時網址作為創意輸入,關於測試版的報導列出 .doc、.xls、.ppt、.pdf 和 .txt 為接受的格式(AlphaSignal,2026 年 8 月)。同樣的邏輯已經適用於分鏡圖:一張分鏡板輸入,六個鏡頭輸出,按照分鏡板自己的順序。
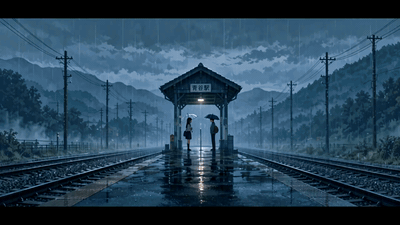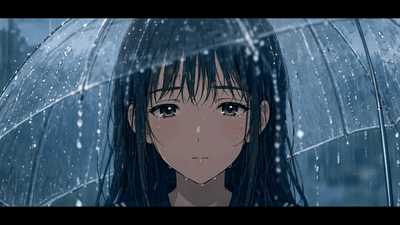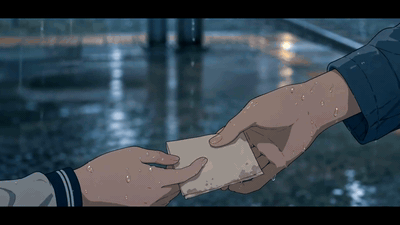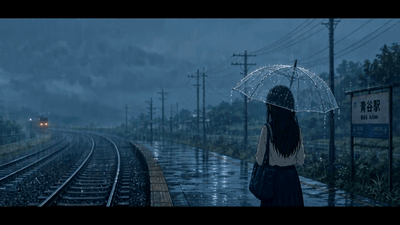
單張分鏡板擴展成下雨火車月台上的六個連續鏡頭。一張分鏡板作為參考,按照其順序生成六個鏡頭,甚至包括第五個鏡頭中傳遞紙條的動作。來源:阿里巴巴官方 Wan 3.0 創作者手冊。
首尾幀控制端點。 最老套的技巧,仍然支援,仍然是限制一個鏡頭最快速的方法。
以下是它與目前大多數人實際使用的版本比較:
| Wan 2.7 參考轉影片 | Wan 3.0 全參考 | |
|---|---|---|
| 參考素材 | 每個主體一張圖片,最多 3 部影片,1 個聲音片段 | 總共最多 20 個素材 |
| 模態 | 圖片、影片、音訊 | 圖片、影片、音訊、文件、網頁 |
| 單次通過最大持續時間 | 10 秒 | 30 秒原生,加上智慧持續時間 |
| 同次通過音訊 | 是 | 是 |
| 影片編輯與擴展 | 未公開 | 基於指令和參考的編輯,加上擴展 |
| 可用性 | 已在第三方 API 上線 | 阿里雲模型服務平台和通義千問雲端測試版 |
有一條規則沒有寫在文件中,但每個人都會學到教訓:一個參考,一項工作。 圖片1鎖定臉部和服裝。影片1僅提供動作。音訊1僅提供音色。一旦你讓一個素材承擔兩項衝突的工作,或者上傳一張包含兩個人的參考圖片,模型就必須猜測,而猜測正是你試圖避免的。阿里巴巴的手冊對此也很直接:每張參考圖片一個主體。
你今天就能執行的 Wan 3.0 多模態參考工作流程
先給直接答案。Wan 3.0 在阿里巴巴自家雲端公開測試,型號為 wan3.0-video(阿里巴巴 Wan,2026 年 8 月)。它尚未登陸第三方 API 平台,包括 Atlas Cloud。現在向你販售 Wan 3.0 API 存取權的人,是在轉售別的東西。
已經落地的是工作流程的形狀。參考包輸入,一次呼叫,附帶聲音的完成片段輸出。這在你可以透過瀏覽器分頁呼叫的參考轉影片模型上今天就能執行,一旦你把它們排列好,20 個素材的標題看起來就不一樣了。
| 模型 | 參考素材 | 模態 | 最大持續時間 | 原生音訊 | 每秒價格 |
|---|---|---|---|---|---|
| Wan 3.0(阿里巴巴測試版,不在 Atlas 上) | 總共 20 個 | 圖片、影片、音訊、文件、網頁 | 30 秒 | 是 | 據報導依解析度為 $0.05 至 $0.20 |
| Wan 2.7 參考轉影片 | 每個主體 1 張圖片,3 部影片,1 個聲音片段 | 圖片、影片、音訊 | 10 秒 | 是 | $0.10 |
| Seedance 2.5 參考轉影片 | 50 個(30 張圖片 / 10 部影片 / 10 個音訊) | 圖片、影片、音訊 | 30 秒 | 是 | $0.13 |
| MiniMax H3 參考轉影片 | 混合,無明確上限 | 圖片、影片、音訊 | 15 秒 | 是 | $0.10 |
| Kling Video O3 Pro 參考轉影片 | 7 張圖片,或 4 張圖片 + 1 部影片 | 圖片、影片 | 15 秒 | 是 | $0.10 |
| Vidu Q3-Mix 參考轉影片 | 4 張圖片 | 圖片 | 16 秒 | 是 | $0.11 |
| Veo 3.1 參考轉影片 | 3 張圖片 | 圖片 | 8 秒 | 可選 | $0.20 |
價格是截至 2026 年 8 月的 Atlas Cloud 費率。Wan 3.0 的數字是阿里巴巴雲端測試版報導的數字,不是 Atlas 費率,且阿里巴巴尚未公佈該模型的公開價格頁面,因此該行視為暫定。
再看一遍表格,真實情況就浮現了。20 個素材的標題並非 Wan 3.0 領先的地方,因為 Seedance 2.5 已經接受 50 個並達到 30 秒。該清單上其他模型都無法接受的是 PDF。
以下逐步說明中,示範在 Wan 2.7 參考轉影片上執行,因為它的輸入形狀與全參考最接近:多張主體圖片、一個可選參考影片、一個聲音片段,全部映射到提示詞中的 character1 和 character2 標籤。三個模型,一個瀏覽器分頁,無需本機安裝。
若要進行當前託管執行,請打開 Atlas Cloud 上的 Wan 3.0 並在發布工作流程之前測試類似下面的提示詞。
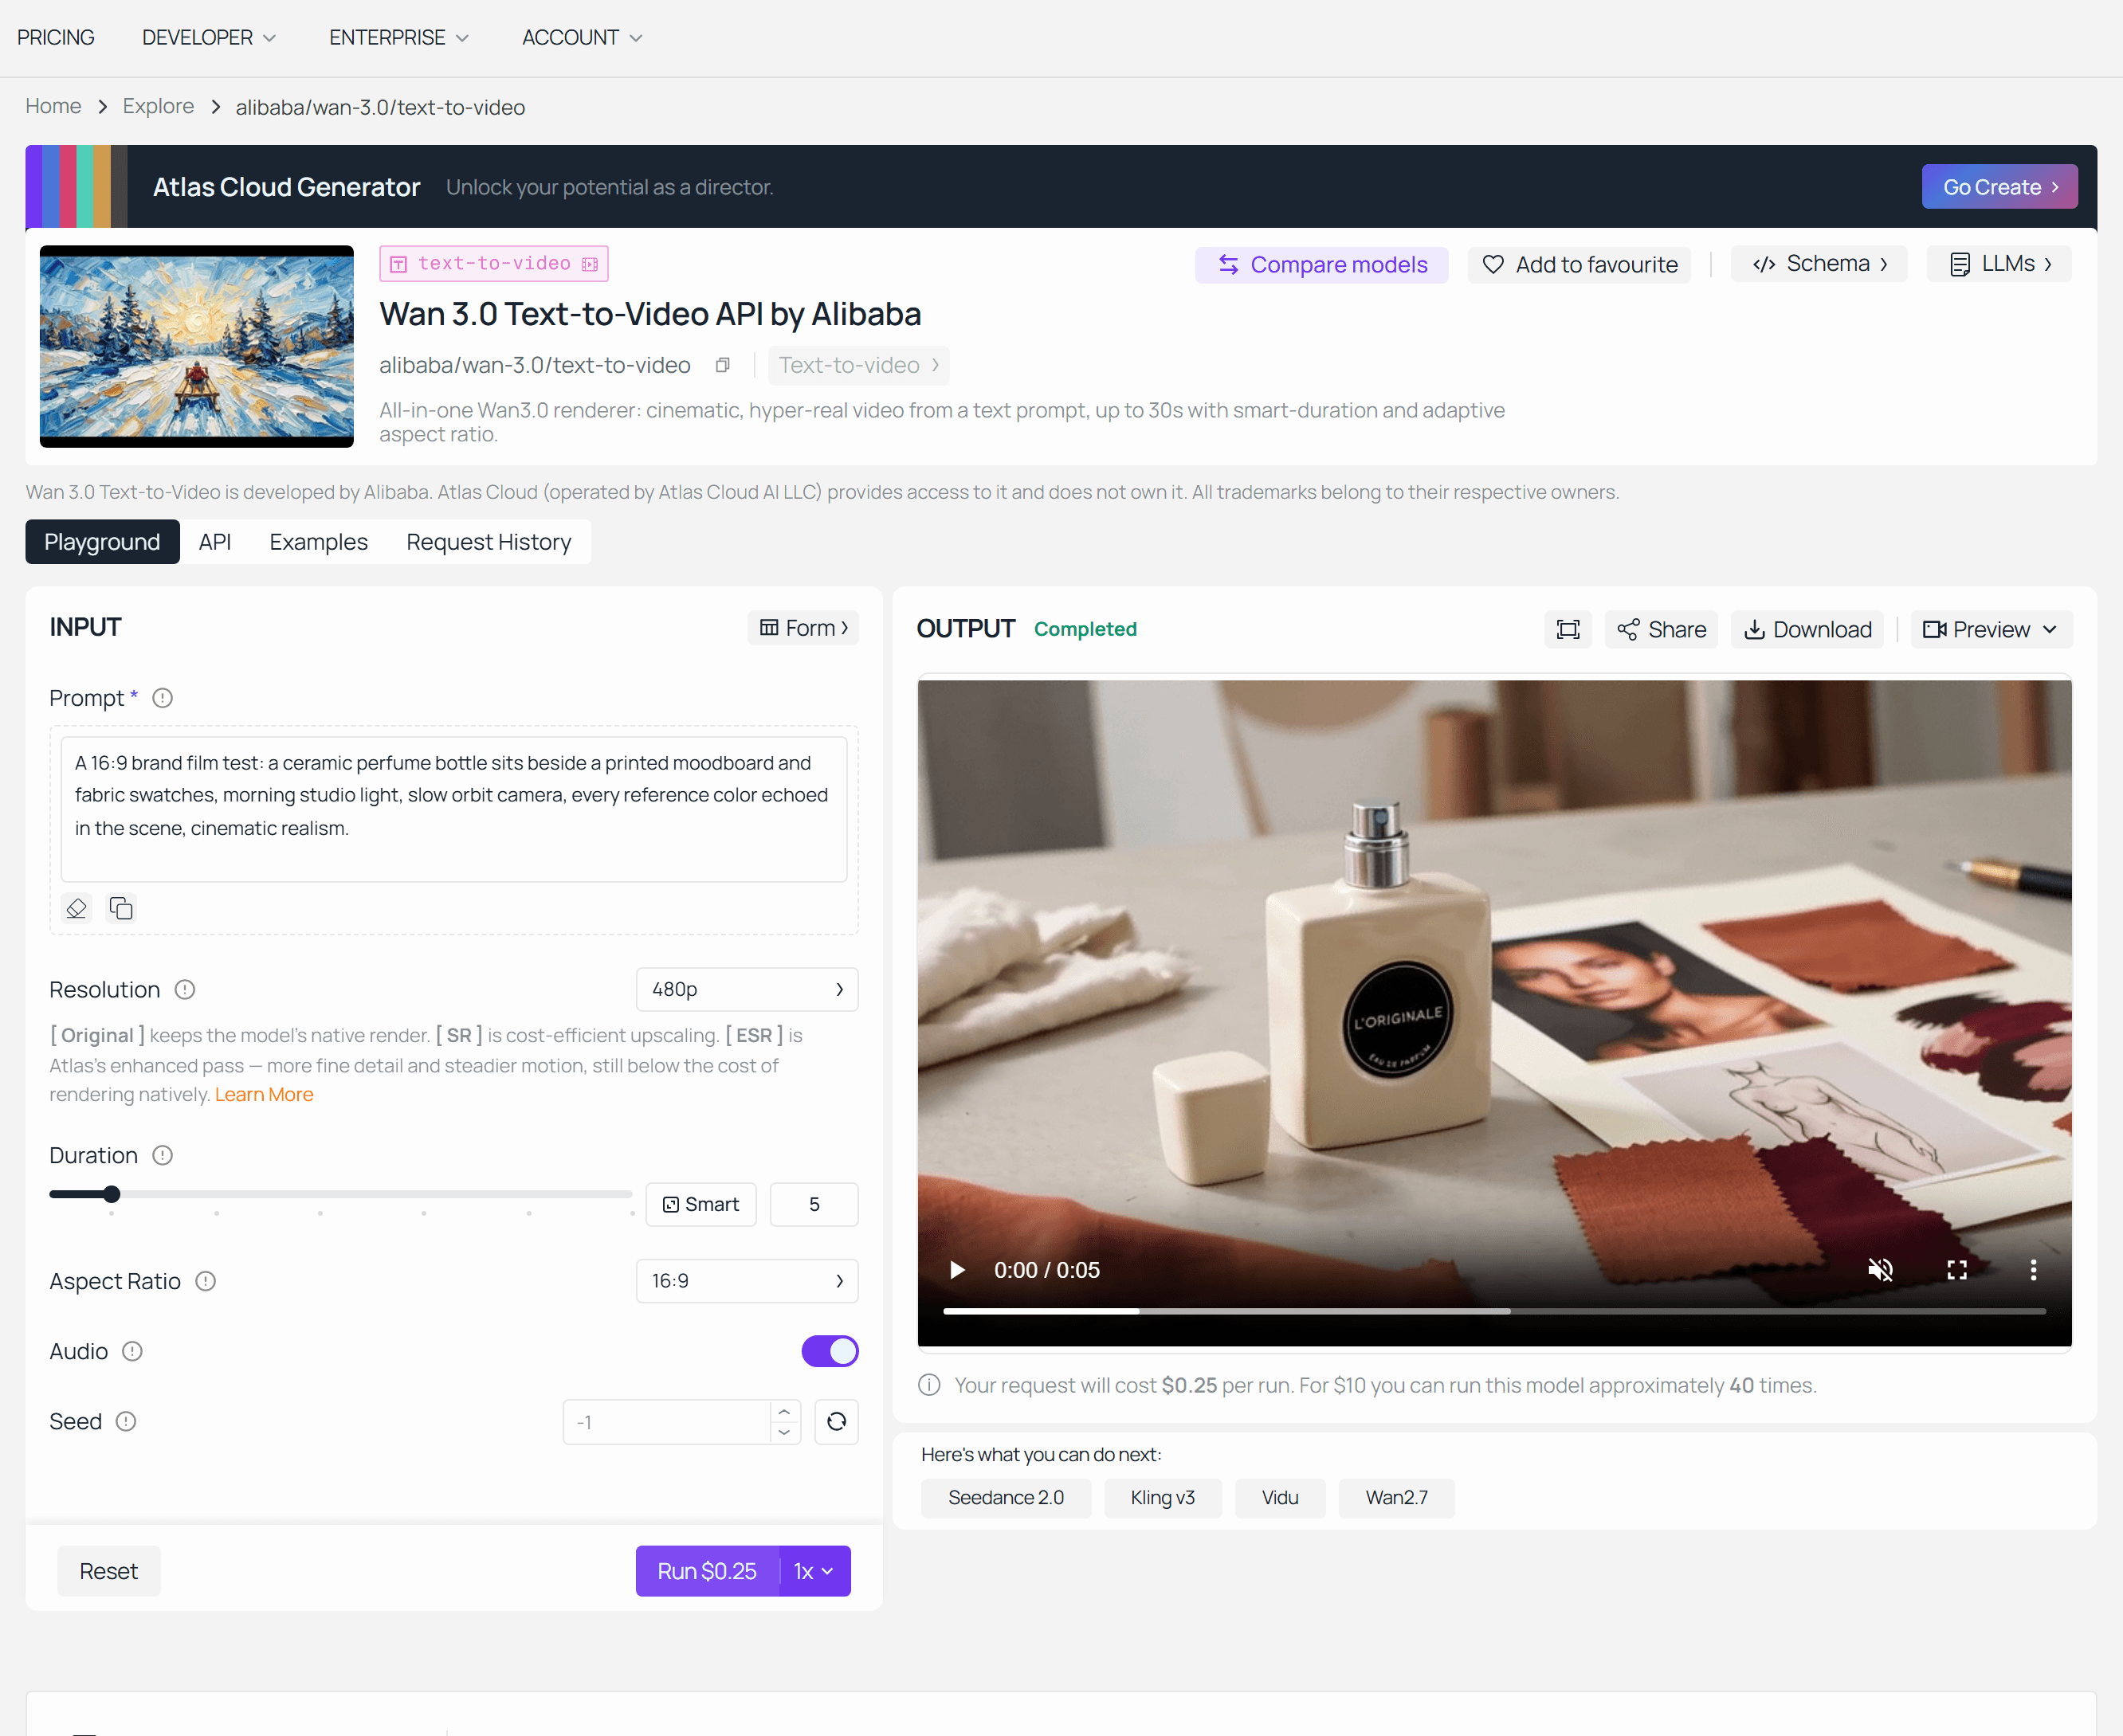
Wan 3.0 提示詞到結果截圖:20 個參考的品牌交接。
自己動手做:一個多模態參考場景,四個步驟
場景:一間粉彩飯店櫃檯。一個面無表情的門房。一個旅行者抱着一隻布偶貓。門房直視鏡頭說:「貓有預約。你沒有。」
兩張圖片加上一個聲音片段,這是橫跨兩種模態的三個參考素材。這是最小的、真正多模態(而不只是多圖像)的建置。
步驟 1. 生成參考圖片 1,要鎖定的主體
參考圖片只有三個工作,也只有三個:一個主體、面對鏡頭、乾淨背景。其他都是裝飾。使用 GPT Image 2,品質 high,尺寸 16:9,n=1。
Plain1Full-body studio portrait of a middle-aged hotel concierge with a deadpan expression, standing dead-centre against a flat dusty-pink wall. He wears a plum-purple double-breasted bellhop uniform with gold piping and brass buttons, a small round pillbox hat, and a thin moustache. Perfectly symmetrical framing, even soft frontal light, no cast shadow on the wall, 35mm film grain, muted pastel palette. One subject only, no other people, no text, no logo, no props in frame. 2
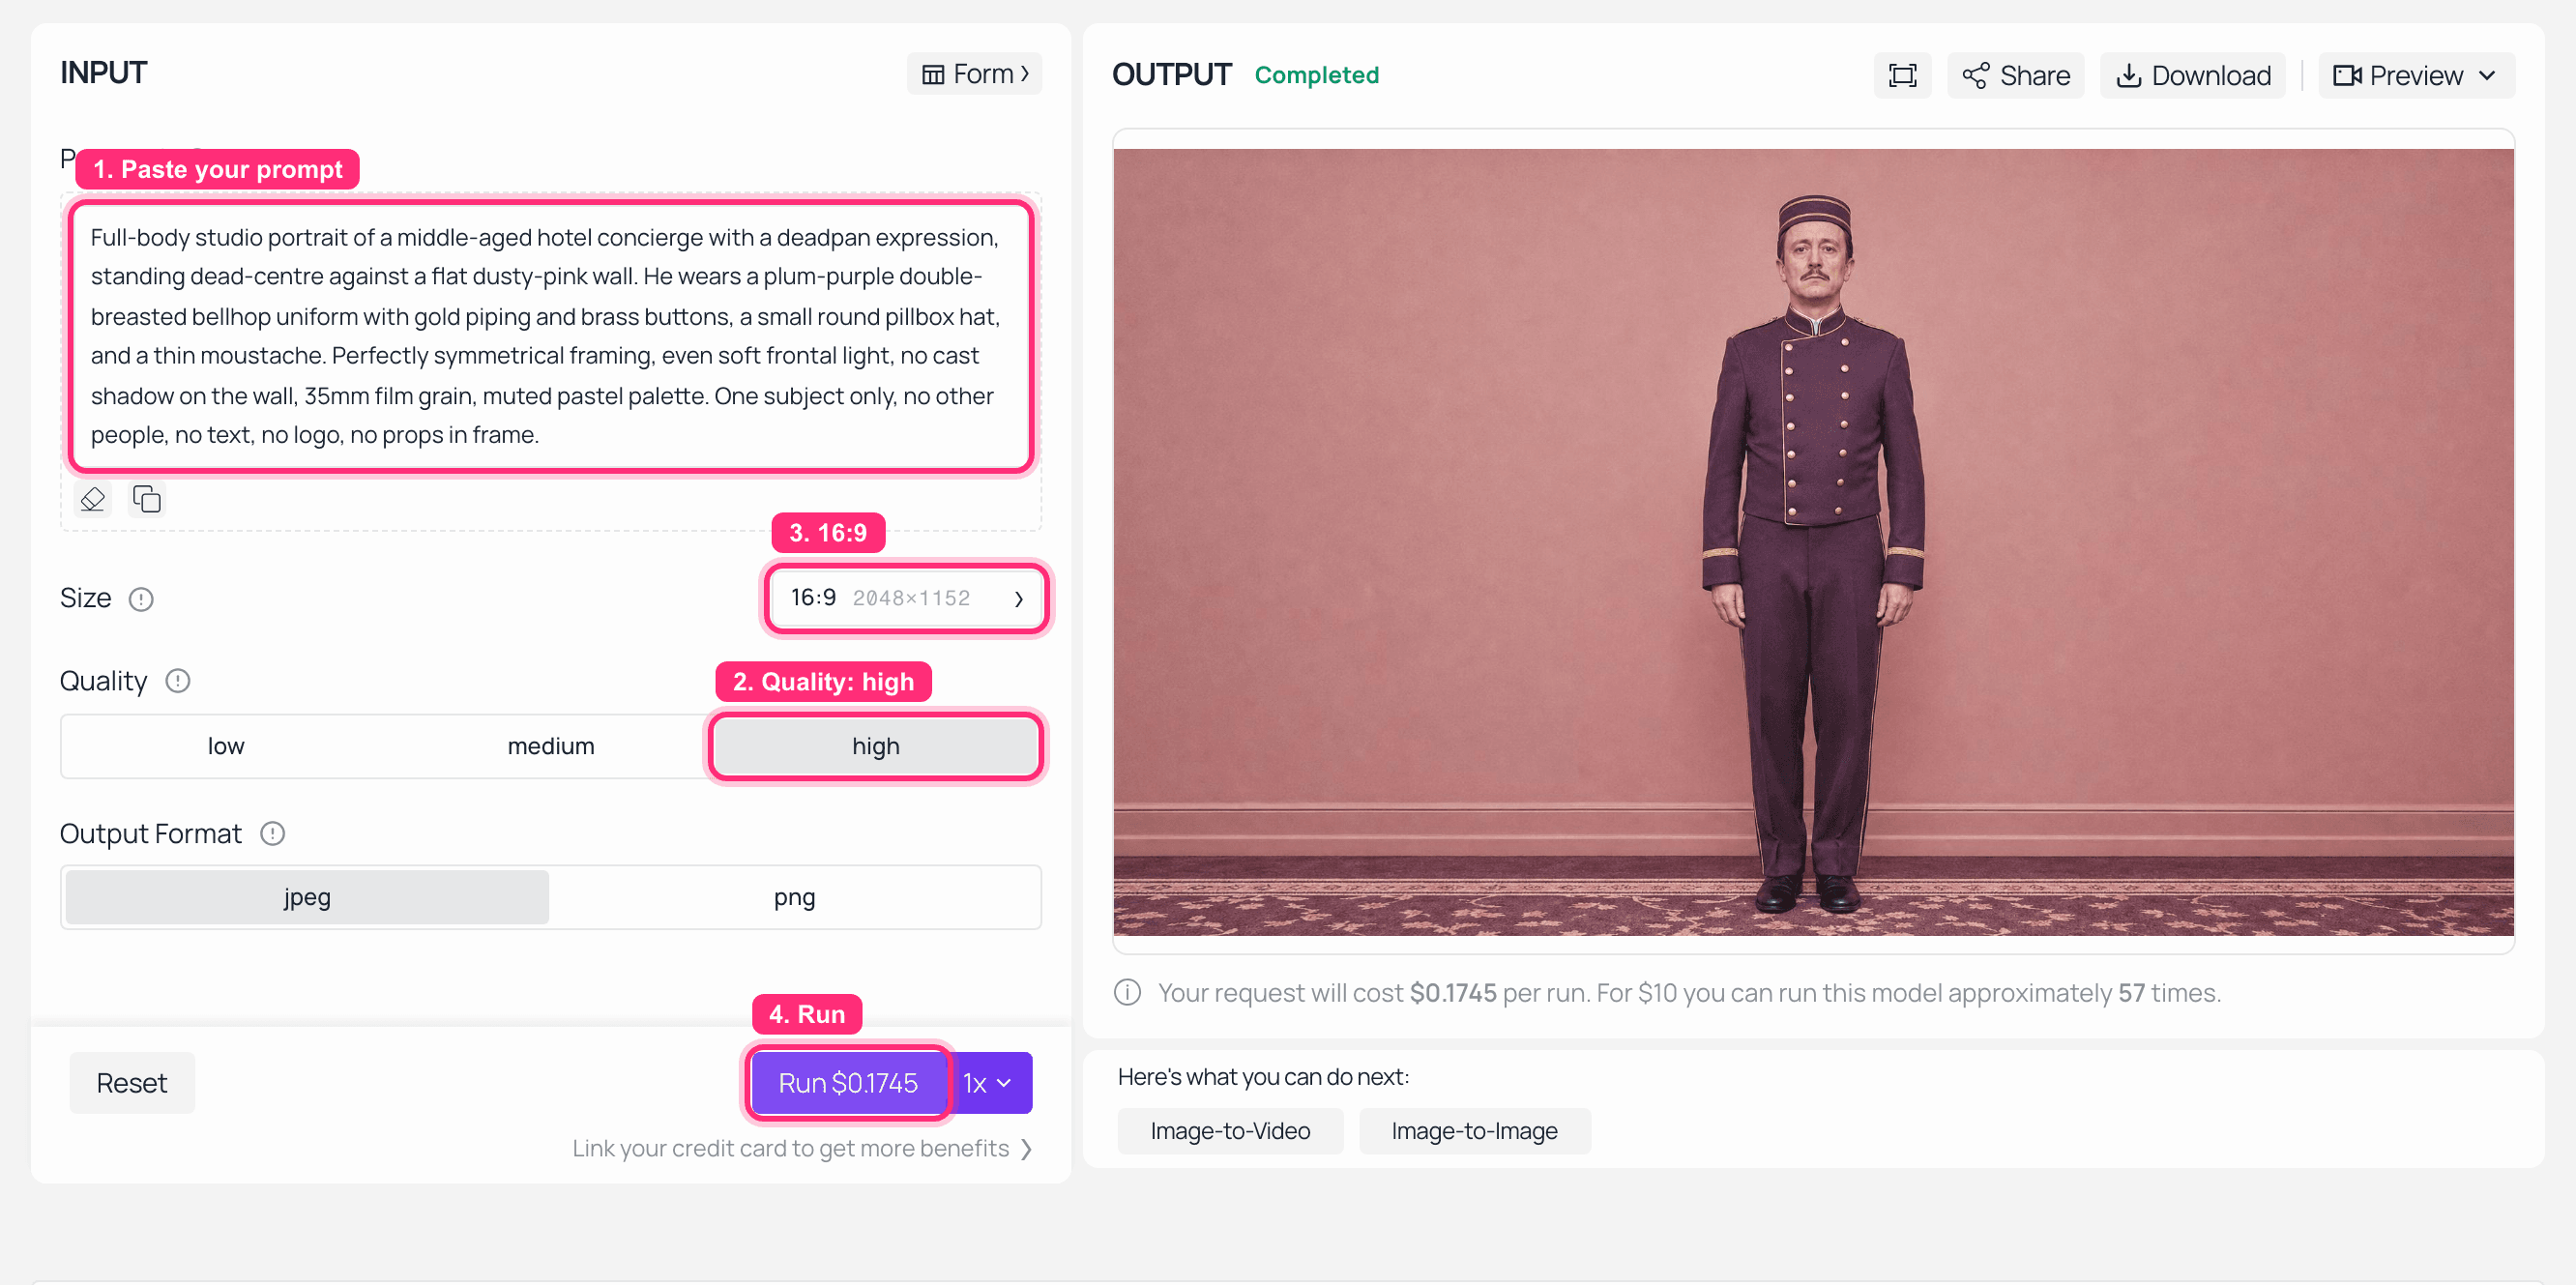
Atlas Cloud 上的 GPT Image 2 遊樂場,門房參考肖像在輸出面板中渲染。GPT Image 2 在 Atlas Cloud 上:品質高,16:9,一個主體,純色背景。這是成為 character1 的檔案。
步驟 2. 生成參考圖片 2,第二個鎖定的主體
相同模型,相同設定。兩個角色之間的顏色對比是刻意設計的,因為這讓模型在他們共享一個畫面時更容易區分他們。
Plain1Full-body studio portrait of a young woman traveller holding a fluffy ragdoll cat against her chest, standing dead-centre against a flat mustard-yellow wall. She wears a mustard wool coat, a red beret and round tortoiseshell glasses, and holds a small vintage leather suitcase in her free hand. Perfectly symmetrical framing, even soft frontal light, no cast shadow on the wall, 35mm film grain, muted pastel palette. One subject only, no other people, no text, no logo. 2
步驟 3. 生成聲音參考,這才是真正的多模態部分
聲音片段是將這從多圖像工作變成多模態工作的關鍵。Wan 2.7 的音訊位置需要一個短樣本,大約 1 到 10 秒,所以台詞要短。使用 MiniMax Speech 2.6 HD,選擇一個低沉、平坦、不帶情緒的男性聲音。
Plain1Good evening. Checking in? Of course. Everyone is. 2
步驟 4. 一次呼叫,三個參考,一個完成片段
現在整個包一起放入 Wan 2.7 參考轉影片。設定:resolution: 1080P,ratio: 16:9,duration: 10,這是該模型的上限,prompt_extend: false,seed: -1。按順序載入 images,先載入步驟 1 以對應到 character1,然後步驟 2 作為 character2,並將步驟 3 的檔案附加到 audio。
Plain1Symmetrical, dead-centre wide shot of a pastel hotel lobby front desk, dusty-pink walls and a mustard-yellow key rack behind it. character1 is the concierge standing behind the desk; character2 is the traveller standing in front of it, still holding her ragdoll cat. The camera pushes in slowly along a perfect centre axis and never tilts. character1 looks straight down the lens and says flatly: "The cat has a reservation. You do not." character2 blinks once, turns her head slowly towards the cat, then back to the desk. The cat stares directly into the camera without moving. 35mm film grain, even soft lighting, muted pastel palette, no camera shake, no cuts. 2
反向提示詞:
Plain1handheld shake, jump cuts, subtitles, on-screen text, watermark, extra people, deformed hands, face morphing, colour shift, motion blur 2
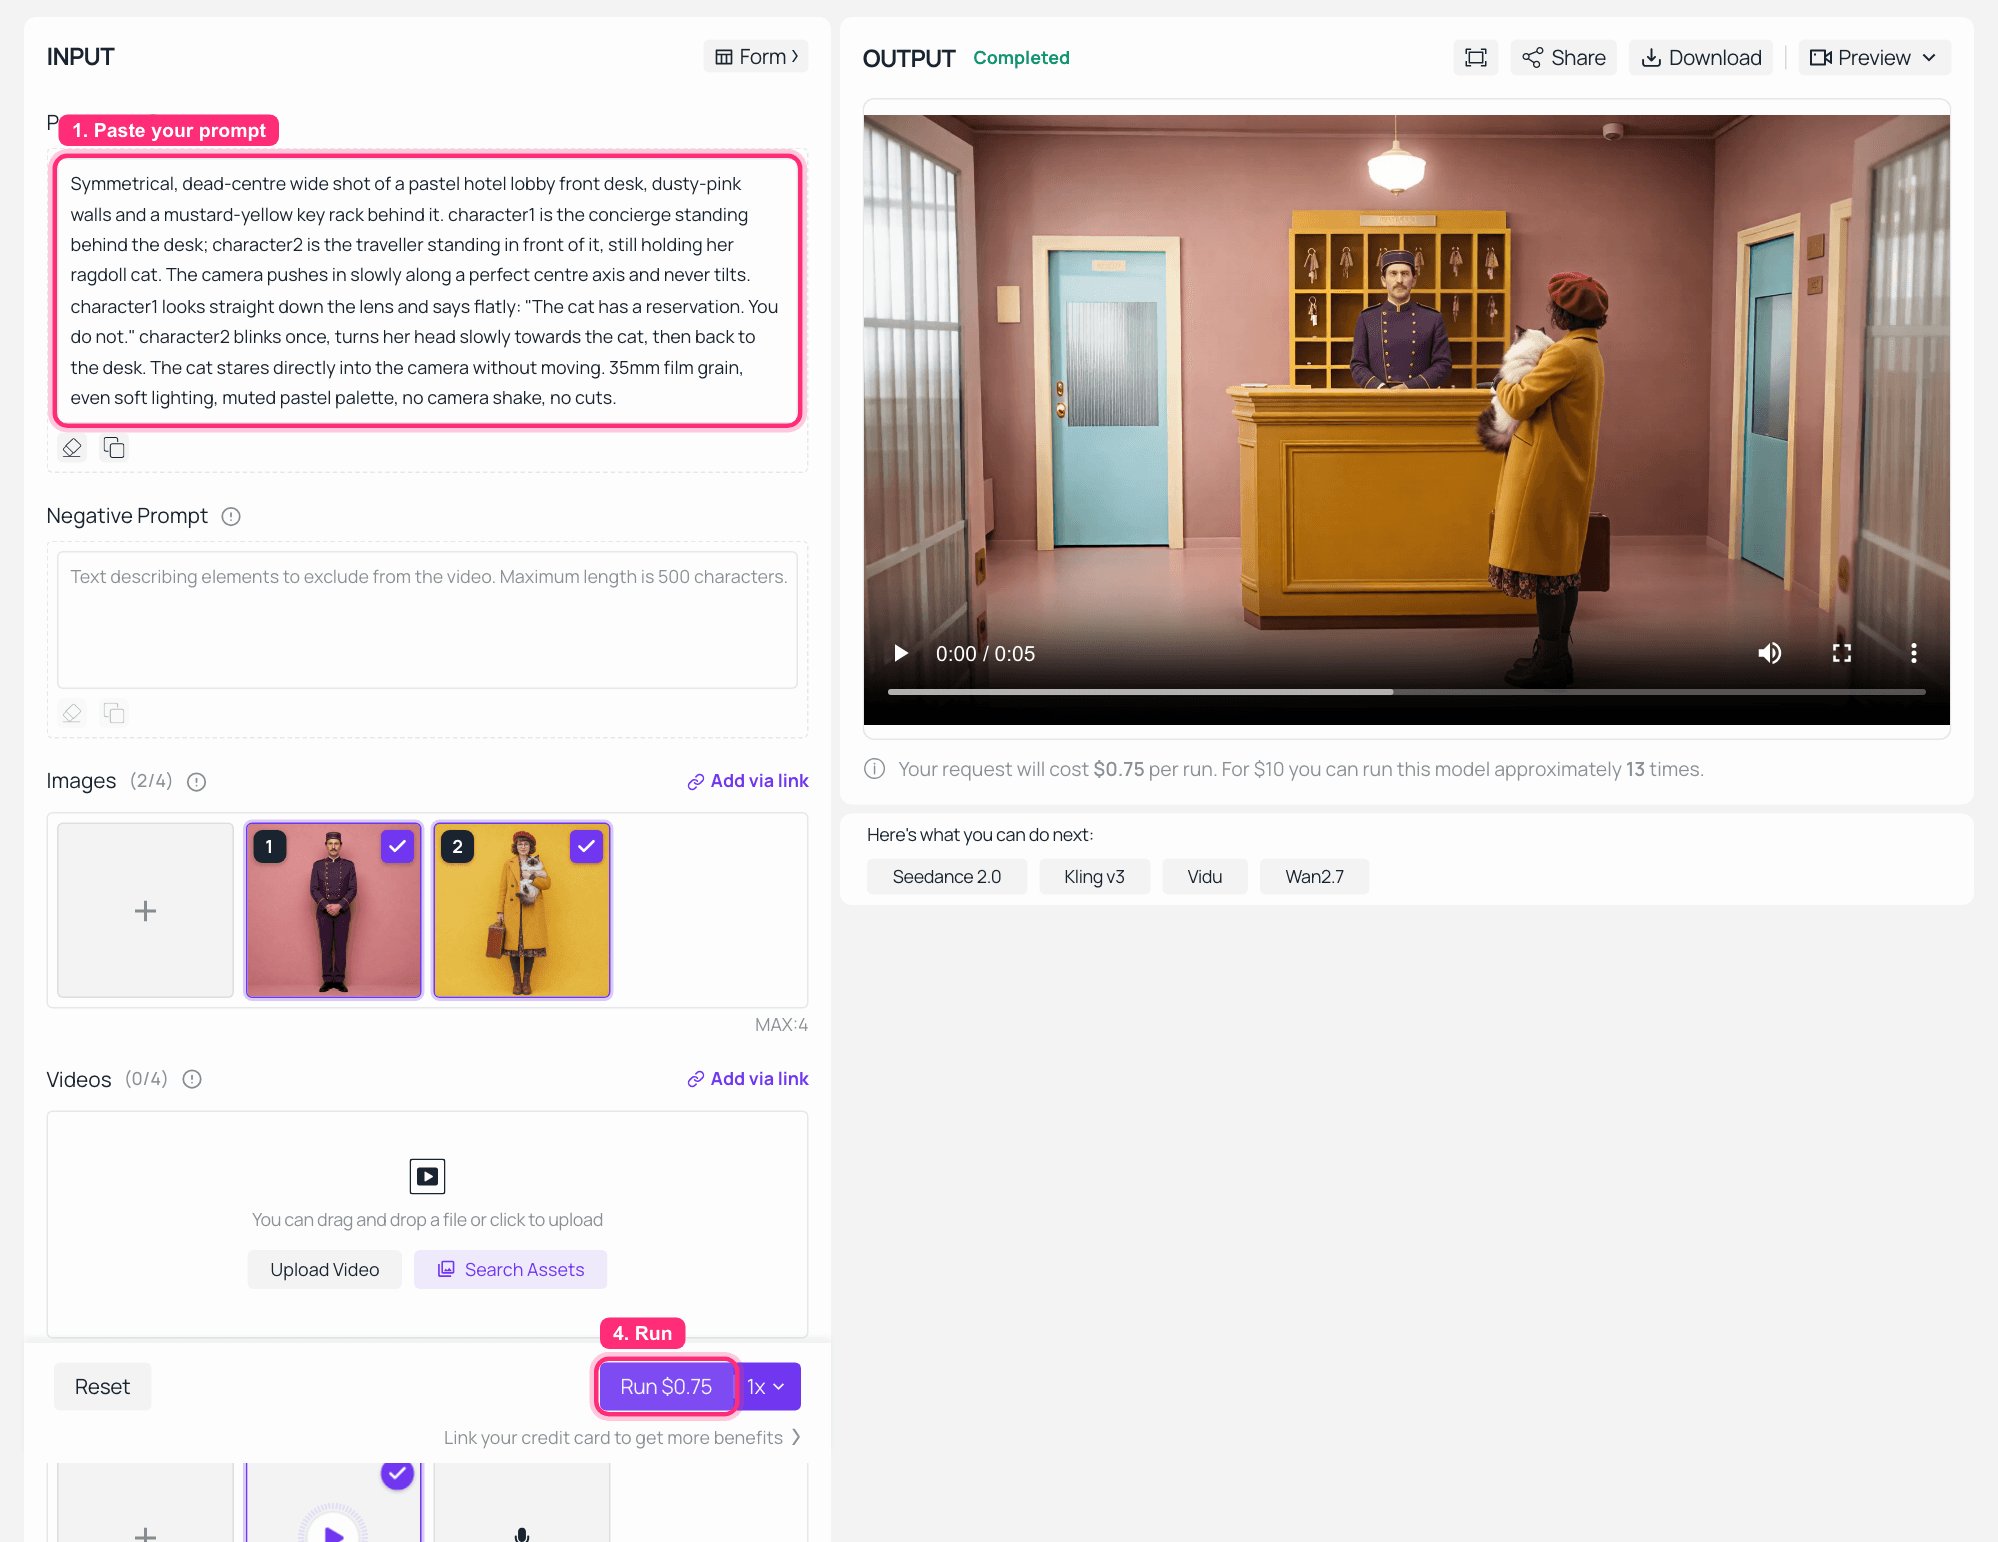
Atlas Cloud 上的 Wan 2.7 參考轉影片遊樂場,已載入兩張參考圖片和一個音訊檔案,輸出面板中顯示完成片段。Atlas Cloud 上的 Wan 2.7 參考轉影片:左側附上兩張參考圖片和一個聲音片段,右側在 1080P 和 16:9 下播放完成的鏡頭。此擷取以模型的預設持續時間執行;下方完整版本設定為 10。
完成的片段。兩張臉都保持,兩套服裝都保持,台詞以步驟 3 的複製聲音傳達,因此這個值得打開聲音觀看。
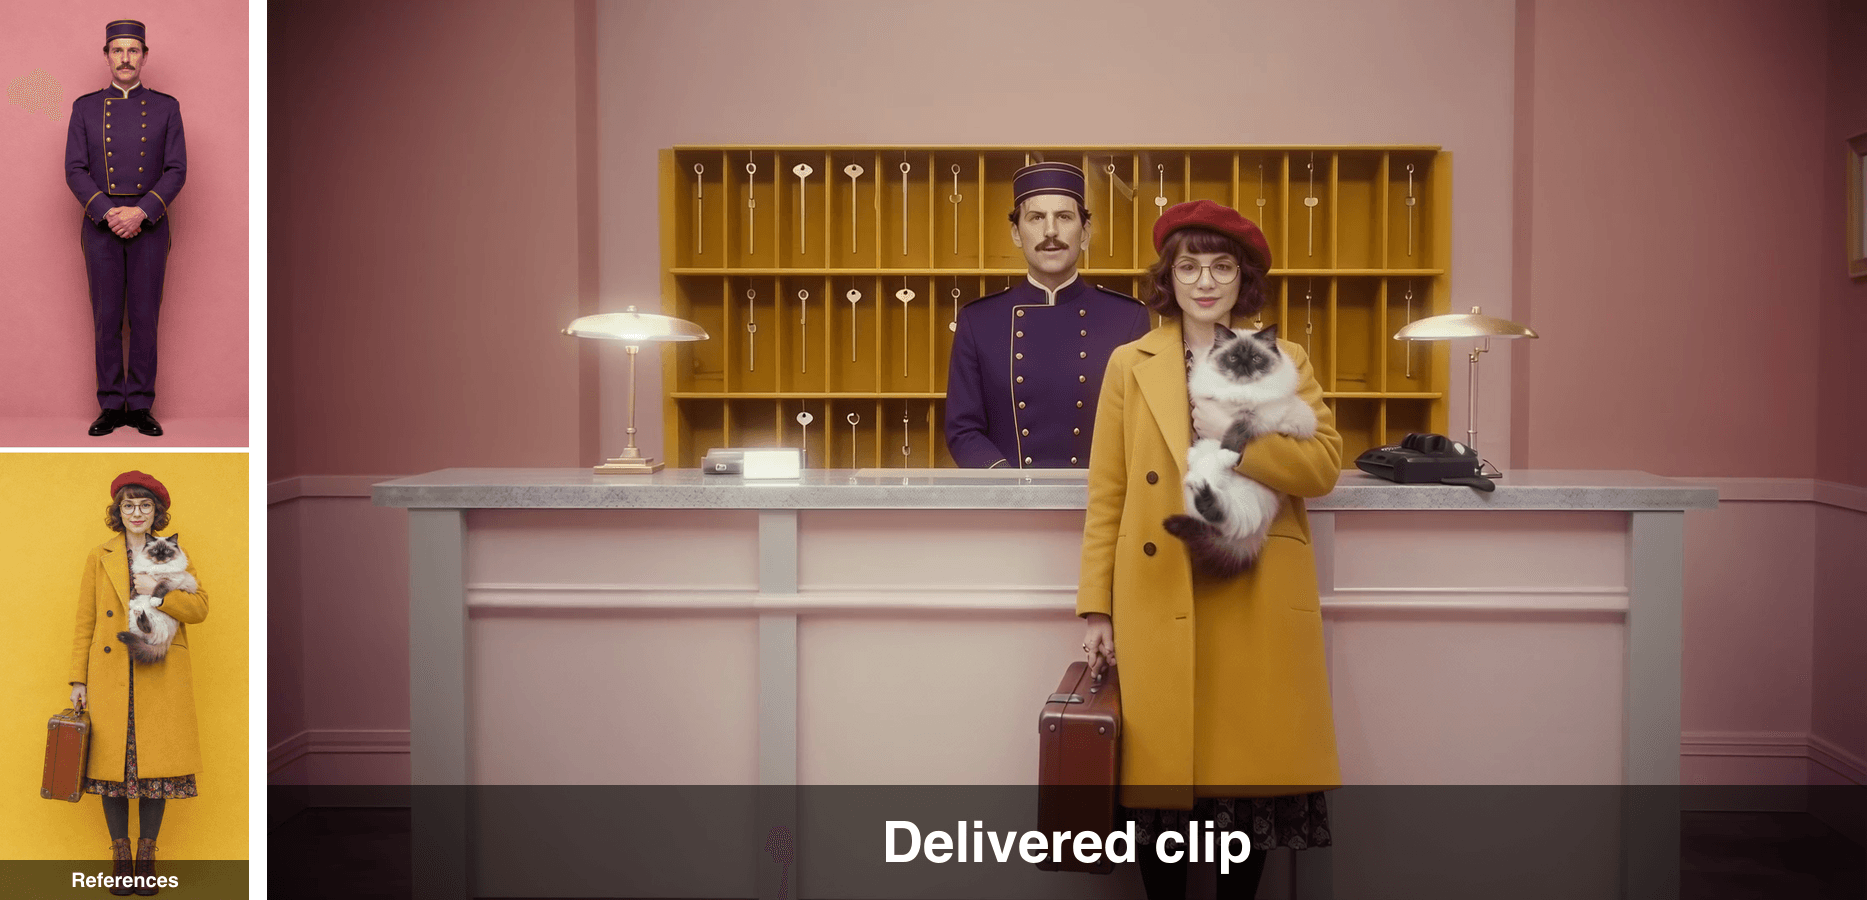
兩張參考肖像與完成片段中的一幀並列,顯示相同的臉孔和服裝。左側為參考,右側為交付片段中的一幀。制服滾邊、貝雷帽、眼鏡和貓都完好無損。
Wan 3.0 多模態參考工作流程的變體
推到 30 秒。 相同的參考包可在 Seedance 2.5 參考轉影片 上執行,設定 duration: 30,這讓你在無需等待測試版的情況下獲得 Wan 3.0 承諾的長度。它最多接受 30 張參考圖片、10 部影片和 10 個音訊片段,因此包有成長空間。將額外的 20 秒寫成提示詞中的節拍,而不是氛圍,否則模型會填充。
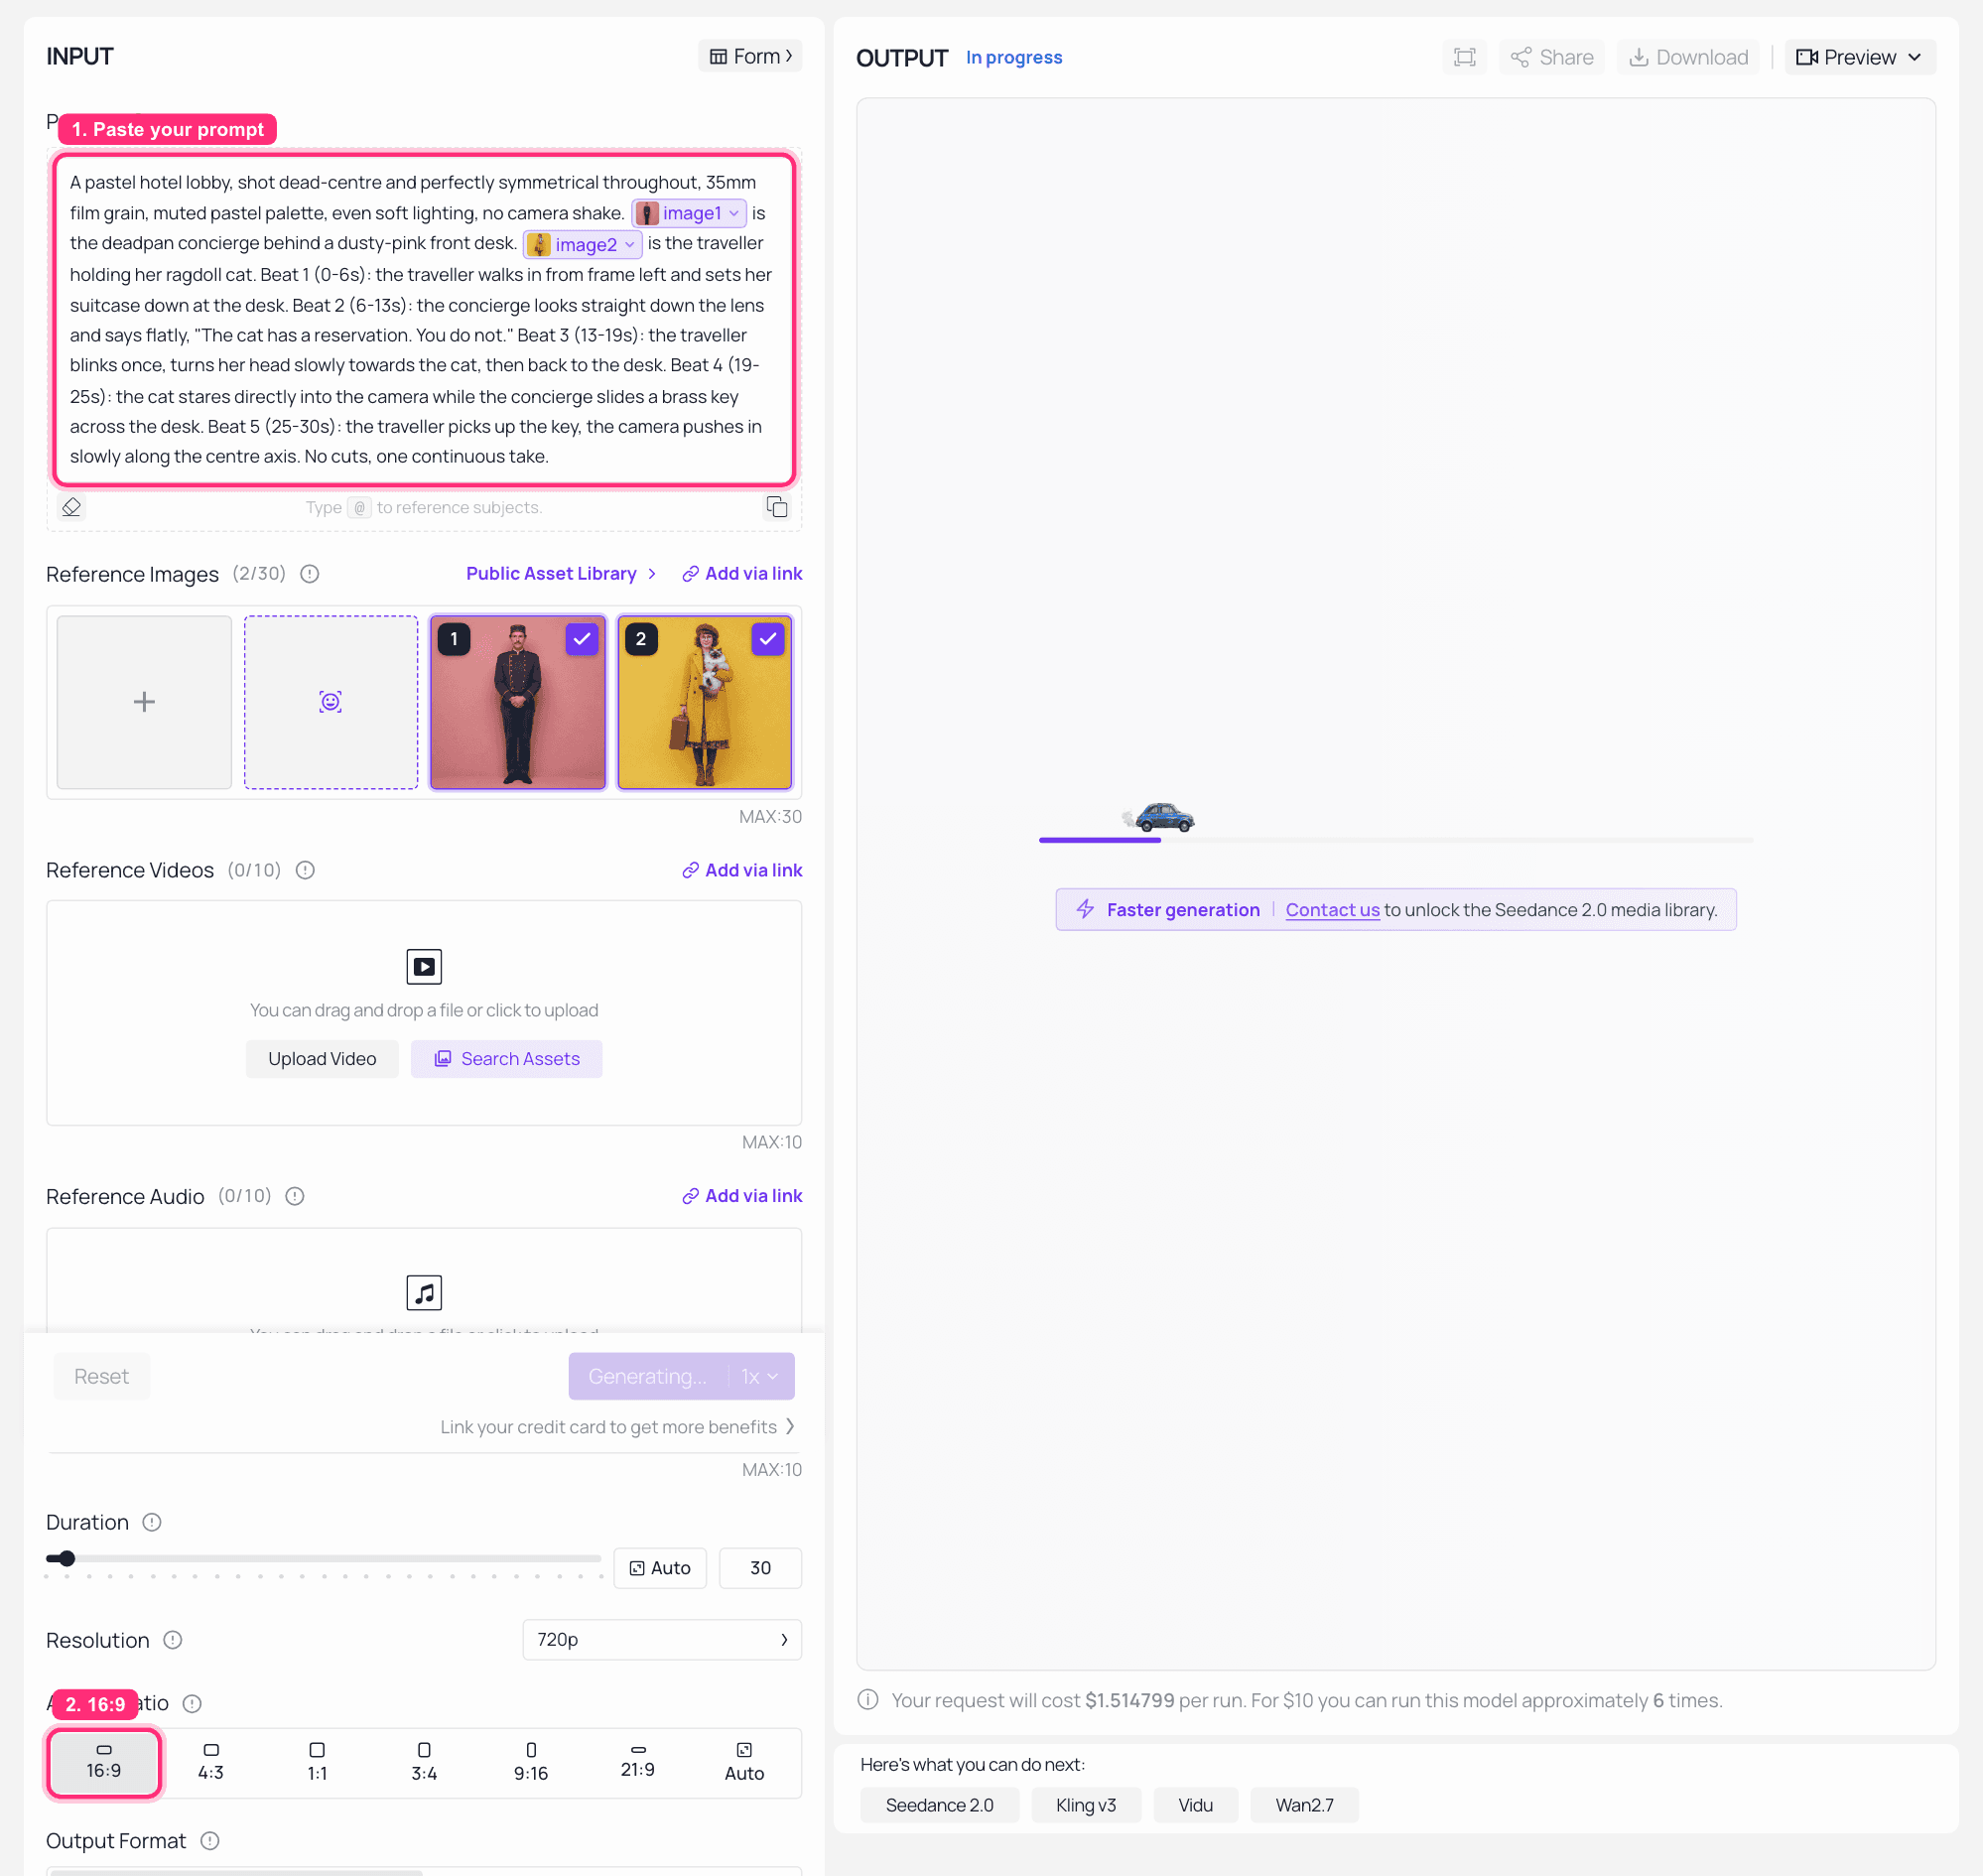
Atlas Cloud 上的 Seedance 2.5 參考轉影片遊樂場,持續時間設為 30,長鏡頭正在渲染。Atlas Cloud 上的 Seedance 2.5 參考轉影片,持續時間設為 30,附上相同的兩張參考肖像,在生成過程中捕捉。注意提示詞中的 @image1 和 @image2 標籤:這是告訴 Seedance 哪個參考扮演哪個部分的方式。在提交之前檢查「執行」按鈕上的報價,因為它會反映工作實際提交的持續時間。
相同場景的 30 秒版本,相同參考包,節拍逐鏡頭寫出。
僅為動作添加參考影片。 附加一個你喜歡其節奏的片段,並在提示詞中明確說明,例如「僅遵循參考影片的剪輯節奏,忽略其主體和場景」。這就是上面翻轉卡片範例背後的技巧。
在碰觸正向提示詞之前,先用反向提示詞修正偏移。 臉部變形、色彩偏移和手持晃動是毀掉參考鎖定鏡頭的三個因素,通常抑制它們比用描述解決它們更便宜。
免費試用多模態參考格式
如果你在調整參數之前想要先體驗這個格式,Atlas Cloud 上週推出了一個免費 AI 廣告短劇生成器,它執行相同的鏈條,但沒有任何旋鈕。
你只需寫一行關於你的產品及其賣點的文字。它會為你寫一個雙角色喜劇劇本,包括鉤子、衝突、轉折,然後渲染一個 15 秒的影片,內建口語對話和音效。你可以附加最多四張真實產品照片作為參考,廣告會從劇本到最終幀保持它們的形狀、顏色、標籤和標誌。它隨附六種風格,從搞笑迷因到劇情轉折、情境喜劇、奢華和硬銷售,對話會以你撰寫描述的語言返回。
這就是本教學中相同的雙角色加參考圖片加聲音鏈條,減去提示詞編寫和費用。這是一個很好的方式,讓你在花錢調整之前,先了解這個格式是否適合你的產品。
為了感受一堆參考靜態圖對產品影片的作用,以下是 Wan 3.0 自己執行這個工作的版本:五張圖片輸入,一個發布影片輸出,每張靜態圖錨定編輯中的一個節拍。
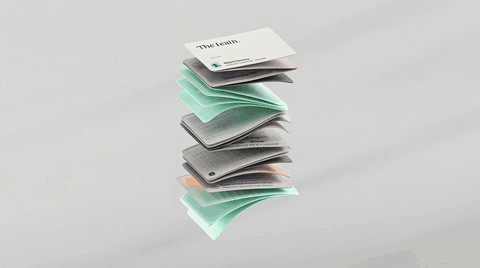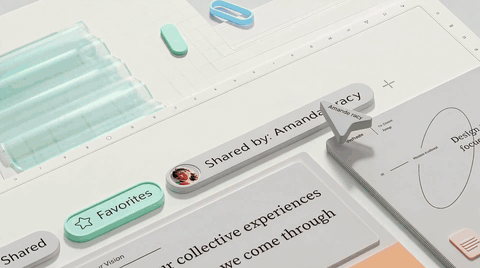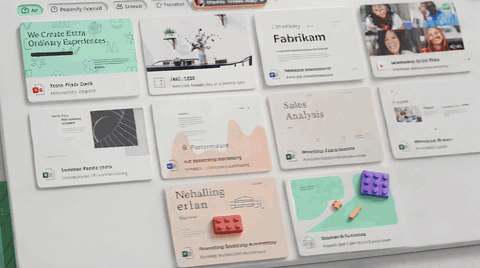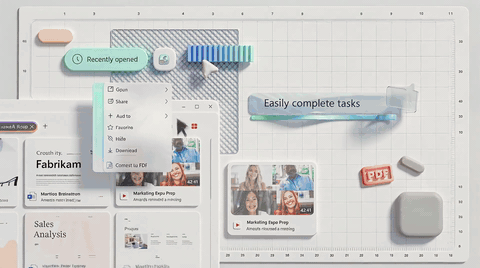
五張參考靜態圖擴展成 Material Design 風格的產品發布影片。五張參考圖片驅動一個九秒的產品影片,每張錨定一個節拍並傳遞給下一個。來源:阿里巴巴官方 Wan 3.0 創作者手冊。
Wan 3.0 多模態參考片段的花費
| 步驟 | 模型 | 單價 | 數量 | 成本 |
|---|---|---|---|---|
| 1 和 2,兩張參考圖片 | GPT Image 2 | 每張圖片 $0.009 | 2 | $0.02 |
| 3,聲音參考 | MiniMax Speech 2.6 HD | 每 1000 字元 $0.08 | 49 字元 | $0.00 |
| 4,10 秒 1080P 鏡頭 | Wan 2.7 參考轉影片 | 1080P 每秒 $0.15 | 10 秒 | $1.50 |
| 教學總計 | 約 $1.52 | |||
| 變體,30 秒 | Seedance 2.5 參考轉影片 | 480P 每秒 $0.134 | 30 秒 | 約 $4.02 |
| 免費路線 | 免費 AI 廣告短劇生成器 | 免費 | 1 個片段,15 秒 | $0 |
這些是平台自身的費率,於 2026 年 8 月確認,按用量付費。有兩件事對總成本的影響超出人們預期。解析度是第一件:比較表中的每秒 $0.10 是 Wan 2.7 的基礎費率,而 1080P 收費為 $0.15,這就是上面 $1.50 的來源。第二件是 Seedance 按像素計費,因此其列出的每秒 $0.134 是 480P 的數字,而 720P 鏡頭的成本高於簡單乘法所暗示的。作為參考,報導的 Wan 3.0 測試版費率為 1080p 每秒 $0.20,這會將完整的 30 秒鏡頭定在約 $6,比目前 480P 的 Seedance 路線更貴。
關於使用這些東西的注意事項。 Wan 3.0 是測試版,其條款可能會變動,因此在建立依賴它的工作流程前請重新閱讀條款。如果你的參考圖片是真人,請先獲得他們的許可,因為參考轉影片正是讓這點變得重要的功能。本文中的範例片段是阿里巴巴從其公開創作者手冊中自行生成的結果,此處轉載用於評論。
常見問題
Wan 3.0 的多模態參考實際上可以接受多少個參考?
單次呼叫最多 20 個素材,來自圖片、影片、音訊、文件和網頁。實際限制低於技術限制。將每個素材精確分配一項工作,每張圖片一個主體,大多數場景你使用的素材會遠少於 20 個。
Wan 3.0 真的能將 PDF 或網頁轉換成影片嗎?
是的,這是真正獨特的部分。除了文字、圖片、音訊和影片之外,它還接受文件檔案和即時網址,關於測試版的報導列出 .doc、.xls、.ppt、.pdf 和 .txt。上面比較表中的其他參考轉影片模型,沒有一個能接受文件。
Wan 3.0 是開源的嗎?我可以在 ComfyUI 中執行它嗎?
不能,目前不行。Wan 3.0 是運行在阿里巴巴自家雲端上的封閉測試版。較早的 Wan 世代是開源發布的,因此存在這種期望,但阿里巴巴尚未確認 3.0 的權重。聲稱 Wan 3.0 有 1.3B 或 14B Apache 2.0 發布的頁面,沒有任何官方依據。
Wan 3.0 是否已可透過第三方 API 使用?
還沒有,包括 Atlas Cloud 在內。你今天可以呼叫的最接近的是 Wan 2.7 參考轉影片,其輸入形狀除了文件和網頁模態外,幾乎與全參考完全相同;或者如果你需要完整的 30 秒,可以使用 Seedance 2.5 參考轉影片。
測試參考鎖定、雙角色影片的最便宜方法是什麼?
上面連結的免費 AI 廣告短劇生成器。放入四張參考照片,輸出一個 15 秒的雙角色口語片段,無需參數,無需花費。如果它能保持你的產品和格式,那麼再去調整付費鏈條。
即使有參考圖片,為什麼我的角色仍然偏移?
三個原因,按頻率排序。一個參考承擔了兩項工作,因此被要求同時固定臉和地點。參考圖片包含多於一個人或複雜背景,因此模型不知道要鎖定哪個部分。或者偏移是渲染人工製品而不是參考失敗,在這種情況下,在改寫任何內容之前,先將 face morphing, colour shift 放入反向提示詞中。


