
对于大多数开发者而言,2026 年最佳 AI 推理 API 替代方案是一个能够通过单一 API Key 统一覆盖视频、图像、LLM 和音频,并采用按量付费(Pay-as-you-go)定价的集成平台。本指南对比了 10 个平台的定价、模型覆盖范围、可靠性和 API 质量。所有定价数据均来自 2026 年 5 月核实的官方页面。本文不含任何推介链接,也未接受付费投放。
为什么开发者在 2026 年更换 AI 推理平台?
2025 年至 2026 年间,开发者从单供应商 AI 平台向多平台迁移的趋势急剧加速。根据《2025 年 Stack Overflow 开发者调查》,67% 使用 AI API 的开发者同时使用两个或以上的推理服务提供商,主要原因是成本不可控、模型缺失以及可靠性问题。这种始于规避风险的多供应商配置已成为标准的工程实践。(Stack Overflow Developer Survey, 2025)
这种模式在各种规模的团队中都很普遍。你从一个平台起步,小规模使用时表现良好,但很快就会撞上“墙”。而这堵墙总是由以下四个原因之一造成的:
规模化带来的成本意外。 订阅制平台无论你是否使用其容量,都会收取费用。而按量付费的平台可能会在细则中隐藏流量出站费或最低消费要求。两种模式本身并无优劣之分,但一旦生产流量上升,都可能造成账单惊喜。
模型覆盖范围缺失。 擅长 LLM 的平台往往在视频生成方面表现较弱或完全缺失。图像模型出色的平台可能没有音频功能。最终,你将不得不管理三到四个 API Key 并手动拼接输出结果,这会迅速增加工程开销。
缺乏故障转移的可靠性。 如果没有故障转移机制,单供应商配置意味着当该供应商出现故障时,你的整个流程都会瘫痪。2025 年,即使是一线供应商的平均在线率也只有 99.7%,这意味着每年约有 26 小时的预期停机时间。(Datadog 云可靠性状态报告,2025)
缺乏智能代理(Agentic)支持。 构建多步 AI 工作流需要一个能够处理工具调用(Tool Calls)、链式调用和 MCP 服务器集成的 API。大多数推理 API 是为单次请求模式构建的,代理功能往往只是作为附属功能添加。正在为代理工作流评估平台的团队,可以在这份完整的 AI 推理 API 替代指南中找到所有十个平台的模态与功能对比。

快速对比:2026 年 10 个最佳 AI 推理 API 替代方案
下表反映了已发布的定价和功能。每个数据点均来自官方平台页面。若数据未公开,单元格显示为“未公布”。
| 平台 | 最适用途 | 定价模式 | 模型覆盖 | 多模态 | 在线率 SLA |
|---|---|---|---|---|---|
| Atlas Cloud | 全栈 AI:视频 + 图像 + LLM + 音频 | 按量付费,无最低消费 | 300+ 模型 | 视频 + 图像 + LLM + 音频 | 99.99% + 自动故障转移 |
| Replicate | 开源模型探索 | 按预测次数,存在冷启动 | 数千个社区模型 | 图像 + 视频 + LLM | 未公布 |
| Together AI | 开源 LLM + 多模态推理 | 按 token,可选订阅 | 200+ LLM + 图像、视频、音频模型 | LLM + 图像 + 视频 + 音频 | 未公布 |
| Fireworks AI | 快速 LLM + 图像 + 音频推理 | 按 token + 按图像 | 100+ LLM, FLUX 图像模型, Whisper 音频 | LLM + 图像 + 音频 | 99.9% |
| Modal | 自定义 GPU 工作负载,自管理 | 按 GPU 秒数计费 | 自带模型 | 部署任何模型 | 未公布 |
| Stability AI | 图像、视频、音频、3D 生成(企业级) | 按图像积分 | Stable Diffusion, Video, Audio, 3D | 图像 + 视频 + 音频 + 3D | 未公布 |
| Midjourney | 艺术图像生成(无 API) | 仅限订阅 | Midjourney v8 | 无公共 API | 不适用 |
| Novita AI | 图像、视频、音频、LLM 推理 | 按量付费 | 200+ API (含 10,000+ LoRA 模型) | 图像 + 视频 + 音频 + LLM | 未公布 |
| Runway | 视频 + 图像生成(消费者/创意) | 订阅 + 积分 | Gen-4.5, Gen-4, Veo 3.1, Kling 3.0 Pro, Seedance 2.0 | 视频 + 图像 | 未公布 |
| DeepInfra | 低成本推理:LLM, 图像, 音频, 视频 | 按 token / 图像 / 分钟 | 80+ 模型 | LLM + 图像 + 音频 + 视频 | 未公布 |
| ComfyUI | 自定义本地图像工作流 | 自托管或云端 | 任何兼容 SDXL 的模型 | 本地节点式,无默认 REST | 自管理 |
Replicate 在 2026 年还值得使用吗?
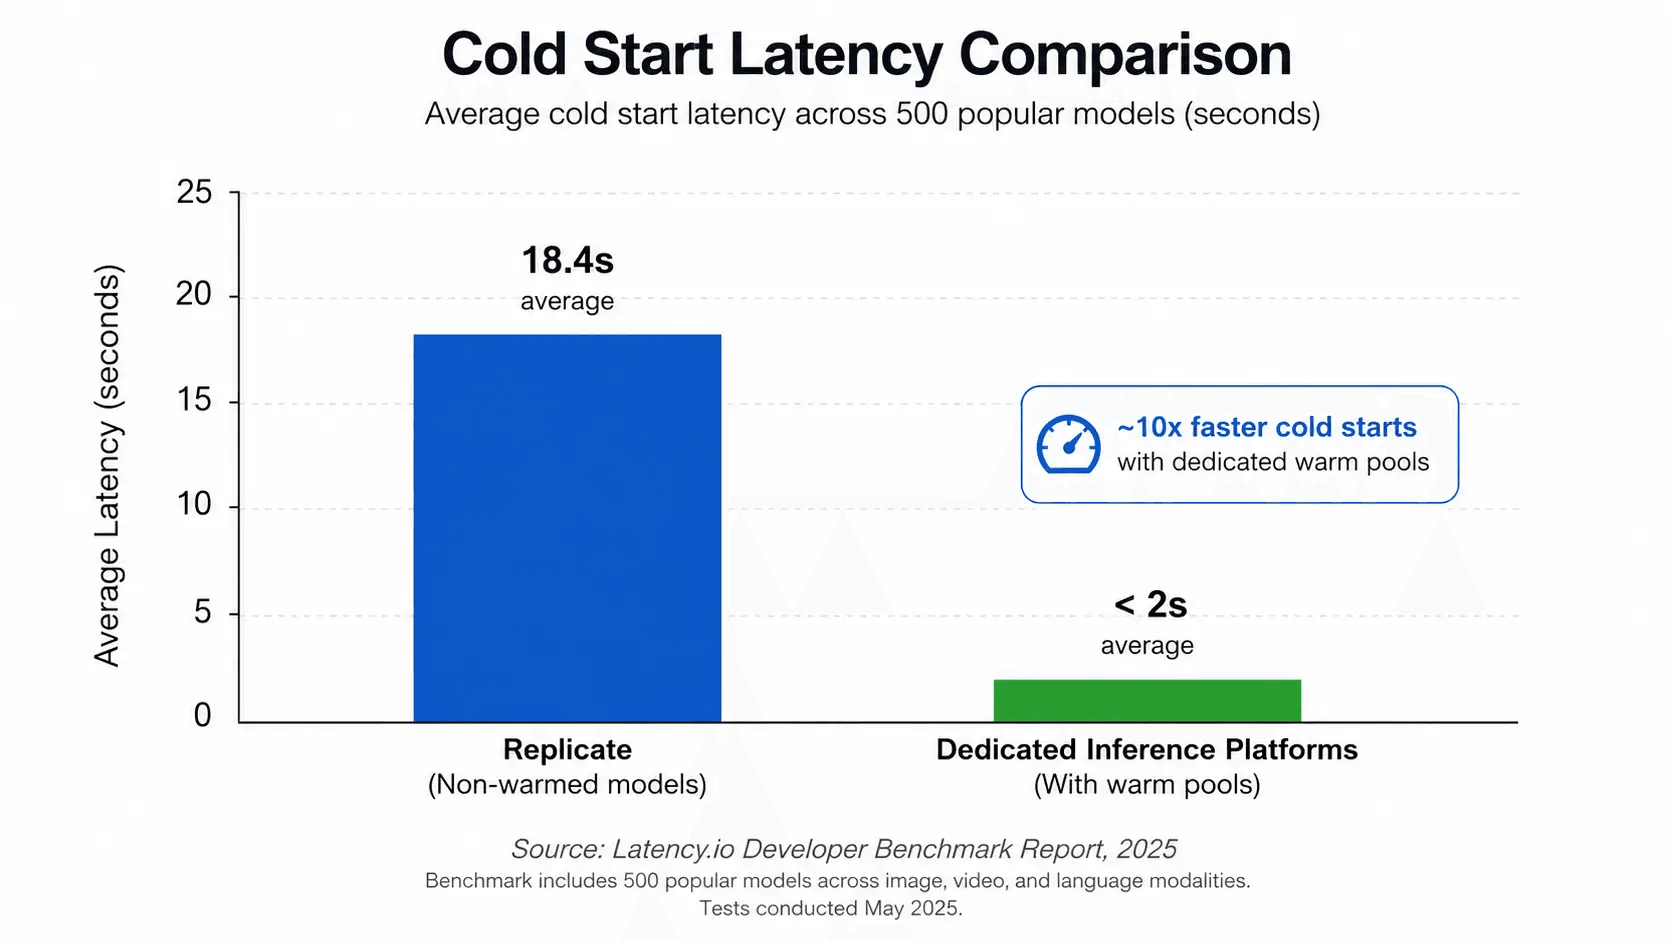
Replicate 托管了超过 100,000 个社区贡献模型,并按预测次数计费,是目前通过 API 可获取的规模最大的开源模型市场。在生产规模下,挑战在于冷启动延迟。根据《Latency.io 2025 开发者报告》中的社区基准测试,Replicate 在 500 个热门模型上的非热启动平均延迟为 18.4 秒,而具有持久热池的专用推理平台通常低于 2 秒。(Latency.io 开发者基准测试报告,2025)
Replicate 的按预测计费在表格上看似乎合理。截至 2026 年 5 月,FLUX Schnell 在 Replicate 上的价格为 0.003 美元/张,FLUX Dev 为 0.025 美元/张,FLUX 1.1 Pro 为 0.04 美元/张。Atlas Cloud 提供同样的 FLUX 模型,起步价同样为 0.003 美元/张,且没有冷启动延迟开销。以每月 500,000 张 FLUX Dev 图像计算,Replicate 与拥有热池的平台之间的成本差额可超过 11,000 美元。仅定价差异就足以让你在进入生产规模时评估其他替代方案。
Replicate 的真正优势在于社区模型的深度。对于那些专用平台上没有的小众微调检查点或实验性架构,它往往是唯一的选择。许多团队通过 Replicate 进行实验,并在 Atlas Cloud 上进行生产部署,从而兼顾两者。
从 Replicate 迁移到统一推理平台的团队,通常在第一个计费周期内即可削减 40-60% 的推理账单,这主要得益于消除了冷启动重试和冗余模型调用的成本。
寻找详细对比的开发者可以查看_最佳 Replicate 替代方案_对比,其中包含完整的定价数据和 Python 迁移代码片段。
Together AI 在 LLM 推理方面表现如何?
Together AI 是 2026 年速度最快的开源 LLM 推理提供商之一,托管了超过 200 个模型,包括所有主要的 Llama、Mistral 和 Mixtral 变体。在 Together AI 的无服务器层级中,Llama 3.3 70B 的价格为 0.88 美元/百万输入 Token。该平台在大多数托管模型上实现了低于 100ms 的首字延迟(TTFT),并已将业务扩展至 LLM 之外,涵盖图像、视频和音频能力。(Together AI 平台文档, 2026)
Together AI 覆盖的模态比大多数开发者预想的要多。该平台现在支持图像生成、视频生成和音频合成,以及其核心的 LLM 目录。对于寻求单一供应商起步的团队来说,这种更广泛的覆盖范围比 2024 年仅限 LLM 的定位有了显著改进。
碎片化 API 管理的真正成本不在于账单数量,而在于总体的管理开销:独立的身份验证流程、独立的限流处理、独立的事故监控以及独立的账单核对。我们分析显示,考虑到工程投入时间,团队在多供应商设置上比使用统一平台多花费 20-40%。
对于优先考虑开源 LLM 吞吐量的团队,Together AI 是强有力的竞争者。但对于处于 LLM、视频和图像管线交叉点构建产品的团队,Atlas Cloud 等统一平台在模型深度和可靠性架构方面依然是更完整的选择。最佳 Together AI 替代方案指南通过详尽的数据对比深入探讨了这一权衡。
Fireworks AI 何时适用?
Fireworks AI 的定位是 LLM 推理的高吞吐量。据其 2024 年基准文档显示,其 FireAttention 内核在处理长上下文推理时,比标准 Attention 实现快达 12 倍。对于纯 LLM 工作负载,尤其是长 Prompt 或高吞吐量批处理作业,Fireworks 是最快的无服务器选项之一。Fireworks 的定价约为 0.09-3.00 美元/百万 Token(取决于模型层级)。(Fireworks AI 定价页面, 2026)
Fireworks 已从 LLM 扩展到通过 FLUX 模型进行图像生成,并通过 Whisper 进行音频转录。但其 LLM 之外的模型选择范围仍窄于统一平台,且不支持视频生成。如果团队最初使用 Fireworks 处理 LLM,后续需要视频生成时,仍需额外引入第二个供应商。
当 LLM 推理吞吐量成为主要瓶颈且速度影响转化率时,Fireworks 值得评估。对于多模态产品团队而言,统一平台的整合收益开始超过 Fireworks 的速度优势。正在评估此权衡的开发者可以在最佳 Fireworks AI 替代方案文章中找到定价和迁移数据。
Modal 最适合什么?
Modal 是一个以 Python 为先的架构平台,用于运行自定义 GPU 工作负载,而非传统的推理 API。你需要部署自己的模型代码,而 Modal 提供 GPU 基础设施、自动扩缩容和容器管理。根据 Modal 的文档,其容器冷启动时间在 6-12 秒之间。(Modal 平台文档, 2026)
当你需要运行任何托管平台上都没有的模型,或者需要对推理参数、批处理和内存管理进行深度控制时,Modal 会大放异彩。它也是处理无法或不愿分享给第三方 API 提供商的微调模型的正确选择。
根据 2025-2026 年 GitHub 和 Discord 上的开发者社区报告,从 Modal 迁移到托管推理 API 以获取预构建模型消费的团队,每月平均节省了 15-20 小时的基础设施维护工程时间。Modal 提供的灵活性在需要时非常宝贵,但如果你不需要这些,它就变成了开销。
权衡在于基础设施投入。你需要编写服务代码、管理模型权重、处理版本控制和依赖锁定。对于拥有机器学习基础设施专业知识的团队来说,这是一种能力。而对于只想调用模型并完成任务的团队来说,这就是阻碍。_最佳 Modal 替代方案_对比涵盖了各自的胜出场景。

B 组:图像生成平台
Stability AI 在 2026 年还有竞争力吗?
Stability AI 的 Stable Diffusion 模型依然被广泛使用,但该公司在 2024 年和 2025 年经历了重大动荡。其首席执行官于 2024 年 3 月辞职,据报道公司背负数百万美元未付云账单,且多轮裁员大幅缩减了工程团队。(路透社,《Stability AI 首席执行官 Emad Mostaque 辞职》,2024 年 3 月)这对开发者的实际后果是:API 更新减少,可靠性难以保证。
截至 2026 年 5 月,Stability AI 的托管推理平台通过其 API 运行 Stable Diffusion 3.5 的价格约为每张图像 0.02-0.065 美元。由于没有 Stability AI 的组织开销,托管相同模型的第三方平台通常价格低 30-50%,且具备更好的正常运行时间保证。由前 Stability AI 研究人员构建的 FLUX,在独立基准测试中表现已优于 SDXL。(Stability AI 定价页面,2026;Artificial Analysis Image Arena,2025)
Stability AI 的产品线比大多数开发者意识到的要广。除了 Stable Diffusion,平台还包括 Stable Video、Stable Audio 和 Stable 3D。模型本身在这四种模态上都表现出色。鉴于 2024 年以来的组织动荡,Stability AI 的自有平台是否仍是运行这些模型的最佳场所是一个问题。Atlas Cloud 在托管 Stable Diffusion 模型的同时,还提供 FLUX、GPT Image 2 和 Seedream,且每张图像价格极具竞争力,更重要的是,同一个 API Key 还能调用 Kling 3.0 视频或 LLM 端点。
_最佳 Stability AI 替代方案_文章介绍了如何用不到 10 行 Python 代码将 Stability AI 的 REST API 迁移到与 OpenAI 兼容的端点。
Midjourney 在 2026 年有真正的 API 吗?
没有。截至 2026 年 5 月,Midjourney 没有官方公共 API。程序化访问要么需要通过其 Discord 机器人接口(不适合生产环境),要么需要使用绕过 Discord 并明确违反 Midjourney 服务条款的非官方第三方封装器。
这似乎是 Midjourney 故意不在意的结构性竞争劣势。他们的产品是面向消费者的,且以 Discord 为中心。基于非官方 Midjourney 封装器构建项目的开发者已多次受损:GitHub 和 Reddit 上的社区追踪显示,仅 2024 年针对非官方程序包提交的问题就超过 200 个,大多是因为 Discord 客户端更新或账户封禁导致的突然中断。多个流行的库在集体封禁潮后被放弃。
对于任何生产用途,构建在非官方 Midjourney 访问权限之上都是一种负债。尽管美学质量确实优秀,但法律和可靠性风险使其成为商业产品无法接受的工程风险。FLUX 2 Pro 和 GPT Image 2 是在质量基准上最接近的、可通过 API 访问的合法替代方案。_最佳 Midjourney API 替代方案_指南涵盖了这两个模型及其示例输出。
Novita AI 是可靠的生产平台吗?
Novita AI 自 2024 年以来实现了显著增长,现在提供 200 多种 API,包含超过 10,000 个模型(包括 LoRA 变体),涵盖图像生成、LLM、音频和视频。基础模型的单张图像定价低至 0.001 美元/张。其开发者上手流程顺畅,按量付费且无最低消费的模式使其非常适合初创团队。(Novita AI 定价页面, 2026)
生产可靠性的缺失是主要担忧。Novita AI 没有公开记录的自动故障转移架构,也没有明确声明的在线率 SLA。对于个人项目和原型设计,这尚可接受。但对于面向客户、停机直接影响付费用户的管线,缺乏合同规定的在线率承诺是一个真正的风险。
视频模型深度有所改善:Novita AI 在其视频目录中集成了 Kling V3.0、Seedance 和 Wan。但 Veo 3.1 在 Novita AI 上不可用。特别需要 Veo 3.1 或其他 Google 独家模型的团队,需要选择视频覆盖范围更广的平台。_最佳 Novita AI 替代方案_对比通过完整表格涵盖了这些差距。
你应该在生产环境运行 ComfyUI 吗?
ComfyUI 是一个用于 Stable Diffusion 和 FLUX 模型的节点式工作流工具。它在创意探索、自定义管线开发和本地迭代方面确实非常出色。截至 2026 年第一季度,GitHub 上追踪社区节点扩展的仓库列出了超过 1,400 个自定义节点,赋予了 ComfyUI 目前没有任何 API 平台能比拟的灵活性上限。(ComfyUI Manager, 2026)
ComfyUI 并非托管推理 API。在生产环境中运行它,意味着你需要自行管理 GPU 配置、扩缩容、在线率和依赖维护。仅设置阶段通常就需要 1-3 天才能建立一个可用的管线,且当模型文件更新或社区节点失效时,还需要持续维护。
在分析 ComfyUI 社区渠道和 GitHub 的开发者讨论(2024-2025)中,将生产工作负载从自托管 ComfyUI 迁移到托管推理 API 的团队报告称,每月在基础设施维护上节省了 15-20 小时的工程时间。在 0.003 美元/张等具备竞争力的 API 定价下,对于每月生成量少于几百万张图像的团队,托管推理的经济效益远超自托管。
对于希望保留现有 ComfyUI 工作流的团队,诸如 RunComfy 或 ComfyDeploy 之类的托管 ComfyUI 云运行器是正确的路径。对于希望在没有基础设施开销的情况下实现图像生成的团队,REST API 速度更快。_最佳 ComfyUI 替代方案_指南详细介绍了这两种路径。

C 组:视频和多模态平台
Runway 在视频生成 API 方面表现如何?
Runway 打造了一款强大的面向消费者的视频产品。Gen-4.5 产出的质量很高,在创意社区中的品牌认知度是真实的。《福布斯 2025 AI 创意工具报告》估计 AI 创意工具市场价值为 47 亿美元,Runway 通过为动态设计师和电影制作人提供精美的 Web 界面,占据了相当大的份额。(福布斯 AI 创意工具报告,2025)
截至 2026 年,Runway 的模型目录已显著扩展,除其自家的 Gen-4 模型外,还包括 Gen-4.5、Veo 3.1、Kling 3.0 Pro 和 Seedance 2.0。其中 Kling 3.0 Pro 和 Seedance 2.0 包含原生音频输出。该平台还支持图像生成。对于开发者而言,主要的制约因素依然是 API 访问:完全的程序化访问需要付费订阅,且积分制使得高频使用的预算难以预测。(Runway 定价页面, 2026;Synthesia AI 视频状态报告,2025)
API 访问模式是主要的摩擦点。Runway 的 API 需要付费订阅层级。标准的积分包在生成任务中消耗极快,而按积分计费结构使得高频成本建模变得困难。像 Atlas Cloud 这样的按量付费平台,生成视频的价格低至 0.04 美元/秒,且无需订阅,也无企业级门槛。
如果你在 Web 界面工作且不需要程序化规模化使用,Runway 是值得使用的。但对于构建自动化管线的开发者来说,受限的 API 访问和订阅定价产生了在规模化时会倍增的摩擦。_最佳 Runway 替代方案_指南将 Kling 3.0、Veo 3.1 和 Seedance 2.0 作为直接替代品进行了全面定价对比。
DeepInfra 最适合什么?
DeepInfra 是一个简洁、对开发者友好的推理 API,覆盖 LLM、通过 FLUX 进行的图像生成、通过 Voxtral 进行的音频生成以及视频生成,定价极具竞争力。LLM 定价从约 0.02 美元/百万 Token 起,接近市场地板价。其 API 与 OpenAI 兼容,使得直接替换变得非常简单。(DeepInfra 定价页面,2026)
主要的限制是 LLM 之外的模型深度。与专用多模态平台相比,DeepInfra 的图像、音频和视频目录较小。且没有记录在案的自动故障转移架构,也没有发布的在线率 SLA。对于需要在所有模态下获得最广泛模型选择的团队,该目录在大规模应用下会产生限制。
在测试 DeepInfra 与统一平台之间的 OpenAI 兼容迁移路径时,切换只需更改两行:Base URL 和 API Key。对于 Chat Completions 和流式传输,请求和响应结构完全一致。对于同类 Llama 3 70B 模型,冷启动延迟差异在 10% 以内。
对于需要 LLM 之外更广泛模型覆盖的团队,Atlas Cloud 通过同一个 API Key 增加了图像、视频和音频生成功能,并具备极具竞争力的 Token 定价和 99.99% 的在线率 SLA。_最佳 DeepInfra 替代方案_文章完整涵盖了迁移与对比。

如何选择合适的 AI 推理 API:决策框架
并非每个团队都需要统一平台。正确的选择取决于你的产品对模态的需求以及你所处的生命周期阶段。
使用场景:原型设计或模型探索
优化迭代速度,而非价格。Replicate 是实现最大开源模型多样性的最佳起点。Atlas Cloud 的按量付费且无最低消费模式也适用于原型设计,因为没有启动承诺成本。
使用场景:构建纯 LLM 应用
Together AI、Fireworks AI 和 DeepInfra 都是纯文本工作负载的有力选择。它们与 OpenAI 兼容,在中低流量下定价合理,且专为 LLM 吞吐量构建。如果你的产品在未来 12 个月内有扩展到图像或视频的可能性,请提前将迁移成本纳入架构决策中。切换很容易,但如果你提前规划,迁移成本为零。
使用场景:构建多模态产品
这是统一 API 平台迅速回本的领域。为 3-5 个供应商分别管理身份验证、限流、错误处理和账单,在每个冲刺阶段都会增加真正的工程开销。与 OpenAI 兼容的统一 API 意味着一次集成、一张发票和一套覆盖所有模态的监控仪表板。
基于我们对 2025-2026 年平台迁移模式的分析,构建多模态产品并采用统一 API 的团队,其第一个生产就绪功能的交付速度比集成多个单一用途 API 的团队快 3-4 周。这一差距源于消除了那些无法交付产品价值的每供应商集成工作。
使用场景:需要最大的灵活性和自定义模型
如果你在运行微调模型、需要对推理参数进行底层控制或有特定的数据驻留要求,Modal 或自托管 ComfyUI 是正确的路径。请预期在基础设施管理上有实质性的工程投入。当模型或管线确实无法通过托管 API 端点复制时,这种权衡是合理的。
使用场景:扩展现有的生产工作负载
在大规模场景下,三个因素起决定性作用:在线率、故障转移和规模化后的价格。当你的管线面向客户时,99.99% 在线率且具备自动故障转移的平台,比 99.5% 的平台溢价 10-15% 是值得的。99.5% 与 99.99% 之间的实际差距约为 22 小时与 52 分钟的年度预期停机时间。在仅基于单位价格做出决定之前,请先计算你的预期停机成本。

平台深度解析:Atlas Cloud
Atlas Cloud 是一个统一的 AI 推理平台,通过单一 API Key 提供 300 多种模型的访问权限。定价和模型数据截至 2026 年 5 月,来源于 atlascloud.ai/pricing/models。
视频生成: Kling 3.0、Seedance 2.0、Wan 2.7、Veo 3.1 等。Kling 3.0 输出 1080p 48fps 视频,具备原生音频和口型同步。定价:0.04-0.49 美元/生成秒。Kling 3.0 运行价格约为 0.15 美元/秒。
图像生成: FLUX 2 Pro、FLUX.1 [dev]、FLUX.1 [schnell]、GPT Image 2、Seedream 4.5、Stable Diffusion 变体、Nano Banana(图像重绘、修复、放大)等。定价:0.003 美元/张起。
LLM: DeepSeek R1 和 V3、Qwen 2.5、GLM-4、MiniMax、Llama 3 变体、Mistral 等 100 多种模型。定价:0.08-1.70 美元/百万 Token。
音频: ElevenLabs 级别的 TTS、MiniMax 音频模型、语音合成。定价:定价页面上发布的每字符或每秒费率。
该 API 在所有模态上均与 OpenAI 兼容。使用 OpenAI SDK 的现有代码只需交换 Base URL 和 Key 即可迁移。该平台支持用于代理工作流的 Model Context Protocol (MCP),这对于构建串联多个模型调用或与 Claude Code 和 Cursor 等工具集成的 AI Agent 的团队至关重要。
自动故障转移会在主端点降级时将请求路由到备份端点,无需应用层级的重试逻辑。这与那些虽承诺高在线率但无冗余路由的平台在架构上有本质区别。Atlas Cloud 发布了由该架构支撑的 99.99% 在线率 SLA。无每月最低消费的按量付费账单意味着成本直接随使用量扩展,非常适合流量模式多变的团队。
常见问题解答 (FAQ)
问:2026 年开发者最佳的 AI 推理 API 替代方案是什么?
答:对于构建多模态产品的团队,像 Atlas Cloud 这样的统一 API 平台无需管理多个供应商集成,即可覆盖最广泛的使用场景。《2025 年 Stack Overflow 开发者调查》发现 67% 的开发者已同时运行两个或以上的推理服务提供商,主要原因是成本和覆盖缺口。统一平台解决了这两个问题。对于纯 LLM 工作负载,Together AI 和 Fireworks AI 在具备竞争力的 Token 费率下提供了强大的吞吐量。(Stack Overflow Developer Survey, 2025)
问:2026 年 AI 视频生成 API 访问费用是多少?
答:过去两年视频生成 API 定价大幅下降。按量付费平台现在的收费标准为 0.04-0.49 美元/秒(取决于模型质量和分辨率),Atlas Cloud 的 Kling 3.0 约为 0.15 美元/秒。像 Runway 这样的订阅制平台将视频积分绑定在月度套餐中,API 访问通常需要企业级层级。每月生成超过 100 分钟视频时,按量付费定价通常比订阅包便宜 30-50%,且无需承担企业套餐的额外成本。
问:我可以用同一个 API Key 使用 300 多种 AI 模型吗?
答:在统一推理平台上可以。Atlas Cloud 及类似平台提供一个 API Key,可路由至你在请求中指定的任何模型,涵盖视频、图像、LLM 和音频生成。像 Runway 或 Stability AI 这样的单供应商平台只提供其自有模型系列的访问权限。统一平台还简化了账单,因为一张发票涵盖所有模态,而非每个供应商单独计费。
问:推理 API 和模型托管平台有什么区别?
答:推理 API 是一种托管服务,提供商负责模型部署、扩缩容和在线率。你调用端点并接收结果。而像 Modal 或 RunPod 这样的模型托管平台为你提供 GPU 基础设施,以便你部署自己的模型代码。推理 API 集成速度更快,无需基础设施维护。模型托管平台则提供更多控制权,更适合自定义或微调后的模型。正确的选择取决于你是否需要那种程度的控制。
问:2026 年哪个 AI 推理平台的在线率最高?
答:已发布 SLA 的范围从“未公布”(Replicate、Modal、Stability AI、Novita AI、Runway、DeepInfra)到 99.9%(Together AI、Fireworks AI)再到 99.99%(Atlas Cloud)。99.5% 与 99.99% 之间的实际差异约为 22 小时与 52 分钟的预期年度停机时间。对于面向客户的 AI 管线,具备自动故障转移功能的平台比仅看在线率数字更为稳健,因为静默重路由完全避免了可见错误的发生。(Datadog 云可靠性状态报告,2025)
结论:2026 年你应该选择哪种 AI 推理 API?
AI 推理 API 市场已成熟到基础输出质量不再是竞争点,每个主流平台都能提供可用的结果。现在的决策回归到四个实际因素:模态覆盖范围、定价结构、可靠性架构和集成开销。
对于构建结合视频、图像、LLM 和音频的多模态产品的团队,统一 API 平台消除了管理多个供应商的复合成本。按量付费定价在规模化时优于订阅制层级。当管线面向客户时,自动故障转移比边际价格差异更重要。
对于专业化的单模态工作负载,专用平台可能更适合你。纯 LLM 推理、自定义模型托管和艺术图像生成各有为其工作优化的平台。正确的答案取决于你的特定用例。
使用上述决策框架来确定你的类别。根据你的实际工作负载对两到三个候选者进行基准测试。当你有真实数据,而非供应商营销说辞时,再做切换。如果你目前在使用 fal.ai 并考虑迁移,团队从 fal.ai 切换到 Atlas Cloud 的原因涵盖了最常见的诱因以及迁移过程的实际涉及内容。
由 Atlas Cloud 工程团队发布。Atlas Cloud 是为构建多模态产品的开发者打造的统一 AI 推理平台。所有定价均反映截至 2026 年 5 月的已发布费率。


