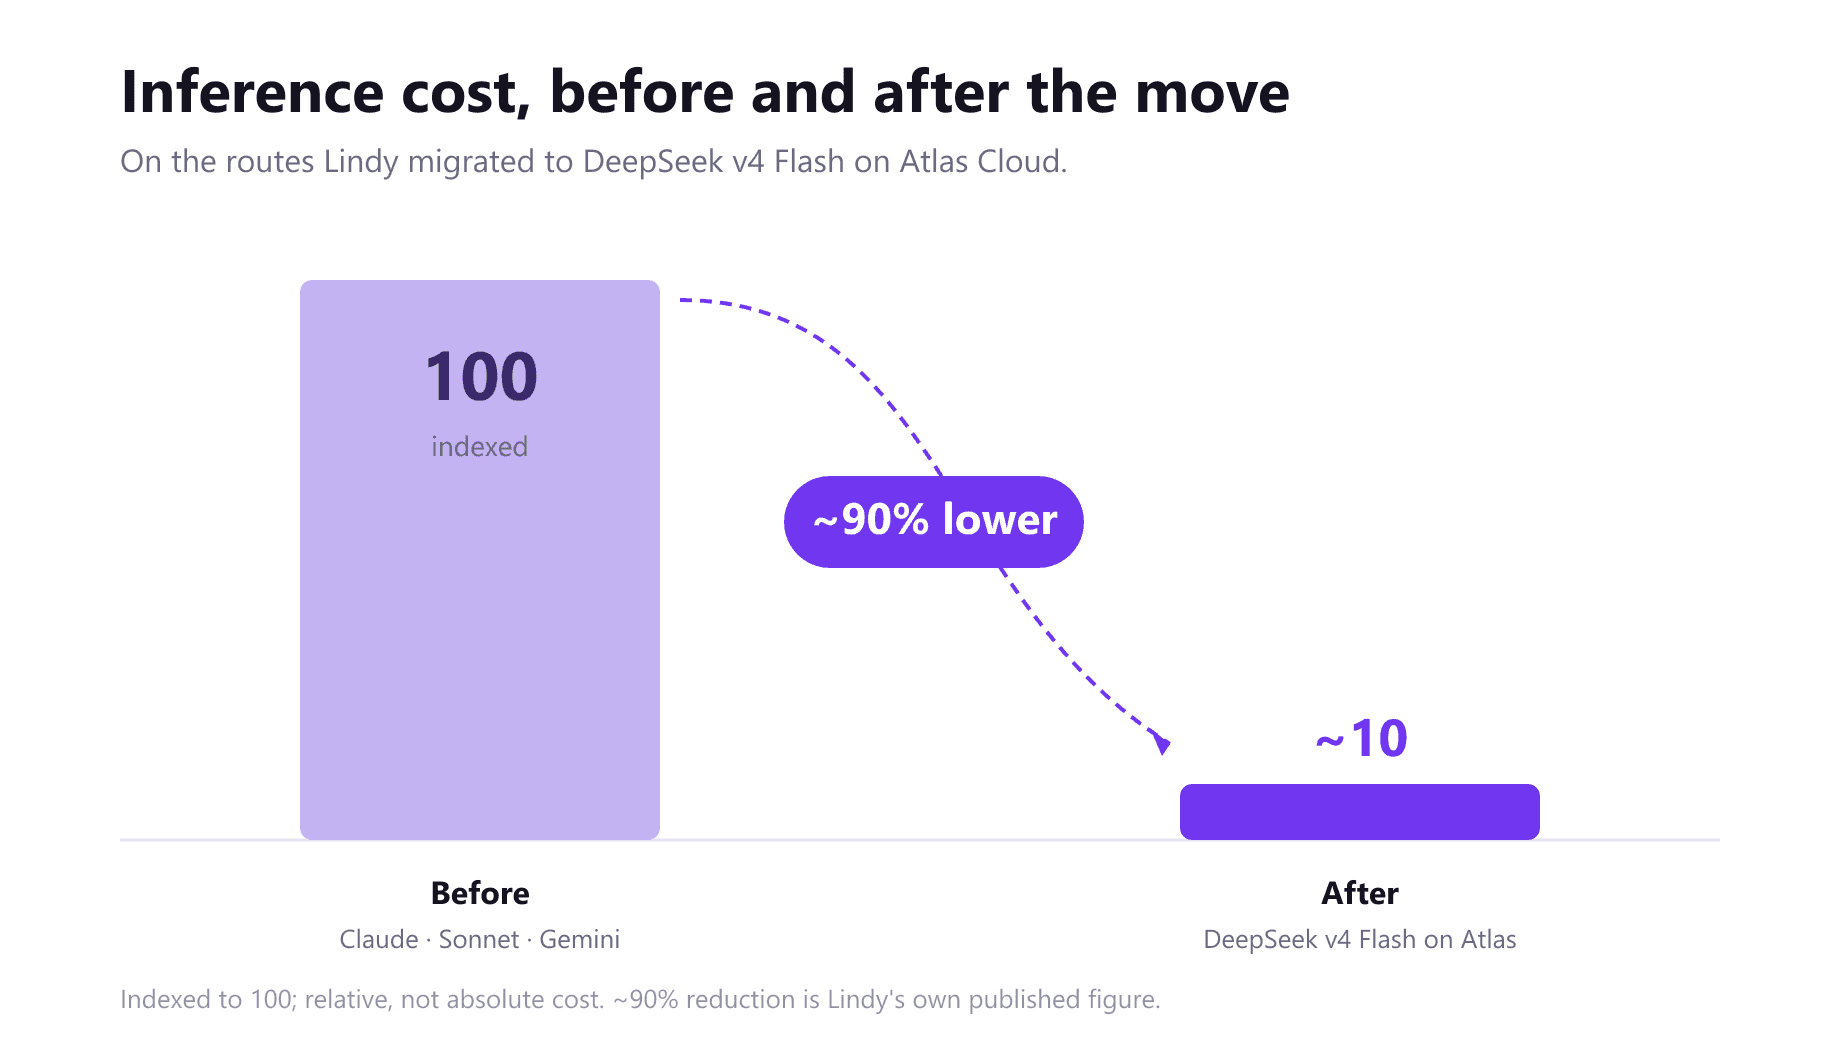
Lindy用AI员工重塑了人力版图。它将整个舰队迁移到由 Atlas Cloud 托管的开放权重模型上,推理账单削减了约90%,而且没有交付更差的产品。
推理成本降低约90% · 60%的输入令牌由缓存提供 · 每分钟稳定处理3,000+请求 · 流量增长10倍以上,无需重建任何东西 · 一个密钥管理来自11家实验室的24个模型
Lindy在生产环境中运行着最严苛的智能体工作负载之一,而它运行在Atlas Cloud上。 这是所带来的改变:
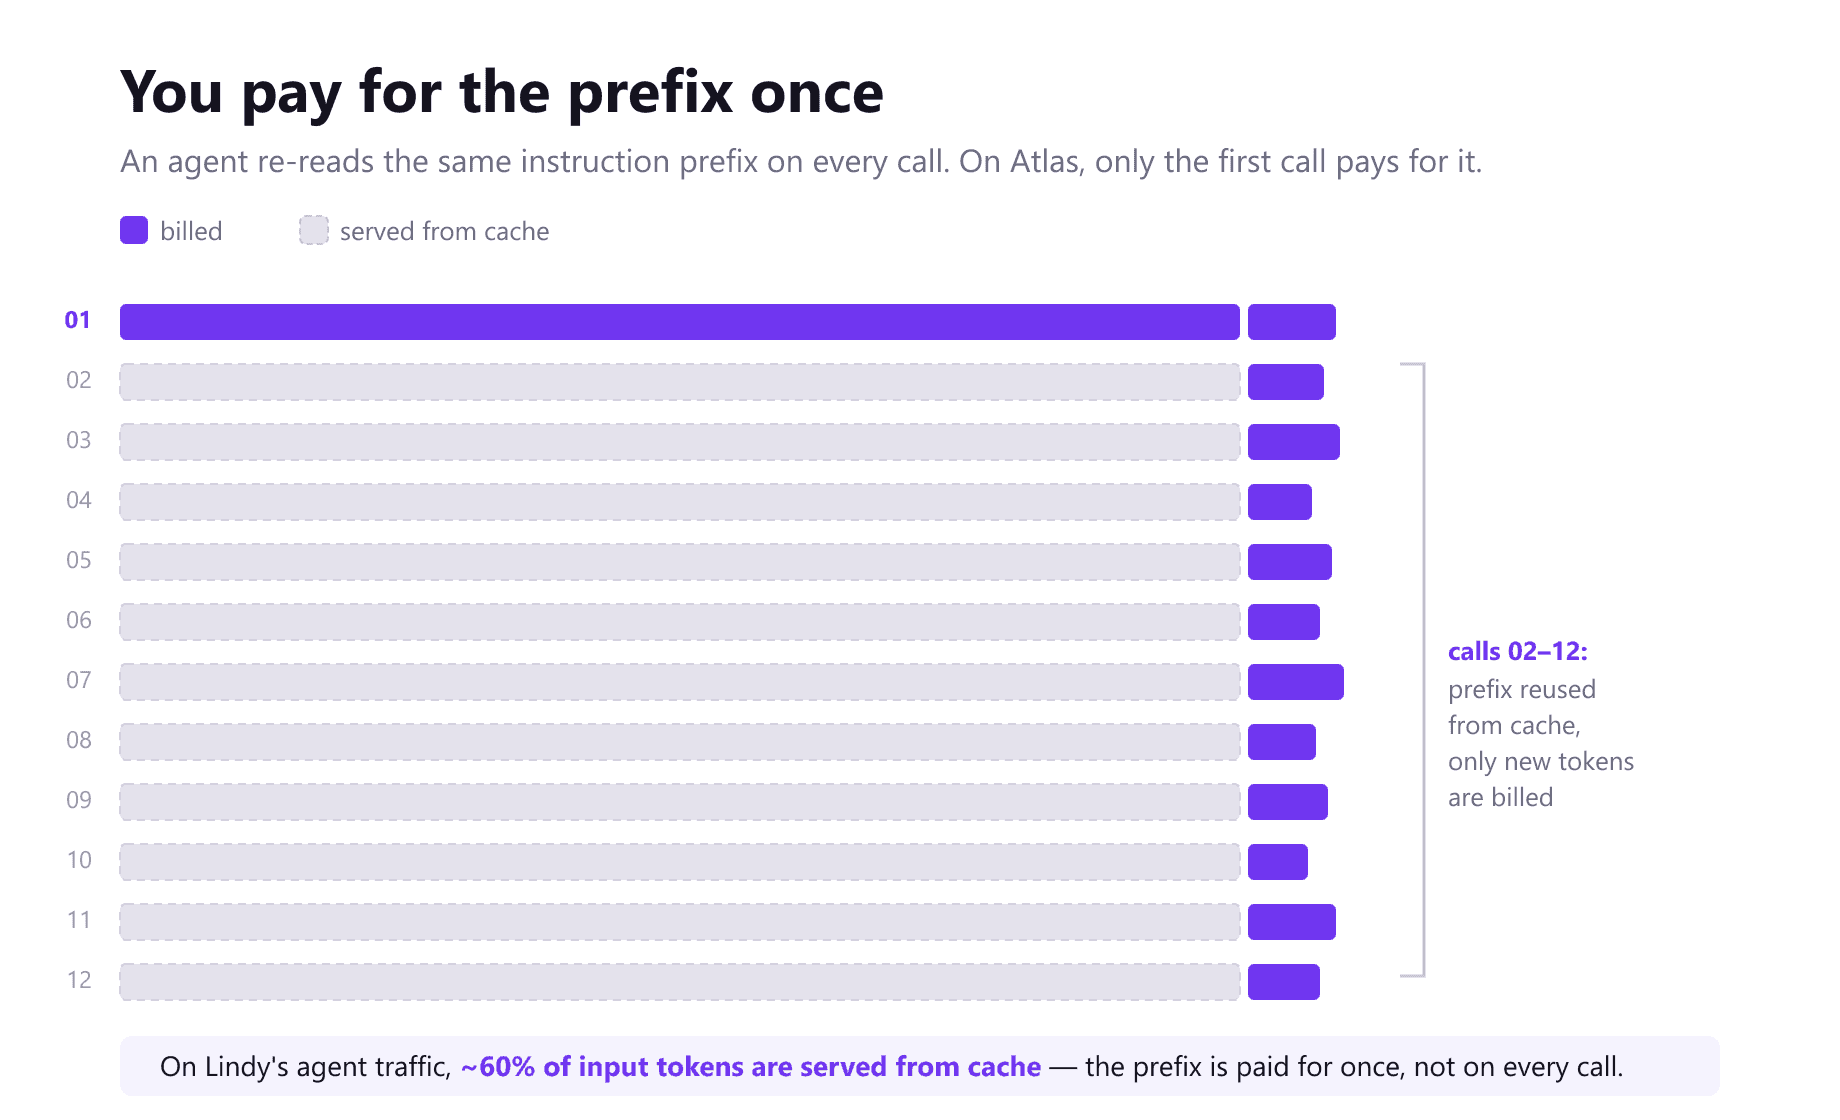
- 因为Atlas对重复调用按缓存费率计费, Lindy可以让智能体反复检查自己的工作,而不是只凭猜测。它发送的每十个输入令牌中就有六个由缓存提供服务,因此智能体在一项任务中反复读取十几次的前缀,成本几乎为零。
- 因为Atlas按工作负载进行容量规划, Lindy通过发送更多流量实现了规模超过十倍的流量增长,无需重建任何基础设施,而且Atlas能够在一小时内持续保持3,000次请求/分钟以上。
- 因为Atlas用一个密钥承载整个模型目录, Lindy可以在一个下午内切换到新模型。它已经通过单个集成运行过来自11家实验室的24个模型。
- 因为Atlas以具名合约为用户提供服务,并通过SOC 2认证, Lindy可以将开放权重模型部署在客户数据之前,并为其运行方承担责任。
90%是Lindy的噱头。这个数字之所以站得住脚,以及下一次迁移比这次更容易的原因,在于底层平台。
对Lindy而言,账单就是业务
Lindy打造AI员工。一个Lindy Teammate就像新员工一样加入公司:它在Slack中接收请求,连接到团队已经在用的工具,参加会议,并保留学到的东西,让下一个请求比上一个起点更高。没有人编写自动化脚本;他们只管分派任务,智能体去完成工作。
这种设计带来了高昂的基础设施成本。一个AI员工要读取线程、检查日历、查找记录并起草回复,在任何人看到一个字之前就已经调用了十几次模型,而且由于Teammate服务的是整个团队,使用量随人数增长而增长。在这种形态下,产品背后模型的价格直接决定业务可行性。
"Lindy的定价只有在推理成本持续下降的前提下才行得通。"
—— Bruno Škvorc,Lindy高级软件工程师
于是Lindy做了财务数学要求做的事情。它将大部分托管智能体流量从Claude、Sonnet和Gemini迁移到运行在Atlas Cloud上的DeepSeek v4 Flash,迁移路由的推理成本下降了约90%。更改模型名称只花了一个下午。但要在生产规模上维持这一成果、同时不劣化产品体验,正是他们选择Atlas Cloud的原因。
为什么90%能够持续:第11次调用几乎免费
按令牌计费时,智能体在每项任务中为同一前缀支付十几次的全价,账单随着它思考的仔细程度而增长。这种成本正是让智能体产品停留在表层的原因:一次通过而不是三次,因为第三次和第一次一样贵。这也是为什么简单地更换模型节省的钱比标价显示的少,因为重复的前缀会悄悄把账单重新填满。
Atlas在负担最重的地方消除了这笔费用。Lindy的输入令牌中每十个就有六个是被识别而非重新处理的, 按实际流量签订的合约费率计价,因此占据每次智能体调用绝大部分的前缀几乎免费。正是这一点,把模型替换变成了可持续的90%下降,而不是随着使用量上升而侵蚀的数字;也是这一点,让运行在Atlas上的智能体可以执行三次推理,而同一个智能体若按token计费,只会执行一次。
"智能体工作负载会跨多次模型调用复用大量上下文。Atlas的缓存意味着我们无需每次为同一上下文支付全价,这是节约成本措施在规模上得以维持的重要原因。"
——Ian McGregor,Lindy工程负责人
在Lindy需要之前就准备好的容量
智能体流量没有安静的深夜时段,也没有可以规划的发布日。工作发生在团队工作的时候,不会因为你在扩容而停下来。重要的不是缓冲能吸收的峰值,而是服务商能够稳定提供服务的速率。Lindy通过发送更多流量实现了10倍以上的增长,无需重建任何基础设施,而Atlas能够持续保持3,000次请求/分钟一小时以上。容量提前于工作负载,所以扩容只是一个业务决策,永远不是一个基础设施工程。
交付产品而非工单的支持
在这种规模下,服务商之间的区别与其说是仪表盘,不如说是当异常发生时谁来响应。Lindy的工程师和Atlas的推理工程师共享一个频道,回复当天见效,而且是能采取实际行动的人给出的。其中一些答复变成了产品改进:Lindy提出需要一种转移团队账户所有权的方式,当时Atlas并不支持,随后功能上线,并且Atlas的工程师亲自动手迁移了账户。
可以指名道姓的供应商
迁移到开放权重模型,意味着负责模型如何运行的那一方不再存在。原本由某家实验室品牌背书的问题,现在指向了提供商:谁在运行这个模型、在什么控制之下,以及经过的数据会发生什么。Atlas以自己的名义回答这些问题,而不是靠路由器, 基于SOC 2认证的合约,客户数据既不会被存储,也不会用于训练。这对AI员工来说比聊天产品更有分量,因为Teammate会读取所服务公司的Slack线程、日历和记录。基础设施问题直接嵌在客户信任问题之下,而Atlas对两者都给出了明确答案。
不被绑定在DeepSeek上,什么都不绑定
这次迁移让Lindy承诺了一个策略,而非一个模型。DeepSeek v4 Flash在测试中赢得了这些工作负载,并将继续把这个位置保留到它不再是质量合格前提下最划算的选择为止。下一任赢家会来自不同实验室、遵守不同许可证,而因为Atlas Cloud用一个API提供所有模型的访问,尝试一次的成本只是一个下午,而不是一个采购周期。在一天的测试中,Lindy从未使用过的十二个模型上运行了47次请求,横跨七家实验室、三种模态,全部使用它已有的密钥。其中三个变成了生产工作负载。通过Atlas Cloud持续运行最优模型的能力,为Lindy带来了真正的运营业务灵活性。
如果你在市场上运行智能体,请迁移它们
Lindy走的就是这条路。它先在OpenRouter上接触到DeepSeek,在那里运行了评估,证明了迁移的价值。在同样的测试中,它发现了决定生产环境在哪里运行的关键因素。
"我们还与不同推理服务商测试了同一个模型。很烦人,服务商真的有影响。同一个名义上的模型,由不同者提供服务,分数都不一样。"
—— Bruno Škvorc,Lindy高级软件工程师
关于Atlas Cloud
Atlas Cloud是统一的、全模态的AI平台:400+模型涵盖视频、图像、语言和音频,通过一个API密钥、一个端点和一份账单账户即可使用,语言模型兼容OpenAI格式。已通过SOC 2和HIPAA认证认证。





