代码看起来已经完成。然后测试失败了,修复改动了一个接口,另一个请求又开始运行。选择最佳 AI 编程 API,意味着找到一个能在可接受预算内完成你这类工作的模型和端点。
从 Claude、GPT 或 Gemini 作为参考候选开始。如果你想要替代的部署和支出方案,可在相同任务上比较 DeepSeek、Qwen 和 Kimi。调试时优先考虑回归测试。重构时检查 diff。对于编程智能体,在比较 token 价格之前先验证整个工具循环。
这种挫败感是可以量化的。在 2025 年 Stack Overflow 开发者调查中,66% 回答挫败感问题的受访者表示遇到过“几乎正确”的 AI 方案;45% 表示花更多时间调试生成的代码。这些是调查回答,不是 2026 年的模型评估。(Stack Overflow 开发者调查,2025)
关键要点
- 将 API 和智能体分开选择。
- 按任务和所需端点特性筛选候选。
- 保存首次答案,并用固定的验收测试评判它们。
- 在成本计算中纳入失败尝试和修复。
本指南提供一份候选名单、三个可复制的评估任务和一份成本工作表。研究核查于 2026 年 9 月 21 日。模型可用性、文档化能力和实测结果在全文中属于不同的证据类别。
最佳 AI 编程 API:候选名单
从两个候选开始:一个适合你现有应用,一个作为替代。使用以下六个系列来构建这个初始组合。
下表提出的是测试建议,并非比较性能的声明。访问权限取决于你的账户、地区、配额和端点;文档中列出某项并不代表你的凭据就能调用它。
| 具体模型与 ID | 访问路径 | 值得评估的任务 | 主要决策边界 | 端点证据 | 价格核查 |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | 受限的多文件修改 | 验证客户端和推理控制 | Claude Platform 模型概览;账户访问未测试 | 未引用费率 |
GPT-6 Astra, gpt-6-astra | OpenAI API | 多条件编程任务 | 验证路由和工具 | OpenAI 模型文档;账户访问未测试 | 未引用费率 |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | 交互式生成与评审 | 验证延迟和协议 | Google AI 模型目录;账户访问未测试 | 未引用费率 |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud 模型路由 | 数值修复;上下文实验 | 将 0813 版本单独保留 | 已核验具体模型页面;运行时特性未测试 | 2026 年 9 月 21 日 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Atlas Cloud 模型路由 | 重构;自包含接口 | 指定版本;非最新版本 | 已核验具体模型页面;运行时特性未测试 | 2026 年 9 月 21 日 |
Kimi K3, moonshotai/kimi-k3 | Atlas Cloud 模型路由 | 相同三个任务;CSV 接口 | 验证输出和完成限制 | 已核验具体模型页面;运行时特性未测试 | 2026 年 9 月 21 日 |
Claude、GPT 和 Gemini 提供了有用的参考候选。 它们的官方模型目录标明了上述版本。用你已熟悉的提供商作为基线,然后测试替代方案是否能降低“已接受任务”的成本或集成工作量。不要将消费级助手的行为当作对应 API 的结果。
OpenAI 的模型目录将 GPT-6 Astra 与 GPT-5.6 系列并列。这只确立了一个当前候选,并不表示它在编程上胜过其他行。该表有意避免从无日期的对比页面引入旧模型 ID。(OpenAI 模型目录,2026 年 9 月访问)
DeepSeek 作为独立的模型系列,值得调查。 测试它是否能修复特定缺陷而不扩大改动范围。如果部署的路由无法满足你要求的响应格式、工具行为或延迟上限,就选另一个候选,无论该模型整体声誉如何。
按版本评估 Qwen。 指定的 122B A10B 部署提供了具体的价格参考。在得出价值结论之前,先运行解析和浏览器测试。来自其他 Qwen 版本的上下文数据不能归到该模型上。
Kimi 是可供实操的配置候选。 其公开页面标明了模型 ID。配置评审可以完成;成功生成仍未经核实。用与其他候选相同的约束来评估它的完成输出。
Atlas Cloud 在此比较中处于访问层。它不是第七个模型。它的相关性是实用性的:你可以在提交一个工作流之前,查看多个候选模型页面并比较它们的集成需求。
对于开放权重,核验确切的发布许可证和部署产物。托管推理有单独的服务条款和运营成本;仅凭模型系列无法确定这些。
编程 API、模型与智能体解析
模型根据输入生成内容。API 定义你的应用如何发送输入和接收结果。编程智能体组织周边工作:读取文件、调用工具、应用修改、运行测试,以及决定是否继续。
这三层可以独立失败。模型可能提出正确的补丁,而智能体把它写到了错误的文件。API 可能返回有效的 JSON,而应用忽略了工具调用。一个能力强的智能体可能因为所选端点拒绝某个参数而卡住。
假设你发送一个 handler 并要求生成一个 ID 解析器。基础代码生成 API 返回包含代码的文本。你的程序仍需提取该代码、放入合适的工作区并运行测试。成功的 HTTP 响应只确立了交付,而非正确性。
只有当提供工具和权限时,智能体才能自动化这些步骤。它还需要一个停止条件。没有停止条件,它可能反复修改一个已经可接受的函数、扩大任务范围,或花费额外请求去改进无关细节。
将三项预算分开核算:
- 工具订阅: 你使用的应用、编辑器集成或智能体服务。
- 推理用量: 按计费条款向所选模型端点发出的请求。
- 执行环境: 容器、测试运行器、存储和其他基础设施。
部分产品将这套栈中的部分内容打包。其他产品则期望你自带独立凭据。在假设编辑器订阅包含你自己应用的任意 API 流量之前,先查看具体方案。
协议兼容性也有边界。一个接受熟悉 messages 数组的服务,仍可能暴露不同的工具行为、流式事件、上下文限制或推理控制。复制一个 base URL 无法确立对另一提供商生态中每个特性的支持。
梳理应用、智能体、端点、模型、工具和测试。在更换模型之前,确定每一步的可计费组件和负责方。
最佳 AI 编程 API:7 项选择检查
1. 功能正确性与回归行为。 在请求代码之前先写出预期输出。一个能处理普通整数但把 null 当作 0 的价格函数违反了契约。既运行新的边缘用例,也运行现有项目测试;通过一个新测试可能掩盖别处被破坏的调用方。
2. 改动范围。 将补丁与请求进行比较。提取一个 ID 解析器应保留 URL、成功响应和错误响应。未经请求的框架迁移会增加评审工作,即使替代实现能编译。事先决定无关修改是否应判定该答案为不合格,或需要修复。
3. 可用上下文与输出空间。 你的请求包括指令、相关文件、工具定义和先前对话。同时为答案预留足够空间。大的标称上下文窗口并不确立模型能找到相关的不变量,也不确立你的端点接受同样的最大值。
用真正相关的依赖测试上下文质量。包含一个接口必须保持稳定的调用方,并核实模型尊重它。单独测量截断:一个在函数中途结束的响应不能因为开头几行看起来不错就被接受。
4. 工具调用与结构化输出。 用你实际的工具 schema 验证部署的路由。检查参数类型、缺失字段、工具标识符,以及工具结果后的后续响应。一个能写出看似合理的 JSON 对象的模型,未必完成了原生工具调用往返。
5. 到已接受结果的时间。 记录整个尝试的时长,包括修复和测试。对于交互式助手,首个可见文本的时间也重要,但它不能替代完成时间。一个很快的首 token 后跟一段冗长无用的答案,仍会阻塞开发者。
6. 输入、输出、缓存和重试费用。 阅读你所选端点实际报告的计费类别。在适用时,将缓存读取与普通输入分开。跟踪未成功的请求和被中止的循环。如果提供商未提供你需要的细节,明确标注估算中缺失的假设。
7. 集成与代码处理条件。 确认你的编辑器或应用支持该路由、认证方法和错误格式。在发送私有源码之前,查看提供商当前的数据处理条款。开放权重描述的是模型分发选择;它们不确立托管服务如何处理你的请求。
公开基准可以帮助你选出候选,前提是你阅读其条件。SWE-bench Verified 包含 500 个人工筛选实例。其当前页面还描述了使用相同 mini-SWE-agent 环境的 Bash Only 视图。这些细节有助于解释正在比较的内容。(SWE-bench,2026 年 9 月访问)
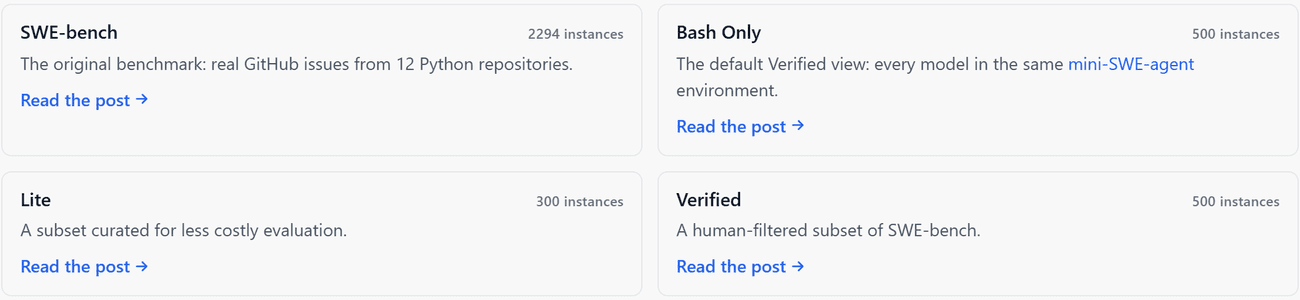 SWE-bench 页面,显示 Verified 数据集规模和共享智能体环境
来源证据:真实基准页面,截图于 2026 年 9 月 21 日。数据集和执行条件应与任何性能声明并列呈现。
基准结果描述的是特定设置。你的语言、业务规则、权限和评审标准可能不同。最终决定应基于你能检查的工作。
最佳 AI 编程 API:运行三项实操检查
这三个可复现的评估示例揭示不同的失败模式。在请求输出之前先固定其验收规则。无论解释质量如何,都要按契约评判函数或页面。
对于 DeepSeek V4 Pro、Qwen3.5 122B A10B 和 Kimi K3,预期协议是每个任务独立运行三次。这意味着 27 次初始尝试。每次尝试最多允许一次反馈修复,保留首次答案,并分别报告初始和修复后的结果。
仅在支持的地方请求 temperature 为零,并记录实际接受设置。在检查端点限制后,A 和 B 的请求输出上限设为 4,096 tokens,C 设为 8,192。必须记录默认值和不支持的控制项。低 temperature 不保证答案完全相同。
证据状态: 测试环境访问被 Cloudflare Access 登录页面阻止。27 次候选尝试无法执行。以下证据显示的是本地执行的原始代码和一篇由文章作者编写的 CSV 参考样例,而非候选模型结果。模型通过率、token 用量和任务成本仍未测量。
任务 A:修复数值价格选择。 将以下确切提示词粘贴到新会话中:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
固定的验收输入为 [2,10,3]、["12","3"]、空数组、仅含无效值的数组、零、负数和仅含空白的字符串。trim 之后拒绝空字符串。检查调用后原始数组元素数量相同、顺序相同。
原始实现使用 JavaScript 默认排序并修改输入。因此该任务检查两个不同义务:选出正确的数值最小值,以及避免改变调用方的数据。显式测试转换规则,因为简短的强制转换方案可能意外接受布尔值或 null。
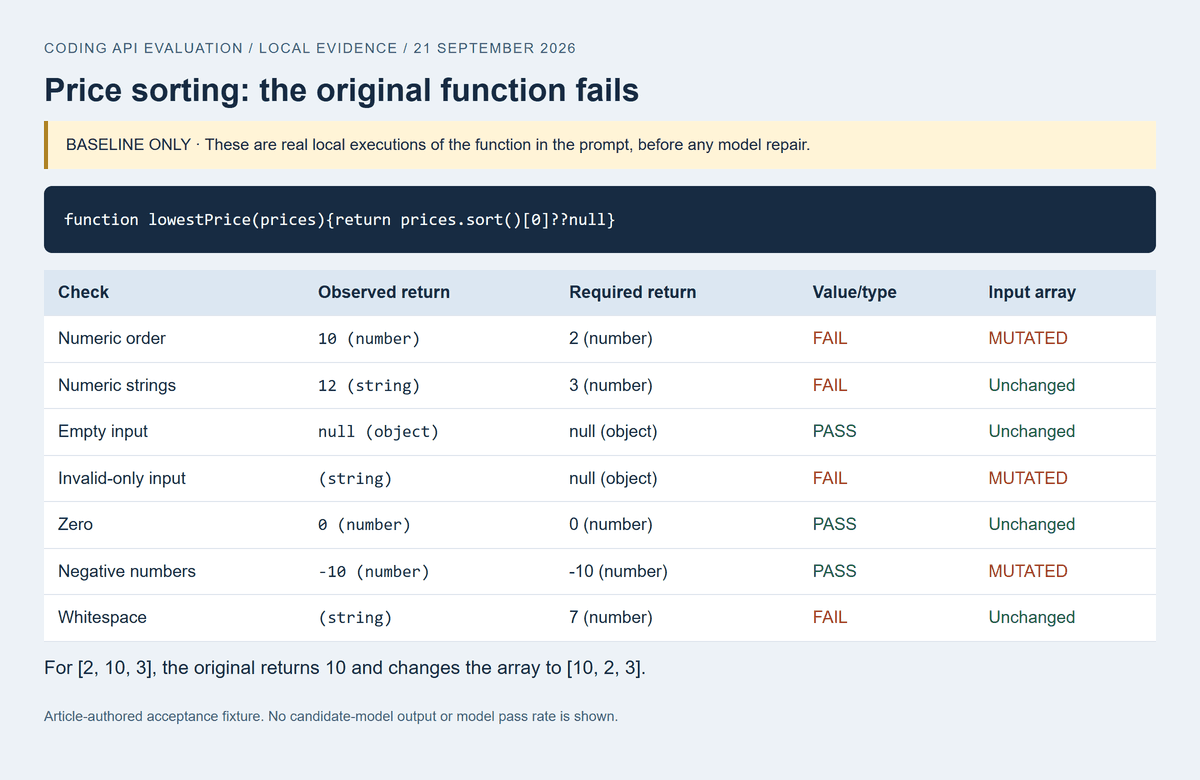 本地执行原始价格函数,显示错误的数值排序和被修改的输入
已执行基线:原始函数对 [2,10,3] 返回 10,并将数组改成 [10,2,3]。数值字符串也违反返回值契约。未展示模型修复。
任务 B:在小型重构中保留接口。 原样使用此提示词:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
接受 "12" 和 "0012" 为 12。拒绝 "1e2"、"1.0"、负数、零、空白、非字符串输入,以及超出 JavaScript 安全整数范围的值。验证注册路径和两个响应体。无效输入不得到达 findUser。
该任务测试模型是否理解数值转换与指定字符串语法之间的区别。检查 diff 中是否有无关修改,然后用打桩的 request 和 response 对象调用该 handler。一个正确的辅助函数配上一个未修改、仍然宽松的 handler 仍然失败。
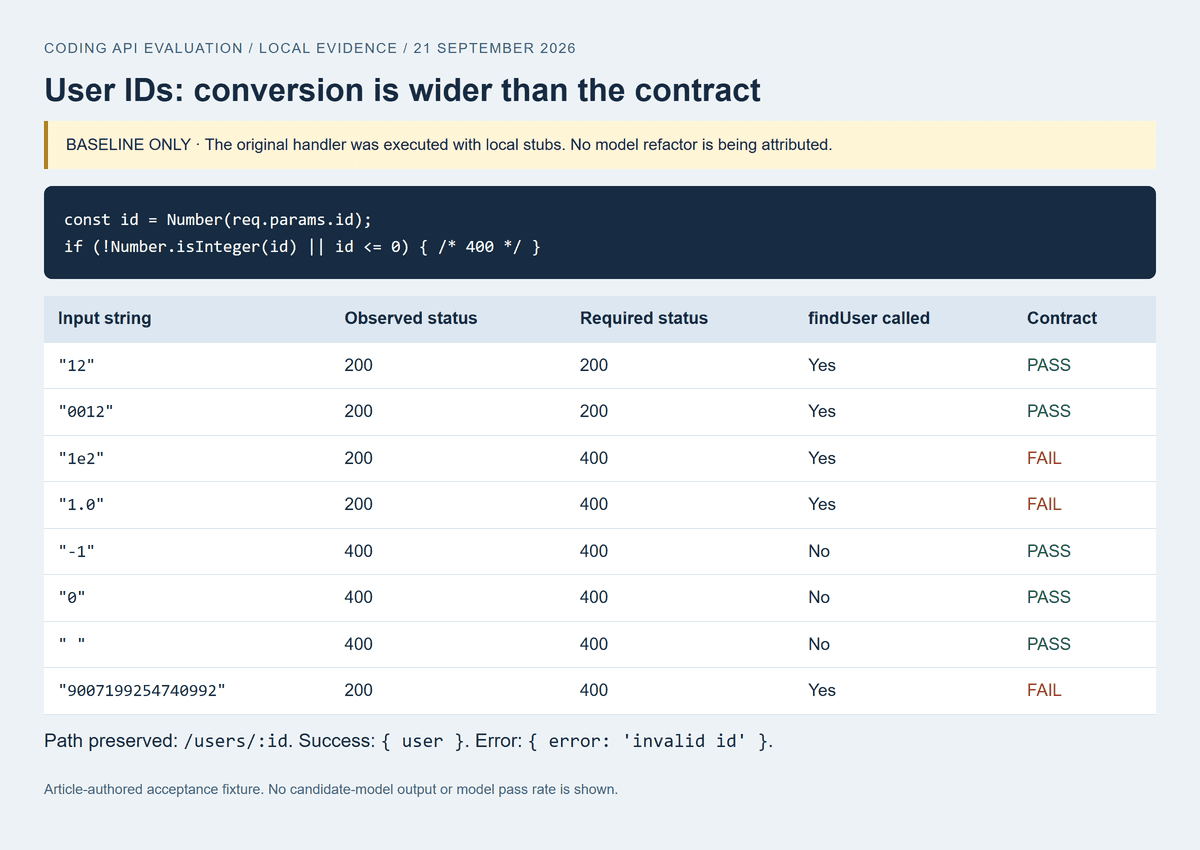 原始 handler 测试日志,显示无效数值字符串以状态 200 被接受
已执行基线:原始 handler 对 "1e2"、"1.0" 和 "9007199254740992" 返回 200,尽管要求 400 响应。本地桩记录了这些调用;这不是模型生成的重构。
任务 C:构建一个你可操作的 CSV 预览。 提交:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
用以下确切记录进行测试,先使用 LF,再使用 CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
预期两列、三行数据,Alice 的逗号位于一个单元格内,Bob 的转义引号正确显示。Eve 的值必须以字面文本出现,不得有图片元素、事件执行或网络请求。添加一行有三个字段的数据,确认页面明显报告字段数不匹配。
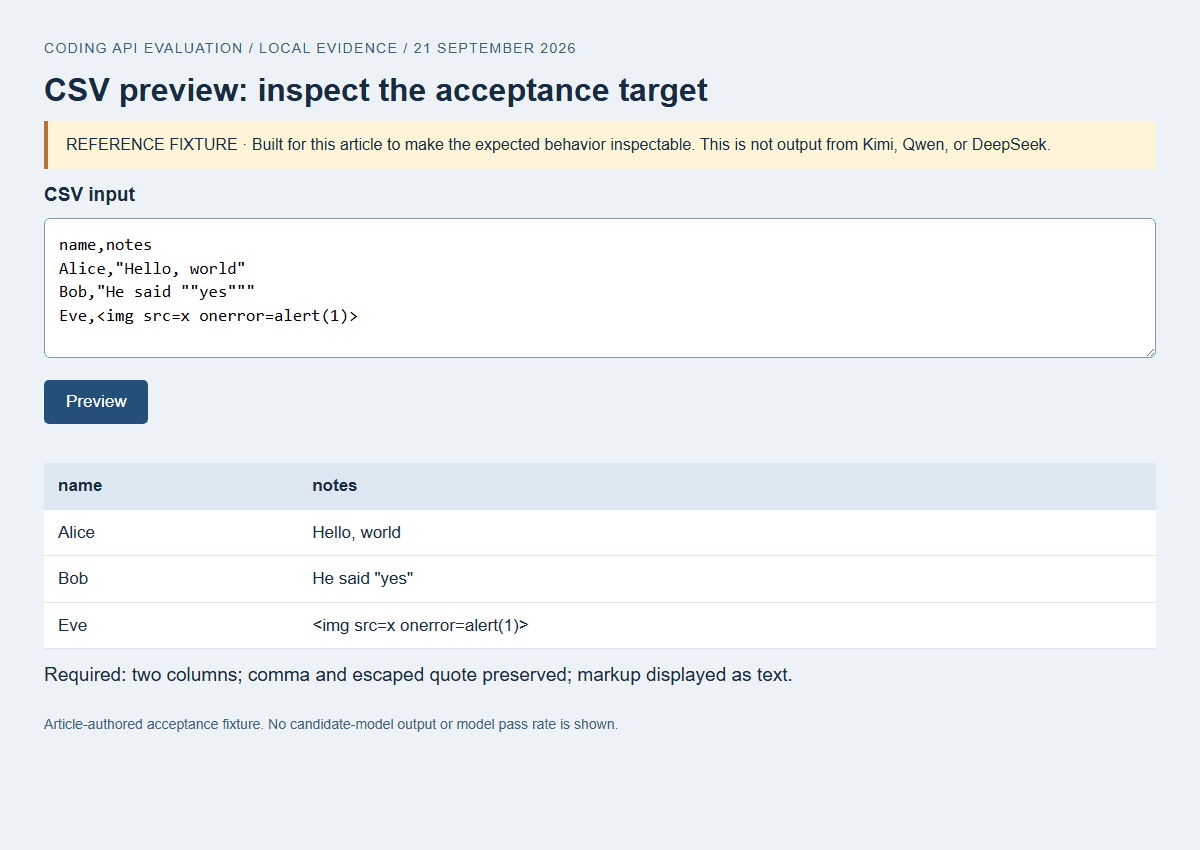 CSV 验收样例,显示带引号的值和字面标记要求
为本文构建的操作参考样例,并非由候选模型生成。浏览器检查核实了 LF/CRLF 解析、转义引号、字面标记、可见的字段数错误,以及无 HTTP 请求。截图显示的是点击 Preview 后的有效输入状态。
保存原始输出、日志、模型 ID、日期、参数、计时、修复和手工修改。将失败的断言发送以进行修复,但不改变预期结果。将拒绝、截断和错误与成功记录一并保留。
预算内的最佳 AI 编程 API
将 token 费率与完成质量和使用量一并比较。重复输入可能主导代码评审成本;整文件生成可能增加输出费用。重复修复会同时增加两者。
Atlas 目录和具体详情页在 2026 年 9 月 21 日显示以下每百万 token 的美元费率:
- DeepSeek V4 Pro: 输入 $1.68,输出 $3.38。单独的 V4 Pro 0813 挂牌使用不同费率;不要用它替代。
- Qwen3.5 122B A10B: 输入 $0.30,输出 $2.40。截至 2026 年 9 月,目录显示原价 $0.40 和 $3.20,并有 25% 折扣。
- Kimi K3: 输入 $3.00,输出 $15.00。
这些是展示的生产费率,不是本文评估产生的账单。缓存专属费率及其适用性未确认。DeepSeek 和 Kimi 的促销折扣未确认。未观察到折扣并不证明不存在优惠。
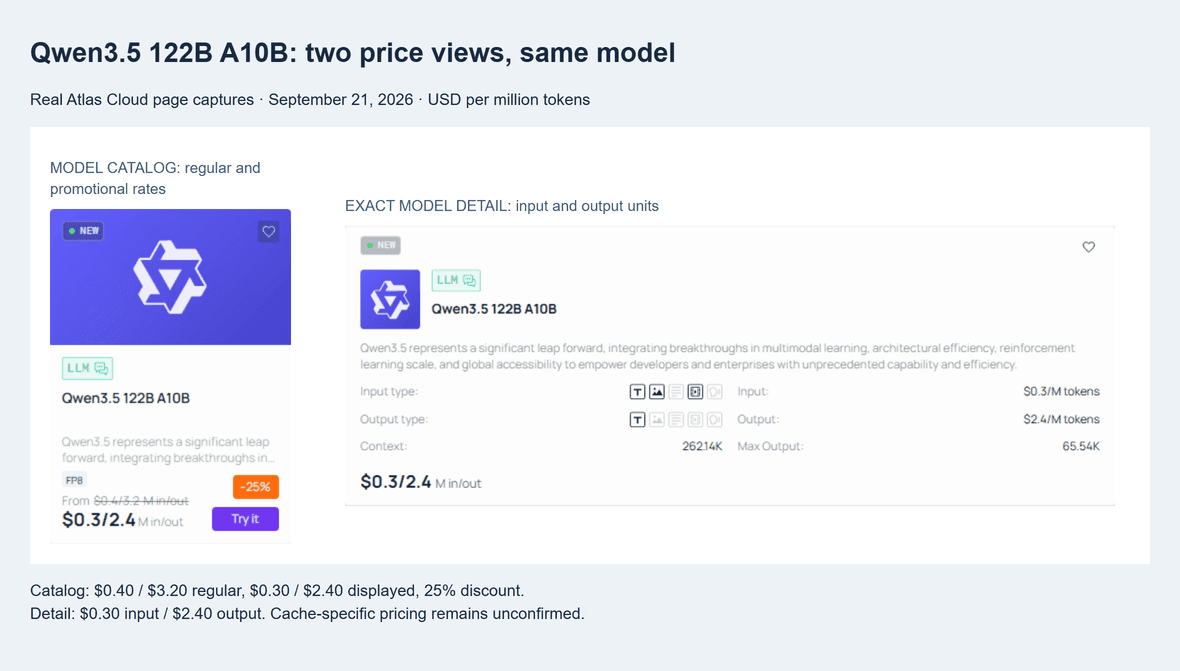 Qwen3.5 122B A10B 目录折扣与其具体模型详情页的输入和输出费率并列
Qwen 价格交叉核查,2026 年 9 月 21 日:目录显示 25% 促销;具体模型详情确认每百万 token 输入 $0.30、输出 $2.40。缓存专属费率仍未确认。
将任务中的模型部分计算为:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
如果计费记录将缓存 token 单独处理,不要再按普通输入重复计费。检查推理用量是否包含在可计费输出中。如果没有任务通过,报告“无成功结果”;除以零或显示零完成成本会误导读者。
做一个透明的算术示例,假设按所示的 Qwen 费率有 10,000 个普通输入 token 和 2,000 个输出 token。估算的模型费用为 $0.0078,尚未计入任何其他适用项目。这是一个假设请求,不是观测到的 token 用量或实际账单。
一次同样大小的修复会把估算带到 $0.0156。实际修复包含不同的上下文和输出,因此要根据每个请求记录的用量分别计算。
| 任务 | 模型 | 首轮通过 | 修复后 | token 用量 | 成本来源 | 总费用 | 总时间 | 手工修改 |
|---|---|---|---|---|---|---|---|---|
| A、B、C;计划各重复 3 次 | DeepSeek V4 Pro | 未测量 | 未测量 | 未记录 | 无用量记录 | 未知 | 未测量 | 未评估 |
| A、B、C;计划各重复 3 次 | Qwen3.5 122B A10B | 未测量 | 未测量 | 未记录 | 无用量记录 | 未知 | 未测量 | 未评估 |
| A、B、C;计划各重复 3 次 | Kimi K3 | 未测量 | 未测量 | 未记录 | 无用量记录 | 未知 | 未测量 | 未评估 |
在你自己的工作表中,将每行扩展为每个模型和重复一次一行。将一次修复后的成功在已接受任务的分母中计为一次。将未成功的尝试纳入分子,并保留单独的首轮和最终接受列。
单独跟踪人工评审和基础设施。理清不必要的重写可能抹去推理节省。比较既满足验收要求、又符合你评审时间预算的候选。
使用 Atlas Cloud 的最佳 AI 编程 API
从 Kimi K3 模型页面开始,确认 ID,并查看 API 和 Code 视图。将所选版本与测试记录放在一起。
在将两条路由视为可互换之前,先阅读 LLM 协议文档。它将 Chat Completions 标识为覆盖面较广的路由,并引导用户查看每个模型的 supported_apis。采样控制和工具特性也取决于该模型标称所支持的内容。
这里有几个值得核查的具体集成细节。文档说明,经翻译的 Anthropic 请求不会应用 cache_control,且提供商托管的工具在该翻译路由上不可用。如果你的现有智能体假设有原生缓存或托管浏览工具,这些约束就很关键。请将客户端与实际的路线匹配。
以下 Node.js 示例演示一次文本请求。它使用内置 fetch、用于凭据的环境变量,以及已核验的 Kimi 模型 ID。将任务 A 的确切提示词保存为 task-a.txt。将 base URL 环境变量设置为其文档中所示、以 /v1 结尾的 Atlas API base。
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages 承载任务;model 选择部署;max_tokens 请求一个输出上限。响应读取器在返回代码之前会检查是否为普通的已完成文本。超时限制了本示例的等待时长;它并不确立服务器已停止处理,也不确立未发生费用。
Temperature 被省略,因为每个模型的支持情况和既定行为仍需核实。该示例不自动重试。在添加有界重试策略之前,先查看失败类别,并且绝不要记录授权头。本文的代码在文章制作期间未使用 API 密钥执行。
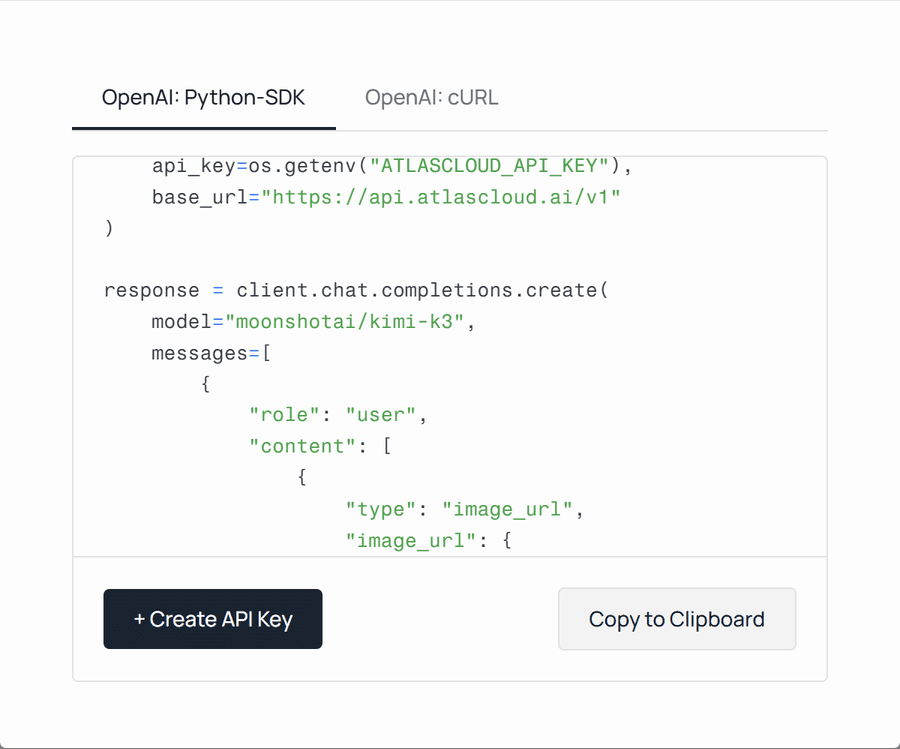 公开的 Kimi K3 API 代码示例,显示 Atlas 端点和模型标识符
公开的 Kimi K3 Code 对话框,截图于 2026 年 9 月 21 日。这是配置证据,不是已完成的编程运行。页面示例包含媒体输入;本文示例仅使用文本。
对返回的函数运行任务 A 的验收检查。在切换到 DeepSeek 或 Qwen 之前,核验其协议和参数。比较输出和用量时,保持提示词和测试不变;共享的请求形态并不确立相同的行为。
在生产中使用编程 API 之前
先在一次性分支或隔离工作区中运行生成的代码。对于 CSV 任务,使用阻止网络请求、且无法访问敏感应用状态的本地浏览器环境。对于仓库任务,只给进程提供评估所需的文件和命令。
在模型响应之外定义成功。智能体说“所有测试通过”,应引导你去查看实际的测试日志、退出码和已核查的修订。将 diff 与该证据一起存储。否则,后续修复可能在看似成功之后更改文件,使报告过时。
将超时和重试视为你自己负责的应用行为。设置请求截止时间和总任务预算。将凭据或无效参数导致的错误与瞬态传输故障分开。重复无效请求浪费时间;重复触发副作用的请求可能产生重复工作。
当智能体能调用工具时,区分只读检查与写入。在工具设计支持的地方分配操作标识符,并在重复一次不确定的写入前确认状态。模型端点的重试策略无法保证你应用随后执行的工具具备幂等性。
像对待源文件一样谨慎保护日志。记录模型 ID、时间戳、状态、计时和用量,但不要例行将密钥或整个私有仓库复制到遥测中。将任何必需的原始输出证据保存在适当受限的位置,并确定团队需要保留多久。
用真实客户端检查流式传输。它必须处理部分事件、终止、错误和可用的用量记录。确认实际账户和部署的速率限制。安静的单用户实验无法确立同一路由在团队同时提交请求时的表现。
使用这份简短的发布清单:
- 验收测试和现有回归在最终修订上通过。
- diff 保持在已批准的任务边界内。
- 超时、取消和重试行为已经过演练。
- 工具调用和结构化响应在所选端点上正常工作。
- 日志不包含凭据和不需要的私有代码。
- 数据处理条款满足团队要求。
- 备用方案有其自身已核验的配置和测试记录。
私有仓库需要针对具体服务的决定。与负责代码的人一起查看当前的保留、训练用途、访问和合同条件。仅发送已批准的材料。不要因为模型权重可用,或因为协议看起来像你已在使用的协议,就推断其保密性。
最佳 AI 编程 API:做出最终选择
分三轮做决定。
第一,排除缺少必需能力的候选。 写下必须成立的条件:可接受的输出格式、可运行的工具循环、合适的数据处理安排,或可行的响应截止时间。缺少其中一项的候选需要单独的补救决定,然后才能进入最终比较。
第二,比较已接受任务的成本和耗时。 在相同的修复策略下使用所有尝试。将首轮成功与修复后成功分开,并显示缺失的用量记录。如果两个模型都满足契约,就比较它们的评审负担以及模型费用。你的开发者将长期面对由此产生的补丁。
第三,保留一个备用方案,并定义其触发条件。 示例包括持续端点中断、反复的结构化输出失败,或任务成本超过选定上限。提前测试备用配置。在压力下切换模型 ID 可能引入第二个集成问题——如果其控制项或响应行为不同。
本指南中的三个小任务是筛选演练。在依赖某个候选进行大规模改动之前,用你自有代码库中的代表性工作扩展测试套件。保留一些不在提示词调优范围内的任务,以便检查改进是否能迁移到你优化过的示例之外。
最佳的 AI 编程 API 是你能够解释的组合:它完成所需工作、暴露你可跟踪的成本,并契合你应用的运行方式。做出这个决定并不需要一个普适的赢家。
打开当前模型目录,选两个候选,并保存它们确切的 ID 和设置。然后对两者使用相同的任务、相同的测试和相同的停止规则。
常见问题
预算有限时,最佳的 AI 编程 API 是哪个?
从展示费率符合你预期输入和输出量的候选开始,然后比较每个已接受任务的成本。Qwen、DeepSeek 和 Kimi 各行提供了可供调查的具体版本,但并未断言经测试的价值赢家。限制修复次数、有意识地复用相关上下文,并跟踪失败请求。将评审时间单独纳入,以免低推理账单掩盖大量清理负担。
编程订阅比按 API token 付费更便宜吗?
这取决于你的工作负载和方案包含的内容。订阅可能适合在其支持的应用内进行交互式使用,而按用量计费可能适合流量可变的定制服务。检查模型访问、上限、并发,以及是否包含外部 API 调用。在具有代表性的时间段内比较同等数量的有用工作;月度标价和 token 费率衡量的是不同的东西。
编程模型和编程智能体有什么区别?
模型生成响应。智能体管理围绕这些响应的循环,包括文件访问、工具执行、测试和停止规则。你可以通过 API 调用编程模型而不构建智能体,例如为人工评审建议一个函数。如果你想要自主编辑,就要连同智能体及其实际会使用的权限一起评估模型。
调试和重构应该使用哪个 AI API?
筛选符合你端点和代码处理要求的候选,然后使用你工作中的小缺陷和受限重构。任务 A 检查正确性和输入修改;任务 B 检查解析和接口保留。随后用具有代表性的仓库测试跟进。
优先选择在可管理的评审工作量下满足你验收条件的候选,而不是仅仅生成最长解释或最广泛重写的那个。
有没有免费的 AI 编程 API?
试用额度、带免费额度的应用和可下载的模型权重是不同的东西。它们都不会自动为你的应用提供无限制的托管推理。在为免费访问做预算之前,核实当前的资格、到期时间、配额和支持的模型。本文不主张当前存在可用的免费额度。
如果你自行托管权重,即使下载权重不花钱,也要考虑计算和运维成本。
我可以把私有仓库代码发给编程 API 吗?
只发送你的组织根据该具体服务适用条款允许你共享的代码。查看所选部署的保留、训练用途、访问控制和合同要求。
移除凭据和无关文件,并检查你的智能体在提示词和日志中自动包含了什么。开放权重模型或熟悉的 API 格式本身并不确立某个托管服务满足你团队的保密要求。


