当每个输出都能被单独找到、审核和重试时,用于批量生成的 AI API 才有用。这比一次提交多少条提示词更重要。代价高昂的时刻不是第 1,000 个请求,而是任务 37 超时、任务 38 成功、两个文件同名,却没人能判断哪张图像可以安全发布的时候。
把批次视为一组可恢复的素材任务。为每个任务提供持久化业务 ID,保存确切的输入和模型设置,限制并发,并且只重试实际失败的那一项。本指南使用一个 8 个素材的角色营销活动工作流,让开发者或增长团队能够把一份清单转化为可控的生产运行。
要点
- 批处理作业和并行请求解决的是不同的延迟与控制问题。
- 稳定的素材 ID 和幂等键让部分失败变得可管理。
- 从 4 到 8 个视觉素材开始,审核它们,然后再扩展。
- 成功的 API 响应在发布前仍需经过视觉和权利审核。
用于批量生成的 AI API:先给出答案
用于批量生成的 AI API 会把一组不同的生成任务提交到异步队列,然后通过状态检查、完成回调或可下载的输出文件返回结果。每个任务都需要一个独立于模型提供商之外的标识。提供商的任务 ID 有助于运营,但 maya-ridgeline-001 才能让你的编辑或营销活动系统在数月后识别该素材。
不要混淆三个相关概念。单个提示词可以请求多个变体。你自己的 worker 可以同时发送多个普通请求。服务端批处理作业是提供商管理的集合,稍后完成。后者通常适合离线工作,而受控并行请求适合需要即时进度的仪表板。
OpenAI 当前的 Batch API 文档说明了这种异步模式:请求被收集到 JSONL 中,作为作业提交,检查是否完成,然后作为结果取回。其 24 小时窗口、独立的批处理速率限制和各项限制是该服务特有的,并非每个图像提供商都会做出的承诺(OpenAI Batch API 文档,2026 年 9 月)。Gemini 当前的参考文档同样记录了其服务的长时运行批处理作业、状态检查和 webhook 支持(Gemini Batch API 参考,2026 年 9 月)。
| 决策点 | 批处理 API | 受控并行请求 |
|---|---|---|
| 预期响应 | 延迟完成 | 每个请求完成后即返回 |
| 最适合 | 离线目录、分镜和内容库工作 | 交互式工具和短审核循环 |
| 故障处理 | 作业完成后读取逐项结果 | 在每个子请求完成时处理 |
| 成本与限制 | 提供商特定的批处理规则可能与实时流量不同 | 使用账户的普通请求限制 |
| 必要记录 | 素材 ID、请求 ID、结果状态、输出位置 | 相同字段,外加进行中尝试状态 |
当审核者需要快速看到第一张可用图像时,选择受控并行请求。当工作可以等待且提供商记录了批处理路径时,选择服务端批处理作业。无论哪种情况,都要存储 asset_id、规范化输入、参考哈希、模型、尝试次数和输出 URL。这个公共层让工作流在交付机制变化时仍可移植。
为什么批量图像项目在规模化时失败
生产批次通常会零散地失败。一个请求可能已完成、超时、被拒绝,或者返回技术上有效但视觉上不可用的输出。只记录最终 URL 的应用程序已经丢弃了从除最简单成功情形之外的所有情况中恢复所需的信息。
第一个失败是缺失标识。如果请求只携带提示词字符串,输出就无法可靠地映射回产品、营销活动区域设置或源行。从提示词派生的文件名很脆弱,因为提示词修订和重复产品会发生冲突。使用来自业务记录的稳定素材 ID,然后为每次生成尝试提供各自的后缀。
第二个失败是在没有幂等性的情况下重试。网络超时并不能证明提供商没有执行任何工作。如果工作进程立即用新的请求标识重新提交同一素材,就可能产生重复输出和重复费用。幂等键让调用方实际上可以表示:“这仍然是同一个被请求的素材。”某个特定端点是否支持该机制取决于提供商,因此在依赖它之前,请在 API 文档中确认。
第三个失败是盲目的 40 或 60 条提示词队列。颜色、构图或产品身份的漂移可能只有在运行结束后才会显现。最近一次创作者讨论描述了在发送下一页之前先审核大约 7 到 8 张图像的分镜页面,专门为了捕捉准确性和一致性问题(批量图像生成讨论,2026 年 6 月)。这是社区经验,不是基准,但这是一个合理的运营检查点。
使用小批次 QC 规则:运行 4 到 8 个素材,检查它们,必要时修复提示词或参考图,然后解锁下一组。保留原始提示词、提示词版本、输入参考、可获取时的模型修订版本、质量设置、宽高比、时间戳、错误类别和审核决策。仅凭 URL 无法回答某个素材为何存在,或它是否应被复用。
设计可靠的用于批量生成的 AI API
实现可以很小。一份清单、一个队列 worker、一份只追加的作业记录,以及一个便于审核者使用的输出文件夹,就足以开始。目标不是庞大的编排系统,而是一个让人能够回答以下问题的工作流:请求了什么、发生了什么、下一步应该运行什么?
为每个批量输出提供持久素材标识
让 asset_id 成为业务键,而不是提供商任务 ID。有用的任务记录可以包含以下字段。当多个 worker 运行时,将其保存在数据库中;对于较小的团队,则保存在带版本的 CSV 加 JSONL 日志中。
| 字段 | 为什么存在 |
|---|---|
asset_id | 可发布素材的不可变标识 |
source_row | 映射回产品、营销活动或内容记录 |
prompt_version | 显示哪个指令模板产出了结果 |
reference_hash | 确认使用了哪个锁定的源图像 |
model, aspect_ratio, quality | 让运行具有足够可复现性以进行诊断 |
attempt, idempotency_key, status | 将子作业重试与新请求区分开 |
output_url, review_status, failure_reason | 连接交付与人工验收 |
例如,maya-train-001 保持为素材标识。maya-train-001-a2 是第 2 次尝试。幂等键可以是 maya-train-001-v1,其中 v1 标识不可变的请求规格。如果简报发生实质变化,请创建新的提示词版本,而不是覆盖旧记录。
使用批处理队列,而不是无限循环
在派发前设置并发上限、素材数量上限、金额护栏和重试上限。一个实用的起始配置是 4 个进行中的作业、每个作业最多 2 次生成尝试,以及在下一次质量门禁前不超过 8 个视觉任务。这些是起始值,不是平台保证。将它们设置在你账户文档化限制之下,并在观察实际完成时间和错误率后进行调整。
worker 应领取一个待处理任务,将其标记为 submitted,存储提供商请求 ID,并在结果到达时更新同一条记录。当达到预算上限时,停止领取工作。当队列因审核而暂停时,允许已提交的工作完成,但不要自动释放另一组。
只重试失败的子作业
一次只针对一个素材重试 failed、timed_out 或提供商特定的可重试状态。对于 429 响应、暂时性 5xx 响应和真正的传输超时,使用带抖动的有上限指数退避。存储错误分类和计划重试时间。不要自动重复内容政策拒绝、格式错误的输入、缺失参考图或来自人工审核者的视觉拒绝。
绝不要因为一个子作业失败就重新提交整个批次。立即归档成功结果,并保留源到输出的映射。如果批处理作业在带有部分结果时过期,请摄取已完成的子项,识别未完成的素材 ID,并创建一个仅包含这些剩余记录的新作业。这就是恢复与重复之间的区别。
可复制的 8 个素材批量图像工作流
以下示例是刻意虚构的:Maya,一位在高地执行任务的成年旅行摄影师。它让操作机制变得具体,但并不暗示有真实人物为该营销活动背书。请将这些字段替换为你自己获得许可的角色、人才授权或营销活动数据,并保留该结构。
步骤 0:生成前创建清单
在打开 playground 或调用端点之前创建 batch-manifest.csv。它为操作员提供了每个素材的明确验收目标。
| asset_id | batch | use_case | ratio | status |
|---|---|---|---|---|
| maya-master-001 | master | 规范角色参考图 | 16:9 | 待处理 |
| maya-ridgeline-001 | a | 日出山脊营销活动图像 | 16:9 | 待处理 |
| maya-market-001 | a | 山地市场编辑图像 | 16:9 | 待处理 |
| maya-cabin-001 | a | 小屋规划编辑图像 | 16:9 | 待处理 |
| maya-lake-001 | a | 湖畔田野笔记图像 | 16:9 | 待处理 |
| maya-forest-001 | b | 森林小径营销活动图像 | 16:9 | 待处理 |
| maya-train-001 | b | 火车旅程编辑图像 | 16:9 | 待处理 |
| maya-workbench-001 | b | 野外工具包准备图像 | 16:9 | 待处理 |
| maya-portrait-001 | b | 近景肖像营销活动图像 | 16:9 | 待处理 |
为每个不可变请求生成确定性的幂等键,例如 maya-ridgeline-001-v1。下面的结构刻意保持提供商中立。将提供商端点及其文档化参数放入 request 中;不要把虚构的私有端点复制到生产环境。
plaintext1{"asset_id":"maya-ridgeline-001","idempotency_key":"maya-ridgeline-001-v1","request":{"model":"your-approved-model","ratio":"16:9","reference_hash":"sha256:...","prompt_version":"maya-highlands-v1"}}
步骤 1:创建一个规范角色参考图
单独生成主图。它是之后每个场景的身份锚点,因此值得在任何批次开始前进行简短审核。在 GPT Image 2 playground 中,选择 High quality 和 16:9,然后使用此提示词:
plaintext1Editorial portrait of Maya, a fictional adult travel photographer in her early thirties, with short wavy dark-brown hair, warm olive complexion, a weathered rust-orange field jacket over a charcoal knit top, and a compact black camera on a woven shoulder strap. She stands three-quarter length against a softly lit pale-stone studio backdrop, facing slightly right with a calm, observant expression. Soft window light from the upper left, realistic subtle shadow, no logo, no text, no other people, no duplicated hands or camera. Clean cinematic campaign composition with negative space on both sides.
保留一张清晰展示 Maya 的脸、头发、夹克、相机背带和一双完整手部的图像,不得包含文字或重复人物。将其保存为 maya-master-001.png,计算参考哈希,并将同一源图附加到下游子作业。不要对这一步骤进行批处理。薄弱的主参考图会在每个场景中成倍放大歧义。
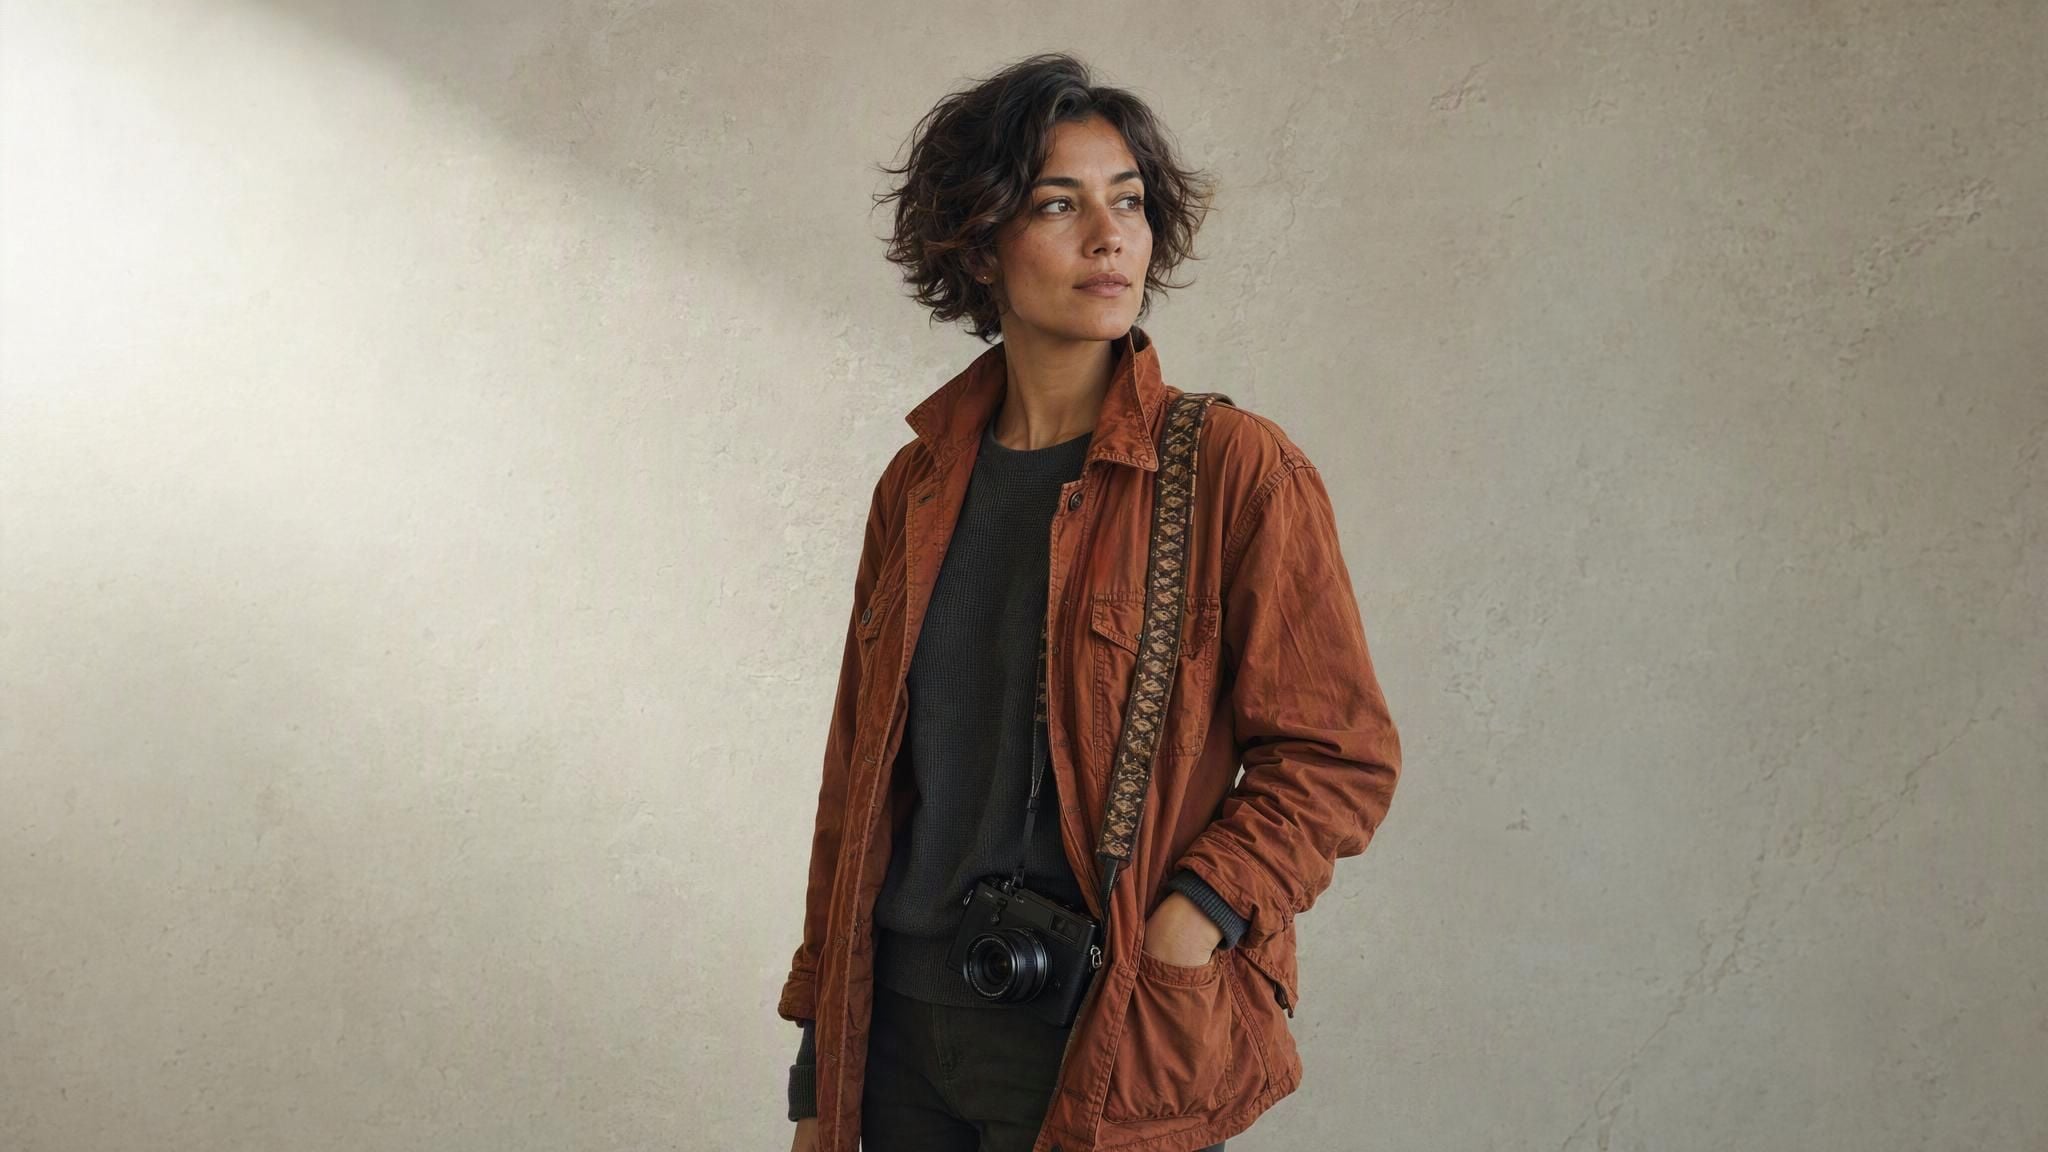
用于批量生成的 AI API 功能演示:Maya 的角色参考提示词与生成的旅行摄影师肖像并列展示
一次真实的 GPT Image 2 主参考图运行:提示词确立了虚构摄影师,后续场景作业必须保持其身份。
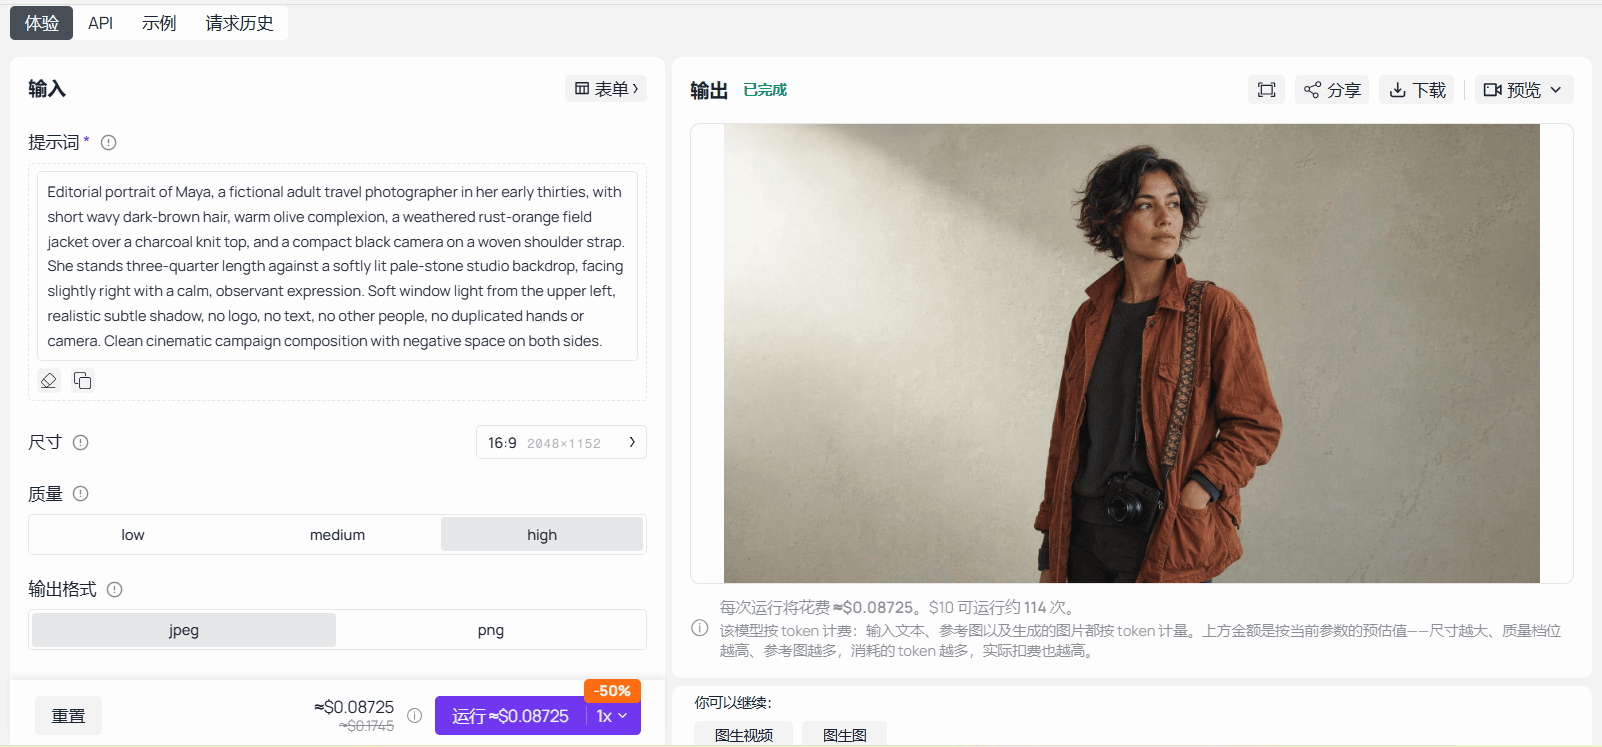
GPT Image 2 playground 已完成,使用 High quality、16:9 设置和 Maya 的主肖像
Atlas Cloud 上的 GPT Image 2,使用文章中的角色参考提示词,并在输出面板中显示已完成的结果。
步骤 2:将批次 A 作为 4 个关联角色场景运行
将 maya-master-001.png 上传到 Seedream v4.7 Sequential。保持参考图、提示词模板和 16:9 比例不变。使用此提示词:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya on a sunlit granite ridgeline, consulting a folded topographic map at sunrise, distant cloud-filled valley below. 4Image 2: Maya walking through a small mountain market, photographing bright woven textiles, soft morning activity behind her. 5Image 3: Maya at a timber cabin table, arranging printed contact sheets and a notebook beside a rain-speckled window. 6Image 4: Maya kneeling by a clear alpine lake, taking field notes while her camera rests on a rock, late-afternoon light. 7 8Keep the composition editorial and realistic. Leave clean negative space on the left third for possible marketing copy, but do not render any text.
使用实时页面实际公开的 sequential 或 coherent-batch 模式。仅接受能够明确映射到 maya-ridgeline-001 至 maya-lake-001 的输出。如果 playground 每个请求返回一个输出,而不是 4 个单独的子素材,请将同一锁定模板作为 4 个子作业提交。保留相同的参考哈希和参数,而不是假装该界面返回了它并未提供的功能。
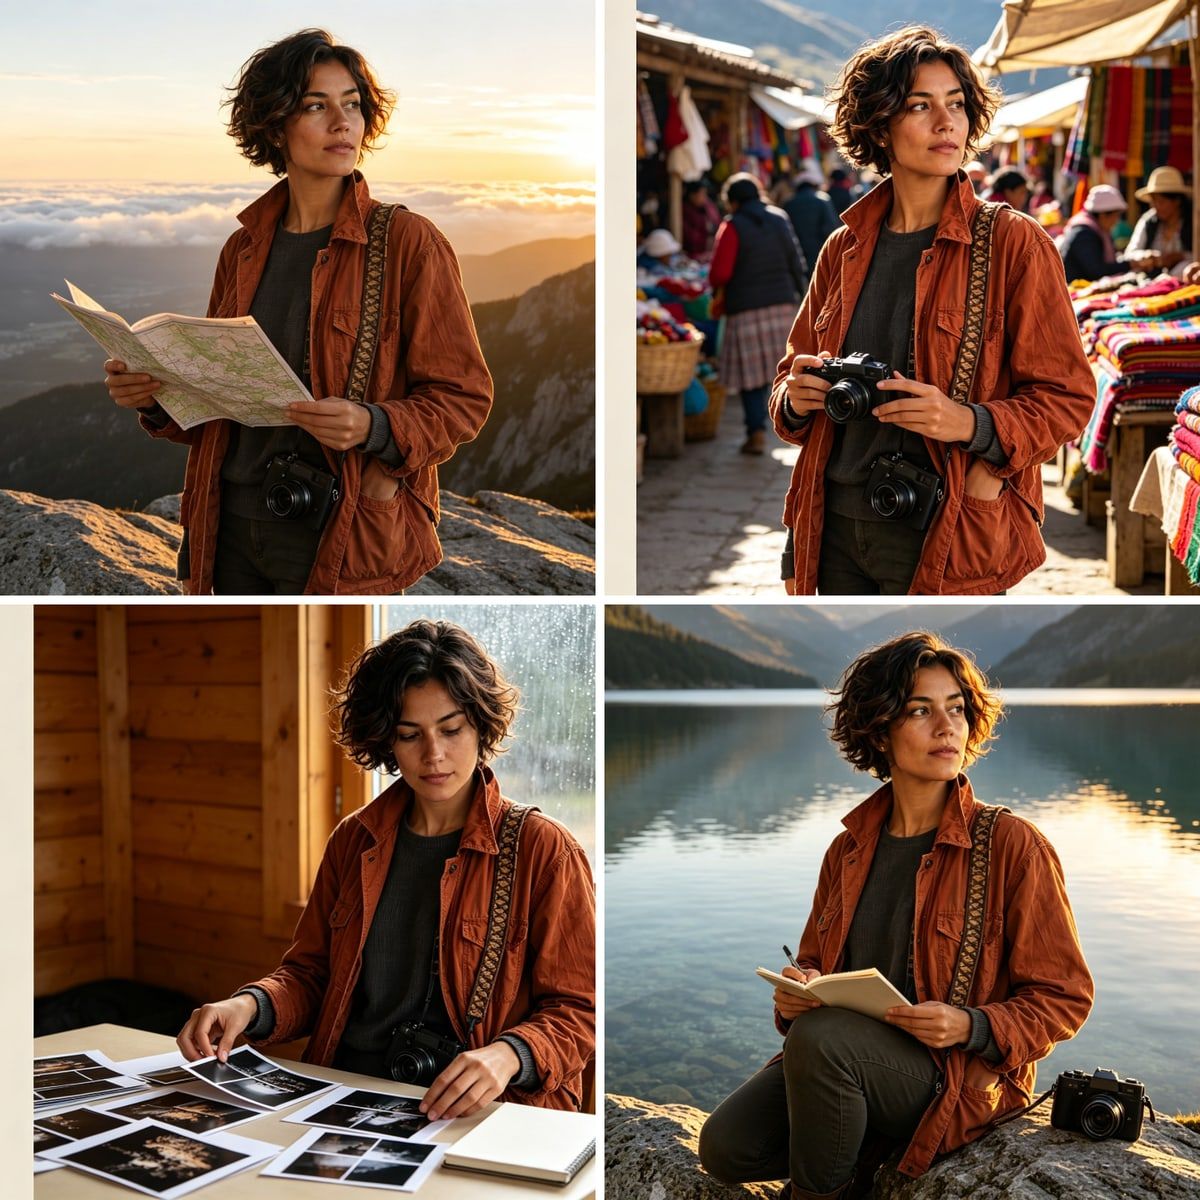
四张真实的 Seedream v4.7 Sequential Maya 场景输出以网格排列,并映射到 ridgeline、market、cabin 和 lake 素材 ID
批次 A 的 4 场景输出网格:即使模型产出了连贯序列,每一帧仍保持为单独的素材记录。
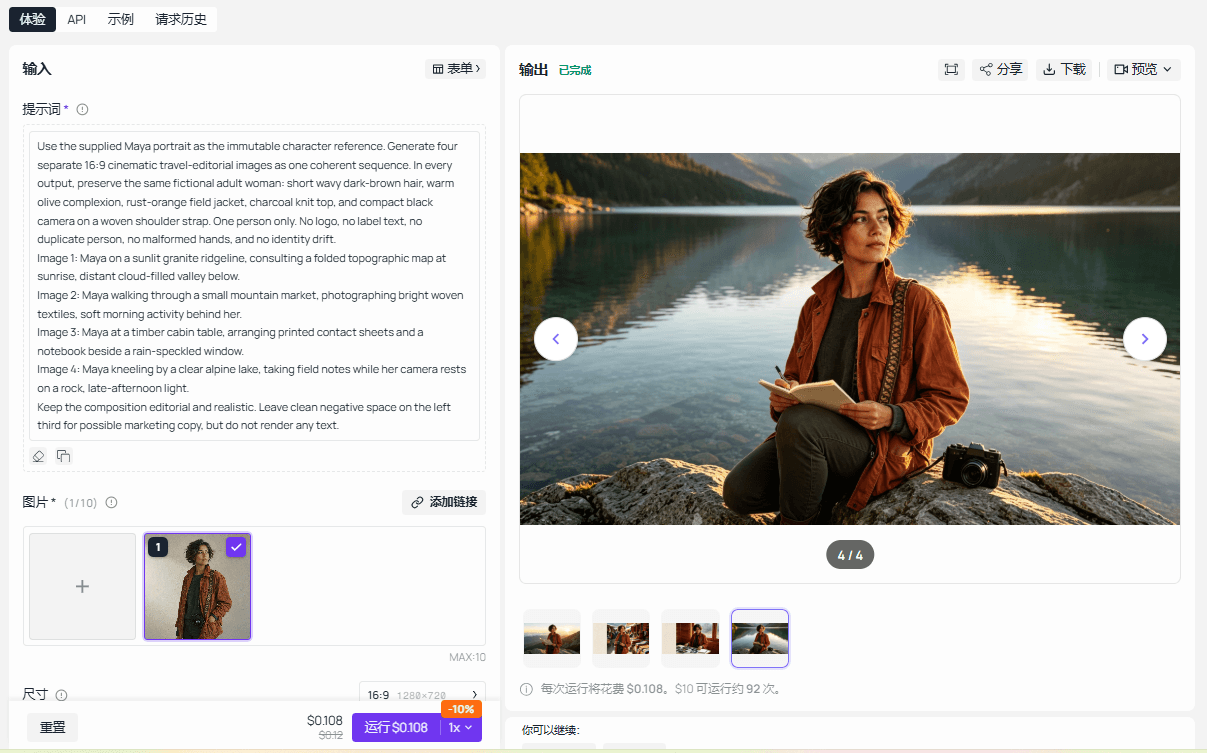
Seedream v4.7 Sequential playground 已完成,显示关联的 Maya 场景提示词及其真实输出
Atlas Cloud 上的 Seedream v4.7 Sequential,使用文章中关联的角色场景提示词和已完成的结果。
步骤 3:运行批次 B,然后停下来进行质量控制
复用已批准的主参考图。不要重新创建它,也不要重写身份规则。使用新的批次标签和相同的验收检查提交接下来的 4 个场景:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya moving through a mossy cedar forest on a narrow trail, camera raised toward a shaft of morning light. 4Image 2: Maya seated at a train-window table, reviewing contact sheets as a sunlit landscape blurs outside. 5Image 3: Maya at a weathered cabin workbench, packing film canisters, a lens cloth, and a folded paper map before departure. 6Image 4: close three-quarter portrait of Maya outdoors in light mist, camera strap visible, shallow depth of field, no text. 7 8Keep the same visual color treatment as the first sequence. Leave clean negative space on the left third where the composition permits, but do not render any text.
批次 B 之后,停止。在释放另一个营销活动序列之前,审核所有 8 条场景记录。这个暂停能捕捉队列所掩盖的各种漂移:头发或服装变化、出现第二个人、非请求的文字、畸形的手,或不再适合其渠道的场景。将审核者决策存储在素材旁边,而不是未跟踪的聊天消息中。
步骤 4:应用发布、重试或拒绝决策
当图像包含一个 Maya、在脸、头发、服装和相机方面与主参考图匹配、不包含破损文字或畸形解剖结构,并符合其分配场景时,将其标记为 approved。当 Maya 重复、漂移、丢失必要道具,或显示畸形手或文字时,将其标记为 retry。当构图无法服务于预期渠道,或角色不再可识别时,将其标记为 rejected。
对于重试,保留 maya-train-001 作为业务素材,并创建尝试 maya-train-001-a2。只提交该子作业,仅在提示词被有意版本化时才调整原始幂等键规格。不要仅仅因为一个场景需要修复就重新运行其他 7 个素材。
为批量生成选择模型
围绕工作单元选择模型,而不是排行榜。干净的主参考图和连贯的场景序列是不同的作业。对一张失败图像进行编辑又是另一回事。如果团队想通过一个 OpenAI 兼容集成来测试这些阶段,Atlas Cloud 提供了一个自然的地方来验证本示例中使用的两个模型页面。
| 作业 | 模型和工作方法 | 排队前需核实的价格背景 |
|---|---|---|
| 创建干净的角色主图 | GPT Image 2,一次 High-quality 16:9 运行,成为参考锚点 | GPT Image 2 Developer text-to-image 标价约为每张图像 $0.004,而标准版为 $0.009;截至 2026 年 9 月显示为 50% 折扣 |
| 构建连贯场景集 | Seedream v4.7 Sequential,跨子作业使用相同参考和锁定提示词 schema | 当前目录标价为每张图像 $0.03;生产前请核实实时输出模式和价格 |
| 修复一个失败素材 | GPT Image 2 编辑模式,仅限未通过审核的素材 | 在提交前确认编辑端点、输出尺寸、质量和当前价格 |
价格会因模型、模式和所选设置而变化。使用 Atlas Cloud 模型目录 在你排队工作当天重新核对可用性、折扣和确切模式。将表格视为估算输入,而绝不是促销声明或成本保证。
规模化前的质量控制、成本与权利
生成完成有 3 个不同含义:提供商报告成功、文件被正确归档,以及人工审核者接受其用于发布。让这 3 点在记录中都可见。已完成任务却缺少输出文件是运营失败。已保存文件却包含重复角色是创意失败。两者都不应自动进入发布环节。
使用足够简单、可应用于每个子素材的审核者清单:
| 检查 | 审核者问题 |
|---|---|
| 角色身份 | Maya 在脸、头发、服装和相机方面是否与已批准的主参考图匹配? |
| 对象数量 | 关键对象的数量是否恰好符合预期? |
| 提示词匹配 | 场景是否实现了分配的用例? |
| 文字伪影 | 是否存在不想要的、畸形的或不支持的文字? |
| 比例和文件名 | 保存的文件是否与清单记录匹配? |
| 权利审核 | 参考图和预期声明是否被允许用于此用途? |
运行后使用 approved asset cost = total completed attempts cost / approved assets 估算成本。这会暴露重试和被拒绝结果的成本,而不假装每张图像都有相同的最终成本。在开始前设置任务上限、批次上限和每日上限。如果达到其中任何一个上限,就暂停派发。
仅使用拥有、获许可或以其他方式允许的参考图像。在商业使用前,检查当前平台政策和模型条款。不要让模型编造认证、实验室结果、安全承诺、医疗声明或未经证实的产品规格。精致的输出并不能把不受支持的声明变成可发布的声明。
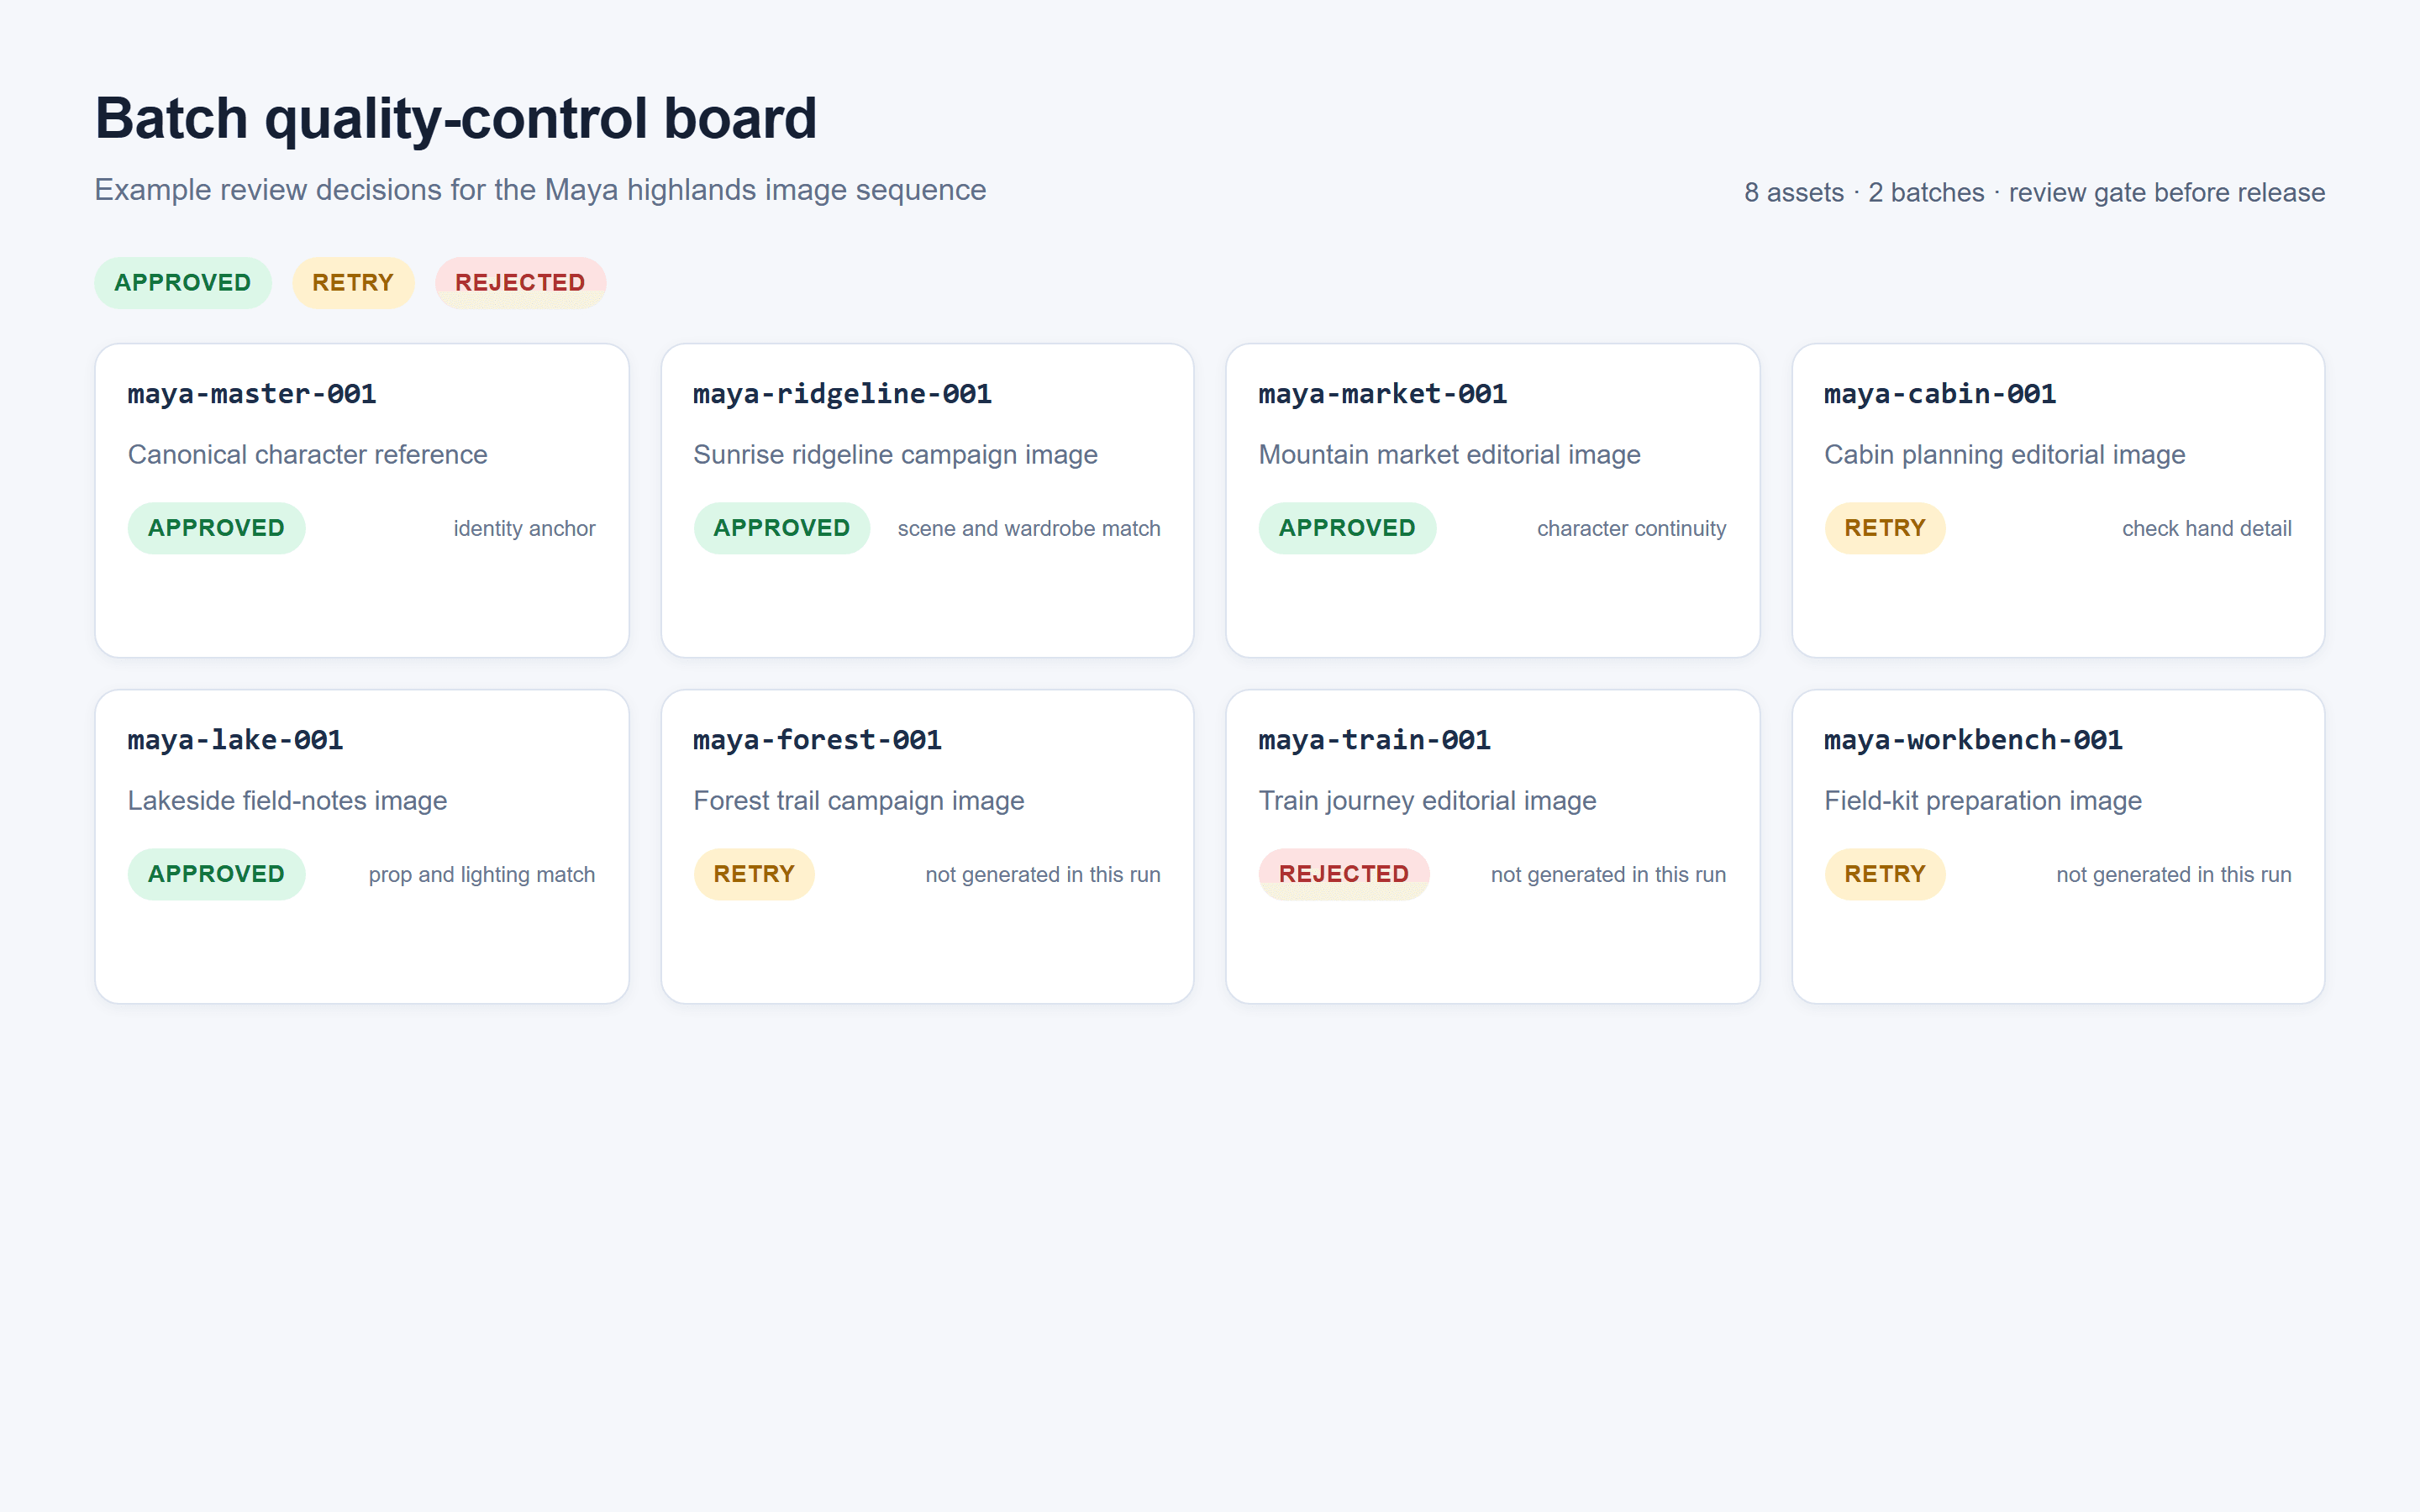
浏览器渲染的批量质量控制面板,显示 8 个 Maya 素材 ID 及其 approved、retry 和 rejected 审核状态
浏览器渲染的审核面板将真实运行文件映射回其 8 个素材 ID,并让发布、重试或拒绝决策清晰可见。
用于批量生成的 AI API:生产发布清单
在从 8 个素材练习转向实时目录或内容库之前,确认以下每一项。
- 每个素材都有一个不可变的
asset_id。 - 提示词、参考哈希、模型、比例和质量都有记录。
- 在提供商支持的情况下,每次提交都有一个幂等键。
- 并发保持低于账户实际文档化限制。
- 存在任务、批次和每日预算上限。
- 429 响应、5xx 响应、超时和内容拒绝遵循不同规则。
- 重试有硬性最大次数。
- 成功结果会立即归档并映射回源数据。
- 在释放下一组之前,通过小批次 QC 门禁。
- 最终抽样审核检查角色身份、文字、比例、文件名和权利。
这份清单让用于批量生成的 AI API 在规模增长时仍然有用。当编辑询问某张特定图像为何被生成、接受或重新运行时,它也留下了清晰的审计轨迹。
常见问题:用于批量生成的 AI API
什么是用于批量生成的 AI API?
它是一种提交许多独立 AI 任务、跟踪其执行并稍后收集结果的方式。好的实现会为每个任务保留持久化业务素材 ID,无论提供商使用的是异步批处理作业还是普通并发请求。
批处理 API 比并行发送图像请求更好吗?
两者都不会自动更好。当工作流需要即时进度时,使用受控并行请求。当其文档化的队列、周转时间和成本规则适合你的工作时,对于非紧急的量使用提供商批处理作业。两者都需要按素材记录日志和审核。
一个批次中应该放多少张 AI 图像?
在验证新的提示词 schema 或角色参考图时,从 4 到 8 个视觉素材开始。只有在团队能够映射每个结果、快速发现漂移,并在不重启整组的情况下恢复失败的子作业之后,再增加数量。提供商限制可能允许更多,但运营上有用的批次是可审核的批次。
幂等键如何防止重复生成成本?
它们在重试后把一次提交标识为同一预期操作。如果端点支持幂等性,提供商可以避免将重复网络调用视为一次全新生成。将密钥与素材记录一起存储,并在提供商文档中确认确切语义。
我可以从同一角色参考图批量生成图像吗?
可以。使用一张已批准、获许可的参考图像;将其哈希附加到每个子作业;锁定身份指令;并在扩展前审核一个小场景组。参考一致性会减少歧义,但不能替代视觉 QC。
我应该重试整个失败批次,还是只重试失败素材?
只重试失败素材。先归档成功项,对失败进行分类,并为受影响的子作业创建新的尝试记录。整批重新提交更可能导致重复素材和不必要支出。


