DeepSeek Harness 并未参与该基准测试。它在两天后才发布。这意味着有用的问题不是“哪个赢了?”而是如何用同一个模型、通过两个工具运行相同的任务,并读取账单而不自欺欺人。
关键要点
- 在可比的智能体任务中,工具链的选择可使 token 消耗波动约 7 倍。
- 使用相同的模型和相同的仓库状态来测量 DeepSeek Harness 和 OpenCode。
- 在选定日常使用的工具前,分别使用独立的 API 密钥。
两台笔记本电脑通过两个智能体工具链运行相同的编码任务
公平的设置:一个模型、一个任务、两个终端。
公开基准测试告诉我们什么
Composio 通过 8 个智能体工具链运行了 30 个复杂的多应用工作流,全部使用 DeepSeek V4 Flash,每个任务限时 900 秒,并在 240 次运行中进行二进制程序化评分(Composio,2026 年 8 月)。相同模型,不同工具链。
| 工具链 | 通过率 | 中位时间 | 平均每个任务的 token 数 |
|---|---|---|---|
| Pi Agent | 66.7% | 132.2s | 559,000 |
| Prime Agent | 62.5% | 242.1s | 1,400,000 |
| OMP | 56.7% | 272.4s | 742,000 |
| Claude Code | 53.3% | 122.7s | 742,000 |
| Codex | 53.3% | 245.0s | 678,000 |
| DeepAgents | 53.3% | 187.1s | 665,000 |
| Hermes Agent | 50.0% | 175.5s | 192,000 |
| OpenCode | 46.7% | 129.7s | 692,000 |
token 列比排名更重要。平均每个任务的 token 数从 192,000 到 1,400,000 不等。这是同一个模型通过不同运行时完成类似工作时的差异。
OpenCode 提供了一个有来源的基线:每个任务 692,000 token,通过率 46.7%,中位时间 129.7 秒。DeepSeek Harness 没有来自该基准测试的公开对比数据,因为 DeepSeek 于 2026 年 8 月 13 日发布,比基准测试发布晚了两天。
把这张表当作警告,而非定论。它表明工具链可以主导成本。它并不能证明在你的仓库中 DeepSeek Harness 是否优于 OpenCode。
切换工具链时会发生什么变化
在测试之前,从影响开发者的方面比较这两个工具:设置复杂度、成熟度、token 可见性以及你可以替换多少智能体循环。
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| 来源 | DeepSeek AI | Anomaly(原 SST) |
| 发布日期 | 2026 年 8 月 13 日 | 2025 年末 |
| GitHub 星标 | ~143k | ~198k |
| 许可证 | MIT | MIT |
| 语言 | TypeScript | Go |
| 界面 | Web UI 运行于 127.0.0.1:3080 | 终端 TUI |
| 状态 | 开发者预览版,预计会有破坏性变更 | 成熟,已广泛部署 |
| 架构 | 可替换的模型、工具、会话、沙箱、存储、循环和 UI 插件 | 固定核心,支持构建/计划智能体、MCP 和 LSP 扩展 |
| 配置 | $DSH_HOME/settings.yaml | opencode.json |
| Token 统计 | Token 仪表盘,包含上下文压力和分解预测 | 会话内 token 和成本追踪,显示在 TUI 中 |
| 适用场景 | 希望修改智能体循环本身的团队 | 希望今天就能使用的编码智能体的团队 |
OpenCode 为你提供一个稳定的编码智能体,并在边缘提供扩展点。DeepSeek Harness 则提供了一个运行时,其循环本身可以替换。这种灵活性在你构建智能体基础设施时很有帮助。如果你需要本周内用于生产代码的默认工具,则会增加风险。
两个工具都可以访问相同的 OpenAI 兼容端点。这使得公平测试成为可能:一个模型、一个基础 URL、一个任务、一个起始仓库状态。
在本教程中,DeepSeek V4 Flash 通过 Atlas Cloud 运行,它暴露了一个两个工具都接受的 OpenAI 兼容端点。deepseek-v4-flash-0731 列表显示每百万输入 token 0.14 美元,每百万输出 token 0.28 美元,上下文窗口 1,048,576 token,最大输出 393,216(截至 2026 年 8 月)。只要两个工具链使用相同的端点和模型 ID,任何提供商都可以。
OpenCode 还发布聚合使用数据。DeepSeek 模型通过 OpenCode 已移动了 233 万亿 token,其中 V4 Flash 占 85.5%,V4 Pro 占 14.5%(OpenCode,2026 年 8 月)。这种使用模式使 V4 Flash 成为比较中的实用默认选择。
步骤 1:将两个工具指向同一个模型
创建一个 API 密钥和一个基础 URL,然后将相同的对提供给两个工具。在 Atlas Cloud 控制台 中创建密钥,并导出一次:
plaintext1export ATLAS_API_KEY="your-api-key" 2
在将端点交给任何工具链之前,先检查端点:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Reply with the single word: ready"}] 7 }' 8
该调用证明路由、密钥和模型 ID 在工具链添加工具、重试或对话回放之前是有效的。
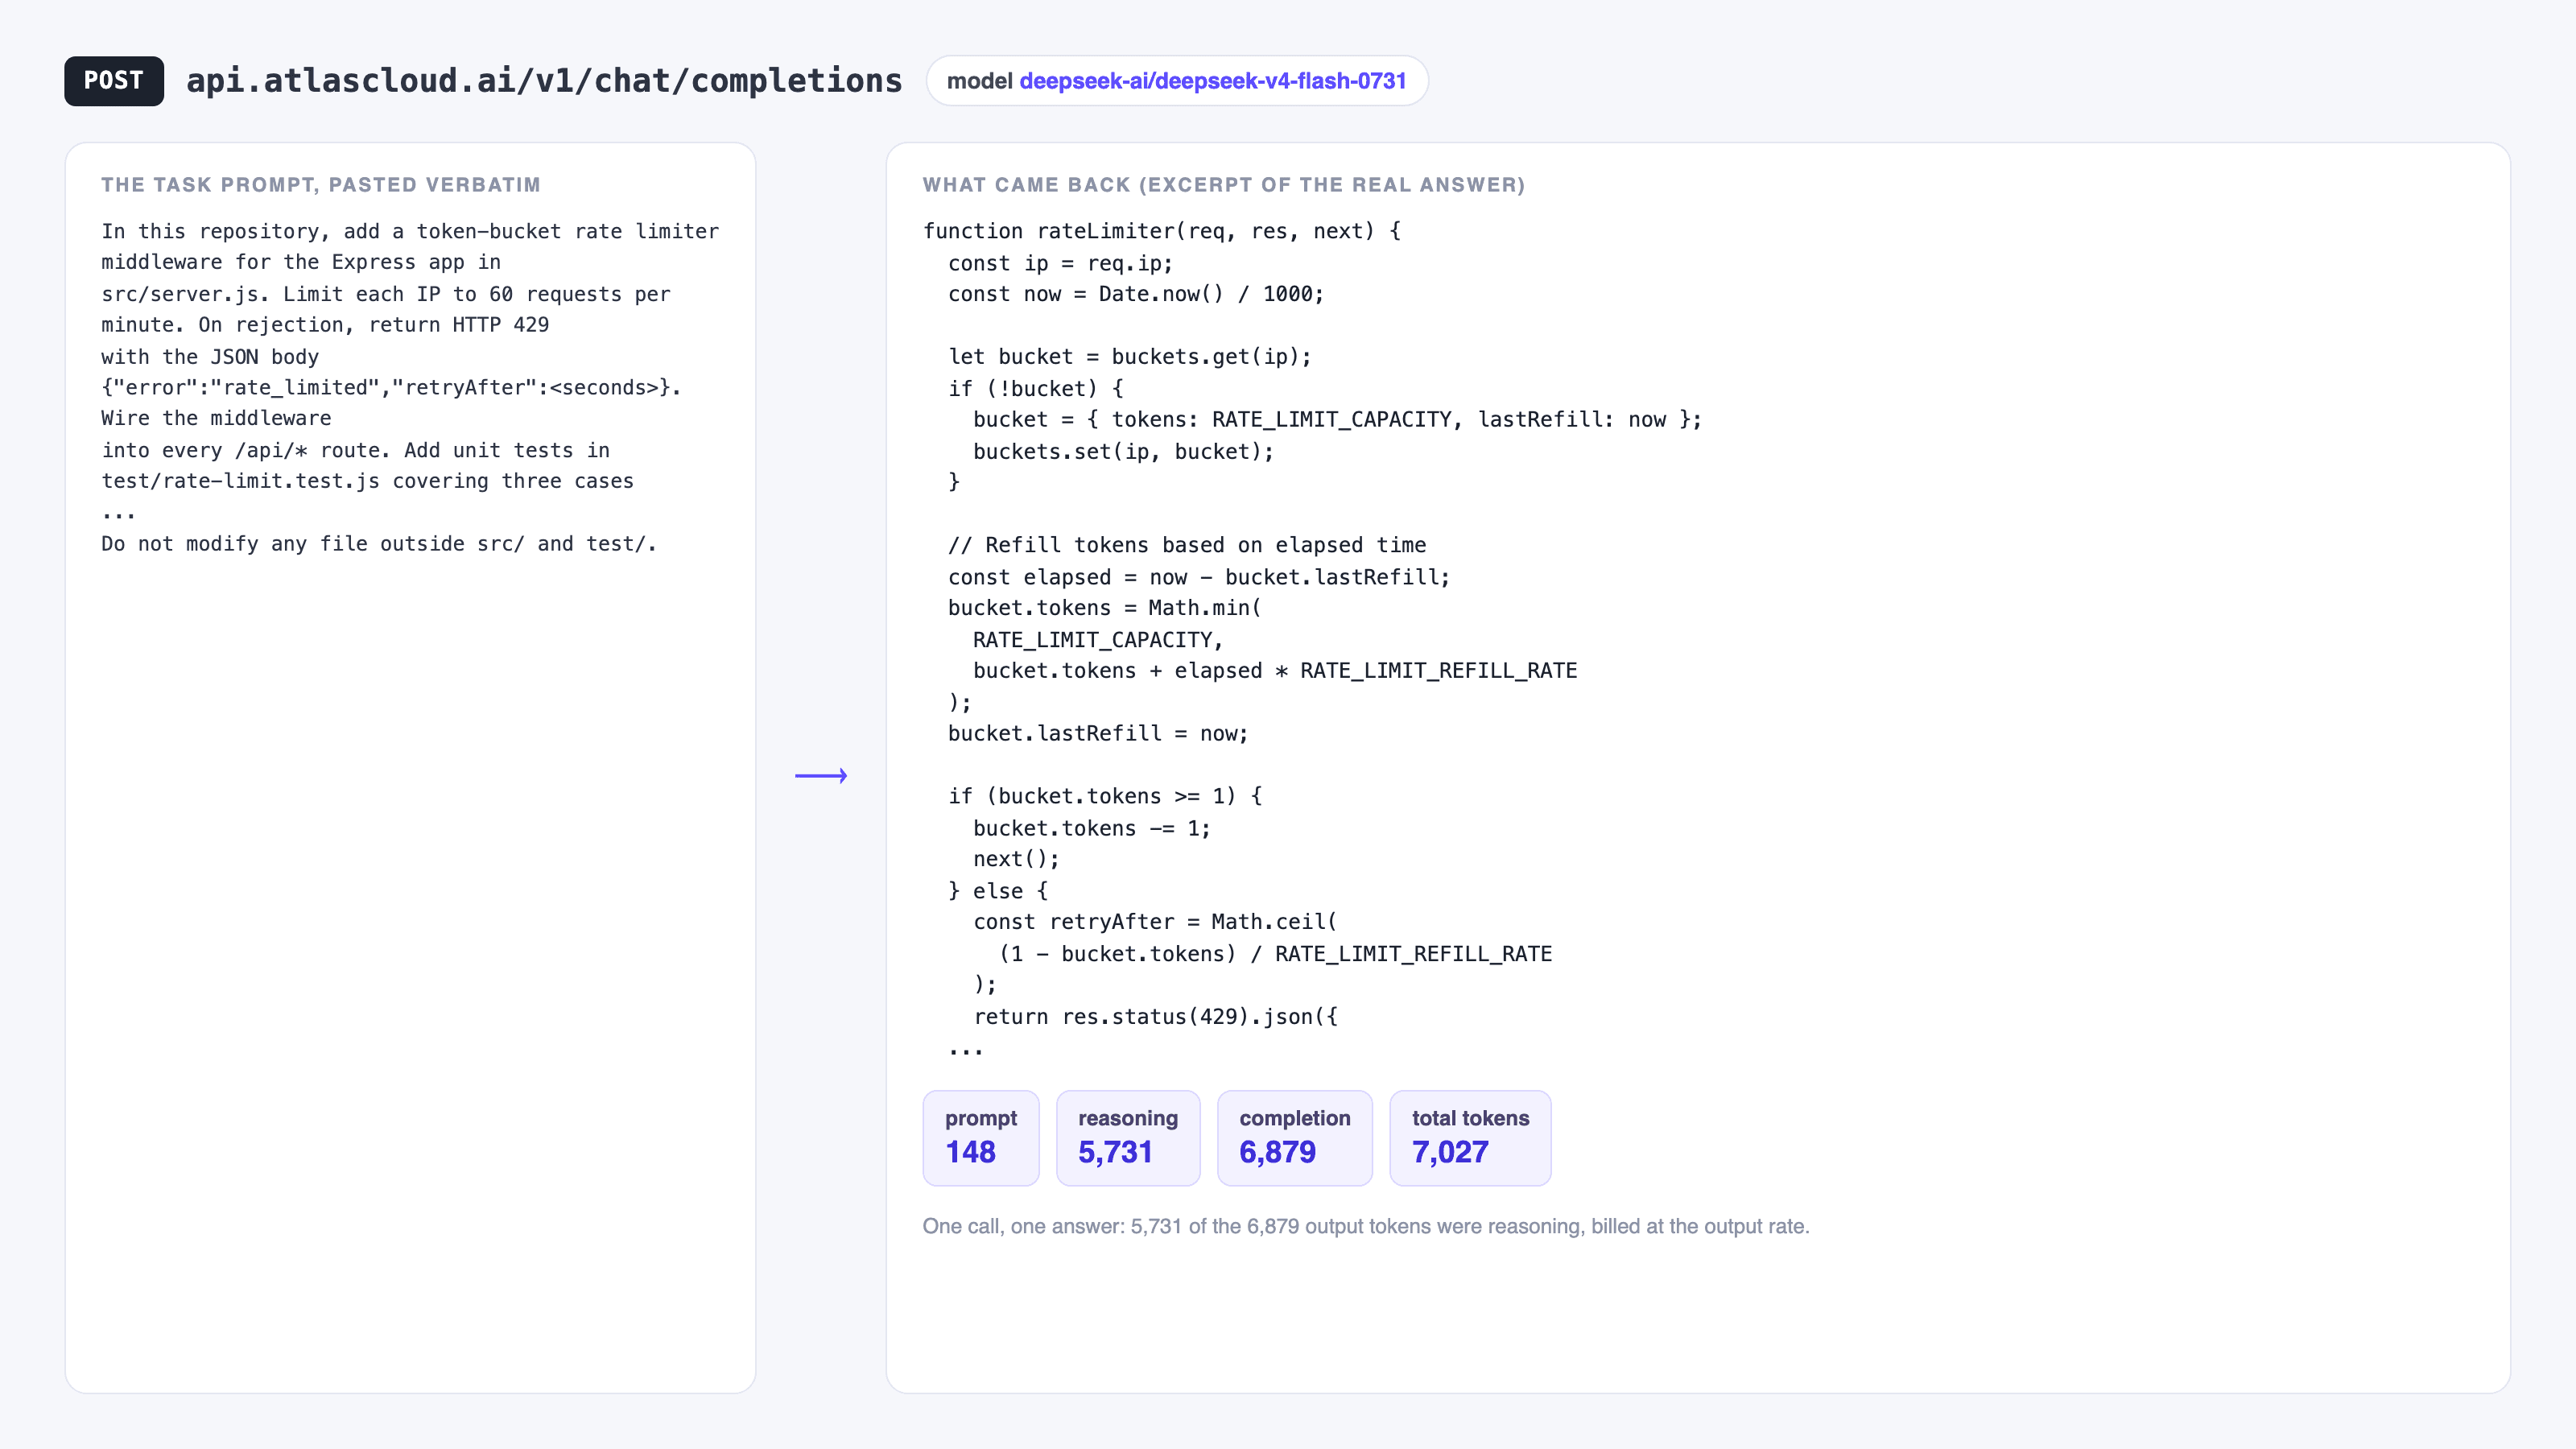
对 deepseek-ai/deepseek-v4-flash-0731 的一次直接调用:输入 148 个 prompt token,输出 6,879 个 token,其中包含 5,731 个推理 token。将其视为工具链添加工具模式和历史之前的基准。
DeepSeek Harness 读取 $DSH_HOME/settings.yaml,自定义 OpenAI 兼容的提供商在 llm-pi-ai 插件下配置(DeepSeek Harness 文档,2026 年 8 月):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
此端点使用 openai-completions。Web UI 也可以从设置、模型、添加自定义提供程序写入相同的提供程序块,然后将密钥存储在 $DSH_HOME/.credentials.yaml 中。
OpenCode 读取项目根目录或全局配置目录中的 opencode.json(OpenCode 文档,2026 年 8 月):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
使用 @ai-sdk/openai-compatible,因为此端点提供 /v1/chat/completions。设置真实的上下文和输出限制。OpenCode 在决定何时总结时使用它们,错误的限制可能会扭曲 token 比较。
步骤 2:在 DeepSeek Harness 中运行相同的基准任务
选择一个足够大需要多次工具调用、又足够小可以评分的任务。两次运行使用相同的仓库状态,因此在开始之前提交或暂存。
将以下确切任务粘贴到两个工具中:
plaintext1在这个仓库中,为 src/server.js 中的 Express 应用添加一个令牌桶限流中间件。 2将每个 IP 限制为每分钟 60 个请求。拒绝时,返回 HTTP 429,JSON 体为 {"error":"rate_limited","retryAfter":<seconds>}。 3将中间件连接到每个 /api/* 路由。在 test/rate-limit.test.js 中添加单元测试,涵盖三种情况: 4低于限制的请求被允许,超过限制的请求被阻止并返回 429,计数器在窗口过期后重置。 5运行测试套件并修复失败,直到通过。不要修改 src/ 和 test/ 之外的任何文件。 6
从项目目录启动 Harness:
plaintext1cd /path/to/your/repo 2npx @deepseek-ai/dsh web 3
UI 运行在 http://127.0.0.1:3080。选择 atlas 提供商和 deepseek-ai/deepseek-v4-flash-0731 模型,粘贴任务,让它完成。运行开始后不要添加提示。对一个工具的额外帮助会使比较无效。
当 Harness 完成后,打开 Trajectory 视图。该会话记录包含其 token 数量。
步骤 3:在 OpenCode 中重复运行
将仓库重置到确切的起始状态。第二个工具链不能继承第一个工具链已经更改的文件。
plaintext1git checkout -- . && git clean -fd 2
然后针对相同的模型运行 OpenCode:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
粘贴步骤 2 中的相同任务提示。使用默认的 build 智能体。让它完成,不要提示。
使用相同的命令对两次运行评分:
plaintext1npm test 2
即使智能体摘要听起来很自信,如果运行使测试套件变红,则失败。使用二进制评分:通过或失败。
步骤 4:读取 token 使用量
两个工具都跟踪使用情况,但两个计数器都不应该是你的最终账单数字。
DeepSeek Harness 默认挂载了一个 token 仪表盘。它在 Trajectory 视图中暴露了 tokenUsage、contextPressure 和 contextBreakdown。contextBreakdown 告诉你账单来自系统提示、工具模式、文件读取还是对话回放。仪表盘大致估算每个 token 对应四个字符,因此将其用作诊断视图。
OpenCode 跟踪每个会话的 token 和成本,并在 TUI 状态行中显示。其内置分解较小,因此需要按工具归因的团队通常使用外部分析器检查会话数据库。
使用提供商侧的数字进行比较:
| 比较内容 | 获取位置 |
|---|---|
| 总输入 token | 提供商使用情况仪表盘,按 API 密钥 |
| 总输出 token | 提供商使用情况仪表盘,按 API 密钥 |
| 模型调用次数 | Harness 轨迹视图 / OpenCode 会话日志 |
| 挂钟时间 | 秒表,从开始到最后一次文件写入 |
| 通过或失败 | npm test 退出代码 |
创建两个 API 密钥,harness-test 和 opencode-test,每次运行使用一个密钥。提供商仪表盘会为你提供并排的干净使用数据,而无需协调两个内部估算器。
为什么账单会变化
Token 使用量因具体原因而变化。以下五个因素通常比模型价格更重要。
对话回放累积成本。 智能体在每一步重新发送不断增长的对话。一个 40 步的任务的成本更接近 40 个不断增长的提示的总和,而不是 40 个相同提示的总和。早期总结的工具链更接近基准测试的低端。
缓存命中可降低输入成本。 DeepSeek V4 Flash 缓存命中价格约为每百万 token 0.0028 美元,而未命中为 0.14 美元,便宜约 98%。缓存需要字节级稳定的前缀。如果工具链在调用之间打乱系统提示文本,则会将命中变为未命中。
工具模式会被携带。 二十个连接的 MCP 服务器意味着 prompt 中有二十个模式集,即使任务只使用其中两个。在基准测试之前断开不需要的工具,否则你测量的是工具设置而不是工具链。
大型工具输出污染上下文。 cat 一个 3000 行的文件或冗长的失败测试日志会保留在对话中供后续调用使用。DeepSeek Harness 可以在总结之前修剪过大的工具结果。当任务产生嘈杂输出时,请打开该功能。
重试隐藏在调用次数中。 一个重试失败测试循环的工具链每次都会消耗 token。将模型调用次数与总 token 数一起比较,以便将重试循环与昂贵的 prompt 分开。
以 Atlas Cloud 的 DeepSeek V4 Flash 费率计算,一个 692,000 token 的任务(偏向输入)成本在个位数美分。对于一次运行来说很小,但对于全天运行智能体的团队来说则很大。如果你想在第二个模型上重复测试并分离模型效应与工具链效应,请浏览完整的模型目录。
DeepSeek Harness 仍然是开发者预览版,其 README 警告会有破坏性变更。如果你希望控制智能体循环,请对其进行基准测试。只有当你的团队能够承受变更时,才将其标准化。对于今天需要一个工具的团队来说,OpenCode 是更稳定的选择。
常见问题
DeepSeek Harness 比 OpenCode 更好吗?
对大多数团队来说还不是。OpenCode 成熟、基于终端、拥有约 198k 星标和庞大的提供商目录,并且今天就能工作。DeepSeek Harness 较新,处于开发者预览版,并警告会有破坏性变更。如果你希望修改智能体内部机制,选择 Harness。如果你希望一个用于日常工作的编码智能体,选择 OpenCode。
DeepSeek Harness 只适用于 DeepSeek 模型吗?
不。它与模型无关。它附带 DeepSeek、Anthropic、OpenAI、Bedrock、Vertex、Azure 和 Codex 的目录提供商,并且你可以在 $DSH_HOME/settings.yaml 中添加任何支持 openai-completions、openai-responses 或 anthropic-messages 的自定义提供商。步骤 1 的配置将其指向一个无需适配器代码的 OpenAI 兼容端点。
如何检查 DeepSeek Harness 的 token 使用量?
使用 Trajectory 视图中内置的 token 仪表盘。它暴露了 tokenUsage、contextPressure 和 contextBreakdown。将其视为估算值,因为它大致使用每个 token 对应四个字符。为了计费准确性,请读取提供商使用情况仪表盘,理想情况下每次运行使用专用的 API 密钥。
哪个工具链使用的 token 更少,DeepSeek Harness 还是 OpenCode?
目前没有公开的对比基准测试能回答这个问题。Composio 基准测试测量 OpenCode 平均每个任务 692,000 token,但它在 DeepSeek Harness 发布之前运行。请在自己的仓库上运行步骤 2 到步骤 4 的测试,因为 token 使用量取决于代码库大小、工具设置和任务形状。
我可以将 DeepSeek Harness 和 OpenCode 针对同一个 API 密钥运行吗?
是的,用于临时测试。为了干净的测量,请使用两个独立的密钥,每个工具链一个。提供商仪表盘会将每个 token 归因到正确的运行。
智能体和工具链有什么区别?
DeepSeek 将智能体描述为模型加工具链。模型进行推理。工具链将模型连接到文件、shell 命令、工具、会话、批准以及决定下一步操作的循环。更改工具链后,同一个模型可以在同一个任务上消耗不同数量的 token。


