

目前在 Google 上仍名列前茅的 DeepSeek vs ChatGPT 文章,大多还在对比两个应用早已不再运行的模型。DeepSeek 于 2026 年 10 月 17 日将官网和应用切换到 V4.1 Flash 1017。ChatGPT 于 10 月 7 日将 Plus 及更高方案切换到 GPT-6 Sol,次日 Free 和 Go 切换到 GPT-6 Luna。因此,我们通过一个 API 密钥向两款当前模型发送了五条相同的提示词,对答案进行评分,并记录了响应耗时。下文包括:评分表、来自两家公司自有页面的隐私事实,以及 Claude 的定位。
核心要点
- DeepSeek 的应用现在运行 V4.1 Flash 1017,而 ChatGPT Plus 运行 GPT-6 Sol,所以大多数旧对比已经过时。
- 在五条相同的提示词上,两款模型每次都给出了正确答案,在编程、数学或文档处理方面没有质量差距。
- GPT-6 Sol 在每项任务上使用的 token 都更少;DeepSeek 在推理上花费的输出 token 最多达 4.2 倍。
- DeepSeek 的隐私政策声明应用数据存储在中国;模型权重本身采用 MIT 许可,可自行托管。
- 你可以通过 Atlas Cloud 上的 DeepSeek 和一个密钥并排运行两款模型,以及 OpenAI 系列。
DeepSeek vs ChatGPT 一览(2026 年 10 月)
在评分之前,先了解每个名字如今实际指向什么会有所帮助。“DeepSeek”是一家模型公司,其聊天应用运行一个默认模型。“ChatGPT”是一个产品,会根据你的方案将你路由到不同的 OpenAI 模型。
| DeepSeek | ChatGPT | |
|---|---|---|
| 开发者 | DeepSeek(中国杭州) | OpenAI(美国旧金山) |
| 当前应用背后的模型 | V4.1 Flash 1017,自 2026 年 10 月 17 日起在官网、应用和 API 上线 | Plus、Pro、Business 和 Enterprise 使用 GPT-6 Sol;Free 和 Go 使用 GPT-6 Luna |
| 免费方案 | 整个应用。DeepSeek 的发布文章将其描述为免费、无广告且无应用内购买 | 免费层级,对上传、图像和语音有使用限制 |
| 付费方案 | 消费级应用无付费方案 | Go、Plus、Pro(三个层级)、Business、Enterprise |
| 开放权重 | 是,V4.1 Flash 1017 以 MIT 许可发布 | 否 |
| 接受图像作为输入 | 是,V4.1 Flash 具备原生视觉能力 | 是 |
| 生成图像和语音 | 否,模型仅输出文本 | 是,通过 ChatGPT Images 2.5 和 GPT-Live 语音 |
该表刻意不涉及答案质量。这正是下文测试的目的。
从 DeepSeek 3.1 vs ChatGPT 5 到今天的版本
“deepseek 3.1 vs chatgpt 5”的搜索仍然会出现,而这种配对在 2025 年 8 月是合理的:DeepSeek V3.1 于 8 月 21 日发布,比 8 月 7 日的 GPT-5 晚两周。自那以后,两家公司都已发布四到五次重大更新。下面的时间线说明了为什么 2026 年初的对比在每一方都可能落后两代。
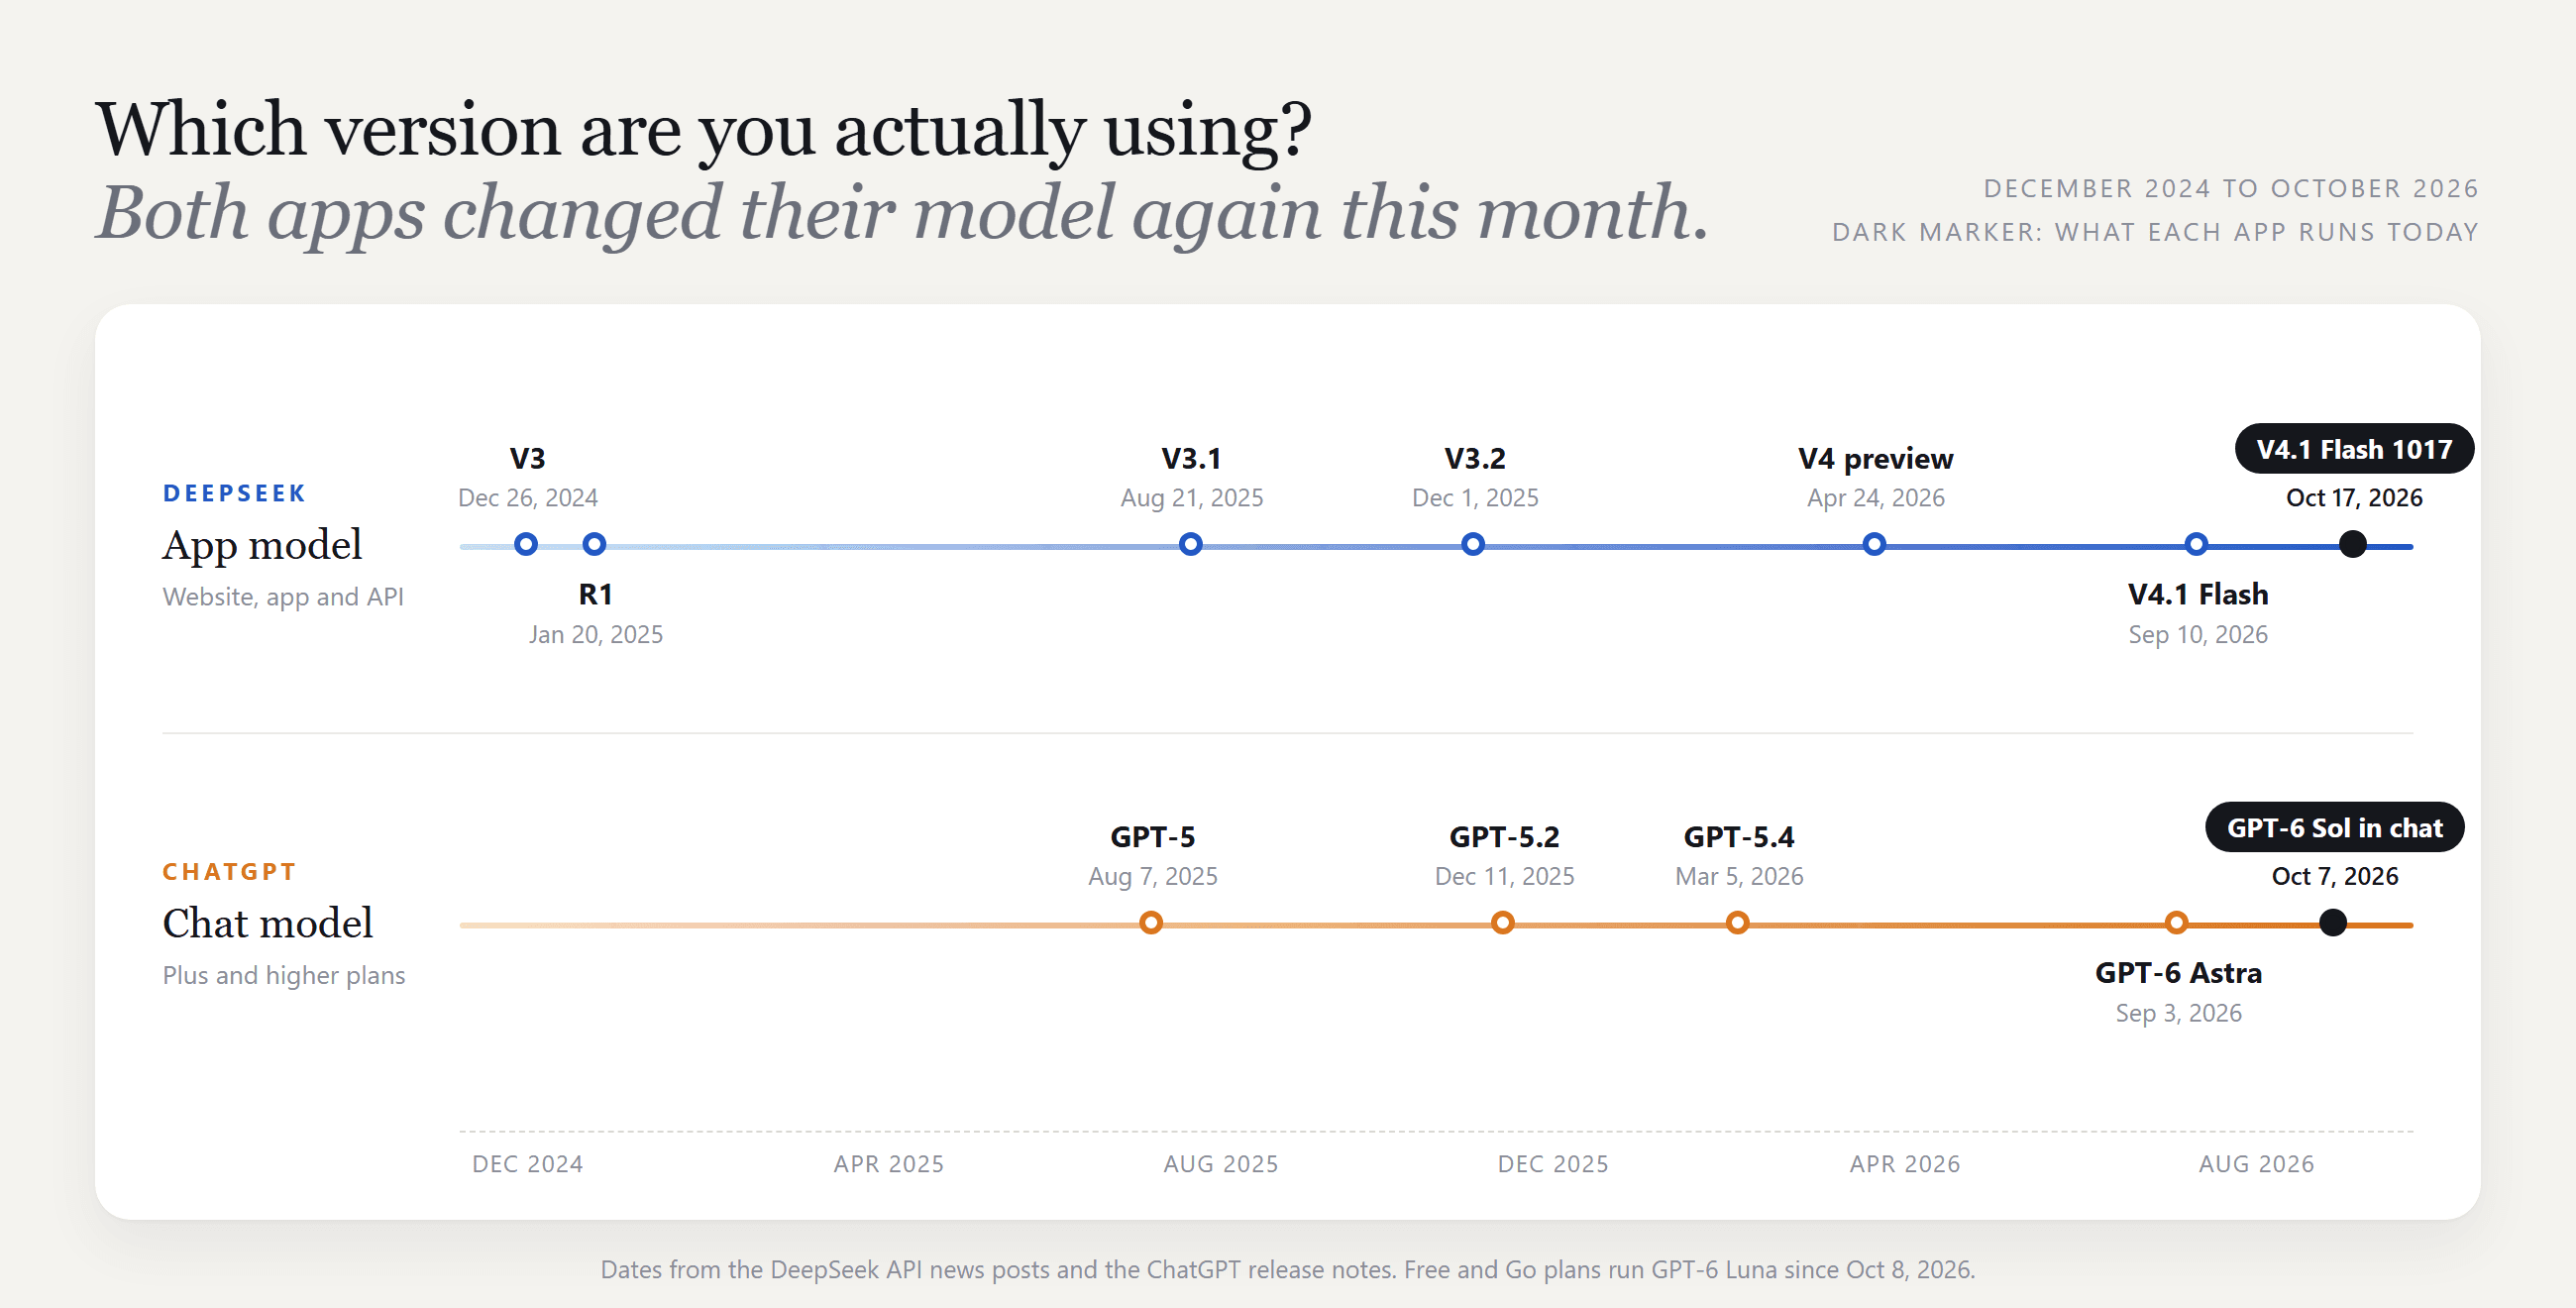
有两个细节对解读任何基准测试都很重要。DeepSeek 的 1017 版本是 V4.1 Flash 的一个点更新,DeepSeek 描述说它的输出比 9 月版本更短。另一方面,根据 2026 年 10 月 7 日的 ChatGPT 发布说明,GPT-6.1 Sol 存在于 ChatGPT Work 和 Codex 中,但聊天标签页本身运行的是 GPT-6 Sol。我们测试的是聊天标签页模型,因为这是 Plus 订阅者所获得的。
我们如何用一个 API 密钥对比 ChatGPT vs DeepSeek
并排测试两个聊天应用意味着两个账户、两套使用限制,而且无法判断某个应用是否悄悄将你路由到了更小的模型。我们通过 Atlas Cloud 调用两款模型来避免这一点,该平台在同一个 chat completions 端点后提供 DeepSeek 系列和 OpenAI 系列。相同的提示词、相同的参数、同一天,请求中的模型 ID 会准确告诉你哪个版本作出了回答。
方法 1:在 Atlas Cloud 游乐场中运行两者
快速检查无需代码。登录后,在一个标签页中打开 DeepSeek V4.1 Flash 1017 游乐场,在另一个标签页中打开 GPT-6 Sol 游乐场,然后:
- 将相同的提示词粘贴到每个页面的消息框中。
- 点击发送箭头。DeepSeek 会在答案上方显示一个可折叠的 Thinking Process 面板;GPT-6 Sol 直接返回答案。
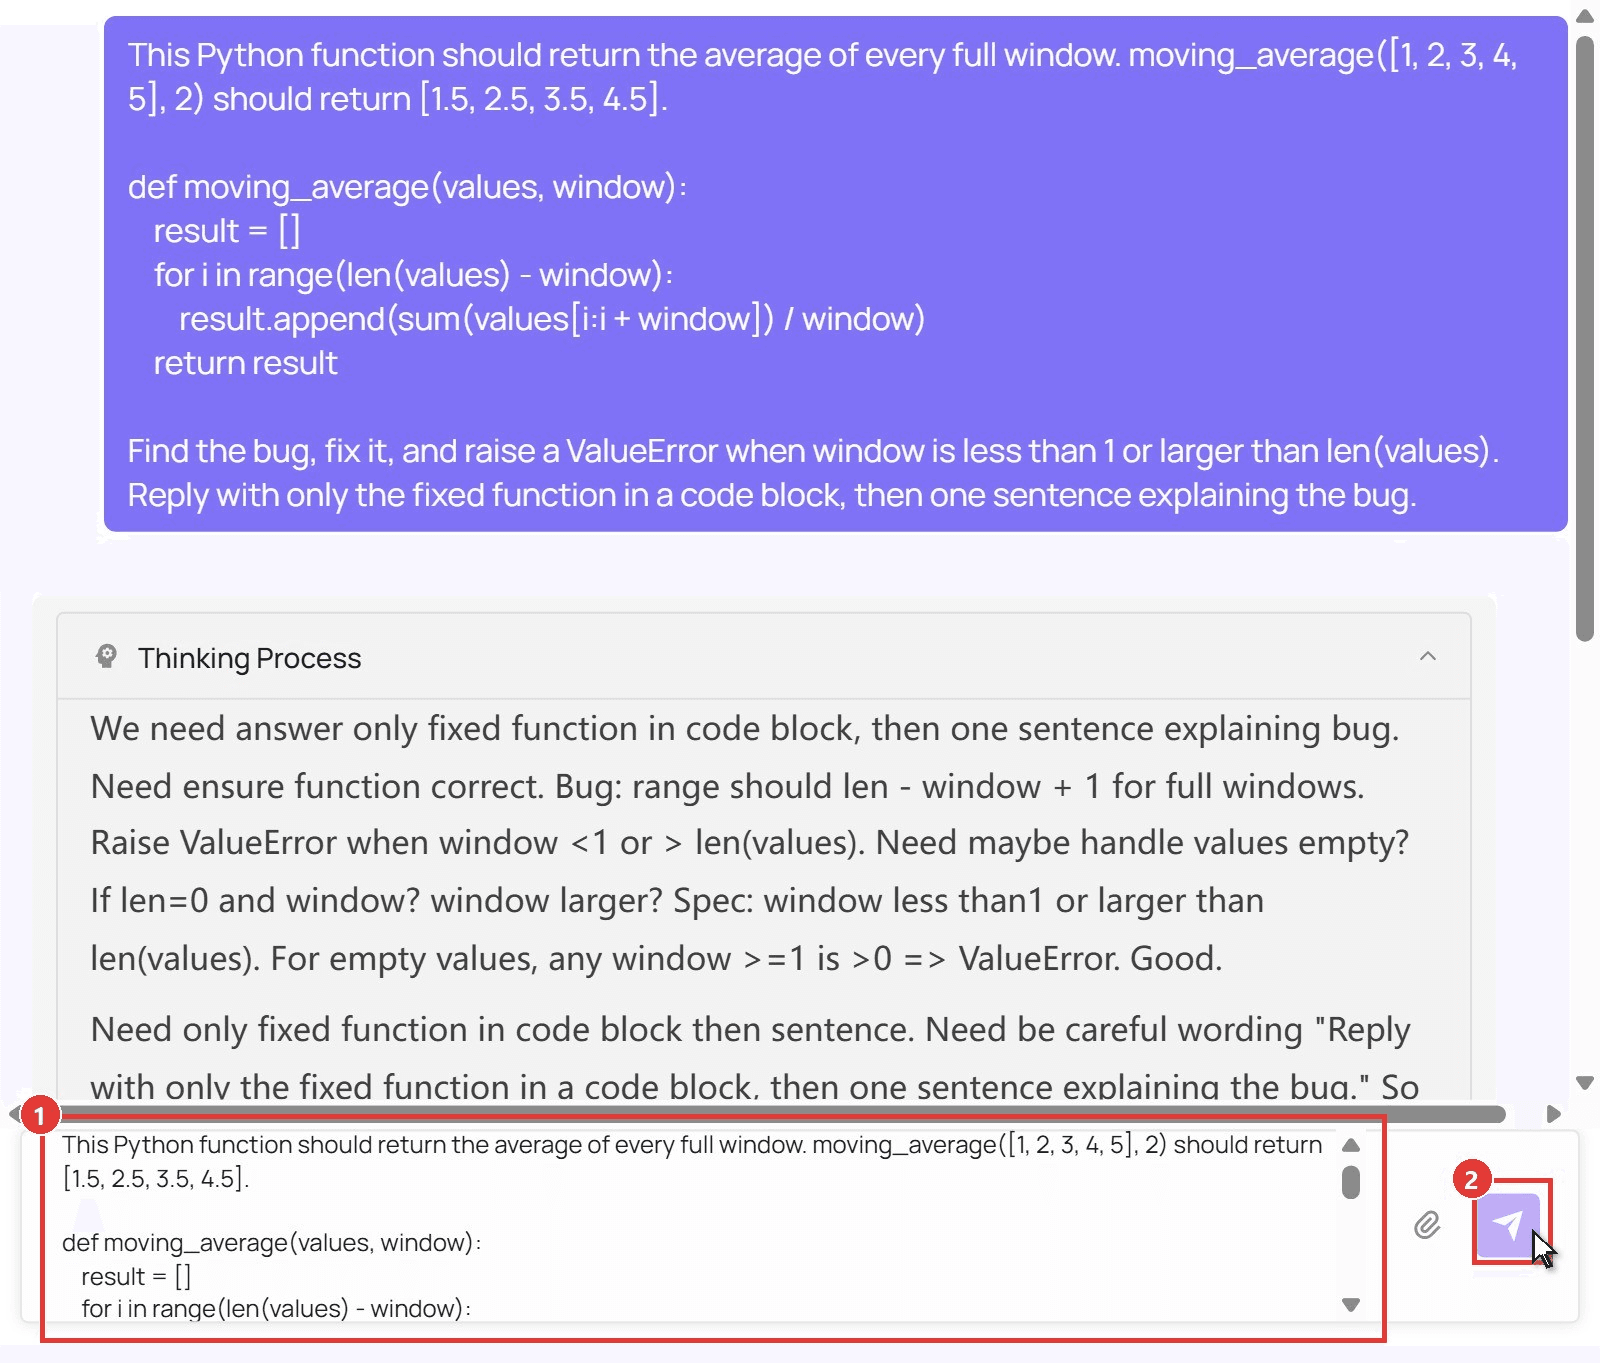
每次运行都会记录在 Request History 中,因此你之后可以重新打开两个答案,而无需重新运行它们。
方法 2:通过 API 发送相同的提示词
如需可重复的测试,或将任一模型接入你自己的应用,请使用 API。共三步。
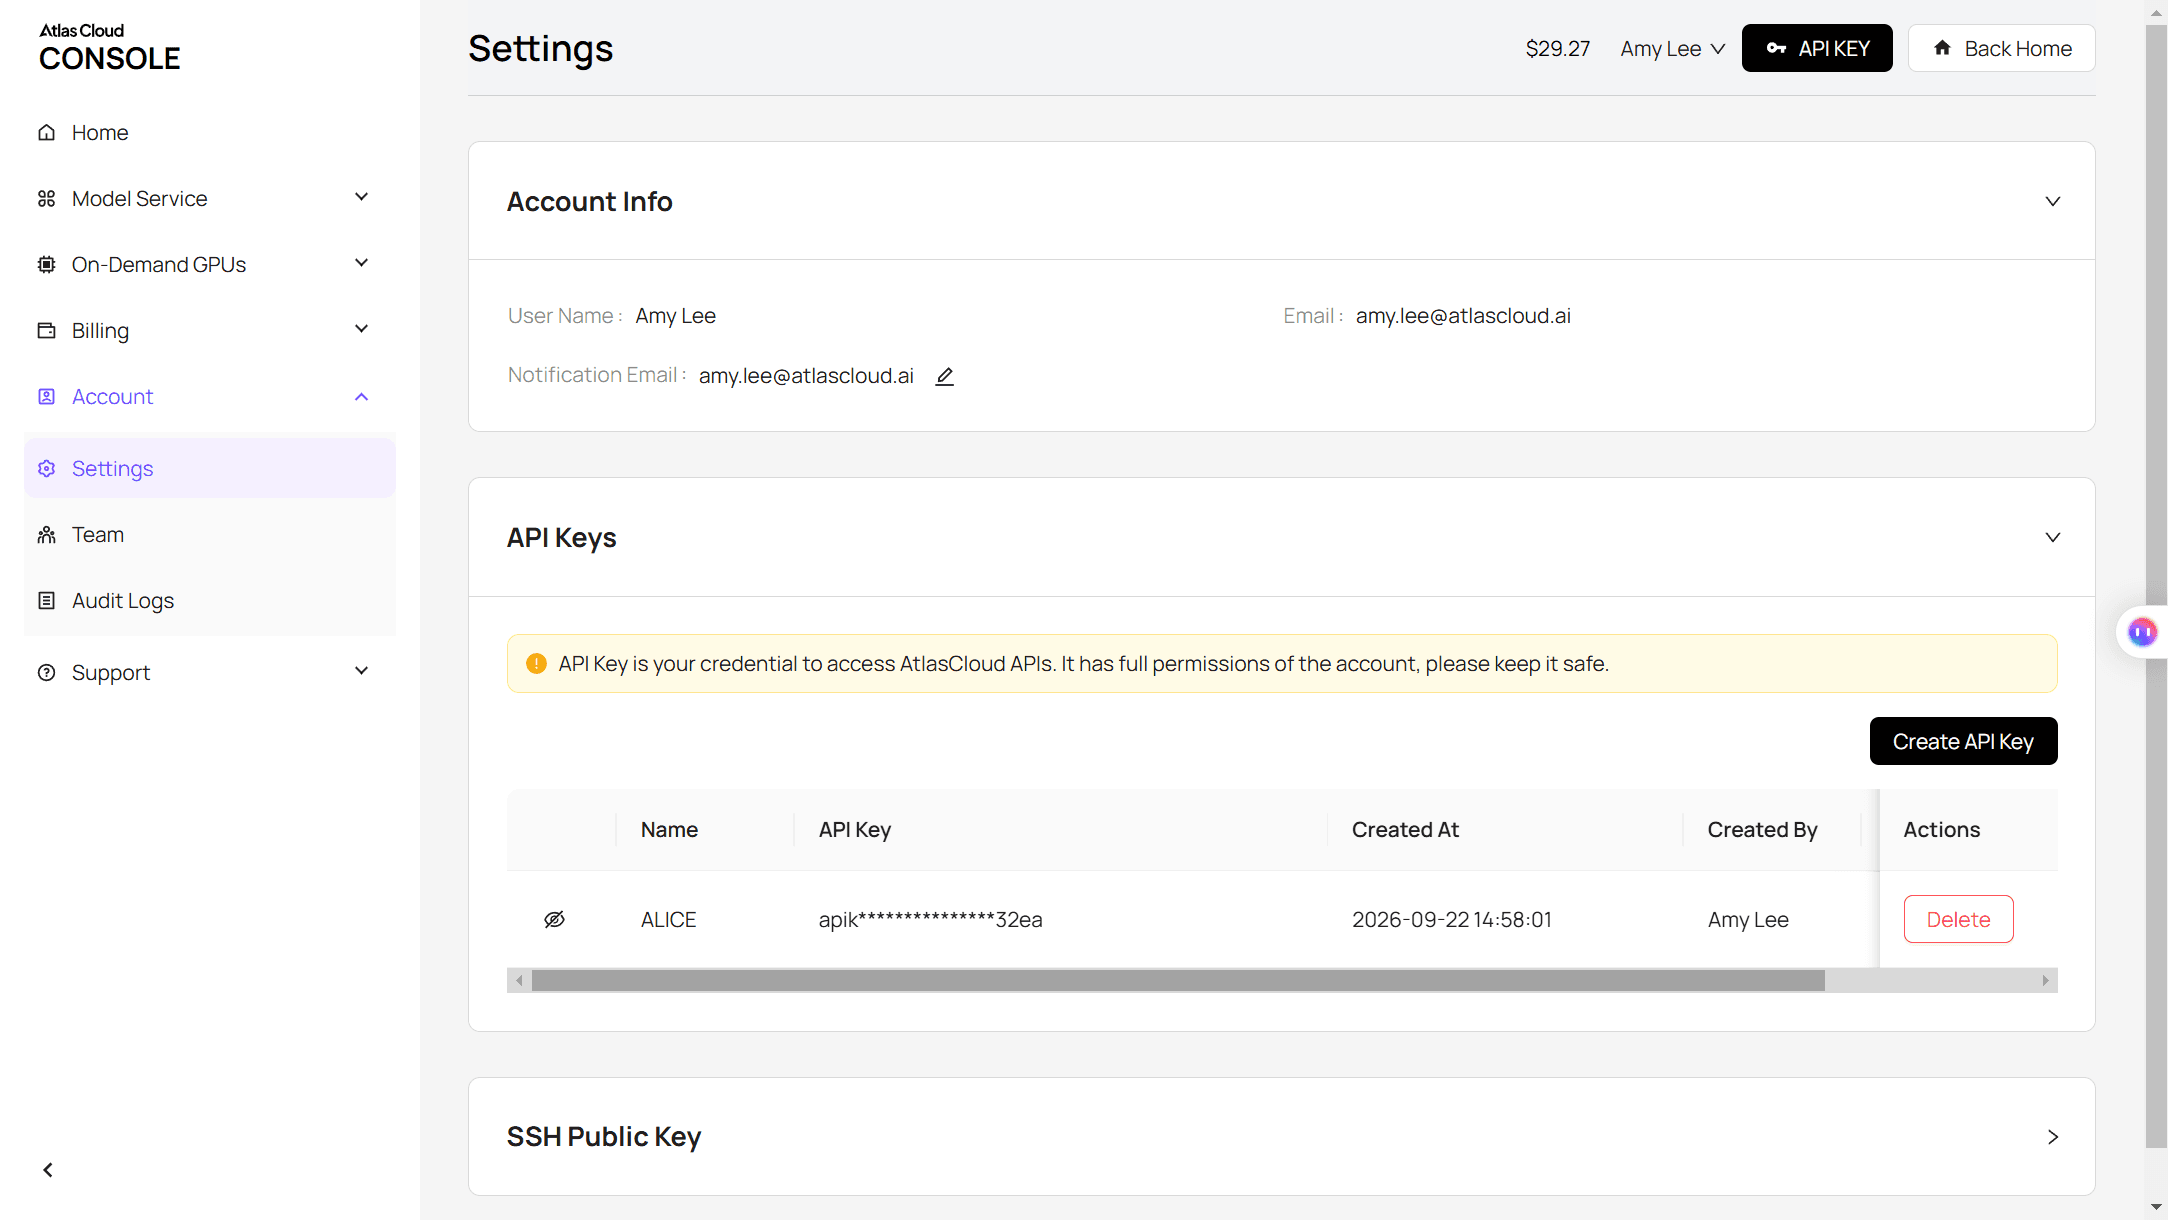
步骤 1:创建 API 密钥。 在控制台中打开 Settings,进入 API Keys,然后点击 Create API Key。请将其保存在服务端;一个密钥即可覆盖平台上的所有模型。
步骤 2:检查请求格式。 API 文档涵盖了 chat completions 格式,每个模型页面都有一个 API 标签页,附带现成的示例。
步骤 3:发送请求。 两款模型都采用 OpenAI chat completions 协议,因此两次调用之间唯一的变化就是模型字符串。
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4.1-flash-1017", 6 "messages": [{"role": "user", "content": "Find the bug in this function: ..."}], 7 "max_tokens": 4000 8 }'
将 model 值换成 openai/gpt-6-sol 并再次发送。两次的回复文本都位于 choices[0].message.content,而 usage 块会告诉你每个模型花费了多少 token,这是我们测试中最有趣的数字。
DeepSeek vs ChatGPT 对比:5 条相同提示词的结果
我们挑选了五项日常任务,各写了一条提示词,并以默认采样和 4,000 token 上限发送。评分按所述要求通过或失败,并按答案遵循指令的紧密程度进行平局判定。完整提示词见表格后的方框。
| # | 任务 | DeepSeek V4.1 Flash 1017 | GPT-6 Sol | 结果 |
|---|---|---|---|---|
| 1 | 修复一个有 bug 的 Python moving_average 函数,并添加 ValueError 防护 | 修复正确,防护正确,一句话解释。216 个输出 token | 相同的修复,相同的防护。131 个输出 token | 平局 |
| 2 | 两列火车追赶问题,向 9 年级学生解释 | 正确,上午 11:45,五个步骤含方程。512 个输出 token | 正确,上午 11:45,五个更短的步骤。233 个输出 token | 平局 |
| 3 | 产品发布邮件:主题不超过 50 个字符,正文 110 到 130 个单词,不使用感叹号 | 三项规则均满足:34 字符主题,115 词正文。2,536 个输出 token | 三项规则均满足:36 字符主题,119 词正文。750 个输出 token | 平局 |
| 4 | 将会议记录转换为含真实日期的 JSON 行动项 | 四项,所有四个日期均正确解析,JSON 有效。782 个输出 token | 四项,日期相同,JSON 有效。377 个输出 token | 平局 |
| 5 | 读取一张柱状图,报告增长量和最接近的差距 | 正确:City Mug 增长 220 件,第四季度差距为 10。465 个输出 token | 相同的两个答案。112 个输出 token | 平局 |
五次平局是一个真实的结果,与 2025 年对比所报告的不同。在办公室或学生用户每天发送的任务上,两款当前模型都能答对。
差距在于 token 用量。上面的输出计数包括推理,而 DeepSeek V4.1 Flash 默认在回答前进行可见推理,因此在相同提示词上,它使用的输出 token 是 GPT-6 Sol 的 1.6 到 4.2 倍。图表问题的比率最大,465 对 112 个 token,而邮件花费的绝对量最大:一封 115 词的邮件用了 2,536 个 token。这会体现在 API 账单上,也会在应用中显示为很长的思考面板。
速度更接近。在一个短流式提示词上,各运行三次,GPT-6 Sol 在 2.9 到 3.1 秒内到达首字节,并在 3.4 到 3.7 秒内完成;DeepSeek V4.1 Flash 1017 到达首字节需 2.8 到 4.0 秒,完成需 3.9 到 5.3 秒。
以下是这五条提示词,你可以重新运行:
plaintext11. This Python function should return the average of every full window. moving_average([1, 2, 3, 4, 5], 2) should return [1.5, 2.5, 3.5, 4.5]. [function pasted] Find the bug, fix it, and raise a ValueError when window is less than 1 or larger than len(values). Reply with only the fixed function in a code block, then one sentence explaining the bug. 2 32. A train leaves a station at 9:40 a.m. traveling at 72 km/h. A second train leaves the same station at 10:05 a.m. on a parallel track in the same direction at 90 km/h. At what time does the second train catch up with the first? Explain it step by step for a 9th grader, then give the final answer on its own line. 4 53. Write a launch email for a reusable coffee cup that keeps drinks hot for 6 hours. Audience: people who commute by train. Rules: a subject line under 50 characters, a body of 110 to 130 words, no exclamation marks, and end with one clear call to action. 6 74. Turn these meeting notes into JSON: an array called action_items, where each item has owner, task, and due_date (YYYY-MM-DD). The meeting was on Monday, November 3, 2025. Output only valid JSON. [notes pasted] 8 95. Look at this chart. Which product grew the most in units from Q1 to Q4, and by how many units? Then name the quarter where two products came closest in sales and give the gap. [chart attached]
DeepSeek vs ChatGPT 的编程能力
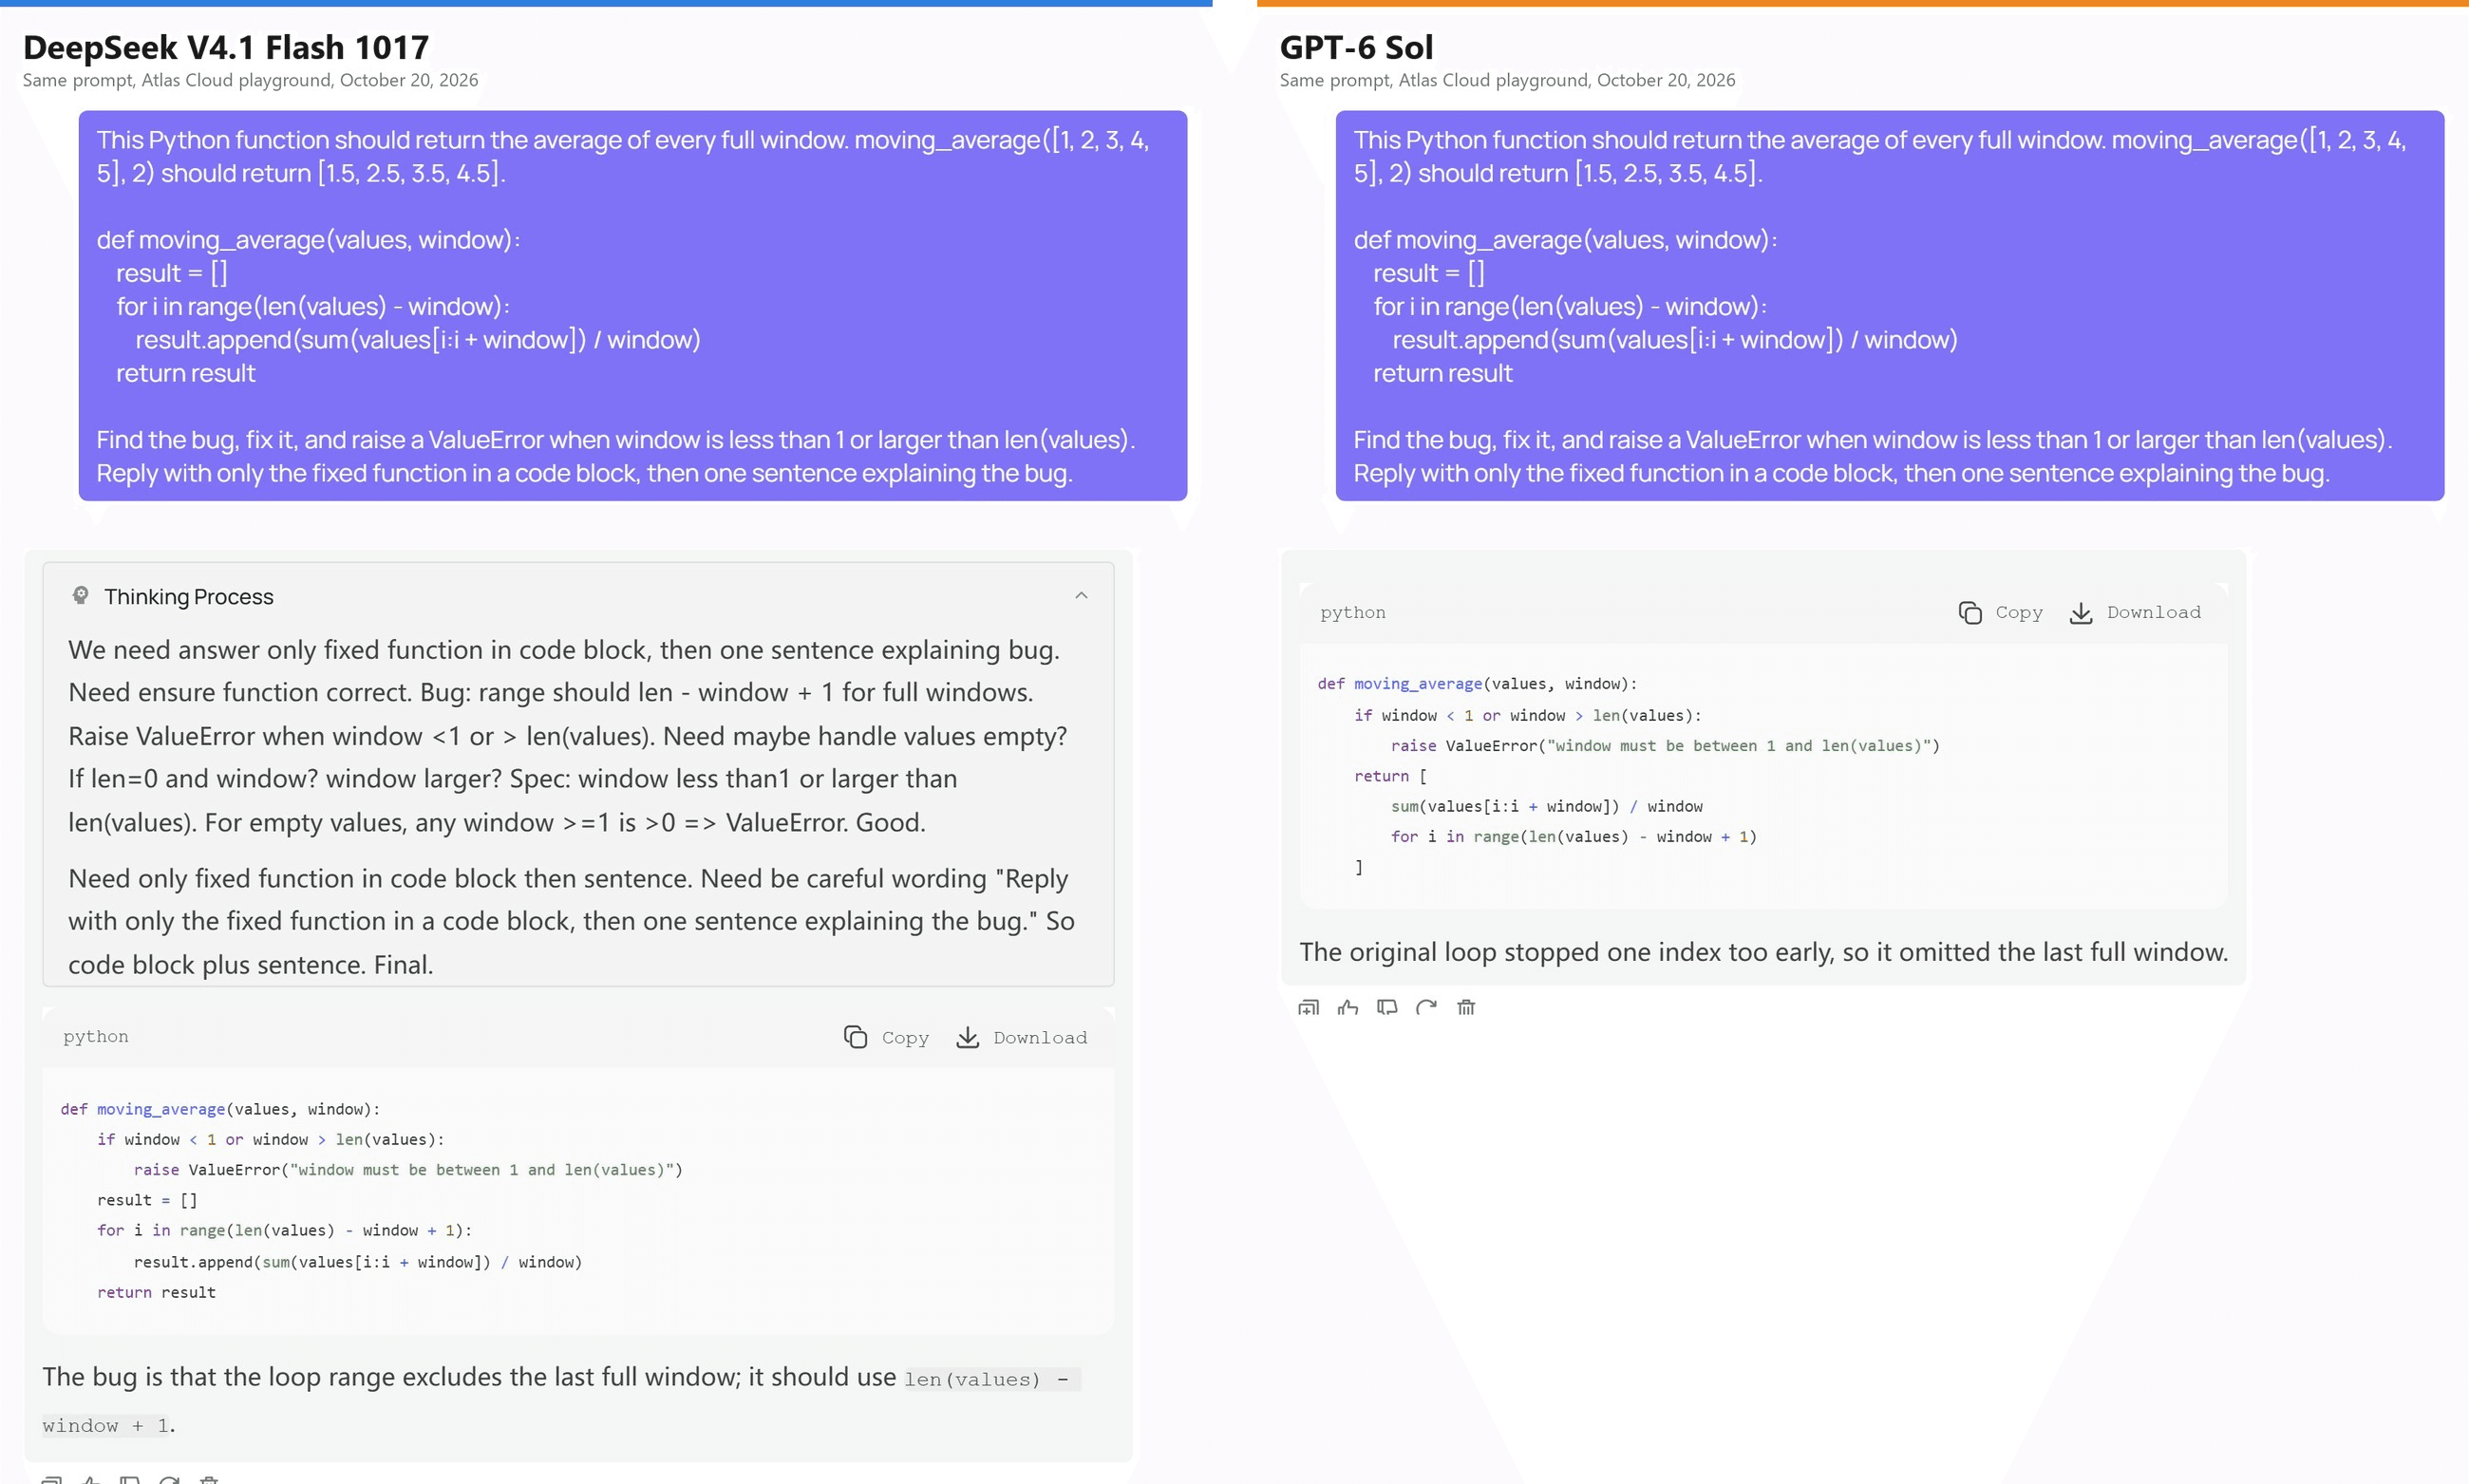
看看上面截图中的两个输出。两款模型都发现循环少跑了一个窗口,也都添加了相同条件的防护子句。GPT-6 Sol 将函数体重写为列表推导式;DeepSeek 保留了原始循环,仅修改了 range,这是更小的差异,也是你希望在 bug 修复中看到的。
一次测试不构成基准。2026 年 10 月 20 日我们查看时,Artificial Analysis 在其 Intelligence Index 上将 GPT-6.1 Sol 列为 52,DeepSeek V4.1 Flash 1017 列为 45,免费的 ChatGPT 模型 GPT-6 Luna 为 38;聊天标签页模型 GPT-6 Sol 当天没有得分。因此,付费 ChatGPT 模型在综合基准上领先,免费模型落后于 DeepSeek,而在单个 bug 修复上你不会看出差别。
DeepSeek 安全吗?你的聊天记录流向何处
这是许多“deepseek vs chatgpt”搜索背后的问题,诚实的答案来自政策页面,而非新闻标题。DeepSeek 的隐私政策最后更新于 2026 年 2 月 10 日,篇幅简短,值得通读;重要内容见下表。
| DeepSeek 应用 | ChatGPT | |
|---|---|---|
| 数据存储位置 | 政策声明:“我们直接收集、处理并将你的个人数据存储在中华人民共和国” | OpenAI 的帮助中心按账户记录了数据控制;我们查阅的消费级政策页面未明确说明存储位置 |
| 用你的聊天进行训练 | 政策将模型训练列为目的之一,并提供通过发送邮件至 [email protected] 选择退出的方式 | Settings 和 Data controls 下的“Improve the model for everyone”开关可关闭对新对话的训练 |
| 监管机构行动 | 意大利数据保护机构于 2025 年 1 月 30 日封禁了该服务,依据其自身新闻稿 | 消费级应用上没有可比的行动 |
美国国家标准与技术研究院的 CAISI 于 2025 年 9 月 30 日发布的评估发现,“DeepSeek 模型复述的不准确且具误导性的中共叙事数量是美国参考模型的四倍。”该评估覆盖 R1、R1-0528 和 V3.1,而非 V4 一代,因此应将其视为早期模型的已知行为,而不是对今天模型的定论。
开放权重改变了开发者的处境。由于 V4.1 Flash 1017 采用 MIT 许可,公司可以在自己的服务器上或通过美国托管的 API 运行它,而无需接触 DeepSeek 的应用。上述政策管辖的是该应用和 DeepSeek 自己的 API,而非在别处运行的模型副本。
DeepSeek vs Claude vs ChatGPT:Claude 的定位
搜索三方对比的读者通常想知道 Claude 是否会改变决策。2026 年 10 月,根据 Anthropic 的模型文档,其模型阵容为 Claude Fable 5.1、Opus 5.5、Sonnet 5.5 和 Haiku 5.5,Claude 应用在 Pro 和 Max 之外还有免费方案。
| DeepSeek | ChatGPT | Claude | |
|---|---|---|---|
| 当前应用背后的旗舰模型 | V4.1 Flash 1017 | GPT-6 Sol(Plus 及以上)、GPT-6 Astra(Pro 推理) | Fable 5.1 和 Opus 5.5 |
| 开放权重 | 是,MIT | ChatGPT 背后的模型不开放;OpenAI 独立的 gpt-oss 模型是开放的 | 否 |
| 免费消费级方案 | 整个应用 | 是,有使用限制 | 是,有使用限制 |
| 在此对比中的突出之处 | 每 token 价格和自托管 | 在一个应用中提供图像、语音和智能体功能 | 长时间运行的智能体式编程工作,依据 Anthropic 自身的定位 |
如果你的工作主要是聊天、写作和快速代码修复,Claude 是第三个选项,形态与 ChatGPT 相同:闭源权重、免费层级、付费层级。如果你需要你实际聊天所用模型的权重,那指向 DeepSeek。要深入了解当前 OpenAI 的发布如何按方案运作,请参阅我们的 GPT-6 可用性指南。
DeepSeek 和 ChatGPT 哪个更好?
在五次平局之后,选择取决于模型周围的应用和政策,而非答案质量。
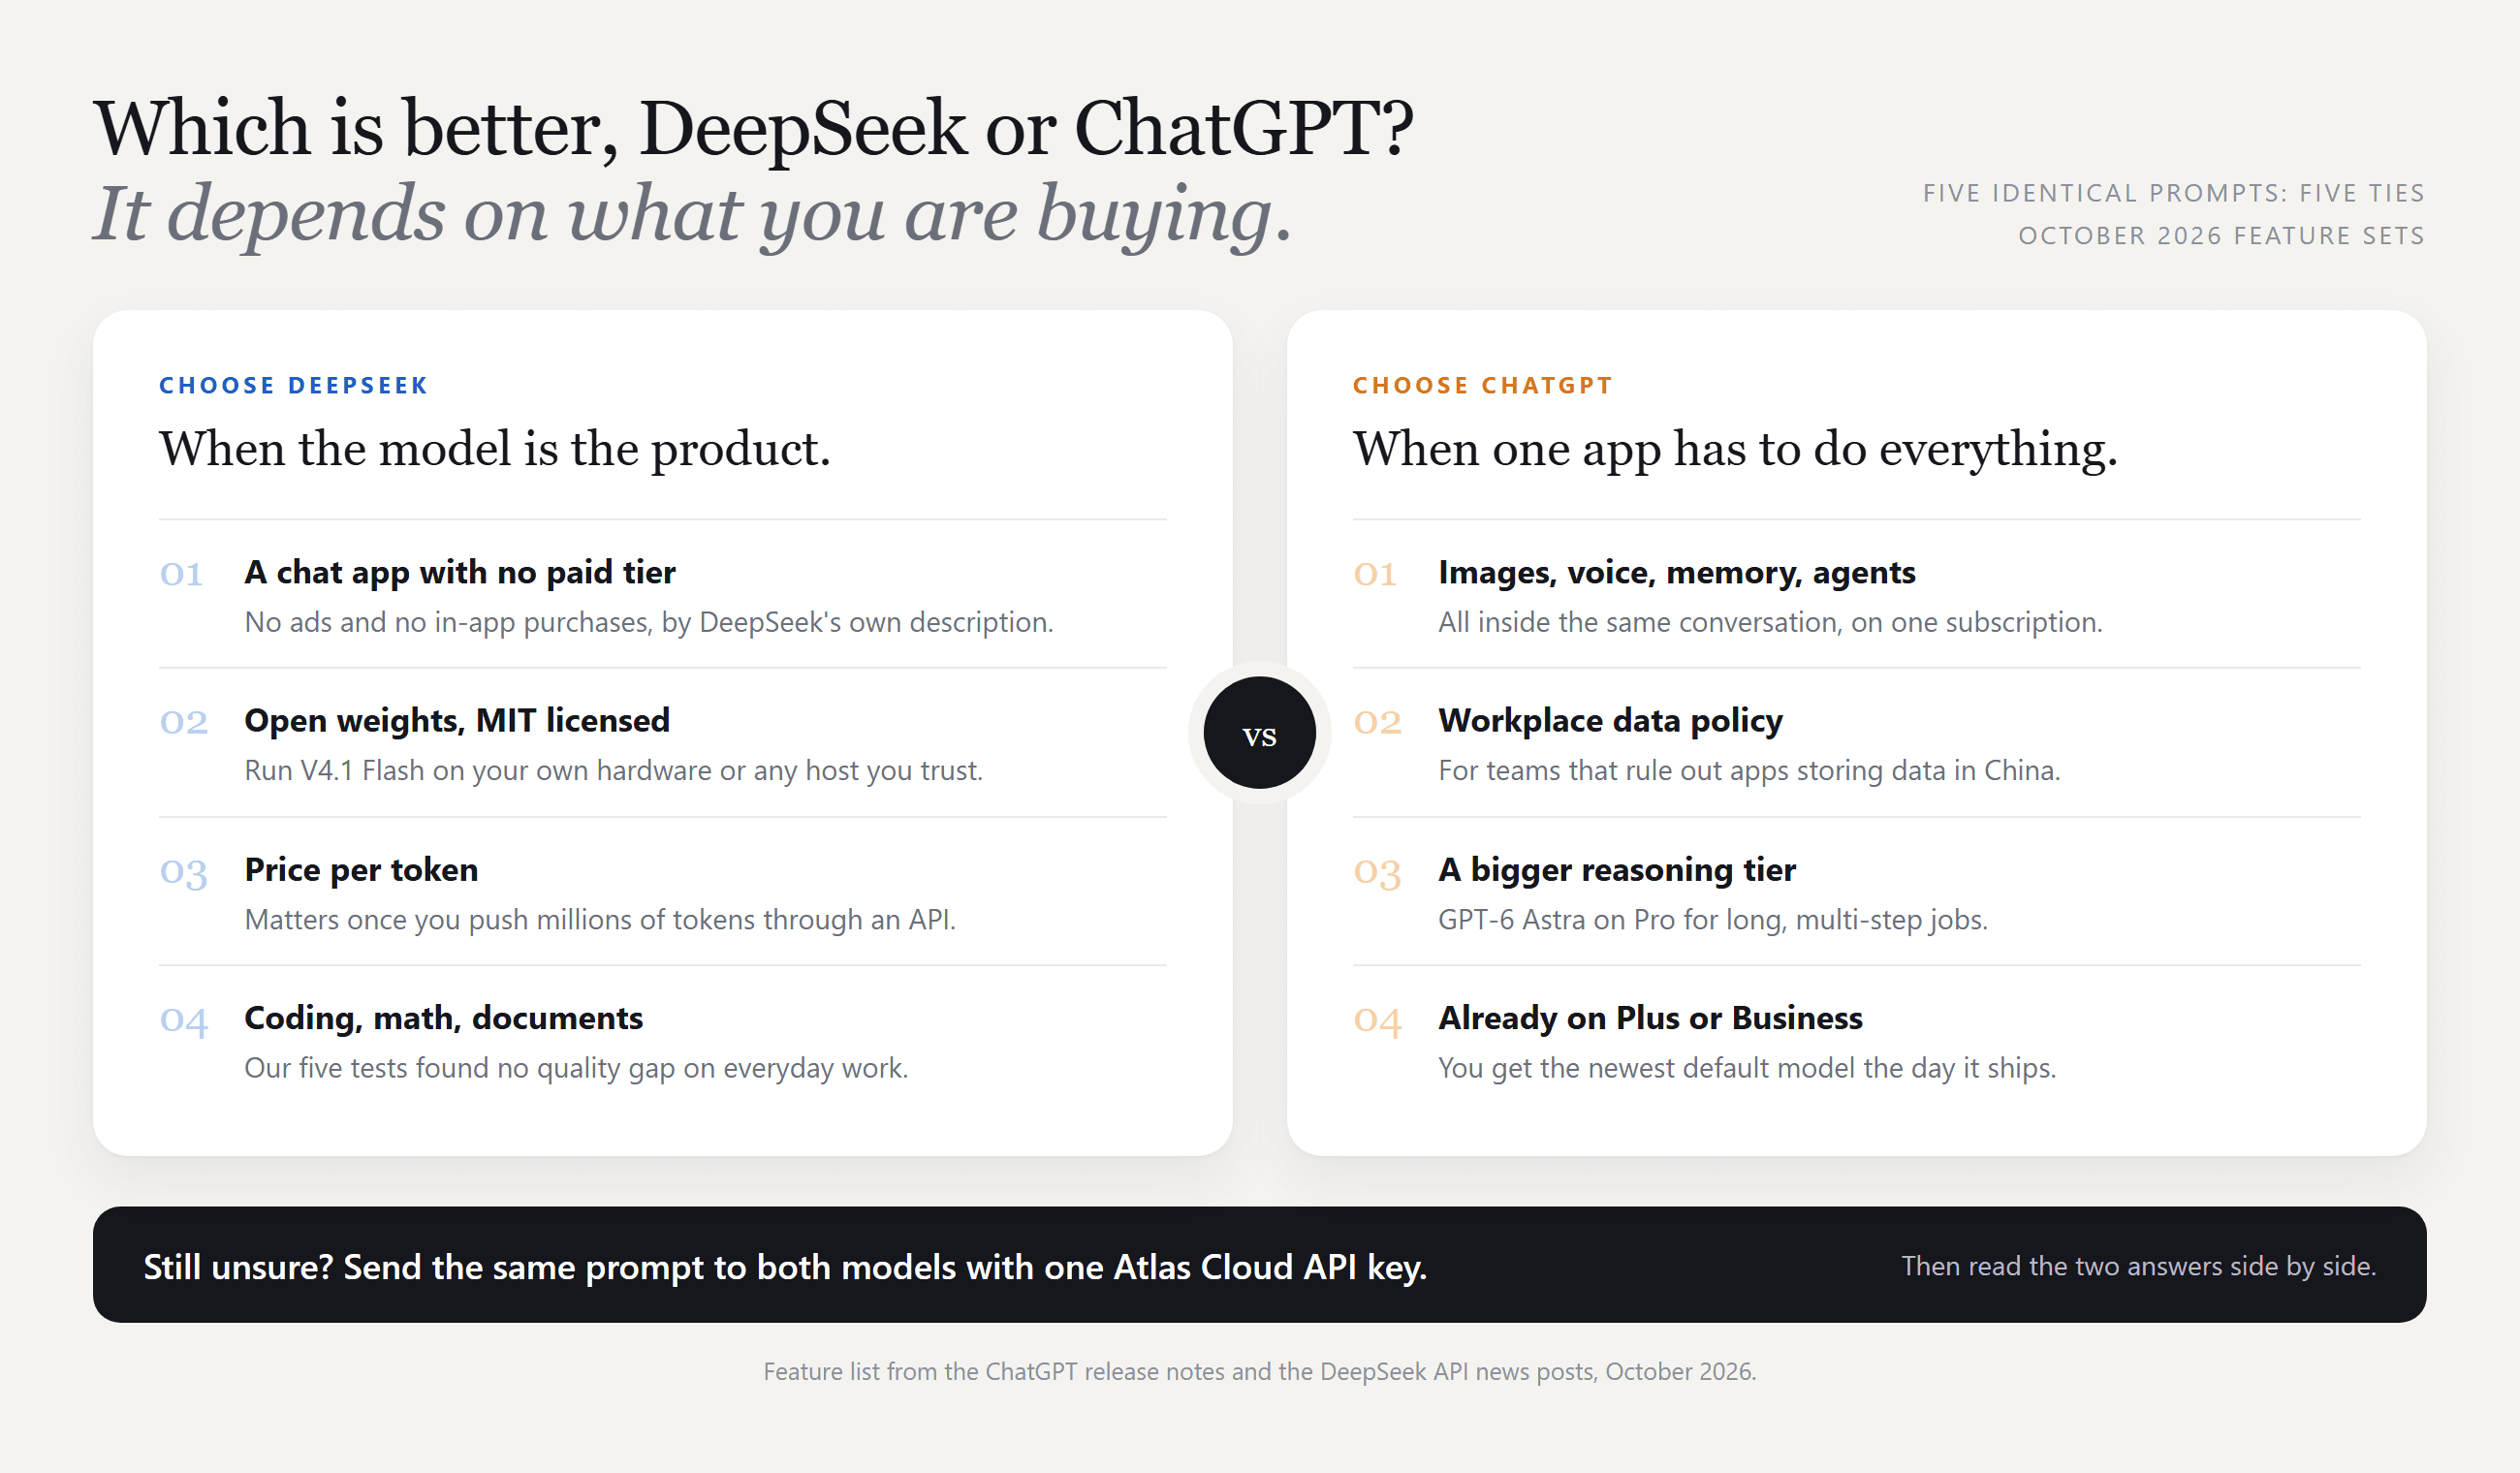
当你认为模型本身就是产品时,选择 DeepSeek:你想要一个无追加销售的免费聊天应用,你计划自行托管,或者你通过 API 推送大量 token。DeepSeek 的 1M token 上下文还开启了文档任务,我们在 V4.1 Flash 上下文窗口指南中有所介绍。
当你想要一个能生成图像、能语音回应、能记住你并运行常驻智能体的应用,或者当你雇主的政策排除了将数据存储在中国的工具时,选择 ChatGPT。付费层级还为你提供用于长时间多步骤工作的 GPT-6 Astra,这在 DeepSeek 的应用中没有对应物。
开发者有第三条路:通过一个网关路由两款模型,并按任务切换。我们的统一 LLM API 网关文章详细介绍了这一设置。
常见问题
DeepSeek 免费使用吗?
是的。DeepSeek 的应用发布文章将消费级应用描述为 100% 免费、无广告且无应用内购买,当前的 V4.1 Flash 1017 模型在官网和应用上免费运行。API 按 token 收费,因此基于 DeepSeek 构建的开发者需要付费,而在应用中聊天的人则不需要。
与 ChatGPT 的模型相比,DeepSeek API 的费用是多少?
在 Atlas Cloud 上,DeepSeek V4.1 Flash 1017 标价为每百万输入 token $0.30,每百万输出 token $1.20。GPT-6 Sol 标价为每百万输入 $2,每百万输出 $10。请记住我们测试中的推理开销:在相同提示词上,DeepSeek 使用的输出 token 最多达 4.2 倍,这缩小了短任务上的实际差距。ChatGPT 应用则按订阅定价:定价页面将 Go 列为每月 $8,Plus 为 $20,Pro 从 $100 起,含三个使用层级,根据 2026 年 10 月的发布说明,最高层级为 $500。
DeepSeek 比 ChatGPT 5 更好吗?
这个问题现在已经过时,因为 ChatGPT 不再默认运行 GPT-5。面对当前的 GPT-6 Sol,DeepSeek V4.1 Flash 1017 在我们全部五条日常提示词上与它持平,同时在 Artificial Analysis 指数上落后于它。如果你上一次对比是在 GPT-5 时代,请重新运行你自己的提示词;双方都已推进了多个版本。
谁拥有 DeepSeek?
DeepSeek 是一家中国 AI 公司;其隐私政策将杭州深度求索人工智能有限公司列为运营方,将中华人民共和国列为用户数据存储地。上述监管行动针对的是这一所有权,而非模型质量。
DeepSeek 是开源的吗?
模型权重是。DeepSeek V4.1 Flash 1017 以 MIT 许可发布,允许商业使用和修改,之前的 R1 也采用相同许可。训练数据和完整训练代码并未公开,因此“开放权重”是更精确的说法。对大多数团队来说,实际效果是一样的:你可以下载模型并自行运行。
为什么 DeepSeek 比 ChatGPT 便宜?
部分源于架构,部分源于商业模式。DeepSeek 的模型采用 Mixture-of-Experts 设计,每个 token 只激活一小部分参数,公司的 V3 技术报告称该模型最终训练运行花费了 557.6 万美元的租用 GPU 时间,同时指出该数字不包括先前的研究和消融实验。在商业方面,DeepSeek 出售 API token 并免费提供应用,而 OpenAI 通过订阅为更大的产品面提供资金。
结论
这个对比的 2025 年版本是一个廉价挑战者追赶一个精致在位者。在 2026 年 10 月,DeepSeek V4.1 Flash 1017 和 GPT-6 Sol 在五条普通提示词上的正确性上已难分伯仲,剩下的就是 token、功能以及你的数据存储在哪里。
就这些方面做决定吧。如果你想要免费应用或开放权重,DeepSeek 两者兼备。如果你想在一个订阅中获得图像、语音、记忆和智能体,ChatGPT 都有。而如果你宁愿测试而不是听我们一面之词,为你的提示词确定 DeepSeek vs ChatGPT 的最快方式,就是通过一个密钥将它们发送给两款模型,并排阅读答案。





