你的请求成功返回了。但应用仍然拿不到可用的图片。也许响应里只包含一个任务 ID,或者生成好的图片多了一个对象,导致它不适合用在页面上。
面向开发者的生成式 AI API 让应用把输入发送给模型并接收生成内容。选择时要围绕所需的输入、输出格式、等待时间和验收标准。然后构建任务处理与校验流程,把一次响应变成用户真正能用的东西。
本指南沿着图像工作流,从选型一直讲到交付。你将获得一张任务选型表、配套的 JavaScript 与 Python 示例、3 个具体图像简报,以及一份成本测算表。同样的决策过程也适用于文本和视频,只是协议和输出校验不同。
关键要点
- 先确定任务和验收标准,再选模型。
- 保存异步任务 ID,以便中断的工作可以续跑。
- 按每个被接受的输出来衡量成本,包含被拒绝的生成结果。
- 在展示成品之前,先测试文件和业务约束。
面向开发者的生成式 AI API:它能做什么
模型负责执行生成。API 定义你的软件如何请求这项工作。SDK 用特定语言的辅助工具封装接口。托管平台负责运营对模型的访问,而你的应用则提供用户体验、权限以及接受结果的规则。
阅读产品页面时,这些区别很重要。一个能生成图片的聊天应用,并不能说明它的开发者端点接受同样的输入。SDK 提供了便捷方法,也不代表你不需要了解其底层的响应与失败状态。
从下面这张任务对照表开始。“交互方式”一列描述的是可供评估的应用设计,而不是承诺每个服务商都支持该模式。
| 任务 | 输入 | 所需能力 | 输出 | 待评估的交互方式 | 验收标准 |
|---|---|---|---|---|---|
| 客服回复草稿 | 工单与已批准的帮助内容 | 有依据的文本生成 | 草稿文本 | 同步或流式 | 回答该工单;不编造政策 |
| 文档字段提取 | 文档文本或受支持的文件 | 结构化提取 | JSON 字段 | 请求式或排队任务 | 结构合法且有来源依据 |
| 编辑配图 | 文字视觉简报 | 文生图 | 图像文件 | 异步任务 | 对象、版式、尺寸正确 |
| 图像编辑 | 源图像与指令 | 图像条件编辑 | 编辑后的图像 | 异步任务 | 完成所需修改;保留原有细节 |
| 视频生成 | 提示词或受支持的参考素材 | 视频生成 | 视频文件 | 排队任务 | 时长、运动正确,必要时包含音频 |
| 检索辅助回答 | 问题与检索到的段落 | 检索加生成 | 回答与引用 | 同步或流式 | 论断有检索段落支撑 |
生成图像、分析上传的图像和编辑已有图像是彼此独立的能力,需要分别验证。同样,视频端点可能支持起始帧,却不支持任意多图参考。
嵌入把输入转换为可用于检索和相似度计算的向量。它们有助于在生成回答之前找到相关文档,但它们本身并不产生回答,也不能证明检索到的内容支撑其论断。
实际的边界是 输入 → 请求 → 输出 → 应用验收。最后一步由你负责。生成的发票字段仍需校验;图片仍需检查;客服回复仍需确认它是否有权做出其中的承诺。
协议选择也各不相同。Google 的参考文档区分了标准生成、流式生成和实时交互。应把这视为交互模式存在差异的证据,而不是假定其他平台的支持情况完全一致。(Google Gemini API 参考文档,访问于 2026 年 9 月。)
面向开发者的生成式 AI API:如何选型
在比较各平台目录之前,先写一份简短的验收说明。对于编辑配图功能,它可能规定横向输出、对象数量有上限、不出现可见品牌标识,并包含人工审核环节。对于工单分类,它可能规定固定的标签集合,以及一个明确的“不确定”结果。
按以下顺序评估候选方案:
- 输入与输出。 针对确切的模型端点,核查支持的文件、输入限制、输出格式和参考图行为。模型系列名称过于宽泛,不能作为契约。
- 任务符合度。 用有代表性的简报试跑,包括那些棘手的。把约束不符与文件或网络故障分开统计,这样你才知道要修什么。
- 集成契合度。 确认认证方式、响应结构、任务状态取值和客户端库支持情况。把适配到现有后端所需的工作量也计入。
- 等待时间与并发。 判断用户是否可以离开后再回来。在承诺做出有严格时限的交互体验之前,先按预期负载实测。
- 计费透明度。 弄清计费单位,以及哪些设置会改变它。核查失败与退款的处理方式,而不要假定每次提交的请求都收取相同费用。
- 数据要求。 对照你实际打算发送的数据,审查输入处理、留存、删除和适用条款。在使用敏感材料之前,先记录下尚未解决的问题。
- 变更管理。 维护一组回归用例,并记录模型标识、提示词和参数。规划好模型更新或更换后如何重新评估其表现。
机构层面的指引说明了为什么访问与数据规则也属于这项决策:哈佛描述了其 AI 开发者工具经批准的访问途径与限制。那些是哈佛自身的安排,并非适用于你应用的通用许可。(Harvard University Information Technology,访问于 2026 年 9 月。)
| 访问途径 | 适合的团队 | 集成工作 | 运营责任 | 主要限制 | 选择前需核实 |
|---|---|---|---|---|---|
| 直接使用模型服务商 | 以单一服务商能力为核心的团队 | 服务商专属 API、账户、适配器 | 你的应用与任务;服务商负责推理 | 增加服务商会带来各自独立的合约 | 端点功能、区域、配额、条款 |
| 多模型托管平台 | 正在评估多个受支持模型的团队 | 共享访问,加上针对各模型的校验 | 你的应用与任务;平台托管推理 | 共享访问并不能统一所有参数 | 确切模型、结构、计费、数据路径 |
| 自托管开源模型 | 具备基础设施与模型服务能力的团队 | 部署、对外提供、加固并维护推理服务 | 硬件、服务、扩缩容、监控、更新 | 容量与工程开销 | 许可证、硬件适配、吞吐、维护 |
当同一个应用需要多种模型能力时,Atlas Cloud 是一个可供评估的托管选项。本文以其图像任务接口作为具体示例。你仍然需要逐个验证每个模型的输入与输出;仅更换模型 ID 是不够的。
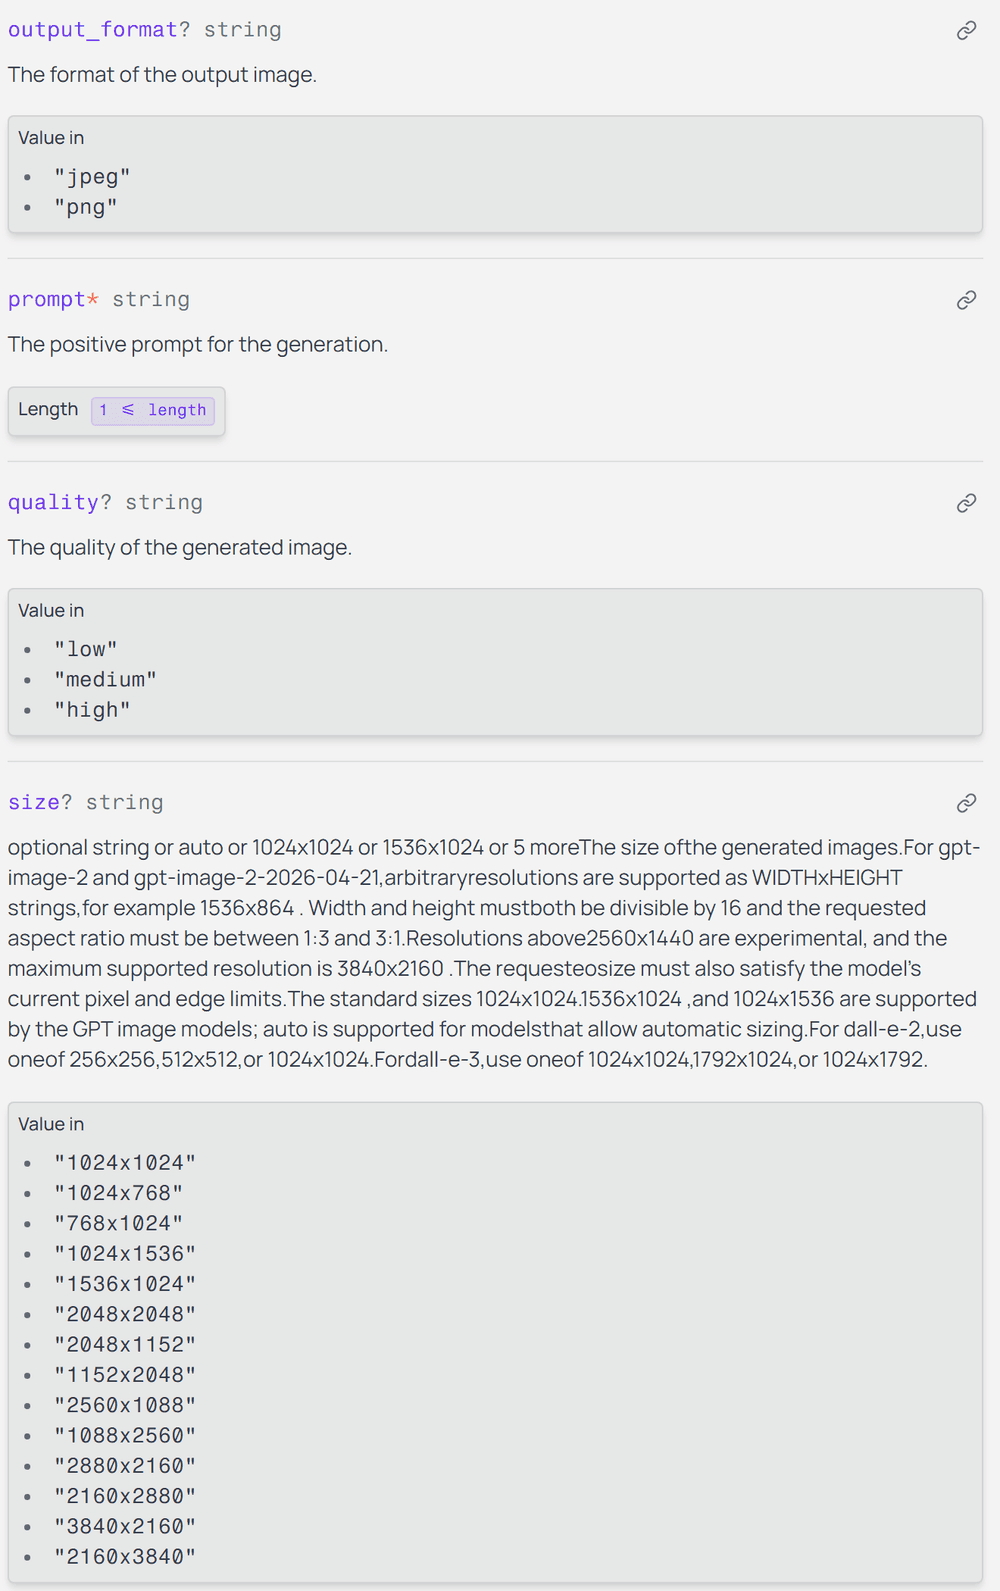
官方图像端点文档,展示输出格式、质量和尺寸约束
模型专属参数是集成契约的一部分。在复用请求体之前,先阅读其允许的取值。
对一个小型 SaaS 团队来说,有用的比较维度是交付一个被接受结果的总投入。除了推理费用,还要计入适配代码、支持排查、审核时间和迁移测试。这样才能避免一个便捷的原型掩盖了昂贵的生产工作流。
面向开发者的生成式 AI API:第一次请求
示例使用 GPT Image 2 文生图,模型 ID 为 openai/gpt-image-2/text-to-image。其端点文档列出了 quality: high、size: 2048x1152 和 output_format: png。这些就是下面示例所请求的设置。
1. 先在试验场中把提示词定下来。 使用下面的早餐简报,不要添加参考图。在点击运行之前,检查模型名称和已确认的设置。如果一个选项在你离开该字段后就回退,那它就不是你请求的设置。
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. 把认证留在服务端。 前端应当向你自己的后端请求启动任务。把 ATLAS_API_KEY 存放在服务器环境中。绝不要把它写进浏览器 JavaScript、图片 URL 或客户端可见的日志。把 ATLAS_API_HOST 设为 api.atlascloud.ai;这是一个主机名,不带协议或路径。
3. 只提交一次并持久化 ID。 文档中的生成路由是 POST /api/v1/model/generateImage。读取 data.id,然后把它与你的应用任务关联存储。如果提交响应丢失,先排查,再决定是否创建另一个可能产生费用的任务。
4. 轮询已保存的任务。 查询 GET /api/v1/model/prediction/{prediction_id}。预测文档 描述了 processing、completed 和 failed 三种状态,输出 URL 位于 data.outputs。即使是 completed 状态,也应检查输出数组是否非空。
5. 下载并校验。 把文件保存到你控制的存储中,验证它能被解码,并对照简报检查。只有到这一步,才把被接受的结果返回给应用。下载或校验错误应当仍然挂在既有任务上。
以下代码依据官方接口文档整理而成,并非实时的 API 基准测试。本文的媒体工作流使用的是浏览器测试试验场,而不是 API 密钥。
把那段早餐提示词原样保存为 prompt.txt。使用 Node.js 时,选用内置 fetch 的运行环境,安装 sharp,并将代码保存为 generate.mjs。在专门的工作目录中运行。除非你确实想跑两个任务,否则只运行两种语言示例中的一个。
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
更短的 Python 版本使用 requests 和 Pillow,读取同一个 prompt.txt,设置也完全相同。它也接受 PREDICTION_ID 以便续跑。这些脚本演示的是单个本地任务;部署成服务后需要持久化的任务记录和受限制的下载。
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
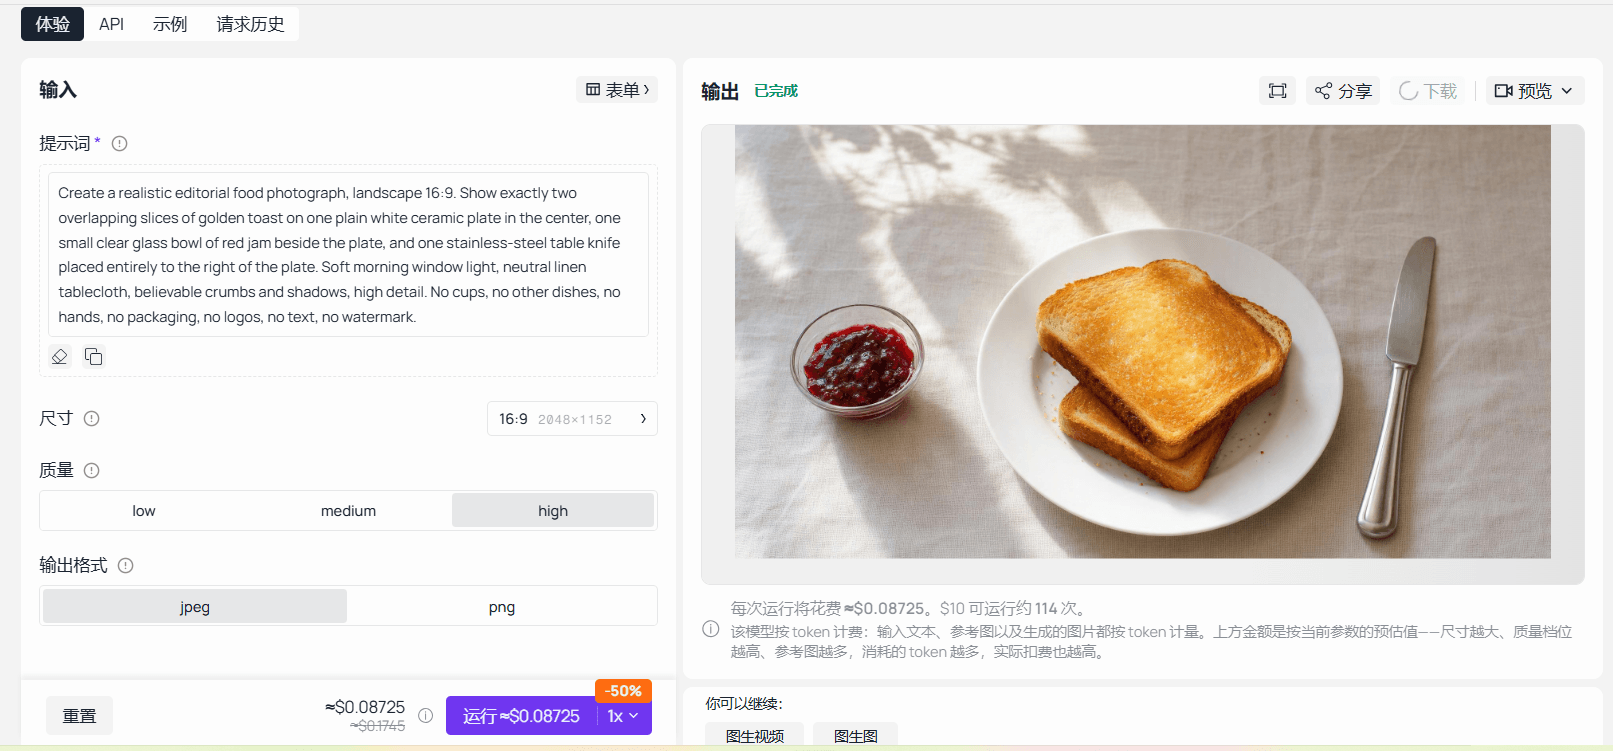 已完成运行的 GPT Image 2 试验场,显示提交的早餐提示词与最终输出
一次完成的试验场运行会同时记录提交的提示词、输出尺寸、质量设置和生成结果。
轮询截止时间只是让这个客户端停止等待,并不会取消服务端的任务。已经在执行的请求可能在轮询窗口结束后才完成,因此这并不是严格的端到端延迟保证。请保留 ID,让工作进程稍后再去查询。
面向开发者的生成式 AI API:实际用途
下面 3 个简报测试不同的需求。它们是彼此独立的请求,而不是把上一个结果作为下一个输入的链条。保持相同的模型和请求设置,这样简报之间的差异更容易看懂。
A. 美食编辑图:数量与位置。 早餐提示词检验输出中是否正好有 2 片吐司、1 个盘子、1 个果酱碗和 1 把刀。刀必须位于盘子右侧,所有必需物体都必须完整留在画面内。
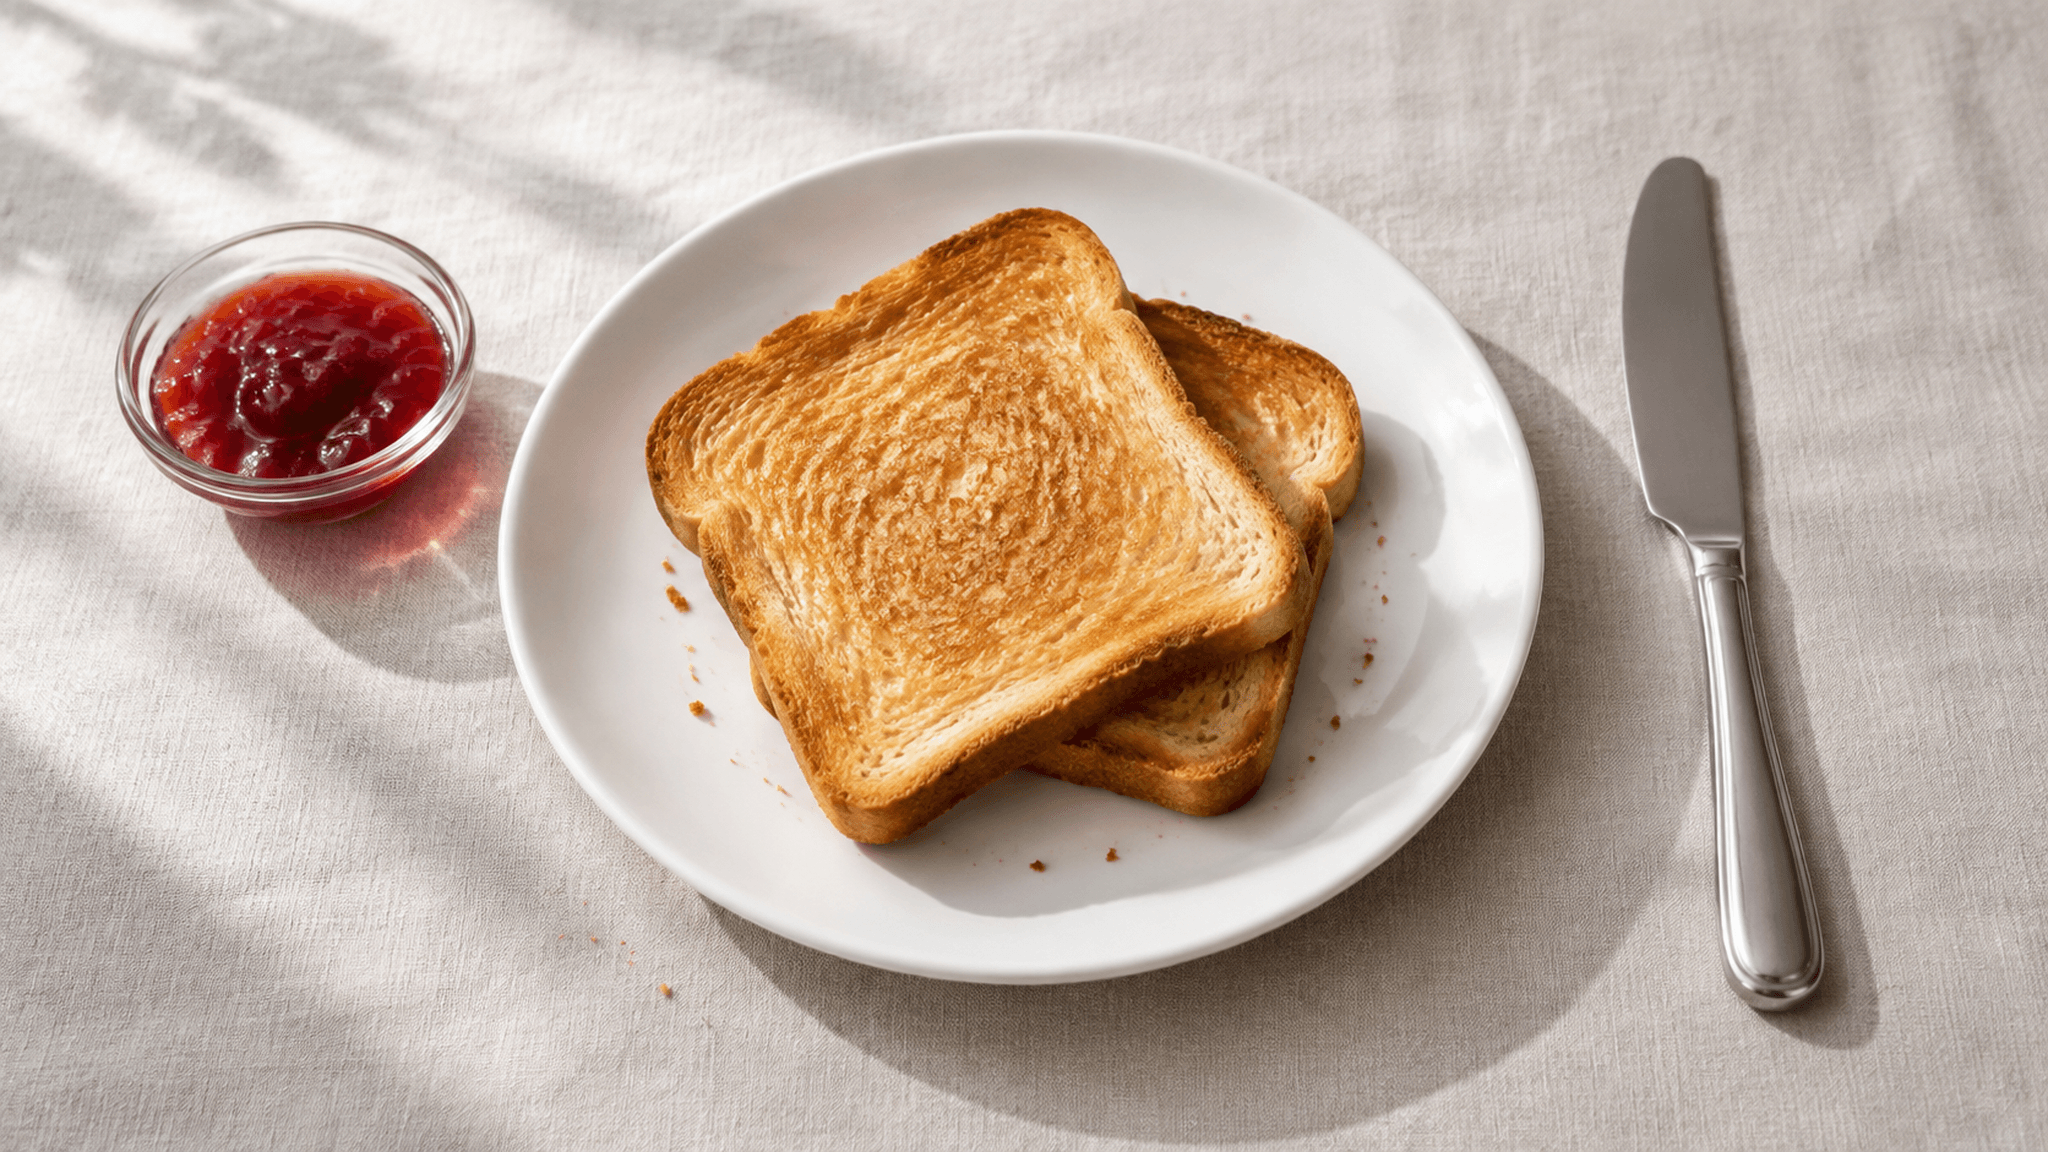
早餐图生成示例,配合对象数量与刀的位置检查_生成结果包含所需的盘子、吐司、果酱碗以及右侧的刀,可供下面的位置审核。_
要逐一检查重叠的切片。一个看起来很有说服力的早餐场景,如果背景里出现杯子,或者刀移到了盘子上,依然算失败。如果结果不合格,就修改有歧义的空间指令,每次只改一个变量,并保留拒绝原因。不要反复要求“画得更好看一点”。
B. 文章封面:可用的标题空间。 这个请求把构图当作版式依赖来处理。页面编辑需要在左侧留出空白,右侧放置工具和花盆。之后用 HTML/CSS 添加真实标题,这样它仍然可编辑、可阅读。
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
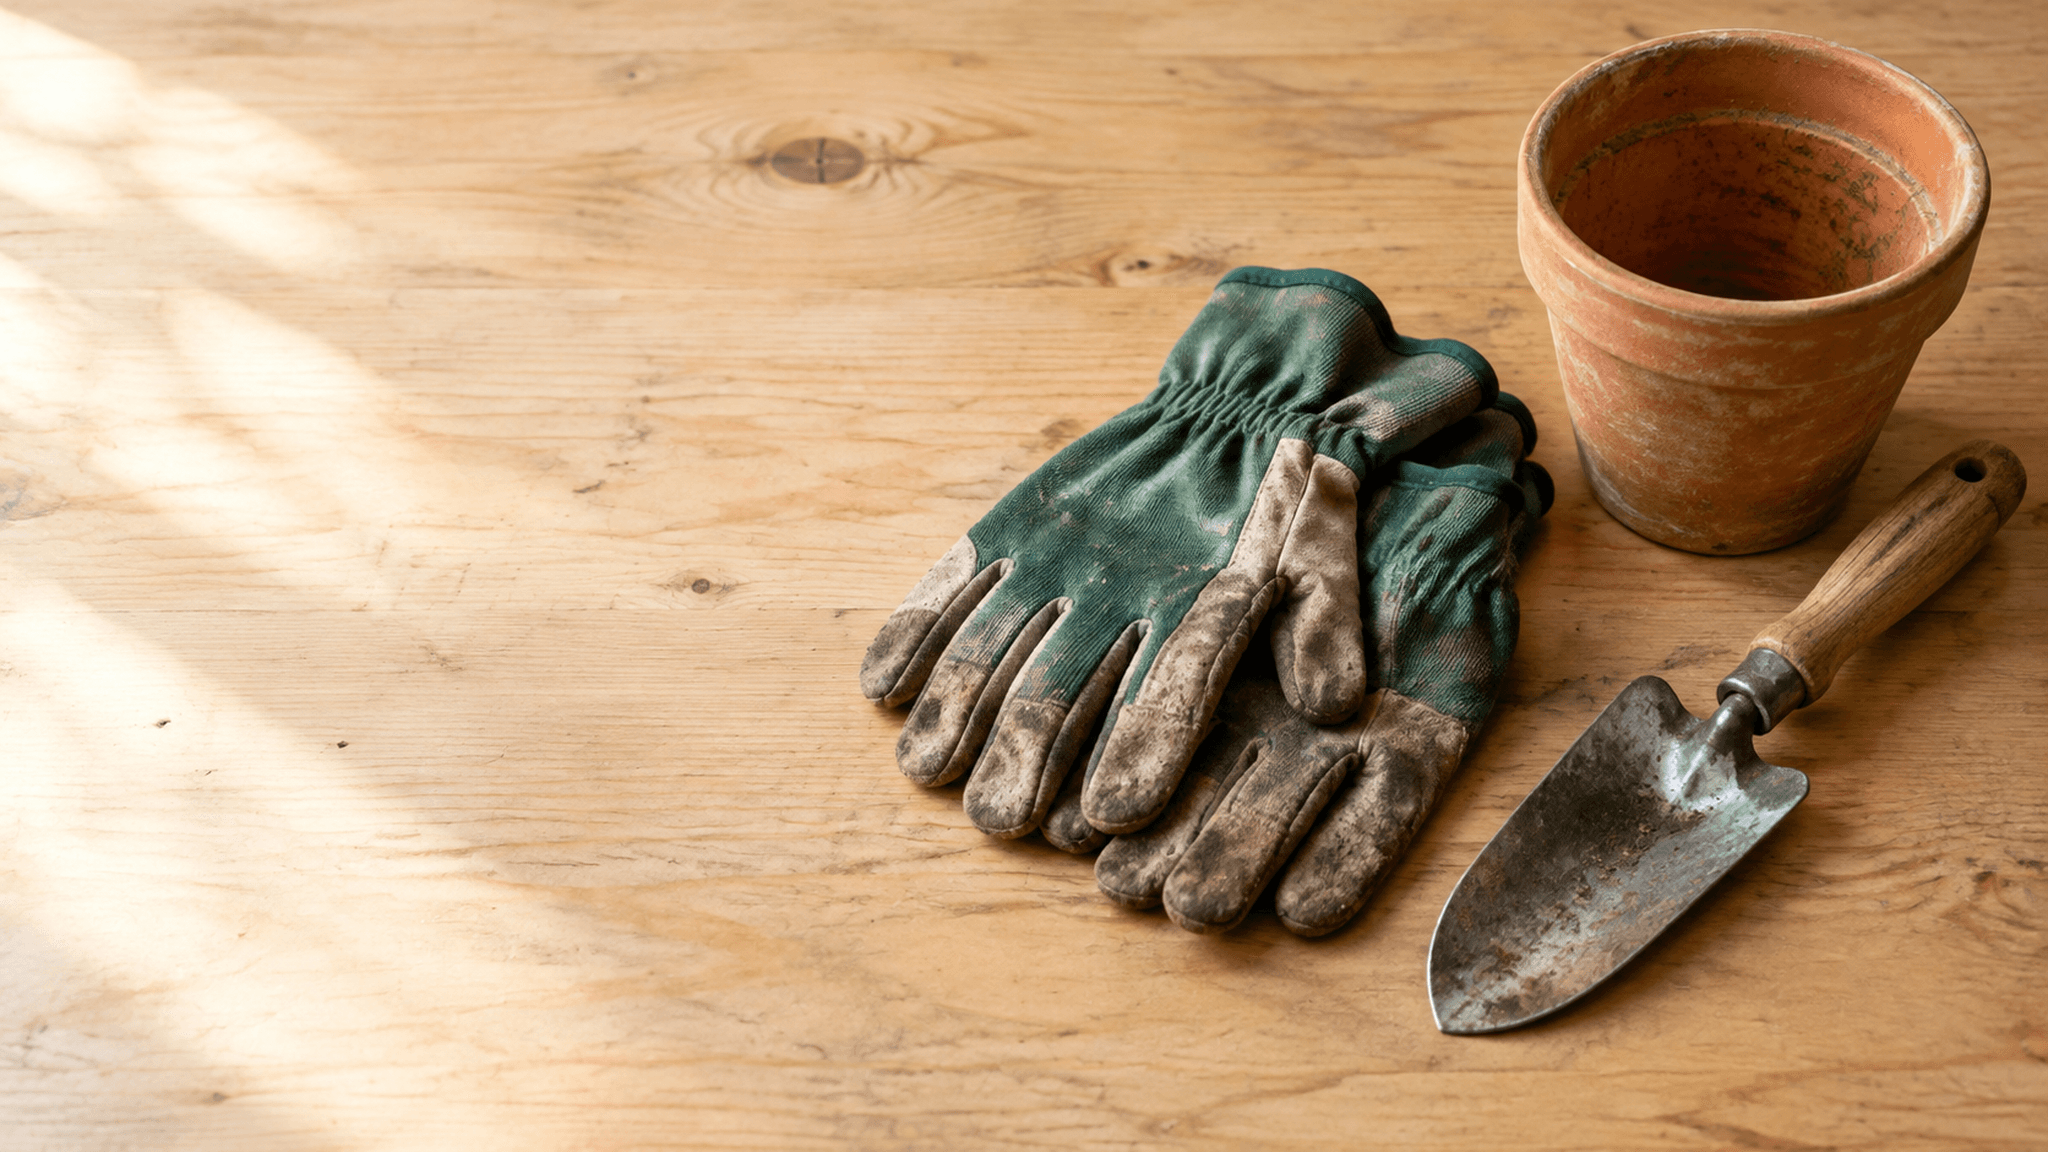 工作台封面示例,显示所要求的左侧标题留白与右侧物体
结果在左侧保留了可用的空白,同时把手套、花盆和小铲留在右侧。
要按实际发布的裁切方式检查结果。一张横向母图在移动端卡片居中裁切时,可能丢掉那块有用的空白区域。如果构图不合格,就规定更紧凑的物体边界,或者调整应用端的裁切。不要靠在所需主体上叠加文字来掩盖这个失败。
C. 面料插图:细节与顺序。 下一个请求要求 3 块折叠好的布样,且各自可见的纹理能够区分。它检验数量、位置,以及结果在读者实际看到的尺寸下是否足以支撑一张说明性插图。
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
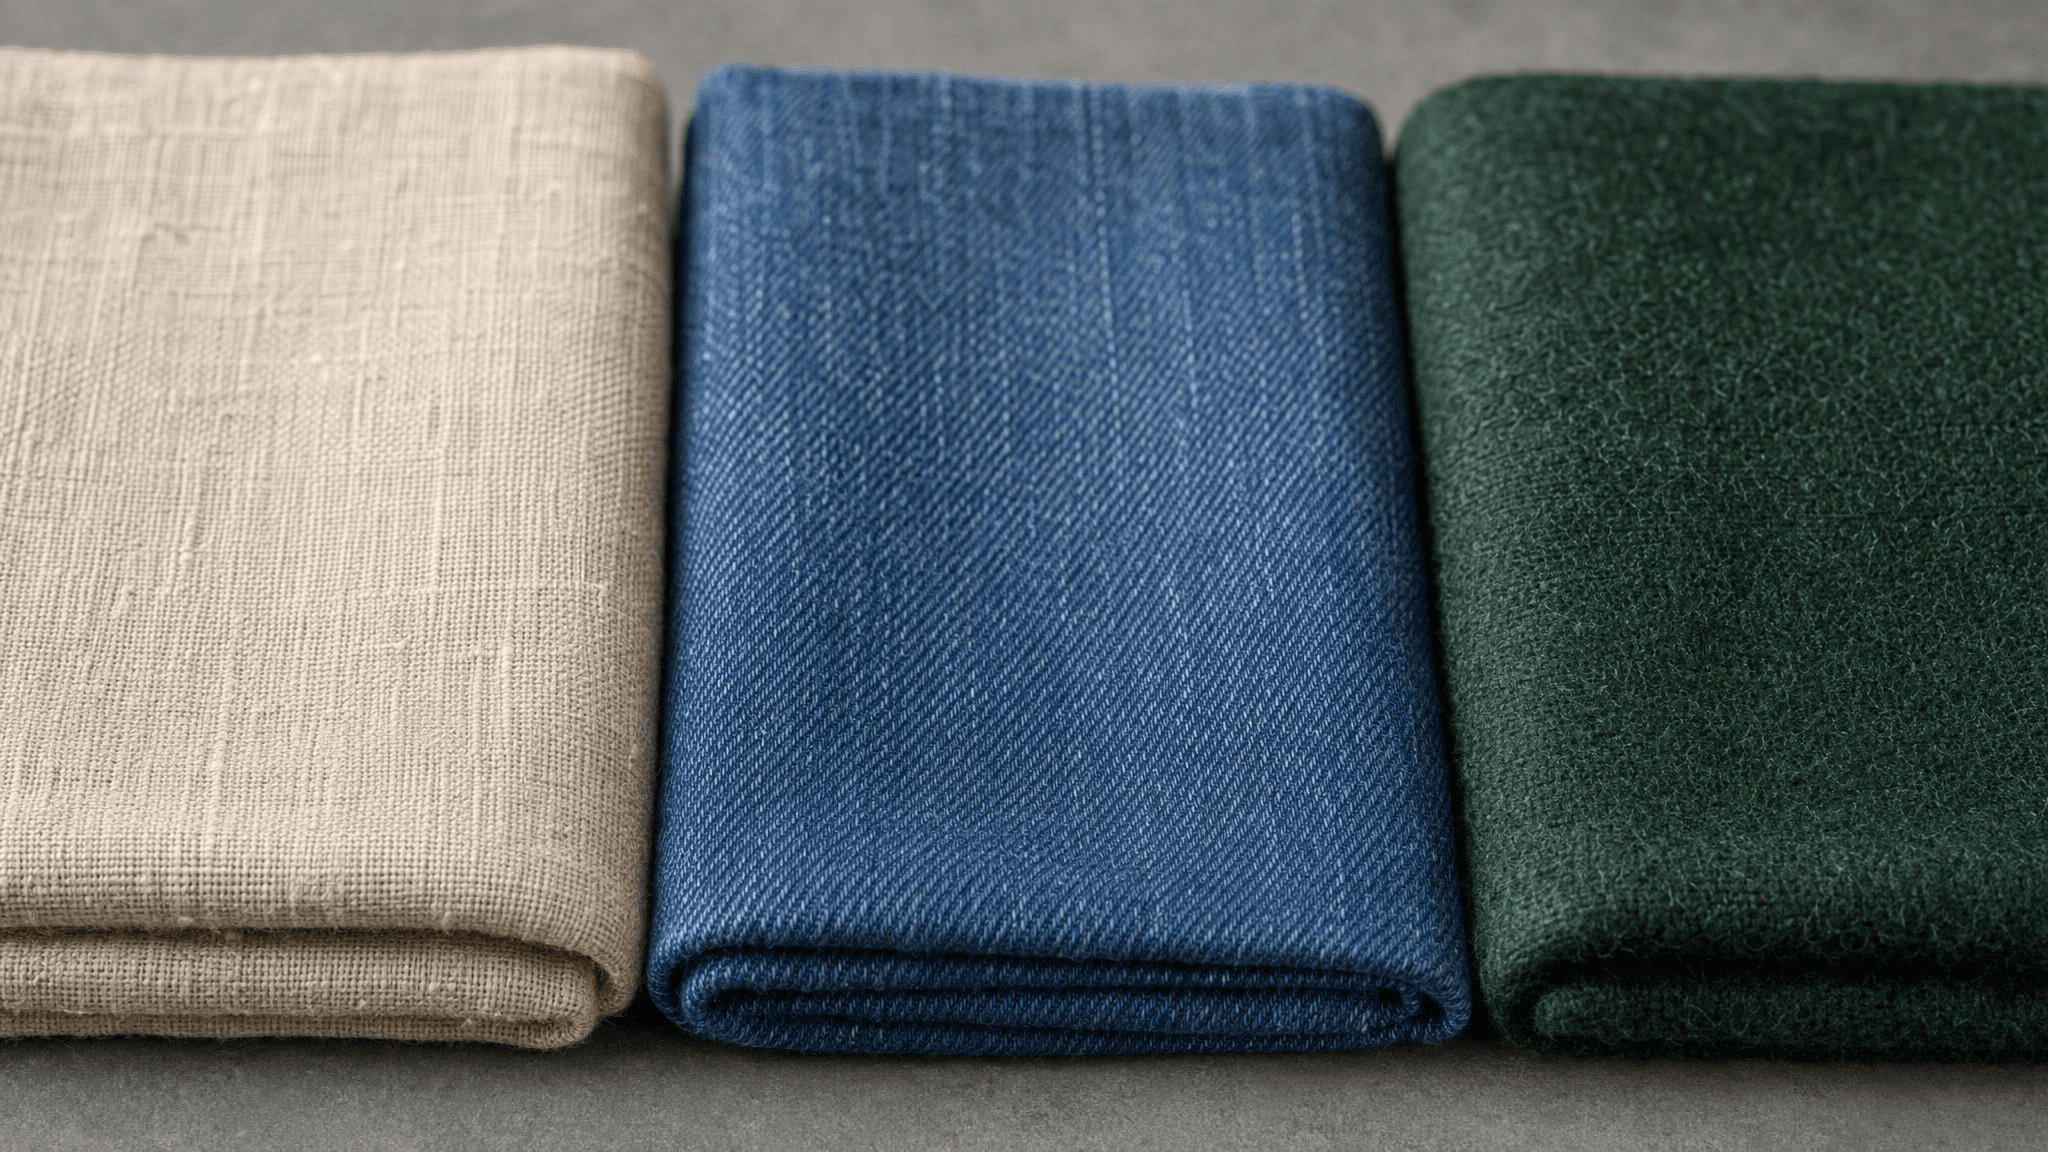 AI 生成的面料插图,带有米色、蓝色和深绿色布样的位置检查
所要求的三块布样在视觉上可以区分。这里生成的纹理只是一张插图,并不能作为真实产品纤维成分的证据。
如果中间的布样纹理看不清,记录这个问题,并调整取景或细节描述。绝不要把生成的纹理说成真实产品实测的属性。
文本类功能也需要同样严格的检查。对于工单分类,要拒绝允许集合之外的标签,并保留一条“不确定”路径。对于文档提取,除了可解析的 JSON,还必须要求字段和来源片段。语法上合法的响应仍然可能把错误的金额放进错误的字段。
面向开发者的生成式 AI API:处理失败
要把传输成功、任务完成和业务验收分别跟踪。一次成功的 HTTP 响应可能只包含一个处理中的任务。一个已完成的任务可能产出一个损坏的下载文件。一张读得出来的图片可能违反简报要求。每一种都需要不同的补救动作。
要有意设定 3 个时钟:单个 HTTP 超时、轮询间隔和整体等待窗口。示例使用 30 秒的 API 请求超时、2 秒轮询和 10 分钟轮询窗口。这些是应用侧的选择,不是服务商宣传的性能。
| 症状 | 可能原因 | 接下来检查 | 重试方式 |
|---|---|---|---|
| 参数错误 | 不支持的字段或取值 | 确切的端点结构与提交的请求体 | 先修正请求 |
| HTTP 401 | 认证问题或路由错误 | 密钥配置与端点路径 | 不要原样重试 |
| 余额不足 | 可用余额或额度 | 账户计费状态 | 先解决资金或额度问题 |
| HTTP 429 | 触发速率限制 | 账户/模型并发与请求速率 | 带抖动的有限退避 |
| 任务报告失败 | 模型、输入或策略问题 | 预测 ID、错误码、错误详情 | 先排查,再重新生成 |
| 轮询超时 | 客户端截止时间或任务缓慢 | 既有任务状态 | 继续查询同一个 ID |
| 已完成但输出为空 | 结果缺失或异常 | 完整的结构化任务响应 | 标记待排查;不要盲目重提 |
当前的平台错误文档说明,LLM 与媒体端点不提供 Retry-After 或剩余速率限制相关的响应头。请使用客户端延迟策略;不要让恢复逻辑依赖于这些路由并不返回的响应头。其他 API 系列的行为可能不同。
自动读取重试要保持有界。指数延迟加上少量随机抖动,有助于避免大量工作进程同时重试。如果限流持续存在,就降低并发。反复失败应当变成一个可观测的事件,而不是藏在加载动画背后的死循环。
提交重试需要更严格的处理。当你在发送请求体之后连接中断,你可能无法知道服务端是否已经创建了任务。提交前先记录一条本地意图;当没有收到预测 ID 时,去查请求历史或联系支持获取追踪信息。除非端点有文档说明,否则不要自行编造幂等头。
拿到 ID 之后,就用它来续跑。下载失败应触发再次下载或状态查询,而不是再发一次图像生成请求。示例有意只在轮询读取时保留自动重试,在提交失败时停止。
每个任务都要保留:应用任务 ID、预测 ID、请求 ID、模型、设置、时间戳和最终处置结果。提示词只能按照合适的数据策略存储。绝不要把授权头或敏感用户内容写进通用错误日志。
给前端提供它能解释清楚的状态:准备中、处理中、校验输出中、就绪,或需要关注。当用户刷新页面时,显示一个可恢复的任务。同一个本地任务还在等待时,禁用重复提交,但在合适的情况下仍允许有意发起新请求。
面向开发者的生成式 AI API:真实成本
单次请求价格低,并不能说明一个可用功能的成本。你的预算需要三项:实际收取的金额、被接受的输出数量,以及为交付它们所需的配套工作。
文本 API 通常区分输入和输出 token。长上下文、检索到的段落、对话历史和重复响应都会累加用量。要记录所选端点实际计费的类别,而不是对每种工作负载都套用一个 token 估算。
对于图像,要查看确切模型的计费单位和配置。尺寸和质量对不同模型计费的影响方式不同。对于视频,时长、分辨率和模型选择都可能改变费用。不要把目录里的起价当作某个具体配置的报价。
在本文调研期间,所选图像模型在高质量、2048 × 1152 下的确切价格,未能在目录页和详情页两处同时核实。此处不主张任何当前单价或折扣。在开展付费的生产评估之前,请先确认价格。
使用两个相关的计算式:
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
观察周期要保持一致。对于持续性存储,要说明该计算覆盖的是第一个月、某个明确的留存期,还是分摊后的经常性成本。不要把某个模型仅含推理的数字,与另一个工作流的全量成本作比较。
假设示例: 你提交 100 个请求,接受 80 个输出。用该批次实际总费用除以 80。如果这 100 个请求都被收取相同的金额 c,那么每个被接受输出的 API 成本就是 1.25c。这个前提很重要:它并不假定每个失败的请求都会被计费。
| 模型 | 设置 | 提交数 | 实际费用 | 被接受的输出 | 每个被接受输出的 API 成本 | 测算日期 |
|---|---|---|---|---|---|---|
| GPT Image 2 文生图 | high;2048x1152;PNG | 待记录 | 待记录 | 待记录 | 待计算 | 待记录 |
| 同一模型,下一评估批次 | 记录确切设置 | 待记录 | 待记录 | 待记录 | 待计算 | 待记录 |
把这当作一张工作表,而不是结果表。这些图像演示并不能得出有代表性的接受率或生产成本。要把试验场报价与最终结算的账单记录分开,尤其是在测试环境中评估时。
当被接受的输出为零时,应把这批任务报告为不成功,并展示总支出。此时“每个被接受输出的成本”这一比率是没有定义的。隐藏失败的批次只会让你的预算看起来比应用的实际表现更好。
先减少浪费:提交前校验输入、保存任务 ID、避免意外重复,并在产品允许时复用已被接受的素材。然后在相同的简报和检查下比较更便宜的设置。一个能压低报价、却让返工翻倍的设置,可能反而抬高功能成本。
校验输出,而不只是响应
在起草提示词的同时就写验收标准。这样可以避免一张看起来很有说服力的图片事后改变你对“成功”的定义。把硬性要求与可选偏好分开,并记录审核者拒绝某个结果的原因。
把有明确机械答案的检查自动化:下载是否成功、文件能否解码、格式、尺寸和文件大小限制。对于 JSON,校验结构、必填字段、允许的标签和类型。缺少必填字段不应悄悄变成一个编造的默认值。
需要解读的要求交给人工审核。在早餐示例中,审核者必须分辨出重叠的切片、认出那把刀、判断它的位置,并找出多余的对象。自动视觉检查器可以提供辅助,但在让它单独批准结果之前,先评估它的出错情况。
早餐图的审核应包含以下各项独立检查:
- 正好 2 片吐司、1 个白盘子、1 个透明果酱碗和 1 把刀。
- 刀位于盘子右侧;必需物体完整在画面内。
- 没有多余的杯子、餐具、手、包装或可见品牌标识。
- 在请求尺寸下可正常读取的 PNG。
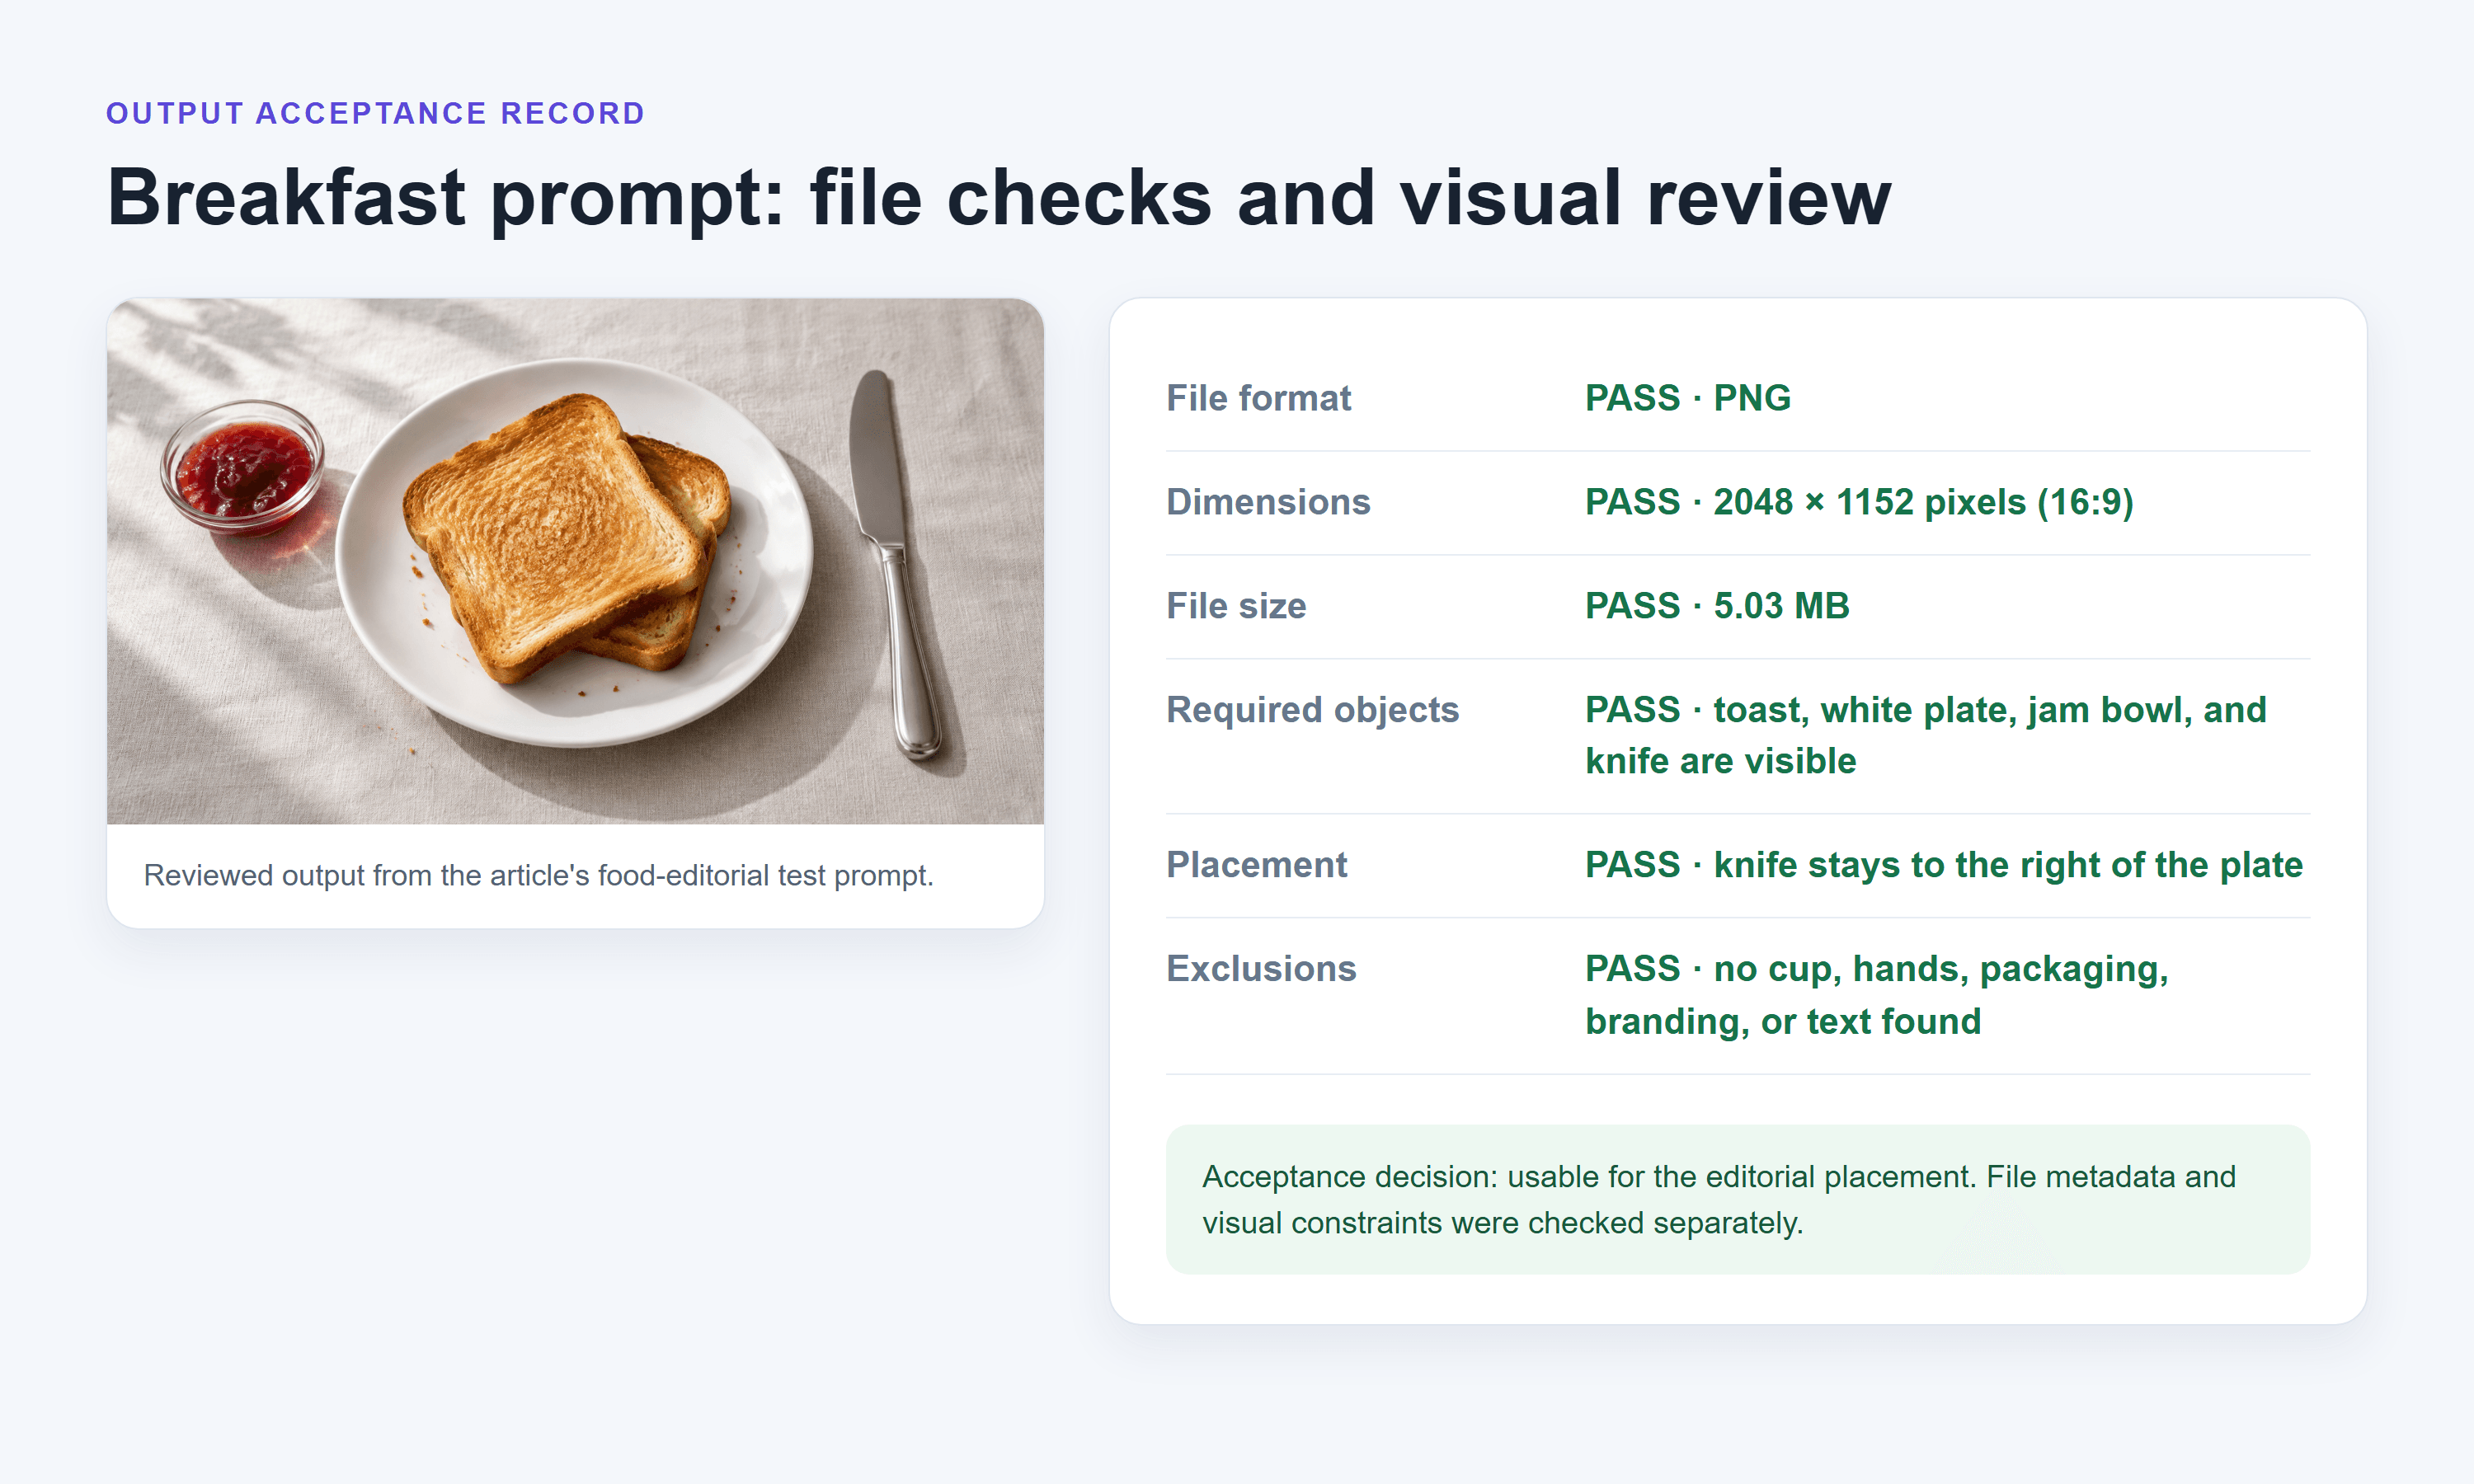 校验记录,将文件元数据检查与视觉验收检查分开
该记录将生成文件的真实尺寸和大小与其视觉验收检查分开报告。
基于实际功能构建一组固定的回归用例:常规请求、拥挤构图、相互冲突的指令、棘手的裁切,以及相关的输入限制。给简报和审核规则加上版本。在更换模型、提示词模板或输出设置时重新跑一遍。
把技术成功率与被接受的输出率分开报告。一个能正常读取、却多了一个对象的文件,既算成功交付,也算内容被拒。把这两种结果合并成一个成功率数字,会掩盖团队真正需要修复的问题。
2025 年开发者调查发现,46% 的人不信任 AI 工具的准确性,33% 的人信任,3% 表示高度信任。这些回答针对的是开发工作流中的 AI 工具,并不是生成 API 的实测失败率。(Stack Overflow 开发者调查,2025 年。)
同样,3 次演示运行无法得出整体准确率或有参考价值的 p95 延迟。要在你预期生产环境中会遇到的各类条件下收集更大、更有代表性的样本,并保留异常值。先用这些演示来开发检查项,再用系统化评估来做发布决策。
上线前的生产环境清单
第一个跑通的请求,只解决了发布决策中的一小部分。你的应用还必须控制支出、恢复未完成的工作,并在拿不到结果时说明发生了什么。
保护访问。 把凭据放在后端,隔离环境,限制对任务记录的访问,并规划凭据轮换。每个状态查询和下载请求都要针对拥有该任务的用户做鉴权。任务 ID 难以猜到,并不能替代权限检查。
限制输入与资源占用。 校验提示词长度、上传类型和大小、请求的输出设置以及受支持的组合。对于下载的媒体,要强制限制允许的目标地址、重定向、字节上限和解码上限。上面的精简脚本只是演示生命周期,并不是加固过的公开下载服务。
提交前设定预算。 定义每个用户和每个任务的限额、最大并发任务数,以及谁可以请求更昂贵的设置。任务待处理时就预留预算,这样并发请求不会都通过同一个剩余余额检查。
持久化状态。 在调用服务商之前先写入本地任务。立即保存返回的预测 ID,并让轮询在进程重启后仍可续跑。如果提交状态未知,就使用“排查中”状态,而不是告诉用户任务肯定失败了。
对交付的素材负责。 决定被接受的文件存放在哪里、谁能访问、何时过期。核实服务商链接的有效期和留存条款,而不是无限期依赖一个临时输出 URL。把派生文件的删除纳入应用的数据流程。
让失败可被理解。 区分任务延迟、结果被拒和服务错误。提供明确的路径,让用户有意重试或请求人工审核。保留用户的简报,这样恢复时不必重新拼凑原本的工作。
监控变更。 分别跟踪完成情况、接受率、成本和等待时间。在模型或参数变更后重跑回归用例,并在可行时保留上一套配置。对敏感日志做脱敏,并为内容记录和运营记录都设定留存期限。
要针对你自己的应用评估这个示例平台,可以先从 Atlas Cloud 模型目录 入手,然后阅读所选端点和预测相关的文档。先选定一个任务,定义验收标准,并记录评估实际交付了什么,然后再扩大使用范围。
常见问题
我该为应用选择哪个生成式 AI API?
围绕功能的输入、输出、可接受的等待时间和审核要求来选择。在你法律上和运营上都能使用的候选方案上,跑同一组有代表性的简报。在比较能力的同时,也比较被接受输出的成本和集成工作量。这 3 个图像示例并不能得出一个普遍适用的答案。
有面向开发者的免费生成式 AI API 吗?
有些服务提供试用或有限的免费额度,但可用性、资格、配额和允许的用途都会变化。请核实确切端点的当前条款。消费级工具的免费额度不一定包含 API 访问权限。即使模型权重可以下载,自托管同样要消耗硬件、电力和工程时间。
使用生成式 AI API 需要机器学习经验吗?
你可以从 HTTP、JSON、认证和普通的后端开发技能起步。但要交付一个可靠的功能,还需要评估和运维方面的工作。你需要足够了解模型的局限,以便定义可接受的输出,而不必自己去训练模型。
一个 API 能同时处理文本、图像和视频吗?
一个平台可能三种都提供,但每种能力可能使用不同的端点、参数、输出类型和等待模式。要分别验证每个接口。共用同一个账户或凭据,并不意味着文本请求体能用于图像或视频模型。
为什么我的图像请求返回的是任务 ID 而不是图片?
该端点以异步方式提交任务。保存这个 ID,并查询文档中的状态路由。任务完成后取回文件,然后校验它。如果客户端停止等待,服务端任务可能仍在运行;在再次提交之前,先续查那个任务。
如何在不破坏工作流的前提下降低 API 成本?
避免重复提交、尽早校验输入、在合适时复用已被接受的素材,并在验收标准不变的前提下测试更便宜的配置。按每个被接受的结果衡量实际费用。只有当外围应用能以你可持续承担的成本交付可用成果时,面向开发者的生成式 AI API 才真正物有所值。


