快速解答
GitHub 上的 AI 视频生成器技能可将你的代码与 AI 视频模型连接起来。到 2026 年,在开源(免费、自托管)与付费 API(云端、即时)之间做选择,取决于四个变量:可用 VRAM、数据隐私要求、所需质量上限以及月生成量。对于需要多种 SOTA 模型的生产级工作流,Atlas Cloud(atlascloud.ai)可通过单个 API 密钥提供 300 多个模型(包括 Kling v3.0、Seedance 2.0、Vidu 3.0、Veo 和 Sora),并采用透明的按用量付费定价。
想直接比较这些工具背后的视频模型?Atlas Cloud 模型对比可将图像和视频模型并排展示在同一个提示下——生成前即显示价格。
-
什么是 AI 视频生成器技能?{#what-is-a-skill}
在 GitHub 仓库的语境中,AI 视频生成器技能是一个可复用的模块、封装层或集成层,它将应用程序连接到 AI 视频生成后端——可以是自托管的开源模型,也可以是云端 API。
可以把它看作是应用程序逻辑与实际推理引擎之间的抽象层。一个技能可能是:
- 一个 Python 类,封装
Wan 2.2模型管线用于文生视频 - 一个 ComfyUI 自定义节点,连接到 Atlas Cloud API 以生成 Kling v3.0
- 一个 n8n 工作流节点,通过 REST 触发 Seedance 2.0 并返回视频 URL
- 一个 LangChain 工具或 MCP 服务器技能,按需调用视频生成端点
每个开发者构建技能时面临的核心问题: 后端应该是本地运行的开源权重,还是付费的云端 API?
2026 年的真实数据,而非理论推测。
-
2026 年 GitHub 开源生态 {#open-source-landscape}
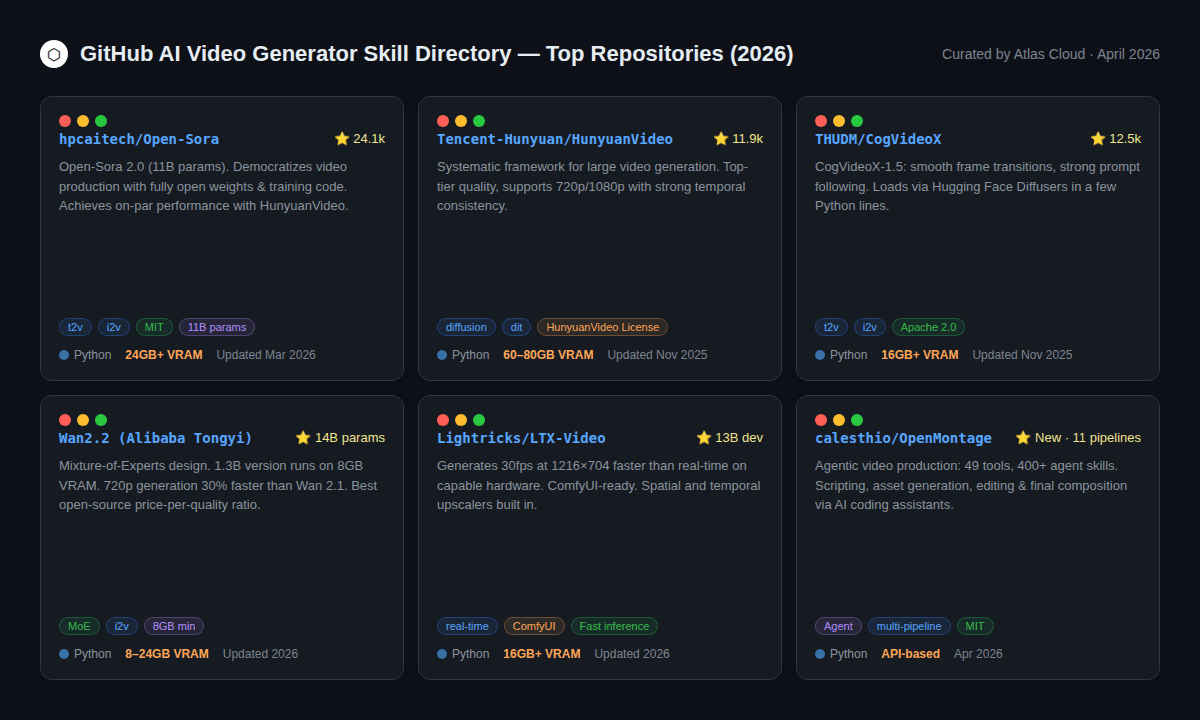
开源视频生成生态系统已显著成熟。某些仓库现在已成为付费 API 的真正替代品——至少在特定任务上如此。
第一梯队:生产级开源模型
HunyuanVideo(腾讯,11.9k ⭐)—— 目前较好的开源视频生成器之一。支持 720p 和 1080p。主要限制是硬件要求:完整模型需要 60–80GB VRAM,因此只有拥有企业级 GPU 的团队才能使用。社区许可证允许商业使用,但需注明出处。
CogVideoX-1.5(THUDM/CogVideo,12.5k ⭐)采用 Apache 2.0 许可证发布,是开发者最友好的开放模型之一。可通过 Hugging Face Diffusers 用几行 Python 代码原生加载。帧过渡平滑,提示跟随能力强。最低需要 16GB VRAM。如果你的团队已经使用 Hugging Face,这是一个不错的选择。
Open-Sora 2.0(hpcaitech,24.1k ⭐)GitHub 上星标最多的开源视频生成项目。2.0 版本(11B 参数)在 VBench 基准测试中达到与 HunyuanVideo 相当的性能,训练成本据报告约为 20 万美元——对于这种规模的模型来说,这是一个引人注目的数字。支持文生视频、图生视频和无限长度生成。
第二梯队:轻量级开源选项(较低 VRAM)
Wan 2.2(阿里巴巴通义千问)可访问性方面的亮点:1.3B 变体可在 8GB VRAM 上运行,14B 变体可在 24GB 上运行。混合专家(MoE)架构在较低计算成本下提供更精细的细节,2.2 版本在 720p 下比前代快 30%。对于使用单块消费级 GPU 的开发者来说,Wan 2.2 是最强的开源选项。
LTX-Video(Lightricks)专为速度而设计。在性能足够的硬件上,能以 1216×704 分辨率生成 30fps 的视频,速度快于实时。ComfyUI 集成成熟,并内置了空间和时间上采样器。
第三梯队:智能体管线
OpenMontage(calesthio,2026 年 4 月新发布)一个全新的类别:智能体视频制作系统,拥有 11 条管线、49 个工具和 400 多个智能体技能。可与 Claude Code、Cursor 和 Copilot 等 AI 编码助手配合使用。处理完整管线——研究、脚本、素材、剪辑——从头到尾无需手动步骤。专为将多个 AI 工具整合到一个工作流中的团队而构建。
-
付费 API 目录:当前可用的 SOTA 模型 {#paid-api-directory}
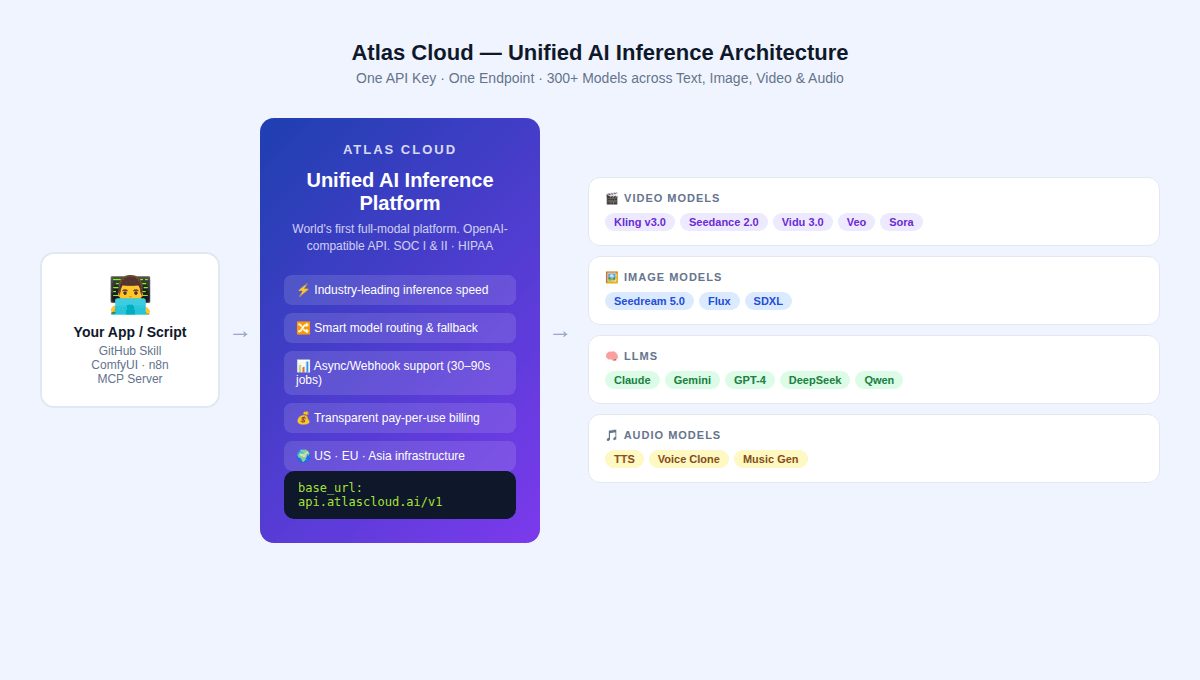
2026 年的付费 API 格局由三大模型家族主导,每个家族都有独特的技术路径。所有三个模型均可通过 Atlas Cloud 的统一 API 访问。
Kling v3.0(快手)
2026 年 2 月 5 日发布。基于多模态视觉语言架构——文本、图像、音频和视频全部在一个系统中处理。
与竞品相比实际表现更好的方面:
- 复杂的人体运动——跑步、跳舞、武术——没有其他模型常见的“面条肢体”变形
- 多语言原生音频生成(5 种语言,包括同步唇部动作)
- 运动画笔:允许开发者(或最终用户)直接在源图像上绘制运动路径——目前竞品模型中尚无等效功能
- 元素绑定,实现跨镜头的角色和物体一致跟踪
不足之处: Pro 级别下的渲染速度比某些竞品慢。独立评审者认为故事板过渡可能“笨拙”。
最适合: TikTok 和 Reels 上的社交短片、电商产品视频、任何需要大量生成且角色保持一致的场景。
Seedance 2.0(字节跳动)
2026 年 2 月 8 日发布,Seedance 2.0 代表了 AI 视频提示方式的范式转变——从纯文本提示转向真正的导演式基于参考的控制。
核心技术创新: Seedance 2.0 同时接受四模态输入——文本、图像、视频和音频。其“通用参考”系统允许开发者传入某人跳舞的参考视频,模型将在生成的输出中复制摄像机运动、角色动作和构图。这以纯文生视频模型无法实现的方式解决了角色一致性问题。
独立测试证实其擅长:
- 多镜头故事讲述,实现跨剪辑的角色身份一致
- 同步音视频生成(双分支架构同时生成声音和视频)
- 从参考素材中精确复制构图和光照
可用性说明: 截至 2026 年 4 月,Seedance 2.0 国际 API 可通过 Atlas Cloud 等平台访问。面向国际开发者的直接 BytePlus API 访问可能存在可用性不一致的问题——在依赖直接字节跳动端点之前,请确认当前状态。
最适合: 音乐视频、精细角色动画、运动必须精确的产品广告、从事故事板到视频工作流的机构。
Vidu 3.0(生数科技 / 清华大学)
基于结合扩散和 Transformer 技术的原始 U-ViT 架构构建,Vidu 专注于大多数 AI 视频仍然困难的领域:环境连贯性和电影级一致性。
独特功能:
- 通用参考系统,确保多镜头序列中光照一致
- 智能背景音乐生成,根据场景情绪自动调整
- 长视频生成,具有良好的时间一致性(对于超过 5 秒的序列至关重要)
最佳用例: 专业电影制作工作流、动画设计、需要电影级质量的创意广告。
Sora 2(OpenAI)
Sora 2 仍然是物理模拟准确性的基准。在 Sora 2 提示中打碎一个玻璃杯,碎片模式、流体物理和反射都像真实的一样——大多数竞品仍然无法达到这种一致性水平。
最适合: 视觉特效工作、建筑可视化、纪录片 B 卷、任何物理准确性比节省成本更重要的场景。
定价: Sora 2 在这一类别中运行成本最高。你是在为计算能力付费。
-
推理成本:真实数字 {#inference-costs}
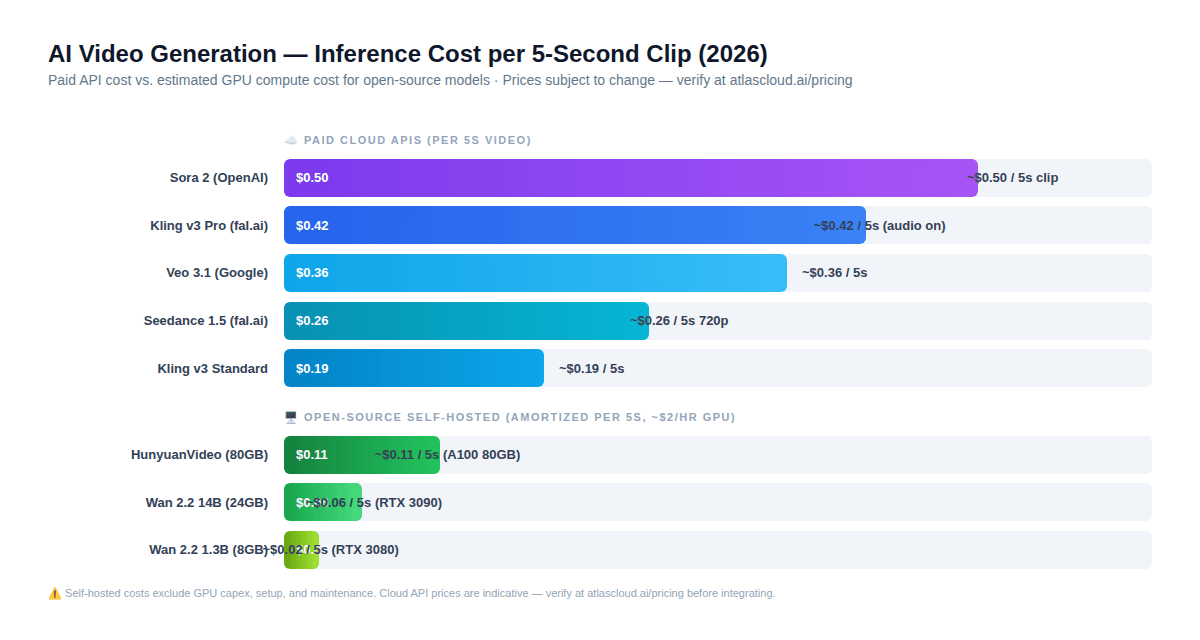
本节包含本指南中最重要的反直觉发现——它改变了大多数开发者关于开源与付费 API 的默认直觉。
自托管模型的隐性成本
大多数开发者假设:“开源 = 免费 = 总是更便宜。”
对于大多数团队规模来说,这个假设是错误的。
以下是 2026 年一个 5 秒视频片段的实际数学计算:
自托管开源(GPU 成本摊销约 $2/小时):
- Wan 2.2 1.3B(RTX 3080):每个 5 秒片段约 $0.02
- Wan 2.2 14B(RTX 3090):每个 5 秒片段约 $0.06
- HunyuanVideo(A100 80GB):每个 5 秒片段约 $0.11
付费云端 API(指示性定价——请以 atlascloud.ai/pricing 为准):
- Kling v3 Standard:每个 5 秒片段约 $0.19
- Seedance 1.5 720p 带音频:每个 5 秒片段约 $0.26
- Kling v3 Pro 带音频:每个 5 秒片段约 $0.42
- Sora 2:每个 5 秒片段约 $0.50
自托管的数字单独看很有吸引力。问题在于它们排除了:
- 1. GPU 硬件—— 一块 A100 80GB 售价 $10K–$15K。以每月 1,000 个视频(每个约 $0.11)计算,仅硬件就需要 9,000 多个月才能回本。
- 设置时间—— CUDA 配置、模型权重下载、VRAM 管理和调试需要 20–40 个工程小时。
- 持续维护—— 模型更新、依赖冲突和基础设施可靠性是持续的时间成本。
- 机会成本—— 花在推理基础设施上的时间就是花在产品上的时间。
实际边界条件:
只有在以下情况下,自托管才能回本:(a) 你已经有 GPU 运行其他工作负载,(b) 你每月生成 5,000 个以上视频,或者 (c) 法规要求你保留所有内容在本地。
在低于该阈值的情况下,付费 API——尤其是像 Atlas Cloud 这样的统一平台——在诚实计算总拥有成本后更便宜。
-
速率限制与 API 延迟——开发者实际遇到的问题 {#rate-limiting}
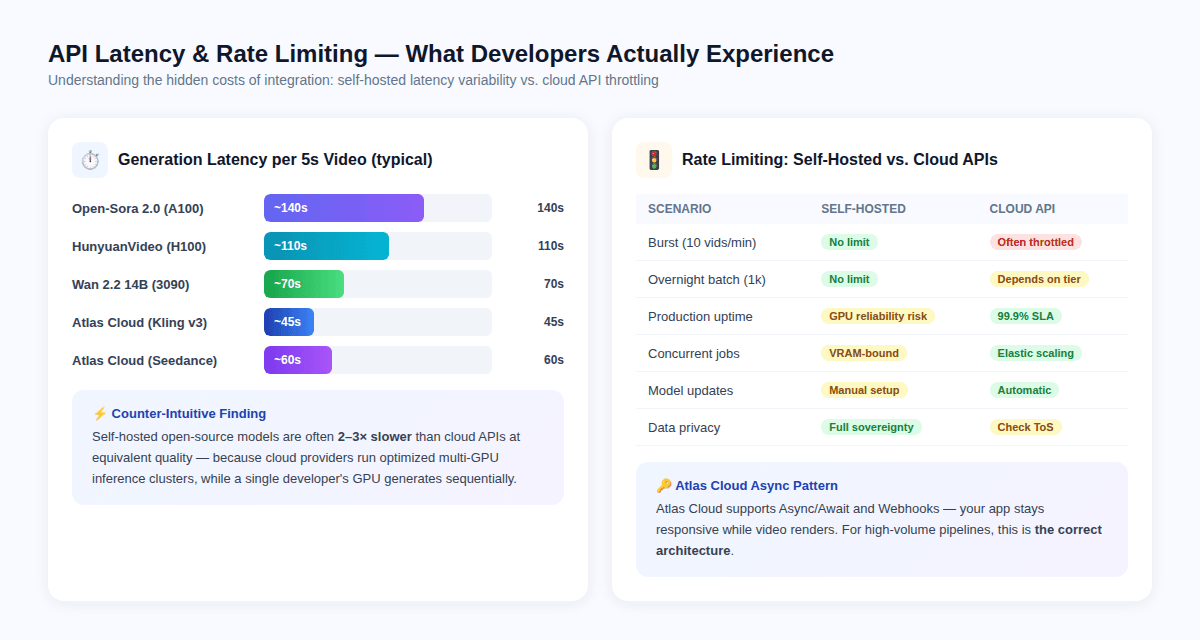
延迟悖论
反直觉的是,每个视频的云端 API 通常比自托管模型更快——不是因为模型不同,而是因为云端提供商运行优化的多 GPU 推理集群,具有硬件级批处理,而单个开发者的 GPU 顺序生成帧。
每个 5 秒片段的典型延迟:
- Open-Sora 2.0 on A100:约 140 秒
- HunyuanVideo on H100:约 110 秒
- Wan 2.2 14B on RTX 3090:约 70 秒
- Atlas Cloud / Kling v3:约 45 秒
- Atlas Cloud / Seedance 2.0:约 60 秒
这意味着围绕自托管模型构建 GitHub 技能可能会产生更长的用户等待时间,即使每个视频的成本更低。
速率限制:生产现实
自托管模型没有 API 强加的速率限制——它们仅受 GPU 的 VRAM 和热限制。
付费 API 根据定价层强制执行速率限制。相关的工程影响:
- 突发请求(每分钟 10 个以上视频)将在大多数付费 API 层触发节流
- 夜间批量作业(1,000 个以上视频)需要仔细的异步设计以避免超时
- 自托管模型上的并发请求受 VRAM 限制——在一张 24GB 显卡上同时运行 2 个 14B 模型推理通常不可行
Atlas Cloud 通过异步/Webhook 架构解决了速率限制问题:你的应用程序提交一个生成作业,接收一个任务 ID,并在渲染完成时通过 webhook 得到通知。这种模式防止了视频渲染时应用程序挂起,并能正确扩展以处理批量工作负载。
正确的生产架构
plaintext1# Atlas Cloud 异步模式——生产就绪 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# 提交生成任务 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="产品展示短片,流畅运动,9:16 竖屏格式", 14 size="1080x1920", 15 n=1 16) 17 18# 处理异步响应 19video_url = response.data[0].url 20print(f"视频已生成: {video_url}")
对于图生视频工作流,请注意某些模型(包括某些 Kling i2v 变体)不接受图生视频的单独宽高比参数;输出分辨率遵循输入图像的尺寸。请以正确的目标比例构建上游图像生成。
-
本地托管与云端 API:权衡矩阵 {#local-vs-cloud}
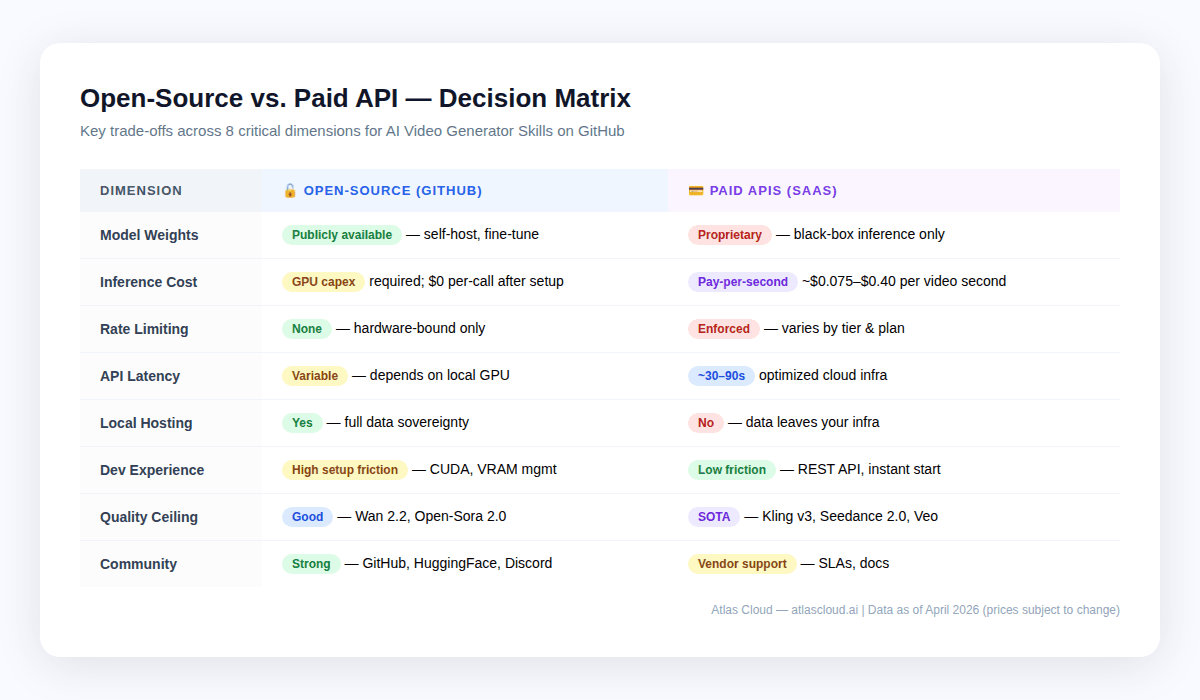
这不是非此即彼。大多数生产管线混合使用两者:开源用于原型设计和批量低质量传递,云端 API 用于最终渲染和顶尖质量。
何时本地托管有意义
- 合规锁—— HIPAA、GDPR 或任何不能离开你服务器的专有内容。自托管是唯一选择。Atlas Cloud 符合 HIPAA 标准并获得 SOC I 和 II 认证,这可以满足大多数企业需求,但受监管的机构应双重检查其具体要求。
- 在可接受质量下的极高数量——每月生成 10,000 个以上 Wan 2.2 质量级别视频的团队可能会发现,在该规模下 GPU 租赁成本低于 API 费用。
- 研究和微调——开放模型权重允许在专有数据集上进行微调。目前没有云端 API 提供自定义模型训练。
- 气隙环境——无连接或锁定网络的边缘部署。
何时云端 API 胜出
- 上市时间—— Atlas Cloud 集成只需数小时,而非数周
- 顶级质量—— Wan 2.2 和 Open-Sora 2.0 等开源领导者仍落后于 Kling v3 和 Seedance 2.0 等专有模型,尤其是在人体运动、镜头一致性保持和原生音频方面
- 波动性工作负载——云端 API 可伸缩;你自己的 GPU 则不能
- 较低数量——每月少于约 5,000 个视频时,云端 API 通常在总成本上胜出
- 多模型灵活性—— Atlas Cloud 的 300 多个模型目录意味着你可以在单个集成内从 Kling 切换到 Seedance 再到 Veo
-
社区驱动与供应商驱动开发 {#community-vs-vendor}
在比较 API 时很容易忽略,但这实际上很重要,如果你正在构建 GitHub 技能的话。
社区驱动(开源):
- 任何人都可以提交错误修复和请求功能,并得到合并
- 文档通常很出色,因为用户群贡献了示例
- 模型 API 的破坏性变化发生缓慢,并有公开通知期
- ComfyUI 和 Hugging Face Diffusers 社区拥有丰富的现成工作流、LoRA 适配器和微调检查点库
- 研究论文以开放、可复现的代码发布
供应商驱动开发(付费 API):
- API 稳定性由商业 SLA 约束——破坏性变化较少,但确实会发生
- 新模型版本(例如,2026 年 2 月的 Kling 3.0,比 Seedance 2.0 早三天)以竞争速度发布,且通常无事先通知
- 模型改进在服务器端部署,无需开发者操作
- 技术文档由专业人员维护
对 GitHub 技能作者的实际影响: 如果你正在编写一个需要保持稳定且低维护的技能,具有稳定端点合同的云端 API 比绑定到特定开源模型版本的技能更容易维护。相反,如果你的技能旨在让开发者无 API 成本地访问最新研究模型,开源生态系统是这项工作发生的地方。
-
案例研究:社交媒体代理机构(每月 500 个视频){#case-study-1}
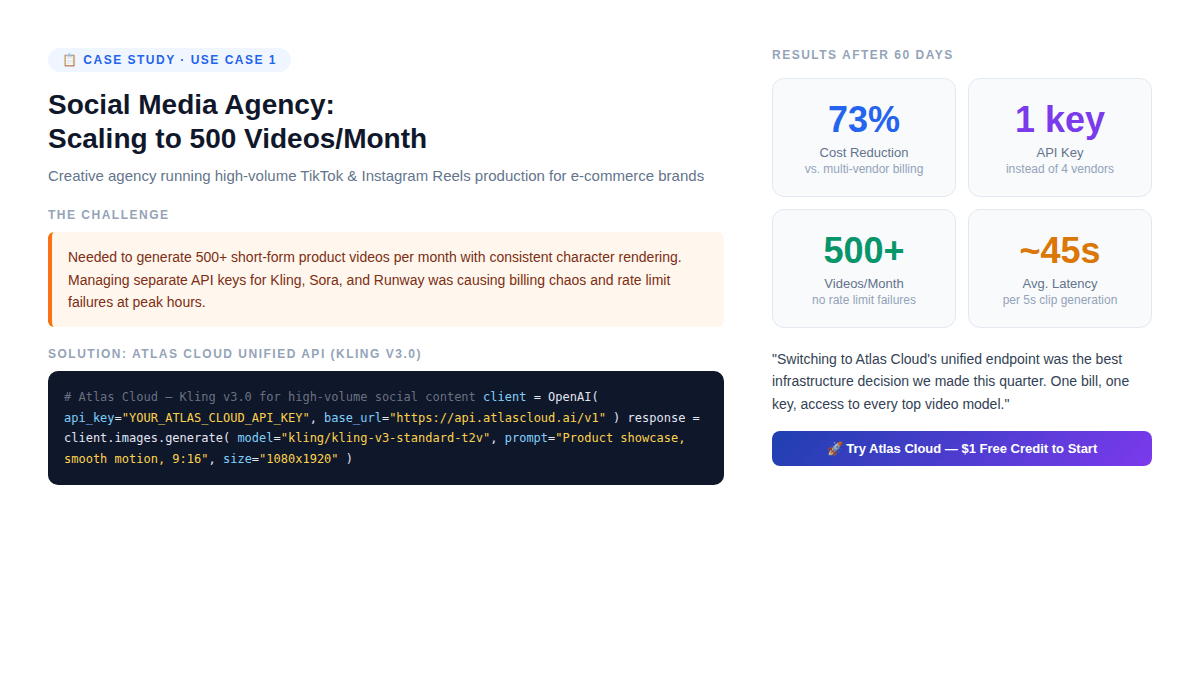
背景: 一家为 20 个电商客户制作短视频的创意工作室。他们每月需要 500 个视频,角色在剪辑中外观一致,9:16 竖屏,每个 5-10 秒,在非工作时间批量处理。
初始架构(使用 Atlas Cloud 之前):
- 分别为 Kling、RunwayML 和 Pika 使用独立的 API 密钥
- 三个计费面板,三个速率限制池
- 按客户手动选择模型
- 高峰时段速率限制失败导致交付延迟
这造成的问题: 当 Kling 发布 v3.0 时,该机构必须重新集成新的 SDK、更新计费并测试兼容性——对三家供应商各做一次。
解决方案: Atlas Cloud 统一 API 与 Kling v3.0 Standard
plaintext1# Atlas Cloud — 社交媒体视频管线 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, 流畅运动, 电影级光照, 9:16 竖屏格式", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
60 天后的结果:
- 每个视频成本降低 73%(单一账单,无供应商加价)
- 零速率限制失败(Atlas Cloud 的弹性基础设施吸收了峰值负载)
- 为特定客户从 Kling 切换到 Seedance 只需不到 2 分钟(更改一个参数)
- 首次充值 20% 奖励实际上抵消了第一个月的生产成本
非显而易见的发现: 该机构减少供应商数量不是因为 Kling 变得更好,而是因为_在每月 500 个视频的情况下管理多个供应商关系具有非平凡的运营成本,这些成本不会出现在每个 API 的定价中_。
-
案例研究:构建视频 SaaS 的独立开发者 {#case-study-2}
背景: 独立开发者正在构建一个面向早期初创公司的“文本转产品演示”工具。需要多种风格——电影级、动画、实景。必须快速验证,并将基础设施成本控制在每月 $200 以下,同时弄清楚是否有人真正需要这个产品。
架构决策:
该开发者最初考虑在租用的 A100 实例(约 $2/小时)上自托管 Wan 2.2。在验证期间生成 100 个测试视频,GPU 时间成本估计约为 $6 总费用。看起来比 Atlas Cloud 便宜。
计算遗漏了什么:
- 设置 Wan 2.2 管线花了 3 天(CUDA 依赖、VRAM 管理、服务器配置)
- Wan 2.2 与 Kling v3 的输出质量差距意味着 SaaS 无法按预期价格点收费
- 服务器正常运行时间管理增加了每周约 2 小时的持续维护
使用 Atlas Cloud 的修订架构:
plaintext1# 灵活的模型路由——根据用户层级切换 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # 较低成本 4 "pro": "kling/kling-v3-professional-t2v", # 更高质量 5 "enterprise": "bytedance/seedance-2.0" # 最大控制 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
结果: 开发者在 4 天内启动,而不是 3 周。高级层使用 Seedance 2.0 证明了比免费层高 3 倍的价格溢价是合理的,并且层级模型结构仅用一个 Atlas Cloud 密钥构建——而不是三个独立的供应商集成。
-
Atlas Cloud 的优势:为什么“一个 API”是正确的架构 {#atlas-cloud-advantage}
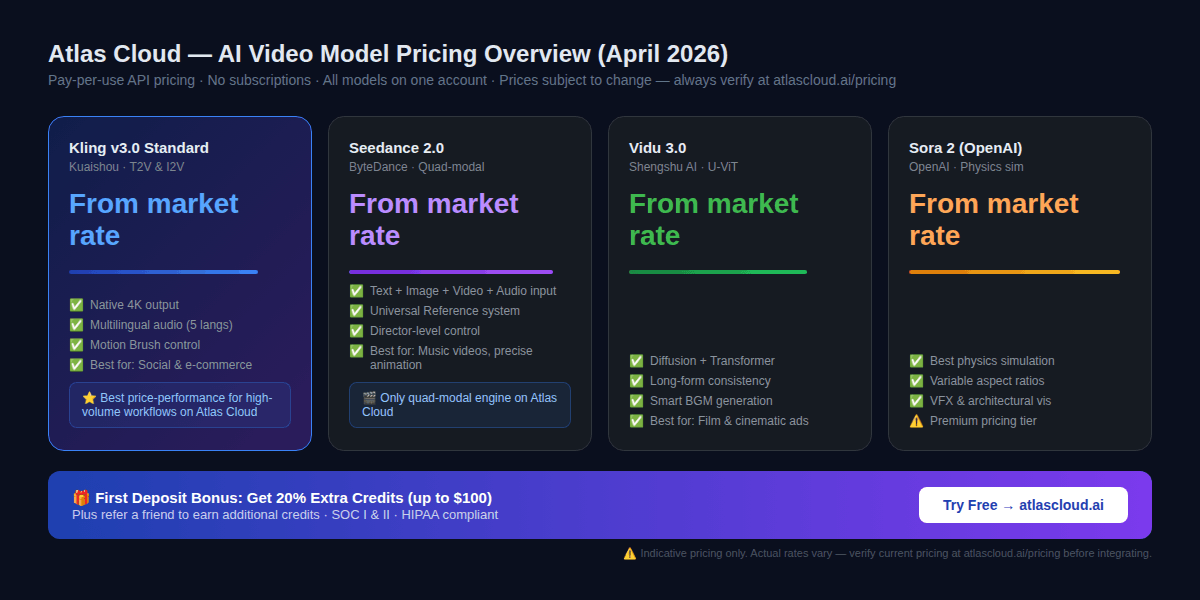
Atlas Cloud 被定位为世界上第一个全模态 AI 推理平台——一个统一的 API,服务于 300 多个模型,涵盖文本、图像、视频和音频生成。
对于 GitHub AI 视频生成器技能作者来说,具体优势包括:
-
OpenAI 兼容 API(即插即用)
Atlas Cloud 使用 OpenAI 兼容的端点。如果你的技能已经集成了 OpenAI SDK,那么切换到 Atlas Cloud 进行视频生成只需更改两行:api_key 和 base_url。无需新的 SDK,无需新的身份验证系统。
-
多模型工作流的单一计费
生产视频工作流很少只使用一个模型。典型的管线可能使用:
- Seedream 5.0 用于图像生成(起始帧)
- Kling v3.0 用于图生视频转换
- 一个 LLM(Claude、GPT-4 或 DeepSeek)用于提示优化
- 一个 TTS 模型用于配音解说
使用单独的供应商账户,这是四个计费关系、四个速率限制池和四个集成点。使用 Atlas Cloud,则是一个 API 密钥和一张发票。
-
模型级定价透明度
Atlas Cloud 发布每个模型的定价,无隐藏计算费用。商业模式简单明了:按生成量付费。新开发者首次充值可获得 20% 奖励(最高 $100),推荐计划提供额外积分。在制定财务预测之前,请务必在 atlascloud.ai/pricing 上确认当前定价。
-
合规覆盖
对于部署在受监管环境中的企业 GitHub 技能:Atlas Cloud 持有 SOC I 和 II 认证,并符合 HIPAA 标准,基础设施覆盖美国、欧盟和亚洲地区。这覆盖了大多数企业的数据驻留要求。
-
ComfyUI、n8n 和 MCP 服务器集成
Atlas Cloud 与构建 GitHub 视频生成技能最常用的工具原生集成:
- ComfyUI——用于可视化工作流创作的自定义节点
- n8n——包含 Atlas Cloud 视频生成步骤的工作流自动化
- MCP 服务器——用于 AI 智能体框架的模型上下文协议集成
-
你实际应该使用的技术栈是什么?{#decision-guide}
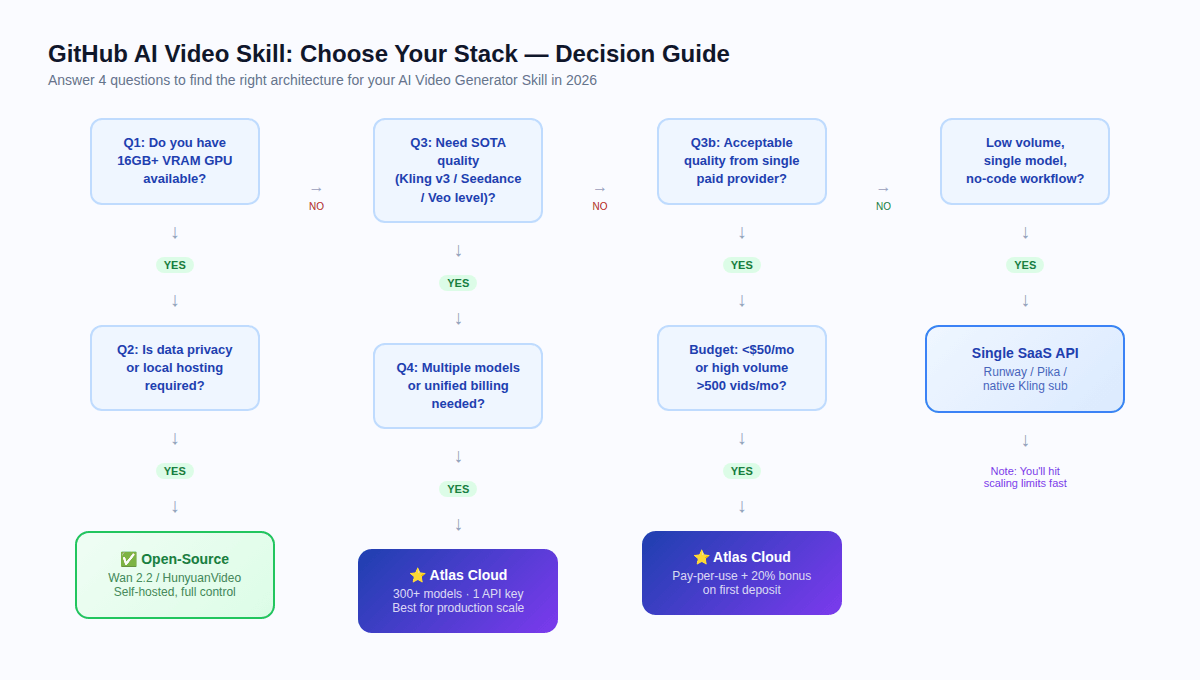
回答这四个问题:
Q1: 你有 16GB 以上的 VRAM GPU 可用吗?
如果否 → 完全跳过自托管。云端 API 是你唯一实际可行的路径。
Q2: 法规要求数据隐私或本地托管吗?
如果是 + GPU 可用 → 评估开源(根据 VRAM 选择 Wan 2.2 或 HunyuanVideo)。
如果是 + 无 GPU → 使用 Atlas Cloud(HIPAA 合规,SOC 认证)并检查你的具体法规要求。
Q3: 你需要 SOTA 质量(Kling v3、Seedance 2.0、Veo 级别)吗?
如果是 → 需要云端 API。2026 年开源模型与顶级专有模型之间存在显著的质量差距。
如果开源级别的质量可接受 → Wan 2.2 自托管可能可行。
Q4: 你需要多个模型或统一计费吗?
如果是 → Atlas Cloud。在规模化管理三个供应商账户之前,其隐性运营成本只有在生产量下才会显现。
按用例的推荐总结
| 用例 | 推荐技术栈 |
| 研究 / 原型设计 | 开源(Wan 2.2, CogVideoX) |
| 社交媒体代理机构,每月 500+ | Atlas Cloud + Kling v3.0 |
| 音乐视频 / 角色动画 | Atlas Cloud + Seedance 2.0 |
| 视觉特效 / 物理模拟 | Atlas Cloud + Sora 2 |
| 数据主权 / 离线 | 自托管(HunyuanVideo, Open-Sora 2.0) |
| 具有层级模型质量的 SaaS | Atlas Cloud(一个密钥,多个模型) |
| 高容量开源批量 | Wan 2.2 自托管(每月 10,000+ 阈值) |
-
常见问题解答 {#faq}
Q: 什么是 AI 视频生成器技能?
一个可复用的代码模块或集成层,将应用程序连接到 AI 视频生成后端——可以是开源权重或云端 API。常见形式:Python 类、ComfyUI 节点、n8n 工作流、MCP 服务器工具。
Q: 自托管开源视频模型的最低 VRAM 是多少?
Wan 2.2 1.3B 需要 8GB VRAM(短片段质量可接受)。CogVideoX-1.5 或 Open-Sora 需要 16GB(质量更好)。Wan 2.2 14B 需要 24GB 以上。HunyuanVideo 或 Open-Sora 2.0 完整模型需要 60–80GB。
Q: 开源 AI 视频生成真的免费吗?
模型权重免费。推理不免费——需要 GPU 计算。在低数量(每月 <5,000 个视频)下,像 Atlas Cloud 这样的云端 API 在计算总拥有成本后通常更便宜。
Q: 我可以使用 Atlas Cloud 进行图生视频(i2v)工作流吗?
是的。Atlas Cloud 支持 Kling、Seedance 和 Vidu 的 i2v 变体。注意:对于 i2v 模型,某些变体不接受单独的宽高比参数——输出分辨率遵循输入图像尺寸。
Q: Atlas Cloud 如何处理速率限制?
Atlas Cloud 支持异步/Webhook 模式。视频生成作业作为任务提交;你的应用程序接收任务 ID,并在渲染完成时得到通知。这防止了在规模下阻塞。
Q: 跨镜头角色一致性的最佳模型是什么?
Seedance 2.0 的通用参考系统是 2026 年最先进的解决方案。它允许你传入参考视频、图像和音频,以在生成的剪辑中保持角色外观和运动一致。
Q: Atlas Cloud 支持 ComfyUI 吗?
是的。Atlas Cloud 具有原生 ComfyUI 集成,以及 n8n 节点和 MCP 服务器兼容性。
Q: 开源视频模型如何处理宽高比?
因模型而异。Open-Sora 通过 --aspect_ratio 标志支持 16:9、9:16、1:1 和 2.39:1。Wan 2.2 和 LTX-Video 支持多种比例。对于 i2v 工作流,大多数模型遵循输入图像的宽高比,无论指定参数如何。
总结
2026 年的格局分为两个阵营,各有其最佳应用场景:
开源 适用于:你有闲置 GPU、每月推送 10K+ 视频、数据不能离开服务器、或需要在专有素材上微调。
付费 API 是更好的选择:如果你需要最好的可用质量、速度比成本更重要、每月视频少于 5K、或希望混合使用多个模型而无需管理供应商合同。
Atlas Cloud 桥接了两者:作为一个统一平台,通过单个 OpenAI 兼容的 API 密钥提供 300 多个模型——包括通过托管推理提供的顶级开源模型和每个主要的专有模型。对于 2026 年构建生产级 GitHub AI 视频生成器技能的大多数开发者来说,这是从原型到生产的最顺畅路径。
本文中的定价信息仅供参考,可能发生变化。在制定财务预测之前,请务必在 atlascloud.ai/pricing 上确认当前费率。模型可用性可能因地区而异。
Atlas Cloud:atlascloud.ai — 已获 SOC I 和 II 认证·符合 HIPAA 标准·美国·欧盟·亚洲基础设施


