一位企业客户询问年度套餐续费后是否可以退款。你的助手扫描了大量文档后干脆地回答"可以"。它甚至还引用了某条政策。问题在于:它选择了已归档的 v4.1 政策,而签署的附录和 v4.2 却规定的是另一回事。
这就是为什么 GPT-6 Astra 知识库最佳实践首先要从证据入手。为模型提供权威顺序,只检索经授权的现行有效证据,并让每一条实质性声明都能追溯到具体的文档、版本和章节。如果证据相互冲突或已经用尽,回答必须停止。
GPT-6 Astra 可以在文件搜索和 1,050,000 token 上下文窗口上运行,最大输出为 128,000 token。容量有助于调查,但它不能决定哪条政策是现行有效的、哪个用户有权查看,或者某条引文是否真正支持其邻近的声明。( OpenAI GPT-6 Astra 模型页面,2026 年 9 月 )
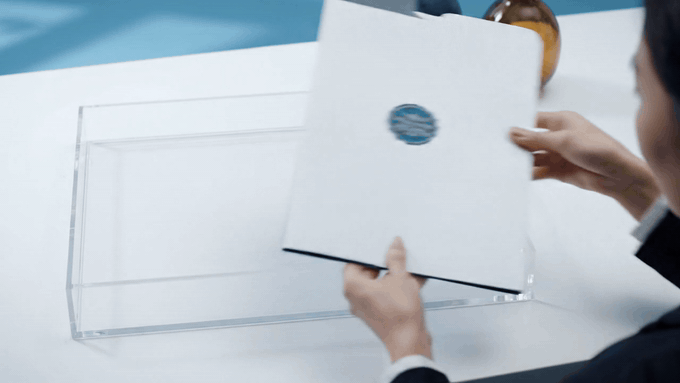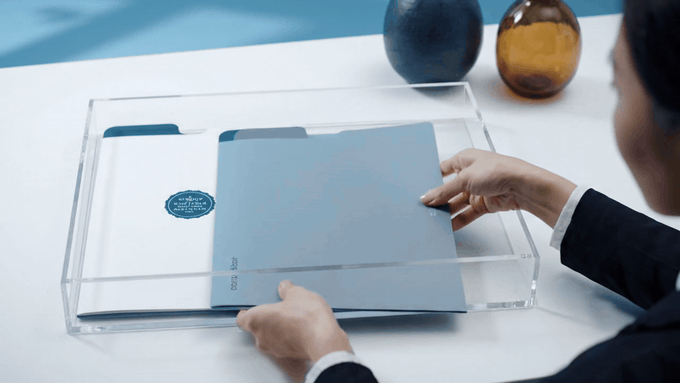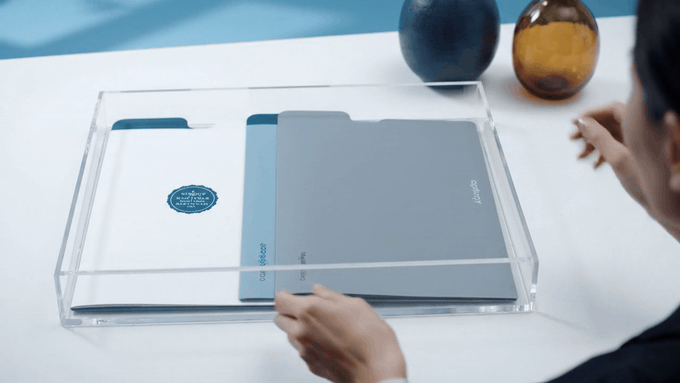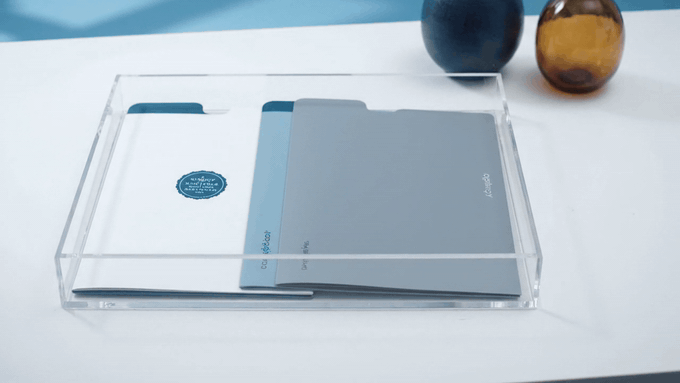
权威优先的知识库工作流动图
一张 8 秒的生成式工作流示意图:签署的优先协议和现行政策保留在证据盘中,而一份已归档文件被明显移开。这用于说明来源治理,而非实际产品界面或源文档。
核心要点
- 上传前先批准来源的权威性。
- 分别衡量检索效果和回答的忠实度。
- 在检索前按访问权限、状态、日期和区域进行过滤。
- 将长上下文视为调查工具,而非默认提示词。
- 将冲突和缺失证据上报给人工处理。
为什么 GPT-6 Astra 知识库在 100 万 token 下会失败
大多数失败在回答之前就已开始。一次 Drive 导出会把签署的附录、现行政策、旧版 FAQ 和草稿都当作同样可搜索的文本。一个强大的模型可以迅速把那堆杂乱的材料变成一段很有说服力的文字。
四项检查可以捕获常见的失败模式:
- 权威漂移: 较新的政策或客户附录输给了被大量使用的旧版 FAQ。
- 引文表演: 回答中包含了来源链接,但被引用的段落并不支持该声明。
- 不受控的实验: 块大小、top-k 和上下文预算同时改变,没人知道到底是什么带来了改进。
- 访问权限漂移: 区域例外、受限草稿或私人笔记可能被错误的受众检索到。
讨论评估的法律 RAG 实践者通常会区分"检索是否找到了所需来源?"和"回答是否忠实地应用了该来源?"这种区分应该出现在每一个发布门禁中,包括内部支持机器人。( r/Rag 法律知识库讨论,2026 年 9 月 )
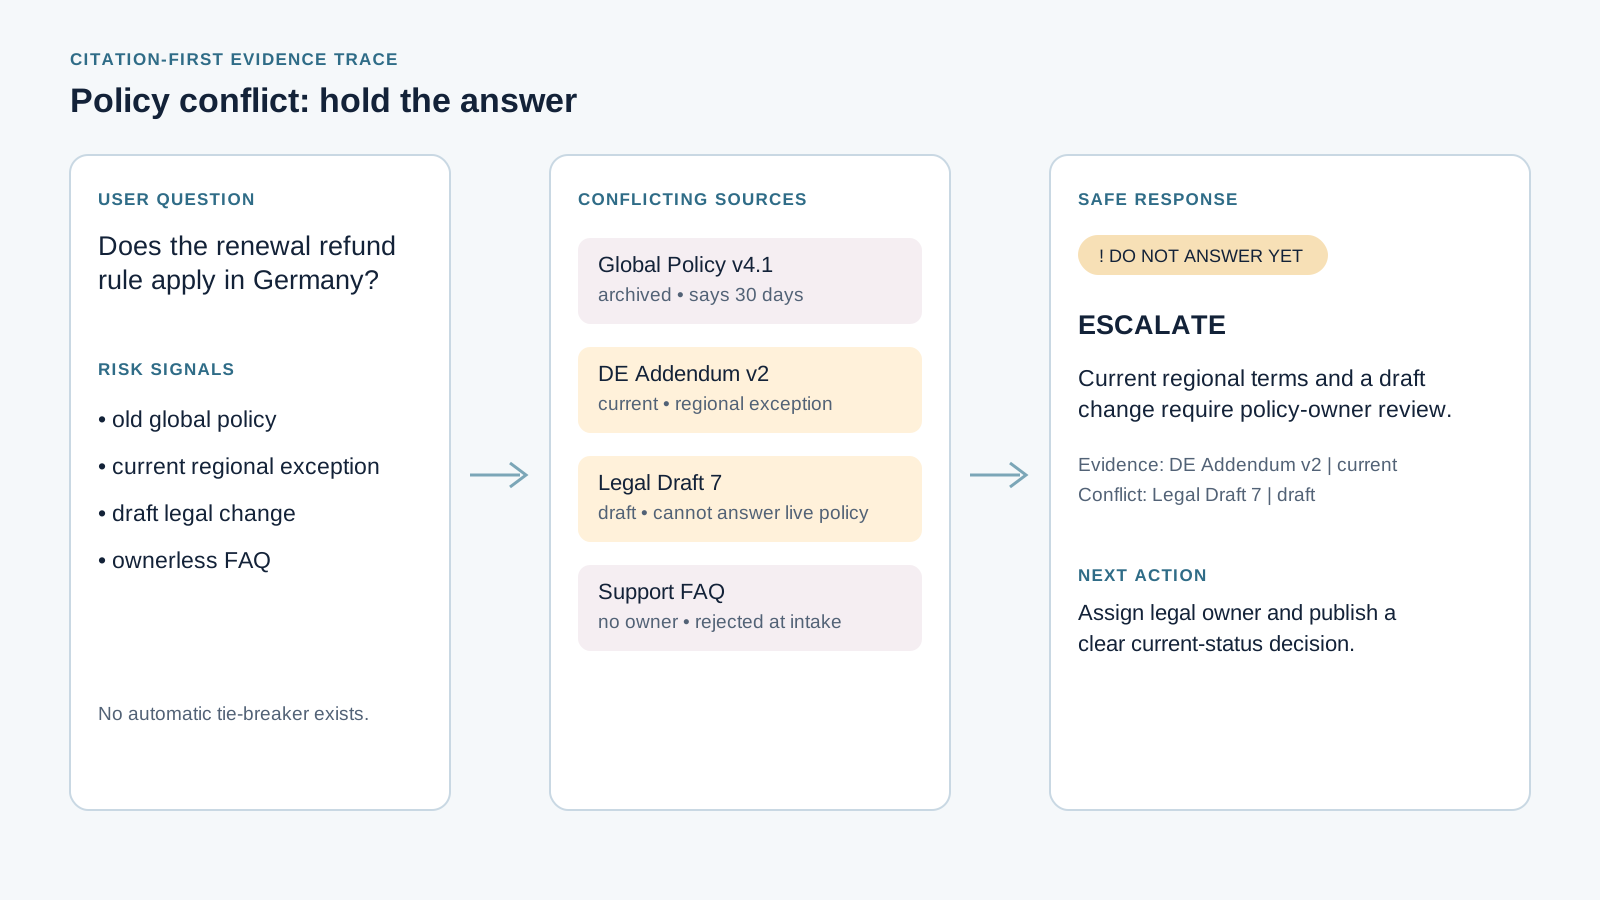
带弃权结果的知识库版本冲突证据追踪
冲突也是一种有用的输出。这个案例说明了为什么系统应该返回"暂不回答",而不是在草稿、区域例外、旧政策和无主文件之间默默做出选择。
GPT-6 Astra 知识库工作流、模型与成本
试点阶段只需一个浏览器标签页:盘点来源、批准权威清单、规范化文件和元数据、检索一小部分证据集,然后回答并评估。运营目标是可审查的证据轨迹,而不是一个花哨的聊天演示。
对于正在比较其余技术栈的团队,Atlas Cloud 提供了一个查看当前模型选项的地方。在发布当天核实之前,不要假设某个目录中列有 GPT-6 Astra。
| 层级 | 解决的问题 | 单独无法解决的问题 | 试点规则 |
|---|---|---|---|
| 长上下文 | 读取大型调查资料包 | 权威性、权限、引文支持 | 用于例外情况和调查 |
| 文件搜索 | 检索少量来源集 | 版本治理 | 搜索前先过滤 |
| 自定义检索 | 调优索引和排序 | 回答忠实度 | 测试中保持上下文预算不变 |
| 人工升级 | 解决冲突和高影响事件 | 常规规模 | 明确负责人和响应时间 |
| 模型或工具 | 职责 | 建议设置 | 规划时使用的发布价格 |
|---|---|---|---|
| GPT-6 Astra | 冲突判断、综合、评估 | reasoning.effort: high | 输入 $10/MTok,输出 $50/MTok |
| OpenAI 文件搜索 | 经授权的文档检索 | 元数据过滤和引文 | 上线前核实工具费用 |
| 常规模型路由 | 标签和低风险分类 | 先做基准测试 | 不要硬编码价格 |
| Atlas Cloud 模型目录 | 后续模型探索 | 使用实时目录 | 不假设 Astra 一定可用 |
从 20 到 50 个高价值问题和一组刻意设置的棘手文档开始。其中包括一份已被取代的政策、一份缺失的附录、一个区域例外,以及至少一个必须不给出答案的问题。
第 1 步:创建权威清单
在上传任何内容之前,先把盘点结果变成一层经过签署确认的决策层。在返回的 JSON 成为 KB_MANIFEST.md 之前,应由人工负责人批准。这是防止基于已废弃文本生成"完美"回答的第一道护栏。
plaintext1You are the knowledge-governance reviewer for an enterprise support knowledge base. 2 3Goal: 4Create an authority manifest before any answer-generation workflow begins. 5 6For every supplied document, identify: 7- document_id 8- title 9- owner 10- effective_date 11- region 12- audience 13- status: current, draft, archived, superseded, or unknown 14- authority_rank from 1 to 5 15- conflict_rules 16- access_policy 17- reason_for_rank 18 19Authority rules: 201. Signed customer addenda override general policies for the covered account. 212. Current policy versions override archived or superseded versions. 223. Official policy documents override FAQs and training notes. 234. Drafts may be used only when the user explicitly asks about a draft. 245. If two current sources conflict, do not resolve the conflict. Return ESCALATE. 25 26Return valid JSON only. Do not infer missing dates or policy terms.
设置: 模型 gpt-6-astra;Responses API;reasoning.effort: high;结构化 JSON 输出。初步审核时仅提供标题、负责人、生效日期、区域、状态和访问级别。
完成标准: 每个文件都有负责人、日期、状态和排名,并且 Refund Policy v4.1 被标记为已被 v4.2 取代。
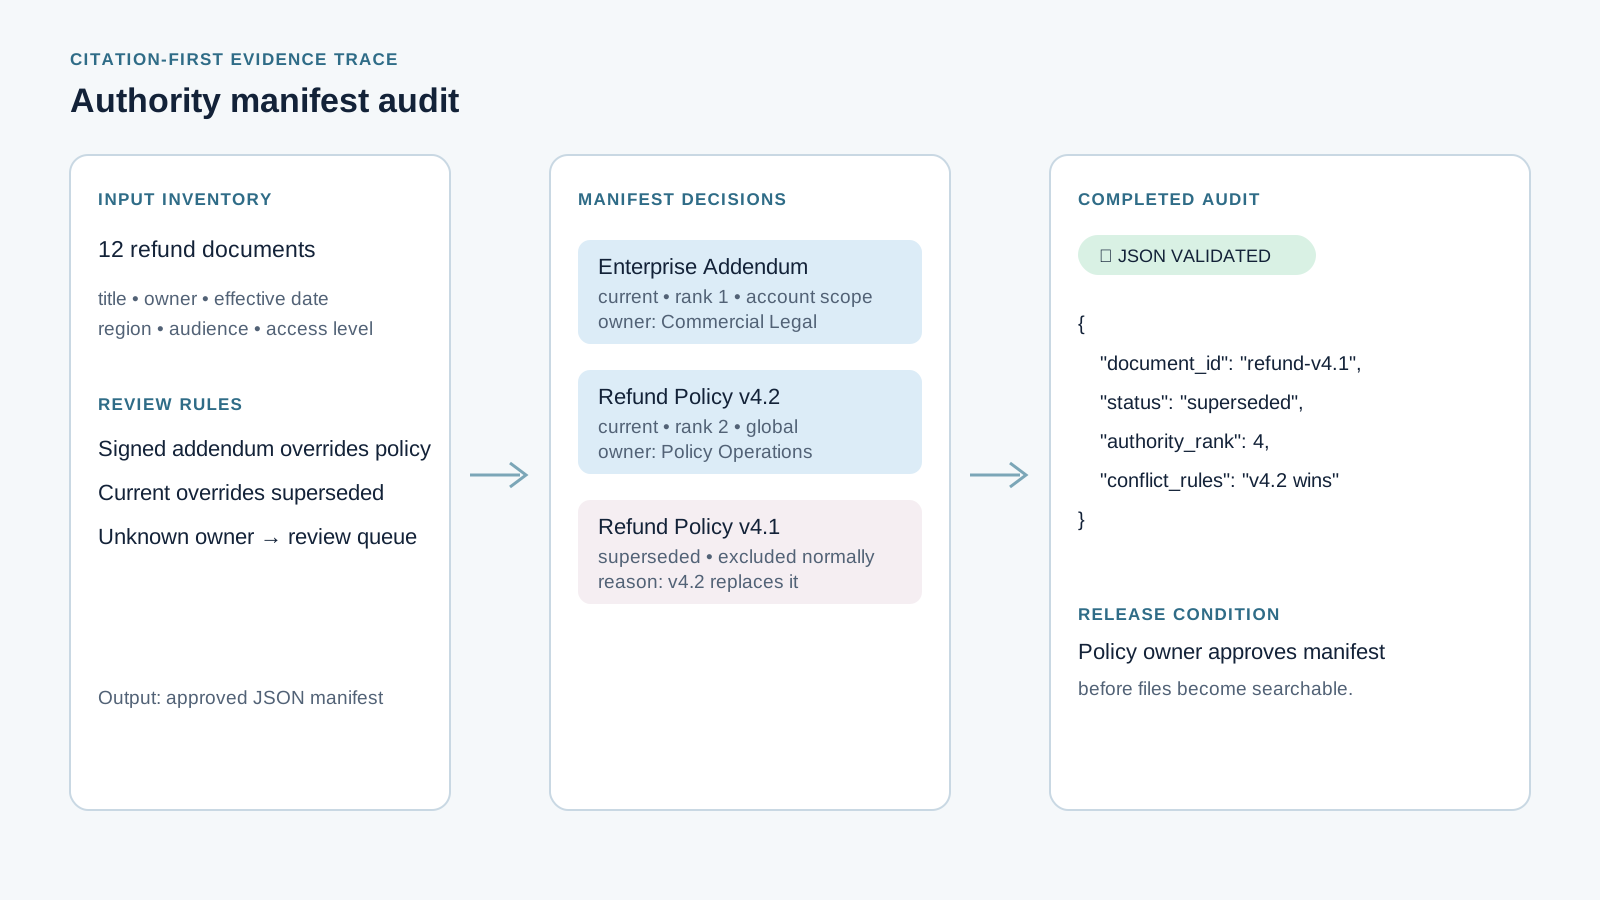
带有已完成 JSON 决策的权威清单审计
退款试点的权威清单审计已完成。审计页面记录了已被取代的 v4.1 和企业客户优先规则。
第 2 步:准备 GPT-6 Astra 知识库以供检索
对已批准来源进行规范化处理。保留标题、条件、页码标记和版本数据。删除重复的页脚、导航和 OCR 残留物。不要上传没有负责人或生效日期的文档。
plaintext1You are preparing files for a retrieval-based knowledge base. 2 3Inspect the supplied document inventory and return a file-preparation checklist. 4 5For each file: 61. Keep the source title, version, effective date, owner, and page or section markers. 72. Remove navigation, duplicated footers, stale boilerplate, and OCR fragments. 83. Preserve headings and lists that carry policy conditions. 94. Mark whether the file is current, archived, draft, or restricted. 105. Reject any file that cannot be assigned an owner and effective date. 11 12Return a table with: 13file_name | status | metadata_to_attach | cleanup_required | upload_decision | reason
设置: 将 document_id、version、effective_date、status、region、audience 和 authority_rank 作为元数据附加。检索测试开始时,检索到的上下文总量大约为 2,000 token。每次只改变一个变量:分块策略或检索数量,绝不要同时改变两者。
完成标准: 已归档材料被排除在常规查询之外,无主文件进入审核队列。
下一个动态案例让分类决策变得可见:两个已批准的来源文件夹一起留在权威盘中,而一份有歧义的草稿则进入独立的审核路径。这是一个说明性的工作流渲染图,不是实时的 GPT-6 响应或产品界面。
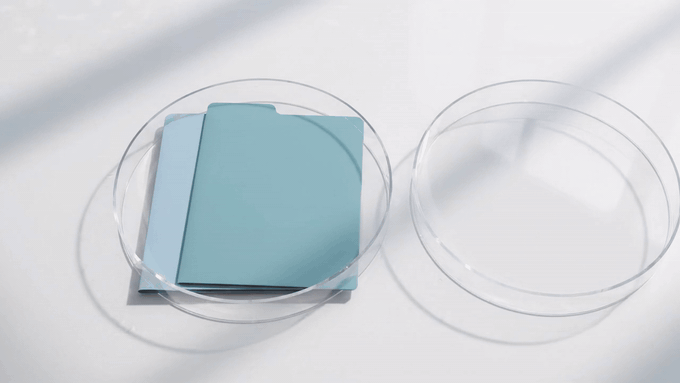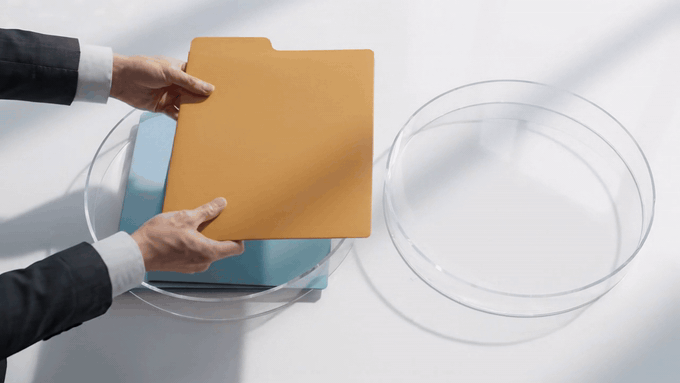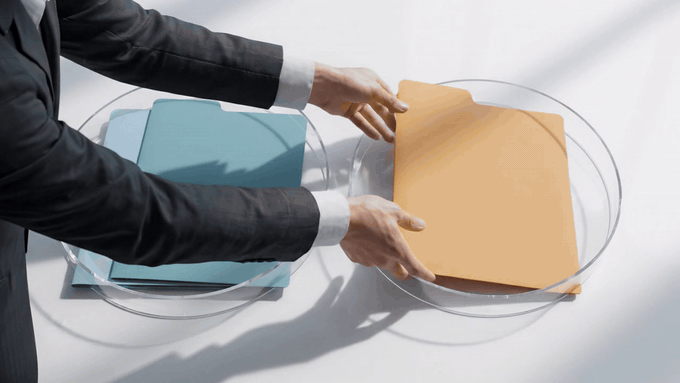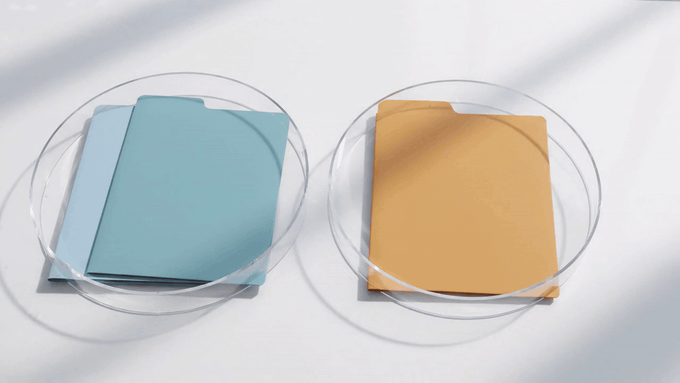
证据移交人工审核动图
一张 8 秒的生成式工作流示意图:已批准的来源文件夹保持在一起,而未解决的文件夹被转交给人工审核。
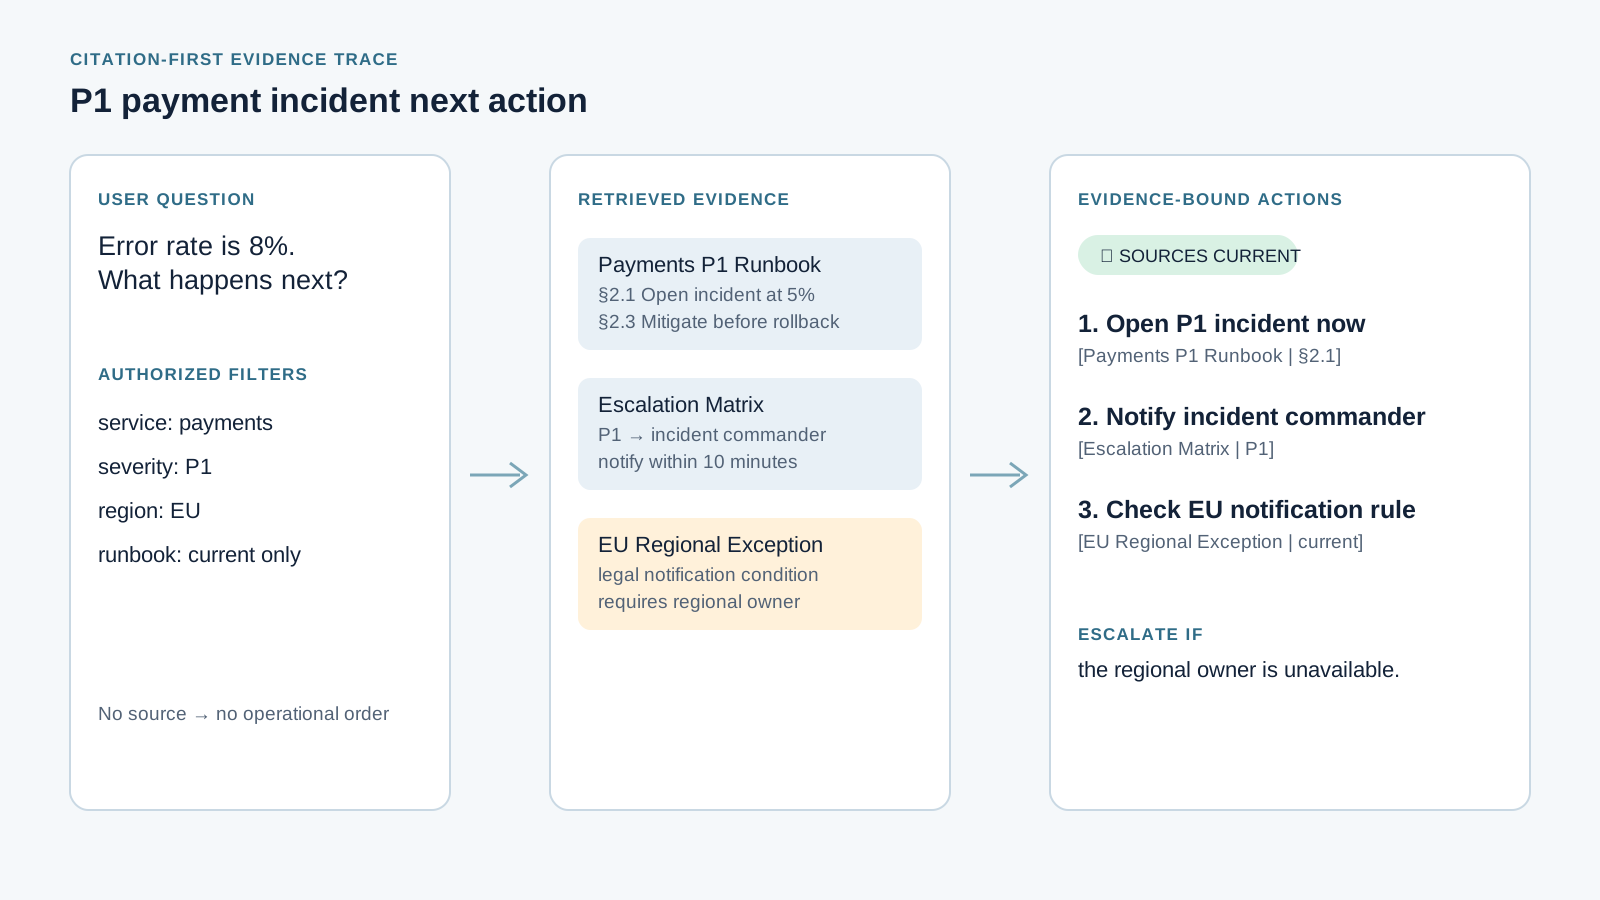
带升级条件的 P1 支付事件证据追踪
案例 2:一个关于支付错误的问题拉取了值班运行手册、升级矩阵和区域例外。回答指出了事件指挥官的触发条件,而不是临时拼凑恢复方案。
第 3 步:要求基于证据的回答
将回答生成与检索到的、经授权的证据绑定。模型应区分事实、假设和后续行动,以便审核者能够看到系统的知识边界在哪里。
plaintext1You are an evidence-bound knowledge-base assistant. 2 3Answer the user question using only the retrieved, authorized knowledge-base sources. 4 5Rules: 6- Treat the authority manifest as binding. 7- Prefer the highest-ranked current source that applies to the user’s region and audience. 8- Every factual claim must include [document title | version | section or page]. 9- If sources conflict, identify the conflict and return ESCALATE instead of choosing silently. 10- If the evidence does not support a claim, write INSUFFICIENT_EVIDENCE. 11- Do not use general model knowledge to fill gaps. 12- Separate confirmed facts, assumptions, and recommended next actions. 13- For regulated or high-impact questions, state that a qualified human review is required when the evidence is incomplete. 14 15User question: 16Can an Enterprise annual-plan customer receive a refund after renewal if the account has a signed Enterprise addendum? 17 18Return: 191. Decision 202. Evidence 213. Exceptions or conflicts 224. Next action 235. Confidence: supported, partial, or insufficient
设置: 使用 reasoning.effort: high 和文件搜索。在检索之前应用现行状态、用户授权、区域和受众过滤器。工具调用应放在 Responses API 上;OpenAI 当前的指南还建议为 Astra 工作流设定明确的成功条件和工具边界。( OpenAI 模型指南,2026 年 9 月 )
完成标准: 回复引用了现行通用政策和已签署的企业附录,绝不将已归档的 v4.1 作为规则使用,并且如果附录缺失则返回 INSUFFICIENT_EVIDENCE。
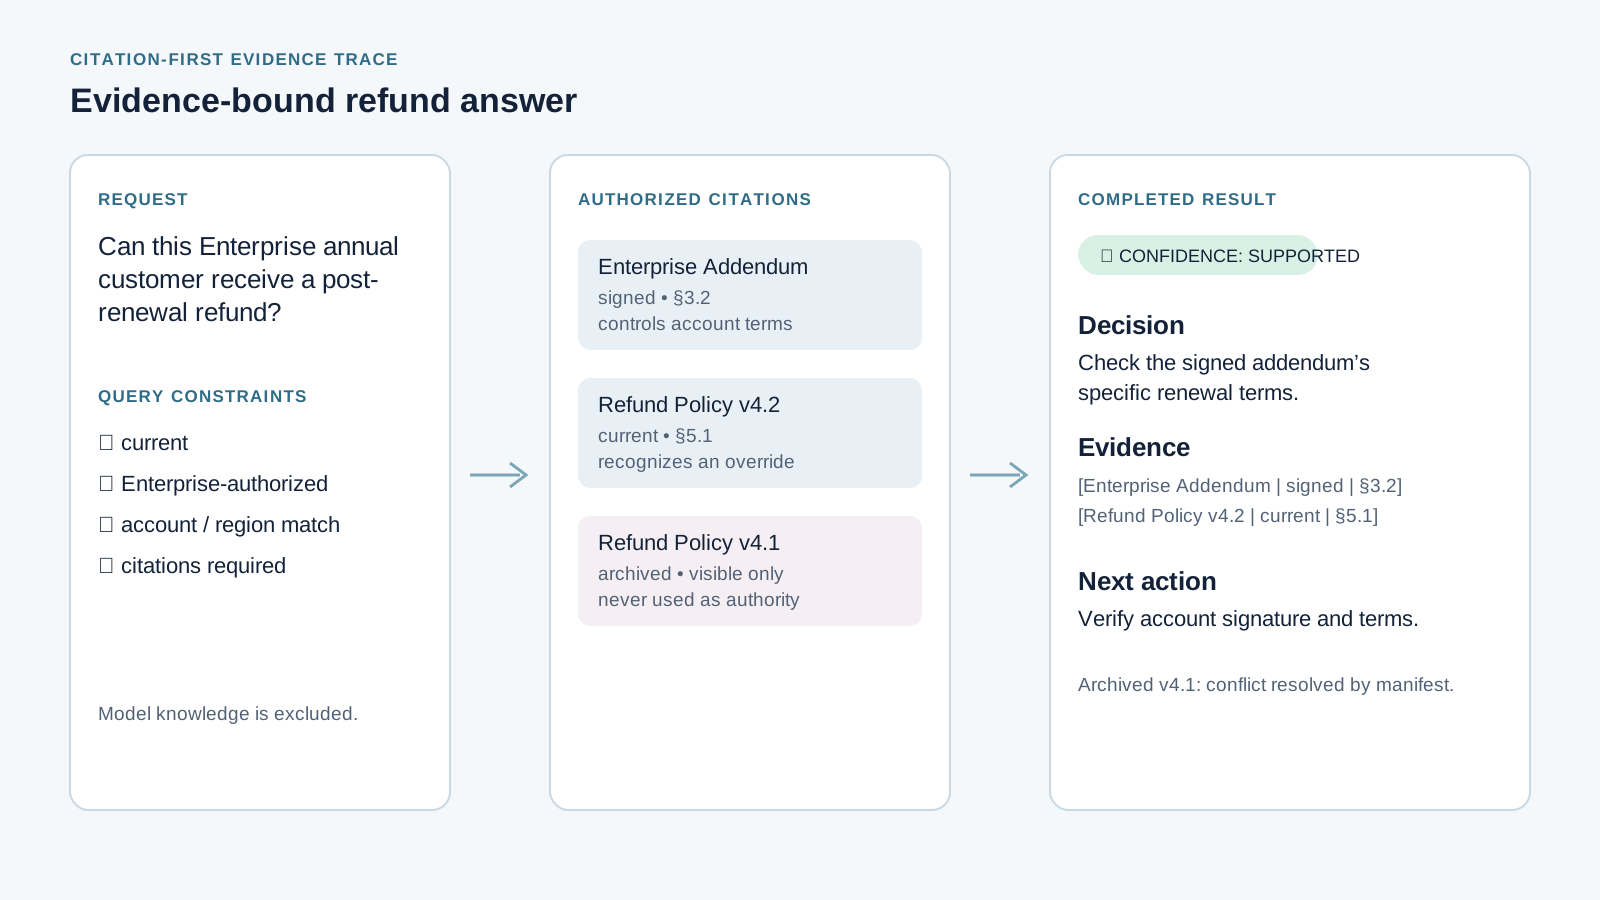
带有现行政策引用的基于证据的退款回答
主要已完成结果:该决定由 v4.2 和已签署附录支持,而已归档文档仅作为已解决的冲突保留可见。
第 4 步:分别评估检索效果和忠实度
一个回答可能引用了文档,却仍然用错了条款。应分别对检索召回率和声明忠实度进行评分。这样才能产生产品、支持或法务负责人可以捍卫的发布决策。
plaintext1You are evaluating a knowledge-base answer. 2 3Given: 4- the user question 5- expected source sections 6- retrieved source sections 7- the final answer 8 9Score these dimensions separately: 101. Retrieval recall: did the required source appear in the retrieved evidence? 112. Citation precision: does each cited source support the nearby claim? 123. Claim faithfulness: is every atomic factual claim supported by retrieved evidence? 134. Conflict handling: did the answer surface conflicting current sources? 145. Abstention quality: did the answer refuse unsupported conclusions? 15 16Return JSON with: 17question_id, retrieval_recall, citation_precision, claim_faithfulness, 18conflict_handling, abstention_quality, unsupported_claims, reviewer_notes, 19release_decision 20 21Use FAIL if any high-risk factual claim lacks supporting evidence.
设置: 制作一个 20 题的金标准集,其中简单、常见、冲突、无答案和高风险案例各 4 题。高风险和冲突问题保持高推理级别。只有在基线通过后,才在低风险工作中测试较低的推理级别。
完成标准: 该集合包含一个"检索到正确文档 / 应用错误条款"的失败案例和一个正确的弃权案例。人工审核者抽样检查每一条有支持的高风险回答。
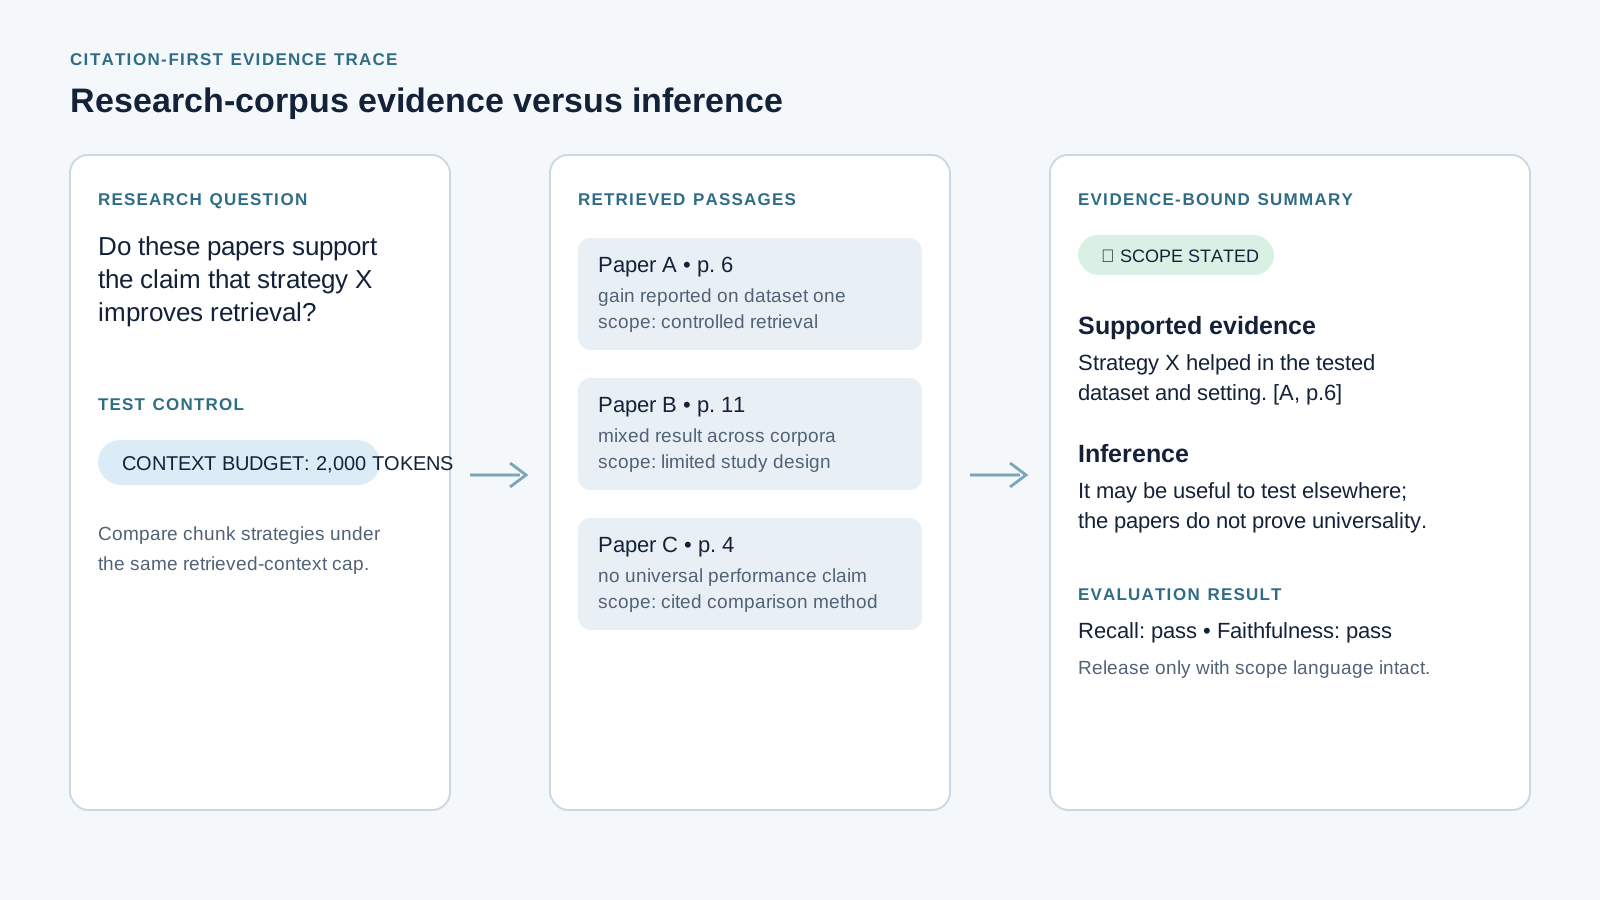
在 2000 token 预算下比较支持与推断的研究语料证据追踪
案例 3:一个研究语料的回答将三篇论文明确支持的内容与推断区分开来。检索对比将上下文预算保持在 2,000 token。
扩展 GPT-6 Astra 知识库而不丢失证据
试点模式因领域而异。保留证据追踪,但让权威来源和拒绝边界针对具体工作来设定。
| 试点 | 权威来源 | 所需元数据 | 拒绝或升级条件 | 人工发布门禁 |
|---|---|---|---|---|
| 企业退款政策 | 已签署附录、现行政策 | 账户、区域、生效日期、状态 | 附录缺失或现行来源冲突 | 支持团队和政策负责人 |
| P1 事件运行手册 | 现行运行手册和升级矩阵 | 服务、严重级别、负责人、上次演练 | 行动缺少负责人或现行运行手册 | 事件指挥官 |
| 研究语料 | 被引用的论文段落 | DOI、页码、发表日期、方法 | 结论超出证据范围 | 主题专家审核 |
对于代码和内部规则库,为 AGENTS.md、架构决策、当前部署流程和已退役脚本赋予明确的排名。对于研究,将"证据"和"推断"作为不同字段返回。对于客户支持,产品、区域和生效日期过滤器承担了大部分可靠性工作。
成本与路由检查清单。 一个包含 20K 输入 token 和 2K 输出 token 的高风险回答,在 GPT-6 Astra 文本 token 上大约花费 $0.30:20,000 × $10 / 1,000,000 + 2,000 × $50 / 1,000,000。这不包括文件搜索和其他工具费用,这些费用应在发布前在当前控制台中核实。超过 272K token 的输入具有更高的模型定价,因此 100 万 token 的提示词不应成为常规路径。
| 任务风险 | 推理级别 | 证据规则 | 人工审核 |
|---|---|---|---|
| 标签和路由 | 先做基准测试再降低 | 仅元数据 | 抽样 |
| 标准支持 | 测试后使用中或高 | 现行引用来源 | 异常队列 |
| 冲突、政策或事件 | 高 | 每条声明都有来源依据 | 必需 |
| 法律、医疗、金融、人力资源、隐私 | 高 | 不完整时弃权 | 行动前必需 |
从上游开始控制成本:移除过时和无主的文件,在检索前过滤元数据,先测试高价值问题,并保留清单、检索到的段落、模型版本和发布决策。需要后续多模型路线的团队可以结合自己的试点结果查看当前的 LLM API 文档。
对于受监管、私密、雇佣、健康、金融或生产事件相关的内容,在检索前应用访问过滤,确认数据处理和保留条款,保留撤回路径,并将不完整的证据转交给可问责的人工处理。在这些场景中,流畅的回答永远不是最终建议。
常见问题
100 万 token 的上下文窗口是否意味着不再需要 RAG?
不能。它可以帮助调查者阅读更大的资料包,但它不能确定文档权威性、用户访问权限、时效性、引文精确度或发布测试。使用检索进行常规证据选择,并将大范围上下文保留给例外情况调查。
什么内容绝不应进入 GPT-6 Astra 知识库?
不要摄入无主文件、无日期的政策、没有明确草稿工作流的草稿、请求者无权查看的内容,或缺乏历史使用规则的已归档材料。将这些文件放入审核流程,或在常规检索之外进行归档。
两份意见不一致的现行文档应如何处理?
返回 ESCALATE,指出冲突,保留两条引文,并指定负责人。模型不应默默编造一个打破平局的规则。清单需要在下次发布之前有一个记录在案的规则。
GPT-6 Astra 知识库的最佳块大小是多少?
没有统一的标准数字。保留有意义的政策标题和条件,然后在相同的上下文预算下比较不同策略。固定的 top-k 可能掩盖大得多的检索 token 预算,让实验看起来比实际更好。
如何证明回答基于正确的来源?
为每个金标准问题存储预期来源、检索到的段落、最终的原子声明,以及审核者对召回率、引文精确度、忠实度、冲突处理和弃权的评分。对于高风险回答,缺少支持链接即为失败。
GPT-6 Astra 知识库的成本是多少?
使用 token 公式计算,然后加上当前的文件搜索和工具费用。对于上面的例子,20K 输入加上 2K 输出大约需要 $0.30 的模型 token。实际的节省来自于排除过时材料,并在证据至关重要的场景使用高推理级别。这就是 GPT-6 Astra 知识库最佳实践的持久版本。


