


两个人隔着桌子坐着。一句台词开始,然后两张嘴都动起来。反打镜头切过来,声音不再像是从那张脸上发出的。这正是创作者在搜索 kling 4 对话唇形同步测试 时想要避免的失败。
本文运行了 3 个用 Kling 4.0 生成的简短对话测试:一个说话人、2 个说话人轮流说,以及一段英语-西班牙语混合交流。每个测试在生成时都使用原生音频;文章以 GIF 展示视觉结果,并附上相同的 10 分制评分卡。这些都是单独运行,并非通用基准。
更新:Kling 4 现已在 Atlas Cloud 上线。探索 Kling 4,了解当前视频生成工作流并开始创作。
关键要点
- 本文中的三段对话片段由 Kling 4.0 生成。
- 简短、带姓名、轮流的台词能让审阅者更清楚地检查说话人分配。
- GIF 便于快速查看面部动作和说话人切换,但仍需要源 MP4 来核对声音时序。
- 在投入更高要求的制作版本之前,把 10 秒运行当作脚本检查。
- 像审视说话者一样仔细审视沉默的倾听者。
Kling 4 对话唇形同步测试:先检查版本
Kling 4.0 于 2026 年 10 月 15 日正式发布。本文中的三段对话片段是在经过验证的 Kling 3.0 路径上渲染的,因此它们仍是可复现的基线,而不是 Kling 4.0 唇形同步性能的证明。在重复评分卡之前,请检查所选的 V4 模型及其当前控件。
当前可验证的参考点是 Kling AI 3.0。Kuaishou 于 2026 年 2 月 5 日发布了 Video 3.0、Video 3.0 Omni、Image 3.0 和 Image 3.0 Omni 系列。公告描述了跨语言、方言和口音的原生音频;说话顺序可控的对话场景;多镜头指导;以及最长 15 秒的视频时长(Kuaishou Technology,2026 年 2 月)。
这一产品声明设定了一个有用的测试目标。它并不保证每一个生成片段都合格。原生音频意味着模型可以在视频任务中生成音频。它并不保证某个嘴巴会在每个辅音上闭合、倾听者保持不动,或剪辑能保持说话人身份。这些正是本测试要检查的细节。
下面的 3 次运行保留视觉结果和评分卡,以便读者评估与书面说明相同的证据。
我们测试了什么
该协议刻意排除了借口。每个场景都使用 16:9 画幅、10 秒时长、在测试场提供该设置时启用原生音频或设为 Auto、无音乐,并且没有后期唇形同步。每个可见说话者都有一句短台词。文章中的 GIF 保留视觉表演;评判声音时序时请单独查看原始 MP4 文件。
| 测试 | 模型 | 时长 | 可见角色 | 语言 | 台词 | 主要评估目标 |
|---|---|---|---|---|---|---|
| 1 | Kling V3.0 Standard T2V | 10 秒 | 1 | 英语 | 1 | 第一个音节、闭唇音、结尾停顿 |
| 2 | Kling V3.0 Standard T2V | 10 秒 | 2 | 英语 | 2 | 正确说话人和安静倾听者行为 |
| 3 | Kling V3.0 Pro T2V | 10 秒 | 2 | 英语和西班牙语 | 2 | 语言切换、归属和面部连续性 |
评分卡为每个类别给出 0、1 或 2 分。2 分表示对于预期的 10 秒样本,该行为足够清晰。1 分表示部分可信,但需要再看一次。0 分表示观看者能明显看出问题。总分是对一个提示词下一次生成结果的记录,而不是对模型所有输出的断言。
| 类别 | 0 分 | 1 分 | 2 分 |
|---|---|---|---|
| 嘴型与词语时序 | 明显不匹配 | 大体跟得上,但有可见失误 | 全程时序自然 |
| 正确说话人分配 | 说话人错误或共用 | 有一处不确定 | 每句台词都属于指定的人 |
| 沉默倾听者行为 | 倾听者说话或动嘴型 | 轻微游离嘴部动作 | 倾听者保持自然专注 |
| 面部表情连续性 | 面部明显崩坏或偏移 | 轻微不稳定 | 表情保持连贯 |
| 剪辑中的音频连续性 | 声音脱离或突然变化 | 过渡可察觉 | 剪辑支撑同一对话节拍 |
测试设计还回答了这次搜索背后可能衍生的问题:Kling 4 是否发布、当前哪个模型可以生成对话、2 个人能否交替说话、创作者如何防止两个角色同时说话、混合语言对话是否可行,以及小型测试预算应覆盖什么。
Kling 对话测试 #1:一个说话人,一句短台词
一个人说一句短台词是基线。它隔离出最早的有用检查点:第一次张嘴、围绕“p”或“b”音的闭唇,以及说话结束后的放松节拍。如果这个基线看起来就不对,再加入另一个角色、一次镜头切换或另一种语言只会让诊断更难。
这次运行使用一位虚构的办公室职员 Maya。场景有一个小幅手势和直接视线,但没有快速镜头运动。这让嘴部和声音成为主要证据。
运行设置: 16:9、10 秒、运行时测试场可用的最高分辨率、原生音频 On 或 Auto、无背景音乐。模型:Kling V3.0 Standard Text-to-Video。
plaintext1A realistic 10-second medium close-up of Maya, a fictional woman in her early thirties wearing a navy blazer, seated at a bright office desk. She looks directly at her colleague just off camera and says exactly: “The report is ready. Please review the blue chart.” Natural conversational pacing, clear English speech, accurate mouth movements, subtle blinking, small hand gesture, quiet office room tone only. Maya is the only visible person and the only speaker. No subtitles, no background music, no narration.
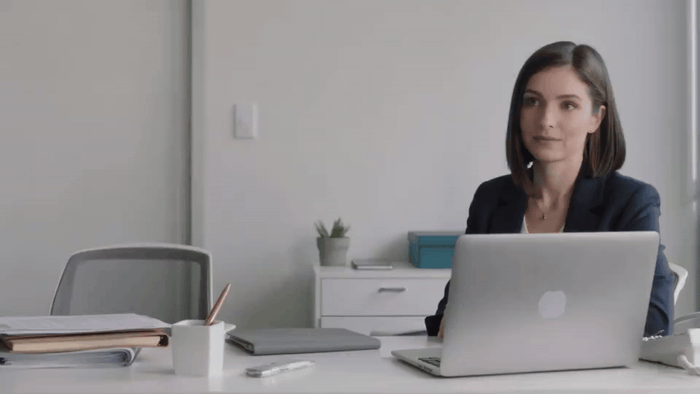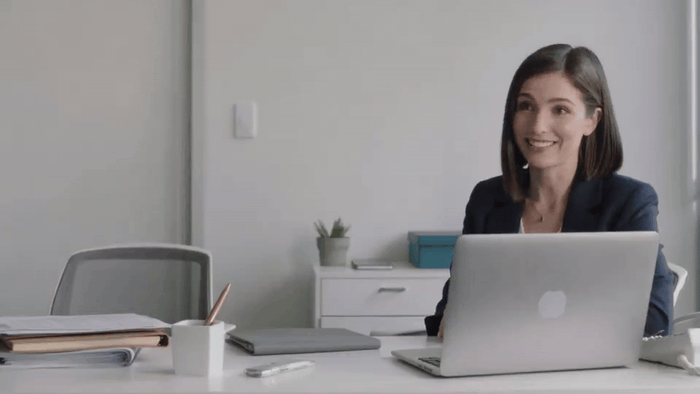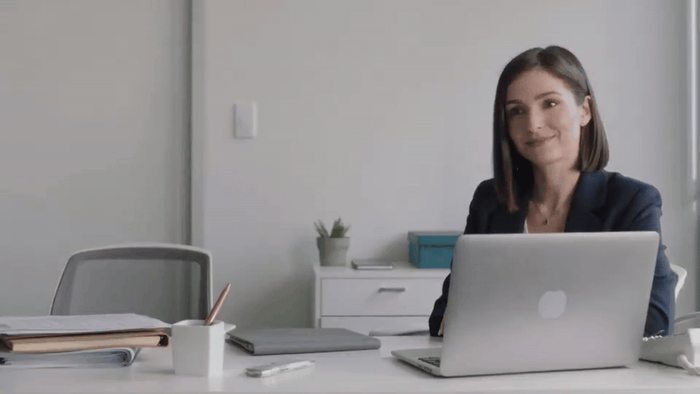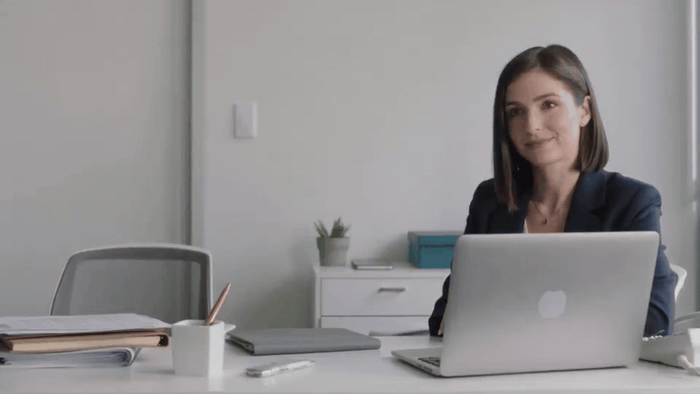
测试 1 视觉结果:Maya 说出一句办公室台词
测试 1 视觉结果。观察 Maya 在说“Please”时的闭唇以及台词结束后的停顿;使用源 MP4 判断音频时序。
运行状态: 已在 Atlas 测试场中渲染。视觉 GIF 嵌入在上方。
| 测试 1 视觉结果 | 状态 | GIF 显示的内容 |
|---|---|---|
| 单说话人构图 | 清晰 | Maya 是整个办公室场景中唯一可见的人 |
| 嘴部动作 | 可见 | 近景构图让说话动作易于检查 |
| 面部连续性 | 稳定 | 眨眼、姿势和照明在片段中保持一致 |
| 倾听者行为和剪辑 | 不适用 | 这个基线场景没有第二个说话人或反打镜头 |
| 音频时序 | 查看源 MP4 | 嵌入的 GIF 没有声音 |
如果台词清晰度下降,只改变 1 个变量,并进行单独标记的重跑。首先,缩短口语句子。其次,移除手势或任何不必要的镜头指令。避免同时改变角色、时长和语言。否则会把诊断变成新的实验。
Kling 对话测试 #2:两个人轮流说话
这正是对话生成需要被严格审视的地方。一个可信的场景需要 2 个独立动作:Maya 说话时 Daniel 倾听,然后 Daniel 说话时 Maya 倾听。沉默的人不是空背景。他们闭合的嘴、眼神接触、细微反应和稳定的脸都是证明的一部分。
提示词为每个说话者使用 3 个锚点:姓名、左侧或右侧位置,以及可见的服装细节。它还说明了倾听者的预期行为。这些并不是魔法词。它们给模型更明确的场景契约,也给审阅者清晰的失败条件。
plaintext1A realistic 10-second two-person office dialogue in a sunlit meeting room. Maya, wearing a navy blazer, sits on the left. Daniel, wearing a light gray shirt, sits on the right. Shot 1: medium two-shot. Maya looks at Daniel and says exactly: “The report is ready. Please review the blue chart.” Daniel remains silent and listens naturally with his mouth closed. Shot 2: reverse medium shot on Daniel. Daniel says exactly: “Great. I will check it before lunch.” Maya remains silent and listens naturally with her mouth closed. Clear English speech, precise lip sync, one speaker at a time, no overlapping dialogue, no subtitles, no background music, quiet office room tone.
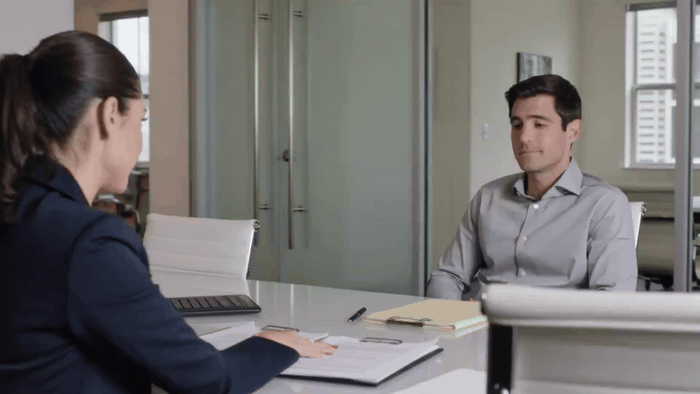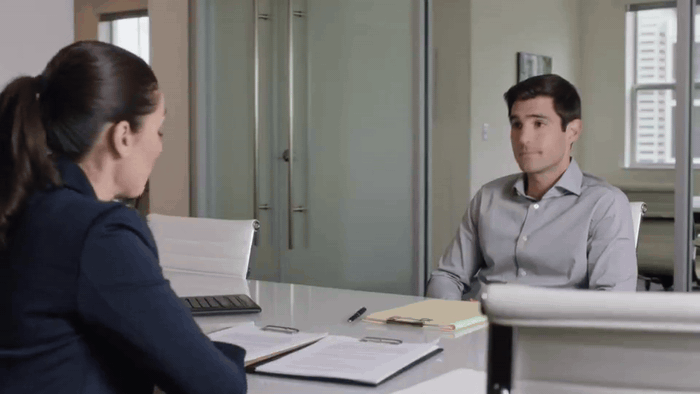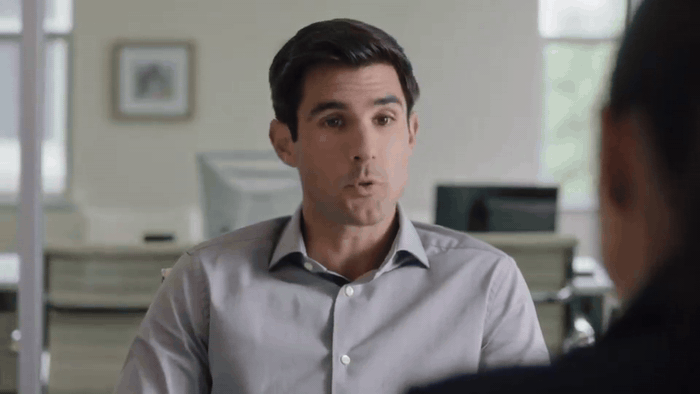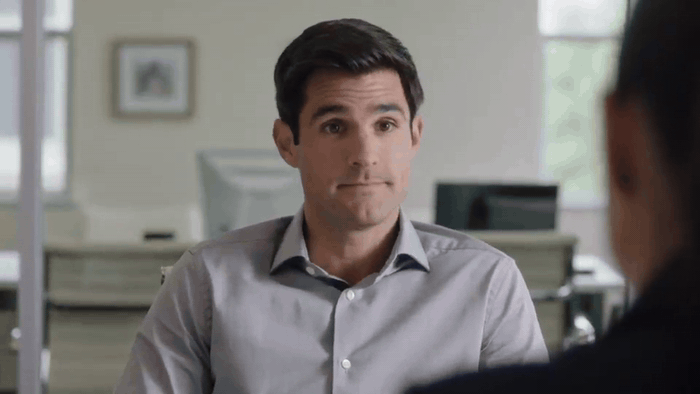
测试 2 视觉结果:Maya 和 Daniel 在办公室对话中轮流说话
测试 2 视觉结果。观察每句台词期间倾听者的嘴部,以及反打镜头处的说话人切换;使用源 MP4 判断音频时序。
创作者经常在社区讨论中描述相反的问题:原本要做唇形同步的任务可能会失去同步,或让本应安静的人出现不想要的嘴部动作。这是轶事经验,而非产品规格,但它是每次运行都检查倾听者的充分理由(r/KLING,2026 年 9 月)。
运行状态: 已在 Atlas 测试场中渲染。视觉 GIF 嵌入在上方。
| 测试 2 视觉结果 | 状态 | GIF 显示的内容 |
|---|---|---|
| 双说话人设置 | 清晰 | Maya 和 Daniel 出现在同一场办公室对话中 |
| 说话人切换 | 可见 | 场景从 Maya 的回合切到 Daniel 的反打镜头 |
| 倾听者行为 | 可检查 | GIF 让非说话者保持可见,以便进行视觉检查 |
| 面部连续性 | 稳定 | Daniel 的脸和办公室环境在反打镜头中保持一致 |
| 音频时序 | 查看源 MP4 | 嵌入的 GIF 没有声音 |
实际边界并不高:可以测试一段 2 个人、顺序进行、10 秒的交流。不应把它当作现成模板,用于带有打断、群体反应、快速剪辑和多种语言的长场景。每次只增加一个维度的难度。
Kling 对话测试 #3:混合语言对话
第 3 次运行测试 Kuaishou 所描述功能的一个更严格版本:一个人说英语,另一个人用西班牙语回答。价值不在于新奇。混合语言交流可以揭示单语言片段会掩盖的说话人分配错误,尤其是当剪辑和不同声音模式同时出现时。
西班牙语回应刻意很短。每个人仍然只有一句台词,镜头顺序保持明确,并且告诉倾听者保持沉默。这里使用 Pro 层级作为一个单独、更严格的测试,而不是用来替代清晰的提示词。
运行设置: 16:9、10 秒、运行时可用最高分辨率和质量、原生音频 On 或 Auto、无背景音乐。模型:Kling V3.0 Pro Text-to-Video。
plaintext1A realistic 10-second two-person dialogue at a quiet outdoor café in late afternoon. Maya, wearing a navy blazer, is seated on the left. Daniel, wearing a light gray shirt, is seated on the right. Shot 1: Maya smiles and says exactly in English: “The product demo starts in five minutes.” Daniel remains silent and listens with his mouth closed. Shot 2: Daniel replies exactly in Spanish: “Perfecto, ya tengo las notas listas.” Maya remains silent and listens naturally with her mouth closed. One speaker at a time, accurate lip sync for each spoken language, natural pauses, stable faces, no subtitles, no background music, soft café ambience only.
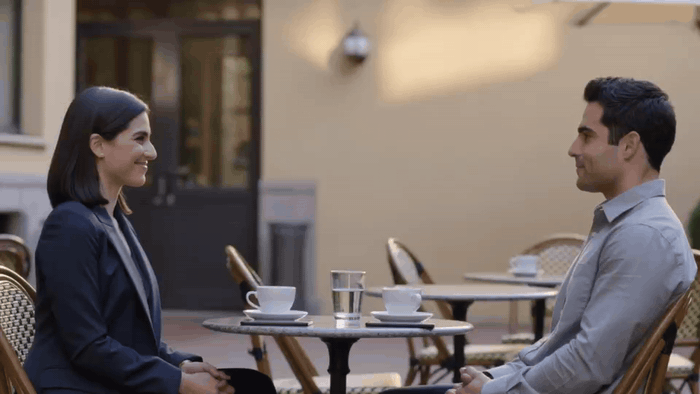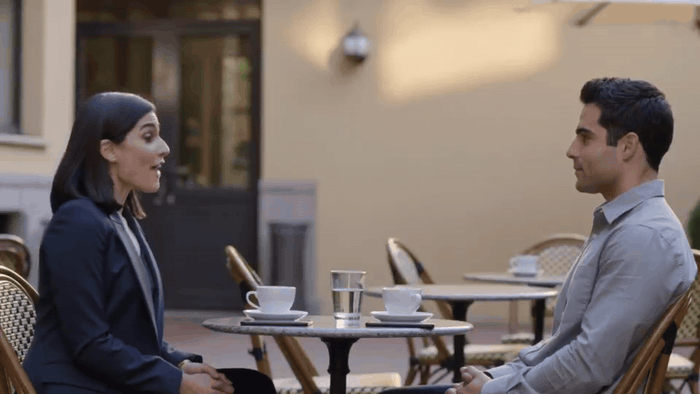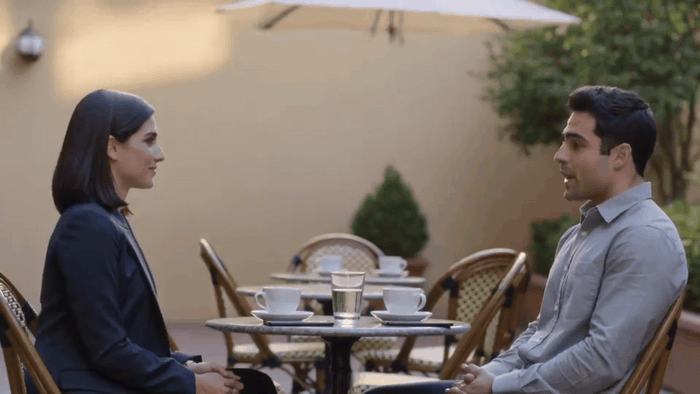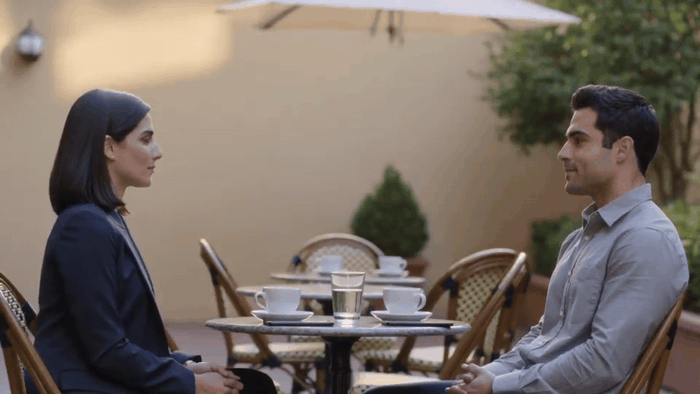
测试 3 视觉结果:两位说话人在户外咖啡馆交换台词
测试 3 视觉结果。观察在英语到西班牙语的切换过程中,每句台词属于哪张脸;使用源 MP4 判断音频时序。
运行状态: 已在 Atlas 测试场中渲染。视觉 GIF 嵌入在上方。
| 测试 3 视觉结果 | 状态 | GIF 显示的内容 |
|---|---|---|
| 双人咖啡馆设置 | 清晰 | 两个人都保持在户外咖啡馆桌旁的位置 |
| 说话人切换 | 可见 | 构图保留了两位角色之间的交流 |
| 脸部和场景连续性 | 稳定 | 服装、座位和傍晚咖啡馆照明保持一致 |
更干净的 Kling 唇形同步结果
这 3 个提示词共享一种结构,使失败可见、重跑可解释。在增加更多润色之前,请使用这份清单。
- 首次对话测试中,可见人物不超过 2 个。
- 每个人每轮给 1 句话。
- 尽可能让英语台词保持在 8 到 12 个词左右。
- 用位置、可见特征和姓名标记说话者。
- 说明另一个角色自然地倾听,嘴巴闭合。
- 在提高细节设置或时长之前,先用 10 秒样本确定脚本。
- 将唇部时序、说话人分配、倾听者行为、面部连续性和剪辑作为独立检查项来审视。
- 不要在第一次运行中组合长独白、群体场景、快速剪辑和语言切换。
| 提示词元素 | 测试中的示例 | 它帮助审阅者隔离什么 |
|---|---|---|
| 位置 | “Maya ... 在左侧” | 应该由哪个人说话 |
| 外观锚点 | “海军蓝西装外套” | 身份是否在剪辑中保持 |
| 精确台词 | “太好了。我会在午餐前检查。” | 预期声音和嘴部时序 |
| 沉默角色指令 | “保持沉默……嘴巴闭合” | 不想要的倾听者唇部动作 |
| 镜头序列 | “镜头 1 ... 镜头 2” | 剪辑后音频是否仍然附着 |
这种格式并不承诺完美结果。它让小型团队能够把源提示词、媒体和决策放在一起。如果片段需要重跑,记录失败是发生在第一个音节、倾听者反应期间,还是在剪辑处。“唇形同步感觉不对”太模糊,无法改进制作脚本。
预算与模型选择
使用成本更低的当前层级来验证脚本,然后把更高层级的测试留给你可能真正要展示的版本。这就是 Standard 和 Pro 在本文中的角色。创作者可以在单个 Atlas Cloud 模型工作区 中运行相同的提示词结构,保留测试记录,并在无需为不同界面改写脚本的情况下进行比较。
下面的数字是价格背景,不是促销声明。它们是在 2026 年 9 月 28 日根据 Atlas Cloud 模型目录和模型详情页核对的。目录在审阅时显示降价 15%。价格和模型参数可能会变化,因此在设定客户预算前请重新查看页面。
| 本测试所用模型 | 页面每秒价格,2026 年 9 月核对 | 预计 10 秒生成 | 此协议中的最佳用途 |
|---|---|---|---|
| Kling V3.0 Standard T2V | $0.071,原价 $0.084 | $0.71 | 验证单说话人和轮流说话提示词结构 |
| Kling V3.0 Pro T2V | $0.095,原价 $0.112 | $0.95 | 运行混合语言或展示候选版本 |
3 个 10 秒测试列出的总成本是 $2.37,不含任何重跑。把它当作简单的规划估算。它假设显示出的每秒价格、所请求的时长被实时表单接受,并且账户适用价格与公开页面一致。真实测试场的 schema 是可用画幅比、质量选项和原生音频控制的最终依据。
常见问题
Kling 4 正式发布了吗?
是的。Kling 4.0 于 2026 年 10 月 15 日正式发布。本文使用的官方发布和生成片段是 Kling 3.0,因此它们无法确定 Kling 4.0 在相同对话测试中的表现。在报告 V4 结果之前,请在选定的 V4 路径上运行评分卡。
今天做 Kling 对话唇形同步测试应该使用什么模型?
对于简短脚本检查,使用已验证的当前 Kling V3.0 Standard Text-to-Video 路径。对于更严格的后续测试,例如本文中的混合语言场景,使用 Pro。保持设置足够稳定,以便你能判断结果是因提示词还是模型层级而改变。
Kling 能让 2 个人一个接一个说话吗?
Kuaishou 表示 Video 3.0 可以生成内容和说话顺序可控的多角色对话。在实践中,先运行一个简短的轮流说话样本。为每个说话者命名,锚定他们的位置和服装,说明镜头顺序,并明确指示倾听者保持沉默。
为什么我的 Kling 视频里两个角色都在动嘴唇?
场景可能让说话人归属过于开放,或者模型在该次运行中产生了不想要的面部动作。将测试限制为 2 个人,每人 1 句台词。然后加入直接的沉默倾听者指令,并带音频检查结果。如果问题仍然存在,将其报告为失败结果,并只改变 1 个变量后重跑。
Kling 支持在 1 个片段中使用英语和西班牙语对话吗?
Kuaishou 将英语和西班牙语都列为 Video 3.0 原生音频支持的语言。支持语言列表并不等同于对任何对话脚本的保证。上文第三个 Kling 4 对话唇形同步测试 保持交流简短,以便你可以在同一个文件中判断语言切换、嘴部动作和说话人归属。
展示唇形同步测试时,我应该使用 GIF 还是视频?
当文章需要轻量、易浏览的面部动作和说话人切换视图时,使用 GIF。在审阅词语和声音时序时,使用原始 MP4。这里的 3 个嵌入结果是 GIF,而它们的源 MP4 文件仍保留在文章资源文件夹中。




