一段短片要求角色向前走并摘下太阳镜。另一幅肖像在几秒内改变表情。第三段显示一张参考脸逐渐变成别人。如果你正在决定用 Meta Muse video 制作什么,这些信号比精修过的发布宣传片更有用。我们审阅了在 Muse 围绕日本扩张的首周活动期间收集的 18 个视频帖子,然后观看提供的视频文件,而不是根据封面帧来判断。这些片段表明,它适合快速、手机优先的实验,同时也为任何必须让主体保持可识别的人带来一个具体问题。
关键要点
- 选出的 18 个帖子是一组经过策展的观察样本,而不是 18 次独立、受控的生成,也不是模型基准测试。
- 短肖像和简单动作让人容易看出片段是否保持了表情、时序和主体身份。
- 提示词可能看起来遵循了某个动作,但人物的脸、身体或视觉风格却发生了变化;发布前检查完整片段。
- Meta 的 Muse 智能体、其 Muse Video 研究预览和 Meta 的开发者 API 是不同的产品界面。公开帖子无法确定每个片段由哪个模型版本生成。
观察页面包含什么
提供的研究页面是 2026 年 10 月 22 日至 27 日发布的 X 帖子的可视化索引。其作者报告通过 X API 阅读了 200 个帖子,发现 163 个带视频,并选出 18 个进行详细审查。最终集合包括 1 个官方帖子、14 个用户帖子和 3 个汇编或转发帖子。其中 3 个用户帖子被明确标记为失败。每张卡片显示一个视频、一段简短编辑备注以及当时抓取的互动数据。随页面提供的 ZIP 包含 18 个视频文件和一份 TSV,其中包含日期、时长和分辨率。
这是一个有用的集合,但其选择过程是定性的。热门帖子可能因为已有受众、推荐优惠或片段话题而排在前面。有些汇编帖子重复了用户集合中已经存在的素材。一段 10 秒肖像再次出现在一个汇编中。因此,我们将该集合视为人们当时发布内容的示例,而不是成功率估计或唯一模型运行次数的统计。保存的互动数据是历史快照,不是当前总数。
页面称 Muse 于 10 月 22 日在日本上线。Meta 的日本公告将本地发布时间定为日本时间 10 月 23 日。时区差异可能解释这一出入,但面向日本的文章应使用官方本地日期。页面中约 $1 的数字指的是其 X API 研究成本;这不是 Muse video 生成价格。
这些帖子讨论的是哪个 Muse?
“Muse” 现在指代若干相关事物。Meta 将 Muse 描述为个人 AI 智能体,可通过应用、网页和某些消息界面使用。另外,Meta Superintelligence Labs 于 2026 年 7 月推出 Muse Image,并预览了 Muse Video。研究帖子描述了原生音频支持,并表示 Meta 仍在研究音视频同步和物理准确的快速运动。这些陈述描述的是已发布的研究预览,而不是对 10 月流传的每个片段测得的实际结果。
此样本中的用户表示他们使用 Muse 制作视频,通常是在手机应用中。他们的帖子和下载的片段是其所分享输出的证据。它们并未揭示后端模型标识符、版本、生成设置、隐藏编辑,或一条成功帖子背后的尝试次数。仅凭这些文件,将某种特定视觉行为归因于某个命名研究检查点,会是错误的。用 Meta 的 Model API 定价页来计算这些视频的成本也会是错误的:该页面列出了文本、图像、转录和分割费用,但我们检查的版本中没有公布 Muse Video 生成费率。
在规划生产工作流时,这一区别很重要。普通用户可能关心是否能在应用中做出可用的短片。开发者需要 API、有文档记录的限制、可复现的设置,以及每个被接受片段的可预测成本。这些帖子主要回答的是第一个问题。
观看视频本身,而不只是缩略图,会看到什么
发布片段展示的是形式,而不是失败边界
官方发布帖子是一段 6 秒的序列,桌面上排列着小型角色照片。一只手将一张新照片放到其中。这是对短视频视觉创作的清晰发布演示,但它并未测试人脸能否在 10 秒内保持一致、产品标签是否仍然可读,或快速动作是否遵循物理规律。在整个样本中,值得始终留意宣传序列与受控用户测试之间的区别。
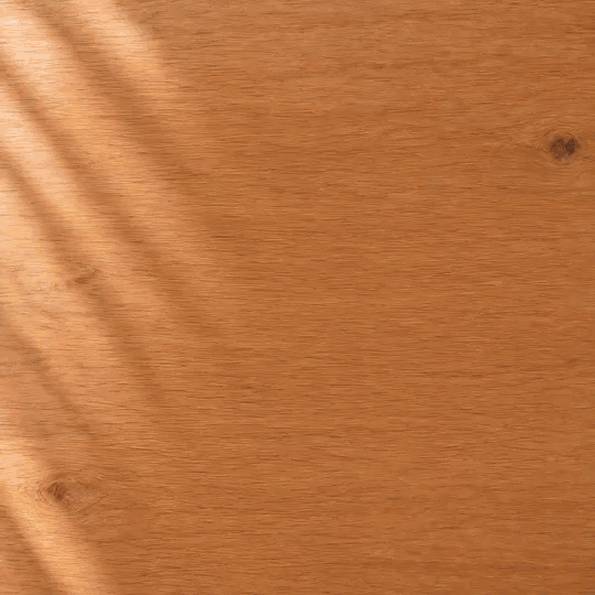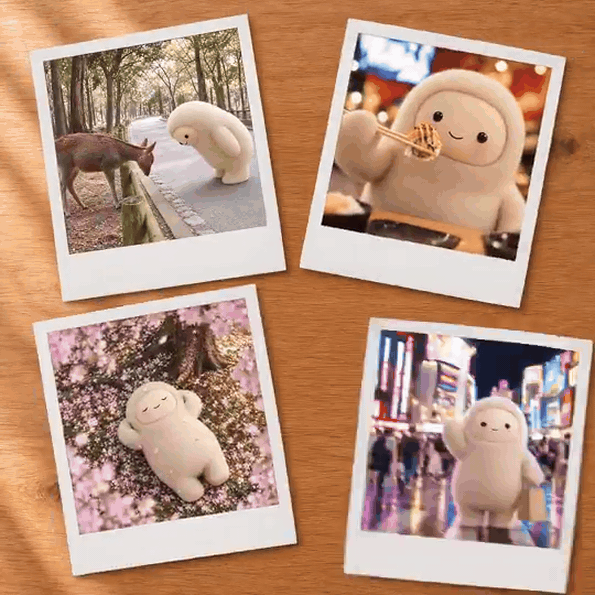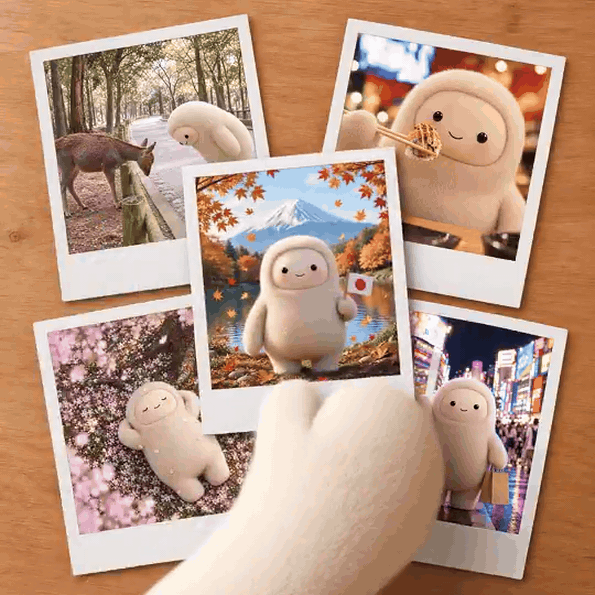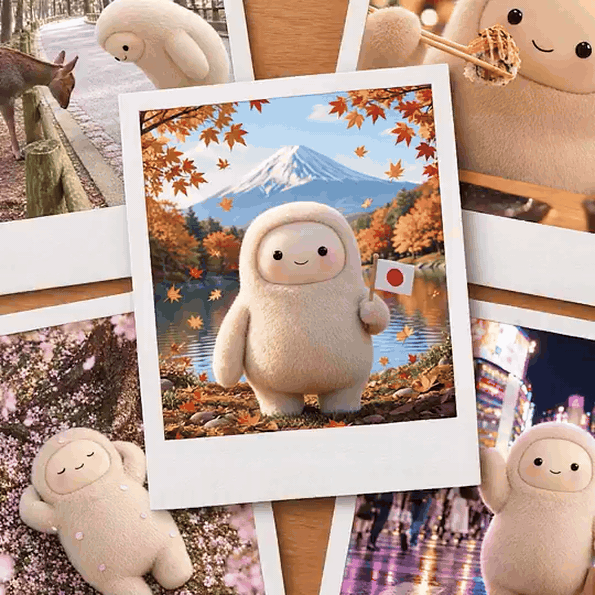
完整的 6.2 秒官方片段,从提供的归档转换为无声 GIF。静态照片和手的放置是这个示例的重点。
肖像运动容易讨喜,也容易被误读
在一个用户帖子中,特写角色从担忧变为微笑,切到更宽的泰迪熊镜头,再回到脸部。表情变化让片段在大约七秒内有了开端和回报。这是手机用户能立即评估的那种运动:角色有没有反应,剪辑是否感觉像一个短想法,而不是带有镜头运动的静态图像?
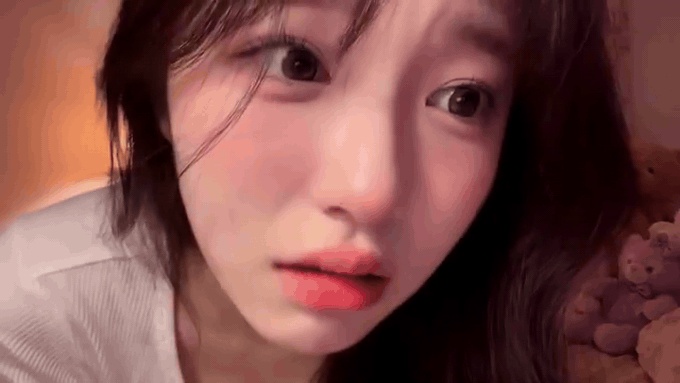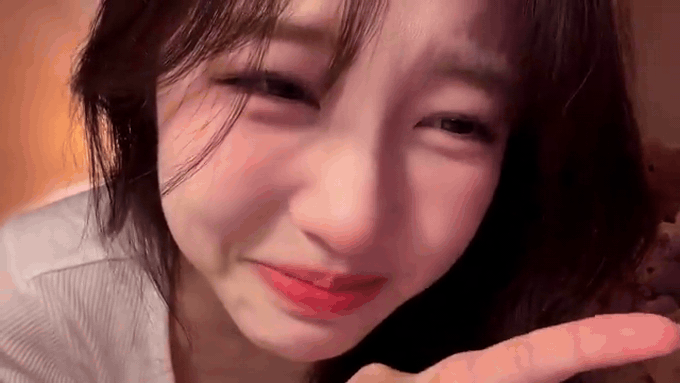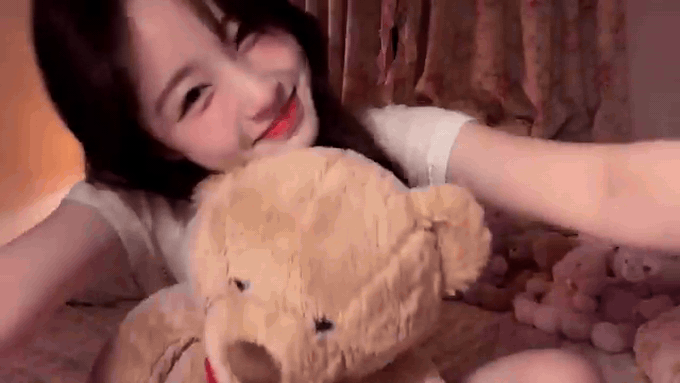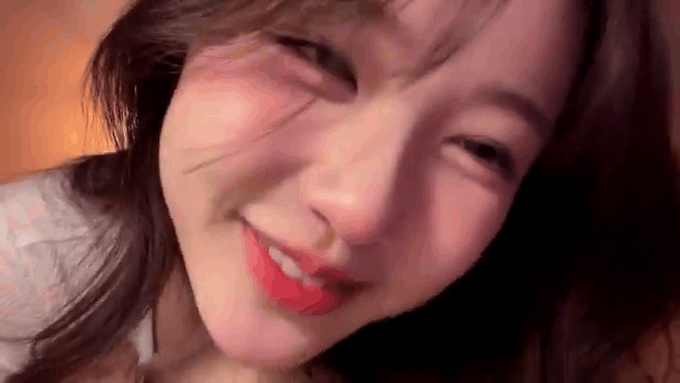
观察集合中完整的 7.4 秒片段,以无声 GIF 展示。切到泰迪熊使它成为一个表情加剪辑的示例,而不是连续身份测试。
它作为肖像一致性的证明用处较小。短片改变了构图并包含剪辑,因此观看者无法全程获得同一张脸的连续高分辨率视图。随附帖子声称 Muse 比另一个视频模型更便宜,但没有提供可比较的设置、生成次数或账单。应将其视为轶事性的成本印象,而不是独立价格比较。
另一段手机优先片段从咖啡馆入口的背面视角移动到正面谈话镜头。这一变化也改变了角度、光线和距离。对于角色营销活动,测试不在于每一帧单独看起来是否合理,而在于当这些条件改变时,观看者是否还能认出同一个人。单张首帧无法回答这一点。
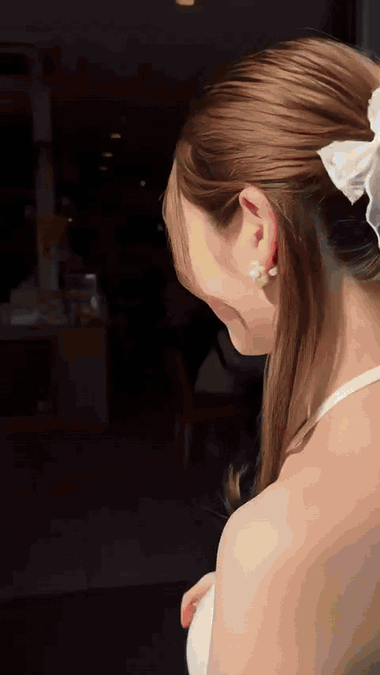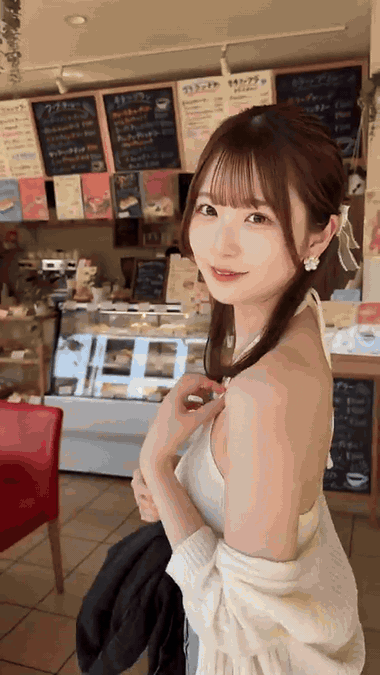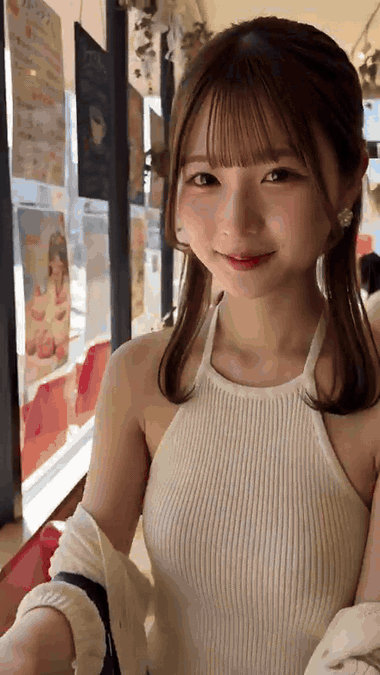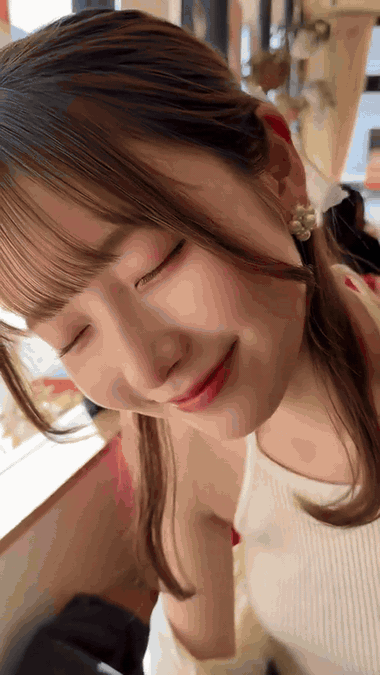
来自提供归档的完整 10 秒咖啡馆片段,已转换为无声 GIF。比较入口处、咖啡馆内和窗边的拍摄对象,以判断角色在角度和光线变化中是否仍可识别。
简短指令可以产生动作,却仍会丢失参考
一个帖子报告,给出参考图像和简短指令:朝镜头走来并摘下太阳镜。归档片段确实显示了一个行走的主体,眼镜也摘下了。它也从写实街头肖像过渡到动漫风格特写。随附备注对结果持正面态度,所以这并不是说用户认为它失败。它提醒我们,动作遵循和风格连续性是不同的检查项。如果参考图像旨在为广告或系列锁定一个角色,那么最终帧与所请求的动作是否发生同样重要。
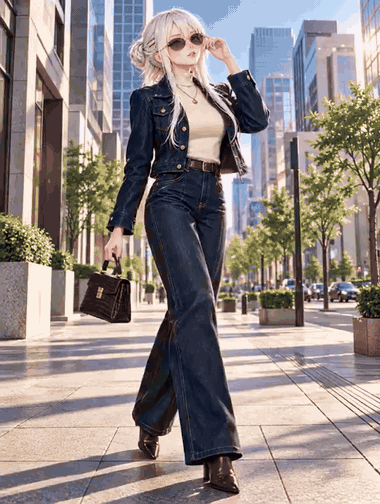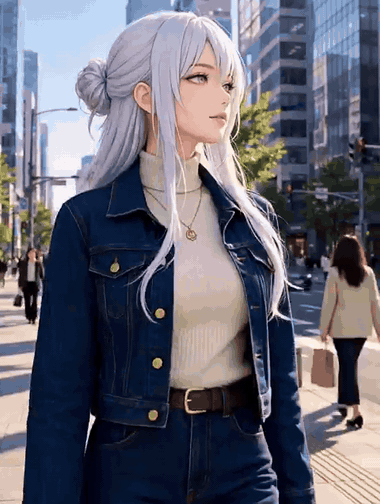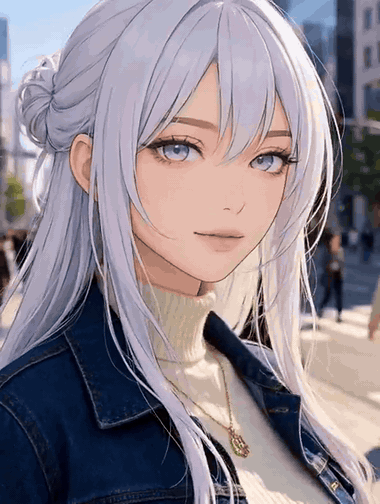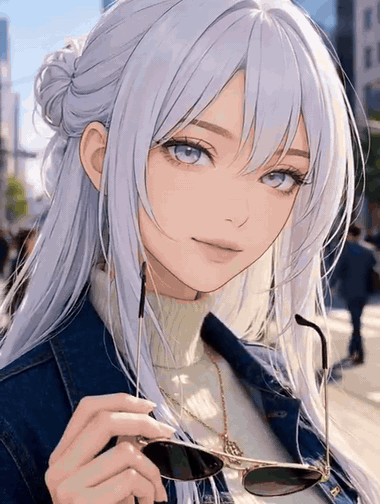
完整的 10.1 秒归档片段。观看摘下太阳镜动作后,从写实行走镜头到风格化特写的转变。
这时更具体的简报会有所帮助。说明哪些特征必须保持不变、允许哪个单一动作,以及镜头是否应保持在一个镜头内。即便如此,书面约束是请求,不是保证。在判定片段可用之前,将首帧、中间帧和最终帧与源图像进行比较。
可见的日文文本不等于已验证的日文文本
一段动画万圣节片段让角色穿过明亮的街道。随附备注称场景中出现了日文文本。在提供的视频中,随着镜头移动,类似标牌的文字仍然存在。对于日本场景来说,这是有用的观察。但这不是可读性审计:有些字符很小、有角度,或只出现不到一秒。对于真实店铺名称、安全标签或产品包装,请将导出的视频以全分辨率定格,并检查每一个必需字符。生成的标牌绝不应成为重要文案的唯一来源。
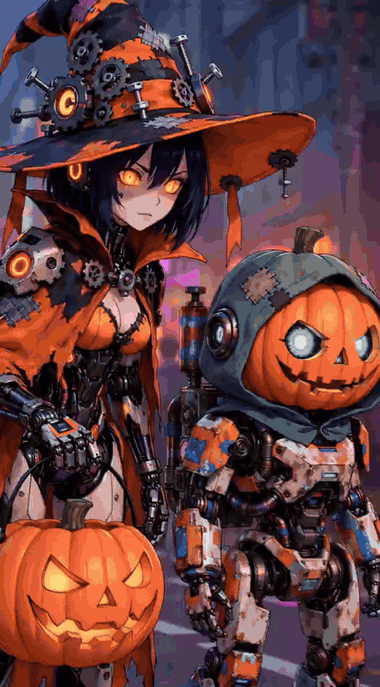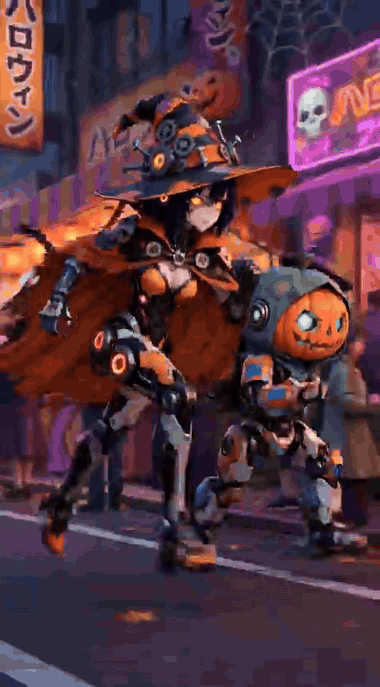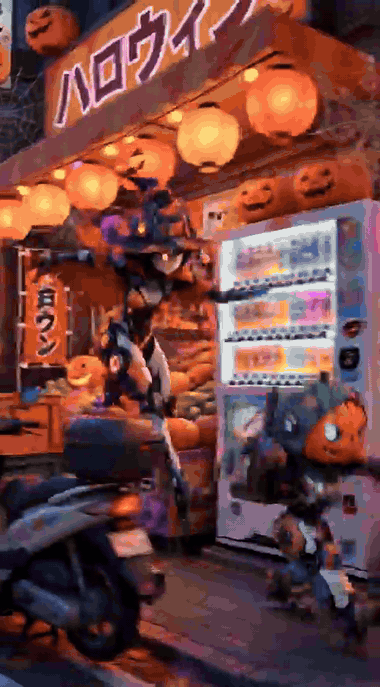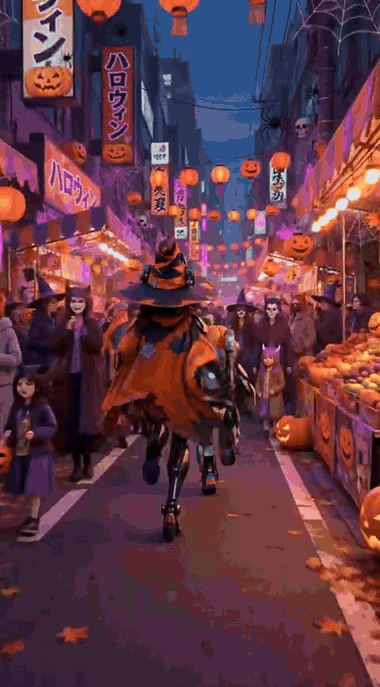
完整的 10.1 秒归档片段。帖子展示了移动角色旁边的日式标牌;文本准确性需要单独检查。
失败帖子说明为什么身份需要单独审查
最明确的负面示例之一是对越来越阴险的微笑的测试。随附备注说脸部变化太大。观看这段 10 秒片段时,主体靠近镜头,脸部的比例和表情随着构图变化。这个示例有价值,因为漂移被指出来了,而不是被一个有利的帧掩盖。
完整的 10.1 秒归档片段。随附备注明确指出了微笑测试期间的脸部变化。
该集合中另外两个帖子提出了相关抱怨:一个说两个不同的参考角色变成了不同的人,另一个说被参考的女性的身份和体型发生了变化。我们无法从归档中重建其原始输入,因此我们将其作为用户观察来报告,并仅将可见片段用于它们所展示的内容。它们共同的警告很实际:基于参考的动画应审查身份、轮廓、服装和场景连续性,而不仅仅是运动。
| 创意任务 | 这些片段能展示什么 | 它们不能证明什么 | 使用前审查 |
|---|---|---|---|
| 短篇表情肖像 | 一张脸是否会改变表情并让镜头保持生动 | 跨剪辑或更长序列中的稳定身份 | 比较开头、中间和结尾的脸型及显著特征 |
| 参考图像动作 | 所请求的手势是否出现 | 参考是否锁定风格、服装或身体 | 将参考与最终帧并排检查,并记录每一次漂移 |
| 带标牌的动画场景 | 类似文字的痕迹是否在移动帧中持续存在 | 拼写正确或日文可读 | 检查导出中的全分辨率静帧 |
| 多角色或快速运动 | 场景是否有运动以及可识别的节拍 | 物理准确性、精确数量或可靠的角色分离 | 围绕接触、转身和遮挡逐帧审查 |
如何测试 Muse video,而不会把一条好帖子误认为可靠工作流
从一项你能在生成前写下验收标准的任务开始。对于角色短片,选择一张参考图像、一个动作、一个镜头方案和一个目标时长。保存你提交的确切指令。如果产品提供宽高比、质量或时长控制,记录你自己屏幕上可见的设置。X 归档中没有其示例的这些设置,因此从片段中复现它们只会是猜测。
例如,一个参考图像测试简报可以写道:“始终使用上传的肖像作为同一个成年角色。在一个连续的半身镜头中,她朝镜头走两步,停下,然后用右手摘下太阳镜。保持她的头发、夹克、脸型和背景一致。使用自然日光和竖幅画面。”这是一个测试提示词,不是该集合中任何视频背后的提示词。它的价值在于为审查者提供对动作、角色、场景和镜头行为的单独检查项。
在得出工作流结论之前,至少用同一简报尝试三次。保留失败的输出,而不只是最好的那一个。记录每次运行是否满足具体验收标准,以及你花了多少时间修改它。一个需要多次重试的便宜生成,按每个可用片段计算,可能比一个更贵但很早就成功的模型更昂贵。提供的页面记录的是收集 X 数据的成本,而不是每个生成视频的成本,因此无法回答这个经济问题。
如果该作品将由品牌发布,请进行最终人工审查,检查权利和呈现。确认任何真实人物的脸或声音的使用已获得许可,生成的角色不会冒充某人,并且产品声明和屏幕上的文字准确。无论选择哪种模型,这些都是编辑检查。如果一致性或精确文本至关重要,请将生成的动态影像作为素材进行审查和编辑,然后在常规编辑器中添加已验证的排版,而不是信任片段内部渲染的文本。
任何比较其他托管视频模型的人,都可以在 Atlas Cloud 的模型目录中使用相同的简报和验收表。通过匹配时长、宽高比、参考输入和审查标准来保持比较公平。这里的样本并未建立 Muse 与任何其他模型之间的排名。
从第一波中可以得出什么
对这 18 个帖子有用的解读,比“Muse 很好”或“Muse 很糟”更狭窄。短片显示,在日本上线后,用户很快就在制作肖像、动漫场景、动作提示词和混编汇编。它们也说明了为什么 10 秒导出需要完整观看:脸可能在片段后期漂移,风格可能在所请求的动作之后改变,文字可能出现却不可靠。一个遵循提示词的瞬间不等于完成制作资产。
对于你的第一次 Meta Muse video 测试,选择一个带有一个可观察动作的小场景。保存参考和提示词,检查完整导出,并根据你在看到它之前设定的标准判断结果。这样你就能得到一个可用的答案,即使片段本身未达标。
常见问题
Muse 应用和 Muse Video 模型是同一个东西吗?
Meta 将 Muse 呈现为个人 AI 智能体,并单独发布了 Muse Video 的研究预览。本集合中的公开帖子没有透露应用使用的后端版本。在技术比较中,避免将这些名称视为可互换。
Meta Muse video 生成免费吗?
Meta 表示许多基础 Muse 智能体功能免费,并为更重度使用提供订阅计划。有几个帖子称手机视频创作免费。这些报告并未确立永久视频配额或开发者价格。在规划定期生产计划之前,请查看应用中的当前条款。
这个样本能证明 Muse 比其他视频模型更好或更便宜吗?
不能。该页面是社交帖子的策展集合,不是受控的并排测试。它缺少进行质量或成本排名所需的提示词、匹配设置、重试次数和已验证生成费用。
我可以在自己的营销活动中重复使用这些视频吗?
为本次审查提供的归档帖子和片段是第三方示例。它们出现在研究页面中并不授予重复使用权利。请从权利持有人处获得许可,或制作并审查你自己的原创输出。
来源与观察备注
- Meta 日本的 Muse 发布公告,日期为日本时间 2026 年 10 月 23 日。
- Meta Superintelligence Labs 的 Muse Image 和 Muse Video 介绍,发布于 2026 年 7 月 7 日。
- Meta Model API 定价和速率限制,检查于 2026 年 10 月 28 日。
- 提供的 18 个视频文件和
清单.tsv。我们直接审查了归档文件;社交帖子的归因和互动数据在抓取后可能发生变化。





