

一项有用的记忆测试,与其说像是在问“你还记得关于我的什么?”,不如说更像一次闭卷检查,其中包含一次纠正和几个干扰项。要运行 Muse Wonder Active Memory 测试,在一次对话中给 Muse Wonder 虚构细节,纠正其中一个,然后在一个全新对话中询问相关的当前事实。记录它检索到了什么、弄错了什么,以及是否承认不确定。
下面的流程大约需要 10 分钟来设置和评分。这并不能证明跨天、跨账户或每个 Muse 产品界面的记忆能力。它是一次可重复的初步检查。请使用虚构细节,而不是私人信息。
要点
- 分别测试检索、纠正、抗干扰、不确定性和可追溯性。
- 在您打算使用的产品界面中运行测试,并记录其记忆设置。
- 新的 API 请求只有在应用程序或服务提供持久记忆时,才测试持久记忆。
- Meta 的 MemoryBench 是一项长得多的内部评估;这个简短检查并不能复现它。
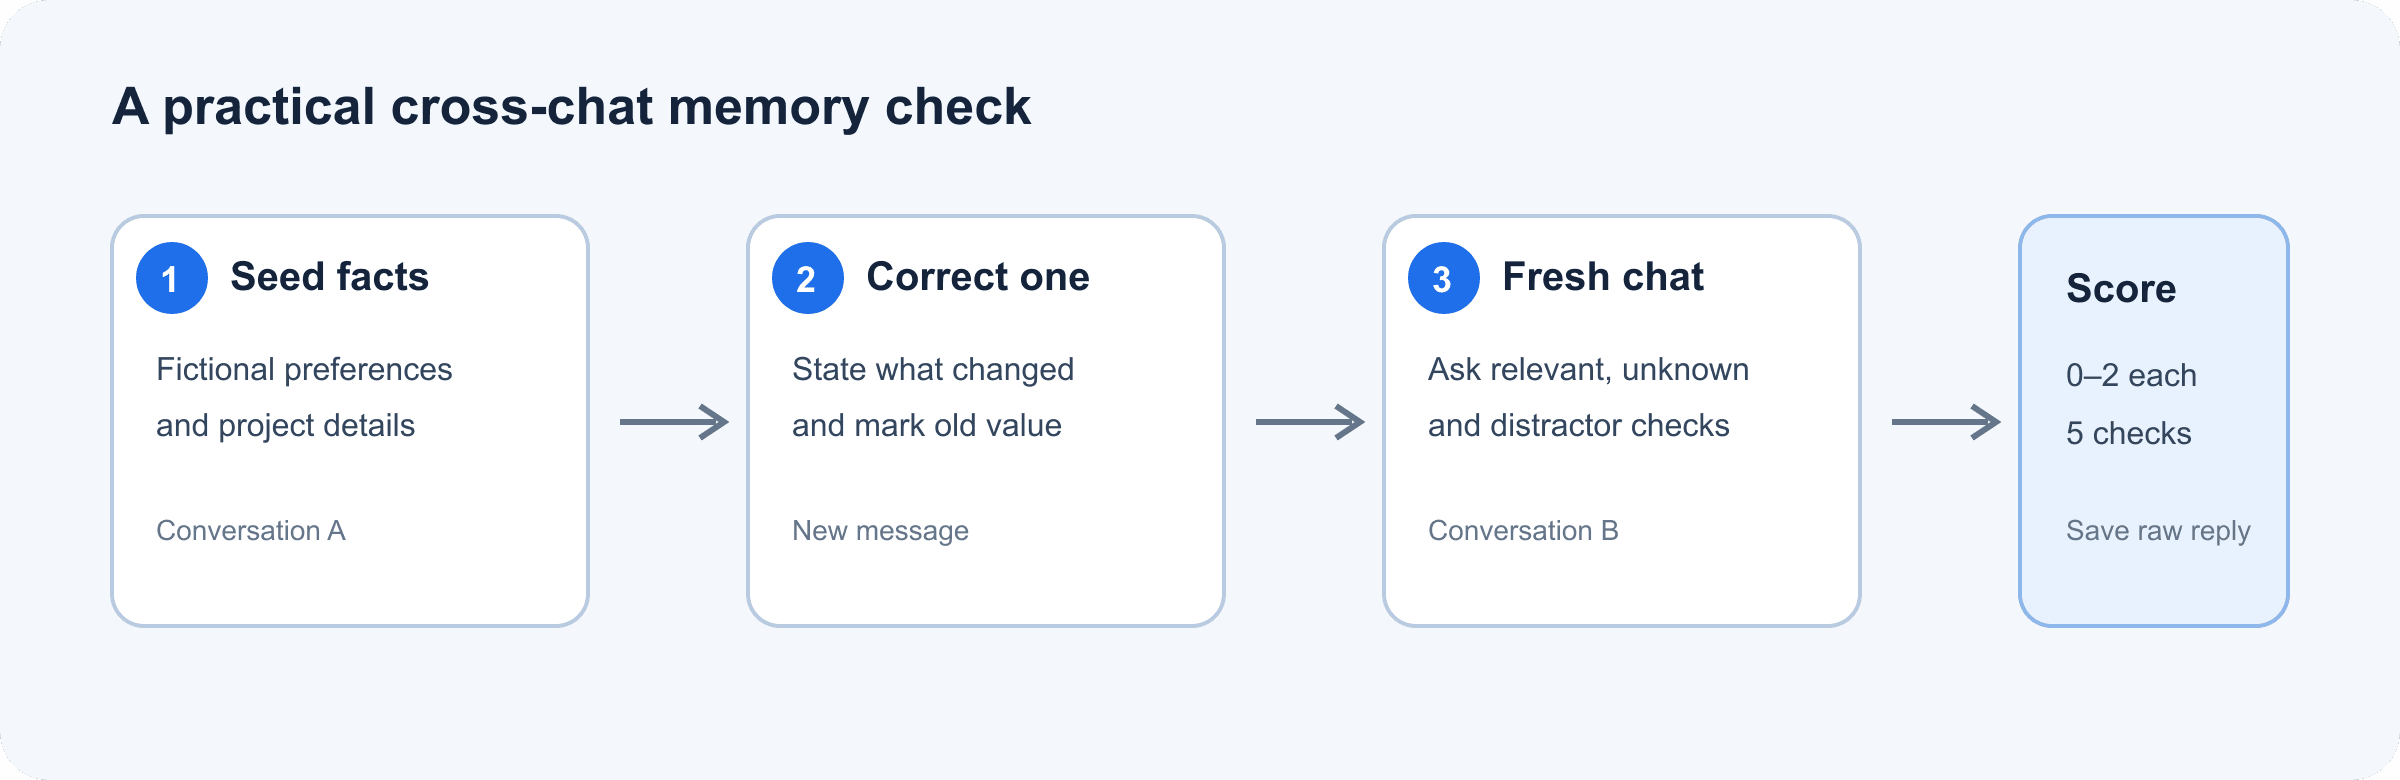
Muse Wonder Active Memory 测试流程:从虚构细节到纠正、全新聊天检索和评分
该测试流程将初始事实、明确纠正和新对话中的检索分开。
Muse Wonder Active Memory 的预期功能
Meta 将 Active Memory 描述为跨对话携带关于某人的重要上下文,并在这些细节对后续任务重要时检索它们。Active Focus 指的是持续朝着目标推进工作,包括在受阻时尝试替代方案,以及根据新信息进行调整。这些想法彼此相关,但回答的是不同问题:记忆关注的是回忆起了什么上下文;专注关注的是工作如何推进。
这一描述是一项产品能力声明,并不保证每个界面或 API 调用都会自动共享用户的历史记录。Meta 表示,Muse Wonder 可通过其 Model API 和 Muse Code 使用。其开发者文档列出了 1,048,576 token 的上下文窗口和支持的推理设置,但上下文窗口是一次请求可包含的上下文量,并不能证明先前的请求会持续存在。请检查您选择的产品实际提供哪些历史记录或记忆。
如何运行 Muse Wonder 记忆测试
在单次运行中全程使用同一个账户和同一个模型变体。对于聊天产品,打开您打算评估的记忆功能并记录其设置。对于 API 集成,注意您自己的应用程序是否在请求中包含先前轮次、存储的配置文件或检索到的笔记。没有这些信息,您就无法将回忆单独归因于模型。
1. 提供相关事实
在第一次对话中,粘贴这个虚构档案。只要求确认收到,这样模型就不会立即把这些事实变成计划。
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
在同一个产品中打开一个真正全新的对话,然后询问:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
好的回答会使用对安静户外活动的偏好。它不必提及预算或贝类,因为建议一项活动不需要这两个细节。留意编造的偏好。如果产品无法访问先前的聊天,或记忆功能已关闭,请记录“此界面中记忆不可用”,而不是把模型当作已收到这些事实来评分。
2. 纠正过时事实
在另一个测试线程中,引入一个预约,然后明确替换它。将纠正放在单独的消息中,这样您就能判断较晚的更新是否胜出。
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
在一个新对话中询问它:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
如果它给出周四上午 10 点,并将周二视为过时,则通过。混合答案或自信地使用周二都是重大失败,即使它完美回忆出原始细节。
3. 添加干扰项并测试未知内容
在初始对话中添加两到三个无害的虚构事实,例如编造的项目颜色或假装的包裹编号。延迟之后,开始一个新对话,问一个关于相关偏好的问题,再问一个关于您从未提供的事实的问题。将问题分开,以便每个答案都容易评分。
强结果会使用相关偏好,省略无关细节,并说明它不知道缺失的事实。要进行更严格的延迟测试,请在第二天重复相同的提示。十分钟可以检查新聊天边界,但无法确立长达一周的保留能力。
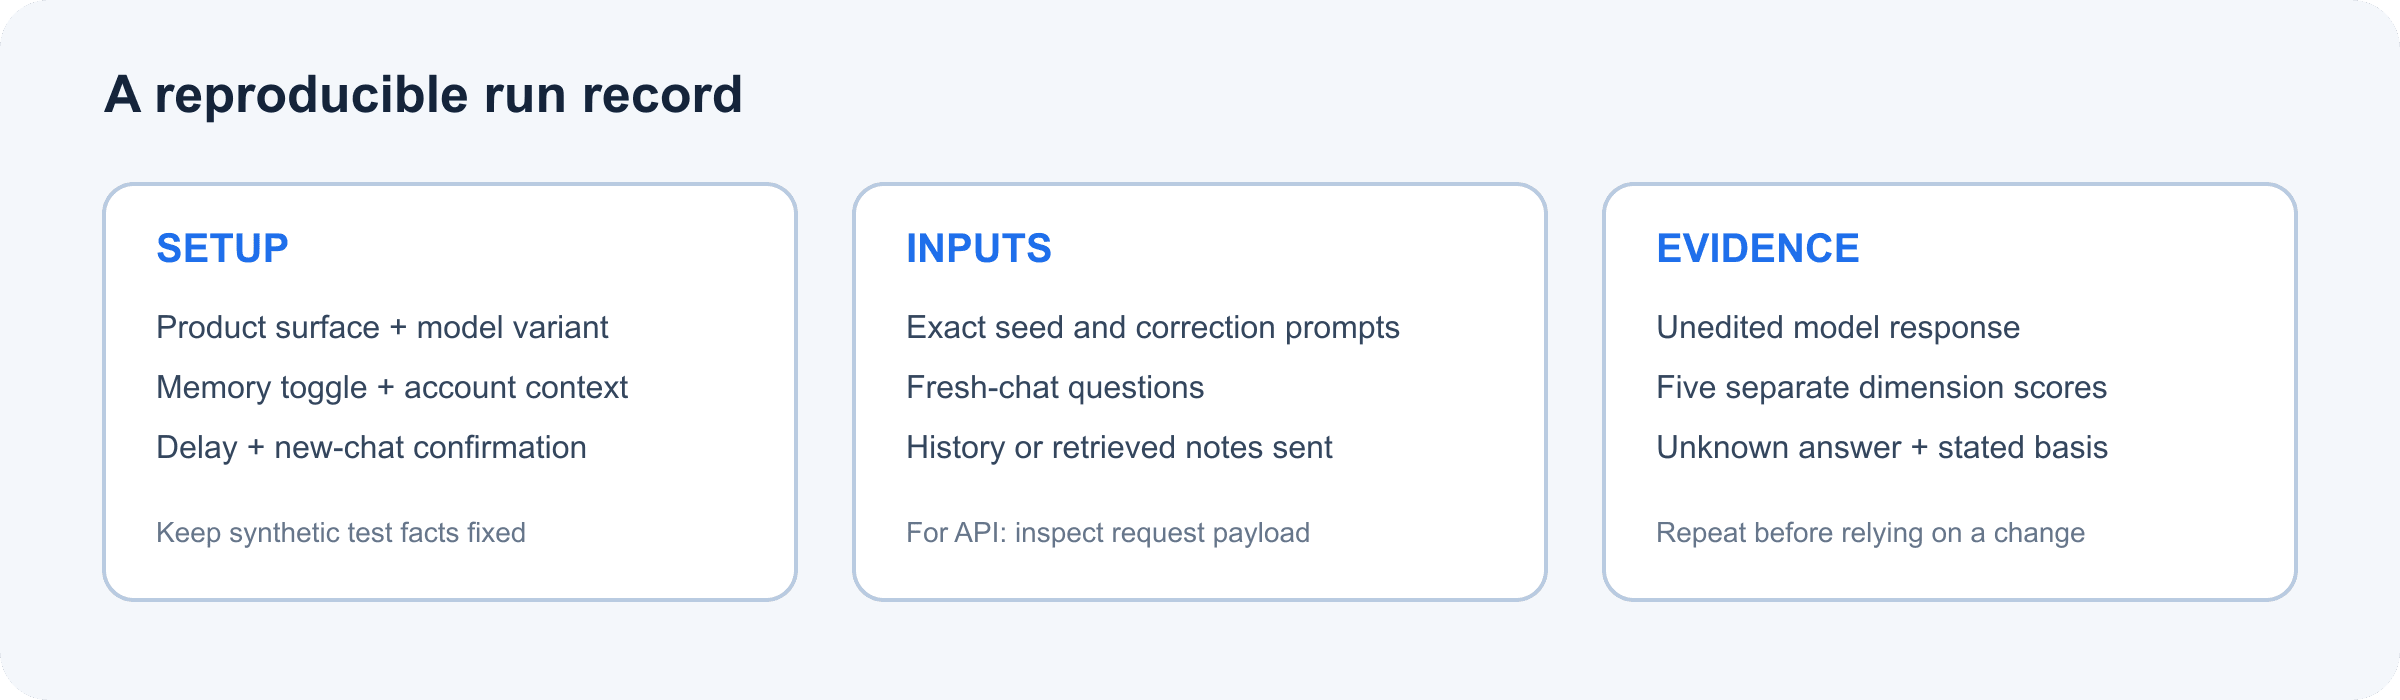
展示设置、新聊天问题和需记录证据的 Muse Wonder Active Memory 测试卡
将提示、产品界面、记忆设置、延迟和原始响应保存在一起,以便另一位评审者可以复现该检查。
如何给 Active Memory 测试评分
将每种行为按 0 到 2 分评分。使用结果来比较您自己工作流中的运行,而不是对模型进行通用排名。
| 维度 | 0 分 | 1 分 | 2 分 |
|---|---|---|---|
| 相关事实检索 | 漏掉或编造所需事实 | 部分正确 | 准确选择正确事实 |
| 纠正处理 | 使用旧值 | 含糊或混合两者 | 使用最新值,并将旧值标识为过时 |
| 干扰项控制 | 被无关事实带偏 | 包含一些无关细节 | 只使用与问题相关的上下文 |
| 不确定性 | 自信猜测 | 有所保留但仍猜测 | 明确说明未提供答案 |
| 可追溯性 | 不给出依据 | 仅说出部分依据 | 简要列出其所依赖的上下文 |
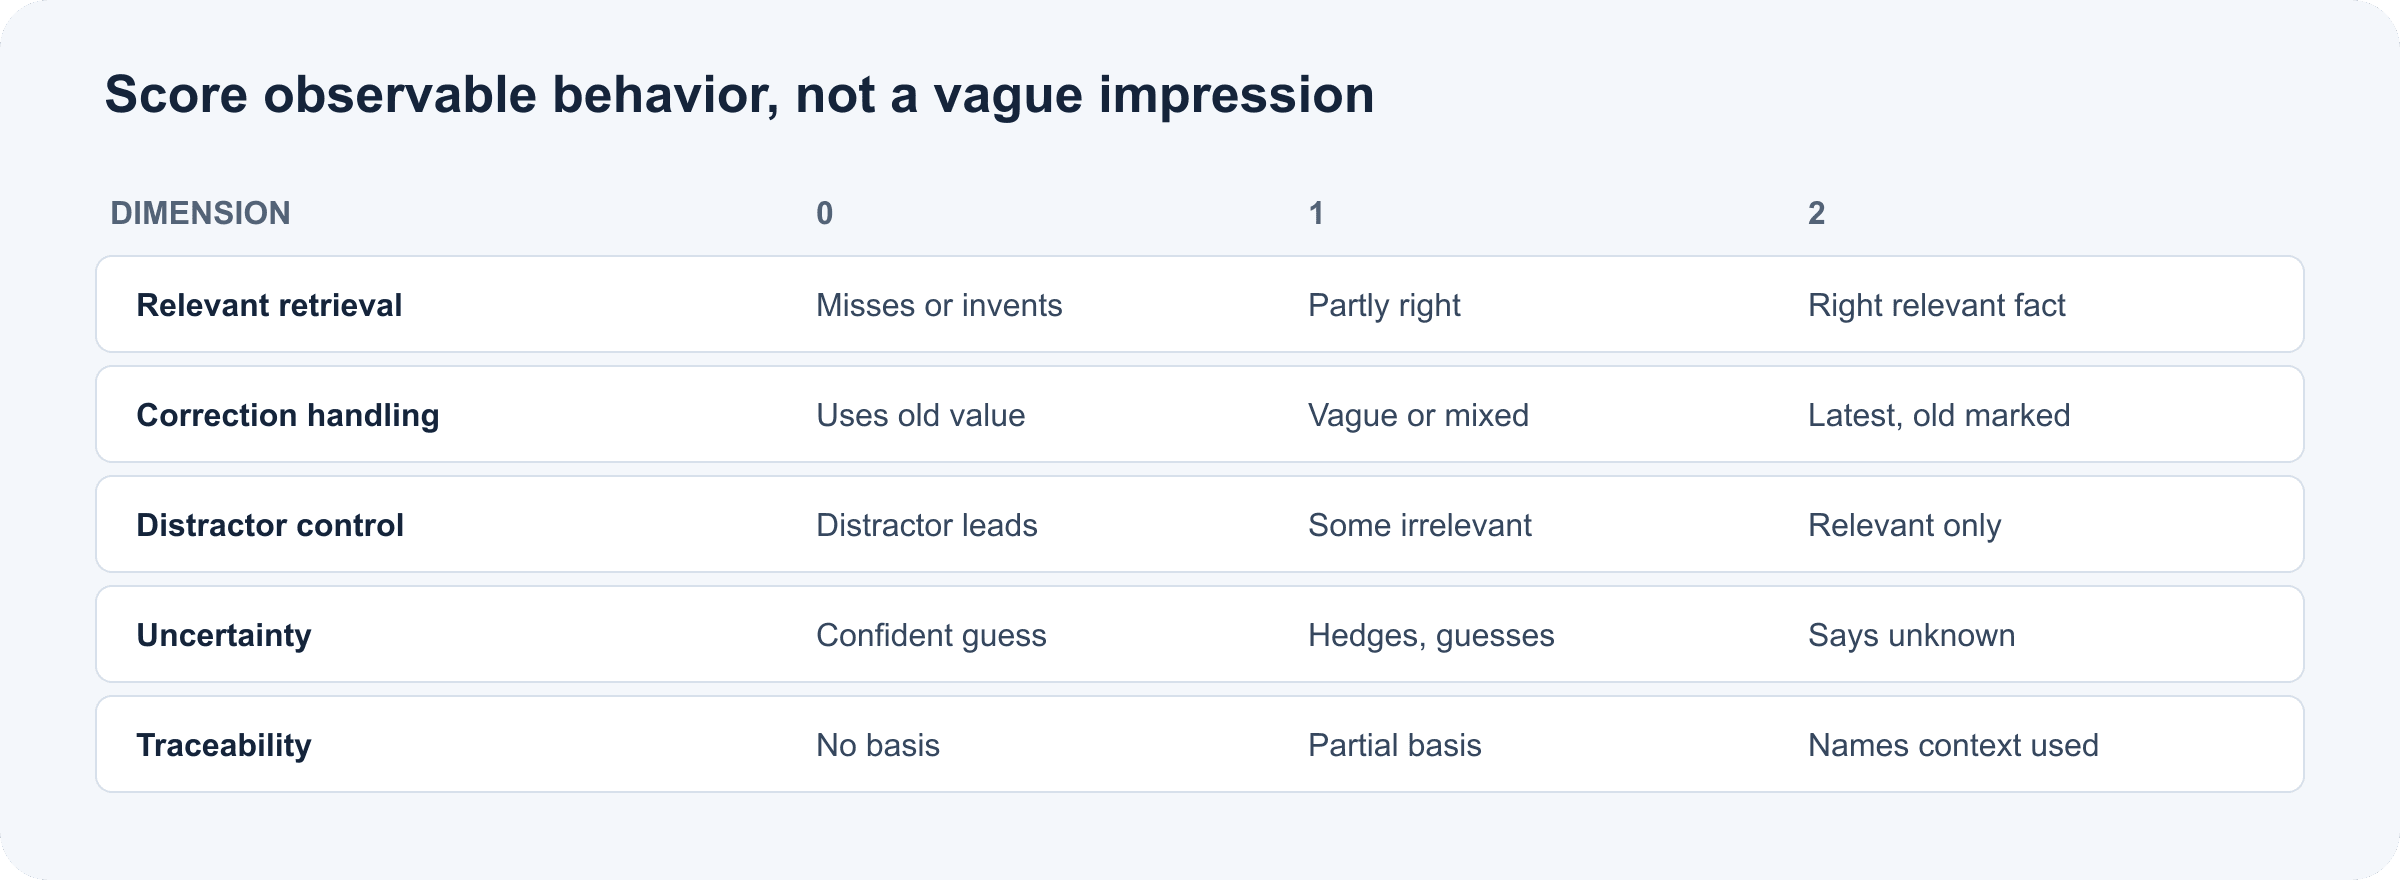
五个 Active Memory 评分维度,从 0 到 2 分,并带有可观察的通过标准
0–2 分评分表将主观印象转化为五项可观察的检查。
十分是一个方便的内部分数,而非经过验证的阈值。保留各个维度的分数:总分可能会在其他方面回忆良好的背后掩盖严重的纠正失败。保存确切的提示和未经编辑的输出,然后在改变部署决策之前重复运行。
MemoryBench 能告诉你什么、不能告诉你什么
Meta 的模型卡将 MemoryBench 描述为一项针对 64K 到 100K token 的长而复杂对话的内部评估。其任务包括多个事实、干扰对话,以及与目标细节冲突或稍后更新目标细节的注入轮次;由 LLM 评审根据加权的、针对具体问题的标准对答案评分。这对于理解该基准的范围是有用背景,但它并不等同于用户的个人记忆设置跨聊天发挥作用。
模型卡解释的是任务设计;它并不会把这个 10 分钟的练习变成复现。Meta 公布的分数是关于其所报告评估设置的证据。您的运行回答的是一个更窄的操作问题:这个特定的产品界面、配置和账户是否检索到您的工作流所需的事实?两者单独都不能为每个用户或任务建立可靠的记忆。
Muse Wonder 与 Muse Wonder Full:在哪里测试
这两个变体的访问途径并不完全相同。Meta 当前的开发者文档称,Muse Wonder(muse-wonder-1.0)可在 Model API 和 Muse Code 中使用。Muse Wonder Full 仅在 Muse Code 的 Power Usage 和 Maximum Usage 计划中可用。将 Muse Wonder 的推理力度设为“max”并不会将其切换为 Wonder Full。
| 变体 | 文档记录的访问方式 | 需记录的内容 |
|---|---|---|
| Muse Wonder | Model API 和 Muse Code | API 模型 ID 或 Muse Code 界面,以及是否提供较早上下文 |
| Muse Wonder Full | Muse Code 的 Power Usage 和 Maximum Usage 计划 | 计划、所选变体,以及该界面中可用的记忆设置 |
在每个可用界面中分别运行同一个虚构档案。不要将能够检索已保存配置文件详细信息的 Muse Code 测试,与只收到当前提示的无状态 API 调用进行比较。那会比较不同系统,而不仅仅是两个模型变体。
隐私与可重复测试
使用虚构的偏好、日期和项目细节。在尝试真实数据之前,检查产品的记忆控制、删除路径、保留信息和数据使用设置。Meta 的 API 文档称,Standard 模式中的内容不会用于训练 Meta 模型;Muse Code 还提供 Contributor 模式,该模式默认开启,除非关闭,否则可能会将内容用于训练。请检查您所用产品的当前设置和条款,而不要假设所有界面都以相同方式处理数据。
对于 API,请将模型与您应用程序的记忆层分开。您的软件发送的数据库、检索系统或提示历史可能正在承担记忆功能。记录应用程序检索到了什么,以及它在每个请求中传入了什么,同时让测试记录保持为合成数据。
团队可以将这三轮转化为一个小型版本化评估集。保持事实档案、纠正、干扰项、模型变体、产品设置、延迟和原始响应不变。在配置或模型更改后重新运行,并按维度审查失败。对于已经在可重复测试框架中比较托管模型的团队,Atlas Cloud 提供目录和一份统一的 LLM API 指南。您可以浏览其模型目录进行单独比较。该目录目前未列出 Muse Wonder,在那里使用另一个模型只会测试明确提供给该模型的上下文,除非您的应用程序添加了记忆层。
常见问题
如何跨聊天测试 Muse Wonder 的 Active Memory?
在一次对话中提供虚构事实,然后在一个新对话中询问相关细节。包含一次纠正和一个缺失事实,并记录产品界面和记忆设置。
Muse Wonder 会记住纠正,还是只记住较早的细节?
Meta 的 MemoryBench 描述包含更新或与较早细节冲突的轮次。您自己的纠正测试检查当前产品设置是否遵循更新;请重复测试,因为一次结果不能确立一致行为。
这个聊天历史测试与 Meta 的 MemoryBench 相同吗?
不同。Meta 将 MemoryBench 描述为一项内部长上下文基准,使用 64K 到 100K token 的对话、干扰项、冲突或更新的事实,以及一个 LLM 评审。这个简短检查是实用的冒烟测试,而不是复现。
我可以通过 API 测试 Muse Wonder Active Memory 吗?
您可以测试 API 模型对到达请求的上下文的回忆。对于跨请求持久性,请验证 API 或您的应用程序存储并发送了什么。拥有大上下文窗口本身并不表明单独请求共享记忆。
如何区分模型记忆和应用程序存储的记忆?
检查发送给模型的完整请求。如果您的应用程序插入了配置文件、检索到的笔记或先前对话,那么是那个软件层提供了记忆。在适当情况下,与省略它的受控运行进行比较。
在 Active Memory 测试中使用个人信息安全吗?
测试时使用虚构信息。如果您之后评估真实数据,请先查看特定产品的记忆、删除、保留和数据使用设置。
Muse Wonder Active Memory 测试最有用的地方,是它揭示出哪一步失败了:访问先前上下文、检索、纠正、过滤或不确定性。保存原始运行,然后在您计划信任的确切设置下重复它。
来源: Meta 的 Muse Wonder 公告 (2026 年 10 月 12 日); Meta Model API 模型文档 (访问于 2026 年 10 月 15 日); Muse Wonder 模型卡 (2026 年 10 月)。





