一个只会动嘴的课程虚拟形象可能吸引人听完一句话,然后就让人失去对课程的兴趣。OmniHuman 2.0 AI 课程讲师视频 让你能够围绕录制的讲解来规划可见的表情、有目的的手势和镜头方向。下面的颜色对比示例展示了一个完整的 30 秒讲师场景,同样有用的是,它还揭示了一个在发布课程前需要发现的道具连续性问题。
核心要点
- 核心输入是讲师图像和音频;文本提示可以指导表演或镜头方向。
- 将 OmniHuman 2.0 视为讲师视频舞台。课程、幻灯片、屏幕录制、事实核查和剪辑仍然由你负责。
- 30 秒的颜色对比示例展示了有用的手势和视角变化,以及一张消失的卡片,需要编辑审查。
- 发布前检查唇同步、表情、手势、图像稳定性和权利。
- Atlas Cloud 标价为每秒 $0.07,并显示每秒 $0.056 的折扣价;生成前确认当前价格。
示意性准备场景:参考肖像、旁白录音和课程材料是制作讲师视频前需要规划的输入。
OmniHuman 2.0 能为课程讲师视频做什么
OmniHuman 2.0 将参考图像和音轨转化为所描绘角色说话或唱歌的 720p 视频。Atlas Cloud 模型目录介绍了可选的文本指导、动态手势、多人场景、镜头运动以及长达五分钟的片段。这些是列出的功能,并不保证每个课程提示都能生成合适的镜头。
职责划分很重要。你提供教学内容和语音录音。模型生成可见的表演。你决定在哪些地方讲师有帮助,在哪些地方图表、幻灯片、软件截图或特写演示能更好地解释材料。
| 制作元素 | 你准备或做什么 | 模型贡献什么 | 你审查什么 |
|---|---|---|---|
| 讲师图像 | 清晰、获准的肖像 | 可见的身份参考 | 面部、服装和背景一致性 |
| 课程旁白 | 经过检查、节奏刻意的录音 | 音频驱动的说话表演 | 时间、发音和停顿 |
| 指导 | 关于构图和表达的简洁说明 | 提示引导的表演和镜头方向 | 动作是否支持课程 |
| 教学视觉素材 | 幻灯片、屏幕录制、图表或示例 | 不能替代这些材料 | 每个概念是否容易理解 |
| 最终课程 | 剪辑、字幕和质量审查 | 生成的视频片段 | 准确性、可访问性和权限 |
早期的 OmniHuman 研究论文描述了音频条件化的人体动画,但它涵盖的是 OmniHuman-1,不应被视为 2.0 版本的性能测试。对于课程制作决策,请依赖当前模型列表所述的输入和输出限制,然后用自己的材料制作样本来判断。(OmniHuman-1 论文)
在生成 AI 讲师视频之前要准备什么
一个令人信服的样本不仅仅取决于上传任意肖像和任意录音。选择便于判断结果是否适合真实课程的材料。
选择清晰、已获授权的讲师图像
使用正面或略微侧转的肖像,面部清晰可见,肩膀在画面内,背景整洁。避免面部过小、严重遮挡、戏剧性阴影或没有自然头部活动空间的裁剪。如果你希望在多个模块中使用同一位讲师,请保留已批准源图像的副本并一致地重复使用。
使用你自己的图像,或确认此人已授予预期合成视频用途的许可。肖像在网上可获取并不代表获得将其动画化或发布的许可。
录制在镜头前听起来自然的课程音频
以适中的语速录制一个连贯的教学要点。短段落比整堂课更容易评估和修改。录音前,检查术语、名称、数字和课程的事实性陈述。在观点之间保留自然停顿,但修剪可能使时间评估更困难的长间隔和背景噪音。
对照课程文本听一遍。如果录音中的数字或技术术语不清楚,先修正源音频。生成的面部无法修复错误的解释或含糊的发音。
让课程在没有虚拟形象的情况下也有用
撰写解释,使其在与幻灯片或屏幕截图搭配时仍然易懂。使用讲师来提供背景、过渡和简短解释。使用屏幕录制来展示软件操作,使用带标签的图表来展示流程,使用解题示例来展示计算。然后在课程编辑器中将这些元素编辑在一起。
准备一个样本包,包含肖像、一段完整旁白、指导提示以及你预期使用的支持幻灯片或屏幕截图。这样你就能对制作链进行实际测试,而不是孤立的面部动画。
如何制作 OmniHuman 2.0 课程讲师视频
第一次生成的目标是做出决定:这个讲师加音频的组合是否有助于这节课?保持测试范围狭窄,以便容易诊断薄弱结果。
从一个简短的课程片段开始
选择一个完整的思路,介绍一个概念,给出一个示例,并落到明确的下一步。不要为了达到目标时长而将句子切成两半。下面提供的示例时长 30 秒,足以展示可见动作和变化的镜头视角。上传前,在实时模型界面中检查实际支持的音频时长和当前输入规则。
上传图像和旁白,然后指导表演
打开 Avatar Omni Human 2.0 演练场以查看当前输入。自行准备图像和旁白;模型列表描述的是图像加音频到视频,而不是文本到语音的工作流。如果你还没有录制语音,请在此步骤之前在你偏好的音频工作流中创建并审查它。
在此工作流中,提供的音频决定所说的话和节奏。文本提示指导可见动作、表情和镜头运动。在将任何计划中的动作描述为成功输出之前,先审查你自己生成的结果。Atlas Cloud 列出 720p 输出和长达五分钟的片段,但实时控件和完成的任务才是你自己运行的最终检查。
在制作完整课程前审查片段
带声音看一遍结果,然后对照课程文本再看一遍。记录嘴部动作、停顿或手势让人分心的确切时刻。如果问题出现在特定短语,缩短或重新录制该句子,并只生成修订后的片段。如果面部保持可信但解释需要图表,保留讲师镜头并在编辑中添加这些视觉素材。
只有在片段通过审查后,才应在下一个课程部分重用已批准的肖像、录音风格和提示结构。一致性来自可重复的输入流程;这并不意味着每个生成的片段都会完全相同。
实操示例:30 秒颜色对比课程
这节课有一个视觉任务:让学习者看到当较柔和的黄色进入排列时,明亮的珊瑚色和青绿色搭配如何变化。提供的讲师图像、从完成视频中选择的两帧以及完整片段,让你可以检查实际教学动作,而不是从提示中推断。该示例说明了场景设计和编辑审查;在对其输出下结论之前,请用你自己批准的图像和音频测试上述工作流。
从支持教学的构图开始
输入图像有清晰的面部和可见的手,工作台上有三张哑光卡片。在任何运动开始之前,珊瑚色、青绿色和黄色都已出现。工作室的青绿色拱门、珊瑚色面板和琥珀色玻璃营造出多彩的环境,同时让卡片容易区分。
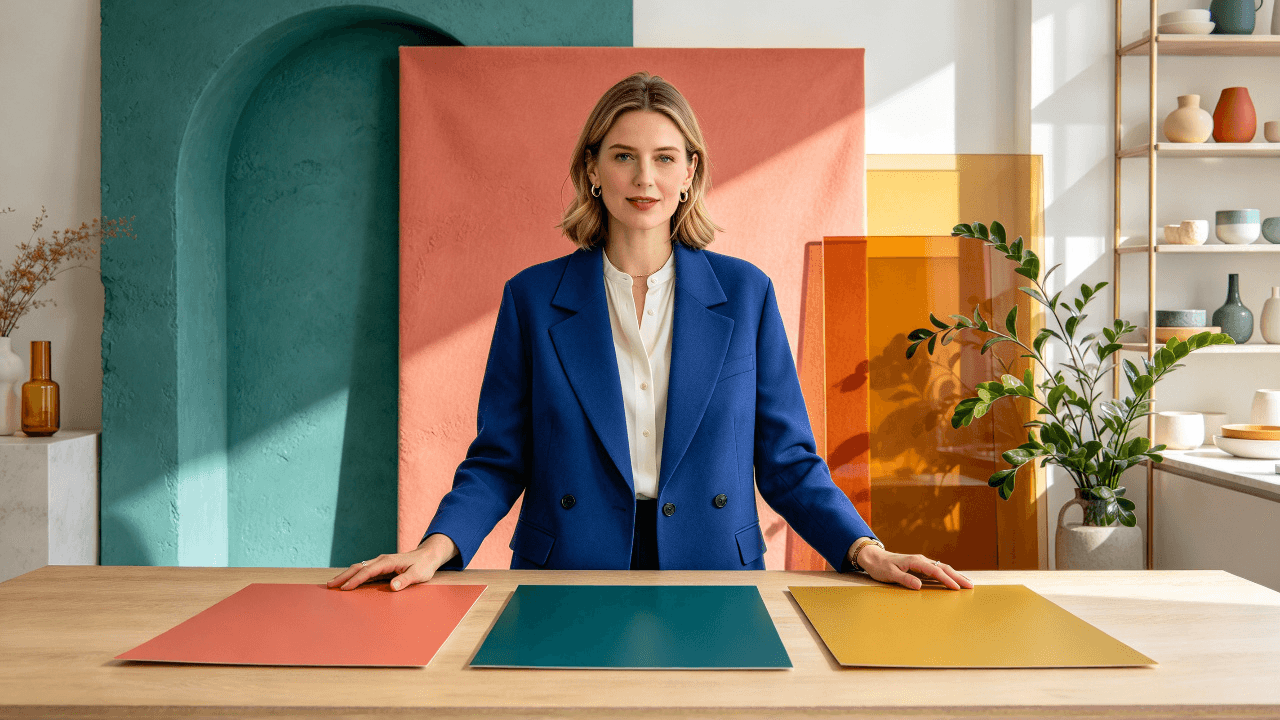
提供的参考图像在动画前让讲师的面部、手和三个教学道具清晰可见。
第一个对比清晰可读
在片段早期,讲师将注意力转向工作台,并将手放在珊瑚色和青绿色边界附近。镜头比参考静态图更近,但她的面部和三种原始颜色仍然可见。这一帧展示了学习者需要跟随的动作:在改变排列之前比较两种相邻颜色。
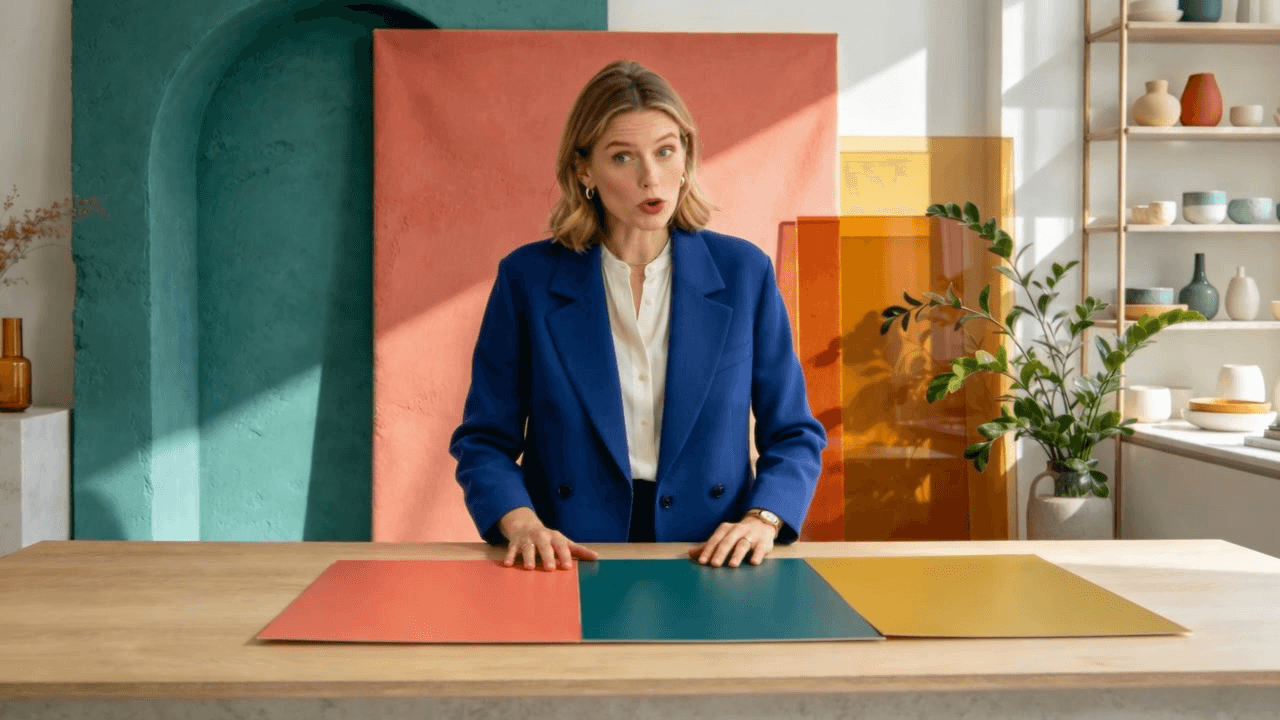
来自提供视频的真实帧:讲师将注意力引向珊瑚色和青绿色边缘,同时三张卡片仍然可见。
变化的视角揭示连续性问题
后来,视角切换到桌子的另一侧,讲师朝黄色做手势。青绿色卡片不再可见。这与计划的三卡片排列不同,其中黄色应位于珊瑚色和青绿色之间。更近的镜头和表情给场景带来了变化,但缺失的卡片改变了教学示例。如果这是最终课程,道具变化需要重新拍摄或编辑,使预期对比准确。
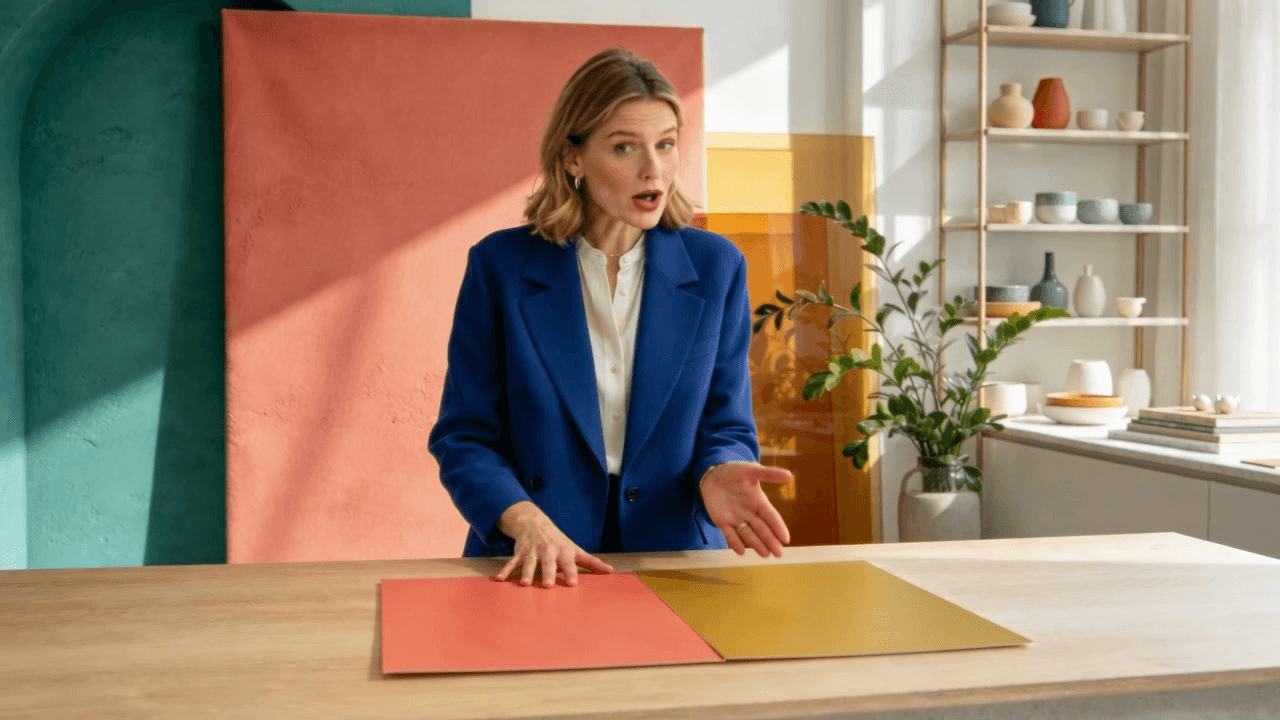
同一片段中稍后的一帧:镜头角度和手势变化,而青绿色卡片已从排列中消失。
带声音观看完整场景
提供的视频时长略超 30 秒,包含音轨。将其作为一个连续示例观看,以便将手势、表情、镜头运动和声音放在一起判断。上面两张静态图是不同时刻的证据,而不是单独的生成案例。
该场景成功让讲师除了面对镜头之外还有更多事情可做:她处理道具、改变目光,并从多个视角展示。消失的青绿色卡片是重要的审查发现。只有当视觉示例与学习者应理解的内容一致时,才保留最终课程,并在发布前对照音频核实口头解释。
如何检查 AI 讲师视频是否准备好
使用一轮审查,同时检查生成的表演和学习者将看到的课程:
- 嘴部时机: 嘴部动作是否大致跟随关键音节和停顿?重放困难的名字和短停顿。
- 表情: 面部是否适合平静的解释,还是会变成无关的微笑或夸张的情绪?
- 手势: 手是否避开面部,避免分散对重要幻灯片的注意力?
- 身份和场景: 面部特征、服装和背景在片段中是否保持稳定?
- 音频准确性: 提供的录音中术语、名称和数字的发音是否正确?
- 教学清晰度: 编辑是否在正确时刻包含所需的幻灯片、屏幕截图、字幕或解题示例?
- 权利和披露: 你是否获得图像和声音的许可,并且是否针对目标受众和市场检查了披露规则和机构政策?
决定是保留片段、修改源音频或图像,还是改用幻灯片加旁白。不要仅仅因为生成耗时较长就保留讲师镜头。清晰的屏幕录制可能更好地教授过程步骤。
课程视频的成本和扩展
截至 2026 年 10 月,Atlas Cloud 模型页面列出标准价格为每秒 $0.07,并显示每秒 $0.056 的折扣价,相当于 20% 折扣。根据这些列出价格的简单估算如下:
| 生成时长 | 按 $0.07/秒 | 按显示的 $0.056/秒 |
|---|---|---|
| 20 秒 | $1.40 | $1.12 |
| 60 秒 | $4.20 | $3.36 |
| 5 分钟 | $21.00 | $16.80 |
这些是模型费率的计算,不是针对你账户的报价,也不保证最终收费。显示的折扣可能会变化,税费、账户级条款或其他费用可能会影响结账。在生产前重新检查模型详情和实际确认屏幕。
短样本限制了检查新肖像、语音或提示的成本。对于较长材料,在真正的教学边界(如新概念或解题示例)处划分课程。不要为了匹配生成限制而拆分句子或删除需要的解释。按列出的标准费率,五分钟输出在适用折扣前为 $21;将其与较短片段加编辑时间进行比较,并决定哪种格式更适合课程。
隐私、同意和课程信任
在生成之前,确认你可以在预期课程、分发渠道和时长中,将讲师的肖像和声音用于合成视频。如果出现承包商、员工、客座讲师或学生,记录许可和任何限制。检查你的机构对 AI 生成或修改媒体的要求以及目标市场的适用规则;本文不决定法律义务。
像讲师一样审查完成的课程。纠正脚本和录音,在观众或政策期望的地方披露合成演示,并让人类对课程的主张负责。精致的讲师可能让薄弱或未经检查的材料看起来权威,因此课程所有者应批准文字和最终编辑。
对于首次制作,制作一个短片段,根据清单审查,并使用当前每秒费率估算下一批。这个小决定告诉你 OmniHuman 2.0 AI 课程讲师视频 是否属于你的课程工作流。
常见问题
OmniHuman 2.0 可以仅从文本创建课程视频吗?
Atlas Cloud 列表描述的是图像加音频到视频的工作流,并带有可选文本指导。它没有将纯文本列为旁白音频的替代品,因此请单独准备语音轨道。
我可以在多个课程中重复使用同一讲师图像吗?
你可以为不同的生成准备同一张已批准的图像。重复使用它有助于保持一致的视觉参考,但并不保证每个输出中的表情、构图或手势完全相同。在拼接之前审查每个片段。
OmniHuman 2.0 会生成课程语音吗?
列出的工作流将音轨作为输入。单独录制或制作语音,检查后上传完成的旁白。
在 Atlas Cloud 上,20 秒的 OmniHuman 2.0 课程片段费用是多少?
按列出的标准费率每秒 $0.07 计算,20 秒为 $1.40。按显示的 $0.056 费率计算,为 $1.12。在运行生成之前确认当前定价和最终收费。


