让AI生成摘要
房地产看房视频里,一半镜头都斜插着一台施工起重机。婚礼视频中,一名餐饮服务人员从圣坛后方穿过,正好在誓言环节中间。
这些都不是叠在画面上的文字。它们就站在场景里。所以当你从视频中移除对象时,AI 模型并不是剥掉一个平面图层。它是在重建一段自己实际上从未见过的场景;一旦重建出错,人物原先所在的位置就会留下一团涂抹痕,或者一块与周围对不上的补丁。
我们测试了路人穿过固定镜头、运动相机边缘的对象,以及主体位于杂乱背景前的场景,看看哪些接缝会露出来,哪些不会。
要点
- 从视频中移除对象或人物,意味着要在每一帧里重建其后方的画面,而移动主体后方的空间一直在变化。
- 画一次遮罩并让跟踪器跟随,在主体被短暂遮挡或离开画面之前都有效。大多数工具就是在这里留下拖尾涂抹。
- Atlas Cloud 的 Video Edit 标签页 可从上传的片段和文字描述开始,无需遮罩或画笔:准确说出要移除什么,然后运行任务。
- 同一个 Video Edit 工具还能替换成全新背景,不只是抹掉前景中站着的东西。
- 只能从你拥有或获准编辑的素材中移除人物。
为什么从视频中移除对象或人物意味着要重建每一帧
一个用来从照片中抹掉东西的工具,只需要把一帧处理好。修补对象后面的像素,搞定。
把同样的逻辑用于视频,它就必须每秒做出几十次这样的判断,而且得出的结果还要与前一帧和后一帧一致。
一旦主体移动,这就会变得更难。一个人穿过房间时,会先经过一面墙,然后是一个门口,再然后是一个书架。无论用什么填补他们身后的空缺,都必须随之变化来匹配,同时又要足够稳定,让接缝始终不闪烁。
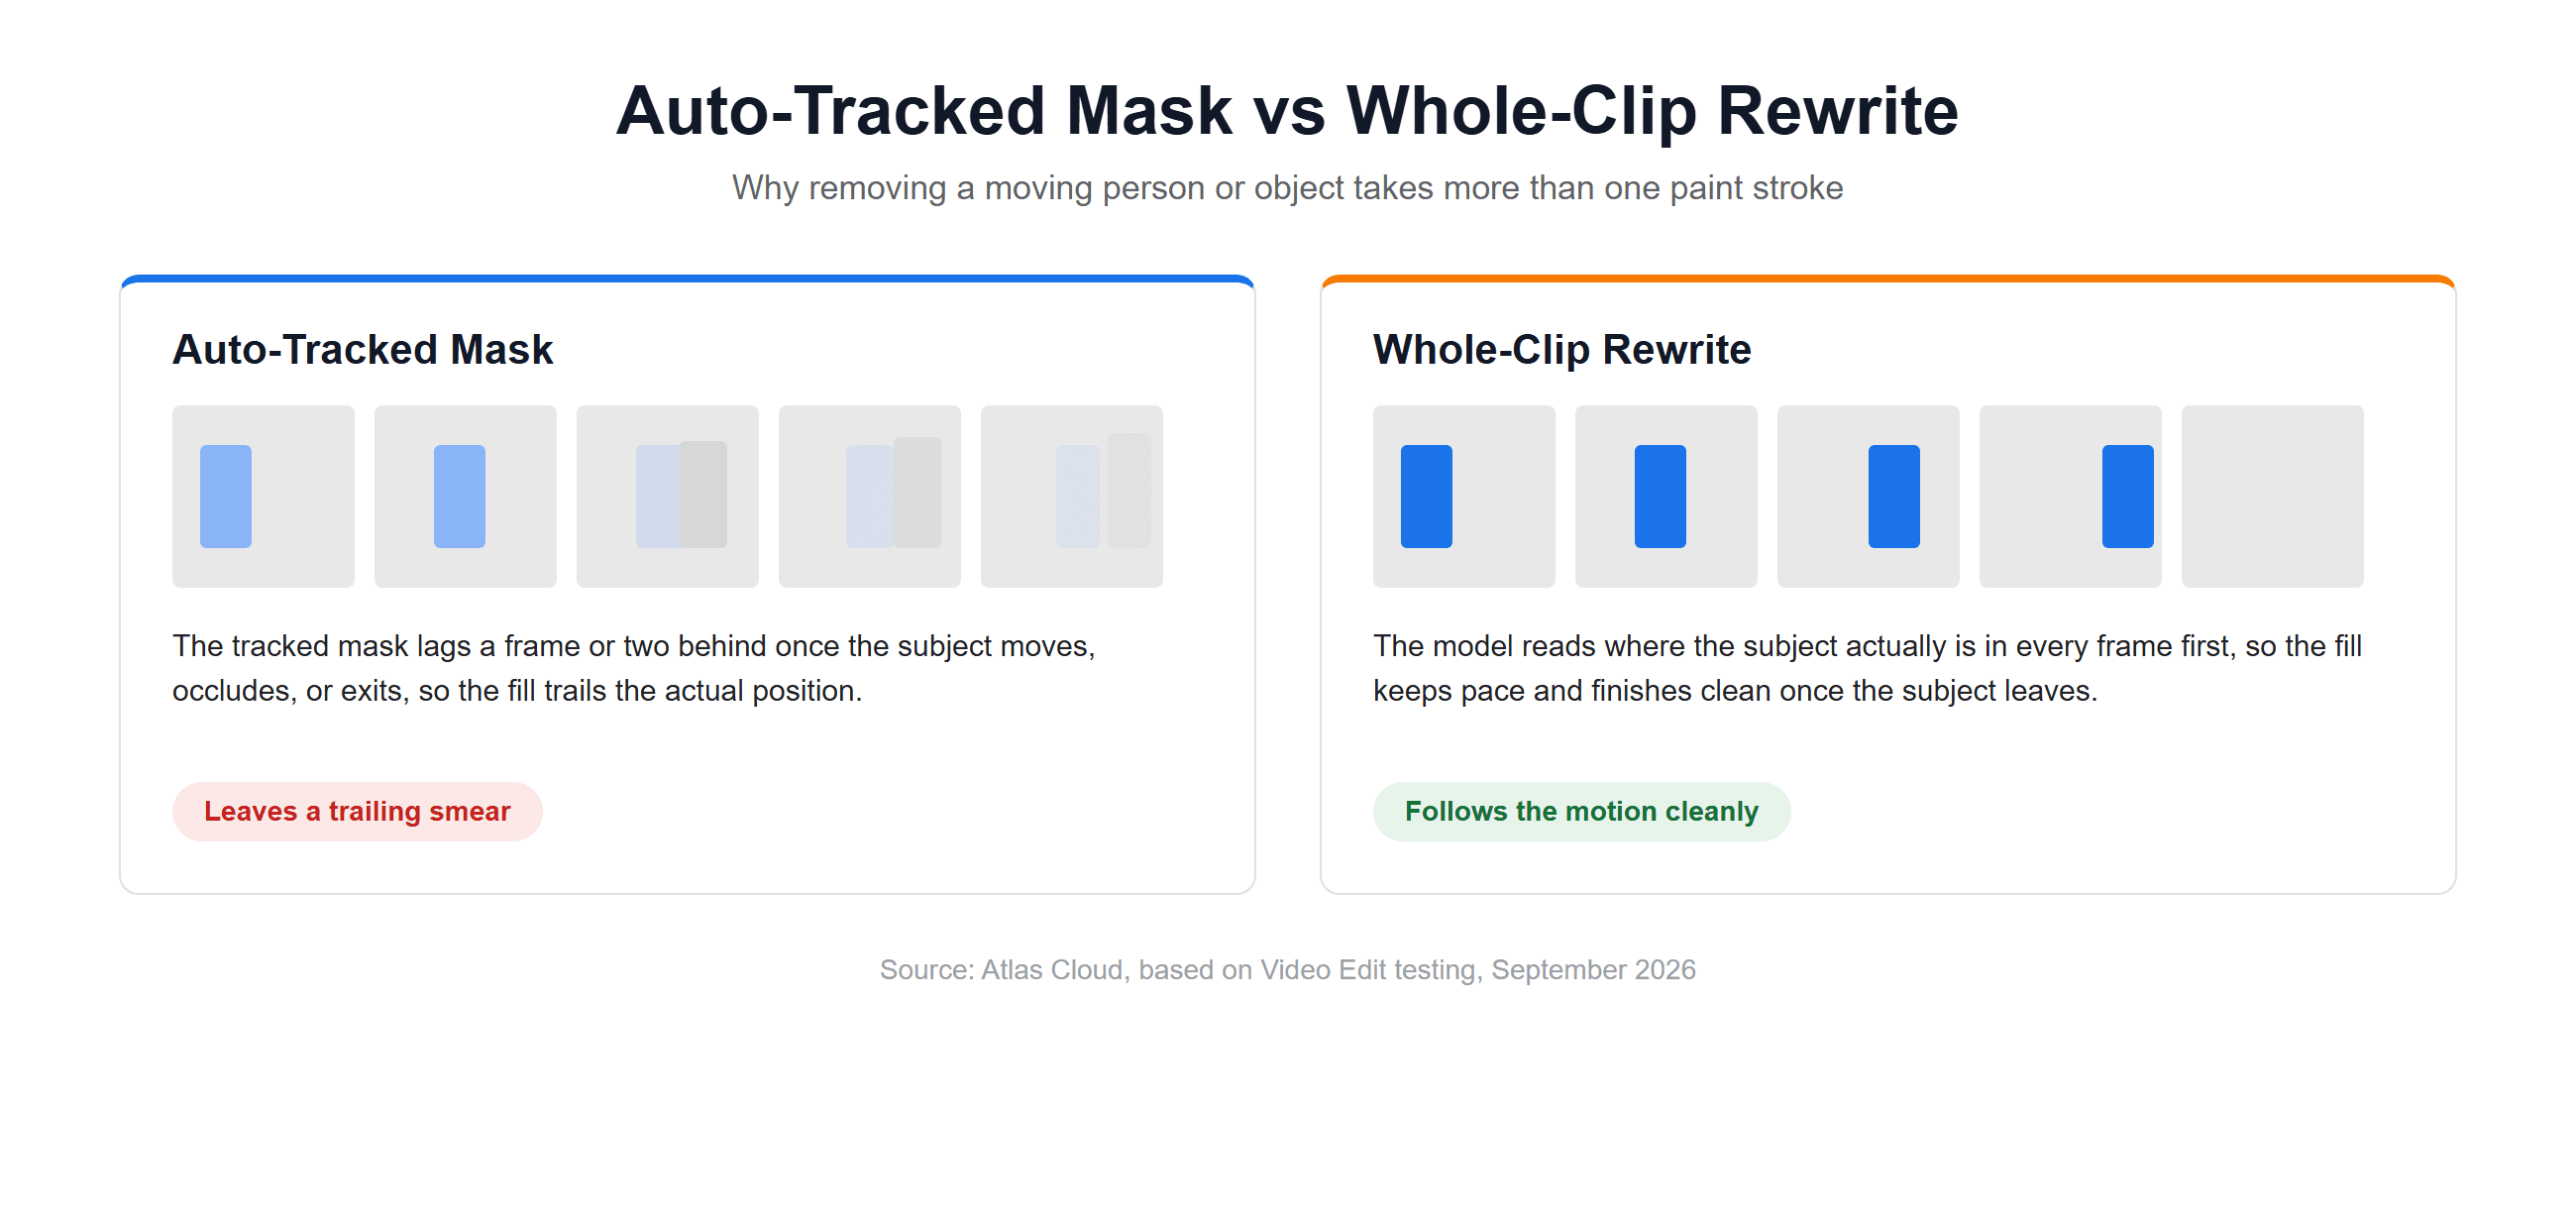
大多数工具的处理方式是:你画一次遮罩,然后由算法在片段余下部分向前跟踪它。当主体几乎不动时,这很好用。
但一旦他们走过镜头,效果就会变得不稳定。跟踪器必须在每一帧里不断重新找到精确轮廓,而几个像素的漂移就足以在他们身后留下一块淡淡的拖尾补丁——这种“幽灵”第一遍看很容易错过,一旦你知道要去找它,就会变得很明显。
一个用来从照片中移除人物的工具永远不会遇到这个问题,因为只需要处理好一帧。把它逐帧导出用于视频,同样的漂移就会出现,再乘以片段拥有的帧数。
视频对象移除工具到底做什么:3 种方法对比
| 方法 | 工作原理 | 需要你做什么 | 会在哪里出问题 |
|---|---|---|---|
| 绘制并跟踪遮罩(After Effects 内容识别填充) | 你为对象绘制遮罩;填充引擎会估算其后方场景的运动,并从邻近帧中提取匹配像素 | 在主体出现的每一帧上都要有遮罩,手动绘制或跟踪 | 遮罩正确时填充质量很扎实,但在长片段中让遮罩始终贴合移动主体,确实要花不少剪辑时间 |
| 一次涂抹自动跟踪(大多数网页工具) | 在主体上涂抹一次;工具自带的跟踪器会把该轮廓延续到片段余下部分 | 一个粗略轮廓;其余交给跟踪器 | 当主体被短暂遮挡、离开画面或快速移动时会跟丢,填充在之后几帧里也会偏离目标 |
| 文本指令重写(Runway、Atlas Cloud) | 描述要移除什么;模型读取整段片段并重绘该区域,不涉及遮罩 | 一段文字描述,无需绘制任何东西 | 完全取决于描述措辞有多精确 |
Adobe 自己的 Content-Aware Fill 文档把第一种路线解释得很清楚:该面板“具备时间感知”,因此会“随时间分析帧,从其他帧合成新像素”,而它的 Object fill 模式就是为“路上的一辆车”这样的移动主体而构建的。问题在于,得由你来绘制并跟踪遮罩,告诉它该看哪里。
第三条路线完全跳过遮罩,也最接近 Atlas Cloud 的 Video Edit 工具的工作方式。
在 Atlas Cloud 上用 AI 从视频中移除对象
在 Atlas Cloud 上,移除对象与任何其他 Video Edit 任务的工作方式相同:上传片段,附带一条文字指令,模型只重写该指令指向的部分。
默认由 Seedance 2.5 处理该任务。它把上传的片段视为参考,而不是起点,因此输出长度与输入相同,可以直接放入时间线,无需重新调整时码。
方法 1:在 Video Edit 标签页中移除对象
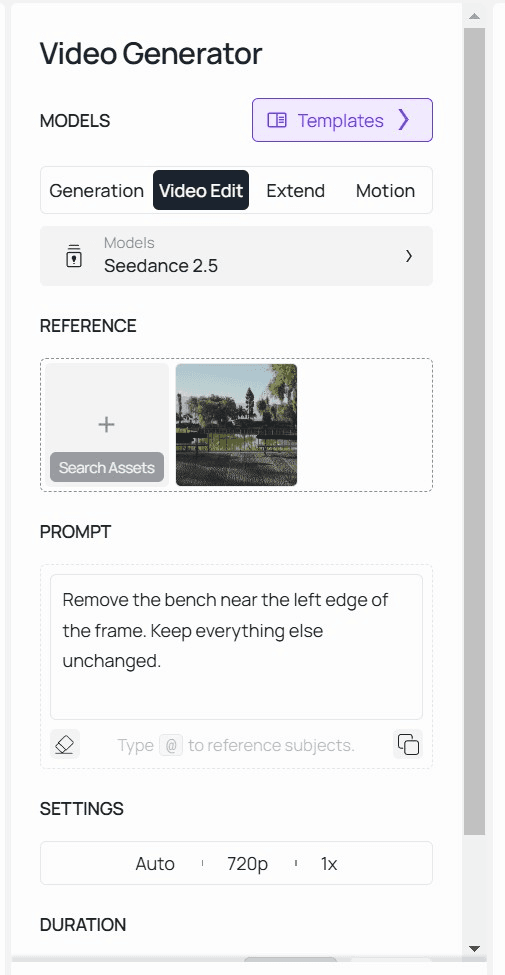
- 前往 AI 视频编辑器,点击 Video Edit 标签页,它位于面板顶部,与 Generation、Extend 和 Motion 归在一起。编辑模式会告诉模型读取你上传的内容,而不是从空提示词开始生成。
- 拖入仍带有该对象或人物的片段。
- 要具体指向主体,而不是整个镜头:“移除从背景中从左到右走过的人。其他一切保持不变。”提示词越精确地隔离目标,模型触碰周围内容的可能性就越小。
- 提交任务,然后以完整尺寸查看输出,而不是看时间线缩略图。慢慢拖动经过主体离开画面的位置,因为薄弱的填充往往最先在那里显露出来。
方法 2:通过 API 从视频中移除对象
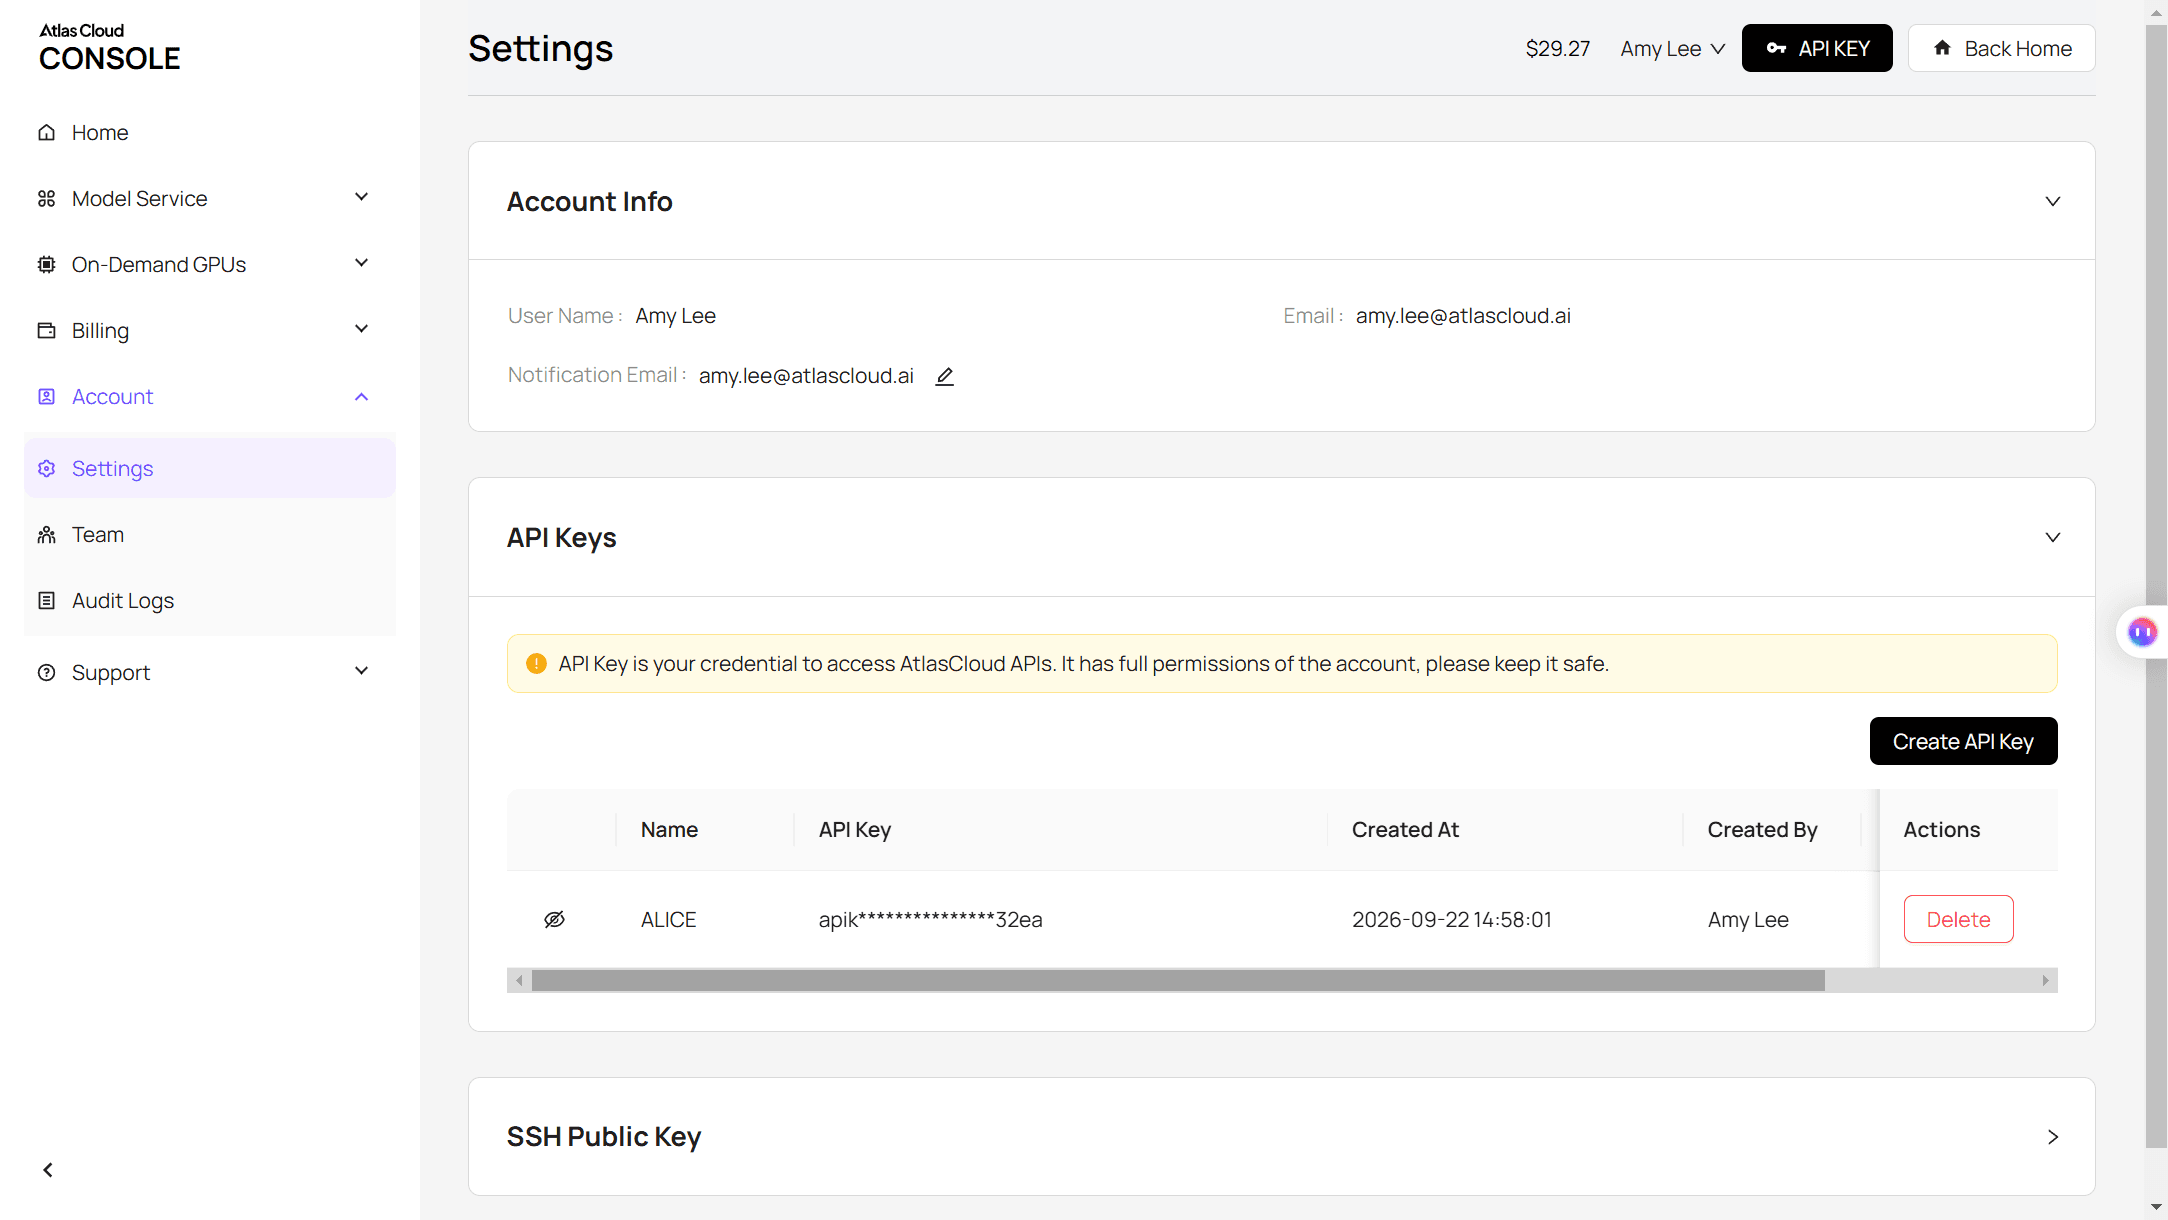
第 1 步:获取 API 密钥。 在 Atlas Cloud 控制台 中创建一个并复制。
第 2 步:查看 API 文档。 参数、接受的格式和时长限制都在 API 文档 中。
第 3 步:发出第一个请求。 提交片段和指令:
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "Remove the person walking through the background, moving from left to right. Keep everything else unchanged.", 7 "reference_videos": ["<your_clip_url>"], 8 "duration": -1, 9 "resolution": "720p" 10 }'
对于这样的编辑提示词,duration 必须保持为 -1。模型会把它理解为匹配源片段长度的指令,而不是生成新长度。
轮询任务,直到它完成:
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
密钥以及提交并轮询的循环并不专属于这一个模型。Atlas Cloud 把托管的每个模型都放在同一个 API 之后,所以以后要把这个集成指向另一个模型,只需更改 model 字符串,代码中其他内容都不用动。
我们在 3 个困难场景中测试了如何从视频中移除人物
单个物体一动不动地立在纯色墙前,是每个演示都会展示的情况。我们选了三个并非如此的场景。
一个人穿过固定镜头。 有人从锁定画面的背景中穿过,经过栅栏、小路,或任何实际存在的东西。
摇摄镜头边缘附近的对象。 这次相机本身在移动,这意味着对象后方的背景也在滑动,而不是静止不动等着被填充。
主体位于杂乱、有纹理的背景前。 主体后方是茂密枝叶或带图案的表面,这类细节对任何模型来说都最难有把握地重建。
在这三个场景中,仅仅检查“字没了”还不够。要在相机或主体移动时观察填充的边缘,确认画面中没有其他东西发生位移,并检查音频是否原样通过。
从视频中移除东西时该输入什么
Atlas Cloud 的视频编辑器里没有画笔或遮罩,只有一个文本框,所以提示词几乎承担了全部工作。
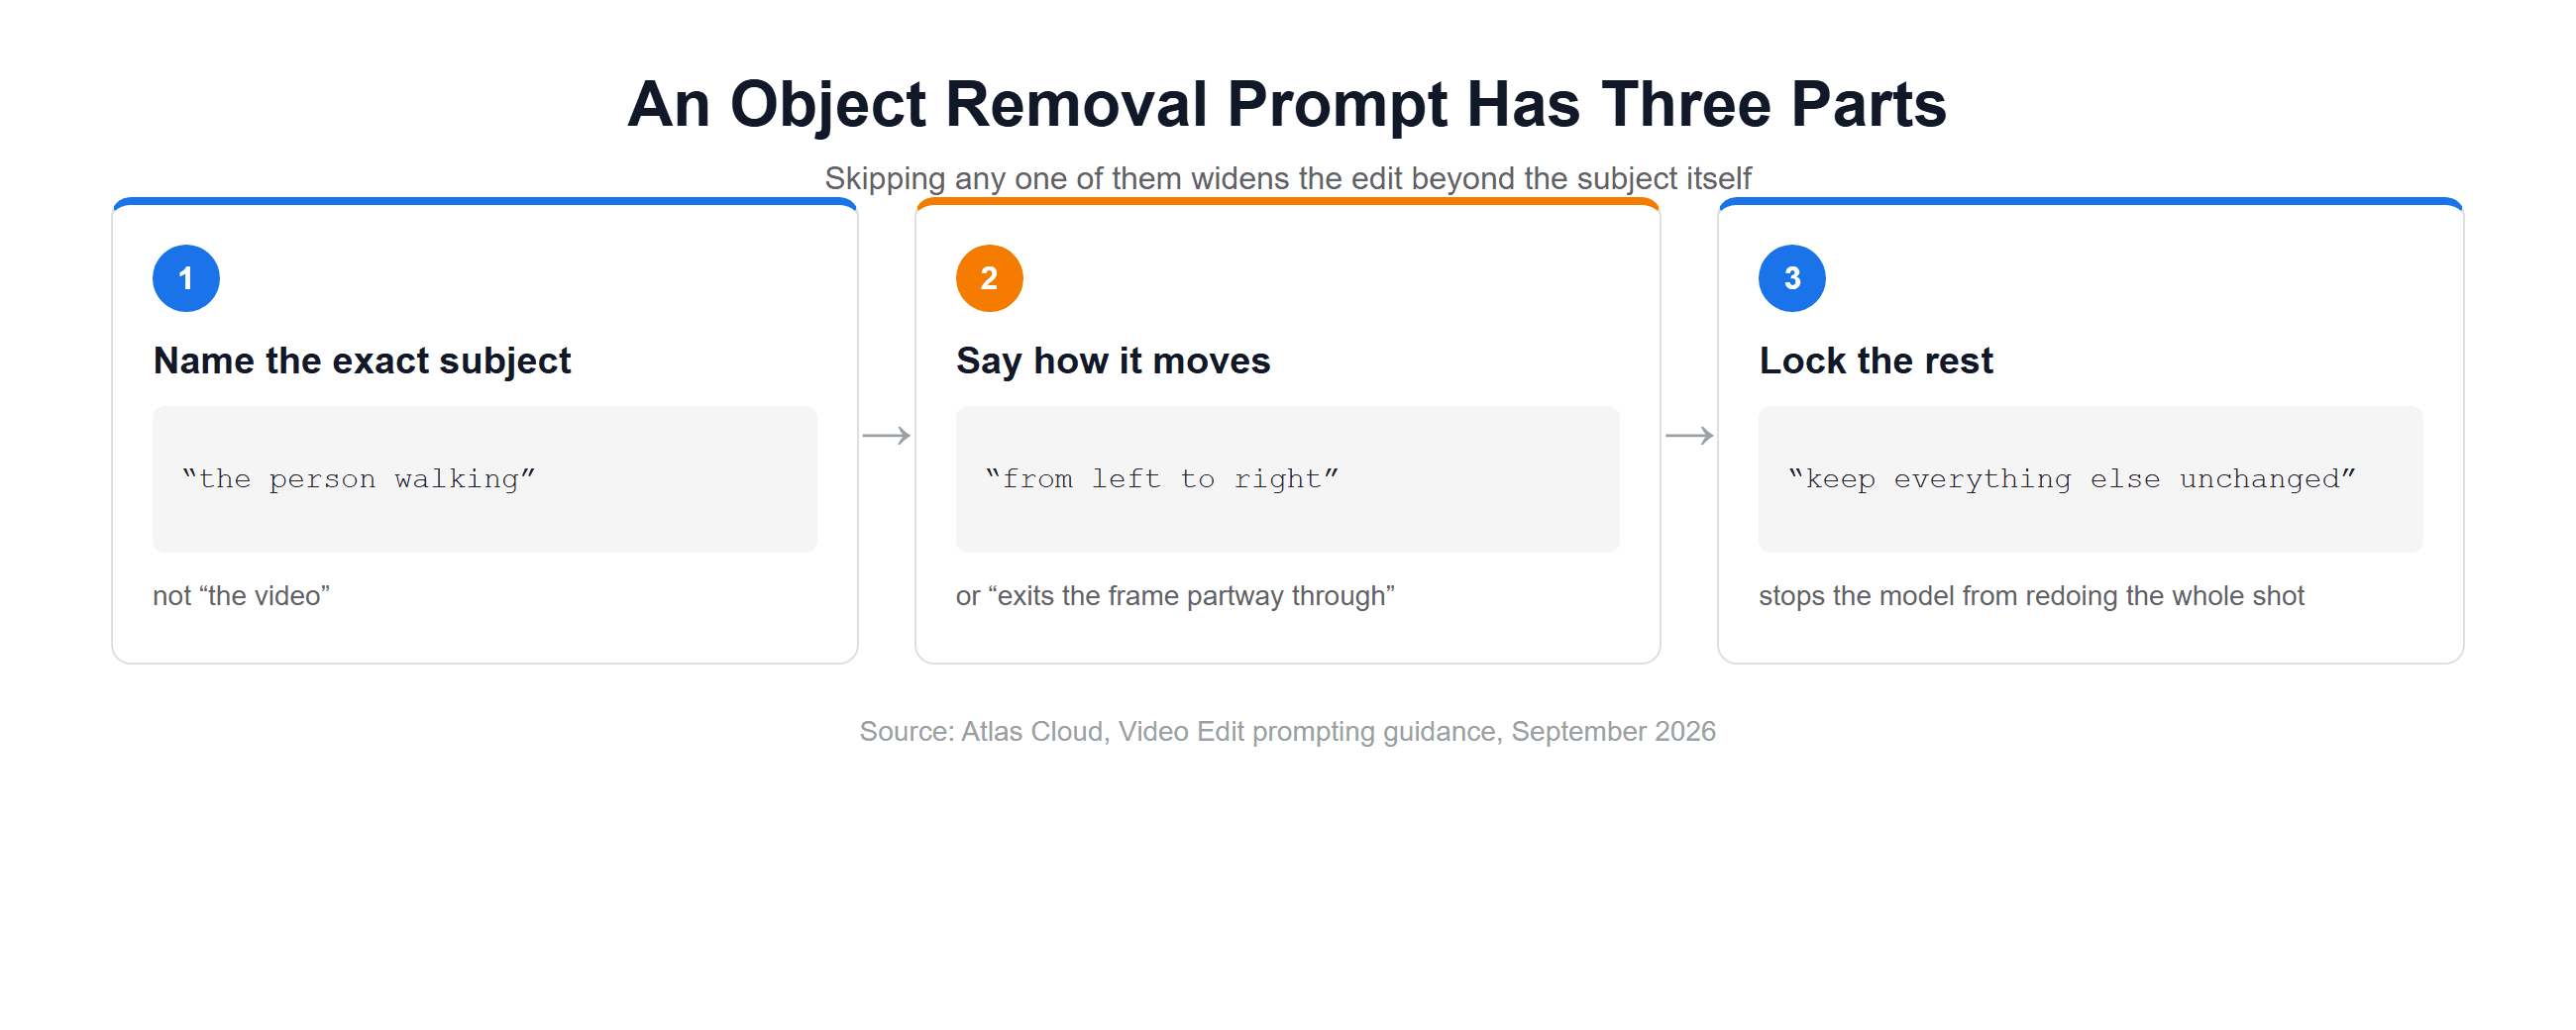
要准确说出要移除的东西,而不是整个场景:说“走路的那个人”,而不是“视频”。如果它在移动,就说明怎么移动:“从左到右”,或者“中途离开画面”。静态对象只需要位置:“右下角的锥桶。”
然后用一条指令收尾,要求其他一切保持不变。省略这部分,模型就可能重新诠释比你预期更多的镜头内容。
单独一句“移除人物”往往会产生技术上正确、但过于激进的编辑,有时背景被重新打乱得超出必要。 “移除从背景中从左到右走过的人,镜头中其他一切保持原样” 则给模型一个它真正能照做的边界。
同一个工具还能替换视频背景
一旦你已经在描述要移除什么,再描述要在其后放上什么,就只差一小步。Video Edit 标签页用同样仅靠提示词的设置来处理背景替换:不用遮罩,只要一段文字指令。
“把背景替换成海上的日落,前景中的人保持不变”会和对象移除提示词走同一个标签页,并得到同样的结果:一整段片段,而非单帧,生成长度与源片段匹配。
常见问题
我可以免费在线从视频中移除对象吗?
可以,适用于短片或单个片段。Atlas Cloud 的 Video Edit 标签页基于浏览器,无需安装软件,而且计费按输出秒数而非固定订阅,因此一个短片段的费用只是完整编辑的一小部分。
在进行更大批量之前,请在 模型页面 查看当前费率,因为促销价格会变化。
移除对象会留下模糊或残影吗?
只会在被重绘的区域出现,而且只有当主体后方的内容难以重建时才会出现。纯色墙面或失焦背景可以干净地填补。
茂密枝叶、杂乱图案或快速移动的相机会让任何模型都更难保持稳定,这正是我们上面单独测试那些情况、而不是只测试简单情况的原因。无论哪种情况,画面其余部分都会保持原始分辨率——这和通常锐化模糊片段时一样,是需要留意的区别。
AI 能移除正在移动的人物或对象,而不只是静止不动的东西吗?
可以,前提是模型读取整段片段,而不是一次一帧。描述运动,而不是某一个瞬间:说“从左到右走路的那个人”,而不只是“那个人”,这样指令才能应用于他们实际出现在画面中的那些帧。
我可以一次从视频中移除多个对象或人物吗?
可以,在一个提示词里就能完成:逐个描述,可以放在同一句里,也可以分开列出,并告诉模型哪些不要动。一个片段里有多件不相关的东西要移除时,最好对每一项都具体说明,而不是用一句含糊的指令覆盖全部。
从别人的视频中移除人物可以吗?
许可才是决定因素:你自己的素材,或者你已获准编辑的素材。TikTok 社区准则 直接指出:“你只应发布你创作或有权分享的内容”,而这一标准不会因为片段托管在哪个平台、或用了哪个工具编辑而改变。在这里,这比文字叠加更重要,因为消失的是一个当时确实在场的人。
结论
从视频中移除对象或人物,归根结底取决于填充能否跟上运动。画一次并向前跟踪的遮罩,在主体移动得足够快或足够远、从遮罩下溜走之前都还有效。
而一个在重绘任何内容之前先读取整段片段的模型就没有这个问题,因为它在决定用什么填补之前,已经知道主体在每一帧里实际位于何处。先从你自己素材中最简单的情况开始,等结果可信后,再处理移动主体或杂乱背景。无论任务是为客户从视频中移除对象,还是从婚礼片段中抠掉一个人,方法都一样:准确说出要移除什么,描述它如何移动,并在运行前锁定其他一切。




