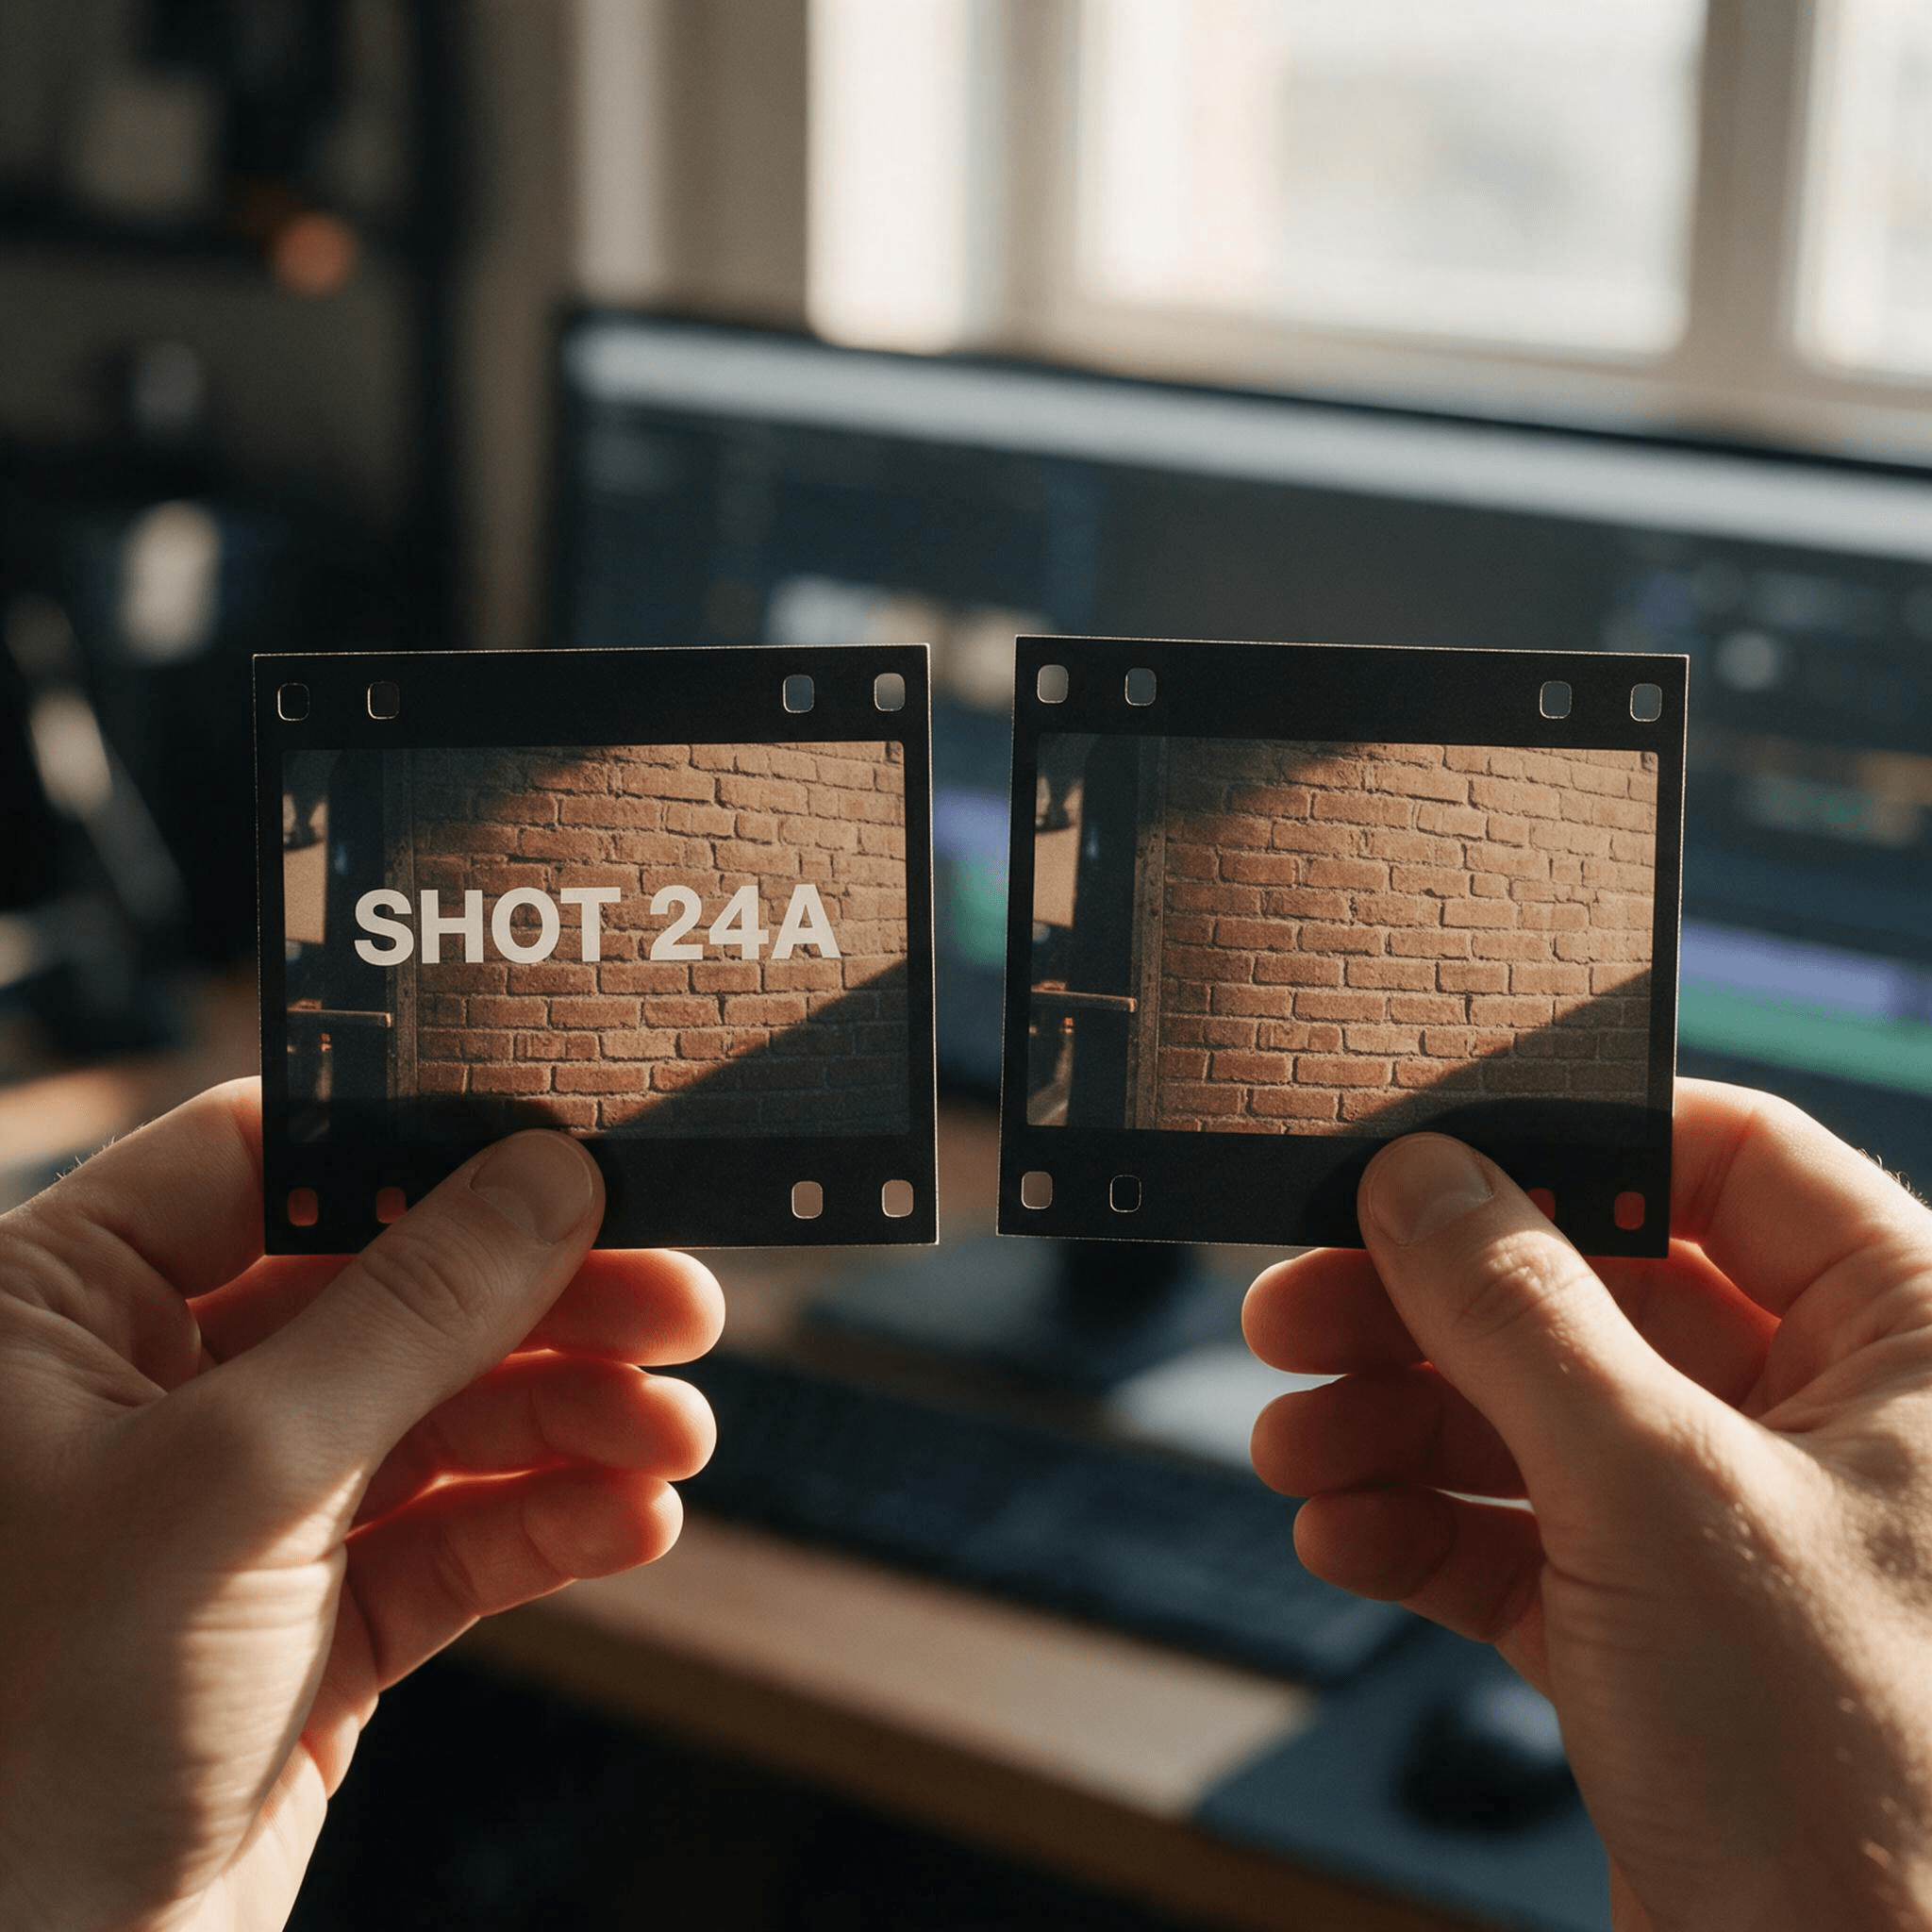
客户 logo 被烧录在画面角落。错误字幕被烙进片段。一段家庭老视频里带着没人想要的电视台日期戳。素材不同,问题相同:这些文字不在一个可以关闭的图层上,它们就是像素,和它们背后的墙壁一模一样。
所以当你从视频中移除文字时,工具并不是在删除任何东西。它是在逐帧猜测字母下方原本是什么,并在镜头移动时尽量让这个猜测保持稳定。搞砸了,你只是用一个碍眼的东西换掉另一个:原本清晰锐利的画面变成了柔和污迹。
我们把同一段视频跑过四种移除方法,然后又让一个 AI 视频编辑器处理三个最容易让大多数工具翻车的案例:会移动的文字、覆盖在人脸上的字幕、竖版 TikTok 视频上的贴纸。
关键要点
- 烧录进片段的文字存在于每一帧中。视频文字移除工具必须在所有帧中重建背景,并在镜头移动时保持结果稳定。
- 裁剪、模糊和贴纸叠加都只是遮住文字。只有生成式重写才能移除它们,并在原处放入可信的内容。
- 打开 Atlas Cloud 的视频编辑器 ,切换到 Video Edit 标签页,上传片段,并准确描述要擦除哪段文字。
- 软字幕,比如 TikTok 自动生成的字幕,可以由观看者关闭。它们根本不需要 AI 擦除器。
- 只从你拥有或有权编辑的素材中移除文字。
为什么从视频中移除文字很难,而不只是处理一帧
从单张照片中擦除文字是一次性问题:修补像素,完成。视频会把这个问题乘以片段中的每一帧,而且所有修补都必须彼此一致。
一次只读取一帧、猜测填充内容、然后移到下一帧的工具,并不记得自己片刻前画了什么。每次修补都可能与上一次差一个色阶。
回放结果时,这种微小不一致会在文字原本所在的位置表现为闪烁,而且在镜头平移或光线变化时会变得更糟。
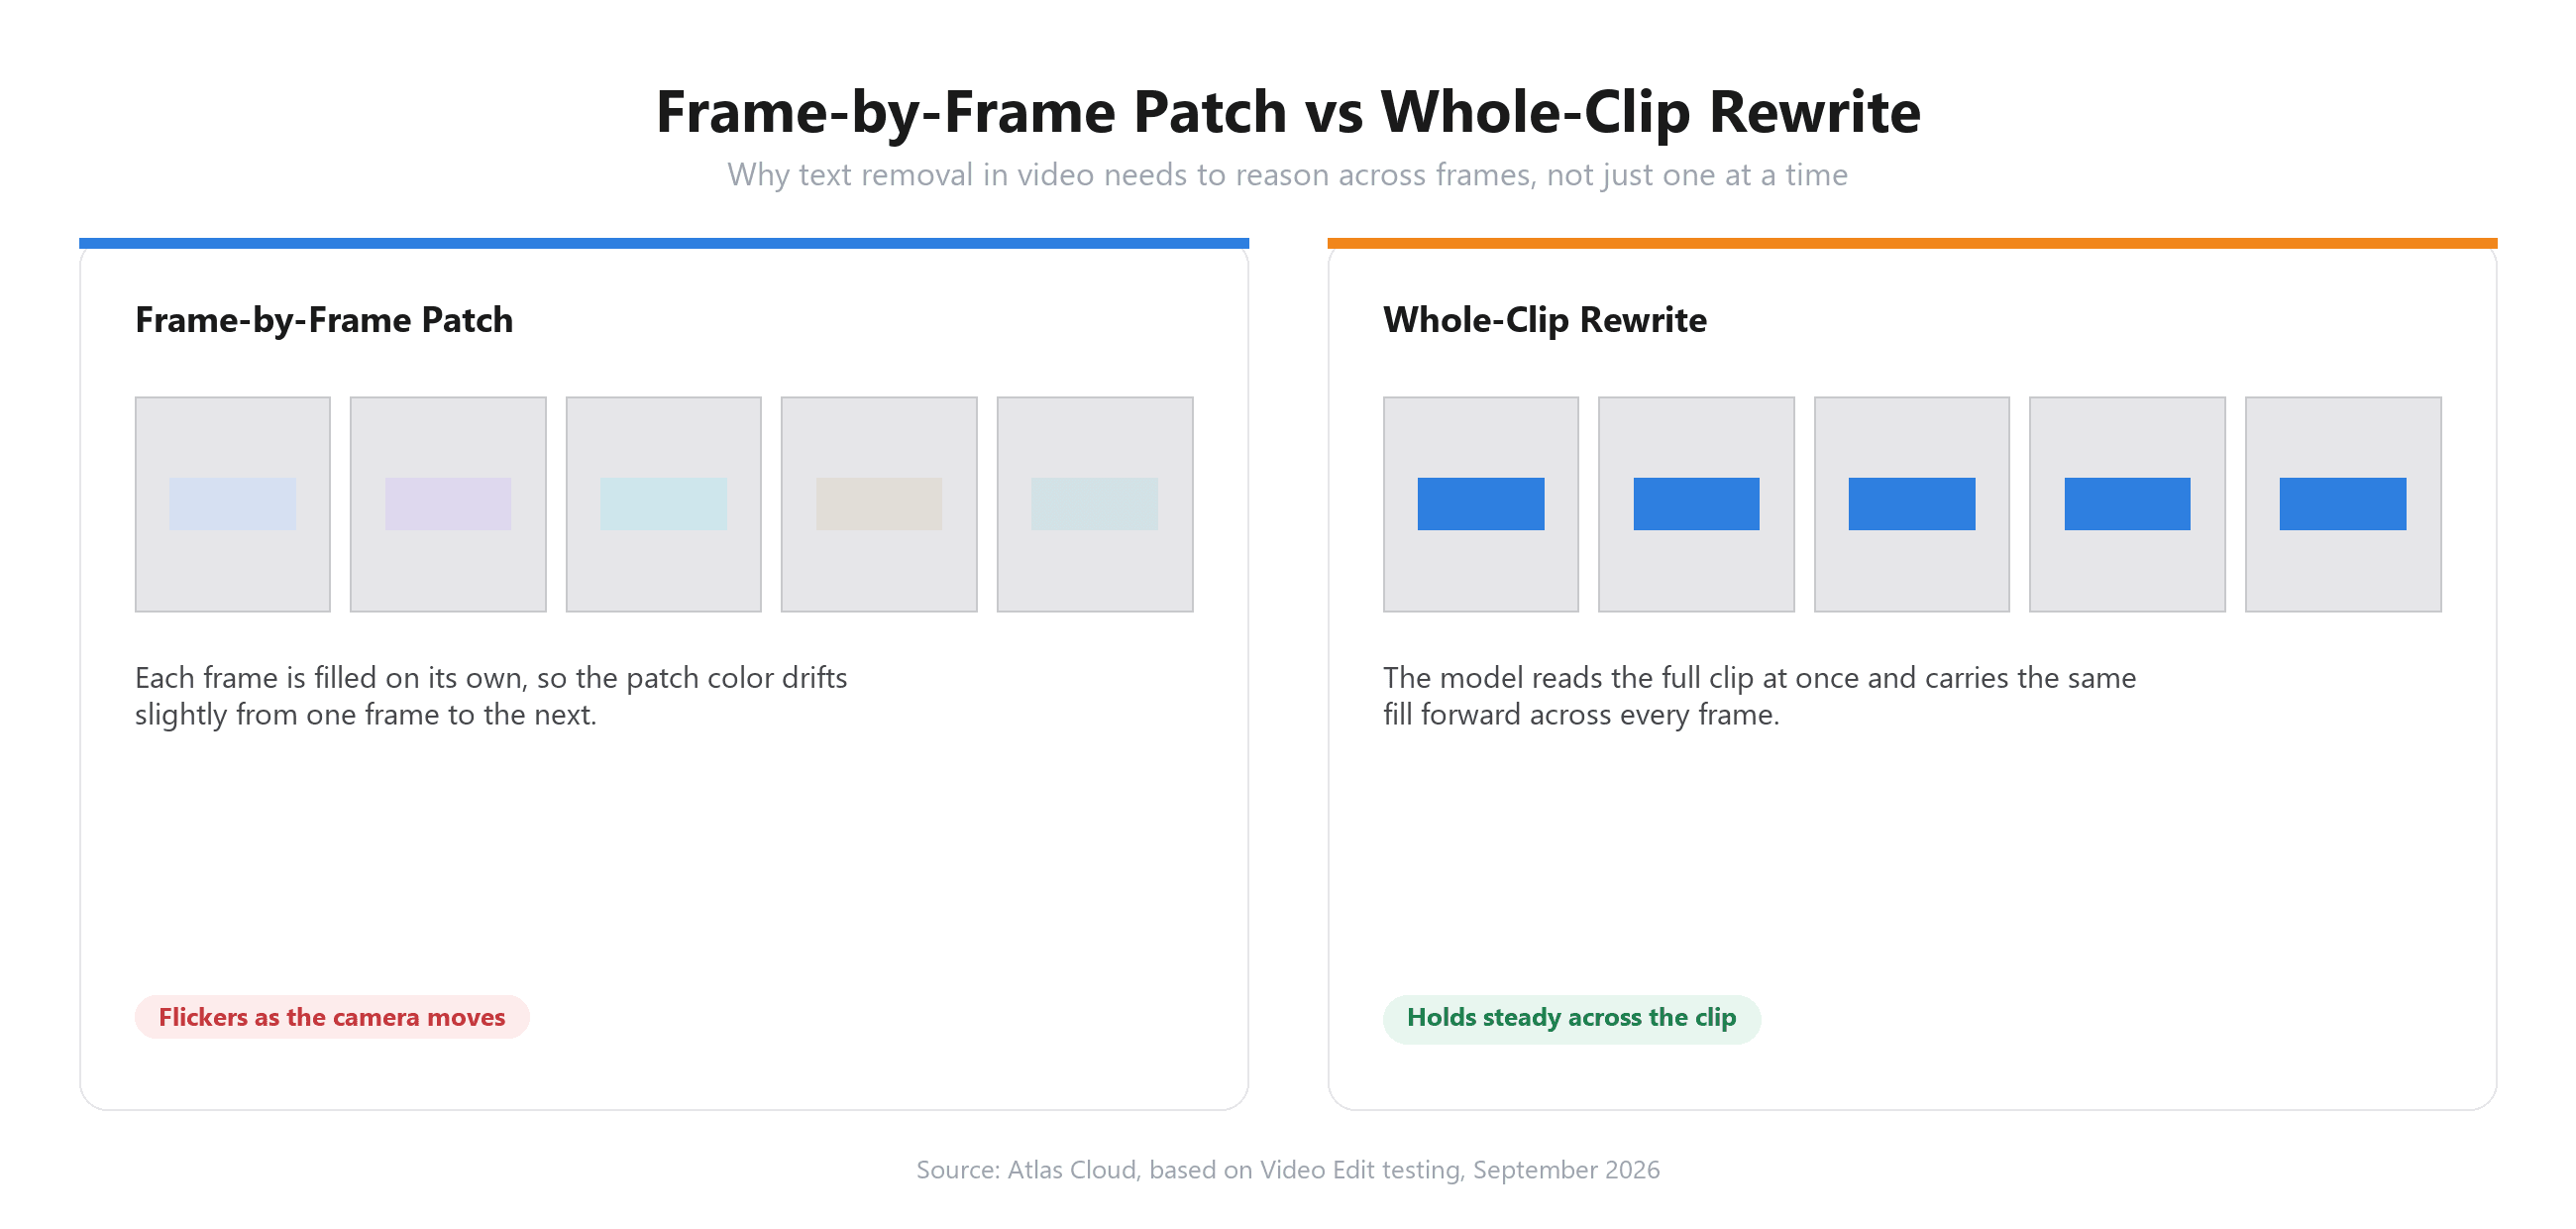
为编辑视频而构建的模型,而不是逐帧运行的照片工具,会一次读取整个片段并将该上下文延续下去。这就是同一面墙的四张静态照片与一段连续拍摄之间的区别。
这也是为什么为照片构建的文字移除工具不能只是指向视频导出文件并指望它能撑得住。
在这一切之前,有一点值得单独说明:如果文字是平台为你生成的字幕,比如 TikTok 自动字幕 或 YouTube 自动字幕,它通常根本没有烧录进画面。观看者可以从分享面板中关掉它,不需要 AI 移除。
烧录文字,也就是编辑器或屏幕录制留下的那种,才是本指南其余部分要讲的内容。
从视频中擦除文字的 4 种方法:哪些会留下模糊?
四处搜索,你会发现人们常用的四种方法。其中只有一种真正移除文字,而不是把它藏起来。
| 方法 | 工作原理 | 会留下什么 | 最适合 |
|---|---|---|---|
| 裁剪 | 裁掉画面中包含文字的部分 | 一个更小、放大的画面;那条区域里的其他内容也一起没了 | 文字正好位于镜头边缘 |
| 模糊或像素化 | 涂抹文字区域使其无法辨认 | 一块明显的柔和区域,看起来像“这里藏了东西” | 以隐藏而非移除为目标的快速修复 |
| 用贴纸或方框遮盖 | 在文字上粘贴形状或图形 | 一个可见叠加层,必须匹配背景色,否则会比原来的文字更突兀 | 可以接受角落有 logo 或水印的短片段 |
| 生成式重写 | AI 模型以周围画面为参考,重新绘制该区域 | 当背景简单时什么也不留;只有在密集、高细节背景上才会留下柔和修补 | 文字覆盖在观看者需要看清的真实场景上 |
前三种都只是把文字藏起来。它们都没有重建字母背后原本的内容,所以经过裁剪、模糊或遮盖的片段一眼看上去仍然像是被编辑过。
生成式重写是唯一一种旨在让文字看起来从未存在过的方法。它也是唯一一种会悄悄失败的方法:如果文字下方的背景太密集,模型无法有把握地重建,这与我们的AI 修复工具指南中讨论的权衡相同。
在 Atlas Cloud 上使用 AI 从视频中移除文字
Atlas Cloud 将文字移除作为视频编辑任务来运行:上传片段,描述要移除什么,模型会重新生成其周围画面,同时保持其余素材不变。
其背后的默认模型是 Seedance 2.5,它会将源视频作为参考读取,并输出与原始长度匹配的片段,因此编辑结果可以直接放回时间线,无需重新调整时长。
方法 1:在 Video Edit 标签页中移除文字
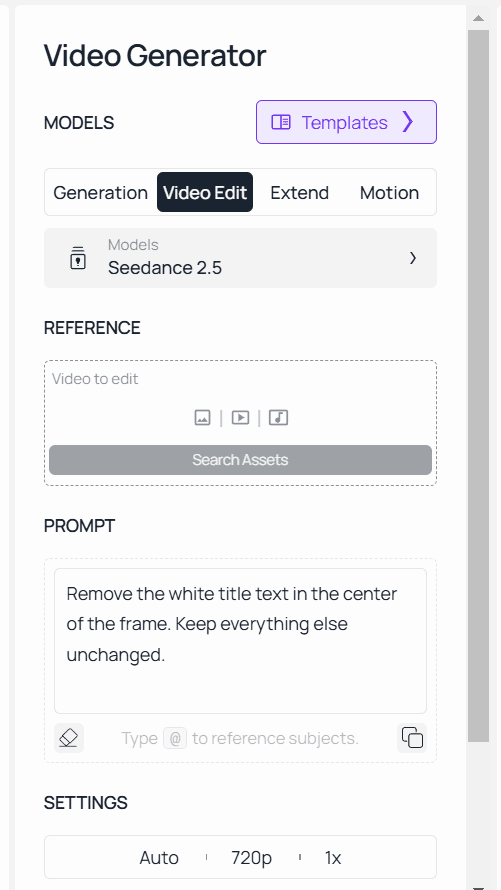
- 打开 AI 视频编辑器,切换到 Video Edit 标签页。它位于 Generation、Extend 和 Motion 旁边,模型在这里读取现有片段,而不是从空白提示词生成。
- 上传带有文字的片段。
- 只描述文字,而不是整个场景:“移除画面底部的字幕。其余内容保持不变。” 准确说明要更改什么,并告诉模型不要动其余部分,可以让编辑保持精准。
- 运行任务,并在导出前以完整分辨率检查结果。在复杂背景上,先放大查看被擦除的区域。
方法 2:通过 API 从视频中移除文字
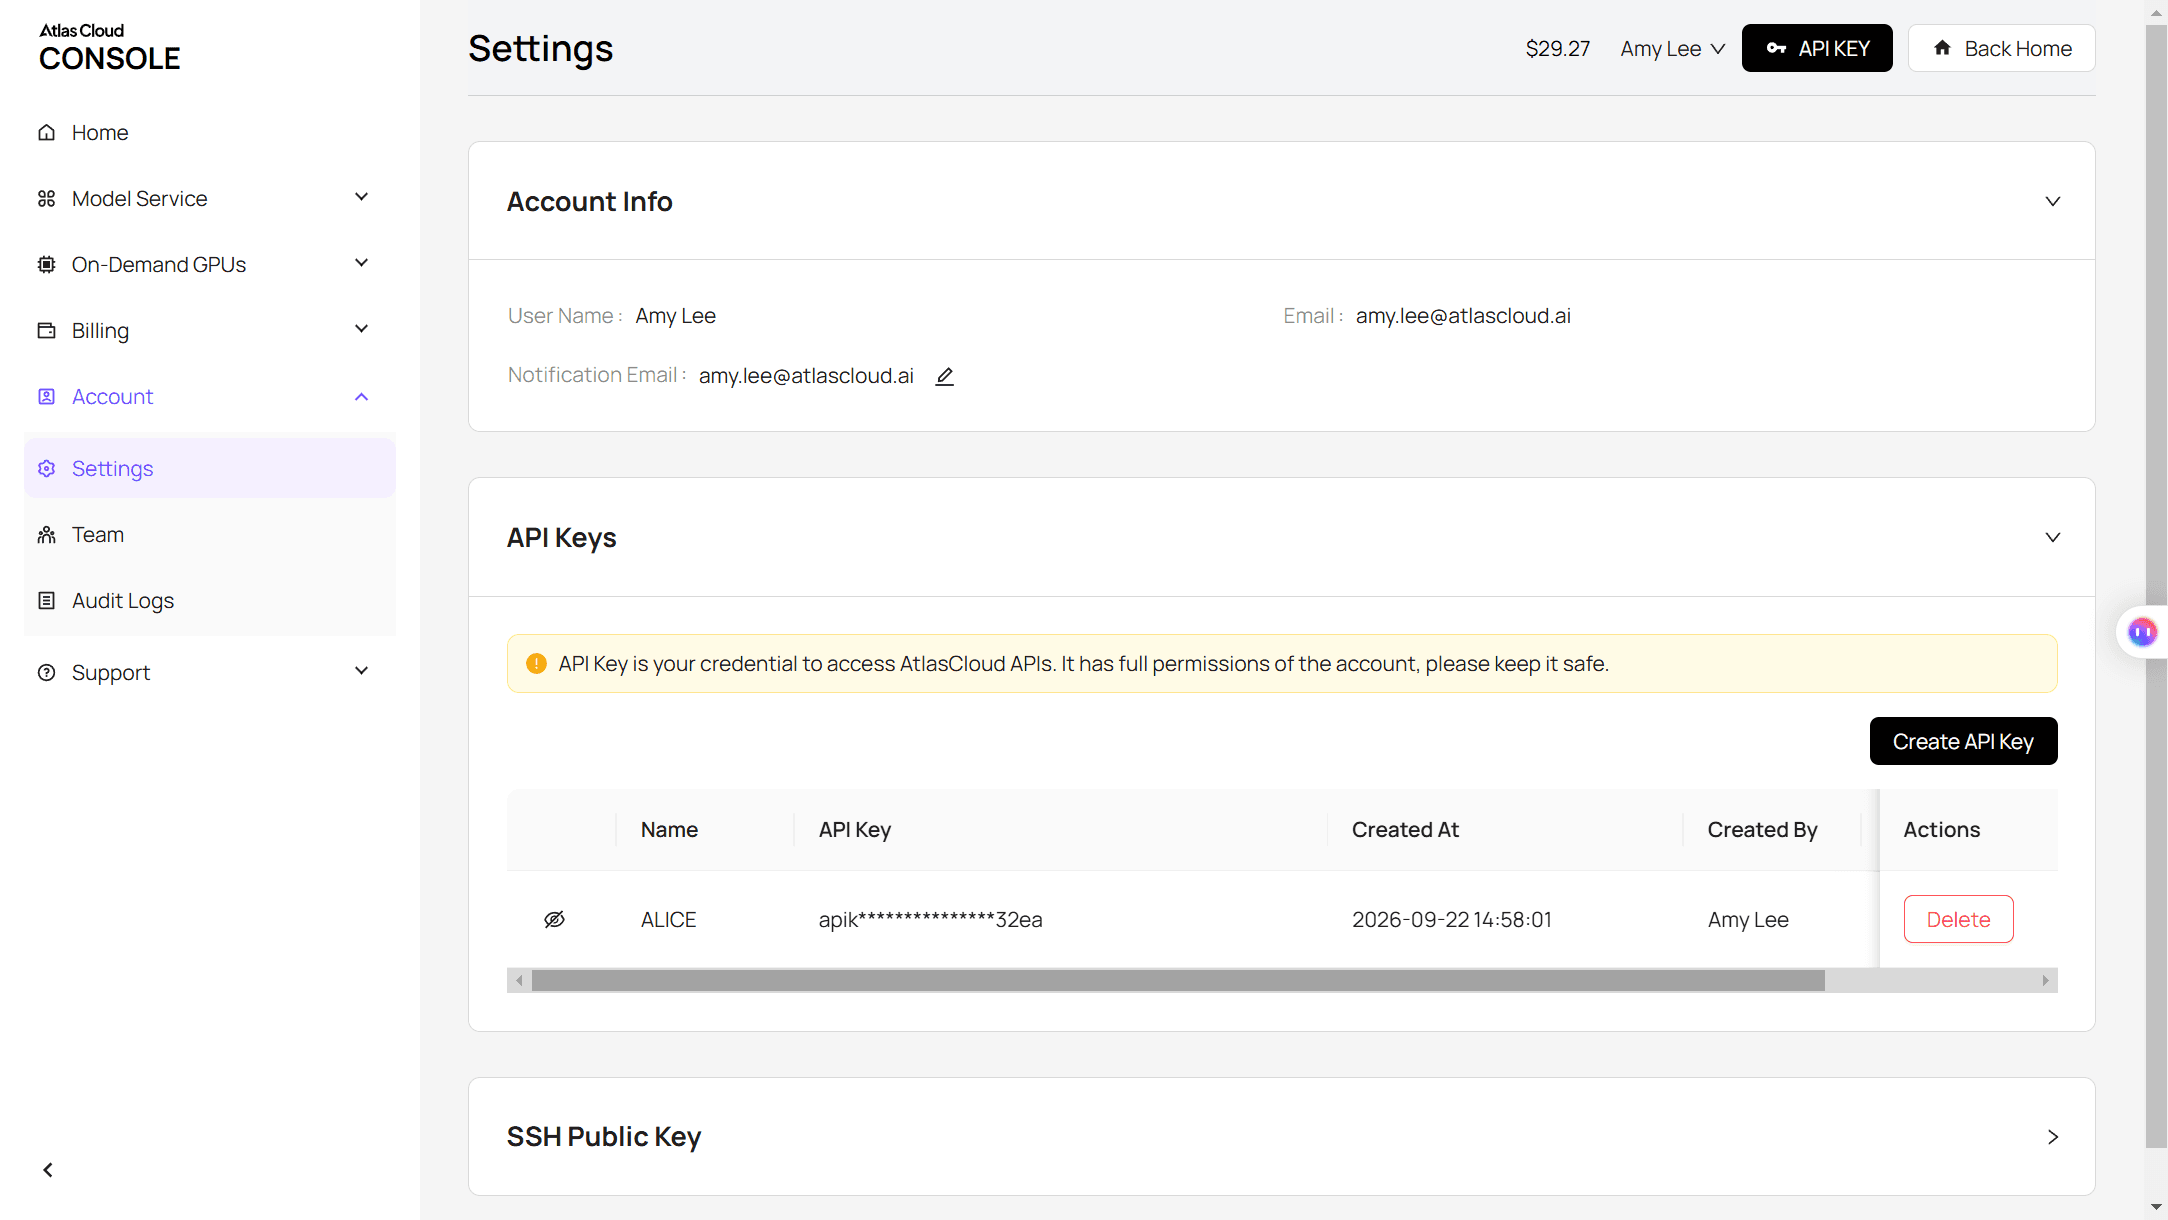
第 1 步:获取 API 密钥。 在 Atlas Cloud 控制台中创建一个并复制它。
第 2 步:查看 API 文档。 参数、接受的格式和时长限制都在 API 文档中。
第 3 步:发出你的第一个请求。 提交片段和指令:
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "Remove the white title text in the center of the frame. Keep everything else unchanged.", 7 "reference_videos": ["<your_clip_url>"], 8 "duration": -1, 9 "resolution": "720p" 10 }'
对于这样的编辑提示,duration 必须保持为 -1。模型会把它读作匹配源片段长度的指令,而不是生成一个新片段。
轮询任务,直到完成:
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
Atlas Cloud 在整个平台上运行一个 API,因此同一个密钥以及相同的提交与轮询循环适用于它托管的每个模型。之后更换模型字符串,集成的其余部分无需更改。
我们在 3 个高难度案例中尝试从视频中移除文字
纯色墙上的静态字幕是简单案例,那种能让任何文字移除工具看起来完美无瑕的演示片段。我们选了三个并不简单的案例。
带纹理背景上的大型静态标题。 一个巨大的白色标题横跨砖墙或植物,这种背景细节足够多,弱填充会立刻暴露。
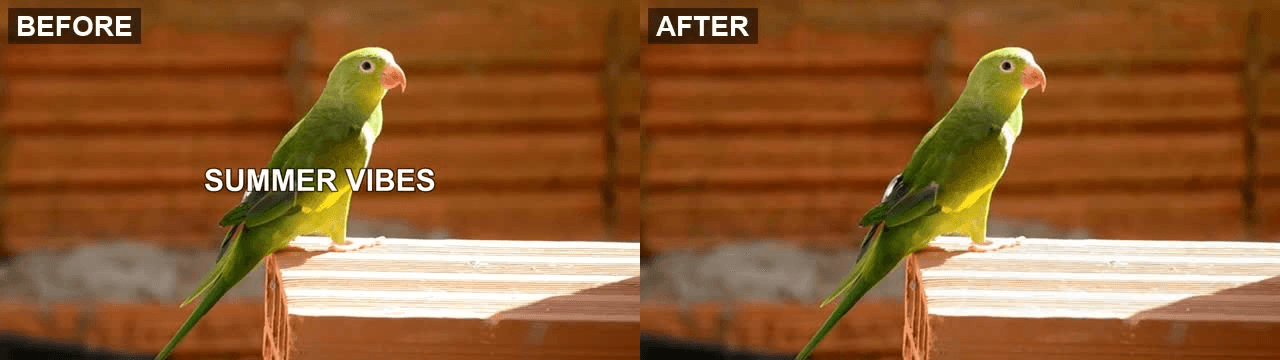
随着片段播放而变化的字幕。 一段短片,底部有烧录字幕,屏幕上每隔几秒就出现不同文字,镜头全程移动。
覆盖在人脸上的文字贴纸。 一段竖版片段,叠加层部分遮住某人的脸或衣服;这个案例能区分理解场景的模型和只会画矩形的模型。
在所有三个案例中,不只要检查字母是否消失。还要在镜头移动时观察被擦除区域的边缘,确认画面其余部分完全保持原样,并听音频是否在编辑后原封不动地保留下来。
输入什么才能只让文字消失
在这里,提示词几乎承担了全部工作,因为 Atlas Cloud 的视频编辑器中没有蒙版或画笔控制,只有一个文本字段。
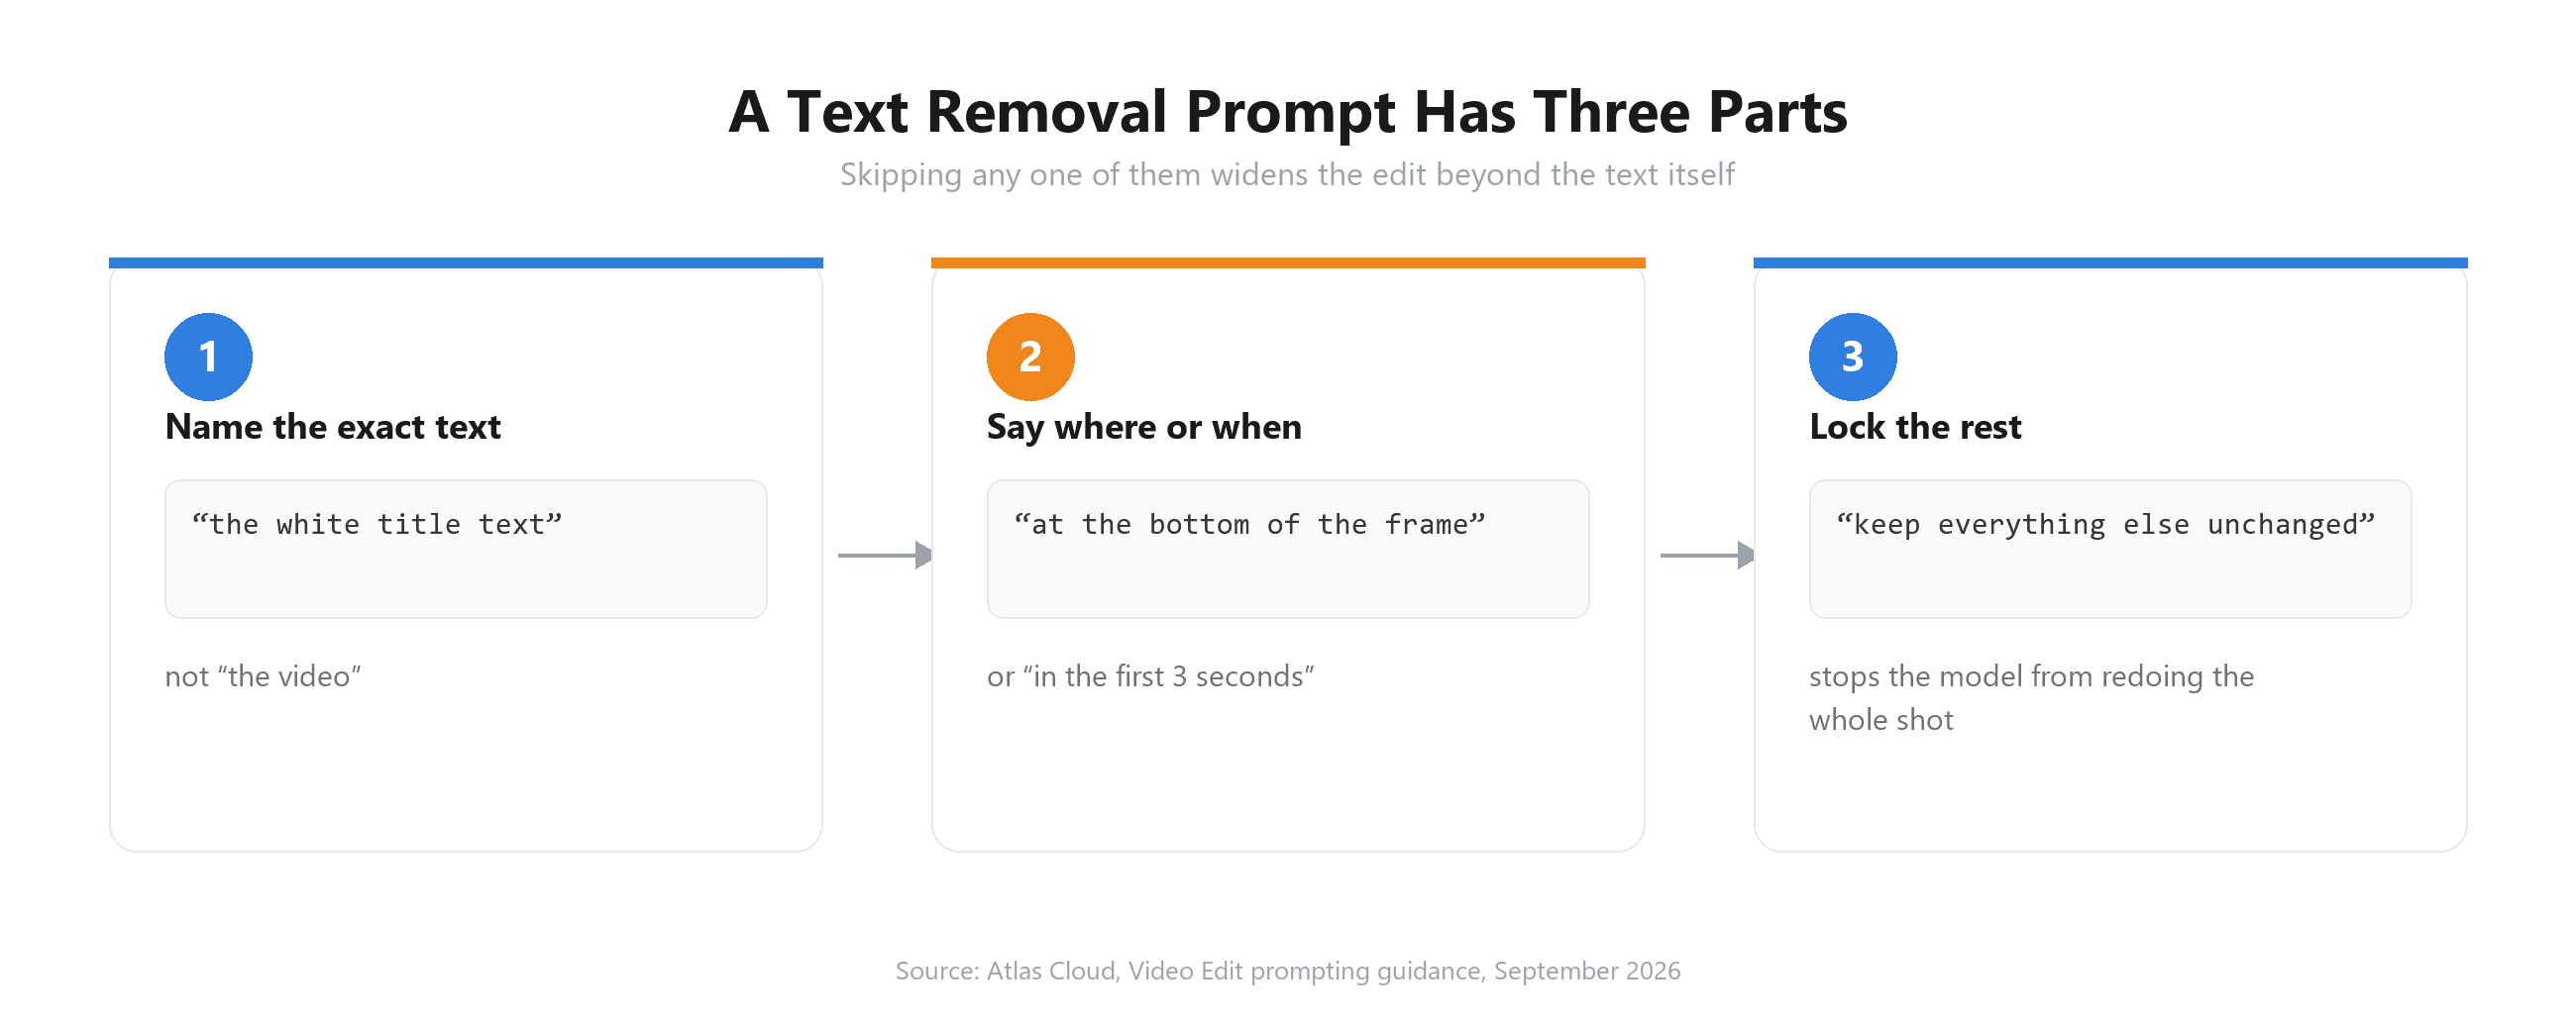
有效的提示词包含三部分。准确说出要移除的东西,而不是整个场景:说“白色标题文字”,而不是“视频”。如果片段里有不止一件事,说明它出现的位置或时间:“画面底部”、“前三秒内”、“在人物脸上”。
然后以明确指令收尾,要求其余一切保持不动。模型读到模糊提示时,有时会重新诠释整个镜头,而不是做一个有针对性的更改。
单独一句“移除文字”这种提示词,会产生技术上正确但过于激进的编辑,有时整幅画面的光线或颜色都会偏移。“移除画面底部的烧录字幕,画面中其余一切保持原样”会给模型一个它真正能遵守的边界。
如何从 TikTok 视频中移除文字
TikTok 文字有两种形式,需要两种完全不同的修复方式。
还是草稿?在 TikTok 编辑器中删除文字
如果片段尚未发布,就不涉及 AI 步骤。TikTok 自己的草稿编辑器可以直接移除文字叠加层:按住文字或贴纸,将其拖向屏幕顶部,直到出现 Delete 按钮,然后把它放到那里。
这种编辑流程只适用于发布前你自己的草稿,不适用于已经上线后的片段上的文字。
已发布:在片段上运行 TikTok 文字移除工具
视频一旦上线,应用内的删除路径就不再存在。必须像处理任何带有烧录文字的其他素材一样处理该片段:下载它,用视频编辑器处理,然后导出结果。
上面介绍的同一个 Video Edit 标签页可直接处理 9:16 片段,无需额外步骤,因为分辨率和宽高比会跟随源文件。
常见问题
我可以在线免费从视频中移除文字吗?
可以,对于短片或单个片段。Atlas Cloud 的 Video Edit 标签页基于浏览器,无需安装软件,并且按输出秒数计费而不是固定订阅,因此短片的成本只是完整长度编辑的一小部分。
在更大批量处理前,请在模型页面查看当前费率,因为促销价格会变化。
移除文字会降低视频质量吗?
只会在被重新绘制的区域,而且只有那里背景密集时才会。文字背后的平整墙面或柔和模糊可以干净地重建。
紧密的砖墙、密集的植物或精细织物纹理对任何模型来说都更难令人信服地重建,这与通常针对模糊源素材提到的限制相同。无论哪种情况,画面其余部分都会保持原始分辨率不受影响。
AI 能移除移动文字或片段中不断变化的字幕吗?
可以,当模型读取整个片段而不是一次一帧时。告诉它要移除什么以及它在哪里(“整个片段中画面底部的字幕”),而不是描述某一个瞬间,这样指令会应用于每一帧,而不只是模型碰巧预览的那一帧。
编辑后音频会保持不变吗?
只要指令不涉及声音,仅移除文字的提示会保留源音频。在对有重要对话或音乐的片段依赖这一点之前,请先在自己的片段上确认。
从别人的视频中移除文字可以吗?
只有在你制作了它或有权编辑它时才可以。TikTok 社区准则说得很直接:“你只应发布你创建或有权分享的内容。” 无论片段来自哪个平台,或由哪个工具进行编辑,同一原则都适用。
结论
从视频中移除文字归结为一个问题:这种修复是遮住文字,还是重建文字背后原本的内容?裁剪、模糊和贴纸都属于前者。
一个读取整个片段并只重绘你指定区域的模型属于后者,这就是仍然看起来被编辑过的素材和看起来完全未被碰过的素材之间的区别。
先用自己的素材从最简单的情况开始:纯色背景上的静态字幕,然后再处理移动叠加层或竖屏拍摄的片段。无论是一次性下载的 TikTok 视频,还是一批客户素材,同一条规则都适用:准确说出要移除什么,并告诉模型什么必须保留。
在宣布完成之前,以完整分辨率检查结果。这正是 AI 视频文字移除工具比裁剪或模糊更值得信赖的原因。


