MiniMax 周五发布了 H3。二十四小时内,Seedance 2.5 就落到了人们手中,时间线坍缩成一场对话:三十秒、原生 4K、五十个参考输入。H3 的发布帖安静地躺在下面,几乎没人真正跑过一次测试。
我理解为什么。三十秒是个漂亮的数字。它适合上标题。
但如果你真的制作竖屏短剧,你就会知道,毁掉你夜晚的不是第三十秒。而是第四镜。男主的下颌线偏移了半厘米,他的领结少了一个褶,观众在钩子落下之前就划走了。没有人因为一段片段是十五秒而不是三十秒而流失。他们流失是因为特写里的那个人不是全景里的那个人。
所以我跳过了规格表对决。我建了一张角色转面图,一张六格场景板,写了一个 15 秒哥特短剧提示词,然后把完全相同的包发给两边。然后我盯着那张脸。
关键要点
- 只有 H3 今天可调用 — Seedance 2.5 的 API 在字节跳动已上线,但在这个平台上仍是一个第 0 天页面。
- 规格清晰分界: Seedance 2.5 = 单次 30 秒、原生 4K、最多 50 个参考;H3 = 5–15 秒、2K、每个片段带立体声。
- 角色稳定性是一个打包问题 — 一个良好的参考包,而不是一个更大的模型,能稳住那张脸。
- 两者都生成原生音频; H3 还能从最多三个音频参考中固定一个声音。
- 按每帧像素评判,而不是按秒数 — 在同一轮运行中,H3 返回 1440p,而 Seedance 返回 720p。
Seedance 2.5 对比 MiniMax H3 的结果,在没有理论之前
在没有理论之前,先看工作流产生的结果。这是从一个完成的 15 秒竖屏片段中提取的四帧并拼贴在一起。这是 MiniMax 自己的 H3 参考运行,完全使用你将在步骤 1 和步骤 2 中看到的角色转面图和场景板,原生 1440x2560。我自己使用相同包的运行稍后会在教程中给出,显示 playground 状态。
她到达了雕刻的门,这是场景板中的第 4 格,然后是走廊对峙,然后是紧贴他的特写,然后是双人镜。他的发际线在侧面和特写中分得一样。她的半扎编发王冠经受住了整个脸部的特写,这正是大多数模型悄悄重建脸部的地方。奶油色蕾丝紧身胸衣从第一帧到最后一帧保持了相同的领口和袖口。
这就是整个测试。不是三十秒。四帧和一条下颌线。
为什么 Seedance 2.5 与 MiniMax H3 在同一周发布,以及为什么大多数角色测试毫无用处
MiniMax 于 7 月 30 日发布了 H3,这是一个通用多模态视频模型,将文本、图像、视频和音频作为单一上下文读取,并返回 5 到 15 秒的片段,最高可达 2K,带有原生立体声。它还可以编辑现有素材,并将运动从一个片段转移到另一个片段,MiniMax 表示权重将在几天内发布(Reuters,2026 年 7 月)。
Seedance 2.5 在同一窗口期落地,带着一个更响亮的数字:单次生成 30 秒、原生 4K 以及一次任务中最多 50 个多模态参考输入(The Next Web,2026 年 7 月)。其 API 已在开发者手中,具有局部编辑功能(可重绘帧的一部分,同时保留表演、光照和相机行为)、参考到视频(可接受绿幕遮罩或 3D 白模区块)、11 种语言,以及实验性长视频模式,可达 180 秒(CineD,2026 年 7 月)。
注意力差距是有趣的部分。我找到的几乎每篇帖子都是关于 2.5 的片段。与此同时,公共竞技场的数字却说明了别的情况:在 Artificial Analysis 图像到视频排行榜上,Seedance 2.0 720p 以 1196 Elo 领先,Gemini Omni Flash 以 1195 紧随其后,而 MiniMax H3 在发布仅四天后就已位列第三,Elo 为 1185。Seedance 2.5 在那里还没有评分(Artificial Analysis,2026 年 7 月)。讨论最少的模型,是分数与注意力之比最高的模型。
现在来看真正决定你输出结果的部分,因为它几乎与你选择哪个标志无关。
大多数角色一致性测试在模型参与之前就已经失败了。四种失败模式,而且全都可以由你来修复:
| 失败模式 | 你在输出中看到的现象 | 修复方法 |
|---|---|---|
| 多视图参考作为单独文件发送 | 每镜的脸都“几乎正确”,但没有两张一致 | 将这些视图合成为一张图像,然后在提示词中分配角色(“左侧的男人”、“右侧的女人”) |
| 每镜重写角色描述 | 服装和配饰的镜头间发生漂移 | 一次性编写身份块并逐字复用;每镜只改变相机和动作 |
| 让光照随场景变化 | 面部在新光源下被结构性重建 | 构建一个单独的、锁定光源方向、雾气和地面反射的场景板,并将其作为参考输入 |
| 将最大时长视为质量指标 | 30 秒内发生一次漂移,毁掉了全部 30 秒 | 将剪辑缩减到可以重新尝试的粒度,然后再讨论长度 |
想自己把 Seedance 2.5 和 MiniMax H3 放在同一个提示词面前吗?Atlas Cloud 的模型比较 可以一次运行两个模型,并排显示——相同的提示词和设置,生成前估算成本——这样你无需预订两次测试,就能判断面部、动作和屏幕文字。
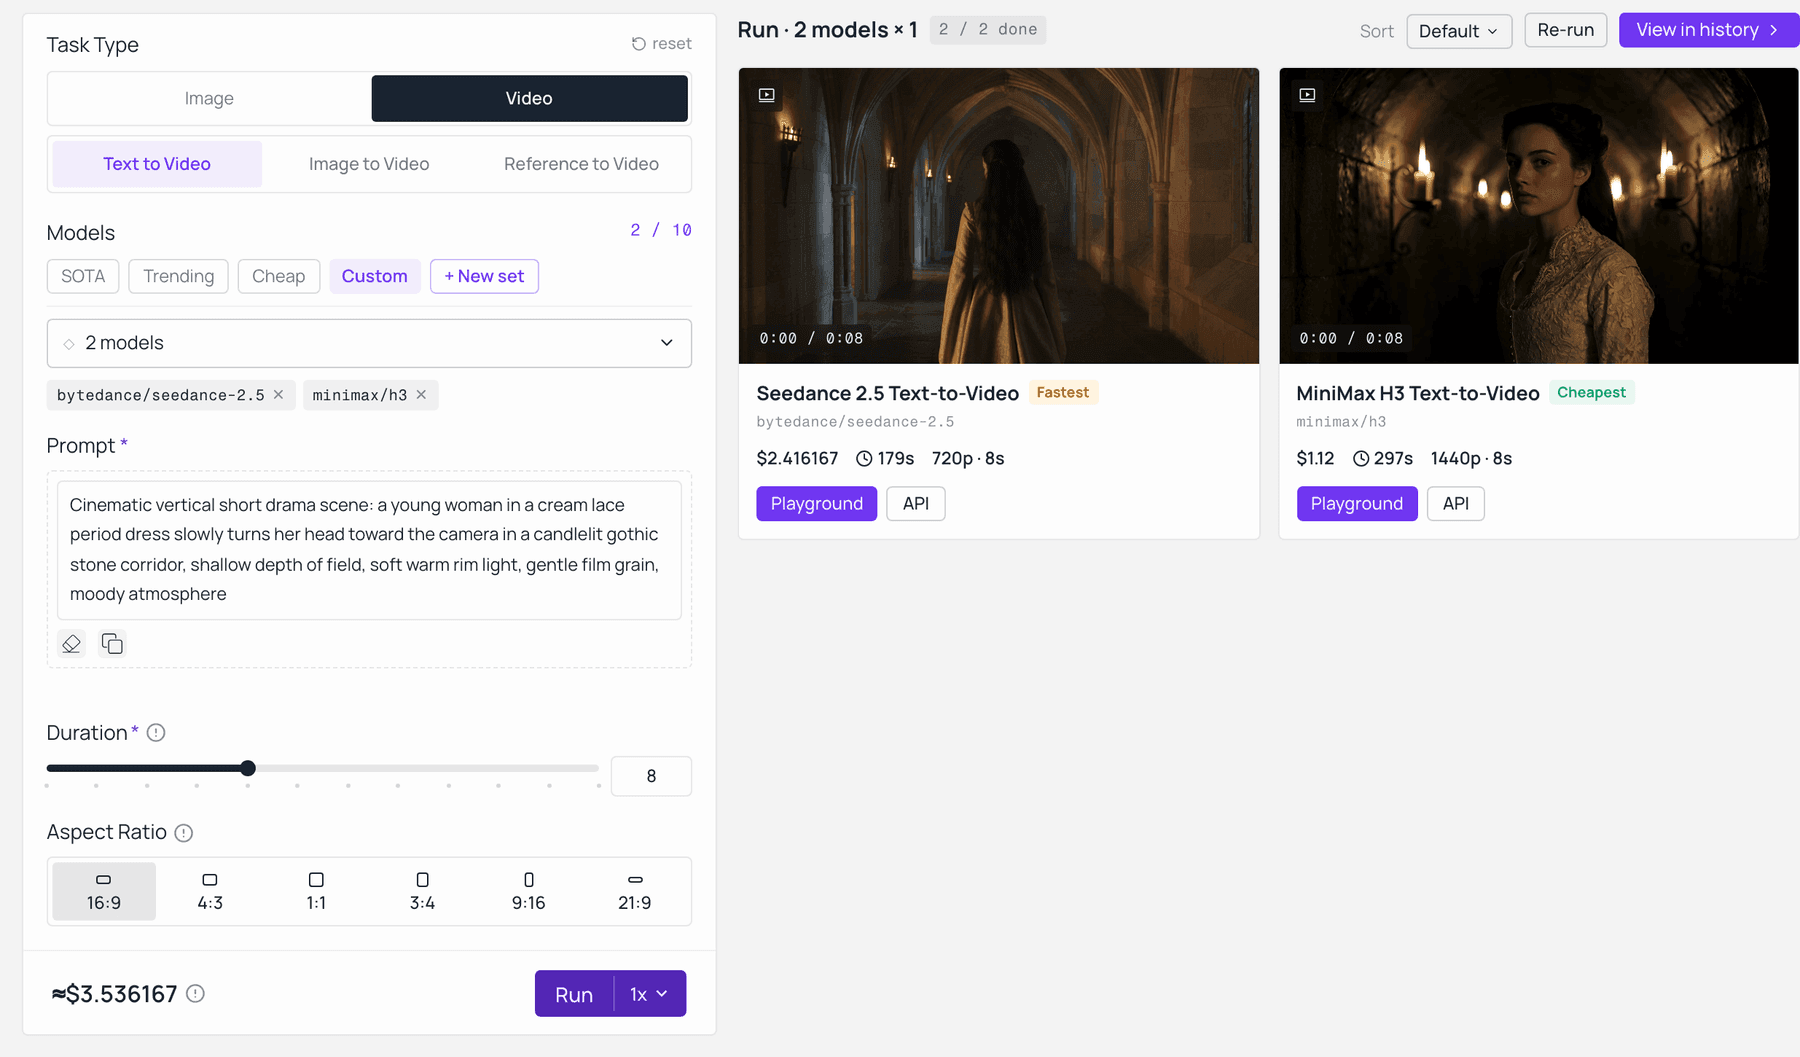
Seedance 2.5 和 MiniMax H3 在 Atlas Cloud 的模型比较中,使用相同提示词。Seedance 2.5 返回 720p,费用 $2.42;MiniMax H3 返回 1440p,费用 $1.12,两项费用均在运行前估算。在模型探索器上实时捕获。
第一行是大多数人最容易出错的地方。发送六张单视图图像,模型会将其视为六个候选人物并取平均值。发送一张干净的合成图像,模型会将其视为从三个角度看到的同一个人。同样的像素,完全不同的结果。
Seedance 2.5 对比 MiniMax H3 规格表,以及你今天实际可以调用的内容
将能力与可用性分开,紧张感就变得清晰。在原始能力上,Seedance 2.5 在时长、分辨率上限、参考数量以及编辑粒度方面领先。在可用性上,H3 是本周在一个通用模型平台上拥有三个实时端点的那个。如果你在做 2026 年规划的 AI 视频模型比较,第二列和第一列同等重要。
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 参考到视频(我运行的) | |
|---|---|---|---|
| 单次生成最大长度 | 5 到 15 秒 | 最多 30 秒,无需拼接(测试版可达 180 秒,实验性) | 短片段菜单,详见模型页面 |
| 分辨率 | 原生 2K,16:9 到 9:16 短边 1440p;768p 层级标注为即将推出 | 原生 4K,10 位色彩 | 此端点最高 720p |
| 帧率 | 24 fps | 未单独公布 | 未单独公布 |
| 参考输入 | 9 张图像 + 3 个视频 + 3 个音频,共 12 个文件 | 最多 50 个多模态参考 | 9 张图像 + 3 个视频 + 3 个音频 |
| 原生音频 | 有,每个输出,立体声 | 有,外加 11 种字幕和语音语言 | 有 |
| 编辑粒度 | 整片段指令编辑(替换角色、背景、光照、对白) | 区域级编辑,可重绘帧的一部分 | 整片段指令编辑 |
| 提示词上限 | 7000 个字符 | 未公布 | 未公布 |
| 开放权重 | 宣布在发布后几天内发布 | 未宣布 | 未宣布 |
| Artificial Analysis I2V Elo,2026 年 7 月 31 日 | 1185(第 3 名) | 尚未评分 | 1196(第 1 名,Dreamina 720p 条目) |
| 在我测试的平台上可调用 | 是,3 个端点 | 尚未,第 0 天页面 | 是 |
关于测试设置的完全披露。 我运行测试时,Seedance 2.5 在我的平台上尚未开放,所以 Seedance 方面使用的是 Seedance 2.0 参考到视频,这是同一家族中当前正在出货的成员,具有相同的四模态参考系统。如果 2.5 会改变答案,我会说明。Seedance 2.5 页面 目前只是一个第 0 天通知。
以下所有内容都在一个浏览器标签页中,用一个密钥运行,总共三个模型:
| 步骤 | 模型 | 输出内容 | 关键设置 | 成本驱动因素 |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 文本到图像 | 角色转面图 | quality high, 16:9 | 按图像计费,按使用付费,当前费率见模型页面 |
| 2 | 同一模型,第二次运行 | 六格场景和光照板 | quality high, 16:9 | 按图像计费,按使用付费 |
| 3 | MiniMax H3 参考到视频 | 9:16 片段,带原生音频 | 9:16, 2K, 测试时持续 5 秒,正式剪辑时 15 秒 | 秒数 × 分辨率,按秒计费 |
| 4 | Seedance 2.0 参考到视频 | 对照运行,相同输入 | 9:16, 最高可用分辨率,相同时长 | 秒数 × 分辨率,按秒计费 |
| 5 | H3 参考到视频,以片段为输入 | 固定一镜,无需重滚整个片段 | 相同分辨率,短时长 | 秒数 × 分辨率,按秒计费 |
H3 也有文本到视频和图像到视频入口,如果你想要纯文本基线或首尾帧控制。
在计划批量生成之前,还有一件事值得知道:屏幕文字。这个 15 秒的 H3 标题序列在八次硬切中保持了英文演职员表,没有一次拼写错误,这是生成视频中最难保持稳定的事情之一。
Seedance 2.5 对比 MiniMax H3 短剧工作流,逐步操作
五个步骤。完全按照写出的提示词复制,包括那些丑陋的部分。我没有为了文章清理它们,你也不应该为了模型清理它们。
步骤 1:使用 GPT Image 2 构建角色转面图
在制作任何视频之前先制作参考包。一张图像,两个角色,每个角色三个视图,纯白色无缝背景,均匀的摄影棚灯光。这消除了除你关心的那个之外的所有歧义:这个人长什么样。
plaintext1一张全身角色转面参考图,纯白色无缝背景,两个角色并排,共六个人物,均匀中性摄影棚灯光,地面无阴影,无文字,无标签,无水印。 2 3左半部分,男主角,三个视图依次排列:正面、右侧面、背面。20 多岁,肤色苍白,深色波浪中长发,轮廓分明的下颌线。穿着及地黑色天鹅绒长礼服外套,翻领和袖口有细微的同色系刺绣,黑色锦缎马甲,黑色丝绸领结,直筒黑色长裤,抛光黑色皮革德比鞋。手臂放松垂于两侧,中性表情。 4 5右半部分,女主角,三个视图依次排列:正面、右侧面、背面。20 岁出头,肤色白皙,长波浪栗色头发,半扎编发王冠。穿着奶油色维多利亚棉质蕾丝连衣裙,长袖带蕾丝袖口,合身紧身胸衣有小纽扣,全长及踝裙,奶油色踝带低跟鞋。手臂放松垂于两侧,中性表情。 6 7摄影写实风格,所有六个人物比例一致,脚部对齐在同一基线,整体清晰对焦。
设置: 模型 OpenAI GPT Image 2 文本到图像,质量高,宽高比 16:9,其他默认。
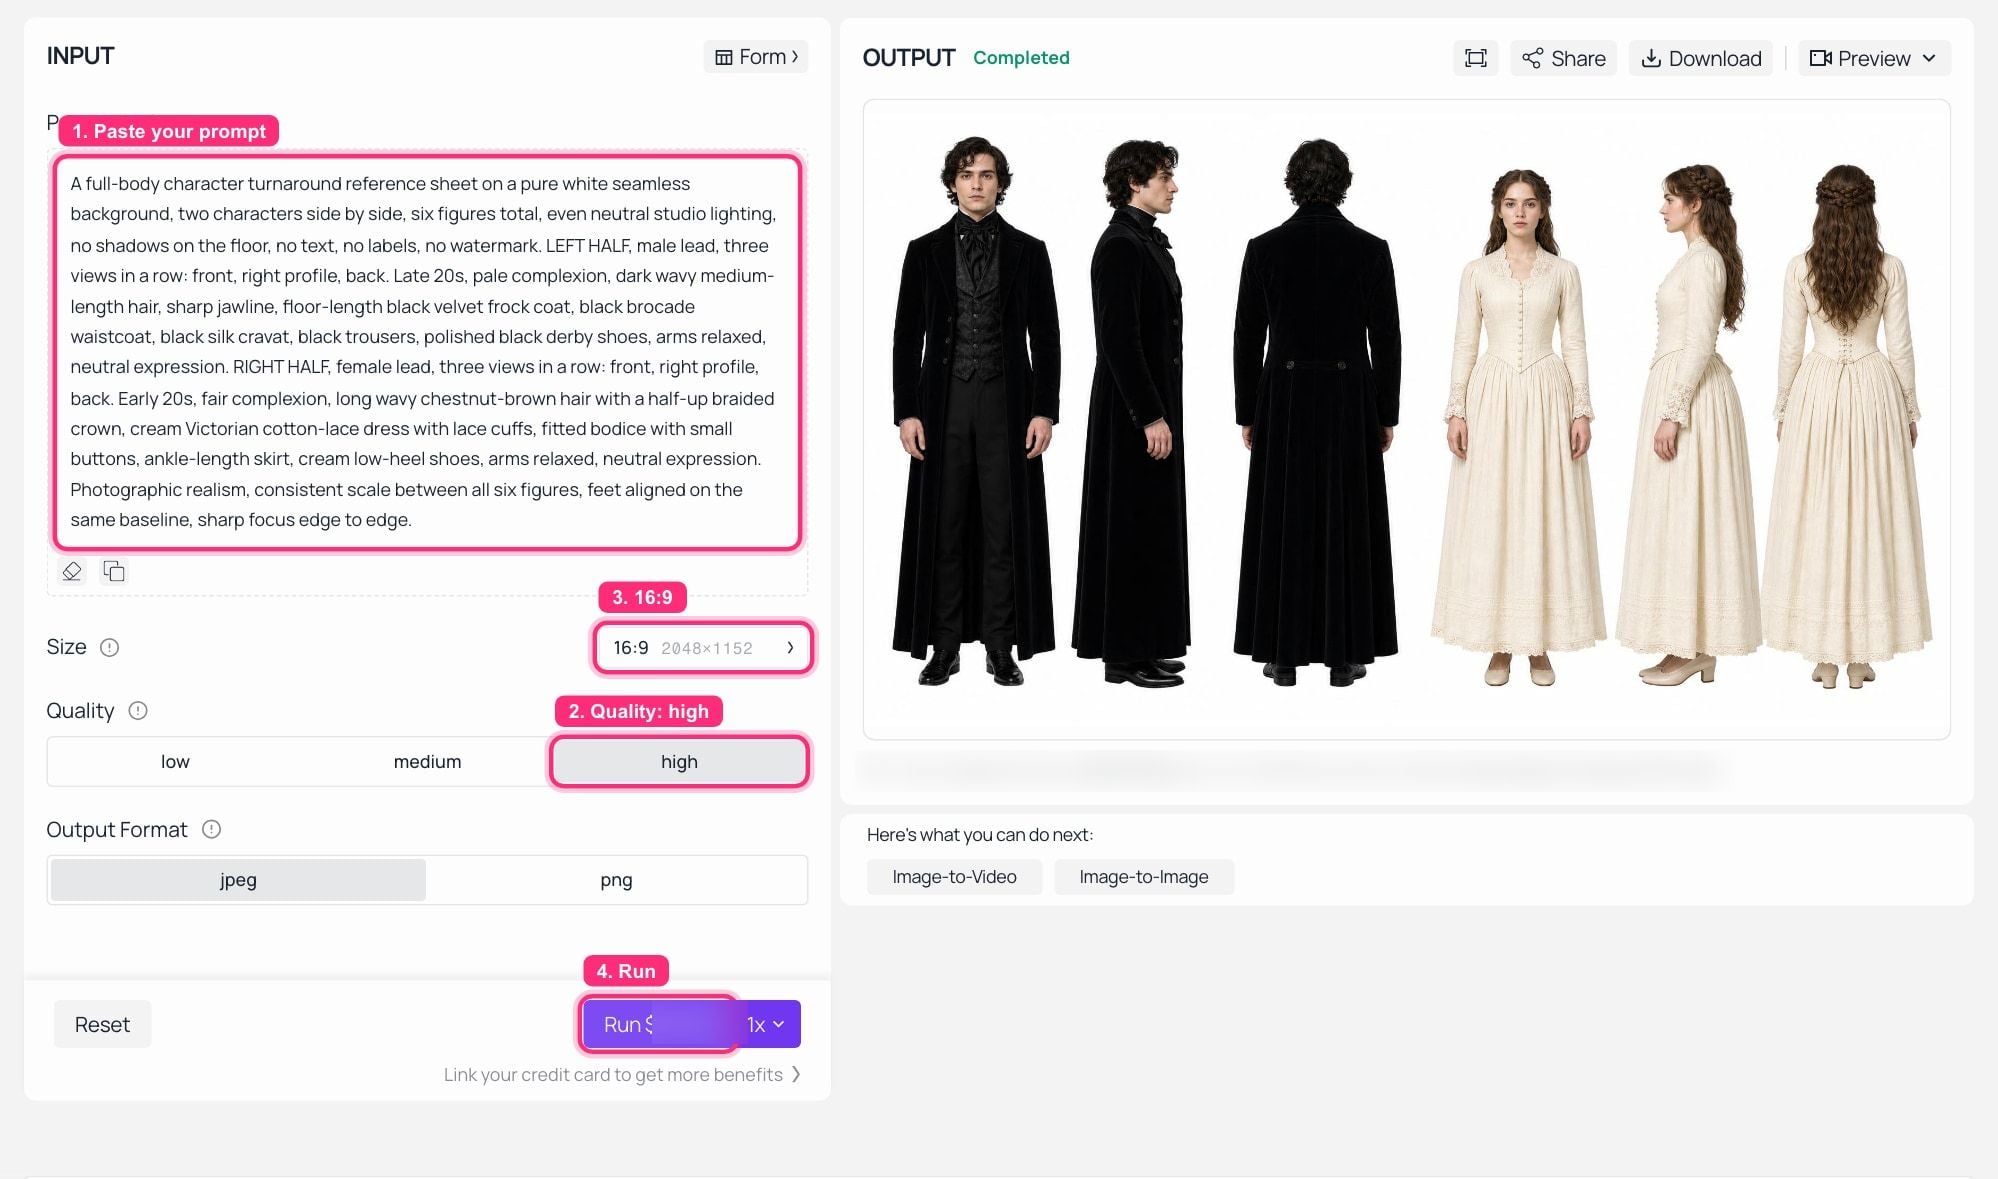 Atlas Cloud 上的 GPT Image 2 文本到图像,运行完成:左侧是转面提示词,OUTPUT 面板中是白色背景上的六个人物。
这是目标形状。六个人物,一条基线,背景中没有任何可争论的内容:
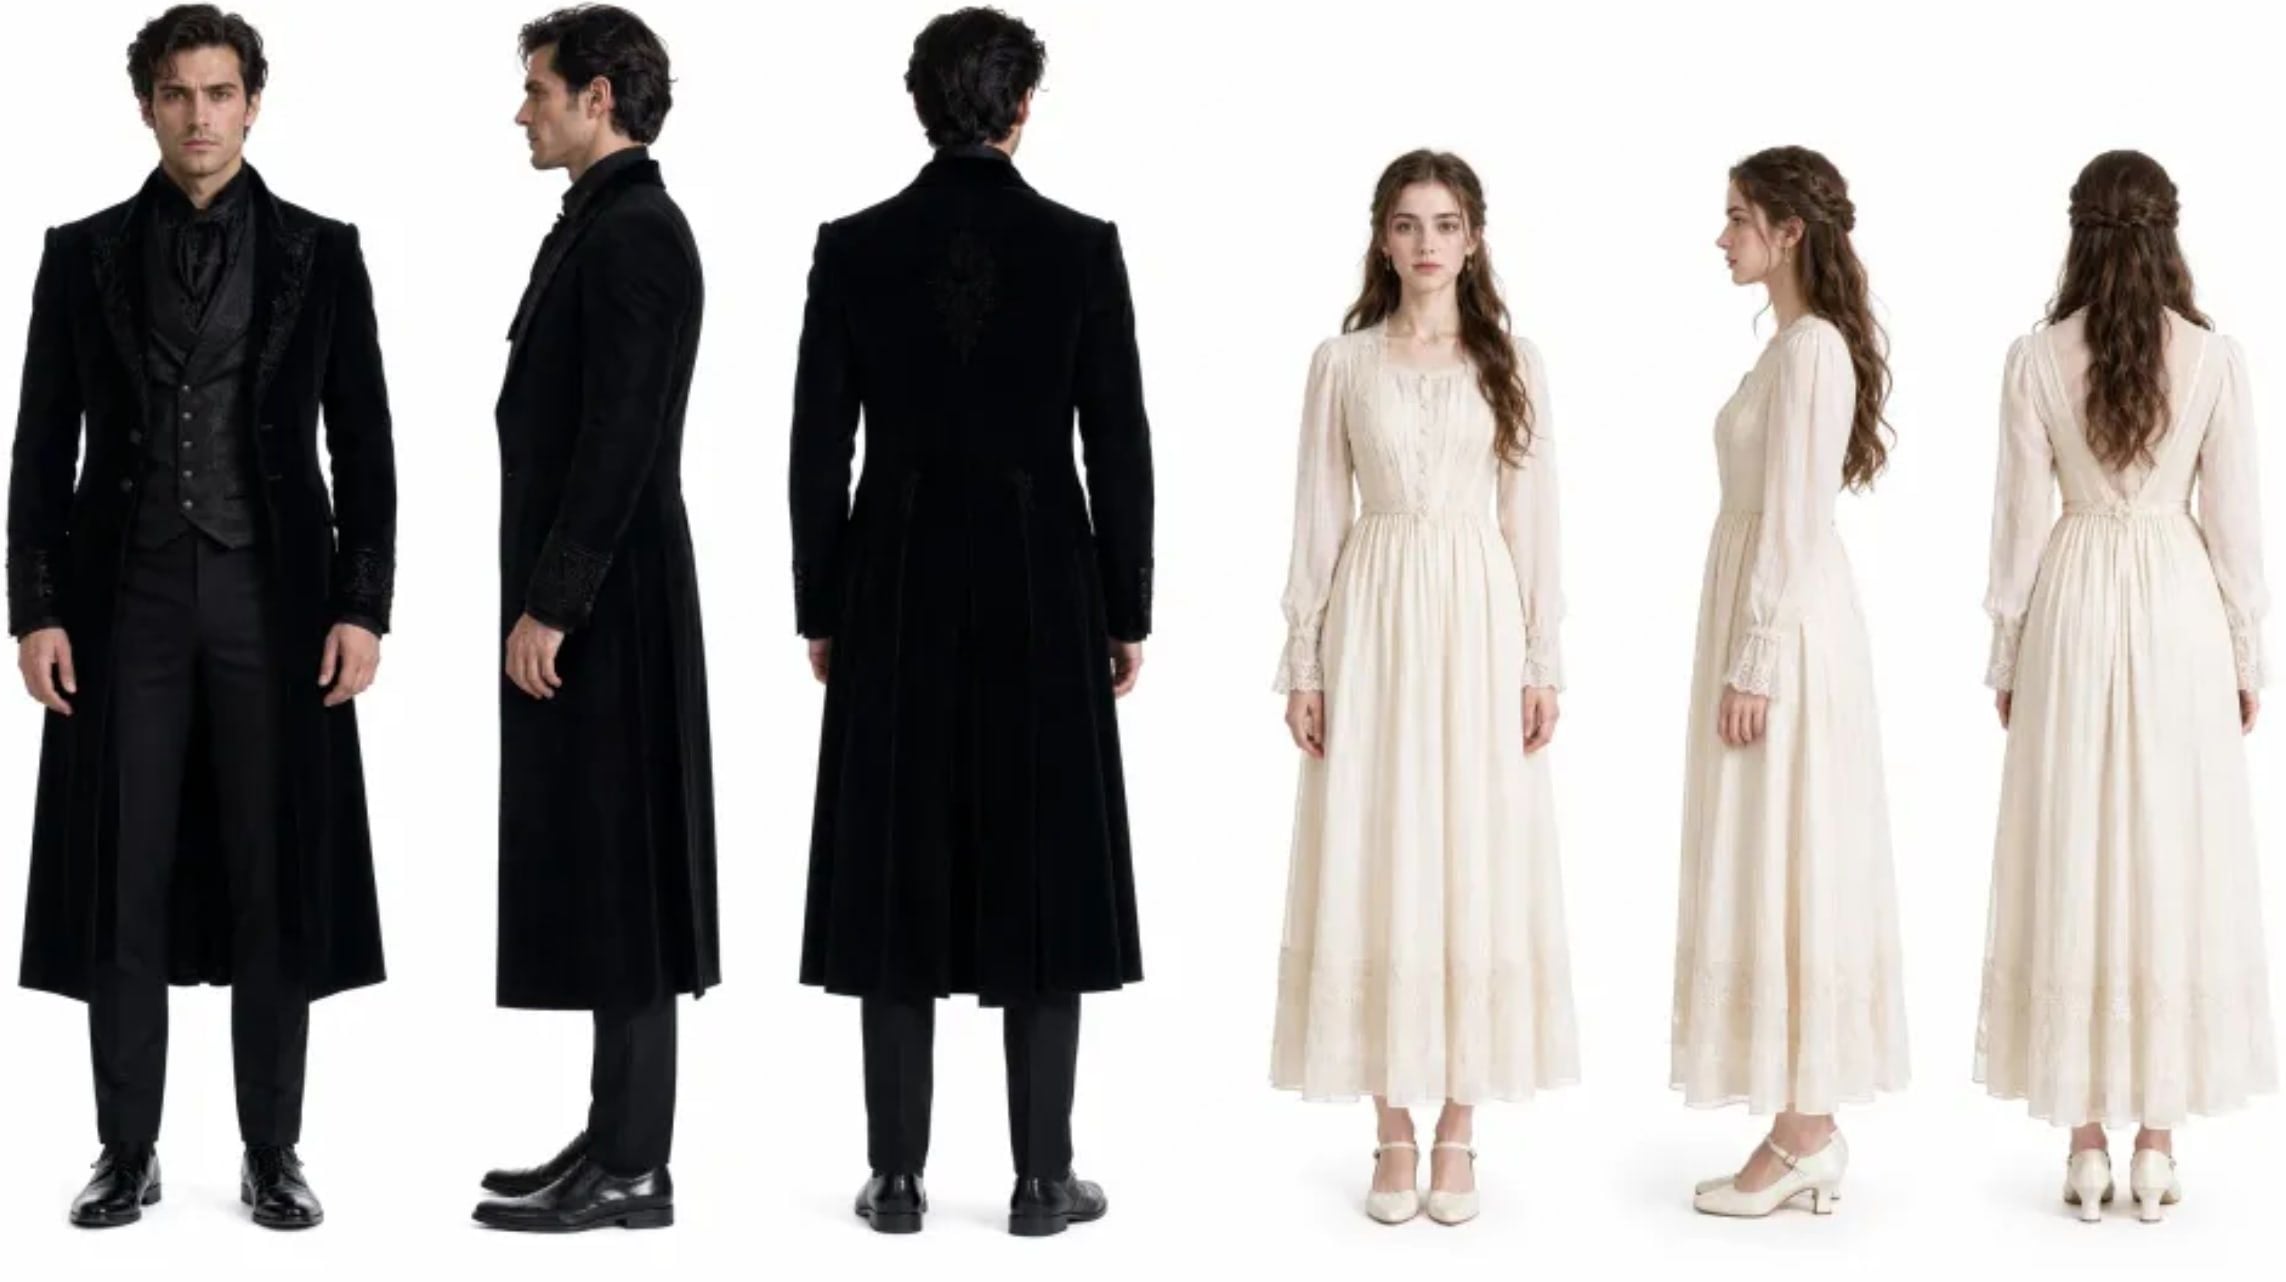 驱动演示片段的参考包:男主角穿黑色天鹅绒,女主角穿奶油色维多利亚蕾丝,每个角色三个视图,一个文件。
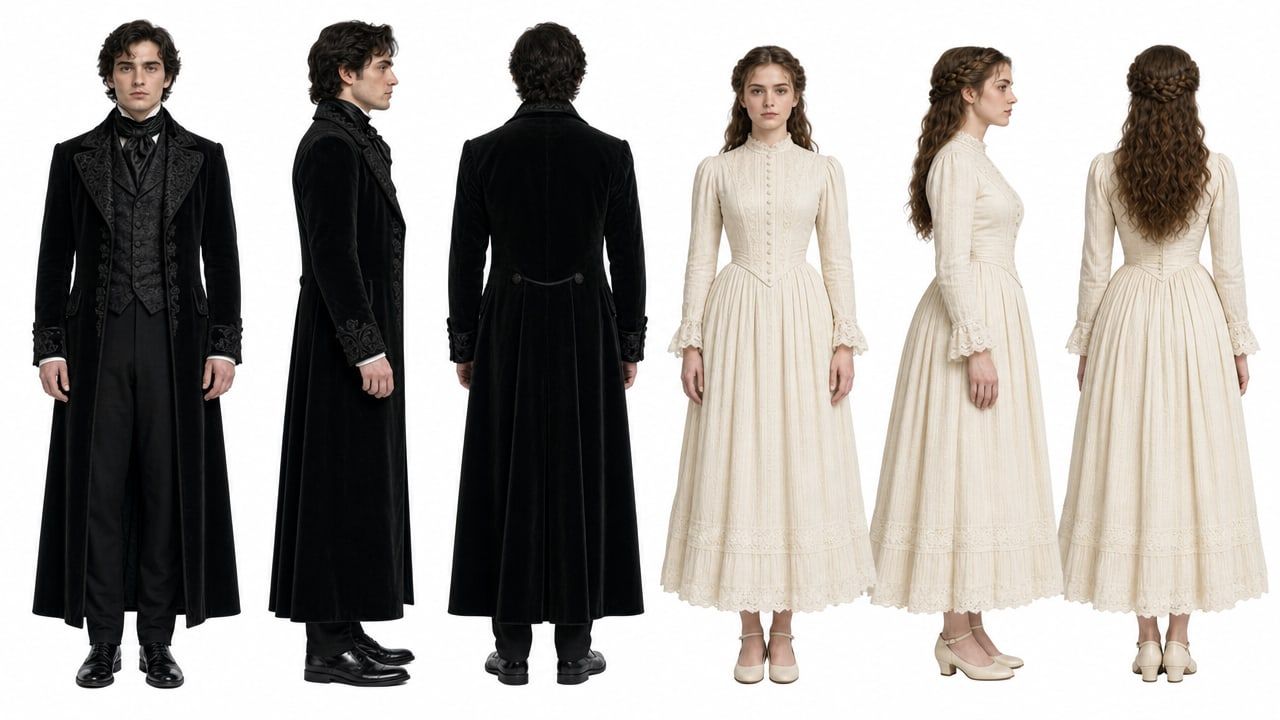 我自己对步骤 1 提示词执行的 GPT Image 2 运行,与上述参考图进行比较。
步骤 2:用六格场景板锁定场景
你稳住了脸。但光线仍然会背叛你。第二张参考图像固定了六个相机位置、月光的方向、空气中的雾气量以及地面的湿滑程度。你是在告诉模型,这部电影只有一种光照设置。
plaintext1一张六格电影场景板,2 行 3 列,面板之间细黑分割线,每个面板底部用优雅的小号白色全大写字母间距字体标注。主题:废弃哥特城堡内部,夜晚。冷蓝色月光,低飘雾气,湿滑反光石质地面,高挑彩色玻璃窗,铁制蜡烛壁灯带小暖色火焰,深暗低饱和度黑色,厚重天鹅绒窗帘。所有面板中无人物。 2 3面板 1,标注“WIDE ESTABLISHING VIEW - CORRIDOR”:一条长柱廊后退到一扇有灯光的彩色玻璃窗。 4面板 2,标注“LOW ANGLE - MOONLIGHT ACROSS FLOOR”:低角度,一束月光斜照在湿滑的石板上。 5面板 3,标注“DOORWAY & STAIRCASE COMPOSITION”:一个拱形门道,框住一段弯曲的石头楼梯。 6面板 4,标注“CLOSE DETAIL - CARVED DOOR”:紧贴的雕花木门特写,带铁制把手。 7面板 5,标注“WINDOW-SIDE VIEW - FOG & CURTAINS”:高挑窗户,雾气涌入,窗帘边缘在前景。 8面板 6,标注“FINAL POSTER FRAME - EMPTY HALL”:对称的空旷大厅,可看到图案地毯通往窗户。 9 10摄影感、电影感、胶片颗粒,所有六个面板色调一致。
设置: 同一模型,质量高,宽高比 16:9。
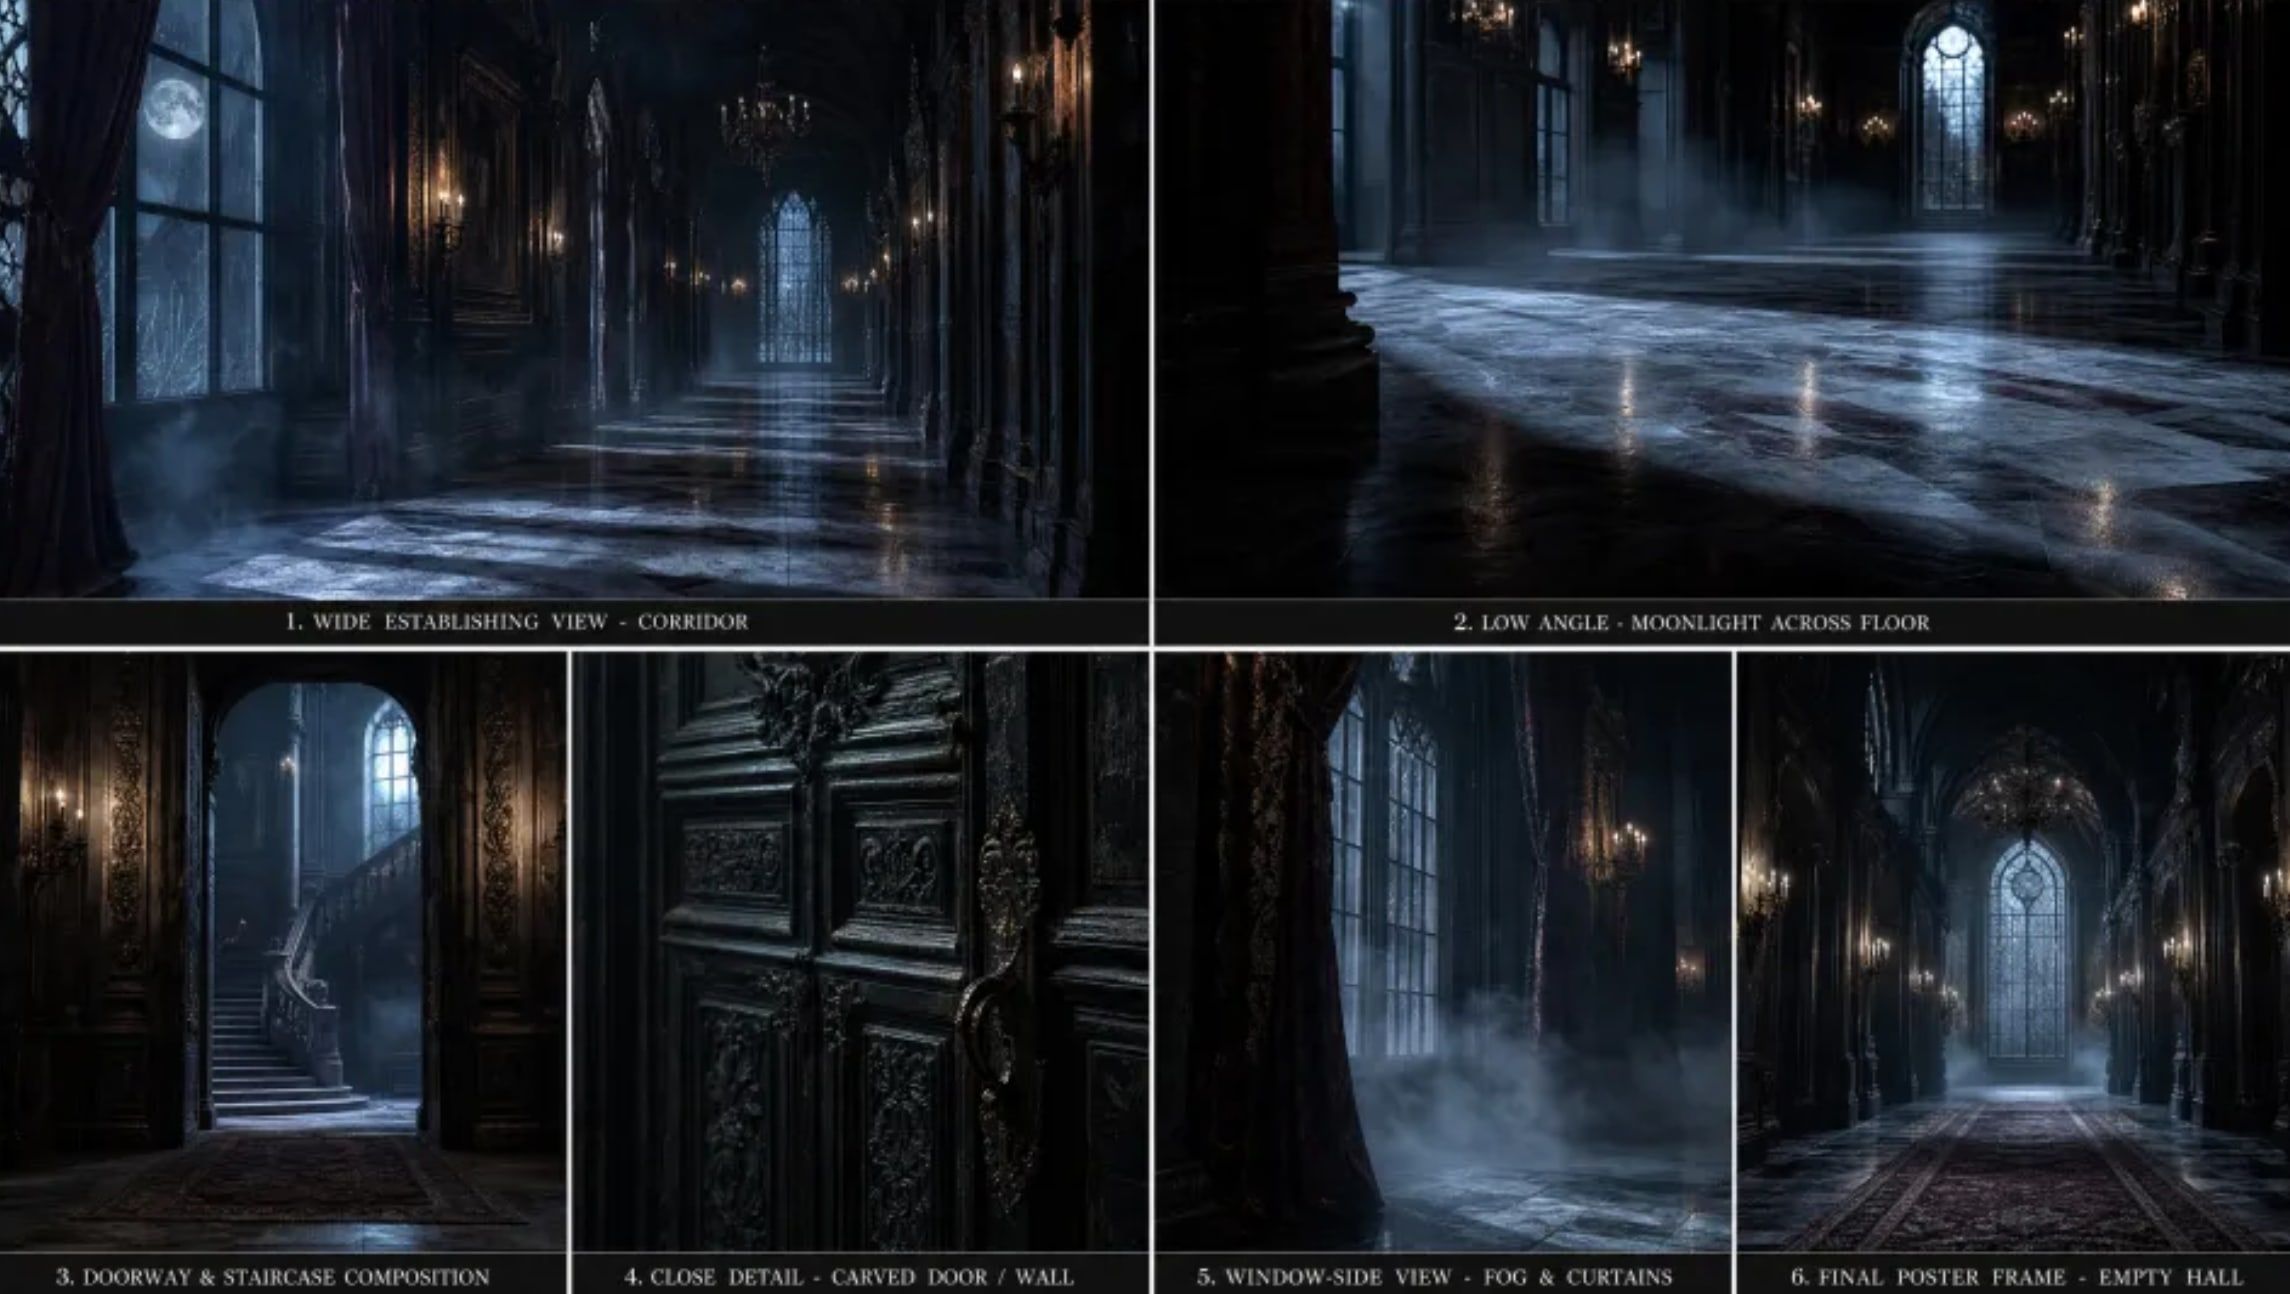 驱动演示片段的场景板:六张哥特式城堡内部,一种色调,标注可读。
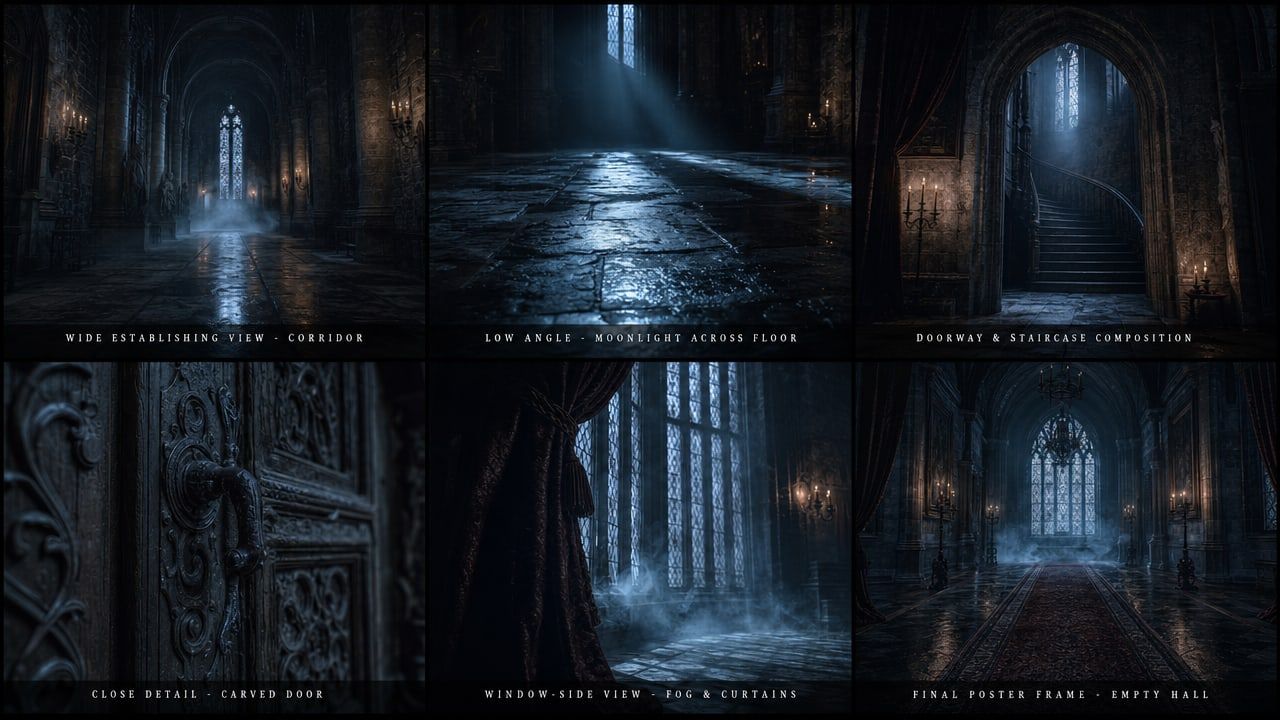 我自己对步骤 2 场景板提示词执行的 GPT Image 2 运行。
步骤 3:使用 MiniMax H3 参考到视频生成镜头
两张参考图像加上一个提示词,携带相机位置和音频方向。声音在同一个通道中产生,因此没有单独的语音或配乐步骤。调整时保持短时长,然后在正式剪辑中推到 15 秒。
plaintext1参考图像 1 是角色转面图:左侧的男人是男主角,右侧的女人是女主角。保持两者身份完全如图所示:他的下颌线、深色波浪头发、黑色天鹅绒长礼服外套、黑色锦缎马甲和黑色丝绸领结;她的栗色半扎编发和奶油色维多利亚蕾丝连衣裙。参考图像 2 是场景和光照板:匹配其冷蓝色月光、飘浮雾气、湿滑反光石质地面和低饱和度黑色调。 2 39:16 竖屏,高级真人短剧风格,浅景深,电影对比度,无字幕,无屏幕文字,无水印。 4 5镜头 1:中近景,相机缓慢推进。女主角站在月光照耀的走廊中,呼吸急促,眼睛盯着画外右侧的某个东西。雾气在她膝盖高度移动。 6镜头 2:硬切。从她身后过肩镜头,男主角从黑暗拱门中步入月光,大衣捕捉光线,表情冷漠而好奇。 7镜头 3:紧贴他脸部特写,半被窗户照亮,然后是她脸部的匹配特写,同时她拒绝移开视线。 8 9音频:低沉的持续低音嗡鸣,遥远的石质回声,她不稳定的呼吸,他步入光线时一个沉重的脚步声,最后一个切上有一个柔和的弦乐渐强。
设置: 模型 MiniMax H3 参考到视频,分辨率 2K,时长 8(滑块默认值;正式剪辑推到 15),宽高比自适应,以及参考资料中的两个文件。面板将其计为 9 个中的 2 个,所以你还有充足的空间来添加服装或道具图片。
值得一提的是宽高比的情况。我将宽高比保持在自适应,只在提示词中写了“9:16 竖屏”。H3 仍然返回了竖屏,所以它从文本中读取了构图,而不需要表单字段。
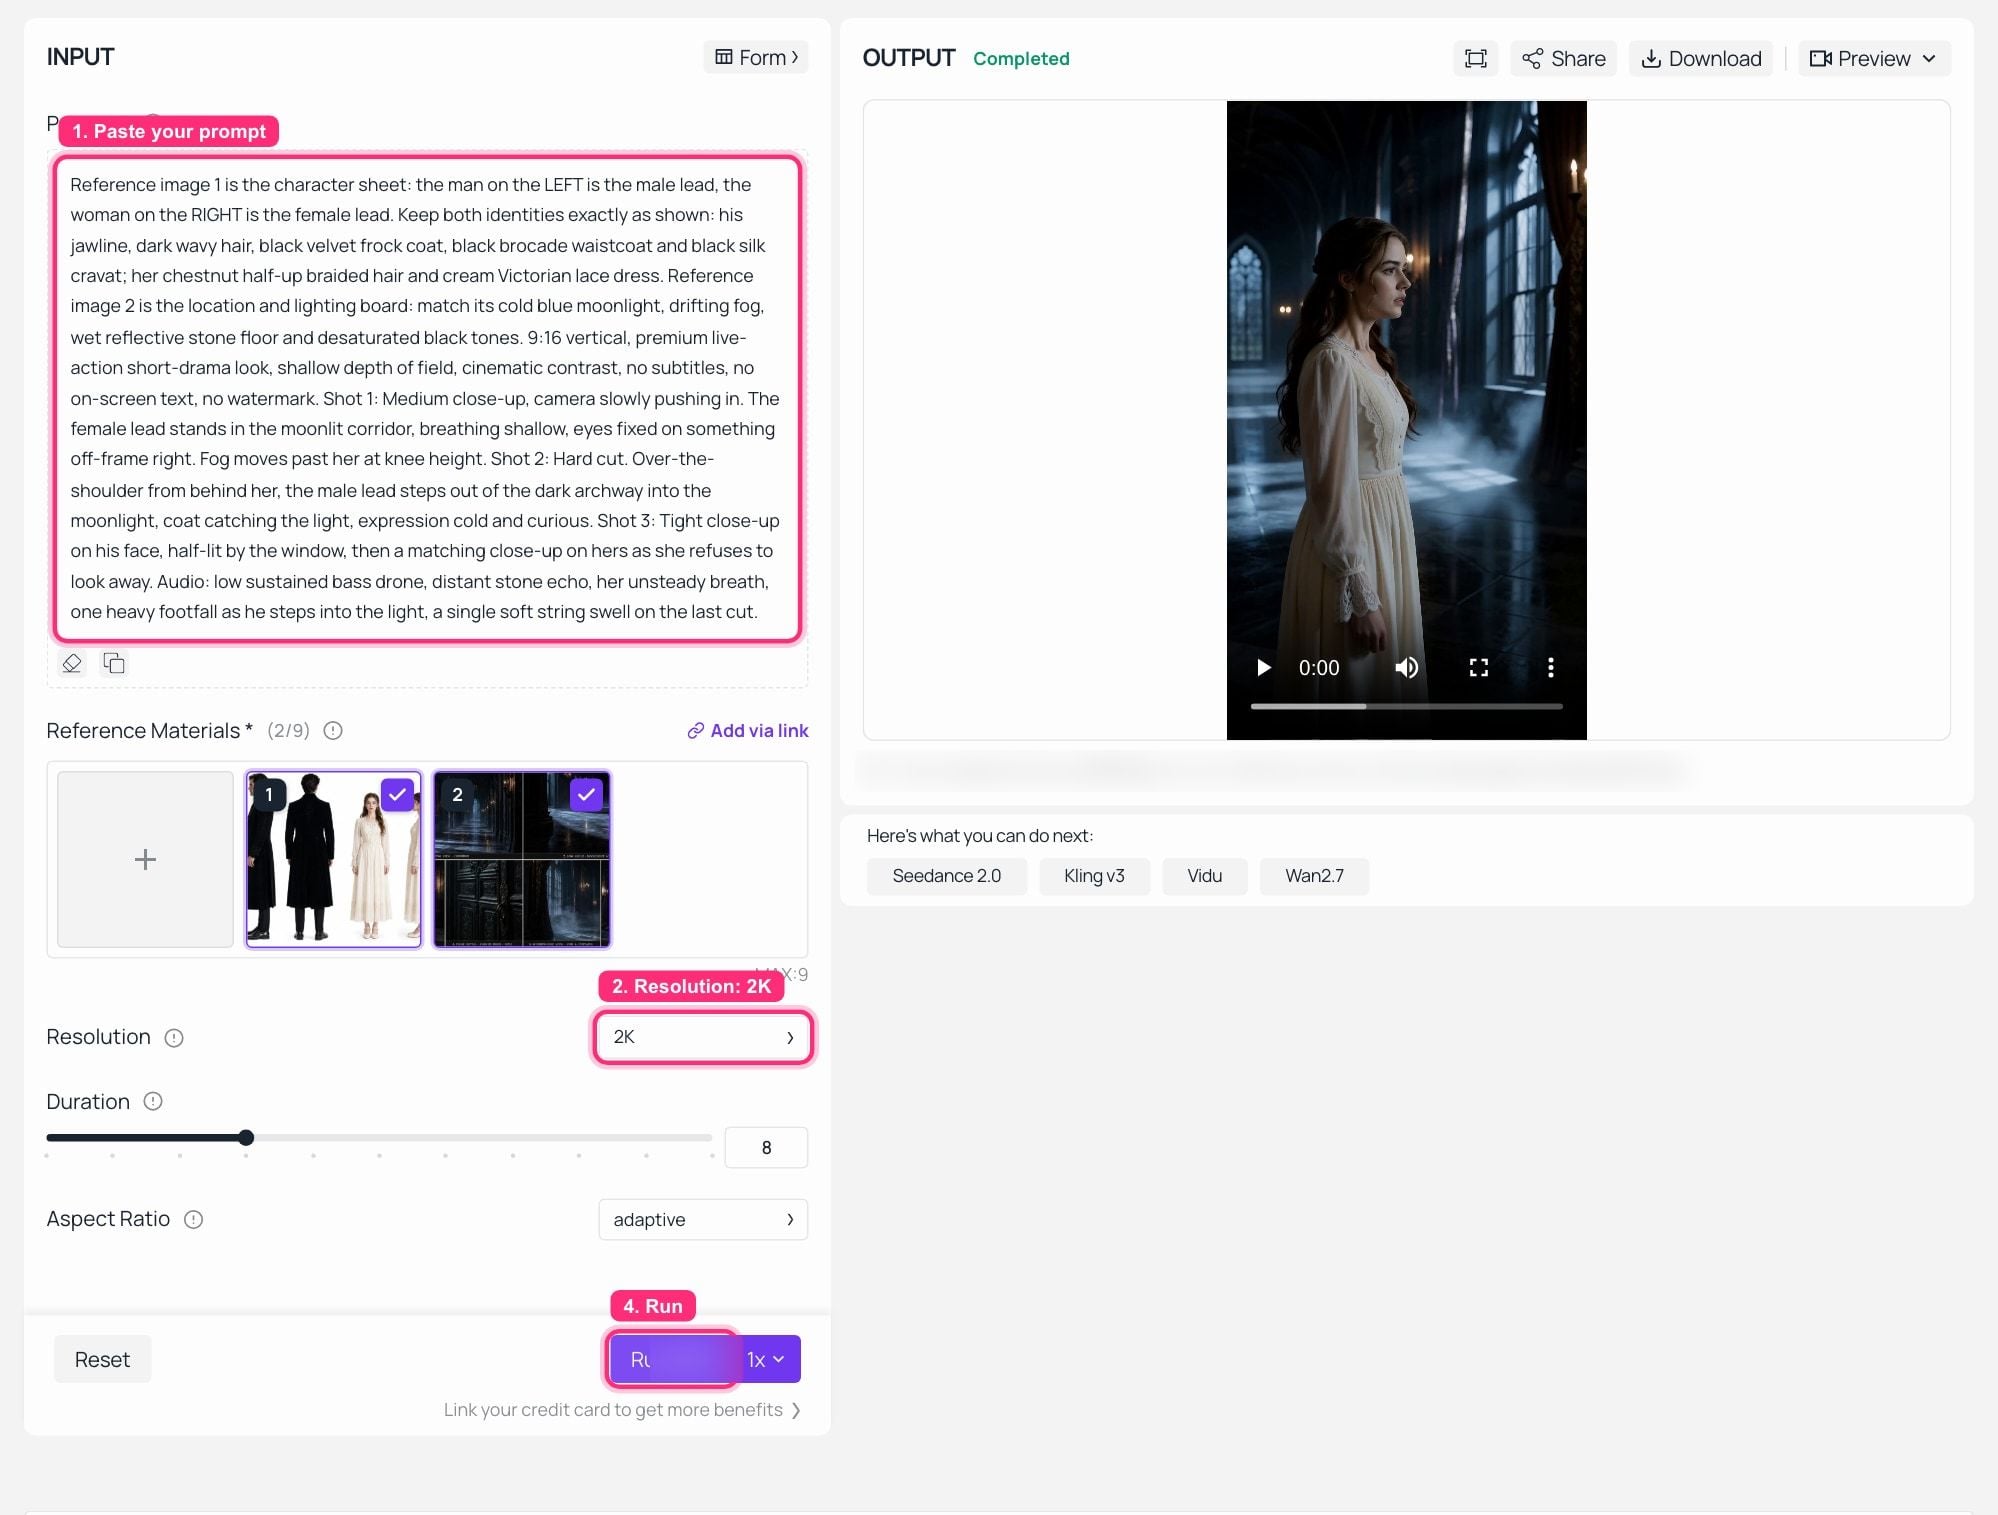 Atlas Cloud 上的 MiniMax H3 参考到视频,运行完成:两个参考文件已加载,计为 9 个中的 2 个,分辨率 2K,生成的竖屏片段在 OUTPUT 面板中播放。
第一帧是女主角穿着奶油色蕾丝紧身胸衣,站在场景板图 1 的走廊中,雾气在膝盖高度,月光照在湿滑的地板上,正好落在场景板放置的位置。两张参考图像都落地了。
步骤 4:使用相同的包运行 Seedance 2.5 对比 MiniMax H3 的对照测试
不要改变一个字。相同的两张参考图像,相同的提示词,不同的模型。我让每个页面自己的时长默认值保持不变,而不是强制匹配,我会在下面说明每个模型返回了什么。为“适应”另一个模型而重写提示词,正是比较开始撒谎的方式。
plaintext1与步骤 3 相同的提示词,逐字复制。不要为另一个模型重写它。
设置: 模型 Seedance 2.0 参考到视频,分辨率 720p,参考图像中的相同两张参考图像(同样是 9 个中的 2 个,还有单独的槽位用于最多 3 个参考视频和 3 个参考音频文件)。时长保持页面默认值,返回了一个 10 秒片段。
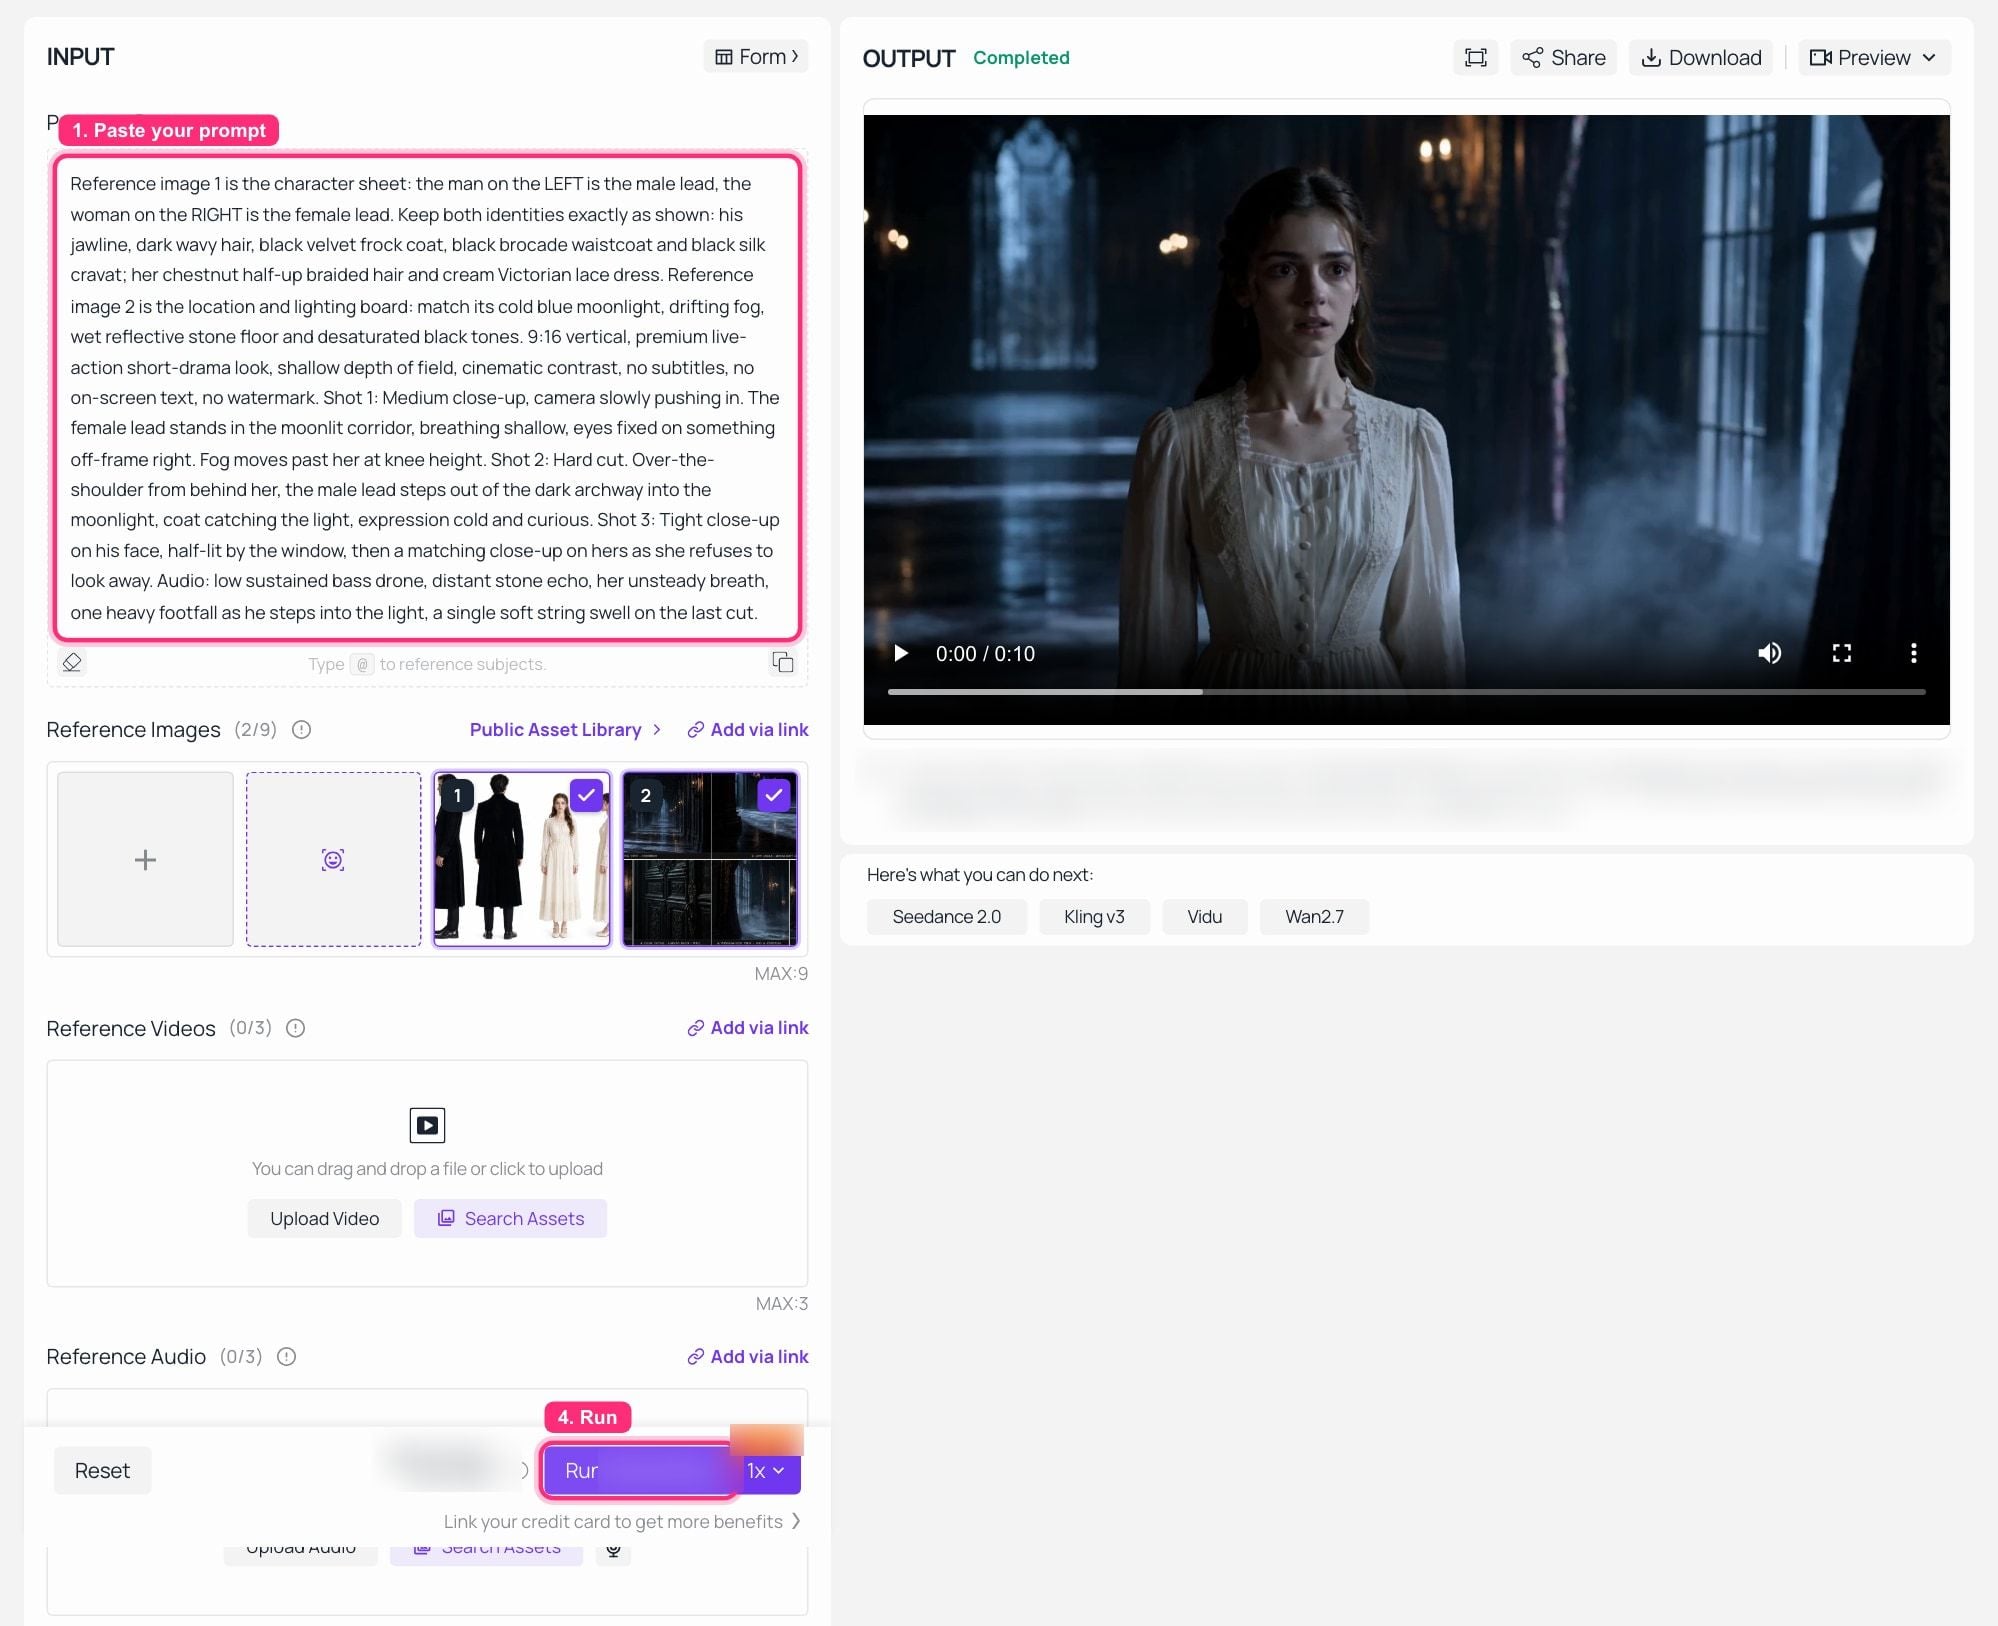 Atlas Cloud 上的 Seedance 2.0 参考到视频,使用与步骤 3 完全相同的参考包和提示词运行完成,OUTPUT 面板中显示 10 秒结果。
以下是两个 OUTPUT 面板实际显示的内容,我如实报告,而不是挑选赢家。
两轮运行都保持了角色。相同的奶油色蕾丝连衣裙,带有相同的领口和袖口,相同的栗色头发,相同的雾气月光走廊,从场景板中提取。两者都没有发明一个不同的女人。参考包在两侧都完成了这项工作,这是我最关心的发现。
差异在于形式,而不是面部。这个 Seedance 端点交付了 720p;H3 交付了 2K,输入相同。而且构图不同:H3 从提示词文本中直接读取了“9:16 竖屏”并返回了竖屏,而 Seedance 运行返回了 16:9,因为该页面有自己的宽高比控制,仅凭提示词文本无法覆盖。如果你是为 TikTok 剪辑,这种差异会在你第一次忘记表单字段时让你多花一次运行时间。Seedance 2.5 可能会改变分辨率的这一半,并增加区域级重新尝试,我不会假装我测量了这一点。
步骤 5:修复一镜,无需重滚整个片段
短剧的真正成本不是第一次生成。而是第七次修订。H3 接受现有片段作为输入,并根据指令进行编辑,同时保持你未提及的部分不变。Seedance 2.5 在这里的卖点更精细:重绘帧的一个区域,同时保留表演、光照和相机。
plaintext1使用提供的片段:保持两个角色、他们的服装、相机运动和剪辑节奏完全不变。只改变环境,将月光石走廊替换为同一城堡的舞厅,高挑拱形窗,亮着的水晶吊灯,温暖的烛光,并重新照亮两个角色,使他们的主光源来自画面左侧的吊灯,而不是窗户。将她唯一的一句台词重写为“你从来就没睡着过,是吗。”保持她的表演节奏在相同节拍上。
设置: MiniMax H3 参考到视频,将步骤 3 的片段作为参考输入,时长 5,分辨率 2K。
超越 Seedance 2.5 对比 MiniMax H3 测试:推动参考包的四种方法
同一角色,下一集。 将步骤 1 的转面图保存为资产,只在提示词中更改镜头列表和故事块。身份来自一个文件,而不是你记忆中的措辞。
固定声音。 H3 最多接受三个音频参考,每个 2 到 15 秒,并且必须伴随图像或视频输入。给它一个声音样本,角色就会以那种音色说话,这样你就不用在剧集之间重新选配音演员了。
在支付渲染费用之前先锁定相机。 Seedance 2.5 的参考到视频接受 3D 白模区块和绿幕遮罩,因此你可以在灰色几何体上锁定构图,然后再投入最终外观。这个示例运行在 Seedance 2.1 上,是该家族的早期成员,但工作流的形状是相同的。
本地化一个母版剪辑,而不是重新拍摄。 区域级替换可以替换一张脸、一个产品或一种口语,同时保持相机、时间和嘴唇动作不变。这里,一个母版美容剪辑被重新选角和重新配音,用于西班牙语、韩语和印地语,而房间、构图和嘴唇动作都保持不变。
另外,因为有人会问,当你停止理智时,运动转移看起来是什么样子:三个穿西装的男人,被三只照片级逼真的水豚取代,忠实地跟随原始片段的运动路径,直到它们堆叠成一个金字塔。
还有这一切的朴素版本,没人会发帖:一张静态海报变成一个动态海报,布局保持不变。
 静态源海报。将其输入参考到视频,提示词为“保持帧、调色板和布局,使文字动起来”,你就会得到同一个设计的动态版本。
Seedance 2.5 对比 MiniMax H3 短片的实际成本
这里没有数字,因为数字会变,而结构不会。两个系列都按秒计费,按使用付费,无需座位和订阅。这就剩下三个变量:秒数、分辨率层级和重新尝试次数。
第三个变量就是全部账单。一个 15 秒片段第一次尝试就成功,只收一次费。同一个片段第七次尝试才成功,就收七次。所以省钱的做法不是选择更便宜的每秒模型,而是在生成任何东西之前先把参考包弄对。步骤 1 和步骤 2 中的那两个图像调用是整个管线上最便宜的环节,却决定了你要进行多少次视频调用。在整个链路中,投资回报率最高,遥遥领先。
然后纠正每秒的本能。相同的参考包,相同的运行时间:H3 的参考到视频返回 1440p,这个 Seedance 参考到视频端点返回 720p。每秒是错误单位。每帧像素,以及你是否需要另外付费进行单独的上采样通道,才是正确的单位。
音频也应该计入算术。两边都在同一个通道中产生原生同步声音。如果你当前的管线上是视频模型加 TTS 再加一个编辑对齐轨道的编辑人员,那么你节省的是两次 API 调用和一个下午的人力,而这项节省不会出现在任何价格表上。
哪个模型适合哪个工作:
| 工作 | 选择 | 理由 | 注意事项 |
|---|---|---|---|
| 竖屏短剧,9:16,TikTok 或 ReelShort | MiniMax H3 | 1440p 竖屏带原生立体声,现在可调用,15 秒是一个完整的钩子 | 你在 15 秒处剪辑,所以据此规划节拍 |
| 一部连续 30 秒的品牌电影 | Seedance 2.5 | 单次生成,无需拼接,原生 4K | 先检查平台可用性 |
| 在已批准的剪辑中修复一镜 | Seedance 2.5 | 区域级重绘,其余部分保持不变 | H3 的整片段剪辑今天已能满足大部分需求 |
| 产品和电商剪辑 | 两者均可 | 两者都能很好地保持屏幕文字和品牌标记 | 以你交付的分辨率验证文字 |
| 游戏或界面演示 | MiniMax H3 | 用户界面和排版在 2K 下的稳定性强 | 单次通过的上限为 15 秒 |
| 一个母版的多语言版本 | Seedance 2.5 | 区域替换加多语言语音 | 本地化质量仍需要母语者检查 |
| 今晚就要发货 | MiniMax H3 | 三个端点已上线,外加整个 Seedance 2.0 系列 | Seedance 2.5 的访问因平台而异 |
在发货之前。 MiniMax 表示 H3 的权重将在发布后几天内发布,而开放权重与商业许可是不同的,所以在自托管之前请阅读条款。两边的消费者应用和 API 访问在水印和商业使用政策上也不同,我在撰写本文时无法从主要条款页面确认任何一项,所以请查看提供商的条款,而不是相信我的话。而且没有任何模型许可涵盖肖像或商标。如果参考包中包含真人、真实品牌或他人的知识产权,那是一个独立的法律问题,模型的条款不会回答它。
上表中所有模型都在同一个密钥上运行,模型页面 带有当前费率以及可复制粘贴的代码,包括本周 Seedance 系列的促销活动。
常见问题
Seedance 2.5 在角色一致性上比 MiniMax H3 更好吗?
理论上应该如此,它支持最多 50 个多模态参考,而 H3 是 12 个文件,此外还有区域级重试。但截至 2026 年 7 月 31 日,没有我可以指出的配对公开测试,而且 Seedance 2.5 还没有竞技场评分。在我实际能做的运行中,决定身份稳定性的变量是参考包结构,而不是模型代次:使用一张组合转面图加一张场景板,两边都保持了角色。在花时间比较模型之前,先把包弄对。
我现在就能用 Seedance 2.5 吗,还是必须等?
它的 API 在字节跳动已上线。在第三方模型平台上的可用性参差不齐,在我测试的那个平台上,它仍然是一个第 0 天通知。如果你今晚就需要输出,可调用的选项是 MiniMax H3 的三个端点和整个 Seedance 2.0 系列。
MiniMax H3 真的能做 30 秒视频吗?
不。规格是每次生成 5 到 15 秒,24fps。任何更长的都是扩展或拼接,这是不同的事情,具有不同的漂移风险。30 秒单次生成属于 Seedance 2.5。不要让这两个说法混淆。
两个模型都生成音频吗?我能跨剧集保持同一个声音吗?
两者都在同一个通道中产生原生同步音频,H3 在每个结果上输出立体声。对于持久的声音,H3 最多接受三个音频参考,每个 2 到 15 秒,必须与图像或视频输入一起提交,而不能单独提交。
我实际上应该发送多少张参考图像?
比你想象的要少,结构比你想象的要好。一张精心组合的合成图通常胜过六张松散的裁切图,因为单独的文件会诱使模型将它们平均成一个不存在的人。给它两个明确的任务:身份和光照,并且不要包含相互冲突的风格样本。
我应该使用哪个模型来制作 TikTok 或 ReelShort 风格的竖屏短剧?
本周发货,9:16,高分辨率,声音已混好:MiniMax H3。如果计划一个 30 秒的连续场景,并且希望重新尝试单个区域而不是整段剪辑:为 Seedance 2.5 构建,并检查你的平台何时开放它。


