最新更新: Wan 3.0 已于 2026 年 8 月 24 日正式上线。
你为一个 15 秒广告建了一个文件夹。两张角色静态图。客户发来的一段品牌调性视频。一份仅以 PDF 形式存在的品牌手册。一段你真正想要的那位演员的声音样本。
然后你打开视频模型,它只要求一张图片。
于是你做了所有人都会做的事。你把文件夹翻译成一段 800 字的提示词,然后祈祷。第三镜时,脸变了。夹克颜色变了。声音也换成了另一个人。
Wan 3.0 的全参考功能是视频模型第一次说:好吧,把文件夹给我。单次调用最多 20 个素材,涵盖五种输入类型,通过一次连续 30 秒的镜头保持一致性。
这篇文章只做三件事,其余略过。它拆解了这 20 个素材到底是什么,以阿里巴巴自己生成的片段作为证据,并为你提供一个今天就能运行的等效工作流,因为 Wan 3.0 仍在阿里巴巴自家云上公开测试,且暂无法从第三方平台调用。
关键要点
- Wan 3.0 的多模态参考可在单次调用中接受最多 20 个素材,涵盖图像、视频、音频、文档和实时网页,并在一次 30 秒的镜头中保持一致性。
- 它是首个将 PDF、幻灯片或 URL 视为创意输入而非需要转述成提示词的主流视频模型。
- Wan 3.0 于 2026 年 8 月 6 日在阿里云百炼和通义千问云上以
wan3.0-video模型 ID 进入公开测试。权重封闭。任何告诉你它已经是 Apache 2.0 的人都是在猜测。 - 20 个素材的标题并非其真正领先之处。你现在就能调用的参考转视频模型已经能接受超过 20 个素材。差距在于文档和网页,而非数量。
- 你可以通过 Atlas Cloud 的免费 AI 广告短剧生成器免费测试双角色、参考锁定、全配音的格式:放入四张产品照片,输出一个 15 秒的语音短剧,无需付费。
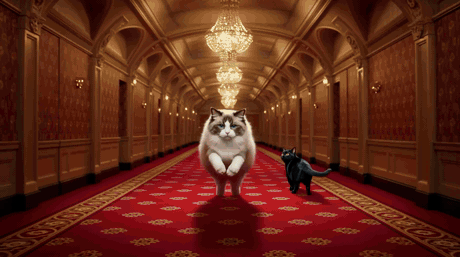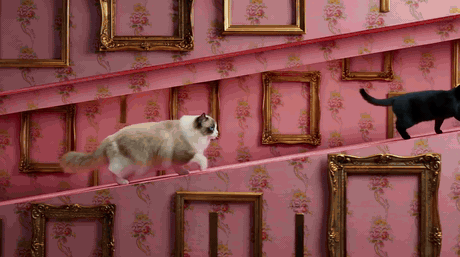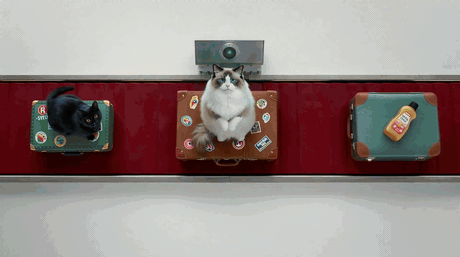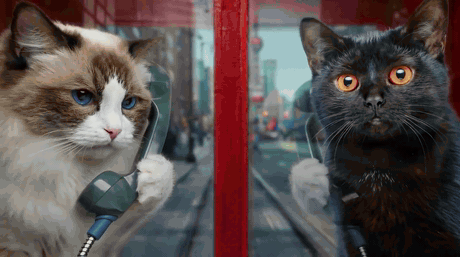
两只猫在五个不同场景中由 Wan 3.0 追逐,无角色漂移_两张参考图片。五个完全不同的场景,从酒店走廊到洗衣机滚筒再到红色电话亭。没有一帧漂移。来源:阿里巴巴官方_ Wan 3.0 创作者手册 ,2026 年 8 月,本文中所有其他 Wan 3.0 片段也来自此来源。
为什么多参考视频会失败,以及 Wan 3.0 多模态参考如何改变这一点
视频模型在片段之间没有记忆。每次生成都从零开始。这就是整个问题所在。
因此,一旦你的故事需要多个镜头,你就得拼接。第一镜给你一张你喜欢的脸。第二镜给你那张脸的亲戚。第三镜悄悄把夹克从李子色变成酒红色,等你注意到时,你已经付了十一次渲染的钱。
单图像参考有所帮助,但它只能锁定一件事。一张脸。它无法同时保持一张脸、一套服装、一个道具、一个地点和一个声音,因为只有一个位置,却有五个任务。
只有两条出路。给模型更多位置,或者不再让它重新开始。Wan 3.0 同时做到了这两点,这就是为什么两个标题功能实际上是一个功能。原生 30 秒镜头意味着没有剪切点让角色漂移。二十个参考素材意味着每个必须固定的元素都有自己专属的位置,而不是争抢一个。
以下就是当不需要拼接时的样子。三十秒,一个连续镜头,一个购物车里的孩子最终被嵌入广告牌,然后从下面走出来。
一次通过,无剪辑,30 秒完整画面,音轨在同一过程中生成。来源:阿里巴巴官方 Wan 3.0 创作者手册。
Wan 3.0 多模态参考中“20 个素材”的实际含义
二十是一个标题数字。重要的是这二十个并非都是同一种类型。Wan 3.0 的全参考覆盖五种输入类型,每种控制输出中的不同维度。
图像控制身份。 角色卡、产品照片、地点图。Wan 3.0 称之为像素级一致性,在阿里巴巴自己的示例中,锁定范围超出了面部,延伸到服装:层叠的灰色长袍、系带皮革背心、深色腰封,在跨越三个地点的十六秒徒手打斗中都能保持。
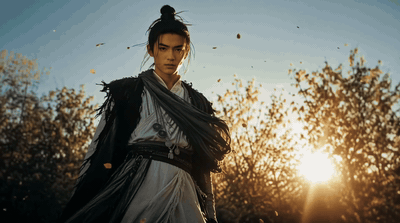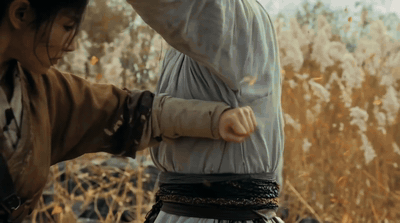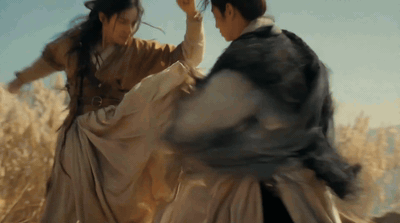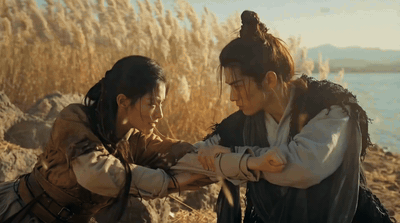
两张角色卡驱动武打场景,服装细节在帧与帧之间保持
两张角色卡加上一张芦苇岸边地点图。服装和场景在每一次投掷中保持。此处显示为静音 GIF;交付文件包含 44.1kHz 立体声混音。来源:阿里巴巴官方 Wan 3.0 创作者手册。
音频控制声音。 这是让“多模态”超越营销术语的部分。你为每个角色附加一段声音样本,在提示词中写好台词,对话就会以该音色返回,口型同步,与画面在同一过程中生成。两个人,两个声音参考,一个健身房。
两张主体图像加上两段独立的声音参考片段,对话以那两种声音返回。这个值得打开声音。来源:阿里巴巴官方 Wan 3.0 创作者手册。
视频控制节奏。 参考视频不是为了复制。它是为了提供节奏:一个节拍持续多久,一个转场如何移动。在这个例子中,五个关键帧提供主体,一个参考视频提供它们之间的水平翻牌节奏。
五个关键帧通过参考视频的节奏翻转_五个_ 关键帧图像用于主体,一个参考视频用于翻转节奏。来源:阿里巴巴官方 Wan 3.0 创作者手册。
文档和网页控制结构。 这是真正新颖的部分。Wan 3.0 接受文档文件和实时 URL 作为创意输入,测试版报告列出了 .doc、.xls、.ppt、.pdf 和 .txt 作为接受的格式(AlphaSignal,2026 年 8 月)。同样的逻辑也适用于分镜图:一张分镜图输入,六个镜头输出,按照分镜图本身的顺序。
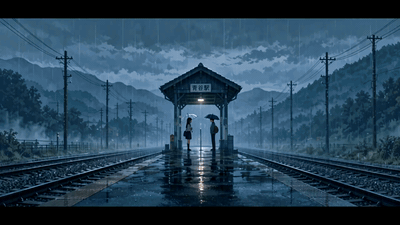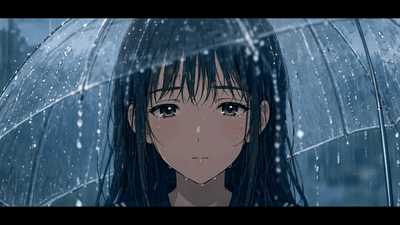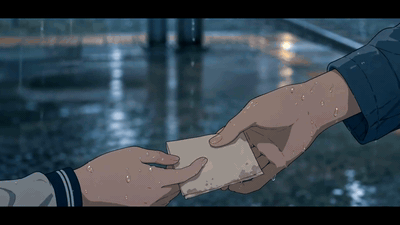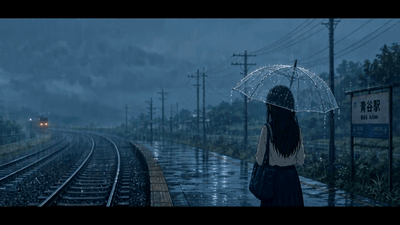
一张分镜图扩展为雨夜火车站的六个连续镜头
一张分镜图作为参考,按顺序生成六个镜头,直到第五镜中传递纸条的手。来源:阿里巴巴官方 Wan 3.0 创作者手册。
首帧和尾帧控制端点。 最古老的方法,仍然支持,仍然是限定镜头最快的方式。
以下是它与大多数人今天实际使用的版本的对比。
| Wan 2.7 参考转视频 | Wan 3.0 全参考 | |
|---|---|---|
| 参考素材 | 每主体一张图像,最多 3 个视频,1 个语音片段 | 总计最多 20 个素材 |
| 模态 | 图像、视频、音频 | 图像、视频、音频、文档、网页 |
| 单次通过最大时长 | 10 秒 | 原生 30 秒,加上智能时长 |
| 同一过程中的音频 | 是 | 是 |
| 视频编辑与扩展 | 未暴露 | 基于指令和参考的编辑,加上扩展 |
| 可用性 | 在第三方 API 上可用 | 阿里云百炼和通义千问云测试版 |
有一条规则没人写在文档里,但每个人都会通过艰难的方式学到:一个参考,一个任务。 图像1 锁定面部和服装。视频1 仅提供运动。音频1 仅提供音色。一旦你给单个素材分配两个冲突的任务,或者上传一张包含两个人的参考图像,模型就必须猜测,而猜测正是你试图阻止的事情。阿里巴巴的手册对此也直言不讳:每张参考图像一个主体。
你今天就能运行的 Wan 3.0 多模态参考工作流
先直接回答。Wan 3.0 在阿里巴巴自家云上公开测试,模型 ID 为 wan3.0-video(阿里巴巴 Wan,2026 年 8 月)。它尚未登陆第三方 API 平台,包括 Atlas Cloud。现在任何向你出售 Wan 3.0 API 访问权限的人都是在转售其他东西。
已经落地的是工作流形态。参考包输入,一次调用,带声音的完整片段输出。这在今天就可以通过浏览器标签页调用的参考转视频模型上运行,一旦你把它们一一排列好,20 个素材的标题看起来就不一样了。
| 模型 | 参考素材 | 模态 | 最大时长 | 原生音频 | 每秒价格 |
|---|---|---|---|---|---|
| Wan 3.0(阿里巴巴测试版,不在 Atlas 上) | 总计 20 个 | 图像、视频、音频、文档、网页 | 30 秒 | 是 | 据报告按分辨率 $0.05 至 $0.20 |
| Wan 2.7 参考转视频 | 每主体 1 张图像,3 个视频,1 个语音片段 | 图像、视频、音频 | 10 秒 | 是 | $0.10 |
| Seedance 2.5 参考转视频 | 50 个(30 图像 / 10 视频 / 10 音频) | 图像、视频、音频 | 30 秒 | 是 | $0.13 |
| MiniMax H3 参考转视频 | 混合,无明确上限 | 图像、视频、音频 | 15 秒 | 是 | $0.10 |
| Kling Video O3 Pro 参考转视频 | 7 张图像,或 4 张图像 + 1 个视频 | 图像、视频 | 15 秒 | 是 | $0.10 |
| Vidu Q3-Mix 参考转视频 | 4 张图像 | 图像 | 16 秒 | 是 | $0.11 |
| Veo 3.1 参考转视频 | 3 张图像 | 图像 | 8 秒 | 可选 | $0.20 |
价格是截至 2026 年 8 月的 Atlas Cloud 费率。Wan 3.0 的数字是阿里云测试版报告的,并非 Atlas 费率,且阿里巴巴尚未发布该模型的公开价格页面,因此该行数据为暂定。
把表格读两遍,真实情况就显现了。20 个素材的标题并非 Wan 3.0 领先之处,因为 Seedance 2.5 已经能接受 50 个并达到 30 秒。而该列表中其他模型都无法接受的是 PDF。
以下演示中,工作流在 Wan 2.7 参考转视频上运行,因为它的输入形态与全参考最接近:多个主体图像、一个可选的参考视频和一个语音片段,全部映射到提示词中的 character1 和 character2 标签。三个模型,一个浏览器标签页,无需本地安装。
对于当前托管的运行,在发布工作流之前,打开 Atlas Cloud 上的 Wan 3.0 并测试类似下面的提示词。
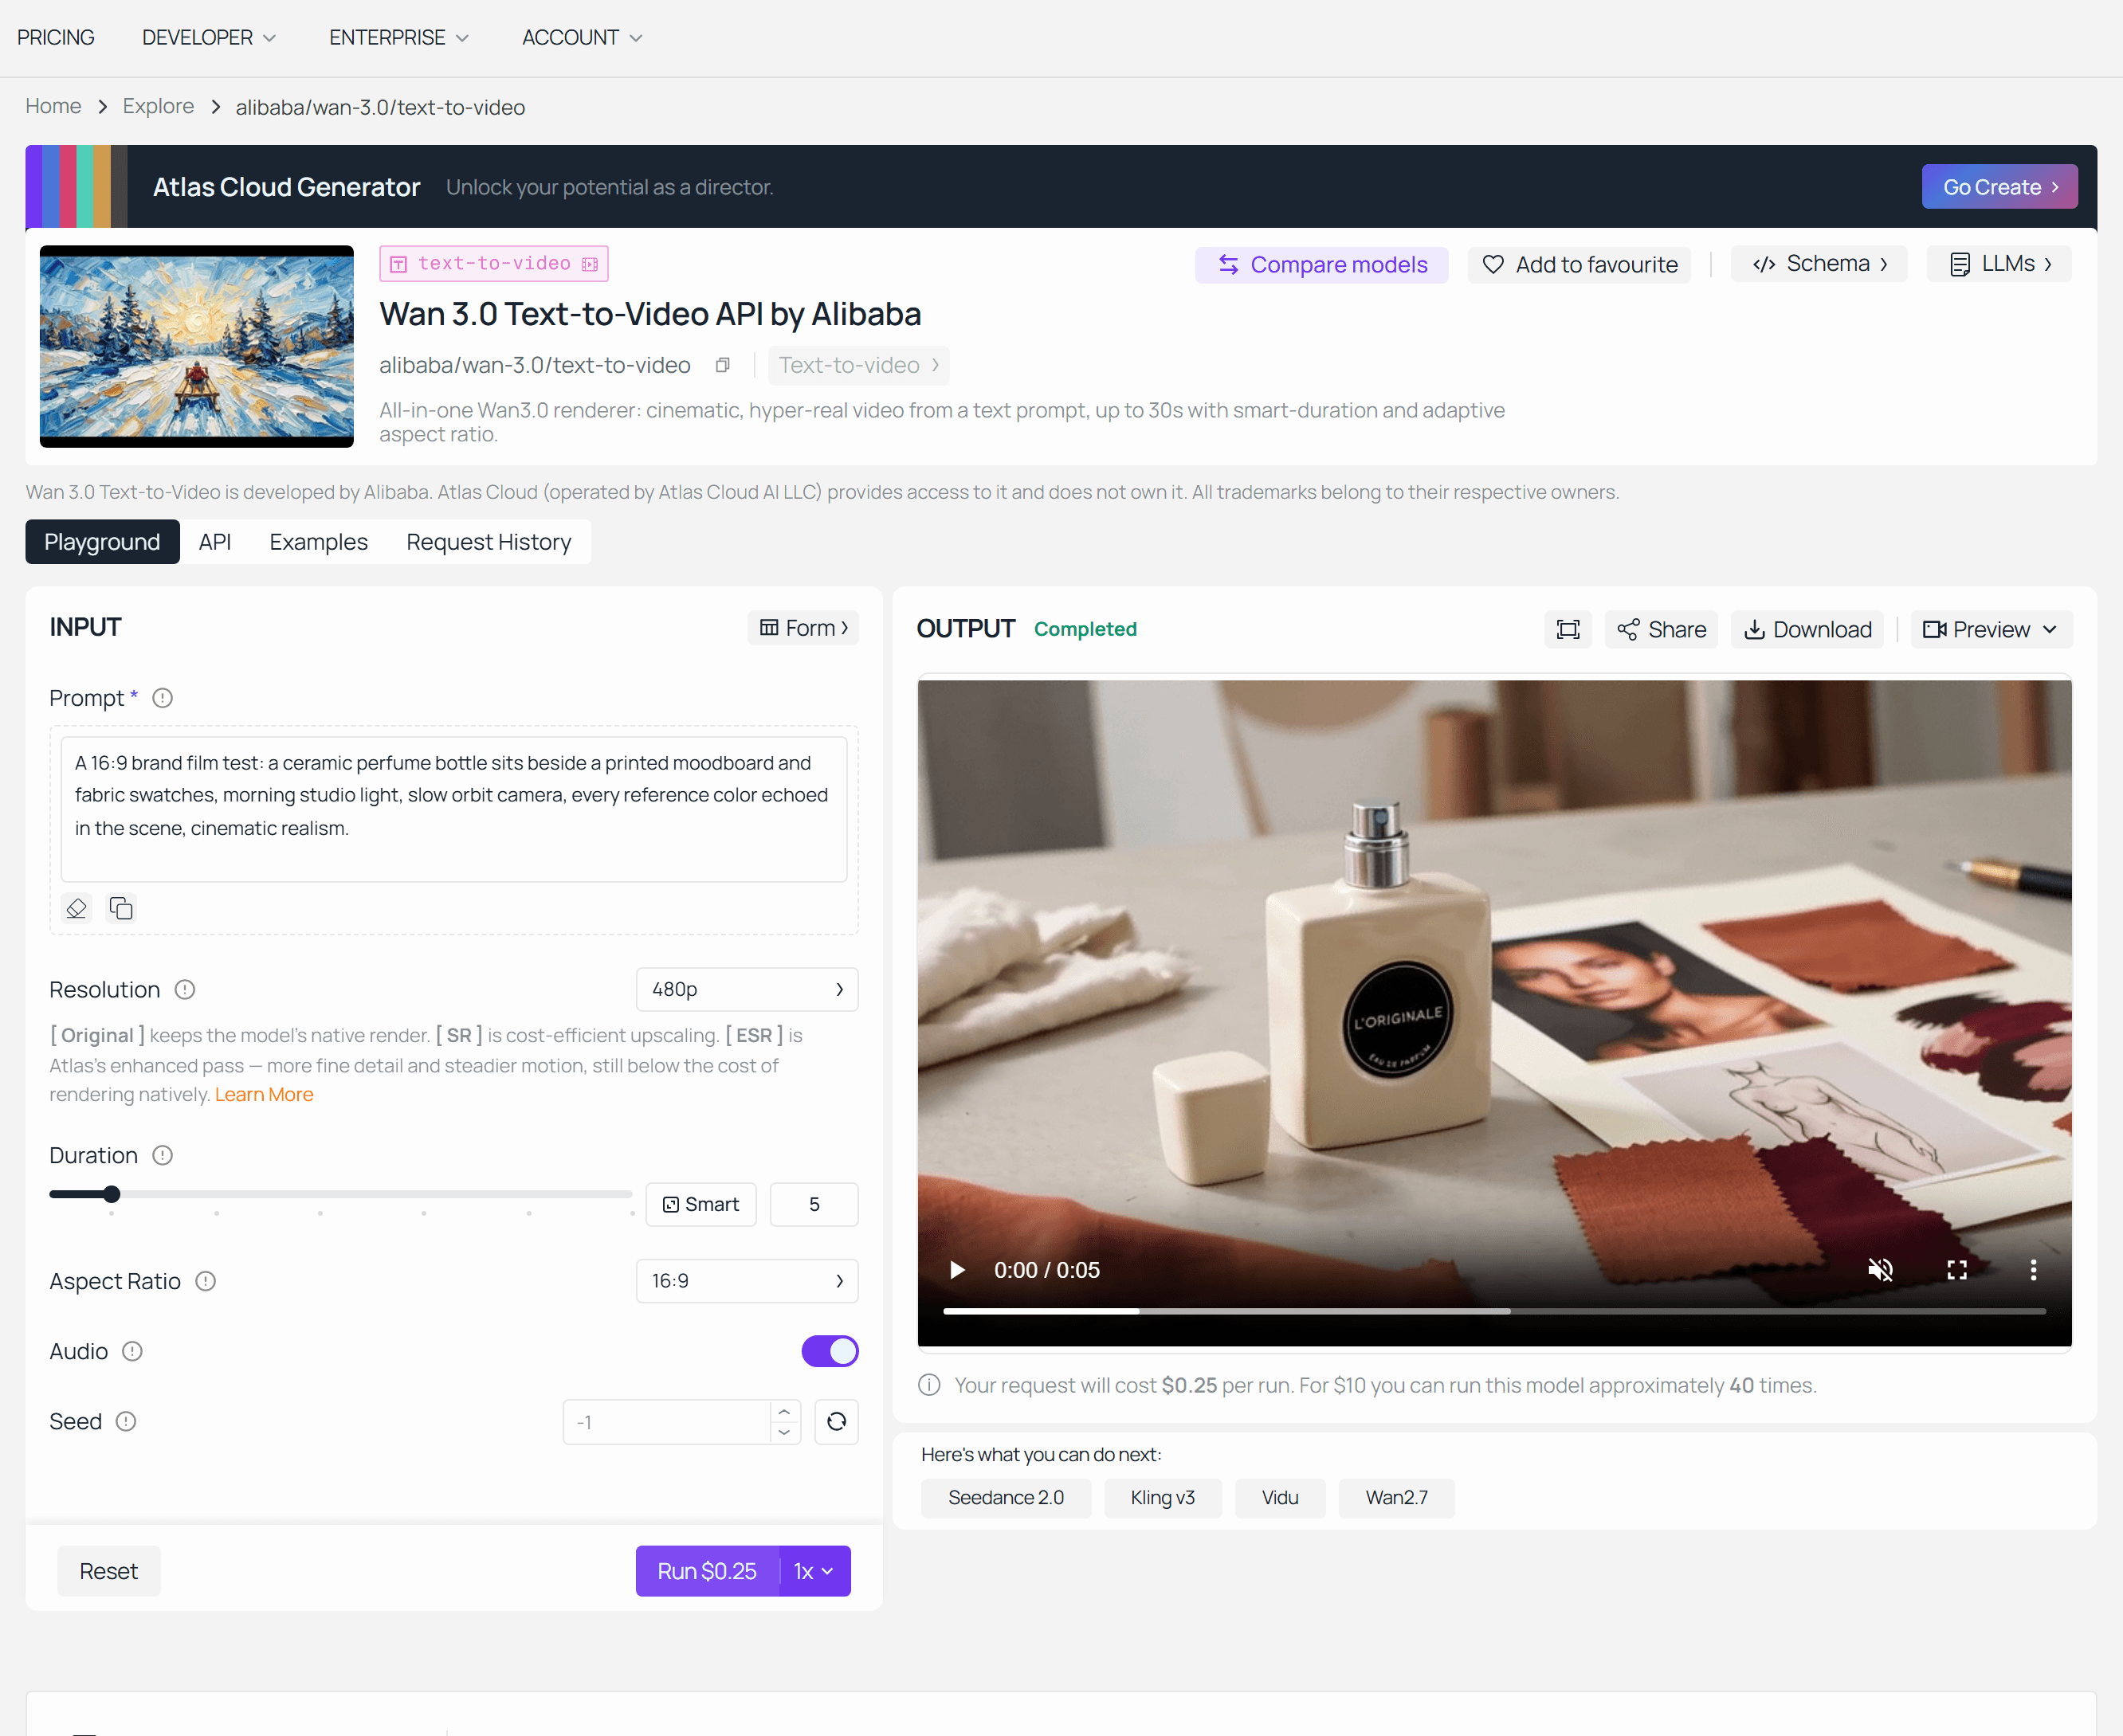
Wan 3.0 提示词转结果截图:20 参考品牌交接。
自己构建:四步完成多模态参考场景
场景:一个柔和色调的酒店前台。一个面无表情的礼宾员。一位抱着布偶猫的旅客。礼宾员直视镜头说:“猫有预订。你没有。”
两张图像加一段语音片段,这是跨两个模态的三个参考素材。这是真正多模态而非仅多图像的最小构建。
第一步:生成参考图像 1,必须锁定的主体
参考图像只有三个任务且只有三个:一个主体,面向相机,干净背景。其他都是装饰。使用 GPT Image 2,质量 high,尺寸 16:9,n=1。
Plain1一位中年酒店礼宾员全身工作室肖像照,面无表情,正对镜头居中站立,背景为平坦的灰粉色墙壁。他身穿李子紫双排扣侍者制服,配金色滚边和黄铜纽扣,头戴小圆药盒帽,留着小胡子。完美对称构图,均匀柔和的正面光,墙上无投影,35mm 胶片颗粒感,柔和粉彩调色板。仅一个主体,无其他人,无文字,无标志,画面中无道具。 2
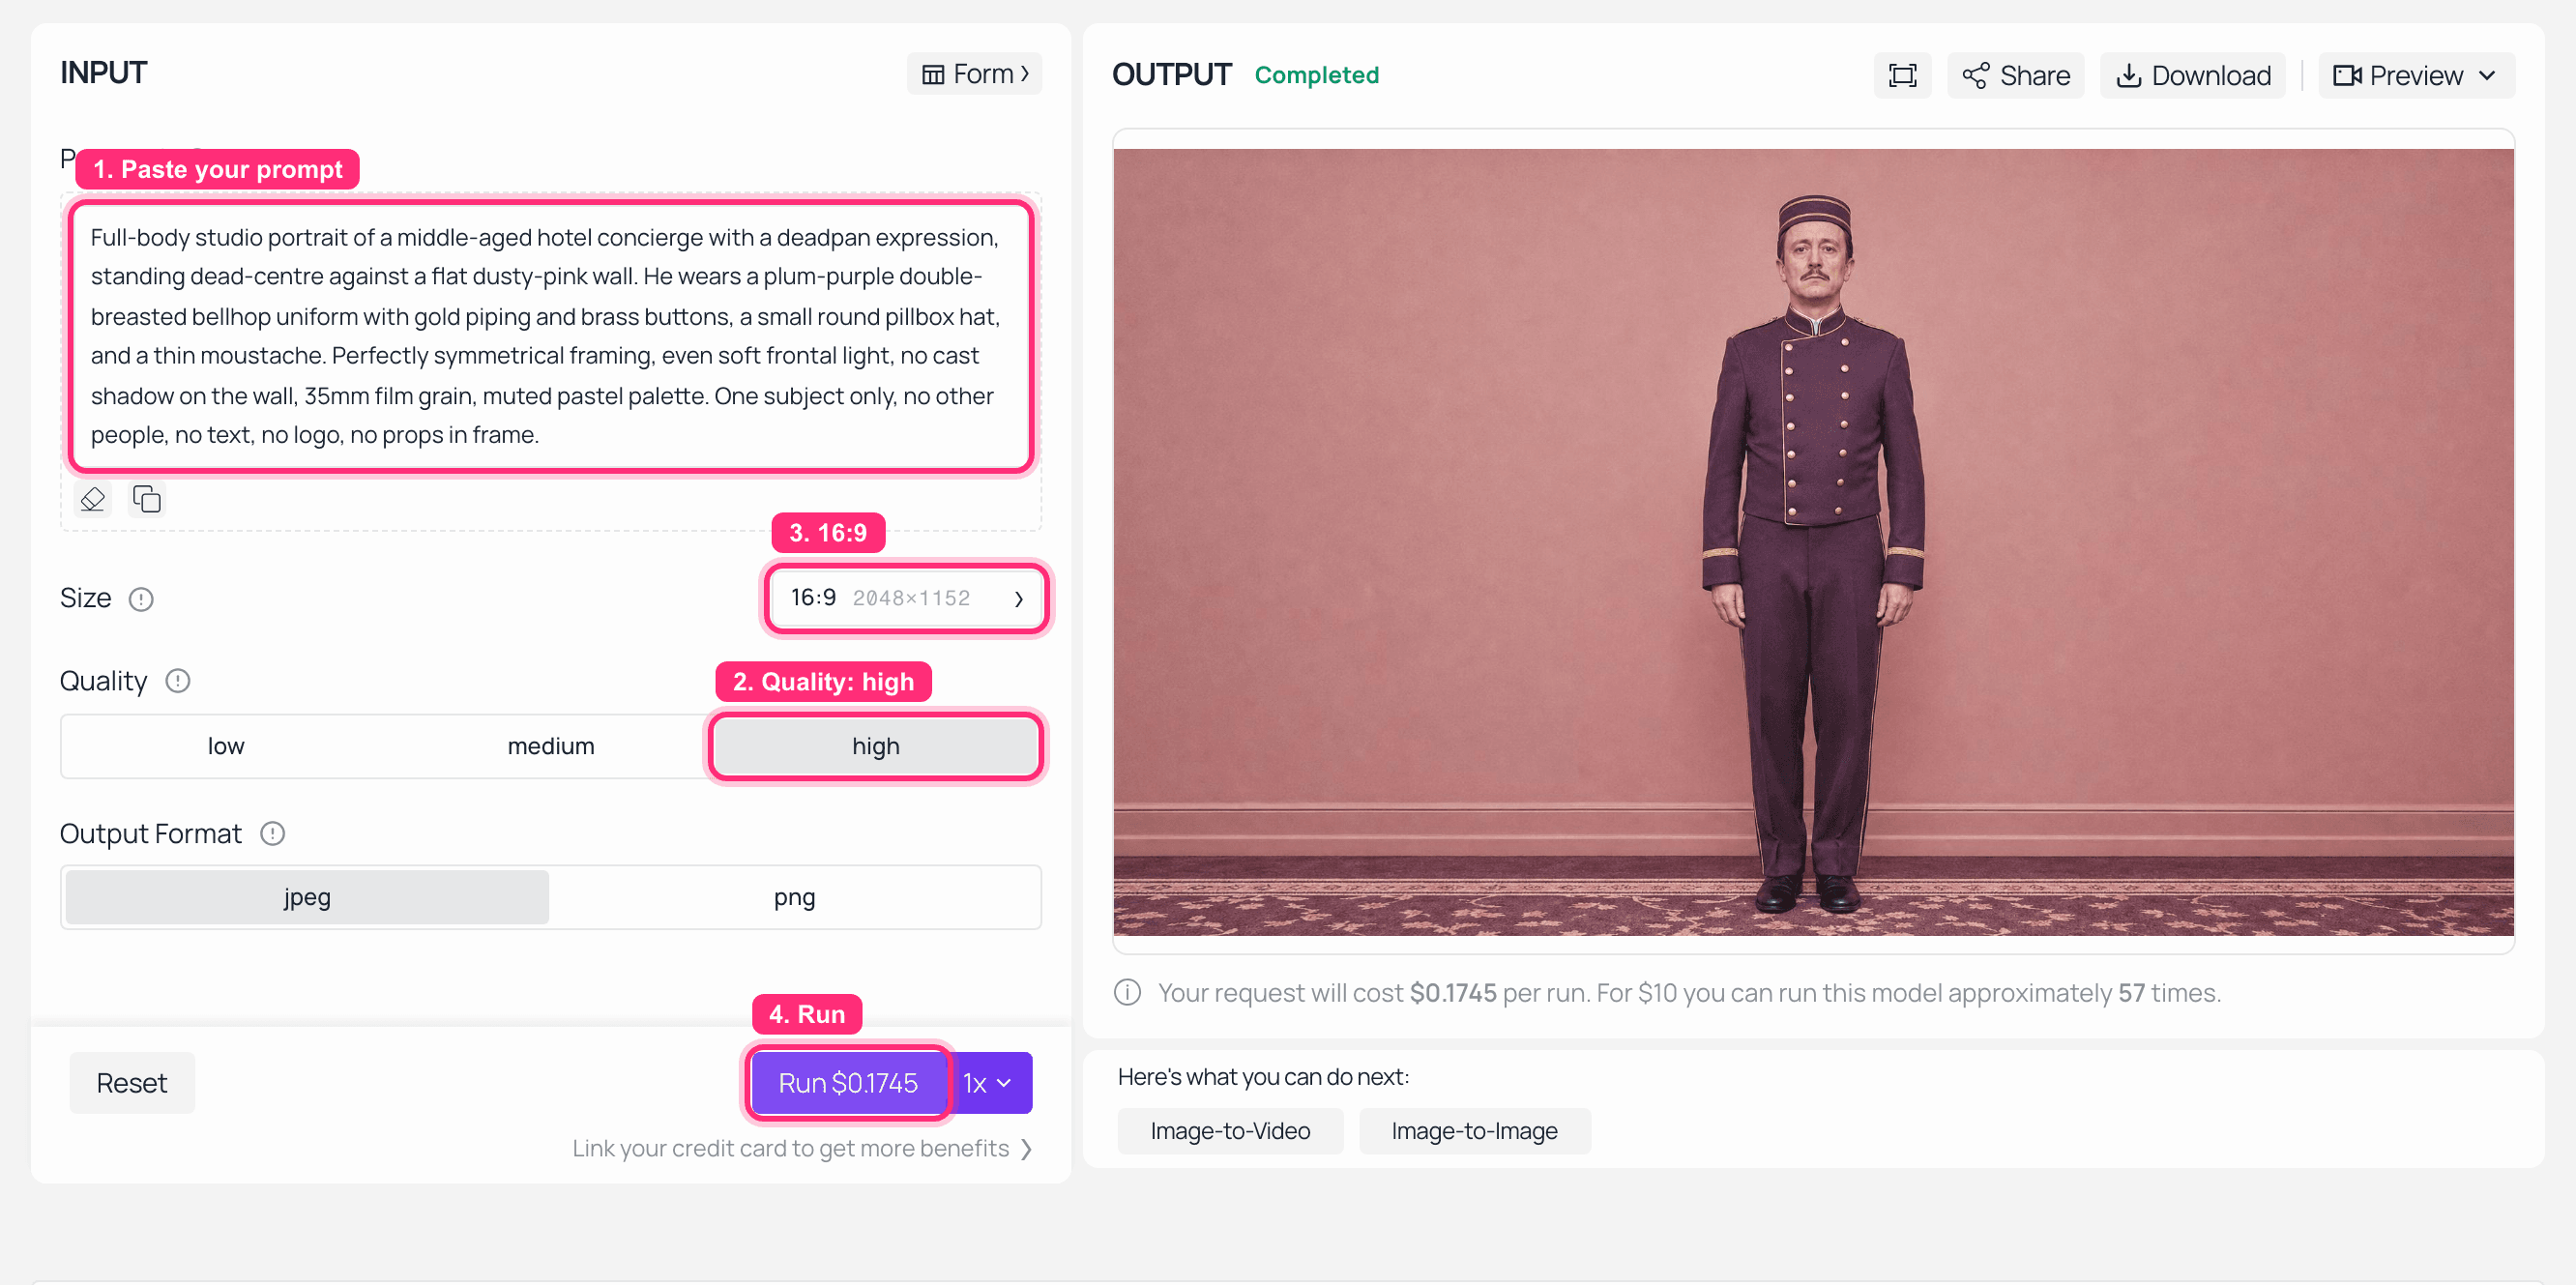
Atlas Cloud 上的 GPT Image 2 工作区,输出面板中渲染了礼宾员参考肖像
Atlas Cloud 上的 GPT Image 2:质量高,16:9,一个主体,平坦背景。这是将变成 character1 的文件。
第二步:生成参考图像 2,第二个锁定主体
相同模型,相同设置。两个角色之间的颜色对比是有意为之,因为当它们共享一个画面时,这为模型提供了轻松区分它们的方法。
Plain1一位年轻女旅行者全身工作室肖像照,将一只毛茸茸的布偶猫抱在胸前,正对镜头居中站立,背景为平坦的芥末黄墙壁。她身穿芥末色羊毛大衣,头戴红色贝雷帽,戴圆形玳瑁眼镜,空着的手提着一只小复古皮箱。完美对称构图,均匀柔和的正面光,墙上无投影,35mm 胶片颗粒感,柔和粉彩调色板。仅一个主体,无其他人,无文字,无标志。 2
第三步:生成语音参考,这是真正的多模态部分
语音片段将这项工作从多图像工作转变为多模态工作。Wan 2.7 的音频位置需要一段短样本,大约 1 到 10 秒,所以保持台词简短。使用 MiniMax Speech 2.6 HD,选择一个低沉、平坦、不慌不忙的男性声音。
Plain1晚上好。办理入住?当然。每个人都有。 2
第四步:一次调用,三个参考,一个完成的片段
现在整个包一起进入 Wan 2.7 参考转视频。设置:resolution: 1080P,ratio: 16:9,duration: 10(这是该模型的上限),prompt_extend: false,seed: -1。按顺序加载 images,第一步的图片在前,这样它映射到 character1,然后第二步作为 character2,并将第三步的文件附加到 audio。
Plain1对称、正对镜头居中的广角镜头,展现柔和色调的酒店大堂前台,灰粉色墙壁和后面的芥末色钥匙架。character1 是站在柜台后面的礼宾员;character2 是站在柜台前的旅客,仍然抱着她的布偶猫。摄像机沿着完美中心轴线缓慢推进,从不倾斜。character1 直视镜头,平淡地说:“猫有预订。你没有。”character2 眨了一下眼,慢慢转向猫,然后回到柜台。猫盯着镜头,一动不动。35mm 胶片颗粒感,均匀柔和的照明,柔和粉彩调色板,无摄像机抖动,无剪辑。 2
负面提示词:
Plain1手持抖动,跳切,字幕,屏幕文字,水印,额外人物,变形的手,面部变形,颜色偏移,运动模糊 2
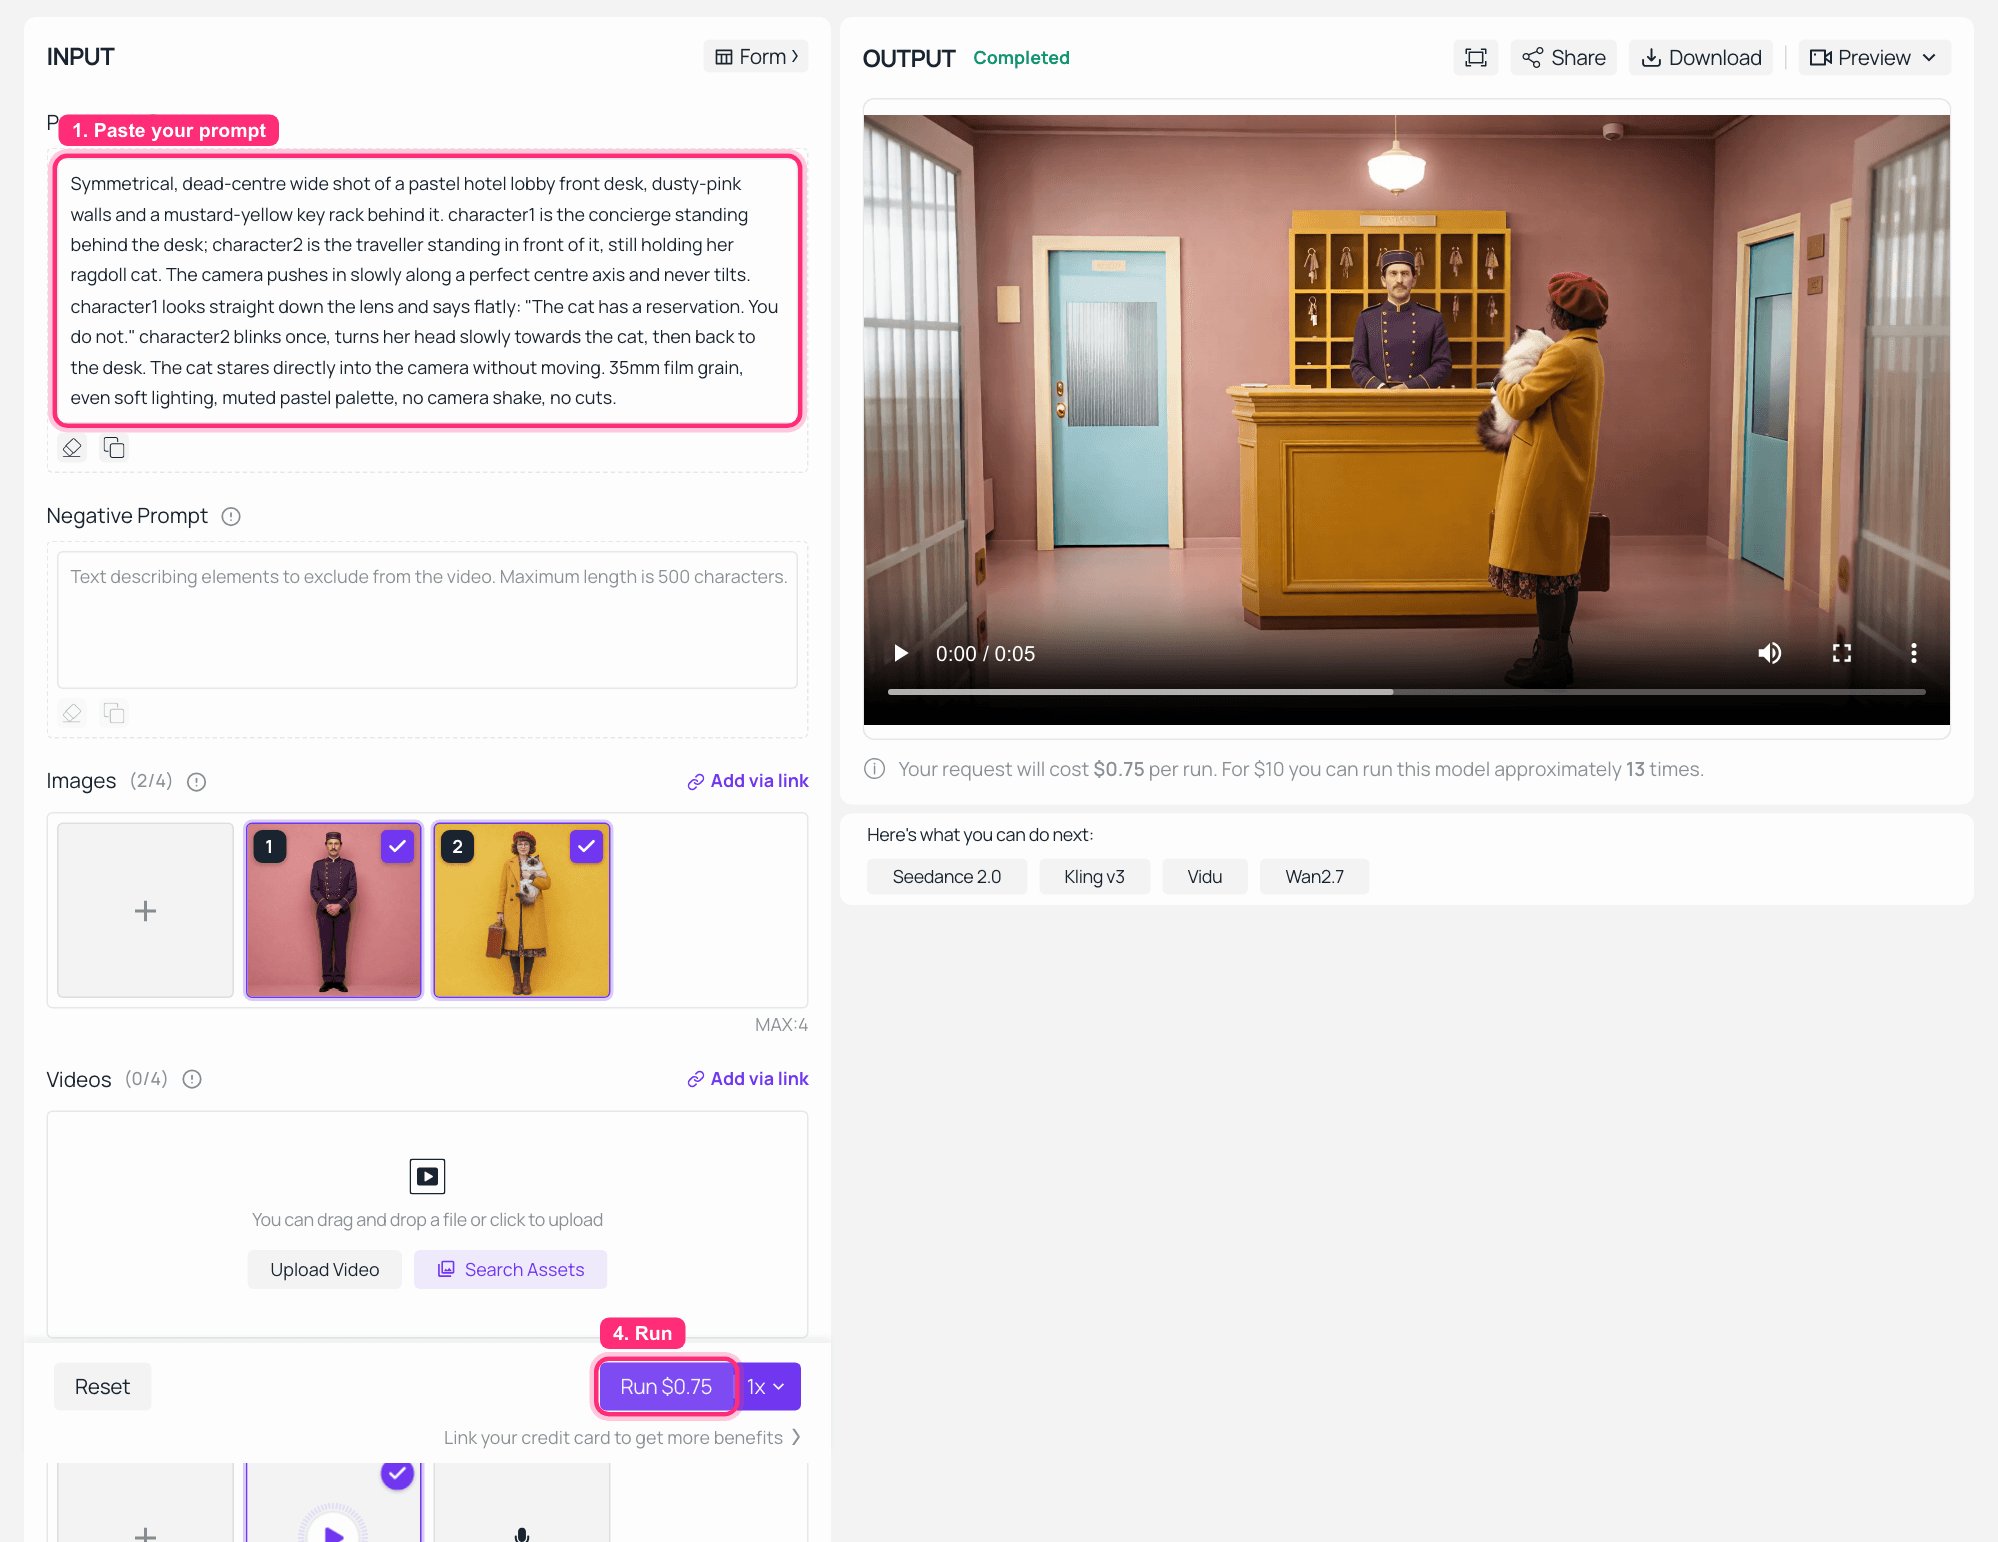
Atlas Cloud 上的 Wan 2.7 参考转视频工作区,加载了两张参考图像和一个音频文件,输出面板中显示完成的片段
Atlas Cloud 上的 Wan 2.7 参考转视频:左侧附加了两张参考图像和一个语音片段,右侧以 1080P 和 16:9 播放完成的镜头。此截图以模型默认时长运行;将其设置为 10 以获得下面的完整版本。
完成的片段。两张脸都保持,两套服装都保持,台词以第三步中克隆的声音说出,所以这个值得打开声音播放。
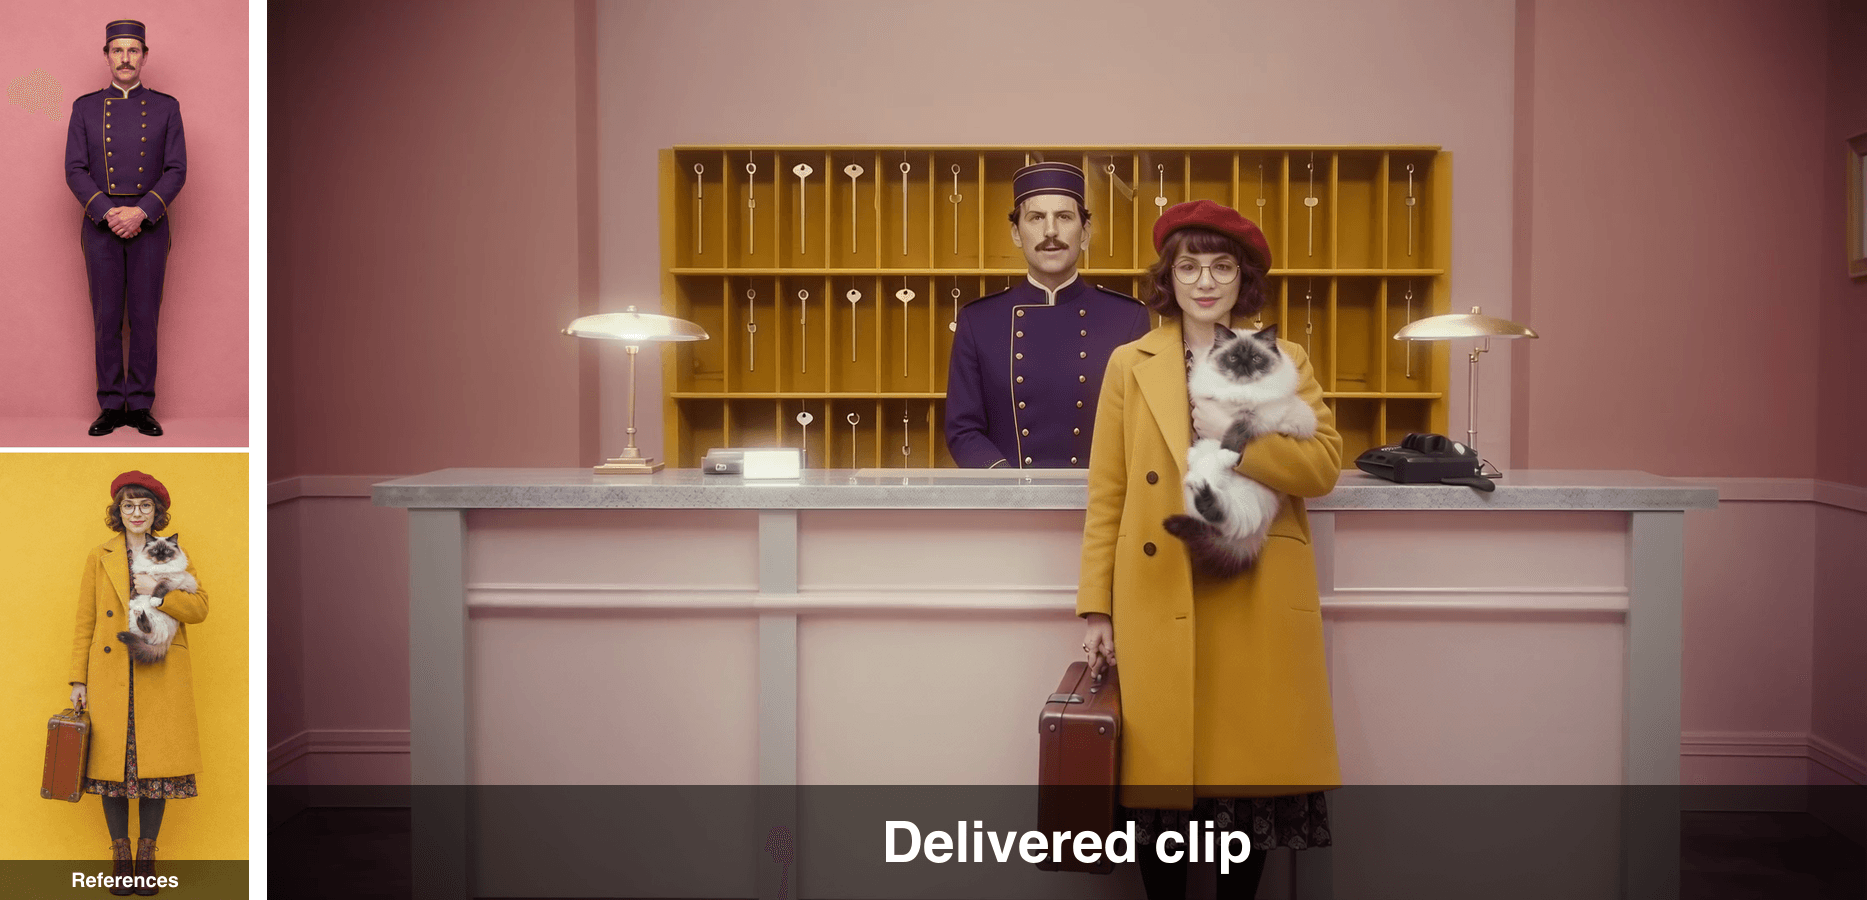
两张参考肖像与完成片段的一帧并排显示,显示相同的面孔和服装
左侧参考图片,右侧交付片段的一帧。制服滚边、贝雷帽、眼镜和猫都完好无损地保留下来。
Wan 3.0 多模态参考工作流的变体
扩展到 30 秒。 相同的参考包可以在 Seedance 2.5 参考转视频 上运行,duration: 30,这样无需等待测试版就能获得 Wan 3.0 承诺的时长。它最多可接受 30 张参考图像、10 个视频和 10 个音频片段,因此参考包有增长空间。将额外的 20 秒写成提示词中的节拍,而不是氛围,否则模型会填充空白。
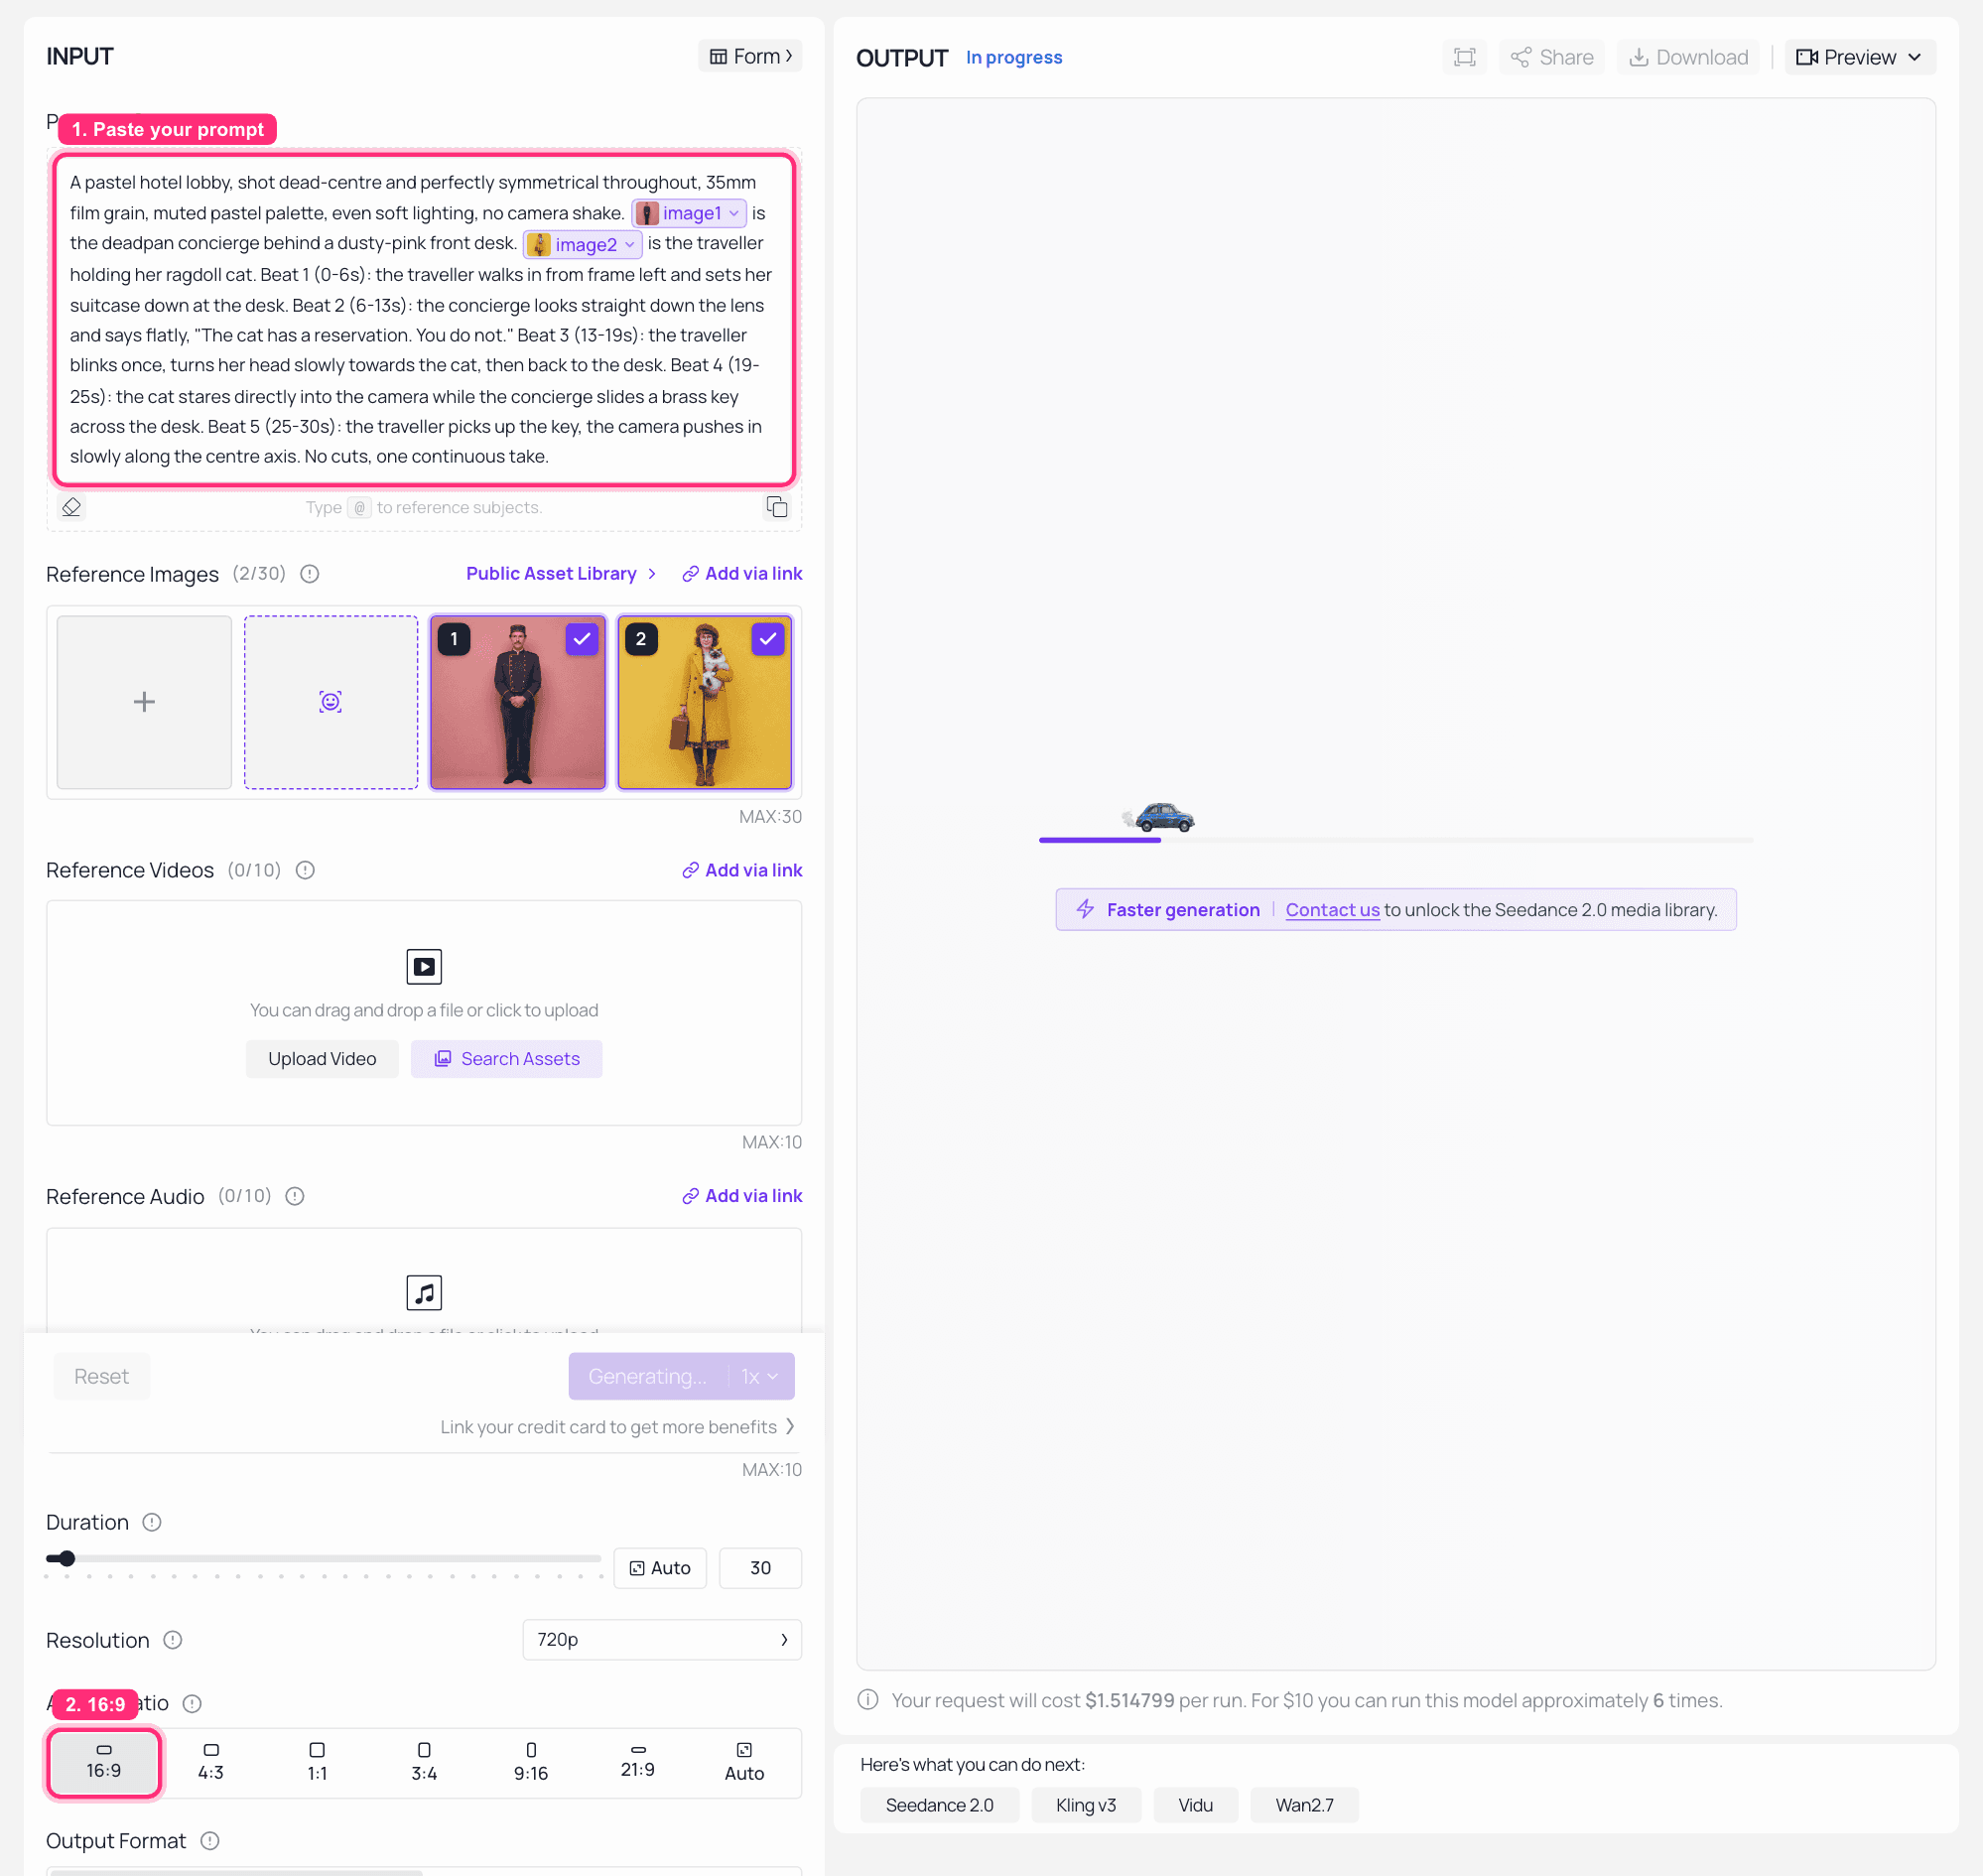
Atlas Cloud 上的 Seedance 2.5 参考转视频工作区,时长设置为 30,长镜头正在渲染
Atlas Cloud 上的 Seedance 2.5 参考转视频,时长设置为 30,附加了相同的两张参考肖像,捕捉到生成过程中。注意提示词中的 @image1 和 @image2 标签:这就是你告诉 Seedance 哪个参考扮演哪个部分的方式。在提交前检查“运行”按钮上的报价价格,因为它反映了作业实际将提交的时长。
同一场景的 30 秒版本,相同参考包,节拍逐镜头写出。
添加参考视频仅用于运动。 附上一个你喜欢的节奏的片段,并在提示词中明确说明,比如“仅跟随参考视频的剪辑节奏,忽略其主体和场景”。这就是上面翻牌示例背后的技巧。
在调整正面提示词之前,先用负面提示词修复漂移。 面部变形、颜色偏移和手持抖动是破坏参考锁定镜头的三个主要因素,它们通常比通过正面描述来抑制更便宜。
免费尝试多模态参考格式
如果你想要这种形式但暂不需要参数,Atlas Cloud 上周发布了一个免费的 AI 广告短剧生成器,它运行相同的链,但没有任何旋钮。
你只需写一行关于你的产品和卖点的文字。它会为你编写一个双角色喜剧剧本,包含钩子、冲突、转折,然后渲染出一个 15 秒的视频,内置对话和音效。你可以附加最多四张真实产品照片作为参考,广告会从脚本到最终帧一直保持它们的形状、颜色、标签和标志。附带六种风格,从搞笑表情包到情节转折、情景喜剧、奢华和硬销售,对话会以你写描述时使用的语言返回。
这就是教程中相同的双角色加参考图像加语音链,省去了提示词编写和费用。这使得它成为在花钱调整之前,了解这种格式是否适合你的产品的一个不错方式。
要了解一堆参考静态图对产品片段的作用,以下是 Wan 3.0 自己对该任务的版本:五张图像输入,一个发布视频输出,每张静态图锚定编辑中的一个节拍。
五张参考静态图扩展为 Material Design 风格的产品发布视频_五张参考图像驱动一个九秒的产品短片,每张锚定一个节拍并传递给下一张。来源:阿里巴巴官方 Wan 3.0 创作者手册。_
Wan 3.0 多模态参考片段的成本
| 步骤 | 模型 | 单价 | 数量 | 成本 |
|---|---|---|---|---|
| 1 和 2,两张参考图像 | GPT Image 2 | 每张 $0.009 | 2 | $0.02 |
| 3,语音参考 | MiniMax Speech 2.6 HD | 每千字符 $0.08 | 49 字符 | $0.00 |
| 4,10 秒 1080P 片段 | Wan 2.7 参考转视频 | 1080P 每秒 $0.15 | 10 秒 | $1.50 |
| 教程总计 | 约 $1.52 | |||
| 变体,30 秒 | Seedance 2.5 参考转视频 | 480P 每秒 $0.134 | 30 秒 | 约 $4.02 |
| 免费路线 | 免费 AI 广告短剧生成器 | 免费 | 1 个片段,15 秒 | $0 |
这些是平台自己的费率,于 2026 年 8 月检查,按量付费。有两件事比你预期的更能影响总成本。首先是分辨率:对比表中的每秒 $0.10 是 Wan 2.7 的基础费率,1080P 收费 $0.15,这就是上面 $1.50 的来源。其次是 Seedance 按像素数定价,因此其列出的每秒 $0.134 是 480P 的数字,720P 片段的成本比简单的乘法计算更高。作为参考,据报告 Wan 3.0 测试版 1080p 的费率为每秒 $0.20,这将使完整的 30 秒片段成本约为 $6,高于今天的 480P Seedance 路线。
关于使用这些内容的一个说明。 Wan 3.0 是测试版,其条款可能变化,因此在构建管道之前请重新阅读。如果你的参考图像是真人,请事先获得他们的许可,因为参考转视频正是使这一点重要的能力。本文中的示例片段是阿里巴巴从其公开创作者手册中自行生成的结果,此处为评论目的而转载。
常见问题
Wan 3.0 的多模态参考实际上能接受多少个参考?
单次调用最多 20 个素材,来自图像、视频、音频、文档和网页。实际限制低于技术限制。为每个素材分配恰好一个任务,每张图像一个主体,对于大多数场景,你将使用远少于 20 个。
Wan 3.0 真的能将 PDF 或网页转化为视频吗?
是的,这是真正独特的部分。除了文本、图像、音频和视频,它还接受文档文件和实时 URL,测试版报告列出了 .doc、.xls、.ppt、.pdf 和 .txt。上述对比表中没有其他参考转视频模型能接受文档。
Wan 3.0 是开源的吗?我能在 ComfyUI 中运行它吗?
不能,目前不行。Wan 3.0 是在阿里巴巴自家云上运行的封闭测试版。早期的 Wan 代是开放发布的,这就是期望存在的原因,但阿里巴巴尚未确认 3.0 的权重。声称 Wan 3.0 有 1.3B 或 14B Apache 2.0 版本的页面没有任何官方支持。
Wan 3.0 现在可以通过第三方 API 使用吗?
还没有,包括 Atlas Cloud。你今天能调用的最接近的是 Wan 2.7 参考转视频,其输入形态几乎与全参考完全匹配,除了文档和网页模态,或者如果你需要完整的 30 秒,可以使用 Seedance 2.5 参考转视频。
测试参考锁定、双角色视频的最便宜方法是什么?
上面链接的免费 AI 广告短剧生成器。放入四张参考照片,输出一个 15 秒的语音双角色片段,无需参数,无需花费。如果它能保持你的产品和格式,那么再去调整付费链。
为什么即使有参考图像,我的角色仍然会漂移?
三个原因,按频率排序。一个参考承担了两个任务,因此被要求同时固定面部和地点。参考图像中有多个人或复杂背景,因此模型不知道锁定哪个部分。或者漂移是渲染伪影而非参考失败,在这种情况下,在重写任何内容之前,将 face morphing, colour shift 放入负面提示词。


