

你的浓缩咖啡已经凉了,羊角面包只剩一半,而回复仍然显示三个灰色的点。如果你在问 为什么 ChatGPT 这么慢,答案取决于等待发生在哪里:在你的浏览器标签页、你的网络,还是 OpenAI 的服务器。每种情况都有不同的解决办法,而流行的建议(清除缓存)只对第一种有帮助。
我们在同一台笔记本电脑上,对一段很长的 ChatGPT 对话和一段全新对话进行了计时,查阅了 OpenAI 自己的发布说明以了解 2026 年的变化,并将每种解决办法与其真正解决的问题对应起来。
要点
- ChatGPT 回复缓慢通常停滞在三个位置之一:你的浏览器、你的网络或 OpenAI 的服务器。
- 在我们的测试中,长对话的回复速度与全新对话一样快,但其打开的标签页内存增长超过 900 MB。
- 自 2026 年 9 月 14 日起,Plus 和 Pro 不再从 Instant 自动切换到 Thinking,因此你选择的模式基本决定了等待时间。
- OpenAI 状态页面上有未解决的 ChatGPT 事件就意味着延迟在他们那边,浏览器端的修复不会有帮助。
- 对于长文档,Atlas Cloud 上的 OpenAI 模型_ 通过 API 流式返回答案,只传输你发送的内容。_
为什么 ChatGPT 这么慢?回复卡住的三个地方
每个 ChatGPT 回答都是一次往返。你的问题离开浏览器,穿过你的网络,由 OpenAI 服务器上的模型处理,然后流式返回一个必须渲染它的页面。从你的座位上看,任何一站的延迟感觉都一样:光标闪烁,没有文字。
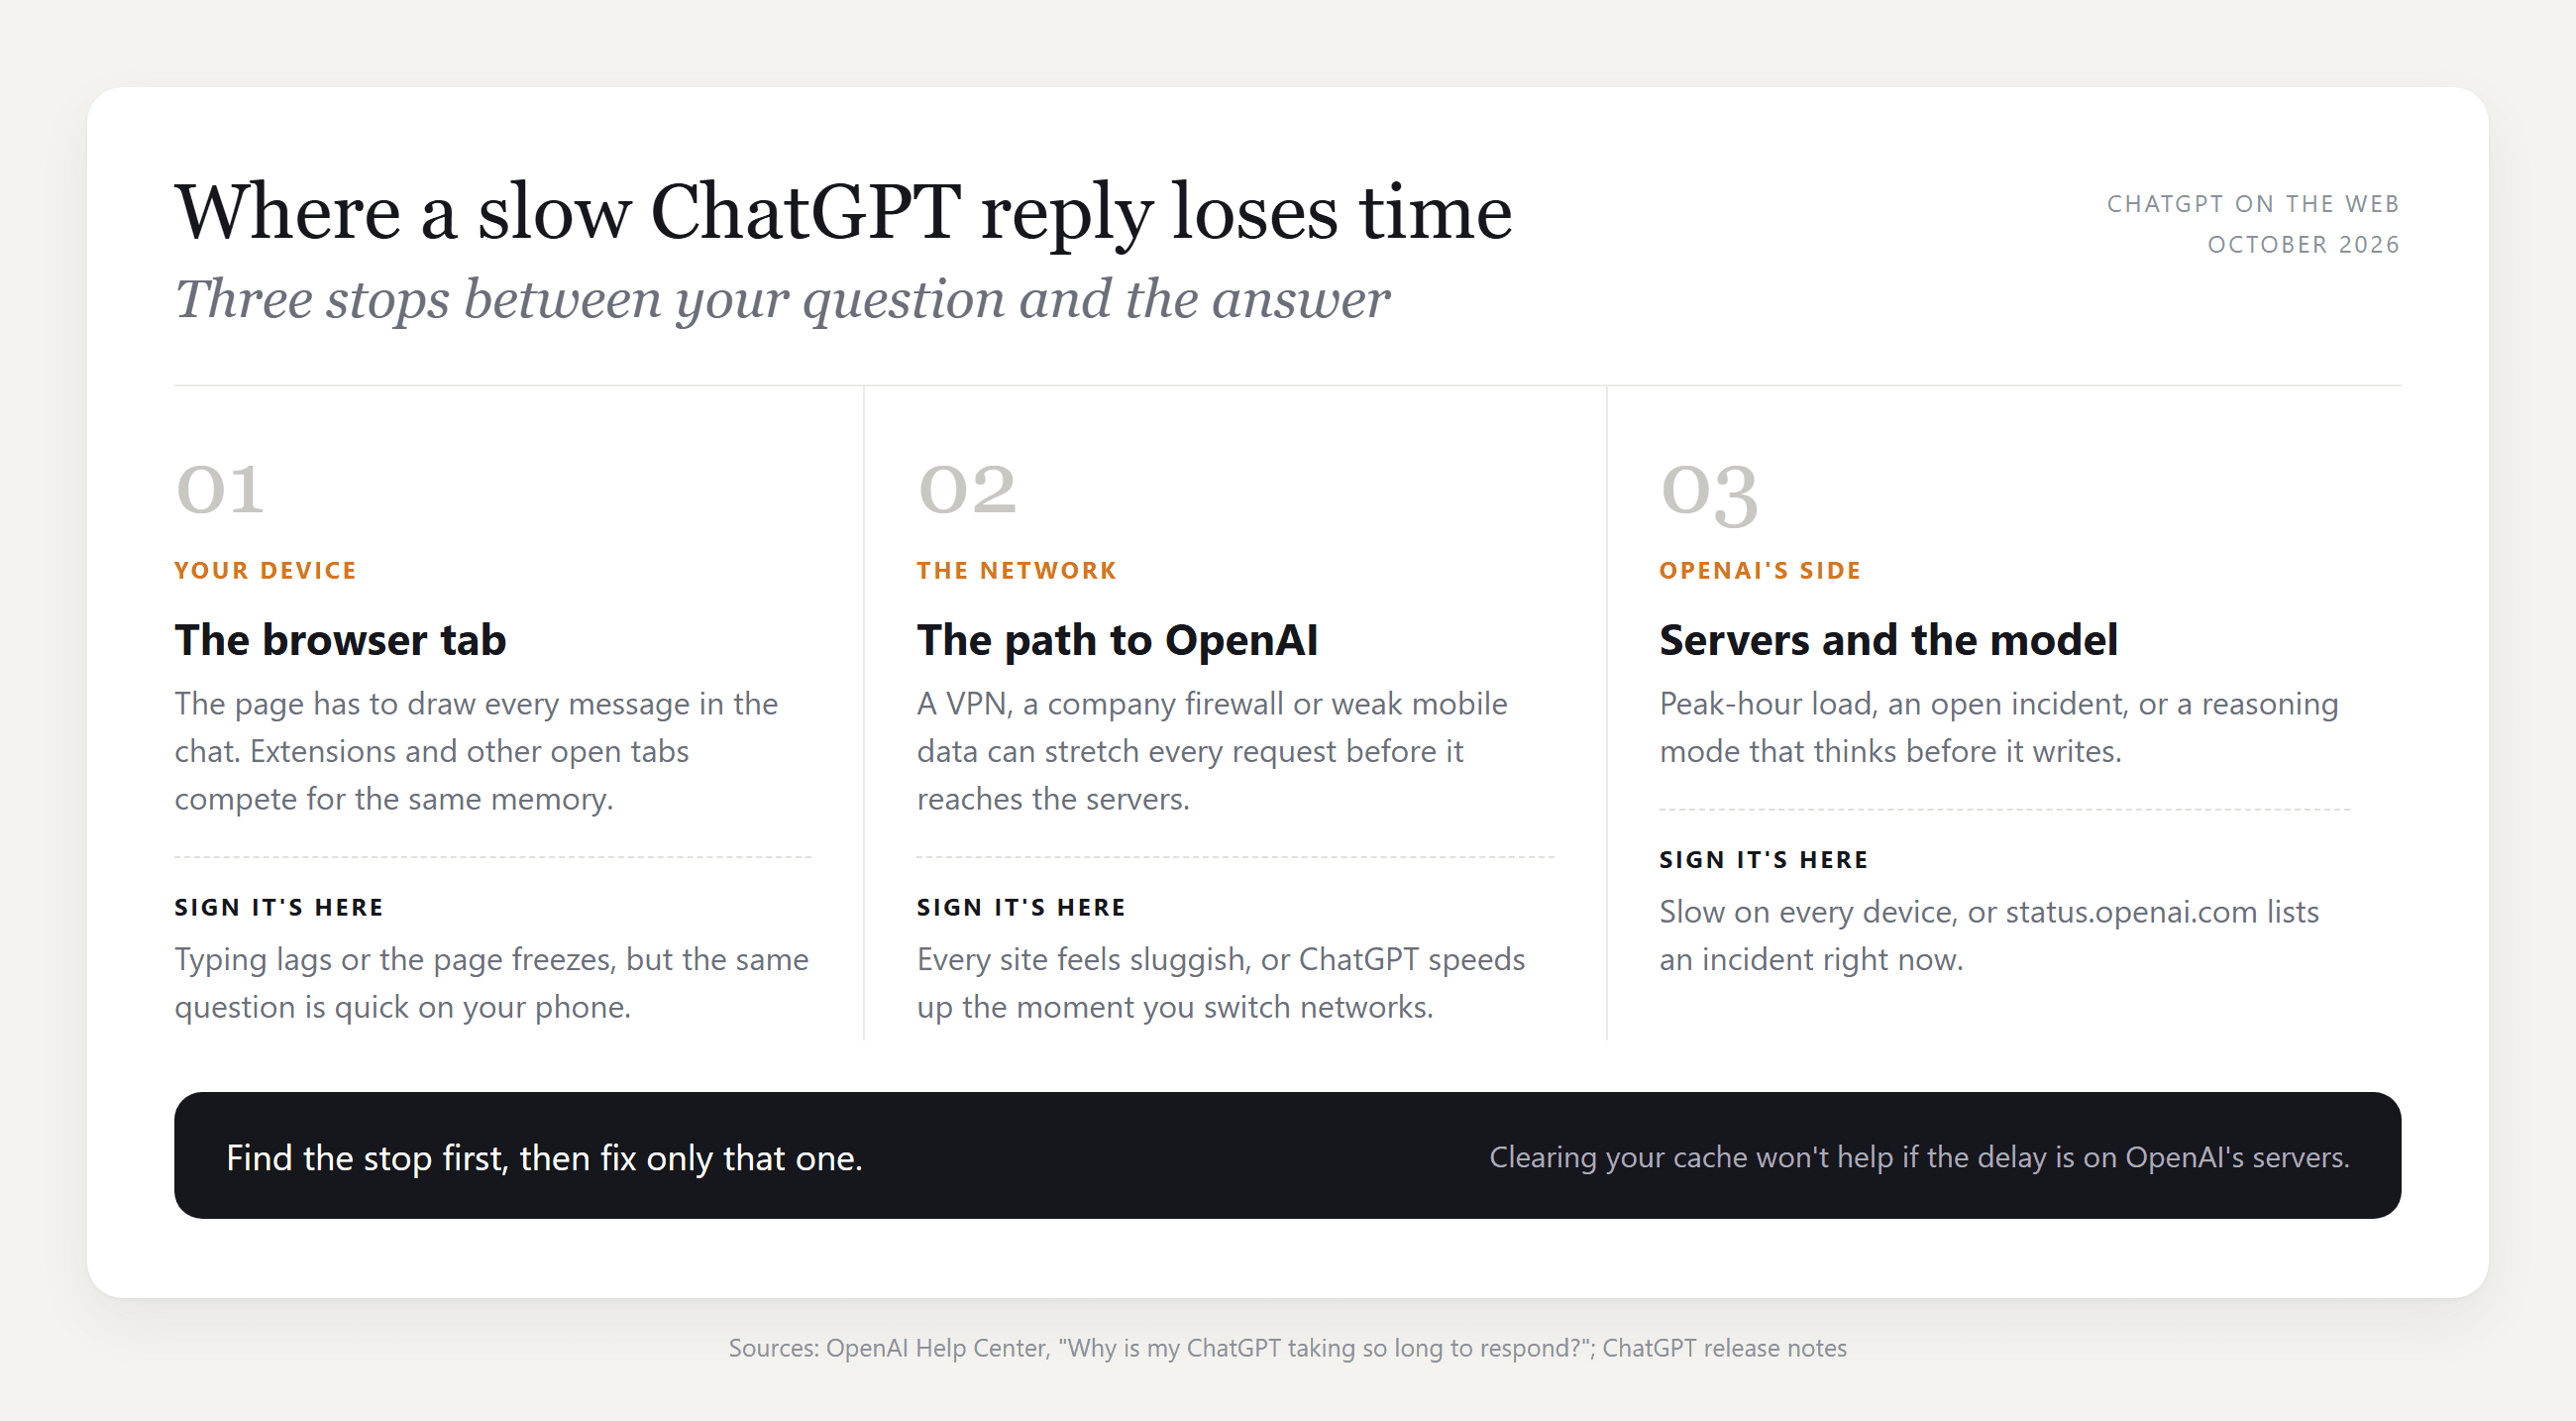
区分它们最快的方法是双设备测试。在你的笔记本电脑上和手机上用移动数据问同一个简短问题。两者都慢?问题出在你的上游。手机快?检查你的浏览器或 Wi-Fi。
为什么 ChatGPT 今天这么慢?
当 ChatGPT 今天很慢但昨天还好时,在动任何设置之前,先查看 status.openai.com 上的 OpenAI 状态页面。OpenAI 自己的 故障排除文章 说得很清楚:用户“在高峰时段可能会注意到一天中特定时间出现缓慢的模式。”
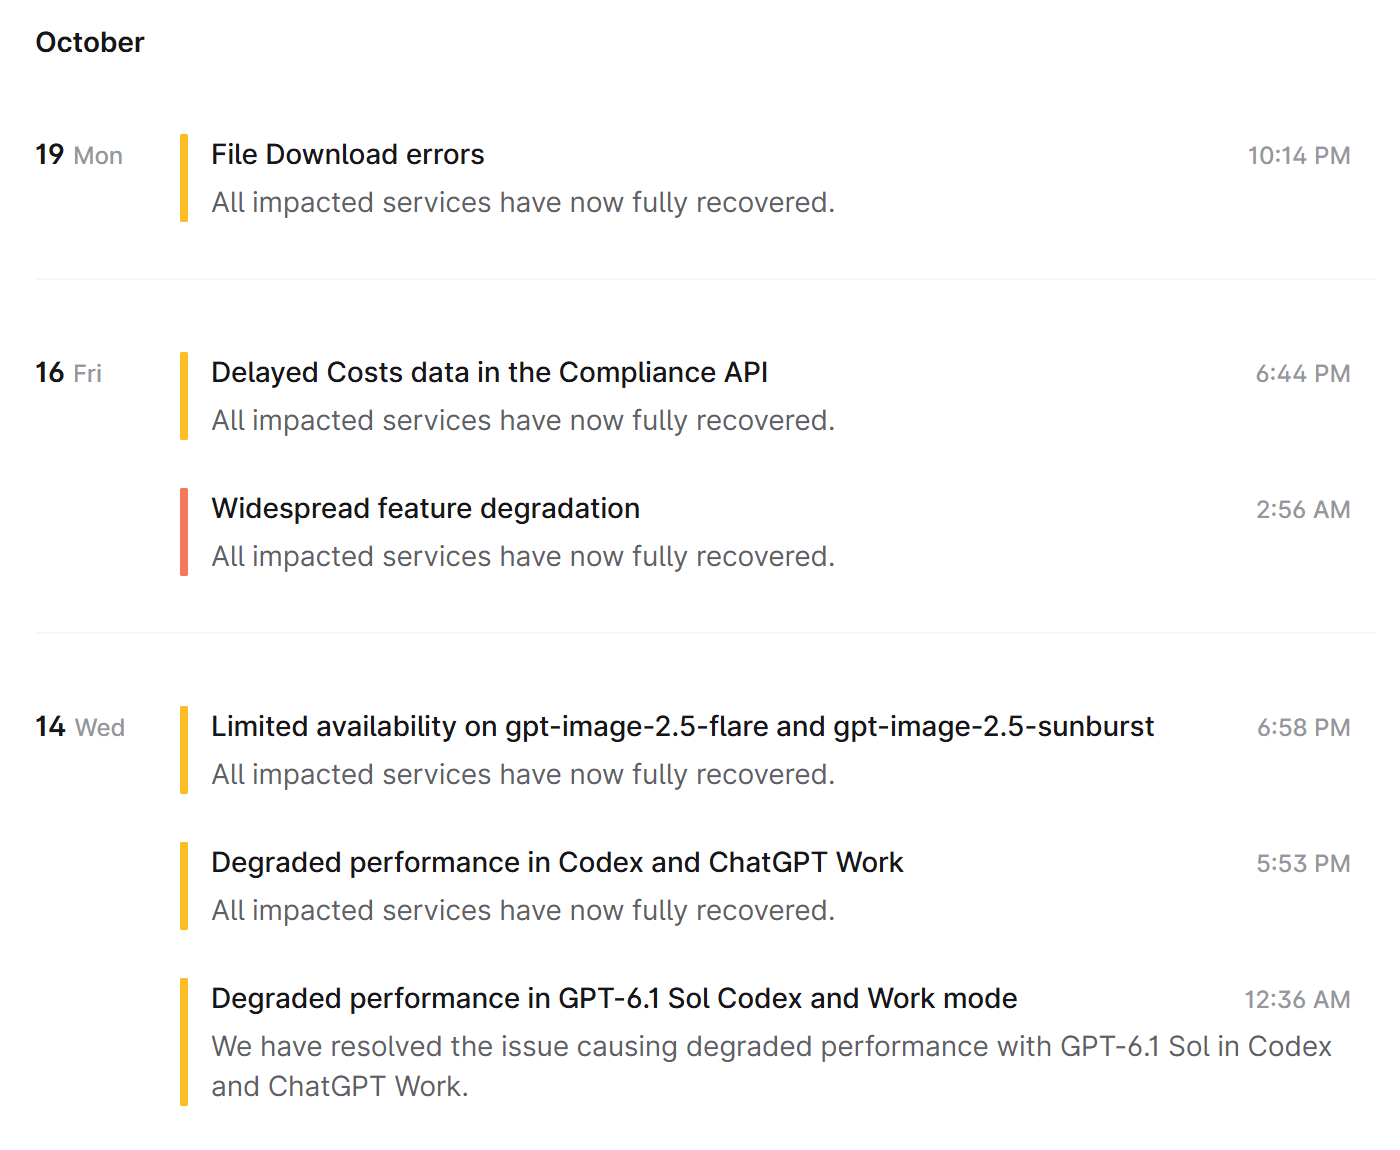
来源: OpenAI Status ,截取于 2026 年 10 月 20 日
阅读每个事件的措辞。“性能下降”和“延迟升高”意味着服务可用但缓慢,这正是今天感觉慢的原因。“错误升高”意味着某些请求直接失败,那属于另一个问题:ChatGPT 完全无法工作。还要注意标题有多具体。针对 Codex 和 ChatGPT Work 的事件不会拖慢普通聊天,所以在归咎于故障之前,先匹配产品名称。
如何通过直接调用 GPT-6 来修复 ChatGPT 缓慢的响应
有些变慢来自聊天页面本身:一个在长时间会话中变得沉重的标签页,或者扩展程序争抢内存。API 调用没有页面负担。你发送自己选择的精确上下文,模型回答,文字在写出时流式返回。
Atlas Cloud 在一个聊天补全端点后提供 GPT-6 Luna,这是 ChatGPT 为其 Free 和 Go 用户提供的相同模型名称。
这条路线特别适合一项工作:你原本会粘贴到已经进行了几十轮对话的聊天中的长文档。会议记录、转录文本、合同草案。每个请求都从干净状态开始,所以下一个文档和第一个一样都是白板。
方法 1:使用 Atlas Cloud Playground
无需代码。登录并打开 GPT-6 Luna playground,然后:
- 将你的文本和指令粘贴到消息框中。我们使用了一份每周会议记录,并要求给出五条要点以及带负责人的行动项。
- 点击发送箭头。答案会流式显示在聊天区域,你可以在同一个框中输入后续内容。
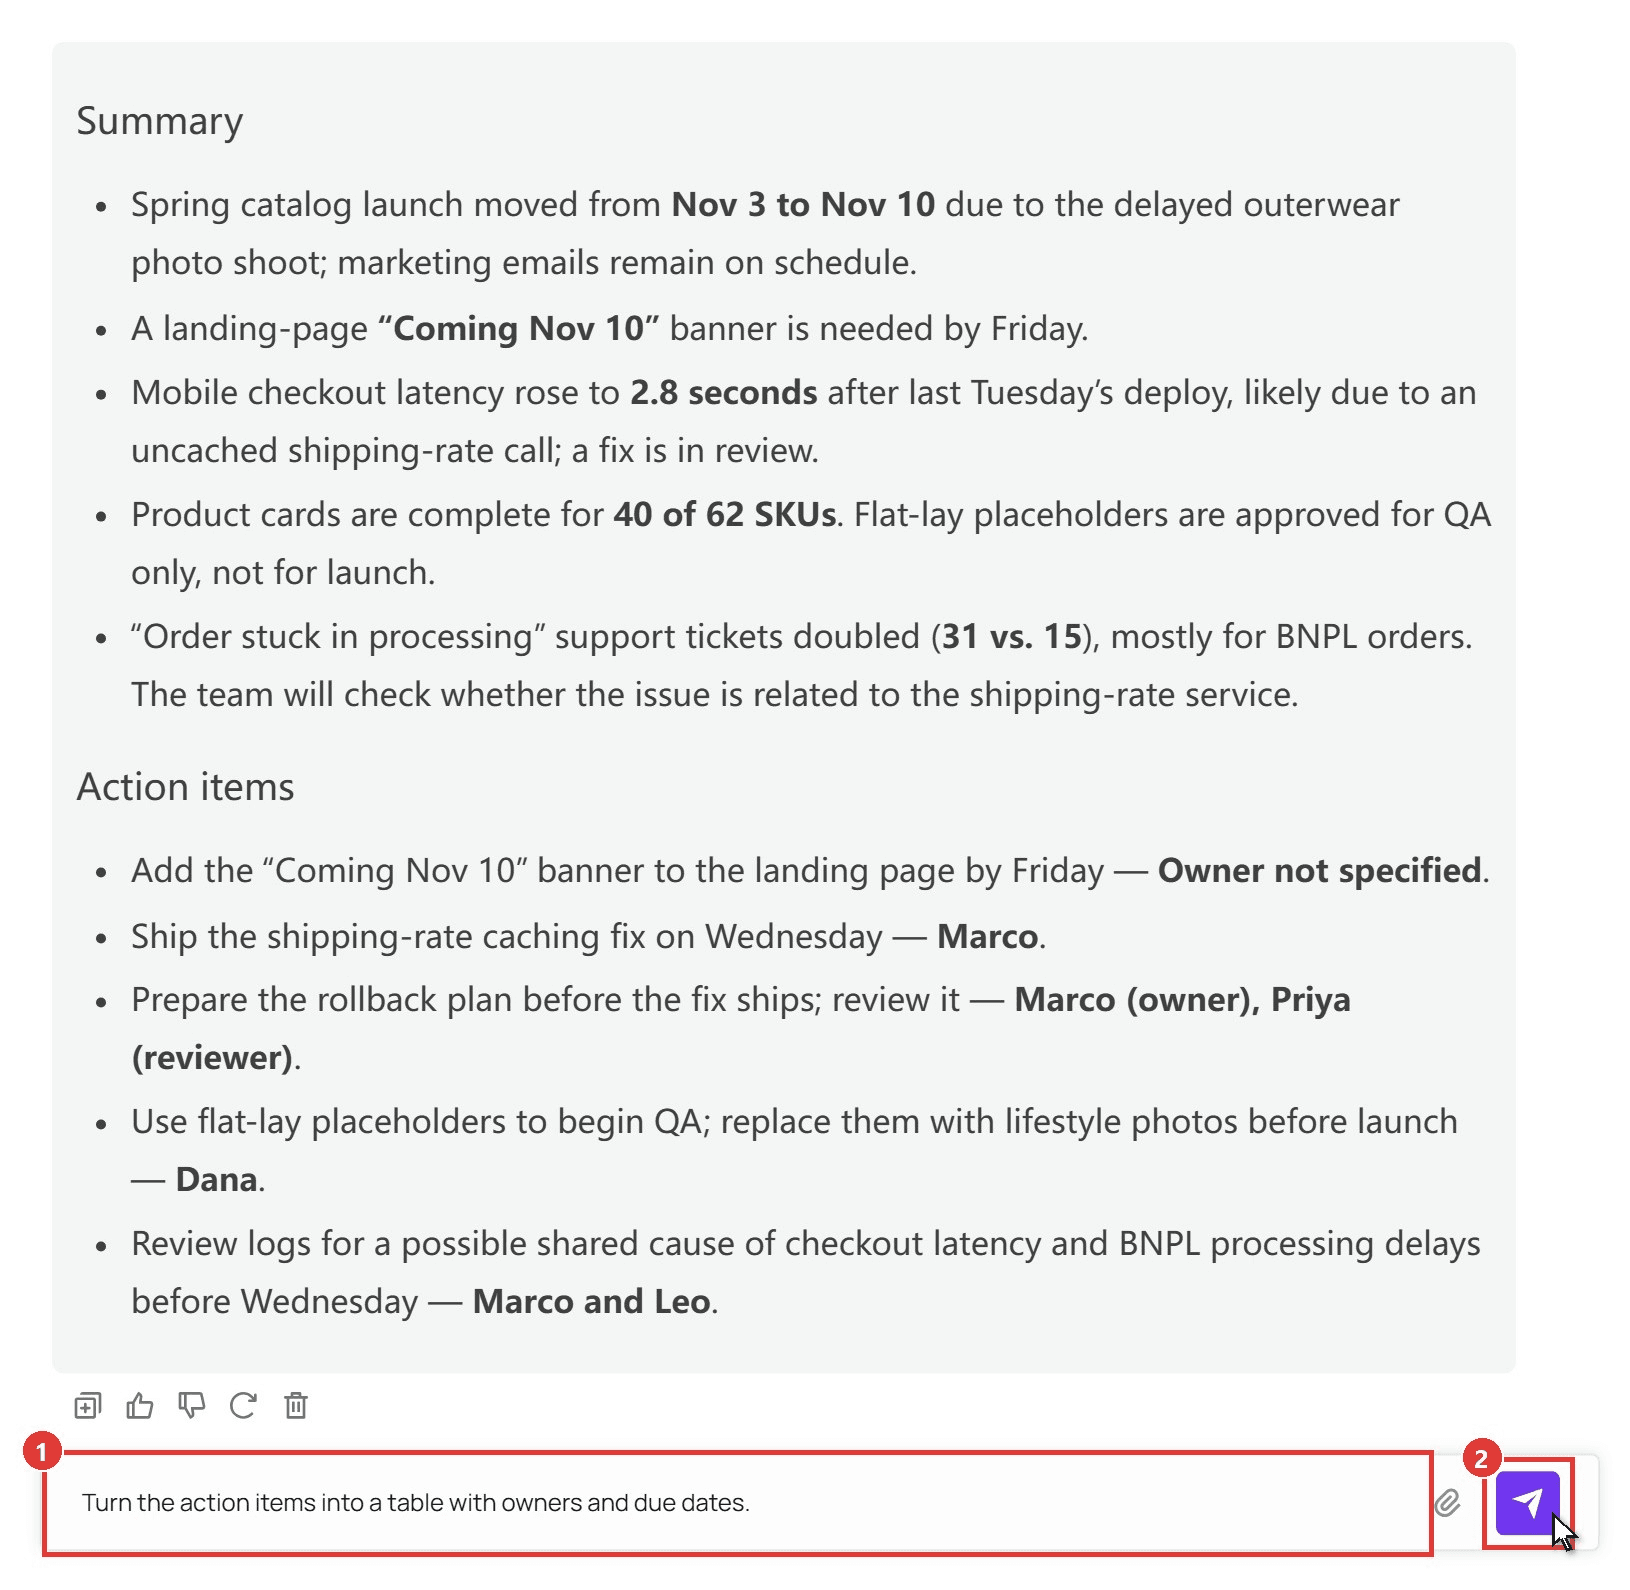
结果中有一个值得注意的细节:记录中从未指定落地页横幅的负责人,而 Luna 写了“Owner not specified”而不是猜测。
方法 2:通过 API 流式调用 GPT-6 Luna
对于你每天都要运行的任务,把它接入脚本。三个步骤。
步骤 1:创建 API 密钥。 在控制台中打开 Settings,进入 API Keys,然后点击 Create API Key。将它保存在服务器端。
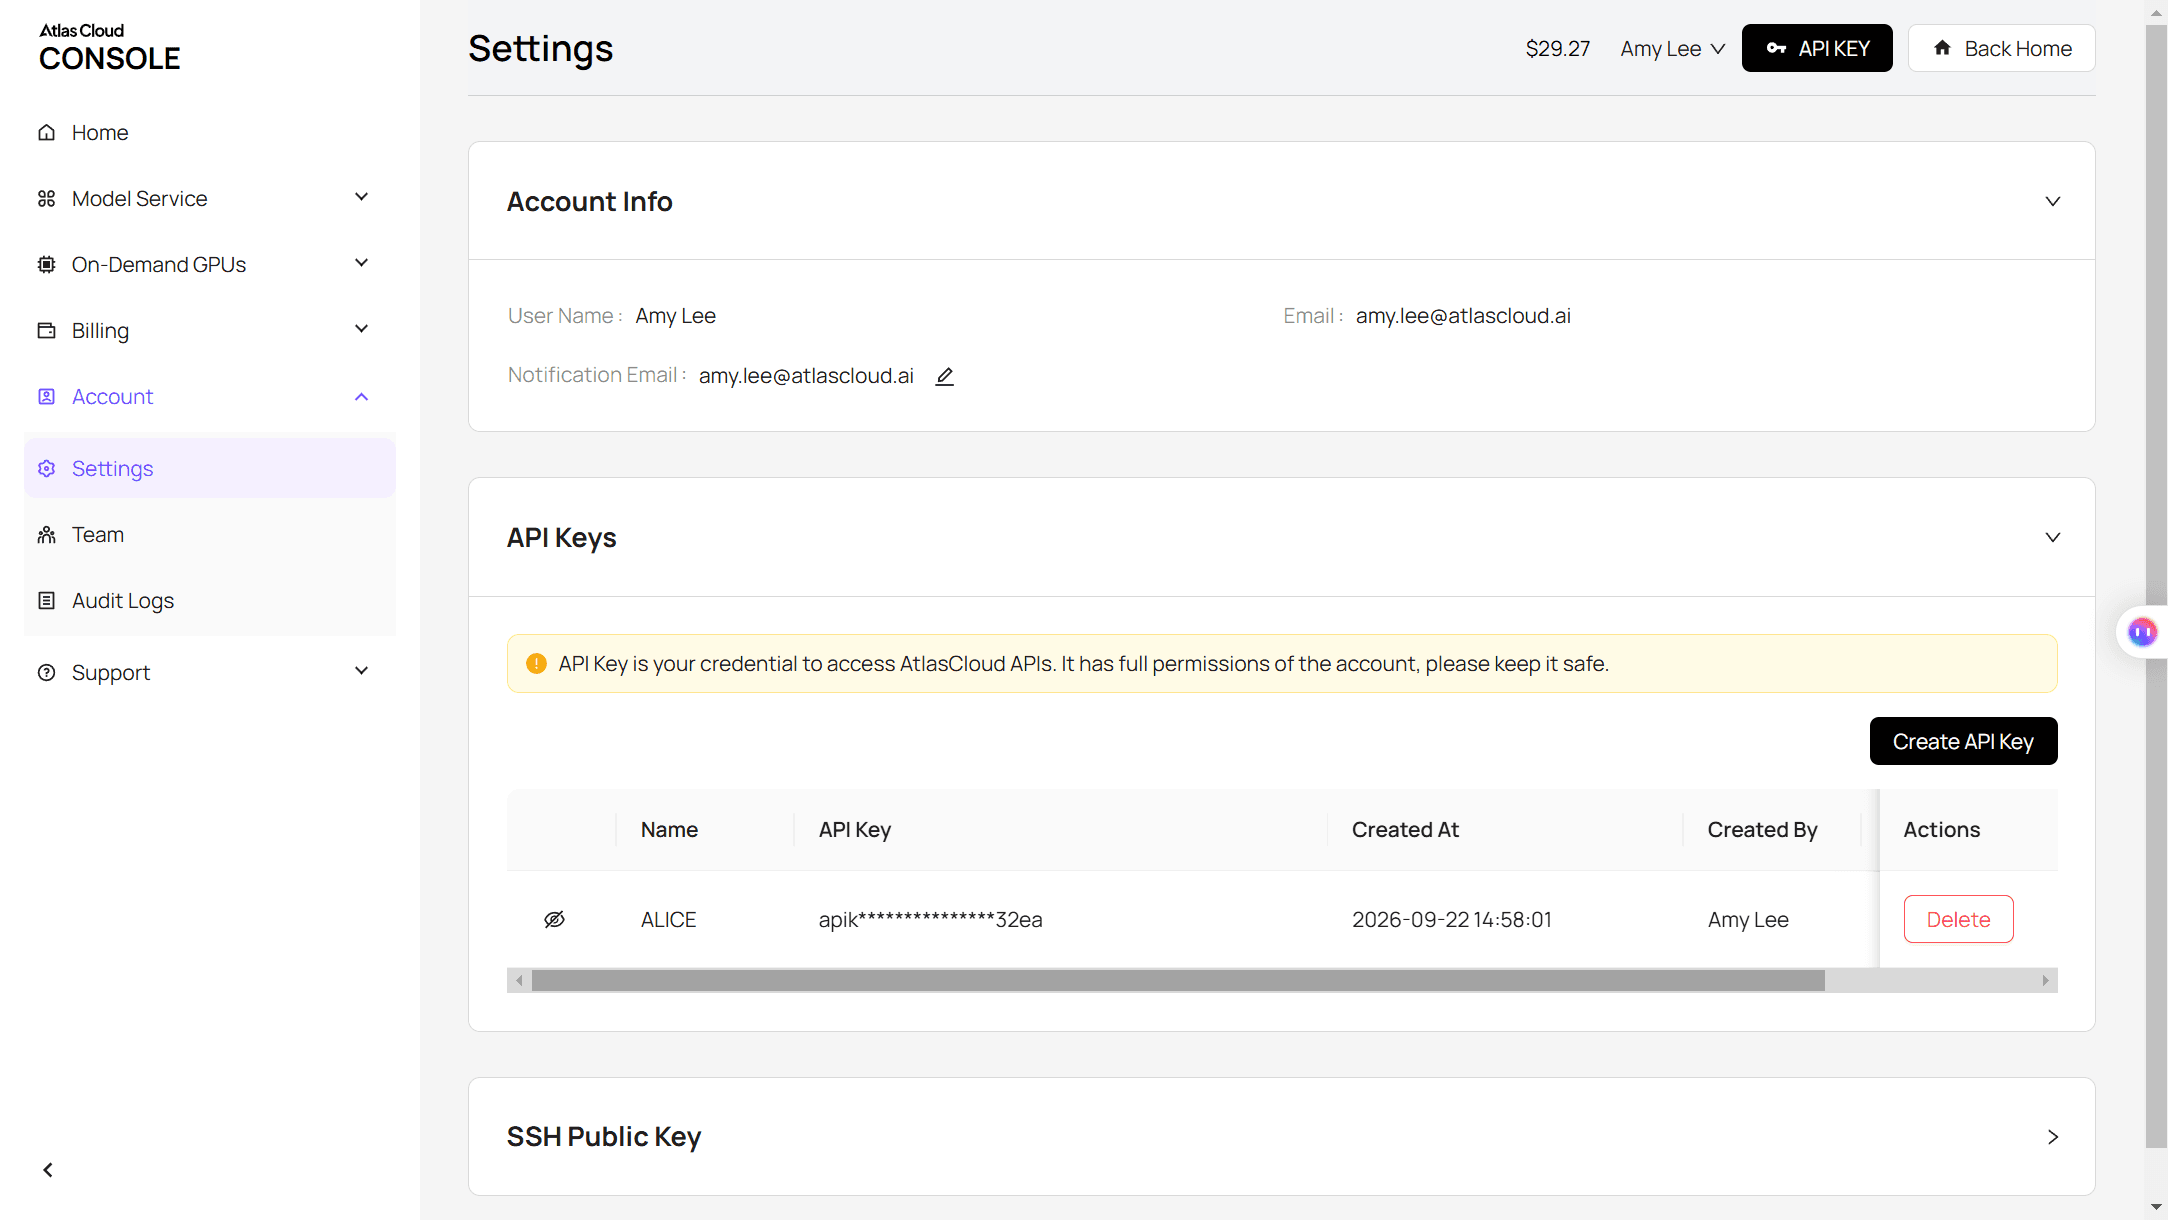
步骤 2:检查请求格式。 API 文档 涵盖了聊天补全格式,模型页面有一个 API 标签,里面有现成的示例。
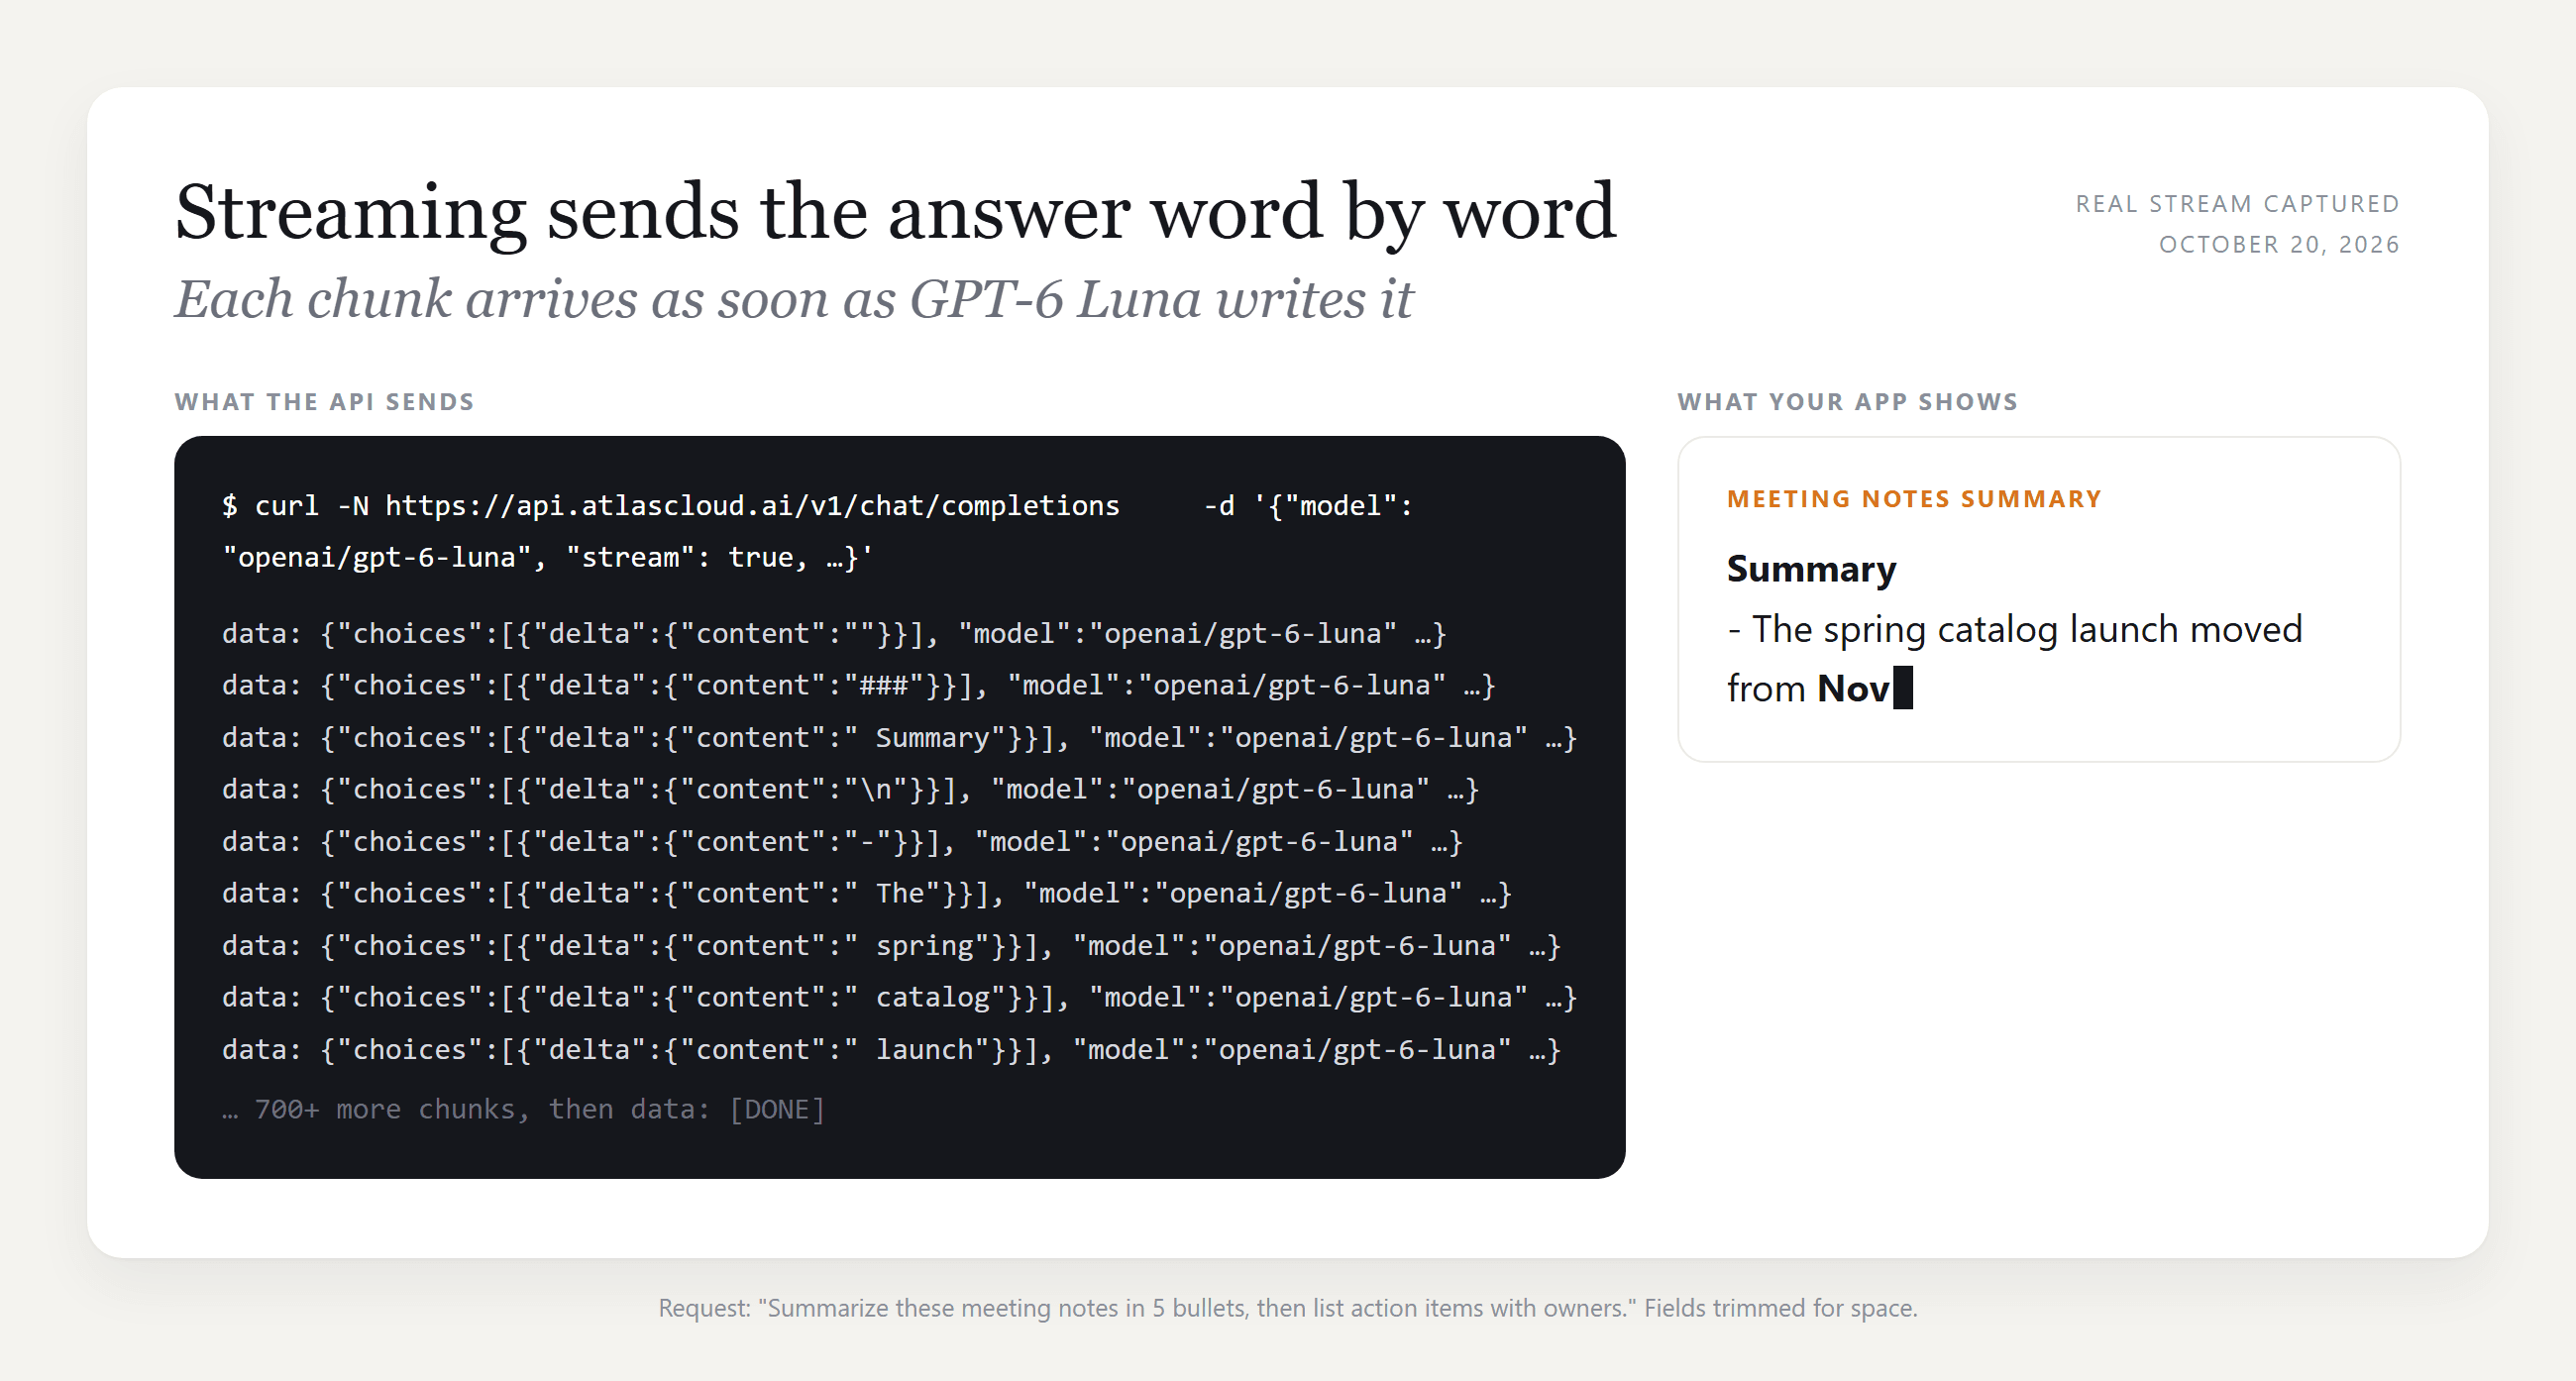
步骤 3:发送流式请求。 将 "stream" 设为 true 会以小数据块返回答案,这样你的应用可以在其余内容仍在编写时显示开头的文字。
plaintext1curl -N -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "openai/gpt-6-luna", 6 "messages": [{"role": "user", "content": "Summarize these meeting notes in 5 bullets, then list action items with owners: ..."}], 7 "stream": true, 8 "max_tokens": 1500 9 }'
返回的每一行都以 "data:" 开头,并在 choices[0].delta.content 中携带下一段文本,直到最后的 "data: [DONE]"。同一个端点和密钥覆盖 OpenAI 系列的其他模型以及平台上所有其他聊天模型,因此为了更难的推理而迁移到 GPT-6 Sol 只需更改模型字符串。
为什么 ChatGPT 在长对话后会变慢?
这是人们描述得最精确的变慢:一个一开始很敏捷的聊天现在变得拖沓。所以我们构建了一个。在一个免费账户上,我们在一次对话中要求 ChatGPT 生成 18 个手册章节,每章约 6,300 个字符,包含一个表格和一个代码块。然后我们在这个聊天和全新聊天中,对同一个两句话的问题进行计时,各运行三次,从点击 Send 的那一刻开始。
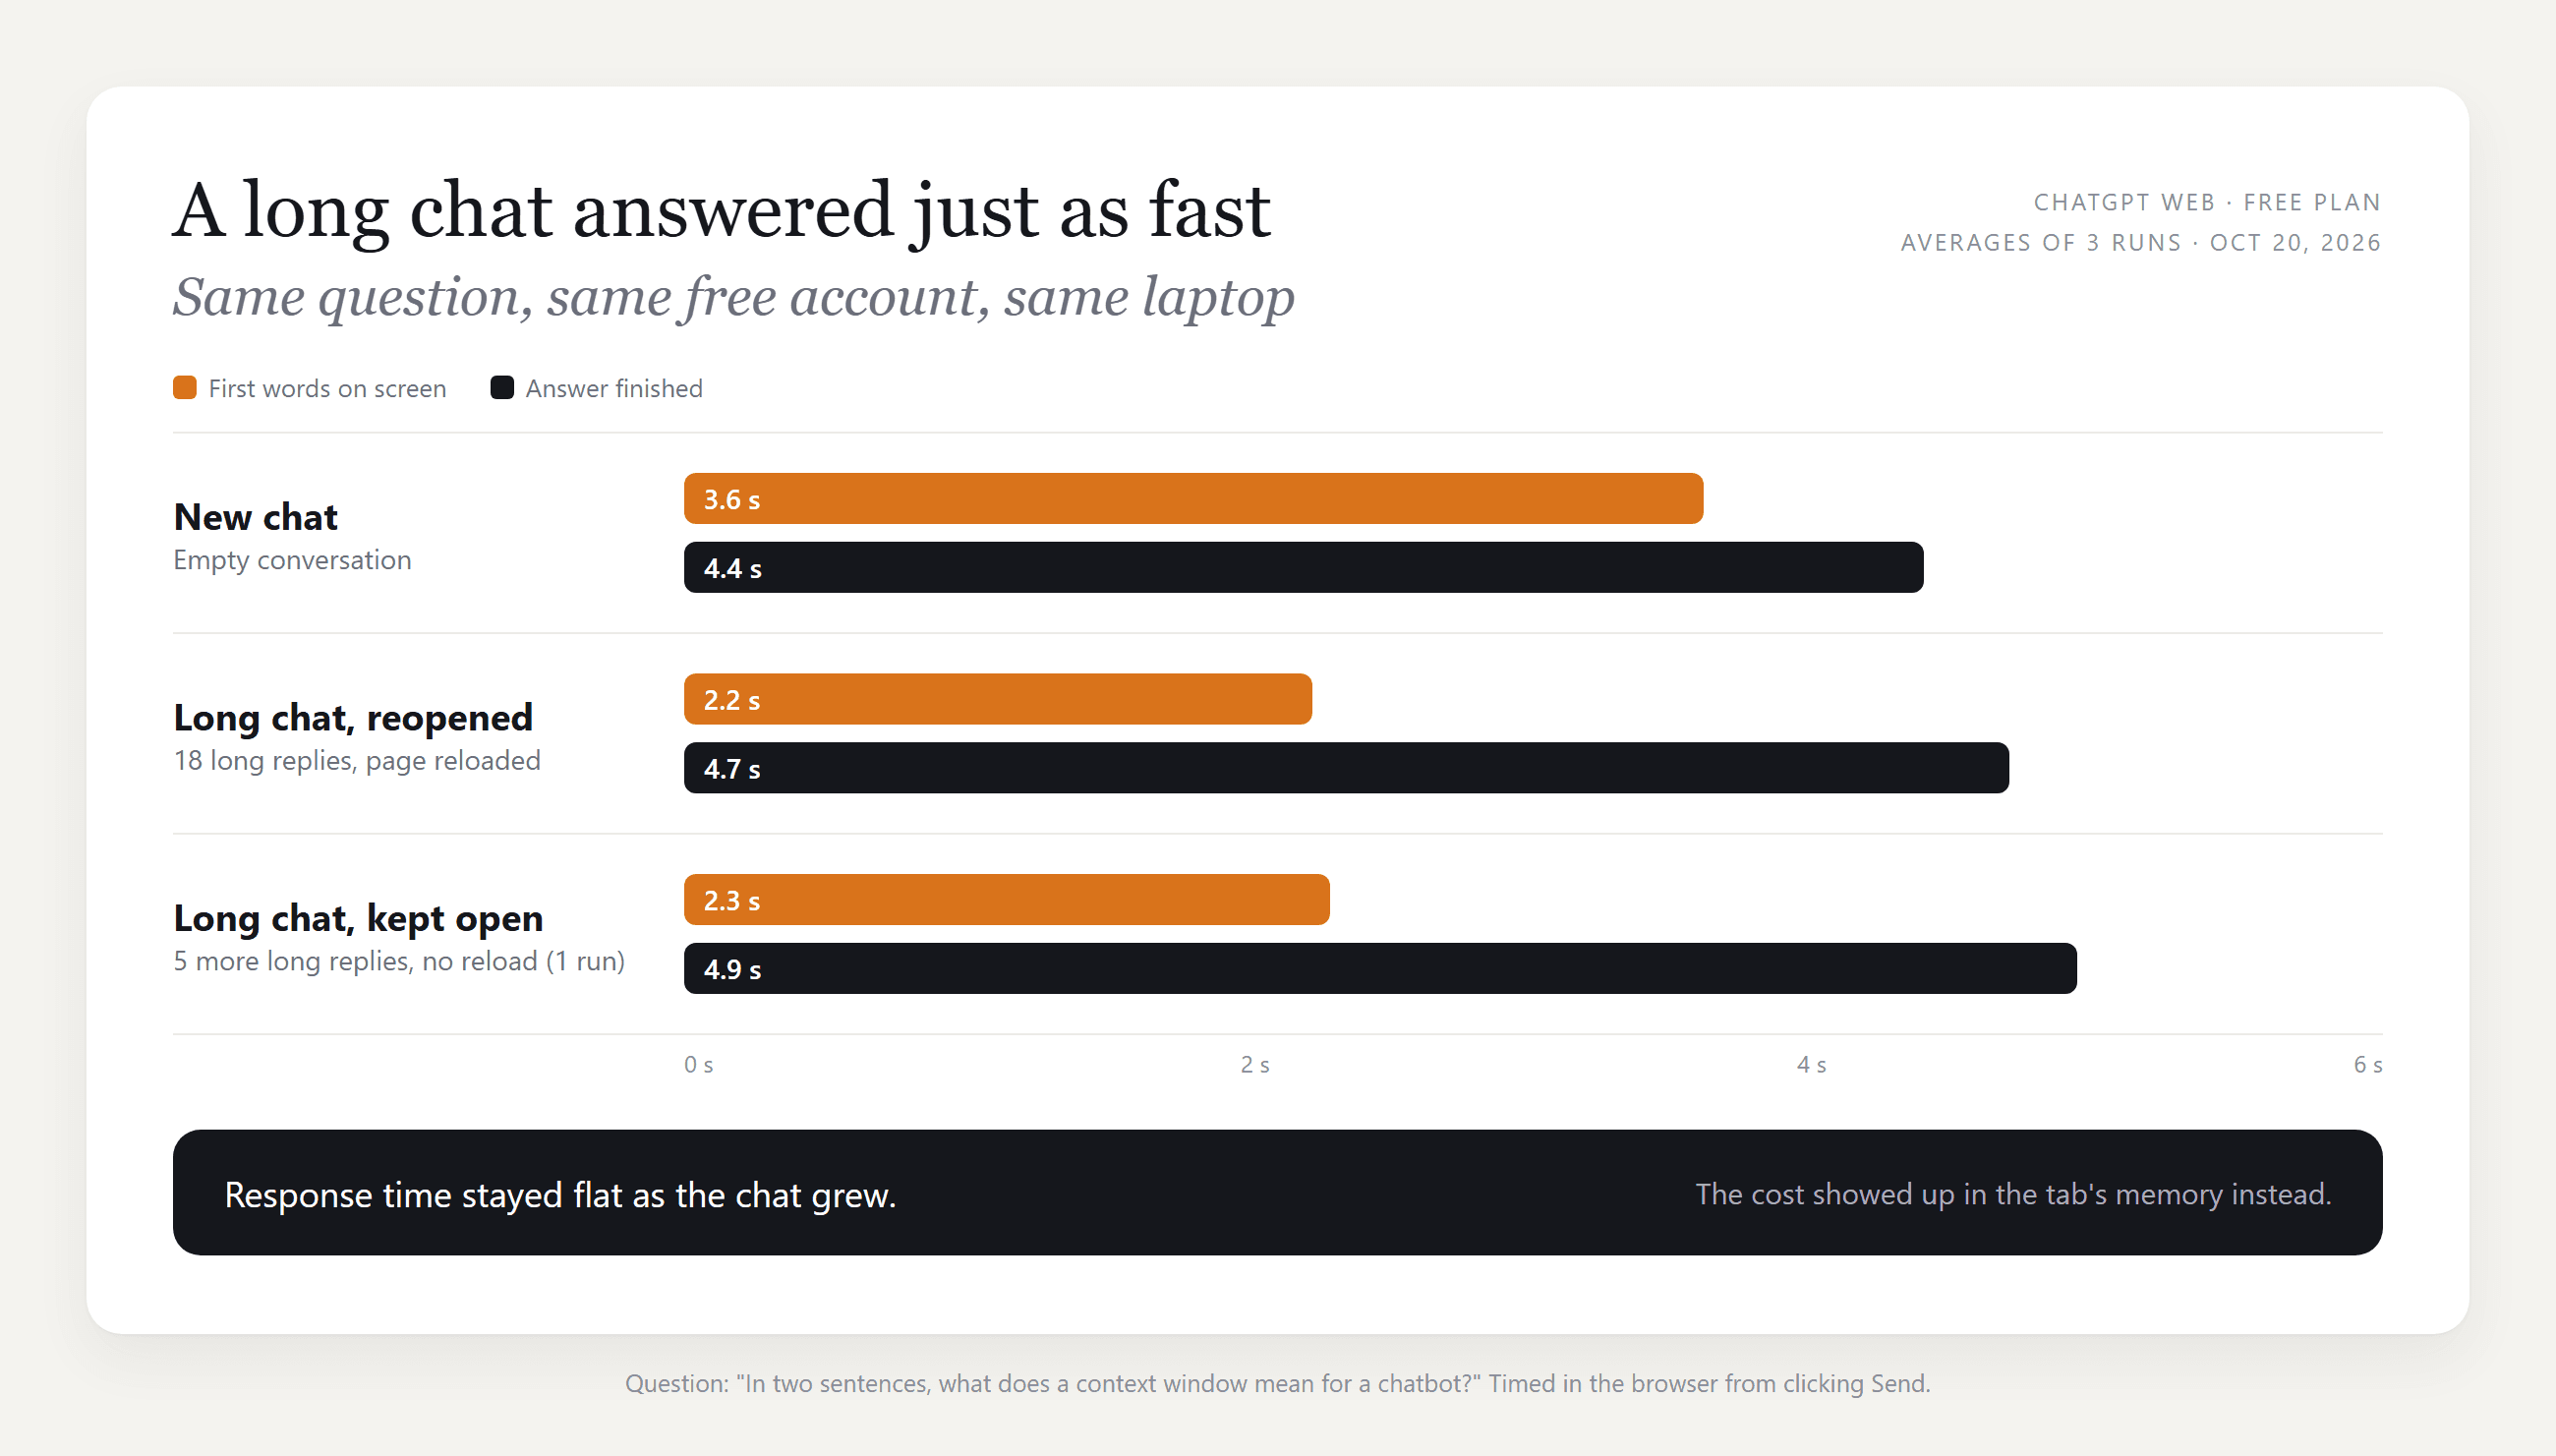
长聊天回答并不慢。首批文字大约在 2.2 秒出现,而新聊天是 3.6 秒,两者平均都在 5 秒内完成。
部分原因是 2026 年 8 月 21 日的一项变化:ChatGPT 发布说明 称 Web 应用“以更小的片段加载消息,而不是一次性检索整个对话。”在我们的标签页中,无论聊天变得多长,页面上任何时候都只有大约七轮对话。
真正增长的是标签页本身,而这就是你感觉到的卡顿。下一节将展示数字。
上下文窗口是另一个限制。ChatGPT 的定价页面列出 Instant 的总上下文窗口:Free 为 27K tokens,Go 和 Plus 为 54K,Pro 为 128K。我们的 18 章总计约 113,000 个字符,大约 28,000 tokens,已经超过了免费 Instant 窗口,因此最早的章节可能超出模型读取的范围。长聊天先消耗内存,再消耗速度。
OpenAI 的错误故障排除页面用一句话给出了同样的建议:“如果对话很长或轮次很多,请开始新聊天。”为了保留进度,可以将其延续:
- 让 ChatGPT“总结到目前为止的对话,包括决定、未解决的问题以及我们达成一致的任何数字。”
- 复制摘要,打开新聊天,并将其粘贴为你的第一条消息。
- 从那里继续。
为什么 ChatGPT 在我的电脑上这么慢?
为什么我的 ChatGPT 这么慢,而笔记本电脑的其他部分感觉正常?与你的手机比较。手机快意味着浏览器在做慢的部分。卡顿通常表现为打字延迟、回复流式输入时页面冻结,或者纯文本答案让风扇转起来。
我们观察了它的发生。重新打开长聊天后,我们保持标签页打开,并要求再生成五个长章节而不重新加载,在每次回复后读取标签页的 JavaScript 内存。
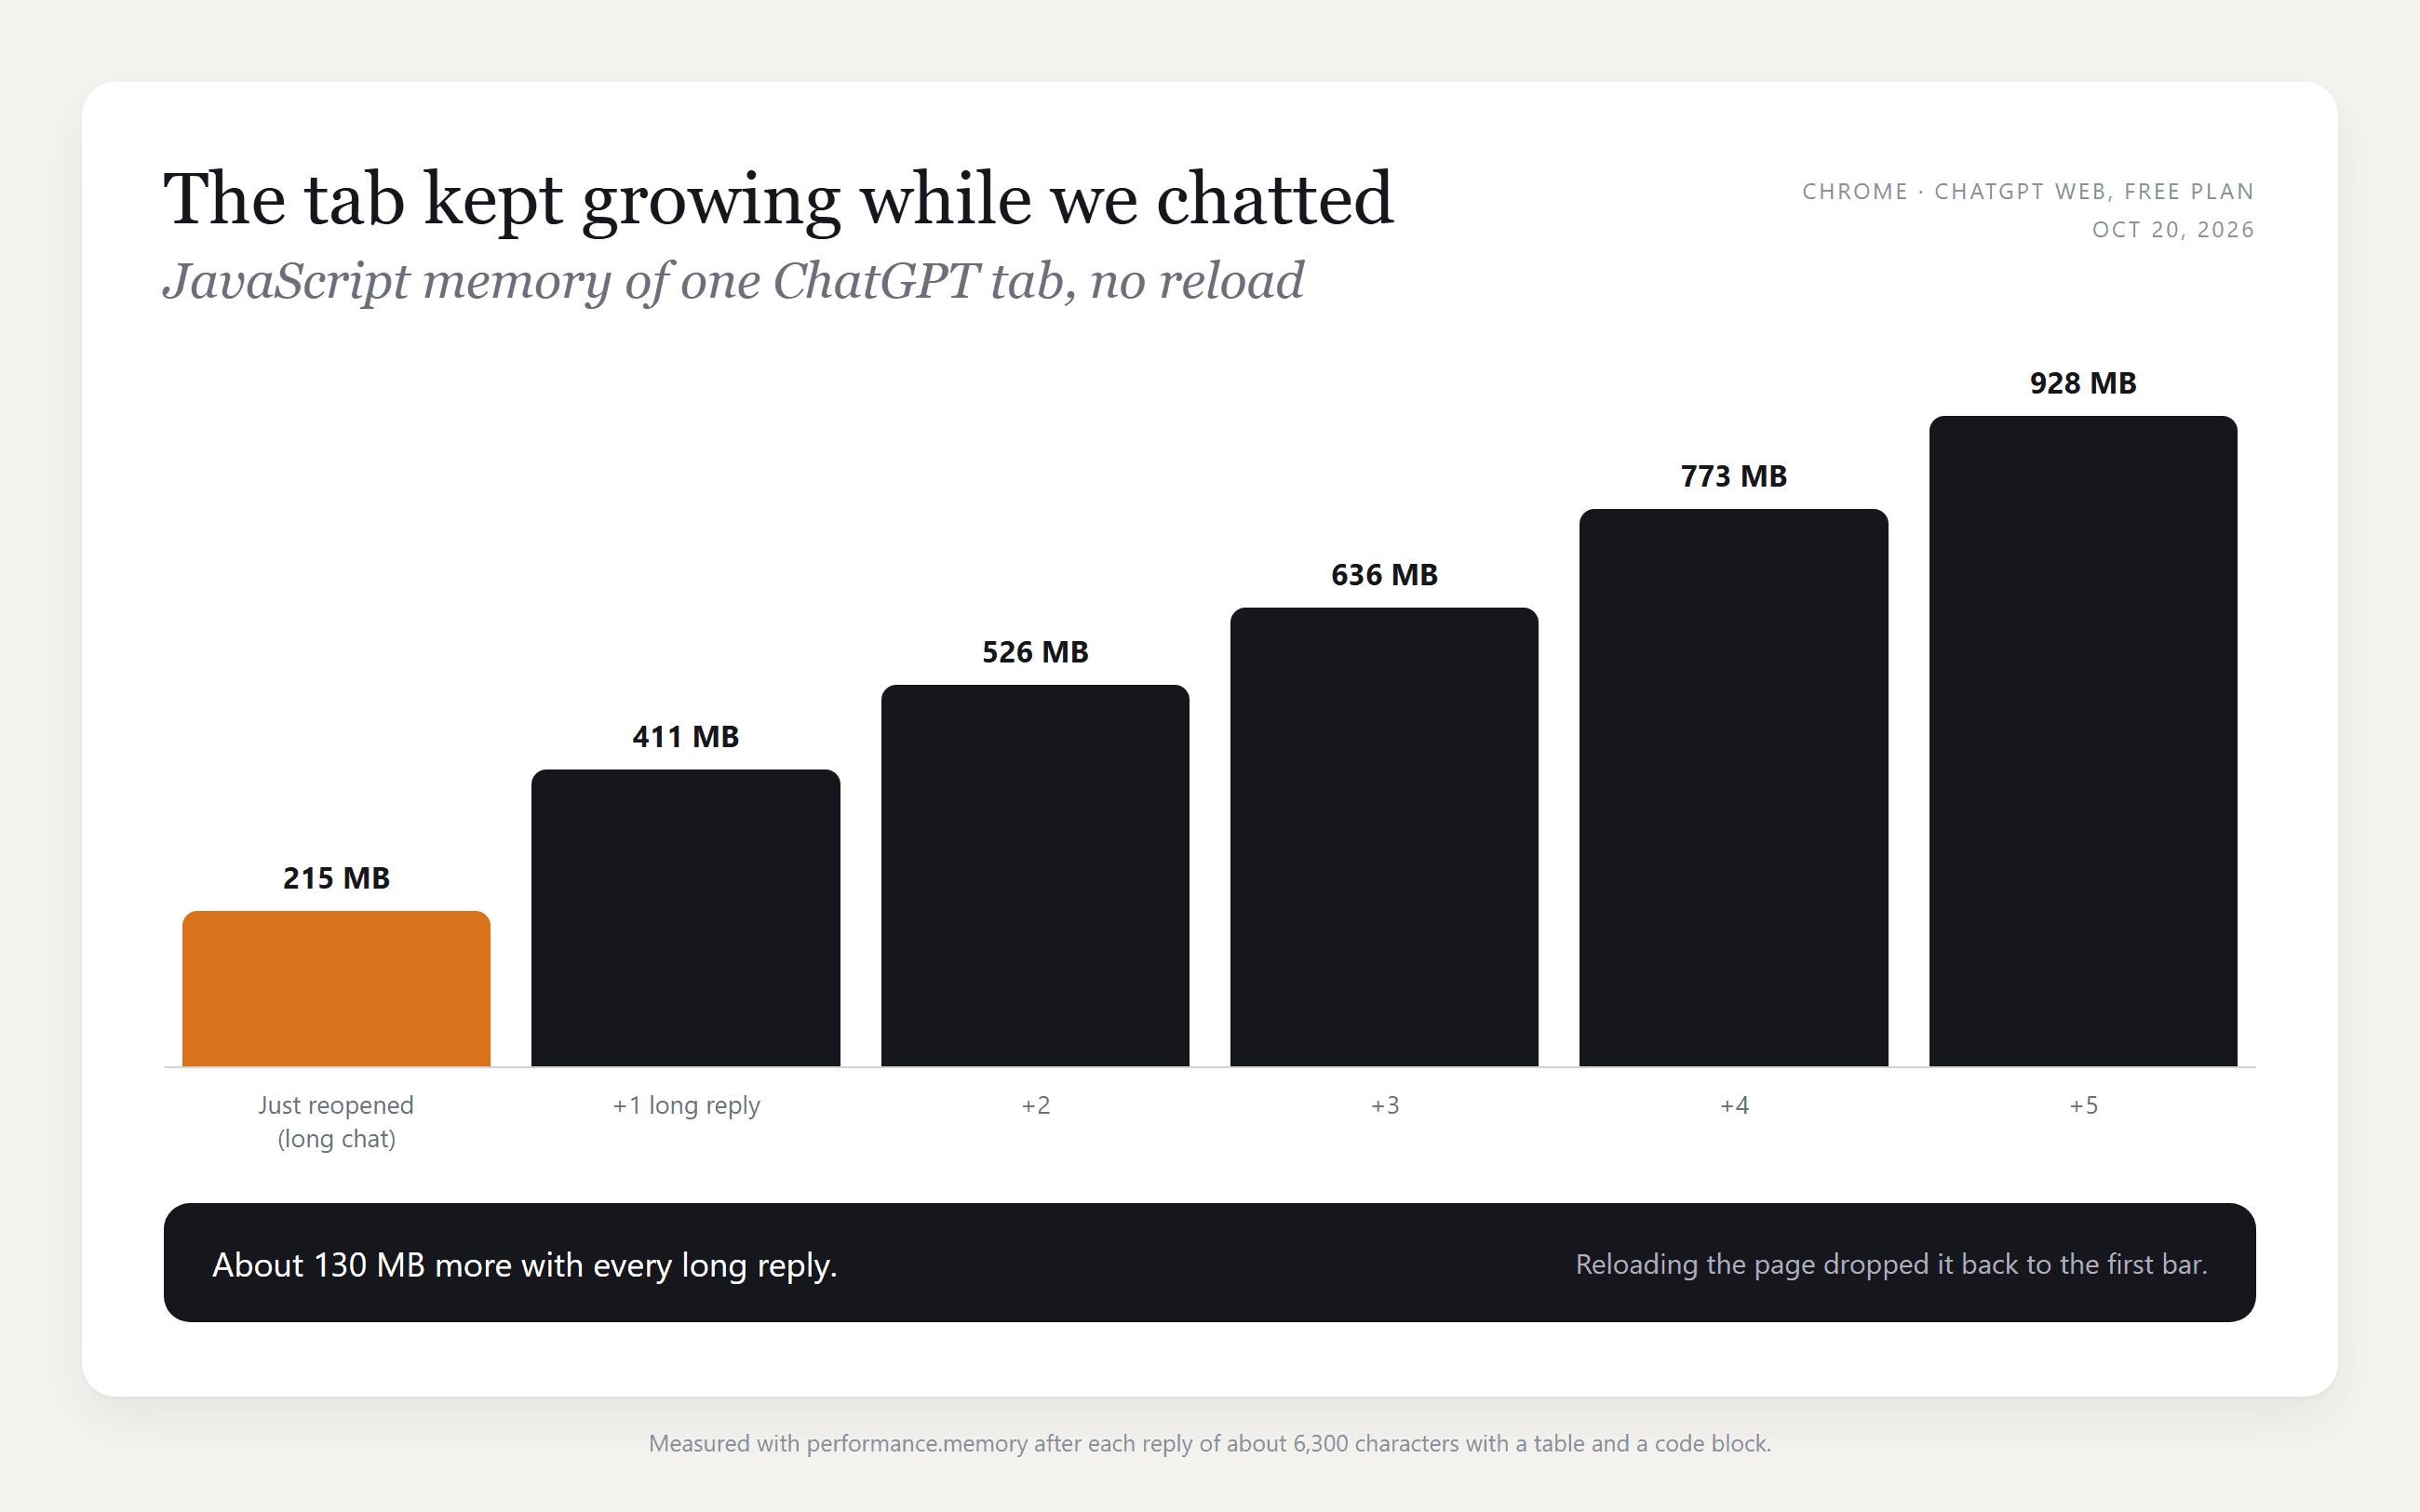
内存每次回复大约增加 130 MB,五次后超过 900 MB。在构建聊天的会话期间,页面变得如此沉重,以至于我们的浏览器工具仅仅截屏就两次超时。重新加载将标签页恢复到约 215 MB。因此,对于迟缓的长聊天,最便宜的修复是重新加载按钮:按 F5,或者关闭标签页并从侧边栏重新打开对话。
Chrome 有一个内置的检查方法。按 Shift+Esc 打开其任务管理器,在内存列中找到 ChatGPT 标签页。
ChatGPT 在 Chrome 上变慢:扩展程序、缓存和强制刷新
OpenAI 帮助中心列出了浏览器端的修复方法。以下按值得尝试的顺序排列,最便宜的优先:
| 尝试什么 | 排除了什么 | OpenAI 的措辞 |
|---|---|---|
| 在无痕窗口中打开 ChatGPT | 扩展程序和存储的设置 | 无痕模式“默认禁用大多数扩展程序” |
| 逐个禁用扩展程序 | 脚本拦截器或广告拦截器干扰 | “尤其是那些阻止脚本或广告的” |
| 关闭其他标签页和程序 | 电脑上的内存压力 | 为 ChatGPT 释放“系统资源” |
| 使用 Shift + Reload 强制刷新 | 卡住的页面或过时的脚本 | 针对“卡在加载中”的页面列出 |
| 清除站点数据,然后重新登录 | 损坏的缓存或 cookie | “清除站点数据”,“不只是缓存” |
| 尝试其他浏览器 | Chrome 特有的问题 | 有助于“确定问题是否特定于”浏览器 |
如果这些都没有帮助,延迟可能出在你的浏览器上游。
为什么 ChatGPT 5 这么慢?模式、计划和思考时间
GPT-5 开局艰难。它于 2025 年 8 月 7 日发布,发布说明将其描述为“缓慢推出”。第二天,Sam Altman 在 X 上写道,自动切换器——即在快速模型和思考模型之间路由问题的部分——“当天有一段时间无法工作”,正如 VentureBeat 在 2025 年 8 月 8 日报道的那样。
ChatGPT 现在运行不同的模型。2026 年 10 月 7 日的发布说明指出:“Plus、Pro、Business 和 Enterprise 使用 GPT-6 Sol;Free 和 Go 使用 GPT-6 Luna。”除了服务器负载,你能控制的最大因素是你选择的推理级别:
| 计划 | 聊天模型 | Instant 上下文窗口 | 推理上下文窗口 |
|---|---|---|---|
| Free | GPT-6 Luna | 27K | 不定 |
| Go | GPT-6 Luna | 54K | 256K |
| Plus | GPT-6 Sol | 54K | 256K |
| Pro | GPT-6 Sol,Pro 推理使用 GPT-6 Astra | 128K | 400K |
2026 年的两项变化对速度有影响。9 月 14 日,OpenAI 取消了 Plus 和 Pro 从 Instant 到 Thinking 的自动切换,因此快速问题不再被静默路由到较慢的推理模型(OpenAI 对安全情况保留例外)。
GPT-6“可以在继续思考的同时开始回答”,因此你可以在推理答案完成之前开始阅读。OpenAI 的 GPT-6 公告 补充说,对于需要网络搜索的问题,GPT-6 Instant“平均比 GPT-5.6 Instant 提前 44% 开始回答。”
如果 Plus 今天特别慢,请检查状态页面和时间:OpenAI 的帮助文章将缓慢与高峰时段联系起来,而该说明并未区分免费和付费计划。如果你的答案卡在“Thinking”上,降低推理级别是另一种修复方法,有其自身的取舍。
为什么 ChatGPT 图像生成器这么慢?
图像生成运行在自己的轨道上,OpenAI 也相应地设定了预期。其 ChatGPT 中的图像 文章称生成“可能需要几分钟,取决于你请求的复杂程度”,并且你可以在它工作时继续聊天。2026 年 9 月 8 日发布的 ChatGPT Images 2.5 承诺比之前的版本“更快的图像生成”。
我们在同一个免费账户上计时了一次:一个简短的提示,要求生成雨夜里的阅读角落。
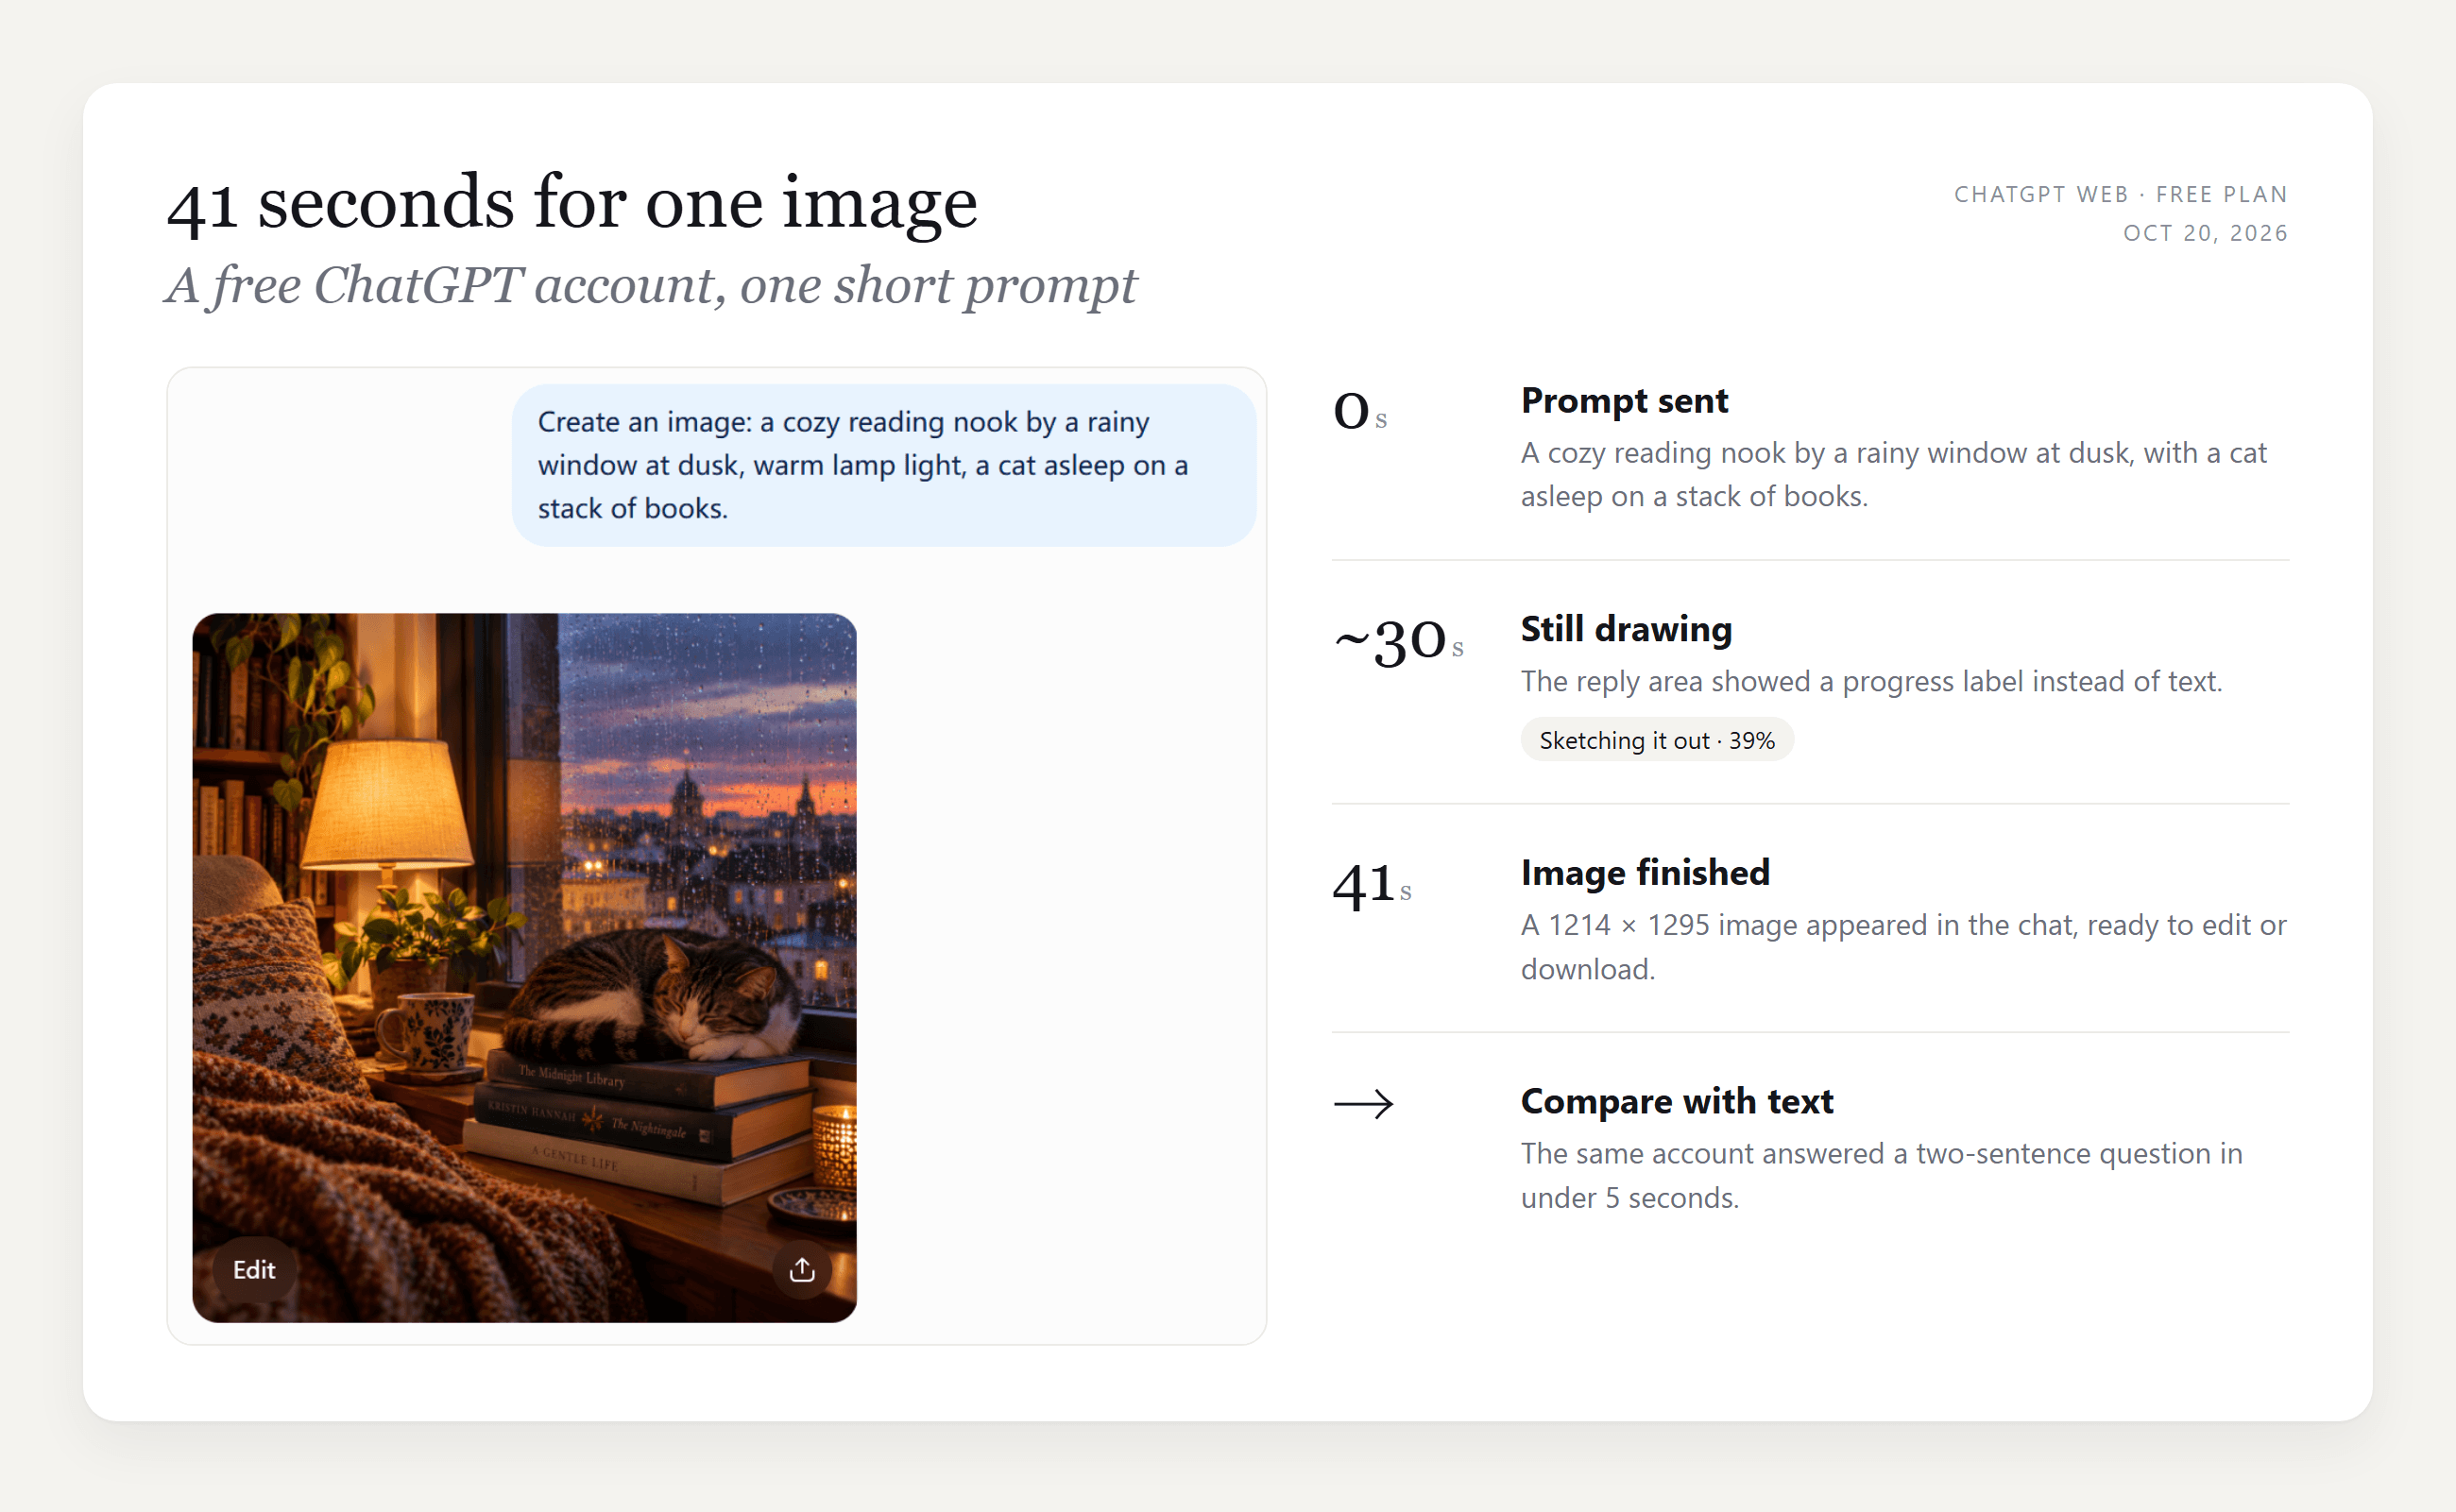
完成的图像用了 41 秒,大约是我们文本答案的十倍,并且聊天在大部分时间里显示“Sketching it out”进度标签而不是文字。这是正常的。
等待远超几分钟就值得查看状态页面,图像生成在那里有自己的事件行。图像请求也使用单独的配额,我们的 ChatGPT 图像限制测试 展示了一个免费计划在 22 次请求中的表现。如果你更愿意自己选择图像模型,Atlas Cloud 的 ChatGPT 插件 可以在同一个聊天中使用其他模型生成图像。
常见问题
使用得越多,ChatGPT 会变慢吗?
不会以你感觉的那种方式变慢。在我们的测试中,一个有 18 条长回复的聊天回答速度与全新聊天一样快。增长的是打开标签页的内存,所以一个开了一下午的页面感觉更沉重。重新加载可以重置它,每个任务新开聊天可以保持上下文窗口干净。
VPN 会让 ChatGPT 变慢吗?
可能会。OpenAI 帮助中心将公司网络和 VPN 列为原因之一,因为请求可能走更长的路径。短暂关闭 VPN 并比较。如果你的工作场所要求使用它,请按 OpenAI 的建议与 IT 团队沟通。
为什么 ChatGPT 打字输出答案这么慢?
你看到的是流式传输:模型在编写时以小数据块发送答案,页面在每块到达时显示。文字慢慢滴出通常意味着答案很长或推理繁重。要求“五行答案”是减少总等待时间最简单的方法之一。
ChatGPT 桌面应用比浏览器更快吗?
OpenAI 没有发布应用之间的速度比较。桌面应用避免了浏览器扩展程序,这消除了一个常见的卡顿原因,所以如果 Chrome 感觉慢,这是一个公平的测试。非常长的对话在任何应用中仍然会沉重。
GPT-6 Luna 在 Atlas Cloud 上多少钱?
GPT-6 Luna 按 token 计费:截至 2026 年 10 月,其模型页面上每百万输入 token 0.10 美元,每百万输出 token 0.50 美元。总结一份 300 字的会议记录并给出完整答案总共大约使用一千个 token,不到一美分的零头。
结论
缓慢的 ChatGPT 会话通常归结为三个位置之一,而最便宜的测试是在笔记本电脑旁边用手机上的移动数据。如果手机快,就修复浏览器端:重新加载已打开数小时的标签页,尝试无痕模式,然后从摘要开始新对话。如果两者都慢,请阅读状态页面上的事件标题并等待恢复。
对于不断处理长文档的工作,通过 API 调用 GPT-6 Luna 可以让每个请求都有干净的上下文,并且文字一写出就显示在屏幕上。这就是我们找到的关于为什么 ChatGPT 在长而文档繁重的会话中如此缓慢的最可靠答案:聊天会增长,而请求不必增长。





