
 Atlas Cloud 现已成为 Dreamina Seedance 2.5 与 Seedream 5.0 Pro 的美国授权经销商。Atlas Cloud 现已成为 Dreamina Seedance 2.5 与 Seedream 5.0 Pro 的美国授权经销商。

Qwen 是 Alibaba Cloud 的大语言模型家族,Qwen API 向开发者开放了完整模型阵容。你可以使用旗舰级 Qwen3.7 Max 进行高级推理和编码,也可以使用覆盖多种规模的高效 mixture-of-experts 模型,以及用于即时、高并发响应的 Qwen3.5 Flash。在 Atlas Cloud 上,所有模型都通过同一个 endpoint 运行,采用透明的 pay-as-you-go 定价,并可在新版本发布当天即刻使用。立即开始构建。
Qwen 由 Alibaba 开发。Atlas Cloud(由 Atlas Cloud AI LLC 运营)仅提供接入服务,并不拥有该模型。所有商标均归其各自所有者所有。
Atlas Cloud 为您提供最新的行业领先创意模型。
了解各个 Qwen API endpoint 如何将文本提示词转换为生成文本,从快速轻量的助手到旗舰级推理模型,帮助你为工作负载匹配合适的模型。
| 模态 | 描述 |
|---|---|
| Qwen3.6 35B A3B(文本到文本) | 这是产品线中最新的推理模型。这个 35B mixture-of-experts endpoint 每个 token 约激活 3B 参数,让深度推理保持可负担的成本。适合提交多步数学、逻辑和分析任务,尤其是在 chain-of-thought 质量比原始速度更重要的场景。 |
| Qwen3.6 Plus(文本到文本) | Qwen3.6 Plus 适用于聊天和生产力工作流,兼具出色的对话质量、prompt caching,以及覆盖 256K tokens 以上输入的阶梯定价。当助手需要在长文档或冗长的多轮会话中保持连贯性时,可以优先选择它。 |
| Qwen3.5 122B A10B(文本到文本) | 这个 122B mixture-of-experts 模型每个 token 约运行 10B 活跃参数,以少量规模取舍换来更快、更低成本的推理。适合通用文本生成、摘要和推理任务,在中档成本下获得大模型级质量。 |
| Qwen3.5 35B A3B(文本到文本) | 当吞吐量和预算同样重要时,这个 35B MoE endpoint 每个 token 仅保持约 3B 参数处于活跃状态。适合高容量聊天、草稿撰写和分类任务,这些场景如果使用旗舰模型会显得资源浪费。 |
| Qwen3.5 27B(文本到文本) | Qwen3.5 27B 是一个 dense 27B 模型,无需 mixture-of-experts 路由即可提供可预测的延迟和稳定的质量。它适合直接的生成和指令遵循任务,尤其适合需要紧凑、可靠基础模型的场景。 |
| Qwen3.5 397B A17B(文本到文本) | 这是 3.5 层级中最大的模型。这个 397B mixture-of-experts endpoint 每个 token 激活约 17B 参数,并加入 prompt caching 以降低重复上下文成本。适合需要该系列最深层能力的高要求推理和生成任务。 |
| Qwen3.7 Max(文本到文本) | 作为旗舰模型,Qwen3.7 Max 面向高级推理、编码和复杂多步任务,并通过 prompt caching 降低重复上下文的成本。适合 agentic pipelines、高难度编码问题,以及准确性优先于价格的工作负载。 |
| Qwen3.5 Plus(文本到文本) | Qwen3.5 Plus 以高效为设计目标,可支持日常任务和 AI 助手,同时支持 prompt caching 以及超过 256K tokens 的输入。对于需要稳定质量且成本可控的生产级助手,它是可靠的默认选择。 |
| Qwen3.7 Plus(文本到文本) | 需要在一个模型中兼顾能力、速度和效率?Qwen3.7 Plus 在三者之间取得平衡,加入 prompt caching,并对超过 256K tokens 的提示词采用阶梯定价。适合规模化助手和文档密集型工作流,同时仍能提供快速响应。 |
| Qwen3.5 Flash(文本到文本) | Qwen3.5 Flash 针对即时响应和大规模使用进行了优化,是该系列中最快、最经济的选择。适合部署到高流量聊天、自动补全和实时功能中,尤其是在低延迟为优先事项的场景。 |
| Qwen3 VL 235B A22B Thinking(文本到文本) | 这个面向推理调优的 endpoint 采用 235B mixture-of-experts 架构,拥有约 22B 活跃参数,并提供专用的 thinking mode。适合结构化问题求解和分析任务,尤其适合能从明确、逐步推理中受益的场景。 |
| Qwen3-235B-A22B-Instruct-2507(文本到文本) | 这个 Qwen3 系列中的指令调优 MoE 模型拥有 235B 总参数,每个 token 约激活 22B 参数,可处理广泛的文本生成和推理任务。2507 版本使其成为 Qwen API 上通用助手和内容流水线的稳妥选择。 |
Qwen API 将双模式思考、原生函数调用、超过 256K tokens 的上下文、119 种语言覆盖以及 prompt caching 集成在一个 OpenAI-compatible key 之后,覆盖从 Qwen3.5 Flash 到 Qwen3.7 Max 的模型。
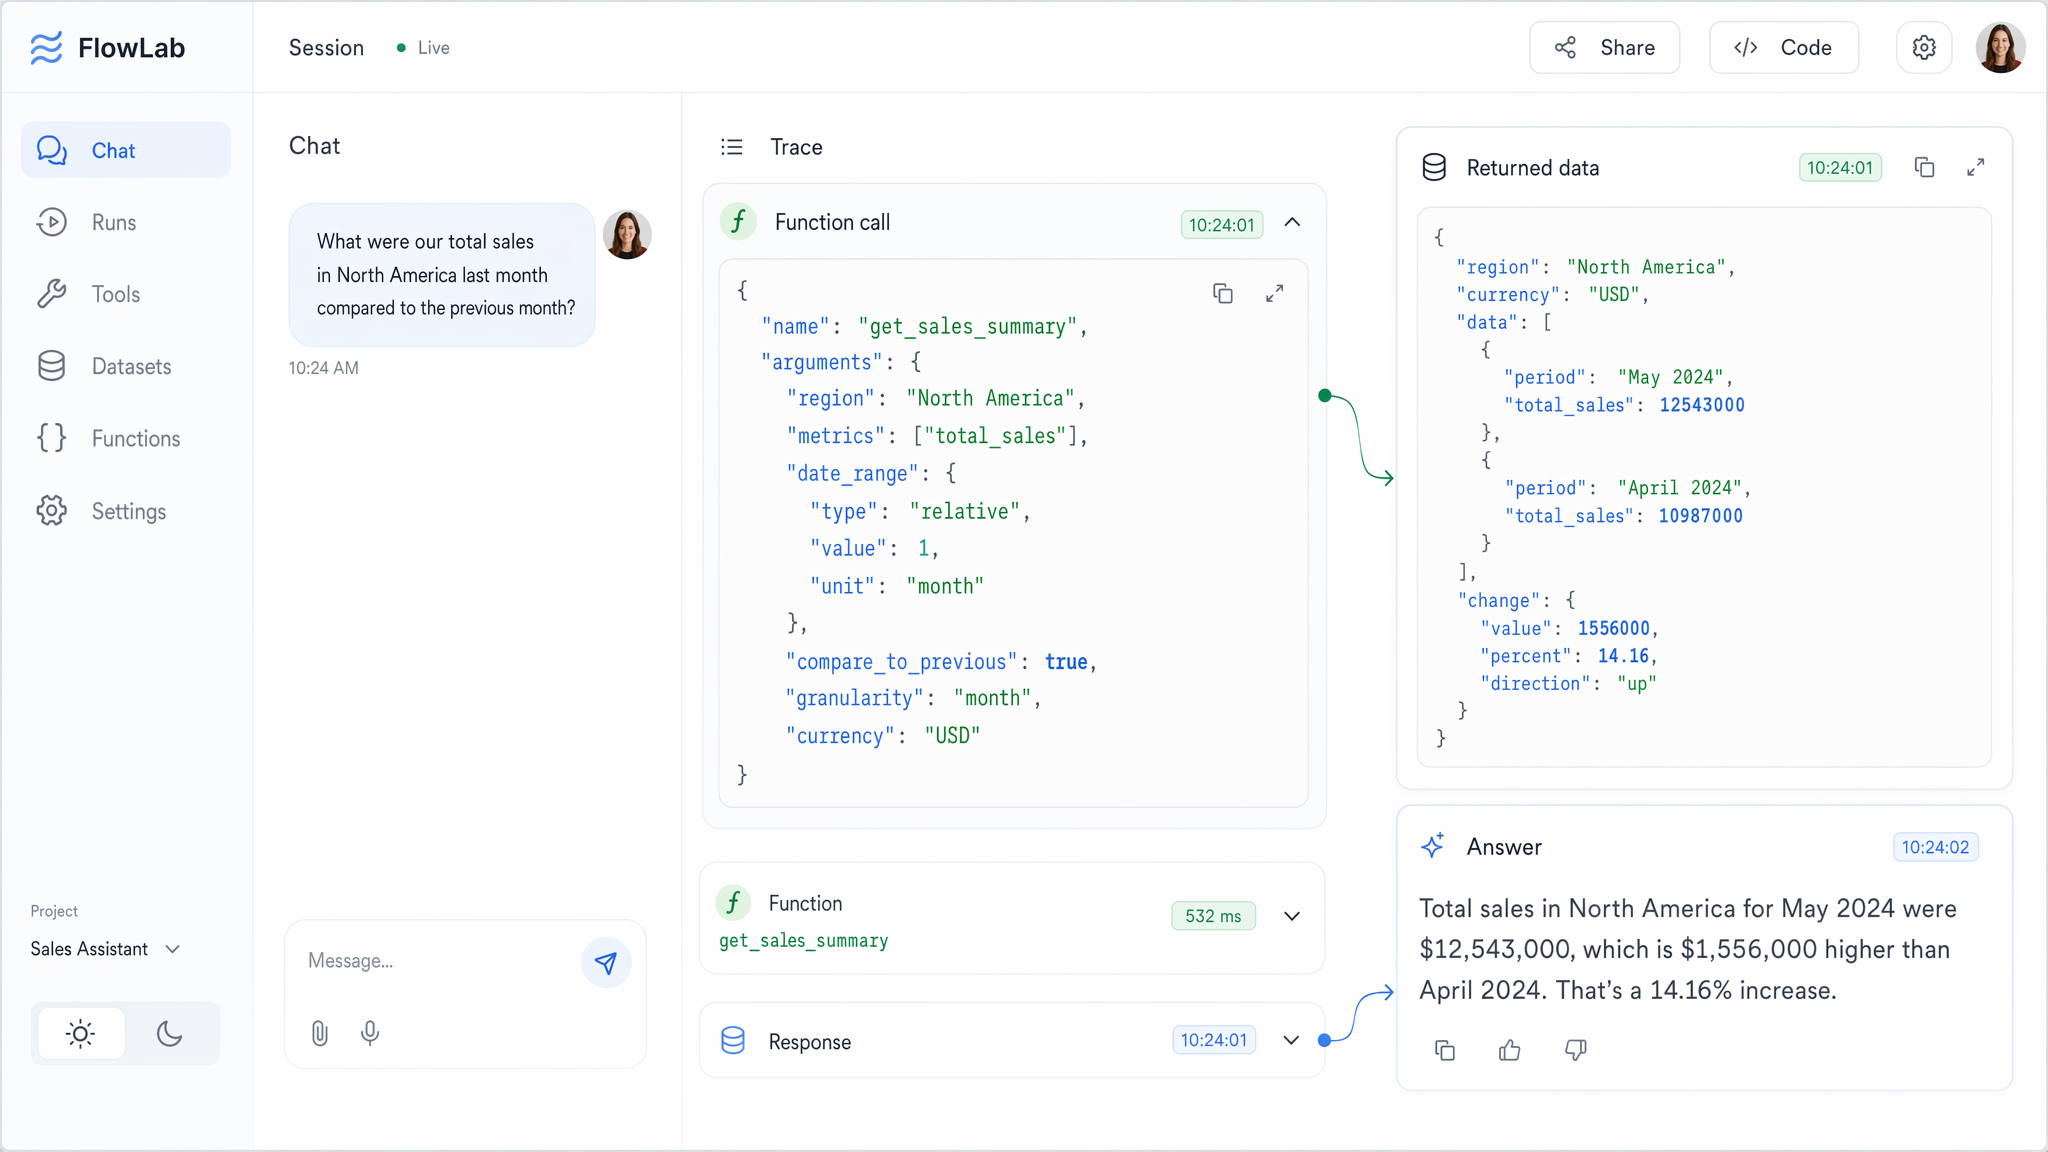
函数调用让 Qwen models 能够输出结构化的工具调用,并直接接入你自己的 APIs、数据库和 MCP servers。模型会决定何时调用函数、格式化参数,然后将结果整合回回答中。结合 OpenAI-compatible endpoint,这可以把现有的 SDK 代码转变为自主 Agent、检索流水线和工作流自动化。
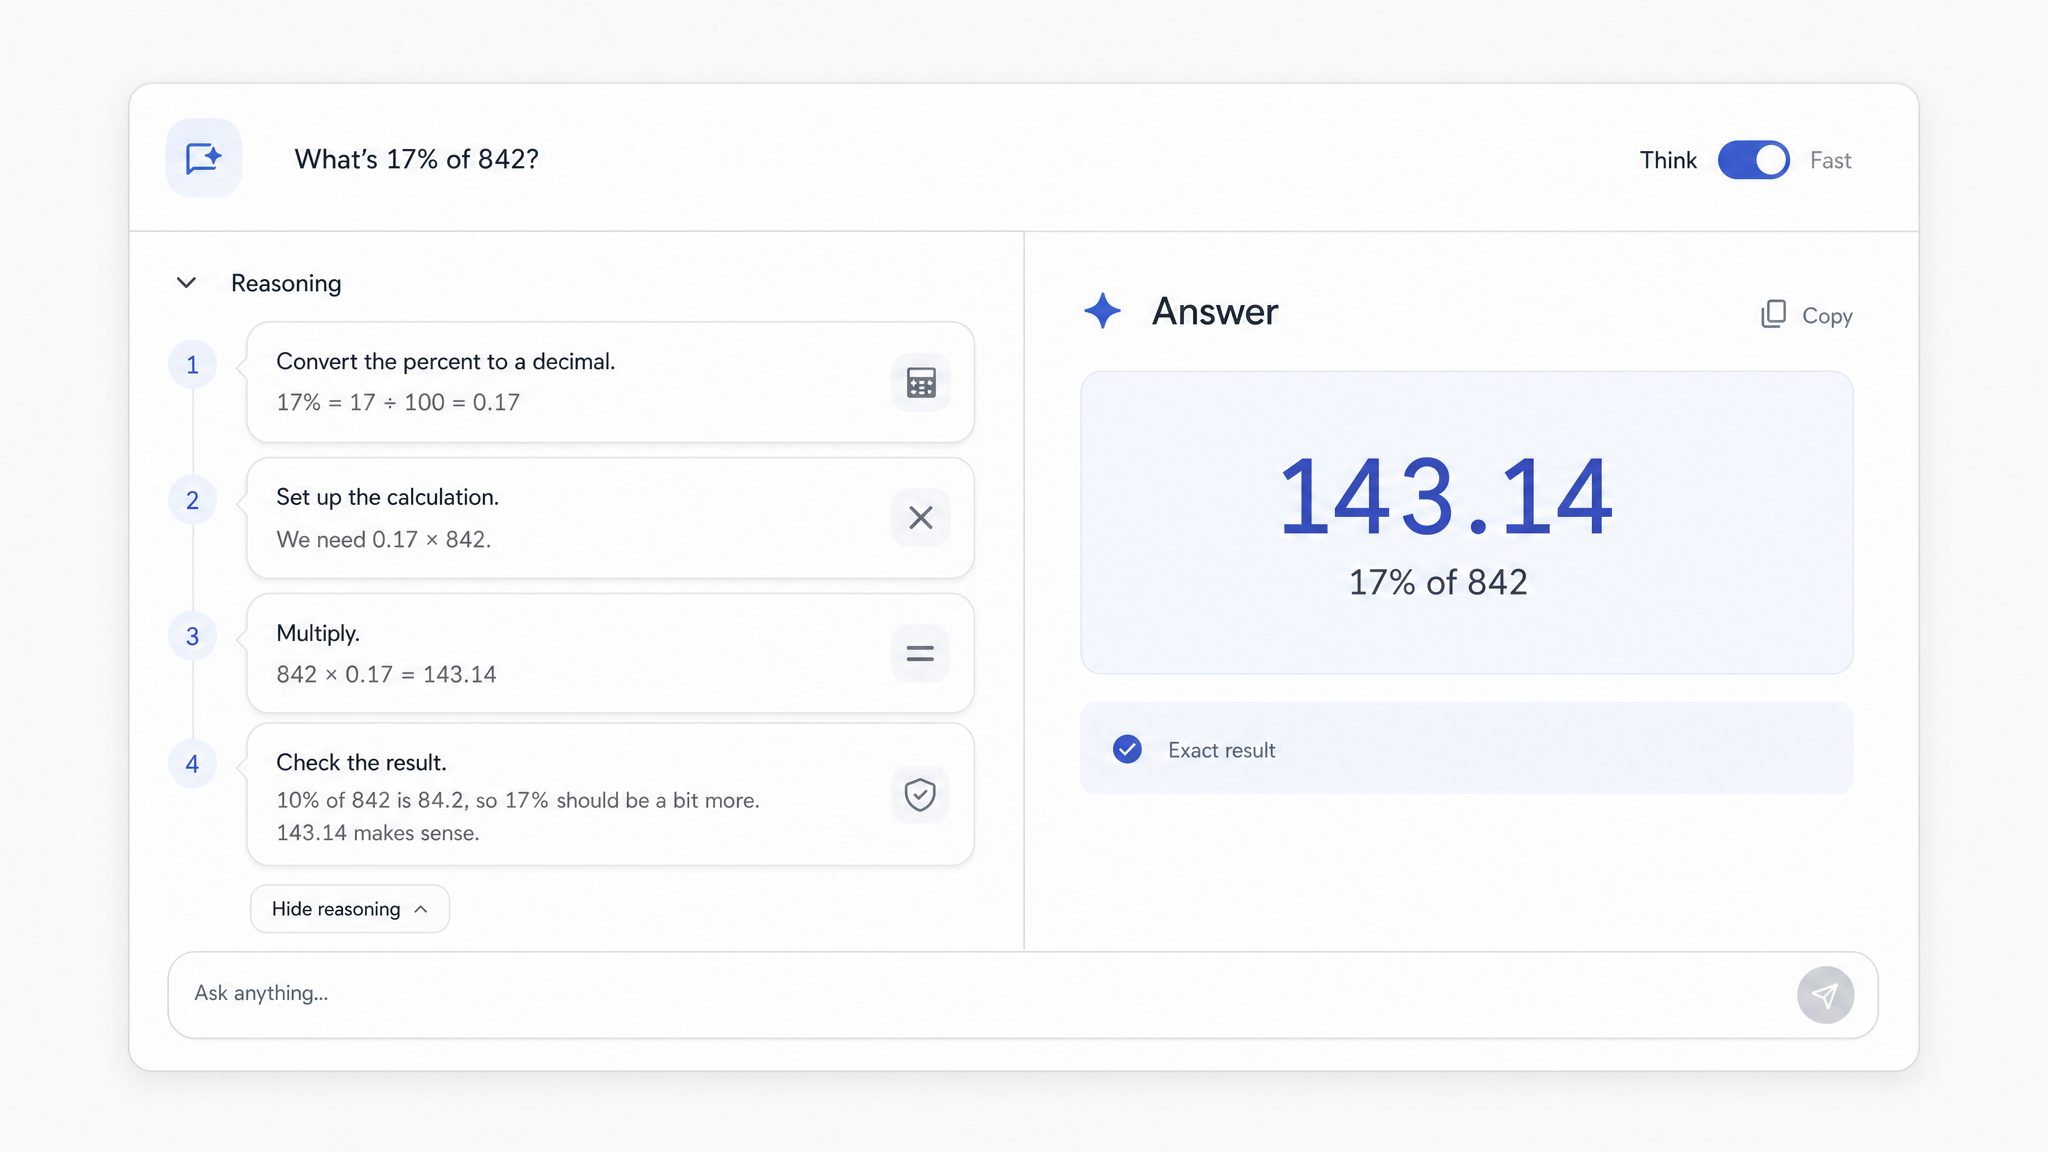
同一个模型可以在用于数学、逻辑和编码的深度思考模式,与用于日常对话的快速非思考模式之间切换。Qwen3.6 35B A3B 和旗舰 Qwen3.7 Max 等推理模型通过同一个 endpoint 提供这种深度能力。当任务需要逐步推导时启用思考;当延迟更重要时关闭思考,无需更换模型或 key。
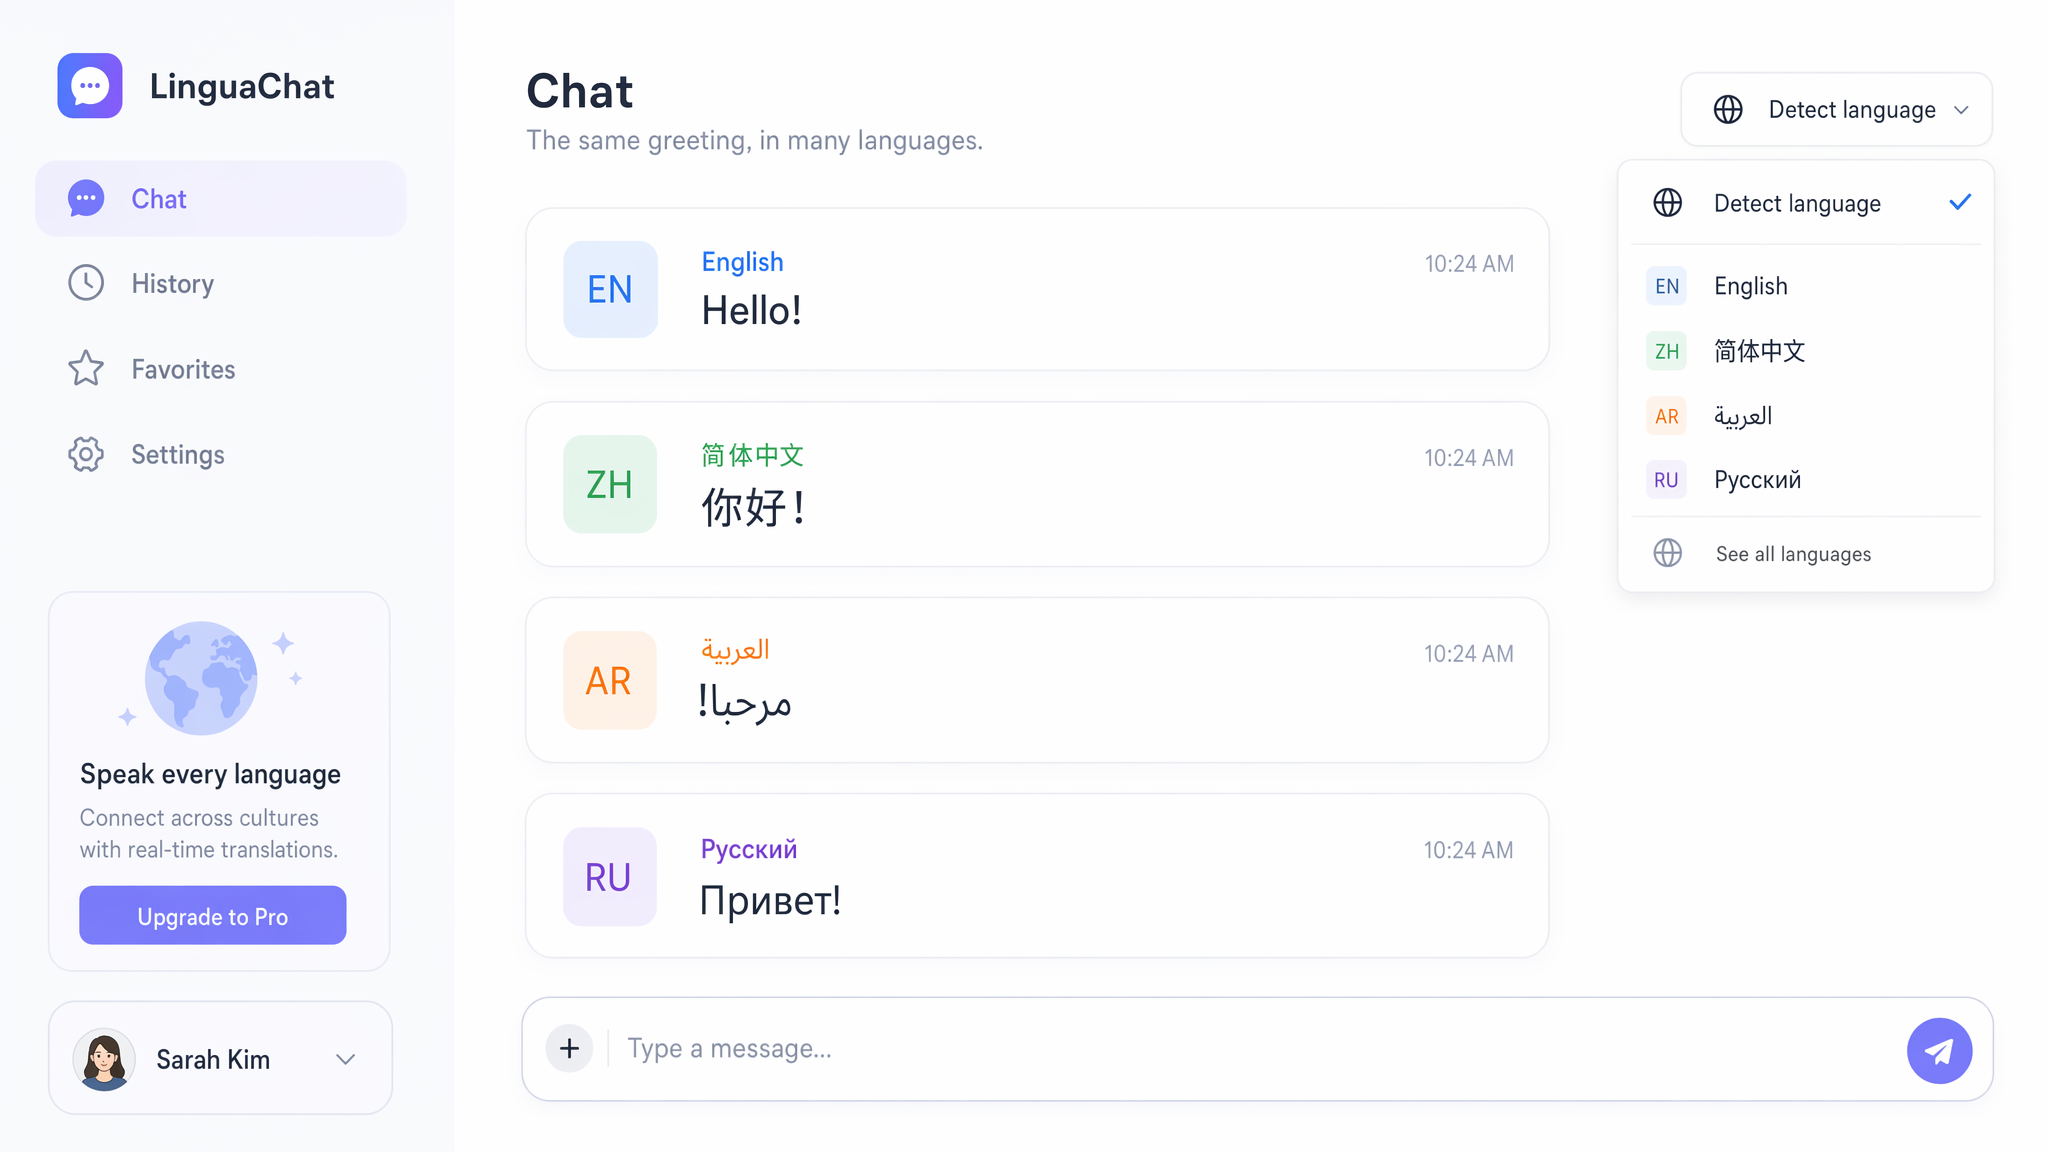
Qwen 在 119 种语言和方言上训练,能够流畅地处理多语言指令遵循和翻译,并在中文和英文上表现同样出色。单个 prompt 就可以在多种语言之间切换,无需单独的翻译服务。面向全球用户交付产品的团队依靠它实现本地化聊天、跨语言搜索,以及在每个目标市场都读起来自然的文案。
从低延迟的 Qwen3.5 Flash 到旗舰 Qwen3.7 Max,整个模型家族都可通过一个 OpenAI-compatible key 调用。397B A17B 和 235B A22B 等高效的 mixture-of-experts 设计,每个 token 只激活一小部分参数,并且所有层级共享相同的请求格式。无需重写任何集成代码,就能将简单调用路由到 Flash,将高难度推理路由到 Max。
重复上下文会按远低于标准输入价格的缓存费率计费,因此系统 prompts 和共享文档在每次后续调用中成本更低。定价保持按量付费且透明,公布按 token 计费的费率,无需订阅。高调用量助手、RAG stacks 和长对话受益最大,因为相同前缀会被一次又一次发送。
把同一份简报分别交给 Qwen API 和竞争引擎,然后观察每个模型如何将完全相同的指令转化为一个可直接打开并点击交互的单文件网页。
构建一个完整的、单文件、自包含的 HTML 页面(所有 CSS 和 JavaScript 都内联在一个 .html 文件中),渲染一个可交互的“深夜法式甜品店橱窗”——一个精品甜点展示柜,在打烊后仍散发着温暖的灯光。绝对约束:禁止使用任何外部资源——不使用 CDNs、不链接样式表或脚本、不使用 Web 字体、不使用 `<img>` 标签、不使用 SVG 文件、不使用 base64 照片、不把 emoji 当作美术元素。所有视觉内容都必须完全由带 CSS 样式的 HTML 元素构建:分层的 linear/radial/conic gradients、叠加与内阴影 box-shadows、border-radius、blur/backdrop-filter、transforms,以及 canvas 或 DOM 绘制的形状。这是一次仅用矢量 CSS 渲染拟真材质与光线的测试。 场景:从正面、视线水平的角度看进一家玻璃甜品橱窗,货架以平静的三分法构图排列。货架上摆放至少四款各不相同、精心制作的甜点,每一款都完全由渐变和阴影构成:(1) 一颗光亮的巧克力可可慕斯半球,带镜面淋面效果,能看到柔和的高光和反射光;(2) 一块 mille-feuille,拥有许多酥脆且清晰分离的千层酥皮层;(3) 一座分层的 macaron tower,外壳覆着糖霜、略带哑光质感;(4) 一只放在缓慢旋转转盘上的柠檬塔。要塑造可信的纵深:来自上方的暖金色聚光灯(橱窗展示灯)与冷蓝色夜间环境光形成对比,并具有投影、边缘轮廓光和柔和的光泽反射。所有元素前方悬浮着一层微妙的玻璃——淡淡的倒影、划痕,以及零散的冷凝水珠——并且每个甜点都在下方货架表面产生柔和倒影。 交互(全部使用平滑、带弹性的 CSS/JS 过渡): - HOVER 某个甜点:它会轻轻抬起,聚光灯和阴影增强,并通过横截面“cutaway”动画展示其内部结构——用堆叠渐变色带绘制分层奶油、ganache、curd,以及饼干/酥皮底,并带有标签。 - CLICK 某个甜点进入“Customize”模式:出现一个优雅的面板,包含滑块和开关,让用户实时添加并调节装饰元素——撒糖珠(密度滑块)、拉丝焦糖淋面(数量 + 丝线粗细)、镜面淋面/光亮 pectin 涂层(光泽度滑块),以及 berry-red 点缀淋面。甜点必须随着数值变化实时重绘,高光/光泽要响应光泽度数值。提供“Reset”和“Exit”控件。切换不同甜点时,要保留每个甜点的自定义设置。 - 可选氛围细节:暖灯有轻微动画闪烁,冷凝水缓慢漂移,柠檬塔的转盘循环旋转。 视觉风格:精致、舒适、诱人的深夜氛围;以焦糖棕、奶油白、莓果红为主色,并以薄荷绿点缀,背景为深冷蓝夜色。排版应具有高级甜品店气质——标题和甜点名称使用优雅的 CSS-only serif 字体栈,并采用宽松字距;布局保持整洁、有序且响应式,从移动端到宽屏都能呈现良好效果。相比堆砌元素,更优先考虑克制的微动画、分层纵深和材质真实感。包含直接在浏览器中打开文件并立即交互所需的一切。只输出完整 HTML 文档,不要输出其他内容。
Generated with Qwen3.7 Max on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with Qwen3.5 397BA17B on Atlas Cloud
创建一个单文件自包含的 HTML 文件(所有 CSS 和 JavaScript 内联,绝对不使用外部库、CDNs、图片、字体或网络请求),在一个填满浏览器窗口并能随 resize 保持响应式的 HTML5 Canvas 元素上,渲染一款名为“Rapid Run”的实时可玩白水皮划艇游戏。视角为第三人称俯视镜头,带轻微前向透视,俯瞰一条程序生成的高山溪流,河水从上到下持续滚动且永不重复:使用 noise/pseudo-random generator 为关卡设定种子,让每次游玩都切出不同的辫状河道,其中包含逐渐收窄的急槽、河心巨石、旋转漩涡、小型瀑布落差,以及翻腾白沫的浪列。玩家驾驶一艘深红与琥珀色的单人 kayak,位置保持在屏幕下方三分之一附近,河流从身边疾速掠过;使用 Left/Right 方向键(或 A/D)转向、压边和切线,并让鼠标充当船桨——kayak 会倾斜并朝鼠标的水平位置发力,点击或按住鼠标按钮可插入一次强力划桨,让船迅速切入更紧的线路。将水流模拟为由多层滚动 noise 驱动的实时 flow field:水流会把 kayak 向下游和侧向推移,在主流舌区更快,在回水区更慢,因此玩家必须读懂水势,并为竞速线路奋力调整。释放一个丰富且 GPU 友好的粒子系统——船头拍上浪时爆出扇形水花,船尾拖出翻腾尾流,撞击时泡沫片状炸开,漩涡向外扩散涟漪环。撞上岩石会让船体失控旋转,产生猛烈晃动,短暂失去控制,并触发镜头震颤。画面采用清爽的扁平插画风格,并融合轻度流体真实感:水面显示来自动流场的动态波纹和折射高光闪烁,正午高原顶光,水花上有冷白色镜面高光,深潭从冰川青蓝渐变到墨绿色深水。配色以 glacier cyan-blue 为主,kayak 的 vermilion-orange-yellow 作为强烈强调色,河岸以灰色岩石和松绿色装点。包含屏幕 HUD:已行进距离、当前速度、受撞击会下降的稳定性/生命值条,以及实时分数;显示带简要操作说明的开始界面,稳定性耗尽时显示游戏结束界面并提供 Restart 选项,并随着下行距离逐步提升难度(更快水流、更密集障碍)。目标是使用 requestAnimationFrame 和 delta-time physics 实现流畅 60fps 游戏循环,整体调校要真正紧张且令人满足,让玩家干净利落地穿过翻沫急槽时感到这是自己赢来的成果。
Generated with Qwen3.7 Max on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with Qwen3.7 Max on Atlas Cloud
了解 Qwen API 在 Atlas Cloud 上与其他旗舰文本模型在上下文长度、最大输出限制、支持的输入类型以及透明的按次调用定价方面的对比。
| 模型 | 上下文窗口 | 最大输出 Token 数 | 输入类型 | 输入价格($/1M) | 输出价格($/1M) |
|---|---|---|---|---|---|
| Qwen3.7 Max | 1M | 67,072 | 文本 | $2.50 | $7.50 |
| Qwen3.7 Plus | 1M | 67,072 | 文本 | $0.40(≤256K)/ $1.20(>256K) | $1.60 / $4.80 |
| Qwen3.6 35B A3B | 256K | 65,536 | 文本、图像、视频 | $0.248 | $1.485 |
| Qwen3.5 Flash | 1M | 67,072 | 文本 | $0.10 | $0.40 |
| DeepSeek V4 Pro | 1M | 393,216 | 文本 | $1.74 | $3.45 |
| Grok 4.5 | 500K | 500,000 | 文本 | $2.00 | $6.00 |
| GLM 5.2 | 1M | 131,072 | 文本 | $1.40 | $4.40 |
几分钟即可上手 — 按照以下简单步骤,通过 Atlas Cloud 平台集成和部署模型。
在 atlascloud.ai 注册并完成验证。新用户可获得免费额度,用于探索平台和测试模型。
将先进的 Qwen 模型与 Atlas Cloud 的 GPU 加速平台相结合,提供无与伦比的性能、可扩展性和开发体验。
低延迟:
GPU 优化推理,实现实时响应。
统一 API:
一次集成,畅用 Qwen、GPT、Gemini 和 DeepSeek。
透明定价:
按 Token 计费,支持 Serverless 模式。
开发者体验:
SDK、数据分析、微调工具和模板一应俱全。
可靠性:
99.99% 可用性、RBAC 权限控制、合规日志。
安全与合规:
SOC 2 Type II 认证、HIPAA 合规、美国数据主权。
Qwen API 让开发者能够以编程方式访问 Alibaba Cloud 的 Qwen 大语言模型系列,用于文本生成、推理、编码和多语言任务。在 Atlas Cloud 上,你可以通过一个 OpenAI 兼容端点访问完整模型阵容,因此一个密钥即可覆盖所有 Qwen 模型。
Atlas Cloud 托管了丰富的模型阵容,从快速且经济的 Qwen3.5 Flash,到通用的 Plus 层级,再到面向高级推理和编码打造的旗舰模型 Qwen3.7 Max。专注推理的模型(如 Qwen3.6 35B A3B)以及大型 mixture-of-experts 变体(如 Qwen3.5 397B A17B)也可用于更重的工作负载。
开始使用只需几个步骤:创建 Atlas Cloud 账户、生成 API key,并将你现有的 OpenAI 兼容客户端指向 Atlas endpoint。定价采用按量付费模式,按调用透明计费;Day-0 access 意味着新的 Qwen 版本一经发布即可使用。立即开始构建。
是的。Atlas Cloud 上的 Qwen API 遵循 OpenAI chat completions 格式,因此大多数 SDK 只需替换 base URL 和 key 即可使用。你可以继续使用现有工具链,并在不重写集成的情况下调用任意 Qwen 模型。
Atlas Cloud 上的 Qwen 模型采用透明的按量付费定价,按 token 计费,无需订阅。Qwen3.5 Flash 的价格从每百万 input tokens $0.1、每百万 output tokens $0.4 起,旗舰模型 Qwen3.7 Max 则为每百万 tokens $2.5 和 $7.5,因此你可以根据每个工作负载匹配支出。
Qwen3.7 Max 等旗舰模型提供最高可达 one million tokens 的上下文窗口,适合长文档、大型代码库和长时间对话历史。该系列还覆盖文本以及视觉语言变体(如 Qwen3-VL),让你在任务不只是纯文本提示时也有更多选择。
除了普通聊天,Qwen 模型还通过标准 API 参数支持流式响应、function calling 和结构化工具使用。Qwen3.7 Max、Qwen3.6 35B A3B 等专用推理模型为数学、编码和复杂 agentic 任务提供逐步问题求解能力。
选择取决于你在速度、成本和能力之间需要怎样的平衡。当延迟和高吞吐量很重要时,选择 Qwen3.5 Flash;日常助手和生产力工作流可选择 Plus 层级;当任务需要最强推理和编码能力时,选择 Qwen3.7 Max。由于所有模型共享同一个 endpoint,在它们之间切换只需更改一个参数。
Seedance 2.5 API 现已在 Atlas Cloud 上线!它为开发者提供了 ByteDance 最新的视频模型。该模型可通过文本、单张图像或多达 50 个多模态参考,一次性生成长达 30 秒的原生视频,并包含同步音频和画面内的多语言文本。在 Atlas Cloud 上,您可以通过单个密钥访问它,其主体一致性和改进的物理特性能够保持长镜头的连贯性。

Wan 3.0 API 是阿里巴巴 Wan 视频系列的下一代产品,旨在将长视频生成、多参考控制和音视频质量推向新的高度。Atlas Cloud 已经托管了 Wan 2.7、2.6 和 2.5,而 Wan 3.0 使用相同的统一密钥运行,无需额外设置。立即开始构建吧。向下滚动至展示区,查看 Wan 3.0 的创作能力。
MiniMax H3 是 MiniMax 的多模态视频系列,支持文本、图像和参考内容引导创作。在支持的路由中,它能够保留参考媒体中的主体,提供灵活的宽高比,并通过 H3 Developer 将生成的声音与画面结合;输出配置则由 endpoint 选择。Atlas Cloud 通过一个 OpenAI 兼容密钥统一接入整个系列,并提供透明的按量付费定价,标准费率为每秒 $0.038。立即开始构建。
OpenAI 的 gpt-image-2.5 系列为开发者提供 Flare 和 Sunburst 两种选择,满足生产级图像工作流需求。支持最高 3840x2160 的任意分辨率渲染,并提供包括 xhigh 和 max 在内的五档质量等级,以匹配特定的输出要求。Atlas Cloud 提供开箱即用的 REST 推理服务,无冷启动,每次生成起价 $0.004,采用标准定价。立即开始构建。
Seedream 5.0 Pro API 为开发者在 Atlas Cloud 上提供了字节跳动的可控图像编辑模型。它通过锚点和坐标精确定位编辑,将图像分离为可编辑图层,融合多个参考,并精准匹配颜色和材质,支持 2K 和 3K 分辨率的多语言文本。在 Atlas Cloud 上,您只需一个密钥即可访问!
Seedance 2.0 是 ByteDance 面向生产环境的视频模型,专用于精准镜头创作。将提示词转换为视频,使用首帧图像生成动画并可选用尾帧引导,或结合参考媒体和可选的联网搜索来塑造结果。Atlas Cloud 将这些工作流整合到统一的 API 中,提供透明的按量付费定价和一个兼容 OpenAI 的密钥。立即开始构建。
Kling 3.0 API 通过一个 OpenAI 兼容的密钥,将 Kuaishou 的旗舰视频套件引入 Atlas Cloud。它包含两个模型:Kling 3.0 用于 AI Director 叙事、多语言唇形同步和精准的屏幕文本;Kling 3.0 Omni (O3) 用于通过短视频或图像进行主体和声音克隆。两者都能在同一次处理中生成原生音频,最高支持 4K 输出。在可靠的基础设施上构建电影级叙事、全球营销、多语言广告和系列化角色内容。
Grok Imagine Video 为开发者提供访问 xAI 视频模型家族的能力,用于创建、制作动画、延展和编辑视频片段。通过提示词生成 1 至 15 秒的视频,使用最多 7 张参考图像引导人物、物体或风格,并支持 480p 或 720p。Atlas Cloud 通过兼容 OpenAI 的端点整合这些能力,并提供透明的按需付费定价。立即开始构建。
Vidu Q4 是 Vidu 最新的旗舰视频模型,专为图像转视频和参考图转视频生成而设计。它可以让单张静态图像动起来,并自动创建场景转场,为不同的产品工作流提供两种输入路径。Atlas Cloud 提供专用 API 端点,并以经验证的标准价格 $0.04/second 发布参数 schema。立即开始构建。
Gemini Omni 1.1 Flash 是 Google DeepMind 推出的原生多模态视频系列,适用于灵活的生产工作流。通过文本指令编辑现有素材,借助最多 10 张参考图像和 3 段视频片段保持视觉一致性,或以可串联的片段延长镜头,最长可达 40 秒。在 Atlas Cloud 上使用一个 OpenAI-compatible API key 即可访问所有工作流,按量付费,并支持 Day-0 上线。立即开始构建。
Nano Banana 2.1 是 Google 基于 Gemini 3.6 Flash 打造的图像模型系列。它以 Flash 级速度提供 Pro 级生成与编辑能力,支持通过自然语言对 1 到 14 张输入图像进行编辑和融合,并可保持最多 4 个角色和 10 个对象的一致性。通过 Atlas Cloud,开发者只需使用一个 OpenAI-compatible 密钥,即可访问该系列模型,享受可靠的运行时间保障和 Day-0 可用性。立即开始构建。
使用由 Google 的 Gemini 3.1 Flash Image 模型驱动的 Nano Banana 2 API 进行构建。它可生成分辨率高达 4096x2304 的原生 4K 视觉效果,具备准确的文本渲染能力,并在生成和编辑过程中支持多达 14 张参考图像的角色一致性。在 Atlas Cloud 上,您可以通过一个统一的 API 访问它以及其他 300 多个模型,价格低至每张图像 0.04 美元,提供 99.99% 的正常运行时间,并附赠免费额度供您开始使用。


