يصل شريط التنزيل إلى 65 GB، وتبدأ المراوح بالدوران، ثم يطرح السؤال الحقيقي: هل سيُحمَّل فعلاً؟ الجواب المختصر عن متطلبات الذاكرة لـ GPT-OSS-120B هو نحو 61 GB للأوزان، إضافة إلى بضعة غيغابايتات أخرى لمساحة العمل، ولهذا تسوّقه OpenAI كنموذج يعمل على وحدة GPU واحدة بسعة 80GB.
أدناه، نفصّل هذا الرقم إلى أجزائه، ونعرض العتاد الذي شغّله بسرعات مقيسة، ونغطي المسار المستضاف عندما لا يفي عتادك بالغرض.
أهم النقاط
- يأتي GPT-OSS-120B كنقطة تحقق MXFP4 بحجم 60.8 GiB، ولهذا تستهدفه OpenAI على وحدة GPU واحدة بسعة 80GB.
- لا يضيف طول السياق ذاكرة كبيرة: يصل KV cache إلى حوالي 4.5 GiB فقط عند 131K رمزاً كاملة.
- مع أقل من 80GB من VRAM، يمكن لـ llama.cpp نقل طبقات الخبراء إلى ذاكرة النظام وتشغيله رغم ذلك.
- يمكن لأجهزة Mac التي تملك أكثر من 96GB من الذاكرة وأجهزة الكمبيوتر الصغيرة بسعة 128GB أن تستوعب النموذج كاملاً في جهاز واحد.
- لا تملك عتاداً مناسباً؟ استدعِ Qwen3.5 122B A10B على Atlas Cloud عبر واجهة API واحدة متوافقة مع OpenAI.
متطلبات الذاكرة لـ GPT-OSS-120B: الأوزان بالإضافة إلى KV Cache
أطلقت OpenAI نموذج gpt-oss-120b في 5 أغسطس 2025، بموجب ترخيص Apache 2.0. وهو نموذج خليط خبراء، لذا يعمل 5.1B فقط من أصل 116.8B معامل عند كل رمز. يساعد ذلك على السرعة، لا على الذاكرة: إذ يبقى كل خبير في الذاكرة جاهزاً للاختيار.
الحيلة التي تبقيه صغيراً هي MXFP4. وفقاً لـ بطاقة نموذج gpt-oss، تُخزَّن أوزان الخبراء، التي تشكل أكثر من 90% من المعاملات، عند 4.25 بت لكل وزن. وستحتاج نسخة 16-بت من النموذج نفسه إلى مساحة أكبر بنحو أربعة أضعاف.
| المواصفة | GPT-OSS-120B |
|---|---|
| إجمالي المعاملات | 116.8B |
| المعاملات النشطة لكل رمز | 5.1B |
| الطبقات والخبراء | 36 طبقة، 128 خبيراً، 4 نشطة لكل رمز |
| صيغة الأوزان | MXFP4 لطبقات الخبراء، BF16 للباقي |
| حجم نقطة التحقق | 60.8 GiB |
| نافذة السياق | 131,072 رمزاً |
كيف تُغيّر نافذة السياق ذاكرة GPT-OSS-120B
يترك كل رمز مفتاحاً وقيمة خلفه في كل طبقة انتباه. ذلك المخزن هو KV cache، وعندما تنتبه كل طبقة إلى السياق الكامل، فإنه ينمو بالتوازي مع طول السياق.
يتفادى GPT-OSS-120B معظم ذلك. فنصف طبقاته الـ 36 تستخدم نافذة منزلقة تنظر للخلف 128 رمزاً فقط، وكل طبقة تخزّن 8 رؤوس KV فقط بأبعاد 64. وتحتفظ 18 طبقة فقط بالسياق كاملاً. لقد حسبنا KV cache من إعدادات النموذج وهو يطابق الإجماليات المقيسة في دليل llama.cpp gpt-oss.
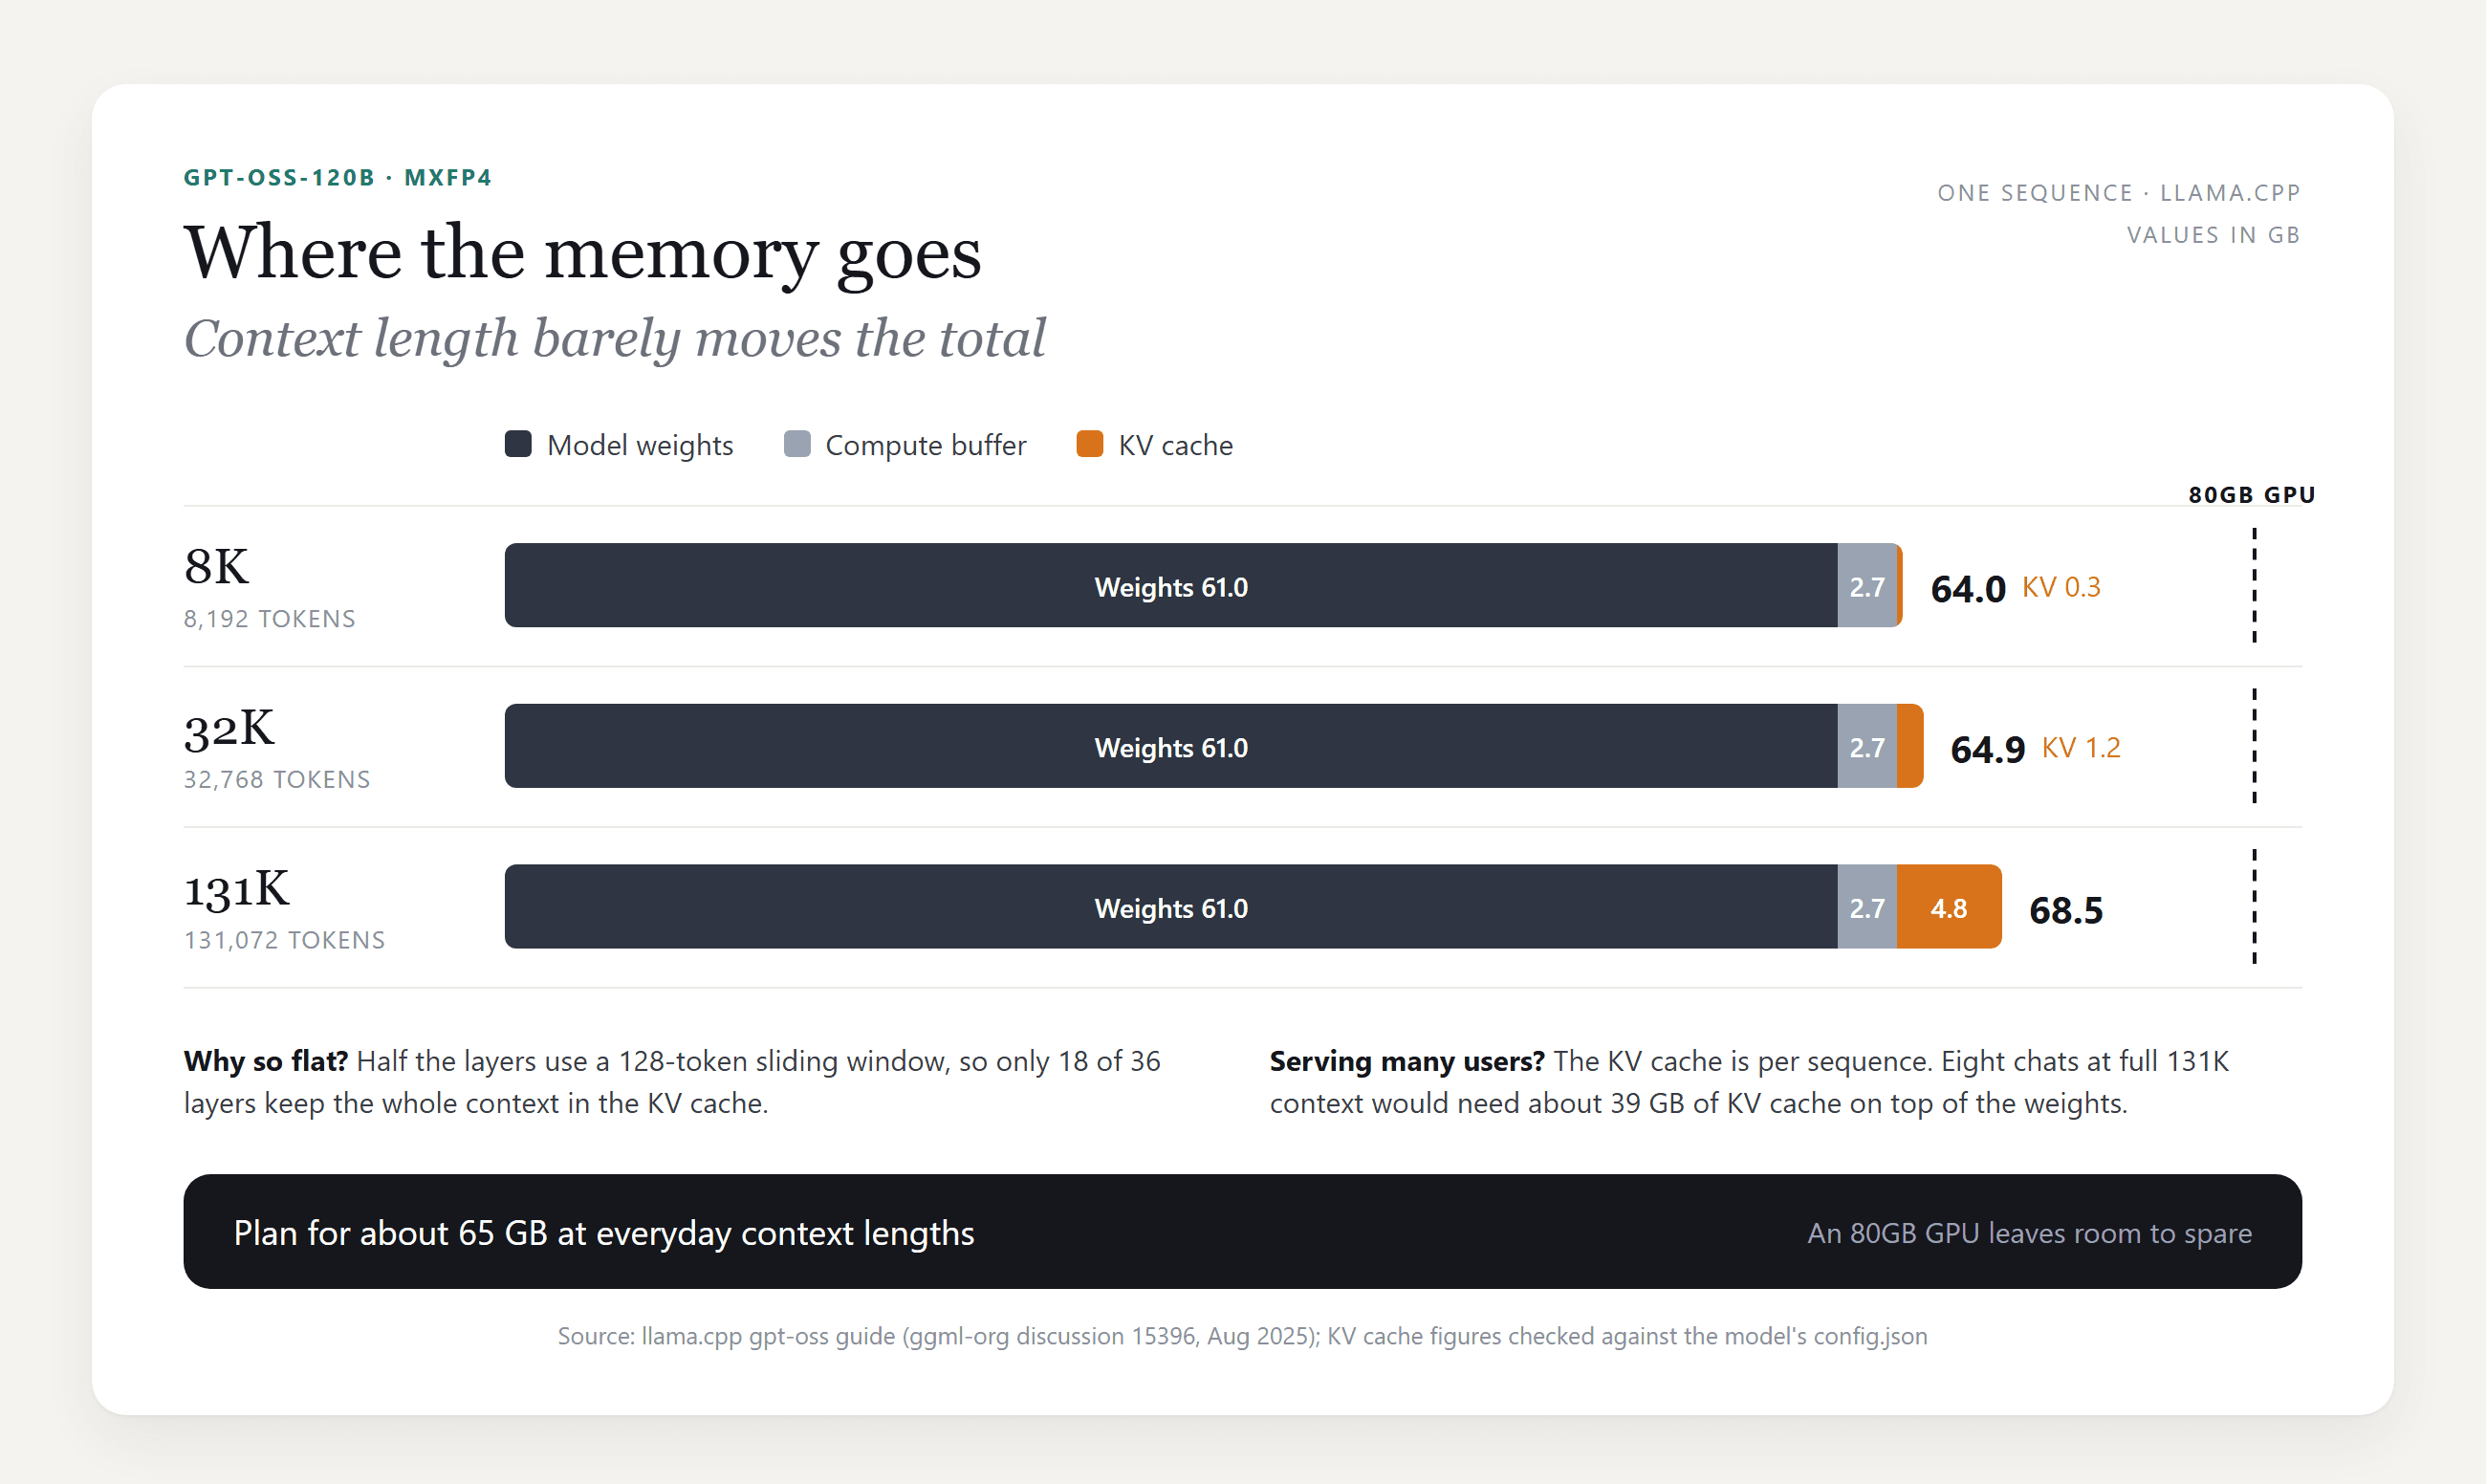
الانتقال من 8K إلى 131K كاملة يكلّف أقل من 5 GB. أما موضع التراكم فهو التزامن: إذ إن KV cache لكل محادثة، لذا يحتاج خادم يحتفظ بثماني محادثات كاملة الطول إلى نحو 39 GB إضافية فوق الأوزان.
هل يمكنني تشغيل GPT-OSS-120B محلياً؟ متطلبات العتاد حسب الإعداد
نعم، إذا كان بإمكانك تخصيص نحو 65 GB في مكان سريع: وحدة GPU كبيرة واحدة، أو GPU مع ذاكرة النظام، أو جهاز بذاكرة موحدة.
متطلبات GPU لـ GPT-OSS-120B
أبسط حالة هي بطاقة مركز بيانات واحدة بسعة 80GB. تقول وصفة vLLM لـ gpt-oss إن نموذج 120b "سيتّسع على بطاقة A100 واحدة (80GB)"، وإن توزيعه على مزيد من وحدات GPU يحسّن الإنتاجية.
تحت 80GB، يقدّم دليل llama.cpp مخرجاً. إذ تُبقي رايته --n-cpu-moe بعض طبقات الخبراء في ذاكرة النظام والباقي على GPU. ويضع الدليل الحد الأدنى عند نحو 8GB من VRAM، ما دام مجموع ذاكرة GPU وذاكرة النظام كافياً لاستيعاب النموذج.
| الإعداد | مكان وجود الأوزان | سرعة التوليد المُبلَّغ عنها |
|---|---|---|
| RTX Pro 6000، 96GB | كلها على GPU | 196 رمزاً/ث (دليل llama.cpp) |
| A100 أو H100، 80GB | كلها على GPU | تتّسع على بطاقة واحدة (وصفة vLLM) |
| RTX 5090، 32GB، مع ذاكرة النظام | 21 طبقة خبراء محفوظة في ذاكرة النظام | نحو 30 رمزاً/ث عند سياق صفري (دليل llama.cpp) |
فخ واحد في Windows من الدليل نفسه: قد يتدفق برنامج التشغيل بصمت إلى ذاكرة النظام عند نفاد VRAM، فيُحمَّل النموذج ثم يتباطأ بشدة. راقب GPU Memory في Task Manager وارفع عدد الطبقات المُنقلة حتى يبقى تحت سعة بطاقتك.
تشغيل GPT-OSS-120B على Mac أو كمبيوتر صغير بسعة 128GB
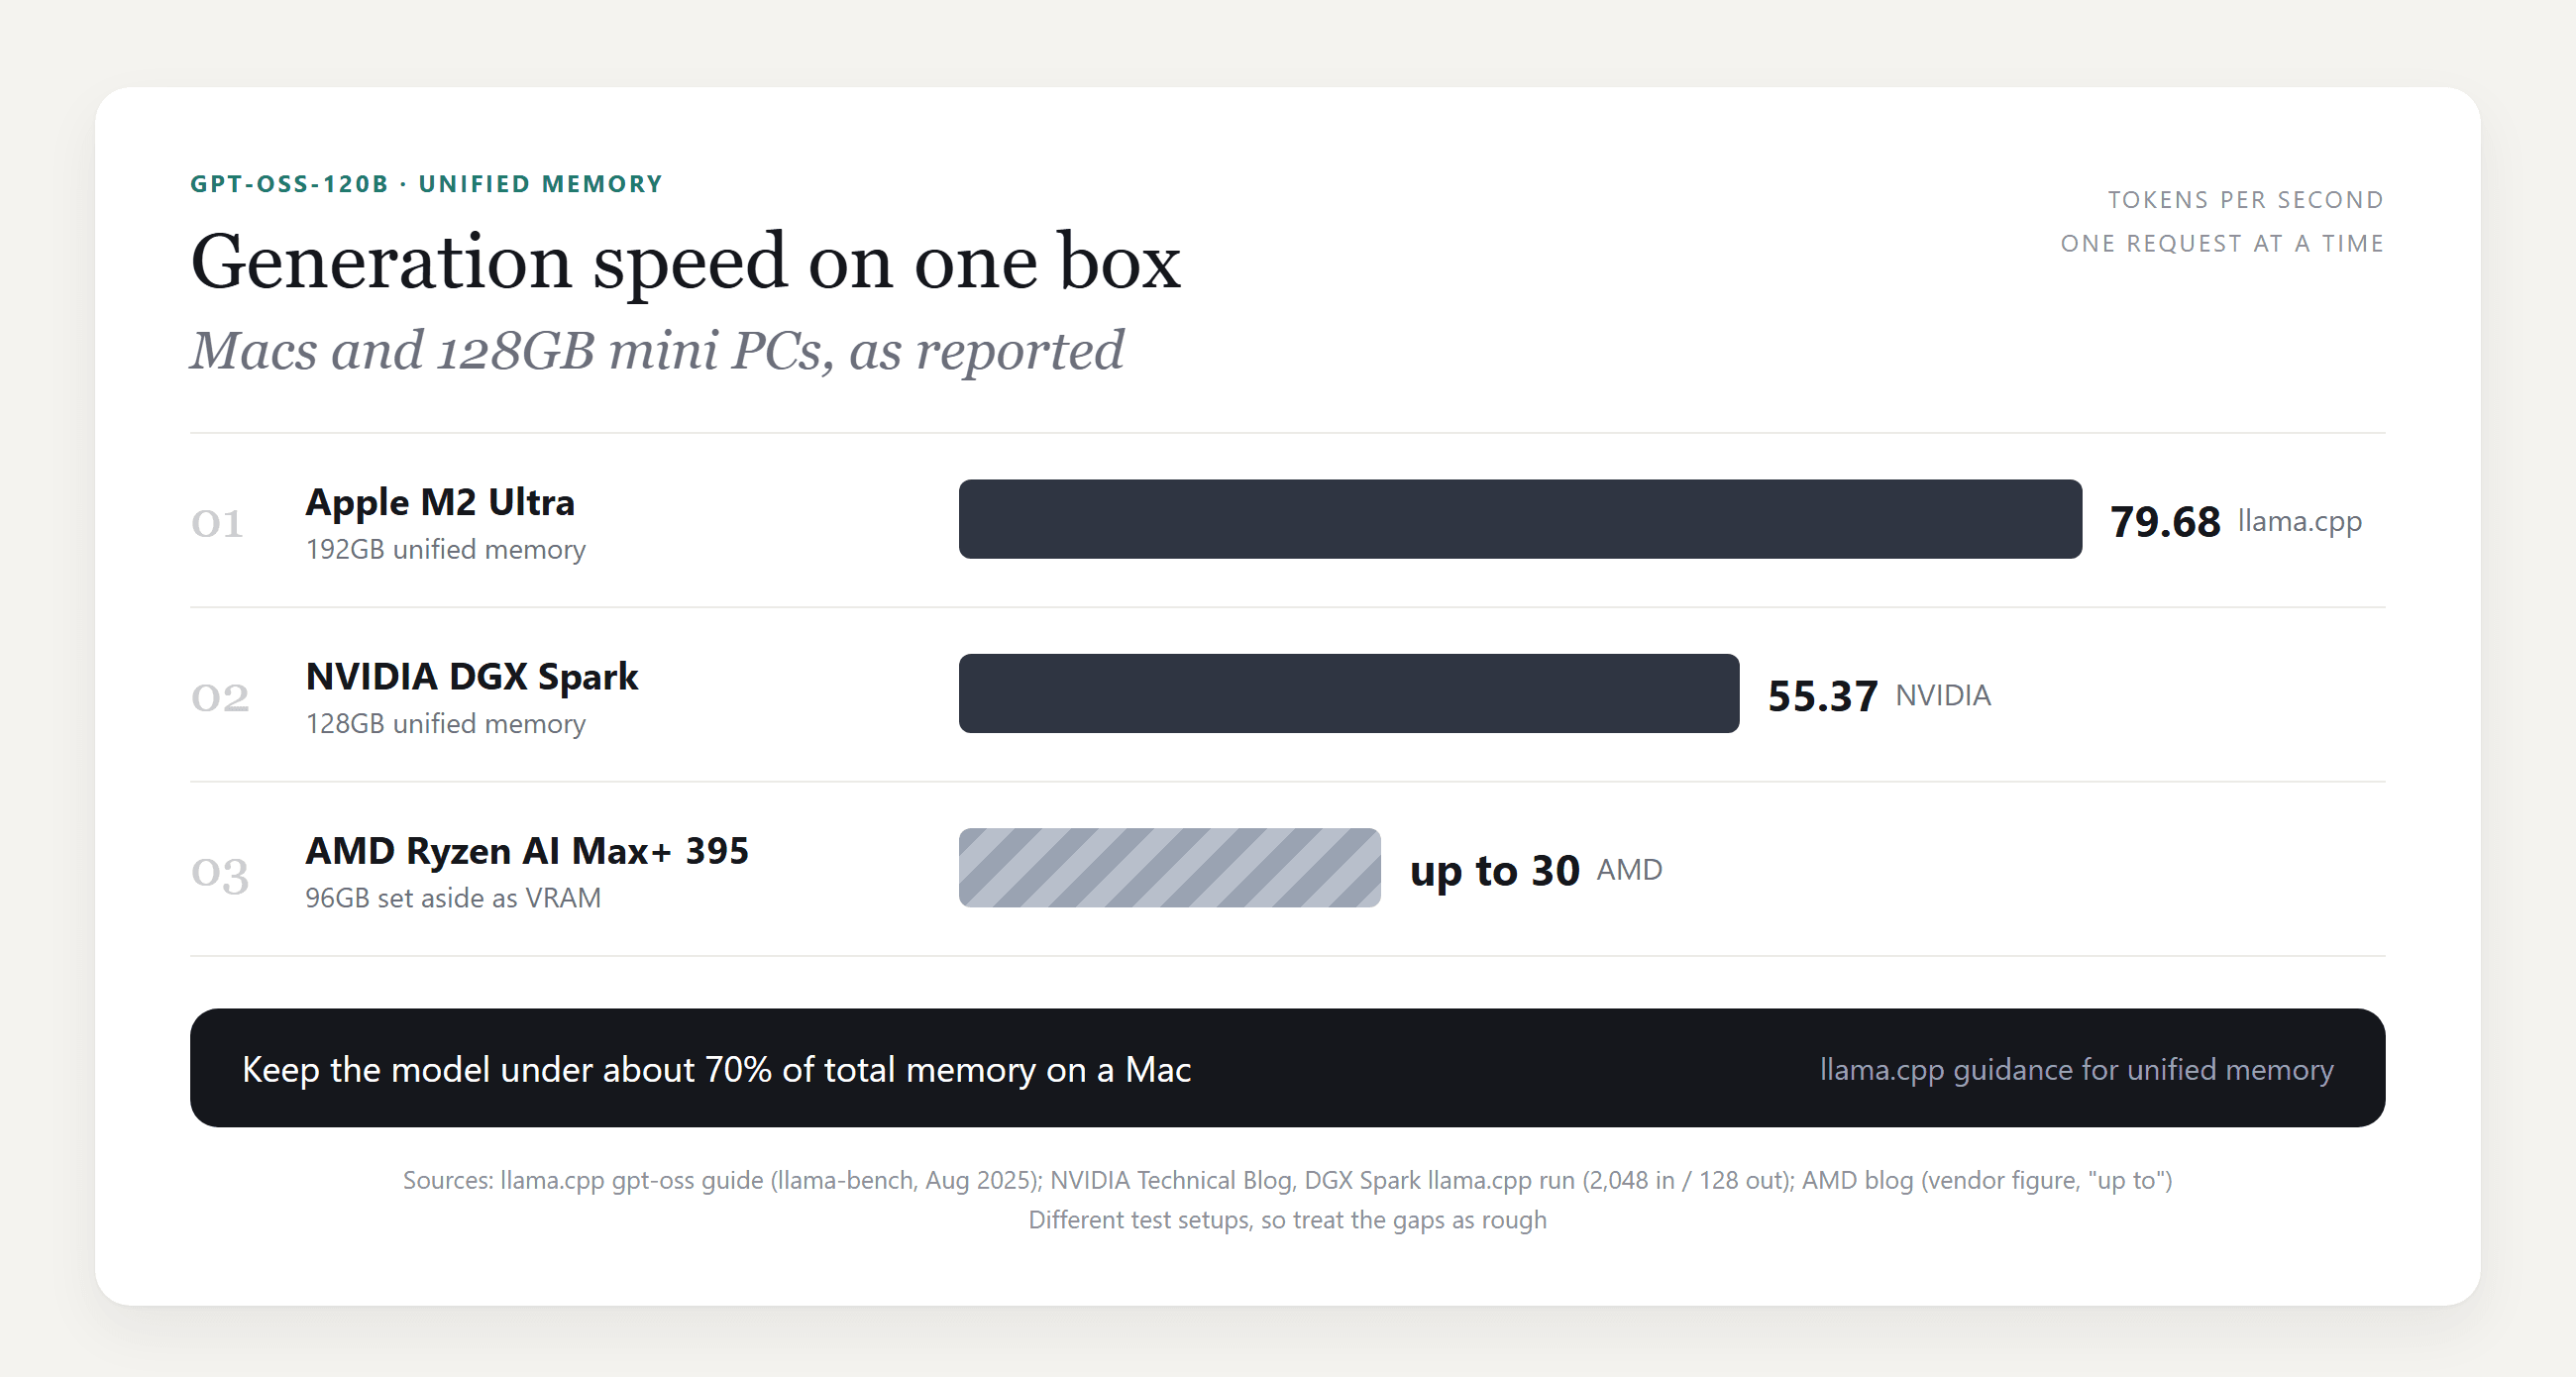
تلغي الذاكرة الموحدة الفصل بين GPU وRAM. يقول دليل llama.cpp إن أجهزة Mac التي تملك أكثر من 96GB من RAM، مثل أجهزة M2 Ultra أو M3 Max، يمكنها تشغيل النموذج بكامل السياق، وينصح بالبقاء تحت نحو 70% من إجمالي الذاكرة.
يحدّ macOS افتراضياً من كمية الذاكرة التي يمكن لوحدة GPU تثبيتها. على جهاز بسعة 192GB، يرفع الدليل هذا الحد من 154GB إلى 180GB بأمر واحد:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
تقع أجهزة الكمبيوتر الصغيرة الجديدة بسعة 128GB في الفئة نفسها. وتذكر NVIDIA سرعة 55.37 رمزاً/ث لـ gpt-oss-120b على DGX Spark يعمل بـ llama.cpp. وتقول AMD إن جهاز Ryzen AI Max+ 395 مع تخصيص 96GB كـ VRAM يصل إلى "ما يصل إلى 30 رمزاً في الثانية"، وهو رقم الشركة نفسها.
لا تملك ذاكرة كافية؟ استخدم نموذجاً مفتوح الأوزان مستضافاً عبر API
إذا لم يكن أي من تلك الأجهزة على مكتبك، فإن نموذجاً مفتوح الأوزان مستضافاً يتجاوز مسألة العتاد بالكامل.
يقدّم Atlas Cloud نموذج Qwen3.5 122B A10B، ضمن تشكيلة نماذج Qwen. على الورق، إنه مطابق قريب لـ gpt-oss-120b: نموذج خليط خبراء بترخيص Apache 2.0 من فريق Qwen في Alibaba، بإجمالي 122B و10B معاملات نشطة. ويقرأ حتى 262,144 رمزاً من السياق.
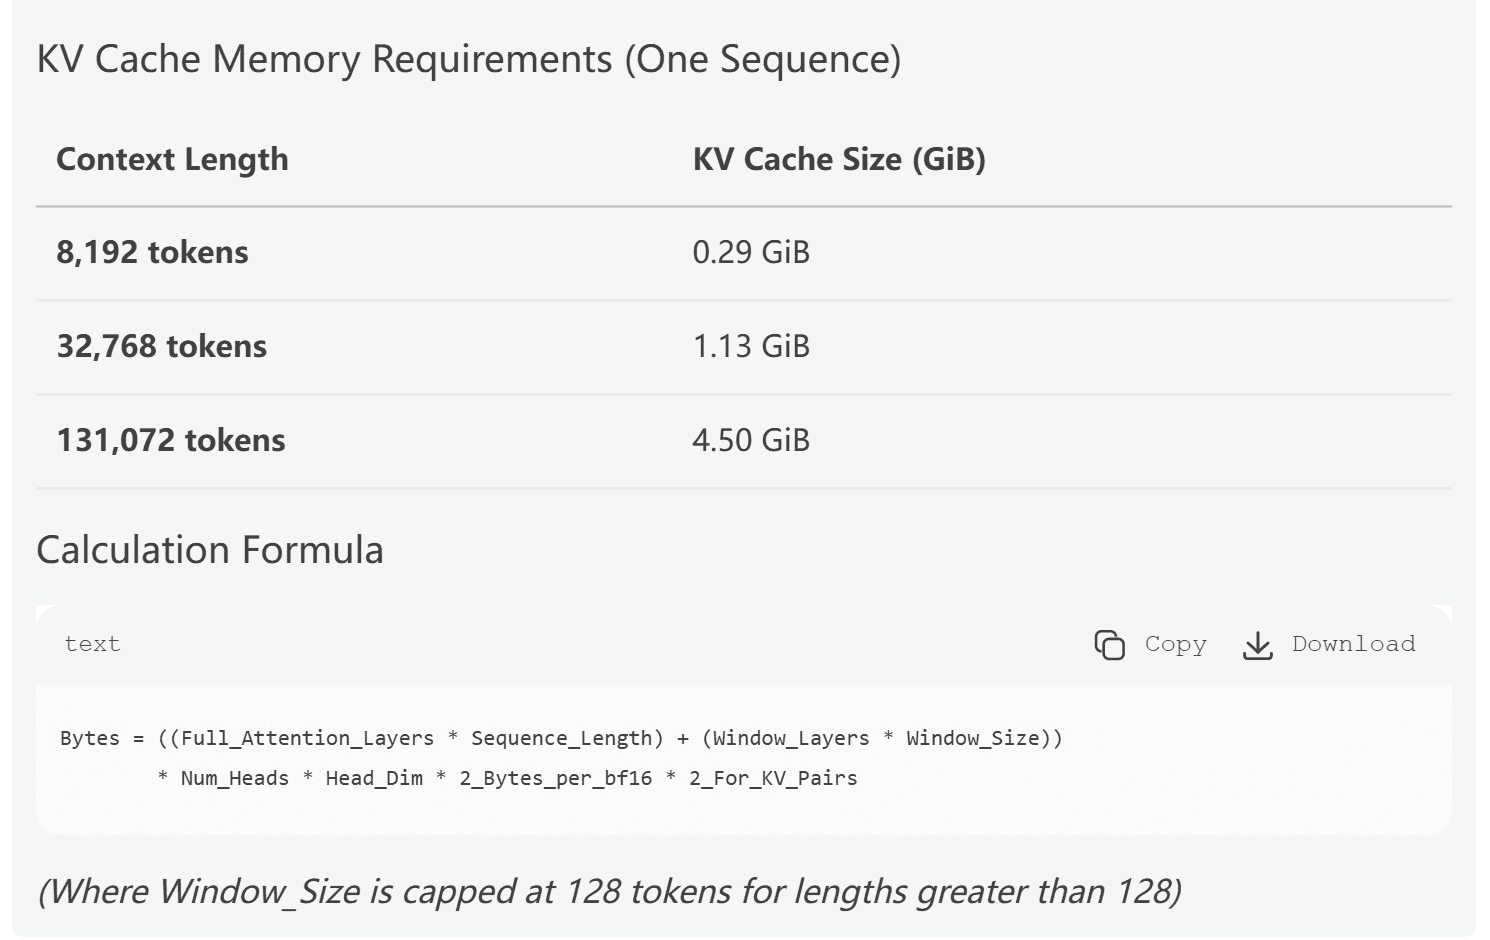
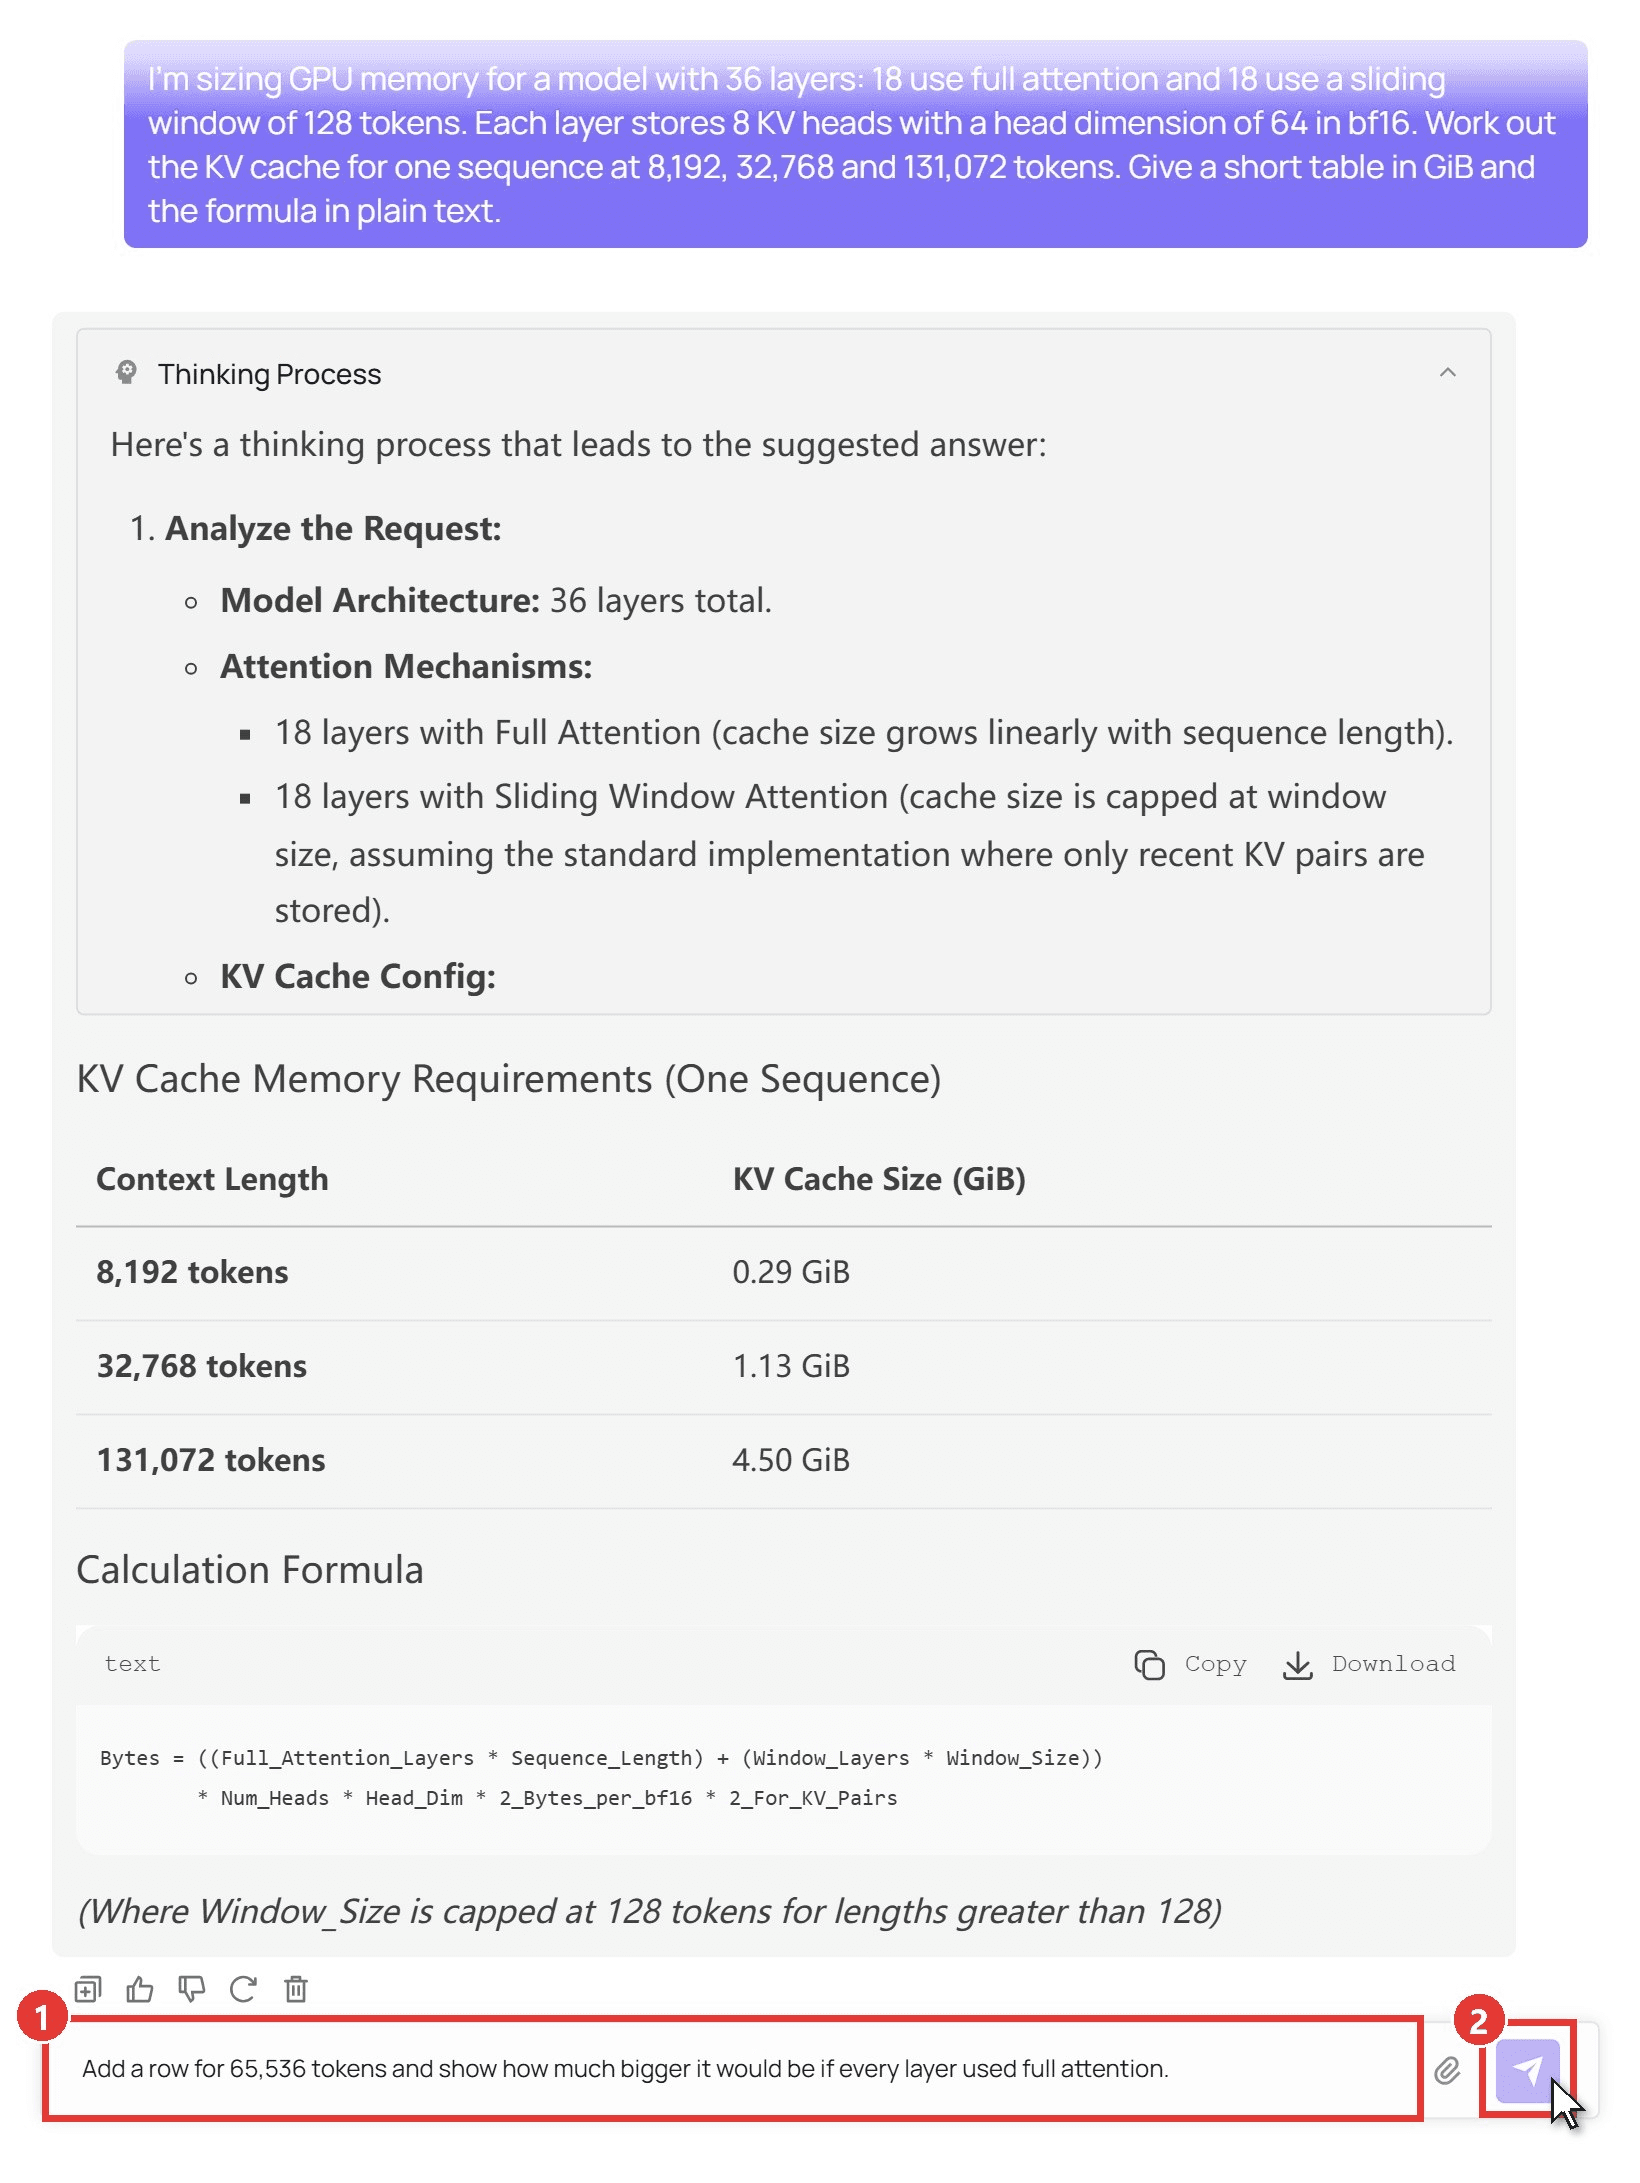
أعطيناه تخطيط الانتباه من إعدادات gpt-oss وطلبنا منه حساب KV cache عند ثلاثة أطوال. وطابق جدوله حساباتنا حتى منزلتين عشريتين. وإذا أردت لاحقاً نموذج Qwen لجهازك، فإن دليلنا إلى أفضل نموذج Qwen للبرمجة المحلية يقدّر أحجامها حسب RAM.
الطريقة 1: جرّب Qwen3.5 122B A10B في Playground
سجّل الدخول وافتح ملعب Qwen3.5 122B A10B، ثم:
- اكتب سؤالك في مربع الرسالة.
- انقر سهم الإرسال. يظهر الاستدلال في لوحة Thinking Process فوق الإجابة.
الطريقة 2: استدعاء Qwen3.5 122B A10B عبر Atlas Cloud API
للنصوص البرمجية والتطبيقات:
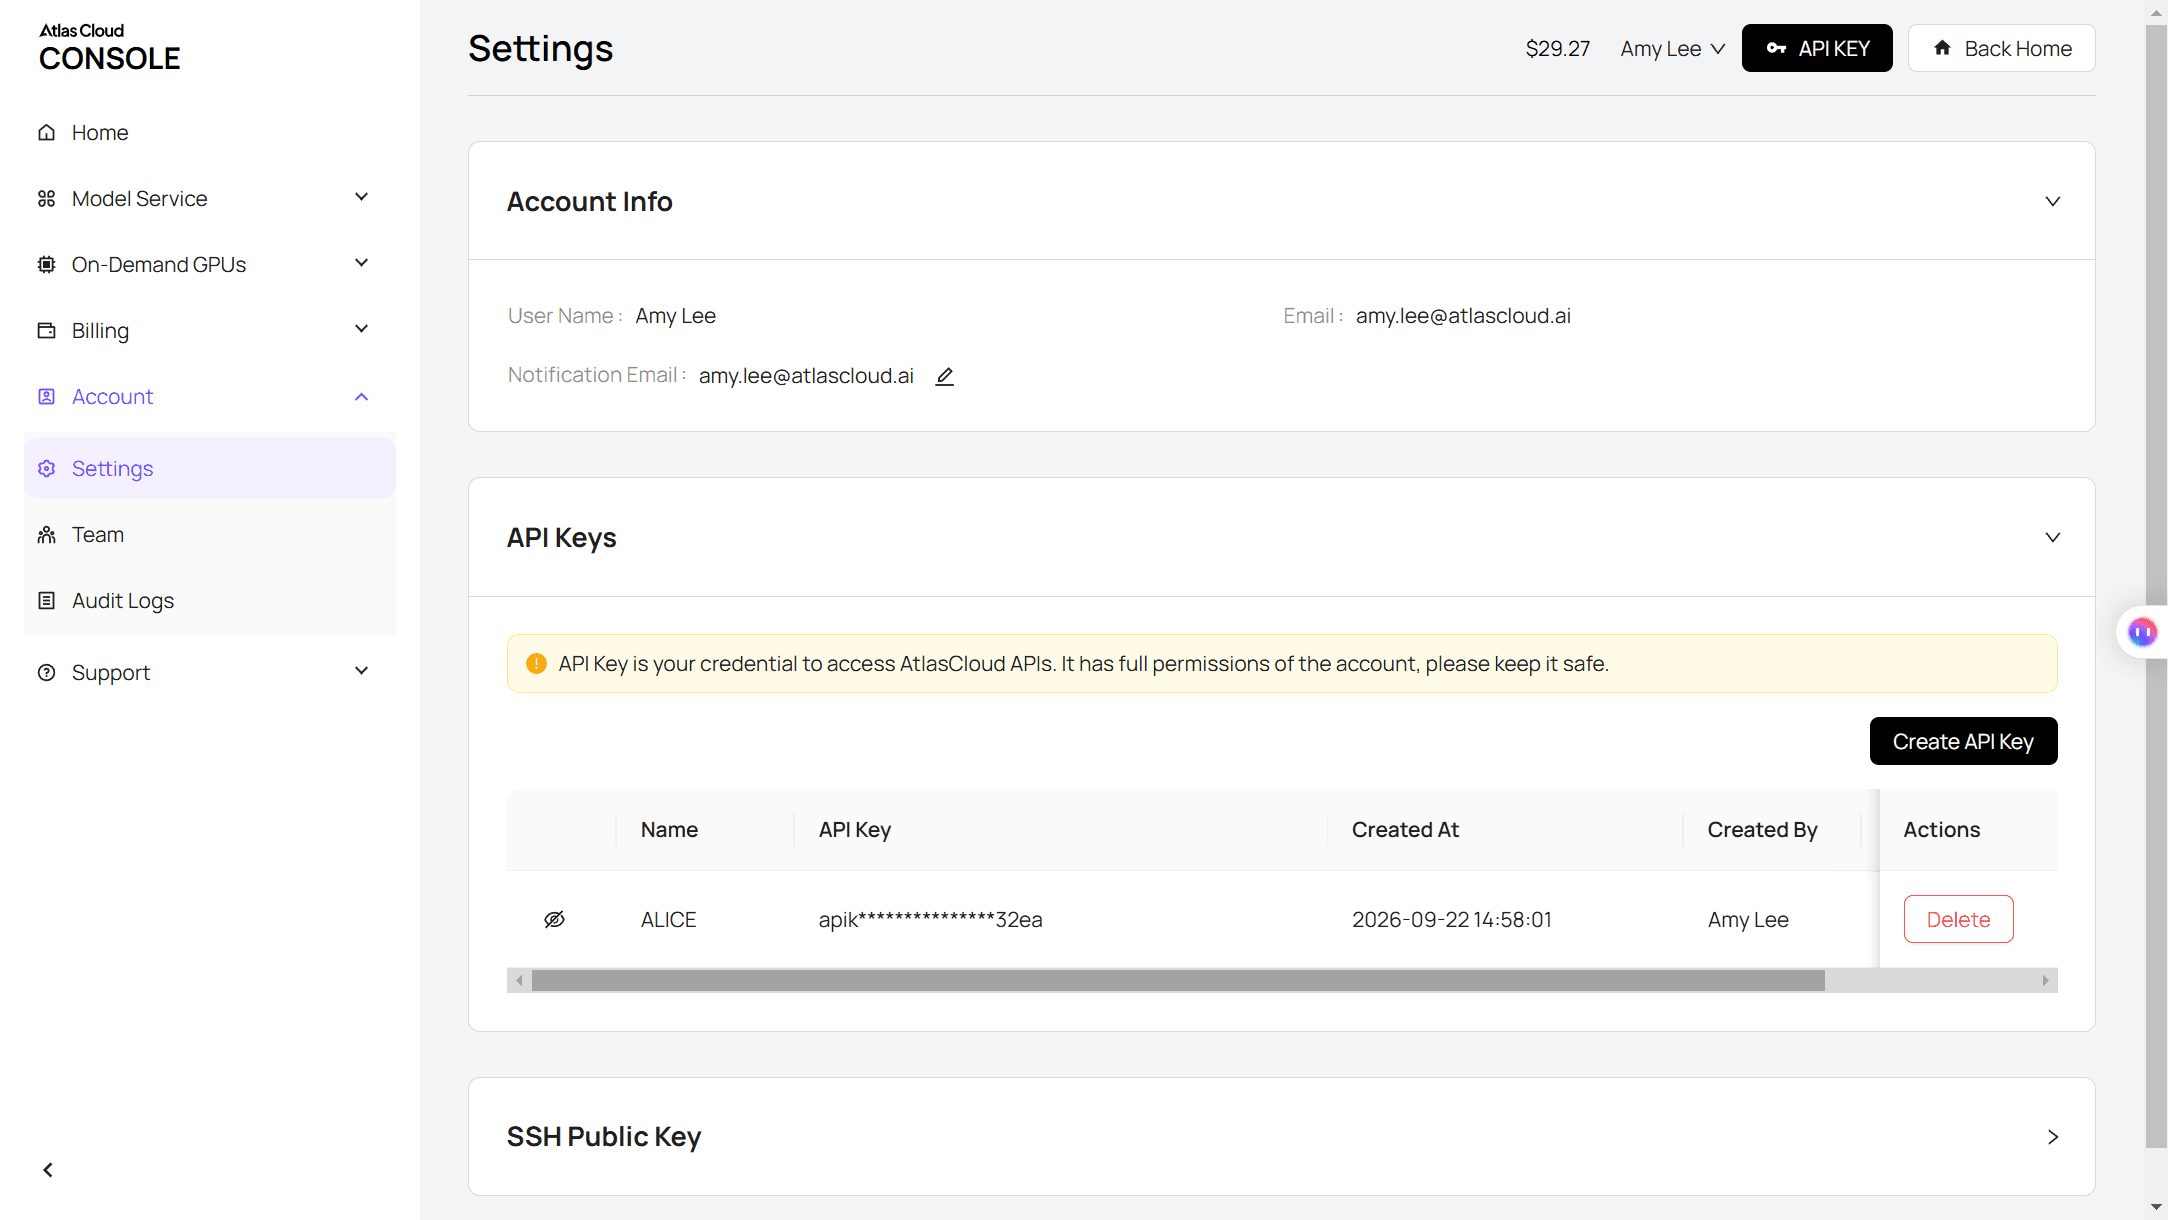
الخطوة 1: أنشئ مفتاح API. افتح Settings في لوحة التحكم، وانتقل إلى API Keys، وانقر على Create API Key. واحتفظ به على جانب الخادم.
الخطوة 2: تحقق من صيغة الطلب. تغطي مستندات API صيغة chat completions، وتحتوي صفحة النموذج على تبويب API مع مثال جاهز.
الخطوة 3: أرسل طلبك الأول.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
تعود الإجابة في choices[0].message.content. ولأن نقطة النهاية تتبع صيغة OpenAI، فإن الكود المكتوب لخادم gpt-oss محلي لا يحتاج عادةً سوى إلى base URL ومفتاح وسلسلة model جديدة. ويعمل المفتاح نفسه أيضاً مع نماذج المحادثة الأخرى على المنصة، كما يشرح مقالنا عن بوابة API موحدة لنماذج LLM.
GPT-OSS-120B مقابل GPT-OSS-20B: المقايضة بين الذاكرة والاختبارات المعيارية
يحتاج النموذج الأصغر خُمس الذاكرة. يمتلك gpt-oss-20b 20.9B معامل مع 3.6B نشطة، وتقول OpenAI إنه يعمل بـ"ذاكرة تصل إلى 16GB فقط". والسؤال هو ما الذي تتخلى عنه.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | الذاكرة عند سياق 8K (llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond (بدون أدوات) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo (بدون أدوات) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
تأتي الدرجات من بطاقة النموذج عند جهد استدلالي عالٍ. والفجوة في البرمجة أقل من نقطتين على SWE-Bench Verified، بينما تبلغ فجوة المعرفة نحو 9 نقاط في علوم مستوى الدراسات العليا و15 على HealthBench. إذا كان العمل في الغالب على الكود باستخدام بطاقة بسعة 16GB إلى 24GB، فإن 20b هو الخيار المنطقي. هل تحتاج المعرفة الإضافية؟ هنا يبرّر 120b فاتورة ذاكرته.
GGUF أم Ollama أم vLLM: اختيار بيئة تشغيل تناسب ميزانية ذاكرتك
كل منها يشغّل أوزان MXFP4 التي أصدرتها OpenAI؛ لكنها تختلف في المكان الذي يمكن أن توجد فيه تلك الأوزان.
| بيئة التشغيل | التنزيل | الأنسب لـ |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | مستخدم واحد على جهاز يستوعب النموذج كاملاً |
| LM Studio | 65 GB | تطبيق سطح مكتب على Mac أو كمبيوتر Windows |
| llama.cpp (ggml-org GGUF) | نحو 63 GB | أقل من 65 GB من VRAM، مع نقل طبقات الخبراء إلى RAM |
| vLLM | نحو 65 GB من safetensors | خدمة العديد من المستخدمين من وحدة أو أكثر من وحدات GPU بمراكز البيانات |
لبداية سريعة على جهاز بذاكرة كبيرة:
plaintext1ollama run gpt-oss:120b
لوحدة GPU أصغر، استخدم llama.cpp واضبط رقم النقل:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
تتعامل البيئات الأربع كلها مع صيغة محادثة harmony من OpenAI، التي يحتاجها النموذج ليعمل بشكل صحيح. ولا يهم ذلك إلا إذا كتبت كود الخدمة الخاص بك.
الأسئلة الشائعة
هل GPT-OSS-120B أفضل من GPT-5 أو Gemini 3 Pro؟
إنها تنتمي إلى فئتين مختلفتين: GPT-5 وGemini نماذج مغلقة تصل إليها عبر تطبيق أو API، بينما يعمل gpt-oss-120b على عتادك الخاص. كما أُغلق Gemini 3 Pro Preview في 9 مارس 2026، وأصبح اسمه الآن يشير إلى Gemini 3.1 Pro Preview. وإذا كانت السيطرة المحلية تهمك، فإن سلسلة Google المفتوحة الأوزان هي عائلة Gemma 4.
لماذا تقول بعض المواقع إن GPT-OSS-120B يحتاج 255 GB؟
تفترض تلك الأرقام أوزاناً 16-بت: نحو 117B معامل × 2 بايت، إضافة إلى الأعباء الإضافية. لكن نقطة التحقق التي تنشرها OpenAI هي بالفعل MXFP4، لذا فإن التنزيل الواقعي في نطاق 61 GB.
هل يغيّر جهد الاستدلال استخدام الذاكرة؟
ليس بالنسبة إلى الأوزان. تغيّر إعدادات منخفض ومتوسط وعالٍ مدة تفكير النموذج. فالجهد العالي يكتب رموز استدلال أكثر، مما يملأ نافذة السياق وينمّي KV cache، لذا تزحف الجلسات الطويلة نحو الإجماليات الأكبر في المخطط أعلاه.
لماذا يقول الناس إن GPT-OSS-120B يعاني مع الألعاب النصية؟
الأدلة حكايات متفرقة. على صفحة نقاش النموذج في Hugging Face، يذكر بعض المستخدمين رفضاً عند كتابة خيال عنيف، بينما يقول آخرون إن لعب الأدوار يعمل جيداً. بالنسبة إلى الخيال التفاعلي، اختبر مطالباتك بنفسك قبل شراء عتاد من أجله.
كم يكلّف نموذج مستضاف من فئة 120B؟
اعتباراً من أكتوبر 2026، يكلّف Qwen3.5 122B A10B مبلغ $0.3 لكل مليون رمز إدخال و$2.4 لكل مليون رمز إخراج على Atlas Cloud. وهذا خصم 25% عن سعريه المعتادين $0.4 و$3.2. وقد استخدم سؤالنا عن الحجم نحو 5,000 رمز إخراج عند احتساب الاستدلال، أي نحو سنت واحد بالسعر المخفّض.
الخلاصة
يعد GPT-OSS-120B أسهل في الاستيعاب مما يوحي عدد معاملاته. خطط لنحو 65 GB عند أطوال السياق اليومية وأقل من 70 GB عند 131K كاملة. وحدة GPU واحدة بسعة 80GB، أو جهاز Mac بذاكرة تزيد عن 96GB، أو كمبيوتر صغير بسعة 128GB ستستوعبه، كما يمكن للبطاقات الأصغر تشغيله عبر نقل طبقات الخبراء إلى ذاكرة النظام.
إذا كانت تلك الأرقام تستبعد جهازك، فانتقل إلى gpt-oss-20b لأعمال البرمجة في الغالب، أو استدعِ نموذجاً مستضافاً مفتوح الأوزان عندما تحتاج العقل الأكبر دون شراء عتاد. وفي كلتا الحالتين، تتوقف متطلبات ذاكرة gpt oss 120b عن كونها تخميناً بمجرد أن تعرف أن الأوزان تستهلك 61 GB وأن الباقي مساحة احتياطية.


