La barra de descarga llega a 65 GB, los ventiladores empiezan a girar y surge la verdadera pregunta: ¿realmente se cargará? La respuesta corta a los requisitos de memoria de GPT-OSS-120B es de unos 61 GB para los pesos más unos pocos más para espacio de trabajo, y por eso OpenAI lo promociona como un modelo para una única GPU de 80 GB.
A continuación, desglosamos ese número en partes, mostramos el hardware que lo ha ejecutado con velocidades medidas y cubrimos la ruta alojada para cuando el tuyo se quede corto.
Puntos clave
- GPT-OSS-120B se distribuye como un checkpoint MXFP4 de 60.8 GiB, y por eso OpenAI apunta a una única GPU de 80GB.
- La longitud del contexto añade poca memoria: la caché KV alcanza solo unos 4.5 GiB en los 131K tokens completos.
- Con menos de 80GB de VRAM, llama.cpp puede transferir capas de expertos a la RAM del sistema y aun así ejecutarlo.
- Los Mac con más de 96GB de memoria y los mini PC de 128GB pueden contener el modelo completo en una sola máquina.
- ¿No tienes el hardware adecuado? Llama Qwen3.5 122B A10B en Atlas Cloud a través de una API compatible con OpenAI.
Requisitos de memoria de GPT-OSS-120B: pesos más caché KV
OpenAI lanzó gpt-oss-120b el 5 de agosto de 2025 bajo la licencia Apache 2.0. Es un modelo de mezcla de expertos, por lo que solo 5.1B de sus 116.8B parámetros trabajan en cada token. Eso ayuda a la velocidad, no a la memoria: cada experto todavía tiene que residir en memoria listo para ser seleccionado.
El truco que lo mantiene pequeño es MXFP4. Según la tarjeta del modelo gpt-oss, los pesos de los expertos, que constituyen más del 90 % de los parámetros, se almacenan a 4.25 bits cada uno. Una copia de 16 bits del mismo modelo necesitaría aproximadamente cuatro veces el espacio.
| Especificación | GPT-OSS-120B |
|---|---|
| Parámetros totales | 116.8B |
| Parámetros activos por token | 5.1B |
| Capas y expertos | 36 capas, 128 expertos, 4 activos por token |
| Formato de pesos | MXFP4 para capas de expertos, BF16 para el resto |
| Tamaño del checkpoint | 60.8 GiB |
| Ventana de contexto | 131,072 tokens |
Cómo la ventana de contexto cambia la memoria de GPT-OSS-120B
Cada token deja una clave y un valor en cada capa de atención. Ese almacén es la caché KV y, cuando cada capa atiende al contexto completo, crece al ritmo de la longitud del contexto.
GPT-OSS-120B esquiva la mayor parte. La mitad de sus 36 capas usan una ventana deslizante que solo mira hacia atrás 128 tokens, y cada capa almacena solo 8 cabezas KV de 64 dimensiones. Solo 18 capas conservan todo el contexto. Calculamos la caché KV a partir de la configuración del modelo y coincide con los totales medidos en la guía de gpt-oss de llama.cpp.
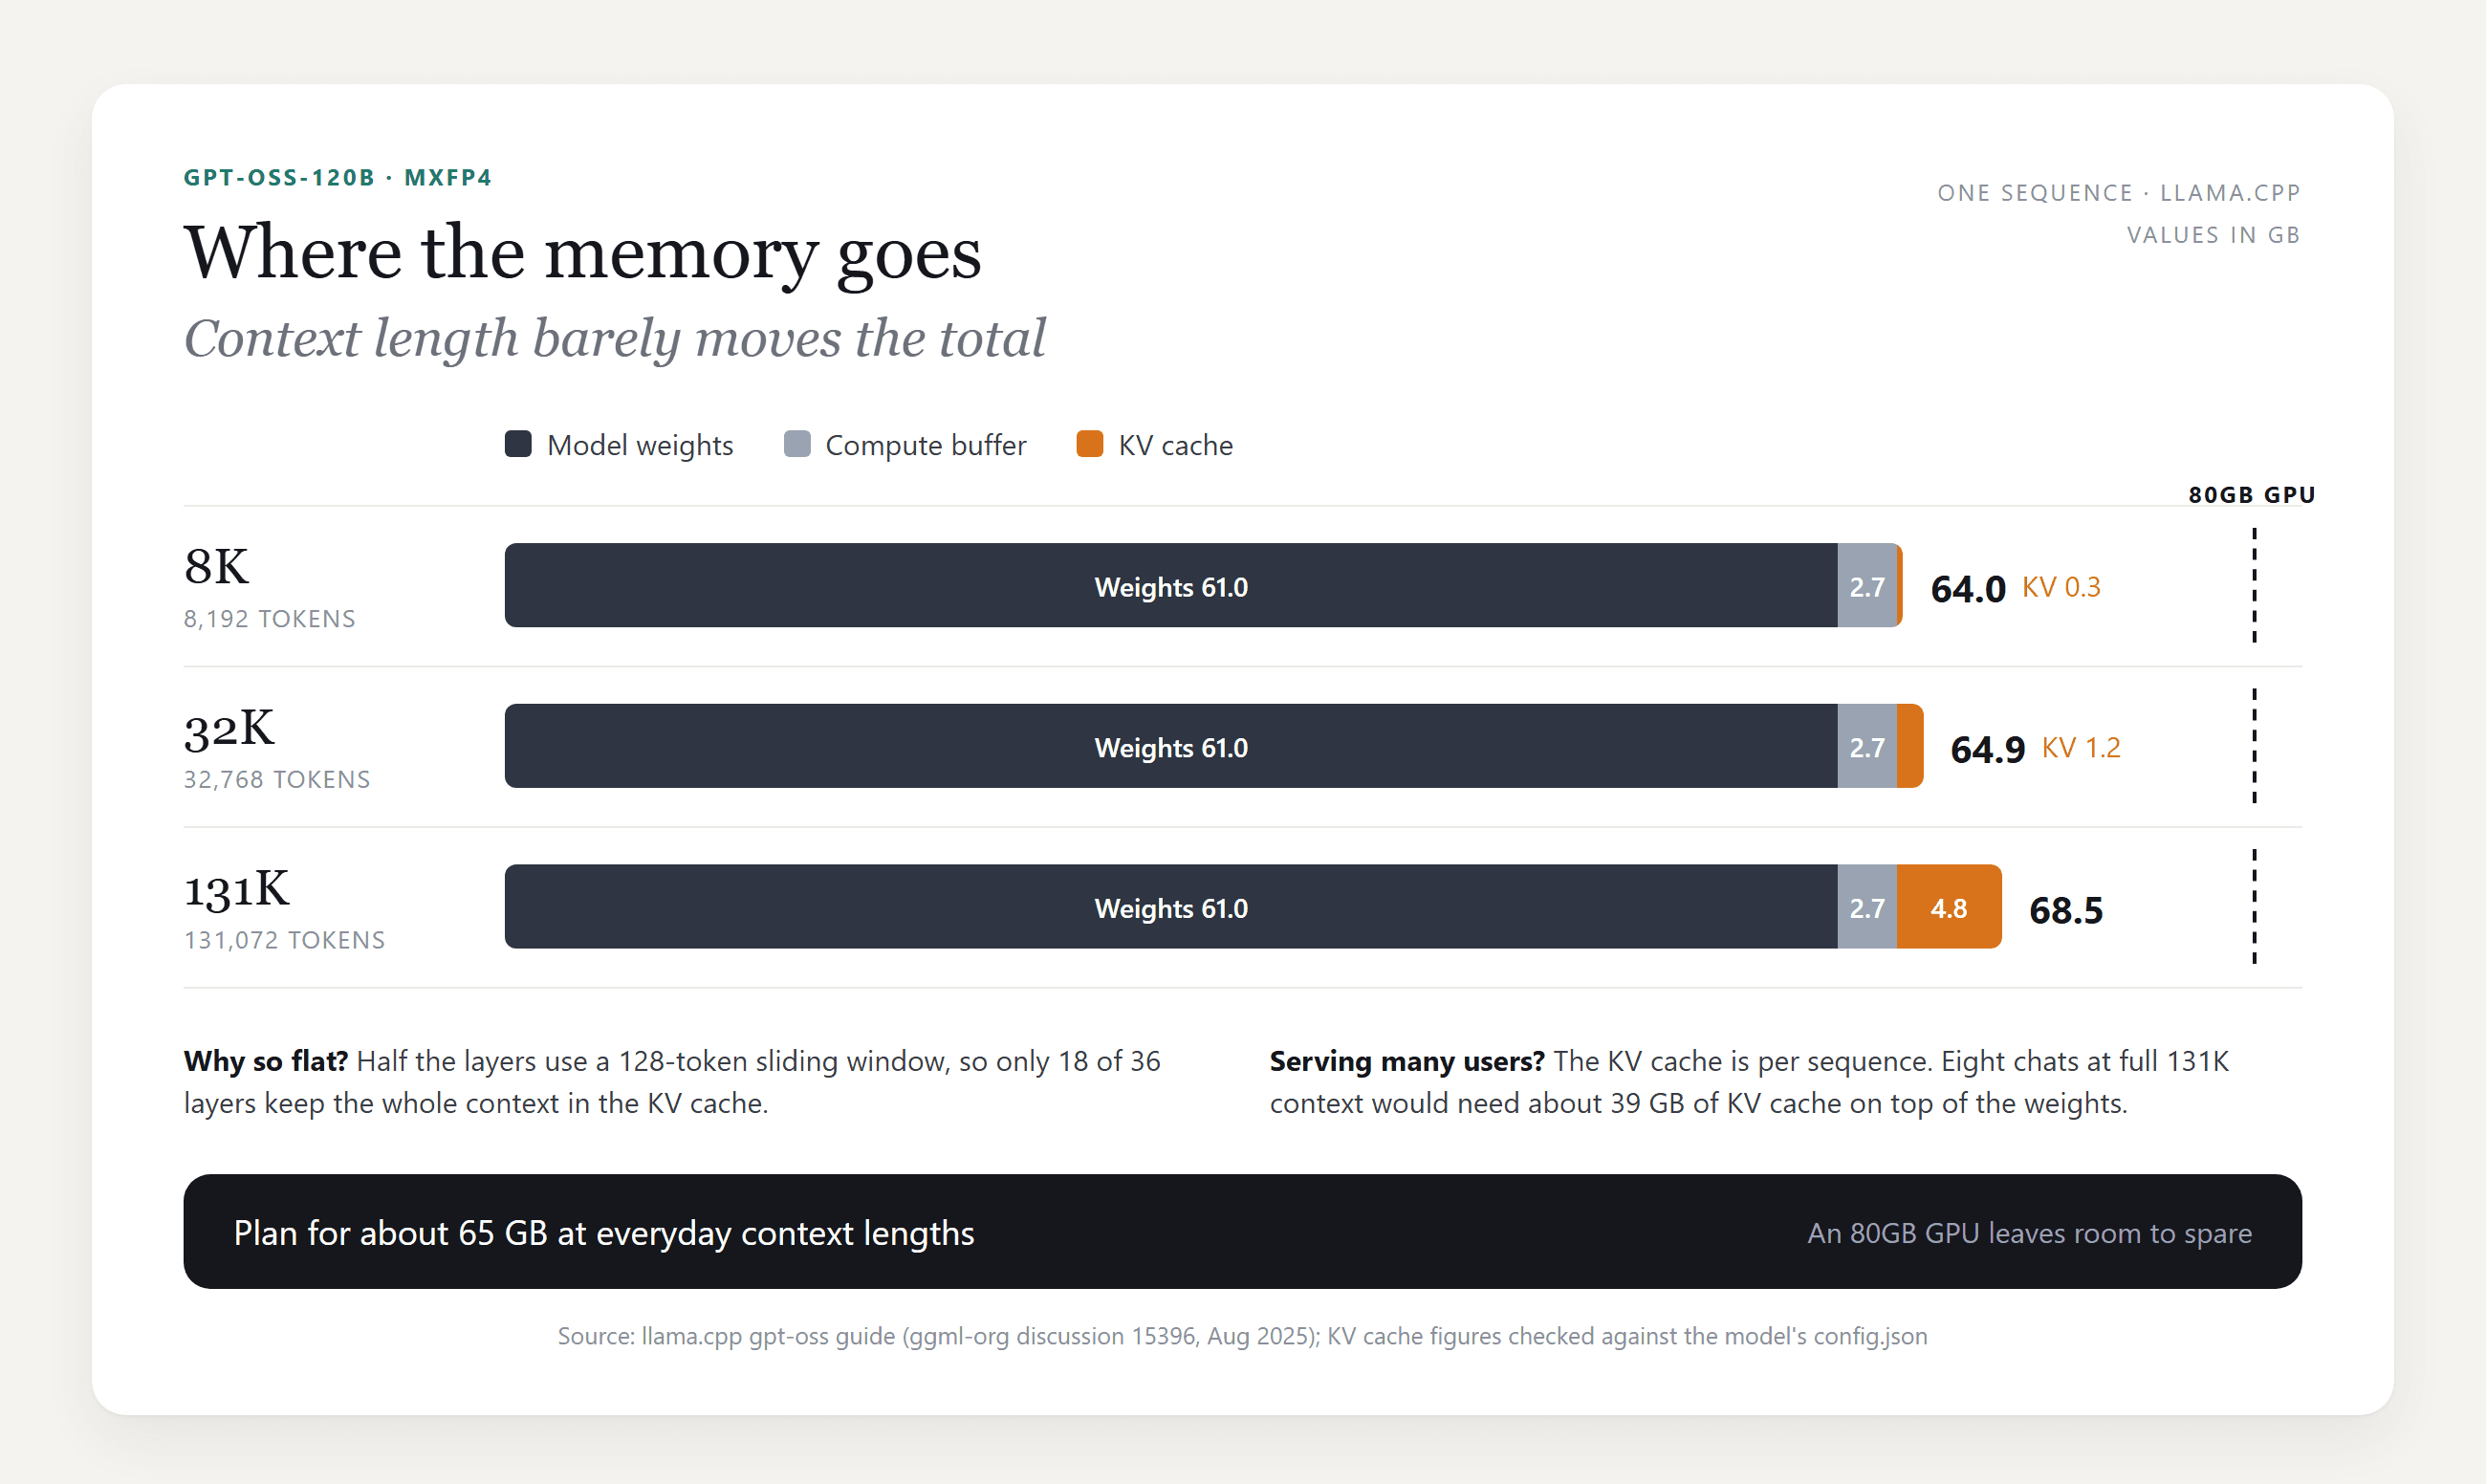
Pasar de 8K al total de 131K cuesta menos de 5 GB. Donde se acumula es en la concurrencia: la caché KV es por conversación, así que un servidor que mantiene ocho chats de longitud completa necesita aproximadamente 39 GB además de los pesos.
¿Puedo ejecutar GPT-OSS-120B localmente? Requisitos de hardware según la configuración
Sí, si puedes reservar unos 65 GB en algún lugar rápido: una GPU grande, una GPU más RAM del sistema, o un equipo con memoria unificada.
Requisitos de GPU para GPT-OSS-120B
El caso más simple es una tarjeta de centro de datos de 80 GB. La receta de vLLM para gpt-oss dice que el modelo 120b "cabe en una sola A100 (80GB)", y que dividirlo entre más GPU mejora el rendimiento.
Por debajo de 80GB, la guía de llama.cpp ofrece una salida. Su opción --n-cpu-moe mantiene algunas capas de expertos en la RAM del sistema y el resto en la GPU. La guía establece el mínimo en unos 8GB de VRAM, siempre que la memoria de la GPU y del sistema en conjunto aún puedan contener el modelo.
| Configuración | Dónde residen los pesos | Velocidad de generación reportada |
|---|---|---|
| RTX Pro 6000, 96GB | Todo en la GPU | 196 tokens/s (guía de llama.cpp) |
| A100 o H100, 80GB | Todo en la GPU | Cabe en una tarjeta (receta de vLLM) |
| RTX 5090, 32GB, más RAM del sistema | 21 capas de expertos en la RAM del sistema | Unos 30 tokens/s con contexto cero (guía de llama.cpp) |
Una trampa de Windows de la misma guía: el controlador puede derramarse silenciosamente en la RAM del sistema cuando se agota la VRAM, así que el modelo se carga y luego se arrastra. Vigila GPU Memory en el Administrador de tareas y aumenta el recuento de offload hasta que se mantenga por debajo del tamaño de tu tarjeta.
Ejecutar GPT-OSS-120B en un Mac o mini PC de 128GB
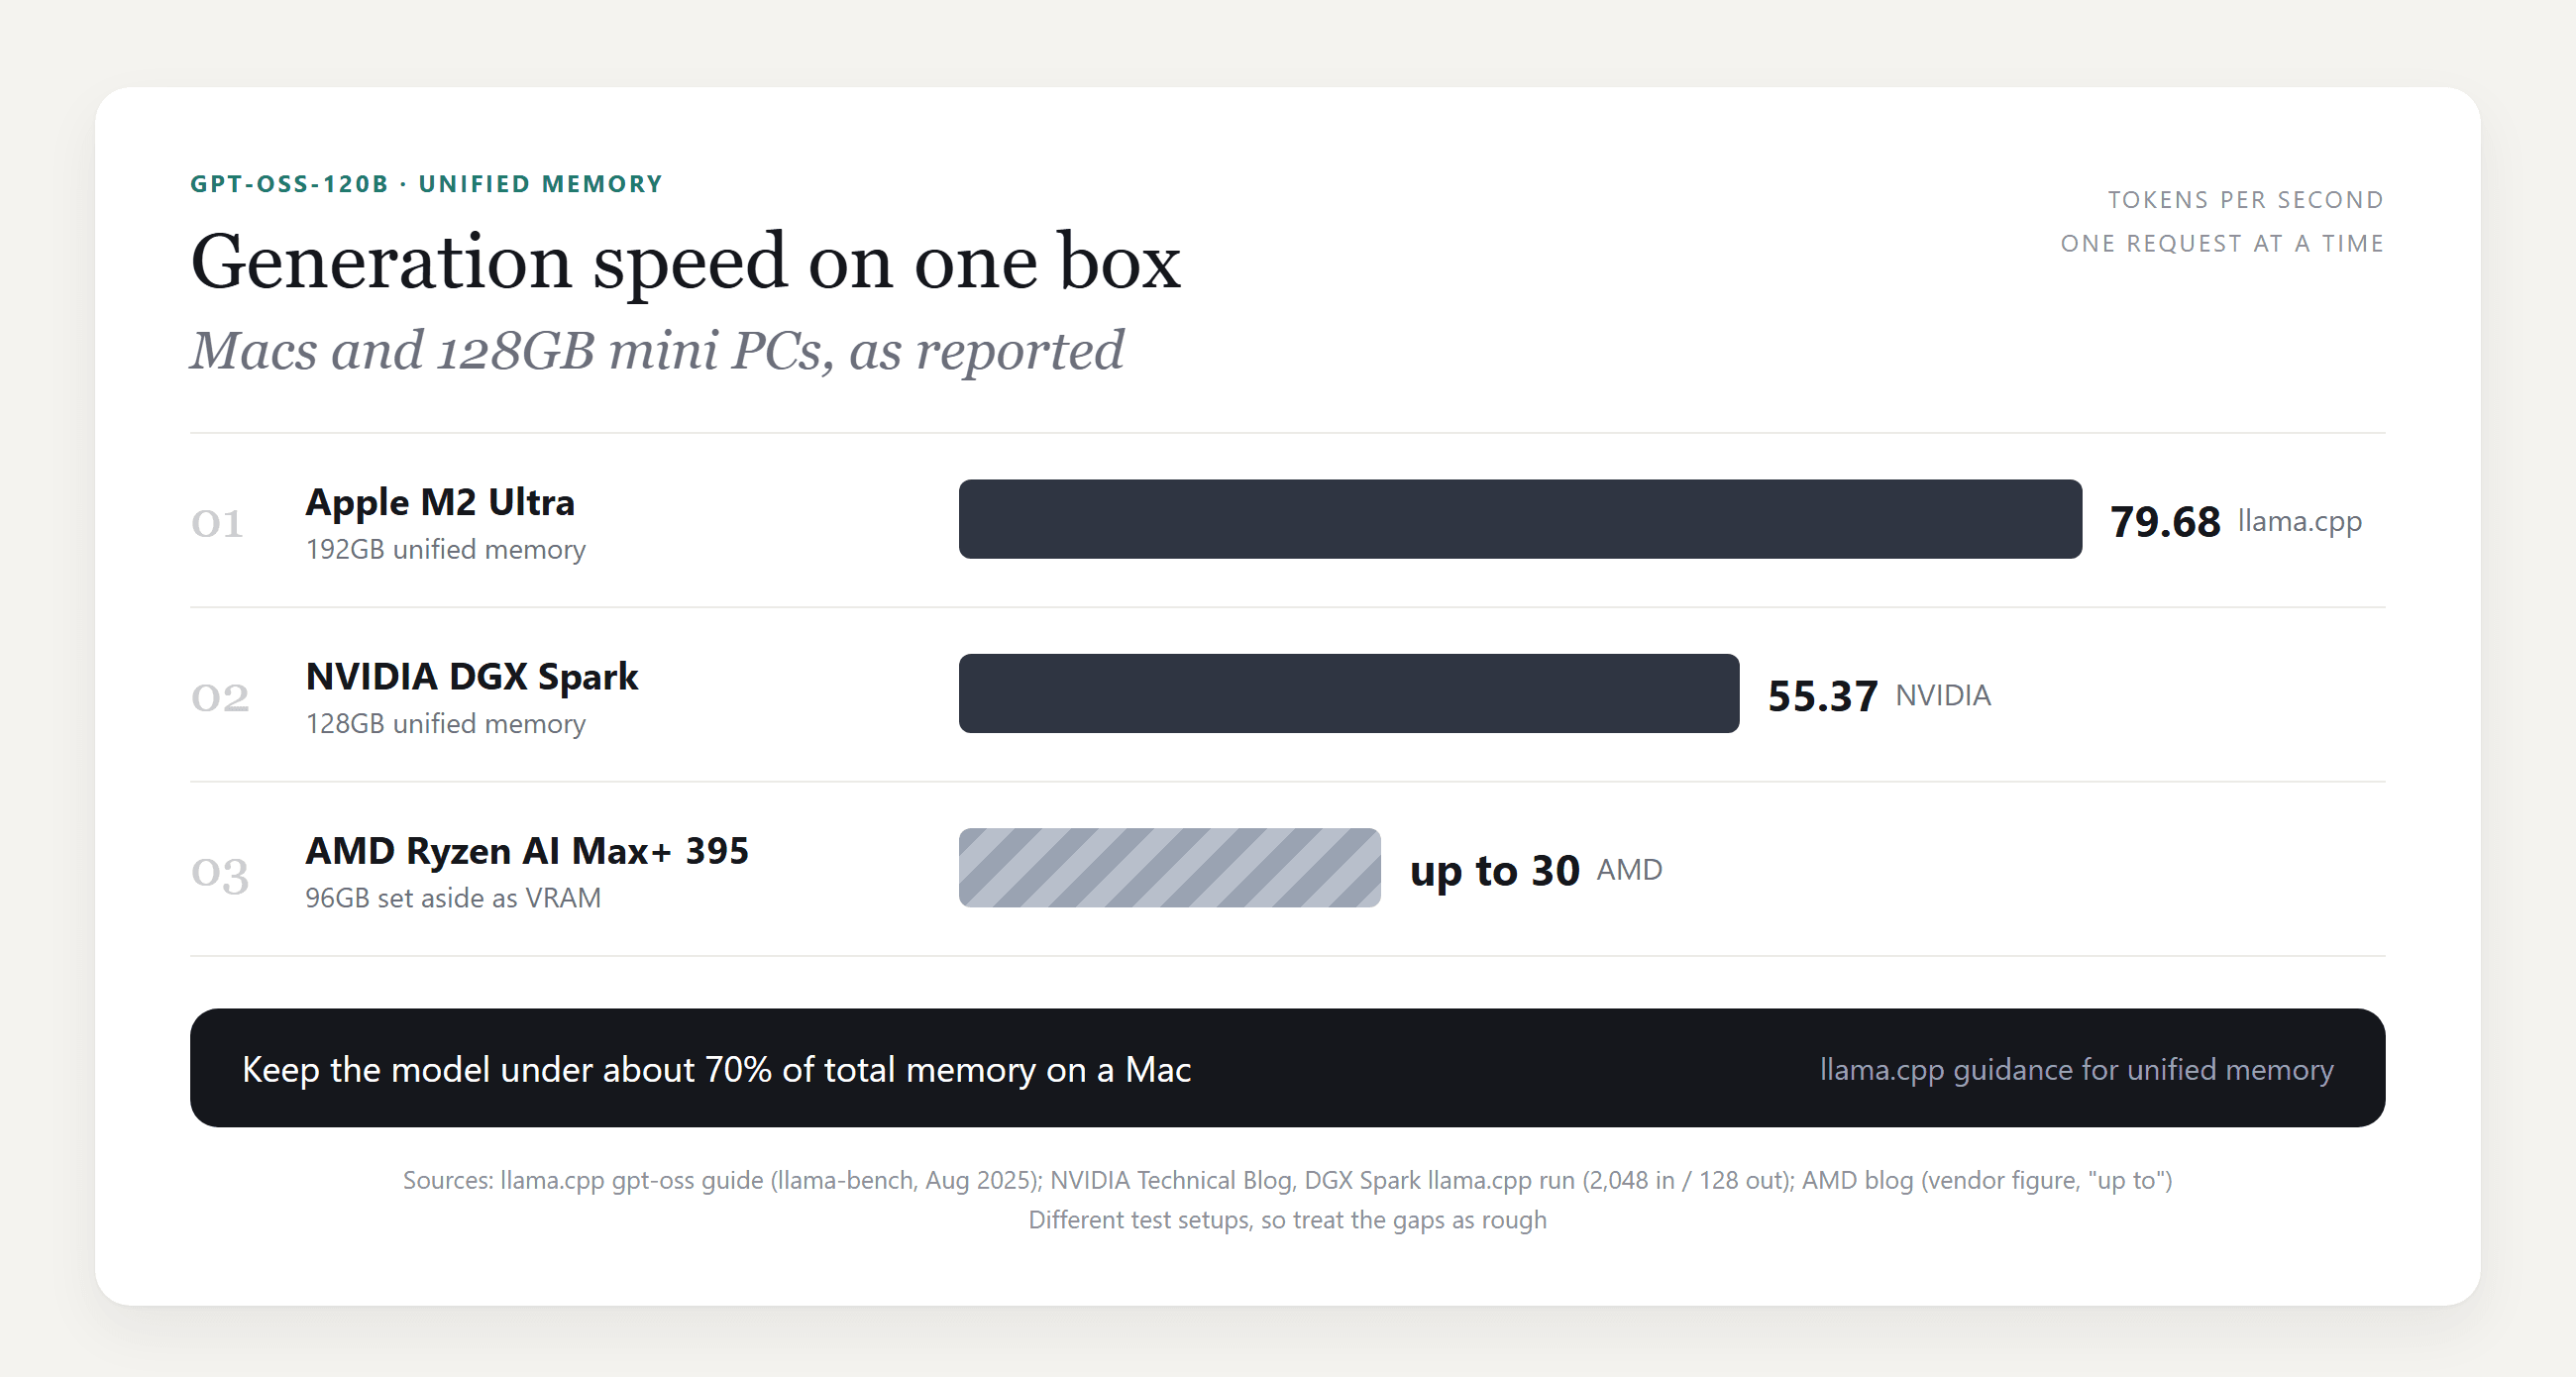
La memoria unificada elimina la división entre GPU y RAM. La guía de llama.cpp dice que los Mac con más de 96GB de RAM, como las máquinas M2 Ultra o M3 Max, pueden ejecutar el modelo con contexto completo, y aconseja mantenerse por debajo de aproximadamente el 70 % de la memoria total.
macOS limita cuánta memoria puede asignar la GPU de forma predeterminada. En una máquina de 192GB, la guía eleva ese límite de 154GB a 180GB con un comando:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
Los nuevos mini PC de 128GB entran en la misma categoría. NVIDIA reporta 55.37 tokens/s para gpt-oss-120b en un DGX Spark ejecutando llama.cpp. AMD dice que una máquina Ryzen AI Max+ 395 con 96GB reservados como VRAM alcanza "hasta 30 tokens por segundo", que es la propia cifra de la compañía.
¿No tienes suficiente memoria? Usa un modelo abierto alojado a través de una API
Si ninguna de esas máquinas está en tu escritorio, un modelo abierto alojado evita por completo la cuestión del hardware.
Atlas Cloud ofrece Qwen3.5 122B A10B, parte de su línea de modelos Qwen. En teoría, es muy similar a gpt-oss-120b: un modelo de mezcla de expertos con licencia Apache 2.0 del equipo Qwen de Alibaba, con 122B totales y 10B parámetros activos. Lee hasta 262,144 tokens de contexto.
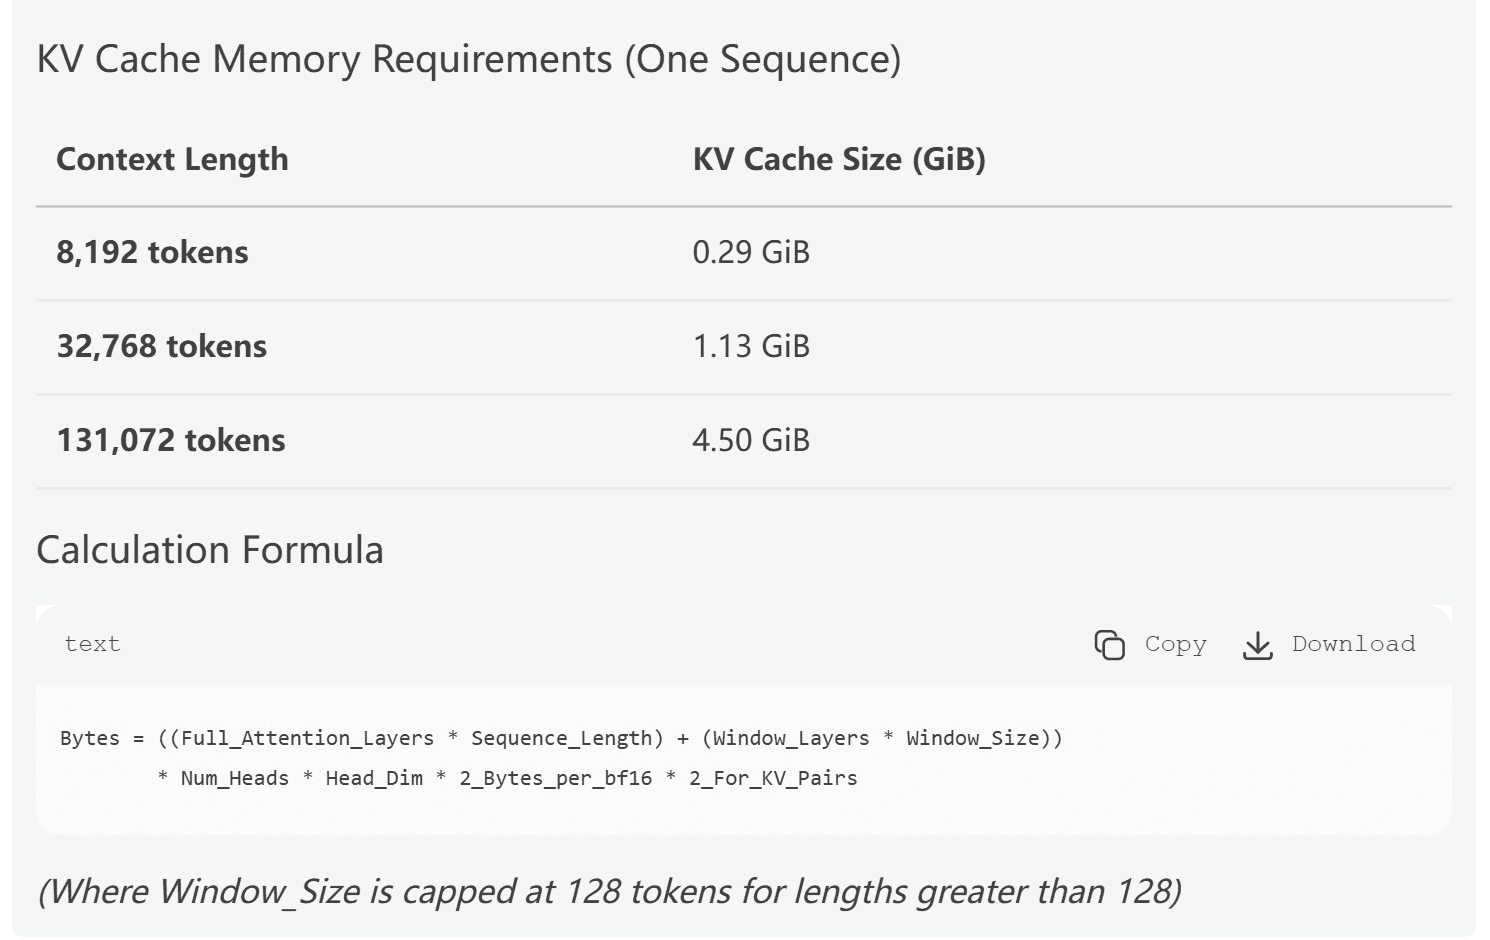
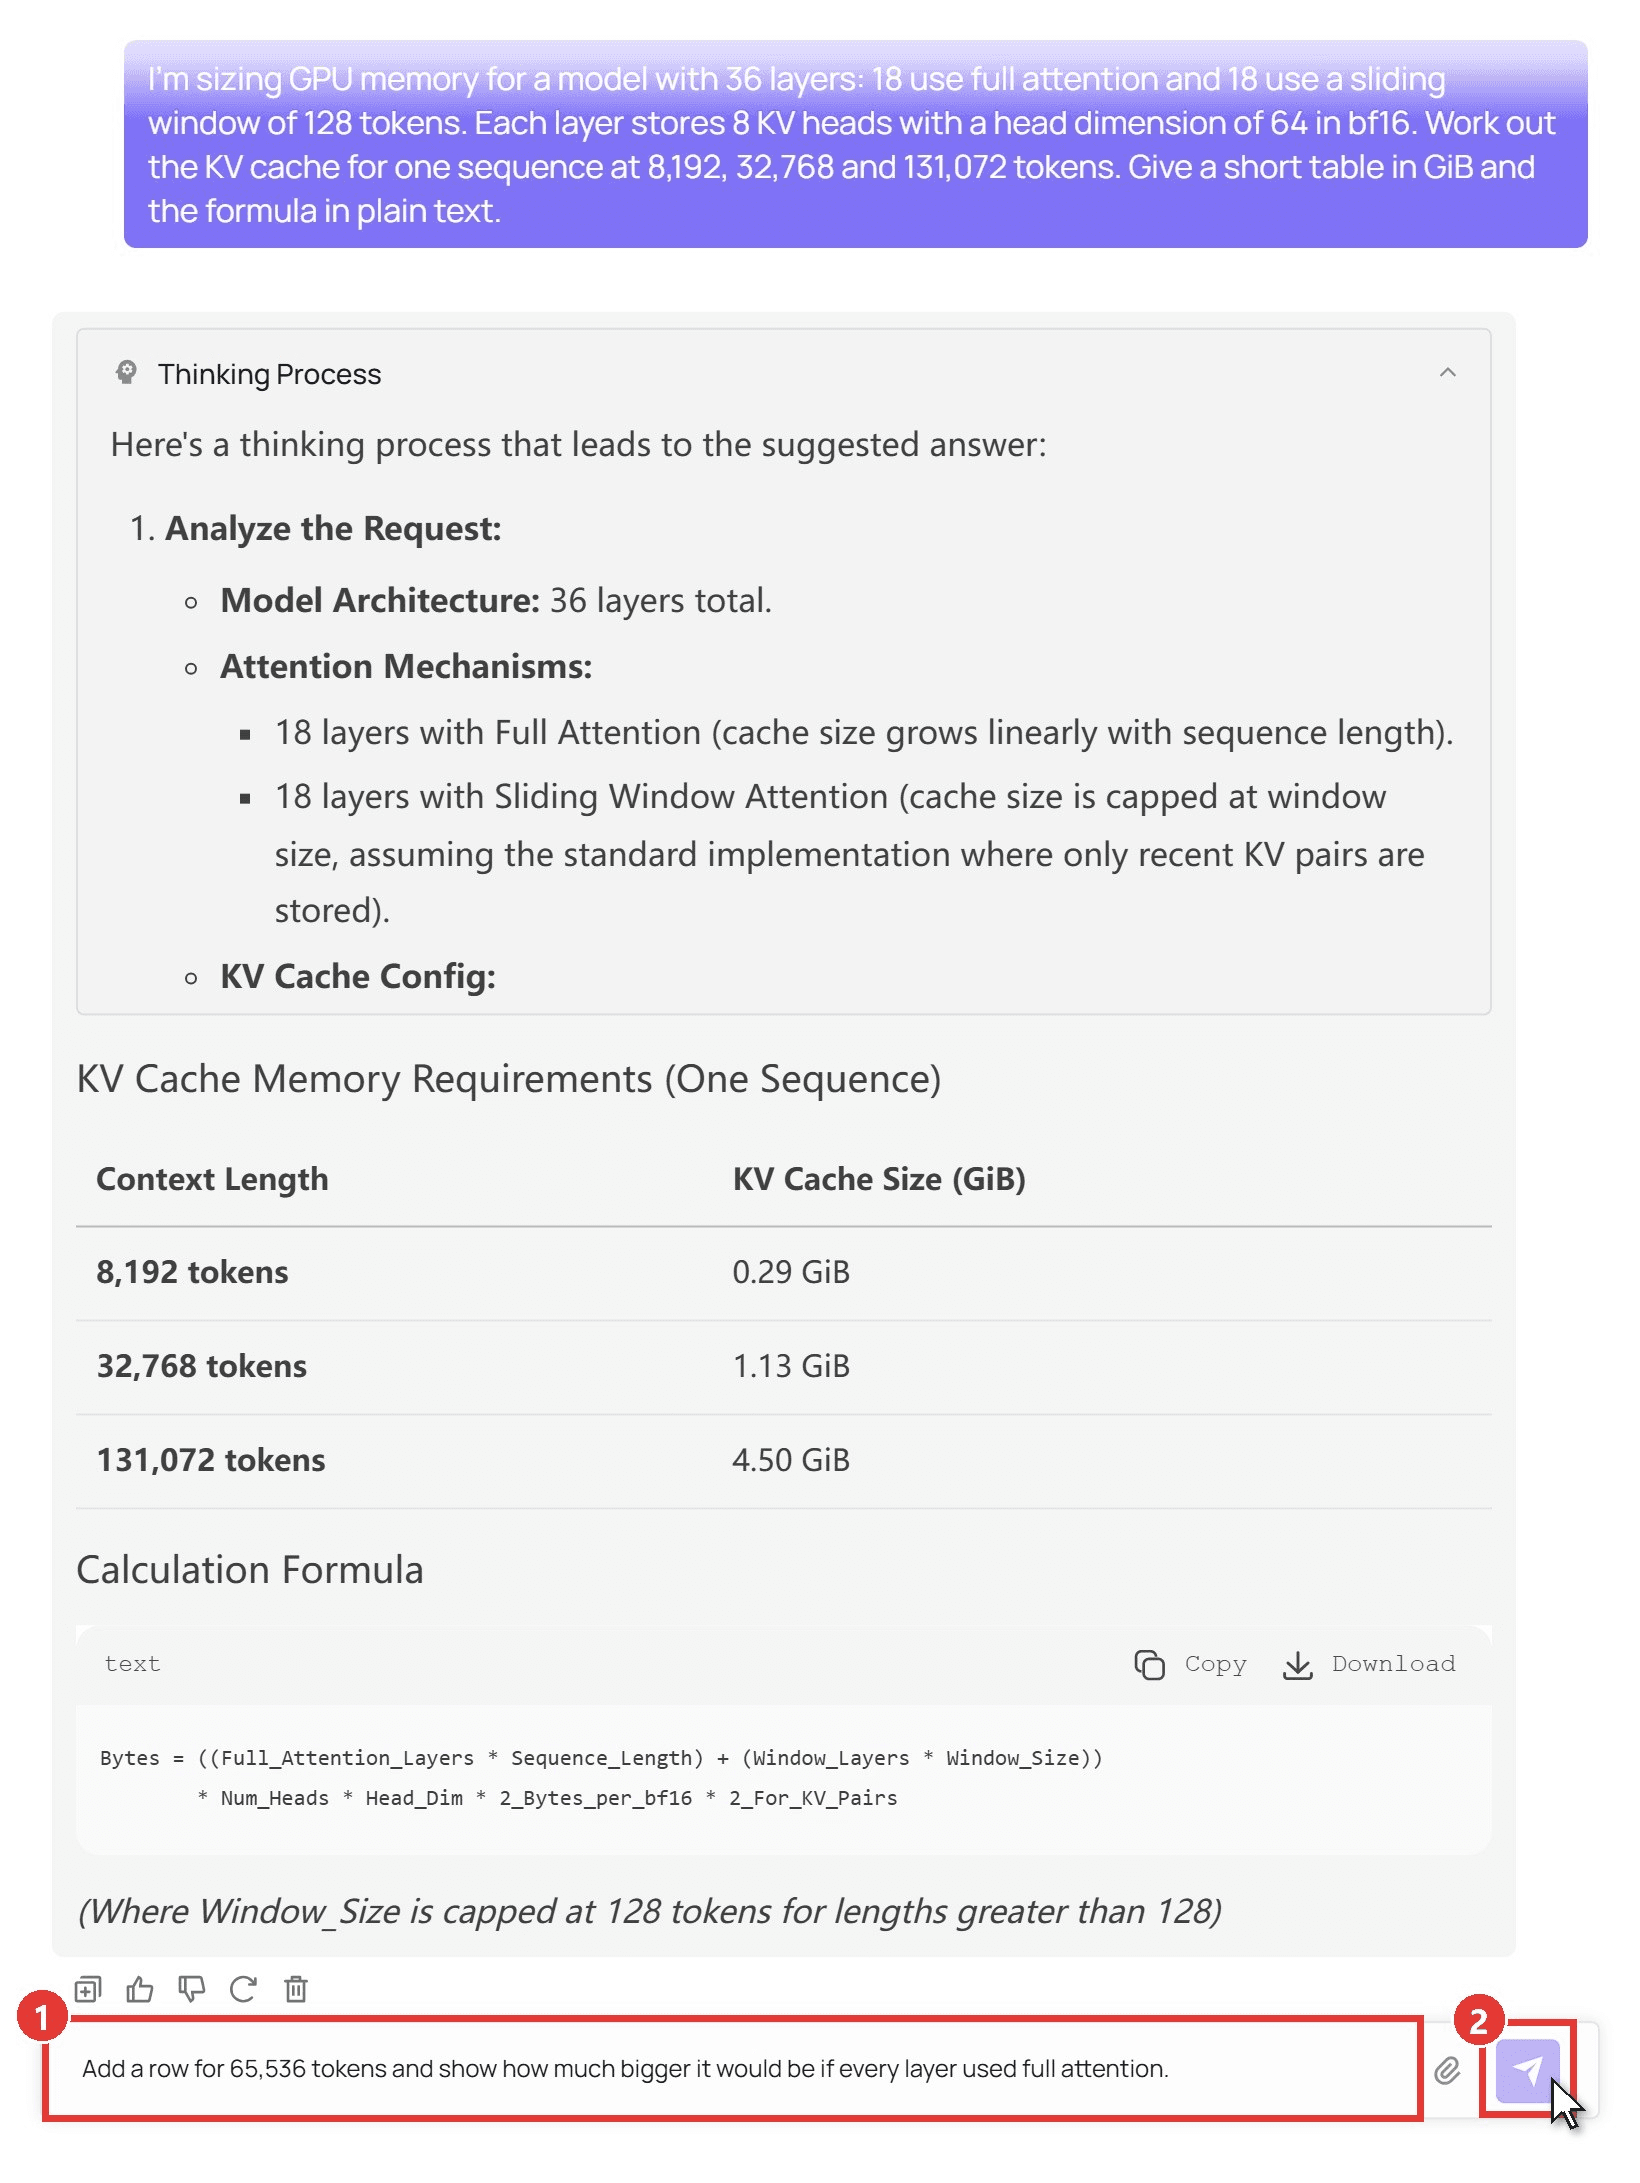
Le dimos la disposición de atención de la configuración de gpt-oss y le pedimos la caché KV en tres longitudes. Su tabla coincidió con nuestros propios cálculos hasta dos decimales. Si más adelante quieres un Qwen para tu propia máquina, nuestra guía del mejor modelo Qwen para programación local los dimensiona según la RAM.
Método 1: Prueba Qwen3.5 122B A10B en el Playground
Inicia sesión y abre el playground de Qwen3.5 122B A10B, luego:
- Escribe tu pregunta en el cuadro de mensaje.
- Haz clic en la flecha de enviar. El razonamiento aparece en un panel de Proceso de pensamiento encima de la respuesta.
Método 2: Llama a Qwen3.5 122B A10B con la API de Atlas Cloud
Para scripts y aplicaciones:
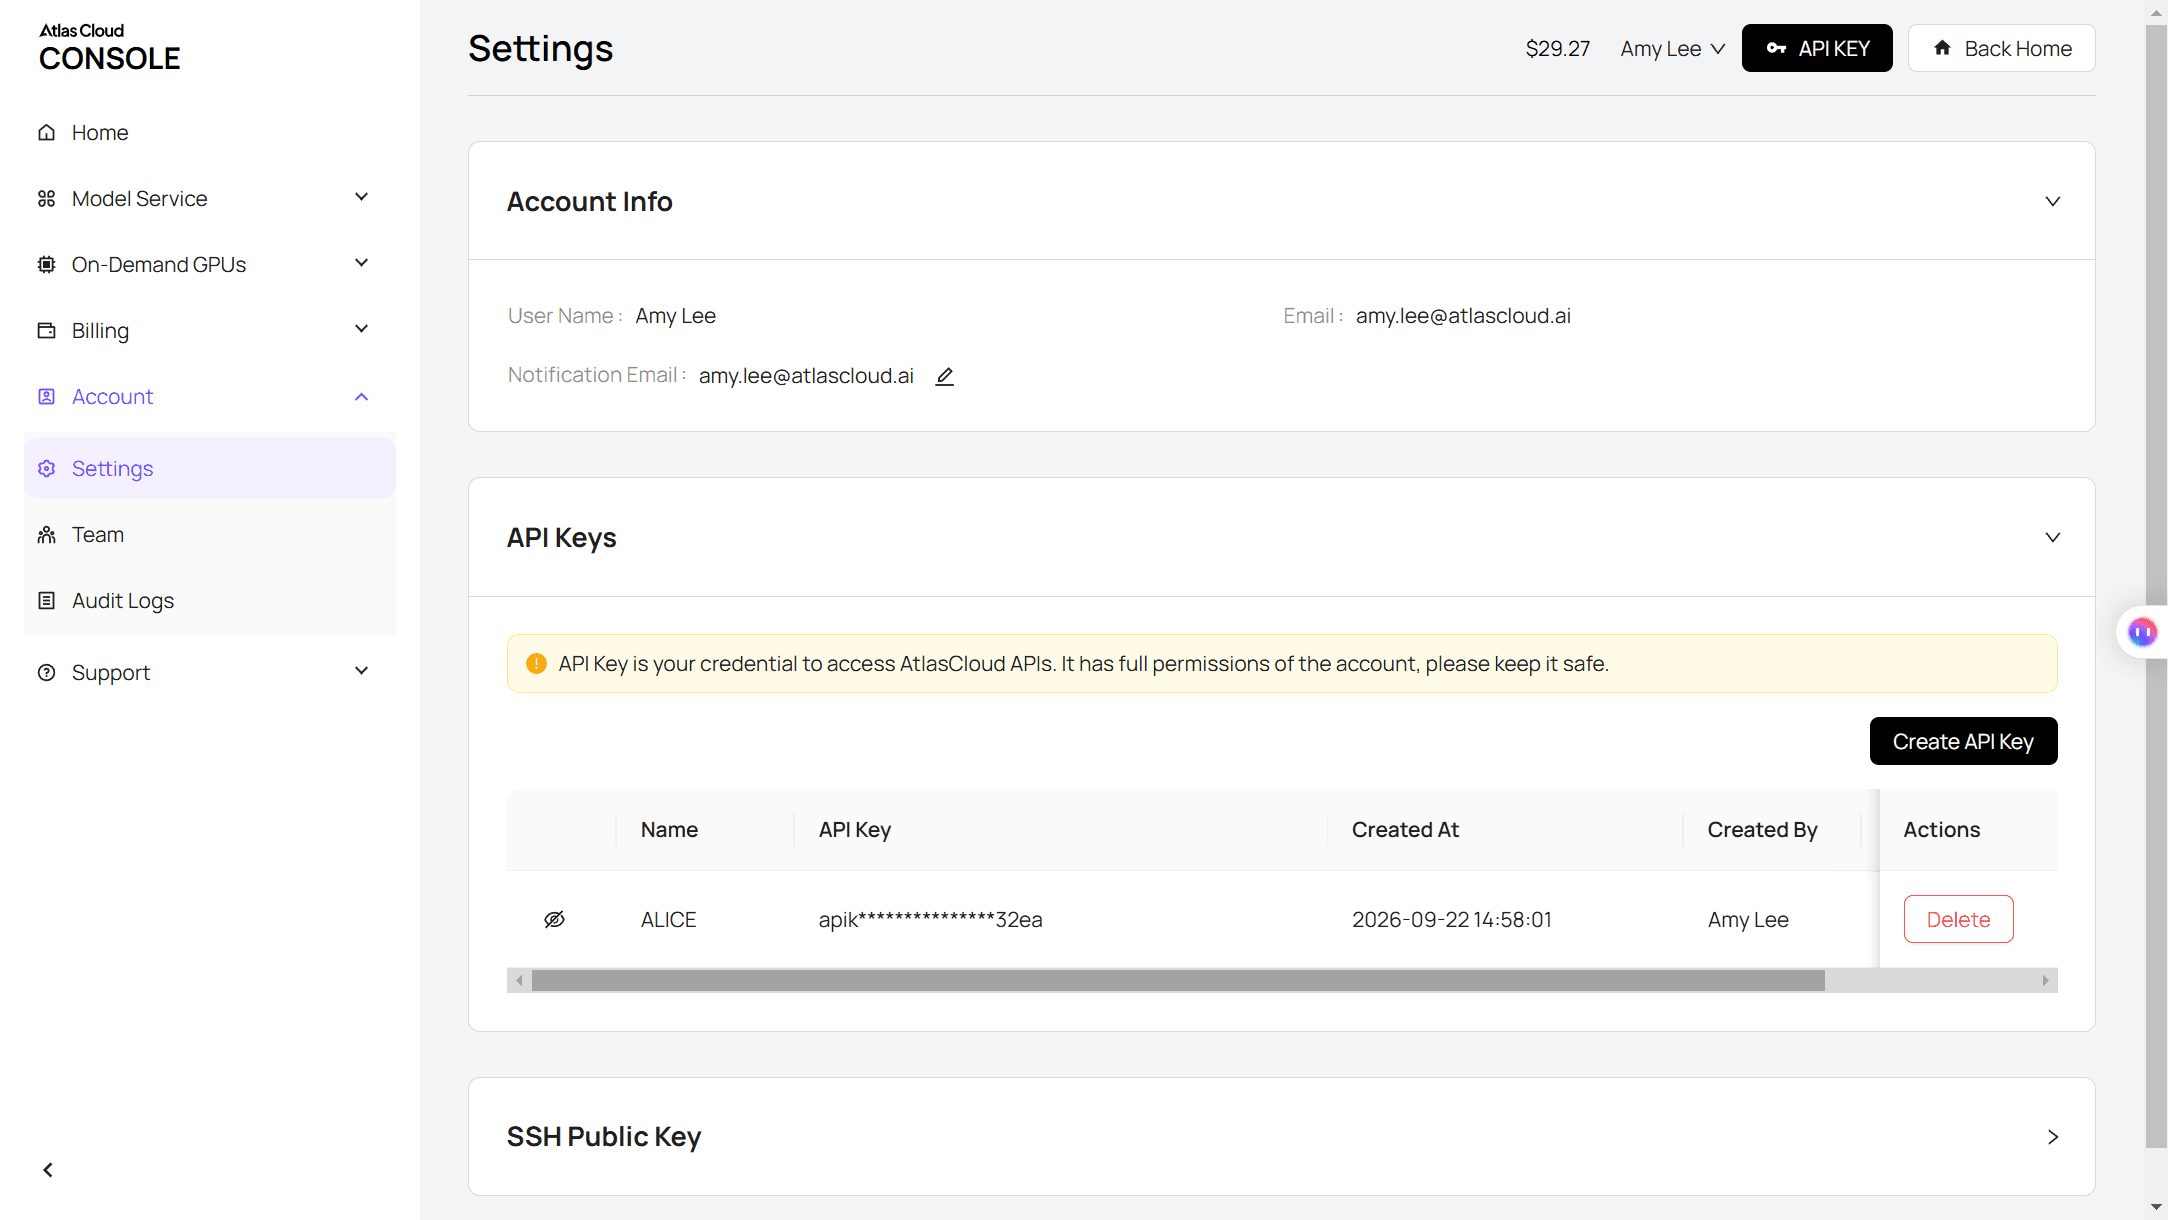
Paso 1: Crea una clave de API. Abre Settings (Configuración) en la consola, ve a API Keys (Claves de API) y haz clic en Create API Key (Crear clave de API). Mantenla en el lado del servidor.
Paso 2: Comprueba el formato de la solicitud. La documentación de la API cubre el formato de chat completions, y la página del modelo tiene una pestaña API con un ejemplo listo para usar.
Paso 3: Envía tu primera solicitud.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
La respuesta llega en choices[0].message.content. Como el endpoint sigue el formato de OpenAI, el código escrito para un servidor local de gpt-oss normalmente solo necesita una nueva URL base, clave y cadena de modelo. La misma clave también funciona con los otros modelos de chat de la plataforma, como explica nuestro artículo sobre una puerta de enlace de API LLM unificada.
GPT-OSS-120B vs. GPT-OSS-20B: compromiso entre memoria y benchmark
El hermano menor necesita una quinta parte de la memoria. gpt-oss-20b tiene 20.9B parámetros con 3.6B activos, y OpenAI dice que funciona con "tan solo 16GB de memoria". La pregunta es qué sacrificas.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | Memoria con contexto de 8K (llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond (sin herramientas) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Elo de Codeforces (sin herramientas) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
Las puntuaciones provienen de la tarjeta del modelo con alto esfuerzo de razonamiento. La brecha en programación es de menos de dos puntos en SWE-Bench Verified, mientras que la brecha de conocimiento es de unos 9 puntos en ciencia de nivel de posgrado y 15 en HealthBench. Para principalmente código en una tarjeta de 16GB a 24GB, 20b es la elección sensata. ¿Necesitas el conocimiento extra? Ahí es donde 120b justifica su factura de memoria.
GGUF, Ollama o vLLM: elegir un runtime para tu presupuesto de memoria
Cada uno ejecuta los pesos MXFP4 que OpenAI publicó; difieren en dónde pueden residir esos pesos.
| Runtime | Descarga | Mejor opción |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | Un usuario en una máquina que contiene todo el modelo |
| LM Studio | 65 GB | Una aplicación de escritorio en un Mac o PC con Windows |
| llama.cpp (ggml-org GGUF) | Unos 63 GB | Menos de 65 GB de VRAM, con capas de expertos transferidas a RAM |
| vLLM | Unos 65 GB de safetensors | Servir a muchos usuarios desde una o más GPU de centro de datos |
Para un inicio rápido en una máquina con mucha memoria:
plaintext1ollama run gpt-oss:120b
Para una GPU más pequeña, usa llama.cpp y ajusta el número de offload:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Los cuatro manejan el formato de chat harmony de OpenAI, que el modelo necesita para funcionar correctamente. Solo importa si escribes tu propio código de servicio.
Preguntas frecuentes
¿Es GPT-OSS-120B mejor que GPT-5 o Gemini 3 Pro?
Están en categorías diferentes: GPT-5 y Gemini son modelos cerrados a los que accedes mediante una app o API, mientras que gpt-oss-120b se ejecuta en tu propio hardware. Gemini 3 Pro Preview también se cerró el 9 de marzo de 2026, y su nombre ahora apunta a Gemini 3.1 Pro Preview. Si el control local importa, la línea de pesos abiertos de Google es la familia Gemma 4.
¿Por qué algunos sitios dicen que GPT-OSS-120B necesita 255 GB?
Esas cifras asumen pesos de 16 bits: aproximadamente 117B parámetros por 2 bytes, más sobrecarga. El checkpoint que publica OpenAI ya está en MXFP4, así que la descarga realista está en el rango de 61 GB.
¿El esfuerzo de razonamiento cambia el uso de memoria?
No para los pesos. Los ajustes bajo, medio y alto cambian cuánto tiempo piensa el modelo. El esfuerzo alto escribe más tokens de razonamiento, que llenan la ventana de contexto y aumentan la caché KV, por lo que las sesiones largas se acercan a los totales mayores del gráfico anterior.
¿Por qué la gente dice que GPT-OSS-120B tiene problemas con juegos basados en texto?
La evidencia es anecdótica. En la página de discusión del modelo en Hugging Face, algunos usuarios reportan negativas al escribir ficción violenta, mientras que otros dicen que el juego de rol funciona bien. Para ficción interactiva, prueba tus propios prompts antes de comprar hardware para ello.
¿Cuánto cuesta un modelo alojado de clase 120B?
A octubre de 2026, Qwen3.5 122B A10B cuesta $0.3 por millón de tokens de entrada y $2.4 por millón de tokens de salida en Atlas Cloud. Eso es un descuento del 25 % sobre sus tarifas habituales de $0.4 y $3.2. Nuestra pregunta de dimensionamiento usó unos 5,000 tokens de salida una vez contado el razonamiento, aproximadamente un centavo con la tarifa con descuento.
Conclusión
GPT-OSS-120B es más fácil de encajar de lo que sugiere su número de parámetros. Cuenta con unos 65 GB en longitudes de contexto cotidianas y menos de 70 GB en los 131K completos. Una GPU de 80GB, un Mac con más de 96GB o un mini PC de 128GB lo contendrán, y las tarjetas más pequeñas pueden ejecutarlo moviendo capas de expertos a la RAM del sistema.
Si esos números descartan tu máquina, baja a gpt-oss-20b para trabajo mayormente de programación, o llama a un modelo abierto alojado cuando necesites el cerebro más grande sin comprar hardware. En cualquier caso, los requisitos de memoria de gpt oss 120b dejan de ser un juego de adivinanzas una vez que sabes que los pesos ocupan 61 GB y el resto es margen.


