
 Atlas Cloud ya es revendedor autorizado en EE. UU. de Dreamina Seedance 2.5 y Seedream 5.0 Pro.Atlas Cloud ya es revendedor autorizado en EE. UU. de Dreamina Seedance 2.5 y Seedream 5.0 Pro.

GPT 6 Astra es el modelo más inteligente y alineado de OpenAI, diseñado para tareas exigentes de uso del ordenador, navegación web, ingeniería de software, ciberseguridad, ciencia y trabajo profesional. Su capacidad de juicio permite ejecutar flujos de trabajo complejos de programación, investigación y uso de herramientas digitales. Atlas Cloud ofrece Astra y Astra Codex mediante una única clave compatible con OpenAI, con tarifas estándar de $10 por millón de tokens de entrada y $50 por millón de tokens de salida. Empieza a crear hoy mismo.
GPT 6 Astra ha sido desarrollado por OpenAI. Atlas Cloud (operado por Atlas Cloud AI LLC) proporciona acceso al modelo, pero no es su propietario. Todas las marcas comerciales pertenecen a sus respectivos titulares.
Consulta cómo cada endpoint de GPT 6 Astra admite flujos de trabajo de conversación, generación de contenido y experiencias de IA personalizadas.
| Modalidad | Descripción |
|---|---|
| GPT 6 Astra API (Text) | GPT 6 Astra procesa prompts de texto y devuelve texto generado mediante un perfil de modelo creativo e intuitivo. Elígelo para conversaciones naturales, generación de contenido y experiencias de IA personalizadas. |
| GPT 6 Astra Codex API (Text) | Para el endpoint de GPT 6 Astra Codex, las solicitudes de texto generan respuestas de texto mediante el perfil creativo e intuitivo verificado. Es adecuado para flujos de trabajo conversacionales, de creación de contenido y de experiencias personalizadas que requieren un endpoint de modelo independiente. |
GPT 6 Astra reúne un contexto de 1,050,000 tokens, cinco niveles de razonamiento, comprensión de texto e imágenes, capacidades de uso del ordenador, dos endpoints de modelos de Atlas y precios escalonados transparentes en una única integración compatible con OpenAI.
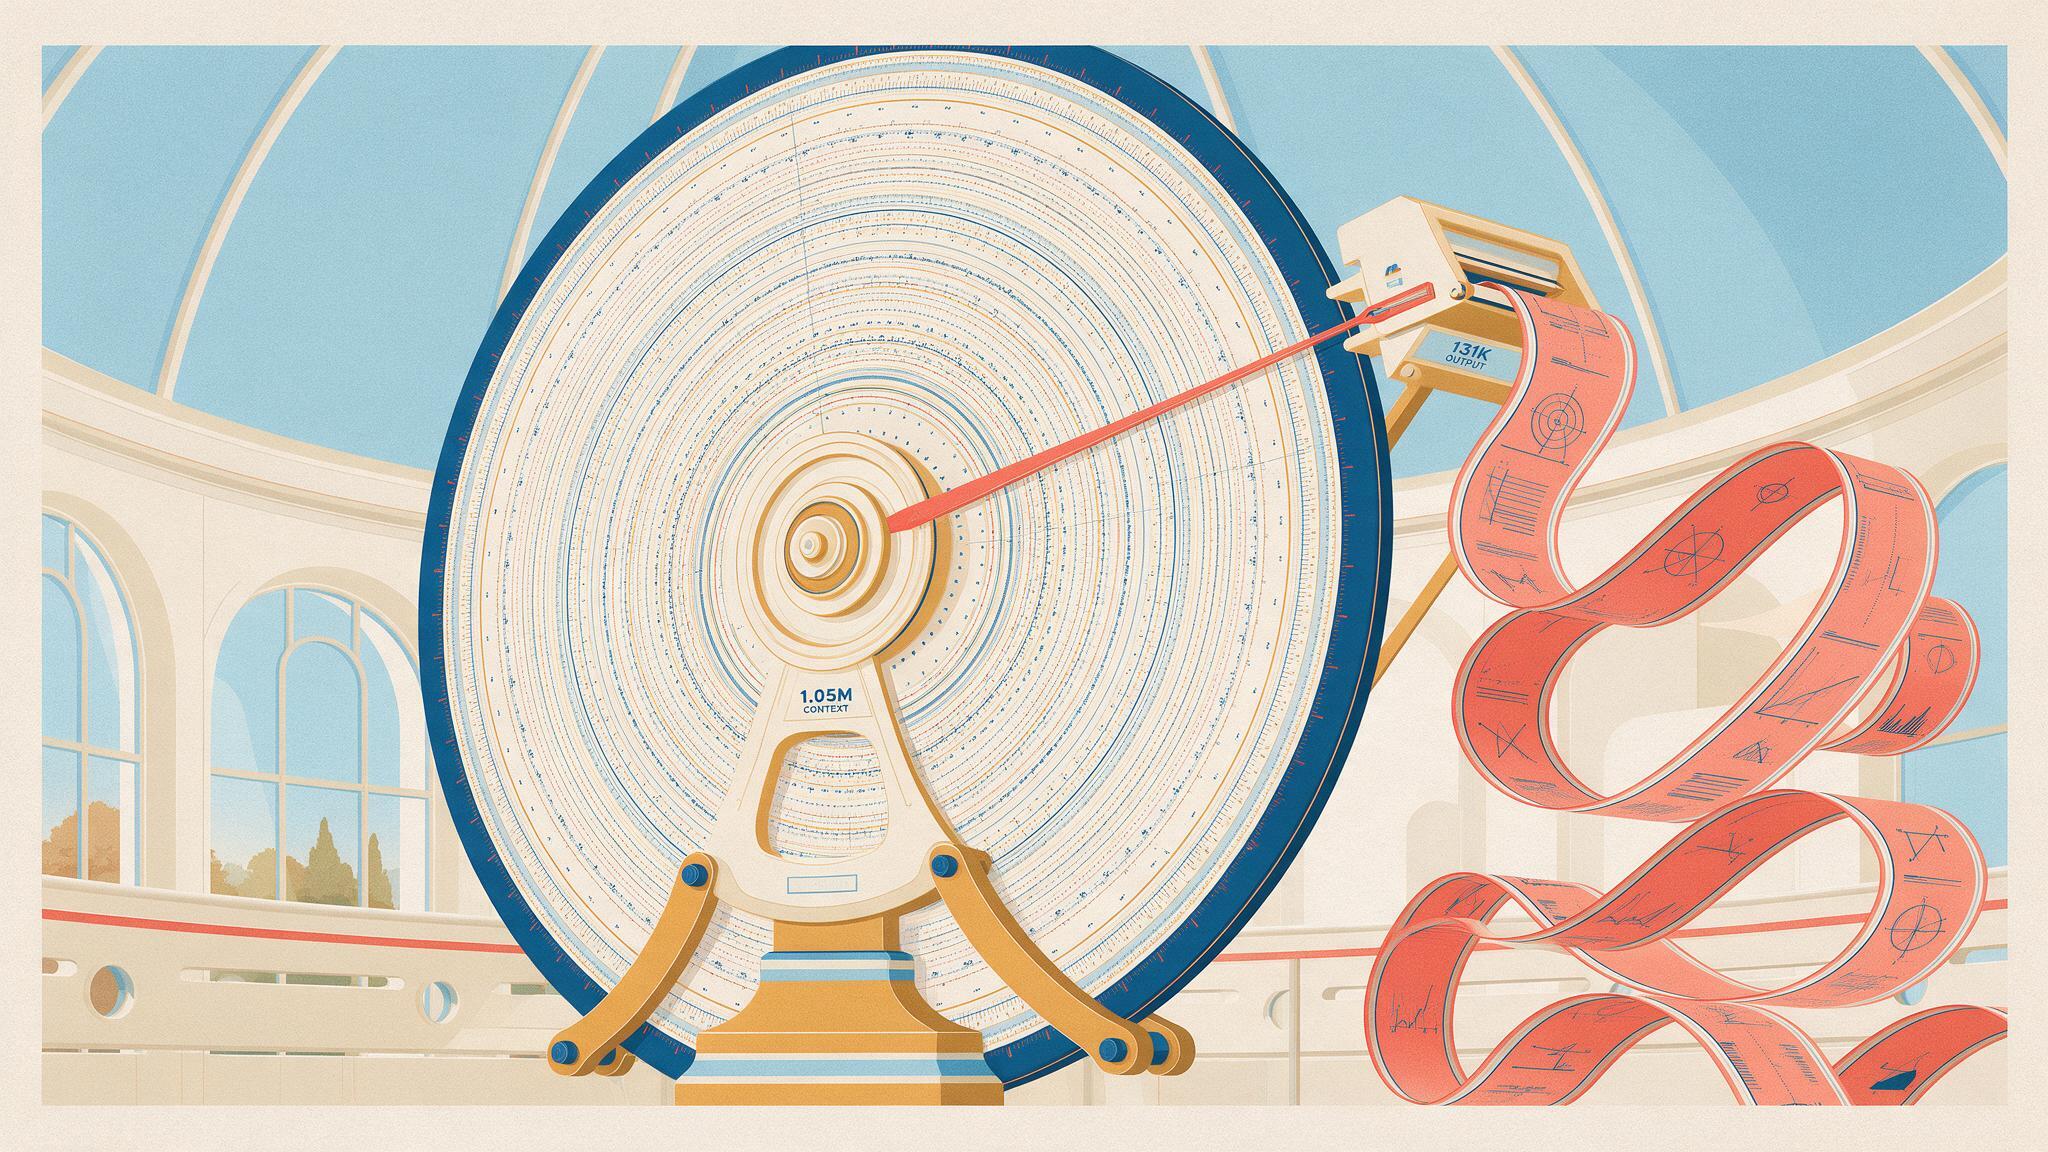
GPT 6 Astra admite hasta 1,050,000 tokens de contexto y puede devolver hasta 131,072 tokens de salida. Proporciónale repositorios extensos, colecciones de investigación o historiales de conversaciones largos en una sola solicitud. Este espacio de trabajo ampliado reduce la necesidad de fragmentar el material fuente en numerosas llamadas desconectadas, por lo que resulta ideal para revisiones exhaustivas, análisis prolongados y contextos de proyecto complejos.
Cinco niveles de esfuerzo de razonamiento te permiten ajustar cuánto deliberará el modelo en cada solicitud: low, medium, high, xhigh y max. Elige una configuración más ligera para tareas sencillas y aumenta el esfuerzo cuando la planificación, el análisis científico o la depuración compleja requieran una consideración más profunda. Este control del nivel de la solicitud ayuda a los equipos a equilibrar la velocidad de respuesta, el uso de tokens y la profundidad de la solución sin cambiar de modelo.
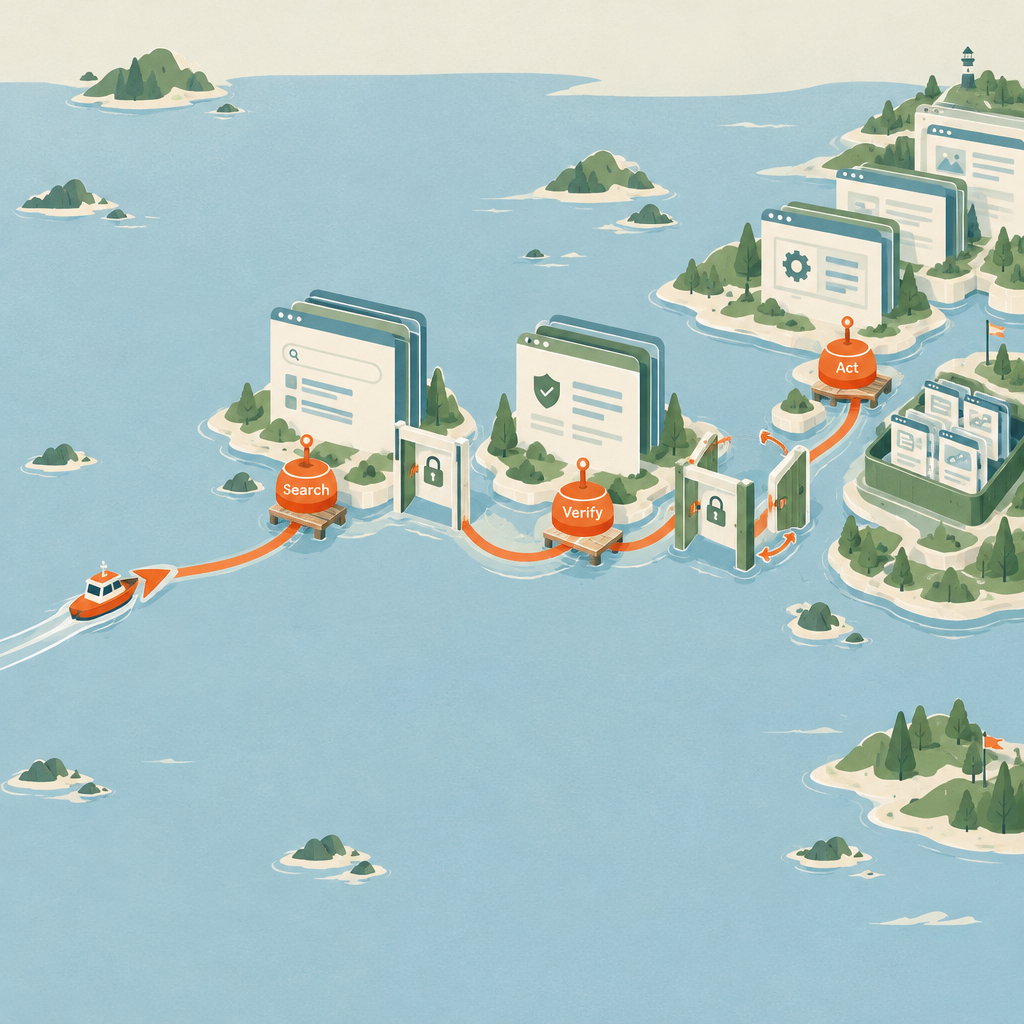
OpenAI sitúa a Astra a la vanguardia en el uso del ordenador y la navegación. Cuando tu aplicación proporciona las herramientas y los permisos necesarios, el modelo puede interpretar el estado de la interfaz, planificar acciones de varios pasos y responder a los resultados a lo largo de un flujo de trabajo más prolongado. Esta combinación se adapta a la investigación en el navegador, la asistencia operativa y las tareas basadas en software, donde el criterio importa tanto como el siguiente clic.
Atlas Cloud ofrece openai/gpt-6-astra y openai/gpt-6-astra-codex mediante una única clave compatible con OpenAI. Ambos cuentan con una ventana de contexto de 1,050,000 tokens y hasta 131,072 tokens de salida, con los mismos precios escalonados verificados. Cambia los identificadores de modelo según evolucione tu flujo de trabajo, manteniendo constantes la integración y el proceso de autenticación. Esto proporciona a los equipos una forma práctica de comparar las variantes general y Codex dentro de una misma pila.
Las entradas de texto e imágenes permiten a Astra razonar sobre prosa, capturas de pantalla, diagramas y documentos visuales mixtos, y generar respuestas de texto. Combina la evidencia visual con instrucciones escritas para que el modelo pueda relacionar lo que ve con la tarea que describes. Los desarrolladores pueden utilizar esta vía de entrada combinada para revisar documentos, analizar interfaces, interpretar gráficos y abordar otros flujos de trabajo en los que el texto por sí solo omite contexto importante.
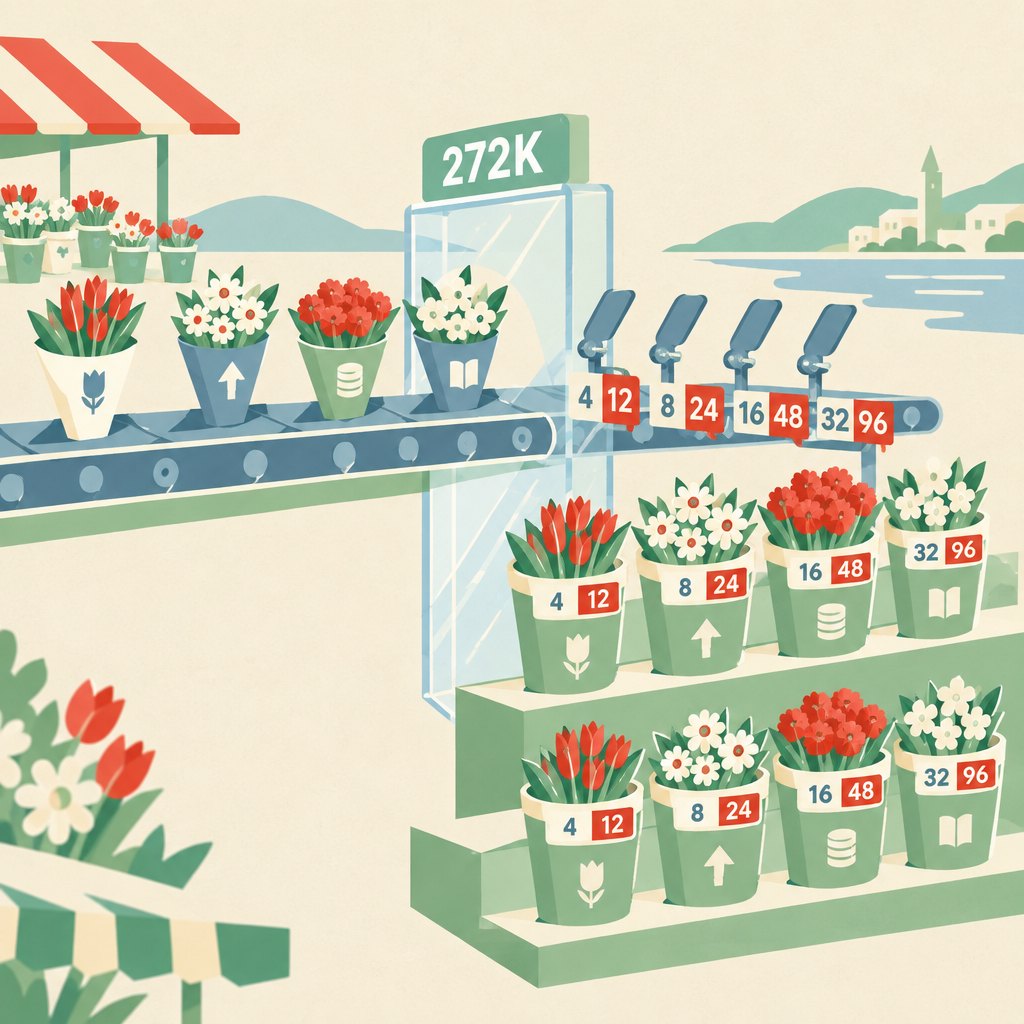
Atlas Cloud aplica precios transparentes y escalonados de pago por uso para ambas variantes de Astra. Para prompts de hasta 272,000 tokens de entrada, las tarifas estándar son de $10 por millón de tokens de entrada, $50 por millón de tokens de salida, $12.50 por la creación de caché y $1 por las lecturas de caché. Por encima de ese umbral, las tarifas correspondientes son $20, $75, $25 y $2, lo que ayuda a los desarrolladores a estimar los costes de contextos largos antes del despliegue.
Compara cómo GPT 6 Astra y dos alternativas líderes convierten prompts idénticos en experiencias HTML pulidas e interactivas.
Crea una página web HTML interactiva completa, en un único archivo, titulada “Laboratorio de Accidentes de Tipografía de Medianoche”. Muestra únicamente el documento HTML terminado, con todo el CSS y JavaScript integrados. Debe abrirse y funcionar directamente en un navegador moderno sin dependencias externas, CDNs, bibliotecas, fuentes, enlaces a imágenes, archivos SVG ni otros recursos. Es una página web adaptable, no una imagen fija de 16:9 ni una composición en canvas; debe adaptarse correctamente a pantallas de escritorio, tabletas y móviles. Construye un simulador táctil experimental de tipografía de plomo en el que el usuario componga una impresión arrastrando bloques individuales de tipos de plomo hasta una hoja central, girándolos y reposicionándolos, y ajustando después la cantidad de tinta, la presión de la prensa y la humedad del papel antes de accionar una enorme palanca mecánica de impresión. El resultado impreso debe responder proceduralmente a esos parámetros: el exceso de tinta provoca sangrado y contadores obstruidos, la poca tinta crea bordes secos y fragmentados, la presión modifica la indentación y la deformación, la humedad aumenta el difuminado y el daño de las fibras del papel, una colocación imperfecta de los tipos crea desregistro, y las impresiones repetidas producen sombras desplazadas e imágenes fantasma. Permite múltiples pasadas de color usando únicamente rojo bermellón, azul ultramar y amarillo ácido, con mezcla realista de sobreimpresión, orden de capas visible, visibilidad por capa, deshacer/rehacer paso a paso y la posibilidad de levantar la esquina del papel para revelar la impresión en evolución. Congela el dramatismo visual principal en torno al instante en que el rodillo de la prensa acaba de elevarse y la impresión terminada está a punto de revelarse. El papel central debe sentirse como un escenario teatral. Organiza bloques tipográficos, rodillos de tinta, pinzas, pasadores de registro, recortes, indicadores y controles en un anillo asimétrico a su alrededor. Usa una base de papel hueso blanquecino y gris plomo, iluminada por una lámpara de trabajo blanca cálida que brilla en diagonal desde la esquina superior izquierda. Representa todo mediante CSS, elementos HTML, Canvas y texturas procedurales, con un estilo tosco de serigrafía física y collage artesanal: bordes rasgados, grano de papel fibroso, pigmento irregular, motas de semitono, metal arañado, manchas de tinta, fragmentos de cinta, ligera perspectiva, registro imperfecto y sombras superpuestas. Evita los degradados brillantes, el estilo SaaS estéril, las tarjetas genéricas, los colores cyberpunk neón, las imágenes fotorrealistas, los emojis, las ilustraciones de stock y la geometría vectorial perfectamente limpia. Incluye un inventario amplio de tipos móviles con letras, signos de puntuación, numerales y varios bloques decorativos. El usuario debe poder arrastrar bloques del inventario al área de composición, seleccionar varios bloques, girarlos mediante controles o atajos de teclado, desplazarlos con las teclas de flecha, eliminarlos o duplicarlos, y editar su contenido textual sin perder el aspecto físico del bloque. Añade guías de ajuste que puedan activarse o desactivarse, pero conserva pequeñas irregularidades manuales. Proporciona estados claros de desplazamiento, activo, seleccionado, deshabilitado y foco. Admite interacción con puntero y táctil, controles de teclado razonables, etiquetas accesibles e indicadores de foco visibles. Crea tres controles táctiles para la cantidad de tinta, la presión y la humedad, cuyos valores actualicen en tiempo real la vista previa del papel, la simulación de texturas, los indicadores, las etiquetas de advertencia y el comportamiento ambiental de la máquina. El sistema debe revelar estados de accidente lúdicos en combinaciones extremas, como explosiones violentas de tinta, letras duplicadas, tipos desplazados, grietas de fibras desgarradas, traqueteo del rodillo y marcas de registro salpicadas, manteniendo la composición legible. Añade un registro compacto del experimento que anote cada impresión y sus parámetros. El usuario debe poder seleccionar un color de pasada, accionar la palanca arrastrándola en un arco convincente, observar un ciclo de prensa breve pero detallado y después despegar el papel. La animación debe incluir resistencia de la palanca, vibración de la máquina, movimiento del rodillo, compresión del papel, motas de polvo, un ligero parpadeo de la lámpara y una pausa de suspense antes de la revelación. Respeta prefers-reduced-motion. Haz que deshacer y rehacer sean realmente funcionales para la colocación, rotación, cambios de parámetros, impresión, pasadas de color y acciones de revelación. Incluye controles de Restablecer, Accidente aleatorio, Volver a entintar, Añadir pasada, Deshacer y Rehacer, además de una indicación concisa de inicio que desaparezca después de la interacción. Prepara la página con un póster parcialmente compuesto e intrigante para que la primera vista sea visualmente rica, pero permite editar todos los elementos importantes. Añade retroalimentación visual sutil parecida a sonidos sin utilizar recursos de audio. Garantiza una textura procedural determinista cuando sea práctico, de modo que deshacer restaure el mismo aspecto. La experiencia debe sentirse ceremonial, artesanal, tensa y traviesamente incontrolable, no meramente decorativa. Da prioridad a los detalles pulidos de interacción, el acoplamiento convincente de los parámetros, los artefactos de impresión procedurales por capas, una temporización de animación refinada y una composición adaptable excelente. Usa HTML semántico y JavaScript vanilla limpio y bien estructurado. La respuesta final debe contener únicamente el documento HTML completo y ejecutable.
Generated with GPT 6 Astra on Atlas Cloud
Generated with Gemini 3.1 Pro Preview on Atlas Cloud
Generated with GPT 5.6 Sol on Atlas Cloud
Crea una página web HTML interactiva completa y pulida, en un único archivo, titulada “Teatro de Paisaje Sonoro de Ramen de Medianoche”. Muestra únicamente el documento HTML final, con todo el CSS y JavaScript integrados. Debe ejecutarse directamente en un navegador moderno sin paso de compilación ni dependencias externas, bibliotecas, fuentes, imágenes, archivos de audio, recursos CDN, solicitudes de red ni recursos enlazados. Construye una escena interactiva expresiva ambientada en un surrealista local de ramen a medianoche. El objeto central es un único manojo continuo de fideos elásticos, representado con Canvas, SVG o una combinación cuidadosamente integrada de ambos. El manojo de fideos debe atravesar diagonalmente el primer plano y sentirse físicamente tangible: el usuario puede agarrarlo en cualquier punto con el ratón o mediante interacción táctil, arrastrarlo, estirarlo, azotarlo, doblarlo sobre sí mismo y soltarlo. Implementa una física de muelle convincente con inercia, amortiguación, gravedad, múltiples segmentos conectados, respuesta a colisiones y movimiento secundario visible. Mantén la simulación estable incluso durante arrastres agresivos, cambios rápidos de dirección, redimensionamientos de la ventana o interacciones repetidas. Distribuye al menos tres cuencos de ramen distintos y varios ingredientes a lo largo de un arco amplio que atraviese la composición, creando un ritmo visual marcado alrededor del fideo diagonal. Cada cuenco debe tener su propio patrón ilustrado de caldo, identidad cromática, etiqueta y carácter sonoro. Cuando el fideo toque o caiga dentro de un cuenco, activa una respuesta audiovisual sincronizada: un ritmo percusivo único sintetizado con Web Audio API, una ráfaga ascendente de vapor, rociadas de partículas verdes de cebolleta, ondas en el caldo, pequeñas gotas, un ligero temblor de registro de serigrafía y onomatopeyas animadas escritas a mano, de estilo japonés, como “ZURU!”, “PON!”, “JUU!” o “BASHAN!”, creadas con texto estilizado en lugar de fuentes externas. La intensidad de la colisión debe afectar al volumen, el tono, la cantidad de partículas, el tamaño de las ondas, la escala de las letras y la fuerza de la animación. El audio debe comenzar únicamente después de la primera interacción del usuario e incluir un control claro para silenciarlo o activar el sonido. El estado visual culminante debe evocar un fotograma congelado en el que el fideo está dramáticamente estirado en el aire mientras el caldo queda suspendido justo antes de salpicar. Refuerza esto con un control “CONGELAR EL SALPICÓN” y la tecla Space: al entrar en modo congelado debe aplicarse una transición breve y contundente, suspender la escena física sin perder su estado, enfatizar las gotas suspendidas y la tensión del fideo estirado, mostrar una tipografía cinética audaz con aspecto de póster y conservar un sutil brillo procedural en las líneas para que la página siga pareciendo viva. Al pulsar Space o el control de nuevo, la escena debe reanudarse sin interrupciones. Añade un control de restablecimiento, un indicador compacto del estado del sonido y una lectura discreta en directo de “tempo/impacto” impulsada por las colisiones recientes. Los controles de teclado deben poder descubrirse en un pequeño panel de ayuda integrado: Space alterna el congelado, R restablece, M silencia y las teclas de flecha aplican impulsos direccionales al fideo. Usa una combinación visual sofisticada de diseño de póster de serigrafía vintage y animación procedural de líneas. Debe dominar un fondo índigo profundo, interrumpido por la calidez localizada del fuego de los fogones alrededor de los cuencos y los puntos de colisión. Usa colores planos superpuestos —rojo bermellón, amarillo jengibre, verde cebolleta, crema cálida y casi negro— con texturas de semitono, bordes de tinta rugosos, ligero desregistro cromático, sombras gráficas marcadas y líneas de contorno animadas. El resultado debe sentirse artesanal y teatral, no brillante ni fotorrealista. Incluye vapor ambiental sutil, un resplandor parpadeante de los fogones, grano flotante y trazos en movimiento, pero conserva un contraste fuerte y controles legibles. Evita el estilo cyberpunk neón genérico. Haz que la composición responda a pantallas anchas de escritorio, tabletas y móviles; es una página web, así que no fuerces una relación de aspecto fija de 16:9. Adapta fluidamente la posición de los cuencos, la tipografía, los controles, los límites de la simulación y las áreas táctiles sin recortar contenido esencial. Usa eventos de puntero para unificar la interacción con ratón, lápiz y pantalla táctil. Impide el desplazamiento de la página únicamente mientras el usuario manipula activamente el fideo. Respeta prefers-reduced-motion reduciendo la animación ambiental mientras mantienes funcional la interacción principal. Conserva un rendimiento fluido mediante un conjunto eficiente de partículas o límites estrictos de partículas, requestAnimationFrame, renderizado consciente de device-pixel-ratio con un límite de resolución razonable y gestión de coordenadas segura ante redimensionamientos. Requisitos de contenido y acabado: incluye un tratamiento atmosférico del título, una invitación breve de una sola línea a interactuar, tres o más cuencos etiquetados, múltiples ingredientes visualmente diferenciados, palabras sonoras manuscritas contextuales, estados de control pulidos, estilos de foco claros, etiquetas accesibles para los botones y una indicación de interacción discreta que se desvanezca tras el primer uso. La escena inicial debe parecer ya un póster coleccionable terminado antes de cualquier interacción, mientras que el estado activo debe convertirse en un juguete rítmico dinámico con retroalimentación por capas y movimientos emergentes sorprendentes. Restricciones negativas: sin recursos ni dependencias externas; sin URLs de imágenes; sin audio pregrabado; sin frameworks; sin marcadores de posición sin terminar; sin comentarios TODO; sin controles rotos; sin canvas fijo de 16:9; sin interfaz de usuario predeterminada y simple; sin fondo genérico compuesto únicamente por degradados; sin emojis como arte principal; sin exceso de texto explicativo; sin audio de reproducción automática; sin crecimiento incontrolado de partículas; sin física frágil que explote o produzca valores NaN; sin una interacción que funcione únicamente con ratón; y sin ninguna salida fuera del documento HTML completo y único.
Generated with GPT 6 Astra on Atlas Cloud
Generated with Gemini 3.1 Pro Preview on Atlas Cloud
Generated with GPT 5.6 Sol on Atlas Cloud
GPT 6 Astra convierte el razonamiento avanzado, la navegación web, el uso del ordenador, la ingeniería de software, el análisis multimodal y el contexto largo en flujos de trabajo prácticos para desarrolladores, investigadores, equipos de seguridad y profesionales del conocimiento.

GPT 6 Astra gestiona tareas de uso del ordenador y navegación web que requieren varios pasos coordinados. Despliega el modelo para operaciones basadas en el navegador, recopilación de información y flujos de trabajo digitales en los que un agente debe pasar de la instrucción a la finalización.

En bases de código existentes, GPT 6 Astra puede ayudar con tareas complejas de ingeniería de software. Los desarrolladores pueden usarlo para inspeccionar el contexto, depurar problemas, implementar cambios y revisar los resultados antes de integrarlos en los flujos de trabajo de producción.

Convierte grandes colecciones de fuentes en investigaciones estructuradas con las capacidades de navegación web y contexto largo de GPT 6 Astra. Los analistas pueden comparar evidencias, conservar el contexto de todo el proyecto y producir conclusiones claras para tomar decisiones fundamentadas.

Cuando el trabajo de seguridad exige un razonamiento cuidadoso, GPT 6 Astra puede examinar código, configuraciones y evidencias técnicas. Usa sus hallazgos para respaldar la revisión de vulnerabilidades, la planificación de medidas correctivas y las transferencias documentadas entre equipos de seguridad.

Los equipos científicos pueden aplicar GPT 6 Astra a análisis exigentes que combinan texto, imágenes y un contexto amplio. Ayuda a los investigadores a organizar observaciones, poner a prueba líneas de razonamiento y redactar resultados para su validación por expertos.

Integra documentos extensos, referencias visuales y registros del proyecto en un único flujo de trabajo profesional. Con GPT 6 Astra, los equipos pueden conciliar materiales y preparar informes, documentos informativos o decisiones sin perder el contexto circundante.
Compara GPT 6 Astra con los principales modelos multimodales disponibles en Atlas Cloud según los tipos de entrada compatibles, la capacidad de contexto, el límite de salida y el precio estándar por token.
| Modelo | Tipos de entrada | Ventana de contexto | Salida máxima | Precio estándar por 1M de tokens |
|---|---|---|---|---|
| GPT 6 Astra | Texto, imagen | 1,050,000 tokens | 131,072 tokens | $10 de entrada / $50 de salida; para prompts de más de 272K: $20 de entrada / $75 de salida |
| GPT 6 Astra Codex | Texto, imagen | 1,050,000 tokens | 131,072 tokens | $10 de entrada / $50 de salida; para prompts de más de 272K: $20 de entrada / $75 de salida |
| Gemini 3.1 Pro Preview | Texto, imagen, vídeo | 1,000,000 tokens | 64,000 tokens | $2 de entrada / $12 de salida; para prompts de más de 200K: $4 de entrada / $18 de salida |
| Grok 4.6 | Texto, imagen | 500,000 tokens | 500,000 tokens | $2 de entrada / $6 de salida; para prompts de más de 200K: $4 de entrada / $12 de salida |
| Kimi K3 | Texto, imagen, vídeo | 1,048,576 tokens | 1,048,576 tokens | $3 de entrada / $15 de salida |
Empieza en minutos — sigue estos sencillos pasos para integrar y desplegar modelos a través de la plataforma de Atlas Cloud.
Regístrate en atlascloud.ai y completa la verificación. Los nuevos usuarios reciben créditos gratuitos para explorar la plataforma y probar modelos.
Combina modelos avanzados de GPT 6 Astra con la plataforma acelerada por GPU de Atlas Cloud, proporcionando rendimiento, escalabilidad y experiencia de desarrollo incomparables.
Baja Latencia:
Inferencia optimizada por GPU para respuestas en tiempo real.
API Unificada:
Una sola integración para acceder a GPT 6 Astra, GPT, Gemini y DeepSeek.
Precios Transparentes:
Facturación por Token, soporta modo Serverless.
Experiencia del Desarrollador:
SDK, análisis de datos, herramientas de ajuste fino y plantillas todo en uno.
Confiabilidad:
99.99% de disponibilidad, control de permisos RBAC, registros de cumplimiento.
Seguridad y Cumplimiento:
Certificación SOC 2 Type II, cumplimiento HIPAA, soberanía de datos en EE.UU.
GPT-6 Astra es el modelo de vanguardia de OpenAI para tareas exigentes de uso de ordenadores, navegación web, ingeniería de software, ciberseguridad, ciencia y trabajo profesional. Atlas Cloud proporciona acceso basado en el uso a GPT 6 Astra y GPT 6 Astra Codex mediante una única clave compatible con OpenAI.
Diseñado para trabajos complejos, Astra admite razonamiento, programación, navegación web, uso de ordenadores, investigación y análisis de contextos extensos. Acepta entradas de texto e imagen y genera texto para flujos de trabajo con agentes, creación de documentos y otras tareas profesionales exigentes.
Configura un cliente compatible con OpenAI para usar el endpoint de Atlas Cloud, añade tu clave de API de Atlas y selecciona openai/gpt-6-astra u openai/gpt-6-astra-codex. Atlas Cloud ofrece la familia mediante el protocolo Chat Completions, lo que permite conservar estructuras de solicitud y respuesta conocidas.
Atlas Cloud admite entradas de texto e imagen con salida de texto. La ventana de contexto indicada es de 1,050,000 tokens, la salida máxima es de 131,072 tokens y la fecha de corte del conocimiento es el 30 de abril de 2026.
Sí. Se admite streaming y el esfuerzo de razonamiento puede configurarse como low, medium, high, xhigh o max. Los ajustes más bajos priorizan la velocidad y un menor uso de tokens, mientras que los más altos permiten un mayor razonamiento para trabajos difíciles.
El precio estándar es de $10 por millón de tokens de entrada y $50 por millón de tokens de salida. La entrada en caché cuesta $1 por millón de tokens, mientras que la creación de caché cuesta $12.50 por millón. Para prompts de más de 272,000 tokens, las tarifas correspondientes son de $20, $75, $2 y $25 por millón de tokens.
Empieza con un esfuerzo de razonamiento low o medium y mide el uso de tokens en tareas representativas antes de aumentar el ajuste. La caché de prompts puede reducir el coste de las entradas reutilizables, mientras que un modelo de menor coste puede ser más adecuado para solicitudes rutinarias o de gran volumen.
Atlas Cloud incluye dos ID de modelo independientes: openai/gpt-6-astra y openai/gpt-6-astra-codex. Ambos utilizan la misma tabla de precios verificada, pero los datos disponibles del backend no establecen una diferencia cuantificada en capacidad o latencia. Evalúa ambos con tus propias cargas de trabajo de programación y uso general antes de seleccionar un modelo predeterminado para producción.
Elige Astra para trabajos difíciles en los que la calidad sea lo más importante, incluido el uso agéntico de ordenadores, la ingeniería de software compleja, el análisis de contextos extensos y las tareas científicas o profesionales exigentes. Para solicitudes rutinarias, tráfico de gran volumen o flujos de trabajo en los que la latencia sea importante, compara un modelo más pequeño según el éxito de las tareas y el coste total.
¡La API de Seedance 2.5 ya está disponible en Atlas Cloud! Ofrece a los desarrolladores el modelo de video más reciente de ByteDance. Genera hasta 30 segundos de video nativo en una sola pasada a partir de texto, una sola imagen o hasta 50 referencias multimodales, con audio sincronizado y texto multilingüe en el encuadre. En Atlas Cloud puede acceder a él mediante una única clave, con consistencia del sujeto y físicas mejoradas que mantienen la coherencia en las tomas largas.

La API Wan 3.0 es la próxima generación de la familia de videos Wan de Alibaba, diseñada para llevar la generación de formato largo, el control de múltiples referencias y la calidad audiovisual a nuevas alturas. Atlas Cloud ya aloja Wan 2.7, 2.6 y 2.5, y Wan 3.0 se ejecuta con la misma clave unificada sin necesidad de configuración adicional. Empieza a construir hoy mismo. Desplázate hacia abajo hasta la galería para ver lo que Wan 3.0 puede crear.
MiniMax H3 es la familia de vídeo multimodal de MiniMax para la creación guiada por texto, imagen y referencias. En las rutas compatibles, conserva los sujetos del material de referencia, ofrece relaciones de aspecto flexibles y combina el sonido generado con los elementos visuales mediante H3 Developer, con perfiles de salida seleccionados según el endpoint. Atlas Cloud reúne toda la familia bajo una única clave compatible con OpenAI, con precios transparentes de pago por uso a partir de la tarifa estándar de $0.038 por segundo. Empieza a crear hoy mismo.
La familia gpt-image-2.5 de OpenAI ofrece a los desarrolladores la posibilidad de elegir entre Flare y Sunburst para flujos de trabajo de producción de imágenes. Renderiza con resoluciones arbitrarias de hasta 3840x2160 y elige entre cinco niveles de calidad, incluidos xhigh y max, para adaptarte a requisitos de salida específicos. Atlas Cloud proporciona inferencia REST lista para usar, sin arranques en frío y con precios estándar desde $0.004 por generación. Empieza a crear hoy mismo.
La API de Seedream 5.0 Pro ofrece a los desarrolladores el modelo de edición de imágenes controlable de ByteDance en Atlas Cloud. Sitúa las ediciones con precisión mediante anclajes y coordenadas, separa las imágenes en capas editables, fusiona múltiples referencias y empareja colores y materiales exactos, con texto multilingüe a 2K y 3K. ¡En Atlas Cloud puede acceder a él mediante una sola clave!
Seedance 2.0 es el modelo de vídeo para producción de ByteDance, diseñado para crear planos con precisión. Convierte prompts en vídeo, anima una imagen del primer fotograma con orientación opcional del último fotograma o da forma a los resultados mediante medios de referencia y búsqueda web opcional. Atlas Cloud reúne estos flujos de trabajo en una única API unificada, con precios transparentes de pago por uso y una sola clave compatible con OpenAI. Empieza a crear hoy mismo.
La Kling 3.0 API lleva la suite de video insignia de Kuaishou a Atlas Cloud mediante una clave compatible con OpenAI. Abarca dos modelos: Kling 3.0 para la narración de AI Director, sincronización labial multilingüe y texto en pantalla preciso, y Kling 3.0 Omni (O3) para la clonación de sujetos y voz a partir de un video corto o imagen. Ambos generan audio nativo en la misma pasada, con una salida de hasta 4K. Construya narrativas cinematográficas, marketing global, anuncios multilingües y contenido de personajes en serie sobre una infraestructura confiable.
Grok Imagine Video brinda a los desarrolladores acceso a la familia de modelos de video de xAI para crear, animar, ampliar y editar clips. Genera videos de 1 a 15 segundos a partir de indicaciones, guía personas, objetos o estilos con hasta siete imágenes de referencia y trabaja en 480p o 720p. Atlas Cloud reúne estas capacidades mediante endpoints compatibles con OpenAI y precios transparentes de pago por uso. Empieza a crear hoy mismo.
Vidu Q4 es el último modelo de vídeo insignia de Vidu, diseñado para la generación de vídeo a partir de imágenes y referencias. Puede animar una sola imagen estática y crear transiciones automáticas entre escenas, ofreciendo a los desarrolladores dos vías de entrada para distintos flujos de trabajo de producto. Atlas Cloud proporciona endpoints de API dedicados con esquemas de parámetros publicados, a un precio estándar verificado de $0.04 por segundo. Empieza a desarrollar hoy mismo.
Gemini Omni 1.1 Flash es la familia de vídeo nativamente multimodal de Google DeepMind para flujos de producción flexibles. Edita material existente mediante instrucciones de texto, mantén la coherencia visual con hasta 10 imágenes de referencia y 3 clips de vídeo, o amplía una toma en segmentos encadenables de hasta 40 segundos. Accede a todos los flujos de trabajo en Atlas Cloud con una sola clave de API compatible con OpenAI, precios de pago por uso y disponibilidad desde el día 0. Empieza a desarrollar hoy mismo.
Nano Banana 2.1 es la familia de modelos de imagen de Google basada en Gemini 3.6 Flash. Ofrece generación y edición con calidad Pro a la velocidad de Flash, admite ediciones y combinaciones mediante lenguaje natural con entre 1 y 14 imágenes de entrada, y mantiene la coherencia de hasta 4 personajes y 10 objetos. A través de Atlas Cloud, los desarrolladores pueden acceder a la familia con una única clave compatible con OpenAI, disponibilidad fiable y disponibilidad desde el día 0. Empieza a crear hoy mismo.
Construya con la API Nano Banana 2, impulsada por el modelo Gemini 3.1 Flash Image de Google. Genera imágenes en 4K nativo de hasta 4096x2304 con una representación de texto precisa y personajes consistentes en hasta 14 imágenes de referencia, tanto para generación como para edición. En Atlas Cloud puede acceder a ella a través de una API unificada junto con más de 300 modelos, con precios desde $0.04 por imagen, un tiempo de actividad del 99.99% y créditos gratuitos para comenzar.
Guías, tutoriales y novedades de producto para aprovechar al máximo Atlas Cloud.



