
MiniMax API
Jako wiodący pakiet Large Language Models (LLMs) opracowany przez MiniMax AI, MiniMax został zaprojektowany tak, aby na nowo definiować produktywność w realnym świecie dzięki najnowocześniejszej sztucznej inteligencji. Ekosystem obejmuje MiniMax M2.5, stworzony specjalnie z myślą o wysoce wydajnych środowiskach profesjonalnych, oraz MiniMax M2.1, model oferujący znacznie ulepszone możliwości programowania w wielu językach, pozwalające opanować złożone zadania techniczne na dużą skalę. Dzięki osiąganiu wyników SOTA w kodowaniu, agentowym korzystaniu z narzędzi, inteligentnym wyszukiwaniu i automatyzacji przepływów pracy biurowej MiniMax umożliwia użytkownikom usprawnianie szerokiego zakresu operacji o dużej wartości ekonomicznej z niezrównaną precyzją i niezawodnością.
MiniMax został opracowany przez MiniMax. Atlas Cloud (prowadzona przez Atlas Cloud AI LLC) zapewnia dostęp do modelu, ale nie jest jego właścicielem. Wszystkie znaki towarowe należą do ich odpowiednich właścicieli.
Poznaj Wiodące Modele
Atlas Cloud zapewnia najnowsze, wiodące w branży modele kreatywne.



Porównanie linii modeli MiniMax API
Przejrzysty przegląd tego, co każdy endpoint MiniMax przyjmuje, generuje i ile kosztuje — od tekstu, kodowania i agentowych przepływów pracy po generowanie muzyki.
| Modalność | Opis |
|---|---|
| MiniMax M3 API (tekst) | Potrzebujesz szybkiego modelu agentowego? MiniMax M3 przekształca prompty tekstowe w kod, wywołania narzędzi i rozumowanie, korzystając z lekkiego rdzenia o 10 billion aktywowanych parametrów, zaprojektowanego z myślą o niskich opóźnieniach i skalowalności. Standardowa cena wynosi $0.6 za milion tokenów wejściowych oraz $2.4 za milion tokenów wyjściowych, a po przekroczeniu przez prompt 512K tokenów stosowany jest osobny próg cenowy. Dobrze sprawdza się w długich, intensywnie korzystających z narzędzi sesjach agentowych oraz w nowoczesnym tworzeniu aplikacji. |
| MiniMax M2.7 (tekst) | MiniMax M2.7 zamienia instrukcje w języku naturalnym na kod produkcyjny i wieloetapowe działania agentowe, wykorzystując tę samą architekturę 10 billion aktywowanych parametrów dla wysokiej przepustowości. Standardowe ceny wynoszą $0.3 za milion tokenów wejściowych i $1.2 za milion tokenów wyjściowych, dzięki czemu duże uruchomienia agentowe pozostają ekonomiczne. Wybierz go, gdy niezawodne kodowanie i tworzenie aplikacji są ważniejsze niż sama wielkość modelu. |
| MiniMax M2.5 (tekst) | Jeśli Twoje obciążenia wymagają przystępnego cenowo, skalowalnego rozumowania, MiniMax M2.5 obsługuje kodowanie, orkiestrację agentową i codzienne tworzenie aplikacji dzięki kompaktowemu silnikowi o 10 billion aktywowanych parametrów. Cena katalogowa to $0.3 za milion tokenów wejściowych i $1.2 za milion tokenów wyjściowych, a wejście z pamięci podręcznej kosztuje $0.03 za milion, co obniża koszt wielokrotnego używania tego samego kontekstu. To praktyczny wybór domyślny dla wysokowolumenowych pipeline’ów ponownie wykorzystujących kontekst. |
| MiniMax Music 2.6 API (tekst na muzykę) | Opisz styl i podaj uporządkowany tekst utworu ze znacznikami takimi jak [Verse] i [Chorus], a MiniMax Music 2.6 zwróci kompletną ścieżkę wokalną lub instrumentalną z jednego żądania generowania. Obsługiwane formaty wyjściowe obejmują MP3, WAV i PCM, z częstotliwościami próbkowania do 44.1 kHz oraz bitrate’em do 256 kbps; model przyjmuje prompty do 2,000 znaków i teksty utworów do 3,500 znaków. Przy cenie $0.15 za generację sprawdza się w prototypowaniu ścieżek dźwiękowych, jingli oraz muzyki tła do aplikacji i wideo. |
Nowe funkcje MiniMax + Showcase
Połączenie zaawansowanych modeli z platformą Atlas Cloud z akceleracją GPU zapewnia niezrównaną szybkość, skalowalność i kreatywną kontrolę w generowaniu obrazów i wideo.
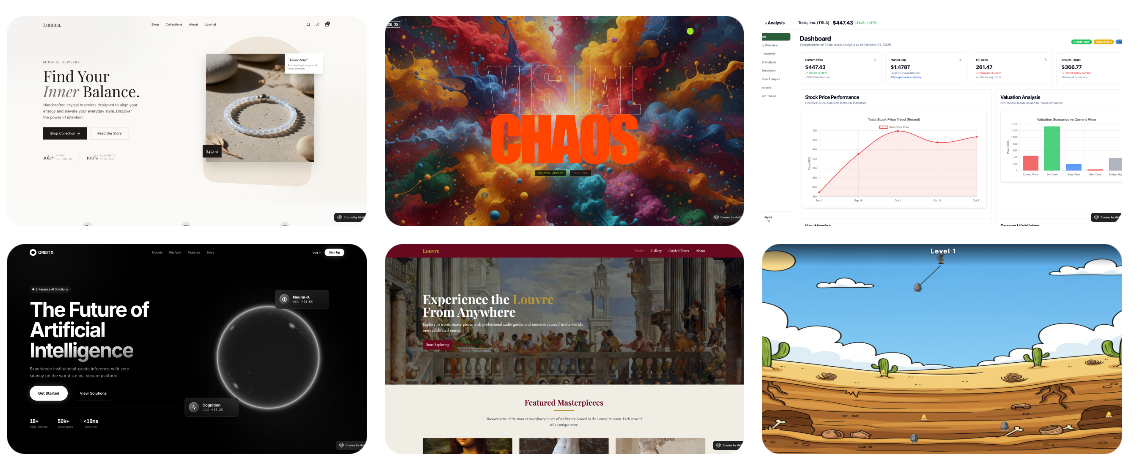
Zaawansowane programowanie i planowanie agentowe z użyciem MiniMax M2.5
MiniMax M2.5 obsługuje ponad 10 języków programowania, w tym Rust, Go i Python, ułatwiając kompleksowe tworzenie rozwiązań full-stack na platformy Web, mobile i desktop. Dzięki integracji głębokiej wiedzy branżowej w zakresie profesjonalnego formatowania dokumentów i modelowania finansowego umożliwia płynne przejście od projektowania architektury systemu do testowania finalnego rezultatu. To kompletne rozwiązanie dla złożonej inżynierii oprogramowania oraz krytycznych przepływów pracy związanych z produktywnością biurową.
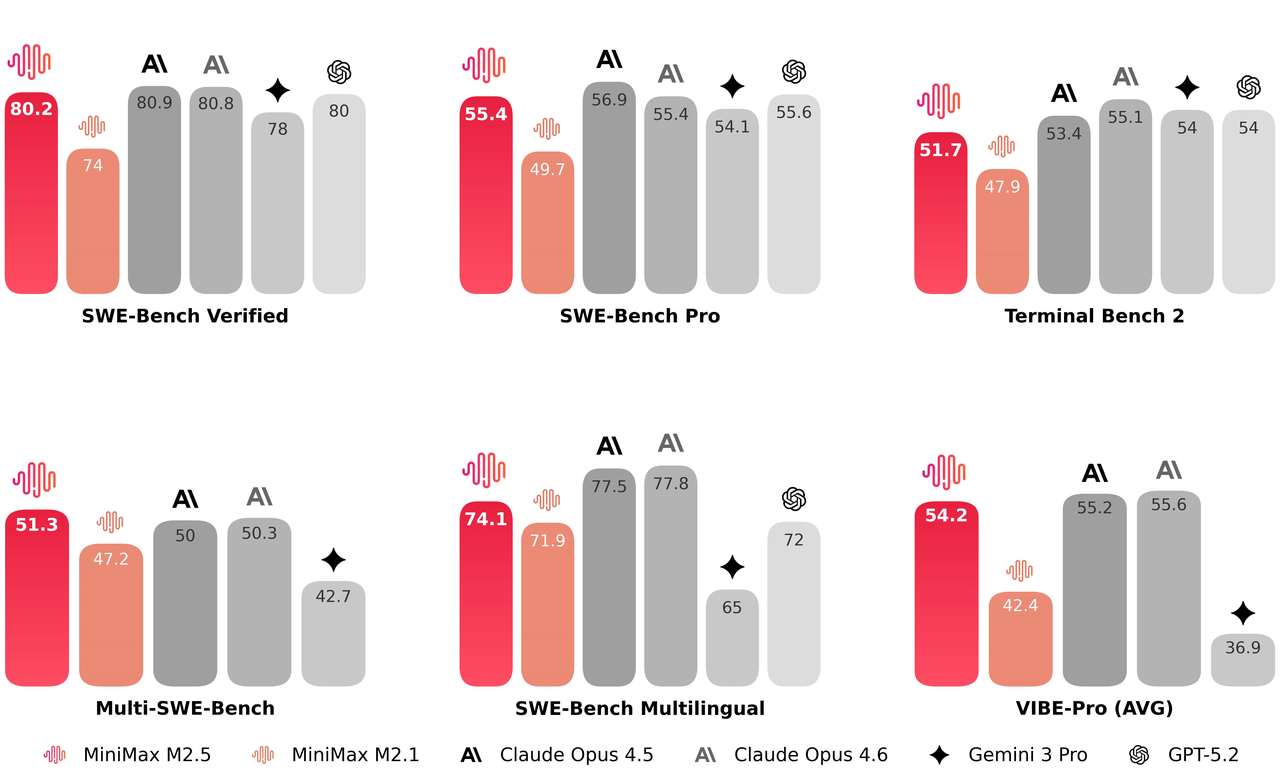
Szybka reakcja i sprawniejsze podejmowanie decyzji w zadaniach z użyciem MiniMax M2.5
Architektura M2.5 osiąga 37% wzrost szybkości wykonania end-to-end, znacząco skracając czas realizacji złożonych zadań z 31.3 do 22.8 minuty w SWE-bench. Dzięki optymalizacji logiki dekompozycji zadań model potrzebuje o 20% mniej tokenów i rund wyszukiwania, aby osiągać cele w benchmarkach takich jak BrowseComp. Oferuje usprawnione rozwiązanie do szybkiego podejmowania decyzji, eliminując jednocześnie zbędny narzut obliczeniowy.
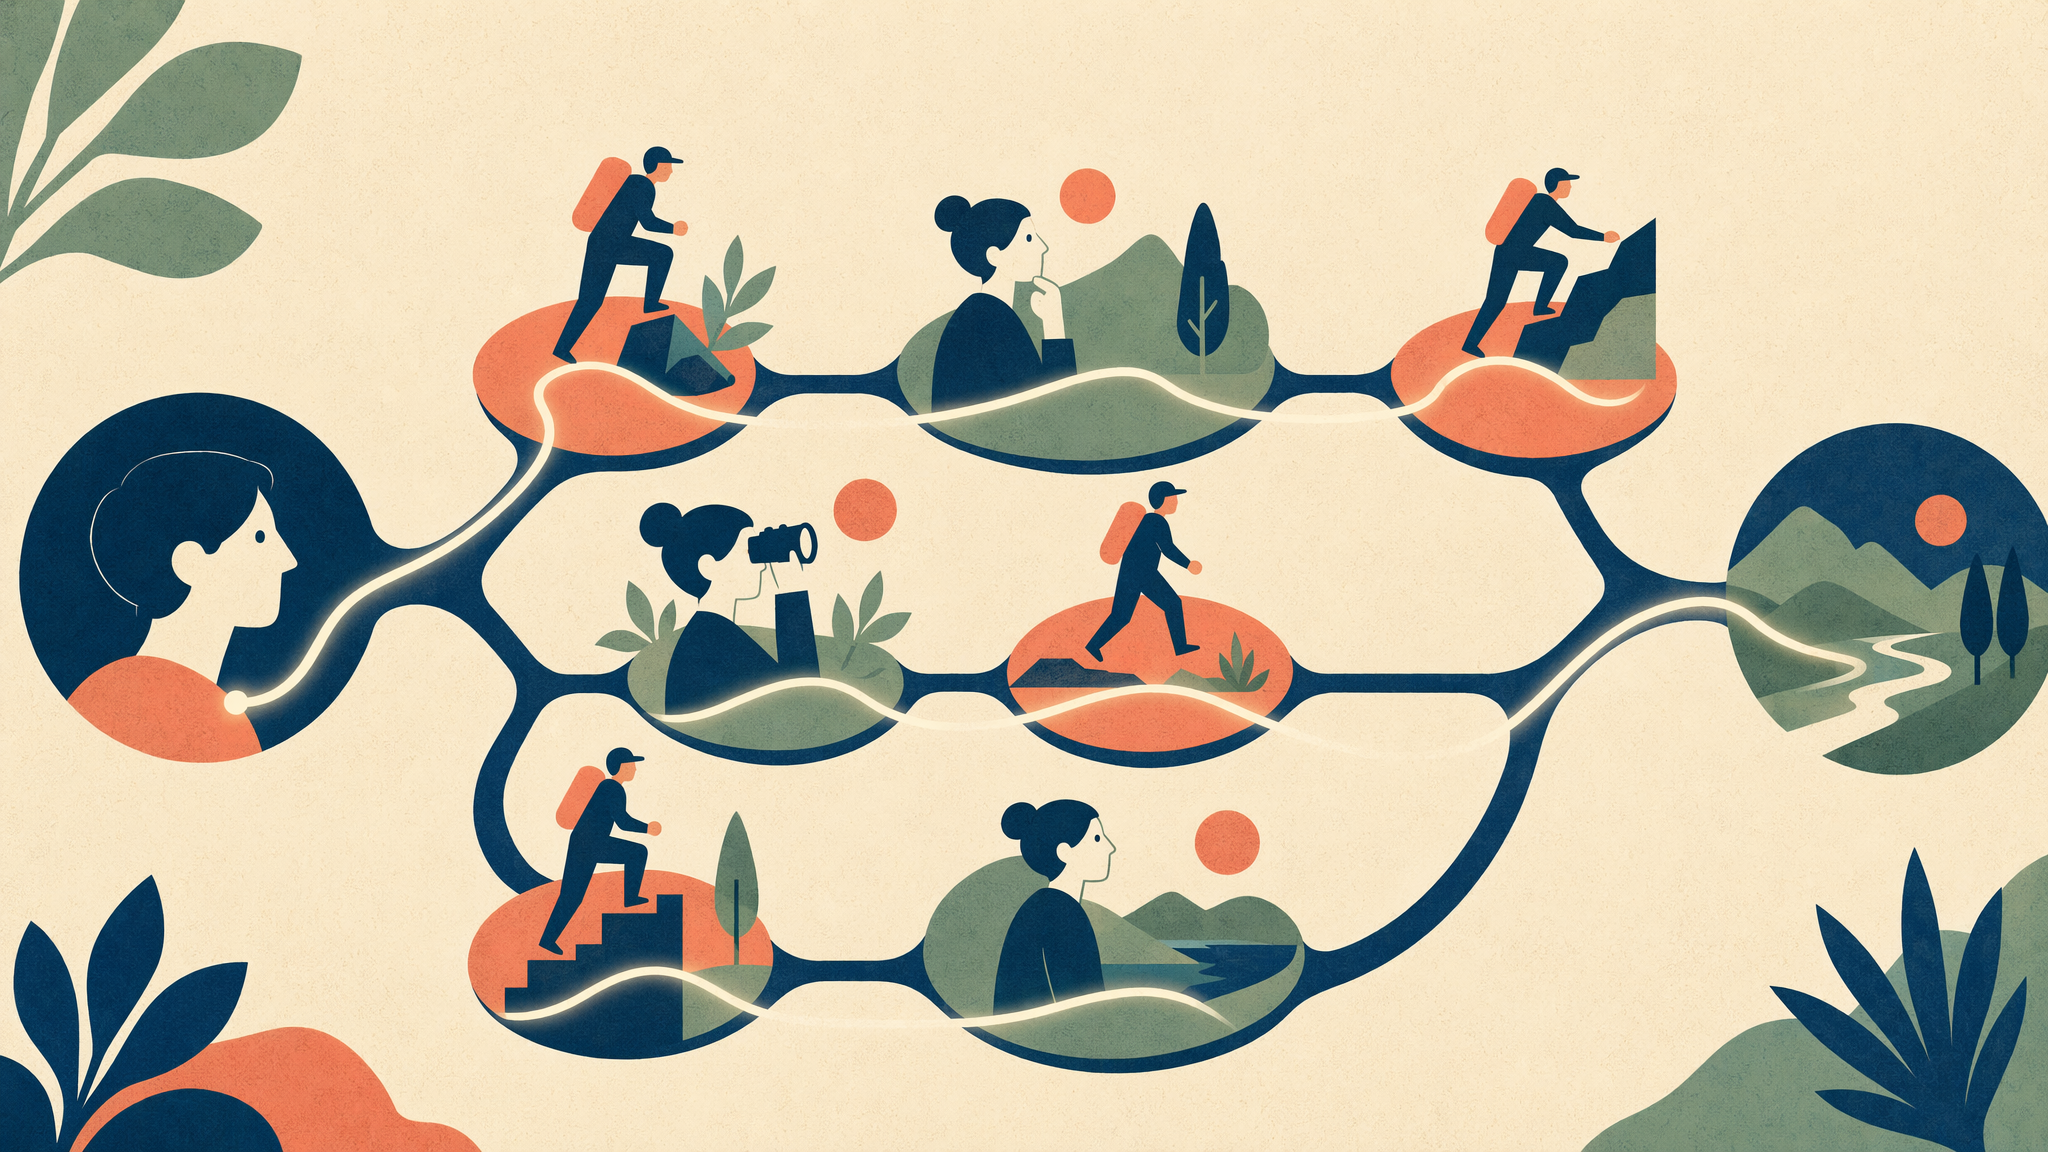
Przeplatane myślenie, które zachowuje tok rozumowania
Tokeny rozumowania są zachowywane między turami, dzięki czemu model wznawia każdy etap wieloturowej konwersacji agentowej z nienaruszonym wcześniejszym procesem myślowym. Takie przeplatane myślenie pozwala mu planować, działać, obserwować i udoskonalać bez porzucania logiki, która doprowadziła go do danego miejsca. Efektem jest stabilniejsze podejmowanie decyzji w długim horyzoncie — kluczowa przewaga, gdy pojedyncze zadanie obejmuje wiele sekwencyjnych wywołań narzędzi.
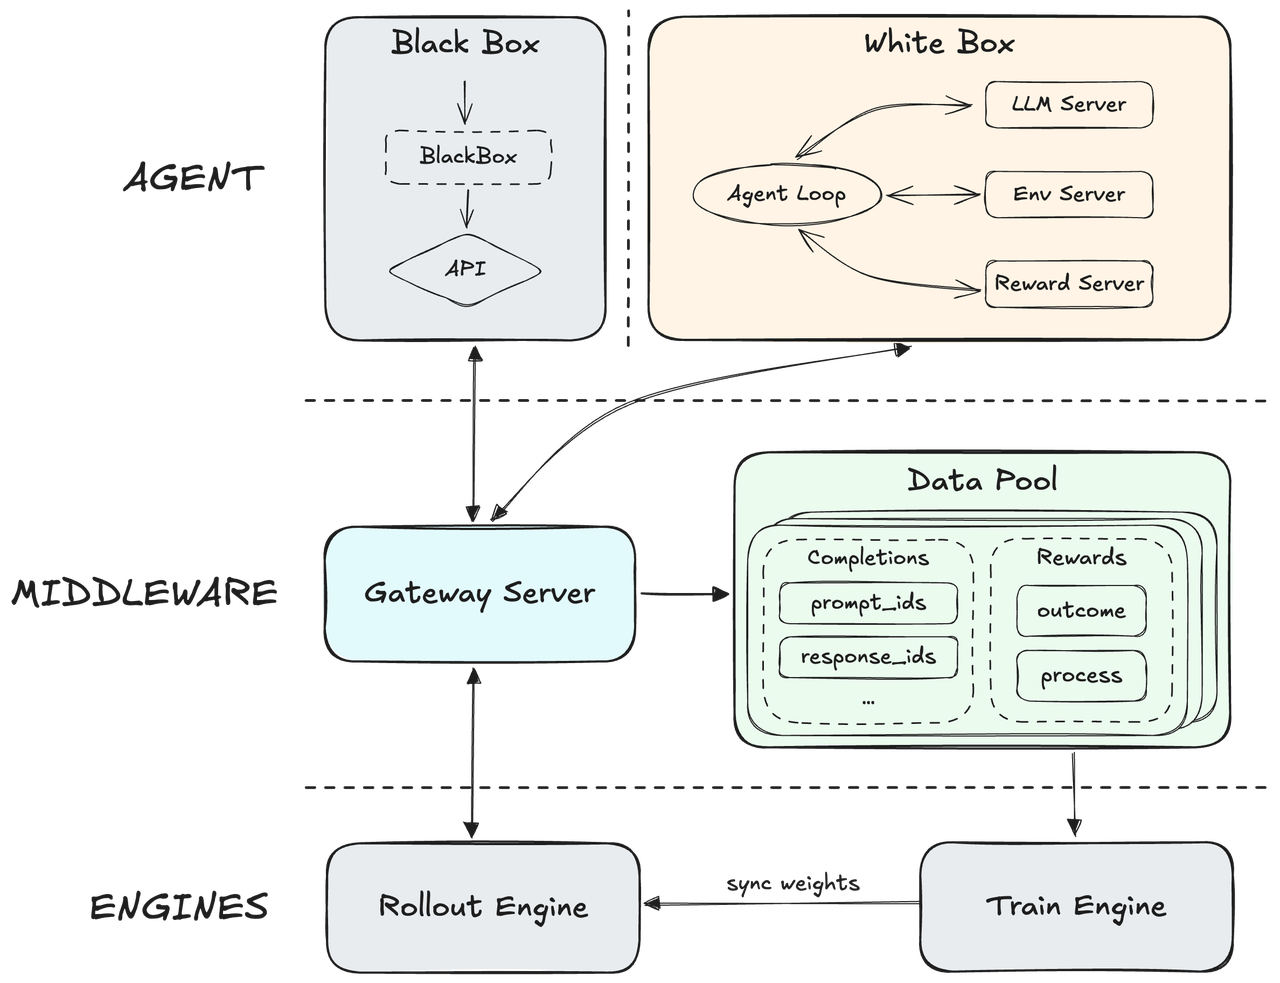
Ewolucyjna architektura dzięki wielkoskalowemu RL z użyciem MiniMax M2.5
MiniMax, zbudowany na natywnym frameworku Agent RL, oddziela swój rdzeniowy silnik od warstwy agentowej, aby uogólniać działanie w setkach tysięcy zróżnicowanych środowisk rzeczywistych. Wykorzystuje zaawansowany mechanizm nagrody procesowej, który korzysta z informacji zwrotnej z wykonywania w czasie rzeczywistym, aby udoskonalać ścieżki rozumowania i zapewniać najwyższą jakość wyników. Tworzy to wysoce adaptacyjny system zdolny do utrzymywania ponadprzeciętnej dokładności przy jednoczesnej maksymalizacji ogólnej szybkości reakcji operacyjnej.
Okno kontekstu 196K tokenów w MiniMax API
Każde żądanie do MiniMax M2.1 ma okno kontekstu o długości 196,608 tokenów — wystarczająco szerokie, aby w jednym przebiegu objąć rozległe monorepo, setki stron specyfikacji lub długie transkrypty agentów. Ponieważ pełny obraz pozostaje dostępny, model śledzi zależności między plikami zamiast tracić wątek w połowie zadania. Zespoły pracujące na dużych bazach kodu i gęstych korpusach badawczych zyskują spójność, której modele z krótkim kontekstem nie są w stanie zapewnić.
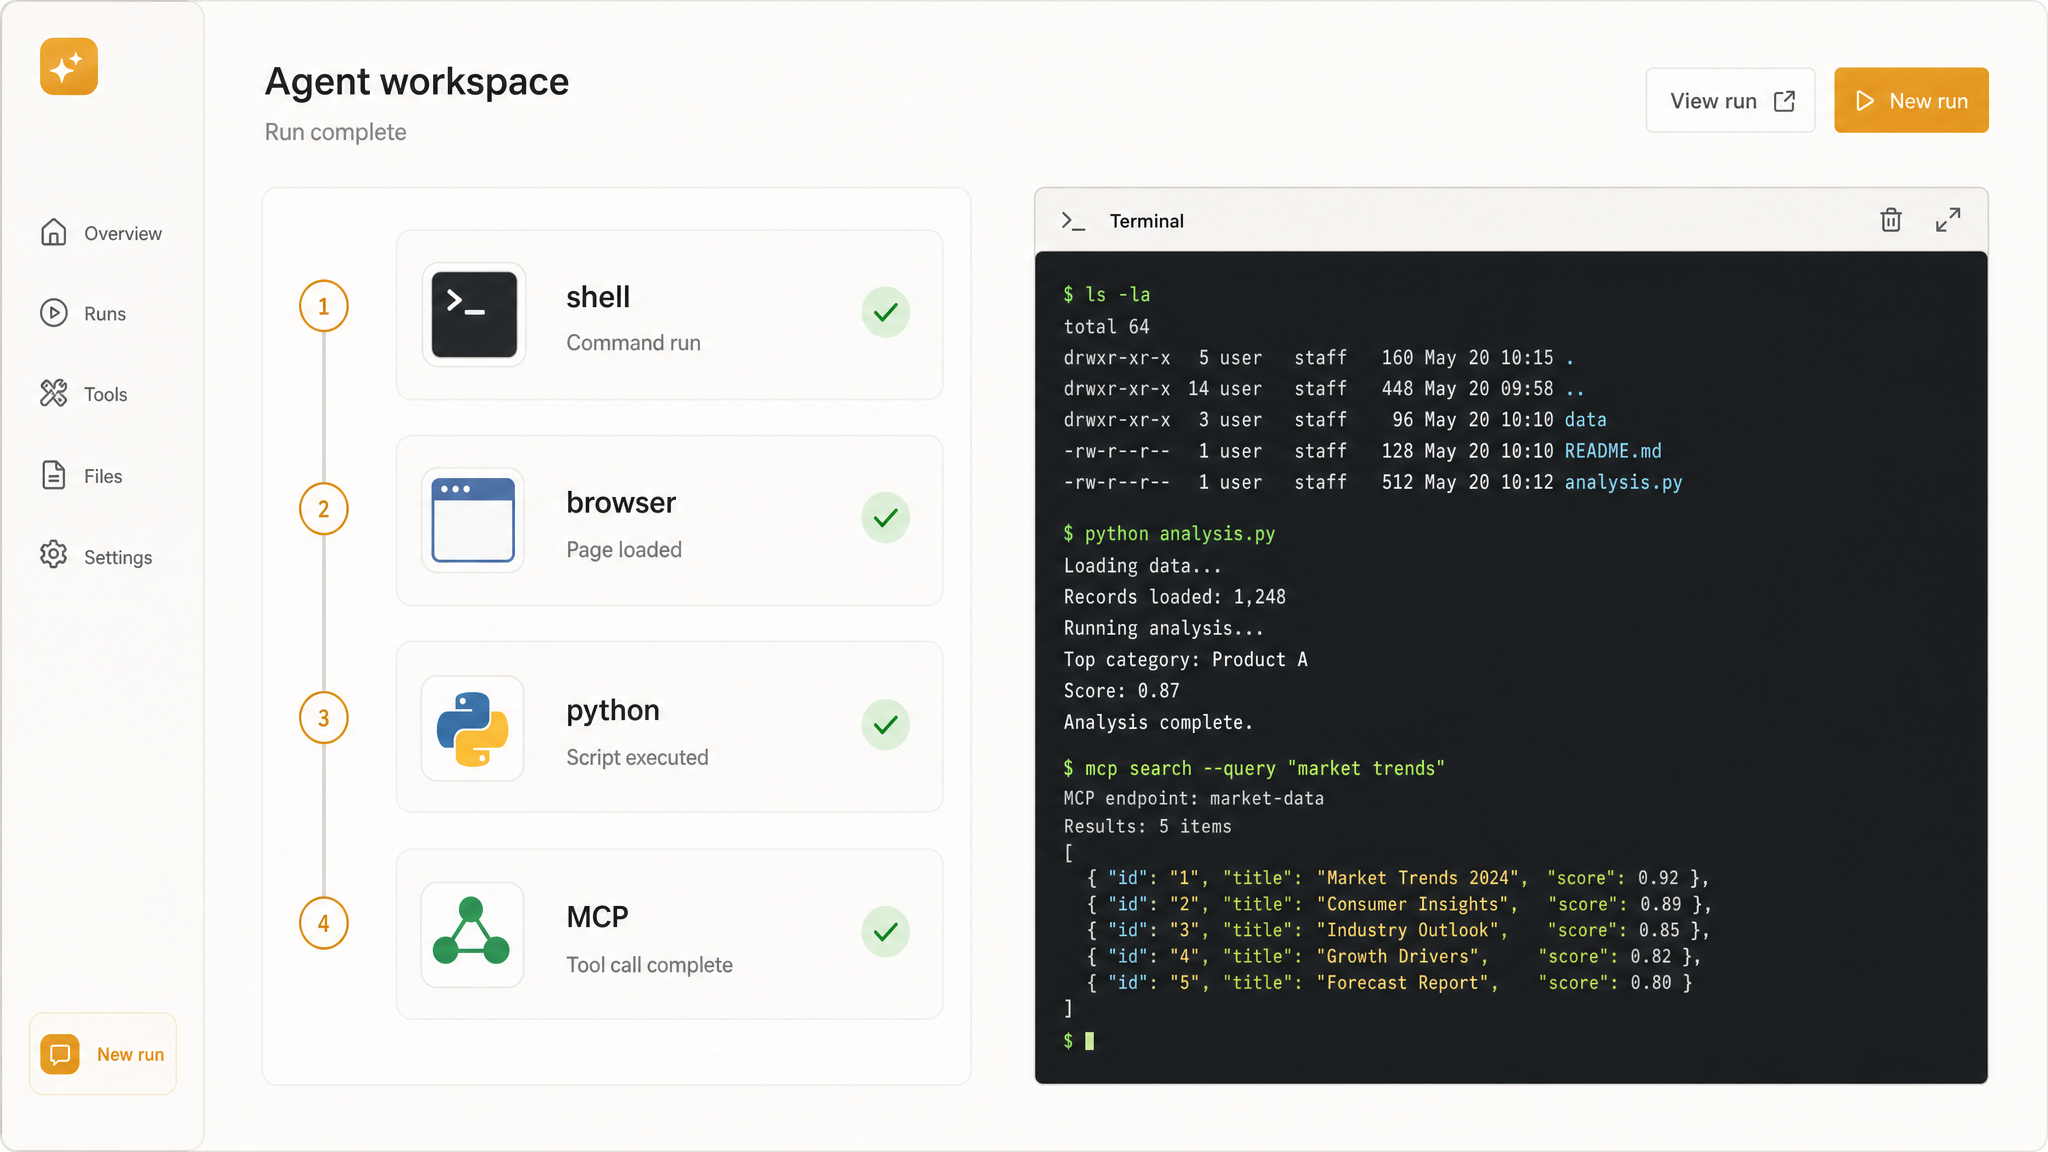
Orkiestruj shell, przeglądarkę i kod za pomocą MiniMax API
Function calling przekształca MiniMax M2.1 w aktywnego agenta, który orkiestruje polecenia shell, sesje przeglądarki, wykonywanie kodu Python oraz narzędzia MCP w ramach planów długohoryzontowych. Łączy dziesiątki kroków, odczytuje informacje zwrotne z wykonania i samodzielnie się koryguje, zamiast zatrzymywać się na pierwszym wyniku. Z wynikiem 47.9 percent w Terminal-bench 2.0 stanowi niezawodną podstawę dla autonomicznych pętli build, test i deployment.
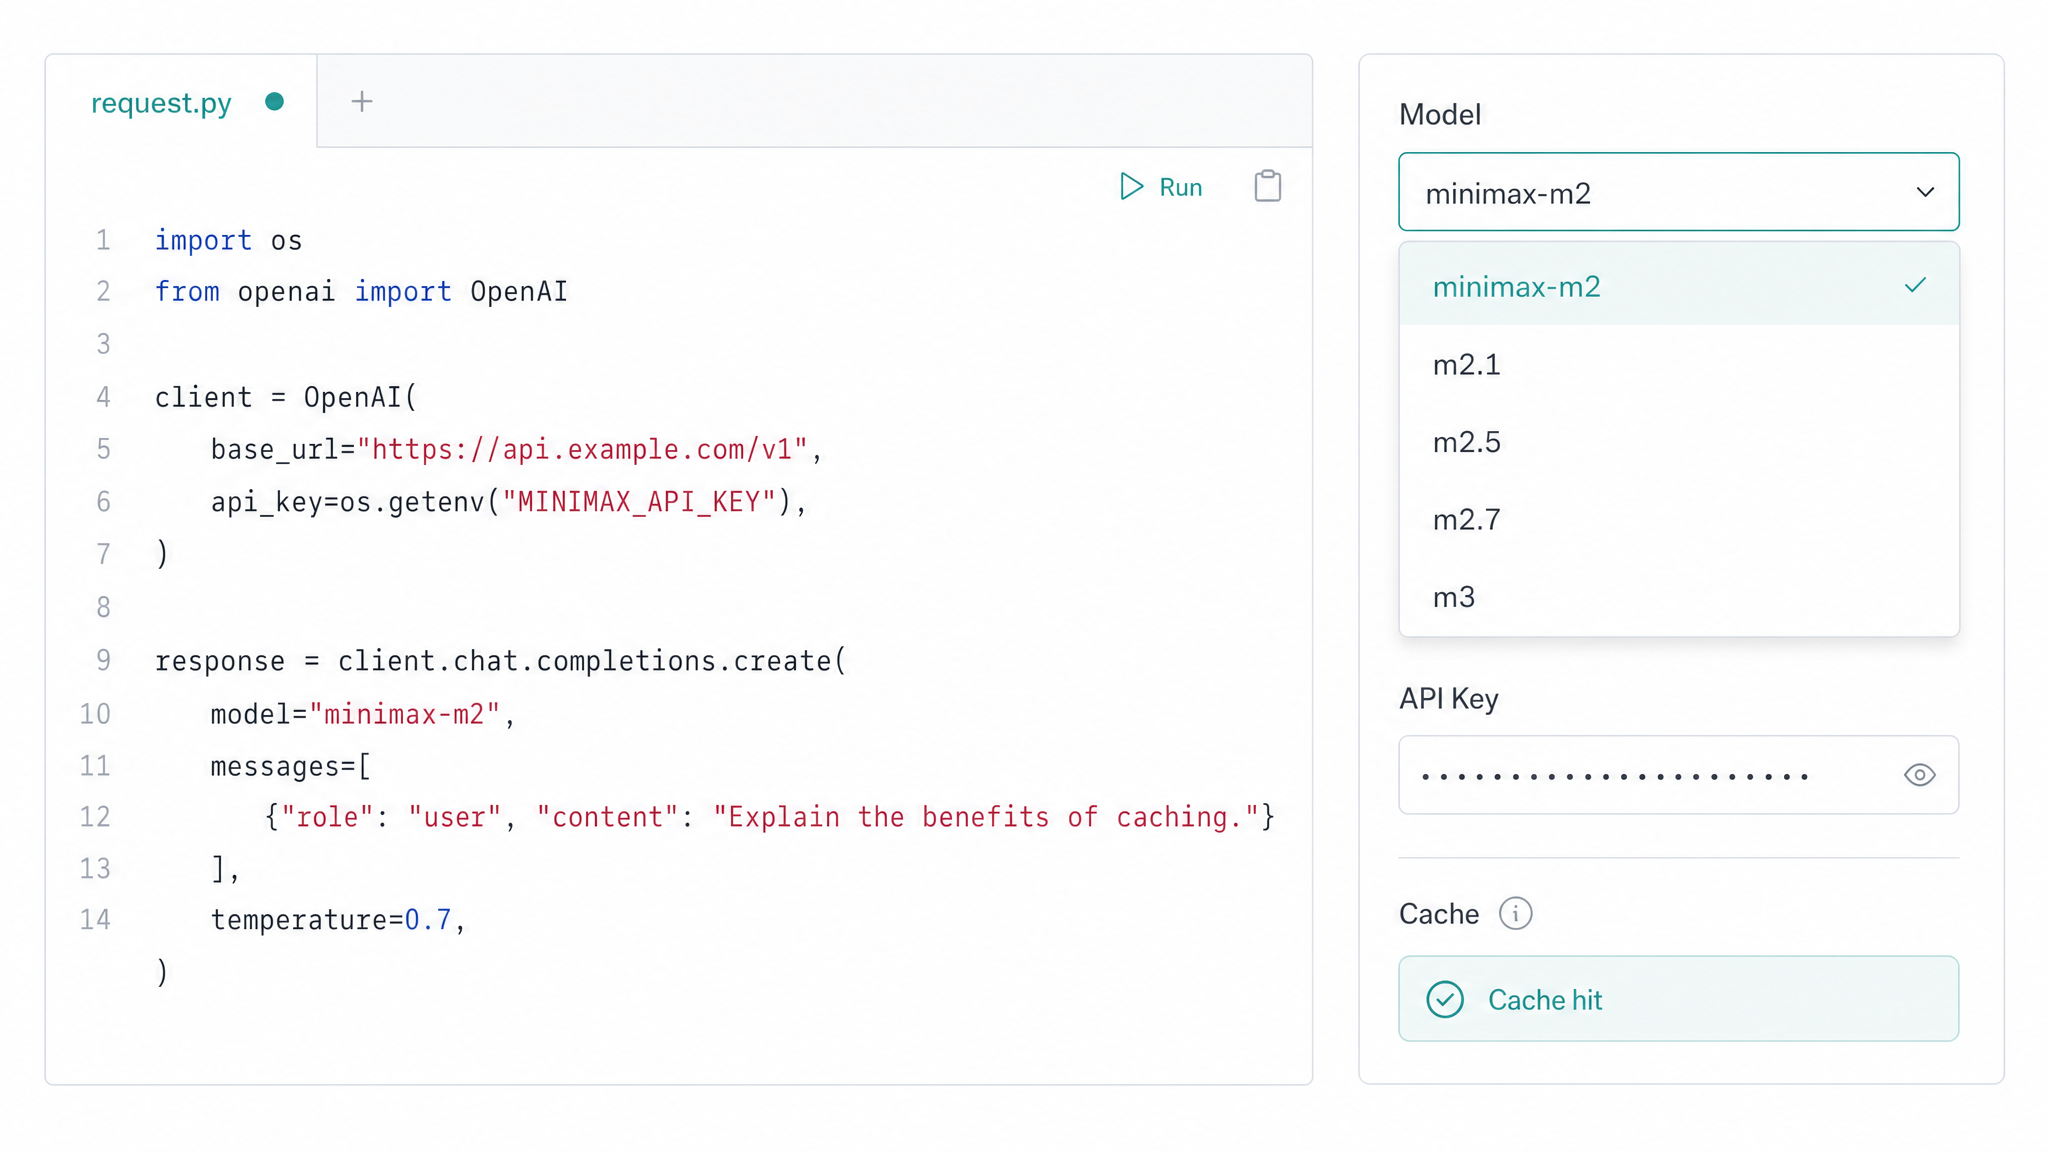
Jeden klucz MiniMax API dla każdego poziomu modelu
Jeden klucz zgodny z OpenAI odblokowuje całą linię MiniMax — od M2 i M2.1 po M2.5, M2.7 i M3 — wraz z dostępem przez Anthropic SDK oraz surowy HTTP. Poziomy można przełączać, edytując pojedynczy ciąg modelu, bez przebudowywania stosu. Prompt caching nalicza powtarzający się kontekst po $0.03 za milion tokenów, dzięki czemu iteracyjne pętle agentowe i długie prompty systemowe pozostają opłacalne w skali.
Jeden prompt, trzy modele: pojedynek kodowania w MiniMax API
Podaj ten sam prompt budowy do MiniMax API i dwóch konkurencyjnych modeli, a potem zobacz, jak każdy z nich zamienia pojedynczą instrukcję w działającą, jednoplikową stronę internetową.
Nieskazitelna, jednoplikowa, samowystarczalna strona HTML (wyłącznie inline CSS i JavaScript — absolutnie bez zewnętrznych bibliotek, CDN-ów, fontów ani adresów URL obrazów; każda faktura zbudowana wyłącznie z gradientów CSS, box-shadow i cieni inset), która renderuje interaktywny, skeuomorficzny WARSZTAT ZECERSKI DO DRUKU TYPOGRAFICZNEGO: wypełnij viewport ciepłą powierzchnią roboczą z drewna orzecha (warstwowe brązowe gradienty + subtelne usłojenie przez repeating linear-gradients i ziarniste cieniowanie przypominające szum), oświetloną pojedynczą ciepłą lampą wolframową z lewego górnego rogu, tak aby elementy ze szczotkowanego metalu łapały miękki refleks, a każdy wypukły obiekt rzucał długi, miękki cień ku prawemu dołowi. Lewa strona: podzielona na przegródki kaszta zecerska (California job case) z komórkami siatki zawierającymi maleńkie, tłoczone ołowiane czcionki (litery, cyfry, znaki interpunkcyjne), z których każda jest fazowanym metalowym słupkiem z wypukłym, lustrzanie odwróconym glifem na powierzchni. Środek: otwarty wierszownik / galley tray, w którym gromadzi się skład. Zapewnij pełny działający przepływ składu: (1) użytkownik pisze na fizycznej klawiaturze ALBO klika glify w kaszcie, a dla każdego znaku ołowiana czcionka animuje lot ze swojej komórki i wpada do wierszownika z wyraźnym mikroodbiciem osiadania typu "clack"; (2) przeciągalne cienkie ołowiane justunki między czcionkami pozwalają regulować odstępy między literami/kerning przez przeciąganie, z podglądem przełamania układu na żywo; (3) obracalny wałek farbiarski (brayer), który użytkownik przeciąga po zamkniętej formie, zostawia błyszczącą, głęboko indygową warstwę farby (animowany, ruchomy refleks) na wypukłych powierzchniach czcionek; (4) dźwignia dociskowa opuszczana w dół, którą użytkownik naciska (kliknięcie i przytrzymanie albo przycisk), obniża arkusz kremowego papieru czerpanego nad nafarbioną formę i odbija ją — kulminacyjny moment to sprężysty powrót dźwigni, podczas gdy świeżo wydrukowany wers pojawia się na papierze z autentycznie wklęsłą typografią letterpress: każda litera wciśnięta w papier dzięki cieniowi inset dającemu fizyczne wgłębienie, farba lekko rozpływa się/strzępi w widocznym ziarnie włókien papieru, a wokół bloku widać subtelną poświatę odcisku płyty. Paleta: dominują palona umbra, złoto szczotkowanego mosiądzu i ciepła kremowa/ryżowopapierowa złamana biel, a głęboki indygo farby jest JEDYNYM chłodnym akcentem. Uwzględnij dotykowe detale: mosiężne śruby radełkowane, zamek klinowy, drewniane przyciski z realistycznymi stanami wciśnięcia/aktywności oraz satysfakcjonujące easing na każdym przejściu (sprężyste cubic-bezier). Zrób to responsywnie (płynne skalowanie do szerokości tabletu), przechowuj cały stan w vanilla JS i pozwól użytkownikowi złożyć krótki wers poezji, nafarbić go oraz wykonać odbitkę, którą może wizualnie podziwiać — wszystko ma sprawiać wrażenie rękodzielniczego, masywnego i ceremonialnego, a fizyka upadku, przeciągania i docisku ma być przekazana ruchem i cieniem, bez żadnych zewnętrznych zasobów.
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
Utwórz pojedynczy, kompletny, samowystarczalny plik HTML, który otwiera się bezpośrednio w każdej nowoczesnej przeglądarce i nie ma żadnych zewnętrznych zależności — cały CSS i JavaScript muszą być inline, a zewnętrzne biblioteki, CDN-y, fonty ani adresy URL obrazów są niedozwolone (rysuj wszystko za pomocą Canvas 2D albo SVG generowanego w kodzie). Zbuduj interaktywny "Warsztat mosiężnej przekładni zębatej": mechaniczny symulator kół zębatych składanych na zatrzask, renderowany na zakurzonym blacie z inżynierskim blueprintem, w którym użytkownik składa działającą przekładnię i obserwuje, jak fizycznie poprawny obrót rozchodzi się przez cały łańcuch. Główne wymagania dotyczące interakcji i symulacji: - Wyrenderuj główną scenę jako powierzchnię kreślarską blueprintu: drobną cyjanową siatkę na głębokim inżynierskim niebieskim papierze z delikatną warstwą kurzu i winietą, a także znaczniki wymiarowe i adnotacje kreślarskie wzdłuż krawędzi. - Zapewnij lewy pojemnik/pasek boczny z częściami, zawierający koła zębate w kilku wyraźnie różnych rozmiarach (różne liczby zębów / moduły, np. 12, 18, 24, 36, 48 zębów). Użytkownik przeciąga koło z pojemnika na scenę; po puszczeniu zatrzaskuje się ono do siatki. - Każde koło musi być narysowane jak prawdziwe koło zębate o zębach ewolwentowych w odcieniach mosiądzu — ciepłozłoty korpus, postarzana obręcz z miedzianą patyną, kościany refleks, widoczna piasta, ramiona i centralny otwór — z subtelnym cieniowaniem faz, aby metal wyglądał jak metal. - Zaimplementuj rzeczywiste wykrywanie zazębienia: gdy dwa umieszczone koła znajdują się w odległości między środkami równej sumie ich promieni podziałowych (module × teeth / 2) w granicach tolerancji, automatycznie zazębiają się i blokują w napędzany łańcuch; narysuj wskaźnik zazębienia w miejscu, gdzie zęby wchodzą w siebie. Łańcuchy mogą rozgałęziać się przez wiele kół. - Umieść korbę z kołem ręcznym w lewym dolnym rogu jako wizualny i mechaniczny punkt początkowy. Użytkownik obraca korbę (przeciąganiem, aby ją obracać, albo przytrzymaniem przycisku); cały zazębiony łańcuch obraca się wtedy sekwencyjnie. Obliczaj prędkość kątową i kierunek każdego kolejnego koła ściśle na podstawie przełożenia (ω_out = ω_in × N_in / N_out, kierunek zmienia się przy każdym zazębieniu) i animuj zęby tak, aby pozostawały idealnie zsynchronizowane fazowo w punkcie styku, bez widocznego nakładania się ani przenikania. - Ostatnie koło w łańcuchu napędza wskazówkę na numerowanym zegarze pomiarowym; wskazówka musi pokazywać rzeczywisty odczyt wyprowadzony ze skumulowanego przełożenia (wyświetlaj obliczone output RPM i total ratio jako tekst na żywo). - Jeśli użytkownik spróbuje umieścić koła, których geometria zębów nie może się zazębić (niezgodny rozstaw/moduł), to połączenie musi się zablokować: mignąć na czerwono, zatrzymać propagację za wadliwym złączem i pokazać małe ostrzeżenie "tooth mismatch". - Dodaj snop światła: wiązkę ciepłego porannego słońca padającą skośnie z górnego okna przez scenę, z drobinami kurzu dryfującymi w świetle i ciepłymi, lustrzanymi błyskami przesuwającymi się po zębach podczas obrotu, aby maszyna wyglądała, jakby budziła się do życia. Dopracowanie wizualne i UX: - Kierunek artystyczny: retro inżynierska, ręcznie rysowana kreska połączona z fotorealistycznym metalem — drobna siatka blueprintu pod mosiądzem, postarzanym brązem, zielononiebieską patyną i kościową bielą; ciepłe oświetlenie boczne z długimi, miękkimi cieniami rzutowanymi, które rzeźbią objętość i głębię. - Kompozycja powinna czytelnie wskazywać korbę jako punkt wejścia, a łańcuch napędowy ma przecinać kadr po przekątnej. - Dodaj przejrzysty HUD pokazujący prędkość korby, całkowite przełożenie, output RPM i liczbę kół, a także małe kontrolki do odwracania kierunku korby, czyszczenia sceny i regulowania prędkości korby suwakiem. - Wszystko musi działać płynnie (requestAnimationFrame), reagować na rozmiar okna i pozostawać interaktywne — przeciąganie, przyciąganie do siatki, zazębianie i aktualizacja odczytów powinny reagować w czasie rzeczywistym. Całość ma sprawiać wrażenie dotykowej, precyzyjnej i żywej.
Generated with MiniMax M3 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with MiniMax M2.7 on Atlas Cloud
Twórz oprogramowanie produkcyjne za pomocą MiniMax API
Od wielojęzycznych kompilacji full-stack po autonomicznych agentów biurowych, API MiniMax przekształca głębię kodowania i długoterminowe wykorzystanie narzędzi modelu M2.1 w przepływy pracy, które Twój zespół wdraża każdego dnia.

Full-stack development w wielu językach
MiniMax M2.1 pisze i recenzuje kod produkcyjny w Rust, Go, TypeScript, C++ i nie tylko — od niskopoziomowych systemów po warstwy aplikacyjne. Zespoły budujące usługi poliglotyczne polegają na nim, aby zachować spójność na każdym poziomie.

Natywne aplikacje mobilne przez MiniMax API
Gdy funkcje na Androida i iOS muszą zostać dostarczone równocześnie, MiniMax API generuje Kotlin, Swift i Objective-C zgodne z konwencjami platform. Dzięki temu małe zespoły mogą utrzymywać obie platformy sklepowe bez dzielenia wysiłku inżynieryjnego.

Autonomiczni agenci programistyczni w MiniMax API
Włącz M2.1 do pętli agenta przez function calling, aby planować wieloetapowe zadania, uruchamiać narzędzia i samodzielnie korygować błędy w długim horyzoncie. Deweloperzy wykorzystują to do tworzenia asystentów, którzy domykają prawdziwe zgłoszenia, a nie tylko fragmenty kodu.

Cyfrowi pracownicy do biurowych przepływów pracy
Działając jako cyfrowy pracownik, M2.1 wykonuje zadania end-to-end w administracji, finansach, data science i HR na podstawie poleceń w zwykłym tekście. Zespoły operacyjne wdrażają go, aby na dużą skalę eliminować powtarzalną pracę back-office.

Rozumowanie na poziomie całej bazy kodu przy kontekście 196K
Trzeba przeprowadzić refaktoryzację w nieznanym repozytorium? Dzięki oknu kontekstu 196.61K tokenów M2.1 czyta setki plików naraz, śledzi zależności i wskazuje zmiany, których migracja faktycznie wymaga.

Interaktywne interfejsy webowe z MiniMax API
Silne rozumienie designu pozwala MiniMax API tworzyć dopracowane frontendowe interfejsy webowe, złożone interakcje, a nawet symulacje naukowych scen 3D. Zespoły produktowe dostarczają bogate w dane dashboardy i wizualizacje prosto z promptu.
Jak API MiniMax wypada na tle innych LLM-ów do kodowania i agentów
Zestaw MiniMax API z konkurencyjnymi modelami opartymi na agentach i służącymi do programowania w Atlas Cloud, dokonując szczegółowego porównania okna kontekstowego, limitu wyjściowego oraz cen tokenów w modelu pay-as-you-go.
| Model | Context Window | Max Output | Input Price ($/1M) | Output Price ($/1M) |
|---|---|---|---|---|
| MiniMax M3 | 524K tokens | 512K tokens | $0.60 / $1.20 (>512K) | $2.40 / $4.80 (>512K) |
| MiniMax M2.7 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| MiniMax M2.5 | 196K tokens | 196K tokens | $0.30 | $1.20 |
| Kimi K2.7 Code | 262K tokens | 262K tokens | $0.95 | $4.00 |
| GLM 4.7 | 203K tokens | 203K tokens | $0.60 | $2.20 |
| DeepSeek V4 Flash | 1M tokens | 393K tokens | $0.14 | $0.28 |
Jak używać MiniMax na Atlas Cloud
Zacznij w kilka minut — wykonaj te proste kroki, aby zintegrować i wdrożyć modele za pośrednictwem platformy Atlas Cloud.
Utwórz konto Atlas Cloud
Zarejestruj się na atlascloud.ai i ukończ weryfikację. Nowi użytkownicy otrzymują bezpłatne kredyty do eksploracji platformy i testowania modeli.
Dlaczego Używać MiniMax na Atlas Cloud
Połączenie zaawansowanych modeli MiniMax z platformą GPU-akcelerowaną Atlas Cloud zapewnia niezrównaną wydajność, skalowalność i doświadczenie deweloperskie.
Wydajność i Elastyczność
Niska Latencja:
Inferencja zoptymalizowana pod GPU dla rozumowania w czasie rzeczywistym.
Zunifikowane API:
Uruchamiaj MiniMax, GPT, Gemini i DeepSeek za pomocą jednej integracji.
Przejrzysta Wycena:
Przewidywalne rozliczenia za token z opcjami serverless.
Przedsiębiorstwo i Skala
Doświadczenie Dewelopera:
SDK, analityka, narzędzia dostrajania i szablony.
Niezawodność:
99,99% dostępności, RBAC i logowanie gotowe na zgodność.
Bezpieczeństwo i Zgodność:
SOC 2 Type II, zgodność z HIPAA, suwerenność danych w USA.
Pytania i odpowiedzi dotyczące MiniMax API
MiniMax API daje programistom programistyczny dostęp do rodziny dużych modeli językowych MiniMax tworzonych przez MiniMax AI — serii zaprojektowanej z myślą o kodowaniu, agentowym użyciu narzędzi i rozumowaniu w długim horyzoncie. W Atlas Cloud korzystasz z tych modeli przez jeden endpoint zgodny z OpenAI, z przejrzystymi cenami pay-as-you-go i dostępem do nowych wydań od Day-0.
Atlas Cloud udostępnia modele tekstowe z serii M, w tym MiniMax M2.5, MiniMax M2.7 oraz flagowy MiniMax M3, a także MiniMax Music 2.6 do generowania muzyki z tekstu. Wszystkie modele korzystają z tego samego uwierzytelniania i endpointu, więc przełączenie między nimi wymaga zmiany tylko jednego identyfikatora modelu w żądaniu.
Te modele są zoptymalizowane pod kątem kompleksowej inżynierii oprogramowania: obsługują edycję wielu plików, pętle compile-run-fix oraz naprawy weryfikowane testami w wielu językach programowania. Dobrze radzą sobie też w scenariuszach agentowych wymagających function calling, planowania wieloetapowego i odzyskiwania po błędach wykonania, dzięki czemu naturalnie pasują do autonomicznych agentów kodujących i workflow opartych na narzędziach.
Ponieważ MiniMax API jest zgodne z OpenAI, możesz skierować standardowe OpenAI SDK na bazowy URL Atlas Cloud, przekazać swój klucz i ustawić pole model na wybraną wersję. Streaming, function calling i wyjście w strukturze JSON działają przez ten sam interfejs, więc większość istniejących integracji wymaga na start jedynie zmiany bazowego URL i klucza.
Okna kontekstu różnią się w zależności od wersji. MiniMax M2 obsługuje około 200K tokenów, co wystarcza, aby wczytać dużą bazę kodu lub obszerną dokumentację w jednym żądaniu, natomiast nowszy M3 rozszerza ten limit do około 1 miliona tokenów. Wybierz model z większym kontekstem, gdy zadanie obejmuje wiele plików albo długie materiały referencyjne.
Rozliczenie działa w modelu pay-as-you-go i jest mierzone za token, bez wymaganej subskrypcji. Modele tekstowe z serii M2 zaczynają się od $0.30 za milion tokenów wejściowych i $1.20 za milion tokenów wyjściowych, natomiast M3 o większej pojemności kosztuje $0.60 za milion tokenów wejściowych i $2.40 za milion tokenów wyjściowych, a wejście z cache jest rozliczane po niższej stawce.
Tak. MiniMax udostępnił wagi serii M jako open source na zmodyfikowanej licencji MIT, która dodaje wymóg atrybucji dla bardzo dużych wdrożeń komercyjnych. Możesz samodzielnie hostować wagi do ewaluacji, a następnie przejść na Atlas Cloud API, gdy potrzebujesz zarządzanej infrastruktury, stabilnej dostępności i braku utrzymania GPU.
MiniMax celuje w jakość kodowania i zadań agentowych na poziomie frontier za ułamek kosztu większych modeli własnościowych, wykorzystując architekturę mixture-of-experts, która aktywuje tylko około 10 miliardów z 230 miliardów parametrów na token. Jeśli Twoje obciążenie obejmuje generowanie kodu, refaktoryzację albo agentów używających narzędzi przy napiętym budżecie, zapewnia mocny kompromis między możliwościami, szybkością i ceną. Pozycja w benchmarkach zmienia się z każdym wydaniem, więc przed podjęciem decyzji zweryfikuj aktualną wersję na własnych zadaniach.
Poznaj Więcej Rodzin
Seedance 2.5
API Seedance 2.5 jest już dostępne w Atlas Cloud! Zapewnia deweloperom najnowszy model wideo od ByteDance. Generuje do 30 sekund natywnego wideo w jednym przebiegu z tekstu, pojedynczego obrazu lub nawet 50 wielomodalnych odniesień, z zsynchronizowanym dźwiękiem i wielojęzycznym tekstem w kadrze. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza, a spójność obiektu i ulepszona fizyka zachowują spójność długich ujęć.

Wan 3.0
API Wan 3.0 to kolejna generacja rodziny wideo Wan firmy Alibaba, stworzona po to, by wznieść generowanie długich form, kontrolę wielu referencji i jakość audiowizualną na nowe wyżyny. Atlas Cloud hostuje już Wan 2.7, 2.6 i 2.5, a Wan 3.0 działa na tym samym ujednoliconym kluczu bez konieczności oddzielnej konfiguracji. Rozpocznij budowanie już dziś. Przewiń w dół do sekcji prezentacji, aby zobaczyć, co potrafi stworzyć Wan 3.0.
MiniMax H3
MiniMax H3 to rodzina modeli wideo firmy MiniMax do generowania na podstawie tekstu, obrazu i materiałów referencyjnych. Twórz klipy o długości od 5 do 15 sekund, steruj ruchem za pomocą opcjonalnej klatki końcowej, zachowuj obiekty z obrazów referencyjnych lub wybierz H3 Developer, gdy generowany dźwięk pasuje do Twojego przepływu pracy. Atlas Cloud udostępnia H3, H3 Fast, H3 Max i H3 Developer w ramach jednego przepływu pracy API, a standardowe ceny zaczynają się od $0.038 za sekundę. Zacznij tworzyć już dziś.
Seedream 5.0 Pro
Seedream 5.0 Pro API udostępnia programistom sterowalny model edycji obrazów firmy ByteDance w Atlas Cloud. Precyzyjnie rozmieszcza edycje za pomocą kotwic i współrzędnych, dzieli obrazy na edytowalne warstwy, łączy wiele odniesień oraz dopasowuje dokładne kolory i materiały, z wielojęzycznym tekstem w rozdzielczościach 2K i 3K. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza!
Seedance 2.0
API Seedance 2.0 zapewnia produkcyjny dostęp do multimodalnego modelu wideo ByteDance — czteromodalne dane wejściowe (tekst, obraz, wideo, dźwięk) oraz wiodący w branży system „Universal Reference”, który blokuje kompozycję, ruchy kamery i działania postaci w różnych ujęciach. Zintegruj kontrolę na poziomie reżysera za pomocą jednego wywołania API, stałej stawki 0,09 USD/s, natychmiastowego klucza i braku listy oczekujących — wszystko to przy wsparciu czasu sprawności i zgodności klasy korporacyjnej. Seedance 2.0 Native 4K jest już dostępne!
GPT Image 2
API GPT Image 2 daje programistom dostęp do najnowszego modelu obrazów firmy OpenAI, następcy GPT Image 1.5. Generuje i edytuje on obrazy z dokładnym renderowaniem tekstu w skryptach łacińskich i CJK, a także zapewnia silną kompozycję dla plakatów, makiet i infografik. W Atlas Cloud można uzyskać do niego dostęp za pośrednictwem jednego zunifikowanego API wraz z ponad 300 modelami, z darmowymi kredytami, gwarantowanym czasem pracy (uptime) na poziomie 99,99% i bez wymogu weryfikacji organizacji OpenAI.
Gemini Omni Flash
gemini omni API udostępnia deweloperom natywnie multimodalną rodzinę Gemini Omni Flash firmy Google DeepMind, w tym Gemini Omni 1.1 Flash. Twórz filmowe materiały wideo ze zsynchronizowanym natywnym dźwiękiem, ożywiaj nieruchome obrazy z precyzyjną kontrolą klatki początkowej i końcowej lub edytuj istniejące nagrania za pomocą zmian sterowanych tekstem, które zachowują niezmienioną treść. Atlas Cloud zapewnia jeden klucz zgodny z OpenAI, ujednolicony dostęp i przejrzyste rozliczenia w modelu pay-as-you-go. Zacznij tworzyć już dziś.
Grok Imagine
Grok Imagine API obejmuje modele obrazu, wideo i mowy xAI, od Image 2.0 do Video 1.5 i xAI TTS v1. Renderuj statyczne obrazy w rozdzielczości 1K lub 2K w 14 proporcjach, przesuń scenę do 15 sekund ruchu w 1080p, steruj zdjęciami za pomocą do 7 obrazów referencyjnych lub narruj je w 20 językach. Atlas Cloud uruchamia każdy tryb na jednym endpoincie, wyceniony na zasadzie płatności za użycie od $0.02 za obraz i $0.05 za sekundę. Zacznij budować dzisiaj.
Najpotężniejsze modele kreatywne Google są w pełni dostępne na platformie Atlas Cloud. Veo 3.1 zapewnia kinową generację wideo, Nano Banana 2 umożliwia tworzenie obrazów o wysokiej wierności, a Gemini wprowadza wielomodalną inteligencję do każdego przepływu pracy. Uzyskaj dostęp do pełnego pakietu modeli Google za pomocą jednego klucza API key z dostępnością Day-0 i cennikiem pay-as-you-go.
Seedance 2.0 Mini
Seedance 2.0 Mini wprowadza multimodalne generowanie wideo firmy ByteDance do przepływów pracy, w których szybkość i koszty mają największe znaczenie. Zapewnia podstawowe możliwości Seedance 2.0 przy mniejszym zużyciu zasobów — szybsze generowanie, niższy koszt na wideo i tę samą integrację API, z której już korzystasz. Dla zespołów obsługujących potoki o dużej objętości lub tworzących prototypy na dużą skalę, Mini jest praktycznym wyborem domyślnym.
ByteDance
Od generowania kinowych filmów po tworzenie obrazów o wysokiej wierności, najpotężniejsze modele ByteDance są dostępne w Atlas Cloud. Uruchamiaj Seedance i Seedream na dużą skalę z najniższymi cenami wnioskowania i zerowymi kosztami ogólnymi infrastruktury.
Alibaba
Atlas Cloud łączy pełną gamę modeli Alibaba w ramach jednego API: Qwen do zadań związanych z językiem i obrazem oraz Wan do generowania wideo w rozdzielczości do 1080p. Uzyskaj dostęp do każdego modelu w modelu płatności zgodnie z rzeczywistym użyciem (pay-as-you-go) bez subskrypcji. Alibaba API jest dostępne poprzez pojedynczy bazowy adres URL (base URL) przy użyciu istniejącego klienta kompatybilnego z OpenAI.
Polecane artykuły
Poradniki, samouczki i nowości produktowe, dzięki którym w pełni wykorzystasz Atlas Cloud.


