
 Atlas Cloud jest teraz autoryzowanym resellerem Dreamina Seedance 2.5 i Seedream 5.0 Pro w USA.Atlas Cloud jest teraz autoryzowanym resellerem Dreamina Seedance 2.5 i Seedream 5.0 Pro w USA.
GPT Image 1 stanowi fundament rodziny modeli obrazowych OpenAI dla deweloperów tworzących produkcyjne narzędzia wizualne. Renderuje czytelny tekst, dokładnie realizuje szczegółowe polecenia, tworzy fotorealistyczne sceny i dostosowuje się do różnorodnych stylów wizualnych, wykorzystując wiedzę o świecie. Atlas Cloud obsługuje obciążenia produkcyjne bez zimnych startów, oferuje przejrzyste rozliczenie pay-as-you-go, dostępność na poziomie 99,99% oraz dostęp do ponad 300 modeli. Zacznij tworzyć już dziś.
GPT Image został opracowany przez OpenAI. Atlas Cloud (prowadzona przez Atlas Cloud AI LLC) zapewnia dostęp do modelu, ale nie jest jego właścicielem. Wszystkie znaki towarowe należą do ich odpowiednich właścicieli.
Atlas Cloud zapewnia najnowsze, wiodące w branży modele kreatywne.
Najniższy koszt
| Modality | Description |
|---|---|
| GPT Image 1 T2I API (Text to Image) | Turn text prompts into generated images with the GPT Image 1 text to image endpoint. Built for visual asset creation, its ready to use REST inference API offers no cold starts at a standard price of $0.011 per image. |
| GPT Image 1 Edit API (Image to Image) | Refine or transform supplied images through the GPT Image 1 editing endpoint. Its REST inference API supports image creation and revision workflows with no cold starts and standard pricing of $0.011 per image. |
GPT Image 1 łączy precyzyjne renderowanie tekstu, szczegółową kontrolę promptów, różnorodne style wizualne, edycję z użyciem obrazów referencyjnych i masek, trzy poziomy jakości, trzy rozmiary wyjściowe, generowanie wsadowe oraz gotowe do zastosowań produkcyjnych opcje dostarczania za pośrednictwem Atlas Cloud.
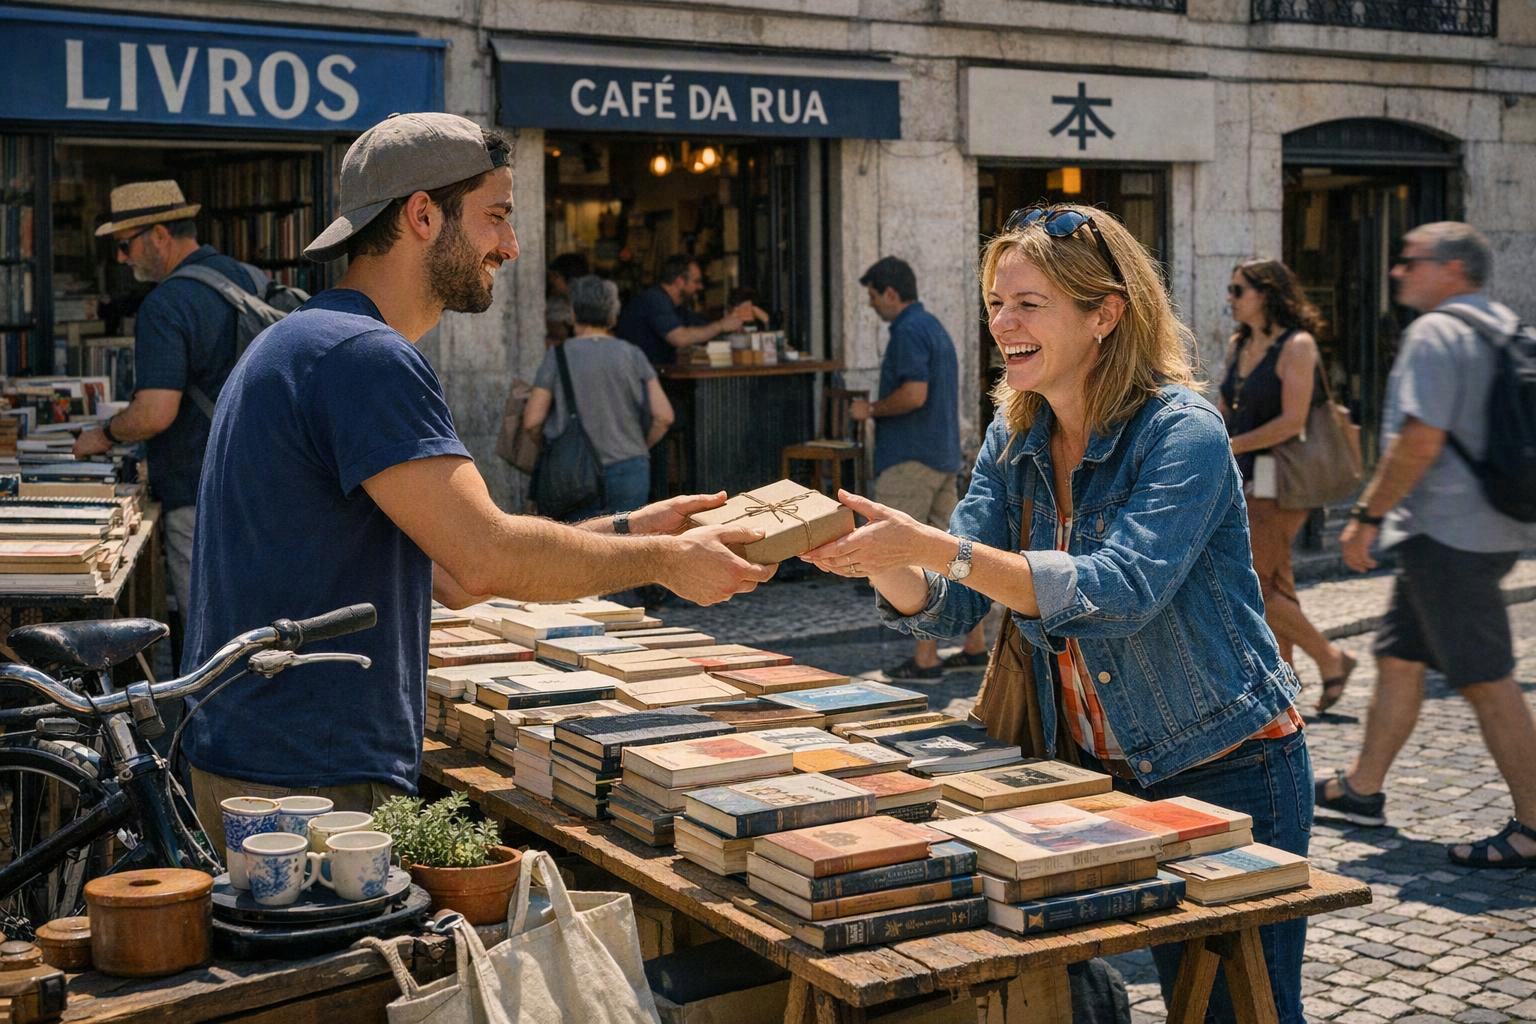
GPT Image 1 stosuje się do szczegółowych promptów, renderuje czytelny tekst i potrafi uporządkować około 10–20 odrębnych obiektów w złożonych scenach. Używaj precyzyjnych sformułowań dotyczących szyldów, etykiet produktów, infografik lub makiet interfejsów, jednocześnie określając kompozycję i relacje wizualne. Połączenie rozumienia języka i obrazu pomaga deweloperom tworzyć zasoby, które w produkcyjnych procesach pracy lepiej odpowiadają wymagającym założeniom kreatywnym.
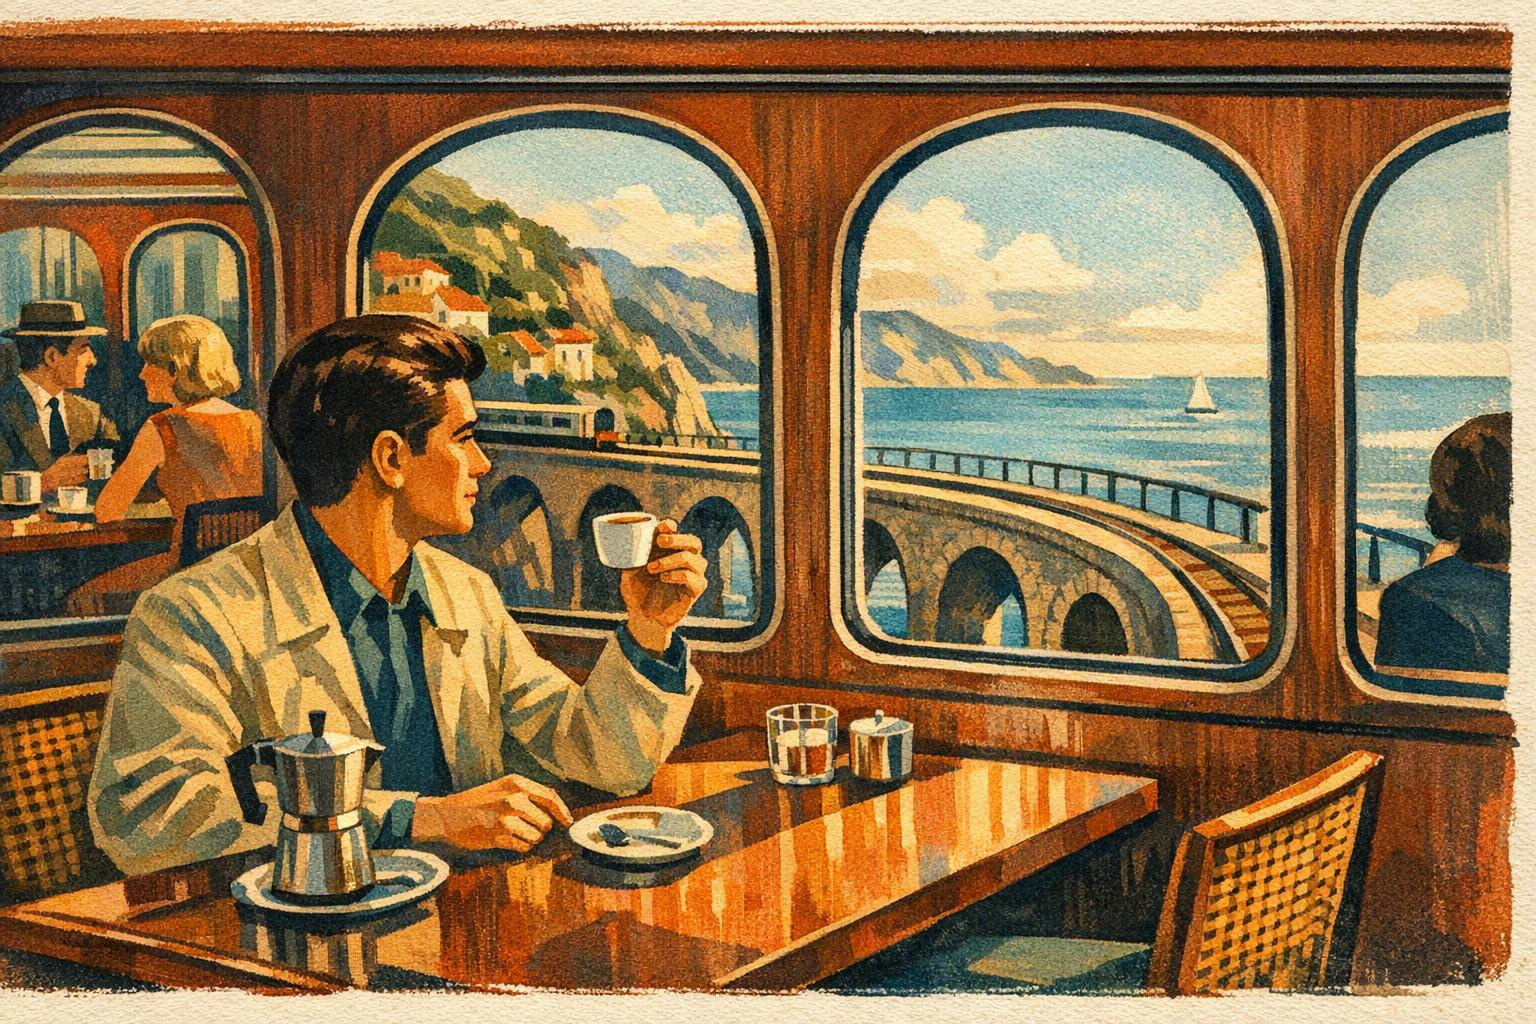
Od fotorealistycznej fotografii po stylizowane ilustracje, concept art, infografiki i wizualizacje inspirowane 3D — GPT Image 1 potrafi interpretować różnorodne kierunki estetyczne. Wzbogacaj prompty o kontekst kulturowy, historyczny lub branżowy, aby wykorzystać wiedzę modelu o świecie wykraczającą poza powierzchowne stylizowanie. Taka różnorodność sprawdza się w procesach kreatywnych, które wymagają wielu języków wizualnych bez zmiany bazowego modelu ani przebudowy stosu integracyjnego.
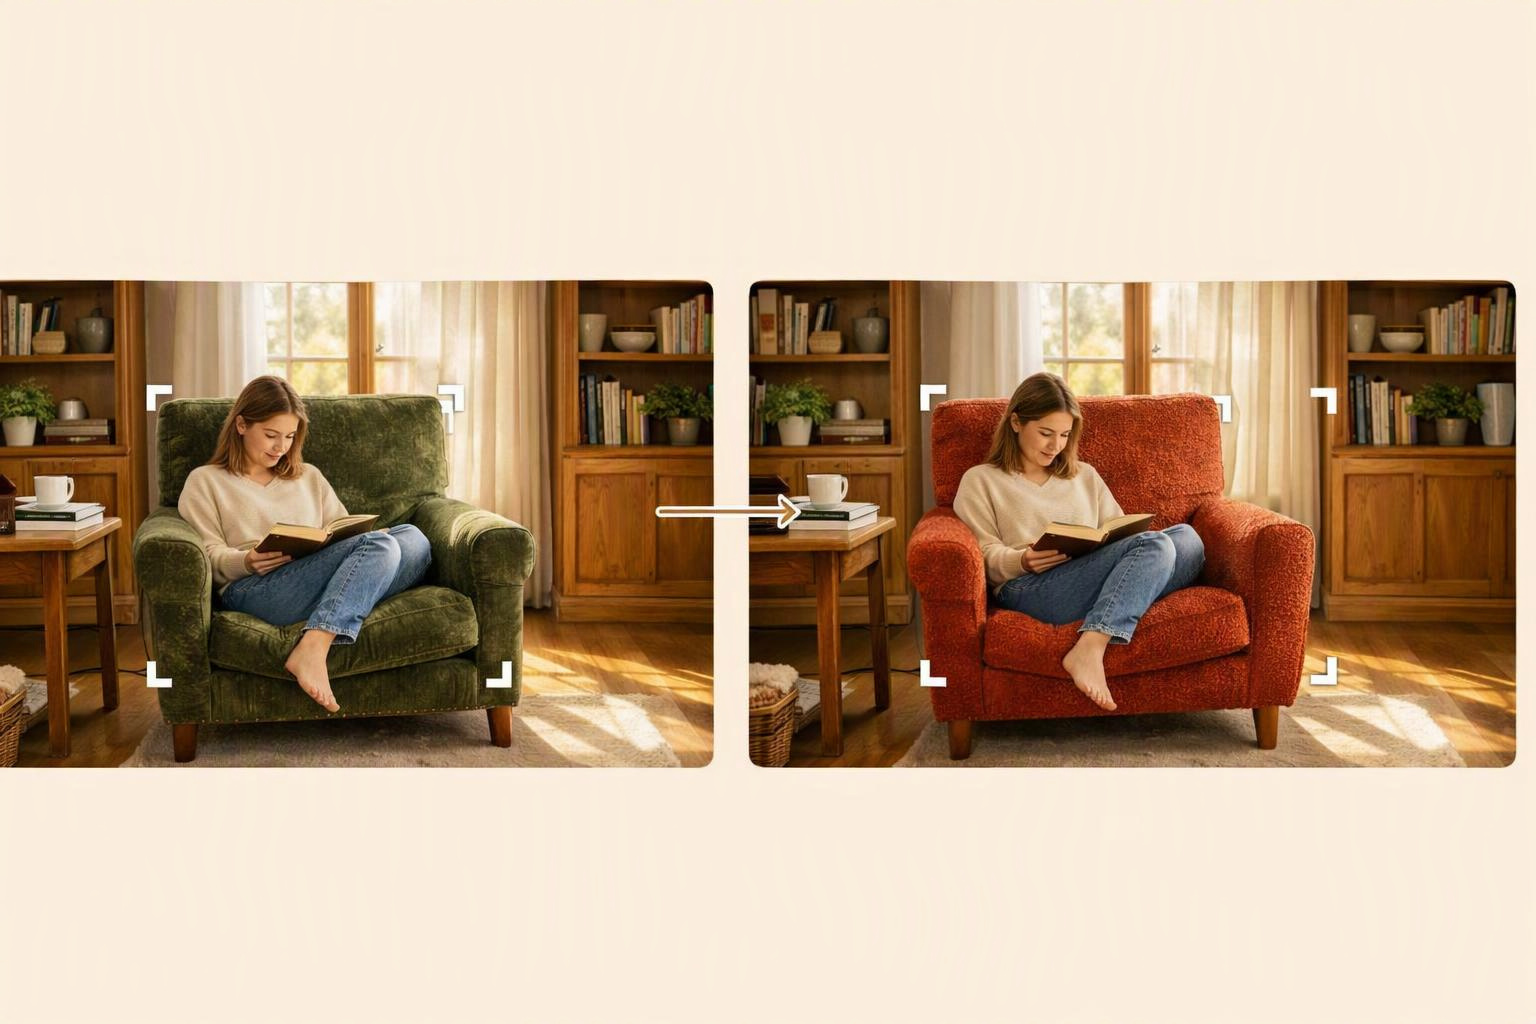
Edytuj istniejące zasoby za pomocą od jednego do czterech obrazów wejściowych oraz opcjonalnej maski PNG oznaczającej przezroczyste obszary przeznaczone do modyfikacji. Gdy dostarczonych jest kilka obrazów referencyjnych, maska jest stosowana do pierwszego obrazu, a prompt określa żądaną zmianę. Umożliwia to precyzyjny retusz, zastępowanie obiektów, komponowanie oraz kontrolowane iteracje z zachowaniem niezmienionych obszarów w zasobach produkcyjnych.
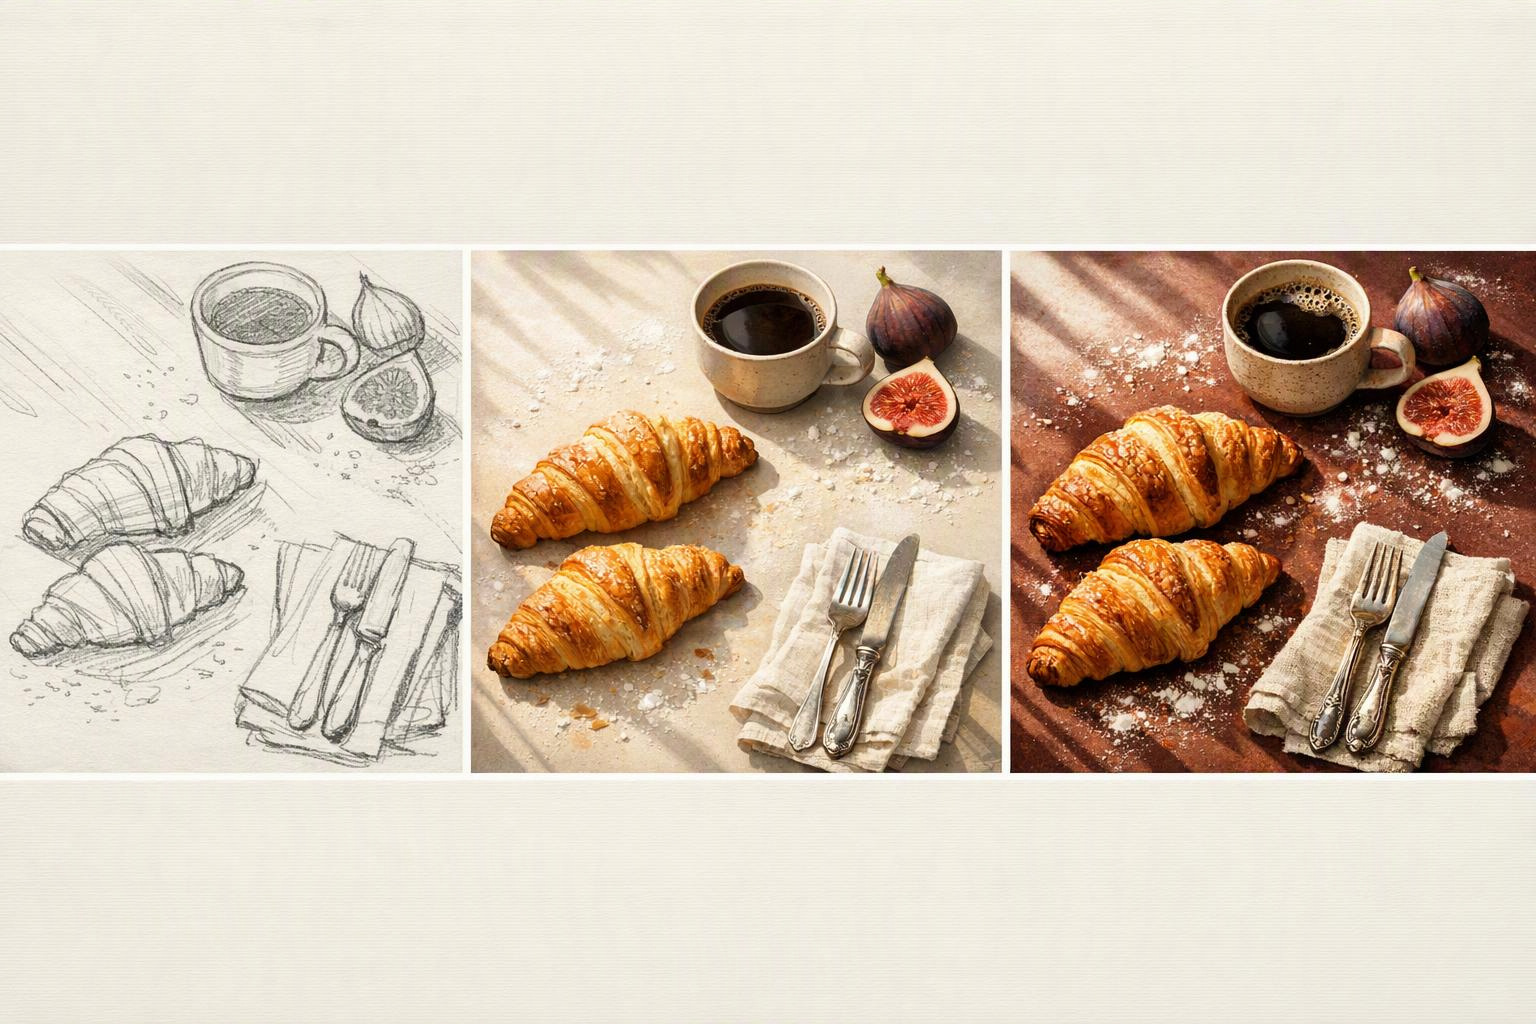
Dla każdego żądania GPT Image 1 wybierz jakość Low, Medium lub High, a następnie rozmiar wyjściowy 1024x1024, 1024x1536 lub 1536x1024. Dopasuj kwadratowy, pionowy lub poziomy kadr do miejsca docelowego, równoważąc szczegółowość z wymaganiami dotyczącymi obciążenia. Te jawne ustawienia sprawiają, że ten sam endpoint nadaje się zarówno do wstępnej eksploracji, jak i tworzenia materiałów kampanii oraz finalnych obrazów produkcyjnych dla różnych kanałów publikacji.
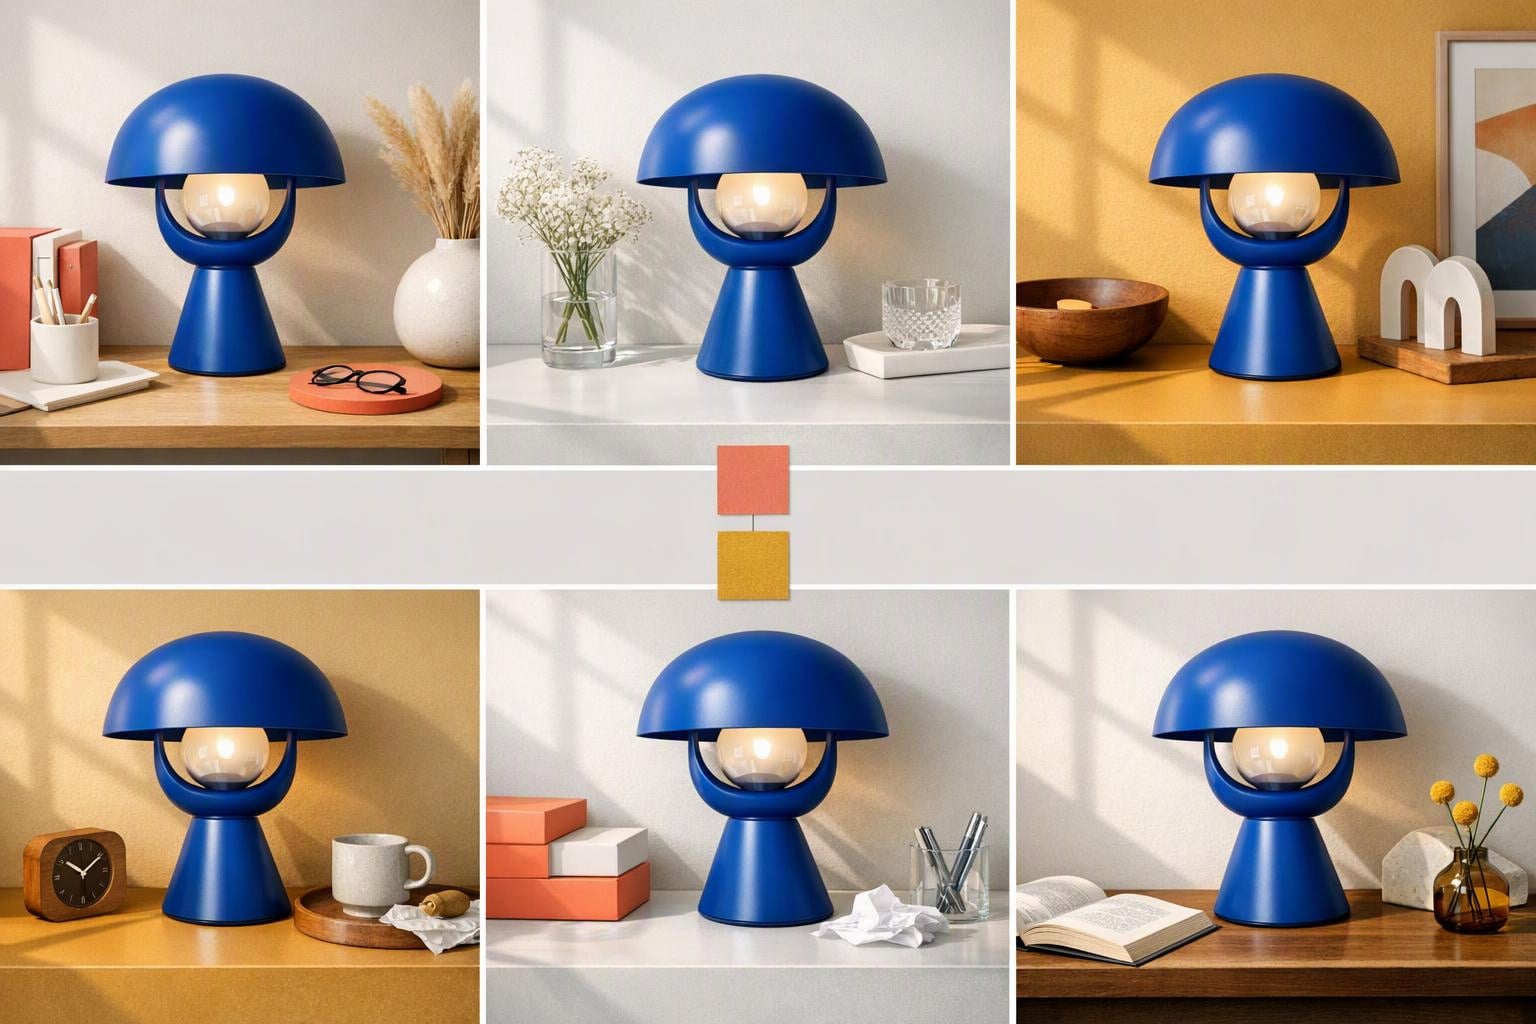
Wygeneruj od jednego do dziesięciu obrazów na podstawie promptu tekstowego, korzystając z wyjścia w formacie PNG lub JPEG. W przypadku dostarczania JPEG ustaw kompresję w zakresie od 0 do 100, a wyjście Base64 i synchroniczne przetwarzanie umożliwiają bezpośrednią obsługę przez aplikację. Łącznie opcje te upraszczają generowanie pomysłów wsadowo, potoki zasobów oraz integracje wymagające przewidywalnych formatów multimediów i elastycznych procesów obsługi odpowiedzi na dużą skalę.
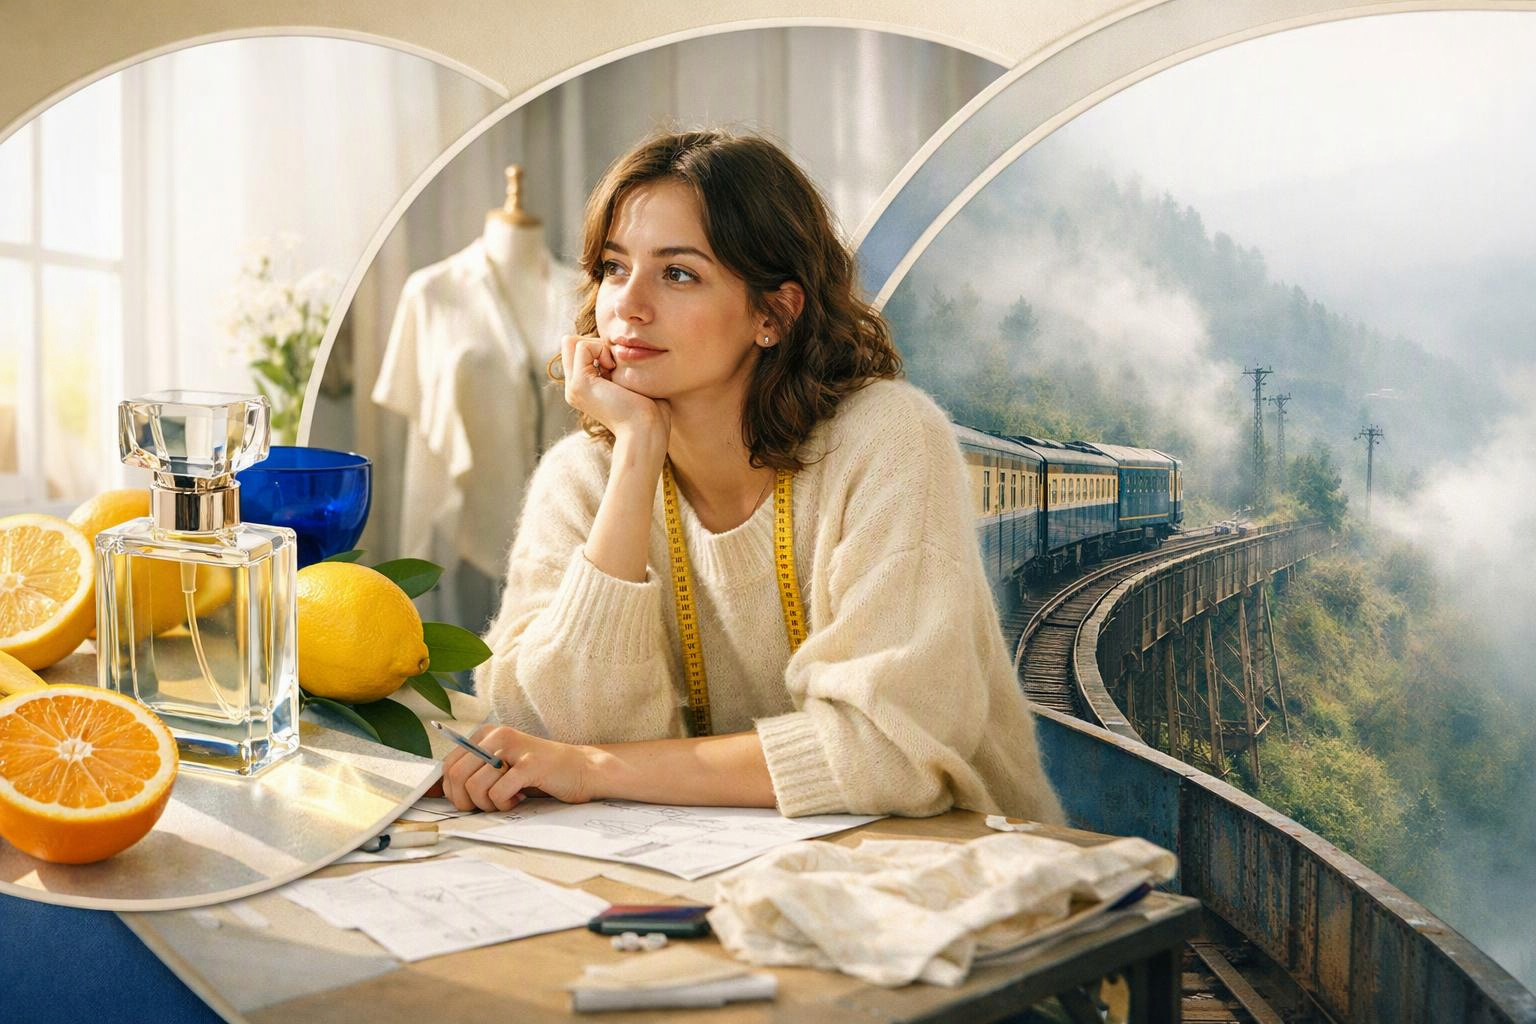
Uruchamiaj generowanie i edycję w GPT Image 1 za pośrednictwem Atlas Cloud, korzystając z przejrzystego rozliczania pay as you go w standardowej cenie $0.011 za obraz. Oba warianty modelu korzystają z tej samej trasy generowania Atlas bez cold startów, a opcje synchroniczne i Base64 obsługują różne przepływy aplikacji. Taka konfiguracja odpowiada deweloperom, którzy chcą bezpośredniego dostępu REST bez konieczności zarządzania oddzielnymi usługami obrazów.
Zobacz, jak linia GPT Image 1 wypada na tle czołowego konkurenta, gdy identyczne prompty testują typografię, kompozycję, teksturę, oświetlenie i decydujący moment akcji.
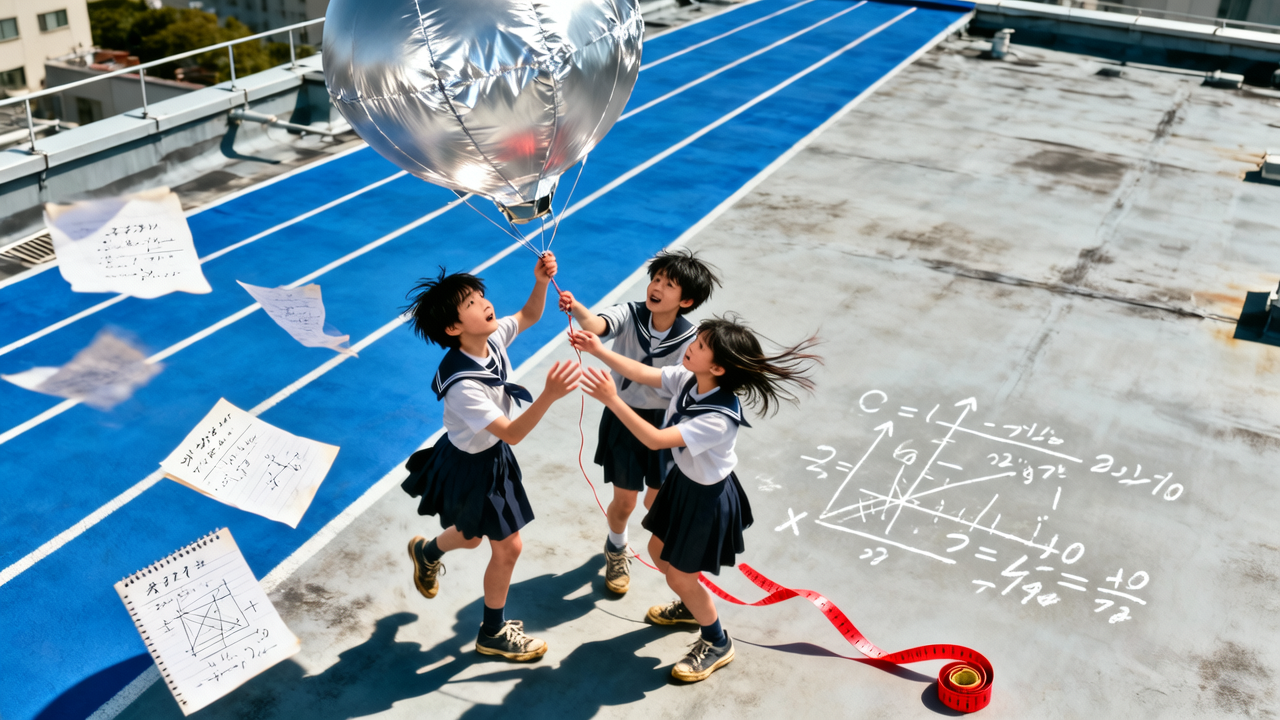
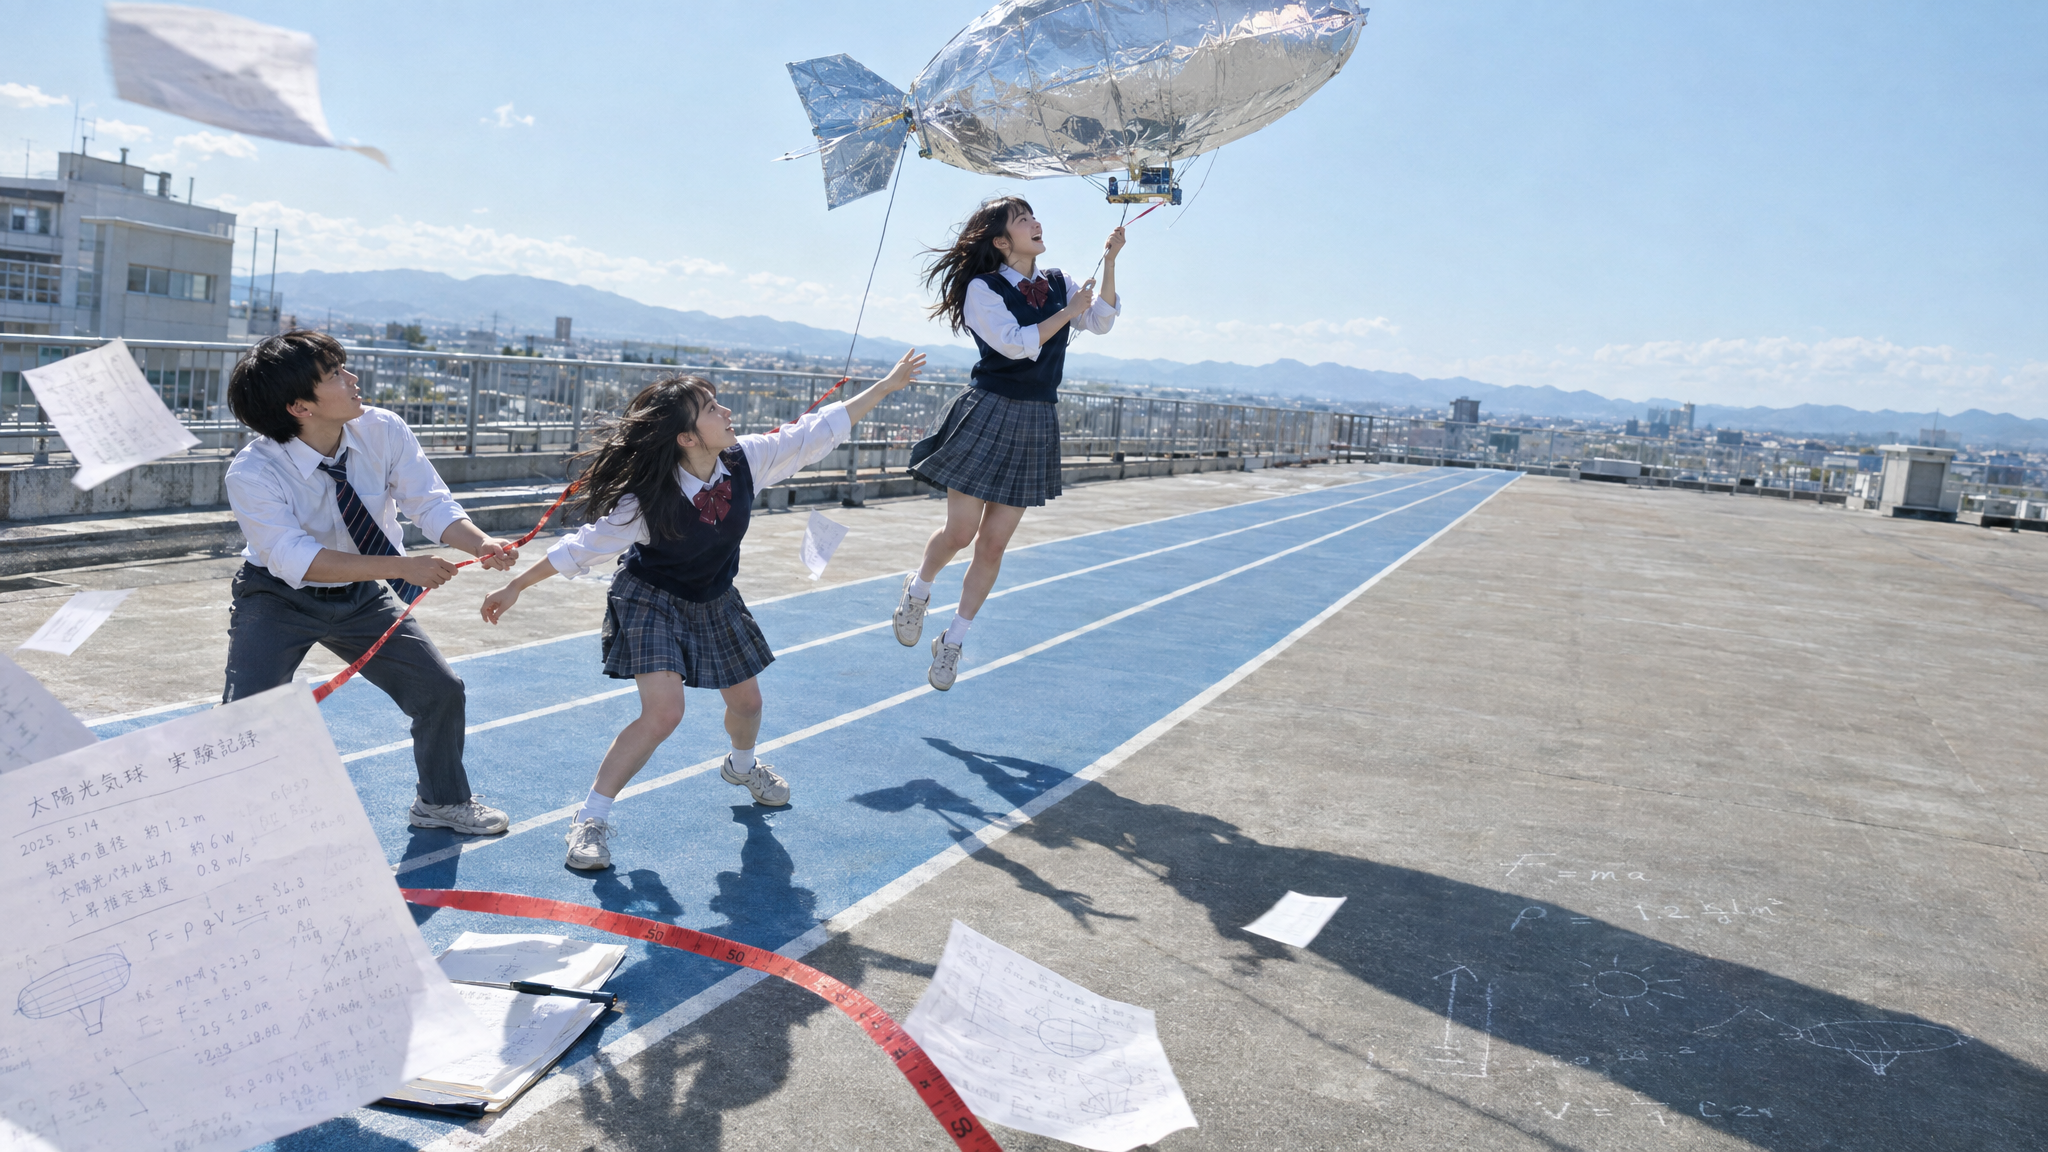
Zdjęcie retro wykonane z wysokiego, ukośnego punktu widzenia, przedstawiające eksperyment szkolnego klubu naukowego na nasłonecznionym dachu kampusu: troje nastolatków w autentycznych japońskich mundurkach szkolnych wspólnie przygotowuje start ręcznie wykonanego srebrnego sterowca solarnego, uchwyconego w decydującej chwili, gdy nagły wzrost siły nośnej delikatnie unosi jednego z uczniów nad ziemię, z palcami stóp zawisającymi nad betonem, podczas gdy pozostała dwójka napina linę i wyciąga ręce w stronę unoszącego się przyjaciela, z anatomicznie poprawnymi dłońmi i wyraźnie czytelnymi relacjami fizycznymi. Arkusze dziennika eksperymentu, pokryte drobnymi odręcznymi obliczeniami, diagramami i japońskimi notatkami, rozsypują się na wietrze wraz z rozwijającą się taśmą mierniczą w pomidorowoczerwonym kolorze, tworząc zaskakującą, radosną i lekko wymykającą się spod kontroli scenę. Kobaltowoniebieskie oznaczenia torów biegowych na dachu tworzą mocne diagonalne linie prowadzące wzrok ku grupie, podczas gdy cała prawa strona zachowuje dużą, celowo pozostawioną powierzchnię pustego betonowego negatywnego tła. Twarde, kierunkowe światło południowego słońca, wyraźnie zarysowane wydłużone cienie, jasne, lecz stonowane refleksy na półprzezroczystej, odbijającej światło membranie sterowca solarnego, subtelne rozmycie ruchu wyłącznie na lecących kartkach, taśmie i rozwianych włosach. Zdyscyplinowana paleta srebrnoszara, kobaltowoniebieska i pomidorowoczerwona; namacalna, pomarszczona metaliczna błona fotograficzna, kredowe wzory na betonie, tkany materiał mundurków, przetarte trampki, pojedyncze pasma włosów, realistyczna młodzieńcza skóra z naturalną teksturą. Realizm japońskiego magazynu młodzieżowego, spontaniczna analogowa fotografia filmowa, lekko prześwietlone niebo, drobne ziarno 35mm, naturalny kontrast, żadnych pozowanych min, żadnej plastikowej skóry z połyskiem, żadnego HDR, żadnych przybrudzonych kolorów, nadmiaru mikroszczegółów, sztucznej poświaty ani kinowego spektaklu fantasy. Głęboka spójność przestrzenna, przekonująca perspektywa dachu, spójny kierunek wiatru, poprawne refleksy i przezroczystość, czytelne drobne odręczne notatki, dynamiczna, a zarazem wiarygodna akcja z udziałem wielu osób, kompozycja pozioma wypełniająca cały kadr, szeroki współczynnik proporcji 16:9, pełne wypełnienie kadru.
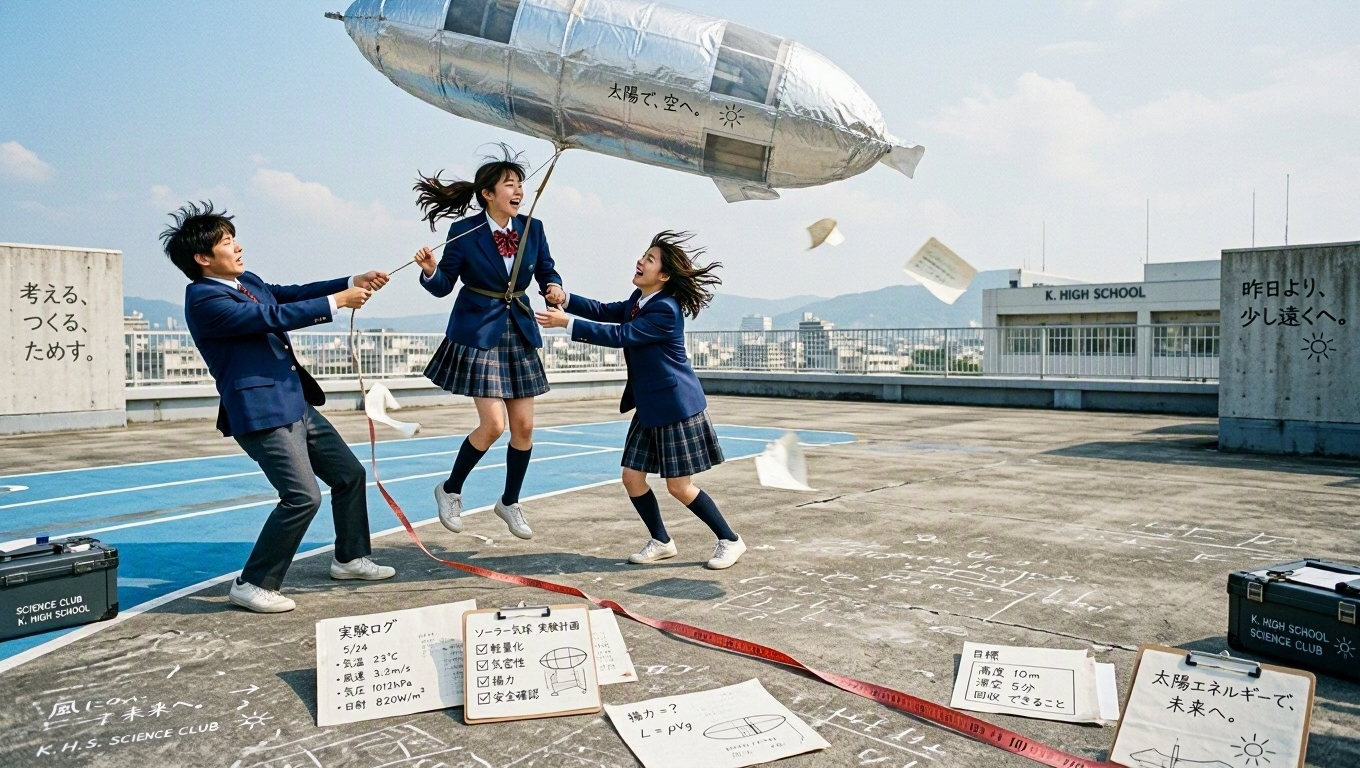
Generated with GPT Image 2.5 Sunburst Text-to-Image on Atlas Cloud
Generated with Nano Banana 2 Text-to-Image on Atlas Cloud
Generated with Openai GPT Image 2 Text-to-Image on Atlas Cloud
Reportażowa fotografia redakcyjna, ścisły pionowy widok z góry na pracownię młodej ceramiczki z miętowozieloną kafelkową podłogą, uchwycona w decydującej, komicznej chwili, gdy kobaltowoniebieskie naczynie z gliny rozpada się w elegancką spiralę na kole obracającym się z dużą prędkością; fizycznie przekonujący ruch odśrodkowy, subtelne rozmycie obrotowe i mokry szlam rozbryzgujący się wdzięcznym łukiem na teksturowanym białym płóciennym fartuchu ceramiczki. Pokryte gliną dłonie młodej garncarki, anatomicznie poprawne, naturalnie odskakują, a jej twarz wyraża zaskoczenie z tłumionym śmiechem; rudy kot obok koła wyciąga jedną poprawnie odwzorowaną łapę w stronę gąbki uchwyconej w locie, z wiarygodnym ruchem sierści i figlarnym skupieniem. Twarde, kierunkowe popołudniowe światło wpada skośnie przez wysokie okno, wycinając na podłodze ostre prostokątne pasy światła i cienie o długich, wyraźnych krawędziach. Zbuduj ekscentryczną, kolistą kompozycję wokół umieszczonego poza centrum wirującego koła; rozmieść drewniane narzędzia, stonowane naczynia z glazurą, resztki gliny i odłamki rozbitej ceramiki w promienistych rytmach o zróżnicowanym zagęszczeniu, zachowując jeden obszerny, niezatłoczony narożnik negatywnego tła. Użyj zdyscyplinowanej trzykolorowej palety kobaltowego błękitu, terakotowej pomarańczy i miętowej zieleni, zrównoważonej bielą i subtelnymi neutralnymi tonami. Wyraźnie zróżnicuj namacalne materiały: błyszczącą mokrą glinę i lepkie rozpryski, szorstkie włókna tkanego fartucha, połysk szkliwionej ceramiki, porysowane drewno, matowe porowate odłamki, miękkie pojedyncze włosy kota, lekkie ziarno filmu i drobne autentyczne niedoskonałości pracowni. Wyrafinowana współczesna fotografia redakcyjna, spontaniczna, a nie pozowana, naturalny wyraz twarzy, spójna geometria przestrzenna widziana z góry, czyste i stonowane rozdzielenie kolorów, wyraźne szczegóły w punkcie skupienia z selektywnym rozmyciem ruchu, bez tłustego prze-renderowania, bałaganu HDR, plastikowej skóry, przybrudzonych kolorów, wszechobecnej poświaty ani taniego epickiego oświetlenia, szeroki poziomy współczynnik proporcji 16:9, kompozycja od krawędzi do krawędzi z pełnym wypełnieniem kadru.
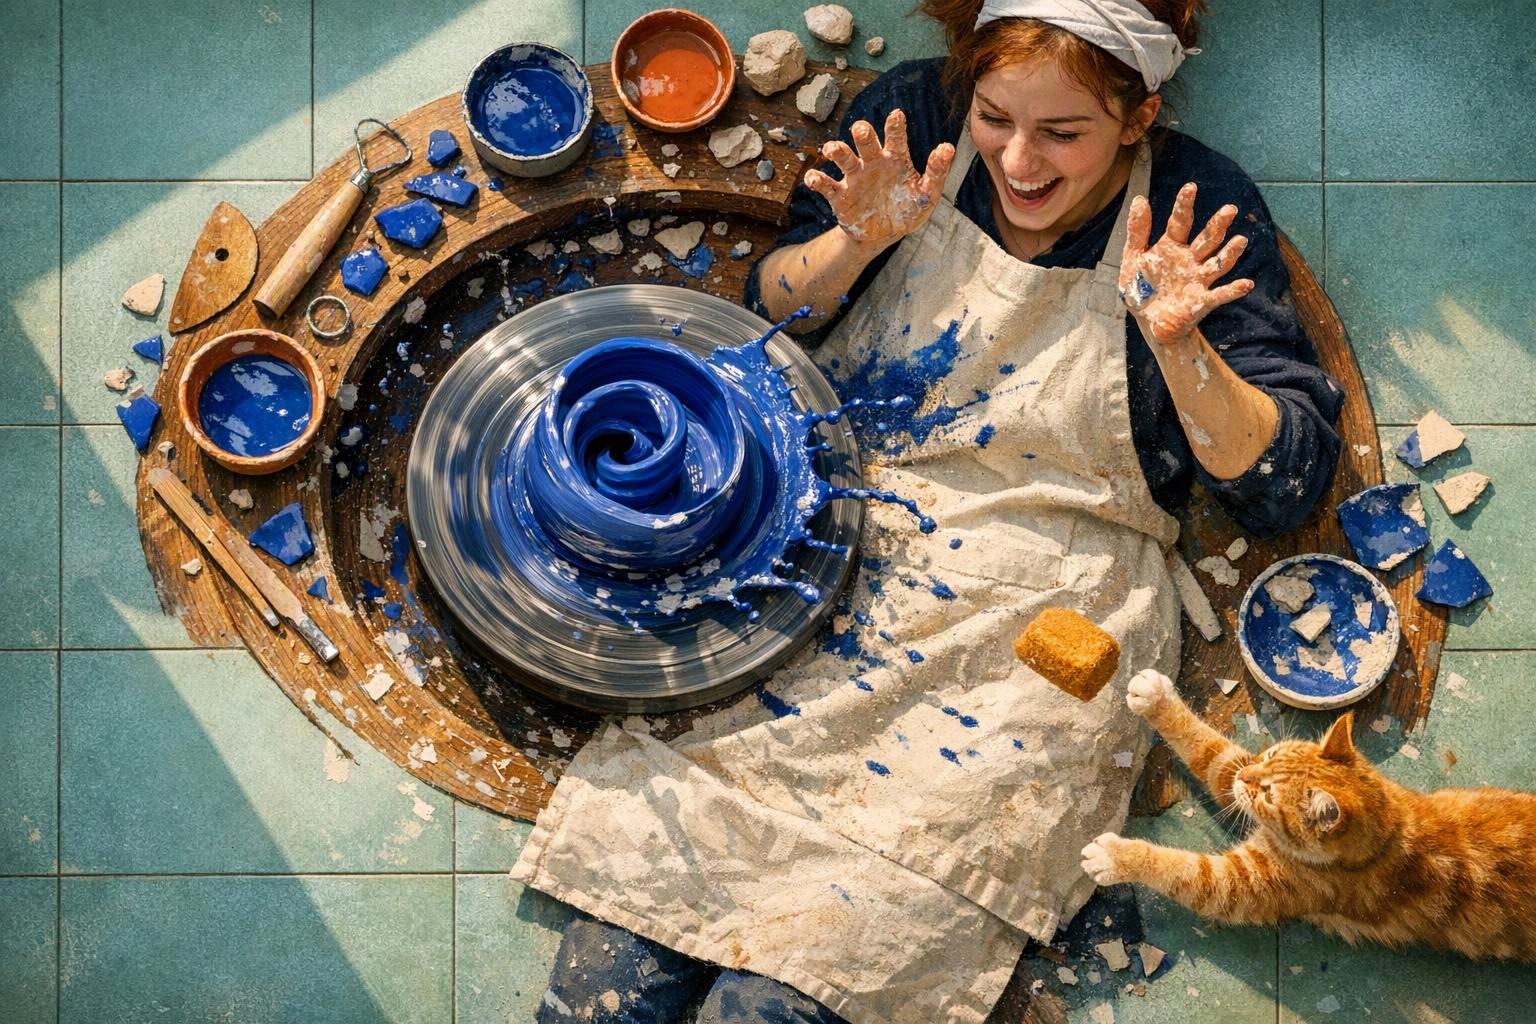
Generated with GPT Image 2.5 Sunburst Text-to-Image on Atlas Cloud
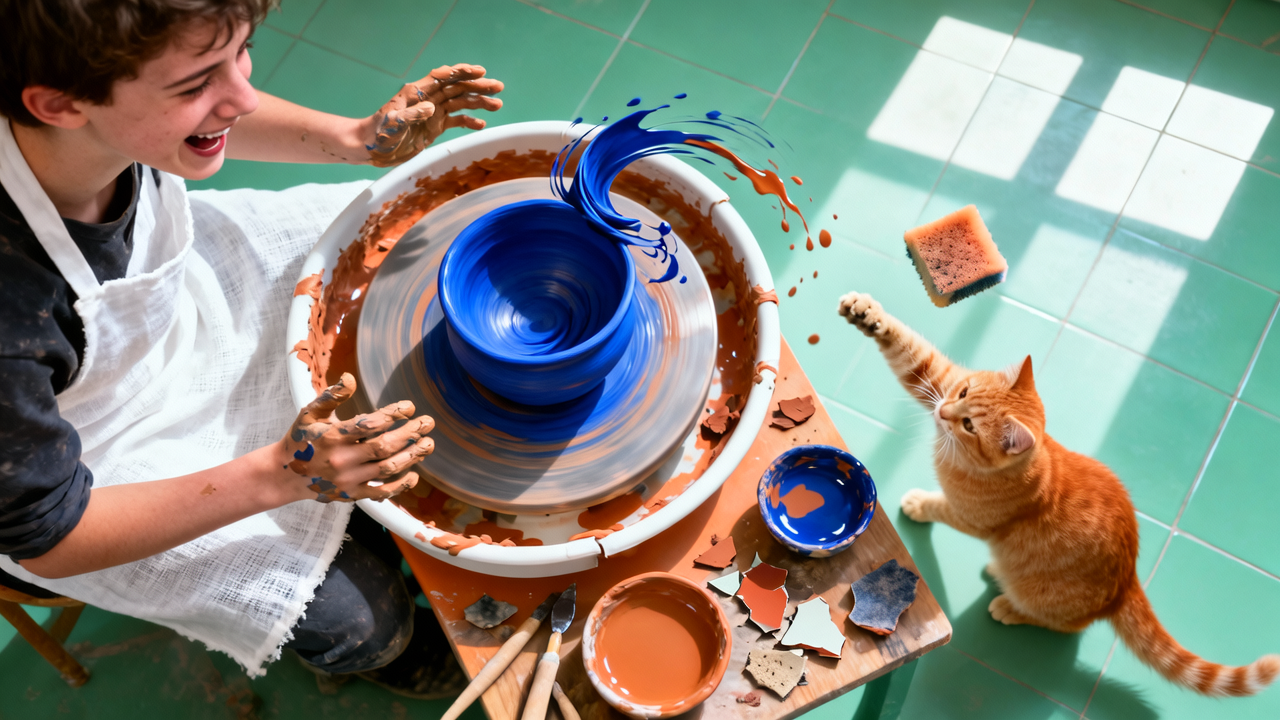
Generated with Nano Banana 2 Text-to-Image on Atlas Cloud
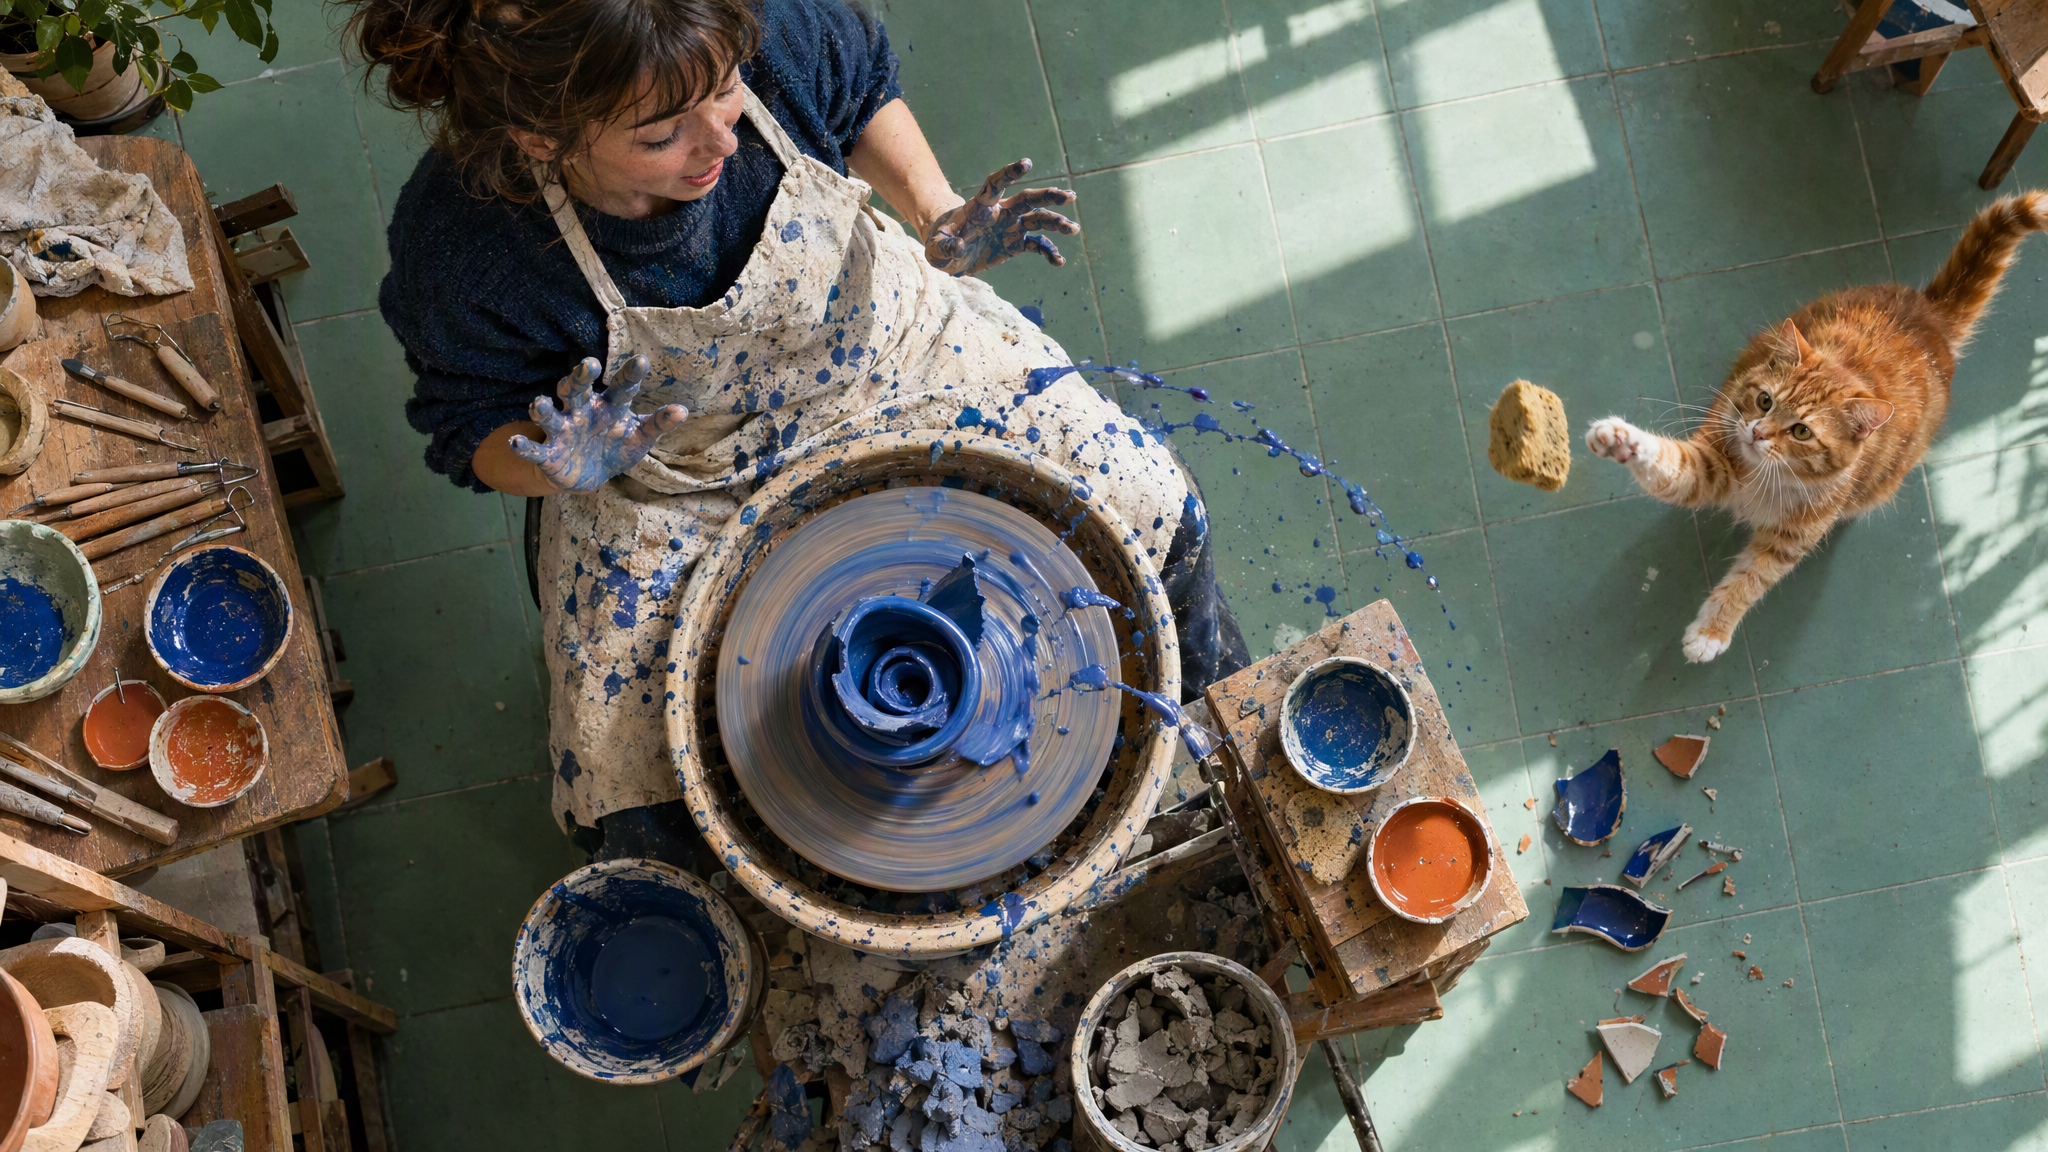
Generated with Openai GPT Image 2 Text-to-Image on Atlas Cloud
W trzech klasach modeli GPT Image 1 obsługuje kreacje kampanii, wizualizację produktów, koncepcje interfejsów, precyzyjną edycję, rozwój koncepcji oraz grafiki instruktażowe z wykorzystaniem tekstu i obrazów jako danych wejściowych.

Twórz materiały wizualne kampanii z czytelnymi nagłówkami, dopracowanymi kompozycjami i stylistyką zgodną z briefem kreatywnym. Zespoły marketingowe mogą szybko iterować nad grafikami do mediów społecznościowych, obrazami na strony docelowe, plakatami i koncepcjami reklam.

Umieszczaj produkty w fotorealistycznych scenach, zachowując naturalne oświetlenie, tekstury i relacje przestrzenne. Zespoły ecommerce mogą tworzyć warianty katalogowe, zdjęcia lifestylowe, koncepcje opakowań i materiały prezentacyjne bez organizowania kolejnej sesji zdjęciowej.

Przekształcaj szczegółowe prompty w koncepcje interfejsów łączące uporządkowane układy z czytelnymi etykietami i uzupełniającymi je elementami wizualnymi. Projektanci produktów mogą analizować ekrany aplikacji, pulpity nawigacyjne, przepływy onboardingu i prototypy gotowe do przeglądu przez interesariuszy przed rozpoczęciem implementacji.

Wykorzystuj obrazy źródłowe i opcjonalne maski, aby edytować wybrane obszary, zachowując kompozycję pozostałej części obrazu. Zespoły kreatywne mogą retuszować obiekty, usuwać elementy, zastępować tła i dopracowywać poszczególne komponenty podczas tworzenia materiałów.

Przekształcaj złożone briefy w fotorealistyczne, ilustracyjne lub stylizowane kierunki wizualne, zachowując wysoką zgodność z promptem. Studia gier, wydawcy i zespoły kreatywne mogą rozwijać koncepcje postaci, środowisk, scen fabularnych i moodboardów przed zaangażowaniem zasobów produkcyjnych.

Łącz wiedzę o świecie, renderowanie tekstu i szczegółowe instrukcje, aby tworzyć diagramy, ilustrowane przewodniki i infografiki. Nauczyciele, wydawcy i zespoły produktowe mogą przekształcać objaśnienia w przystępne materiały wizualne do lekcji, dokumentacji i onboardingu.
Zobacz, jak wypadają modele różnych dostawców — porównaj wydajność, ceny i unikalne mocne strony, aby podjąć świadomą decyzję.
| Model | Limit obrazów referencyjnych | Liczba wyników | Rozdzielczość | Współczynnik proporcji |
|---|---|---|---|---|
| GPT Image-1 | 4 | 1~10 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| GPT Image-1.5 | 10 | 1 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| GPT Image-1 Mini | 4 | 1~10 | 1024×1024, 1024×1536, 1536×1024 | 1:1, 3:2, 2:3 |
| Nano Banana 2 | 14 | 1 | 4K, 2K, 1K | 1:1 3:2 2:3 3:4 4:3 4:5 5:4 9:16 16:9 21:9 |
| Seedream 5.0 | 14 | 1~15 | 2K~4K+ | 1:1 3:2 2:3 3:4 4:3 4:5 5:4 9:16 16:9 21:9 |
Zacznij w kilka minut — wykonaj te proste kroki, aby zintegrować i wdrożyć modele za pośrednictwem platformy Atlas Cloud.
Zarejestruj się na atlascloud.ai i ukończ weryfikację. Nowi użytkownicy otrzymują bezpłatne kredyty do eksploracji platformy i testowania modeli.
Połączenie zaawansowanych modeli GPT Image z platformą GPU-akcelerowaną Atlas Cloud zapewnia niezrównaną wydajność, skalowalność i doświadczenie deweloperskie.
Niska Latencja:
Inferencja zoptymalizowana pod GPU dla rozumowania w czasie rzeczywistym.
Zunifikowane API:
Uruchamiaj GPT Image, GPT, Gemini i DeepSeek za pomocą jednej integracji.
Przejrzysta Wycena:
Przewidywalne rozliczenia za token z opcjami serverless.
Doświadczenie Dewelopera:
SDK, analityka, narzędzia dostrajania i szablony.
Niezawodność:
99,99% dostępności, RBAC i logowanie gotowe na zgodność.
Bezpieczeństwo i Zgodność:
SOC 2 Type II, zgodność z HIPAA, suwerenność danych w USA.
GPT Image 1 to natywnie multimodalny model OpenAI do generowania i edycji obrazów. Przyjmuje dane wejściowe w postaci tekstu i obrazów oraz generuje obrazy. Atlas Cloud udostępnia osobne endpointy REST do generowania obrazów na podstawie tekstu oraz do edycji obrazów.
GPT Image 1 to pierwotny, pełny model, GPT Image 1.5 to późniejsza wersja pełnowymiarowa, a Mini priorytetowo traktuje niższy koszt i większą przepustowość. Porównuj reprezentatywne prompty i edycje między poziomami, ponieważ jakość, opóźnienia i wykonywanie instrukcji mogą różnić się zależnie od obciążenia. W przypadku nowych integracji OpenAI obecnie zaleca migrację do GPT Image 2.
Wyślij prompt do openai/gpt-image-1/text-to-image, aby wygenerować obraz. W przypadku edycji wywołaj openai/gpt-image-1/edit, podając prompt oraz wymagany obraz źródłowy. Przechowuj dane uwierzytelniające Atlas Cloud API na serwerze, zamiast ujawniać je w kodzie przeglądarki lub aplikacji mobilnej.
Obsługiwane rozmiary to 1024x1024, 1024x1536, 1536x1024 oraz auto. Możesz wybrać jakość low, medium, high lub auto, a dostępne formaty wyjściowe to PNG, JPEG i WebP. Przezroczyste obrazy wyjściowe wymagają formatu PNG lub WebP oraz ustawienia parametru background na transparent.
Użyj maski, gdy edycja ma obejmować tylko wybrany obszar, natomiast input fidelity określa, jak silnie model zachowuje szczegóły obrazu źródłowego. Obraz źródłowy i maska muszą mieć ten sam format i wymiary, nie mogą przekraczać 50 MB, a maska musi zawierać kanał alfa. Wysoka wartość input fidelity zachowuje więcej szczegółów obrazu źródłowego, ale zużywa więcej tokenów obrazu wejściowego.
Zweryfikowana standardowa cena bazowa Atlas Cloud wynosi $0.011 za obraz zarówno dla modeli generowania obrazów na podstawie tekstu, jak i edycji. Jest to cena niepromocyjna, dlatego nie obejmuje tymczasowych rabatów.
ChatGPT i bezpośrednie endpointy obrazów to różne procesy produktowe, dlatego identyczny tekst promptu nie gwarantuje identycznego wyniku. ChatGPT może uwzględniać kontekst rozmowy, podczas gdy żądanie API korzysta z promptu i parametrów przekazanych w danym wywołaniu. Ustaw konkretny rozmiar i jakość, podawaj wyraźne ograniczenia oraz oceniaj kilka wyników, gdy spójność ma znaczenie.
Precyzyjne rozmieszczanie tekstu, spójność powtarzających się postaci oraz ścisła kontrola układu mogą nadal wymagać ponownych prób lub kolejnych edycji. Prompty i wygenerowane obrazy podlegają moderacji treści, a zablokowanych żądań nie należy ponawiać bez zmiany promptu lub danych wejściowych. W przypadku przejściowych błędów limitu zapytań lub serwera zapisz identyfikator żądania i ponów próbę z mechanizmem backoff.
Tak. OpenAI zaplanowało wyłączenie GPT Image 1 na 23 października 2026 r., natomiast wyłączenie GPT Image 1.5 i GPT Image 1 Mini zaplanowano na 1 grudnia 2026 r. OpenAI zaleca GPT Image 2 jako zamiennik, dlatego przed wdrożeniem nowego procesu produkcyjnego należy zweryfikować działanie migracji.
API Seedance 2.5 jest już dostępne w Atlas Cloud! Zapewnia deweloperom najnowszy model wideo od ByteDance. Generuje do 30 sekund natywnego wideo w jednym przebiegu z tekstu, pojedynczego obrazu lub nawet 50 wielomodalnych odniesień, z zsynchronizowanym dźwiękiem i wielojęzycznym tekstem w kadrze. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza, a spójność obiektu i ulepszona fizyka zachowują spójność długich ujęć.

API Wan 3.0 to kolejna generacja rodziny wideo Wan firmy Alibaba, stworzona po to, by wznieść generowanie długich form, kontrolę wielu referencji i jakość audiowizualną na nowe wyżyny. Atlas Cloud hostuje już Wan 2.7, 2.6 i 2.5, a Wan 3.0 działa na tym samym ujednoliconym kluczu bez konieczności oddzielnej konfiguracji. Rozpocznij budowanie już dziś. Przewiń w dół do sekcji prezentacji, aby zobaczyć, co potrafi stworzyć Wan 3.0.
MiniMax H3 to multimodalna rodzina modeli wideo MiniMax do tworzenia na podstawie tekstu, obrazu i materiałów referencyjnych. We wszystkich obsługiwanych trasach zachowuje obiekty z materiałów referencyjnych, oferuje elastyczne proporcje obrazu i łączy wygenerowany dźwięk z obrazem za pośrednictwem H3 Developer, a profile wynikowe są wybierane na poziomie endpointu. Atlas Cloud udostępnia całą rodzinę za pomocą jednego klucza zgodnego z OpenAI, z przejrzystym rozliczeniem pay-as-you-go według standardowej stawki $0.038 za sekundę. Zacznij tworzyć już dziś.
Rodzina modeli gpt-image-2.5 firmy OpenAI daje programistom wybór między Flare i Sunburst na potrzeby produkcyjnych procesów generowania obrazów. Renderuj w dowolnych rozdzielczościach do 3840x2160 i wybieraj spośród pięciu poziomów jakości, w tym xhigh i max, aby spełnić konkretne wymagania dotyczące wyników. Atlas Cloud zapewnia gotową do użycia inferencję REST bez zimnych startów i ze standardową ceną od $0.004 za generowanie. Zacznij tworzyć już dziś.
Seedream 5.0 Pro API udostępnia programistom sterowalny model edycji obrazów firmy ByteDance w Atlas Cloud. Precyzyjnie rozmieszcza edycje za pomocą kotwic i współrzędnych, dzieli obrazy na edytowalne warstwy, łączy wiele odniesień oraz dopasowuje dokładne kolory i materiały, z wielojęzycznym tekstem w rozdzielczościach 2K i 3K. W Atlas Cloud można uzyskać do niego dostęp za pomocą jednego klucza!
Seedance 2.0 to produkcyjny model wideo firmy ByteDance, umożliwiający precyzyjne tworzenie ujęć. Zamieniaj polecenia na wideo, animuj obraz pierwszej klatki z opcjonalnym wskazaniem ostatniej klatki lub kształtuj wyniki za pomocą materiałów referencyjnych i opcjonalnego wyszukiwania w sieci. Atlas Cloud łączy te procesy w jeden ujednolicony interfejs API, oferując przejrzyste rozliczanie zgodnie z użyciem oraz jeden klucz kompatybilny z OpenAI. Zacznij tworzyć już dziś.
Kling 3.0 API przenosi flagowy pakiet wideo Kuaishou do Atlas Cloud za pomocą jednego klucza kompatybilnego z OpenAI. Obejmuje on dwa modele: Kling 3.0 do opowiadania historii AI Director, wielojęzycznej synchronizacji ruchu warg i precyzyjnego tekstu na ekranie, oraz Kling 3.0 Omni (O3) do klonowania obiektów i głosu z krótkiego wideo lub obrazu. Oba generują natywny dźwięk w tym samym przebiegu, z rozdzielczością wyjściową do 4K. Buduj kinowe narracje, globalny marketing, wielojęzyczne reklamy i serializowane treści z postaciami w niezawodnej infrastrukturze.
Grok Imagine Video zapewnia deweloperom dostęp do rodziny modeli wideo xAI do tworzenia, animowania, wydłużania i edytowania klipów. Generuj filmy o długości od 1 do 15 sekund na podstawie promptów, steruj postaciami, obiektami lub stylami, korzystając z maksymalnie siedmiu obrazów referencyjnych, i pracuj w rozdzielczości 480p lub 720p. Atlas Cloud udostępnia te możliwości za pośrednictwem endpointów zgodnych z OpenAI, oferując przejrzyste rozliczanie pay-as-you-go. Zacznij tworzyć już dziś.
Vidu Q4 to najnowszy flagowy model wideo firmy Vidu, przeznaczony do generowania wideo na podstawie obrazu oraz referencji. Potrafi animować pojedynczy obraz nieruchomy i automatycznie tworzyć przejścia między scenami, oferując deweloperom dwie ścieżki wejściowe na potrzeby różnych przepływów pracy produktu. Atlas Cloud udostępnia dedykowane endpointy API z opublikowanymi schematami parametrów w zweryfikowanej standardowej cenie $0.04 za sekundę. Zacznij tworzyć już dziś.
Gemini Omni 1.1 Flash to natywnie multimodalna rodzina modeli wideo Google DeepMind, przeznaczona do elastycznych procesów produkcyjnych. Edytuj istniejący materiał za pomocą instrukcji tekstowych, zachowuj spójność wizualną dzięki maksymalnie 10 obrazom referencyjnym i 3 klipom wideo lub wydłużaj ujęcia w łączonych segmentach do 40 sekund. Uzyskaj dostęp do wszystkich procesów w Atlas Cloud za pomocą jednego klucza API zgodnego z OpenAI, z rozliczaniem według zużycia i dostępnością od pierwszego dnia. Zacznij tworzyć już dziś.
Nano Banana 2.1 to rodzina modeli obrazowych firmy Google, zbudowana na bazie Gemini 3.6 Flash. Zapewnia generowanie i edycję na poziomie Pro z szybkością Flash, obsługuje edycję w języku naturalnym oraz łączenie od 1 do 14 obrazów wejściowych, a także zachowuje spójność do 4 postaci i 10 obiektów. Dzięki Atlas Cloud deweloperzy mogą korzystać z tej rodziny za pomocą jednego klucza zgodnego z OpenAI, niezawodnej dostępności i dostępności od Day-0. Zacznij tworzyć już dziś.
Twórz za pomocą API Nano Banana 2, napędzanego przez model Gemini 3.1 Flash Image od Google. Generuje ono natywne obrazy 4K o rozdzielczości do 4096x2304 z dokładnym renderowaniem tekstu i spójnymi postaciami w oparciu o maksymalnie 14 obrazów referencyjnych, zarówno w przypadku generowania, jak i edycji. W Atlas Cloud zyskujesz do niego dostęp poprzez jedno ujednolicone API obok ponad 300 modeli, z cenami od 0,04 USD za obraz, gwarantowanym czasem bezawaryjnej pracy na poziomie 99,99% i darmowymi kredytami na start.
Poradniki, samouczki i nowości produktowe, dzięki którym w pełni wykorzystasz Atlas Cloud.


