Sua solicitação retorna com sucesso. O aplicativo ainda não tem uma imagem utilizável. Talvez a resposta contenha um ID de tarefa, ou a imagem final inclua um objeto extra que a torna inadequada para a página.
Uma API de IA generativa para desenvolvedores permite que seu aplicativo envie entradas para um modelo e receba conteúdo gerado. Escolha uma com base nas entradas necessárias, formato de saída, tempo de espera e critérios de aceitação. Em seguida, construa o tratamento de trabalhos e as verificações que transformam uma resposta em algo que um usuário possa usar.
Este guia segue um fluxo de trabalho de imagem desde a seleção até a entrega. Você obterá uma tabela de seleção de tarefas, exemplos correspondentes em JavaScript e Python, 3 briefings de imagem concretos e uma planilha de custos. O mesmo processo de decisão se aplica a texto e vídeo, com protocolos e verificações de saída diferentes.
Principais conclusões
- Escolha a tarefa e os critérios de aceitação antes do modelo.
- Salve IDs de tarefas assíncronas para que o trabalho interrompido possa ser retomado.
- Meça o custo por saída aceita, incluindo gerações rejeitadas.
- Teste arquivos e restrições de negócios antes de mostrar um resultado final.
API de IA generativa para desenvolvedores: O que ela faz
Um modelo realiza a geração. Uma API define como seu software solicita esse trabalho. Um SDK encapsula a interface em helpers específicos da linguagem. Uma plataforma hospedada opera o acesso a modelos, enquanto seu aplicativo fornece a experiência do usuário, permissões e regras para aceitar o resultado.
Essas distinções importam ao ler uma página de produto. Um aplicativo de chat que cria imagens não estabelece que seu endpoint de desenvolvedor aceita as mesmas entradas. Um SDK com um método conveniente não elimina a necessidade de entender sua resposta subjacente e estados de falha.
Comece com o seguinte mapa de tarefas. A coluna de interação descreve um design de aplicativo a ser avaliado, em vez de uma promessa de que todo provedor suporta esse modo.
| Tarefa | Entrada | Capacidade necessária | Saída | Interação a avaliar | Critérios de aceitação |
|---|---|---|---|---|---|
| Rascunho de resposta de suporte | Ticket e conteúdo de ajuda aprovado | Geração de texto fundamentada | Texto de rascunho | Síncrona ou streaming | Responde ao ticket; nenhuma política inventada |
| Extração de campos de documento | Texto do documento ou arquivo suportado | Extração estruturada | Campos JSON | Solicitação ou trabalho enfileirado | Esquema válido e evidência de origem |
| Ilustração editorial | Briefing visual escrito | Texto para imagem | Arquivo de imagem | Trabalho assíncrono | Objetos, layout, dimensões corretos |
| Edição de imagem | Imagem de origem e instrução | Edição condicionada por imagem | Imagem editada | Trabalho assíncrono | Alteração solicitada; detalhes preservados |
| Geração de vídeo | Prompt ou referência suportada | Geração de vídeo | Arquivo de vídeo | Trabalho enfileirado | Duração, movimento, áudio corretos, se necessário |
| Resposta assistida por recuperação | Pergunta e passagens recuperadas | Recuperação mais geração | Resposta e referências | Síncrona ou streaming | Afirmações apoiadas por passagens recuperadas |
Gerar uma imagem, analisar uma imagem enviada e editar uma imagem existente são capacidades separadas. Verifique cada uma explicitamente. Da mesma forma, um endpoint de vídeo pode suportar um quadro inicial sem suportar referências arbitrárias de múltiplas imagens.
Embeddings convertem entradas em vetores úteis para recuperação e similaridade. Eles podem ajudar a encontrar documentos relevantes antes que uma resposta seja gerada. Eles próprios não produzem a resposta nem estabelecem que o conteúdo recuperado apoia suas afirmações.
O limite prático é entrada → solicitação → saída → aceitação do aplicativo. Você é o dono do estágio final. Um campo de fatura gerado ainda precisa de validação; uma imagem ainda precisa de inspeção; uma resposta de suporte ainda precisa de permissão para fazer a promessa que contém.
As escolhas de protocolo também variam. A referência do Google distingue geração padrão, streaming e interação ao vivo. Trate isso como evidência de que os modos de interação diferem, em vez de assumir suporte idêntico em outros lugares. (Google Gemini API reference, acessado em setembro de 2026.)
API de IA generativa para desenvolvedores: Como escolher
Escreva um pequeno briefing de aceitação antes de comparar catálogos. Para um recurso de imagem editorial, isso pode especificar saída em paisagem, uma contagem limitada de objetos, nenhuma marca visível e uma etapa de revisão humana. Para classificação de tickets, pode especificar um conjunto fixo de rótulos e um resultado incerto explícito.
Avalie os candidatos nesta ordem:
- Entradas e saídas. Verifique o endpoint exato do modelo para arquivos suportados, limites de entrada, formatos de saída e comportamento de imagem de referência. O nome da família de modelos é muito amplo para servir como contrato.
- Conformidade com a tarefa. Experimente briefings representativos, incluindo os difíceis. Conte falhas de restrição separadamente de falhas de arquivo ou rede para saber o que precisa ser corrigido.
- Adequação de integração. Confirme autenticação, envelopes de resposta, valores de status de tarefa e suporte à biblioteca cliente. Inclua o trabalho necessário para adaptá-los ao seu backend existente.
- Tempo de espera e concorrência. Decida se os usuários podem sair e voltar. Teste sua carga de trabalho esperada antes de se comprometer com uma experiência interativa com prazo curto.
- Clareza de cobrança. Identifique a unidade cobrável e quais configurações a alteram. Verifique o tratamento de falhas e reembolsos em vez de assumir que toda solicitação enviada recebe a mesma cobrança.
- Requisitos de dados. Revise o tratamento de entrada, retenção, exclusão e termos aplicáveis em relação aos dados reais que você pretende enviar. Documente questões não resolvidas antes de usar material sensível.
- Gestão de mudanças. Mantenha um conjunto de regressão e registre identificadores de modelo, prompts e parâmetros. Planeje como você reavaliará o comportamento após uma atualização ou substituição.
A orientação institucional ilustra por que regras de acesso e dados pertencem a esta decisão: Harvard descreve rotas de acesso aprovadas e restrições em torno de suas ferramentas de desenvolvedor de IA. Esses são os arranjos de Harvard, não permissões universais para seu aplicativo. (Harvard University Information Technology, acessado em setembro de 2026.)
| Rota de acesso | Equipe adequada | Trabalho de integração | Responsabilidade operacional | Principal limitação | Verificar antes de escolher |
|---|---|---|---|---|---|
| Provedor direto de modelo | Equipe centrada nas capacidades de um provedor | API específica do provedor, contas, adaptadores | Seu aplicativo e trabalhos; inferência do provedor | Provedores adicionais adicionam contratos separados | Recursos do endpoint, regiões, cotas, termos |
| Plataforma hospedada multimodelo | Equipe avaliando vários modelos suportados | Acesso compartilhado mais validação específica do modelo | Seu aplicativo e trabalhos; inferência hospedada na plataforma | Acesso compartilhado não padroniza todos os parâmetros | Modelos exatos, esquemas, cobrança, caminho de dados |
| Modelo aberto auto-hospedado | Equipe com habilidades de infraestrutura e serviço de modelos | Implantar, expor, proteger e manter a inferência | Hardware, serviço, escalonamento, monitoramento, atualizações | Capacidade e sobrecarga de engenharia | Licença, adequação de hardware, taxa de transferência, manutenção |
Atlas Cloud é uma opção hospedada a ser avaliada quando várias capacidades de modelo pertencem ao mesmo aplicativo. Este artigo usa sua interface de tarefas de imagem como exemplo concreto. Você ainda precisa validar as entradas e saídas de cada modelo; alterar apenas um ID de modelo é insuficiente.
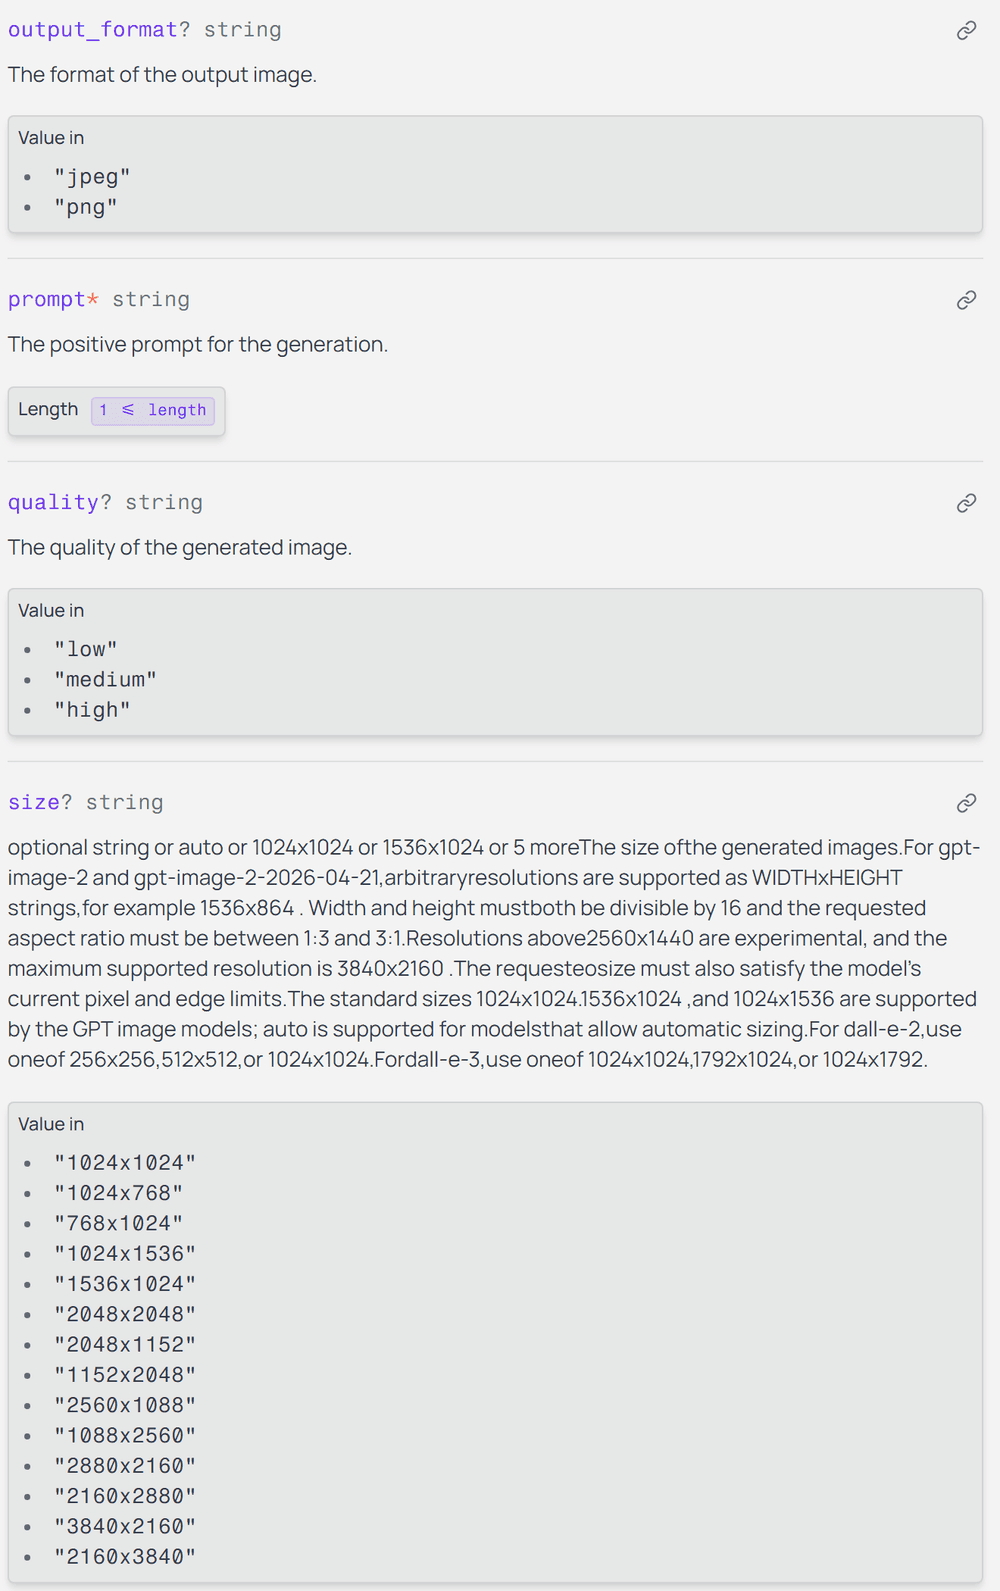
Documentação oficial do endpoint de imagem mostrando formato de saída, qualidade e restrições de tamanho
Parâmetros específicos do modelo fazem parte do contrato de integração. Leia seus valores permitidos antes de reutilizar um corpo de solicitação.
Para uma pequena equipe SaaS, a comparação útil é o esforço total para entregar um resultado aceito. Inclua código de adaptador, investigação de suporte, tempo de revisão e testes de migração junto com a cobrança de inferência. Isso evita que um protótipo conveniente esconda um fluxo de trabalho de produção caro.
API de IA generativa para desenvolvedores: Primeira solicitação
O exemplo usa GPT Image 2 Text-to-Image, com ID de modelo openai/gpt-image-2/text-to-image. A documentação do endpoint lista quality: high, size: 2048x1152 e output_format: png. Essas são as configurações solicitadas para os exemplos abaixo.
1. Estabeleça o prompt no playground. Use o briefing de café da manhã abaixo sem adicionar uma imagem de referência. Verifique o nome do modelo e as configurações confirmadas antes de pressionar Executar. Uma seleção que reverte quando você sai de um campo não é a configuração que você solicitou.
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. Mantenha a autenticação no servidor. Seu frontend deve solicitar ao seu próprio backend para iniciar um trabalho. Armazene ATLAS_API_KEY no ambiente do servidor. Nunca inclua em JavaScript do navegador, URLs de imagem ou logs visíveis ao cliente. Defina ATLAS_API_HOST como api.atlascloud.ai; este é um hostname, sem esquema ou caminho.
3. Envie uma vez e persista o ID. A rota de geração documentada é POST /api/v1/model/generateImage. Leia data.id e armazene-o em relação ao trabalho do seu aplicativo. Se a resposta de envio for perdida, investigue antes de criar outra tarefa potencialmente cobrável.
4. Faça polling do trabalho salvo. Consulte GET /api/v1/model/prediction/{prediction_id}. A documentação de previsão descreve processing, completed e failed, com URLs de saída em data.outputs. Um status concluído ainda deve ser verificado para um array de saída não vazio.
5. Baixe e valide. Salve o arquivo sob seu controle, verifique se ele decodifica e inspecione-o em relação ao briefing. Só então retorne um resultado aceito para o aplicativo. Um erro de download ou validação deve permanecer anexado ao trabalho existente.
O código a seguir foi montado a partir da documentação oficial da interface. Não é apresentado como um benchmark de API ao vivo. O fluxo de trabalho de mídia do artigo usa o playground de teste do navegador, não uma chave de API.
Salve o prompt exato do café da manhã como prompt.txt. Para Node.js, use um ambiente com fetch integrado, instale sharp e salve isto como generate.mjs. Execute-o em um diretório de trabalho dedicado. Execute apenas um dos dois exemplos de linguagem, a menos que você queira intencionalmente dois trabalhos.
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
O equivalente mais curto em Python usa requests e Pillow, o mesmo prompt.txt e configurações idênticas. Ele também aceita PREDICTION_ID para retomar. Esses scripts demonstram um trabalho local; um serviço implantado precisa de registros persistentes de trabalhos e downloads limitados.
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
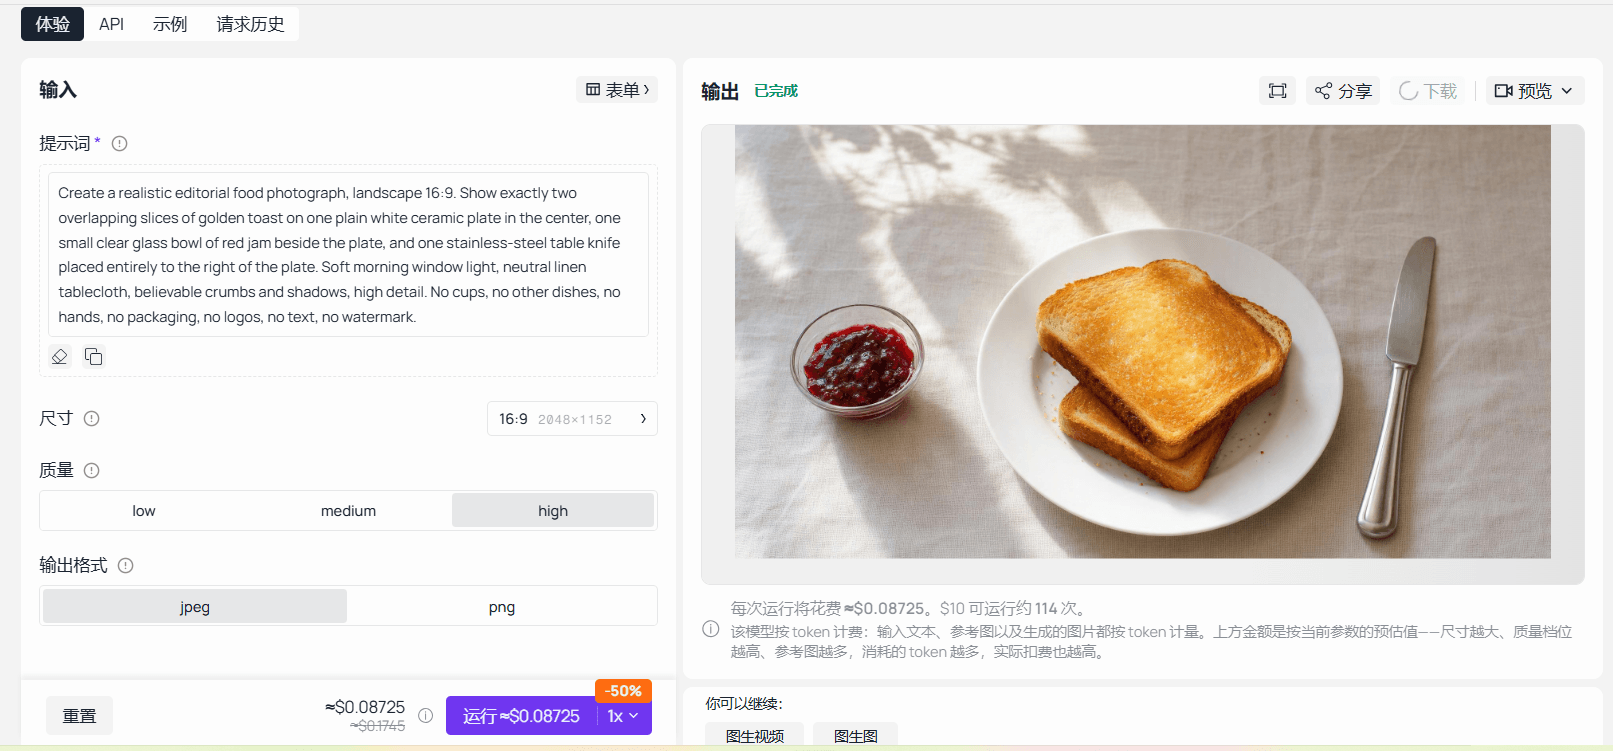
Playground GPT Image 2 concluído mostrando o prompt de café da manhã enviado e a saída final
Um execução concluída do playground registra o prompt enviado, tamanho de saída, configuração de qualidade e o resultado gerado juntos.
Um prazo de polling impede que este cliente espere; ele não cancela o trabalho do lado do servidor. Uma solicitação já em andamento pode terminar após a janela de polling, portanto, isso não é uma garantia estrita de latência de ponta a ponta. Preserve o ID e permita que um worker o verifique mais tarde.
API de IA generativa para desenvolvedores: Usos práticos
Os 3 briefings abaixo testam requisitos diferentes. Eles são solicitações independentes, não uma cadeia em que um resultado se torna a próxima entrada. Mantenha o mesmo modelo e configurações solicitadas para que as diferenças nos briefings permaneçam fáceis de entender.
A. Imagem editorial de comida: contagem e posicionamento. O prompt de café da manhã testa se a saída contém 2 fatias de torrada, 1 prato, 1 tigela de geleia e 1 faca. A faca deve ficar à direita do prato, e todos os objetos necessários devem permanecer dentro do quadro.
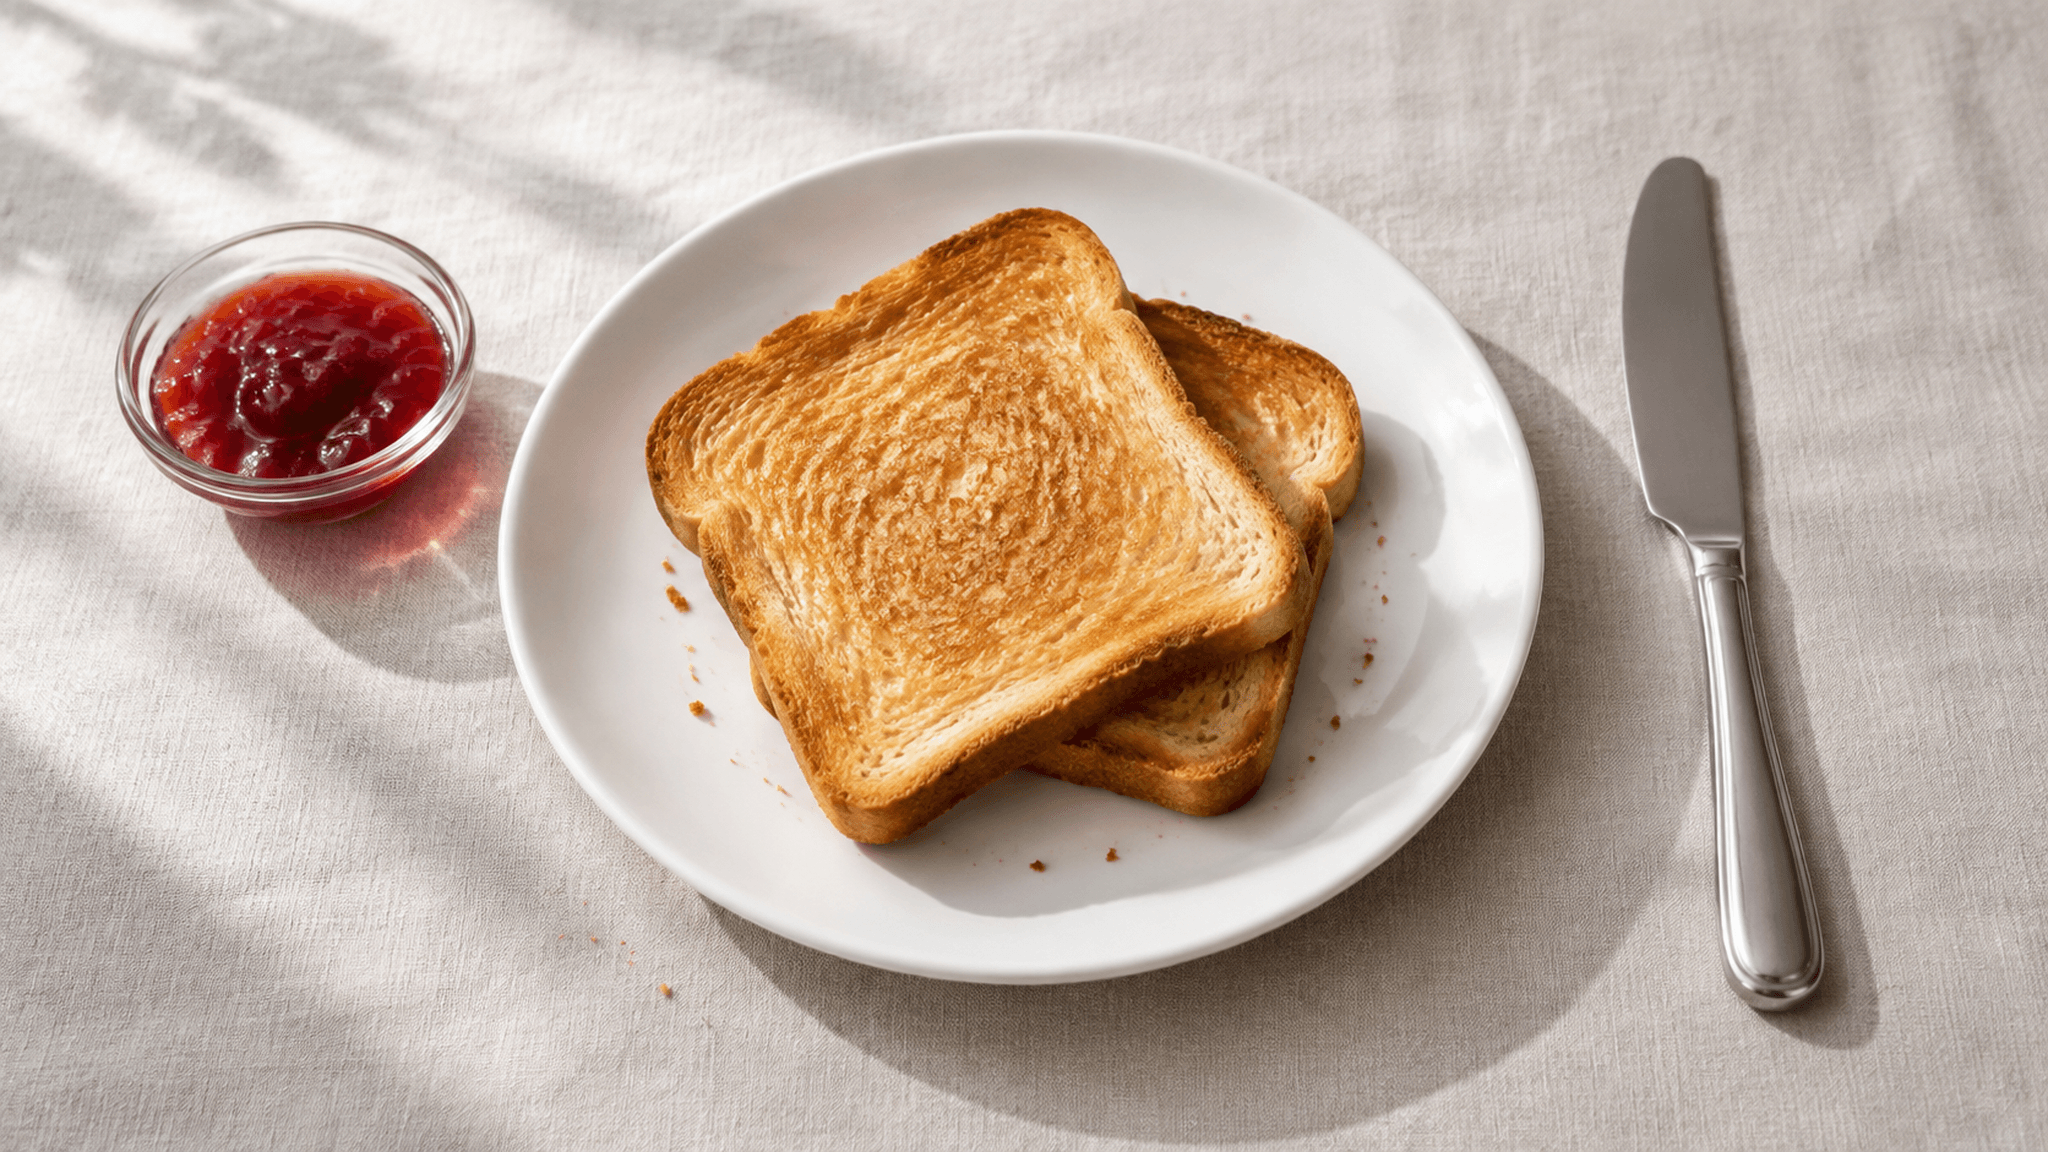
Exemplo de geração de imagem de café da manhã emparelhado com verificação de contagem de objetos e posicionamento da faca
O resultado gerado contém o prato, a torrada, a tigela de geleia e a faca à direita solicitados, prontos para a revisão de posicionamento abaixo.
Inspecione fatias sobrepostas individualmente. Um café da manhã visualmente convincente ainda pode falhar se uma xícara aparecer no fundo ou a faca se mover para o prato. Se um resultado falhar, revise a instrução espacial ambígua, altere uma variável e retenha o motivo da rejeição. Evite pedir repetidamente uma imagem geralmente melhor.
B. Capa de artigo: espaço utilizável para manchete. Esta solicitação trata a composição como uma dependência de layout. O editor da página precisa de espaço vazio à esquerda, enquanto o lado direito carrega as ferramentas e o vaso. Adicione o título real depois usando HTML/CSS para que permaneça editável e legível.
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
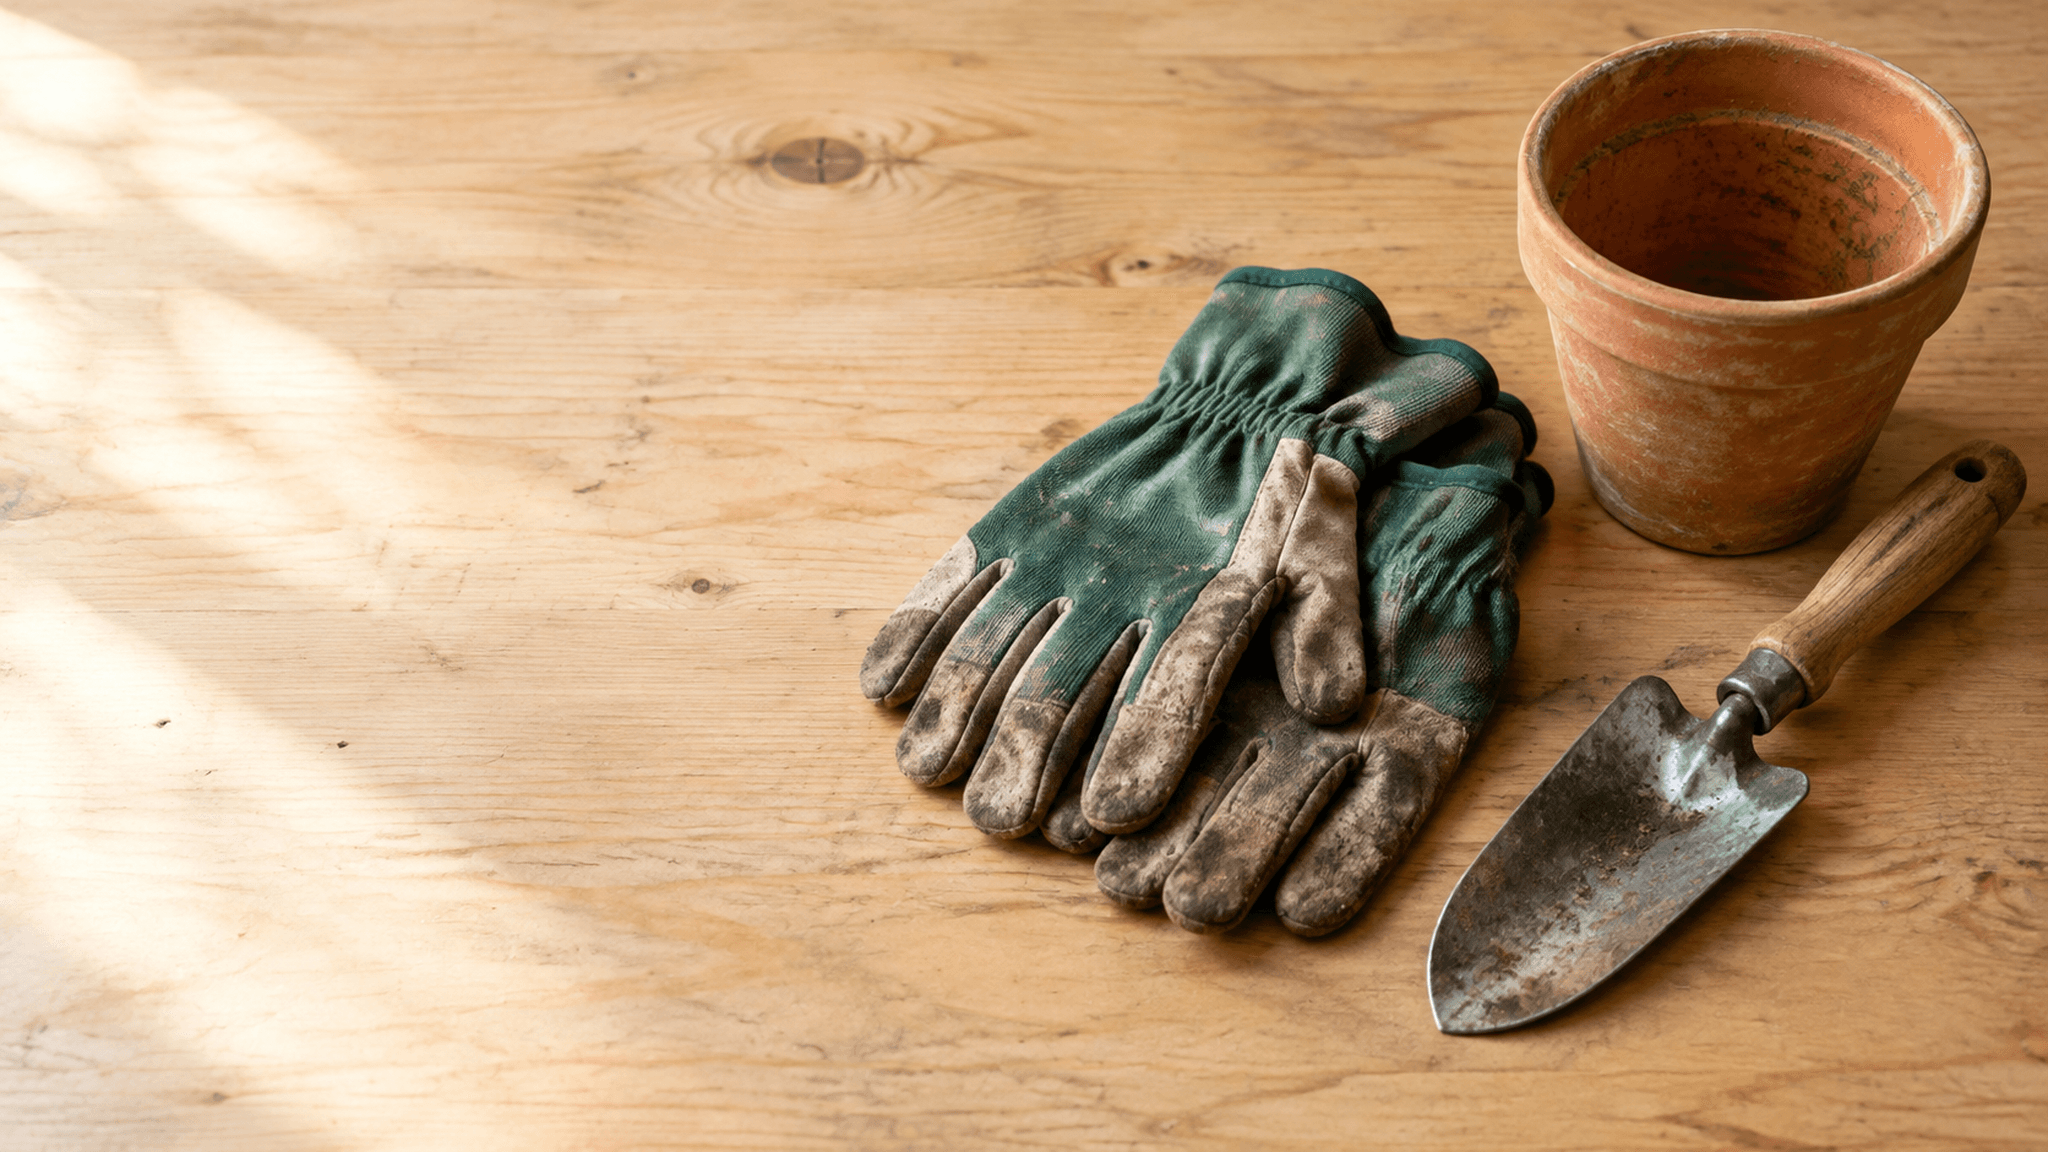
Exemplo de capa de bancada de trabalho mostrando espaço solicitado para manchete à esquerda e objetos à direita
O resultado preserva espaço vazio utilizável à esquerda, mantendo as luvas, o vaso e a colher de jardim à direita.
Verifique o resultado no corte de publicação pretendido. Um master em paisagem pode perder sua região vazia útil quando um cartão móvel corta centralmente. Se a composição falhar, especifique limites de objeto mais restritos ou altere o corte do aplicativo. Não esconda a falha colocando texto sobre os assuntos solicitados.
C. Ilustração de tecido: detalhe e ordem. A próxima solicitação pede 3 amostras dobradas com texturas visíveis distinguíveis. Ela testa contagem, posição e se o resultado suporta uma ilustração explicativa no tamanho que os leitores verão.
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
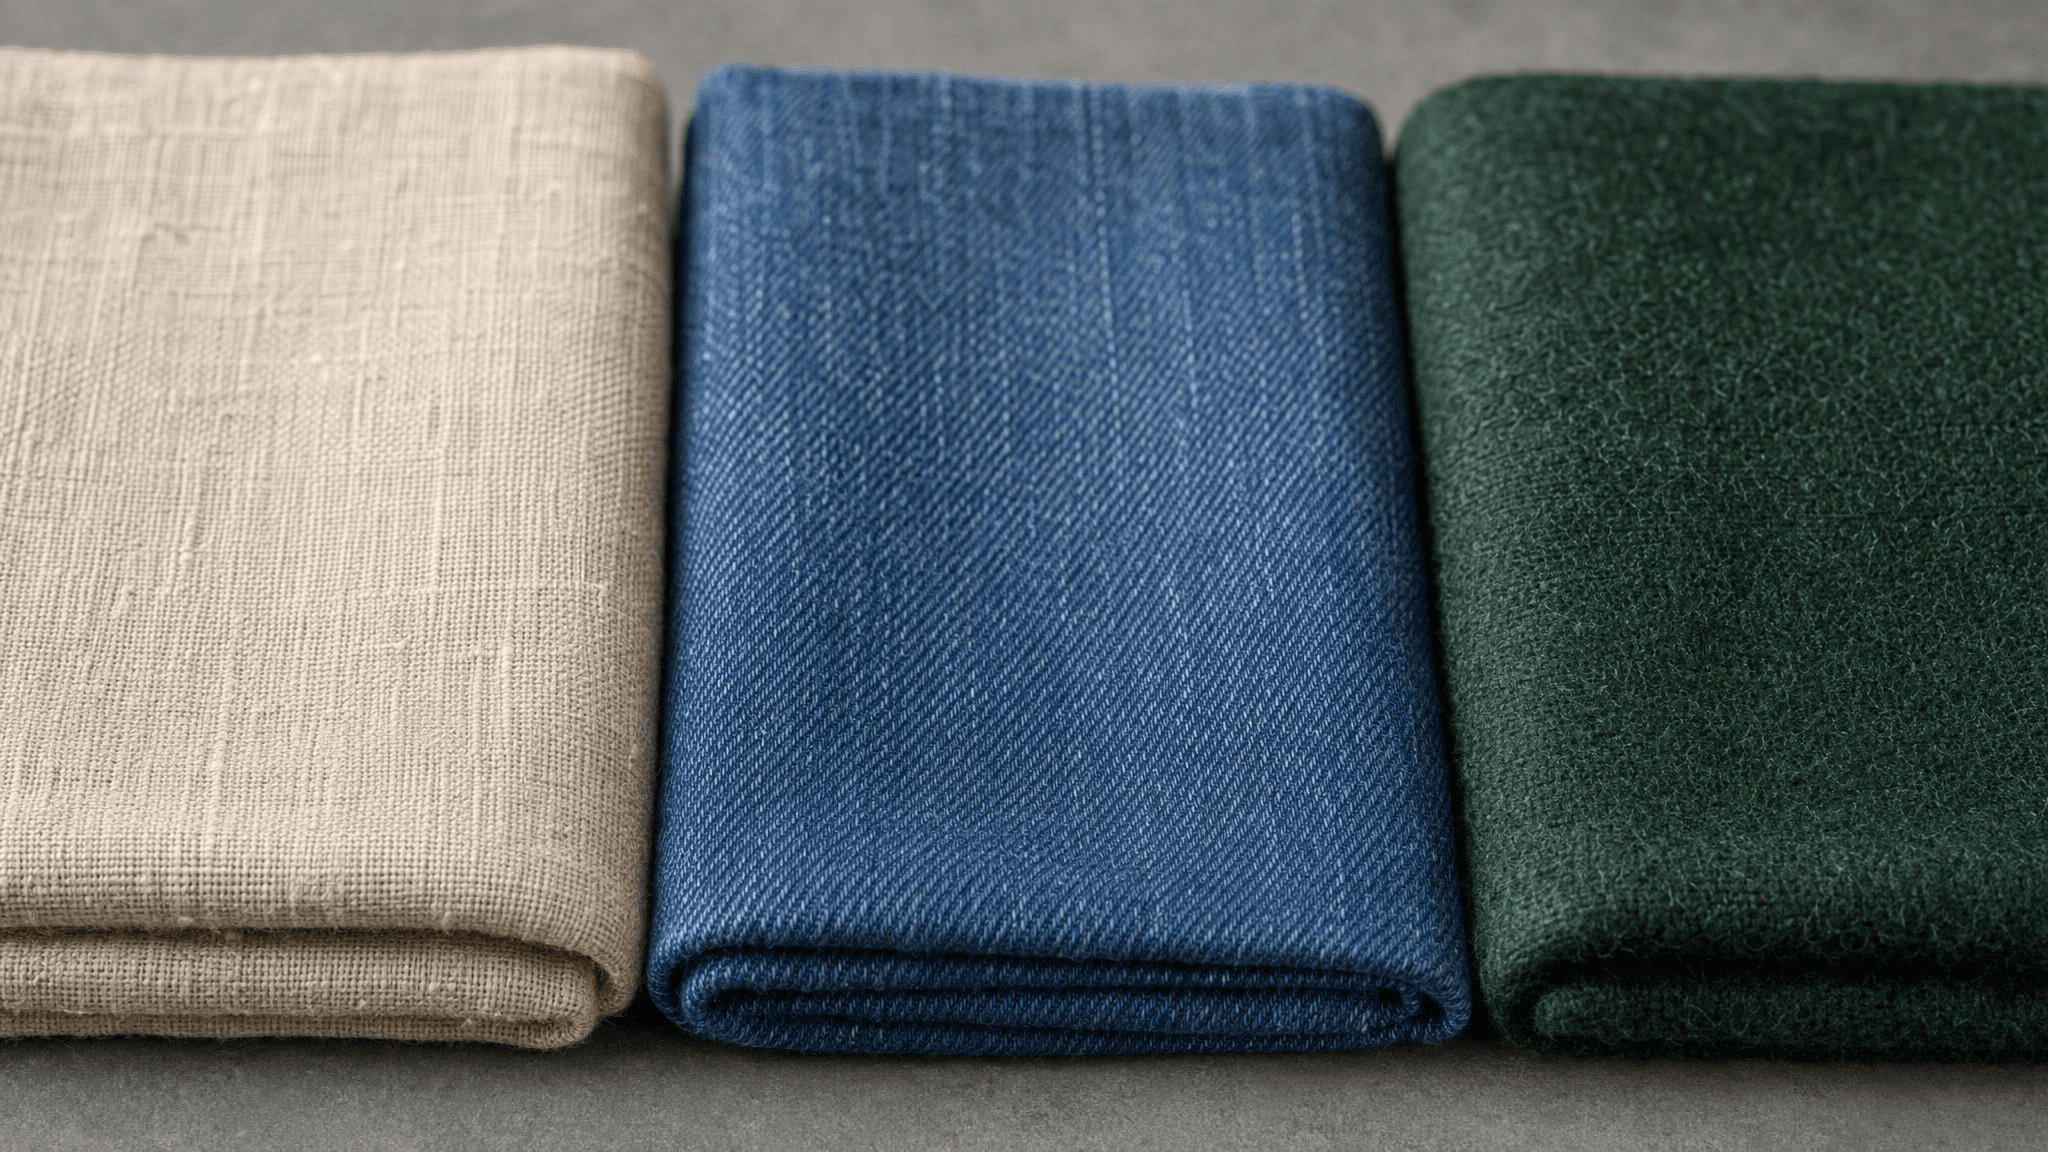
Ilustração de tecido gerada por IA com verificações de posicionamento de amostras bege, azul e verde-escuro
As três amostras solicitadas são visualmente distintas. Esta textura gerada é uma ilustração, não evidência da composição de fibra de um produto real.
Se a amostra central não tiver trama legível, registre esse problema e ajuste o enquadramento ou a instrução de detalhe. Nunca descreva textura gerada como uma propriedade medida de um produto real.
Recursos de texto precisam de verificações igualmente restritas. Para classificação de tickets, rejeite rótulos fora do conjunto permitido e mantenha uma rota incerta. Para extração de documentos, exija campos e intervalos de origem junto com JSON analisável. Uma resposta sintaticamente válida ainda pode colocar o valor errado no campo errado.
API de IA generativa para desenvolvedores: Lidar com falhas
Rastreie sucesso de transporte, conclusão de tarefa e aceitação de negócios separadamente. Uma resposta HTTP bem-sucedida pode conter uma tarefa em processamento. Uma tarefa concluída pode produzir um download quebrado. Uma imagem legível pode violar o briefing. Cada um precisa de uma ação de recuperação diferente.
Defina 3 relógios deliberadamente: um timeout HTTP individual, um intervalo de polling e uma janela de espera geral. Os exemplos usam um timeout de solicitação de API de 30 segundos, polling de 2 segundos e uma janela de polling de 10 minutos. Estas são escolhas do aplicativo, não desempenho de serviço anunciado.
| Sintoma | Causa possível | Verificar em seguida | Abordagem de nova tentativa |
|---|---|---|---|
| Erro de parâmetro | Campo ou valor não suportado | Esquema exato do endpoint e payload enviado | Corrija a solicitação primeiro |
| HTTP 401 | Problema de autenticação ou rota errada | Configuração de chave e caminho do endpoint | Nenhuma nova tentativa inalterada |
| Saldo insuficiente | Saldo disponível ou permissão | Estado de cobrança da conta | Resolva o financiamento ou a permissão primeiro |
| HTTP 429 | Limite de taxa atingido | Concorrência de conta/modelo e taxa de solicitação | Backoff limitado com jitter |
| Tarefa relata falha | Falha de modelo, entrada ou política | ID de previsão, código de erro, detalhe do erro | Investigue antes de nova geração |
| Timeout de polling | Prazo do cliente ou tarefa lenta | Status da tarefa existente | Retome a consulta do mesmo ID |
| Concluído com saída vazia | Resultado ausente ou inesperado | Resposta completa e estruturada do trabalho | Sinalize para investigação; sem reenvio cego |
A documentação atual de erros da plataforma diz que endpoints de LLM e mídia não fornecem cabeçalhos Retry-After ou de limite de taxa restante. Use uma política de atraso do lado do cliente; não faça a recuperação depender de um cabeçalho que essas rotas não retornam. Outras famílias de API podem se comportar de maneira diferente.
Mantenha as novas tentativas automáticas de leitura limitadas. Atrasos exponenciais mais um pouco de jitter aleatório ajudam a evitar que muitos workers tentem novamente juntos. Reduza a concorrência se a limitação persistir. Falhas repetidas devem se tornar um incidente observável em vez de um loop infinito escondido atrás de um spinner.
Novas tentativas de envio merecem tratamento mais rigoroso. Quando uma conexão fecha após você enviar o corpo, você pode não saber se o servidor criou uma tarefa. Registre uma intenção local antes do envio e investigue o histórico de solicitações ou rastros de suporte quando nenhum ID de previsão chegar. Não invente um cabeçalho de idempotência, a menos que o endpoint o documente.
Depois de ter um ID, use-o para retomar. Uma falha de download deve acionar outra tentativa de download ou verificação de status, não outra solicitação de geração de imagem. Os exemplos mantêm deliberadamente o comportamento de nova tentativa automática em leituras de polling e param em um envio falho.
Para cada trabalho, retenha o ID do trabalho do seu aplicativo, ID de previsão, IDs de solicitação, modelo, configurações, timestamps e disposição final. Armazene prompts apenas sob uma política de dados apropriada. Nunca coloque cabeçalhos de autorização ou conteúdo sensível do usuário em logs de erro gerais.
Dê ao frontend estados que ele possa explicar: preparando, processando, verificando saída, pronto ou precisa de atenção. Mostre um trabalho recuperável quando alguém recarregar a página. Desabilite o envio repetido enquanto o mesmo trabalho local estiver pendente, ainda permitindo uma nova solicitação intencional quando apropriado.
API de IA generativa para desenvolvedores: Custos reais
Um preço baixo por solicitação não informa o custo de um recurso utilizável. Seu orçamento precisa do valor cobrado, do número de saídas aceitas e do trabalho de suporte necessário para entregá-las.
APIs de texto comumente distinguem tokens de entrada e saída. Contexto longo, passagens recuperadas, histórico de conversa e respostas repetidas podem contribuir para o uso. Registre as categorias que o endpoint escolhido realmente cobra em vez de aplicar uma única estimativa de token a cada carga de trabalho.
Para imagens, inspecione a unidade de cobrança e a configuração do modelo exato. Tamanho e qualidade podem afetar a cobrança de maneira diferente entre modelos. Para vídeo, duração, resolução e escolha do modelo podem alterar a cobrança. Não transforme o preço inicial de um catálogo em uma cotação para uma configuração específica.
O preço exato de alta qualidade, 2048 × 1152, do modelo de imagem selecionado não foi verificado tanto no catálogo quanto na página de detalhes durante a pesquisa deste artigo. Nenhum preço unitário atual ou desconto é afirmado aqui. Confirme-o antes de executar uma avaliação de produção paga.
Use 2 cálculos relacionados:
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
Mantenha o período de observação consistente. Para armazenamento contínuo, declare se o cálculo cobre o primeiro mês, um período de retenção definido ou um custo recorrente alocado. Evite comparar o número apenas de inferência de um modelo com o custo totalmente carregado de outro fluxo de trabalho.
Exemplo hipotético: você envia 100 solicitações e aceita 80 saídas. Divida a cobrança total real desse lote por 80. Se todas as 100 solicitações fossem cobradas um valor idêntico c, o custo de API por saída aceita seria 1.25c. Essa condição é importante: ela não assume que toda solicitação falha é cobrada.
| Modelo | Configurações | Envios | Cobrança real | Saídas aceitas | Custo de API por saída aceita | Data de medição |
|---|---|---|---|---|---|---|
| GPT Image 2 Text-to-Image | high; 2048x1152; PNG | A registrar | A registrar | A registrar | A calcular | A registrar |
| Mesmo modelo, próximo lote de avaliação | Registrar configurações exatas | A registrar | A registrar | A registrar | A calcular | A registrar |
Use isto como uma planilha, não como uma tabela de resultados. As demonstrações de imagem não estabelecem uma taxa de aceitação representativa ou custo de produção. Mantenha cotações do playground separadas de registros de cobrança liquidados, especialmente ao avaliar em um ambiente de teste.
Quando as saídas aceitas forem iguais a zero, relate o lote como malsucedido e mostre o gasto total. Uma proporção de custo por saída aceita é indefinida nesse caso. Ocultar lotes com falha faria seu orçamento parecer melhor do que o aplicativo se comporta.
Reduza o desperdício primeiro: valide entradas antes do envio, salve IDs de trabalhos, evite duplicatas acidentais e reutilize ativos aceitos quando o produto permitir. Em seguida, compare configurações mais baratas nos mesmos briefings e verificações. Uma configuração que reduz a cotação, mas dobra o trabalho de rejeição, pode aumentar o custo do recurso.
Teste a saída, não apenas a resposta
Escreva critérios de aceitação enquanto redige o prompt. Isso evita que uma imagem convincente mude sua definição de sucesso depois do fato. Mantenha requisitos rígidos separados de preferências opcionais e registre por que um revisor rejeitou um resultado.
Automatize as verificações que têm respostas mecânicas claras: sucesso de download, decodificação de arquivo, formato, dimensões e limites de tamanho de arquivo. Para JSON, valide o esquema, campos obrigatórios, rótulos permitidos e tipos. Um campo obrigatório ausente não deve se tornar silenciosamente um padrão inventado.
Use revisão humana para requisitos que precisam de interpretação. No exemplo do café da manhã, um revisor deve distinguir fatias sobrepostas, identificar a faca, avaliar sua posição e procurar objetos extras. Um verificador de visão automatizado pode auxiliar, mas avalie seus erros antes de deixá-lo aprovar resultados sozinho.
A revisão do café da manhã deve incluir as seguintes verificações independentes:
- Exatamente 2 fatias de torrada, 1 prato branco, 1 tigela de geleia transparente e 1 faca.
- Faca à direita do prato; objetos necessários totalmente no quadro.
- Sem xícaras, pratos, mãos, embalagens ou marcas visíveis extras.
- PNG legível nas dimensões solicitadas.
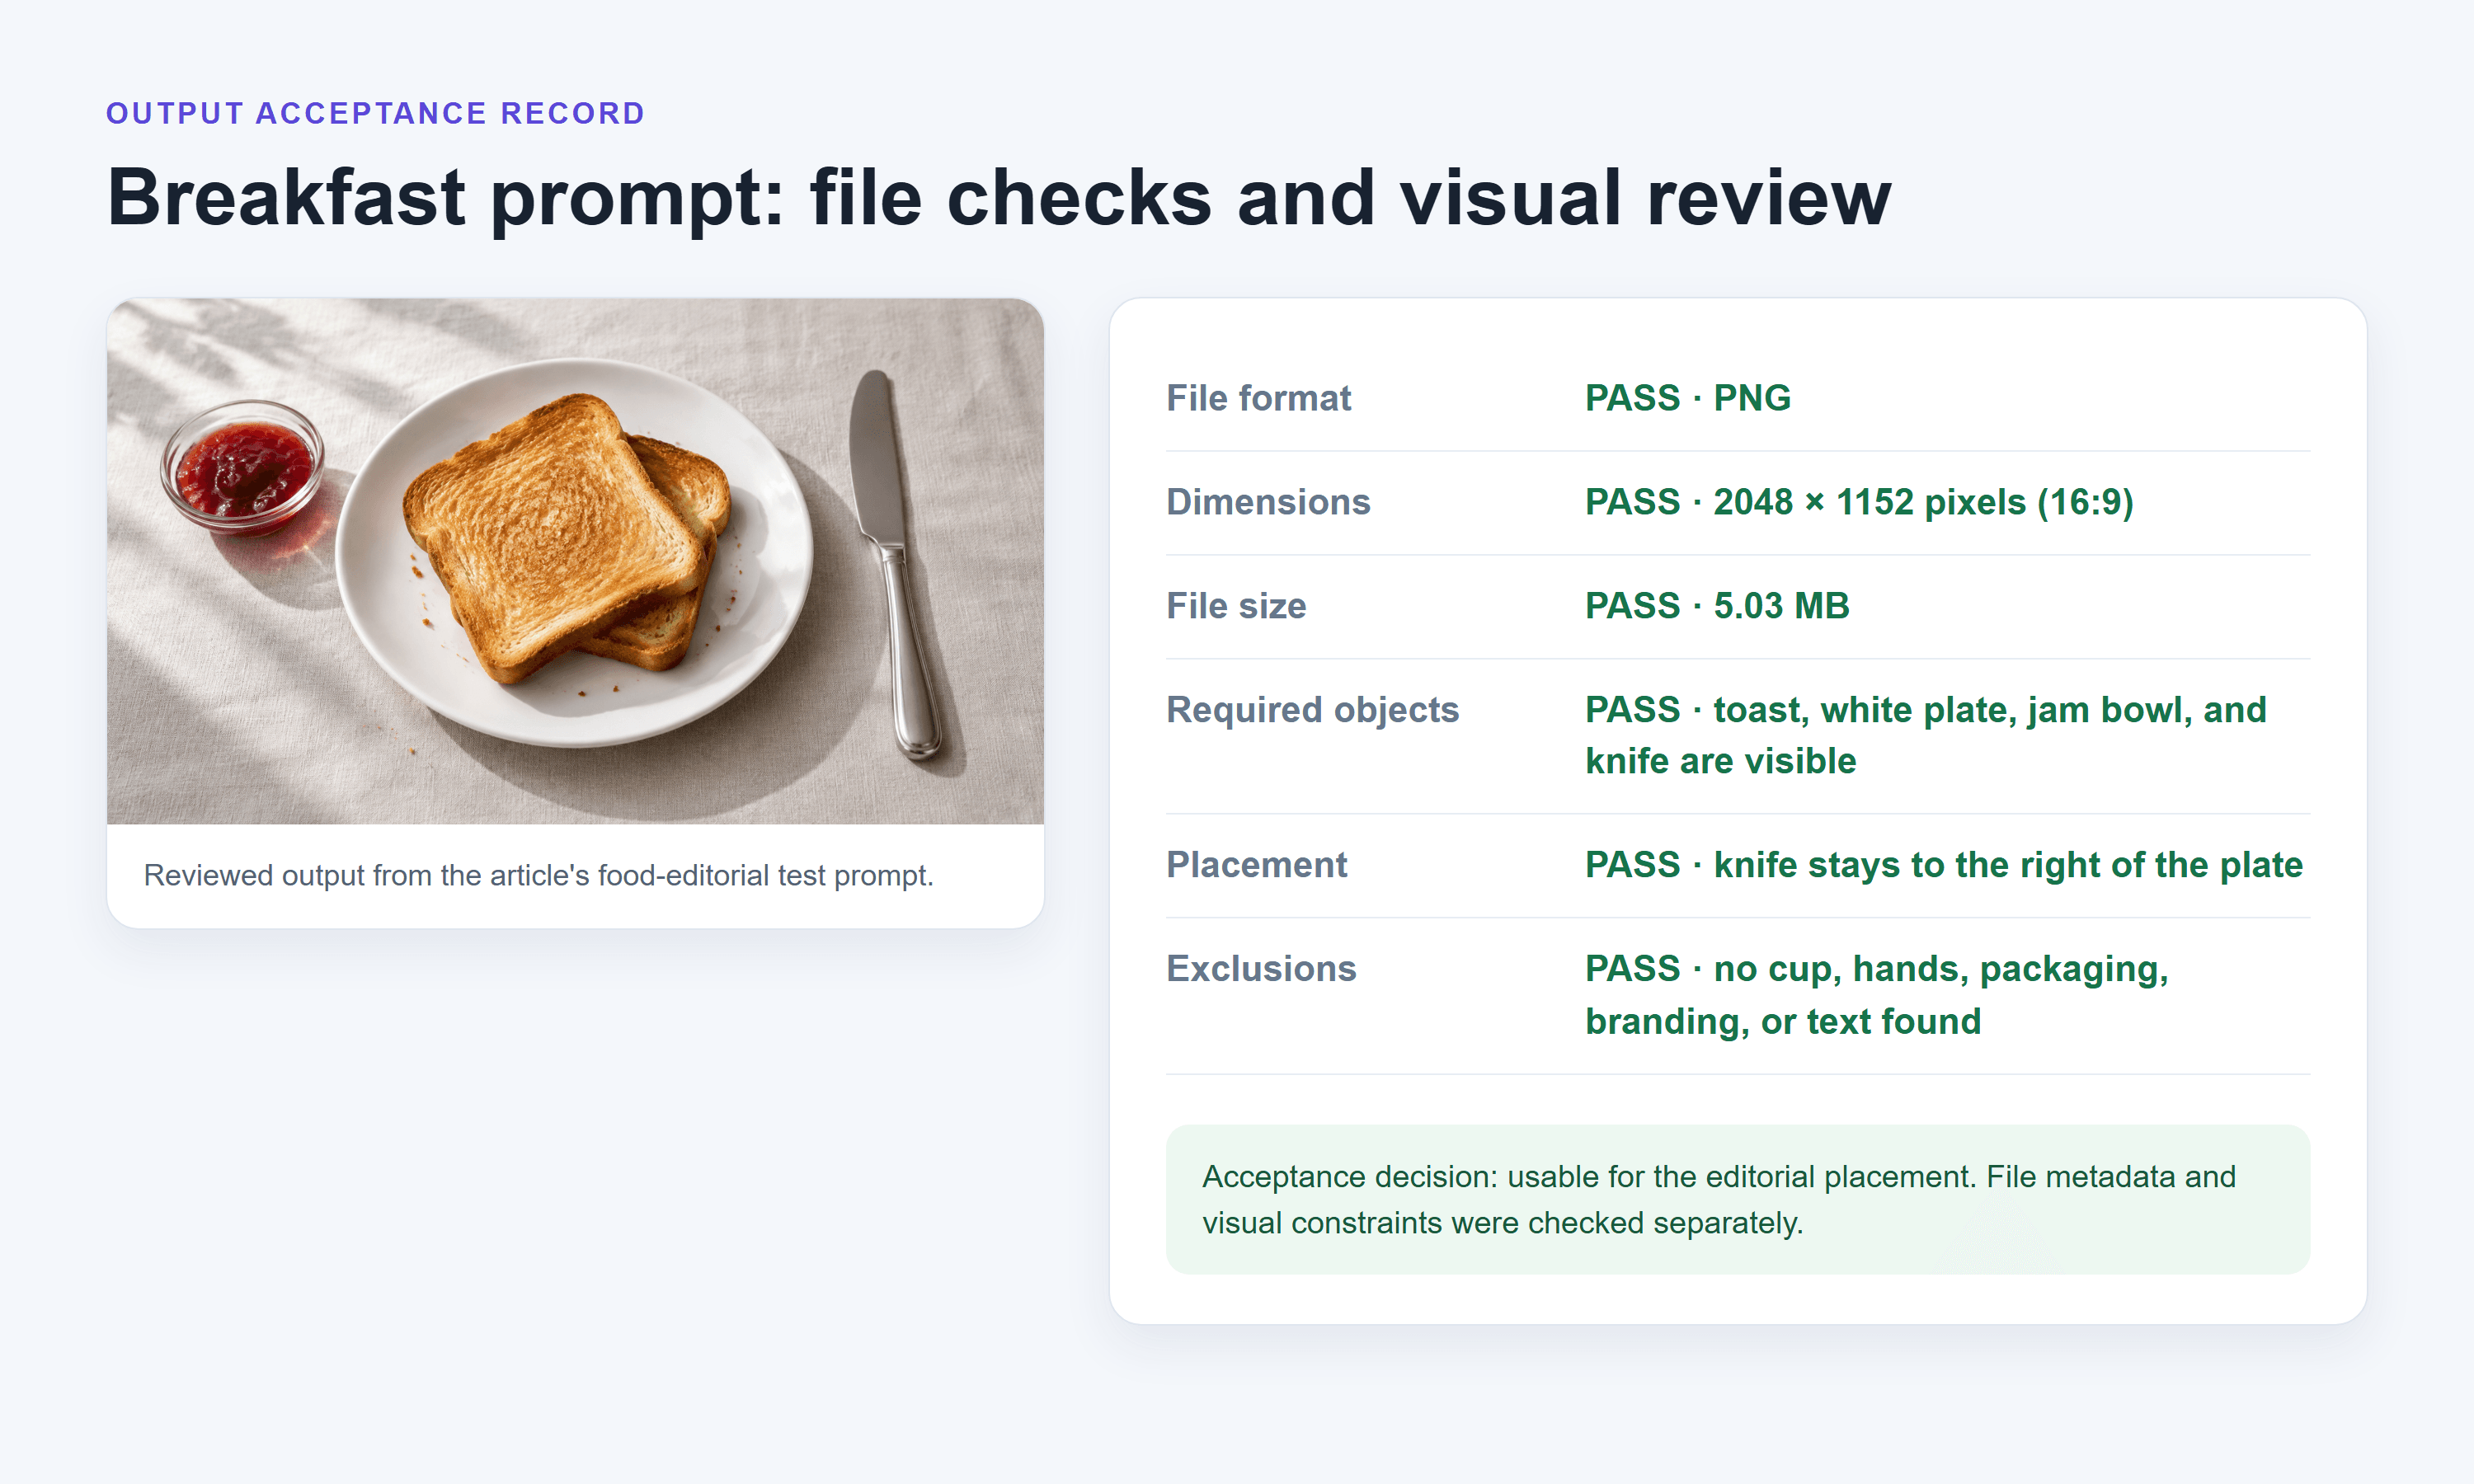
Registro de validação separando verificações de metadados de arquivo de verificações de aceitação visual
O registro relata as dimensões e o tamanho reais do arquivo gerado separadamente de suas verificações de aceitação visual.
Construa um conjunto de regressão fixo a partir do recurso real: solicitações comuns, composições lotadas, instruções conflitantes, cortes difíceis e limites de entrada relevantes. Versione os briefings e as regras do revisor. Repita-os ao alterar o modelo, o template de prompt ou as configurações de saída.
Relate sucesso técnico e taxa de saída aceita separadamente. Um arquivo legível que contém um objeto extra conta como uma entrega bem-sucedida e uma rejeição de conteúdo. Combinar esses resultados em um único número de sucesso oculta a correção que sua equipe precisa.
A pesquisa de desenvolvedores de 2025 descobriu que 46% desconfiavam da precisão das ferramentas de IA e 33% confiavam nelas; 3% relataram alta confiança. Essas respostas dizem respeito a ferramentas de IA em fluxos de trabalho de desenvolvimento, não a uma taxa de falha medida para APIs de geração. (Stack Overflow Developer Survey, 2025.)
Da mesma forma, 3 execuções ilustrativas não podem estabelecer precisão geral ou uma latência p95 útil. Colete uma amostra maior e relevante nas condições que você espera em produção e retenha valores discrepantes. Use as demonstrações para desenvolver as verificações e, em seguida, use a avaliação sistemática para tomar uma decisão de lançamento.
Uma lista de verificação de produção antes de enviar
A primeira solicitação funcional resolve apenas uma pequena parte da decisão de lançamento. Seu aplicativo também deve conter gastos, recuperar trabalhos inacabados e explicar o que aconteceu quando nenhum resultado está disponível.
Proteja o acesso. Mantenha credenciais no backend, separe ambientes, restrinja o acesso a registros de trabalhos e planeje a rotação de credenciais. Autorize cada solicitação de status e download em relação ao usuário que possui esse trabalho. Um ID de tarefa impossível de adivinhar não substitui verificações de permissão.
Limite entradas e uso de recursos. Valide comprimento do prompt, tipo e tamanho do upload, configurações de saída solicitadas e combinações suportadas. Para mídia baixada, imponha destinos permitidos, redirecionamentos, limites de bytes e limites de decodificação. Os scripts compactos acima ilustram o ciclo de vida; eles não são um serviço público de download reforçado.
Defina orçamentos antes do envio. Defina limites por usuário e por tarefa, máximo de trabalhos simultâneos e quem pode solicitar configurações mais caras. Reserve orçamento enquanto o trabalho estiver pendente para que solicitações simultâneas não possam todas passar pela mesma verificação de saldo restante.
Persista o estado. Escreva o trabalho local antes de chamar o provedor. Salve o ID de previsão retornado imediatamente e torne o polling retomável após uma reinicialização do processo. Se o status do envio for desconhecido, use um estado de investigação em vez de dizer aos usuários que o trabalho definitivamente falhou.
Assuma a propriedade do ativo entregue. Decida onde os arquivos aceitos ficam, quem pode acessá-los e quando expiram. Verifique o tempo de vida do link do provedor e os termos de retenção em vez de depender indefinidamente de uma URL de saída temporária. Inclua a exclusão de arquivos derivados no fluxo de dados do aplicativo.
Torne a falha compreensível. Distinga uma tarefa atrasada, um resultado rejeitado e um erro de serviço. Ofereça uma rota clara para tentar novamente intencionalmente ou solicitar revisão. Preserve o briefing do usuário para que a recuperação não exija reconstruir o trabalho.
Monitore mudanças. Acompanhe conclusão, aceitação, custo e tempo de espera separadamente. Execute novamente o conjunto de regressão após alterações de modelo ou parâmetros e mantenha a configuração anterior disponível quando viável. Redija logs sensíveis e atribua períodos de retenção tanto para conteúdo quanto para registros operacionais.
Para avaliar a plataforma de exemplo para seu próprio aplicativo, comece com o catálogo de modelos da Atlas Cloud, depois leia a documentação do endpoint selecionado e de previsão. Escolha uma tarefa, defina a aceitação e registre o que a avaliação realmente entrega antes de expandir o acesso.
Perguntas frequentes
Qual API de IA generativa devo escolher para meu aplicativo?
Escolha com base nas entradas, saídas, tempo de espera aceitável e requisitos de revisão do recurso. Execute os mesmos briefings representativos nos candidatos que você pode usar legal e operacionalmente. Compare o custo de saída aceita e o trabalho de integração junto com as capacidades. Não há escolha universal estabelecida por estes 3 exemplos de imagem.
Existem APIs de IA generativa gratuitas para desenvolvedores?
Alguns serviços oferecem testes ou uso gratuito limitado, mas disponibilidade, elegibilidade, cotas e usos permitidos mudam. Verifique os termos atuais para o endpoint exato. Uma permissão gratuita de ferramenta de consumo não inclui necessariamente acesso à API. A auto-hospedagem também usa hardware, eletricidade e tempo de engenharia, mesmo quando os pesos do modelo são baixáveis.
Preciso de experiência em aprendizado de máquina para usar uma API de IA generativa?
Você pode começar com HTTP, JSON, autenticação e habilidades comuns de desenvolvimento backend. Entregar um recurso confiável também requer avaliação e trabalho operacional. Você precisa entender as limitações do modelo bem o suficiente para definir uma saída aceitável, sem necessariamente treinar um modelo você mesmo.
Uma API pode lidar com texto, imagens e vídeo?
Uma plataforma pode fornecer todos os 3, mas cada capacidade pode usar endpoints, parâmetros, tipos de saída e padrões de espera diferentes. Verifique cada interface separadamente. Uma conta ou credencial compartilhada não torna um corpo de solicitação de texto compatível com um modelo de imagem ou vídeo.
Por que minha solicitação de imagem retorna um ID de tarefa em vez de uma imagem?
O endpoint envia o trabalho de forma assíncrona. Salve o ID e consulte a rota de status documentada. Recupere o arquivo quando a tarefa for concluída e valide-o. Se seu cliente parar de esperar, o trabalho do lado do servidor ainda pode estar em execução; retome esse trabalho antes de enviar outro.
Como posso reduzir os custos da API sem quebrar o fluxo de trabalho?
Evite envios duplicados, valide entradas antecipadamente, reutilize ativos aceitos quando apropriado e teste configurações mais baratas com critérios de aceitação inalterados. Meça as cobranças reais por resultado aceito. Uma API de IA generativa para desenvolvedores conquista seu lugar quando o aplicativo ao redor pode entregar trabalho utilizável a um custo que você pode sustentar.


