Uma API de IA para geração em lote é útil quando cada saída pode ser encontrada, revisada e repetida individualmente. Isso importa mais do que quantos prompts você envia de uma vez. O momento custoso não é a requisição número 1.000. É quando a tarefa 37 expira, a tarefa 38 é bem-sucedida, dois arquivos compartilham um nome e ninguém consegue dizer qual imagem é segura para publicar.
Trate um lote como uma coleção de jobs de ativos recuperáveis. Dê a cada job um ID de negócio durável, salve a entrada exata e as configurações do modelo, limite a concorrência e repita apenas o item que realmente falhou. Este guia usa um fluxo de trabalho de campanha de personagem com 8 ativos para que uma equipe de desenvolvimento ou crescimento possa transformar um manifesto em uma execução de produção controlada.
Principais conclusões
- Um job em lote e requisições paralelas resolvem problemas diferentes de latência e controle.
- IDs de ativo estáveis e chaves de idempotência tornam a falha parcial administrável.
- Comece com 4 a 8 ativos visuais, revise-os e depois expanda.
- Uma resposta bem-sucedida da API ainda precisa de revisão visual e de direitos antes da publicação.
API de IA para geração em lote: a resposta primeiro
Uma API de IA para geração em lote envia um conjunto de tarefas de geração distintas para uma fila assíncrona e, em seguida, retorna seus resultados por meio de verificações de status, um callback de conclusão ou um arquivo de saída para download. Cada tarefa precisa de uma identidade que exista fora do provedor do modelo. O ID de job do provedor ajuda nas operações, mas maya-ridgeline-001 é o que permite ao seu sistema editorial ou de campanha identificar o ativo meses depois.
Não misture três ideias relacionadas. Um único prompt pode solicitar várias variações. Seu próprio worker pode enviar várias requisições normais ao mesmo tempo. Um job em lote do lado do servidor é uma coleção gerenciada pelo provedor que é concluída mais tarde. Este último costuma se adequar a trabalhos offline, enquanto requisições paralelas controladas se adequam a um painel que precisa de progresso imediato.
A documentação atual da Batch API da OpenAI ilustra o padrão assíncrono: as requisições são coletadas em JSONL, enviadas como um job, verificadas quanto à conclusão e recuperadas como resultados. Sua janela de 24 horas, seus limites de taxa de lote separados e seus limites são específicos desse serviço, não uma promessa que todo provedor de imagens faz (documentação da Batch API da OpenAI, setembro de 2026). A referência atual do Gemini também documenta jobs em lote de longa duração, verificações de status e suporte a webhook para seu serviço (referência da Batch API do Gemini, setembro de 2026).
| Ponto de decisão | API em lote | Requisições paralelas controladas |
|---|---|---|
| Resposta esperada | Conclusão adiada | Cada requisição retorna conforme termina |
| Melhor para | Trabalho offline de catálogo, storyboard e biblioteca de conteúdo | Ferramentas interativas e ciclos curtos de revisão |
| Tratamento de falhas | Ler resultados por item após a conclusão de um job | Tratar cada requisição filha conforme ela é concluída |
| Custo e limites | Regras de lote específicas do provedor podem diferir do tráfego em tempo real | Usa os limites comuns de requisições da conta |
| Registro essencial | ID de ativo, ID de requisição, estado do resultado, local da saída | Os mesmos campos, mais o estado da tentativa em andamento |
Escolha requisições paralelas controladas quando um revisor precisar ver a primeira imagem utilizável rapidamente. Escolha um job em lote do lado do servidor quando o trabalho puder esperar e o provedor documentar um caminho de lote. Em qualquer caso, armazene asset_id, entrada normalizada, hash de referência, modelo, contagem de tentativas e URL de saída. Essa camada comum mantém o fluxo de trabalho portátil se o mecanismo de entrega mudar.
Por que projetos de imagens em lote falham em escala
Lotes de produção geralmente falham em partes. Uma requisição pode ser concluída, expirar, ser rejeitada ou retornar uma saída tecnicamente válida, mas visualmente inutilizável. Um aplicativo que registra apenas uma URL final descartou as informações necessárias para recuperar todos os casos, exceto o de sucesso mais simples.
A primeira falha é a identidade ausente. Se a requisição carrega apenas uma string de prompt, uma saída não pode ser mapeada de forma confiável de volta para um produto, uma localidade de campanha ou uma linha de origem. Nomes de arquivo derivados do prompt são frágeis porque revisões de prompt e produtos repetidos colidem. Use um ID de ativo estável do registro de negócio e, em seguida, dê a cada tentativa de geração seu próprio sufixo.
A segunda falha é repetir sem idempotência. Um timeout de rede não prova que o provedor não fez nenhum trabalho. Se um worker reenviar imediatamente o mesmo ativo com uma nova identidade de requisição, ele pode criar saídas duplicadas e cobranças duplicadas. Uma chave de idempotência permite que o chamador diga, na prática, "este ainda é o mesmo ativo solicitado". Se um endpoint específico oferece suporte a esse mecanismo depende do provedor, então confirme isso na documentação da API antes de depender dele.
A terceira falha é uma fila cega de 40 ou 60 prompts. Um desvio de cor, composição ou identidade de produto pode se tornar visível apenas depois que a execução termina. Uma discussão recente de criadores descreve a revisão de páginas de storyboard de cerca de 7 a 8 imagens antes de enviar a próxima página, especificamente para detectar erros de precisão e consistência (discussão sobre geração de imagens em lote, junho de 2026). Isso é experiência da comunidade, não um benchmark, mas é um ponto de verificação operacional sensato.
Use uma regra de QC em pequenos lotes: execute 4 a 8 ativos, inspecione-os, repare o prompt ou a referência se necessário e então libere o próximo grupo. Mantenha o prompt original, a versão do prompt, a referência de entrada, a revisão do modelo quando disponível, a configuração de qualidade, a proporção, os timestamps, a classe de erro e a decisão de revisão. Uma URL sozinha não consegue responder por que um ativo existe ou se ele deve ser reutilizado.
Projete uma API de IA confiável para geração em lote
A implementação pode ser pequena. Um manifesto, um worker de fila, um registro de job somente de acréscimo e uma pasta de saída amigável para revisores são suficientes para começar. O objetivo não é um grande sistema de orquestração. É um fluxo de trabalho em que uma pessoa pode responder: o que foi solicitado, o que aconteceu e o que deve ser executado em seguida?
Dê a cada saída de lote uma identidade de ativo durável
Faça de asset_id uma chave de negócio, não um ID de job do provedor. Um registro de tarefa útil pode incluir os campos abaixo. Mantenha-o em um banco de dados quando vários workers operarem, ou em um CSV versionado mais um log JSONL para uma equipe menor.
| Campo | Por que existe |
|---|---|
asset_id | Identidade imutável do ativo publicável |
source_row | Mapeia de volta para o produto, a campanha ou o registro de conteúdo |
prompt_version | Mostra qual template de instrução produziu o resultado |
reference_hash | Confirma qual imagem de origem bloqueada foi usada |
model, aspect_ratio, quality | Torna a execução reproduzível o suficiente para diagnosticar |
attempt, idempotency_key, status | Separa uma nova tentativa de job filho de uma nova requisição |
output_url, review_status, failure_reason | Conecta entrega e aceitação humana |
Por exemplo, maya-train-001 permanece a identidade do ativo. maya-train-001-a2 é a tentativa 2. A chave de idempotência pode ser maya-train-001-v1, em que v1 identifica a especificação imutável solicitada. Se o briefing mudar de forma relevante, crie uma nova versão de prompt em vez de sobrescrever o registro antigo.
Use uma fila de lote, não um loop ilimitado
Defina um teto de concorrência, um limite de contagem de ativos, uma salvaguarda monetária e um limite de tentativas antes do despacho. Uma configuração inicial prática é 4 jobs em andamento, no máximo 2 tentativas de geração por job e não mais de 8 tarefas visuais antes do próximo portão de qualidade. Esses são valores iniciais, não garantias da plataforma. Defina-os abaixo dos limites documentados da sua conta e ajuste após observar tempos reais de conclusão e taxas de erro.
O worker deve reivindicar uma tarefa pendente, marcá-la como submitted, armazenar o ID de requisição do provedor e atualizar esse mesmo registro quando um resultado chegar. Quando um limite de orçamento for atingido, pare de reivindicar trabalho. Quando a fila for pausada para revisão, permita que o trabalho já enviado seja concluído, mas não libere outro grupo automaticamente.
Repita apenas o job filho que falhou
Repita estados failed, timed_out ou estados repetíveis específicos do provedor, um ativo por vez. Use backoff exponencial limitado com jitter para respostas 429, respostas 5xx transitórias e timeouts de transporte genuínos. Armazene a classificação do erro e o horário agendado para a nova tentativa. Não repita automaticamente uma recusa por política de conteúdo, entrada malformada, referência ausente ou rejeição visual de um revisor humano.
Nunca reenvie um lote inteiro porque um filho falhou. Arquive resultados bem-sucedidos imediatamente e preserve o mapeamento de origem para saída. Se um job em lote expirar com resultados parciais, consuma os filhos concluídos, identifique os IDs de ativos não finalizados e crie um novo job contendo apenas esses registros restantes. Essa é a diferença entre recuperação e duplicação.
Um fluxo copiável de lote de imagens com 8 ativos
O exemplo a seguir é deliberadamente fictício: Maya, uma fotógrafa de viagem adulta em um trabalho em terras altas. Ele torna a mecânica operacional concreta sem sugerir que uma pessoa real endossou a campanha. Substitua os campos pelos seus próprios dados permitidos de personagem, autorização de imagem ou campanha e mantenha a estrutura.
Etapa 0: Crie o manifesto antes de gerar
Crie batch-manifest.csv antes de abrir um playground ou chamar um endpoint. Ele dá ao operador uma meta de aceitação clara para cada ativo.
| asset_id | batch | use_case | ratio | status |
|---|---|---|---|---|
| maya-master-001 | master | referência canônica de personagem | 16:9 | pendente |
| maya-ridgeline-001 | a | imagem de campanha da crista ao nascer do sol | 16:9 | pendente |
| maya-market-001 | a | imagem editorial de mercado na montanha | 16:9 | pendente |
| maya-cabin-001 | a | imagem editorial de planejamento na cabana | 16:9 | pendente |
| maya-lake-001 | a | imagem de anotações de campo à beira do lago | 16:9 | pendente |
| maya-forest-001 | b | imagem de campanha de trilha na floresta | 16:9 | pendente |
| maya-train-001 | b | imagem editorial de viagem de trem | 16:9 | pendente |
| maya-workbench-001 | b | imagem de preparação do kit de campo | 16:9 | pendente |
| maya-portrait-001 | b | imagem de campanha de retrato aproximado | 16:9 | pendente |
Gere uma chave de idempotência determinística para cada requisição imutável, como maya-ridgeline-001-v1. O formato abaixo é neutro em relação ao provedor de propósito. Coloque o endpoint do provedor e seus parâmetros documentados dentro de request; não copie um endpoint privado fictício para produção.
plaintext1{"asset_id":"maya-ridgeline-001","idempotency_key":"maya-ridgeline-001-v1","request":{"model":"your-approved-model","ratio":"16:9","reference_hash":"sha256:...","prompt_version":"maya-highlands-v1"}}
Etapa 1: Crie uma referência canônica de personagem
Gere a imagem mestra separadamente. Ela é a âncora de identidade para cada cena posterior, então merece uma breve revisão antes que qualquer lote comece. No playground do GPT Image 2, selecione High quality e 16:9, depois use este prompt:
plaintext1Editorial portrait of Maya, a fictional adult travel photographer in her early thirties, with short wavy dark-brown hair, warm olive complexion, a weathered rust-orange field jacket over a charcoal knit top, and a compact black camera on a woven shoulder strap. She stands three-quarter length against a softly lit pale-stone studio backdrop, facing slightly right with a calm, observant expression. Soft window light from the upper left, realistic subtle shadow, no logo, no text, no other people, no duplicated hands or camera. Clean cinematic campaign composition with negative space on both sides.
Mantenha uma imagem que mostre claramente o rosto, o cabelo, a jaqueta, a alça da câmera e um par completo de mãos da Maya, sem texto ou pessoa duplicada. Salve-a como maya-master-001.png, calcule um hash de referência e anexe essa mesma origem aos jobs filhos subsequentes. Não coloque esta etapa em lote. Uma referência mestra fraca multiplica a ambiguidade em todas as cenas.
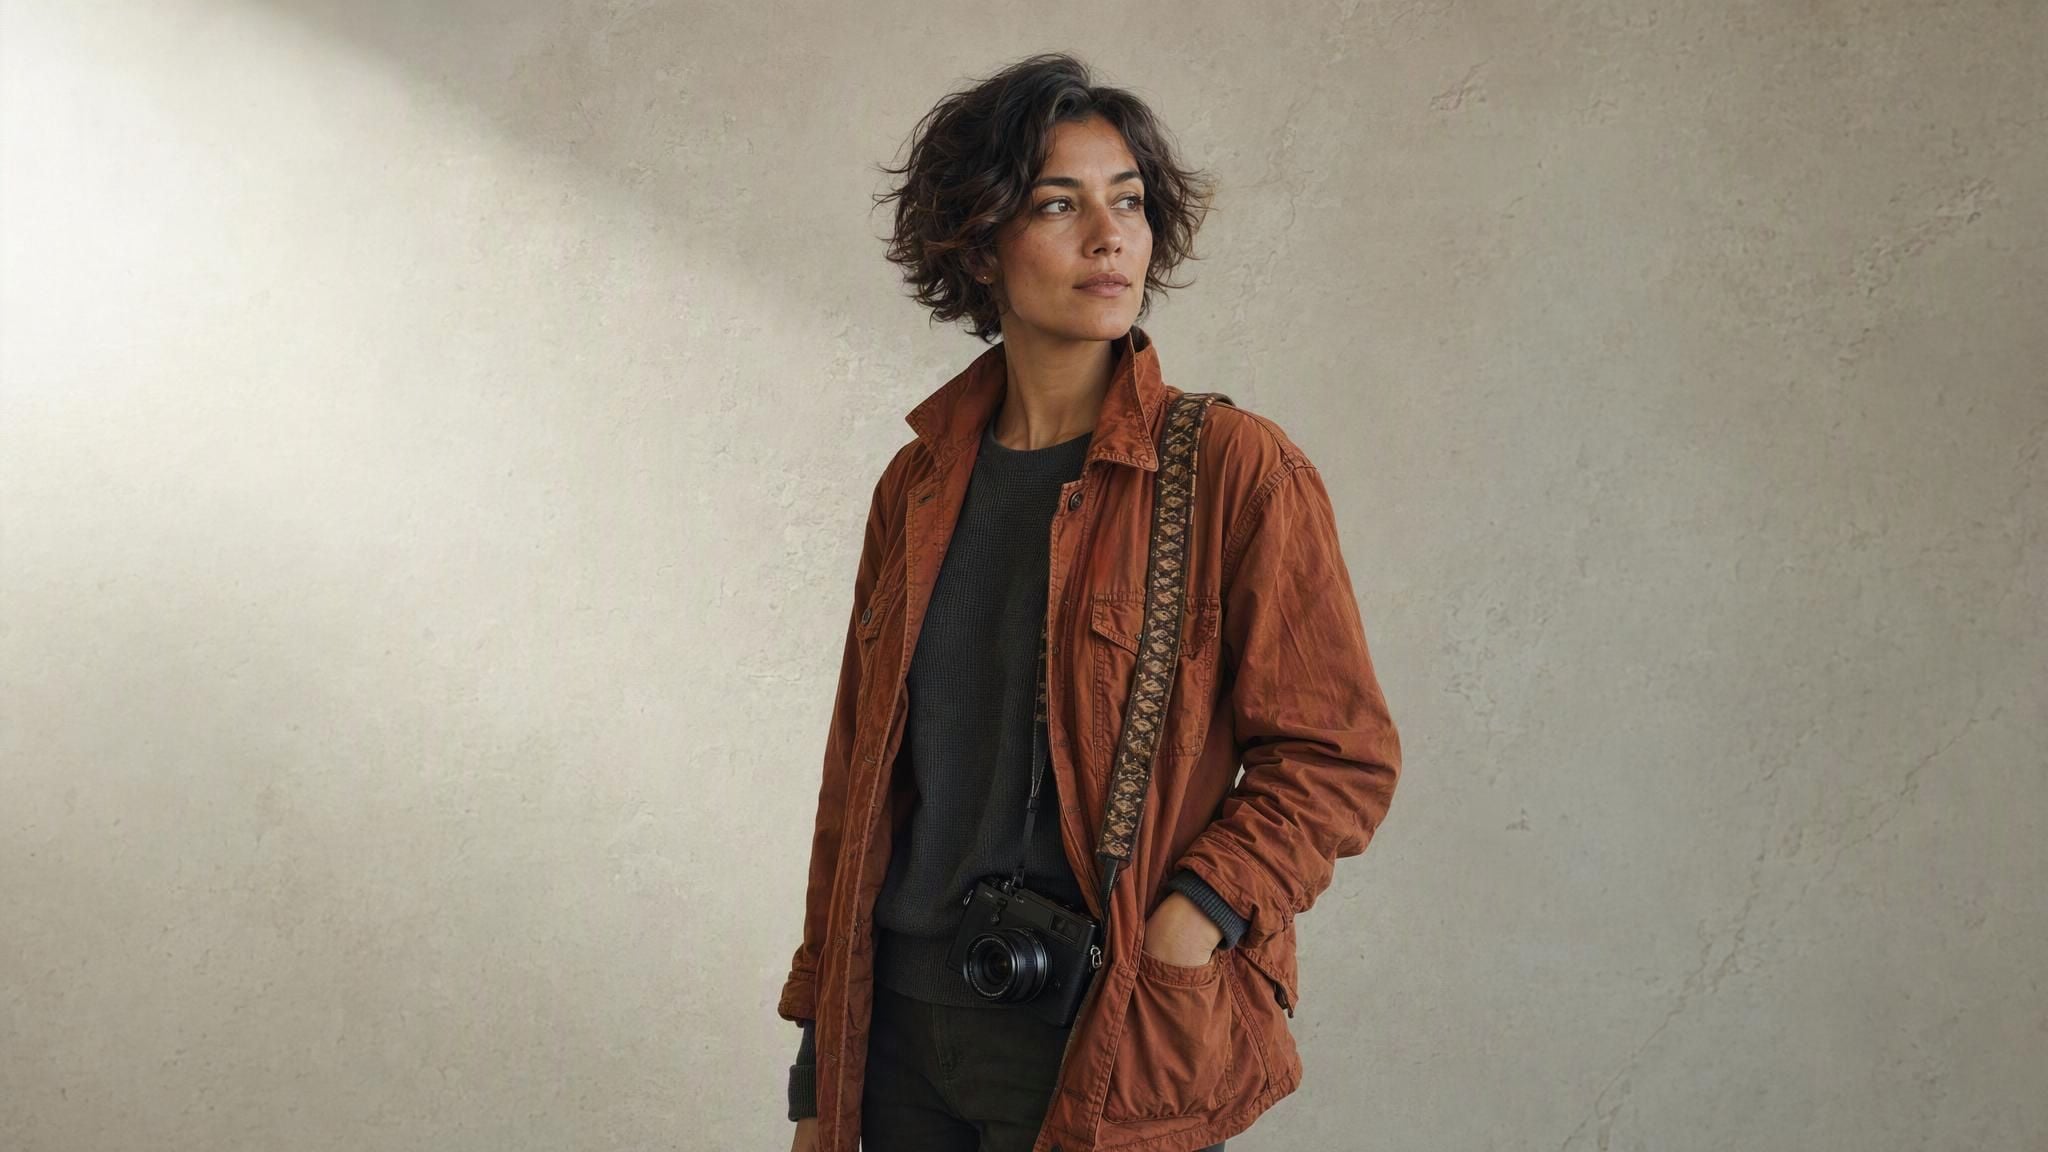
Demonstração do recurso para API de IA para geração em lote: o prompt de referência de personagem da Maya ao lado do retrato gerado da fotógrafa de viagem
Uma execução real de referência mestra do GPT Image 2: o prompt estabelece a fotógrafa fictícia cuja identidade os jobs de cena posteriores devem preservar.
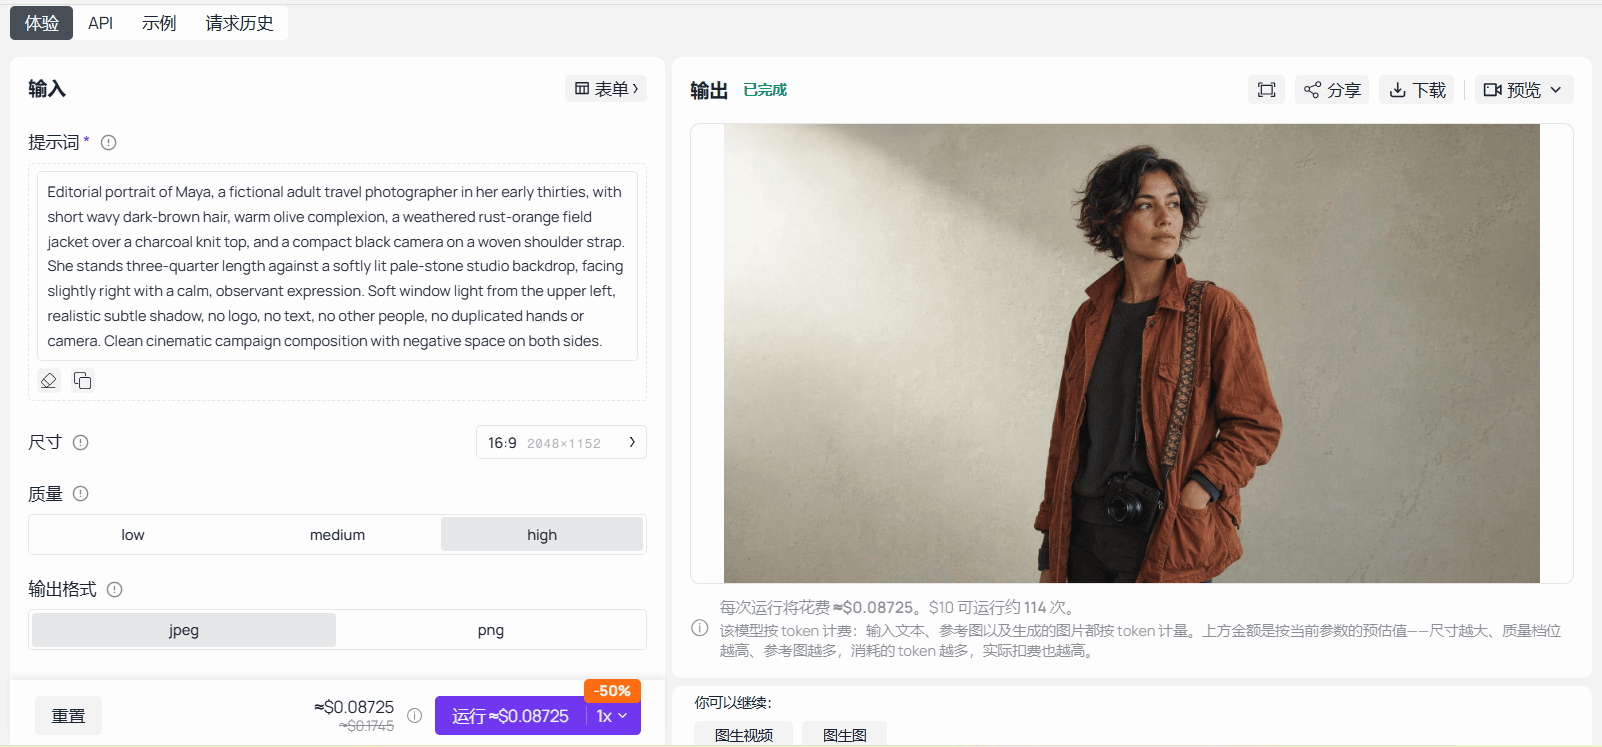
Playground do GPT Image 2 concluído com High quality, configuração 16:9 e o retrato mestra da Maya
GPT Image 2 na Atlas Cloud com o prompt de referência de personagem do artigo e seu resultado concluído no painel de saída.
Etapa 2: Execute o Lote A como 4 cenas de personagem vinculadas
Faça upload de maya-master-001.png para o Seedream v4.7 Sequential. Mantenha a referência, o template de prompt e a proporção 16:9 constantes. Use este prompt:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya on a sunlit granite ridgeline, consulting a folded topographic map at sunrise, distant cloud-filled valley below. 4Image 2: Maya walking through a small mountain market, photographing bright woven textiles, soft morning activity behind her. 5Image 3: Maya at a timber cabin table, arranging printed contact sheets and a notebook beside a rain-speckled window. 6Image 4: Maya kneeling by a clear alpine lake, taking field notes while her camera rests on a rock, late-afternoon light. 7 8Keep the composition editorial and realistic. Leave clean negative space on the left third for possible marketing copy, but do not render any text.
Use o modo sequencial ou de lote coerente que a página ao vivo realmente expõe. Aceite apenas saídas que possam ser mapeadas de forma inequívoca para maya-ridgeline-001 até maya-lake-001. Se o playground retornar uma saída por requisição em vez de 4 ativos filhos separados, envie o mesmo template bloqueado como 4 jobs filhos. Preserve o mesmo hash de referência e os mesmos parâmetros em vez de fingir que a interface retornou um recurso que não retornou.
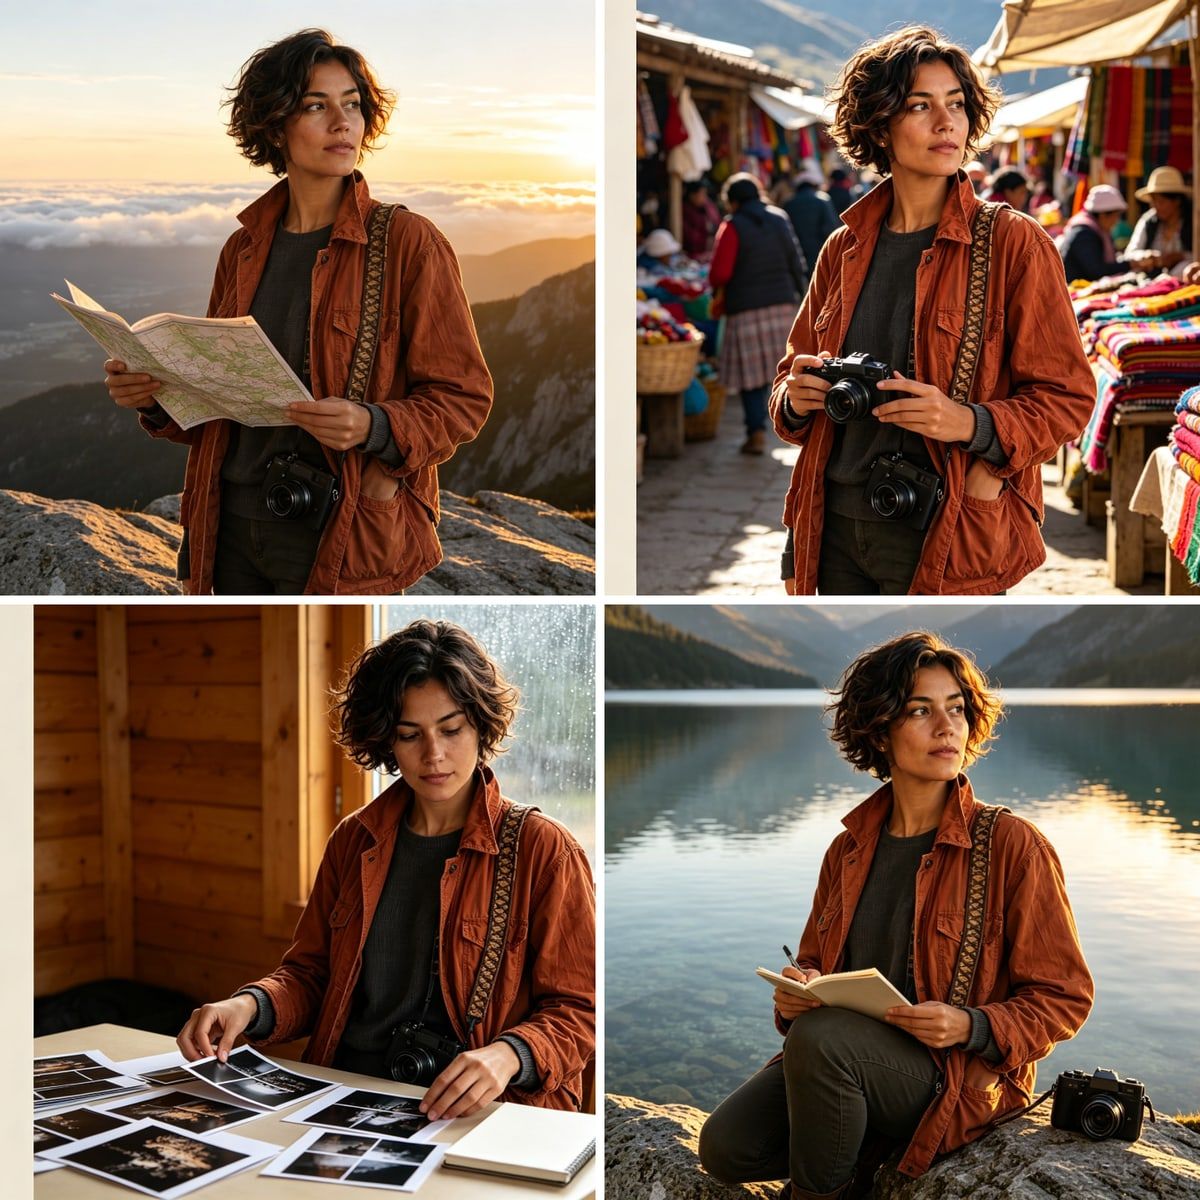
Quatro saídas reais de cena da Maya do Seedream v4.7 Sequential em uma grade, mapeadas para os IDs de ativo ridgeline, market, cabin e lake
A grade de saída do Lote A com 4 cenas: cada quadro permanece um registro de ativo separado mesmo quando o modelo produz uma sequência coerente.
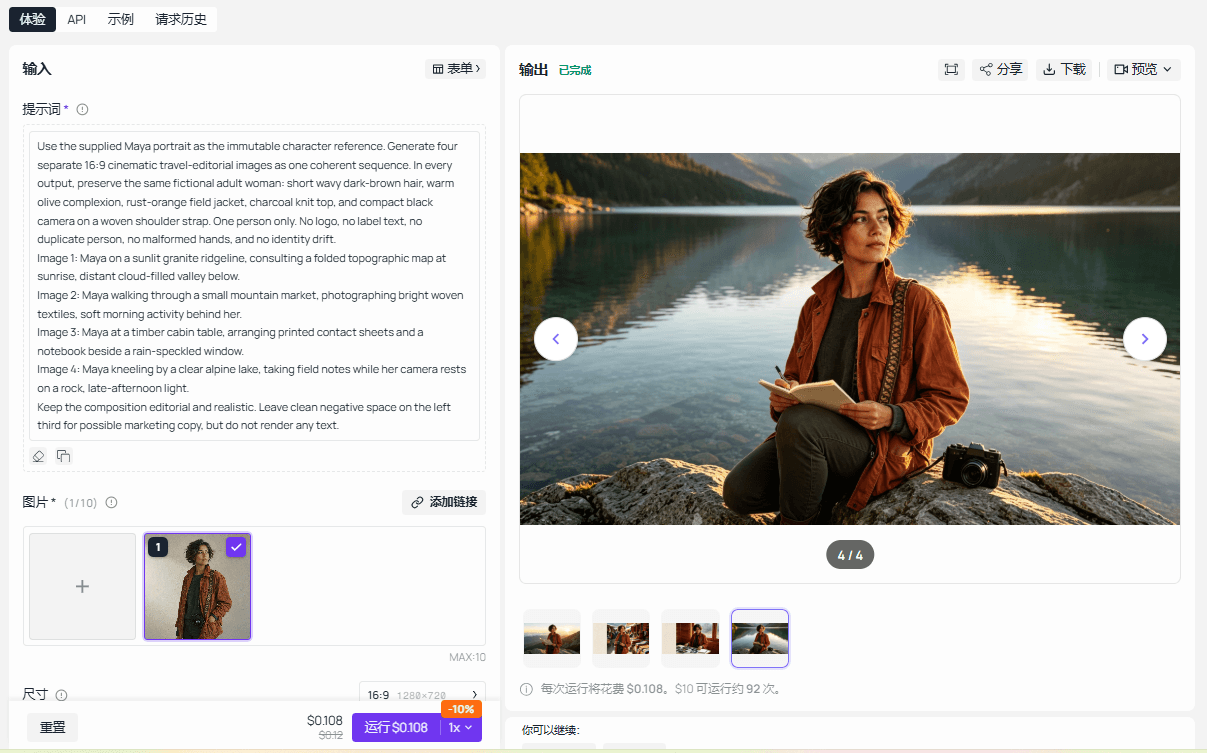
Playground do Seedream v4.7 Sequential concluído com o prompt vinculado de cena da Maya e sua saída real
Seedream v4.7 Sequential na Atlas Cloud com o prompt vinculado de cena de personagem do artigo e um resultado concluído.
Etapa 3: Execute o Lote B e pare para controle de qualidade
Reutilize a referência mestra aprovada. Não a recrie e não reescreva as regras de identidade. Envie as próximas 4 cenas com um novo rótulo de lote e as mesmas verificações de aceitação:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya moving through a mossy cedar forest on a narrow trail, camera raised toward a shaft of morning light. 4Image 2: Maya seated at a train-window table, reviewing contact sheets as a sunlit landscape blurs outside. 5Image 3: Maya at a weathered cabin workbench, packing film canisters, a lens cloth, and a folded paper map before departure. 6Image 4: close three-quarter portrait of Maya outdoors in light mist, camera strap visible, shallow depth of field, no text. 7 8Keep the same visual color treatment as the first sequence. Leave clean negative space on the left third where the composition permits, but do not render any text.
Após o Lote B, pare. Revise todos os 8 registros de cena antes de liberar outra sequência de campanha. Essa pausa detecta os tipos de desvio que as filas ocultam: mudança de cabelo ou guarda-roupa, aparecimento de uma segunda pessoa, letras não solicitadas, mãos malformadas ou uma cena que não atende mais ao seu canal. Armazene a decisão do revisor ao lado do ativo, em vez de em uma mensagem de chat não rastreada.
Etapa 4: Aplique uma decisão de publicar, repetir ou rejeitar
Marque uma imagem como approved quando ela contiver uma única Maya, corresponder à referência mestra em rosto, cabelo, guarda-roupa e câmera, não contiver texto quebrado ou anatomia malformada e se encaixar na cena atribuída. Marque-a como retry quando a Maya se duplicar, sofrer desvio, perder um acessório necessário ou apresentar mãos ou letras malformadas. Marque-a como rejected quando a composição não puder atender ao canal pretendido ou o personagem não for mais reconhecível.
Para uma nova tentativa, mantenha maya-train-001 como o ativo de negócio e crie a tentativa maya-train-001-a2. Envie apenas esse job filho com a especificação original da chave de idempotência ajustada somente se o prompt estiver sendo versionado deliberadamente. Não execute novamente os outros 7 ativos só porque uma cena precisa de reparo.
Escolhendo modelos para geração em lote
Escolha um modelo em torno da unidade de trabalho, não de um ranking. Uma referência mestra limpa e uma sequência coerente de cenas são jobs diferentes. Uma edição de uma imagem que falhou é diferente novamente. Se uma equipe quiser testar essas etapas por meio de uma integração compatível com OpenAI, a Atlas Cloud oferece um lugar natural para validar as duas páginas de modelo usadas neste exemplo.
| Trabalho | Modelo e método de trabalho | Contexto de preço para verificar antes de enfileirar |
|---|---|---|
| Criar uma referência mestra limpa de personagem | GPT Image 2, uma execução High-quality 16:9 que se torna a âncora de referência | GPT Image 2 Developer texto para imagem está listado a partir de cerca de $0.004 por imagem versus $0.009 padrão, um desconto exibido de 50% em setembro de 2026 |
| Construir um conjunto coerente de cenas | Seedream v4.7 Sequential, mesma referência e esquema de prompt bloqueado entre jobs filhos | O catálogo atual lista $0.03 por imagem; verifique o modo de saída ao vivo e o preço antes da produção |
| Reparar um ativo que falhou | Modo de edição do GPT Image 2, limitado ao ativo que falhou na revisão | Confirme o endpoint de edição, o tamanho de saída, a qualidade e o preço atual antes de confirmar |
Os preços mudam por modelo, modo e configurações selecionadas. Use o catálogo de modelos da Atlas Cloud para verificar novamente disponibilidade, descontos e o modo exato no dia em que você enfileirar trabalho. Trate a tabela como um insumo de estimativa, nunca como uma alegação promocional ou garantia de custo.
Controle de qualidade, custo e direitos antes de escalar
A conclusão da geração tem 3 significados separados: o provedor relata sucesso, o arquivo foi arquivado corretamente e um revisor humano o aceita para publicação. Torne todos os 3 visíveis em seus registros. Uma tarefa concluída com um arquivo de saída ausente é uma falha operacional. Um arquivo salvo com um personagem duplicado é uma falha criativa. Nenhum deles deve avançar automaticamente para publicação.
Use uma checklist de revisor simples o suficiente para aplicar a cada ativo filho:
| Verificação | Pergunta do revisor |
|---|---|
| Identidade do personagem | A Maya corresponde à referência mestra aprovada em rosto, cabelo, guarda-roupa e câmera? |
| Contagem de objetos | Há exatamente o número esperado de objetos principais? |
| Correspondência do prompt | A cena entrega o caso de uso atribuído? |
| Artefatos de texto | Há texto indesejado, malformado ou não suportado? |
| Proporção e nome do arquivo | O arquivo salvo corresponde ao registro do manifesto? |
| Revisão de direitos | A referência e as alegações pretendidas são permitidas para este uso? |
Estime o custo após a execução com approved asset cost = total completed attempts cost / approved assets. Isso expõe o custo de novas tentativas e resultados rejeitados sem fingir que toda imagem tem o mesmo custo final. Defina um limite de tarefas, um limite de lote e um limite diário antes de começar. Pause o despacho se qualquer um desses tetos for atingido.
Use apenas imagens de referência próprias, licenciadas ou de outra forma permitidas. Verifique as políticas atuais da plataforma e os termos do modelo antes do uso comercial. Não peça ao modelo para inventar certificações, resultados de laboratório, promessas de segurança, alegações médicas ou especificações de produto não verificadas. Uma saída polida não transforma uma alegação sem suporte em uma alegação publicável.
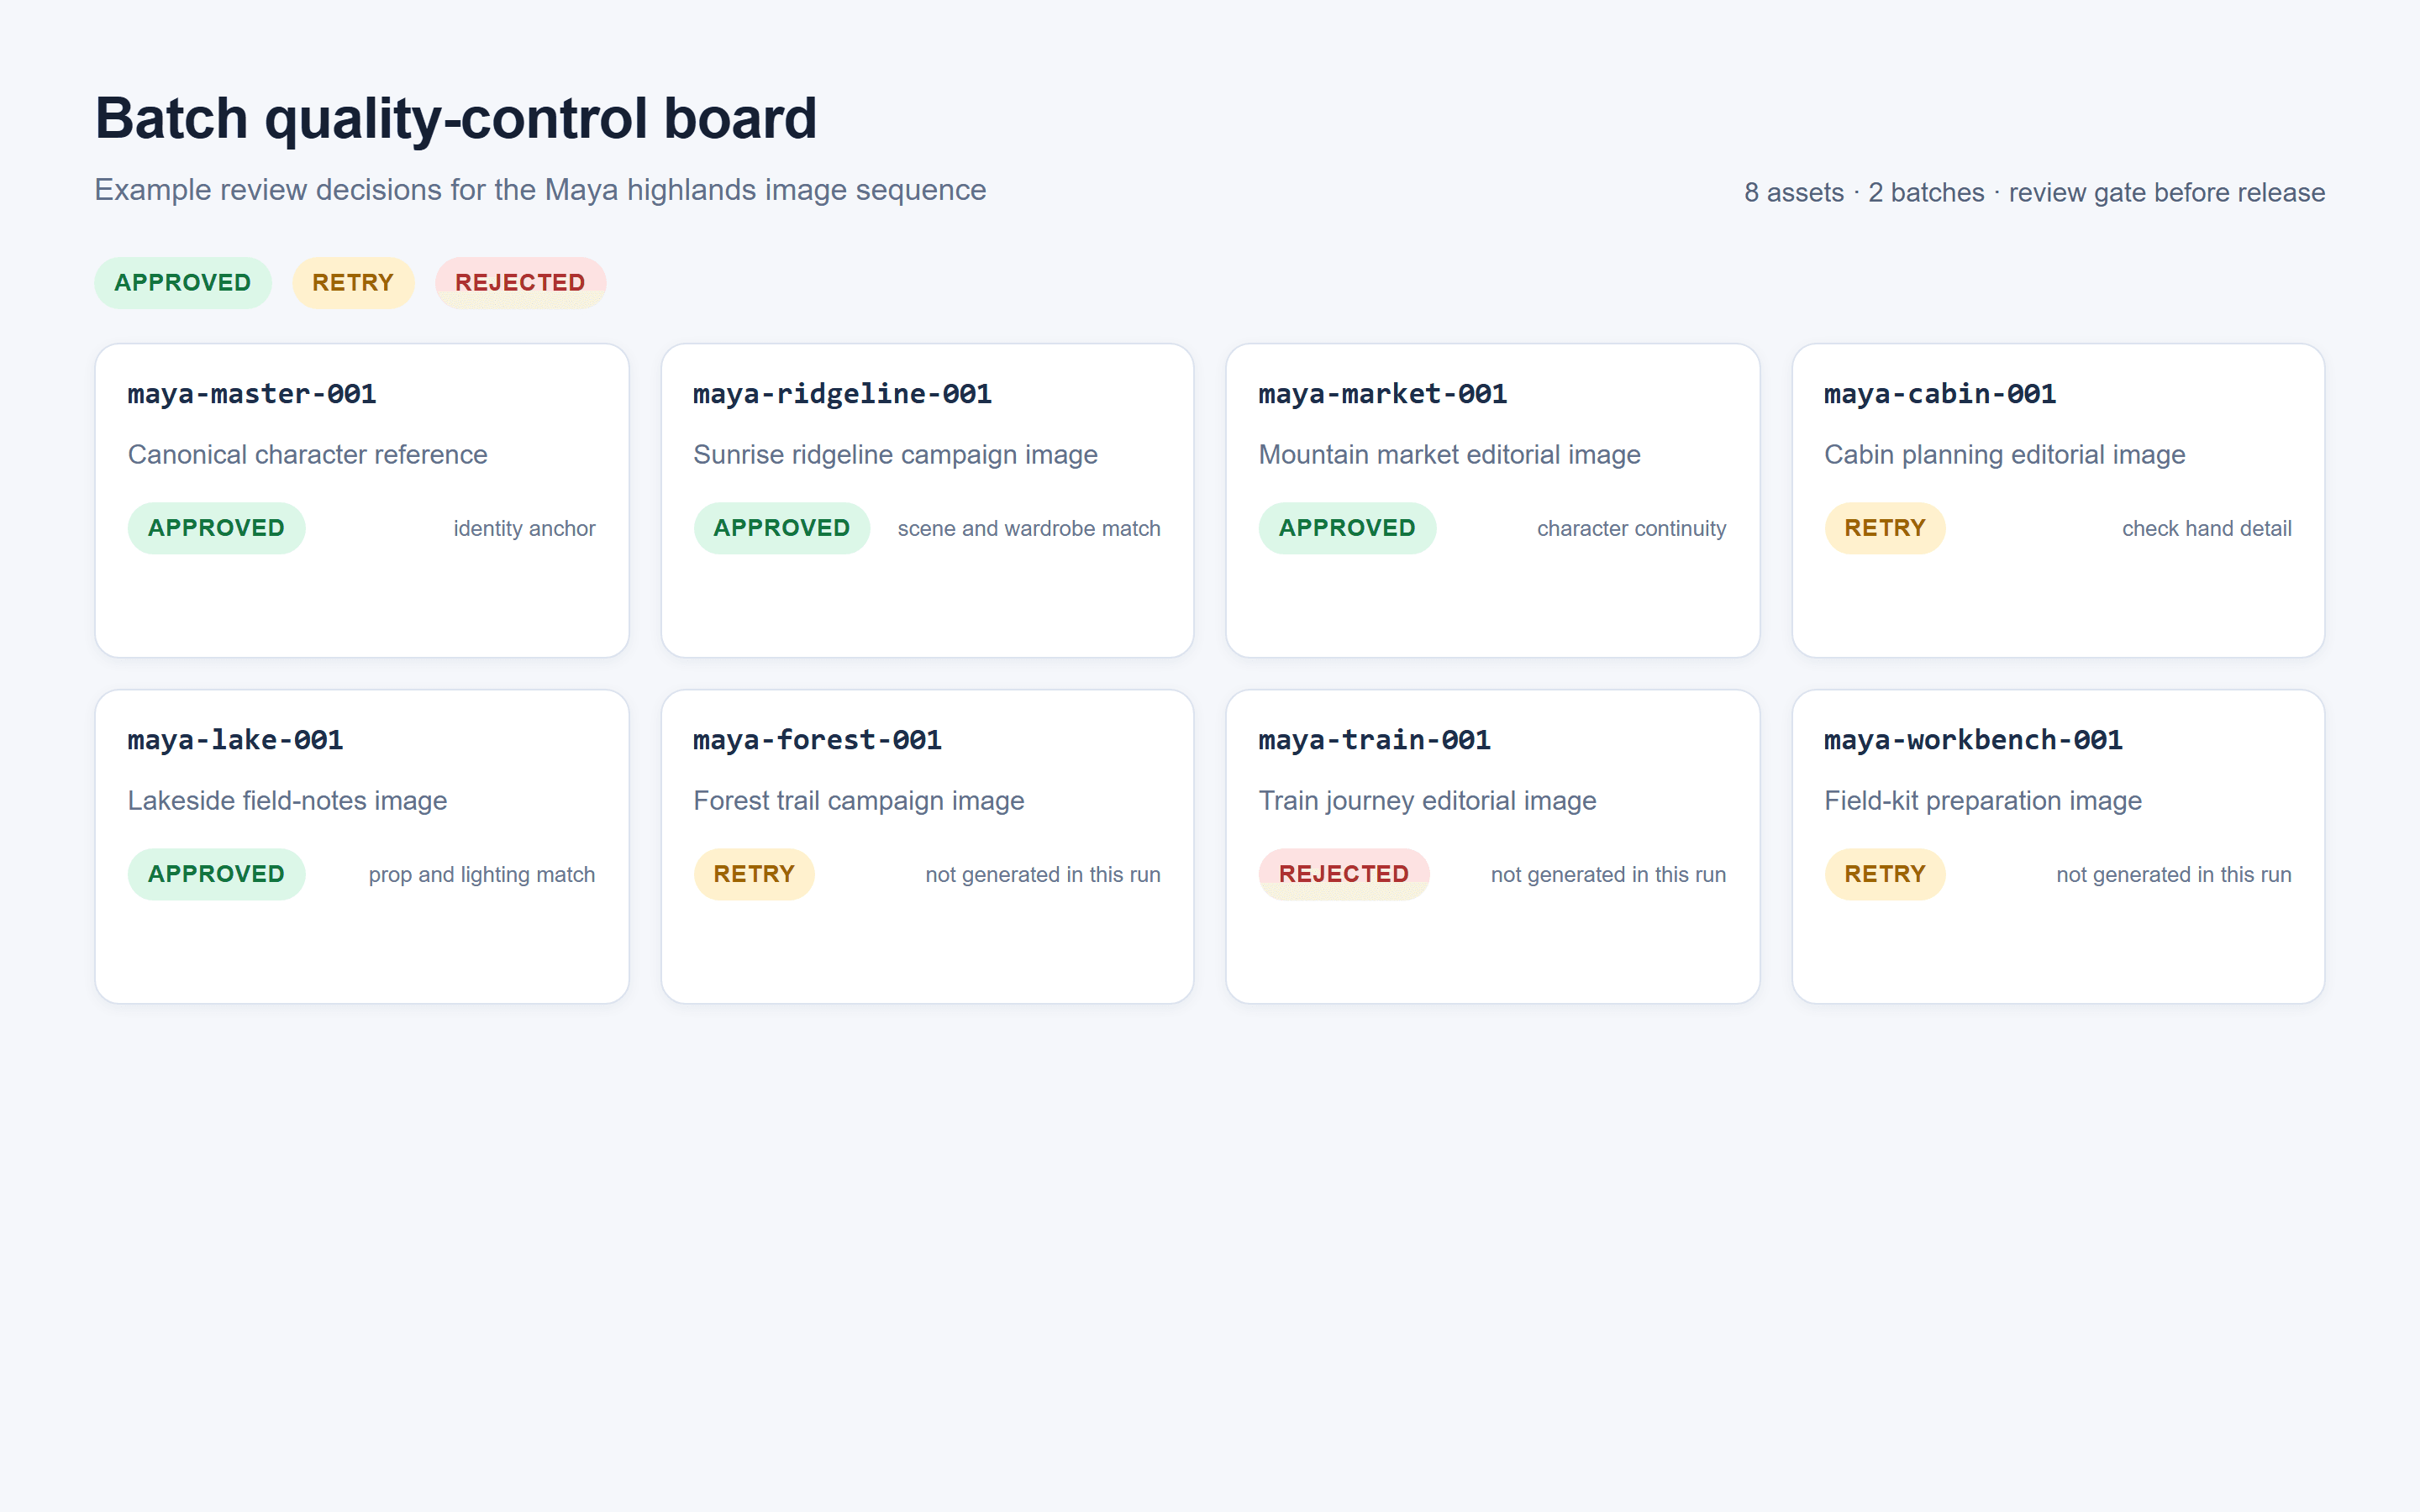
Painel de controle de qualidade de lote renderizado no navegador mostrando 8 IDs de ativo da Maya com estados de revisão approved, retry e rejected
Um painel de revisão renderizado no navegador mapeia arquivos de execução reais de volta para seus 8 IDs de ativo e torna visível a decisão de publicar, repetir ou rejeitar.
API de IA para geração em lote: checklist de lançamento em produção
Antes de passar do exercício com 8 ativos para um catálogo ao vivo ou biblioteca de conteúdo, confirme cada item abaixo.
- Todo ativo tem um
asset_idimutável. - O prompt, o hash de referência, o modelo, a proporção e a qualidade são registrados.
- Toda submissão tem uma chave de idempotência onde o provedor oferece suporte a uma.
- A concorrência permanece abaixo do limite documentado real da conta.
- Existem limites de orçamento por tarefa, por lote e diário.
- Respostas 429, respostas 5xx, timeouts e recusas de conteúdo seguem regras diferentes.
- Novas tentativas têm um máximo absoluto.
- Resultados bem-sucedidos são arquivados e mapeados de volta para os dados de origem imediatamente.
- Um portão de QC em pequenos lotes é aprovado antes que o próximo grupo seja liberado.
- Uma revisão final de amostra verifica identidade do personagem, texto, proporção, nomes de arquivo e direitos.
Este checklist mantém uma API de IA para geração em lote útil quando o volume cresce. Ele também deixa uma trilha de auditoria clara quando um editor pergunta por que uma imagem específica foi gerada, aceita ou executada novamente.
FAQ: API de IA para geração em lote
O que é uma API de IA para geração em lote?
É uma forma de enviar muitas tarefas de IA independentes, acompanhar sua execução e coletar resultados mais tarde. Uma boa implementação mantém um ID de ativo de negócio durável para cada tarefa, independentemente de o provedor usar um job em lote assíncrono ou requisições concorrentes normais.
Uma API em lote é melhor do que enviar requisições de imagem em paralelo?
Nenhuma é automaticamente melhor. Use requisições paralelas controladas quando o fluxo de trabalho precisar de progresso imediato. Use um job em lote do provedor para volume não urgente quando suas regras documentadas de fila, prazo de resposta e custo se adequarem ao seu trabalho. Ambas precisam de logs por ativo e revisão.
Quantas imagens de IA devo colocar em um lote?
Comece com 4 a 8 ativos visuais quando estiver validando um novo esquema de prompt ou referência de personagem. Aumente apenas depois que a equipe conseguir mapear cada resultado, identificar desvios rapidamente e recuperar um job filho que falhou sem reiniciar o grupo. Os limites do provedor podem permitir muito mais, mas um lote operacionalmente útil é um lote revisável.
Como as chaves de idempotência evitam custos duplicados de geração?
Elas identificam uma submissão como a mesma operação pretendida após uma nova tentativa. Se o endpoint oferecer suporte a idempotência, o provedor pode evitar tratar uma chamada de rede repetida como uma geração totalmente nova. Armazene a chave com o registro do ativo e confirme a semântica exata na documentação do provedor.
Posso gerar imagens em lote a partir da mesma referência de personagem?
Sim. Use uma imagem de referência aprovada e permitida; anexe seu hash a cada job filho; bloqueie as instruções de identidade; e revise um pequeno grupo de cenas antes da expansão. A consistência de referência reduz a ambiguidade, mas não substitui o QC visual.
Devo repetir um lote inteiro que falhou ou apenas os ativos que falharam?
Repita apenas os ativos que falharam. Arquive os sucessos primeiro, classifique a falha e crie um novo registro de tentativa para o job filho afetado. O reenvio do lote inteiro torna ativos duplicados e gastos desnecessários mais prováveis.


