Um relatório verde de testes de API parece tranquilizador até você perceber que cada asserção verifica apenas HTTP 200. A resposta poderia conter o registro do cliente errado e ainda assim passar.
Escolha ferramentas de IA para testes de API com base no trabalho que você já tem. Avalie o Postman Agent Mode se sua equipe mantém coleções, o KushoAI se uma especificação é seu ponto de partida, e o Keploy se você precisa de fluxos gerados ou testes de regressão criados a partir de tráfego gravado. Revise e execute os testes resultantes antes de confiar neles.
Este guia aborda assistência de IA para testar APIs comuns. Testar a precisão das respostas de um modelo de IA é um problema de avaliação separado.
Principais conclusões
- Forneça o contrato, dependências de requisição e expectativas de negócio aprovadas.
- Verifique se as asserções rejeitam dados errados, campos ausentes e tipos quebrados.
- Só compre depois que os testes revisados forem executados repetidamente no ambiente de CI pretendido.
A comparação de produtos abaixo reflete a documentação oficial verificada em 21 de setembro de 2026. Não é um benchmark comparativo direto de três contas pagas.
O exemplo prático usa uma especificação fixada do Swagger Petstore e separa expectativas de contrato, comportamento observado e cópias de resposta deliberadamente modificadas.
Nossa execução local passou 5 testes reais e rejeitou todas as 3 cópias de resposta deliberadamente alteradas. Uma sondagem separada de nome ausente ainda retornou 200, mostrando por que o escopo de um relatório verde importa.
O que as ferramentas de IA para testes de API realmente fazem
A assistência de IA geralmente entra em quatro partes dos testes de API. Um modelo lê sua especificação, propõe cenários, redige asserções e ajuda a explicar falhas. Cada parte exige evidências diferentes. Uma explicação plausível de uma falha não estabelece que a correção proposta está correta.
Para revisão de especificação, forneça o arquivo OpenAPI e as regras de negócio relevantes. Para planejamento de cenários, adicione exemplos de dados válidos e limites conhecidos. Para scripts executáveis, inclua seu runner, configuração de autenticação e convenções de fixtures. Para diagnóstico, forneça a requisição real, a resposta e a mensagem de falha após remover segredos.
Mantenha esses quatro mecanismos separados ao avaliar produtos:
- Geração por LLM: propõe testes a partir de linguagem, esquemas e exemplos. Um revisor deve verificar os resultados esperados.
- Reprodução de tráfego: compara comportamento posterior com interações capturadas, geralmente usando respostas de dependência gravadas.
- Testes baseados em propriedades: constrói sistematicamente entradas para desafiar propriedades como conformidade com esquema.
- Execução de testes: envia requisições, avalia asserções e retorna relatórios e códigos de saída.
Um produto pode combinar vários mecanismos. Pergunte qual mecanismo produziu cada teste e o que determina seu resultado esperado. Gravar uma resposta incorreta pode preservar o mesmo erro como linha de base de regressão. Gerar um nome de teste refinado pode disfarçar uma expectativa sem suporte.
Pense em asserções em três profundidades. Primeiro, o servidor respondeu com sucesso? Segundo, o corpo tem os campos e tipos documentados? Terceiro, este corpo representa o recurso e a operação que você solicitou?
Para uma consulta de pet, um objeto válido com um ID inteiro ainda falha na terceira verificação se esse ID pertencer a outro pet. Por outro lado, corresponder ao ID solicitado não prova que todos os campos satisfazem o esquema. Use ambas as verificações e adicione regras de negócio apenas onde a equipe tiver uma fonte acordada para elas.
A saída prática que você quer é um ativo de teste sustentável com um oráculo explicável: um motivo claro pelo qual cada resultado deve passar ou falhar. Conte cenários úteis após a revisão, incluindo os que você rejeitar, em vez de celebrar o tamanho da lista inicial gerada.
Ferramentas de IA para testes de API comparadas por fluxo de trabalho
Comece pelo artefato que sua equipe consegue fornecer hoje. Migrar uma coleção estabelecida, reconstruir regras de negócio ausentes e configurar a gravação de dependências são projetos diferentes. Uma ferramenta adequada a um ponto de partida pode criar trabalho extra em outro.
| Ferramenta ou abordagem | Entrada útil | Papel da IA ou automação | Rota de execução e CI | Saída revisável | Pergunta principal do teste |
|---|---|---|---|---|---|
| Postman Agent Mode | Coleções, requisições, respostas, ambientes, especificações | Rascunha e edita scripts de teste no contexto do workspace | Collection Runner e fluxo de CLI compatível | Asserções JavaScript padrão do Postman | Ele preserva suas variáveis e testa o contrato? |
| KushoAI | OpenAPI, coleção Postman, cURL | Gera cenários e suítes de teste; oferece refinamento em linguagem natural | Execução na plataforma e integração de CI documentada; verifique a elegibilidade | Inspecione requisições geradas, dependências e resultados esperados | Seu plano selecionado consegue executar e reter a suíte onde você precisa? |
| Keploy | Especificações ou definições de requisição; alternativamente tráfego real | Geração por IA e uma rota separada de gravação/reprodução | Fluxos gerados ou testes gravados em ambientes locais/CI compatíveis | Revise definições de teste, linhas de base e mocks de dependência | Qual rota cobre seus modos reais de falha? |
| Runner existente mais um LLM | Matriz aprovada, especificação, convenções de fixtures | Rascunha código para revisão | Seu pytest ou outro runner estabelecido | Código commitado no seu repositório | A revisão é mais barata do que escrever os mesmos testes diretamente? |
Postman Agent Mode para coleções existentes
O Postman é uma primeira avaliação razoável quando sua coleção já contém ordem útil de requisições, variáveis de ambiente e configuração de autenticação. O Agent Mode pode usar esse contexto para gerar scripts de teste JavaScript padrão. Esses scripts podem entrar no fluxo de execução da coleção existente em vez de exigir uma nova linguagem de asserção.
Um teste focado é mais revelador do que pedir que ele teste tudo. Selecione a requisição que recupera um recurso criado anteriormente na coleção. Forneça seu esquema e peça validação de campos obrigatórios, tipos de campo documentados e uma asserção que conecte o ID retornado ao ID de criação armazenado.
Depois, inspecione as alterações propostas antes de aceitá-las. Um exemplo de resposta pode conter um pet chamado Milo. A igualdade com Milo é significativa se sua fixture criou Milo explicitamente; é frágil se o gerador copiou um nome de um registro de amostra compartilhado. O mesmo literal pode ser uma asserção válida ou uma dependência acidental, dependendo de sua origem.
Verifique o escopo das variáveis com atenção. Um ID armazenado em uma variável de ambiente deve estar disponível para a requisição posterior e deve pertencer àquela execução. Variáveis compartilhadas entre execuções simultâneas podem criar falhas intermitentes que se parecem com defeitos do servidor. Peça ao gerador que explique a configuração e a limpeza, assim como as asserções.
Para o primeiro teste de aceitação, execute a coleção duas vezes com dados isolados e depois inspecione a representação exportada ou versionada. Confirme que um colega consegue revisar os scripts alterados sem repetir a conversa com a IA. Verifique também se a CLI, o reporter e o plano escolhidos suportam o caminho de execução que você pretende usar.
Nenhuma geração operada do Postman é apresentada aqui. A pergunta útil de avaliação é se o contexto do workspace dele reduz seu trabalho de revisão em uma coleção existente. Isso exige sua própria coleção e um teste no nível da conta, não uma conclusão tirada de uma captura de tela do produto.
KushoAI para geração de testes baseada em especificação
O KushoAI aceita entradas Swagger/OpenAPI, Postman e cURL e documenta geração de testes, refinamento em linguagem natural e execução em CI. Isso o torna um candidato quando uma equipe tem definições de API úteis, mas um backlog de testes não escritos. Esses são recursos descritos pelo fornecedor, não resultados medidos de detecção de defeitos. (documentação do KushoAI, setembro de 2026)
Escolha a entrada com o contexto confiável mais rico. Uma requisição cURL pode descrever uma requisição válida, mas geralmente diz pouco sobre campos opcionais, valores de enum permitidos ou erros documentados. Um arquivo OpenAPI adiciona estrutura; uma matriz de cenários aprovada adiciona a intenção que a estrutura pode deixar ambígua.
Para um teste do Petstore, peça casos separados para um pet válido, um name obrigatório ausente, um ID com o tipo errado e um filtro de status inválido. Revise se a ferramenta distingue requisitos de corpo da requisição de requisitos de esquema de resposta. Eles podem parecer semelhantes em um exemplo, embora imponham obrigações diferentes.
Em seguida, examine um fluxo conectado de criação-leitura-atualização. A leitura deve usar o ID associado à configuração atual. A atualização deve ter como alvo o mesmo recurso, e uma leitura posterior deve verificar o campo alterado. Quatro requisições independentes com nomes de teste atraentes não estabelecem que a cadeia de dependências funciona.
Trate a primeira geração como uma proposta. Mantenha expectativas documentadas, revise scripts com fluxo de dados incorreto e sinalize resultados subespecificados para uma decisão de requisitos. Se a ferramenta sugerir vários casos equivalentes de campo ausente, mantenha as distinções úteis em vez de pagar para manter duplicatas.
Antes de comprar, peça para executar a suíte no pipeline pretendido e inspecione o artefato de falha. Confirme permissões atuais de CI, tratamento de credenciais e formatos de exportação disponíveis no plano selecionado. Não presuma que um teste interativo gratuito concede os mesmos direitos de automação que uma implantação de equipe.
Keploy para testes gerados e reprodução de tráfego
A documentação do Keploy apresenta dois caminhos de partida distintos. A geração por IA aceita recursos como OpenAPI, Postman, cURL ou endpoints e cria fluxos de API conectados. Gravação e reprodução captura interações de API e suas dependências para execução posterior com mocks. A descrição do fluxo de IA e a descrição da gravação de dependências não devem ser tratadas como mecanismos idênticos. (documentação do Keploy, setembro de 2026)
Se sua dificuldade é reproduzir o que um aplicativo fez com um banco de dados ou serviço upstream, avalie a rota de gravação. Capture uma pequena jornada de criação-leitura-atualização em um ambiente isolado, inspecione as dependências capturadas e reproduza após uma alteração controlada no aplicativo. Verifique o que o runtime suporta antes de planejar uma implantação maior.
Se sua dificuldade é derivar casos de uma especificação, avalie a rota de geração separadamente. Pergunte como as requisições propostas obtêm credenciais, transportam IDs entre etapas e limpam dados. A presença de recursos de gravação em outras partes do produto não responde a essas perguntas para uma suíte gerada.
Valores dinâmicos exigem julgamento. Um timestamp pode variar legitimamente; um ID de recurso pode conectar duas requisições e, portanto, precisa de comparação. Ignorar amplamente todos os campos que mudam pode ocultar erros. Revise exclusões campo a campo e mantenha comparações que expressem relações significativas.
Inspecione também a linha de base antes de aceitá-la. Uma gravação que contém o total errado, uma resposta de fallback acidental ou dados obsoletos pode ser reproduzida de forma consistente. A consistência ajuda a detectar mudanças, mas a equipe ainda decide se o comportamento capturado estava correto.
Um complemento útil: Schemathesis fornece testes de API baseados em propriedades e orientados por esquema. Ele pode desafiar uma API com entradas geradas junto a exemplos revisados. Trate-o como um mecanismo de teste diferente, não como sinônimo de um gerador de testes por LLM. Seus achados ainda precisam ser interpretados em relação ao contrato e à implementação.
Ferramentas de IA gratuitas para testes de API: limites e custos
“Grátis” pode descrever um cliente, uma cota limitada de IA, um runner de código aberto ou um teste temporário. Essas ofertas cobrem partes diferentes do fluxo de trabalho. Um cliente gratuito não estabelece que geração automatizada, execução agendada ou exportação de relatório também sejam gratuitas.
Conforme verificado em 21 de setembro de 2026, o plano Free do Postman lista 50 créditos de IA por mês. Créditos são sua unidade de cobrança; eles não significam 50 testes ou 50 suítes completas. Sua tabela de comparação distingue a cota de IA de execução, recursos orientados a dados e exportações de resultados. (preços do Postman, setembro de 2026)
A apresentação atual de preços do KushoAI usa Developer Edition e Enterprise. O Keploy distingue Playground, Pro e Enterprise, além de sua oferta de código aberto. Use a tela de compra atual para confirmar os limites relevantes. Compilações mais antigas de ferramentas podem descrever nomes de planos descontinuados ou combinar cotas cobradas separadamente.
| Componente de custo | O que registrar em um teste | O que pode tornar a conta enganosa |
|---|---|---|
| Assentos e plano | Editores, revisores, periodicidade de cobrança, recursos necessários | Comparar preços anuais de manchete com compromissos mensais |
| Geração por IA | Uso de créditos para a mesma tarefa aprovada, incluindo novas tentativas | Presumir que um crédito equivale a um teste |
| Execução | Execuções locais, execuções hospedadas, jobs de CI, agendamentos, relatórios | Tratar execuções interativas como permissão para todos os caminhos de automação |
| Modelo independente | Tokens de entrada e saída para rascunho e revisão | Ignorar envios repetidos da especificação completa |
| Tempo de engenharia | Revisão, reparo de fixtures, triagem de falhas, manutenção | Contar o tempo de geração inicial como tempo total de entrega |
Use uma pequena tarefa de aceitação para estimar o custo. Dê a cada candidato as mesmas operações e expectativas e registre quantos cenários sobrevivem à revisão. Mantenha tempo de geração, tempo de revisão prática e tempo de execução em colunas separadas. Esperar por um modelo e corrigir uma asserção perigosa impõe custos diferentes à equipe.
Um denominador útil são cenários revisados e executáveis que sua equipe manteria. Isso impede que um gerador com muitos casos redundantes pareça mais barato simplesmente porque sua saída é maior. Registre casos sem suporte que você removeu e requisitos que permanecem não resolvidos.
Este artigo não reivindica um percentual medido de economia de trabalho nem compara a produtividade de planos pagos. Esses números precisam de um teste controlado com entradas equivalentes. Para uma decisão de compra, inclua uma mudança realista de manutenção, como adicionar um campo obrigatório, para que a estimativa cubra a próxima sprint, bem como a primeira demonstração.
Ferramentas de IA para testes de API: OpenAPI até uma primeira execução
Use uma instância local isolada do projeto real Swagger Petstore. Fixe o commit d57941e8fe959e508796b27469b1e8bba73392dc; sua especificação declara OpenAPI 3.0.4 e versão do aplicativo 1.0.29-SNAPSHOT. Leia o arquivo fixado em vez de uma demonstração pública atualizada independentemente. (especificação do Swagger Petstore, setembro de 2026)
1. Prepare o serviço e registre o ambiente. Obtenha o repositório por meio dessa página de origem, faça checkout da revisão fixada e instale um JDK e Maven compatíveis. O README do projeto fornece este comando de inicialização a partir do diretório do repositório:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty usa a porta 8080. Defina BASE_URL como sua origem HTTP de loopback nessa porta com /api/v3 anexado. Confirme que /openapi.json é legível em relação a essa base antes de testar.
Esta execução usou Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 e jsonschema 4.26.0. Registre suas versões também. A build do código-fonte baixa dependências e a Swagger UI, portanto um commit fixado do aplicativo sozinho não é uma build totalmente hermética.
2. Importe a especificação fixada. Selecione /pet, /pet/{petId} e /pet/findByStatus. Mantenha o delete disponível para limpeza. Substitua o local do servidor público da especificação pela sua base local. Verifique essa configuração antes de enviar qualquer requisição de escrita.
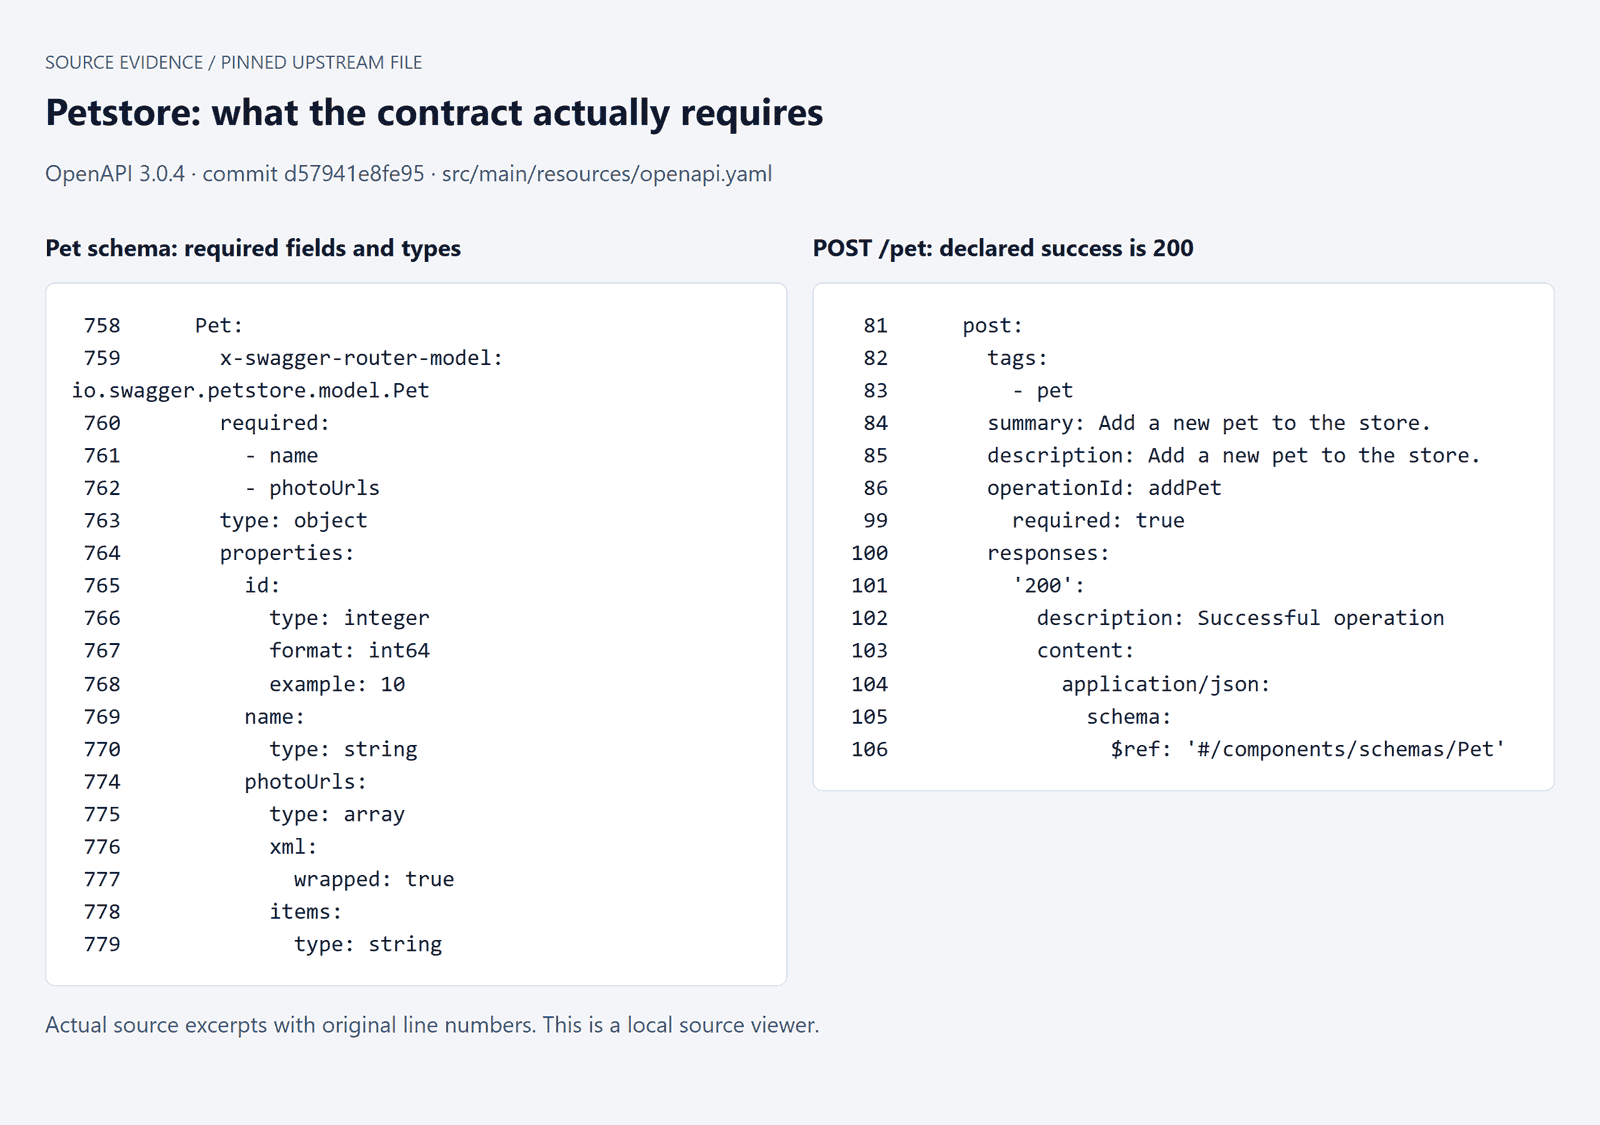 Código-fonte fixado do OpenAPI Petstore mostrando campos obrigatórios e definições de operação selecionadas
Trechos reais do código-fonte renderizados localmente: Pet exige name e photoUrls; POST /pet declara 200 para sucesso. Os números de linha originais são preservados.
3. Gere uma matriz antes do código executável (Prompt A). Anexe a especificação e cole este prompt no gerador escolhido:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Revise o oráculo para cada cenário. O Petstore documenta uma criação bem-sucedida como 200. Seu esquema Pet exige name e photoUrls; id tem tipo inteiro, mas não está nessa lista de obrigatórios. Portanto, validação de campo ausente e identidade requisição-resposta precisam de verificações diferentes.
| Operação | Entrada ou sequência | Evidência de resultado esperado | Asserção a revisar | Status de execução |
|---|---|---|---|---|
| addPet, getPetById | Criar e depois ler o ID atual | 200 documentado e esquema Pet; expectativa explícita de fluxo | Validar corpo e comparar ID retornado | Passou localmente |
| updatePet, getPetById | Alterar name e ler novamente | Operação de atualização mais intenção aprovada da fixture | Mesmo ID, novo name, esquema válido | Passou localmente |
| findPetsByStatus | Consultar available após setup | Enum documentado e resposta de array bem-sucedida | Todos os status retornados correspondem; ID criado está presente | Passou localmente |
| getPetById | ID de caminho não inteiro | 400 de ID inválido documentado | Status exato para este caso documentado | Passou: 400 |
| findPetsByStatus | Valor de enum não documentado | 400 de status inválido documentado | Status exato, retenha qualquer divergência | Passou: 400 |
| addPet | Omitir name obrigatório | Campo obrigatório do esquema; descrições 400 e 422 não mapeiam toda variação | Registrar comportamento; resolver mapeamento exato antes de bloquear | Retornou 200 sem name; discrepância retida |
5. Gere e inspecione o arquivo de execução (Prompt B). Anexe a matriz aprovada e a especificação com este prompt:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Execute, preserve e limpe. Use um ID de pet específico da execução, capture a resposta de criação e passe seu ID para requisições posteriores. Valide a atualização por meio de uma nova leitura. Uma resposta de atualização bem-sucedida sozinha não prova que o servidor persistiu a mudança.
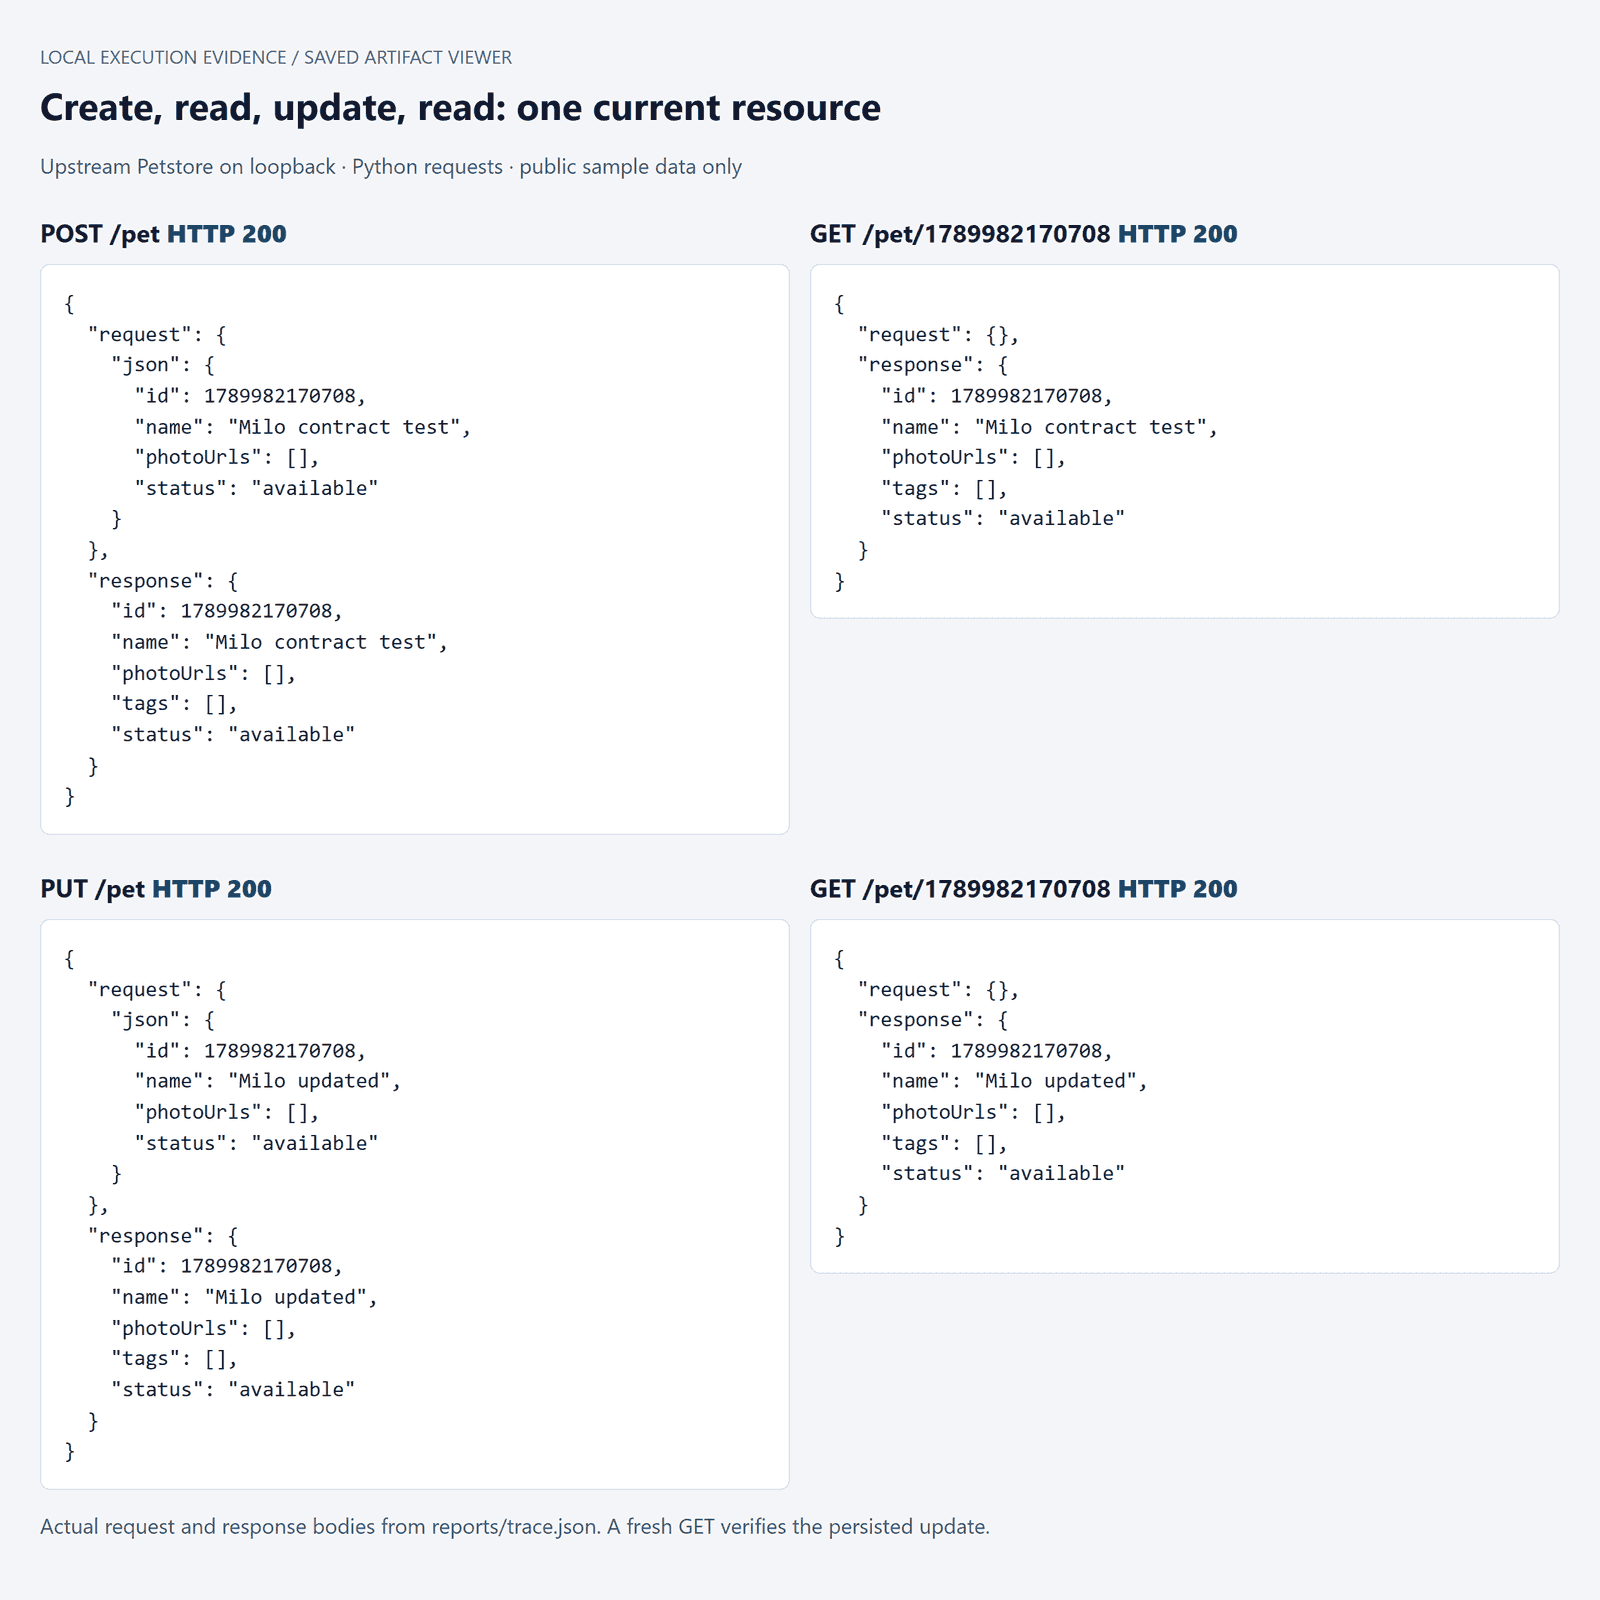 Evidência local da cadeia de requisições do Petstore mostrando criação, consulta, atualização e transferência de ID
Requisições e respostas locais salvas: o mesmo ID específico da execução sobrevive a criação, leitura, atualização e uma nova leitura. Todas as 4 requisições exibidas retornaram 200.
Salve corpos de requisição, respostas, falhas de asserção e o resultado da limpeza. Restrinja a exclusão aos IDs criados por esta execução. Mantenha respostas inesperadas como achados, incluindo casos em que a implementação de demonstração aceita entrada inválida. Não ajuste asserções apenas para obter uma captura de tela verde.
O que esta execução encontrou: as 5 funções de teste reais passaram, incluindo verificações de ID inválido e status inválido retornando 400. A sondagem separada de nome ausente retornou 200 e um corpo sem name. Retivemos essa discrepância de esquema fora da suíte verde; seu mapeamento exato de erro pretendido ainda precisa de esclarecimento. Ambos os registros criados foram excluídos com sucesso.
Os testes locais foram redigidos nesta execução do artigo, independentemente das três ferramentas comerciais. Todos os 5 testes reais foram mantidos; nenhum foi removido nem teve suas expectativas flexibilizadas após a execução. O tempo de revisão humana não foi medido. A pasta de evidências contém os arquivos de teste, o lock de dependências, respostas brutas e instruções de reprodução.
Como validar ferramentas de IA para testes de API
Uma asserção útil deve rejeitar uma resposta errada relevante. Você pode testar essa propriedade sem alterar o serviço em execução: salve uma resposta real bem-sucedida, copie-a e modifique deliberadamente um campo de cada vez. Estas são mutações controladas de resposta, não vulnerabilidades de produção nem um benchmark completo de teste de mutação.
Mantenha o status e o corpo originais juntos. Primeiro, execute o validador contra a resposta não modificada e verifique se ele aceita a linha de base. Depois, crie três cópias independentes. Altere o ID, altere o tipo do name e remova o name obrigatório. Cada cópia deve falhar por um motivo que corresponda à alteração.
| Linha de base salva | Modificação controlada | Verificação relevante | Resultado real |
|---|---|---|---|
| Consulta bem-sucedida do pet atual | Substituir por outro ID inteiro; manter status 200 | ID retornado é igual ao ID esperado desta execução | Falhou: IDs esperado e real diferem |
name string | Substituir name por um número | Tipo string do esquema Pet | Falhou: 42 não é uma string |
name obrigatório presente | Remover name | Lista de obrigatórios do esquema Pet | Falhou: name é obrigatório |
O exemplo de ID expõe uma fraqueza comum. Um validador de esquema pode aceitar o inteiro errado porque a forma permanece válida. A asserção de relacionamento fornece a restrição ausente. Nos outros dois exemplos, a validação de esquema fornece restrições que uma verificação apenas de status não consegue ver.
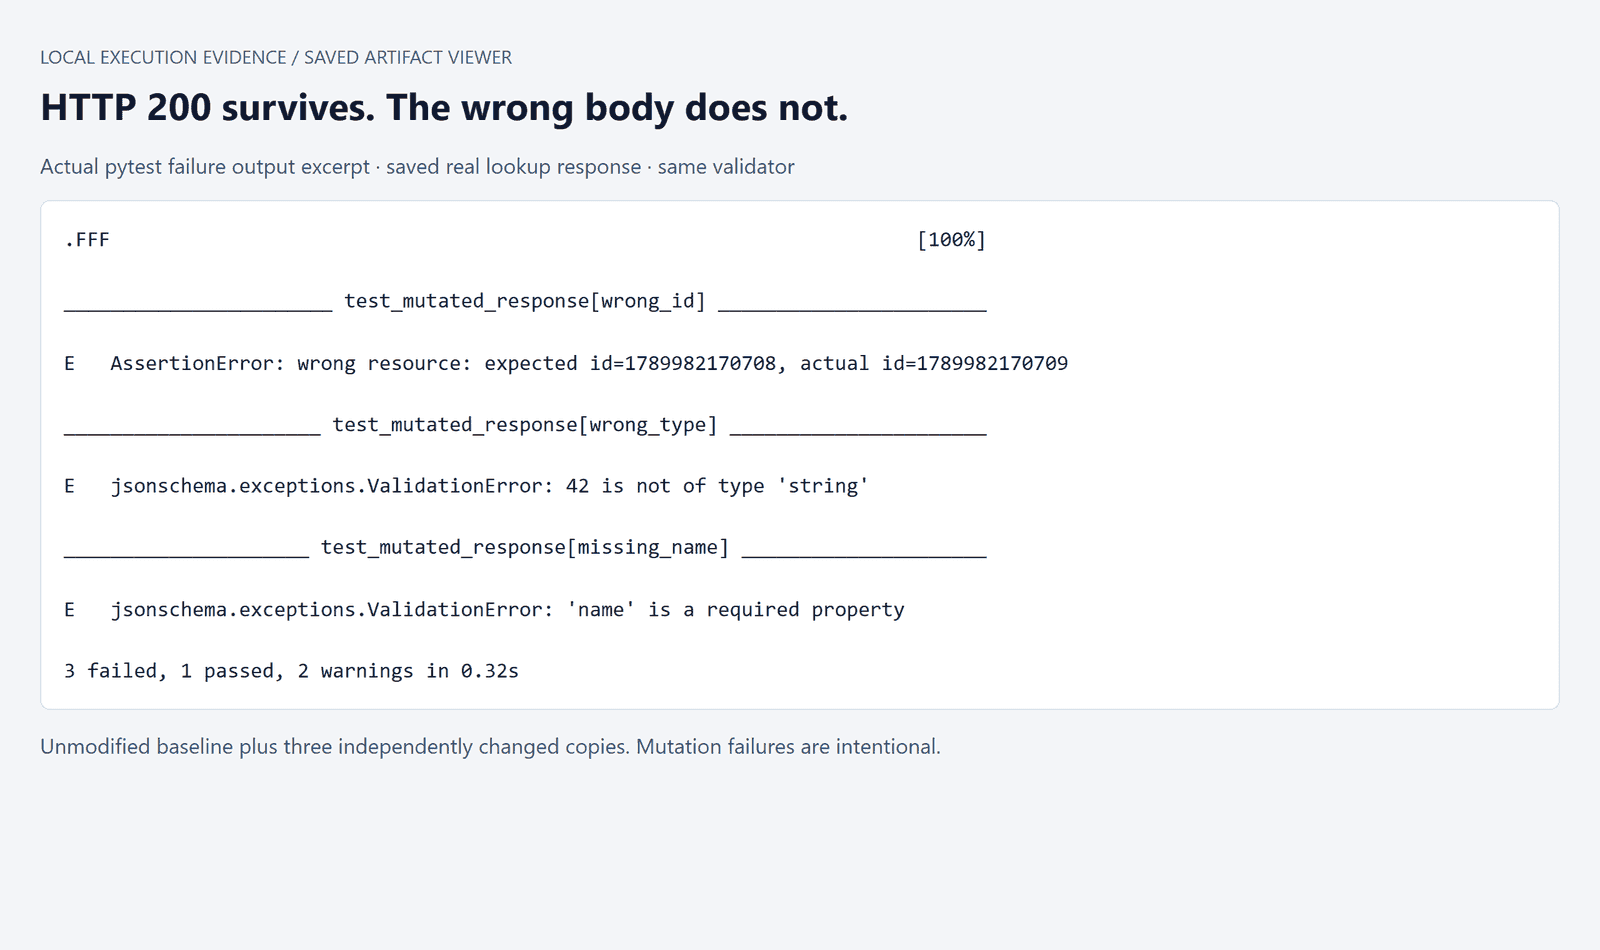 Saída real de falha de asserção para mutações controladas de resposta do Petstore
Trechos reais de falha do pytest: a resposta original passou, e todas as 3 mutações independentes falharam. Essas falhas foram induzidas deliberadamente em cópias salvas.
Nesta execução, a linha de base inalterada passou e 3 de 3 cópias alteradas falharam. A execução de mutação retornou código de saída 1, preservando o sinal de falha. O validador aplica as restrições estruturais relevantes do esquema Pet e uma verificação separada de relacionamento de ID; esta pequena demonstração não é um validador completo de conformidade OpenAPI.
Para uma auditoria repetível, anexe o arquivo de teste e a especificação fixada ao Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Revise alterações sugeridas de “autocorreção” com cuidado especial. Substituir um 400 esperado por 200 pode ocultar uma regressão. Uma mudança legítima de contrato precisa de uma referência de requisitos e uma alteração de teste revisada. A resposta observada é evidência para investigação, não permissão automática para redefinir a correção.
Separe categorias de falha antes de pedir uma correção à IA. Um timeout pode indicar um ambiente indisponível. Uma falha de consulta pode vir de uma fixture quebrada. Um erro de importação pertence ao código de teste. Uma divergência reproduzível com o contrato acordado pode pertencer ao produto. Preserve contexto suficiente para distingui-las.
Relate o denominador com honestidade. Detectar três alterações de resposta selecionadas prova sensibilidade a essas três alterações. Isso não estabelece cobertura de endpoints, cobertura de código, cobertura de segurança ou uma taxa geral de detecção de defeitos. Da mesma forma, uma grande contagem de testes diz pouco sobre cenários duplicados ou a força de suas asserções.
Autenticação e autorização merecem testes independentes em um aplicativo adequado: credenciais ausentes, credenciais expiradas e acesso a recursos de outro usuário. O comportamento de demonstração do Petstore não pode estabelecer que seus controles de acesso de produção funcionam.
Ferramentas de IA para testes de API em CI/CD
Depois que um revisor aceitar a suíte, faça commit dessa versão exata. Uma build deve executar expectativas conhecidas contra o aplicativo candidato. Regerar testes durante cada build introduz outro componente variável e torna as falhas mais difíceis de reproduzir.
Fixe o runner, as dependências, as fixtures e a especificação. Armazene um lock de dependências junto aos testes e preserve a revisão do aplicativo no relatório. Resolva segredos a partir do ambiente de CI, mantenha-os fora de arquivos gerados e verifique se logs de falha não os expõem.
Com pytest, a forma básica de relatório é simples:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Forneça BASE_URL por meio do ambiente do job. Inicie o serviço local no ciclo de vida do job, aguarde a prontidão e então execute a suíte. Sempre colete o relatório e o log do serviço, mesmo em caso de falha. Finalize parando o serviço do próprio job e limpando seus dados; evite comandos de limpeza de todo o processo em agentes compartilhados.
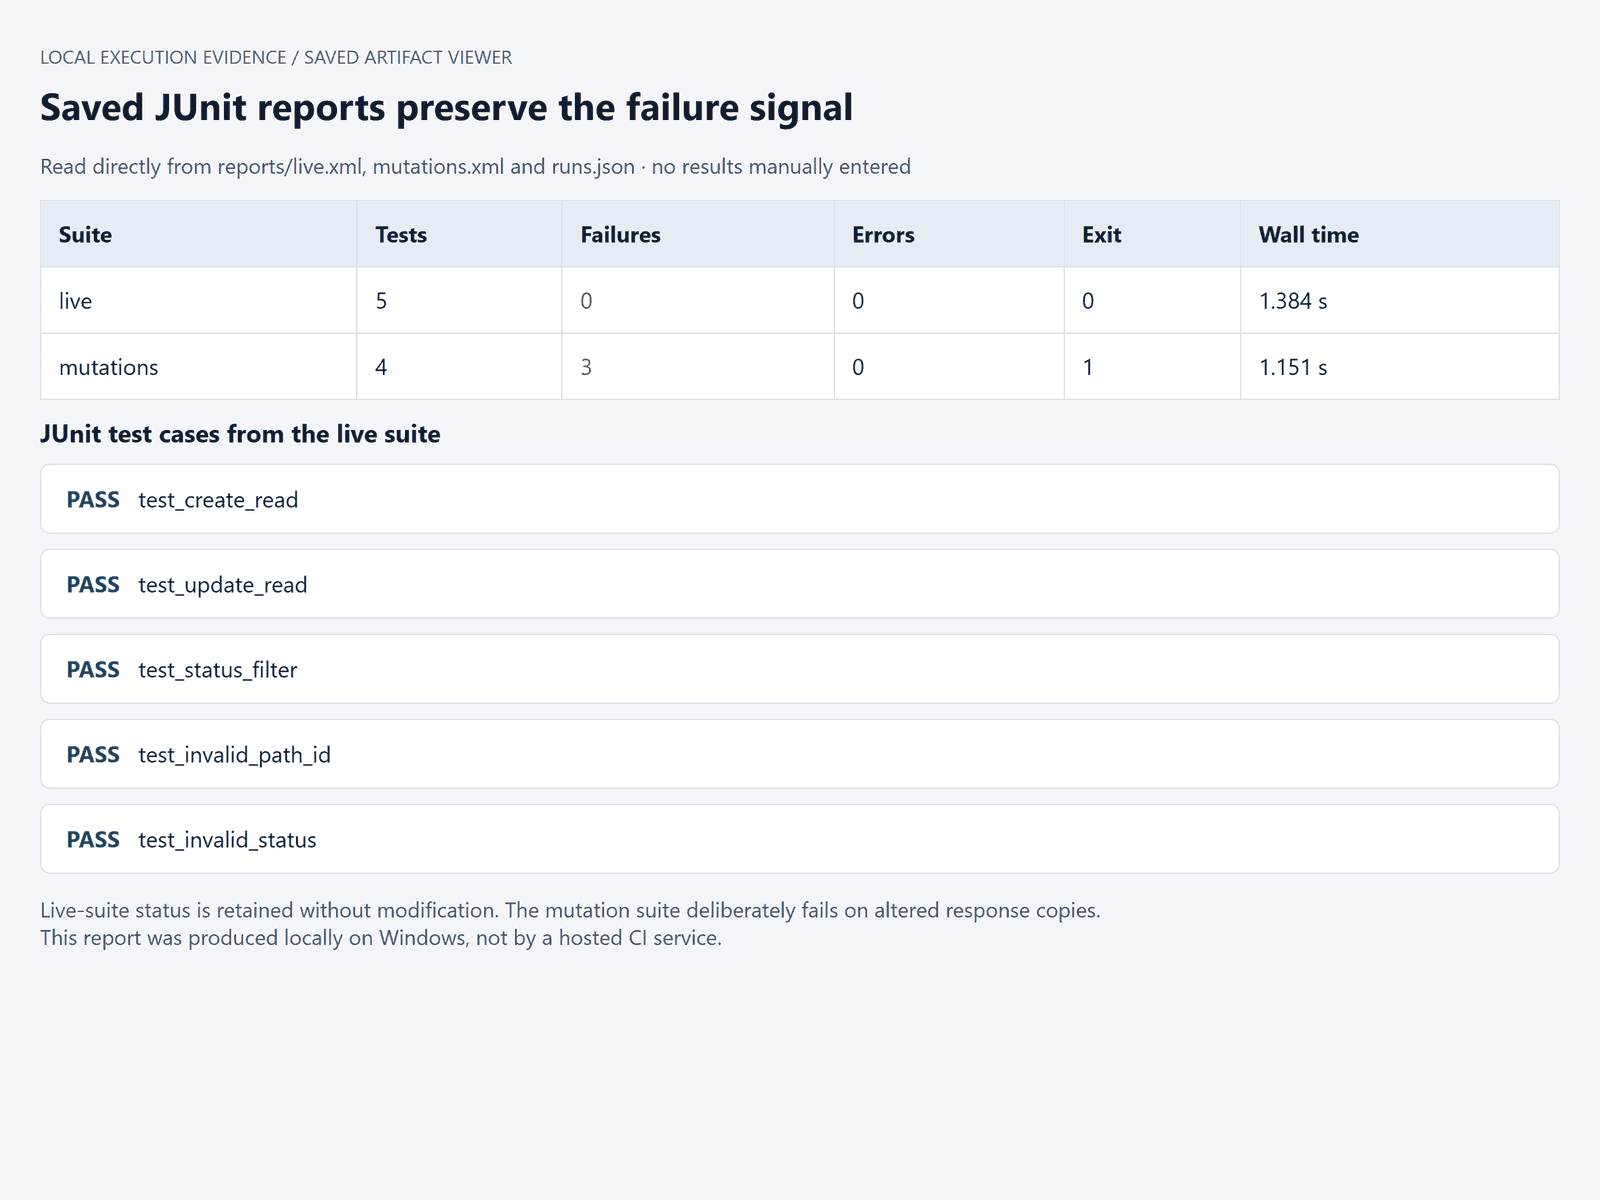 Relatório JUnit local do pytest com contrato real separado e verificação de asserções: resultadosActual local
Resultados do JUnit: 5 testes reais passaram; a suíte de cópias controladas contém 1 linha de base aprovada e 3 falhas intencionais. Nenhuma execução de CI hospedada é alegada.
Os tempos totais medidos, incluindo a inicialização do processo Python, foram 1,384 segundos para a suíte real e 1,151 segundos para a suíte de cópias controladas. Estes excluem build/inicialização do serviço, instalação de dependências, rascunho e revisão. Arquivos JUnit e os logs não abreviados são salvos separadamente.
Teste o caminho de falha antes de confiar no gate. Uma asserção com falha deve produzir um código de saída de job com falha. Tentativas repetidas devem ser limitadas e justificadas para transientes conhecidos de infraestrutura; novas tentativas repetidas que acabam ocultando uma falha do produto tornam o gate menos informativo.
Trate falhas de limpeza explicitamente. Mantenha a falha de asserção primária visível, registre qual recurso permanece e deixe o teardown relatar seu próprio problema. Jobs paralelos precisam de identificadores ou namespaces separados. Um teste que passa sozinho, mas lê dados de outro job, não está pronto para uso não assistido.
Se você já tem pytest, pode escolher o modelo de rascunho separadamente. Atlas Cloud se encaixa nesse papel mais restrito: uma camada de modelo para um fluxo de trabalho personalizado cuja execução e relatório já existem. Ele não é apresentado aqui como uma plataforma completa de testes de API nem como um backend nativo para os três produtos acima.
Para essa avaliação, abra DeepSeek V4.1 Flash, ID do modelo deepseek-ai/deepseek-v4.1-flash, e forneça a mesma especificação pública e matriz revisada usadas localmente. Use o Prompt B e depois salve o rascunho retornado separadamente do teste revisado. Compare suas premissas com o contrato antes de executar qualquer coisa.
Se exposta pela interface, uma temperatura de 0,2 é uma configuração inicial para rascunho, não uma garantia de determinismo. Verifique o limite de saída disponível em relação ao tamanho da sua suíte. Consulte o catálogo atual de modelos para preços de tokens, em vez de orçar com base em um artigo antigo.
A divisão do trabalho permanece explícita: o modelo propõe código, um revisor aprova expectativas e o runner produz resultados. O gate de acesso ao ambiente de teste impediu uma execução completa do Atlas para este artigo, então esta é uma receita de avaliação, não um resultado medido do modelo. Você pode avaliar essa rota sem migrar um runner de teste funcional nem entregar suas responsabilidades de execução a um modelo de chat.
Escolhendo ferramentas de IA para testes de API para sua equipe
Escolha a menor avaliação que possa mudar sua decisão. Use um fluxo de trabalho conectado, um caso negativo documentado e algumas respostas erradas controladas. Mantenha entradas equivalentes entre candidatos. Uma experiência de onboarding refinada não deve pesar mais do que um teste que não consegue identificar o recurso errado.
Para um fluxo de trabalho de coleção maduro, comece avaliando os recursos de IA nesse workspace. Configuração de ambiente existente e dependências de requisição são contexto valioso. Meça se as alterações geradas economizam esforço de revisão sem introduzir premissas frágeis.
Para uma equipe com uma especificação sólida e um backlog de escrita, avalie a geração baseada em especificação. Preste atenção ao que acontece quando a especificação está incompleta. Um gerador que sinaliza claramente expectativas ausentes é mais fácil de revisar do que um que as inventa com confiança.
Para um aplicativo cujas falhas dependem do comportamento upstream, avalie gravação e reprodução. Inspecione linhas de base capturadas e suporte a dependências antes de investir em grandes gravações. Decida quais campos dinâmicos podem variar e quais relacionamentos devem permanecer intactos.
Para uma equipe com um runner estável, avalie um modelo independente para rascunho e revisão. Você mantém o formato de execução que já conhece, mas também é responsável pela integração, design de fixtures e manutenção. Inclua essa responsabilidade no cálculo de custo.
Antes de pagar por ferramentas de IA para testes de API, exija cinco demonstrações concretas:
- A suíte revisada é executada no ambiente pretendido.
- Erros controlados relevantes fazem as asserções apropriadas falharem.
- Testes e relatórios úteis podem ser retidos em um formato aceitável.
- Execuções repetidas, incluindo execução em CI, preservam isolamento e sinais de falha.
- Custos de geração, execução e manutenção cabem no orçamento da equipe.
Atribua alguém para manter a suíte aceita. Uma mudança na especificação deve acionar uma revisão das asserções, fixtures e consumidores afetados. Mantenha a evidência de falha antiga até que a mudança seja compreendida. Isso torna a próxima release mais fácil de avaliar e dá à equipe um motivo para confiar em um relatório verde.
Perguntas frequentes
Qual ferramenta de IA devo usar para testes de API?
Comece com suas entradas existentes. Avalie o Postman Agent Mode para coleções estabelecidas, o KushoAI para geração liderada por especificação e o Keploy por suas rotas distintas de fluxo gerado e gravação. Se sua equipe já mantém pytest ou outro runner, um modelo de rascunho separado pode se adequar. Use o mesmo pequeno fluxo de trabalho para avaliar as asserções, execução e esforço de revisão de cada candidato.
Existem ferramentas de IA gratuitas para testes de API?
Existem clientes gratuitos, ferramentas de teste de código aberto e cotas limitadas de IA. Eles cobrem necessidades diferentes. O plano Free do Postman lista 50 créditos de IA mensais em 21 de setembro de 2026; isso não é uma contagem de testes. Verifique se os recursos necessários de exportação, automação, relatórios e colaboração estão incluídos antes de tratar um teste interativo como solução de CI gratuita.
A IA pode gerar testes de API a partir de uma especificação OpenAPI?
Sim, um gerador pode usar operações, esquemas, parâmetros e definições de resposta para propor testes. A especificação ainda pode omitir regras de negócio ou deixar mapeamentos de erro ambíguos. Forneça expectativas aprovadas e revise o resultado. No exemplo fixado do Petstore, uma criação bem-sucedida é documentada como 200, ilustrando por que convenções REST familiares não podem substituir o contrato real.
Como sei se asserções geradas por IA são úteis?
Verifique três coisas: restrições de esquema documentadas, relações entre requisições e respostas, e sensibilidade a dados deliberadamente incorretos. Salve uma resposta real, modifique uma propriedade relevante e execute novamente o mesmo validador. Mantenha a mensagem de falha. Isso fornece evidência estreita e reproduzível sobre essas asserções, deixando questões mais amplas de cobertura e segurança abertas para testes separados.
Posso executar testes de API gerados por IA em CI/CD?
Sim, quando o formato gerado, o runner, o ambiente e o plano suportam essa rota. Faça commit de testes revisados, instale dependências fixadas, use fixtures isoladas e exporte um relatório estruturado como JUnit. Verifique se falhas retornam um código de saída diferente de zero. Uma execução local bem-sucedida prepara a suíte para CI; isso não prova que um pipeline hospedado foi executado.
A IA pode substituir testes manuais de API?
A IA pode reduzir rascunhos repetitivos e ajudar revisores a encontrar asserções fracas. Pessoas ainda decidem o comportamento pretendido, investigam falhas ambíguas e exploram riscos fora dos exemplos fornecidos. Use ferramentas de IA para testes de API para produzir ativos de teste revisáveis e depois julgue-as por evidência reproduzível. Uma suíte menor que captura erros significativos é mais fácil de confiar do que uma coleção inexplicada de verificações verdes.


