O código parece pronto. Então os testes falham, a correção altera uma interface e outra requisição começa a ser executada. Escolher a melhor API de IA para programação significa encontrar um modelo e um endpoint que concluam o seu tipo de trabalho dentro de um orçamento aceitável.
Comece com Claude, GPT ou Gemini como candidato de referência. Compare DeepSeek, Qwen e Kimi nas mesmas tarefas se quiser opções alternativas de implantação e gasto. Para depuração, priorize testes de regressão. Para refatoração, inspecione o diff. Para um agente de programação, verifique todo o ciclo de ferramentas antes de comparar preços de tokens.
A frustração é mensurável. Na Pesquisa com Desenvolvedores do Stack Overflow de 2025, 66% dos respondentes à pergunta sobre frustrações relataram soluções de IA quase corretas; 45% relataram gastar mais tempo depurando código gerado. Essas são respostas de pesquisa, não uma avaliação de modelos de 2026. (Stack Overflow Developer Survey, 2025)
Principais Conclusões
- Escolha a API e o agente separadamente.
- Faça uma pré-seleção por tarefa e pelos recursos de endpoint exigidos.
- Salve as primeiras respostas e avalie-as segundo testes de aceitação fixos.
- Inclua tentativas falhas e reparos no cálculo de custo.
Este guia oferece uma pré-seleção, três tarefas de avaliação que podem ser copiadas e uma planilha de custos. A pesquisa foi verificada em 21 de setembro de 2026. Disponibilidade de modelos, capacidades documentadas e resultados medidos são categorias de evidência distintas ao longo do texto.
Melhor API de IA para Programação: A Pré-Seleção
Comece com dois candidatos: um que se encaixe na sua aplicação atual e um alternativo. Use estas seis famílias para montar esse par inicial.
A tabela propõe testes, sem alegar desempenho comparativo. O acesso depende da sua conta, região, cota e endpoint; uma listagem na documentação não confirma que suas credenciais conseguem chamá-lo.
| Modelo e ID específicos | Caminho de acesso | Tarefa que vale avaliar | Principal limite de decisão | Evidência do endpoint | Verificação de preço |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | Anthropic API | Alterações restritas em vários arquivos | Verificar cliente e controles de raciocínio | Visão geral dos modelos da Claude Platform; acesso à conta não testado | Nenhuma tarifa citada |
GPT-6 Astra, gpt-6-astra | OpenAI API | Tarefas de programação com múltiplas condições | Verificar rota e ferramentas | Documentação de modelos da OpenAI; acesso à conta não testado | Nenhuma tarifa citada |
Gemini 3.8 Flash, gemini-3.8-flash | Gemini API | Geração e revisão interativas | Verificar latência e protocolo | Diretório de modelos do Google AI; acesso à conta não testado | Nenhuma tarifa citada |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Rota de modelos do Atlas Cloud | Correções numéricas; experimentos de contexto | Manter a versão 0813 separada | Página exata do modelo verificada; recursos em tempo de execução não testados | 21 de setembro de 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Rota de modelos do Atlas Cloud | Refatorações; interfaces autocontidas | Versão especificada; não a mais recente | Página exata do modelo verificada; recursos em tempo de execução não testados | 21 de setembro de 2026 |
Kimi K3, moonshotai/kimi-k3 | Rota de modelos do Atlas Cloud | As mesmas três tarefas; interface CSV | Verificar limites de saída e de conclusão | Página exata do modelo verificada; recursos em tempo de execução não testados | 21 de setembro de 2026 |
Claude, GPT e Gemini fornecem candidatos de referência úteis. Seus diretórios oficiais de modelos identificam as versões acima. Use um provedor que você já conhece como linha de base e depois teste se uma alternativa reduz o custo por tarefa aceita ou o trabalho de integração. Não trate o comportamento de um assistente de consumo como o resultado correspondente da API.
O diretório de modelos da OpenAI lista o GPT-6 Astra junto com a família GPT-5.6. Isso estabelece um candidato atual, não uma vitória em programação sobre as outras linhas. A tabela evita deliberadamente importar IDs de modelos antigos de páginas de comparação sem data. (Diretório de modelos da OpenAI, acessado em setembro de 2026)
O DeepSeek merece um lugar como família de modelos separada a ser investigada. Teste se ele corrige o bug específico sem ampliar a alteração. Escolha outro candidato se a rota implantada não puder satisfazer o formato de resposta, o comportamento de ferramentas ou o teto de latência exigidos, independentemente da reputação geral do modelo.
Avalie o Qwen por versão. A implantação nomeada 122B A10B fornece uma referência de preço concreta. Execute as verificações de parsing e de navegador antes de tirar uma conclusão de valor. Números de contexto de outros lançamentos do Qwen não podem ser atribuídos a este modelo.
O Kimi é o candidato de configuração trabalhado. Sua página pública identifica o ID do modelo. A revisão da configuração é possível; a geração bem-sucedida permanece não verificada. Avalie sua saída concluída segundo as mesmas restrições dos outros candidatos.
O Atlas Cloud fica na camada de acesso nesta comparação. Ele não é um sétimo modelo. Sua relevância é prática: você pode inspecionar várias páginas de modelos candidatos e comparar seus requisitos de integração antes de se comprometer com um fluxo de trabalho.
Para pesos abertos, verifique a licença exata do lançamento e o artefato de implantação. A inferência hospedada tem termos de serviço e custos operacionais separados; apenas a família de modelos não consegue estabelecê-los.
APIs de Programação, Modelos e Agentes Explicados
Um modelo produz conteúdo em resposta a uma entrada. Uma API define como sua aplicação envia essa entrada e recebe o resultado. Um agente de programação organiza o trabalho ao redor: ler arquivos, chamar ferramentas, aplicar edições, executar testes e decidir se deve continuar.
Essas três camadas podem falhar de forma independente. Um modelo pode propor um patch correto enquanto o agente o grava no arquivo errado. Uma API pode retornar JSON válido enquanto a aplicação ignora uma chamada de ferramenta. Um agente capaz pode travar porque o endpoint selecionado rejeita um parâmetro.
Suponha que você envie um handler e peça um parser de ID. Uma API básica de geração de código retorna texto contendo código. Seu programa ainda precisa extrair esse código, colocá-lo em um workspace adequado e executar os testes. Uma resposta HTTP bem-sucedida estabelece entrega, não correção.
Um agente pode automatizar essas etapas apenas se você fornecer as ferramentas e permissões. Ele também precisa de uma condição de parada. Sem uma, ele pode editar repetidamente uma função já aceitável, ampliar a tarefa ou gastar requisições adicionais tentando melhorar um detalhe irrelevante.
Mantenha três linhas de orçamento separadas:
- Assinatura de ferramentas: a aplicação, integração com editor ou serviço de agente que você usa.
- Uso de inferência: requisições ao endpoint de modelo selecionado, sob seus termos de faturamento.
- Ambiente de execução: contêineres, executores de testes, armazenamento e outra infraestrutura.
Alguns produtos empacotam partes dessa pilha. Outros esperam que você traga credenciais separadas. Verifique o plano específico antes de presumir que uma assinatura de editor inclui tráfego arbitrário de API vindo da sua própria aplicação.
A compatibilidade de protocolo também tem um limite. Um serviço que aceita um array messages familiar ainda pode expor comportamento de ferramentas, eventos de streaming, limites de contexto ou controles de raciocínio diferentes. Copiar uma URL base não consegue estabelecer suporte a todos os recursos do ecossistema de outro provedor.
Mapeie aplicação, agente, endpoint, modelo, ferramentas e testes. Identifique o componente faturável e o operador responsável em cada etapa antes de trocar de modelo.
Melhor API de IA para Programação: 7 Verificações de Seleção
1. Correção funcional e comportamento de regressão. Escreva as saídas esperadas antes de solicitar o código. Uma função de preço que lida com inteiros comuns mas aceita null como zero viola o contrato. Execute tanto os novos casos de borda quanto os testes existentes do projeto; passar em um novo teste pode esconder um chamador quebrado em outro lugar.
2. Escopo da alteração. Compare o patch com a solicitação. Extrair um parser de ID deve preservar a URL, a resposta de sucesso e a resposta de erro. Uma migração de framework não solicitada adiciona trabalho de revisão mesmo quando o substituto compila. Decida de antemão se edições não relacionadas desqualificam a resposta ou exigem um reparo.
3. Contexto útil e espaço de saída. Sua requisição inclui instruções, arquivos relevantes, definições de ferramentas e conversa anterior. Reserve espaço suficiente para a resposta também. Uma janela de contexto grande anunciada não estabelece que o modelo encontrará a invariante relevante, nem que seu endpoint aceita o mesmo máximo.
Teste a qualidade do contexto com uma dependência que importa. Inclua um chamador cuja interface deve permanecer estável e verifique se o modelo a respeita. Meça o truncamento separadamente: uma resposta que termina no meio de uma função não pode ser aceita só porque suas primeiras linhas pareciam promissoras.
4. Chamada de ferramentas e saída estruturada. Verifique a rota implantada com o esquema de ferramentas real. Confira tipos de argumentos, campos ausentes, identificadores de ferramentas e a resposta de acompanhamento após o resultado de uma ferramenta. Um modelo que escreve um objeto JSON plausível não necessariamente completou uma ida e volta nativa de chamada de ferramenta.
5. Tempo até um resultado aceito. Registre a duração da tentativa completa, incluindo reparos e testes. Para um assistente interativo, o tempo até o primeiro texto visível também importa, mas não substitui o tempo de conclusão. Um primeiro token rápido seguido de uma resposta longa e inutilizável ainda bloqueia o desenvolvedor.
6. Encargos de entrada, saída, cache e retentativas. Leia as categorias de faturamento que o endpoint escolhido realmente reporta. Separe leituras de cache da entrada comum quando aplicável. Acompanhe requisições malsucedidas e loops abortados. Se o provedor não expõe o detalhe de que você precisa, marque explicitamente as premissas ausentes da estimativa.
7. Condições de integração e tratamento de código. Confirme que seu editor ou aplicação suporta a rota, o método de autenticação e o formato de erro. Revise os termos atuais de tratamento de dados do provedor antes de enviar código-fonte privado. Pesos abertos descrevem uma escolha de distribuição de modelo; eles não estabelecem como um serviço hospedado trata suas requisições.
Benchmarks públicos podem ajudar a selecionar candidatos, desde que você leia suas condições. O SWE-bench Verified contém 500 instâncias filtradas por humanos. Sua página atual também descreve uma visão Bash Only usando o mesmo ambiente mini-SWE-agent. Esses detalhes ajudam a explicar o que está sendo comparado. (SWE-bench, acessado em setembro de 2026)
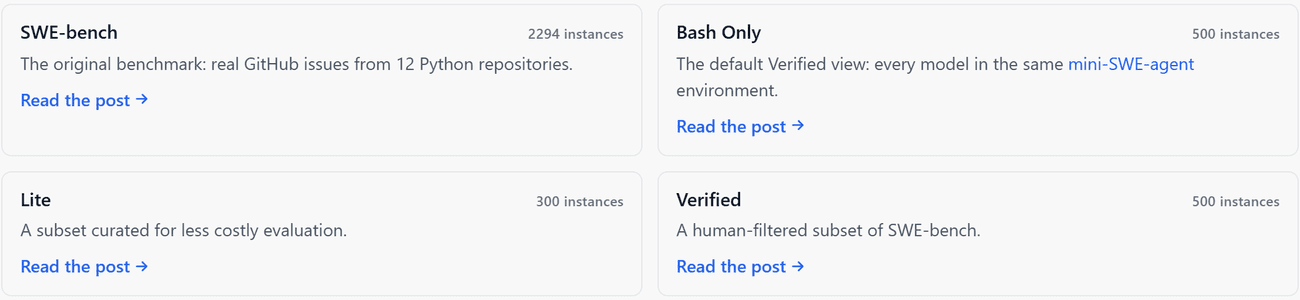 Página do SWE-bench mostrando o tamanho do conjunto de dados Verified e o ambiente de agente compartilhado
Evidência de fonte: a página real do benchmark, capturada em 21 de setembro de 2026. O conjunto de dados e as condições de execução pertencem ao lado de qualquer alegação de desempenho.
Resultados de benchmark descrevem uma configuração específica. Sua linguagem, regras de negócio, permissões e padrões de revisão podem diferir. Tome a decisão final sobre trabalho que você possa inspecionar.
Melhor API de IA para Programação: Execute Três Verificações Práticas
Estes três exemplos de avaliação reproduzíveis expõem modos de falha diferentes. Defina suas regras de aceitação antes de solicitar a saída. Julgue a função ou a página segundo seu contrato, independentemente da qualidade da explicação.
Para o DeepSeek V4 Pro, o Qwen3.5 122B A10B e o Kimi K3, o protocolo pretendido é de três execuções independentes por tarefa. Isso significa 27 tentativas iniciais. Permita no máximo um reparo por feedback por tentativa, preserve a primeira resposta e relate resultados iniciais e reparados separadamente.
Solicite temperatura zero apenas onde houver suporte, registrando a configuração efetivamente aceita. Use um teto de saída solicitado de 4.096 tokens para A e B e 8.192 para C após verificar os limites do endpoint. Padrões e controles não suportados devem ser registrados. Temperatura baixa não garante respostas idênticas.
Status da evidência: o acesso ao ambiente de teste foi bloqueado por uma tela de login do Cloudflare Access. As 27 tentativas dos candidatos não puderam ser executadas. As evidências a seguir mostram código original executado localmente e um fixture de referência em CSV criado pelo autor do artigo, não resultados de modelos candidatos. Taxas de aprovação dos modelos, uso de tokens e custos das tarefas permanecem não medidos.
Tarefa A: corrigir a seleção numérica de preço. Cole este prompt exato em uma sessão nova:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
As entradas de aceitação fixas são [2,10,3], ["12","3"], um array vazio, valores apenas inválidos, zero, números negativos e strings apenas com espaços em branco. Rejeite strings em branco após o trim. Verifique que o array original tem exatamente os mesmos elementos na mesma ordem após a chamada.
O original usa a ordenação padrão do JavaScript e modifica sua entrada. A tarefa, portanto, verifica duas obrigações distintas: selecionar o mínimo numérico correto e evitar alterar os dados do chamador. Teste as regras de conversão explicitamente, pois uma solução curta baseada em coerção pode aceitar booleanos ou null por acidente.
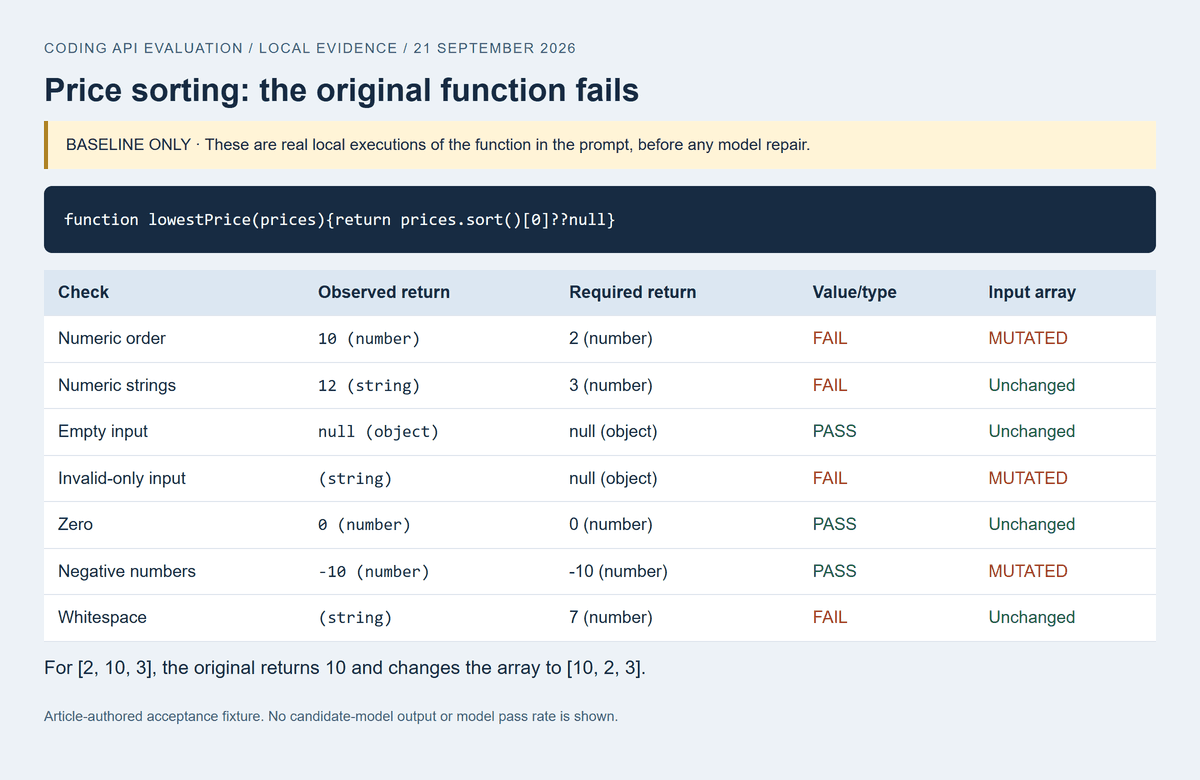 Execução local da função de preço original mostrando ordenação numérica incorreta e entrada modificada
Linha de base executada: a função original retorna 10 para [2,10,3] e altera o array para [10,2,3]. Strings numéricas também falham no contrato do valor de retorno. Nenhum reparo de modelo é mostrado.
Tarefa B: preservar uma interface durante uma pequena refatoração. Use este prompt sem alterações:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Aceite "12" e "0012" como 12. Rejeite "1e2", "1.0", negativos, zero, espaços em branco, entradas que não sejam strings e valores além do intervalo de inteiros seguros do JavaScript. Verifique o caminho registrado e ambos os corpos de resposta. Entradas inválidas não devem chegar a findUser.
Esta tarefa testa se o modelo entende a diferença entre conversão numérica e a gramática de string especificada. Inspecione o diff em busca de alterações não relacionadas e depois chame o handler com objetos de requisição e resposta simulados. Um helper correto emparelhado com um handler permissivo e inalterado ainda falha.
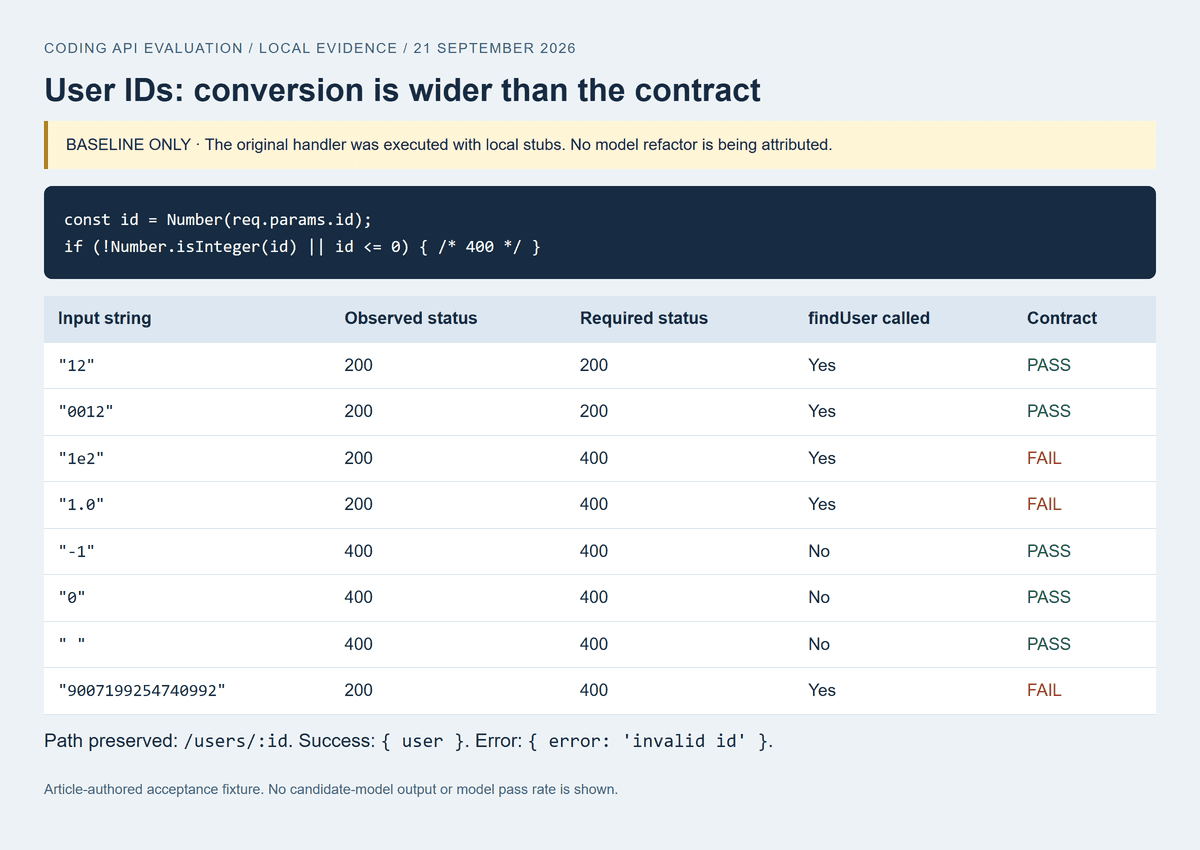 Log de teste do handler original mostrando strings numéricas inválidas aceitas com status 200
Linha de base executada: o handler original retorna 200 para "1e2", "1.0" e "9007199254740992", apesar da resposta 400 exigida. Stubs locais registraram as chamadas; isto não é uma refatoração gerada por modelo.
Tarefa C: construir uma pré-visualização de CSV que você possa operar. Envie:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Teste com estes registros exatos, primeiro usando LF e depois CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Espere duas colunas, três linhas de dados, a vírgula de Alice dentro de uma célula e a aspa escapada de Bob exibida corretamente. O valor de Eve deve aparecer como texto literal, sem elemento de imagem, execução de evento ou requisição de rede. Adicione uma linha com três campos e confirme que a página relata a inconsistência de forma visível.
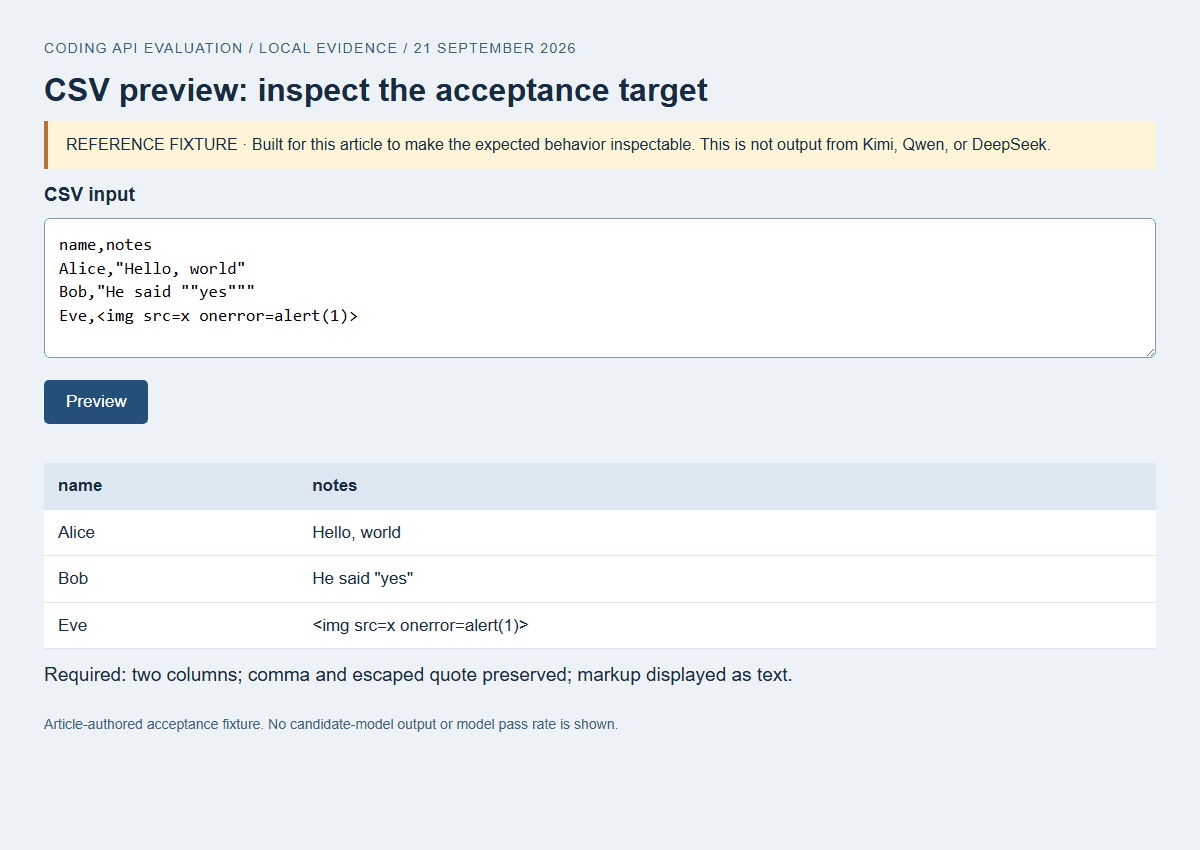 Fixture de aceitação de CSV mostrando valores entre aspas e requisitos de marcação literal
Fixture de referência operado, criado para este artigo, não gerado por um modelo candidato. Verificações no navegador confirmaram parsing de LF/CRLF, aspas escapadas, marcação literal, erros visíveis de contagem de campos e nenhuma requisição HTTP. A captura de tela mostra o estado de entrada válida após clicar em Preview.
Salve a saída bruta, logs, ID do modelo, data, parâmetros, tempo, reparos e edições manuais. Envie as asserções que falharam para um reparo sem alterar os resultados esperados. Mantenha recusas, truncamentos e erros junto com os sucessos.
Melhor API de IA para Programação com Orçamento Limitado
Compare tarifas de tokens juntamente com qualidade de conclusão e uso. Entradas repetidas podem dominar os custos de revisão de código; a geração de arquivos inteiros pode aumentar os encargos de saída. Reparos repetidos somam ambos.
O catálogo e as páginas exatas de detalhes do Atlas mostravam estas tarifas em dólares por milhão de tokens em 21 de setembro de 2026:
- DeepSeek V4 Pro: US$ 1,68 de entrada e US$ 3,38 de saída. A listagem separada V4 Pro 0813 usa tarifas diferentes; não a substitua.
- Qwen3.5 122B A10B: US$ 0,30 de entrada e US$ 2,40 de saída. O catálogo exibia tarifas regulares de US$ 0,40 e US$ 3,20 com 25% de desconto, em setembro de 2026.
- Kimi K3: US$ 3,00 de entrada e US$ 15,00 de saída.
Estas são tarifas de produção exibidas, não faturas da avaliação do artigo. Tarifas específicas de cache e sua aplicabilidade não foram confirmadas. Descontos promocionais para DeepSeek e Kimi não foram confirmados. A ausência de observação de desconto não prova que nenhuma oferta exista.
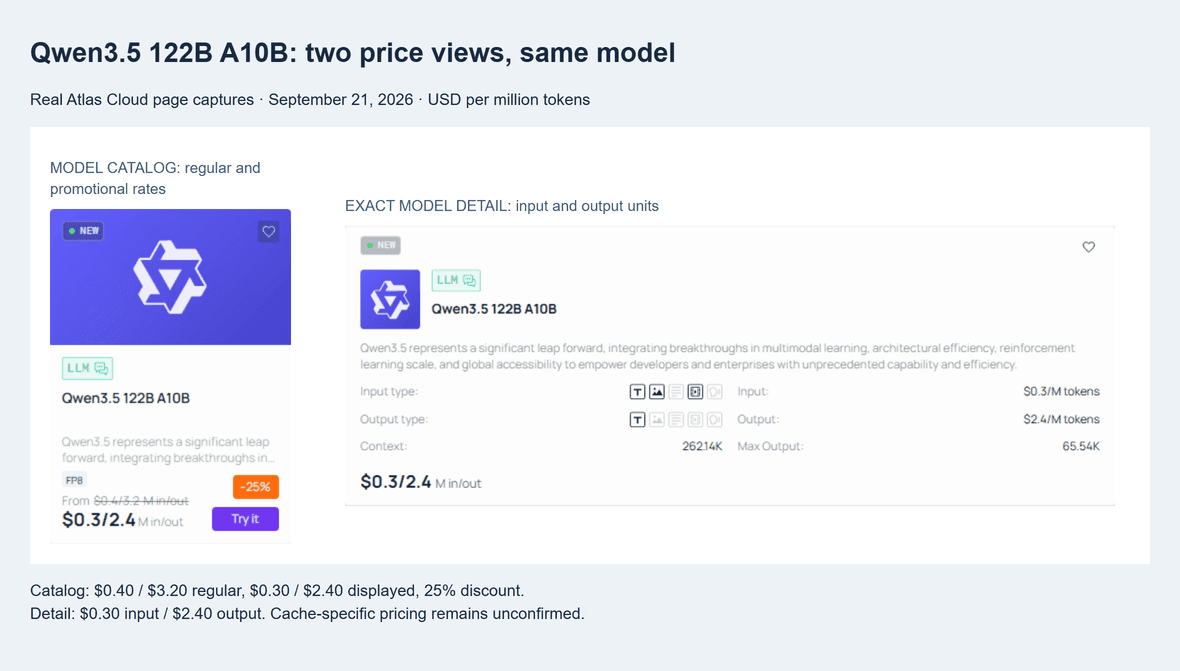 Desconto no catálogo do Qwen3.5 122B A10B ao lado das tarifas exatas de entrada e saída do detalhe do modelo
Verificação cruzada de preços do Qwen, 21 de setembro de 2026: o catálogo mostra a promoção de 25%; o detalhe exato do modelo confirma US$ 0,30 de entrada e US$ 2,40 de saída por milhão de tokens. Tarifas específicas de cache permanecem não confirmadas.
Calcule a parte do modelo em uma tarefa assim:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Não cobre tokens em cache novamente como entrada comum se o registro de faturamento os trata separadamente. Verifique se o uso de raciocínio está incluído na saída faturável. Se nenhuma tarefa passar, relate “nenhum resultado bem-sucedido”; dividir por zero ou exibir um custo de conclusão zero enganaria o leitor.
Para um exemplo aritmético transparente, suponha 10.000 tokens de entrada comum e 2.000 tokens de saída nas tarifas exibidas do Qwen. O encargo estimado do modelo é de US$ 0,0078, antes de quaisquer outros itens aplicáveis. Esta é uma requisição hipotética, não uso de tokens observado nem uma fatura real.
Um reparo de tamanho igual levaria a estimativa a US$ 0,0156. Reparos reais incluem contexto e saída diferentes, então calcule cada requisição a partir do uso registrado.
| Tarefa | Modelo | Primeira passagem | Após reparo | Uso de tokens | Fonte do custo | Encargo total | Tempo total | Alterações manuais |
|---|---|---|---|---|---|---|---|---|
| A, B, C; 3 repetições de cada planejadas | DeepSeek V4 Pro | Não medido | Não medido | Não registrado | Nenhum registro de uso | Desconhecido | Não medido | Nenhuma avaliada |
| A, B, C; 3 repetições de cada planejadas | Qwen3.5 122B A10B | Não medido | Não medido | Não registrado | Nenhum registro de uso | Desconhecido | Não medido | Nenhuma avaliada |
| A, B, C; 3 repetições de cada planejadas | Kimi K3 | Não medido | Não medido | Não registrado | Nenhum registro de uso | Desconhecido | Não medido | Nenhuma avaliada |
Para sua própria planilha, expanda cada linha em uma linha por modelo e repetição. Conte um sucesso reparado uma vez no denominador de tarefas aceitas. Inclua tentativas malsucedidas no numerador e mantenha colunas separadas de primeira passagem e aceitação final.
Acompanhe revisão humana e infraestrutura separadamente. Desemaranhar uma reescrita desnecessária pode apagar uma economia de inferência. Compare candidatos que atendam tanto aos requisitos de aceitação quanto ao seu orçamento de tempo de revisão.
Melhor API de IA para Programação com o Atlas Cloud
Comece pela página do modelo Kimi K3, confirme o ID e inspecione as visualizações de API e Code. Mantenha a versão escolhida junto ao registro de teste.
Leia a documentação de protocolos de LLM antes de tratar duas rotas como intercambiáveis. Ela identifica o Chat Completions como a rota de cobertura ampla e direciona os usuários para o supported_apis de cada modelo. Controles de amostragem e recursos de ferramentas também dependem do suporte anunciado do modelo.
Há detalhes concretos de integração que vale a pena verificar aqui. A documentação diz que requisições Anthropic traduzidas não aplicam cache_control, e que ferramentas hospedadas pelo provedor não estão disponíveis nessa rota traduzida. Essas restrições importam se o seu agente atual assume cache nativo ou uma ferramenta de navegação hospedada. Faça o cliente corresponder à rota real.
O exemplo a seguir em Node.js ilustra uma requisição de texto. Ele usa fetch embutido, uma variável de ambiente para as credenciais e o ID verificado do modelo Kimi. Salve o prompt exato da Tarefa A como task-a.txt. Defina a variável de ambiente da URL base como a base da API do Atlas mostrada em sua documentação, terminando em /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages carrega a tarefa; model seleciona a implantação; max_tokens solicita um teto de saída. O leitor da resposta verifica texto concluído comum antes de retornar código. O timeout limita a espera deste exemplo; ele não estabelece que o servidor parou de processar nem que nenhum encargo ocorreu.
A temperatura foi omitida porque o suporte por modelo e o comportamento garantido precisam de verificação. O exemplo não faz retentativas automaticamente. Revise a classe de falha antes de adicionar uma política de retentativa limitada, e nunca registre o cabeçalho de autorização. Este código de publicação não foi executado com uma chave de API durante a produção do artigo.
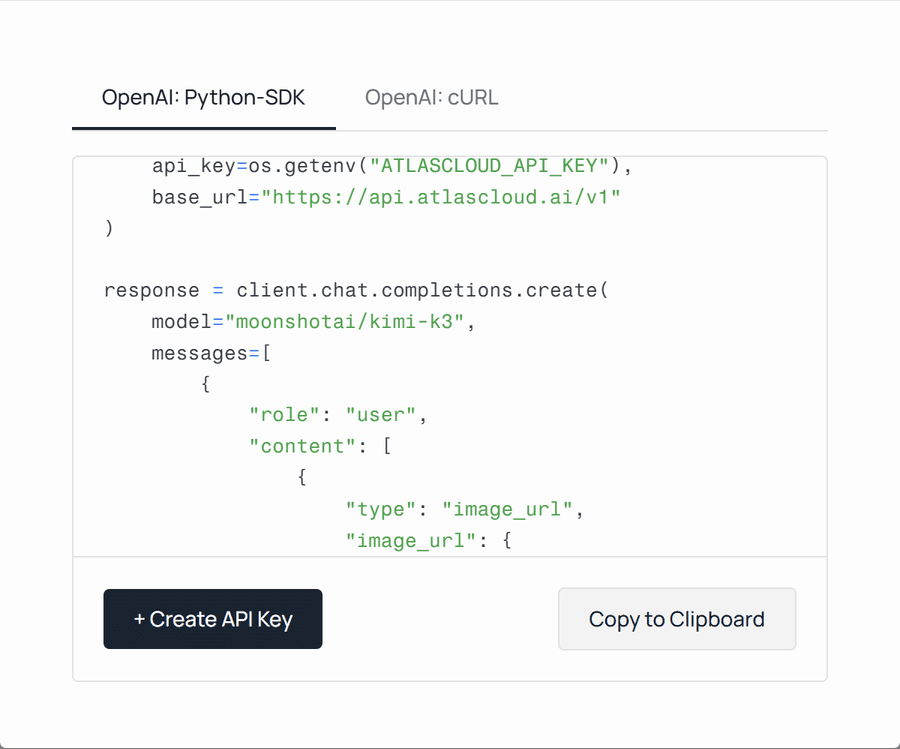 Exemplo público de código da API do Kimi K3 mostrando o endpoint Atlas e o identificador do modelo
Diálogo público de Code do Kimi K3, capturado em 21 de setembro de 2026. Esta é uma evidência de configuração, não uma execução de programação concluída. O exemplo da página inclui entrada de mídia; o exemplo do artigo usa apenas texto.
Execute as verificações de aceitação da Tarefa A em qualquer função retornada. Antes de mudar para DeepSeek ou Qwen, verifique seu protocolo e parâmetros. Mantenha prompts e testes inalterados ao comparar saída e uso; um formato de requisição compartilhado não estabelece comportamento idêntico.
Antes de Usar uma API de Programação em Produção
Execute o código gerado em um branch descartável ou workspace isolado primeiro. Para a tarefa de CSV, use um contexto de navegador local com requisições de rede bloqueadas e sem acesso a estado sensível da aplicação. Para tarefas de repositório, dê ao processo apenas os arquivos e comandos necessários para a avaliação.
Defina o sucesso fora da resposta do modelo. Um agente dizendo “todos os testes passaram” deve levar você a um log de testes real, a um código de saída e a uma revisão verificada. Armazene o diff junto a essa evidência. Caso contrário, um reparo posterior pode alterar os arquivos após o aparente sucesso e deixar o relatório desatualizado.
Trate timeouts e retentativas como comportamento da aplicação que você controla. Defina um prazo para a requisição e um orçamento total para a tarefa. Separe erros causados por credenciais ou parâmetros inválidos de falhas transitórias de transporte. Repetir uma requisição inválida desperdiça tempo; repetir uma requisição que causa efeitos colaterais pode criar trabalho duplicado.
Quando o agente pode chamar ferramentas, distinga inspeção somente leitura de escrita. Atribua identificadores de operação onde seu design de ferramentas suportar, e confirme o estado antes de repetir uma escrita incerta. A política de retentativa de um endpoint de modelo não pode garantir idempotência para as ferramentas que sua aplicação executa depois.
Proteja os logs tão deliberadamente quanto os arquivos-fonte. Registre IDs de modelo, timestamps, status, tempo e uso sem copiar rotineiramente segredos ou repositórios privados inteiros para a telemetria. Mantenha qualquer evidência de saída bruta exigida em um local apropriadamente restrito e estabeleça por quanto tempo a equipe precisa retê-la.
Verifique o streaming com seu cliente real. Ele deve tratar eventos parciais, encerramento, erros e registros de uso quando disponíveis. Confirme os limites de taxa para a conta e a implantação reais. Um experimento silencioso de usuário único não consegue estabelecer como a mesma rota se comporta quando uma equipe envia requisições ao mesmo tempo.
Use esta breve lista de verificação de lançamento:
- Testes de aceitação e regressões existentes passam na revisão final.
- O diff permanece dentro do limite de tarefa aprovado.
- O comportamento de timeout, cancelamento e retentativa foi exercitado.
- Chamadas de ferramentas e respostas estruturadas funcionam no endpoint selecionado.
- Os logs excluem credenciais e código privado desnecessário.
- Os termos de tratamento de dados atendem aos requisitos da equipe.
- Um fallback tem sua própria configuração verificada e registro de teste.
Repositórios privados exigem uma decisão específica do serviço. Revise retenção, uso para treinamento, acesso e condições contratuais atuais com a pessoa responsável pelo código. Envie apenas material aprovado. Não infira confidencialidade pelo fato de os pesos do modelo estarem disponíveis, nem por um protocolo se parecer com um que você já usa.
Melhor API de IA para Programação: Faça Sua Escolha Final
Tome a decisão em três passagens.
Primeiro, elimine candidatos que não atendem a um recurso obrigatório. Anote as condições que devem valer: um formato de saída aceito, um ciclo de ferramentas funcional, um arranjo adequado de tratamento de dados ou um prazo de resposta viável. Um candidato que não atende a uma delas precisa de uma decisão de remediação separada antes de pertencer à comparação final.
Segundo, compare custo por tarefa aceita e tempo decorrido. Use todas as tentativas sob a mesma política de reparo. Separe sucessos de primeira passagem de sucessos reparados e mostre registros de uso ausentes. Se dois modelos atenderem ao contrato, compare também a carga de revisão, além dos encargos do modelo. Seus desenvolvedores conviverão com os patches resultantes.
Terceiro, mantenha um fallback e defina seu gatilho. Exemplos incluem uma indisponibilidade prolongada do endpoint, falhas repetidas de saída estruturada ou custos de tarefa acima de um teto escolhido. Teste a configuração alternativa com antecedência. Trocar um ID de modelo sob pressão pode introduzir um segundo problema de integração se seus controles ou comportamento de resposta forem diferentes.
As três pequenas tarefas deste guia são um exercício de triagem. Amplie o conjunto com trabalho representativo do seu próprio código antes de confiar em um candidato para alterações amplas. Mantenha algumas tarefas fora do ajuste de prompt para poder verificar se as melhorias se transferem além dos exemplos que você otimizou.
A melhor API de IA para programação é a combinação que você consegue explicar: ela conclui o trabalho exigido, expõe custos que você consegue acompanhar e se encaixa na forma como sua aplicação roda. Nenhum vencedor universal é necessário para tomar essa decisão.
Abra o catálogo atual de modelos, escolha dois candidatos e salve seus IDs e configurações exatos. Depois use a mesma tarefa, os mesmos testes e a mesma regra de parada para ambos.
Perguntas Frequentes
Qual é a melhor API de IA para programação com orçamento limitado?
Comece com um candidato cujas tarifas exibidas caibam nos seus volumes prováveis de entrada e saída e depois compare o custo por tarefa aceita. As linhas do Qwen, DeepSeek e Kimi fornecem versões concretas a investigar, sem afirmar um vencedor de valor testado. Limite as tentativas de reparo, reutilize contexto relevante de forma deliberada e acompanhe requisições malsucedidas. Inclua o tempo de revisão separadamente, para que uma fatura de inferência baixa não esconda uma grande carga de limpeza.
Uma assinatura de programação é mais barata do que pagar por tokens de API?
Depende da sua carga de trabalho e do que o plano inclui. Uma assinatura pode servir para uso interativo dentro de sua aplicação suportada, enquanto a cobrança por uso pode se adequar a um serviço personalizado com tráfego variável. Verifique acesso a modelos, limites, concorrência e se chamadas de API externas estão incluídas. Compare a mesma quantidade de trabalho útil em um período representativo; um preço mensal fixo e uma tarifa por token medem coisas diferentes.
Qual é a diferença entre um modelo de programação e um agente de programação?
O modelo gera respostas. O agente gerencia o ciclo ao redor dessas respostas, incluindo acesso a arquivos, execução de ferramentas, testes e regras de parada. Você pode chamar um modelo de programação por uma API sem construir um agente, por exemplo, para sugerir uma função para revisão humana. Se quiser edições autônomas, avalie o modelo junto com o agente e as permissões que ele realmente usará.
Qual API de IA devo usar para depuração e refatoração?
Faça uma pré-seleção de candidatos que se encaixem nos seus requisitos de endpoint e de tratamento de código e depois use pequenos bugs e refatorações restritas do seu trabalho. A Tarefa A verifica correção e mutação de entrada; a Tarefa B verifica parsing e preservação de interface. Siga com testes representativos do repositório.
Prefira o candidato que atende às suas condições de aceitação com esforço de revisão gerenciável, em vez daquele que simplesmente produz a explicação mais longa ou a reescrita mais extensa.
Existe uma API de IA gratuita para programação?
Um crédito de teste, uma aplicação com camada gratuita e pesos de modelo baixáveis são ofertas diferentes. Nenhuma delas dá automaticamente à sua aplicação inferência hospedada ilimitada. Verifique elegibilidade, expiração, cotas e modelos suportados atuais antes de orçar em torno do acesso gratuito. Este artigo não afirma que exista uma cota gratuita disponível no momento.
Se você hospedar os pesos por conta própria, leve em conta computação e operação mesmo quando baixar os pesos não custe nada.
Posso enviar código de repositório privado para uma API de programação?
Envie apenas código que sua organização permite compartilhar sob os termos aplicáveis do serviço específico. Revise retenção, uso para treinamento, controles de acesso e requisitos contratuais para a implantação escolhida.
Remova credenciais e arquivos não relacionados, e verifique o que seu agente inclui automaticamente em prompts e logs. Um modelo de pesos abertos ou um formato de API familiar não estabelece, por si só, que um serviço hospedado atende aos requisitos de confidencialidade da sua equipe.


