DeepSeek Harness não fez parte desse benchmark. Ele foi lançado dois dias depois. Isso significa que a pergunta útil não é "qual venceu?". A pergunta útil é como executar a mesma tarefa em ambas as ferramentas, no mesmo modelo, e ler a conta sem se enganar.
Principais conclusões
- A escolha do harness pode variar o uso de tokens em aproximadamente 7x em tarefas de agente comparáveis.
- Meça o DeepSeek Harness e o OpenCode com o mesmo modelo e o mesmo estado do repositório.
- Use chaves de API separadas antes de escolher uma para o trabalho diário.
Dois laptops executando a mesma tarefa de codificação através de dois harnesses de agente
A configuração justa: um modelo, uma tarefa, dois terminais.
O que o benchmark público nos diz
A Composio executou 30 workflows complexos multi-aplicativos através de 8 harnesses de agente, todos usando DeepSeek V4 Flash, um limite de 900 segundos por tarefa e avaliação binária programática em 240 execuções (Composio, Agosto de 2026). Mesmo modelo, harness diferente.
| Harness | Taxa de aprovação | Tempo médio | Média de tokens por tarefa |
|---|---|---|---|
| Pi Agent | 66,7% | 132,2s | 559.000 |
| Prime Agent | 62,5% | 242,1s | 1.400.000 |
| OMP | 56,7% | 272,4s | 742.000 |
| Claude Code | 53,3% | 122,7s | 742.000 |
| Codex | 53,3% | 245,0s | 678.000 |
| DeepAgents | 53,3% | 187,1s | 665.000 |
| Hermes Agent | 50,0% | 175,5s | 192.000 |
| OpenCode | 46,7% | 129,7s | 692.000 |
A coluna de tokens importa mais do que o ranking. A variação vai de 192.000 a 1.400.000 tokens médios por tarefa. Isso é o mesmo modelo fazendo trabalho comparável através de runtimes diferentes.
O OpenCode nos dá uma linha de base com fonte: 692.000 tokens por tarefa, 46,7% de taxa de aprovação e 129,7 segundos de tempo médio. O DeepSeek Harness não tem um número cabeça a cabeça público desse benchmark porque a DeepSeek o lançou em 13 de agosto de 2026, dois dias após a publicação do benchmark.
Use a tabela como um aviso, não como veredito. Ela mostra que o harness pode dominar o custo. Não prova se o DeepSeek Harness supera o OpenCode no seu repositório.
O que muda quando você troca de harness
Antes de testar, compare as duas ferramentas pelas partes que afetam um desenvolvedor em atividade: superfície de configuração, maturidade, visibilidade de tokens e quanto do loop do agente você pode substituir.
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| Origem | DeepSeek AI | Anomaly (originalmente SST) |
| Lançado | 13 de agosto de 2026 | Final de 2025 |
| Estrelas GitHub | ~143k | ~198k |
| Licença | MIT | MIT |
| Linguagem | TypeScript | Go |
| Interface | Web UI em 127.0.0.1:3080 | Terminal TUI |
| Status | Preview para desenvolvedores, mudanças de quebra esperadas | Maduro, amplamente implantado |
| Arquitetura | Plugins substituíveis para modelos, ferramentas, sessões, sandboxes, armazenamento, loops e UI | Núcleo fixo com agentes de build/planejamento, suporte a MCP e extensões LSP |
| Config | $DSH_HOME/settings.yaml | opencode.json |
| Contabilidade de tokens | Medidor de tokens com pressão de contexto e projeções de detalhamento | Rastreamento de tokens e custo por sessão na TUI |
| Melhor para | Equipes que querem modificar o próprio loop do agente | Equipes que querem um agente de codificação que funcione hoje |
O OpenCode oferece um agente de codificação estável com pontos de extensão nas bordas. O DeepSeek Harness oferece um runtime onde o próprio loop pode ser trocado. Essa flexibilidade ajuda se você estiver construindo infraestrutura de agentes. Adiciona risco se você precisar de uma ferramenta padrão para código de produção esta semana.
Ambas as ferramentas podem atingir o mesmo endpoint compatível com OpenAI. Isso torna possível um teste justo: um modelo, uma URL base, uma tarefa e um estado inicial do repositório.
Para este tutorial, o DeepSeek V4 Flash roda através do Atlas Cloud, que expõe um endpoint compatível com OpenAI aceito por ambas as ferramentas. A listagem deepseek-v4-flash-0731 mostra $0,14 por milhão de tokens de entrada, $0,28 por milhão de tokens de saída, uma janela de contexto de 1.048.576 tokens e saída máxima de 393.216 em agosto de 2026. Qualquer provedor funciona se ambos os harnesses usarem o mesmo endpoint e o mesmo id de modelo.
O OpenCode também publica dados agregados de uso. Os modelos DeepSeek moveram 233 trilhões de tokens através do OpenCode, com V4 Flash respondendo por 85,5% e V4 Pro por 14,5% (OpenCode, Agosto de 2026). Esse padrão de uso torna o V4 Flash uma escolha prática para a comparação.
Passo 1: Aponte ambas as ferramentas para o mesmo modelo
Crie uma chave de API e uma URL base, depois alimente ambas as ferramentas com o mesmo par. Crie a chave no console do Atlas Cloud e exporte-a uma vez:
plaintext1export ATLAS_API_KEY="sua-chave-de-api" 2
Verifique o endpoint antes de passá-lo para qualquer harness:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Responda com a única palavra: pronto"}] 7 }' 8
Essa chamada prova que a rota, a chave e o id do modelo funcionam antes de um harness adicionar ferramentas, retentativas ou repetição de conversa.
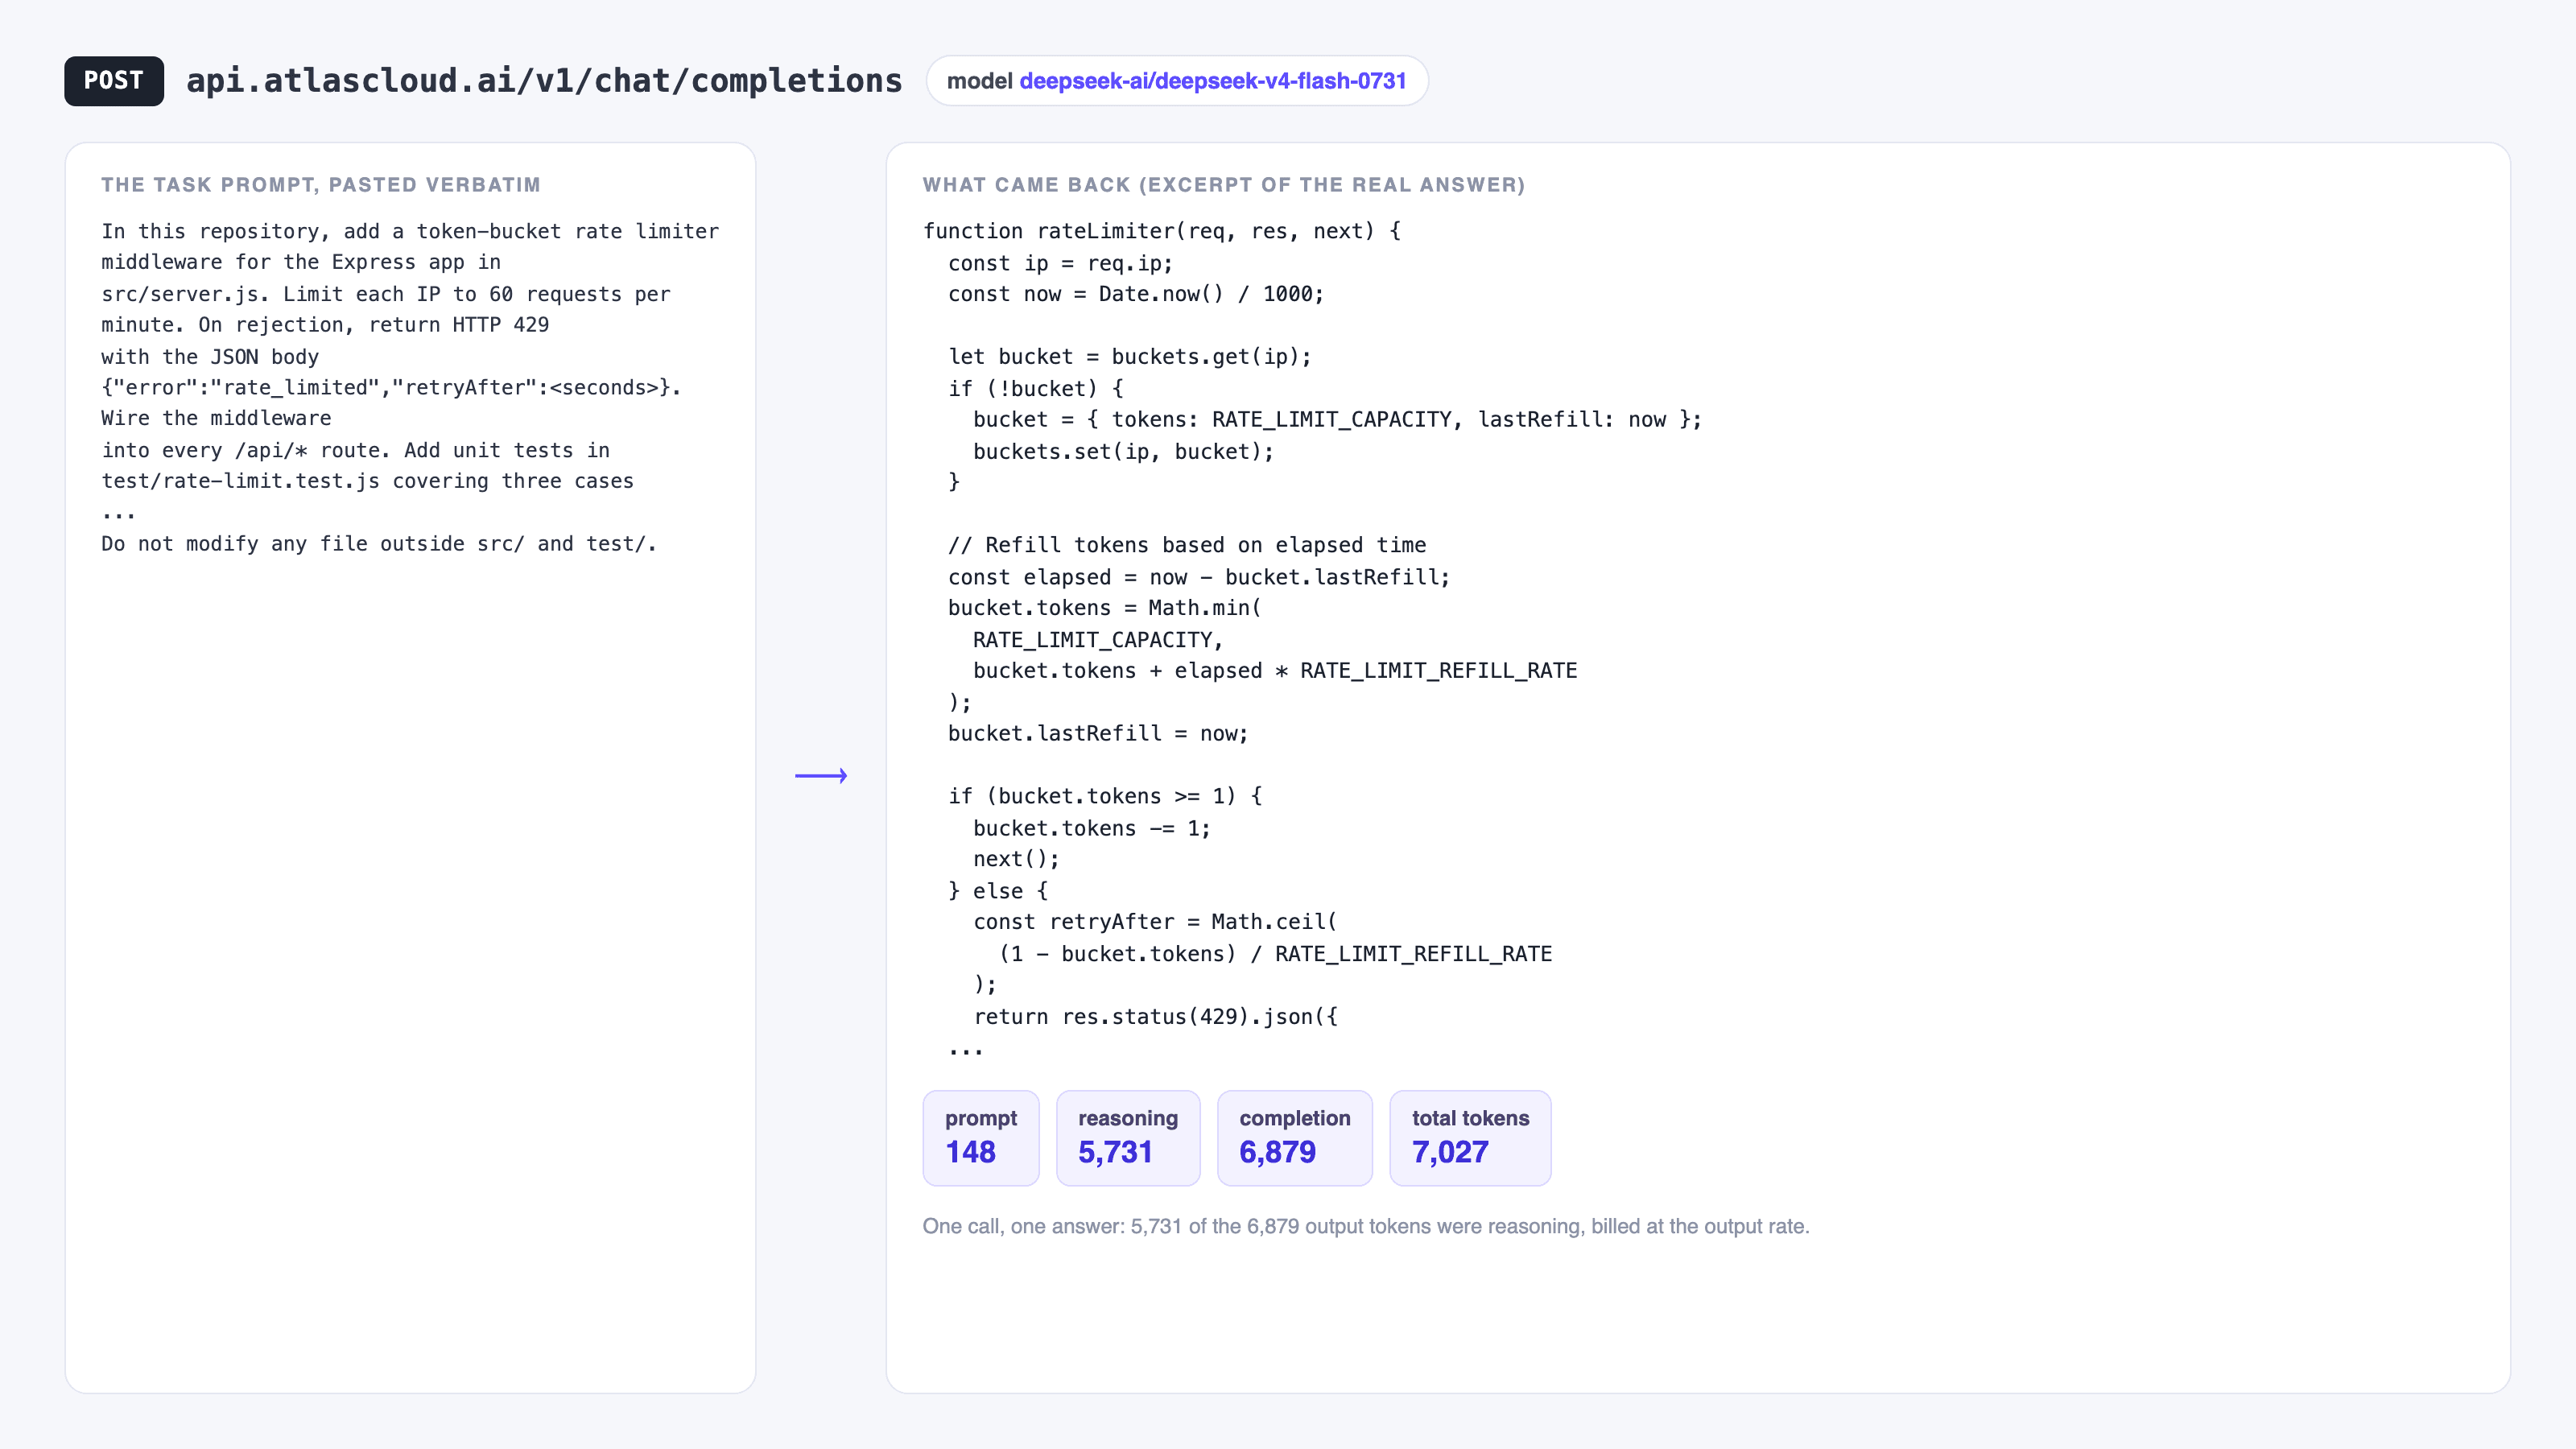
Prompt de codificação, código gerado e estatísticas de tokens de uma chamada de modelo
Uma chamada direta para deepseek-ai/deepseek-v4-flash-0731: 148 tokens de prompt enviados, 6.879 tokens de saída retornados, incluindo 5.731 tokens de raciocínio. Trate isso como o piso antes de um harness adicionar esquemas de ferramentas e histórico.
O DeepSeek Harness lê $DSH_HOME/settings.yaml, e provedores personalizados compatíveis com OpenAI vão sob o plugin llm-pi-ai (docs do DeepSeek Harness, Agosto de 2026):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
Use openai-completions para este endpoint. A interface web pode escrever o mesmo bloco de provedor em Configurações, Modelos, Adicionar provedor personalizado, e depois armazenar a chave em $DSH_HOME/.credentials.yaml.
O OpenCode lê opencode.json na raiz do seu projeto ou no diretório de configuração global (docs do OpenCode, Agosto de 2026):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
Use @ai-sdk/openai-compatible, porque este endpoint serve /v1/chat/completions. Defina os limites reais de contexto e saída. O OpenCode os usa ao decidir quando resumir, e limites errados podem distorcer a comparação de tokens.
Passo 2: Execute a mesma tarefa de benchmark no DeepSeek Harness
Escolha uma tarefa grande o suficiente para precisar de várias chamadas de ferramenta e pequena o suficiente para ser avaliada. Use o mesmo estado do repositório para ambas as execuções, então faça commit ou stash antes de começar.
Cole esta tarefa exata em ambas as ferramentas:
plaintext1Neste repositório, adicione um middleware de limitador de taxa token-bucket para o aplicativo Express em src/server.js. Limite cada IP a 60 requisições por minuto. Na rejeição, retorne HTTP 429 com o corpo JSON {"error":"rate_limited","retryAfter":<segundos>}. Conecte o middleware em todas as rotas /api/*. Adicione testes unitários em test/rate-limit.test.js cobrindo três casos: uma requisição abaixo do limite é permitida, uma requisição acima do limite é bloqueada com 429, e o contador é reiniciado após a janela expirar. Execute a suíte de testes e corrija falhas até passar. Não modifique nenhum arquivo fora de src/ e test/. 2
Inicie o Harness a partir do diretório do seu projeto:
plaintext1cd /caminho/para/seu/repositorio 2npx @deepseek-ai/dsh web 3
A interface roda em http://127.0.0.1:3080. Selecione o provedor atlas e o modelo deepseek-ai/deepseek-v4-flash-0731, cole a tarefa e deixe terminar. Não adicione dicas após a execução começar. Ajuda extra para uma ferramenta invalida a comparação.
Quando o Harness terminar, abra a visualização Trajectory. Esse registro de sessão é onde os números de tokens dele estão.
Passo 3: Repita a execução no OpenCode
Restaure o repositório ao estado inicial exato. O segundo harness não deve herdar arquivos que o primeiro já alterou.
plaintext1git checkout -- . && git clean -fd 2
Depois execute o OpenCode contra o mesmo modelo:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
Cole o mesmo prompt de tarefa do Passo 2. Use o agente build padrão. Deixe terminar sem dicas.
Avalie ambas as execuções com o mesmo comando:
plaintext1npm test 2
Uma execução que deixar a suíte vermelha falha, mesmo que o resumo do agente pareça confiante. Use avaliação binária: passa ou falha.
Passo 4: Leia o uso de tokens
Ambas as ferramentas rastreiam o uso, mas nenhum contador deve ser seu número final de fatura.
DeepSeek Harness vem com um medidor de tokens montado por padrão. Ele expõe tokenUsage, contextPressure e contextBreakdown na visualização Trajectory. contextBreakdown informa se a conta veio do prompt do sistema, esquemas de ferramentas, leituras de arquivo ou repetição de conversa. O medidor estima aproximadamente um token para cada quatro caracteres, então use-o como uma visão diagnóstica.
OpenCode rastreia tokens e custo por sessão e os exibe na linha de status da TUI. Seu detalhamento embutido é menor, então equipes que precisam de atribuição por ferramenta geralmente inspecionam o banco de dados de sessão com analisadores externos.
Use números do lado do provedor para a comparação:
| O que comparar | Onde obter |
|---|---|
| Total de tokens de entrada | Painel de uso do provedor, por chave de API |
| Total de tokens de saída | Painel de uso do provedor, por chave de API |
| Número de chamadas de modelo | Visualização Trajectory do harness / log de sessão do OpenCode |
| Tempo de parede | Cronômetro, do início até a última escrita de arquivo |
| Passa ou falha | Código de saída do npm test |
Crie duas chaves de API, harness-test e opencode-test, e use cada chave para uma execução. O painel do provedor então fornece uso limpo lado a lado sem reconciliar dois estimadores internos.
Por que a conta se move
O uso de tokens muda por razões concretas. Estas cinco geralmente importam mais que o preço do modelo.
A repetição da conversa soma. Agentes reenviam a conversa crescente a cada passo. Uma tarefa de 40 passos custa mais perto da soma de 40 prompts crescentes do que de 40 prompts idênticos. Harnesses que resumem cedo ficam mais perto da extremidade inferior da variação do benchmark.
Acertos de cache reduzem o custo de entrada. Acertos de cache do DeepSeek V4 Flash são precificados em cerca de $0,0028 por milhão de tokens contra $0,14 por milhão em erro, aproximadamente 98% mais baratos. Cache precisa de um prefixo estável byte a byte. Se um harness embaralhar o texto do prompt do sistema entre chamadas, ele transforma acertos em erros.
Esquemas de ferramentas vão junto. Vinte servidores MCP conectados significam vinte conjuntos de esquemas no prompt, mesmo que a tarefa use dois deles. Desconecte ferramentas que você não precisa antes de fazer benchmark, ou você estará medindo sua configuração de ferramentas em vez do harness.
Saídas grandes de ferramentas envenenam o contexto. Um cat de um arquivo de 3.000 linhas ou um log de teste verboso com falha permanece na conversa para chamadas posteriores. O DeepSeek Harness pode podar resultados grandes de ferramentas antes de resumir. Ative isso quando a tarefa produzir saída ruidosa.
Retentativas se escondem dentro da contagem de chamadas. Um harness que tenta novamente um loop de teste com falha gasta tokens a cada vez. Compare chamadas de modelo ao lado do total de tokens para separar um loop de retentativa de um prompt caro.
Na taxa do Atlas Cloud para DeepSeek V4 Flash, uma tarefa de 692.000 tokens ponderada para entrada chega a alguns centavos de dólar. Isso é pequeno para uma execução e grande em uma equipe rodando agentes o dia todo. Navegue pelo catálogo de modelos completo se quiser repetir o teste em um segundo modelo e separar os efeitos do modelo dos efeitos do harness.
O DeepSeek Harness ainda é um preview para desenvolvedores, e seu README avisa sobre mudanças de quebra. Faça benchmark se quiser controle sobre o loop do agente. Padronize nele apenas se sua equipe puder absorver mudanças. O OpenCode é a escolha mais estável para equipes que precisam de uma ferramenta hoje.
Perguntas Frequentes
O DeepSeek Harness é melhor que o OpenCode?
Não para a maioria das equipes ainda. O OpenCode é maduro, nativo de terminal, tem aproximadamente 198k estrelas e um grande catálogo de provedores, e funciona hoje. O DeepSeek Harness é mais novo, em preview para desenvolvedores, e avisa sobre mudanças de quebra. Escolha o Harness se quiser modificar os internos do agente. Escolha o OpenCode se quiser um agente de codificação para o trabalho diário.
O DeepSeek Harness funciona apenas com modelos DeepSeek?
Não. É independente de modelo. Ele vem com provedores de catálogo para DeepSeek, Anthropic, OpenAI, Bedrock, Vertex, Azure e Codex, e você pode adicionar qualquer provedor personalizado que fale openai-completions, openai-responses ou anthropic-messages em $DSH_HOME/settings.yaml. A configuração do Passo 1 o aponta para um endpoint compatível com OpenAI sem código adaptador.
Como verifico o uso de tokens do DeepSeek Harness?
Use o medidor de tokens embutido na visualização Trajectory. Ele expõe tokenUsage, contextPressure e contextBreakdown. Trate como estimativa porque usa aproximadamente um token para cada quatro caracteres. Para precisão de faturamento, leia o painel de uso do provedor, idealmente com uma chave de API dedicada para cada execução.
Qual harness usa menos tokens, DeepSeek Harness ou OpenCode?
Nenhum benchmark público cabeça a cabeça responde isso ainda. O benchmark da Composio mediu o OpenCode em 692.000 tokens médios por tarefa, mas foi executado antes do DeepSeek Harness ser lançado. Execute o teste do Passo 2 ao Passo 4 no seu próprio repositório, porque o uso de tokens depende do tamanho da base de código, configuração de ferramentas e formato da tarefa.
Posso executar DeepSeek Harness e OpenCode contra a mesma chave de API?
Sim, para um teste casual. Para uma medição limpa, use duas chaves separadas, uma por harness. O painel do provedor então atribui cada token à execução correta.
Qual é a diferença entre um agente e um harness?
A DeepSeek descreve um agente como Modelo mais Harness. O modelo raciocina. O harness conecta o modelo a arquivos, comandos de shell, ferramentas, sessões, aprovações e o loop que decide a próxima ação. Mude o harness e o mesmo modelo pode gastar um número diferente de tokens na mesma tarefa.


