

Um arquivo de projeto de 900 páginas é fácil de enviar. A pergunta mais difícil é se o modelo consegue apontar a cláusula, o commit ou o ponto de dados exato de que você precisa. Casos de uso da janela de contexto de 1M do DeepSeek V4.1 Flash fazem sentido quando várias fontes relacionadas precisam ser consideradas em conjunto, como uma base de código, um corpus de pesquisa ou anos de registros de projeto. A janela maior reduz a necessidade de dividir esses materiais antecipadamente, enquanto verificações de evidências ainda determinam se uma resposta é confiável.
Os melhores encaixes são revisão de código entre arquivos, síntese de pesquisa, comparação de políticas, análise de feedback, cronogramas de projeto e registros multimodais longos. A DeepSeek lista um contexto de 1M tokens, mas essa capacidade não garante que todos os detalhes serão lembrados com precisão. Verifique os limites do modelo e da API para sua rota e, em seguida, teste seu próprio material antes de confiar no resultado.
Principais conclusões
- Use uma janela de um milhão de tokens quando a pergunta depender de relações entre muitas fontes relevantes.
- Peça referências de arquivo, seção ou página e separe evidências diretas de inferências.
- Comece com um teste de resposta conhecida e expanda o contexto apenas quando isso melhorar o resultado.
- Estime o custo a partir da entrada, saída e tratamento de cache, não apenas do limite de contexto.
O que significa uma janela de contexto de 1M tokens?
Uma janela de contexto é a quantidade de informação que um modelo pode considerar em uma requisição ou estado de conversa, incluindo o material fornecido e as instruções ao redor. A página atual de preços da API da DeepSeek lista o DeepSeek-V4.1-Flash com um comprimento de contexto de 1M e uma saída máxima de 384K tokens. Esse é o limite declarado pelo provedor; sua aplicação, endpoint ou configuração de requisição pode impor um limite menor. ( Documentação da API DeepSeek )
Tokens são pedaços de texto, não palavras ou páginas. Um arquivo fonte contendo código, tabelas, marcação, texto repetitivo e digitalizações pode ser tokenizado de forma muito diferente de prosa limpa com a mesma contagem de páginas. Para uma carga de trabalho real, estime tokens com o tokenizador ou relatório de uso da API que você vai chamar. Inclua instruções de sistema, nomes de arquivos, metadados, texto da pergunta e o orçamento de resposta na sua estimativa.
O benefício prático é a continuidade. Você pode perguntar sobre dependências entre vários módulos ou contradições entre uma política atual e seus apêndices sem primeiro juntar resumos manualmente. A desvantagem é que um prompt muito grande pode conter material irrelevante ou duplicado, levar mais tempo para processar e ainda dificultar a recuperação exata. Trate “cabe na janela” como uma verificação de capacidade e, em seguida, teste se o modelo consegue encontrar os fatos de que sua tarefa precisa.
Os melhores casos de uso do contexto de 1M do DeepSeek V4.1 Flash
A pergunta certa não é “Posso enviar tudo?” É “Quais fontes precisam ser comparadas para responder a isto?” Use um contexto longo quando a resposta depender de ligações entre materiais e defina como você vai verificar essa resposta antes de enviar o arquivo completo.
| Caso de uso | Por que um contexto longo ajuda | O que incluir | O que verificar |
|---|---|---|---|
| Revisão de grande base de código | Interfaces e convenções abrangem módulos | Código-fonte relevante, testes, notas de arquitetura | Caminhos de arquivo, símbolos, evidências de teste |
| Síntese de pesquisa | Métodos e descobertas precisam de comparação lado a lado | Artigos, relatórios, limitações | Fonte e ressalvas de cada afirmação |
| Comparação de contrato ou política | Definições e exceções recorrem entre seções | Versões atual e anterior, apêndices | Números de cláusula e redação exata |
| Análise de feedback | Temas aparecem em muitos comentários | Feedback desidentificado e regras de codificação | Citações representativas e método de contagem |
| Linha do tempo do histórico do projeto | Decisões evoluem ao longo de registros de reuniões | Atas, registros de decisão, notas de versão | Datas, responsáveis, registros conflitantes |
| Revisão de incidente longo | Logs, tickets e postmortems explicam diferentes estágios | Intervalo de tempo relevante e documentos de incidente | Carimbo de data/hora, fonte do evento, incerteza |
| Revisão de documento multimodal | Evidências textuais e visuais podem precisar de leitura conjunta | Imagens suportadas e suas legendas ou contexto | Se o endpoint suporta o tipo de mídia |
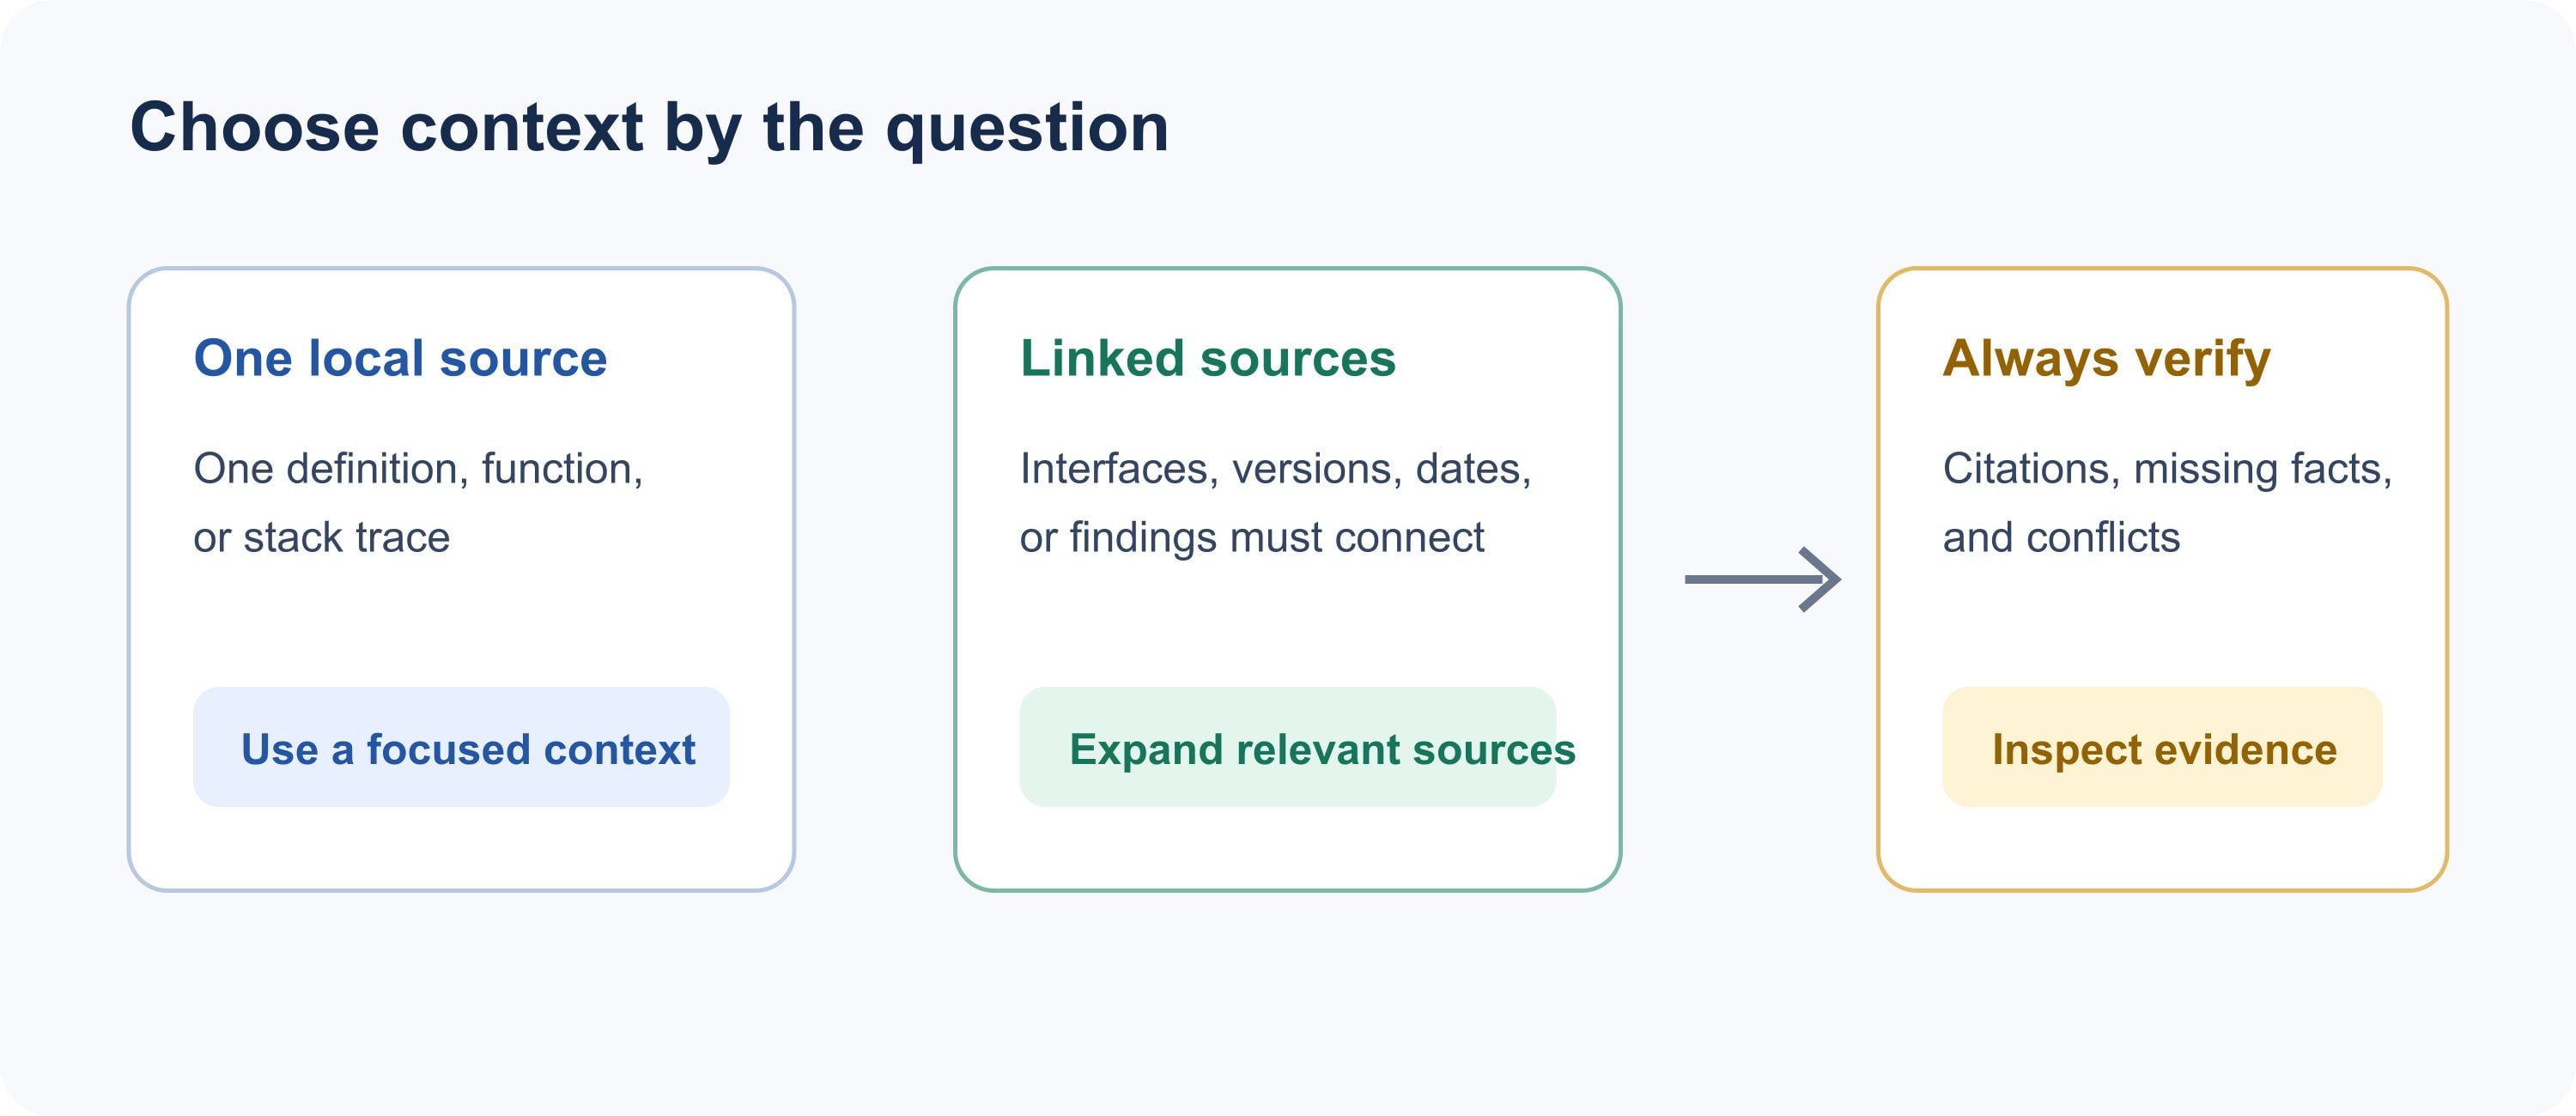
Use um contexto focado para uma pergunta local; expanda quando as fontes precisarem se conectar e, em seguida, inspecione as evidências.
Revisar uma grande base de código entre arquivos
Um contexto de um milhão de tokens pode ajudar um engenheiro a rastrear uma estrutura de dados desde uma fronteira de API, passando pela lógica de serviço, armazenamento e testes. É útil para resumos de arquitetura, encontrar módulos provavelmente afetados e elaborar um plano de refatoração que respeite convenções documentadas em vários lugares.
Forneça ao modelo um instantâneo delimitado do repositório em vez de um despejo de disco sem filtro. Inclua arquivos-fonte relevantes para a mudança, os testes mais próximos, manifestos de dependência e notas de arquitetura. Exclua saídas de build, dependências vendorizadas, pacotes gerados e cópias duplicadas, a menos que a pergunta seja sobre eles. Peça caminhos de arquivo e nomes de símbolos para cada dependência proposta, além de uma distinção entre comportamento observado e suposição.
Use a saída como um plano de revisão. Confirme se cada símbolo citado existe, inspecione as linhas citadas e execute você mesmo as verificações do projeto. O modelo não deve afirmar que os testes passaram, a menos que uma ferramenta os tenha executado de fato e retornado o resultado. Para um bug localizado em uma função, um contexto menor geralmente é mais rápido e mais fácil de auditar.
Sintetizar pesquisas entre artigos e relatórios
Um contexto longo ajuda quando estudos usam métodos, populações, medidas ou definições diferentes. Peça uma tabela de comparação com uma linha por fonte e colunas para pergunta de pesquisa, dados, método, resultado, limitações e relevância para sua pergunta. Mantenha afirmações em nível de fonte vinculadas à sua fonte, em vez de deixar um resumo misturado apagar discordâncias.
Por exemplo, ao comparar avaliações de uma ferramenta, diferencie um resultado de benchmark de um estudo de campo e da interpretação de um autor. Peça ao modelo para sinalizar medidas incompatíveis em vez de classificar resultados que não podem ser comparados. Em seguida, abra as passagens fonte por trás das afirmações mais relevantes para a decisão. Uma síntese é um mapa de evidências, não um substituto para verificar os artigos.
Comparar contratos, políticas ou especificações longas
Contratos e políticas frequentemente definem um termo uma vez e o qualificam em outro lugar. Fornecer a versão vigente, emendas, anexos e o rascunho mais antigo relevante em conjunto pode ajudar a revelar definições alteradas, referências cruzadas, condições ausentes e conflitos aparentes.
Peça a seção ou cláusula exata para cada observação e um trecho curto que um revisor possa localizar. Separe diferenças textuais de suas possíveis consequências. O modelo pode ajudar a organizar uma revisão, mas interpretação jurídica, decisões de conformidade e autoridade para assinar permanecem com pessoas qualificadas que podem considerar jurisdição e contexto.
Analisar feedback de clientes em escala
Um grande volume de feedback pode revelar solicitações e objeções recorrentes entre canais ou períodos. Forneça uma amostra definida, remova informações pessoais que não são necessárias e especifique um esquema de codificação como “atrito de onboarding”, “integração ausente” ou “confusão de preços”. Peça exemplos representativos e contraexemplos, não apenas uma lista de temas.
Não apresente porcentagens de temas geradas pelo modelo como estatísticas de pesquisa. Se você precisar de contagens, defina a unidade (mensagem, cliente ou problema), desduplique registros, aplique uma regra de rotulagem consistente e verifique a contagem com um script repetível ou amostra revisada por humanos. O modelo é útil para propor categorias e encontrar exemplos; um método documentado sustenta afirmações quantitativas.
Construir uma linha do tempo a partir de documentos de projeto
Para uma passagem de bastão ou postmortem, as evidências relevantes podem estar espalhadas por atas de reunião, notas de versão, registros de decisão e tickets. Peça uma tabela cronológica com data, evento, responsável nomeado quando declarado, local da fonte e confiança ou ambiguidade. Instrua o modelo a preservar datas conflitantes em vez de escolher uma silenciosamente.
Uma linha do tempo útil ajuda um novo membro da equipe a ver o que foi decidido, quando um requisito mudou e qual documento sustenta cada evento. Verifique transições críticas em relação ao registro de origem, especialmente quando uma nota foi escrita depois ou resume uma reunião em vez de registrá-la diretamente.
Revisar registros longos de incidentes e material multimodal
A revisão de incidentes pode se beneficiar de manter alertas, notas operacionais, tickets e o postmortem em um único conjunto de evidências. Peça uma sequência de eventos observados e distinga explicitamente carimbos de data/hora em logs de estimativas posteriores em notas narrativas. Isso pode tornar a primeira análise mais coerente, enquanto o engenheiro de plantão ainda verifica os sistemas de origem antes de agir.
O anúncio oficial da DeepSeek diz que o V4.1-Flash está disponível em sua API com suporte multimodal nativo. Os formatos exatos de imagem, métodos de requisição e limites dependem do endpoint e da integração, então confirme esses detalhes antes de assumir que um orçamento de texto de um milhão de tokens também descreve o tratamento de imagens. ( Anúncio do DeepSeek V4.1-Flash )
Quando um milhão de tokens ajuda e quando adiciona ruído?
Mais contexto ajuda quando fontes precisam ser referenciadas cruzadamente. Uma mudança de código envolvendo uma interface compartilhada pode exigir vários módulos e testes. Uma comparação de versão precisa de ambas as versões completas e seus apêndices. Uma linha do tempo de projeto pode precisar de registros espalhados por meses.
Um bug local com um stack trace claro pode precisar apenas da função, de seus chamadores e do teste relevante. Uma pergunta pedindo uma definição pode precisar apenas da seção autoritativa. Para essas tarefas, incluir um repositório inteiro adiciona espaço de busca e pode enterrar a passagem útil.
Antes de expandir o prompt, remova exportações repetidas, rascunhos obsoletos, pastas não relacionadas, texto padrão e registros fora do intervalo de tempo da pergunta. Mantenha um manifesto do que você incluiu e por quê. Se a resposta mudar quando você adicionar um grande lote de arquivos não relacionados, isso é um sinal para restringir o conjunto de fontes e executar o teste novamente.
Um fluxo de trabalho prático para respostas confiáveis com contexto longo
Use um protocolo de evidências consistente para que uma resposta fluente não seja confundida com uma verificada. Primeiro, rotule as fontes com nomes de arquivo estáveis e, quando possível, números de página, títulos, números de linha, datas ou identificadores de versão. Preserve contexto suficiente ao redor para interpretar trechos corretamente.
Em seguida, declare uma decisão ou pergunta de pesquisa. Especifique o formato de saída e os locais que o modelo deve citar. Um prompt reutilizável é:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
Para uma base de código, adicione: “Cite caminhos do repositório e nomes de funções ou classes. Antes de propor uma mudança, liste os arquivos afetados e as evidências de teste que sustentam a proposta. Não diga que um teste foi executado, a menos que seu resultado esteja incluído nas evidências fornecidas.”
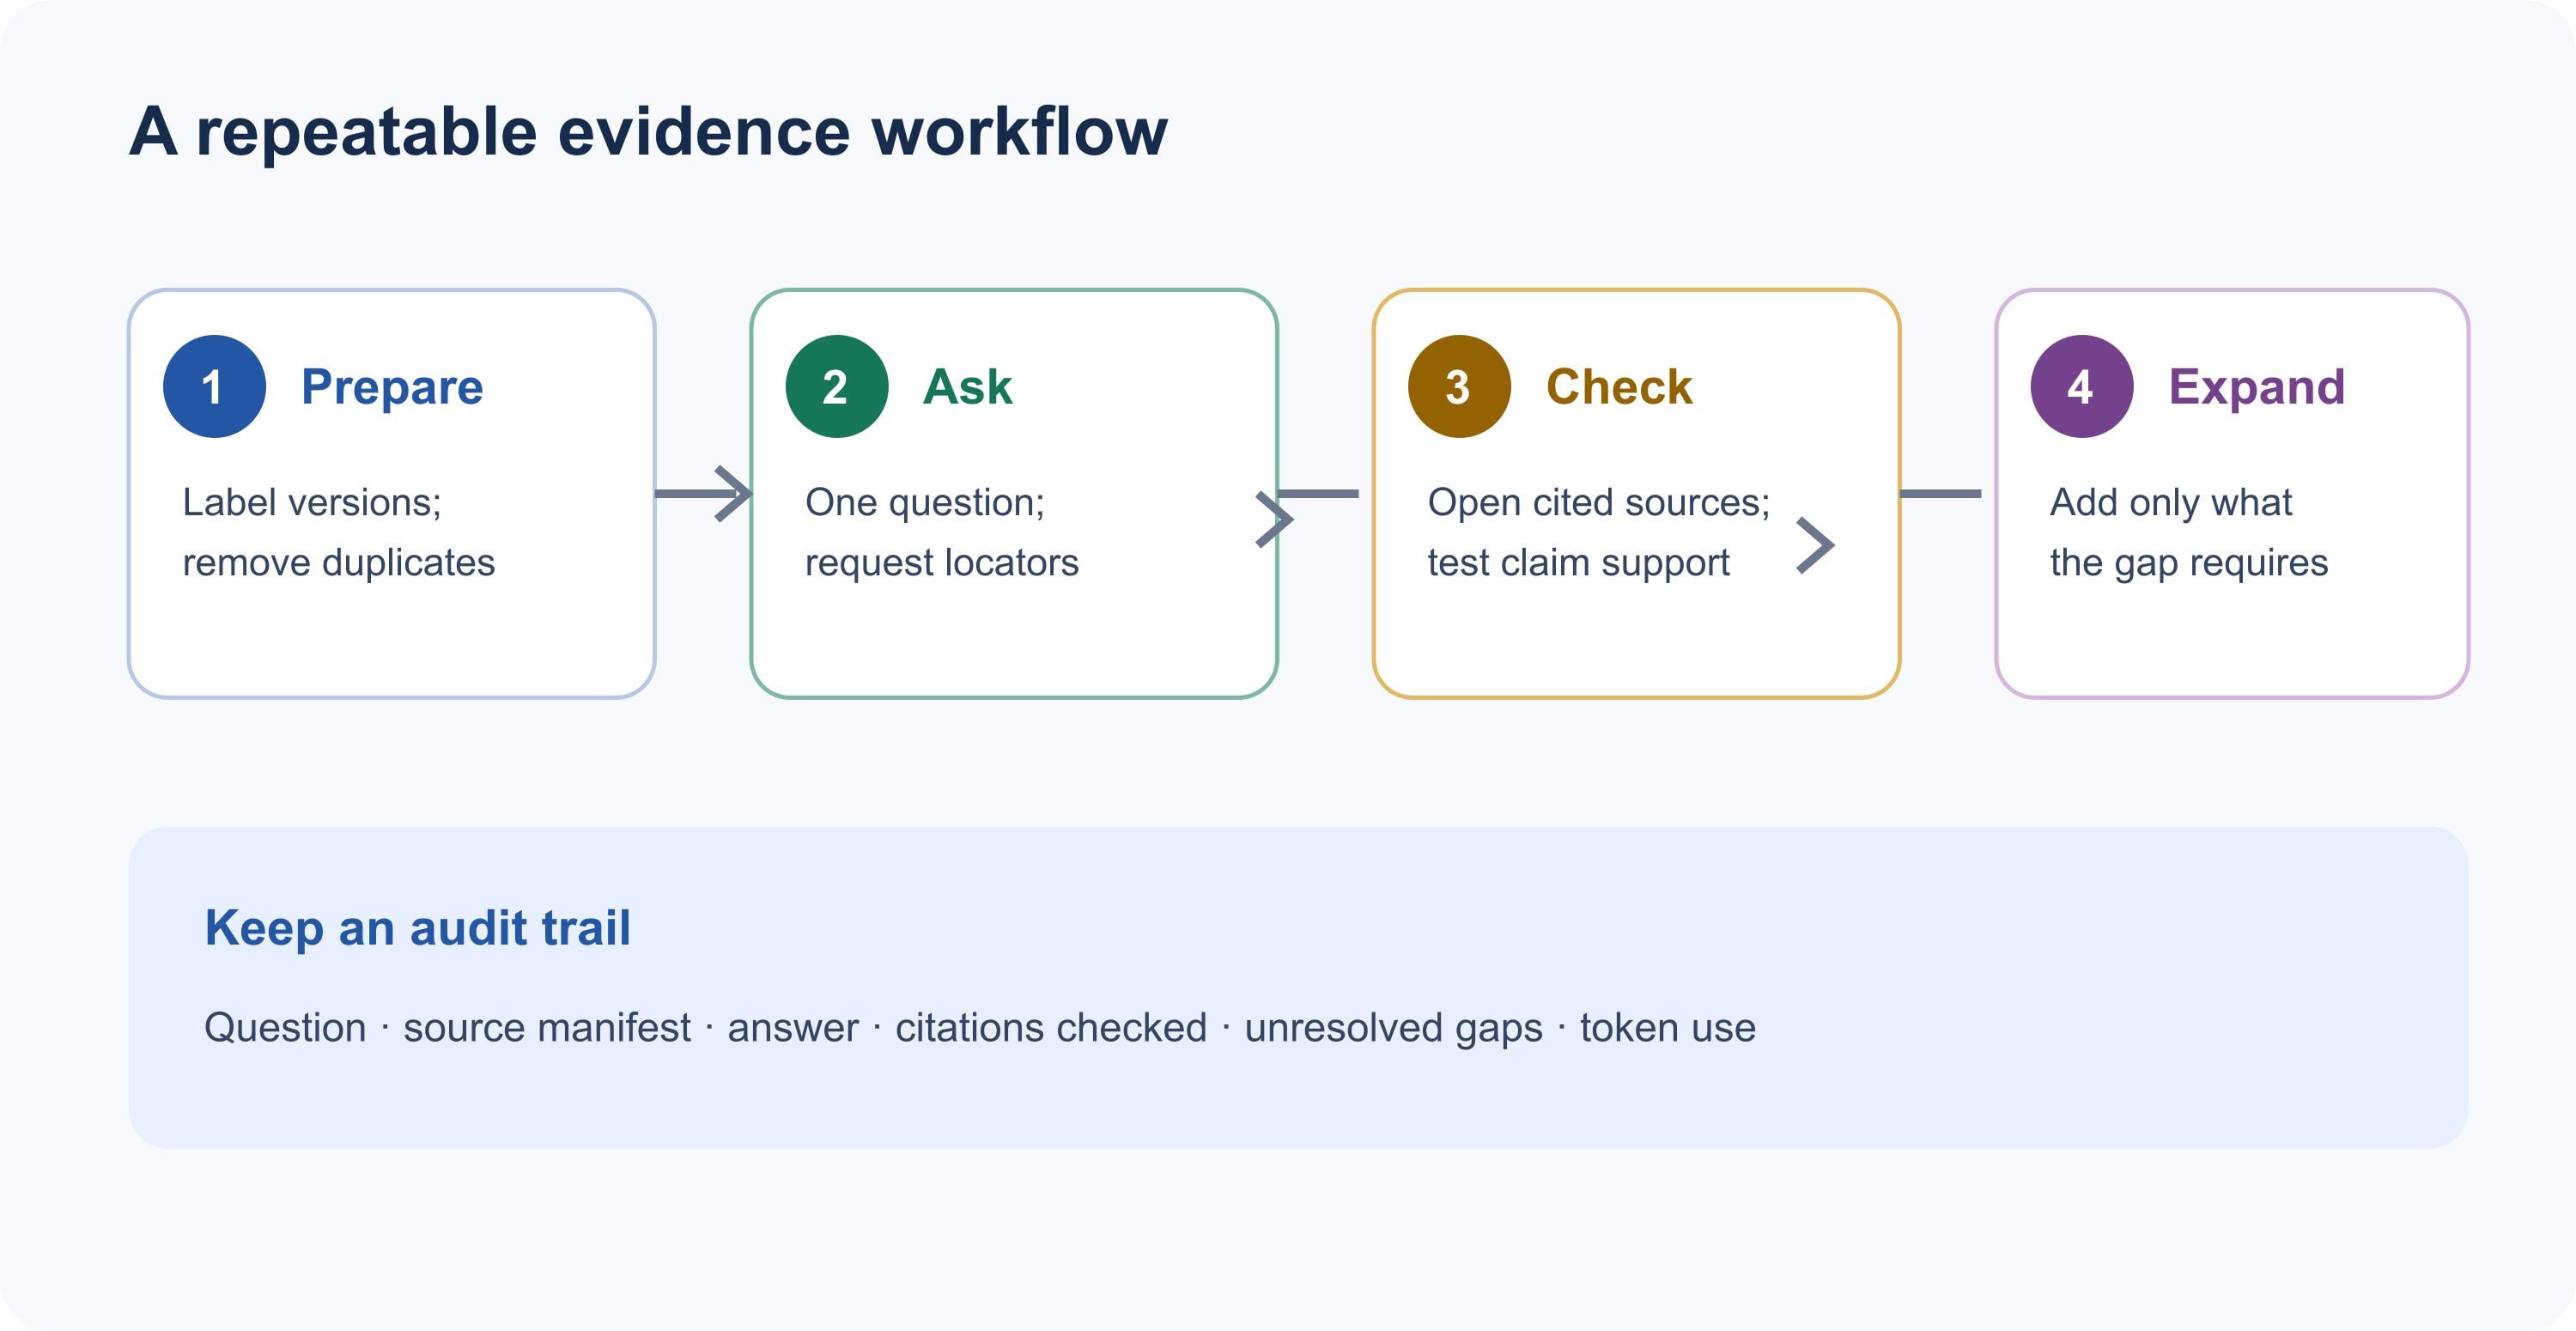
Prepare as fontes, faça uma pergunta delimitada, verifique citações e expanda apenas para resolver uma lacuna.
Em seguida, inspecione a resposta em três etapas. Verifique se cada citação aponta para um local real. Verifique se a passagem citada sustenta a afirmação, em vez de apenas mencionar o tópico. Por fim, revise omissões e conflitos fazendo perguntas direcionadas de acompanhamento contra o mesmo conjunto de fontes. Para decisões de alto risco, faça um revisor qualificado ler o material de origem diretamente.
Mapa de evidências do fluxo de trabalho com contexto longo
| Etapa | Ação | Manter | Sinal de parada |
|---|---|---|---|
| 1. Preparar | Rotular, desduplicar e delimitar fontes | Manifesto de fontes e versões | Proveniência desconhecida ou duplicata obsoleta |
| 2. Perguntar | Definir uma pergunta e um formato de evidência | Nomes de arquivo e localizadores na resposta | Pedido amplo sem alvo de decisão |
| 3. Verificar | Abrir passagens citadas e comparar afirmações | Afirmações sustentadas e lacunas explícitas | Citação não sustenta a afirmação |
| 4. Expandir | Adicionar apenas fontes necessárias para links não resolvidos | Melhoria em testes de resposta conhecida | Mais entrada sem melhores evidências |
Como testar se o contexto de 1M é útil para sua tarefa
Crie um pequeno conjunto de avaliação antes de carregar o arquivo completo. Escreva perguntas cujas respostas você já conhece do material de origem. Coloque alguns fatos perto do início, alguns no meio e alguns perto do fim. Adicione pelo menos uma pergunta que exija conectar dois documentos e uma que não possa ser respondida a partir das fontes fornecidas.
Execute as mesmas perguntas em um subconjunto menor e relevante primeiro, depois aumente o contexto em etapas medidas. Registre correção factual, precisão do localizador, evidências perdidas, afirmações não sustentadas, recusa na pergunta não respondível, latência e uso de tokens. Mantenha o prompt e as configurações de decodificação estáveis para que as mudanças sejam interpretáveis. Repita uma pergunta se as saídas variarem materialmente entre execuções.
| Verificação | O que uma resposta aprovada mostra | O que fazer após uma falha |
|---|---|---|
| Fato conhecido em posições inicial, média e final | Recuperação ao longo do intervalo da fonte | Verifique indexação, rótulos de arquivo e comprimento do prompt |
| Link entre documentos | Evidências podem ser unidas entre fontes | Peça ambas as citações, depois estreite a pergunta do link |
| Pergunta não respondível | O modelo pode relatar evidências ausentes | Reforce “use apenas fontes fornecidas” e teste novamente |
| Auditoria de citação | Localizador e trecho sustentam a afirmação | Trate a afirmação como não verificada até ser corrigida |
| Comparação com contexto maior | Material extra melhora a tarefa alvo | Remova ruído se a precisão ou a latência piorar |
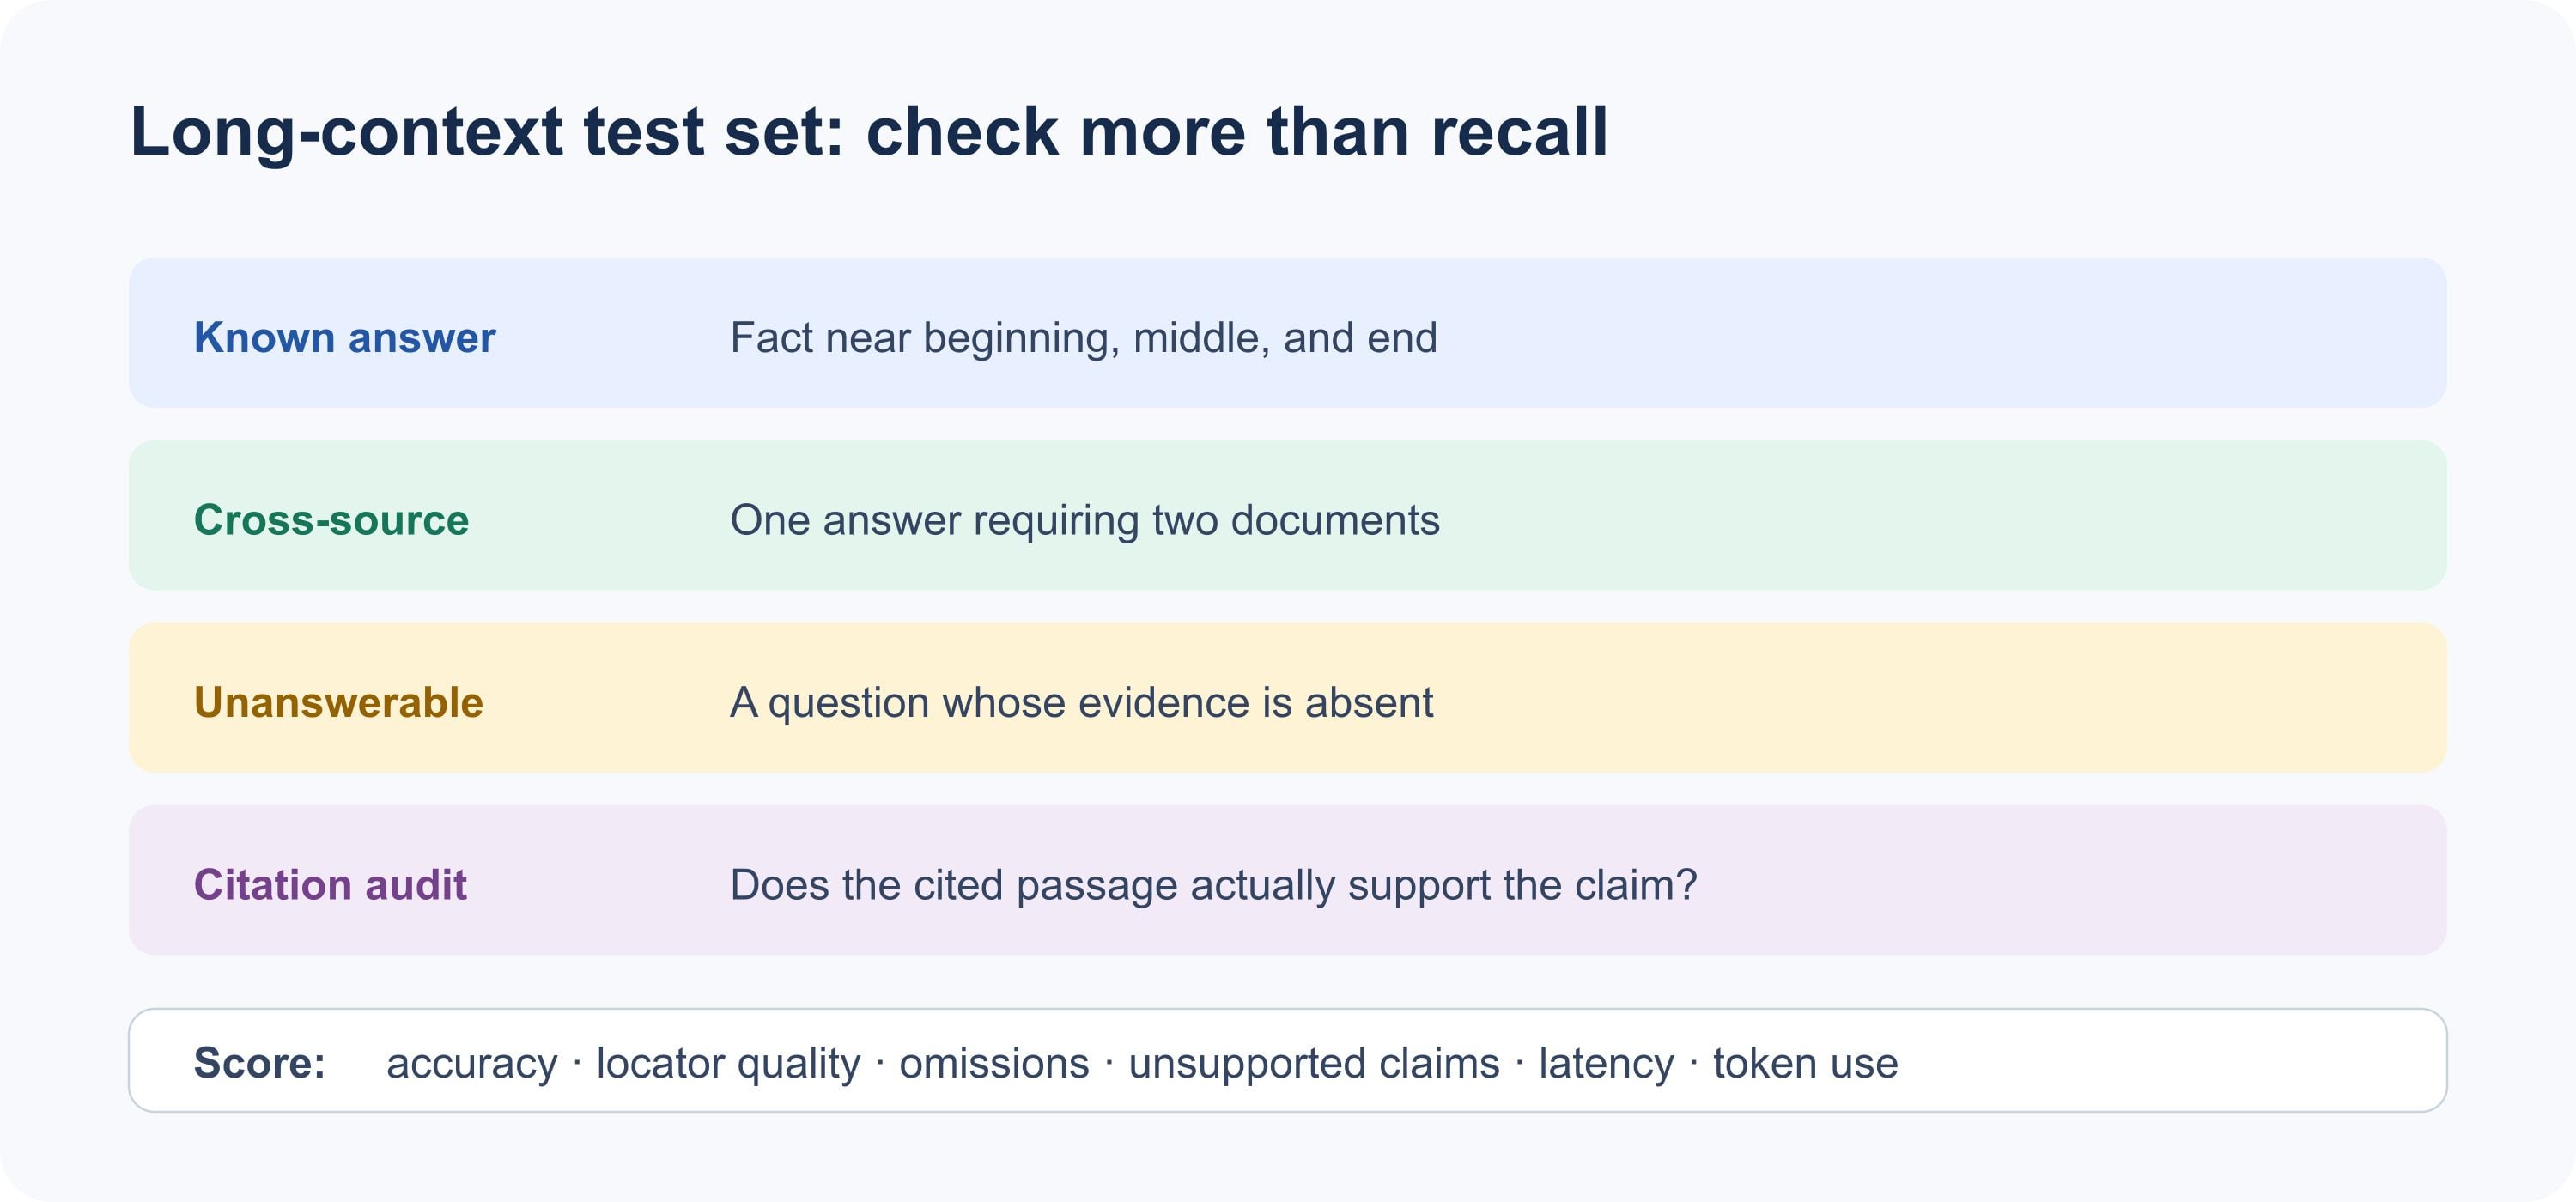
Pontue recuperação, suporte de citação, omissões, afirmações não sustentadas, latência e uso de tokens.
Relatos da comunidade são mistos e dependem da tarefa. Um usuário do Reddit compartilhou um aumento específico do harness em argumentos de ferramenta malformados em tamanhos de contexto maiores, enquanto comentaristas descreveram trabalho bem-sucedido com contagens de tokens mais altas em outras configurações. Isso é um motivo útil para comparar seu próprio harness, não evidência de um limite universal de falha. ( Discussão sobre contexto do DeepSeek no Reddit )
Uma ampliação sensata é: valide o prompt em uma pequena amostra, adicione os grupos de fontes necessários para perguntas entre documentos e, em seguida, teste uma requisição grande representativa. Mantenha o menor contexto que responda à pergunta real com evidências confiáveis. Isso também facilita a interpretação de comparações de latência e custo.
Preços e acesso da API do DeepSeek V4.1 Flash
Na Atlas Cloud, a listagem do modelo atualmente mostra o DeepSeek V4.1 Flash com um contexto de 1M e tarifas de $0.30 por milhão de tokens de entrada, $1.20 por milhão de tokens de saída e $0.03 por milhão de tokens de leitura de cache. A listagem não mostra desconto para este modelo. Essas são tarifas da Atlas Cloud, distintas dos preços de pico e fora de pico da própria DeepSeek, que dependem do horário. Verifique novamente o catálogo de modelos da Atlas Cloud e a página de preços de modelos antes de publicar ou orçar, porque as tarifas podem mudar.
Nas tarifas listadas, uma requisição com 100.000 tokens de entrada não armazenados em cache e 2.000 tokens de saída custa cerca de $0.03 de entrada mais $0.0024 de saída, ou $0.0324 no total antes de quaisquer outras cobranças aplicáveis. Se a entrada for cobrada como leituras de cache, 100.000 tokens em cache custariam $0.003. O exemplo assume essas contagens de tokens e tarifas; não é um orçamento para uma carga de trabalho específica. A capacidade total de 1M não é cobrada apenas porque existe. A cobrança segue o uso e o tratamento de cache.
Para equipes que desejam um único ponto de entrada de API, a página do modelo DeepSeek V4.1 Flash fornece o modelo e os detalhes de chamada. Compare seu uso medido de tokens e necessidades de integração com o endpoint oficial também; nomes de modelos, limites e preços podem variar por provedor.
Perguntas frequentes
Uma janela de contexto de 1M tokens é o mesmo que 1M palavras?
Não. Tokens podem ser partes de palavras, pontuação, fragmentos de código ou outras unidades. O número de palavras ou páginas que cabem depende do material e de sua tokenização. Use contagens de tokens medidas em vez de uma conversão fixa de páginas.
O DeepSeek V4.1 Flash sempre usa a janela de contexto completa?
Não. Um milhão de tokens é uma especificação de contexto máxima, não uma meta para cada requisição. Um prompt curto usa menos, e uma interface ou rota de API específica pode impor um limite menor. Verifique a documentação do endpoint e os campos de uso reais.
Um contexto de 1M é suficiente para uma base de código inteira?
Pode caber em algumas bases de código por contagem de tokens, mas isso não torna todos os arquivos relevantes ou todas as respostas confiáveis. Inclua os arquivos necessários para a pergunta, verifique caminhos e símbolos citados e teste mudanças com as verificações reais do projeto.
Devo colocar todos os documentos disponíveis em um único prompt?
Somente se os documentos se relacionarem à mesma pergunta. Comece com um manifesto de fontes, remova duplicatas e material não relacionado e adicione mais quando um teste entre documentos exigir. Os melhores casos de uso da janela de contexto de 1M do DeepSeek V4.1 Flash são definidos por evidências que precisam ser comparadas, não pelo tamanho do arquivo.





