Duas equipes podem relatar centenas de tokens por segundo para o DeepSeek V4.1 Flash e ainda assim estarem medindo coisas diferentes. Uma pode se referir à velocidade de decodificação de uma única requisição; outra pode se referir à saída agregada de dezenas de requisições simultâneas. Para melhorar a otimização de throughput de inferência do DeepSeek V4.1 Flash, primeiro escolha a métrica que seu serviço precisa, depois faça benchmark da sua própria mistura de requisições, altere uma variável de serving por vez e verifique latência, qualidade e custo em conjunto. A família de modelos agora inclui a atualização Flash-1017 de 17 de outubro, então registre o checkpoint exato antes de comparar resultados. Relatórios públicos mostram caminhos úteis de otimização, mas nenhum substitui um teste correspondente no seu hardware.
Principais conclusões
- Tokens/s de saída agregados medem a capacidade entre requisições; a velocidade de decodificação por requisição mede a experiência de um usuário individual.
- Reproduza seus comprimentos de prompt, limites de saída, concorrência, estado warm e objetivo de latência antes de ajustar.
- O cache KV comprimido e o replay limitado do V4.1 Flash reduzem a pressão de memória, mas não garantem um ganho de velocidade fixo de ponta a ponta.
- Compare vLLM e SGLang apenas sob modelo, hardware, carga de trabalho e condições de medição equivalentes.
O que significa throughput para o DeepSeek V4.1 Flash?
Throughput é uma taxa, mas o numerador e o limite do teste importam. Para um serviço de inferência, registre pelo menos cinco medições:
| Métrica | O que ela informa | Uso típico |
|---|---|---|
| Tokens/s de saída agregados | Tokens de saída produzidos por todas as requisições ativas por segundo | Planejamento de capacidade e eficiência da frota |
| Tokens/s de decodificação por requisição | Velocidade de geração experimentada por uma requisição individual | Responsividade interativa durante a geração |
| Tokens/s de prefill | Tokens de entrada processados por segundo | Prompts longos e cargas com muita recuperação |
| Tempo até o primeiro token (TTFT) | Tempo desde a chegada da requisição até o primeiro token de saída | Atraso percebido na inicialização |
| Latência de ponta a ponta, p50/p95 | Duração total da requisição na distribuição do tráfego | Objetivos de nível de serviço e comportamento de cauda |
Um servidor pode aumentar o throughput agregado ao agrupar mais sequências em lote, ao mesmo tempo que faz cada usuário esperar mais entre tokens. Por outro lado, uma configuração ajustada para baixa concorrência pode entregar respostas individuais rápidas enquanto deixa os aceleradores subutilizados. Nenhum resultado é universalmente melhor. O alvo certo é um ponto na curva de throughput-latência que atenda ao objetivo de serviço do seu produto.
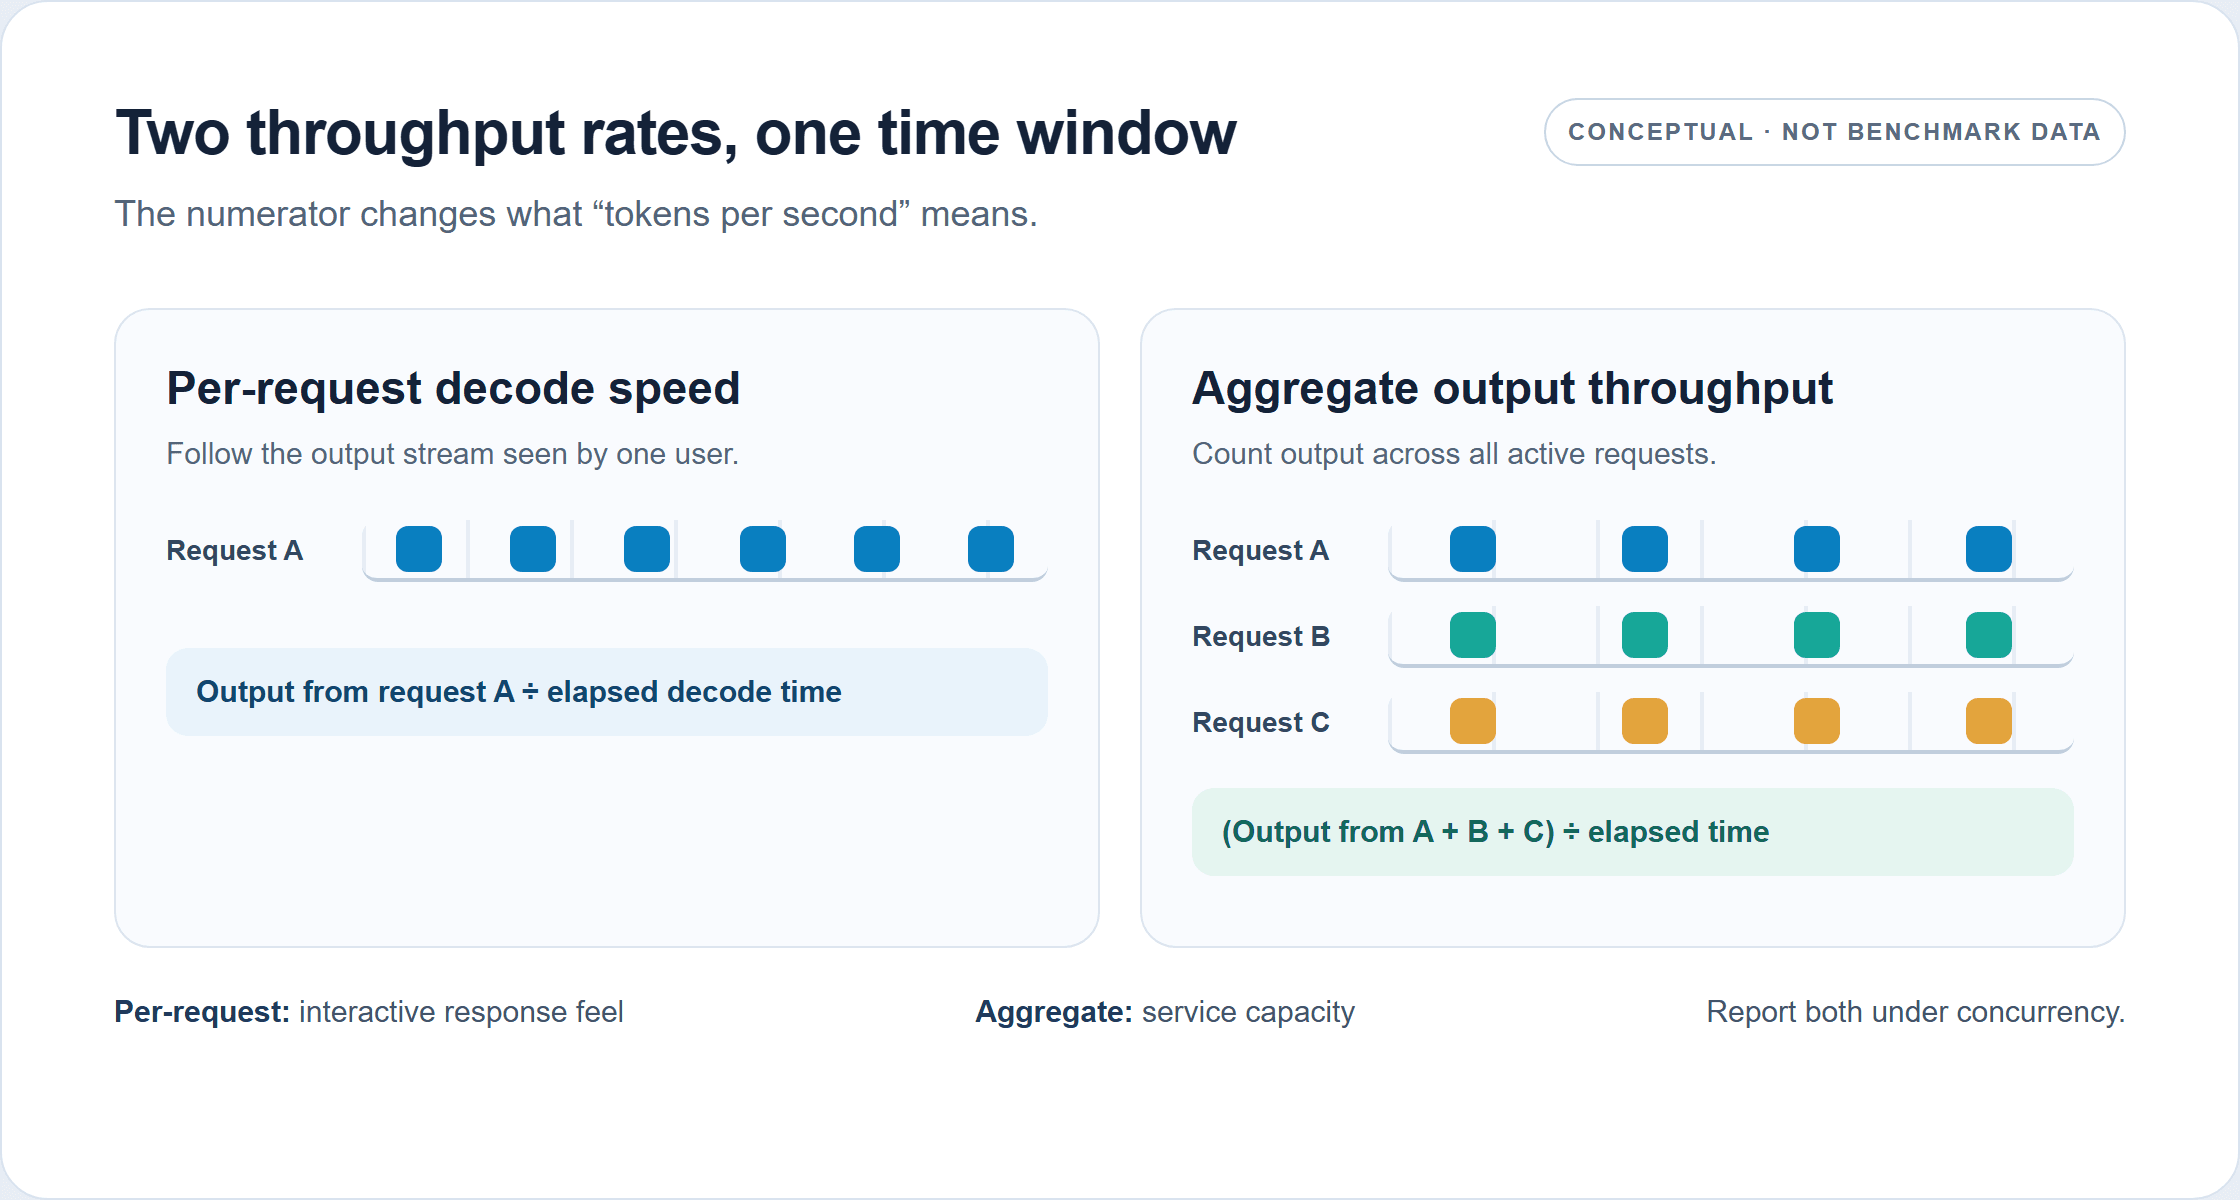
As duas taxas contam fluxos de saída diferentes. Este é um diagrama conceitual, não o desempenho medido do DeepSeek V4.1 Flash.
Especifique se o throughput inclui prefill, decodificação ou ambos. Declare se você divide pela contagem de GPUs. Relate tokens de saída bem-sucedidos em vez de tokens máximos solicitados e divulgue cancelamentos ou erros. Sem esses detalhes, um número de tokens/s não permite que um operador saiba se ele prevê o comportamento da aplicação.
Crie um baseline reproduzível do DeepSeek V4.1 Flash
Um baseline útil se assemelha ao tráfego de produção de forma suficientemente próxima para expor seu gargalo. Um único prompt curto é um proxy ruim para um agente que envia repetidamente um histórico de conversa grande, e uma saída fixa de 1.024 tokens ignora cargas que param cedo ou variam muito.
Fixe a carga de trabalho e a janela de medição
Crie buckets de requisições a partir do tráfego observado. Para cada bucket, preserve o comprimento aproximado da entrada, o comprimento esperado da saída, o padrão de chegada e quaisquer prefixos compartilhados. Inclua turnos de ferramenta ou raciocínio se eles fizerem parte do caminho real da requisição. Mantenha prompts, configurações de amostragem, condições de parada e limites de saída fixos entre execuções.
Execute tanto um caso de baixa concorrência quanto a concorrência que seu serviço espera no pico. Em seguida, adicione níveis intermediários de concorrência para revelar onde o throughput para de subir ou a latência ultrapassa seu limite. Use uma janela de medição estável após o aquecimento, repita cada ponto e informe a mediana mais a faixa. Uma rajada curta pode medir o comportamento de inicialização em vez da capacidade estável do serviço.
Separe medições de cold start do serving warm. Execuções frias incluem carregamento do modelo, graph capture ou população de cache dependendo da stack; execuções warm descrevem um sistema pronto para atender. Para uma carga com cache de prefixo, meça separadamente o tráfego de acerto e de erro de cache. Não os combine em uma única média, a menos que a mistura corresponda à produção.
Mantenha um registro de benchmark
Salve uma linha para cada execução com estes campos: checkpoint ou revisão do modelo; runtime e commit; modelo e quantidade de GPUs; interconnect; precisão e quantização; layout de paralelismo tensor, expert ou pipeline; distribuição de tokens de entrada e saída; concorrência e padrão de chegada das requisições; estado warm ou cold; duração da execução; taxa de sucesso; throughput agregado; velocidade de decodificação por requisição; TTFT; e latência de ponta a ponta p50/p95.
Esse registro é mais útil que um número de leaderboard porque torna o próximo experimento reproduzível. Congele-o antes de ajustar. Se a carga de trabalho ou o checkpoint mudar, inicie um novo baseline em vez de atribuir a diferença a uma flag de serving.
Diagnostique prefill, decodificação, cache KV ou agendamento
Use sintomas para escolher a próxima medição, não para adivinhar uma correção. TTFT alto com velocidade de decodificação aceitável aponta para processamento de entrada, enfileiramento, erros de cache ou overhead de inicialização. Decodificação lenta em baixa concorrência sugere examinar kernels, largura de banda de memória, comunicação paralela e o caminho de execução do modelo. Throughput agregado que atinge um patamar à medida que a concorrência sobe pode indicar pressão de memória, limites do agendador, overhead de comunicação ou um caminho de computação saturado. Degradação em contexto longo exige medir residência de cache, trabalho de prefill e movimentação host-dispositivo.
| Observação | Primeiras verificações |
|---|---|
| TTFT cresce com o comprimento do prompt | Taxa de prefill, tempo de fila, taxa de acerto do cache de prefixo, aquecimento de graph ou compilação |
| Velocidade de decodificação baixa mesmo com concorrência 1 | Caminho do modelo em runtime, suporte a kernel, precisão, utilização da GPU, overhead de comunicação |
| Tokens/s agregados atingem um patamar à medida que a concorrência sobe | Capacidade do cache KV, batching do agendador, largura de banda de memória, topologia paralela |
| Latência p95 sobe acentuadamente enquanto a saída agregada melhora | Tamanho do lote, política de enfileiramento, mistura de comprimentos de requisição, objetivo de serviço |
| Prompts longos removem requisições ativas úteis | Residência do cache KV, alocação de cache, distribuição de contexto, tráfego de memória do host |
O V4.1 Flash tem recursos arquiteturais destinados a aliviar algumas dessas pressões. O relatório do modelo descreve o CSA2 com reuso de cache entre camadas e cache KV global FP4, proporcionando uma pegada global de KV relatada de 890 bytes por token, aproximadamente um quarto da pegada correspondente do V4-Flash. O SWA Bounded Replay aborda um trade-off de armazenamento diferente: em vez de persistir todo o estado de atenção de janela deslizante, uma implantação pode reconstruir o estado ausente ao reproduzir a janela recente. A DeepSeek relata cache KV persistente próximo de um oitavo da pegada do V4-Flash para este design, com uma pequena quantidade de recomputação adicional de prefill. Esses são resultados de arquitetura e implantação, não uma promessa de throughput oito vezes maior. (Relatório técnico da DeepSeek, setembro de 2026)
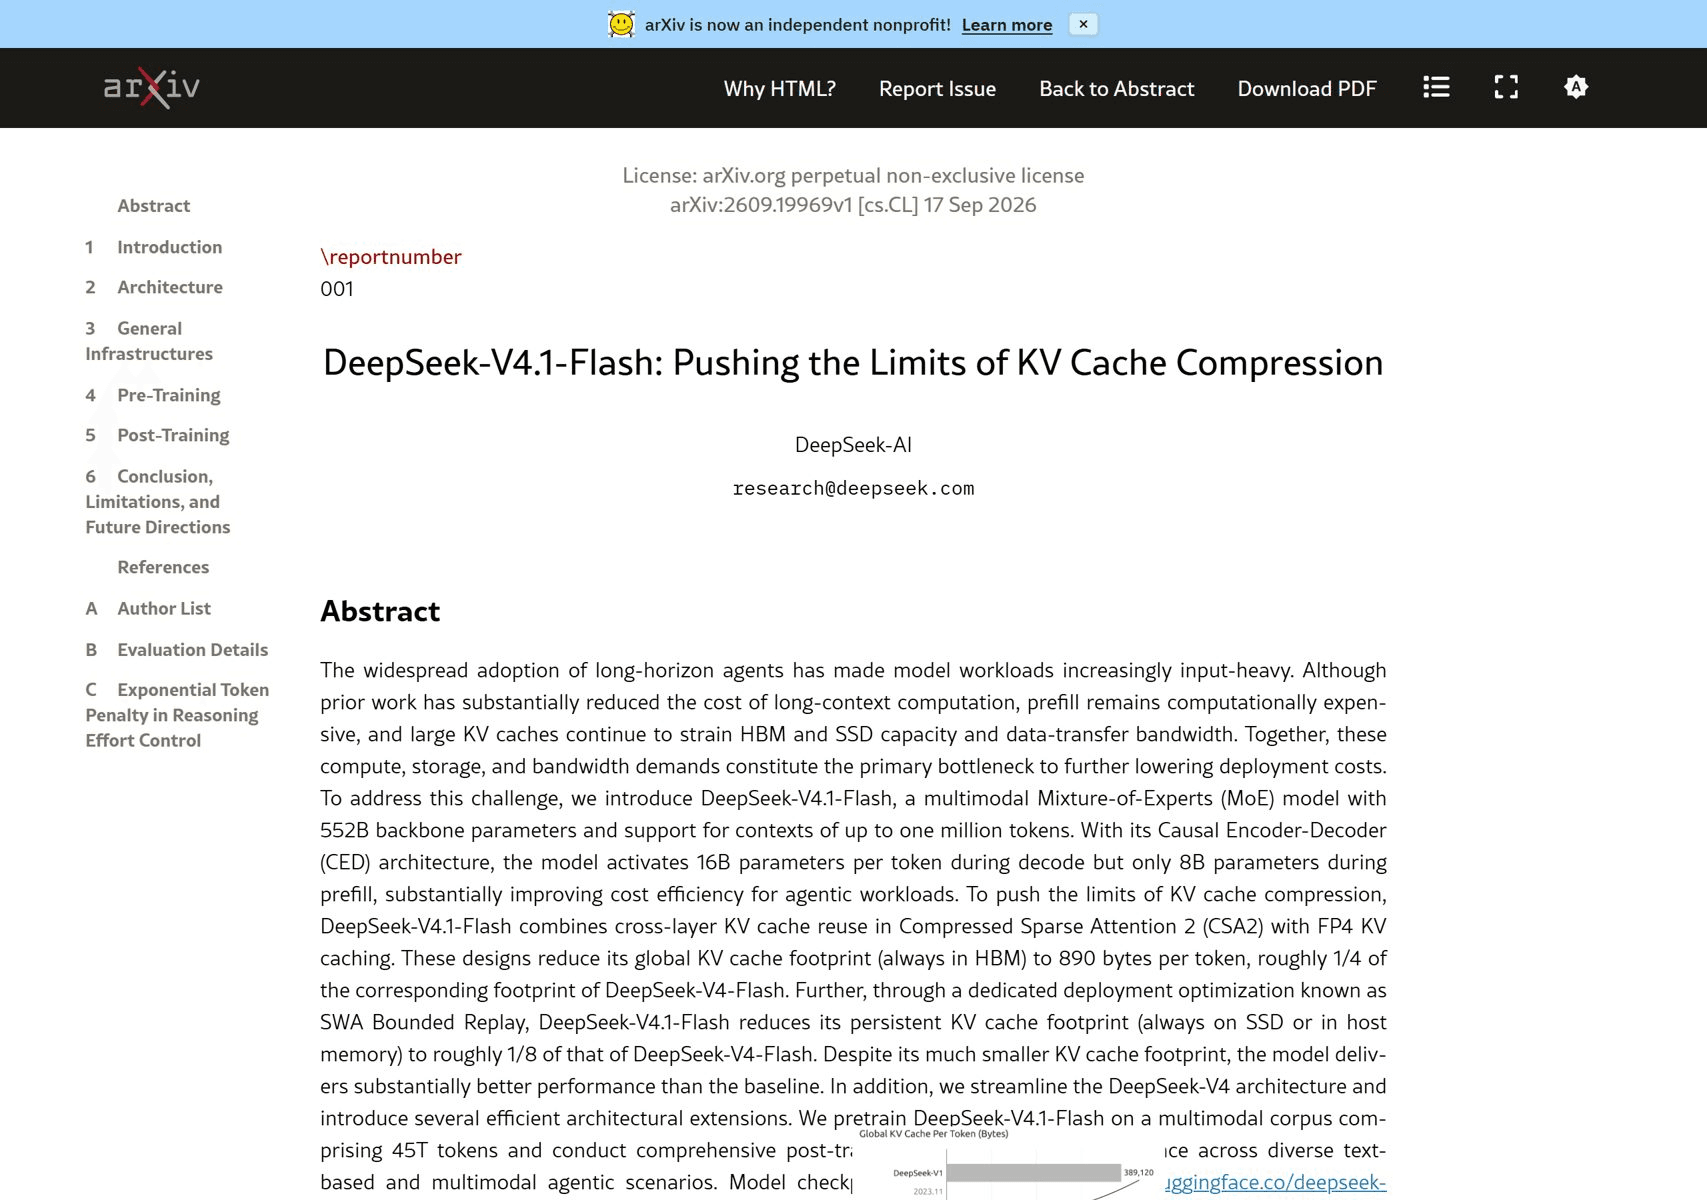
A figura de origem descreve capacidade de cache, não um multiplicador de throughput de ponta a ponta para toda implantação.
Quando o diagnóstico não estiver claro, faça profile de uma execução representativa e inspecione tempo de fila, utilização da GPU, uso de memória e tempo por estágio. Altere uma variável, execute novamente a mesma carga de trabalho e verifique a correção da saída ou a qualidade da tarefa. Isso evita que um ganho de velocidade aparente mascare uma regressão no serviço ou nas respostas.
Ajuste vLLM ou SGLang em relação ao mesmo alvo
Escolha um runtime cujo caminho atual do modelo ofereça suporte ao checkpoint e ao hardware que você pretende implantar. Verifique a release exata, kernels, comportamento de graph e layout paralelo. Um modelo listado como compatível não significa que toda quantização ou topologia esteja igualmente otimizada.
vLLM: valide o caminho do modelo específico da release
O relatório de outubro da equipe do vLLM descreve uma evolução no benchmark AgentX: cerca de 1,9× de melhoria no resultado de baixa latência e cerca de 5,3× de throughput sob uma restrição de 150 TPS em comparação com seu baseline do dia zero. O trabalho incluiu SWA bounded replay com CUDA graphs e integração de kernels específicos do modelo. Trate esses valores como evidência de que a stack mudou materialmente ao longo do tempo sob esse benchmark, não como multiplicadores a aplicar a outro cluster. ( Relatório de engenharia do vLLM, outubro de 2026)
Para sua execução, estabeleça primeiro uma release compatível e uma configuração known-good. Depois, meça individualmente o comportamento de graph capture ou replay, o batching e o paralelismo. Preserve a restrição de latência usada para selecionar um ponto de maior throughput. Se o graph capture alterar a inicialização ou as necessidades de memória, inclua esses custos na decisão de implantação.
SGLang: corresponda ao seu perfil de concorrência
O relatório da equipe do SGLang oferece um exemplo excepcionalmente claro de por que o contexto do teste importa. Em 8 GPUs H200, sua execução otimizada sem decodificação especulativa subiu de aproximadamente 76 para 168 tokens/s por usuário com concorrência um, e de cerca de 96 para 221 tokens de saída/s por GPU com concorrência 64. Ele usou entradas fixas de 8.192 tokens e saídas de 1.024 tokens. Seus resultados separados em 4×GB300 usaram comprimentos de prompt, configurações paralelas e decodificação especulativa DSpark diferentes. O relatório, portanto, apoia a avaliação das otimizações do SGLang no seu tráfego, não sua classificação direta contra os números do AgentX do vLLM. ( Relatório de otimização LMSYS/SGLang, setembro de 2026)
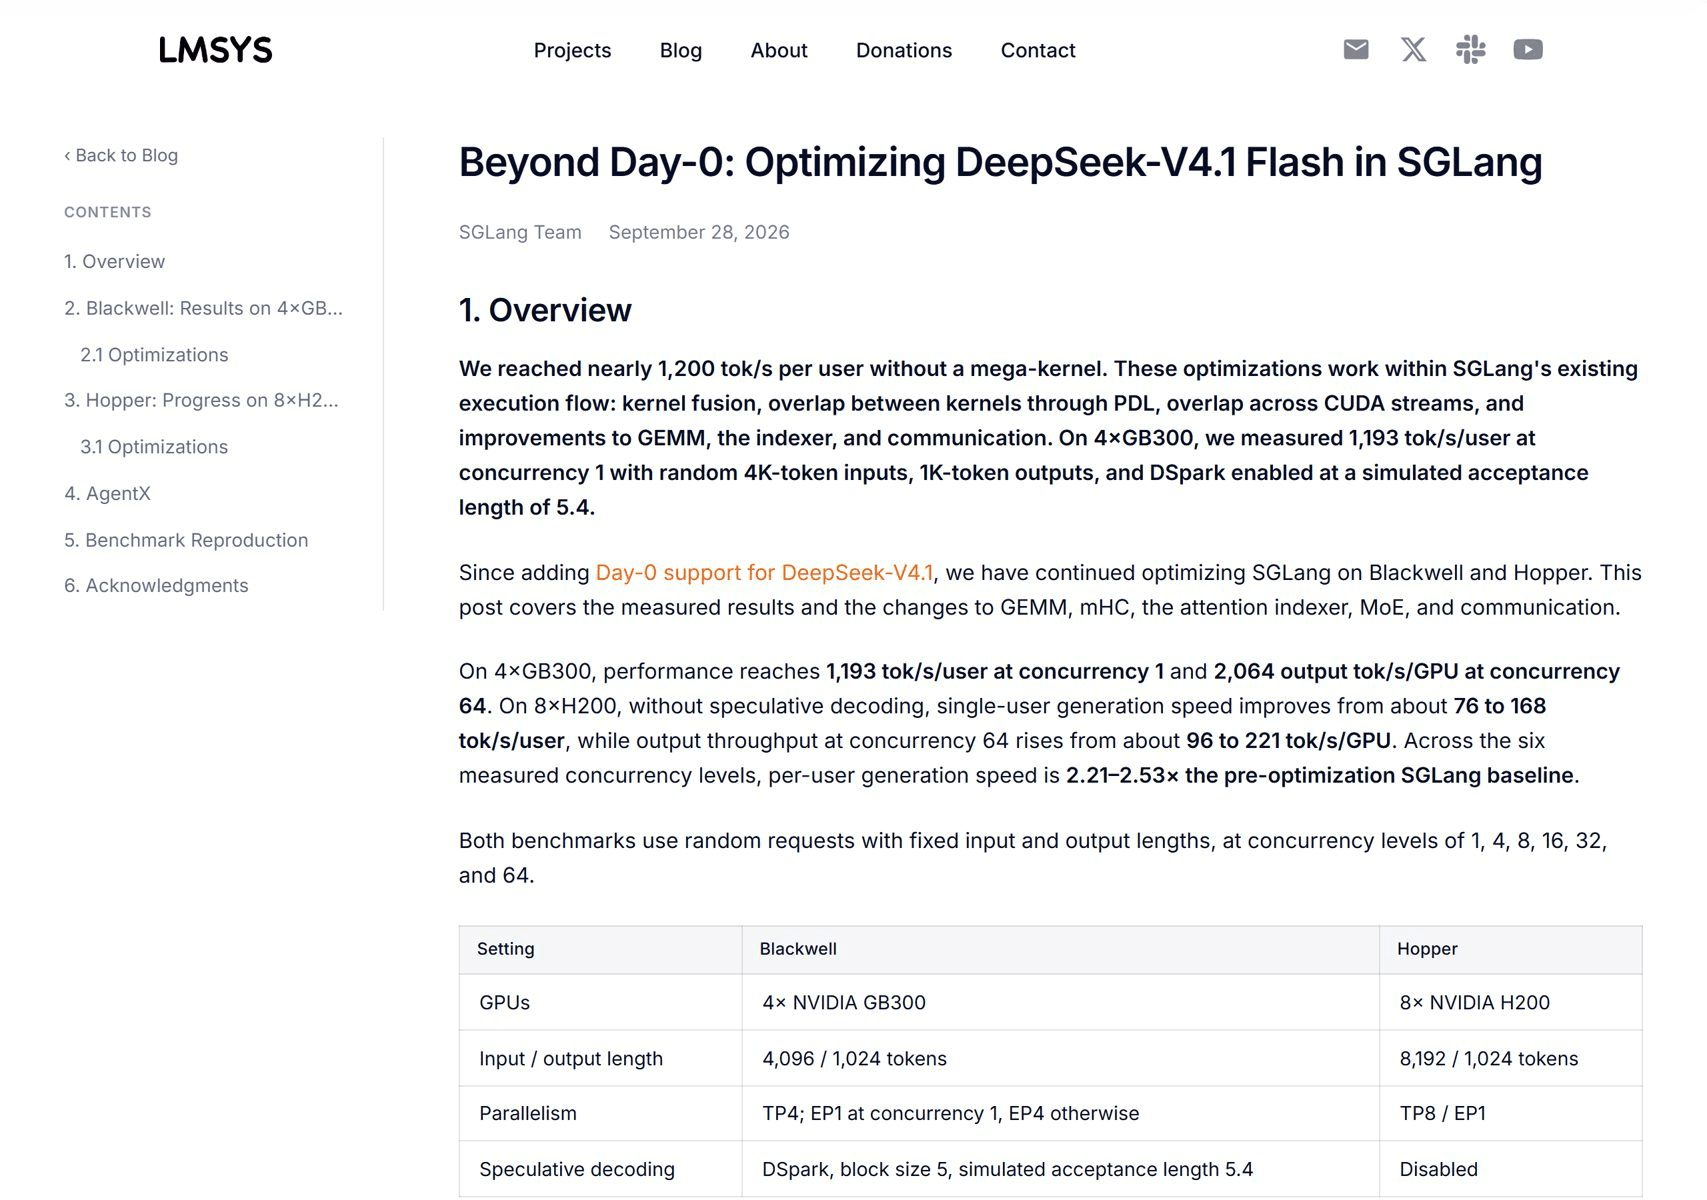
Os relatórios de origem usam cargas de trabalho e hardware diferentes; seus números não devem ser lidos como um gráfico comparativo direto.
Comece com um runtime e otimize seu caminho compatível. Só construa uma comparação com um segundo runtime se puder manter constante o checkpoint, a alocação de GPU, as distribuições de prompt e saída, a concorrência, o aquecimento e o objetivo de serviço. Essa comparação custa tempo de engenharia, então primeiro confirme se a stack atual é de fato o fator limitante.
Otimize concorrência e contexto longo sem quebrar o SLO
Aumente a concorrência em etapas e capture saída agregada, velocidade de decodificação por requisição, TTFT, latência p95, uso de memória e falhas em cada etapa. Mantenha o ponto de maior throughput apenas se sua latência e taxas de erro ainda atenderem ao objetivo de serviço. Se as requisições entrarem na fila antes da geração, um lote maior pode melhorar a utilização do dispositivo enquanto faz o produto parecer mais lento.
Para tráfego de contexto longo, meça a distribuição de contexto ativo e a taxa de acerto de cache. Uma janela de contexto máxima declarada não significa que toda requisição possa ser atendida simultaneamente nesse comprimento. O cache KV compete por memória com pesos, ativações, pools de graph e buffers de runtime. Deixe folga para comprimentos variáveis de requisição e meça eviction ou preemption sob tráfego realista.
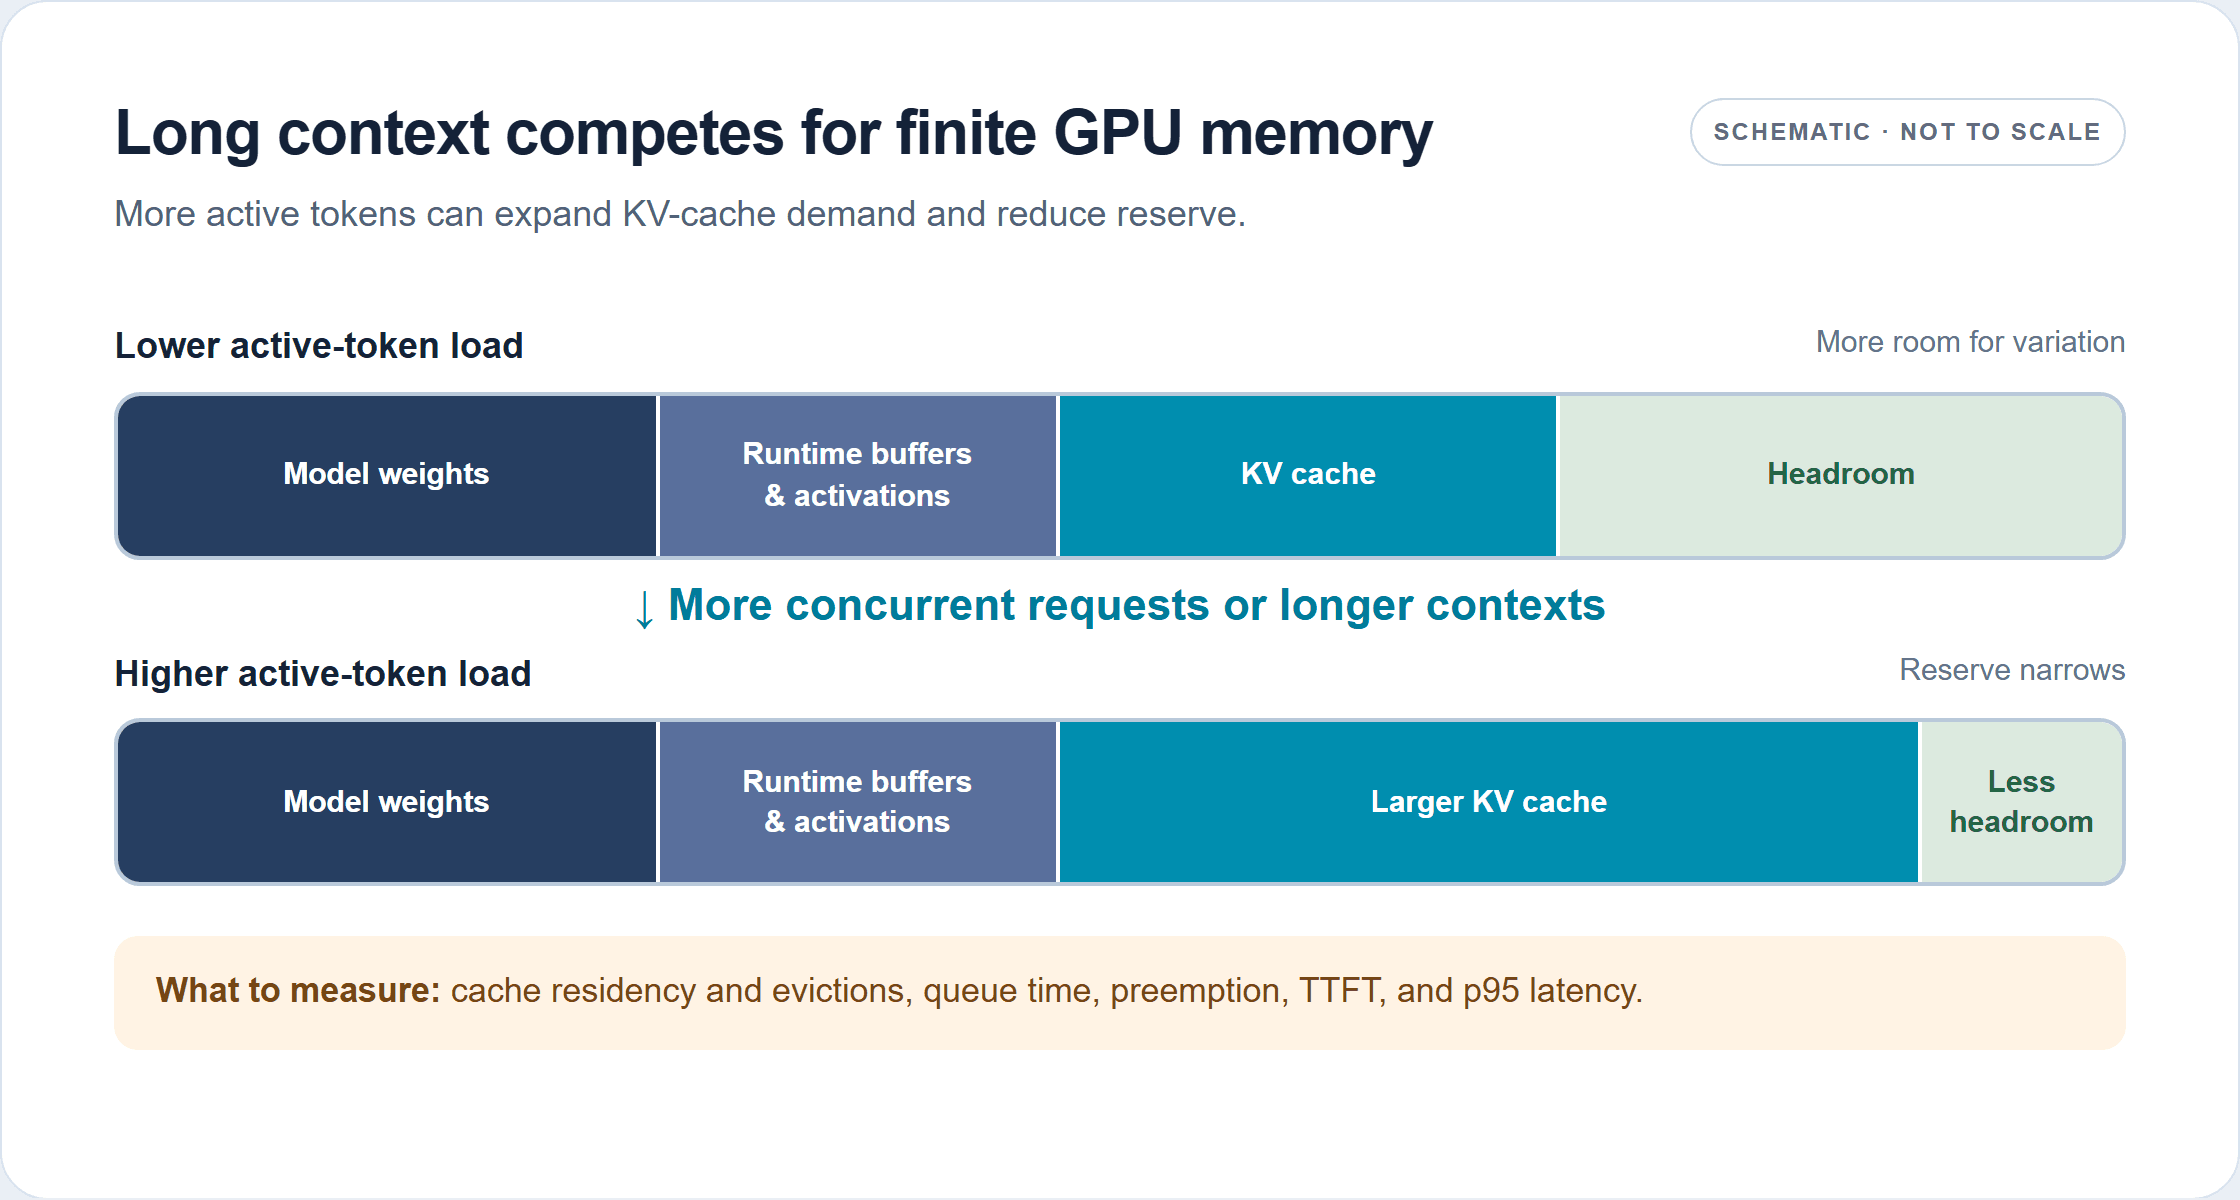
Contextos mais longos ou mais requisições simultâneas podem aumentar a demanda por cache KV. Os blocos de memória são esquemáticos e não estão em escala.
Trate quantização, precisão do cache KV, paralelismo tensor, paralelismo expert e desagregação de prefill/decode como experimentos separados. Eles podem alterar uso de memória, comunicação, seleção de kernel, qualidade da saída e latência. O melhor layout depende do tipo de GPU e do interconnect; adicionar mais GPUs pode aumentar custos de comunicação ou deixar alguns recursos ociosos. Verifique a qualidade exata da saída e os modos de falha após alterar a precisão ou a execução do modelo.
A sequência prática é simples: reproduza o baseline, identifique a métrica que não atinge seu alvo, formule uma hipótese de gargalo, altere uma configuração e repita. Se a configuração melhorar uma métrica e prejudicar outra, decida explicitamente se esse trade-off se adequa ao produto. Isso torna a otimização uma decisão controlada em vez de um monte de flags.
Valide decodificação especulativa e todo ganho de velocidade declarado
A decodificação especulativa pode reduzir o trabalho serial do modelo-alvo quando tokens draft são aceitos com eficiência e o runtime implementa bem a verificação. Seu benefício depende do caminho draft, do comportamento de aceitação, do formato do lote, do hardware e da mistura de prompt/saída. Ela pode ajudar tráfego limitado por decodificação e ter pouco valor quando prefill, enfileiramento ou comunicação dominam.
Execute um teste A/B com a especulação habilitada e desabilitada. Mantenha fixos o checkpoint do modelo, o conjunto de prompts, o limite de tokens, o padrão de chegada, a concorrência, o aquecimento e a janela de medição. Registre tokens aceitos por etapa de verificação, se disponível, junto com throughput agregado, velocidade por requisição, TTFT, latência p95, uso de GPU, falhas e qualidade da tarefa. Um comprimento de aceitação simulado em um benchmark publicado é uma condição de teste, não um valor a assumir para seus prompts.
Um ganho de velocidade declarado só é útil se sobreviver a três verificações: o mesmo objetivo de serviço, qualidade de resposta aceitável e uma comparação de custo justa. Relate o contexto completo junto com qualquer número que publicar. Evite comparar diferentes contagens de GPU, comprimentos de prompt, comprimentos de saída, modos de precisão, revisões de modelo ou métricas como se fossem um experimento controlado.
Auto-hospedar ou usar uma API gerenciada do DeepSeek V4.1 Flash?
Auto-hospedagem faz sentido quando o tráfego é estável o suficiente para manter as GPUs úteis, a equipe consegue operar a infraestrutura de inferência e o controle sobre hardware ou execução justifica o trabalho operacional. Inclua o custo total de aceleradores, folga de capacidade, energia, rede, armazenamento, manutenção e tempo de engenharia. Um resultado alto de pico de tokens/s sozinho não estabelece menor custo por tarefa bem-sucedida.
Uma API gerenciada é útil quando uma equipe precisa validar rapidamente a demanda do produto, evitar operar uma frota de serving ou comparar um baseline de API com sua própria implantação. O Atlas Cloud lista o DeepSeek V4.1 Flash sob o ID de modelo deepseek-ai/deepseek-v4.1-flash com uma API compatível com OpenAI. A página do modelo DeepSeek V4.1 Flash atualmente mostra $0.30 por milhão de tokens de entrada, $1.20 por milhão de tokens de saída e $0.03 por milhão de tokens de leitura de cache, sem desconto exibido em outubro de 2026. Verifique a listagem de preços atual antes de estimar gastos. Um endpoint gerenciado não elimina a necessidade de medir a latência das suas próprias requisições ou a economia do seu tráfego.
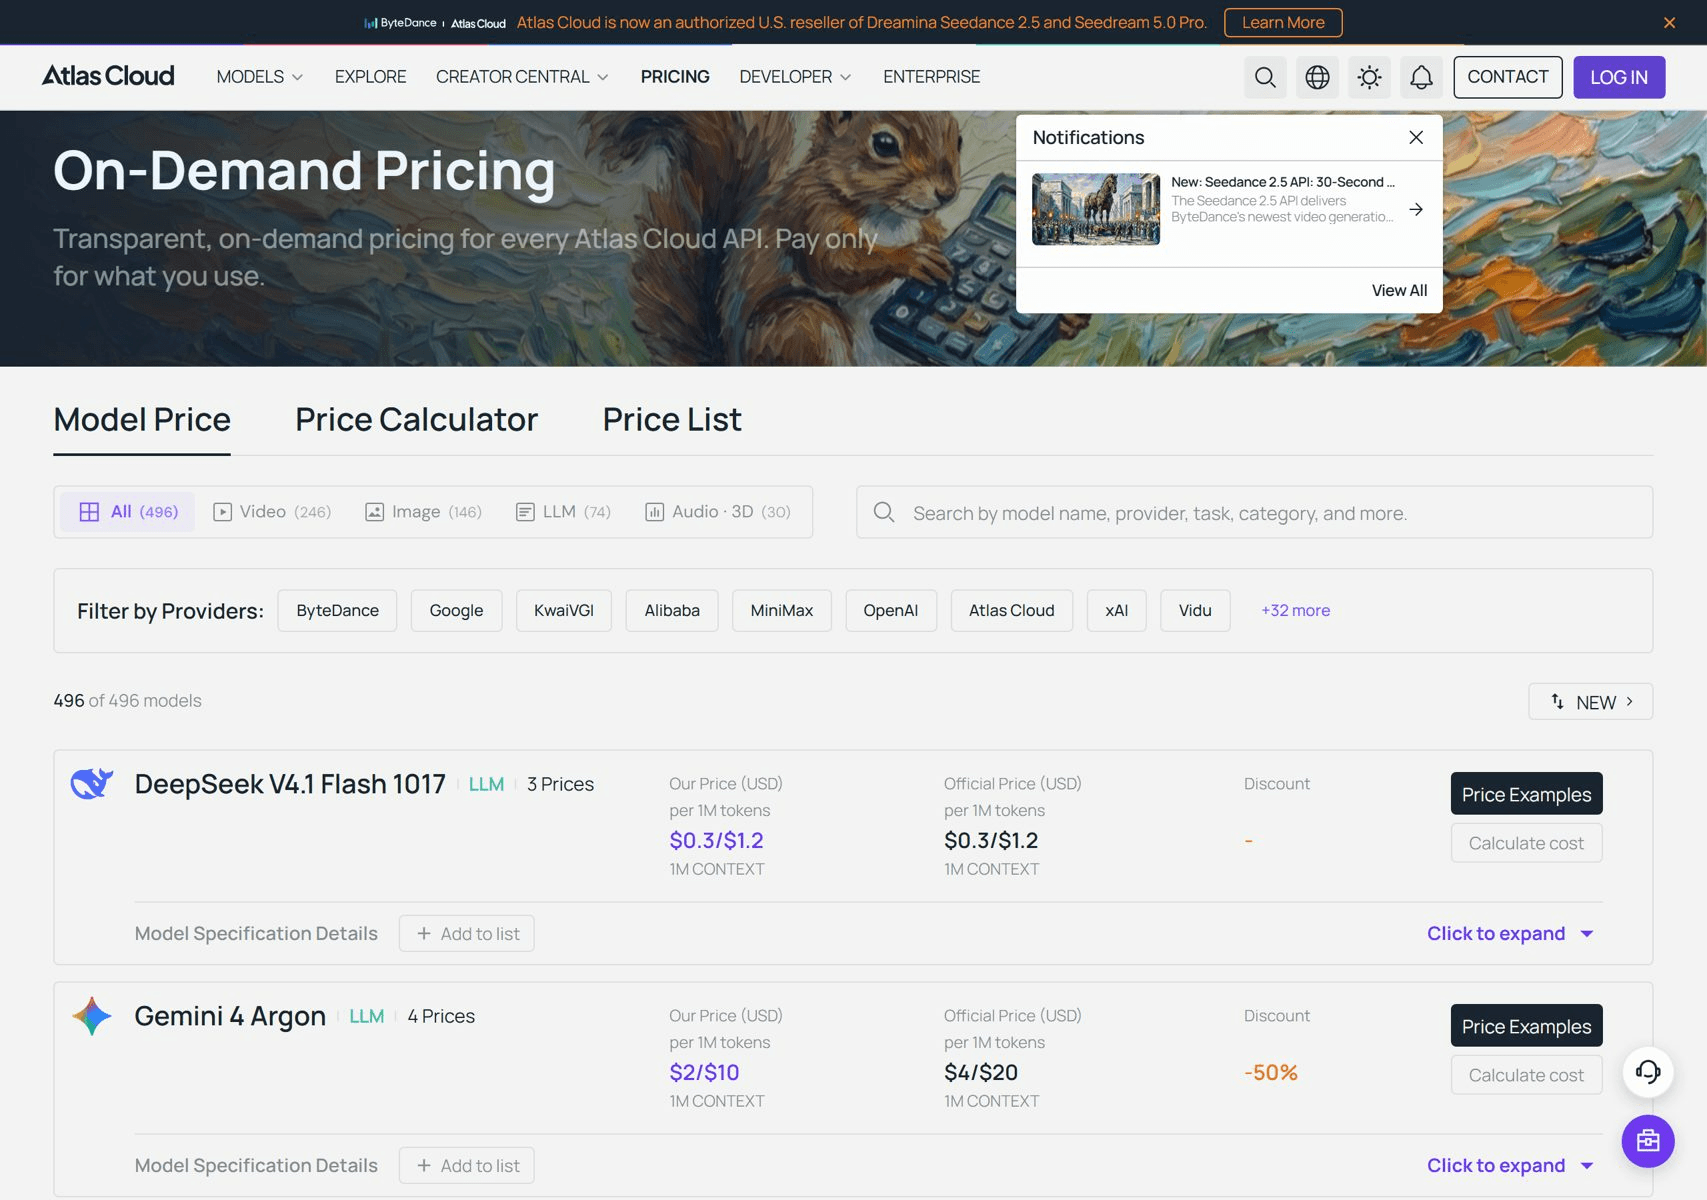
A listagem identifica uma opção de API gerenciada; ela não é um benchmark de serving.
Para uma decisão de implantação justa, reproduza as mesmas requisições de negócio no serviço auto-hospedado e no endpoint gerenciado. Compare custo por tarefa concluída, distribuição de latência, confiabilidade e o tempo de equipe necessário para manter cada opção. Se seu objetivo principal é a otimização de throughput de inferência do DeepSeek V4.1 Flash, mantenha a mesma carga de trabalho e os mesmos critérios de sucesso para ambos os caminhos.
Perguntas frequentes
Qual é a diferença entre throughput e tokens por segundo por usuário?
O throughput agregado conta a saída de todas as requisições ativas. Tokens/s por usuário mede a taxa de decodificação de uma requisição. O batching pode aumentar o primeiro enquanto reduz o segundo, então informe ambos para serviços interativos.
Aumentar a concorrência sempre melhora o throughput?
Não. A saída agregada pode subir até que a computação ou a memória saturem, e então estabilizar. Enfileiramento e latência de cauda podem continuar piorando depois desse ponto. Pare de aumentar a concorrência quando o objetivo de serviço não for atendido.
Os números de benchmark do vLLM e do SGLang podem ser comparados diretamente?
Somente se a revisão do modelo, o hardware, os comprimentos de prompt e saída, a concorrência, o estado warm, o limite de medição e a restrição de latência coincidirem. Relatórios publicados usam configurações diferentes, então demonstram caminhos de otimização em vez de um vencedor direto entre runtimes.
Quando devo usar uma API gerenciada em vez de auto-hospedagem?
Use uma API gerenciada quando a velocidade de integração e a redução do trabalho de infraestrutura importarem mais do que possuir a stack de serving. Auto-hospede quando utilização, experiência operacional, controle e um caso de custo total medido justificarem operar as GPUs.





