Uma janela de contexto de um milhão de tokens informa quanto texto um modelo pode aceitar, não com que confiabilidade ele interpretará cada cláusula. Para a precisão da análise de documentos longos do DeepSeek V4.1 Flash, as evidências públicas são úteis, mas incompletas: o model card da DeepSeek relata 45,2 de exact match no LongBench-V2 para o modelo base V4.1 Flash em uma configuração 1-shot, enquanto a API desde então passou para uma build 1017 mais nova. Esse benchmark é um sinal sobre uma configuração de avaliação, não uma taxa de aprovação para seu contrato, relatório anual ou arquivo de pesquisa.
A resposta prática é usar o Flash para recuperação rápida e síntese de primeira passagem, depois exigir evidências em nível de página e revisão humana para decisões que importam. Nenhuma fonte pública citada aqui fornece uma avaliação reproduzível da build atual para as cinco tarefas de documento abaixo. O plano de teste é um protocolo pronto para execução, não uma afirmação de que essas execuções já ocorreram.
Principais conclusões
- A família de modelos oferece suporte a até 1M de tokens, mas um limite de contexto não é uma garantia de precisão.
- A pontuação publicada de 45,2 no LongBench-V2 é para o modelo base e uma configuração de benchmark 1-shot.
- A API da DeepSeek agora disponibiliza V4.1-Flash-1017; suas notas de versão não publicam uma nova pontuação de documentos longos.
- Peça os locais das evidências, confira-os na fonte e meça erros nos seus próprios documentos.
O que a janela de 1M de tokens significa para a análise de documentos
O model card da DeepSeek descreve o V4.1 Flash como compatível com contextos de até um milhão de tokens. A documentação da API atualmente identifica o modelo disponibilizado como DeepSeek-V4.1-Flash-1017 e lista um comprimento de contexto de 1M. Essas são especificações de capacidade. Elas não estabelecem com que frequência o modelo encontra uma nota de rodapé, mantém duas versões de documento separadas ou admite que um fato solicitado está ausente. (Model card do DeepSeek)
Um token não é uma página. A contagem de páginas varia com tabelas, notas de rodapé, layout, idioma e qualidade da extração. Um PDF digitalizado pode precisar de OCR; uma tabela pode perder os rótulos das linhas quando convertida para texto; cabeçalhos e elementos repetidos de página podem consumir contexto sem ajudar a responder à pergunta. O prompt e a resposta solicitada também usam tokens. Portanto, um teto nominal de um milhão de tokens não significa que todo arquivo de um milhão de tokens chegará intacto por todas as interfaces de chat ou clientes de API.
Antes de um teste, registre o identificador exato do modelo, o cliente e o método de entrada. Verifique se o texto extraído completo foi enviado, se o provedor o truncou e se a solicitação chegou à versão esperada do modelo. A API atual da DeepSeek usa deepseek-flash para a build Flash mais recente. Se seu gateway ou SDK usar outro alias, registre esse alias e verifique seu roteamento. Equipes que configuram chamadas hospedadas repetíveis podem começar pela plataforma de modelos da Atlas Cloud, depois abrir sua listagem da API do DeepSeek V4.1 Flash.
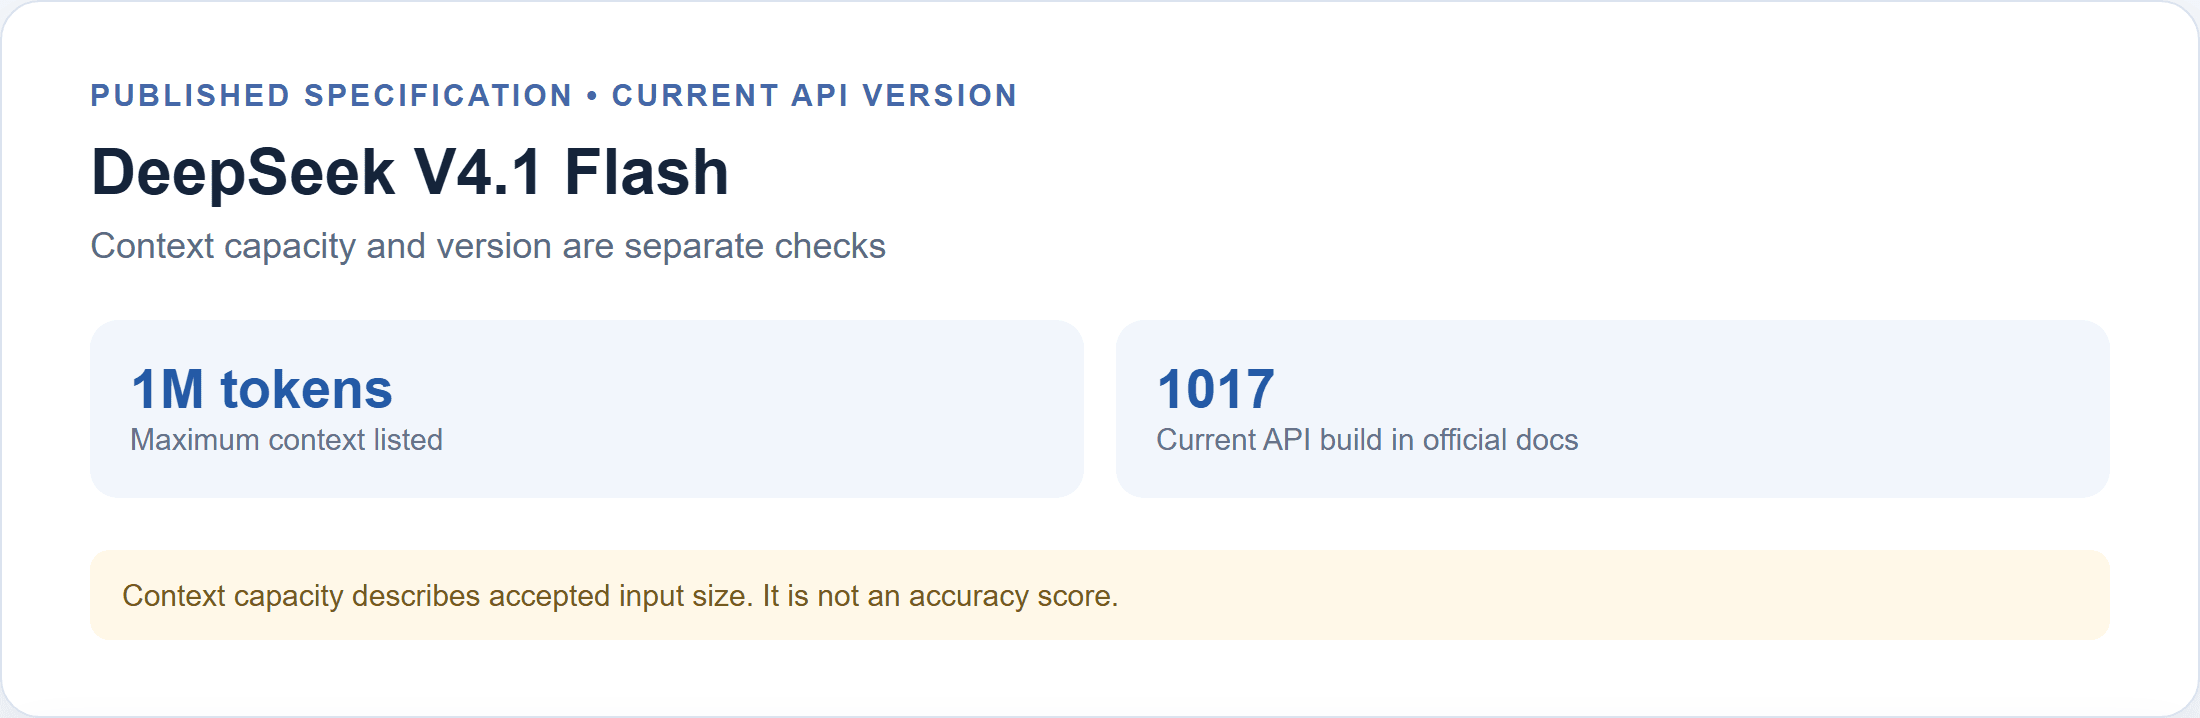
A especificação publicada indica um máximo de contexto de 1M; a documentação atual da API identifica a build 1017.
Um upload ou solicitação bem-sucedido mostra apenas que o sistema aceitou uma entrada. Para estabelecer que um detalhe relevante influenciou a resposta, peça uma localização precisa, recupere essa passagem e confirme que o texto ao redor sustenta a afirmação.
O que a pontuação do LongBench-V2 mostra e não mostra
A linha LongBench-V2 do model card relata pontuações de exact match em uma configuração 1-shot. Sua tabela rotula os resultados como avaliações de modelos base e afirma que todos os modelos base usam o mesmo framework interno de avaliação. Também afirma que pontuações dentro de 0,3 são consideradas equivalentes. Os valores são:
| Modelo base no model card | LongBench-V2 (EM) | Shots |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44,7 | 1 |
| DeepSeek-V4-Pro-Base | 51,5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45,2 | 1 |
A diferença de 0,5 ponto entre V4-Flash-Base e V4.1-Flash-Base é maior que a faixa de equivalência de 0,3 declarada no card, mas continua sendo uma comparação estreita de benchmark. O 45,2 não é “45,2% de precisão em PDFs longos”. É uma pontuação de exact match para um modelo base, conjunto de benchmark, configuração de prompt e avaliador específicos. Ela não avalia diretamente um modelo instruct/API hospedado respondendo às suas perguntas com um prompt diferente.
O LongBench-V2 contém 503 perguntas de múltipla escolha em seis categorias, incluindo perguntas e respostas de documento único e de vários documentos, diálogo longo, repositórios de código e dados estruturados. Seus contextos variam de 8.000 a 2 milhões de palavras. Os autores do benchmark relatam precisão média de 53,7% para especialistas em um limite de 15 minutos, e 50,1% para o melhor modelo de resposta direta na avaliação relatada. Sua amplitude o torna um teste de estresse útil, mas um número agregado não consegue diagnosticar qual operação de documento é forte ou fraca. (artigo do LongBench-V2)
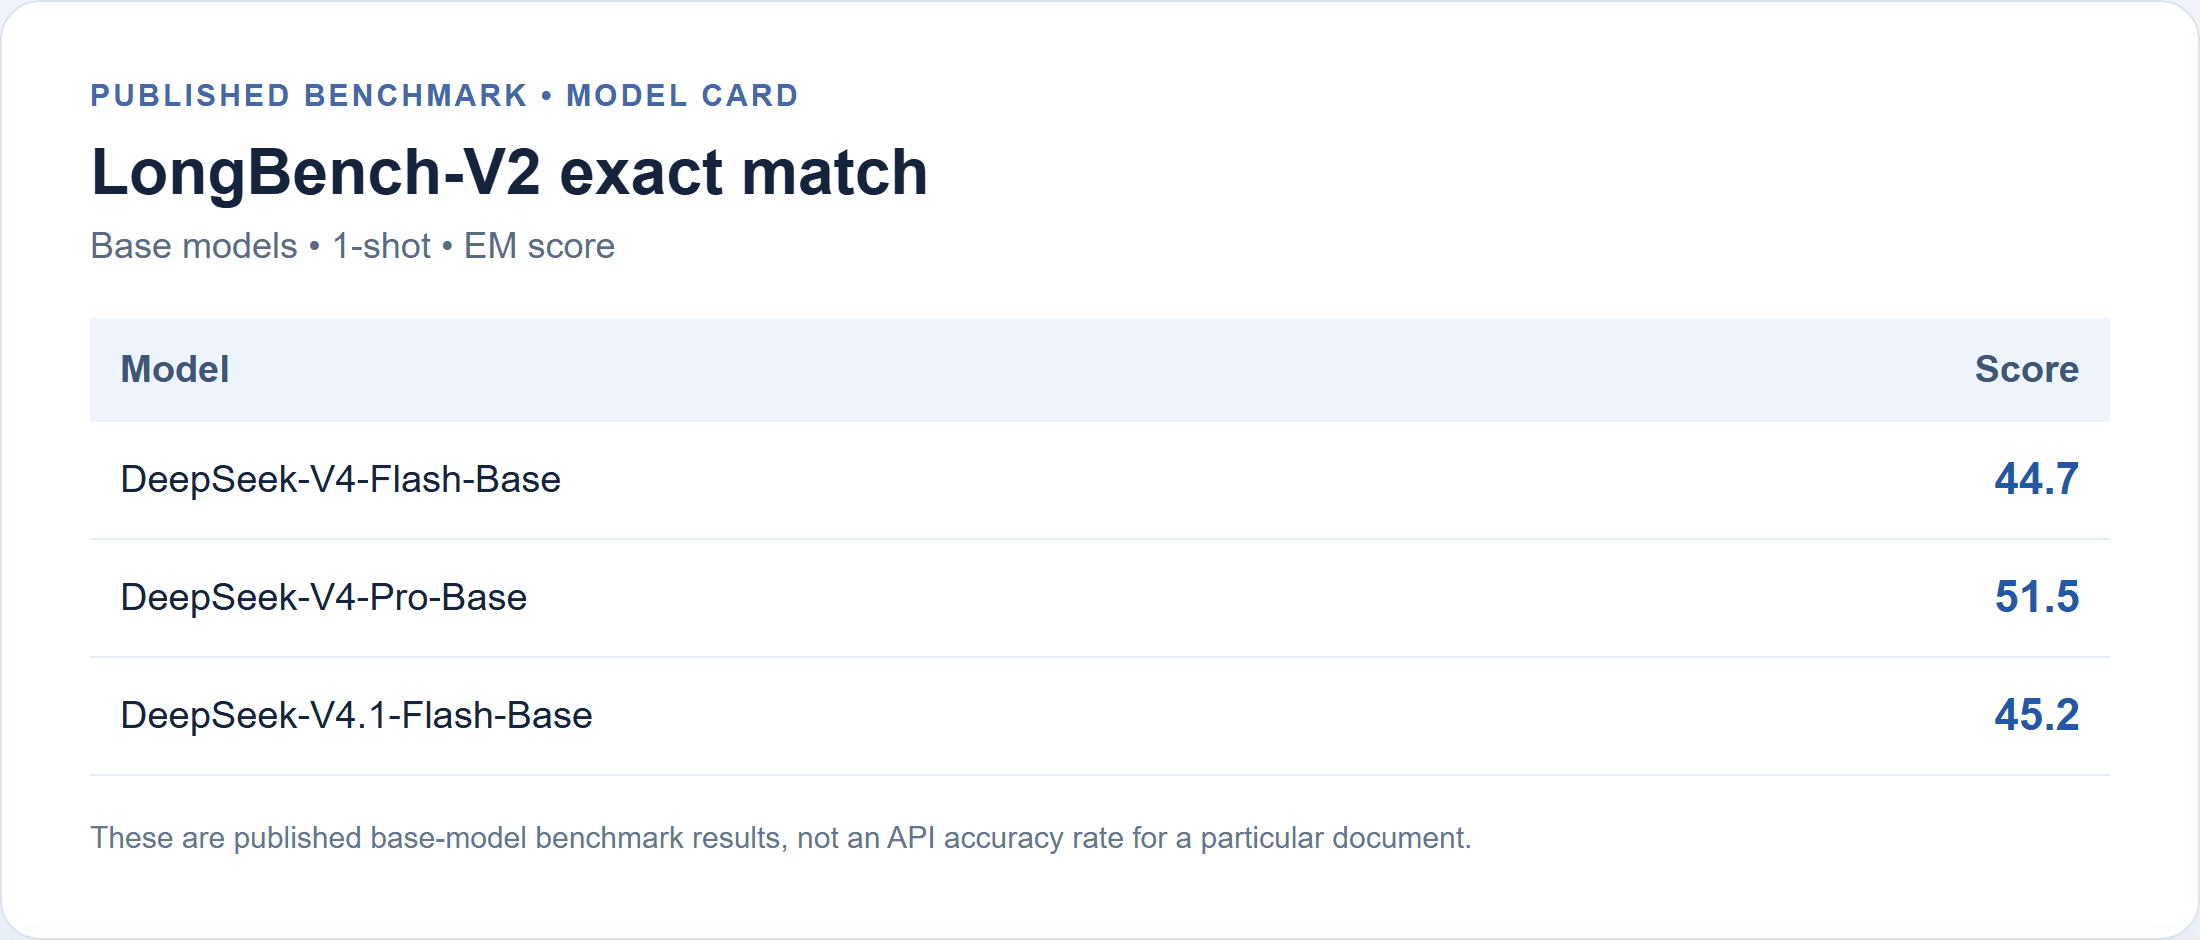
A linha publicada é um resultado de modelo base, em 1-shot. Não é uma taxa de aprovação medida da API.
Há uma ressalva de versão. As notas de versão de 17 de outubro da DeepSeek dizem que a API e o aplicativo web foram atualizados para V4.1-Flash-1017, e o nome do modelo na API continua sendo deepseek-flash. As notas listam benchmarks atualizados de agente e raciocínio, mas não relatam um novo resultado no LongBench-V2. Assim, 45,2 continua sendo uma referência publicada útil para o modelo base V4.1 Flash, enquanto a precisão da build atual da API em perguntas de documentos longos permanece não quantificada nessas fontes. Não transfira ganhos de benchmarks não relacionados para perguntas e respostas de documentos. (atualização do DeepSeek V4.1-Flash-1017)
Como executar um teste justo de precisão em documentos longos
Uma avaliação útil precisa de uma fonte fixa, um gabarito de respostas e regras de pontuação. Comece com um relatório anual ou relatório técnico público cuja versão e estrutura de páginas possam ser compartilhadas. Salve o PDF e o texto extraído, registre a URL da fonte e a data de recuperação e anote se você usou extração de texto nativa ou OCR. Evite selecionar um documento porque você já sabe que o modelo lida bem com ele.
Antes de enviar o prompt ao modelo, escreva você mesmo o gabarito de respostas com base na fonte. Para cada pergunta, registre a resposta esperada e a página ou seção exata. Isso impede que uma resposta convincente se torne o padrão de correção. Mantenha as perguntas específicas o suficiente para pontuar, preservando ao mesmo tempo a ambiguidade que um leitor realmente enfrentaria.
Use o mesmo documento, conjunto de perguntas, identificador de modelo, prompt, configuração de raciocínio e formato de saída em cada execução. Se a API expõe controles de temperatura ou raciocínio, registre-os. Execute o conjunto mais de uma vez se quiser estimar a variabilidade; uma execução é uma amostra, não uma taxa estável. Não corrija silenciosamente a saída antes de pontuá-la.
Um conjunto compacto pode cobrir cinco oportunidades diferentes de falha:
| Tarefa | Formato de exemplo da pergunta | O que verificar |
|---|---|---|
| Consulta pontual | “Que data o relatório fornece para a política revisada?” | Valor exato e página citada |
| Ligação entre seções | “Como o risco na Seção 2 se relaciona com o controle na Seção 7?” | Ambas as passagens e se a ligação é declarada ou inferida |
| Tratamento de exceções | “Quem é excluído da cobertura declarada?” | Nota de rodapé, escopo e qualificadores |
| Conflito de versões | “Qual valor se aplica após a revisão, e o que ele substituiu?” | Datas, rótulos de versão e ambos os locais |
| Informação ausente | “Qual período de retenção o relatório especifica para cópias de fornecedores?” | Reconhecimento de que o documento não diz nada |
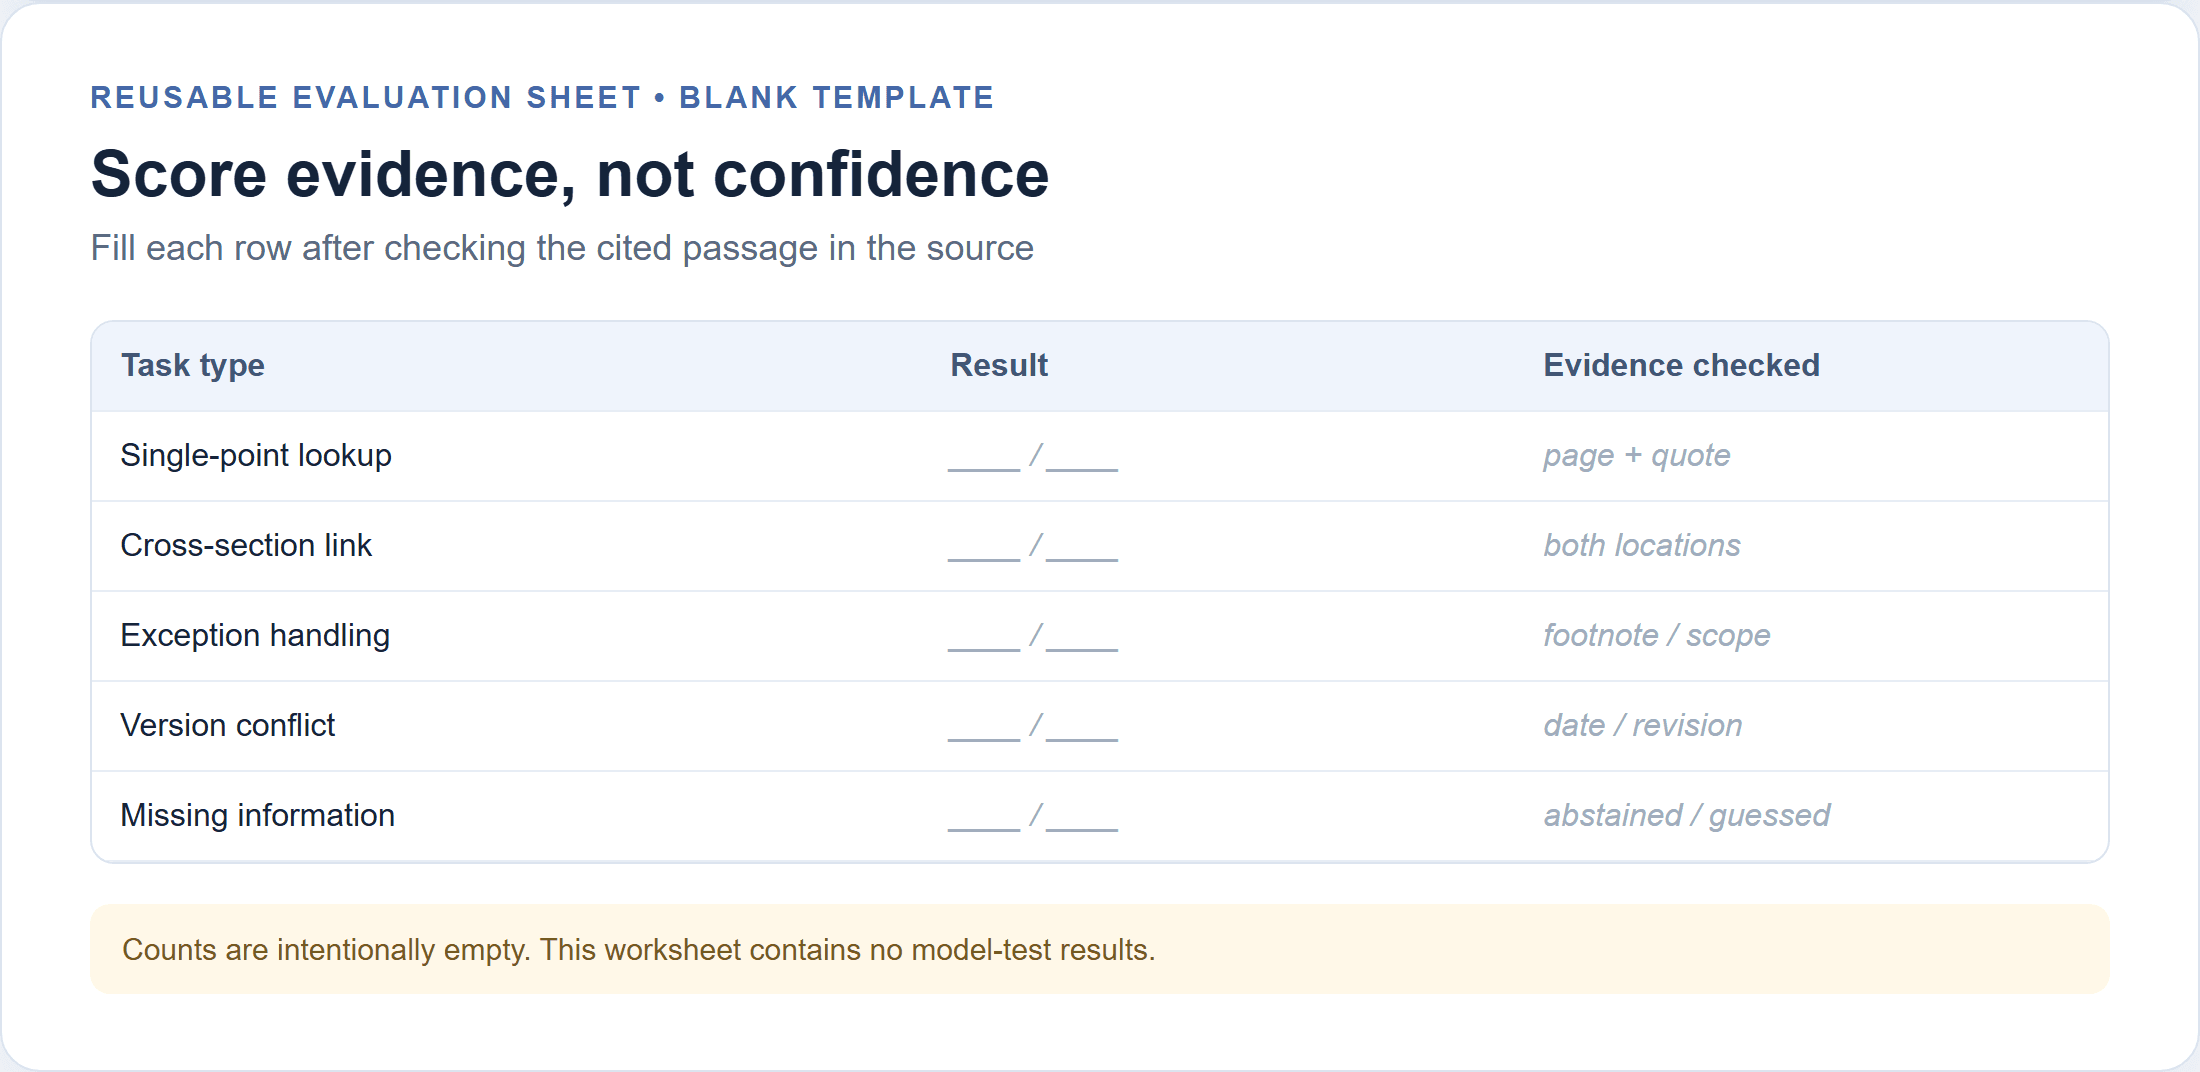
Esta é uma planilha de pontuação em branco, não uma tabela de resultados. Preencha-a somente depois de verificar cada resposta no documento fonte.
Pontue cada resposta como correta, parcial, errada, não sustentada ou com abstenção correta. Conte afirmações não sustentadas separadamente das respostas erradas, porque uma resposta pode dar a manchete correta e inventar um detalhe. Verifique se cada citação aponta para a passagem que sustenta a afirmação. Relate a contagem de perguntas e as contagens por categoria em conjunto. Uma porcentagem geral esconde se o modelo perdeu notas de rodapé ou teve dificuldade apenas quando a informação estava espalhada por seções.
Preserve o arquivo fonte exato, a extração, os prompts, as respostas brutas e a planilha de pontuação. Publique apenas material que você tem permissão para compartilhar e oculte nomes confidenciais ou detalhes de contas. Um revisor deve conseguir rastrear cada resposta pontuada da saída do modelo até uma página na fonte salva.
Onde as respostas para documentos longos tendem a falhar
Sem uma execução da build atual contra um documento declarado, seria errado afirmar que o V4.1 Flash exibiu uma taxa de erro ou padrão de falha específico. As categorias abaixo são itens a inspecionar, não descobertas medidas sobre este modelo.
Comece pela perda de escopo. Um parágrafo do corpo pode declarar uma regra enquanto uma nota de rodapé a limita a uma região, intervalo de datas ou classe de clientes. Peça a exceção explicitamente e inspecione se a passagem citada a inclui. Uma citação apenas do parágrafo principal pode ser insuficiente.
Em seguida, verifique a confusão de versões. Relatórios podem repetir valores semelhantes em um rascunho e em uma seção revisada. Peça ao modelo que nomeie a data ou versão associada a cada valor, em vez de solicitar apenas “o número atual”. Se ele escolher um silenciosamente, pontue a resposta como incompleta mesmo quando por acaso escolher corretamente.
Perguntas entre seções convidam à inferência. Um modelo pode combinar dois fatos precisos em uma explicação causal que o documento nunca faz. Exija que ele rotule declarações diretas separadamente das inferências. Depois compare a inferência com as evidências e decida se ela é razoável para a tarefa.
Por fim, teste a abstenção. Inclua uma pergunta cuja resposta esteja ausente. Um palpite confiante é uma falha mesmo que pareça plausível. Para contratos, conformidade, material clínico ou análise financeira de alto impacto, peça a uma pessoa qualificada que verifique o texto original antes de usar uma conclusão.
Um fluxo de trabalho de verificação para respostas mais seguras
Este prompt torna as respostas mais fáceis de auditar. Ele não pode garantir a correção nem substituir a revisão da fonte. Use-o com uma extração que preserve rótulos de página e, em seguida, faça perguntas focadas em vez de pedir um resumo geral de um arquivo enorme.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
Para um relatório longo, divida o trabalho por tarefa, não automaticamente por uma contagem arbitrária de páginas. Primeiro peça um mapa da fonte: títulos de seções, datas, termos definidos e tabelas relevantes. Depois consulte um tópico específico e solicite suas passagens de apoio. Para uma conclusão entre seções, forneça ou recupere ambas as passagens no mesmo turno e peça ao modelo que explique a ligação, marcando qualquer inferência.
Use um ciclo de verificação humana:
- Verifique a página citada e a citação no arquivo original.
- Confirme se a citação inclui exceções vizinhas e cabeçalhos de tabela.
- Marque cada afirmação como direta, inferida, não sustentada ou contradita.
- Corrija o prompt ou divida a tarefa se a extração omitiu estrutura importante.
- Salve a solicitação e a resposta brutas para que um revisor possa reproduzir a decisão.
Quando você usa um endpoint hospedado, inclua o uso de tokens no log de execução. A página de preços de modelos da Atlas Cloud atualmente lista o DeepSeek V4.1 Flash a $0.30 por 1M tokens de entrada, $1.20 por 1M tokens de saída e $0.03 por 1M tokens de leitura de cache, sem desconto listado. Verifique a listagem atual antes de fazer orçamento. Esta referência de preço é da Atlas Cloud, não um preço universal da API DeepSeek.
A essas tarifas listadas, 100.000 tokens de entrada não armazenados em cache e 3.000 tokens de saída custam cerca de $0.033: $0.030 pela entrada mais $0.0036 pela saída.
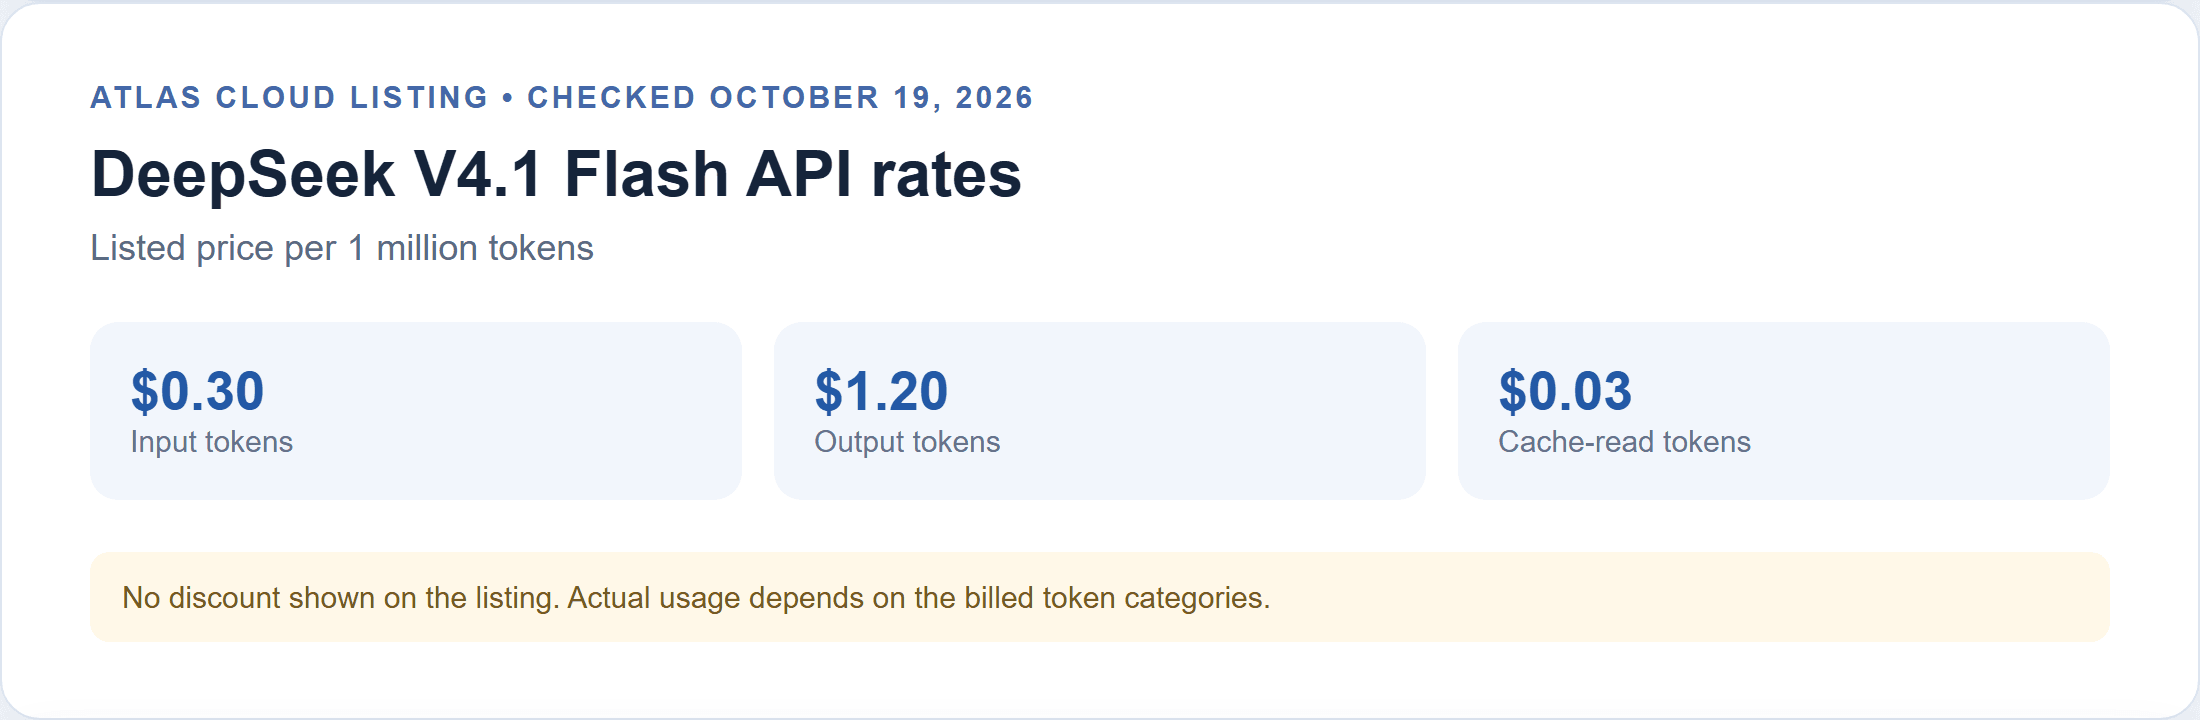
Preços da Atlas Cloud verificados em 19 de outubro de 2026; a listagem não mostra desconto. Uma entrada de 1M de tokens e uma resposta de 20.000 tokens custariam cerca de $0.324 nas mesmas tarifas, antes do tratamento de cache ou outros itens faturáveis. Estes são exemplos aritméticos, não contas medidas de testes de documentos. A entrada real inclui o prompt e o texto extraído; chamadas repetidas adicionam uso. Use as contagens de tokens retornadas pelo provedor em vez de estimar pela contagem de páginas.
Quando usar o DeepSeek V4.1 Flash para documentos longos
O Flash é uma primeira passagem razoável quando você precisa localizar definições, reunir datas, criar um mapa de seções ou redigir um resumo que uma pessoa irá conferir. Essas tarefas têm trilhas de evidências visíveis e são fáceis de repetir com perguntas mais precisas. Para trabalho recorrente, mantenha perguntas com respostas conhecidas e execute-as novamente quando a versão do modelo, o pipeline de extração ou o prompt mudar.
Adicione controles quando uma pergunta combina seções distantes, depende de uma nota de rodapé ou compara revisões. Use citações como auxílios de navegação, não como prova por si sós. Se uma resposta afetar uma obrigação contratual, posição de conformidade, divulgação financeira ou outra decisão de alto impacto, faça um revisor qualificado verificar cada afirmação relevante na fonte.
A pergunta útil é se este modelo, na sua versão do documento e no seu fluxo de trabalho exato, retorna respostas com evidências que sobrevivem à verificação. Esse é o teste que pode estabelecer a precisão da análise de documentos longos do DeepSeek V4.1 Flash para o seu próprio caso de uso.
Perguntas frequentes
Uma janela de contexto de 1M de tokens significa que um modelo pode analisar com precisão um documento de 1M de tokens?
Não. Ela descreve a capacidade de contexto suportada. A solicitação real também inclui instruções e orçamento de saída, enquanto extração, limites de interface e dificuldade da pergunta afetam se evidências úteis estão disponíveis e são interpretadas corretamente.
O LongBench-V2 é o mesmo que precisão de perguntas e respostas de documentos?
Não. Ele inclui várias categorias de tarefas de contexto longo e relata desempenho em uma configuração específica. É um sinal de comparação, não uma garantia para um PDF, build de API, prompt ou domínio específico.
Devo usar um único prompt ou dividir um documento longo em seções?
Use um mapa da fonte e perguntas focadas quando a estrutura importar. Mantenha disponíveis juntas, para a etapa de síntese, as passagens que precisam ser comparadas, e preserve rótulos de página para poder verificar a resposta.
Como devo verificar citações de um resumo gerado por IA?
Abra cada página citada no arquivo original, confira a citação e o texto ao redor e confirme se a passagem sustenta a afirmação específica. Verifique cabeçalhos de tabela e notas de rodapé, bem como a frase citada.
Como os tokens de entrada e saída afetam o custo?
Tokens de entrada cobrem o documento, as instruções e a pergunta. Tokens de saída cobrem a resposta. Prompts mais longos, chamadas múltiplas e passagens repetidas aumentam o uso; use contagens de tokens faturadas e a tabela de preços atual do provedor para estimativas.





