

Um desenvolvedor vê "1M tokens" e se prepara para enviar um repositório inteiro, seu histórico de issues e um longo relatório de design em uma única solicitação. O detalhe crucial na janela de contexto de 1M do Gemini 4 Argon é que 1.048.576 tokens são compartilhados por entrada, raciocínio e saída. Não são um milhão de tokens de entrada mais outro milhão para a resposta. O Google lista um limite padrão de saída síncrona de 65.536 tokens, enquanto a decodificação longa pode estender a geração até a capacidade compartilhada restante. A especificação do modelo do Google fornece os limites; este guia os transforma em um orçamento e em uma decisão sobre contexto longo, recuperação e fragmentação.
Principais conclusões
- A janela de contexto de 1.048.576 tokens é um orçamento combinado de entrada, raciocínio e saída.
- A saída síncrona padrão é limitada a 65.536 tokens; a decodificação longa não adiciona mais contexto.
- Use contexto longo quando relações entre um conjunto conhecido de fontes importarem; use recuperação ou fragmentação quando não importarem.
O que significa a janela de contexto de 1M do Gemini 4 Argon?
O orçamento de 1.048.576 tokens é compartilhado
Uma janela de contexto é o limite de tokens disponível para uma solicitação. Para o Argon, o Google documenta um total unificado de 1.048.576. O prompt, o material de origem anexado, os tokens de raciocínio e a resposta gerada consomem essa margem. Ele descreve capacidade, não uma promessa de que todo detalhe será igualmente fácil de recuperar ou raciocinar.
Se uma solicitação contém 900.000 tokens de origem, no máximo 148.576 permanecem entre raciocínio e saída, antes de restrições específicas da interface. Um aplicativo que presume que pode então solicitar uma resposta de 200.000 tokens comprometeu demais o mesmo orçamento.
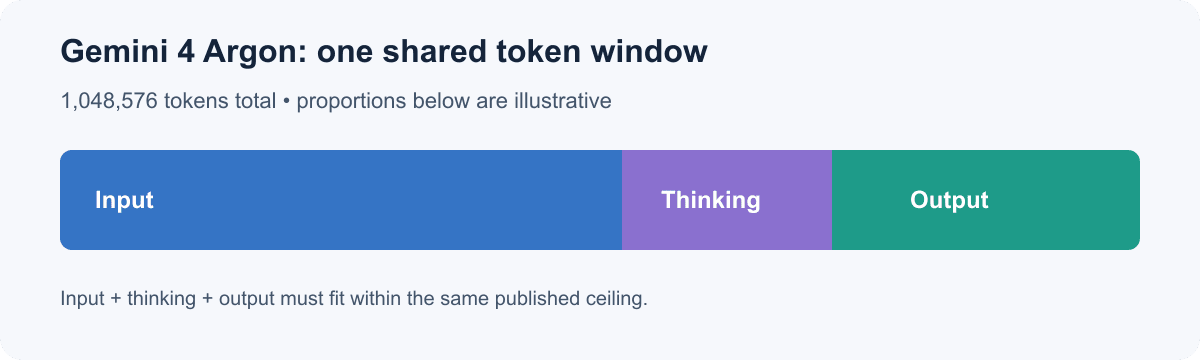
A janela publicada é um teto compartilhado. Os tamanhos dos segmentos são conceituais, não uma alocação fixa.
Entrada, raciocínio e saída saem de uma única janela
Uma equação útil de planejamento é:
input tokens + thinking tokens + output tokens <= 1,048,576
Esta é uma verificação de orçamento, não uma afirmação de que desenvolvedores podem definir uma contagem exata de tokens de raciocínio para cada chamada. O Google lista configurações de raciocínio baixa, média e alta; o consumo interno pode variar conforme a tarefa e as configurações. Reserve espaço para raciocínio em vez de tratar o remanescente teórico como capacidade garantida de resposta.
O Argon aceita entrada de texto, imagem, vídeo, áudio e PDF, com saída de texto. A contabilização de mídia não é equivalente à de texto simples, então uma contagem de arquivos ou de páginas não consegue prever com confiabilidade o total de tokens. Inspecione os metadados de uso de uma solicitação representativa.
Janela de contexto vs. limite de saída: a diferença crucial
O limite padrão de saída
A página do modelo lista uma saída máxima de 65.536 tokens para geração síncrona padrão, cerca de um dezesseis avos da janela total. Uma solicitação pode caber no limite geral de contexto e ainda exceder o limite de saída ativo.
Para muitos aplicativos, esse padrão é suficiente. Uma revisão de repositório ou síntese de documentos geralmente precisa de uma resposta focada, não de uma tão longa quanto o conjunto de fontes. Uma saída limitada é mais fácil de revisar, armazenar e passar para outra etapa.
O que a decodificação longa muda
A decodificação longa suporta geração muito mais longa, de até 1.048.576 tokens, segundo a especificação do modelo. Ela não expande a janela total. Se o prompt já ocupa a maior parte dela, resta menos capacidade para raciocínio e saída. O caminho da API, o SDK, as configurações de solicitação e o tratamento de resposta também importam, então verifique a orientação atual de integração antes de depender de uma resposta longa em produção.
Use decodificação longa somente quando o entregável realmente precisar de material gerado extenso, como uma grande transformação estruturada retornada em uma única operação. Se a resposta puder ser dividida em seções validadas, a geração em estágios pode tornar resultados incompletos mais fáceis de detectar e recuperar.
Como orçar tokens de entrada, raciocínio e saída
Comece pelo entregável; depois, estime os tokens de origem usando o método de contagem do modelo selecionado, quando disponível. Conte também instruções, resultados de ferramentas, texto de esquema e histórico da conversa. Reserve uma margem para raciocínio e erro de estimativa em vez de gastar o remanescente teórico.
Os números abaixo são exemplos aritméticos, não consumo fixo de raciocínio. "Remanescente de planejamento" é o total após a entrada presumida e a reserva para raciocínio. Limites reais do serviço ainda se aplicam.
| Entrada presumida | Reserva para raciocínio | Remanescente de planejamento para saída | Exemplo |
|---|---|---|---|
| 120.000 | 20.000 | 908.576 | Vários manuais, síntese concisa |
| 500.000 | 40.000 | 508.576 | Revisão de base de código com referências de arquivo |
| 900.000 | 50.000 | 98.576 | Comparação de acervo com uma resposta limitada |
Aritmética ilustrativa a partir de um teto de 1.048.576 tokens; as reservas são premissas de planejamento.
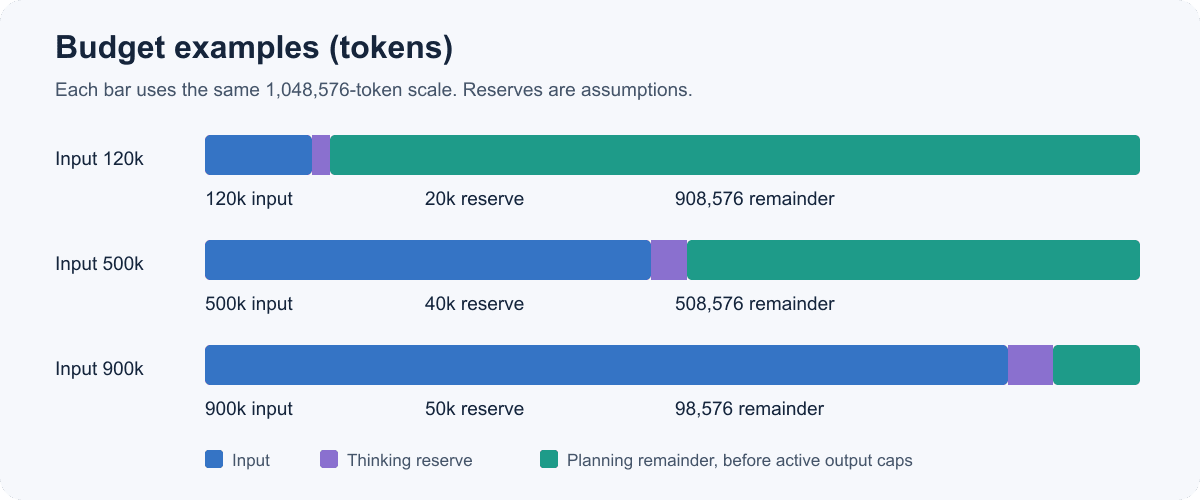
Use esta lista de verificação para planejamento de solicitações:
- Entrada: tokens estimados de origem e prompt.
- Raciocínio: reserve capacidade com base na complexidade da tarefa e nas configurações suportadas.
- Saída: escolha um limite que caiba no entregável.
- Verificação: some os três valores e deixe espaço para erro de estimativa.
- Caminho: confirme se o endpoint ou SDK selecionado suporta o comprimento de saída e o comportamento de continuação.
Para uma revisão de base de código de 500.000 tokens, uma equipe pode reservar 40.000 tokens para raciocínio e mirar uma resposta de 25.000 tokens. Esse plano usa 565.000 tokens no papel e deixa folga para estimativas imperfeitas ou instruções extras. A equipe ainda deve verificar o uso real e os limites de geração configurados. A reserva é uma ferramenta de planejamento, não uma previsão do raciocínio privado.
Antes de uma execução em lote, amostre mais de um tipo de solicitação. Uma página curta de documentação, um módulo com muito código e um PDF com tabelas podem produzir contagens de tokens diferentes mesmo quando seus tamanhos de arquivo parecem semelhantes. Conte entradas representativas e compare as estimativas com o uso retornado pela API. Se o relatório real de raciocínio ou saída do modelo diferir das suas premissas, atualize a reserva e o limite antes de aumentar o tamanho do lote. Esse pequeno passo de calibração ajuda a manter um fluxo de trabalho de contexto longo dentro de seu envelope de tokens e orçamento.
O que cabe em um milhão de tokens?
Documentos, código e material multimodal
Um milhão de tokens pode tornar plausível uma análise em uma única passada de um conjunto de manuais, vários contratos, uma grande árvore de código-fonte ou uma longa transcrição com anotações. O Google usou ilustrações aproximadas, como cerca de 1.500 páginas de texto ou 30.000 linhas de código. Trate esses números como exemplos de escala, não como garantias. Layout, densidade de código, idioma, formatação e tokenização afetam a contagem.
Para trabalho em repositório, inclua arquivos de build, código gerado, comentários, metadados de dependências, testes e contexto relevante de issues na sua estimativa. Depois, pergunte se a tarefa precisa de tudo. Uma revisão de arquitetura entre módulos pode se beneficiar de um conjunto amplo de fontes; uma pergunta sobre uma mensagem de erro provavelmente não.
Entradas multimodais também complicam as estimativas. A duração de um vídeo, a amostragem de quadros, o áudio, a resolução e o tratamento da API podem afetar o uso e as evidências que o modelo vê. Para uma pergunta específica, inclua apenas mídia relevante e inspecione o uso de uma solicitação representativa antes de escalar.
Contagens de tokens não são contagens de páginas
Um token é uma unidade de processamento do modelo, não uma palavra, caractere, página ou linha. Identificadores, tabelas, código-fonte e escrita em idiomas que não o inglês podem ser tokenizados de forma diferente de prosa comum. Uma estimativa de páginas não consegue dizer se a sua coleção específica cabe.
Capacidade também é diferente de qualidade. Fazer um conjunto de fontes caber não prova que o modelo encontrará toda exceção enterrada, preservará toda dependência ou resolverá corretamente passagens conflitantes. A especificação estabelece um limite, não recordação exaustiva nem uma pontuação de precisão específica da tarefa. Para conclusões relevantes, solicite localizações das fontes e valide afirmações importantes contra os originais.
Quando uma janela de 1M ajuda — e quando não ajuda
Contexto longo é mais útil quando uma resposta depende de relações espalhadas por material que uma consulta simples pode não recuperar. Ele é menos convincente para perguntas específicas repetidas em um corpus em mudança, em que a recuperação pode selecionar um conjunto menor de evidências. Esses são trade-offs de fluxo de trabalho, não um ranking universal de precisão.
| Abordagem | Considere quando | Trade-off |
|---|---|---|
| Solicitação de contexto longo | Uma análise pontual precisa de relações entre um conjunto conhecido de fontes | Entrada grande pode aumentar custo e latência; verifique a cobertura |
| Recuperação | Usuários fazem perguntas repetidas em um corpus em mudança | Indexação e recuperação determinam quais evidências chegam ao modelo |
| Fragmentação | Documentos podem ser processados como unidades ou estágios independentes | Relações entre fragmentos precisam de reconciliação |
| Híbrida | Você precisa de orientação ampla seguida de verificações focadas de evidências | Mais orquestração e tratamento de estado |
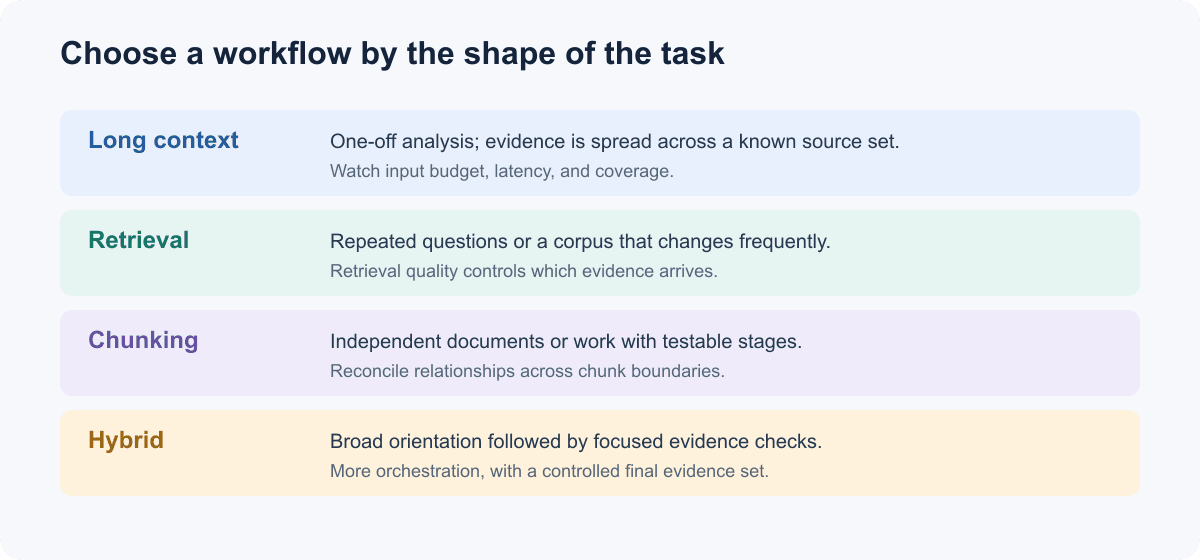 Escolha com base no formato da tarefa e no padrão de consulta; depois, valide em entradas representativas.
Considere contexto longo para comparar políticas cujas cláusulas afetam umas às outras, revisar uma mudança em muitos módulos de software ou sintetizar documentos em que um detalhe em uma fonte muda a interpretação de outra. A recuperação se encaixa em perguntas de suporte repetidas contra uma base de conhecimento em crescimento. A fragmentação funciona quando as unidades de origem são independentes ou cada estágio tem uma saída testável. Um fluxo de trabalho híbrido pode mapear a coleção primeiro e depois recuperar e verificar passagens para uma resposta final.
Avalie as opções com as mesmas perguntas representativas. Acompanhe se as evidências necessárias foram incluídas, se as citações apontam para as passagens corretas, o uso de tokens, o tempo de resposta e o esforço de recuperação após uma resposta incompleta. Isso dá à sua equipe evidências para sua carga de trabalho em vez de presumir que uma janela maior automaticamente a melhora.
Usando o Gemini 4 Argon para tarefas de contexto longo
Confirme o ID do modelo e o caminho da solicitação
O Google lista o ID do modelo da API Gemini como `gemini-4-argon`. Confirme se ele está habilitado para sua conta e se a interface exata da API suporta os recursos de que você precisa. O mesmo nome de modelo não garante que todo proxy, SDK, console ou cliente exponha limites idênticos ou o mesmo comportamento de decodificação longa.
Antes da produção, verifique:
- O ID do modelo e a disponibilidade para sua conta ou região.
- O limite de saída síncrona e como a decodificação longa é solicitada ou retornada.
- Se o SDK lida com continuação e como ele relata respostas parciais ou com falha.
- Configurações de raciocínio, ferramentas, cache e modalidades suportadas para a API selecionada.
- Os campos de uso reais de entrada e saída da solicitação.
O guia de contexto longo do Google descreve o orçamento unificado. As orientações de SDK e API podem mudar, então fixe uma versão de SDK suportada, inspecione o exemplo atual e faça testes de integração com o mesmo transporte e tratamento de resposta planejados para produção. Não copie nomes de parâmetros de uma integração de modelo mais antiga sem verificar se eles ainda se aplicam.
Faça o contrato de saída ser menor que o conjunto de fontes
Dê ao modelo uma tarefa limitada e um formato de resposta definido. Para uma auditoria de repositório, solicite constatações agrupadas por severidade com caminhos de arquivo e referências de linha, e especifique se deve incluir hipóteses ou apenas defeitos confirmados. Para uma comparação de contratos, nomeie as cláusulas e solicite identificadores de seção ou breves trechos de apoio. Isso é mais fácil de revisar do que "analise tudo". Para respostas grandes, planeje a continuação e a conclusão parcial. Persista identificadores e partes da resposta quando o SDK os expõe, valide a saída estruturada antes do uso downstream e tente novamente apenas a parte com falha quando possível. Essas são salvaguardas a implementar e verificar, não uma afirmação de que todo SDK lida com interrupções de forma idêntica.
Preços e acesso: o que verificar antes de executar
O anúncio do Google atualmente lista tarifas introdutórias de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída até 30 de novembro de 2026, seguidas das tarifas declaradas de $4 e $20 por milhão. Isso é sujeito a alteração: verifique novamente o anúncio oficial do Gemini 4 Argon antes de publicar ou projetar gastos. Estime entrada e saída separadamente porque cargas de trabalho com muitos prompts e com muita geração têm perfis de custo diferentes.
A disponibilidade do Argon por meio da Atlas Cloud não está confirmada nas páginas de diretório verificadas para este artigo. O catálogo de modelos Gemini da Atlas mostra os modelos Gemini e os detalhes de acesso atualmente listados ali; ele não estabelece que o Argon está disponível. Confirme uma página de detalhes, um protocolo e um preço específicos do modelo antes de rotear solicitações ou comparar custos.
Comece com uma solicitação representativa e registre versões do modelo e do SDK, uso de tokens, latência, erros e verificações de qualidade específicas da tarefa. Revise o orçamento e a escolha de recuperação quando os conjuntos de fontes ou os padrões de consulta mudarem. A janela de contexto de 1M do Gemini 4 Argon é útil quando sua amplitude resolve um problema real entre fontes e sua solicitação tem um orçamento claro e um plano de verificação.
Perguntas frequentes
A janela de 1M do Gemini 4 Argon é compartilhada entre entrada e saída?
Sim. O Google define uma única janela de 1.048.576 tokens compartilhada entre entrada, raciocínio e saída. A quantidade restante para uma resposta depende da solicitação e dos limites de interface aplicáveis.
Qual é o limite de saída padrão do Gemini 4 Argon?
A especificação lista 65.536 tokens para saída síncrona padrão. A decodificação longa pode suportar geração maior, sujeita à capacidade compartilhada restante e ao caminho da API.
O Gemini 4 Argon consegue gerar 1M de tokens em uma resposta?
A página do modelo lista decodificação longa de até 1.048.576 tokens de saída, mas isso é uma capacidade máxima, não uma garantia de que uma solicitação contendo entrada também possa retornar um milhão de tokens. Entrada e raciocínio ocupam a mesma janela total.
Uma janela de contexto de 1M significa que todo detalhe será lembrado com precisão?
Não. Ela descreve o orçamento máximo de tokens, não recuperação ou raciocínio perfeitos. Exija referências de evidências e teste casos extremos conhecidos do seu próprio material.
O Gemini 4 Argon está disponível atualmente por meio da Atlas Cloud?
Não consegui confirmar uma listagem de modelo ou página de detalhes específica do Argon no catálogo da Atlas Cloud verificado para este artigo. Verifique o diretório atual antes de presumir suporte; o link do catálogo Gemini acima não estabelece por si só a disponibilidade do Argon.


