Uma cena de duas pessoas se torna convincente quando você consegue ver e ouvir quem é dono de cada fala. Para tornar o diálogo com vários falantes do Gemini Omni 1.2 Flash fácil de acompanhar, dê a cada personagem uma identidade visual e vocal fixa, escreva falas curtas na ordem de fala e revise o vídeo final com os olhos e os ouvidos. A atualização de novembro de 2026 do Google oferece suporte a fala com vários falantes mais natural e clipes de até 15 segundos, mas um prompt não consegue garantir uma atribuição limpa de falantes na primeira renderização. Comece com uma troca simples entre 2 pessoas, depois adicione um terceiro turno ou ambiência de rua somente quando conseguir julgar a passagem básica.
Principais conclusões
- O Gemini Omni 1.2 Flash gera vídeo com som nativo, incluindo diálogo; ele é diferente dos modelos de conversão de texto em fala somente de áudio do Gemini.
- Use falantes nomeados, falas exatas entre aspas, posições claras e um ouvinte silencioso em cada turno.
- Deixe espaço para pausas dentro do máximo de 15 segundos, depois confira cada fala em relação ao clipe.
- Precifique uma renderização a partir da duração e resolução selecionadas, não da menor taxa anunciada de uma plataforma.
O que significa diálogo com vários falantes no Gemini Omni 1.2 Flash?
O modelo cria uma cena curta na qual as pessoas podem falar como parte do áudio e do vídeo gerados. O teste prático é saber se um espectador consegue identificar quem diz cada fala sem ler uma transcrição. As palavras, a voz, a pessoa visível e o movimento da boca precisam concordar ao mesmo tempo. Um clipe pode parecer persuasivo com o som mudo e ainda assim falhar nesse teste.
O Google anunciou o Gemini Omni 1.2 Flash em 5 de novembro de 2026, com até 15 segundos de vídeo gerado ou editado. Ele descreve diálogo mais fluido, sincronia labial mais clara e condicionamento distinto para vários falantes. Essas são alegações de capacidade, não uma promessa de que todo roteiro será entregue exatamente como escrito (anúncio do Google de novembro de 2026).
A demonstração publicada pelo Google mostra a capacidade que ele anunciou. Ela é separada dos três casos de vídeo fornecidos abaixo.
O que mudou em relação ao Gemini Omni 1.1 Flash?
A comparação oficial dá ao 1.2 um teto maior: 15 segundos em vez de 10. Ela também nomeia melhorias em fala, sincronia labial, seguimento de referência e edição conversacional. Os 5 segundos extras tornam uma troca de 3 turnos mais plausível de roteirizar, mas uma duração maior não cria mais tempo de fala se um diretor também pedir pausas, reações físicas e mudanças de cena.
A leitura mais segura é direcional. Um melhor condicionamento pode tornar o diálogo mais fácil de dirigir, enquanto cada clipe entregue ainda precisa de inspeção. Um criador pode usar o limite de 15 segundos para definir uma meta de roteiro. Um produtor que promete texto legal exato ou uma correspondência precisa de voz deve tratar a saída gerada como rascunho até que ela passe pela revisão.
Diálogo em vídeo vs. conversão de texto em fala com vários falantes
Os modelos de conversão de texto em fala do Gemini aceitam texto e retornam áudio. Suas configurações de falante e escolhas de voz pertencem a esse fluxo de trabalho de áudio, que o Google documenta separadamente (documentação de conversão de texto em fala do Gemini do Google, acessada em novembro de 2026). A rota de texto para vídeo do Gemini Omni 1.2 Flash aceita um prompt de cena e produz vídeo com som nativo. Um exemplo de speech_config de conversão de texto em fala não é um controle de vídeo do Gemini Omni 1.2 Flash. Esses exemplos descrevem caráter vocal em texto; eles não alegam fazer upload, clonar ou selecionar uma voz gravada. Se um briefing exigir a voz de um ator específico, verifique esse acesso e consentimento separadamente antes de planejar o plano.
Se o seu entregável é uma conversa de podcast ou uma narração bloqueada, use conversão de texto em fala e edite a imagem em torno desse áudio. Se são duas pessoas visivelmente falando em uma cena gerada, use o vídeo do Gemini Omni 1.2 Flash e teste o alinhamento na saída real.
Onde você pode executá-lo e quanto custará um clipe?
Escolha a rota de texto para vídeo
O Google lista o Gemini Omni 1.2 Flash em seus produtos criativos e de desenvolvedor. Para um teste reproduzível, use uma rota: o Atlas Cloud oferece o modelo, e seu playground de texto para vídeo do Gemini Omni 1.2 Flash é onde colar os prompts abaixo. O ID da rota é google/gemini-omni-1.2-flash/text-to-video. Os prompts abaixo usam apenas texto, sem referências de imagem, movimento ou voz.
Os prompts solicitam 12 segundos em 16:9 para o escritório, 15 segundos em 16:9 para o café e 12 segundos em 16:9 para a entrevista na rua. Os três arquivos fornecidos são 720p. Confirme os controles ao vivo e os valores selecionados antes de clicar em Run. Uma configuração anunciada em uma página de produto não é prova de que uma execução de teste específica a aceitou. Salve os valores selecionados e a cotação junto com cada saída. Isso torna cada renderização uma evidência útil: você pode comparar o prompt com a resolução e a rota selecionadas ao revisar sua saída. Este guia especifica a rota de texto para vídeo, então um resultado de uma rota de imagem para vídeo ou referência para vídeo deve ser identificado separadamente.
Os arquivos de vídeo fornecidos não incluem uma captura completa do playground, configurações selecionadas ou uma cotação pré-envio. Portanto, sua rota e configuração permanecem não verificadas.
| Rota | Entrada para este guia | Melhor uso | Onde verificar o custo |
|---|---|---|---|
| Produtos criativos do Google | Um prompt de cena; os controles variam conforme o produto | Criação manual no editor do Google | A tela atual do plano ou de créditos |
| API do Google | Uma solicitação de vídeo de desenvolvedor | Integração de aplicativo | O preço do Google para a resolução exata |
| Texto para vídeo do Atlas Cloud | Prompt, duração, proporção e resolução | Repetir estes testes somente de texto em um playground | A cotação pré-envio da configuração selecionada |
Confira o preço antes de renderizar
O Google informa $0.07 por segundo gerado para 720p por meio de sua API, 30% abaixo do Gemini Omni 1.1 Flash. Nessa taxa informada, 12 segundos de 720p custam $0.84 antes de qualquer outro trabalho faturável. Esse cálculo não é uma cotação do Atlas Cloud para os arquivos fornecidos; sua rota e cobrança não são verificadas. Créditos no Flow ou em outro editor seguem as próprias regras desse produto.
O Atlas Cloud lista uma taxa inicial por segundo mais baixa em seu catálogo de modelos, mas o mínimo pode corresponder a outra resolução ou configuração. Leia a cotação ao vivo depois de escolher duração e resolução. Um rascunho em 360p pode ajudar a explorar um prompt; ele é uma geração separada, e não uma prévia quadro a quadro de uma renderização posterior em 1080p.
Encaixe duas vozes em uma cena de 15 segundos
Dê a cada falante uma identidade visual e vocal
Escreva descrições que um revisor consiga verificar. "O Falante A está à esquerda com uma camisa azul-marinho" é mais claro que "o primeiro colega de trabalho". Adicione uma distinção audível, como tom médio versus mais grave. Mantenha nomes, roupas, posição e vozes consistentes ao longo do prompt. Essas âncoras tornam uma fala trocada mais fácil de identificar.
A identidade visual importa porque só o áudio pode enganar um revisor. Se as vozes diferem, mas a boca errada se move, o clipe tem um problema de sincronia labial. Se a boca correta se move, mas a voz de A muda no segundo turno de A, há desvio de voz. O exemplo do café traz A de volta depois de B para que um revisor possa verificar se a voz de A permanece consistente.
Reserve tempo para fala e reação
Leia o roteiro em voz alta no ritmo pretendido. Inclua uma pausa natural em cada passagem de fala, depois deixe espaço para um ouvinte reagir e para o plano de abertura estabelecer os dois rostos. O roteiro revisado do escritório tem 5 turnos em 12 segundos. O do café tem 8 turnos curtos em 15 segundos, o que o torna o teste de timing mais exigente aqui. Estes são roteiros de exemplo, não um limite universal de palavras por segundo nem uma promessa sobre a saída.
| Orçamento da cena | Sequência falada | Tempo necessário além das palavras |
|---|---|---|
| Escritório de 12 segundos | A-B-A-B-A | Estabelecer as duas pessoas e encaixar 4 passagens |
| Café de 15 segundos | Oito turnos alternados | Sete passagens com pouco tempo de sobra |
| Rua de 12 segundos | A-B-A-B-A | Quatro passagens sobre ambiência de rua |
Uma fala longa convida a apressar ou omitir perto do fim. Se o rascunho levar quase todos os 15 segundos para ser lido em voz alta, encurte-o antes da geração. Se o cenário precisar de mais diálogo, planeje planos separados e verifique a continuidade como outra tarefa de produção. Mantenha os rostos visíveis durante as falas na primeira tentativa. Cortes rápidos e bocas ocluídas tornam a atribuição de falantes mais difícil de julgar. Faça uma leitura cronometrada do roteiro com duas pessoas se a ordem das falas importar. Peça que uma pessoa fale A e a outra B, enquanto uma terceira anota onde cada frase termina. Se a última palavra cair no limite do clipe, remova uma oração ou uma batida de reação antes de renderizar. Um roteiro mais curto é mais fácil de auditar porque o revisor pode reproduzir toda a troca sem adivinhar se uma fala deveria continuar fora da tela.
Como criar prompts no Gemini Omni 1.2 Flash para 2 falantes
Um prompt útil se lê como um briefing de filmagem compacto: cenário e câmera, identidades, diálogo exato, depois som e regras de exclusão. Essa ordem também dá ao revisor uma lista de verificação. É um método de prompting, não uma garantia documentada de controle. Mantenha os rótulos dos personagens idênticos do parágrafo de identidade até o bloco de diálogo. Evite se referir à mesma pessoa tanto como A quanto como “o cliente” em instruções sobre um turno posterior, a menos que o mapeamento já esteja explícito. Um leitor deve conseguir desenhar duas colunas, uma para cada pessoa, e colocar cada ação solicitada e cada fala em exatamente uma coluna.
Use rótulos de falante explícitos e falas entre aspas
Use uma linha por turno com Speaker A: ou Speaker B: e palavras entre aspas. Especifique quem permanece silencioso. Pedir "uma discussão sobre prontidão de lançamento" permite improvisação. Um roteiro exato permite marcar imediatamente uma palavra ausente ou reescrita.
Aqui está o primeiro prompt para copiar. Ele mantém os dois adultos em um plano contínuo para que o espectador possa inspecionar cada boca.
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
Renderização fornecida do escritório, de 12 segundos em 720p. As duas pessoas permanecem visíveis; as cinco falas e a sincronia labial ainda exigem uma revisão auditiva.
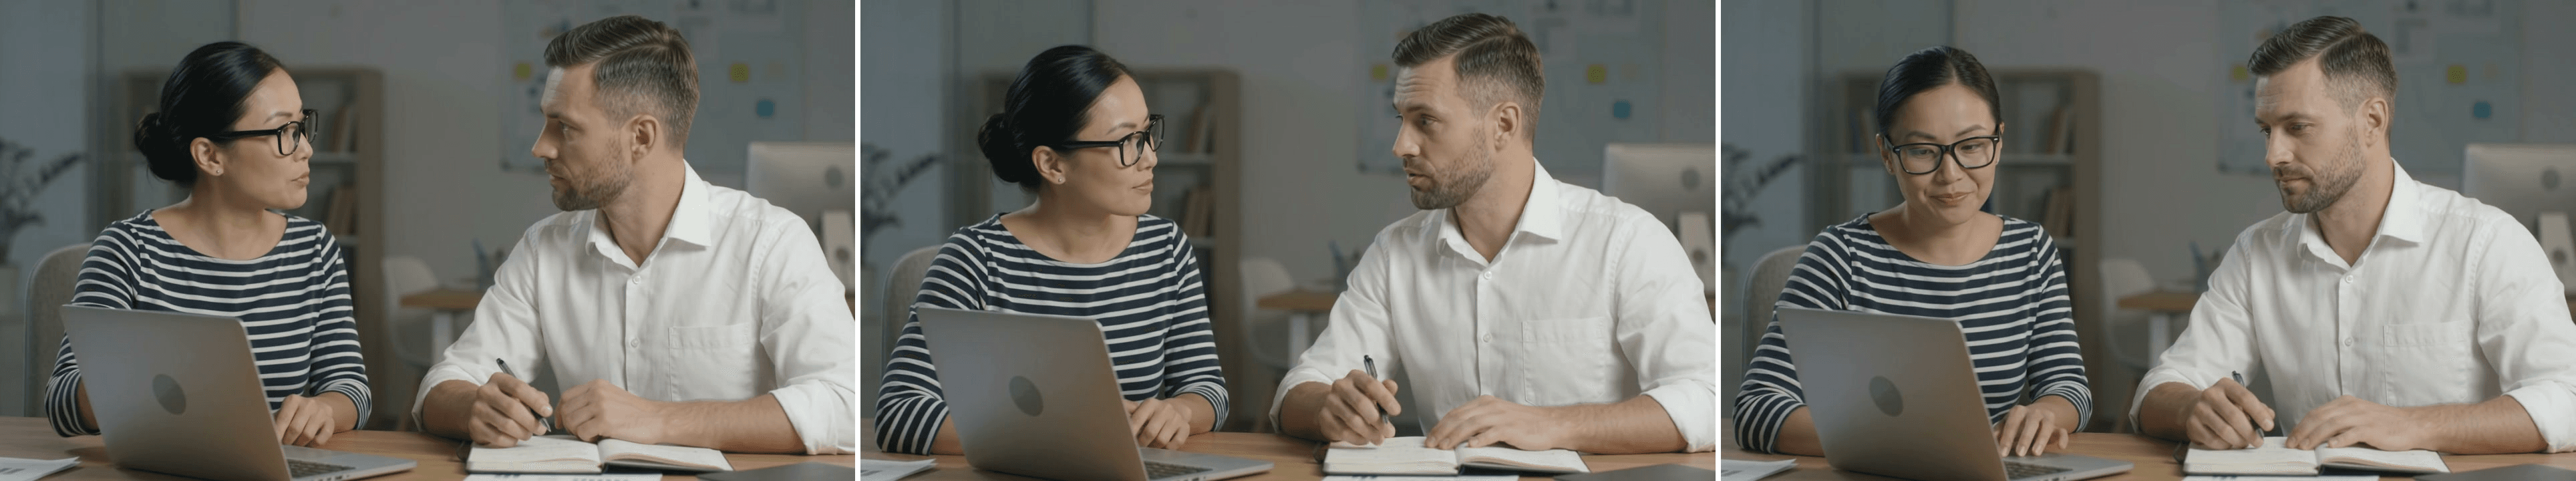 Quadros do Caso A, da esquerda para a direita (cerca de 0:02, 0:05, 0:10): a mulher encara o colega; ele parece responder enquanto ambos permanecem no quadro; eles voltam a atenção para o notebook e o caderno.
Controle a câmera sem perder o falante
Um plano médio contínuo com 2 pessoas é uma escolha diagnóstica. Os dois rostos permanecem em vista, então uma passagem perdida não pode se esconder atrás da edição. O modelo ainda pode variar o enquadramento, e é por isso que o arquivo final precisa de inspeção.
Quando a passagem funcionar para o seu objetivo, tente um movimento modesto que preserve os dois rostos. O prompt de rua solicita um movimento em um quadro 16:9 que mantém os dois rostos visíveis, tornando os movimentos da boca mais fáceis de julgar. Esse é um motivo para estabelecer primeiro a linha de base do escritório.
Mantenha o áudio de fundo abaixo do diálogo
Nomeie a ambiência e sua prioridade. Um tom de sala silencioso dá ao clipe do escritório pouca coisa para competir com a fala. Um som suave de café adiciona contexto enquanto mantém as falas testáveis. O prompt de rua pede passos e som distante abaixo das duas vozes, sem fala de transeuntes.
Instruções negativas podem reduzir áudio indesejado, mas continuam sendo pedidos. Escute para detectar uma terceira voz, narração, música e áudio de marca. Verifique também se a imagem tem legendas e logotipos.
3 cenas de diálogo que mostram quem fala quando
Os três arquivos de vídeo fornecidos mostram as cenas pretendidas de escritório, café e rua. Seu conteúdo visual pode ser inspecionado aqui, mas os arquivos não estabelecem qual rota ou configurações os produziram. Os prompts abaixo são solicitações reproduzíveis, não uma alegação de que a saída falou cada palavra corretamente. O escritório verifica 5 turnos, o café testa 8 turnos rápidos e a rua adiciona som ambiental.
| Caso | Solicitação do prompt | Arquivo fornecido | Verificação principal |
|---|---|---|---|
| A: passagem no escritório | 12s, 16:9, 5 turnos | 12s, 16:9, 720p | Cinco falas, bocas corretas |
| B: troca no café | 15s, 16:9, 8 turnos | 15s, 16:9, 720p | Oito falas, vozes estáveis |
| C: entrevista na rua | 12s, 16:9, 5 turnos | 12s, 16:9, 720p | Audibilidade na rua e turnos de falante |
Uma passagem de cinco turnos no escritório
Use o prompt completo e o vídeo acima. Os dois colegas permanecem no mesmo plano, então cada um dos cinco turnos solicitados tem uma pessoa visível para verificar. Registre cada fala audível em relação ao texto e inspecione a boca ativa. O arquivo fornecido estabelece a cena e a duração, mas suas palavras e sincronia labial não foram verificadas de forma independente.
Uma passagem clara em um clipe sustentaria uma conclusão apenas sobre esse clipe, não uma taxa de sucesso de todo o modelo. Guarde o primeiro resultado para que qualquer revisão possa ser comparada com o original.
Uma troca de oito turnos no café
Solicite 15 segundos em 16:9. Oito turnos curtos colocam a propriedade repetida das vozes e o timing sob pressão. Compare a primeira e a última fala de cada pessoa, depois verifique se alguma fala se sobrepõe ou desaparece. O arquivo fornecido é 720p.
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
Uma sessão de perguntas e respostas ao ar livre
Solicite 12 segundos em 16:9. Isso adiciona um leve movimento de câmera e som ambiental. O arquivo fornecido é 16:9 em 720p e pode ser revisado para cinco turnos de falante e audibilidade na rua.
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
Reprodução combinada: 0:00–0:15 é o Caso B, a troca no café; 0:15–0:27 é o Caso C, a entrevista na rua. Os dois clipes de origem estão incluídos na íntegra.
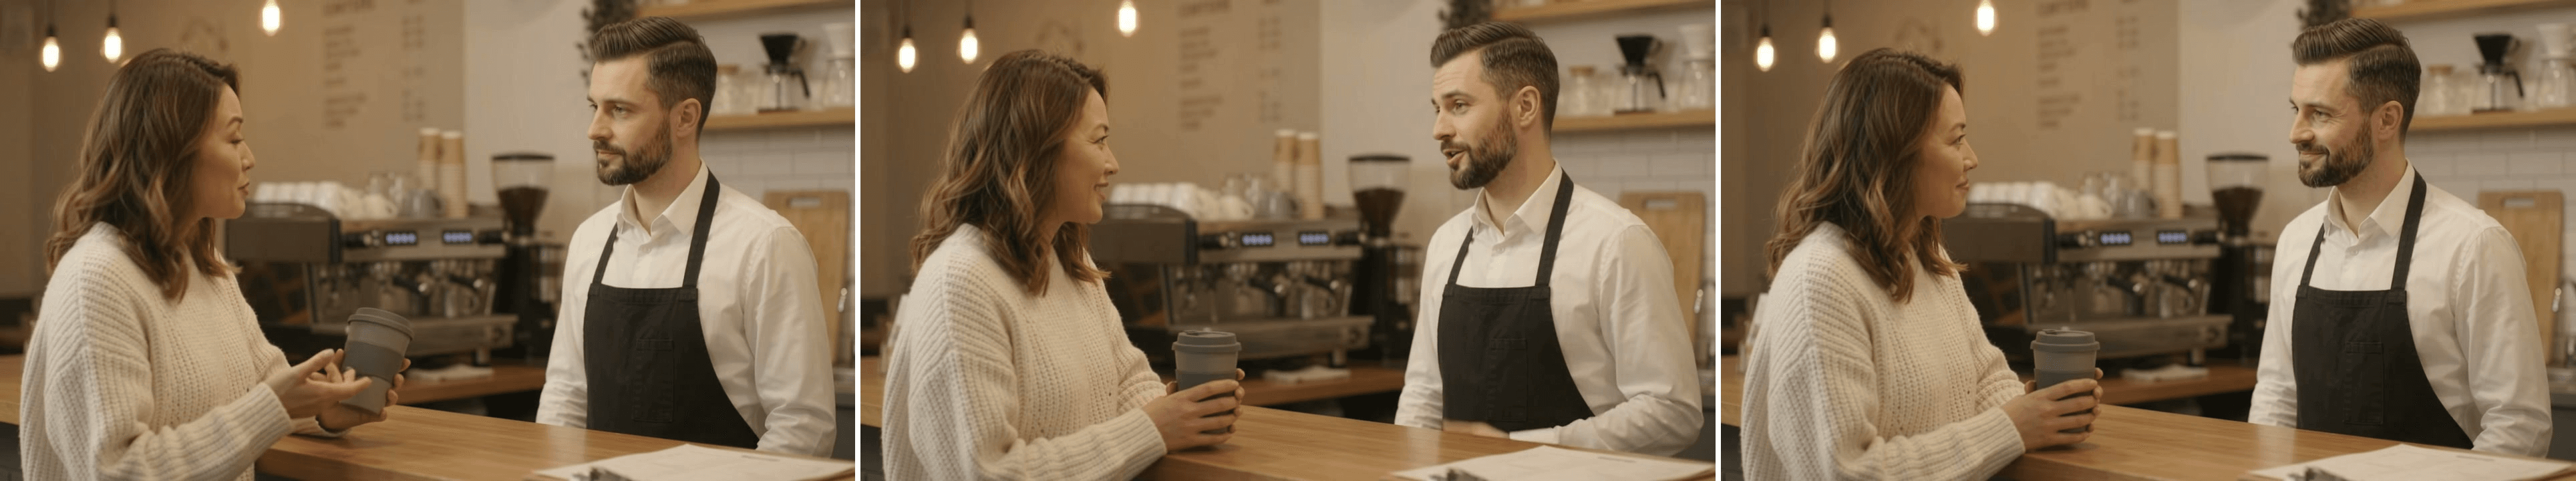 Quadros do Caso B, da esquerda para a direita (cerca de 0:02, 0:08, 0:13 do vídeo combinado): a cliente mostra o copo; a atendente do café parece responder; elas se encaram no encerramento.
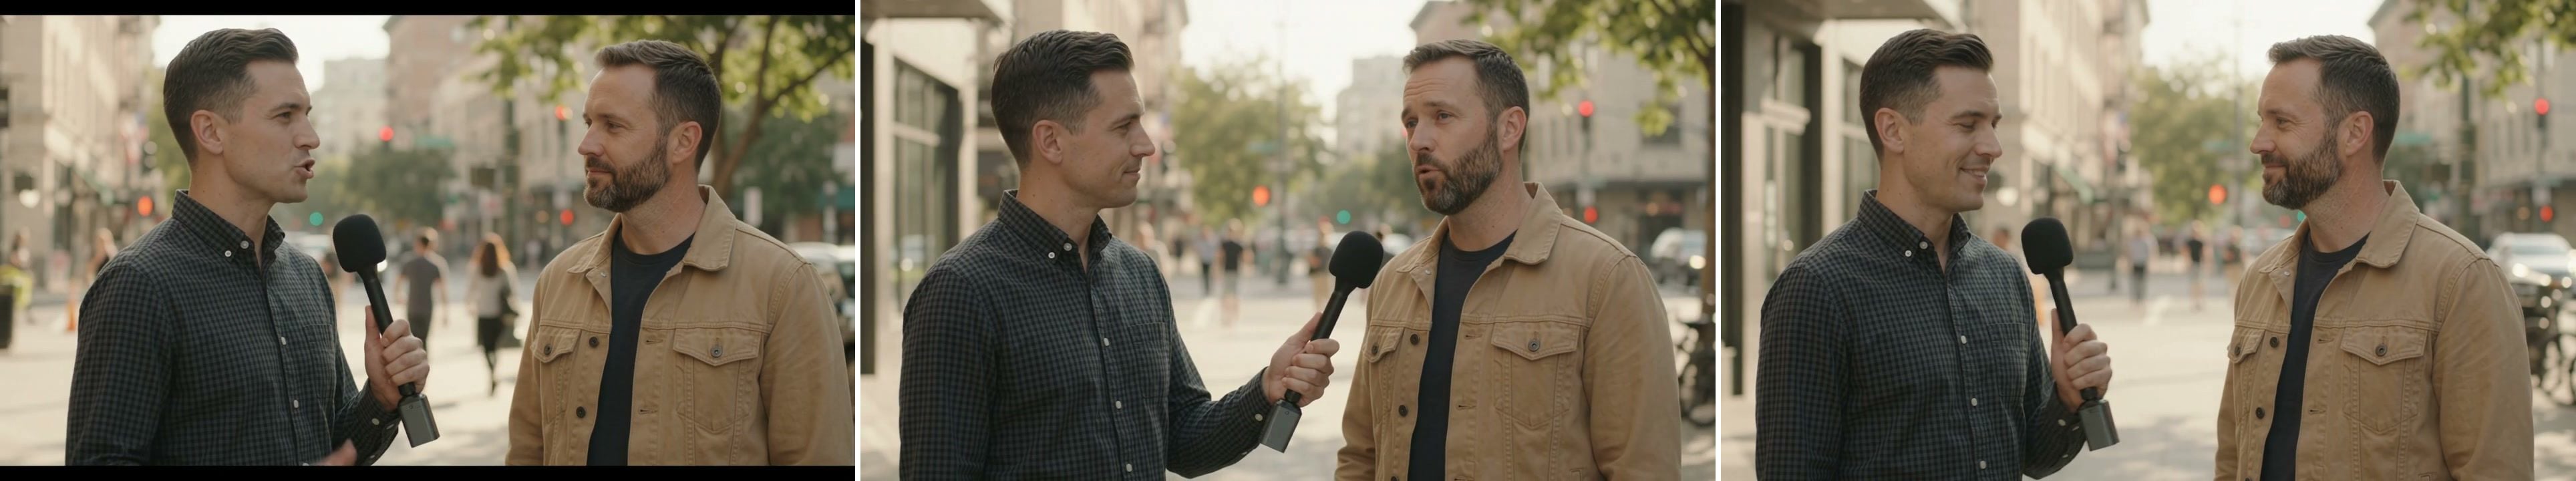
Quadros do Caso C, da esquerda para a direita (cerca de 0:16, 0:19, 0:26 do vídeo combinado): o entrevistador segura o microfone; ele o vira na direção da entrevistada; ambos se encaram no final.
Verifique a ordem dos falantes, a sincronia labial e o desvio de voz antes de publicar
Revise o clipe fala por fala
Baixe o vídeo. Reproduza uma vez sem ler o roteiro para encontrar confusões óbvias, depois reproduza com o prompt ao lado. Pause em cada turno e anote o que você ouve. Inspecione as duas bocas e observe falas fora dos turnos roteirizados. Para uma revisão repetível, registre o horário de início e fim de cada fala audível, o falante esperado, a voz que você ouviu e a boca visível que se moveu. Escreva “incerto” se um rosto estiver oculto ou o som mascarar uma palavra. Não transforme uma célula incerta em aprovação só porque o resto da cena parece convincente. Um segundo ouvinte que não viu o prompt pode identificar quem ele acha que está falando; compare esse julgamento com o roteiro antes de decidir se um espectador público entenderá a cena.
Verifique 4 coisas em cada fala:
- Palavras: As palavras citadas foram ditas em ordem, sem um final omitido ou uma frase adicionada?
- Dono da voz: A pessoa nomeada soou como o falante, especialmente quando A retornou?
- Sincronia visível: A boca dessa pessoa se moveu enquanto o ouvinte permaneceu silencioso?
- Outro conteúdo: O clipe adicionou um narrador, transeunte, legendas, logotipo ou música?
Uma linha do tempo de garantia de qualidade com carimbos de data/hora permanece pendente até que o áudio e os movimentos de boca tenham sido revisados fala por fala.
Revise uma restrição por vez
Se a última fala desaparecer, encurte o roteiro ou dê mais duração a ele dentro do limite de 15 segundos. Se o personagem errado falar, repita a posição visual e especifique que o ouvinte permanece silencioso. Se a ambiência cobrir uma palavra, abaixe-a ou remova-a. Se um corte ocultar a boca ativa, volte para um plano contínuo com 2 pessoas. Mude um fator por tentativa para que a próxima saída responda a uma pergunta clara.
Nenhuma dessas edições garante uma correção. Se uma renderização precisar de revisão, salve o arquivo, as configurações e o problema que você quer resolver. Um produtor pode então decidir se outra renderização vale o custo ou se vozes gravadas e edição manual dariam a precisão necessária. Para uma troca curta e visivelmente falada, comece com o prompt do escritório e aceite um clipe somente após a verificação fala por fala. Esse é o padrão para diálogo com vários falantes do Gemini Omni 1.2 Flash.
Perguntas frequentes
O Gemini Omni 1.2 Flash consegue manter as mesmas vozes em clipes separados?
Uma voz permanecer reconhecível dentro de um clipe gerado é um requisito mais restrito do que preservá-la entre gerações separadas. Estes exemplos somente de texto testam o primeiro caso. Não prometa identidade vocal entre clipes com base neles. Uma campanha que precisa de um falante recorrente deve executar um teste de continuidade separado.
O Gemini Omni 1.2 Flash consegue gerar diálogo em idiomas além do inglês?
O modelo pode produzir outros idiomas, mas estes prompts estão em inglês. Revise o idioma-alvo palavra por palavra com um ouvinte fluente, incluindo nomes, números e alegações localizadas. Um teste de idioma bem-sucedido de outro criador é evidência para esse teste, não uma garantia para o seu roteiro.
Como mantenho cada fala atribuída ao falante certo?
Dê a cada pessoa uma posição visual e uma voz, rotule cada fala citada e especifique quem permanece silencioso durante o turno da outra pessoa. Revise o vídeo gerado fala por fala. Se uma renderização não atender ao briefing, encurte a troca ou use um fluxo de trabalho de áudio controlado para entrega exata.
Quantos turnos de diálogo cabem em um clipe de 15 segundos do Gemini Omni 1.2 Flash?
O prompt do café solicita oito turnos breves em 15 segundos, enquanto os prompts do escritório e da rua solicitam cinco turnos em 12 segundos. Estes são exemplos de roteiro, não limites garantidos. Leia as falas em voz alta, permita pausas e encurte-as se o último turno chegar ao fim do clipe.
O Gemini Omni 1.2 Flash precisa de uma imagem de referência para diálogo com dois falantes?
Nenhuma imagem de referência é usada nestes três prompts de texto para vídeo. Eles descrevem a posição, a roupa e a voz de cada falante em texto. Se um projeto precisar de um rosto ou estilo visual específico, teste uma rota que aceite referências e revise sua saída separadamente.


