Suponha que você envie uma xícara branca, um bar de café e grãos de café, mas o vídeo mostre uma xícara diferente em uma sala genérica. Para usar bem várias imagens de referência do Gemini Omni 1.2 Flash, escolha Reference-to-Video, atribua a cada imagem uma função distinta e descreva essas funções na ordem de upload. Comece com uma tomada curta e depois inspecione o início, o meio, o fim e o movimento entre eles. Uma referência direciona a geração; não garante uma cópia pixel a pixel.
O protocolo de teste usa a mesma tomada da xícara duas vezes: primeiro apenas com a imagem da xícara, depois com a xícara, o café e os grãos. Um segundo exemplo usa fotos exteriores e interiores do Panteão para testar um ponto de vista em movimento. A comparação separa o que o prompt pede do que a saída realmente mostra, para você decidir se outra referência ajudou ou adicionou conflito.
Principais conclusões
- Escolha Reference-to-Video quando as imagens devem orientar o conteúdo sem ditar o quadro de abertura.
- Atribua a cada imagem enviada uma função e nomeie-a pela ordem de upload no prompt.
- Compare uma linha de base curta com 1 imagem com uma execução com 3 imagens antes de aumentar a complexidade.
- Verifique identidade, cenário, objetos de cena e movimento ao longo de todo o clipe, não apenas no primeiro quadro.
O que várias imagens de referência controlam no Gemini Omni 1.2 Flash
Um conjunto de referências com várias imagens pode descrever várias partes de uma tomada. Uma foto pode identificar um produto, outra pode fornecer um local, e uma terceira pode identificar um objeto de cena. Você também pode usar imagens para um personagem ou um estilo visual. Essas funções só são úteis quando o prompt diz quais características visíveis pertencem a qual imagem. “Use todas as imagens” deixa o modelo decidir se a segunda xícara em uma foto de café é um segundo produto ou poluição visual de fundo.
Para o teste da xícara, a imagem 1 define a xícara de cerâmica branca e a alça. A imagem 2 fornece o balcão de espresso e o ambiente interno acolhedor. A imagem 3 fornece grãos visíveis perto da xícara. Não pedimos ao modelo que transporte o fundo branco da foto dos grãos nem cada objeto no balcão do café. Essa exclusão importa: uma foto de referência muitas vezes contém mais informação visual do que a função que você quer que ela cumpra.
O conjunto de referências não consegue remover toda ambiguidade. Uma mão pode esconder a alça. O movimento da câmera pode revelar um lado da xícara que a foto de origem nunca mostra. Iluminação e ângulos de câmera podem entrar em conflito entre as três fotos de origem. Trate o prompt como uma hierarquia de prioridades, com a forma da xícara acima de uma correspondência exata com móveis do fundo. Em seu anúncio de novembro de 2026, o Google descreve uma adesão mais forte às referências no Gemini Omni 1.2 Flash, ao mesmo tempo que observa que ação rápida e física complexa continuam sendo áreas a melhorar.
Antes de enviar, escreva uma frase para cada fonte: “Esta imagem define X; ignore Y.” Se você não conseguir fazer isso sem dar a duas imagens a mesma função, simplifique o conjunto. Depois escolha o modo de entrada que corresponde ao seu objetivo.
Reference-to-Video ou First-and-Last Frame?
Reference-to-Video é o modo certo quando suas imagens devem influenciar uma nova tomada em movimento. Se você precisa de uma imagem de abertura exata, use um fluxo de trabalho de primeiro quadro ou Image-to-Video. Se você precisa de dois pontos de extremidade especificados, use um fluxo de trabalho de primeiro e último quadro quando disponível. A mesma foto enviada pode desempenhar um papel muito diferente dependendo do modo selecionado, e uma frase do prompt nem sempre pode sobrepor-se ao contrato de entrada do modo.
| Modo | O que a entrada controla | Abertura esperada | Melhor uso |
|---|---|---|---|
| Reference-to-Video | Sinais de assunto, cena, objeto de cena ou estilo | Uma visão gerada guiada pelas referências | Combinar uma xícara, café e grãos em uma tomada |
| Image-to-Video / primeiro quadro | O estado visual inicial | Estreitamente ligado à primeira imagem fornecida | Animar uma imagem estática específica |
| First-and-last frame | Os estados visuais inicial e final | Começa a partir da primeira imagem especificada | Planejar uma transição entre pontos de extremidade fixos |
A documentação de imagens de referência do Google Cloud, acessada em novembro de 2026, descreve imagens de referência como orientação adicional para a geração. A distinção é prática: se a primeira foto enviada aparecer quase inalterada como quadro 1 e você queria uma abertura recém-composta, inspecione o modo e o espaço da imagem antes de reescrever o prompt criativo.
Uma xícara branca em um fundo simples de origem pode razoavelmente se tornar uma xícara em um balcão de café no Reference-to-Video. Esse é o experimento aqui. Para o Panteão, as fotos do exterior e da cúpula guiarão duas cenas, mas não são primeiros e últimos quadros prescritos. A função delas é tornar elementos arquitetônicos reconhecíveis durante um movimento contínuo.
Monte um conjunto de referências que o modelo consiga ler
Escolha uma referência principal clara antes de reunir imagens de apoio. A xícara deve ser grande o suficiente para julgar sua borda, corpo e alça. Na foto de origem aprovada, a xícara é pequena e parece creme claro, apesar de o título do arquivo chamá-la de branca. Isso torna esta entrada um teste de estresse útil, mas qualquer perda de detalhe da alça pode começar na origem. Uma xícara minúscula em uma fotografia movimentada de café é uma referência de produto fraca porque o modelo tem pouca informação específica de forma para reter. A imagem de apoio do café tem outra função: deve tornar o ambiente legível, especialmente o balcão e o equipamento de espresso. A imagem dos grãos deve identificar um objeto de cena, não fornecer uma composição concorrente.
Mantenha a ordem de upload estável. O prompt abaixo diz “primeira”, “segunda” e “terceira”; essas palavras só ajudam se a ordem dos arquivos corresponder. Se você substituir uma fonte durante uma nova tentativa, verifique a interface novamente antes de executar. Quando várias fotos mostrarem xícaras semelhantes, remova ou exclua explicitamente a xícara extra. Caso contrário, o modelo pode misturar alças, proporções ou cores das duas. Para um produto com embalagem complexa, várias visualizações do mesmo objeto podem ser mais valiosas do que uma referência de estilo separada.
| Upload | Detalhe alvo | Não herdar |
|---|---|---|
| 1: xícara branca | Corpo, borda e alça da xícara | O fundo da foto de origem |
| 2: bar de café em Roma | Balcão, equipamento, atmosfera interna | Outras xícaras ou pessoas como referências de produto |
| 3: grãos de café | Grãos reconhecíveis ao lado da xícara | O fundo branco da foto dos grãos |
As três fotografias vêm do Wikimedia Commons: as fotografias da xícara de cerâmica branca e do bar de café em Roma estão marcadas como CC0, e a fotografia dos grãos de café está marcada como domínio público. O status de reutilização declarado torna a demonstração mais fácil de rastrear; ele não transforma a saída gerada em uma foto verificada de um produto real.
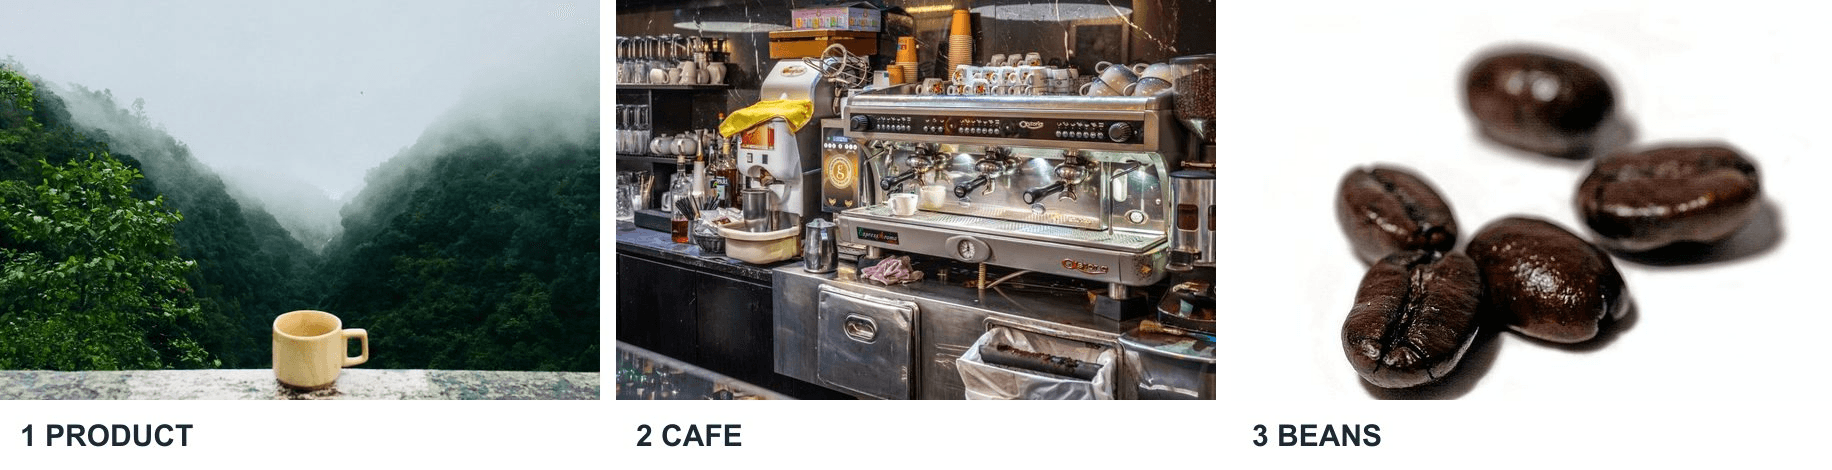
As três fotos de origem separam o produto, o cenário e o objeto de cena antes de qualquer vídeo ser gerado.
Fluxo de trabalho pronto para copiar: 1 xícara, 3 referências, 1 tomada em movimento
Baixe as fotos de origem em tamanho real e anote a página de cada arquivo do Commons. No playground Reference-to-Video do Gemini Omni 1.2 Flash, selecione o modelo Reference-to-Video, não uma variante Image-to-Video. Envie apenas a xícara para a execução A1. Defina 8 segundos, 16:9, 1080p e pensamento padrão. Verifique se o arquivo enviado aparece no campo de imagens de referência. Cole este prompt exatamente:
plaintext1Create an eight-second product video featuring the white ceramic cup in the first reference image. Preserve its recognizable cup shape and handle. Begin with the cup resting still on a counter. The camera itself physically travels in a smooth semicircular arc around the stationary cup, so the counter and café background shift with clear parallax while the cup keeps the same orientation relative to the counter. Do not spin or rotate the cup, and do not place it on a turntable. After the camera arc, raise the camera to a slightly elevated viewpoint as a hand briefly lifts the cup and sets it back down without twisting it. Natural café ambience, no dialogue, no logos or added text. Use the uploaded image as a product reference, not as a literal opening frame.
Execute A1 e assista a toda a saída. O primeiro upload é a linha de base, então anote a forma da xícara e se a órbita e a visão elevada acontecem. Não penalize A1 por omitir um café específico ou grãos: nenhum dos dois foi fornecido como referência. Salve esse resultado separadamente antes de mudar o formulário.
Para a execução A2, use o mesmo modelo e configurações. Envie a xícara, o bar de café e os grãos nessa ordem. Confirme que as três miniaturas aparecem no campo de referência, depois cole:
plaintext1Create an eight-second product video. The first reference image defines the white ceramic cup: preserve its recognizable shape and handle. The second reference image defines the espresso bar counter and its warm indoor atmosphere, but do not copy any other cup from that image. The third reference image defines the coffee beans placed beside the cup, not the background. Begin with the cup and beans on the counter. Move the camera in a smooth semicircle around the cup, then change to a slightly elevated viewpoint as a hand lifts the cup and sets it down. Keep the same cup and counter through the whole shot. Natural café ambience, no dialogue, no logos or added text. Use all three images as references rather than literal opening frames.
Execute A2 e aguarde a saída concluída. Revise o arquivo gerado, não apenas a miniatura de pré-visualização. Os dois clipes finalizados abaixo mostram quais detalhes sobreviveram ao movimento de câmera e à ação da mão.
O que muda com a segunda e a terceira imagem?
Compare os clipes no mesmo tamanho de exibição. Reproduza cada um do início ao fim e depois pause perto da abertura, do ponto médio e do fim. Para a identidade da xícara, inspecione o perfil da borda, o lado da alça e as proporções do corpo, especialmente depois que a mão a levanta. Para o ambiente, procure um balcão e indícios de bar de espresso em vez de uma sala marrom genérica. Para os grãos, verifique se são objetos de cena distintos ao lado da xícara, e não uma textura indistinta.
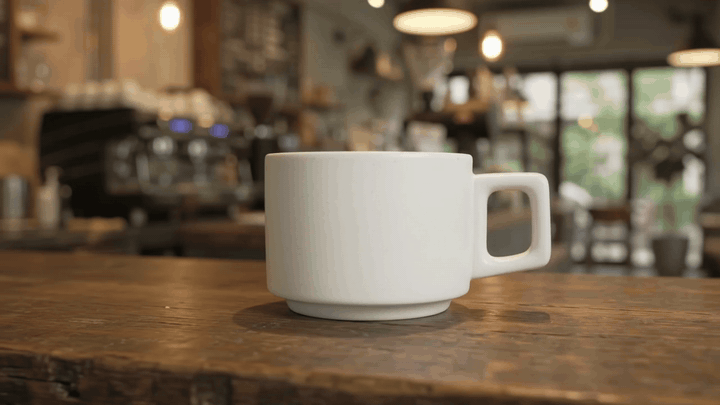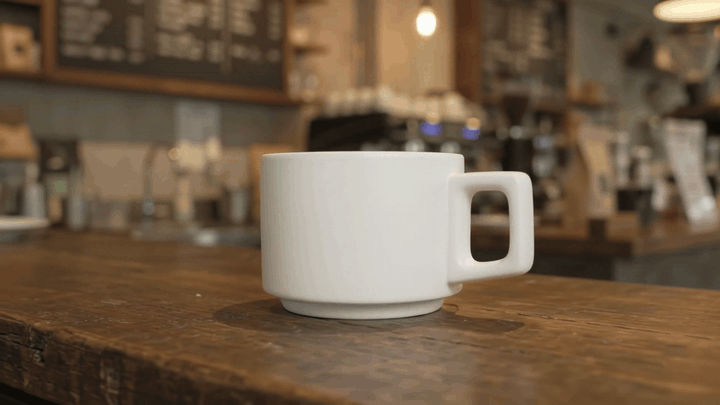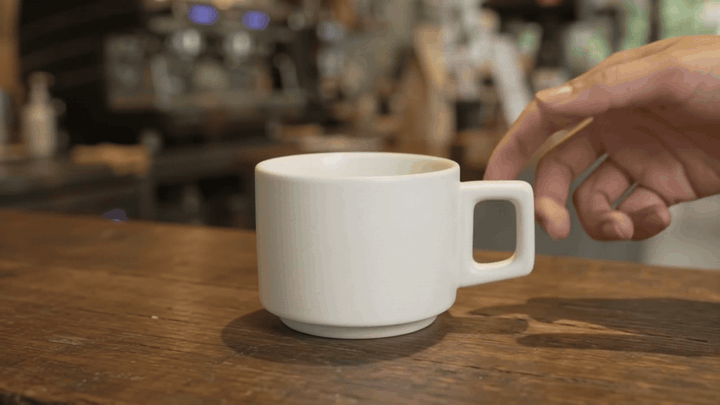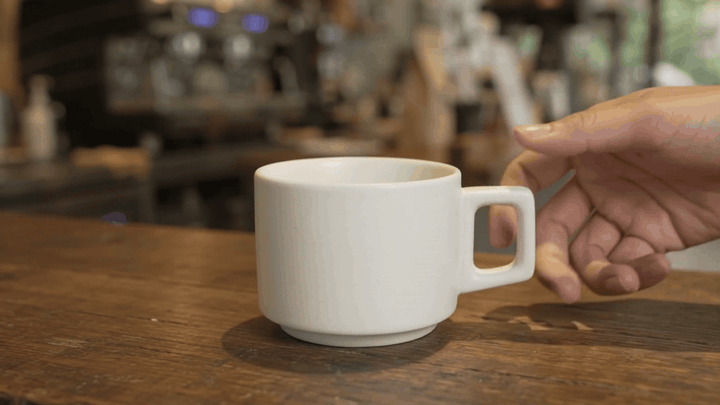
A1 mantém uma xícara branca e alça visível durante o levantamento pela mão. A mudança de câmera é modesta, e não uma órbita semicircular clara.
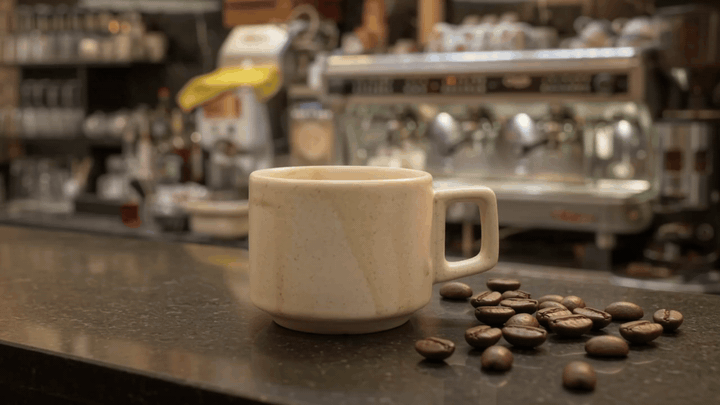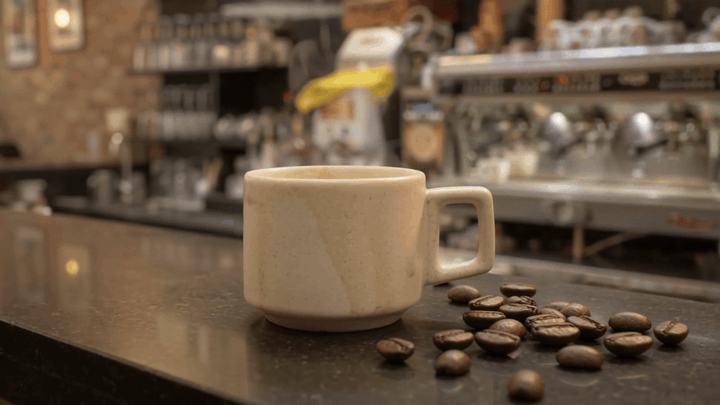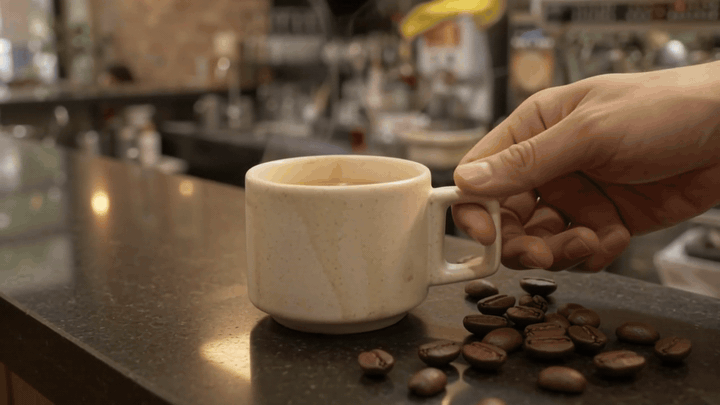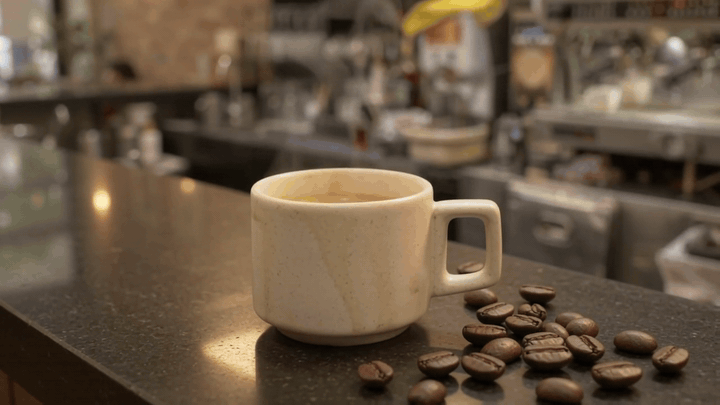
A2 adiciona grãos de café visíveis e um cenário de bar de espresso mais específico. A xícara parece cor de creme e menos regular em forma do que a xícara de A1.
| Verificação | A1: 1 imagem | A2: 3 imagens | O que procurar |
|---|---|---|---|
| Forma e alça da xícara | Corpo branco e alça permanecem visíveis | Alça permanece visível; corpo parece creme e menos regular | Mesmo objeto identificável depois que a câmera se move |
| Balcão de café | Cenário de café genérico | Máquina de espresso e balcão estão claros | Ambiente se assemelha à fonte do balcão |
| Grãos de café | Não mostrados | Visíveis ao lado da xícara | Grãos distintos ao lado da xícara |
| Movimento | Mão levanta a xícara; mudança de câmera é modesta | Mão levanta a xícara; ponto de vista muda modestamente | Órbita, visão elevada, levantamento e recolocação |
As referências adicionadas tornam o balcão e os grãos mais fáceis de identificar, mas a cor e a forma da xícara mudam. Nenhum dos clipes completa claramente o movimento semicircular de câmera solicitado. Estas são saídas únicas, então são exemplos diagnósticos, e não uma estatística de desempenho. Se a identidade da xícara for o mais importante, o próximo teste deve fortalecer a referência da xícara ou simplificar a ação da mão, mantendo as outras configurações fixas.
Um teste de arquitetura com duas imagens
O teste da xícara pergunta se vários tipos de detalhes coexistem em uma tomada de produto. Duas fotos do Panteão fazem uma pergunta diferente: referências do exterior e do interior conseguem guiar um ponto de vista em movimento coerente? A primeira imagem do Commons mostra a fachada externa; a segunda mostra a cúpula interna e o óculo. As páginas de arquivo do Wikimedia Commons tanto para a fotografia do exterior quanto para a da cúpula as marcam como CC0.
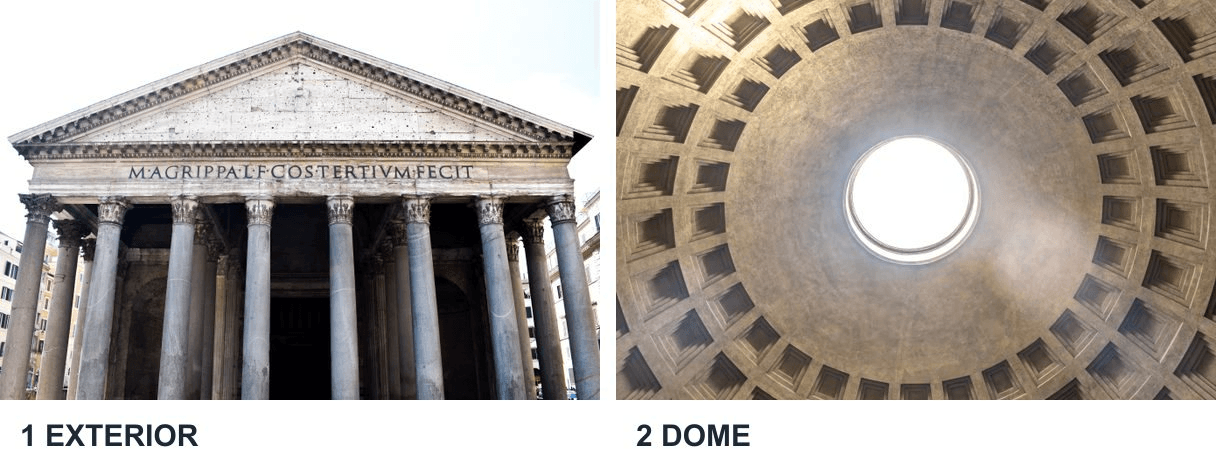 As fotografias do exterior e da cúpula fornecem sinais de cena separados para uma passagem gerada para dentro do edifício.
Envie o exterior primeiro, o interior em segundo, no mesmo modelo Reference-to-Video. Defina 12 segundos, 16:9, 1080p e pensamento padrão. Use o prompt abaixo:
plaintext1Create a twelve-second architectural concept video guided by the two reference photographs of the Pantheon in Rome. The first image defines the exterior facade and entrance; the second defines the interior dome and oculus. Begin from a human-height viewpoint outside, move steadily toward and through the entrance, then tilt upward inside to reveal the dome and oculus. Use a continuous moving viewpoint with clear parallax and no sudden teleporting or isolated zoom. Keep the building recognizable while treating the result as a generated visualization, not documentary footage. Natural footsteps and room ambience, no dialogue, no titles or labels. Both images are scene references, not mandatory first and last frames.
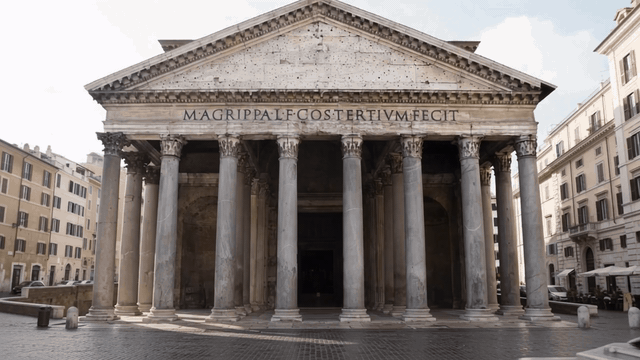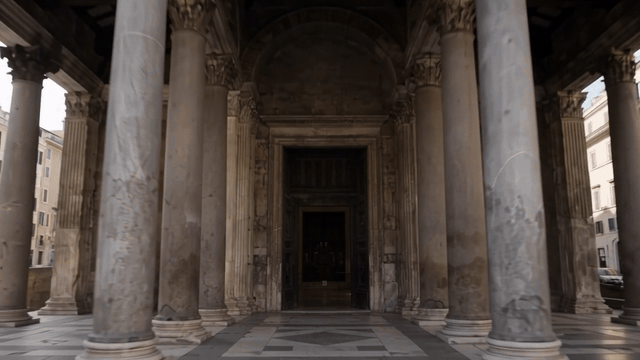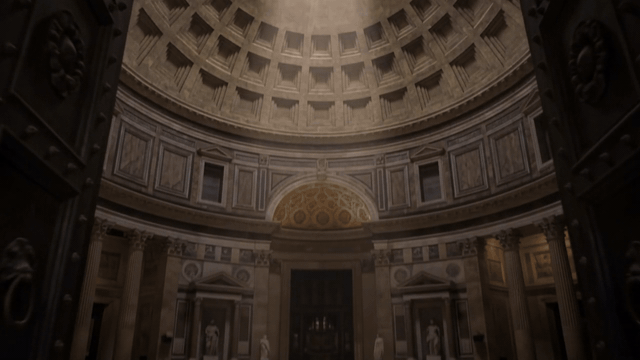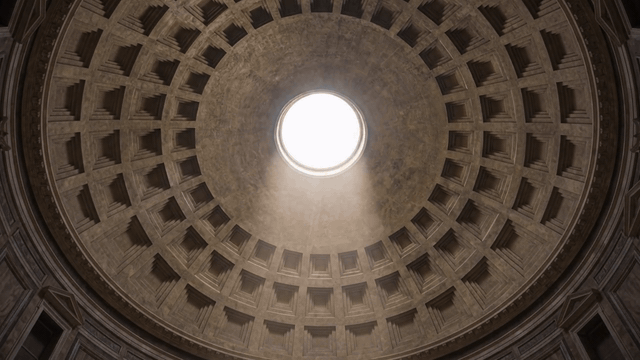
A passagem gerada se move da fachada através do pórtico e entra em uma vista da cúpula e do óculo.
Julgue o clipe por características visíveis e qualidade da transição, não por precisão geográfica. A fachada, o pórtico e a cúpula são reconhecíveis, e o ponto de vista avança em direção à entrada antes de olhar para cima no interior. O resultado é uma visualização por IA baseada em fotografias, não filmagem documental nem levantamento arquitetônico confiável. Uma configuração de primeiro e último quadro responderia a outra pergunta: como conectar duas imagens prescritas como pontos de extremidade.
Três funções de referência em uma tomada de 15 segundos
A comparação da xícara testa um produto, um local e um objeto de cena. Esta tomada adicional dá às três referências funções mais exigentes: um animal em movimento, um ambiente colorido e um grupo em movimento que entra mais tarde. A questão é se todos os três permanecem legíveis enquanto a câmera acompanha a ação, em vez de aparecerem apenas em quadros isolados.
A imagem 1 é uma fotografia de tartaruga-verde do Wikimedia Commons para o casco largo, a cabeça e as nadadeiras da tartaruga. A imagem 2 é uma fotografia de recife de coral do Wikimedia Commons para formas de coral rosa e creme e água límpida. A imagem 3 é uma fotografia de cardume de peixes de cauda amarela do Wikimedia Commons para os corpos dos peixes e o movimento do grupo. Cada página de arquivo marca sua fotografia como domínio público. As fontes vêm de lugares diferentes, então a cena gerada é um conceito visual, não um registro de um recife real.
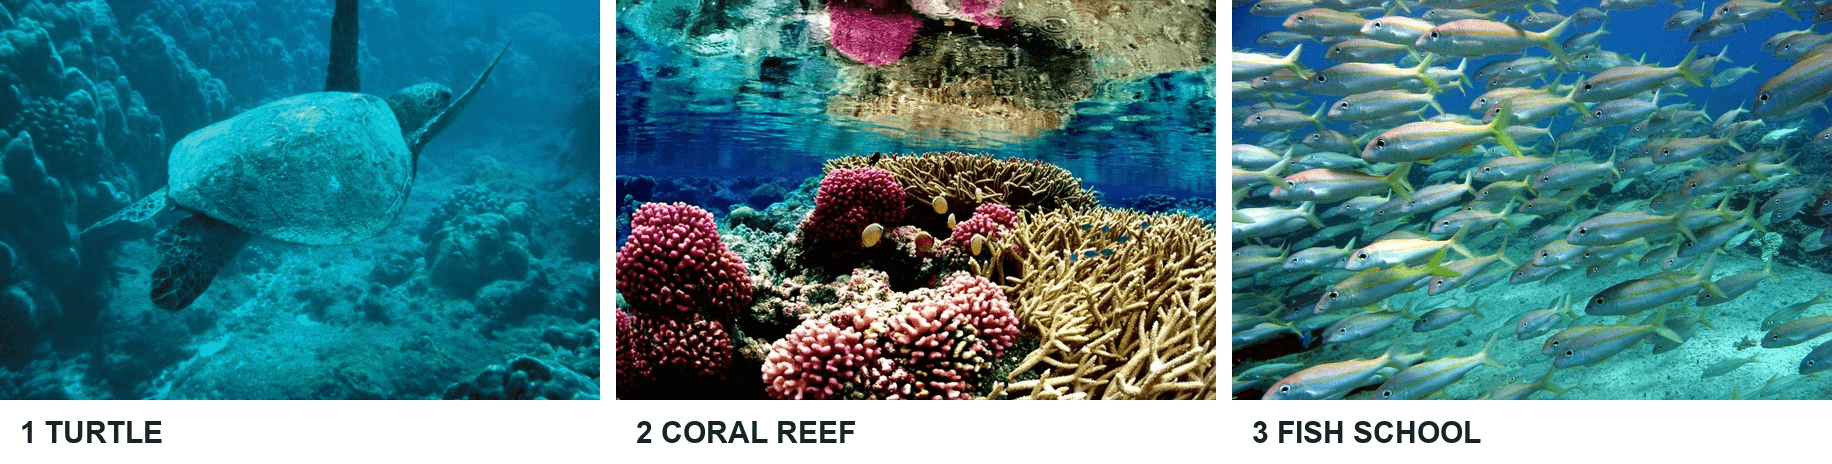 Os três uploads dão ao modelo um sujeito, um cenário e um grupo que deve entrar na tomada mais tarde.
Envie-as nessa ordem no Reference-to-Video. Selecione 15 segundos, 16:9, 1080p e pensamento padrão. Use este prompt:
plaintext1Create a 15-second, single continuous underwater concept film using the three uploaded photographs as references in their exact upload order. The first image defines one green sea turtle: preserve its broad mottled oval shell, head, and four flippers, but ignore that photo's background. The second image defines the setting: vivid pink and cream branching corals, rounded coral heads, clear turquoise water, and rippling sunlight; it is not a mandatory first frame. The third image defines a dense school of slender silver fish with yellow tails; use the fish as moving animals, not as a background texture or a copy of their original seabed. In the opening five seconds, the turtle swims forward above the colorful reef with visible flipper strokes while the camera tracks alongside it. In the middle five seconds, the yellow-tailed fish school sweeps across the frame and curves around the turtle as the camera rises to a three-quarter overhead view. In the final five seconds, the camera widens and arcs to show the same turtle, reef, and fish school together in one coherent underwater space. Keep the turtle's shell pattern and the fish appearance consistent throughout. Show real subject movement, water particles, soft sunbeams, and clear parallax. Smooth camera movement, no cuts, no teleporting, no spinning turtle, no additional turtles, no text, logos, or narration. This is a generated visualization, not documentary footage.
O clipe gerado de 15 segundos começa com a tartaruga sobre coral e depois traz o cardume de cauda amarela para a mesma cena em movimento.
O casco manchado e as nadadeiras da tartaruga permanecem reconhecíveis do início ao fim. O coral rosa é mais nítido perto da abertura; peixes prateados com caudas amarelas entram por volta do meio e dividem o quadro com a tartaruga mais tarde. A câmera acompanha e se amplia, embora o ponto de vista aéreo solicitado não seja claramente estabelecido. Esta saída única mostra as três funções de referência trabalhando juntas e também mostra onde a instrução de câmera do prompt foi apenas parcialmente seguida.
Corrija o desvio de referência sem reiniciar toda a ideia
Quando uma xícara muda de forma, identifique o quadro exato em que isso acontece. Se a alça desaparece apenas enquanto uma mão a cobre, isso pode ser oclusão. Se ela retorna no lado errado ou a borda muda de perfil depois que a xícara é colocada no lugar, a identidade do produto sofreu desvio. Deixe a xícara maior e mais clara na referência, simplifique o levantamento ou especifique um ponto de vista que mantenha a alça visível. Guarde a saída anterior para saber se a mudança ajudou.
Se o cenário salta entre cafés, inspecione o conjunto de origem em busca de salas, iluminação ou objetos semelhantes conflitantes. Substitua a imagem de cena fraca ou remova uma referência que forneça móveis indesejados. No prompt, declare qual imagem é dona do balcão e quais elementos visuais ignorar. Uma lista mais longa de instruções negativas pode criar mais ambiguidade; uma declaração precisa de função costuma ser mais fácil de testar.
Se os últimos segundos perderem detalhe, encurte a ação em vez de adicionar mais substantivos. Peça uma órbita contínua e um pequeno levantamento antes de tentar uma sequência mais longa com várias transições. A nota de lançamento do Google diz que o modelo suporta edição de acompanhamento, mas não presuma que uma edição reterá cada detalhe não tocado. Inspecione uma edição com as mesmas verificações de início, meio e fim.
Altere uma variável por nova tentativa: seleção de referência, redação do prompt, duração ou tarefa de câmera. Mantenha um registro dos arquivos e configurações exatos. Isso transforma uma saída decepcionante em um diagnóstico acionável e evita que um quadro de sorte seja confundido com controle consistente.
Limites, custo e onde experimentar
O Google anunciou o Gemini Omni 1.2 Flash em 5 de novembro de 2026, com clipes nativos de até 15 segundos. A página do modelo Reference-to-Video do Atlas Cloud atualmente lista 1–10 imagens de referência, opções de duração de 3–15 segundos, proporções de 16:9 ou 9:16 e opções de saída em 360p, 720p, 1080p e 4K. As opções de 1080p e 4K são ampliadas a partir de quadros gerados nativamente. Os limites de entrada podem diferir conforme a rota de acesso, então verifique o campo na interface que você usa. Este guia precisa apenas de 1, 2 ou 3 imagens.
Para os exemplos exatos, use a página do modelo vinculada no fluxo de trabalho e verifique a cotação atual antes de cada execução. O catálogo público de modelos do Atlas Cloud oferece um segundo lugar para verificar disponibilidade e preços atuais. Uma tarifa principal por segundo pode não descrever todas as resoluções ou condições de conta, então faça o orçamento a partir dos controles realmente selecionados em vez de copiar um preço de lançamento para um plano de produção.
O próximo passo prático para várias imagens de referência do Gemini Omni 1.2 Flash é executar primeiro a linha de base da xícara. Salve seu prompt exato e sua saída. Adicione o café e os grãos somente depois de identificar qual detalhe falta à linha de base, depois avalie o clipe completo em movimento segundo as quatro verificações acima.
Perguntas frequentes
Posso combinar referências de imagem com um clipe de referência de movimento?
O Google descreve suporte a referências de movimento curtas, mas essa é uma combinação de entradas diferente dos testes com fotos estáticas aqui. Verifique os limites e regras de duração do ponto de entrada específico antes de combiná-los. Mantenha as funções das imagens explícitas mesmo quando o movimento for fornecido separadamente.
O modelo copiará minhas fotos de referência exatamente?
Não. As referências orientam identidade, cenário, objetos de cena ou estilo. Um quadro gerado pode mudar ângulo de câmera, iluminação, superfícies ocultas ou pequenos detalhes. Se você precisa de um quadro inicial exato, escolha um fluxo de trabalho de primeiro quadro e ainda assim inspecione o restante do clipe.
Posso usar fotos de outras pessoas ou ativos de marca?
Use material que você tem permissão para usar e revise sua licença para a publicação pretendida. As páginas de arquivo do Wikimedia Commons das fotos de origem declaram seus termos de reutilização. Verifique cada licença aplicável antes da publicação. Esse status da fonte não concede direitos sobre logotipos, pessoas ou ativos não relacionados que você possa adicionar depois.


