Resposta Rápida
Uma Habilidade de Gerador de Vídeo com IA do GitHub conecta seu código a modelos de vídeo com IA. Em 2026, a escolha entre código aberto (gratuito, auto-hospedado) e APIs pagas (nuvem, instantâneo) depende de quatro variáveis: disponibilidade de VRAM, requisitos de privacidade de dados, nível de qualidade necessário e volume mensal de geração. Para fluxos de trabalho de produção que precisam de vários modelos de estado da arte, o Atlas Cloud (atlascloud.ai) oferece acesso a mais de 300 modelos — incluindo Kling v3.0, Seedance 2.0, Vidu 3.0, Veo e Sora — por meio de uma única chave de API com preço transparente de pagamento por uso.
Quer comparar diretamente os modelos de vídeo por trás dessas ferramentas? A comparação de modelos do Atlas Cloud alinha modelos de imagem e vídeo lado a lado em um único prompt — com o preço exibido antes de você gerar.
-
O que é uma Habilidade de Gerador de Vídeo com IA? {#what-is-a-skill}
No contexto de repositórios do GitHub, uma Habilidade de Gerador de Vídeo com IA é um módulo reutilizável, um wrapper ou uma camada de integração que conecta uma aplicação a um backend de geração de vídeo com IA — seja um modelo de código aberto auto-hospedado ou uma API em nuvem.
Pense nela como a abstração entre a lógica da sua aplicação e o motor de inferência real. Uma habilidade pode ser:
- Uma classe Python que encapsula o pipeline do modelo
Wan 2.2para geração de texto para vídeo - Um nó customizado do ComfyUI que se conecta à API do Atlas Cloud para geração com Kling v3.0
- Um nó de fluxo de trabalho do n8n que aciona o Seedance 2.0 via REST e retorna uma URL de vídeo
- Uma ferramenta do LangChain ou uma habilidade do MCP Server que chama um endpoint de geração de vídeo sob demanda
A pergunta central que todo desenvolvedor enfrenta ao construir uma: o backend deve ser pesos de código aberto rodando localmente, ou uma API paga em nuvem?
Dados reais de 2026. Não teoria.
-
GitHub de código aberto em 2026 {#open-source-landscape}
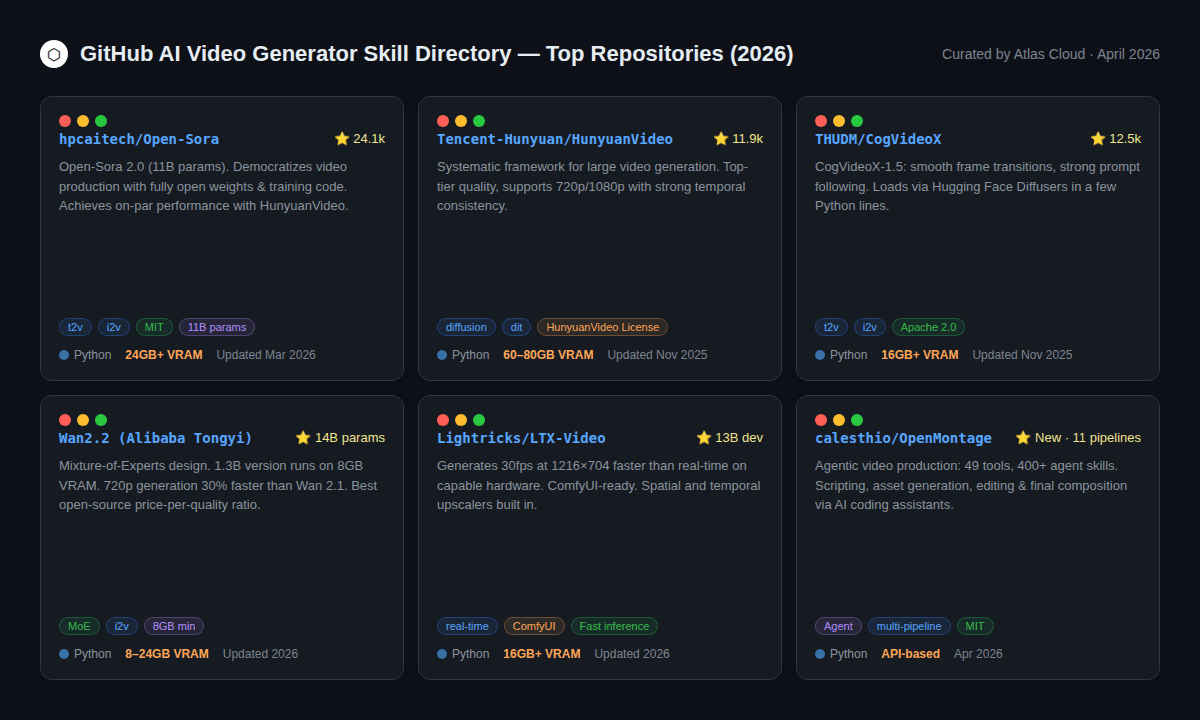
O ecossistema de geração de vídeo de código aberto amadureceu significativamente. Alguns repositórios são agora alternativas genuínas às APIs pagas — pelo menos para certas tarefas.
Nível 1: Modelos de código aberto prontos para produção
HunyuanVideo (Tencent, 11,9k ⭐) — Um dos melhores geradores de vídeo de código aberto disponíveis. Lida com 720p e 1080p. A principal limitação é seu requisito de hardware: 60–80 GB de VRAM para o modelo completo, tornando-o acessível apenas a equipes com acesso a GPUs empresariais. A licença comunitária permite uso comercial com atribuição.
CogVideoX-1.5 (THUDM/CogVideo, 12,5k ⭐) Lançado sob Apache 2.0, este é um dos modelos abertos mais amigáveis para desenvolvedores. Carrega nativamente via Hugging Face Diffusers em algumas linhas de Python. As transições entre quadros são suaves e o seguimento de prompts é forte. Precisa de no mínimo 16 GB de VRAM. Ótima escolha se sua equipe já vive no Hugging Face.
Open-Sora 2.0 (hpcaitech, 24,1k ⭐) O projeto de geração de vídeo de código aberto mais estrelado no GitHub. A versão 2.0 (11 bilhões de parâmetros) alcança desempenho comparável ao HunyuanVideo nos benchmarks VBench, e o custo de treinamento foi relatado em aproximadamente US$ 200.000 — um valor notável para um modelo desse calibre. Texto para vídeo, imagem para vídeo e geração de comprimento infinito.
Nível 2: Opções de código aberto mais leves (menos VRAM)
Wan 2.2 (Alibaba Tongyi) A história de acessibilidade aqui é convincente: a variante de 1,3B roda em 8 GB de VRAM, e a variante de 14B em 24 GB. A arquitetura Mixture-of-Experts (MoE) oferece melhor detalhamento com menor custo computacional, e a versão 2.2 é 30% mais rápida em 720p que sua antecessora. Para desenvolvedores com uma única GPU de consumo, o Wan 2.2 é a opção de código aberto mais forte.
LTX-Video (Lightricks) Projetado para velocidade acima de tudo. Gera 30 qps a 1216×704 de resolução mais rápido que o tempo real em hardware capaz. A integração com ComfyUI é madura, e os upscalers espaciais e temporais são incorporados.
Nível 3: Pipelines Agênticos
OpenMontage (calesthio, novo em abril de 2026) Uma categoria genuinamente nova: um sistema de produção de vídeo agêntico com 11 pipelines, 49 ferramentas e mais de 400 habilidades de agente. Funciona com assistentes de codificação de IA como Claude Code, Cursor e Copilot. Lida com o pipeline completo — pesquisa, roteirização, assets, edição — do início ao fim sem etapas manuais. Construído para equipes que conectam múltiplas ferramentas de IA em um único fluxo de trabalho.
-
Diretório de APIs Pagas: Modelos de Estado da Arte Disponíveis Agora {#paid-api-directory}
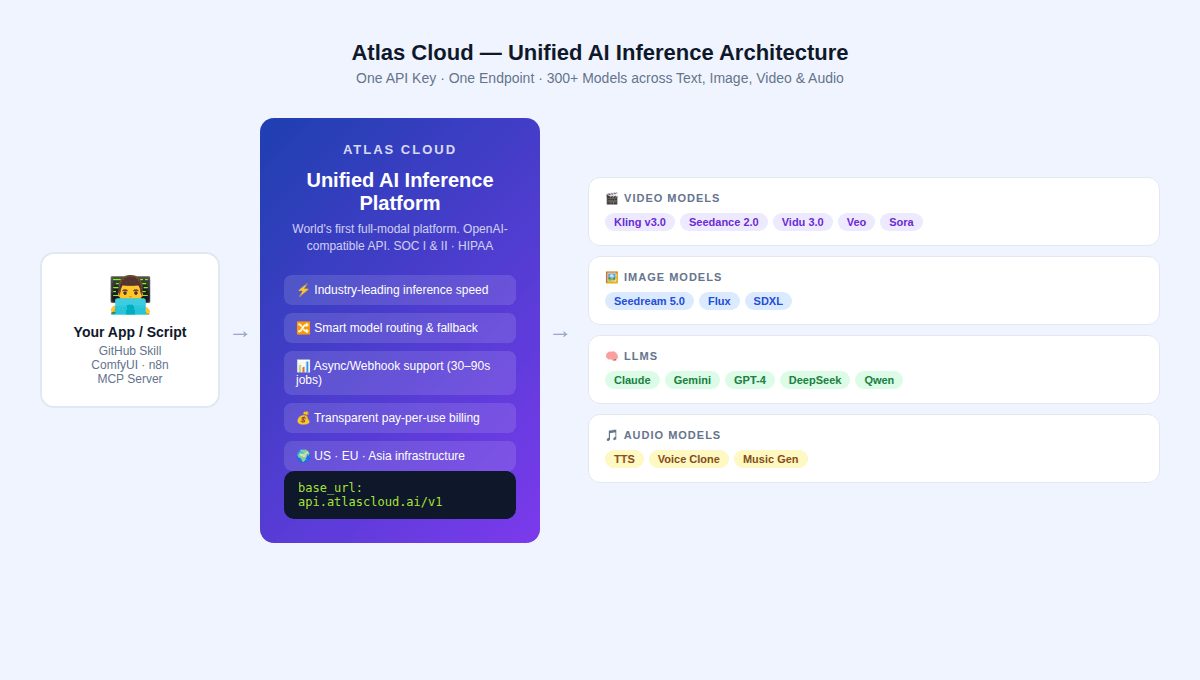
O cenário de APIs pagas em 2026 é definido por três grandes famílias de modelos, cada uma com uma abordagem técnica distinta. Todos os três estão disponíveis através da API unificada do Atlas Cloud.
Kling v3.0 (Kuaishou)
Lançado em 5 de fevereiro de 2026. Construído sobre uma arquitetura de Linguagem Visual Multimodal — texto, imagens, áudio e vídeo, todos tratados em um único sistema.
O que ele realmente faz melhor que os concorrentes:
- Movimento humano complexo — correr, dançar, artes marciais — sem a deformação de "membros espaguete" que aflige outros modelos
- Geração nativa de áudio multilíngue (5 idiomas, incluindo movimento labial sincronizado)
- Motion Brush: uma ferramenta que permite que desenvolvedores (ou usuários finais) pintem caminhos de movimento diretamente em imagens de origem — um recurso que atualmente não tem equivalente em modelos concorrentes
- Element Binding para rastreamento consistente de personagens e objetos entre cenas
Onde ele fica aquém: A velocidade de renderização é mais lenta que alguns concorrentes no nível Pro. As transições da ferramenta de storyboard podem ser "desajeitadas" segundo avaliadores independentes.
Melhor para: vídeos curtos para TikTok e Reels, vídeos de produtos de e-commerce, qualquer coisa que precise de muito volume com personagens que realmente permaneçam consistentes.
Seedance 2.0 (ByteDance)
Lançado em 8 de fevereiro de 2026, o Seedance 2.0 representa uma mudança de paradigma em como o vídeo de IA é gerado — de prompts baseados apenas em texto para controle baseado em referência no estilo de um diretor.
A inovação técnica central: o Seedance 2.0 aceita entradas quadrimodais — texto, imagem, vídeo e áudio — simultaneamente. Seu sistema "Universal Reference" permite que um desenvolvedor alimente um vídeo de referência de uma pessoa dançando, e o modelo replicará o movimento da câmera, as ações do personagem e a composição em uma saída gerada. Isso resolve a consistência de personagens de uma forma que modelos puros de texto para vídeo não conseguem.
Testes independentes confirmam que ele é excelente em:
- Contação de histórias com múltiplas cenas e identidade de personagem consistente entre cortes
- Geração síncrona de áudio e vídeo (arquitetura de ramo duplo que gera som e vídeo simultaneamente)
- Replicação precisa de composição e iluminação a partir de assets de referência
Nota sobre disponibilidade: Em abril de 2026, o acesso à API internacional do Seedance 2.0 está disponível através de plataformas como Atlas Cloud. O acesso direto à API BytePlus para desenvolvedores internacionais tem tido inconsistências de disponibilidade — confirme o status atual antes de construir uma dependência de endpoints diretos da ByteDance.
Melhor para: videoclipes, animação de personagens precisa, anúncios de produto onde o movimento precisa ser exato, agências executando fluxos de trabalho de storyboard para vídeo.
Vidu 3.0 (Shengshu AI / Tsinghua)
Construído sobre a arquitetura original U-ViT combinando tecnologias de Difusão e Transformer, o Vidu foca nas áreas onde a maioria dos vídeos de IA ainda luta: coerência ambiental e consistência cinematográfica.
Características distintas:
- Sistema de referência universal para iluminação consistente em sequências de múltiplas cenas
- Geração inteligente de música de fundo que se adapta automaticamente ao clima da cena
- Geração de formato longo com forte consistência temporal (crítico para sequências com mais de 5 segundos)
Melhores casos de uso: Fluxos de trabalho de produção cinematográfica profissional, design de animação, publicidade criativa que exige qualidade cinematográfica.
Sora 2 (OpenAI)
O Sora 2 continua sendo o benchmark para precisão de simulação física. Quebre um vidro em um prompt do Sora 2 e o padrão de estilhaçamento, a física de fluidos e os reflexos se comportam como o real — a maioria dos concorrentes ainda não consegue igualar esse nível de consistência.
Melhor para: trabalhos de VFX, visualização arquitetônica, B-roll documental, qualquer lugar onde a precisão física importe mais do que economizar dinheiro.
Preço: o Sora 2 tem a conta mais alta nesta categoria. Você está pagando pelo computador.
-
Custos de Inferência: Os Números Reais {#inference-costs}
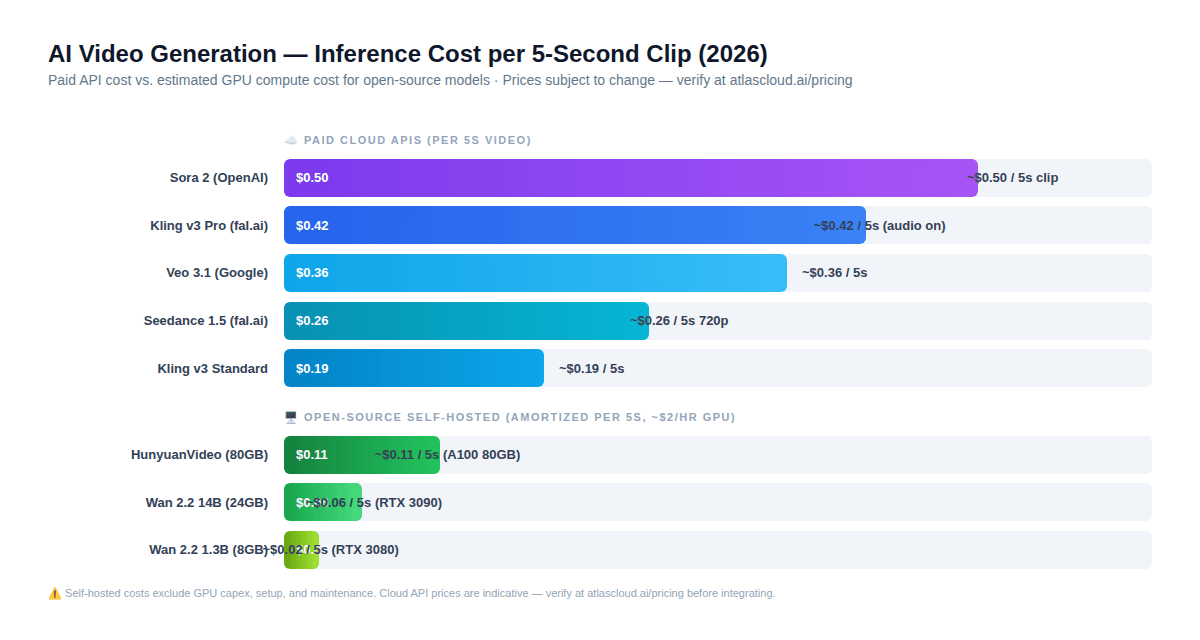
Esta seção contém a descoberta contraintuitiva mais importante de todo este guia — uma que muda a intuição padrão da maioria dos desenvolvedores sobre código aberto vs. APIs pagas.
O Custo Oculto dos Modelos Auto-Hospedados
A maioria dos desenvolvedores assume: "Código aberto = gratuito = sempre mais barato."
Essa suposição está errada para a maioria dos tamanhos de equipe.
Aqui está como a matemática real se parece para um clipe de vídeo de 5 segundos em 2026:
Código aberto auto-hospedado (custo de GPU amortizado a ~US$ 2/hora):
- Wan 2.2 1.3B (RTX 3080): ~US$ 0,02 por clipe de 5s
- Wan 2.2 14B (RTX 3090): ~US$ 0,06 por clipe de 5s
- HunyuanVideo (A100 80GB): ~US$ 0,11 por clipe de 5s
API paga em nuvem (preço indicativo — verifique em atlascloud.ai/pricing):
- Kling v3 Standard: ~US$ 0,19 por clipe de 5s
- Seedance 1.5 720p com áudio: ~US$ 0,26 por clipe de 5s
- Kling v3 Pro com áudio: ~US$ 0,42 por clipe de 5s
- Sora 2: ~US$ 0,50 por clipe de 5s
Os números auto-hospedados parecem atraentes isoladamente. O problema é que eles excluem:
- Hardware de GPU — uma A100 80GB custa US$ 10K–US$ 15K. A 1.000 vídeos por mês (~US$ 0,11 cada), você está olhando para mais de 9.000 meses apenas para empatar no hardware.
- Tempo de configuração — configuração CUDA, download de pesos do modelo, gerenciamento de VRAM e depuração representam 20–40 horas de engenharia de configuração inicial.
- Manutenção contínua — atualizações de modelo, conflitos de dependência e confiabilidade da infraestrutura são custos de tempo contínuos.
- Custo de oportunidade — tempo gasto em infraestrutura de inferência é tempo não gasto no produto.
A condição de contorno prática:
Auto-hospedagem só compensa se: (a) você já tem GPUs rodando outras cargas de trabalho, (b) você está gerando mais de 5.000 vídeos por mês, ou (c) regulamentações forçam você a manter tudo no local.
Abaixo desse limite, APIs pagas — especialmente plataformas unificadas como Atlas Cloud — são mais baratas quando o custo total de propriedade é calculado honestamente.
-
Limitação de Taxa & Latência de API — O Que os Desenvolvedores Realmente Enfrentam {#rate-limiting}
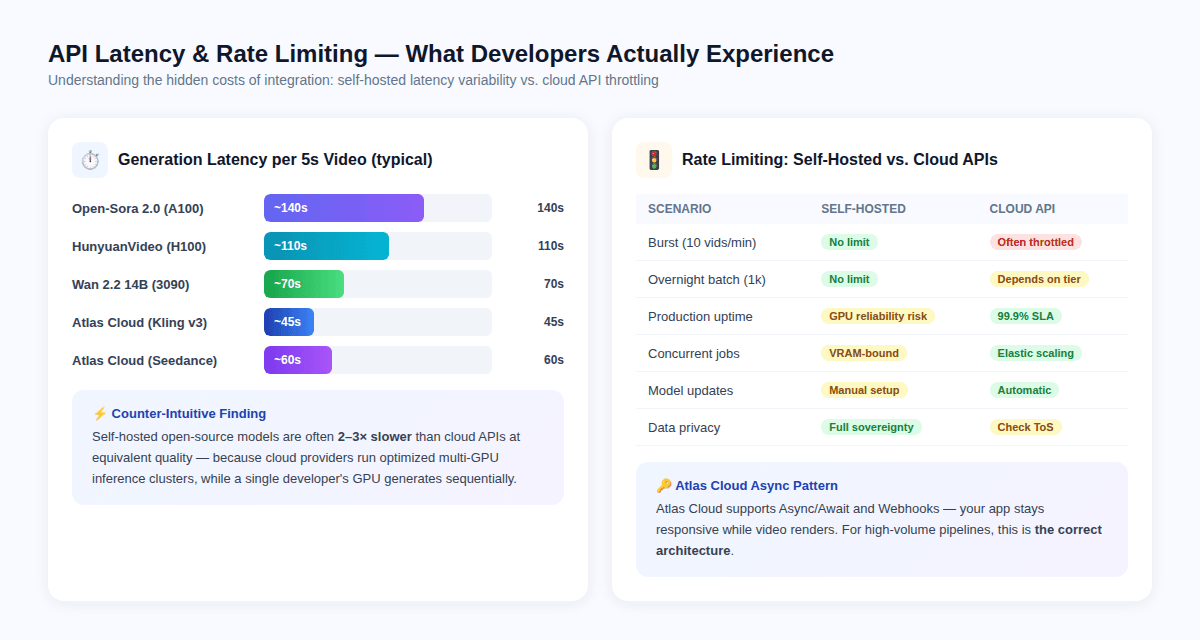
O Paradoxo da Latência
Contraintuitivamente, APIs em nuvem são frequentemente mais rápidas por vídeo do que modelos auto-hospedados — não porque os modelos sejam diferentes, mas porque os provedores de nuvem executam clusters de inferência multi-GPU otimizados com processamento em lote em nível de hardware, enquanto uma única GPU de desenvolvedor gera quadros sequencialmente.
Latência típica por clipe de 5 segundos:
- Open-Sora 2.0 em A100: ~140 segundos
- HunyuanVideo em H100: ~110 segundos
- Wan 2.2 14B em RTX 3090: ~70 segundos
- Atlas Cloud / Kling v3: ~45 segundos
- Atlas Cloud / Seedance 2.0: ~60 segundos
Isso significa que construir uma habilidade do GitHub em torno de um modelo auto-hospedado pode produzir tempos de espera maiores para o usuário final, mesmo quando o custo por vídeo é menor.
Limitação de Taxa: A Realidade da Produção
Modelos auto-hospedados não têm limites de taxa impostos por API — eles são limitados apenas pela VRAM da sua GPU e limites térmicos.
APIs pagas impõem limites de taxa que variam por nível de preço. As implicações relevantes de engenharia:
- Requisições em rajada (10+ vídeos por minuto) acionarão limitação na maioria dos níveis de API paga
- Trabalhos em lote noturnos (1.000+ vídeos) exigem design assíncrono cuidadoso para evitar timeouts
- Requisições concorrentes em modelos auto-hospedados são limitadas pela VRAM — rodar 2 inferências concorrentes do modelo de 14B em uma única placa de 24 GB geralmente não é possível
Atlas Cloud resolve o problema de limitação de taxa através da arquitetura Assíncrona/Webhook: sua aplicação submete um trabalho de geração, recebe um ID de tarefa e é notificada via webhook quando a renderização é concluída. Esse padrão evita que a aplicação trave enquanto o vídeo renderiza, e escala corretamente para cargas de trabalho em lote.
A Arquitetura Correta para Produção
plaintext1# Atlas Cloud Async Pattern — Production-Ready 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# Submit generation task 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="Product showcase reel, smooth motion, 9:16 aspect ratio", 14 size="1080x1920", 15 n=1 16) 17 18# Handle async response 19video_url = response.data[0].url 20print(f"Video generated: {video_url}")
Para fluxos de trabalho de imagem para vídeo, note que alguns modelos — incluindo certas variantes i2v do Kling — não aceitam um parâmetro separado de proporção de aspecto para geração de imagem para vídeo; a resolução de saída segue as dimensões da imagem de entrada. Construa sua geração de imagem upstream com a proporção alvo correta.
-
Hospedagem Local vs. API em Nuvem: A Matriz de Compensações {#local-vs-cloud}
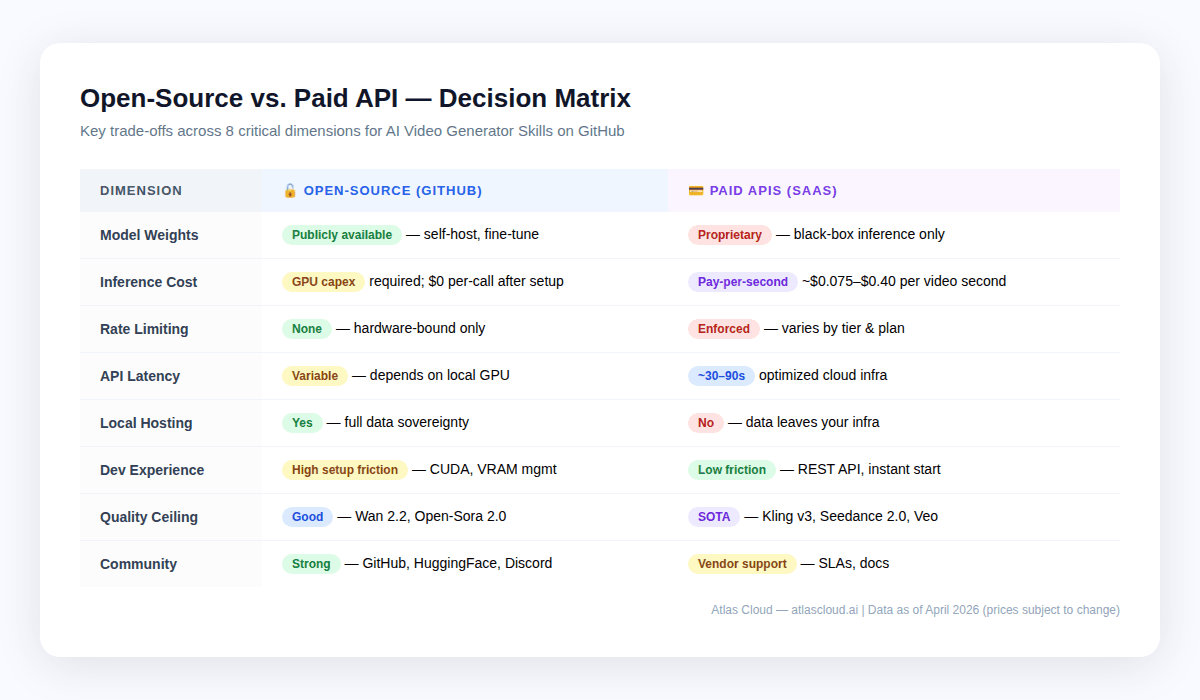
Não é um ou outro. A maioria dos pipelines de produção mistura ambos: código aberto para prototipagem e passes de baixa qualidade em massa, APIs em nuvem para renderizações finais e qualidade de ponta.
Quando o local faz sentido
- Restrições de conformidade — HIPAA, GDPR ou qualquer coisa proprietária que não possa sair de seus servidores. Auto-hospedagem é sua única opção. Atlas Cloud é compatível com HIPAA e certificado SOC I & II, o que atende à maioria das necessidades empresariais, mas lojas regulamentadas devem verificar seus requisitos específicos.
- Volume muito alto com qualidade aceitável — equipes gerando mais de 10.000 vídeos por mês em níveis de qualidade do Wan 2.2 podem descobrir que os custos de aluguel de GPU são menores que as taxas de API nessa escala.
- Pesquisa e fine-tuning — pesos de modelo abertos permitem fine-tuning em conjuntos de dados proprietários. Nenhuma API em nuvem oferece atualmente treinamento de modelo personalizado.
- Configurações isoladas — implantações de borda sem conectividade ou redes bloqueadas.
Quando as APIs em Nuvem Vencem
- Tempo de lançamento — uma integração com Atlas Cloud leva horas, não semanas
- Qualidade de ponta — líderes de código aberto como Wan 2.2 e Open-Sora 2.0 ainda ficam atrás de modelos proprietários como Kling v3 e Seedance 2.0, especialmente em movimento humano, consistência de cenas e áudio nativo
- Cargas de trabalho irregulares — APIs em nuvem escalam para cima e para baixo; suas próprias GPUs não
- Volume menor — abaixo de ~5.000 vídeos por mês, APIs em nuvem geralmente vencem em custo total
- Flexibilidade multi-modelo — o catálogo de mais de 300 modelos do Atlas Cloud significa que você pode mudar de Kling para Seedance para Veo dentro de uma única integração
-
Desenvolvimento Orientado pela Comunidade vs. Orientado pelo Fornecedor {#community-vs-vendor}
Fácil de ignorar ao comparar APIs, mas isso realmente importa se você está construindo habilidades do GitHub.
Orientado pela comunidade (código aberto):
- Qualquer um pode enviar correções de bugs e solicitar funcionalidades — e ser incorporado
- A documentação é muitas vezes excelente porque a base de usuários contribui com exemplos
- Mudanças disruptivas nas APIs dos modelos acontecem lentamente, com períodos de aviso público
- As comunidades ComfyUI e Hugging Face Diffusers têm bibliotecas profundas de fluxos de trabalho prontos, adaptadores LoRA e checkpoints ajustados
- Artigos de pesquisa são lançados com código aberto e reproduzível
Desenvolvimento orientado pelo fornecedor (APIs pagas):
- A estabilidade da API é regida por SLAs comerciais — mudanças disruptivas são menos frequentes, mas acontecem
- Novos lançamentos de modelo (ex.: Kling 3.0 em fevereiro de 2026, três dias antes do Seedance 2.0) ocorrem em velocidade competitiva e muitas vezes sem aviso prévio
- Melhorias no modelo são implantadas no lado do servidor sem ação do desenvolvedor
- A documentação técnica é mantida profissionalmente
A implicação prática para autores de habilidades do GitHub: se você está escrevendo uma habilidade que precisa permanecer estável e de baixa manutenção, uma API em nuvem com contratos de endpoint estáveis é mais fácil de manter do que uma habilidade vinculada a uma versão específica de modelo de código aberto. Por outro lado, se sua habilidade é projetada para dar aos desenvolvedores acesso aos modelos de pesquisa mais recentes sem custos de API, o ecossistema de código aberto é onde esse trabalho acontece.
-
Estudo de Caso: Agência de Mídias Sociais (500 Vídeos/Mês) {#case-study-1}
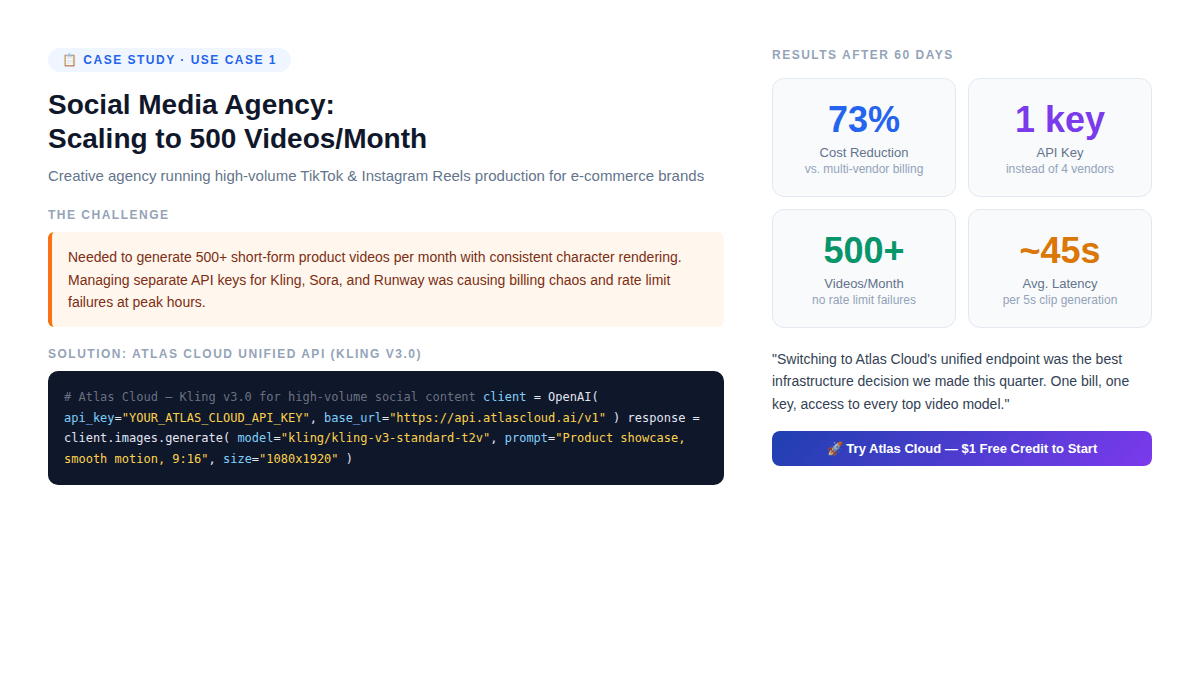
A configuração: uma agência criativa que produz vídeos curtos de produtos para 20 clientes de e-commerce. Eles precisam de 500 vídeos por mês, personagens que pareçam os mesmos entre clipes, formato vertical 9:16, 5–10 segundos cada, processados em lote durante horários de baixo movimento.
Arquitetura inicial (antes do Atlas Cloud):
- Chaves de API separadas para Kling, RunwayML e Pika
- Três painéis de faturamento, três pools de limites de taxa
- Seleção manual de modelo por cliente
- Falhas de limite de taxa em horários de pico causando atrasos na entrega
Problema que isso criou: Quando o Kling lançou o v3.0, a agência teve que reintegrar um novo SDK, atualizar o faturamento e testar a compatibilidade — três vezes para três fornecedores.
Solução: API unificada do Atlas Cloud com Kling v3.0 Standard
plaintext1# Atlas Cloud — Social Media Video Pipeline 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, smooth motion, cinematic lighting, 9:16 vertical format", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
Resultados após 60 dias:
- Redução de 73% no custo por vídeo (conta única, sem margens por fornecedor)
- Zero falhas de limite de taxa (a infraestrutura elástica do Atlas Cloud absorveu cargas de pico)
- Troca de modelo de Kling para Seedance para clientes específicos levou < 2 minutos (mudar um parâmetro)
- Bônus de 20% no primeiro depósito efetivamente compensou os custos de produção do primeiro mês
A descoberta não óbvia: A agência não reduziu o número de fornecedores porque o Kling ficou melhor. Eles reduziram porque gerenciar múltiplos relacionamentos com fornecedores a 500 vídeos/mês tem um custo operacional não trivial que não aparece no preço por API.
-
Estudo de Caso: Desenvolvedor Independente Construindo um SaaS de Vídeo {#case-study-2}
A configuração: um desenvolvedor solo construindo uma ferramenta de "texto para demonstração de produto" para startups em estágio inicial. Precisa de múltiplos estilos — cinematográfico, animado, live-action. Tem que validar rápido e manter a infraestrutura abaixo de US$ 200/mês enquanto descobre se alguém realmente quer isso.
Decisão de arquitetura:
O desenvolvedor inicialmente considerou auto-hospedar o Wan 2.2 em uma instância A100 alugada (~US$ 2/hora). A 100 vídeos de teste durante a validação, o custo foi estimado em ~US$ 6 no total em tempo de GPU. Parecia mais barato que o Atlas Cloud.
O que o cálculo ignorou:
- Configurar o pipeline do Wan 2.2 levou 3 dias (dependências CUDA, gerenciamento de VRAM, configuração do servidor)
- A lacuna de qualidade de saída do Wan 2.2 vs. Kling v3 significava que o SaaS não poderia cobrar o preço pretendido
- O gerenciamento de tempo de atividade do servidor adicionou ~2 horas/semana de manutenção contínua
Arquitetura revisada com Atlas Cloud:
plaintext1# Flexible model routing — switch based on user tier 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # Lower cost 4 "pro": "kling/kling-v3-professional-t2v", # Higher quality 5 "enterprise": "bytedance/seedance-2.0" # Max control 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
Resultado: O desenvolvedor lançou em 4 dias em vez de 3 semanas. O uso do Seedance 2.0 no nível premium justificou um preço 3× maior que o nível gratuito, e a estrutura de modelo em níveis foi construída com uma única chave do Atlas Cloud — não três integrações separadas de fornecedores.
-
A Vantagem do Atlas Cloud: Por que "Uma API" é a Arquitetura Certa {#atlas-cloud-advantage}
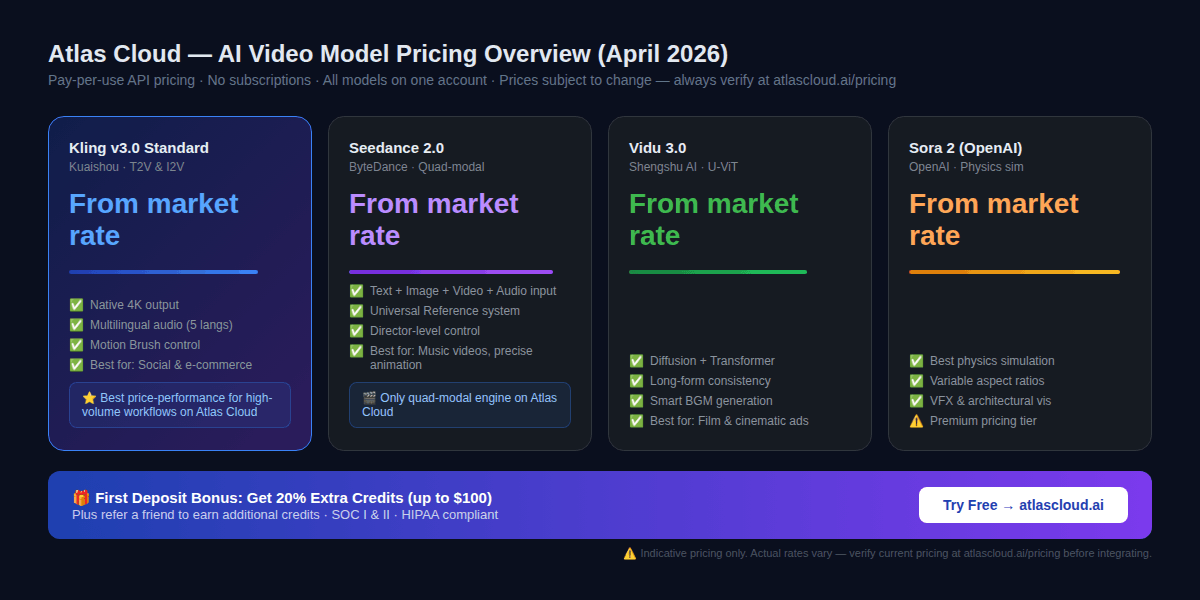
O Atlas Cloud é posicionado como a primeira plataforma de inferência de IA totalmente multimodal do mundo — uma API unificada que serve mais de 300 modelos em geração de texto, imagem, vídeo e áudio.
Para autores de Habilidades de Gerador de Vídeo com IA do GitHub, as vantagens específicas são:
-
API Compatível com OpenAI (Substituta Direta)
O Atlas Cloud usa um endpoint compatível com OpenAI. Se sua habilidade já integra o SDK da OpenAI, mudar para o Atlas Cloud para geração de vídeo requer alterar duas linhas: a api_key e a base_url. Nenhum novo SDK, nenhum novo sistema de autenticação.
-
Faturamento Único para Fluxos de Trabalho Multi-Modelo
Fluxos de trabalho de vídeo em produção raramente usam um único modelo. Um pipeline típico pode usar:
- Seedream 5.0 para geração de imagens (quadros iniciais)
- Kling v3.0 para conversão de imagem para vídeo
- Um LLM (Claude, GPT-4 ou DeepSeek) para otimização de prompts
- Um modelo TTS para narração de voz
Com contas separadas de fornecedores, isso são quatro relacionamentos de faturamento, quatro pools de limites de taxa e quatro pontos de integração. Com o Atlas Cloud, é uma chave de API e uma fatura.
-
Transparência de Preços por Modelo
O Atlas Cloud publica preços por modelo, sem taxas de computação ocultas. O modelo de negócios é direto: pague pelo que você gera. Novos desenvolvedores recebem um bônus de 20% no primeiro depósito (até US$ 100), e um programa de indicação fornece créditos adicionais. Sempre verifique os preços atuais em atlascloud.ai/pricing antes de construir projeções financeiras.
-
Cobertura de Conformidade
Para habilidades do GitHub empresariais implantadas em ambientes regulamentados: o Atlas Cloud possui certificação SOC I & II e é compatível com HIPAA, com infraestrutura nas regiões dos EUA, UE e Ásia. Isso cobre a maioria dos requisitos de residência de dados empresariais.
-
Integração com ComfyUI, n8n e MCP Server
O Atlas Cloud integra-se nativamente com as ferramentas mais usadas para construir habilidades de geração de vídeo no GitHub:
- ComfyUI — nós customizados para criação de fluxos de trabalho visuais
- n8n — automação de fluxos de trabalho com etapas de geração de vídeo do Atlas Cloud
- MCP Server — integração com o Model Context Protocol para frameworks de agentes de IA
-
Qual Stack Você Deve Usar de Fato? {#decision-guide}
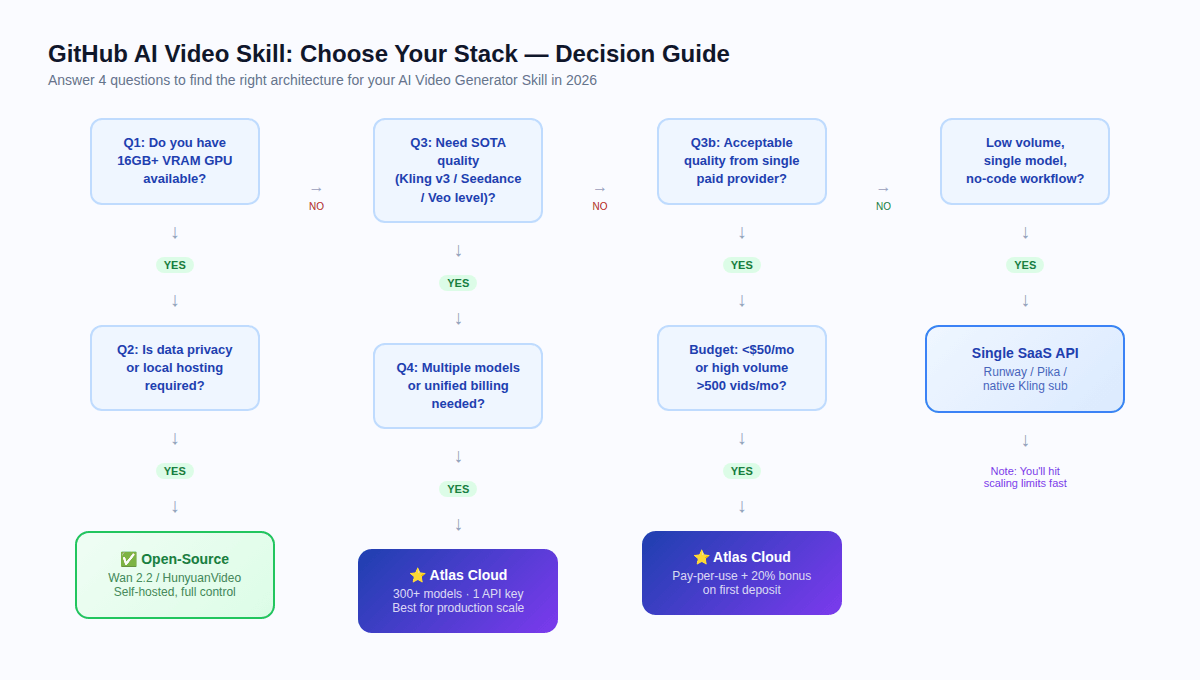
Passe por estas quatro perguntas:
P1: Você tem uma GPU com 16 GB+ de VRAM disponível?
Se não → pule a auto-hospedagem completamente. API em nuvem é seu único caminho prático.
P2: A privacidade de dados ou a hospedagem local são exigidas por regulamentação?
Se sim + GPU disponível → avalie código aberto (Wan 2.2 ou HunyuanVideo dependendo da VRAM).
Se sim + sem GPU → use Atlas Cloud (compatível com HIPAA, certificado SOC) e revise seus requisitos regulatórios específicos.
P3: Você precisa de qualidade de estado da arte (nível Kling v3, Seedance 2.0, Veo)?
Se sim → API em nuvem é necessária. Modelos de código aberto têm uma lacuna de qualidade significativa em relação aos principais modelos proprietários em 2026.
Se qualidade aceitável em nível de código aberto → Wan 2.2 auto-hospedado pode funcionar.
P4: Você precisa de múltiplos modelos ou faturamento unificado?
Se sim → Atlas Cloud. Gerenciar três contas de fornecedores em escala tem um custo operacional oculto que só se torna visível no volume de produção.
Resumo de Recomendações por Caso de Uso
| Caso de Uso | Stack Recomendada |
| Pesquisa / prototipagem | Código aberto (Wan 2.2, CogVideoX) |
| Agência de mídias sociais, 500+/mês | Atlas Cloud + Kling v3.0 |
| Videoclipe / animação de personagens | Atlas Cloud + Seedance 2.0 |
| VFX / simulação física | Atlas Cloud + Sora 2 |
| Dados soberanos / offline | Auto-hospedado (HunyuanVideo, Open-Sora 2.0) |
| SaaS com qualidade de modelo em níveis | Atlas Cloud (uma chave, múltiplos modelos) |
| Lote de código aberto de alto volume | Wan 2.2 auto-hospedado (limiar de 10.000+/mês) |
-
FAQ {#faq}
P: O que é uma Habilidade de Gerador de Vídeo com IA?
Um módulo de código reutilizável ou camada de integração que conecta uma aplicação a um backend de geração de vídeo com IA — seja pesos de código aberto ou uma API em nuvem. Formas comuns: classe Python, nó ComfyUI, fluxo de trabalho n8n, ferramenta MCP Server.
P: Qual é a VRAM mínima para auto-hospedar um modelo de vídeo de código aberto?
8 GB de VRAM para Wan 2.2 1.3B (qualidade aceitável para clipes curtos). 16 GB para CogVideoX-1.5 ou Open-Sora (melhor qualidade). 24 GB+ para Wan 2.2 14B. 60–80 GB para HunyuanVideo ou Open-Sora 2.0 modelo completo.
P: A geração de vídeo com IA de código aberto é realmente gratuita?
Os pesos do modelo são gratuitos. A inferência não é gratuita — requer computação de GPU. Em baixo volume (<5.000 vídeos/mês), APIs em nuvem como Atlas Cloud são tipicamente mais baratas quando o custo total de propriedade é calculado.
P: Posso usar o Atlas Cloud para fluxos de trabalho de imagem para vídeo (i2v)?
Sim. O Atlas Cloud suporta variantes i2v para Kling, Seedance e Vidu. Nota: para modelos i2v, algumas variantes não aceitam um parâmetro separado de proporção de aspecto — a resolução de saída segue as dimensões da imagem de entrada.
P: Como o Atlas Cloud lida com a limitação de taxa?
O Atlas Cloud suporta padrões Assíncronos/Webhook. Trabalhos de geração de vídeo são submetidos como tarefas; sua aplicação recebe um ID de tarefa e é notificada quando a renderização é concluída. Isso evita bloqueios em escala.
P: Qual é o melhor modelo para consistência de personagens entre cenas?
O sistema Universal Reference do Seedance 2.0 é a solução mais avançada em 2026. Ele permite que você alimente vídeos de referência, imagens e áudio para manter a aparência e o movimento consistentes do personagem entre clipes gerados.
P: O Atlas Cloud suporta ComfyUI?
Sim. O Atlas Cloud tem integração nativa com ComfyUI, além de nós n8n e compatibilidade com MCP Server.
P: Como os modelos de vídeo de código aberto lidam com proporções de aspecto?
Varia por modelo. Open-Sora suporta 16:9, 9:16, 1:1 e 2.39:1 via flag --aspect_ratio. Wan 2.2 e LTX-Video suportam múltiplas proporções. Para fluxos de trabalho i2v, a maioria dos modelos segue a proporção de aspecto da imagem de entrada, independentemente dos parâmetros especificados.
Resumo
O cenário de 2026 se divide em dois campos, cada um com seu ponto ideal:
Código aberto faz sentido se você tem GPUs sobrando, está gerando mais de 10 mil vídeos por mês, os dados não podem sair de seus servidores, ou precisa fazer fine-tuning em seu próprio material proprietário.
APIs pagas são a melhor escolha se você precisa da melhor qualidade disponível, a velocidade importa mais que o custo, está abaixo de 5 mil vídeos por mês, ou quer misturar múltiplos modelos sem gerenciar contratos de fornecedores.
O Atlas Cloud faz a ponte entre os dois: como uma plataforma unificada que fornece acesso a mais de 300 modelos — incluindo os principais modelos de código aberto via inferência hospedada e todos os grandes modelos proprietários — através de uma única chave de API compatível com OpenAI. Para a maioria dos desenvolvedores construindo Habilidades de Gerador de Vídeo com IA do GitHub em produção em 2026, é o caminho de menor atrito do protótipo à produção.
As informações de preço neste artigo são indicativas e estão sujeitas a alterações. Sempre verifique as taxas atuais em atlascloud.ai/pricing antes de construir projeções financeiras. A disponibilidade do modelo pode variar por região.
Atlas Cloud: atlascloud.ai — Certificado SOC I & II · Compatível com HIPAA · Infraestrutura nos EUA, UE e Ásia


