Os limites de taxa do GPT Image 2.5 atualmente variam de 5 a 250 imagens por minuto nos níveis pagos da API listados nas páginas dos modelos Flare e Sunburst da OpenAI. Ambas as páginas também listam limites de tokens. Verifique a configuração real da sua conta antes de programar o trabalho: as cotas de uso do ChatGPT, os limites da API da OpenAI e as restrições de endpoint do Atlas Cloud exigem verificações separadas.
O momento desconfortável acontece quando uma campanha está quase pronta e as últimas imagens ainda não foram geradas. Clicar em Gerar novamente pode deixar você com uma tarefa original, uma tarefa duplicada e nenhuma ideia clara de qual terminará primeiro.
Este guia conecta os limites publicados a um plano de entrega prático. Você encontrará uma tabela de diagnóstico, um procedimento de fila, um cálculo trabalhado para 100 imagens e um método controlado para verificar se uma imagem bem-sucedida realmente atende ao briefing. O objetivo útil é uma pasta de assets aprovados até o seu prazo.
Documentação verificada em 16 de setembro de 2026. A capacidade específica da conta e os custos exatos configurados exigem verificação separada.
Status editorial: a barreira de acesso ao ambiente de teste impediu as seis gerações planejadas. O artigo inclui o protocolo reproduzível e as evidências oficiais das fontes, mas suas três comparações de saída e a captura da execução concluída permanecem indisponíveis.
Principais conclusões
- Identifique sua rota de acesso antes de aplicar qualquer limite.
- Verifique a conta, o projeto, o modelo e qualquer cota compartilhada.
- Diagnostique o erro antes de decidir se deve tentar novamente.
- Planeje o orçamento para imagens aprovadas, incluindo inspeção e retrabalho.
Os Limites de Taxa do GPT Image 2.5 Dependem da Sua Rota de Acesso
Comece pelo local onde você pressionou Gerar. Uma assinatura do ChatGPT, um projeto da API da OpenAI e uma conta do Atlas Cloud são rotas de acesso diferentes. Uma captura de tela de uma delas não pode estabelecer a cota de outra.
No ChatGPT, verifique seu plano atual, o acesso ao recurso de imagens e a mensagem exibida quando a geração é interrompida. Uma assinatura paga não estabelece uma cota ilimitada. Evite planejar o trabalho de um dia em torno de um número diário de imagens copiado da conta de outra pessoa.
A discussão do lançamento inclui usuários perguntando se o Plus ainda tem um limite diário de imagens. Isso estabelece uma preocupação dos leitores; os números nessas perguntas não estabelecem política. (Discussão do lançamento no Reddit, setembro de 2026.)
Para a API, registre a organização, o projeto e o identificador exato do modelo usado pelo seu aplicativo. Para o Atlas, identifique o endpoint selecionado e a conta que o executa. Em seguida, classifique o sinal visível em um tipo de limite.
| Tipo de limite | Sinal visível | Próxima verificação |
|---|---|---|
| Cota de uso do produto | O ChatGPT diz que a criação de imagens está temporariamente indisponível | Leia a mensagem atual da conta e qualquer horário de redefinição |
| Imagens por minuto, IPM | Restrição de taxa de imagens durante envios repetidos | Confirme a cota de imagens para aquela rota e modelo |
| Tokens por minuto, TPM | Erro ou painel da conta menciona um limite de tokens | Inspecione a cota de tokens relevante |
| Trabalho concorrente | Tarefas aguardam enquanto outras tarefas permanecem ativas | Conte o trabalho em andamento e verifique a política de concorrência |
| Saldo ou cota de cobrança | Aviso de cobrança ou erro de cota | Verifique fundos, status de cobrança e restrições de gastos |
| Acesso ao modelo | Resposta de permissão ou modelo indisponível | Confirme a elegibilidade da conta e o endpoint exato |
Mantenha essa distinção visível na planilha de tarefas da sua equipe. Um profissional de marketing que diz "atingi o limite" deve registrar a rota e a mensagem antes que outro colega comece a solucionar o problema.
Identifique também quem mais usa os mesmos recursos da conta. Uma segunda estação de trabalho não necessariamente fornece capacidade adicional. Pergunte ao proprietário da conta se o site, a ferramenta interna e os jobs noturnos usam o mesmo pool.
A entrada "Grátis: não suportado" na tabela da API diz respeito a esse nível de modelo da API. Ela não estabelece se o produto gratuito do ChatGPT pode gerar imagens.
Limites de Taxa do GPT Image 2.5 por Nível da API
As páginas oficiais do modelo atualmente publicam a seguinte tabela para ambas as variantes. Estes são valores públicos de nível de uso, verificados em 16 de setembro de 2026, e não uma garantia de que toda conta tenha exatamente essa configuração.
| Nível de uso da API OpenAI | TPM | IPM |
|---|---|---|
| Grátis | Não suportado | Não suportado |
| Nível 1 | 100.000 | 5 |
| Nível 2 | 250.000 | 20 |
| Nível 3 | 800.000 | 50 |
| Nível 4 | 3.000.000 | 150 |
| Nível 5 | 8.000.000 | 250 |
Fontes: (Página do modelo OpenAI Flare, verificada em setembro de 2026) e (Página do modelo OpenAI Sunburst, verificada em setembro de 2026).
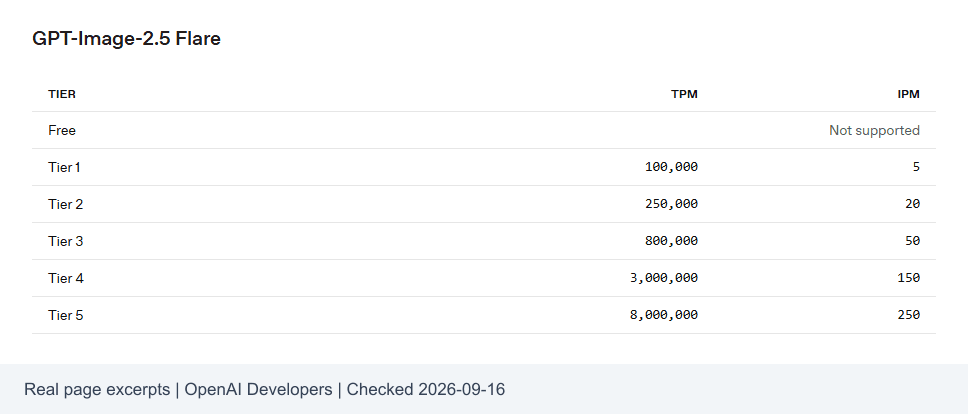 Página oficial do modelo OpenAI mostrando os limites de taxa do GPT Image 2.5 por nível de uso
Evidência da página oficial do modelo. Data da verificação: 16 de setembro de 2026.
IPM conta imagens; RPM conta requisições. Preserve essa distinção em sua planilha de planejamento. Com uma imagem por requisição bem-sucedida, os dois números podem se alinhar em uma estimativa simples. Múltiplas saídas, novas tentativas ou outros comportamentos do endpoint podem quebrar essa suposição.
Use a tabela como ponto de partida para uma conversa sobre capacidade. Anote o nível publicado e compare com os limites visíveis para a conta que realmente está fazendo o trabalho. Se houver diferença, investigue antes de comprometer um prazo.
Tabelas idênticas não mostram que Flare e Sunburst concluem uma tarefa no mesmo tempo. Elas também não estabelecem que alternar entre as variantes soma suas cotas. Confirme quaisquer limites compartilhados na configuração da conta.
Uma equipe que prepara uma campanha para sexta-feira pode transformar isso em um breve checklist: identificar a rota de produção, verificar a cota atual, checar outras cargas de trabalho agendadas e designar uma pessoa para monitorar a fila. Salve a data da verificação para que uma captura de tela antiga não se torne uma premissa operacional permanente.
Não multiplique uma cota por minuto pelos minutos do dia e prometa esse número de imagens concluídas. Esse cálculo exclui tempo ocioso, latência de geração, outras restrições e saídas rejeitadas.
Diagnostique os Limites de Taxa do GPT Image 2.5 Antes de Tentar Novamente
Salve o corpo do erro, o status HTTP, o timestamp e o identificador de requisição disponível antes de alterar qualquer coisa. Uma captura de tela dizendo apenas "429" deixa incerteza demais.
A documentação da OpenAI descreve limites de organização e projeto, pools de modelos compartilhados, cabeçalhos de resposta e tratamento de erros temporários. Ela recomenda aguardar pelo menos o tempo de um Retry-After fornecido, adicionar variação (jitter) e evitar falhas rápidas e repetidas, que podem consumir a cota por minuto. (Limites de taxa da OpenAI, verificados em setembro de 2026.)
O procedimento de diagnóstico a seguir é uma proposta de design de aplicação. Os rótulos de erro e os controles de recuperação devem ser mapeados para a plataforma que você realmente usa.
| Situação visível | Verifique primeiro | Ação |
|---|---|---|
| 429 temporário | Corpo do erro e qualquer dica de espera ou redefinição | Pause a fila afetada e reduza o ritmo de envio |
insufficient_quota da OpenAI | Saldo, estado de cobrança e elegibilidade da conta | Resolva o problema da conta; interrompa novas tentativas automáticas |
| Timeout após o envio | Registro da requisição original, ID da tarefa se disponível, histórico | Reconcilie a tarefa original antes de reenviar |
| Fila longa | Status pendente e contagem de tarefas ativas | Continue aguardando enquanto a tarefa permanecer válida; investigue atrasos separadamente |
| Rejeição de parâmetro ou conteúdo | Motivo específico de validação ou rejeição | Corrija a requisição; não a classifique como nova tentativa por limite de taxa |
O código da OpenAI na tabela é um exemplo de diagnóstico específico da OpenAI. Não é uma garantia de que o Atlas retorna o mesmo objeto de erro ou suporta os mesmos cabeçalhos.
Para um timeout, separe o que você sabe do que você suspeita. "Meu cliente parou de esperar" não estabelece se o servidor aceitou o job. Marque o registro local como incerto e inspecione a operação original através de qualquer mecanismo de status ou histórico que a rota fornecer.
Se não existir mecanismo de reconciliação, encaminhe essa incerteza a um operador. Reenviar às cegas pode criar outro job cobrável. Registre esse risco antes que alguém decida tentar novamente.
Para o momento de redefinição, use a resposta ou a mensagem da conta relevante para o limite que você atingiu. Evite assumir que toda restrição é redefinida à meia-noite ou exatamente 60 segundos após o erro.
Preserve as evidências após a recuperação. Um pequeno registro de incidente mostrando a rota, o erro original, o tempo de espera e o resultado final ajuda o próximo operador a distinguir um problema de conta de um pico de tráfego.
Lide com os Limites de Taxa do GPT Image 2.5 Usando uma Fila
Uma fila dá à sua equipe um lugar único para decidir o que será executado em seguida. Para uma campanha pequena, uma planilha e um operador podem ser suficientes. Um aplicativo pode implementar as mesmas decisões em um armazenamento de jobs durável.
Use este POP de seis etapas:
- Atribua um ID de negócio estável. Registre a versão do prompt, a saída desejada, o modelo, as dimensões, a qualidade e o prazo. Um briefing revisado recebe uma nova versão.
- Verifique o trabalho existente. Retorne a saída salva para um job concluído. Deixe um job ativo ou incerto em reconciliação em vez de criar outro envio.
- Controle ritmo e concorrência separadamente. Admita trabalho somente quando o orçamento de taxa local e um slot em andamento estiverem disponíveis. Novas tentativas usam os mesmos controles de admissão.
- Respeite uma dica de espera do servidor. Para um erro confirmado como passível de nova tentativa, aguarde pelo menos a duração indicada e adicione um pouco de aleatoriedade.
- Caso contrário, use backoff limitado. Aumente os atrasos entre tentativas, adicione variação (jitter) e defina um teto para o atraso. Mantenha o prazo geral da tarefa em vista.
- Pare deliberadamente. Quando o orçamento de novas tentativas ou o prazo for esgotado, salve a última evidência e envie a tarefa para revisão.
Este pseudocódigo neutro em relação à plataforma ilustra as decisões de agendamento. Não é um SDK do Atlas nem um contrato de endpoint.
plaintext1claim business_job_id atomically 2if completed: return saved_asset 3if active_or_uncertain: reconcile_original; stop 4 5while attempts_remaining and before_deadline: 6 wait_for_rate_budget_and_inflight_slot() 7 result = submit_once_and_record_identifiers() 8 9 if completed: save_asset_and_finish() 10 if accepted: track_original_until_terminal(); stop 11 if submission_outcome_unknown: mark_uncertain(); stop 12 if billing_or_access_or_validation_error: stop_for_review() 13 if not_retryable: stop_for_review() 14 15 delay = server_minimum_wait_if_present() 16 otherwise: delay = capped_exponential_backoff() 17 schedule_next_attempt_after(delay + random_jitter) 18 19save_final_state_for_review()
A reivindicação atômica é importante quando dois workers veem a mesma linha na fila. Ambos não podem concluir independentemente que o job está livre para envio. Persista o estado do envio antes que um worker desapareça ou reinicie.
A desduplicação em nível de aplicação ainda deixa uma janela difícil: um serviço pode aceitar uma requisição pouco antes de o cliente perder a resposta. A idempotência nativa do endpoint pode resolver alguns riscos de envio duplicado quando documentada. Um ID de negócio local por si só não pode garantir execução exatamente uma vez, e este guia não assume que o Atlas aceita um cabeçalho de idempotência específico.
Priorize pela necessidade de entrega. Conclua a imagem ausente da campanha aprovada antes de admitir variações opcionais. Mantenha uma breve nota do operador explicando por que o trabalho foi interrompido, para que um colega possa retomar sem adivinhar.
Planeje 100 Imagens em Torno dos Limites de Taxa do GPT Image 2.5
Use dois contadores: saídas geradas e entregáveis aceitos. O segundo contador diz ao responsável pela campanha se o trabalho está pronto.
Considere um exemplo hipotético de planejamento, com uma saída por tarefa. Suponha uma cota efetiva de 5 IPM, ocupação média de slot em andamento de 60 segundos e no máximo 2 tarefas simultâneas. Esses dados são ilustrativos, não medições do Atlas ou da OpenAI.
| Dado ou cálculo de planejamento | Valor hipotético | Interpretação |
|---|---|---|
| Imagens aprovadas necessárias | 100 | A meta real de entrega |
| Cota efetiva de imagens | 5 IPM | Capacidade assumida da conta |
| Cota de imagens necessária para 100 saídas | 100 ÷ 5 = 20 minutos | Requisito de capacidade de cota, não uma promessa de conclusão |
| Tarefas concorrentes | 2 | Teto assumido de tarefas em andamento |
| Ocupação média de slot | 60 segundos | Do envio à conclusão |
| Capacidade pelo lado da concorrência | 2 × 60 ÷ 60 = 2 imagens/minuto | Menor que a cota de imagens |
| Taxa de aceitação assumida | 80% | Estimativa simplificada para planejamento |
| Cota de geração para 100 imagens aceitas | 100 ÷ 0,8 = 125 saídas | Inclui um orçamento aproximado de retrabalho |
| Tempo de capacidade a 2 saídas/minuto | 125 ÷ 2 = 62,5 minutos | Exclui trabalho adicional de inspeção e transferência |
Uma aproximação útil é:
plaintext1imagens sustentáveis/minuto ≈ mínimo de: 2 cota de imagens 3 cota de requisições × imagens por requisição 4 cota de tokens ÷ tokens aplicáveis por imagem 5 concorrência × 60 ÷ ocupação média em segundos
Use unidades comparáveis e medições reais da conta. Se o consumo de tokens não estiver disponível, deixe esse termo sem resolução em vez de estimá-lo pela contagem de palavras do prompt. Esta fórmula descreve um modelo de planejamento, não a implementação do provedor.
A estimativa de 125 saídas assume uma probabilidade de aceitação estável entre tentativas. O retrabalho real pode ser correlacionado: um prompt que erra repetidamente a contagem de objetos pode continuar falhando até que alguém o altere. Revise defeitos recorrentes antes de comprar mais tentativas.
Trabalhos diferentes precisam de critérios de aceitação diferentes:
- Ilustrações semanais de conteúdo: o assunto deve corresponder ao artigo e o corte deve funcionar no tamanho de publicação.
- Material de conceito de produto: a imagem deve preservar a forma e o posicionamento exigidos. Uma imagem conceitual não pode substituir fotografia de produto verificada.
- Ilustrações de ensino ou receitas: contagens, objetos e detalhes de sequência devem corresponder à explicação. Um ingrediente extra pode enganar os leitores.
Adicione ao cronograma o tempo de download, inspeção, revisão e transferência. Se uma pessoa revisa todos os assets, meça também o ritmo dessa pessoa.
Antes de um prazo, separe as imagens essenciais das variantes opcionais. Acompanhe itens prontos, rejeitados, ativos e incertos de forma independente. Uma pasta com 100 arquivos ainda pode estar com vários entregáveis aprovados em falta.
Reduza o Retrabalho Antes de Aumentar Seus Limites
Defina um critério de aprovação antes de pressionar Gerar. Isso torna a decisão repetível e impede que uma imagem convincente passe com uma contagem errada ou texto inutilizável.
O protocolo controlado aqui usa o GPT Image 2.5 Flare Text-to-Image, um PNG por tarefa, em 2048x1152. Para cada briefing, execute max primeiro e depois high, mantendo todas as outras configurações disponíveis inalteradas. Preserve os originais e inspecione ambos no mesmo tamanho de exibição.
Status da evidência: As seis saídas Flare abaixo foram geradas para os três briefings em 2048x1152. Cada par registra um resultado MAX e um HIGH. Esses exemplos apoiam as etapas de inspeção mostradas aqui, mas seis saídas não estabelecem uma ampla classificação de qualidade ou uma taxa de aceitação.
A. Contagem de objetos e composição
Copie este prompt sem alterações:
plaintext1Create a realistic overhead food photograph for a recipe article. 2Show exactly six whole red tomatoes arranged in two neat rows of three 3on a light wooden cutting board. Place one stainless-steel kitchen knife 4to the right of the board and one folded beige linen towel to the left. 5No other vegetables, no sliced tomatoes, no plates, no hands, no text, 6and no logos. Use soft natural window light from the upper left. 7Keep the entire cutting board inside the frame. 8Horizontal 16:9 composition.
Conte cada tomate, verifique as duas fileiras e inspecione as quatro bordas da tábua. Depois, procure objetos proibidos. Aceite o enquadramento somente quando todo o briefing for atendido. Uma contagem correta de tomates com a tábua cortada ainda exige uma decisão sobre reparo ou regeneração.
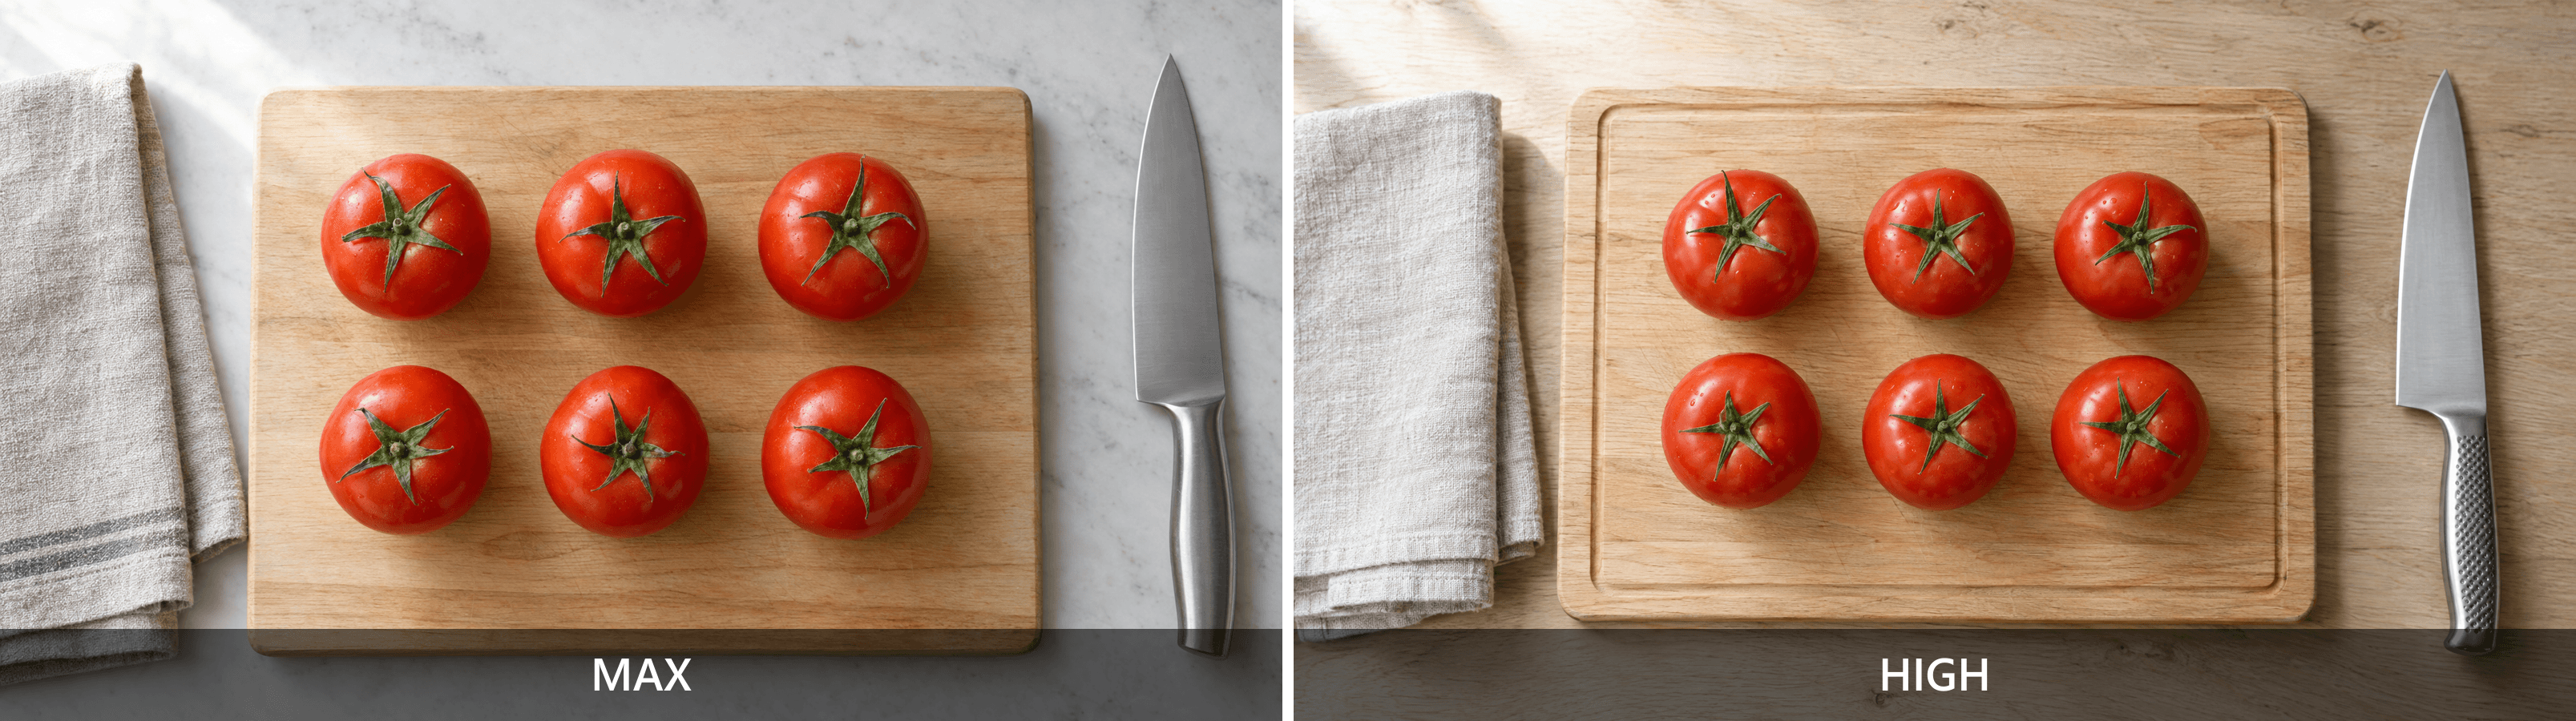 Saídas high e max do Flare para a verificação da contagem de seis tomates e da tábua completa
Esquerda: MAX. Direita: HIGH. Ambas as saídas mostram seis tomates em duas fileiras; inspecione a tábua inteira, a faca, o pano e quaisquer objetos proibidos antes de aprovar qualquer um dos resultados.
B. Espaço para um título
plaintext1Create a realistic editorial still-life photograph for a home-office 2article. Place an open unbranded notebook, one black pen, and one plain 3ceramic coffee cup entirely within the left half of a pale oak desk. 4Keep the right 45 percent of the frame empty, showing only the desk 5surface so a designer can add a headline later. No laptop, no phone, 6no plants, no visible writing, no text, and no logos. 7Use soft daylight and a slightly elevated camera angle. 8Horizontal 16:9 composition.
Em 2048 pixels de largura, os 45% mais à direita começam em aproximadamente x = 1126. Verifique essa área no original. Em seguida, coloque um título real em uma prévia de layout local para avaliar a legibilidade. Uma linha-guia é uma anotação de pós-produção, não parte da cena gerada.
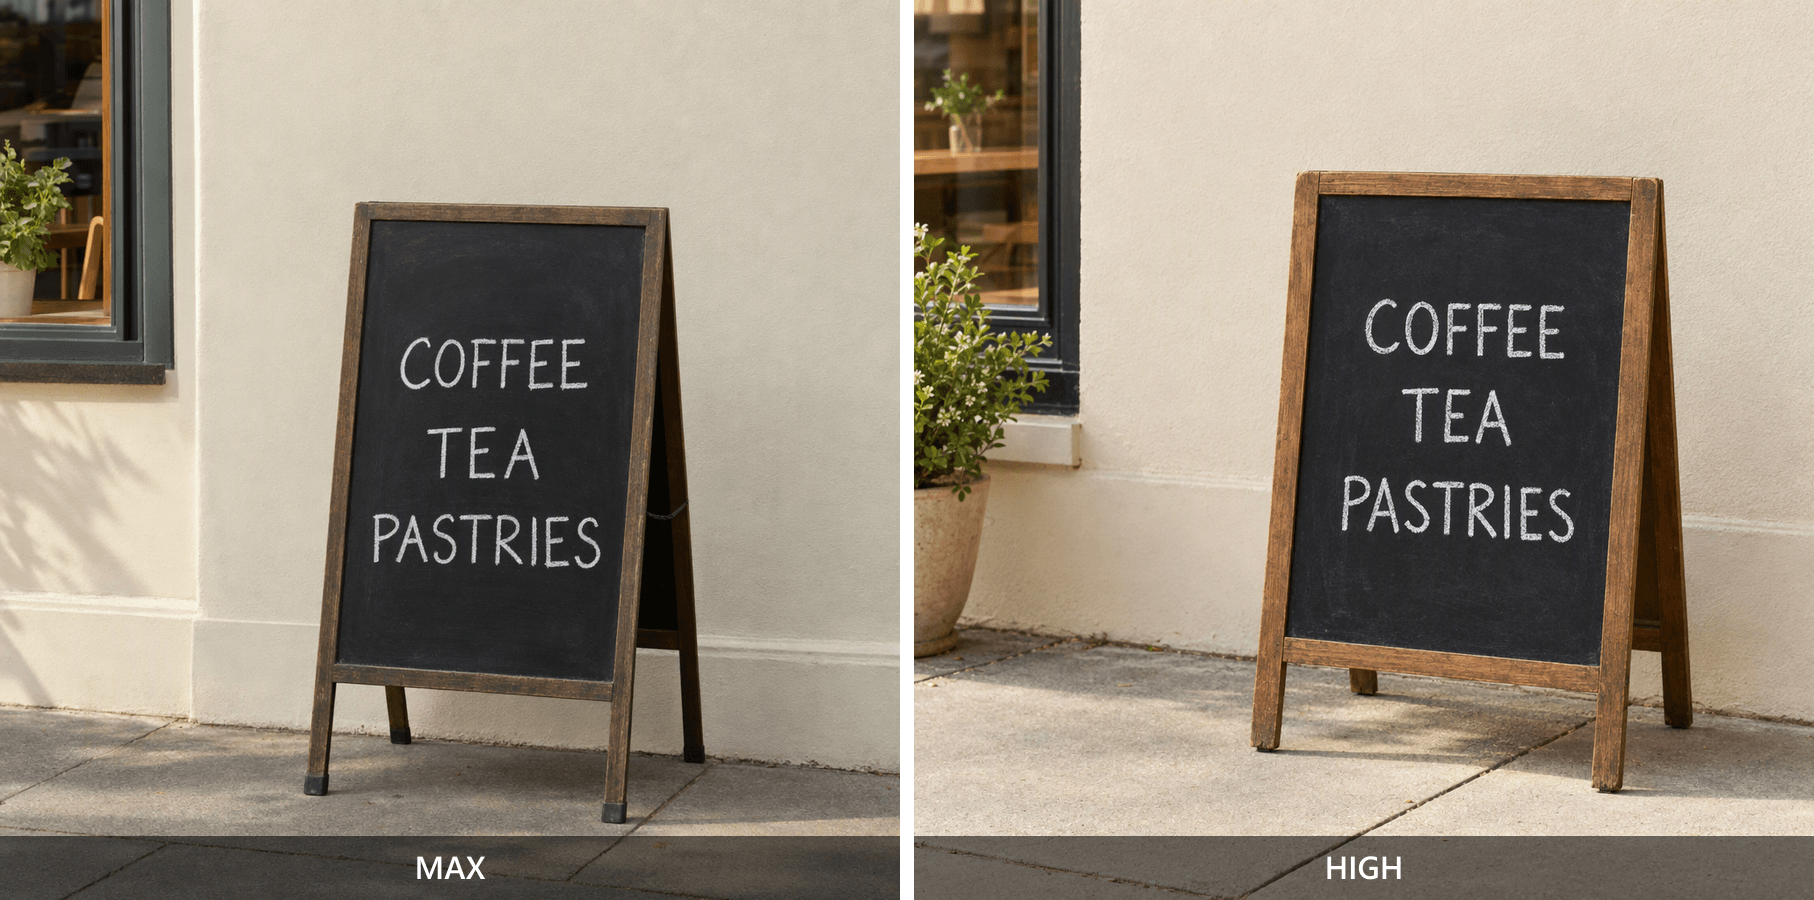 Saídas high e max para home-office com a área direita para título marcada conforme solicitado
Esquerda: MAX. Direita: HIGH. Ambas as saídas preservam uma área útil de mesa à direita para um título; avalie essa região vazia no tamanho final de exibição.
C. Texto curto exato
plaintext1Create a realistic photograph of a small freestanding black chalkboard 2outside a quiet neighborhood cafe. The board must contain exactly 3these three lines of clearly readable white lettering: 4COFFEE 5TEA 6PASTRIES 7Do not add prices, extra words, logos, or other readable signs. 8Show the full board with a simple cream-colored wall behind it, 9warm morning daylight, and a small area of clean pavement. 10No people. Horizontal 16:9 composition.
Leia cada letra no original e na prévia no tamanho de publicação. Verifique o fundo para ver se há sinais legíveis extras. Esta é uma cena de teste gerada por IA, não uma fotografia que documenta um café real. Preserve erros de ortografia na evidência em vez de retocá-los.
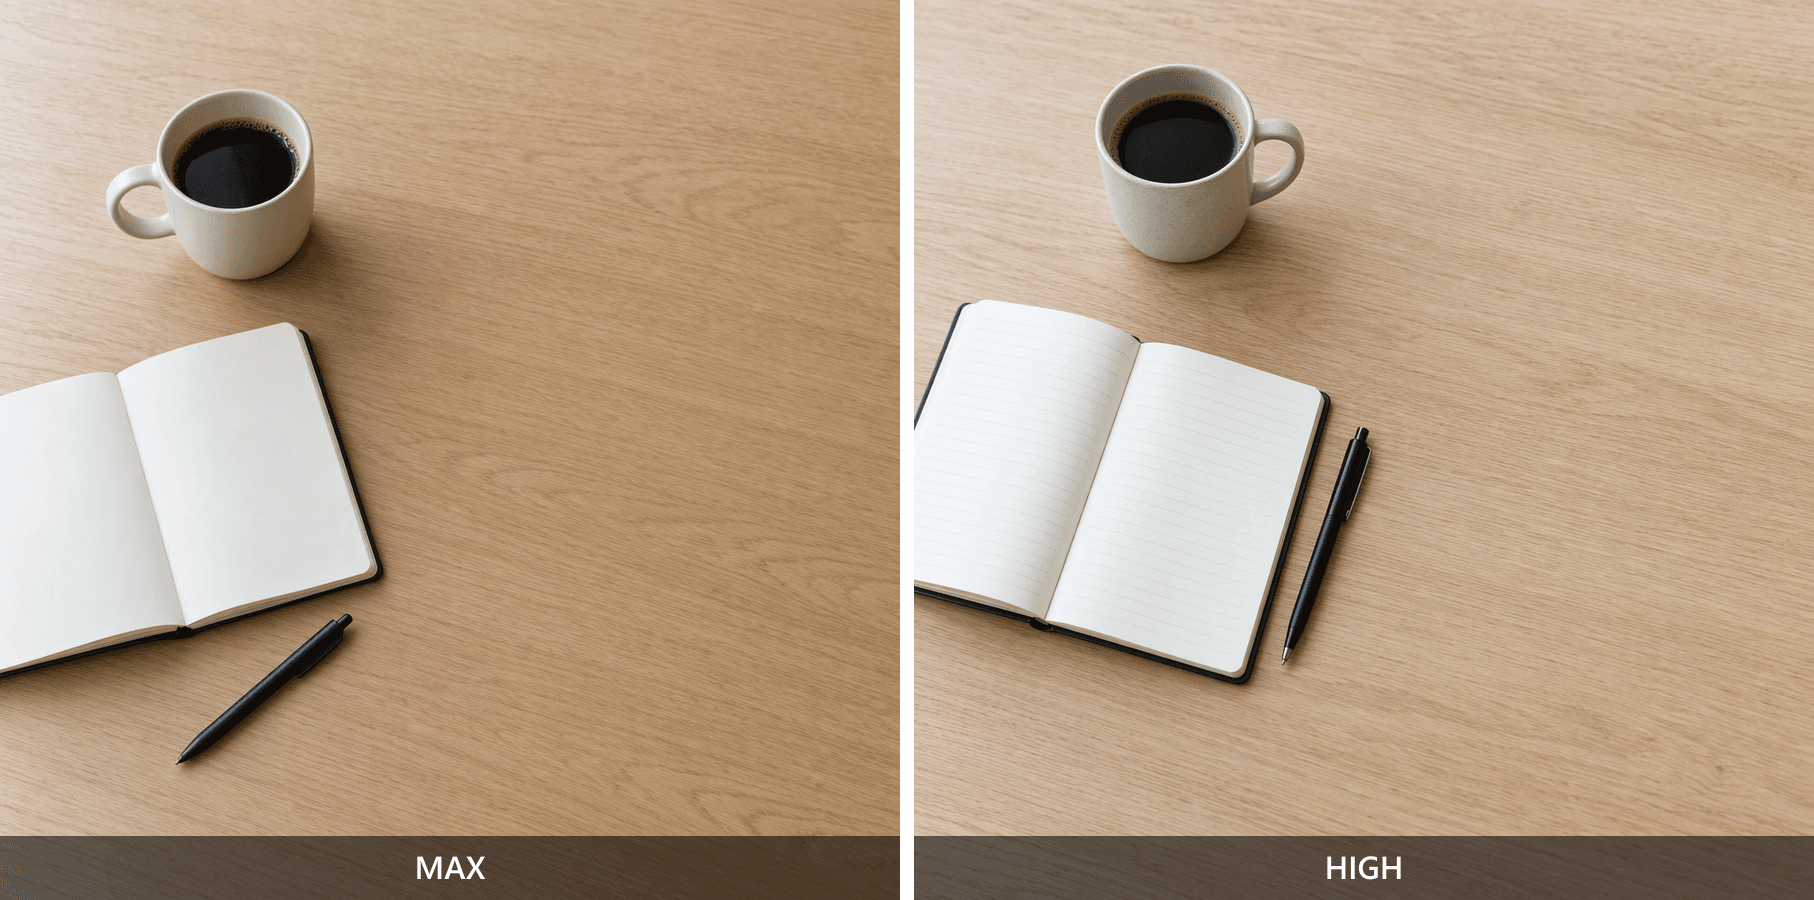
Lousas de café de alta e máxima resolução geradas por IA para verificar COFFEE, TEA e PASTRIES
Esquerda: MAX. Direita: HIGH. Leia cada linha no tamanho de publicação e verifique o fundo para ver se há texto legível extra antes de aprovar um resultado.
Seis saídas podem demonstrar um processo de inspeção. Elas não podem estabelecer uma taxa de sucesso da plataforma, vazão de produção ou um teto de limite de taxa. Um único par também não pode isolar os efeitos das configurações de qualidade da variabilidade de geração.
Avalie uma configuração pelo asset aceito e seu custo registrado. Sem cobranças exatas, uma conclusão de custo high versus max permanece não medida. Se ambos passarem, registre isso; se nenhum passar, revise o briefing antes de repetir a mesma falha.
Avalie o Atlas Cloud para Seu Fluxo de Trabalho de Imagens
Use a mesma tarefa representativa para avaliar uma rota de acesso. Isso mantém a avaliação ligada ao trabalho que sua equipe precisa entregar.
A página selecionada do GPT Image 2.5 Flare Text-to-Image é o endpoint deste protocolo. Abra-a, confirme o nome do modelo, cole um dos prompts completos acima e selecione o tamanho e a qualidade solicitados.
Verifique o que o formulário realmente retém depois que você sai de cada campo. Uma largura digitada que volta ao valor anterior antes do envio não cria um teste de 2048 pixels. Registre as configurações confirmadas, execute uma tarefa, aguarde um estado final e baixe a saída real.
Salve o identificador da tarefa se exposto, o horário do envio, o horário de conclusão e o arquivo de resultado juntos. Para a execução de comparação, crie uma tarefa separada e altere apenas a qualidade. Não infira uma nova saída a partir de exemplos já exibidos na página do modelo.
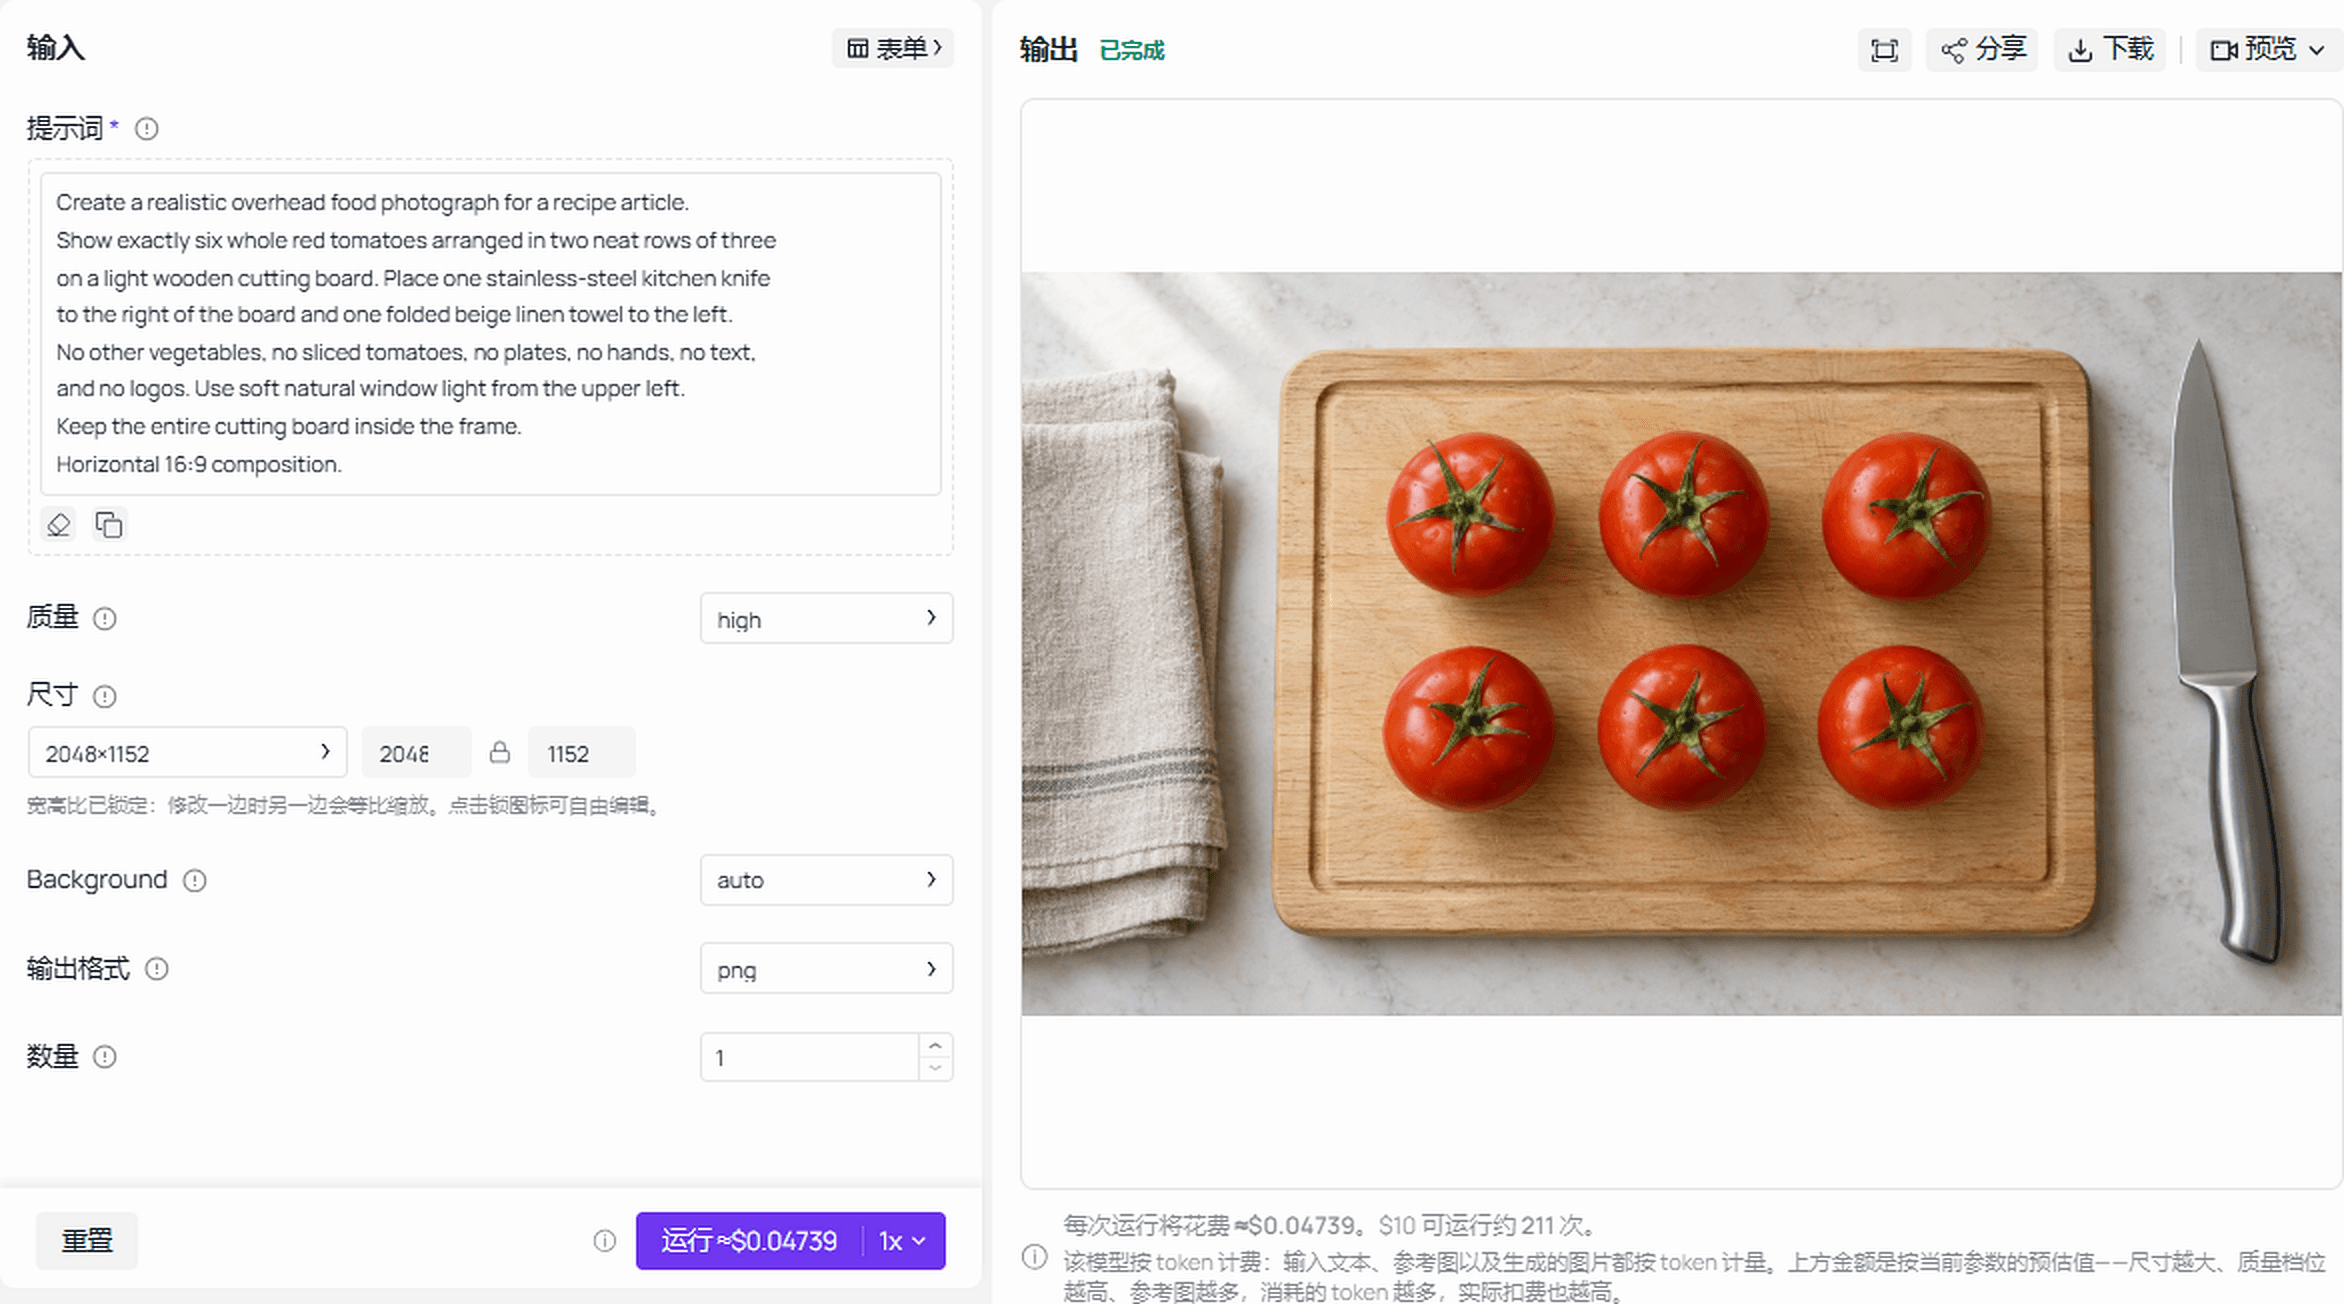 Execução Flare concluída mostrando o briefing de tomates, as configurações ativas e o resultado gerado
Execução Flare concluída: a tela mostra o briefing de tomates, qualidade HIGH, tamanho 2048x1152, saída PNG e o resultado retornado com seis tomates.
Avalie a rota em cinco campos:
- Modelo e endpoint: confirme o Flare text-to-image em vez de um endpoint de edição ou uma variante diferente.
- Taxa e concorrência: obtenha os limites aplicáveis da conta e se as cargas de trabalho os compartilham.
- Recuperação de tarefas: verifique como a conta expõe trabalho ativo, falhas terminais e resultados após um timeout.
- Custo configurado: verifique a unidade, as dimensões selecionadas, a qualidade e quaisquer condições de desconto.
- Aceitação e retrabalho: retenha a saída original e um breve motivo para cada asset rejeitado.
Use o diretório de modelos atual como ponto de entrada para a verificação de preços e, em seguida, inspecione a configuração selecionada. Um preço inicial arredondado não estabelece a cobrança para 2048x1152 + max.
A concorrência da conta Atlas, a vazão de produção, as cotas compartilhadas e a cobrança por tarefas com falha não foram estabelecidas de forma independente para este artigo. Confirme-as pelo lado da conta. Os tempos de tarefa do ambiente de teste também não podem estabelecer o desempenho da API em produção.
Execute um prompt representativo, inspecione o resultado e verifique os limites da sua conta antes de escalar.
Perguntas Frequentes sobre os Limites de Taxa do GPT Image 2.5
Quantas imagens do GPT Image 2.5 posso gerar por minuto?
Os níveis pagos nas páginas do modelo da API da OpenAI listam de 5 a 250 IPM. Use as configurações atuais da sua conta para o planejamento operacional, incluindo tokens e quaisquer outras restrições aplicáveis. Uma cota de imagens publicada não garante que toda imagem será concluída ou aprovada dentro daquele minuto.
O ChatGPT Plus tem um limite diário fixo de imagens?
Este artigo não estabelece um número fixo diário universal para o Plus. Verifique a mensagem atual de geração de imagens e as informações do plano da sua conta. Relatos de usuários podem ajudar a identificar uma questão a ser investigada, mas um número da sessão de outra pessoa não pode se tornar com segurança o orçamento diário de produção da sua equipe.
Flare e Sunburst têm os mesmos limites de taxa?
Suas páginas oficiais de modelo exibiam tabelas de nível idênticas quando verificadas em 16 de setembro de 2026. Isso não estabelece tempos de geração idênticos nem pools de capacidade separados. Antes de planejar uma carga de trabalho dividida, confirme os limites e as regras de compartilhamento que se aplicam a ambas as variantes na sua conta.
Por que recebo um erro 429 se ainda tenho créditos?
Um saldo responde se ainda há fundos; ele não responde se a requisição atual se encaixa em uma restrição de taxa. Leia o corpo do erro e qualquer dica de espera. Se o erro identificar um problema de conta ou cota, resolva esse problema em vez de supor que envios atrasados e repetidos vão resolvê-lo.
Quando os limites de taxa do GPT Image 2.5 são redefinidos?
Use os cabeçalhos de resposta relevantes ou o aviso da conta. Restrições diferentes podem ter janelas diferentes, e não há um único horário de redefinição estabelecido aqui para todas as rotas. Siga uma espera mínima fornecida, reduza o ritmo da fila e retenha o estado original do job ao decidir se uma nova tentativa é apropriada.
Usar o Atlas Cloud elimina os limites de taxa do GPT Image 2.5?
Não. Avalie o Atlas como uma opção de acesso com seu próprio comportamento de endpoint e restrições de conta. Confirme esses detalhes antes de aumentar o volume. Um plano prático para os limites de taxa do GPT Image 2.5 combina capacidade verificada, envios controlados, recuperação de tarefas e verificações de aceitação que reduzem o retrabalho evitável.


