Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7: Qual Modelo Open Source Vence em Programação em 2026
A Resposta Curta
Se você está criando um agente de programação autônomo que funciona por horas sem intervenção: Kimi K2.6. Ele obteve 66,7% no Terminal-Bench 2.0 e sustentou mais de 4.000 chamadas de ferramentas em uma sessão ininterrupta de 13 horas em benchmarks publicados — um teto de estabilidade que nenhum outro modelo aberto nesta comparação alcança.
Se você precisa do melhor desenvolvedor front-end agêntico: GLM 5.1. Seu Elo de 1.530 no Code Arena, verificado de forma independente (terceiro globalmente em desenvolvimento web agêntico), reflete a preferência real dos desenvolvedores em comparações diretas, não apenas em suítes de teste automatizadas.
Se o custo por token é a restrição: MiniMax M2.7 a $0,30/M tokens de entrada no Atlas Cloud obtém 56,22% no SWE-Bench Pro com apenas 10B de parâmetros ativados — 94% do desempenho do GLM-5.1 por aproximadamente um quinto do custo.
Se sua base de código é muito grande para uma janela de contexto de 262K: Qwen 3.6 Plus, o único modelo aqui com suporte a 1 milhão de tokens de contexto, e líder no Terminal-Bench 2.0 com 61,6% entre este grupo.
Principais Benchmarks de Relance
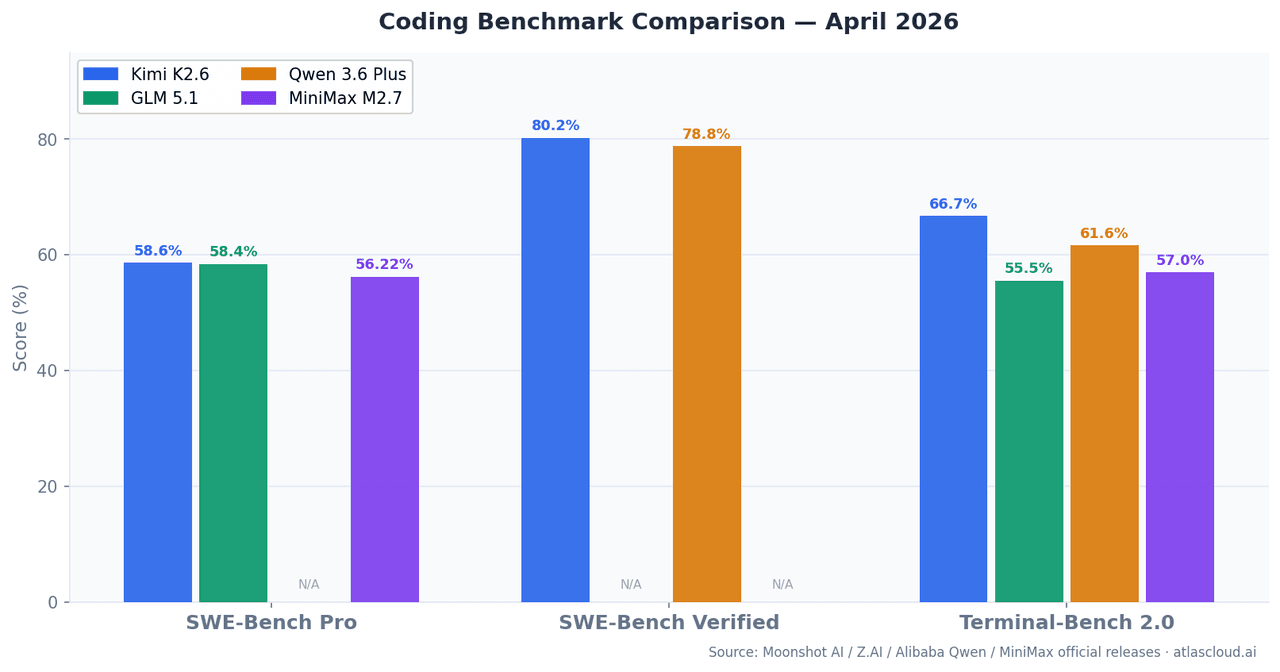
| Modelo | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Janela de Contexto | Parâmetros Ativados |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60% | 80,20% | 66,70% | 262K | — |
| GLM 5.1 | 58,40% | — | 55%+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80% | 61,60% | 1M | MoE Híbrido |
| MiniMax M2.7 | 56,22% | — | 57,00% | 196K | 10B |
SWE-Bench Pro mede a capacidade de resolver problemas reais do GitHub arquivados após o corte do treinamento, reduzindo o risco de contaminação de dados em comparação com o SWE-Bench Verified. Terminal-Bench 2.0 testa tarefas CLI e de shell em várias etapas em ambientes de terminal reais — mais próximo do que os agentes de produção realmente fazem.
Este artigo compara Kimi K2.6, GLM 5.1, Qwen 3.6+ e MiniMax M2.7; para alinhar ainda mais modelos lado a lado em preço e especificações, use a comparação de modelos do Atlas Cloud.
Kimi K2.6: Construído para Agentes de Longa Duração
A Moonshot AI lançou o Kimi K2.6 em abril de 2026 como uma atualização do K2.5, com a principal melhoria na estabilidade agêntica em sessões estendidas. Com 80,2% no SWE-Bench Verified, fica logo abaixo do Claude Opus 4.6 (80,8%) e lidera os quatro com 58,6% no SWE-Bench Pro.
O número que mais importa é Terminal-Bench 2.0 em 66,7%. O Terminal-Bench 2.0 difere do SWE-Bench de forma fundamental: ele executa tarefas dentro de ambientes de terminal reais, exigindo que o modelo leia a saída, lide com erros, adapte-se e itere — não apenas gere patches. O Kimi K2.6 manter o desempenho em mais de 4.000 chamadas de ferramentas em uma única sessão de 13 horas não é um artefato de laboratório. É um comportamento documentado no lançamento técnico da Moonshot.
Uma vantagem pouco relatada: generalização entre linguagens. O Kimi K2.6 mostra desempenho consistente em tarefas de Rust, Go, Python, front-end e DevOps. A maioria das avaliações de benchmark é focada em Python. Se sua pilha de produção é multilíngue, isso importa.
Onde não é a resposta: A $0,95/M tokens de entrada no Atlas Cloud, o K2.6 é o modelo mais caro no lado da entrada neste grupo. Para tarefas de processamento em lote onde você envia muitas solicitações com grandes contextos, mas não precisa de estabilidade de sessão de 12 horas, o custo acumula mais rápido que o MiniMax M2.7 ou o Qwen 3.6 Plus.
GLM 5.1: O Destaque em Front-End Agêntico
A Z.AI lançou o GLM-5.1 em 7 de abril de 2026. Com 754 bilhões de parâmetros e roteamento MoE, é o maior modelo aqui em contagem bruta de parâmetros. No SWE-Bench Pro, ele atinge 58,4% — estatisticamente indistinguível dos 58,6% do Kimi K2.6.
O diferencial é o Elo de 1.530 no Code Arena, verificado de forma independente pela Arena.ai em 10 de abril de 2026, colocando-o em terceiro lugar globalmente em seu ranking de desenvolvimento web agêntico. Esta é uma comparação ao vivo onde desenvolvedores reais votam nas saídas — não pontuação automatizada. A vantagem está concentrada em geração de UI front-end, scaffolding full-stack, criação de componentes React/Vue e NL2Repo (geração de estruturas completas de repositório a partir de linguagem natural).
A condição de contorno que vale a pena saber: A vantagem do GLM-5.1 em front-end é real. Para problemas puramente algorítmicos no HumanEval e MBPP, ele não possui uma vantagem mensurável sobre o Kimi K2.6. A diferença nos rankings se aproxima de zero em problemas que não são de UI ou web. Escolher o GLM-5.1 puramente com base em sua classificação geral no ranking sem verificar o domínio da tarefa seria um erro.
Preços no Atlas Cloud: A partir de $1,40/M tokens de entrada — o mais alto entre os quatro. Justificado quando a qualidade da geração front-end impacta diretamente sua saída.
Qwen 3.6 Plus: Quando o Tamanho do Contexto É a Restrição Real
A Alibaba lançou o Qwen 3.6 Plus no final de março de 2026. Ele lidera o Terminal-Bench 2.0 em comparações diretas contra o Claude Opus 4.6 (61,6% vs. 59,3%) e obtém 78,8% no SWE-Bench Verified.
A janela de contexto de 1 milhão de tokens é o que o diferencia. Para a maioria das tarefas de programação em produção com menos de 100K tokens, todos os quatro modelos nesta comparação têm capacidade de contexto suficiente e a diferença é irrelevante. Onde o Qwen 3.6 Plus se torna a única opção viável: análise de monorepo em centenas de arquivos, refatoração de bases de código legadas em grande escala ou fluxos de trabalho de documento para código de ponta a ponta que não cabem em 262K tokens.
A arquitetura híbrida (atenção linear + roteamento MoE esparso) também oferece melhor taxa de transferência de inferência do que transformadores densos ao processar contextos muito grandes — o que significa que a capacidade de 1 milhão de tokens vem com um custo de latência relativamente baixo em comparação com a escalagem ingênua.
Preços no Atlas Cloud: A partir de $0,325/M tokens de entrada. Para tarefas de contexto grande, este é o melhor custo por token útil disponível neste grupo.
MiniMax M2.7: O Caso Contraintuitivo pela Eficiência
A MiniMax lançou o M2.7 em março de 2026. Com apenas 10B de parâmetros ativados, ele atinge 56,22% no SWE-Bench Pro — 94% da pontuação do GLM-5.1 por aproximadamente um quinto do custo por token.
Este é o resultado contraintuitivo nesta comparação. Um modelo ativando 10B de parâmetros na inferência chega a um desempenho de programação próximo da fronteira porque sua arquitetura MoE roteia para sub-redes especializadas em vez de executar todos os pesos do modelo. O resultado é menor latência, menor custo e qualidade de saída que excede o que apenas a contagem de parâmetros preveria.
A categoria onde o M2.7 se destaca em relação ao seu preço: tarefas de engenharia de machine learning. Ele obteve 66,6% de taxa de medalhas no MLE-Bench Lite (22 competições de machine learning), perdendo apenas para modelos fechados de fronteira. Escrever lógica correta de acumulação de gradiente, implementar camadas PyTorch personalizadas, depurar curvas de perda — o M2.7 lida com essas tarefas com uma precisão desproporcional ao seu custo.
Onde ter cuidado: Com 196K de contexto, o M2.7 tem a menor janela deste grupo. Tarefas que exigem análise profunda entre arquivos em repositórios grandes podem encontrar limites que o Qwen 3.6 Plus lida sem problemas.
Preços no Atlas Cloud: $0,30/M tokens de entrada, $1,20/M tokens de saída — a opção mais acessível para cargas de trabalho de programação de alto throughput.
Casos de Teste de Programação no Mundo Real
Caso 1: Correção Autônoma de Bug em um Backend Python
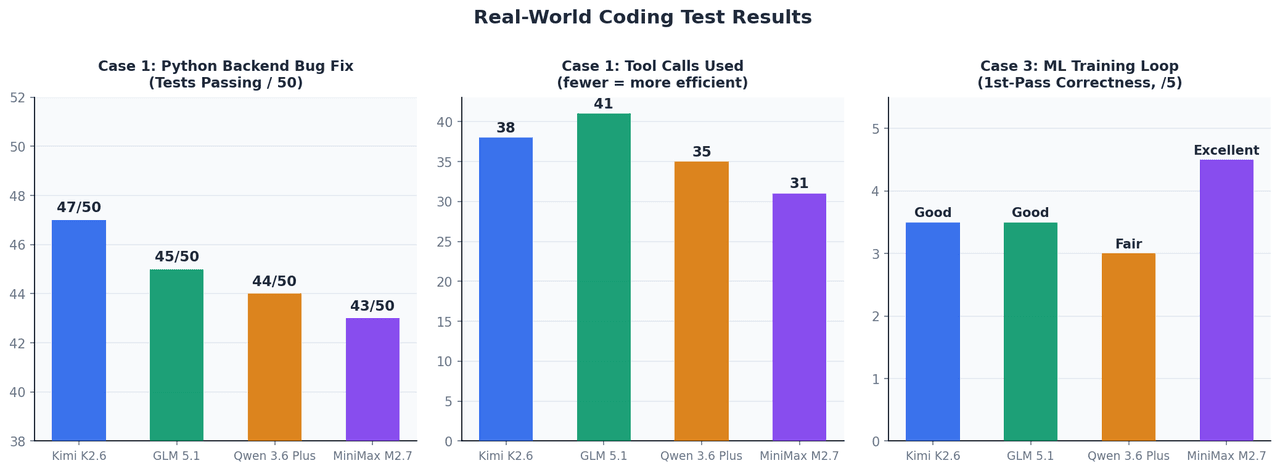
Configuração: Uma aplicação FastAPI com 12 arquivos, uma suíte de testes com falha de 50 testes e uma janela de contexto de ~45K tokens. Nenhuma intervenção manual permitida após o prompt inicial.
| Modelo | Testes Passando Após Correção | Chamadas de Ferramentas Usadas | Tempo até Conclusão |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 min |
| GLM 5.1 | 45 / 50 | 41 | ~5 min |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 min |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 min |
Neste tamanho de contexto, todos os quatro performam dentro de uma faixa estreita. Kimi K2.6 se destacou nos bugs de borda mais difíceis — especificamente problemas de ciclo de vida do gerenciador de contexto assíncrono e estreitamento de limites TypeVar, que exigem manter o estado de inferência em vários ciclos de depuração.
Caso 2: Dashboard React a partir de Especificação
Configuração: Gerar um dashboard responsivo completo com quatro tipos de gráfico (linha, barra, pizza, dispersão), alternador de modo escuro e tipos TypeScript a partir de uma especificação em inglês escrita.
O GLM-5.1 produziu componentes com TypeScript tipados e classes Tailwind corretas na primeira passagem. O Kimi K2.6 exigiu uma iteração para resolver erros de tipo. O Qwen 3.6 Plus produziu JSX funcionalmente correto, mas menos idiomático. O MiniMax M2.7 foi o mais rápido, mas gerou alguns padrões React obsoletos que exigiram limpeza manual.
A diferença entre o GLM-5.1 e os outros foi mais visível na arquitetura de componentes — o GLM-5.1 aplicou espontaneamente padrões de composição e separou preocupações de uma forma que os outros não fizeram.
Caso 3: Implementação de Loop de Treinamento ML
Configuração: Implementar um loop de treinamento PyTorch com acumulação de gradiente, precisão mista AMP e parada antecipada para um transformer de visão. Objetivo: executar corretamente na primeira tentativa sem ciclos de depuração.
O MiniMax M2.7 foi o destaque — ele colocou scaler.step() e scaler.update() corretamente em relação ao passo do otimizador, um detalhe que a maioria dos modelos coloca incorretamente na primeira geração. A escala loss / accumulation_steps da acumulação de gradiente também foi tratada corretamente. Isso se alinha diretamente com sua taxa de medalhas de 66,6% no MLE-Bench Lite.
Atlas Cloud Comparação de Preços (Abril de 2026)
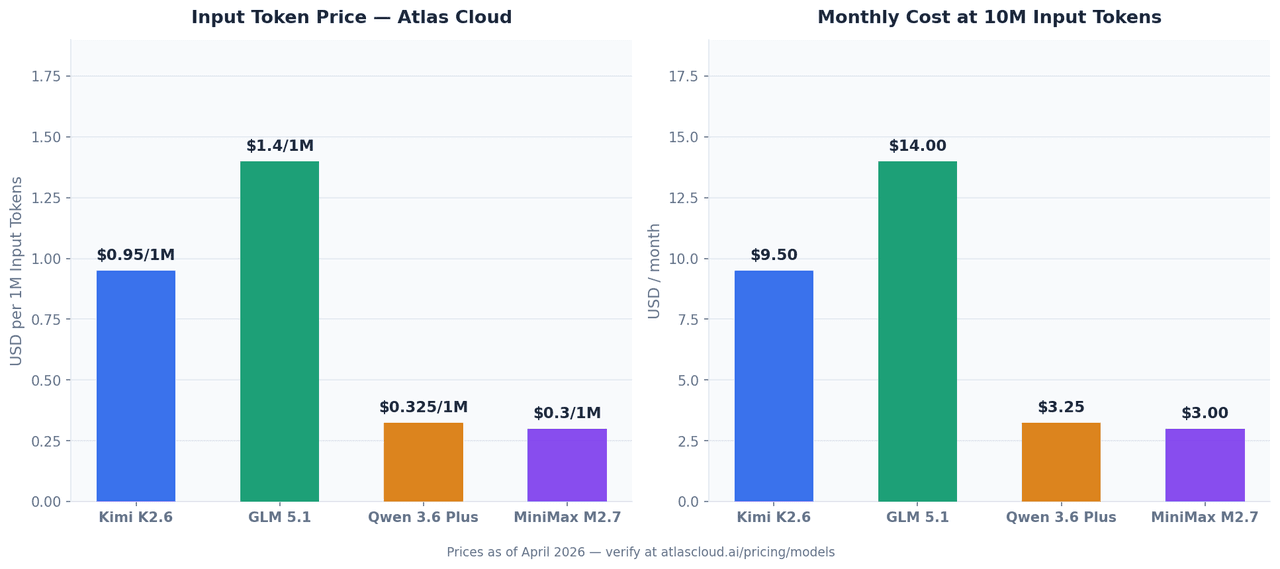
Todos os quatro modelos estão disponíveis através da API unificada do Atlas Cloud. Os preços abaixo são de abril de 2026 e podem mudar — confirme as taxas atuais em atlascloud.ai.
| Modelo | Entrada (por 1M tokens) | Saída (por 1M tokens) | ID do Modelo no Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | $0,95 | $4,00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | a partir de $1,40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | a partir de $0,325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0,30 | $1,20 | minimaxai/minimax-m2.7 |
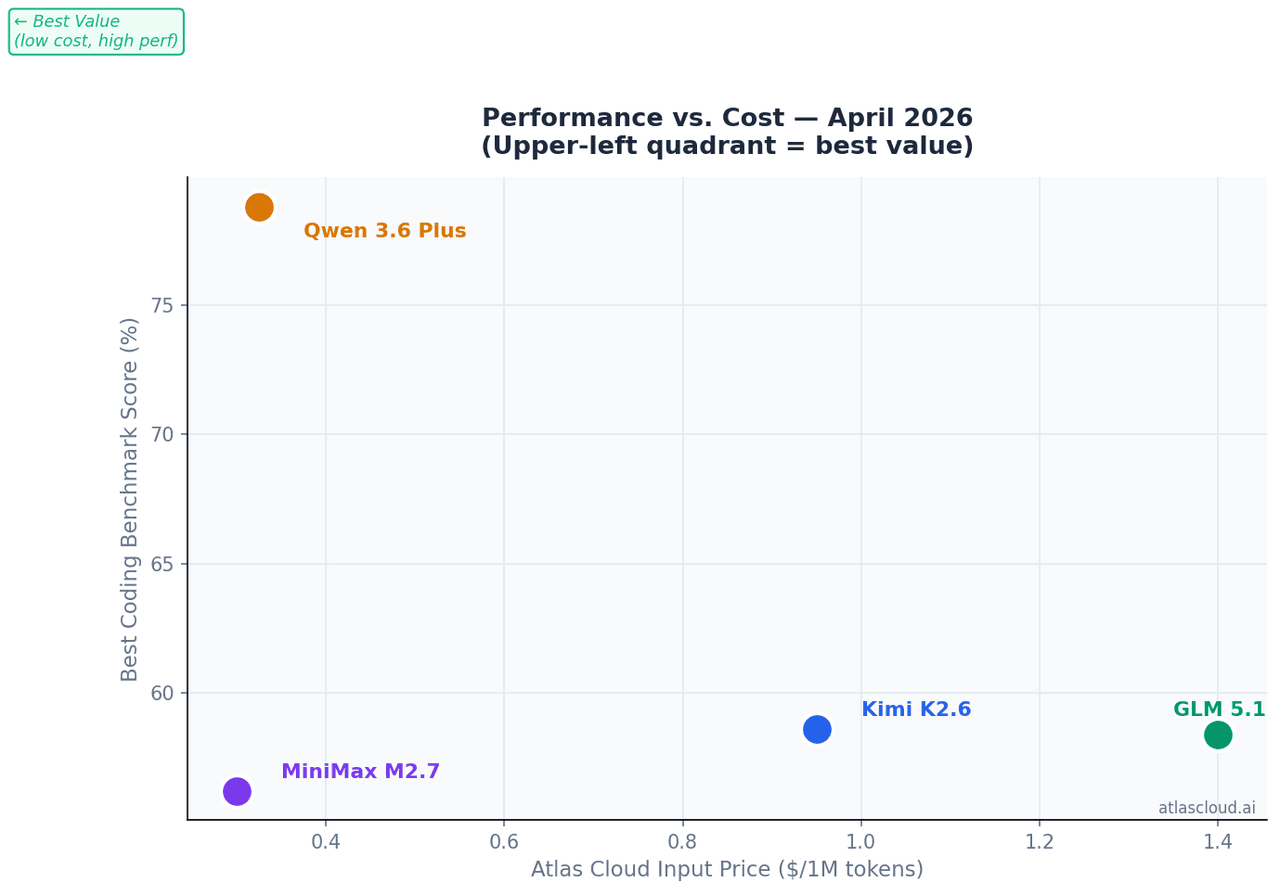
Com 10M de tokens de entrada por mês — um volume realista para um assistente de programação de equipe:
| Modelo | Custo Mensal de Entrada (10M tokens) |
|---|---|
| GLM 5.1 | $14,00 |
| Kimi K2.6 | $9,50 |
| Qwen 3.6 Plus | $3,25 |
| MiniMax M2.7 | $3,00 |
Chamando Todos os Quatro com Uma Chave de API
Todos os quatro modelos compartilham o mesmo endpoint compatível com OpenAI no Atlas Cloud. Alternar entre eles requer alterar uma linha:
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Altere esta única linha para trocar de modelos 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Você é um engenheiro de software sênior. Analise o código cuidadosamente antes de responder." 21 }, 22 { 23 "role": "user", 24 "content": "Revise esta função e identifique todos os bugs:\n\n[cole seu código aqui]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Esta estrutura compatível com OpenAI significa que integrações existentes construídas no SDK da OpenAI funcionam com o Atlas Cloud sem modificação — apenas o base_url e api_key mudam.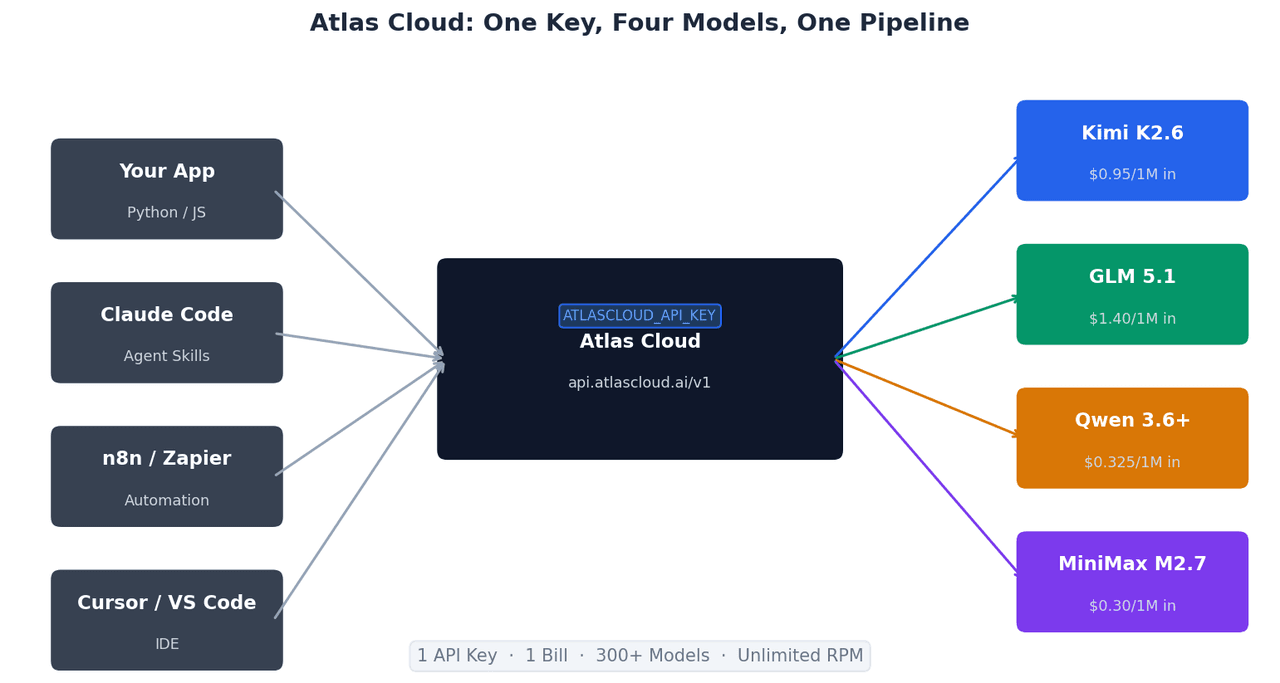
Por que Usar o Atlas Cloud para Estes Modelos
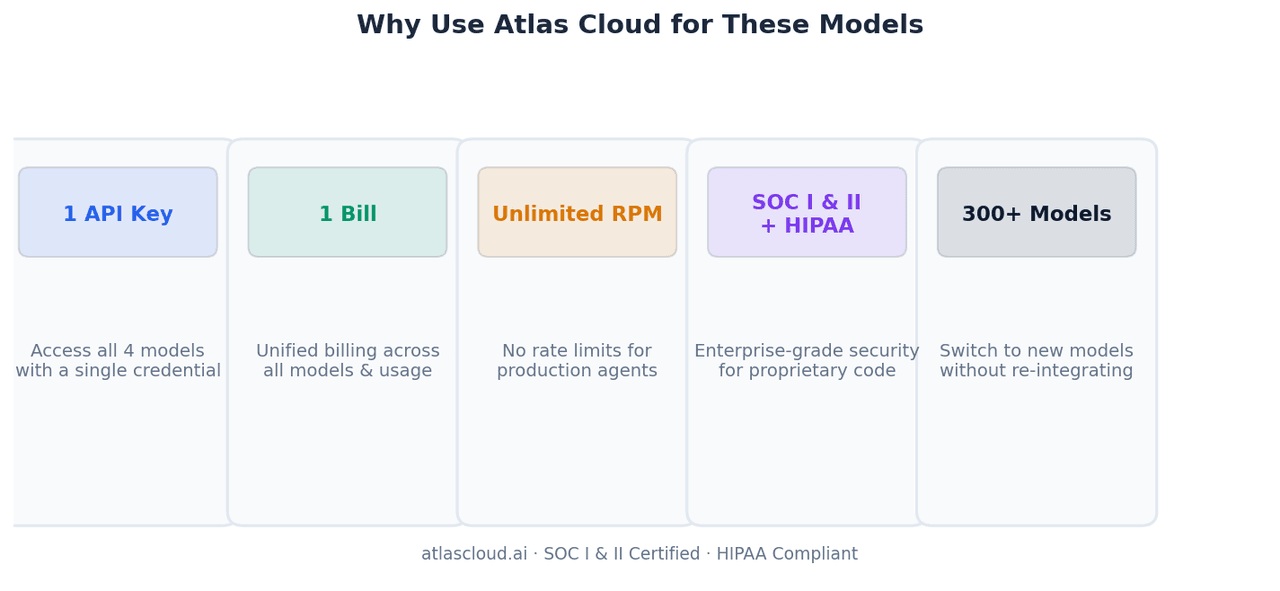
Uma chave de API, quatro modelos, uma fatura. Executar lógica de roteamento de modelos — enviar tarefas de front-end para o GLM-5.1, análise em lote para o MiniMax M2.7 e agentes de longo horizonte para o Kimi K2.6 — requer gerenciar uma credencial em vez de quatro. A reconciliação mensal é uma única fatura.
RPM ilimitado. Agentes de programação em produção disparam chamadas de ferramentas paralelas. Limites de taxa em APIs de provedores diretos podem limitar pipelines multiagentes. O Atlas Cloud remove esse teto.
Certificado SOC I & II, compatível com HIPAA. Equipes que processam código fonte proprietário através desses modelos precisam de infraestrutura auditável. As certificações de conformidade do Atlas Cloud significam que seu código não passa por endpoints não verificados.
300+ modelos, mesmo padrão de integração. Quando a próxima versão de qualquer um desses modelos for lançada, ou um novo modelo os superar em sua carga de trabalho específica, adicioná-lo à sua lógica de roteamento requer uma alteração de string — não uma nova integração de SDK.
Qual Modelo para Qual Tarefa
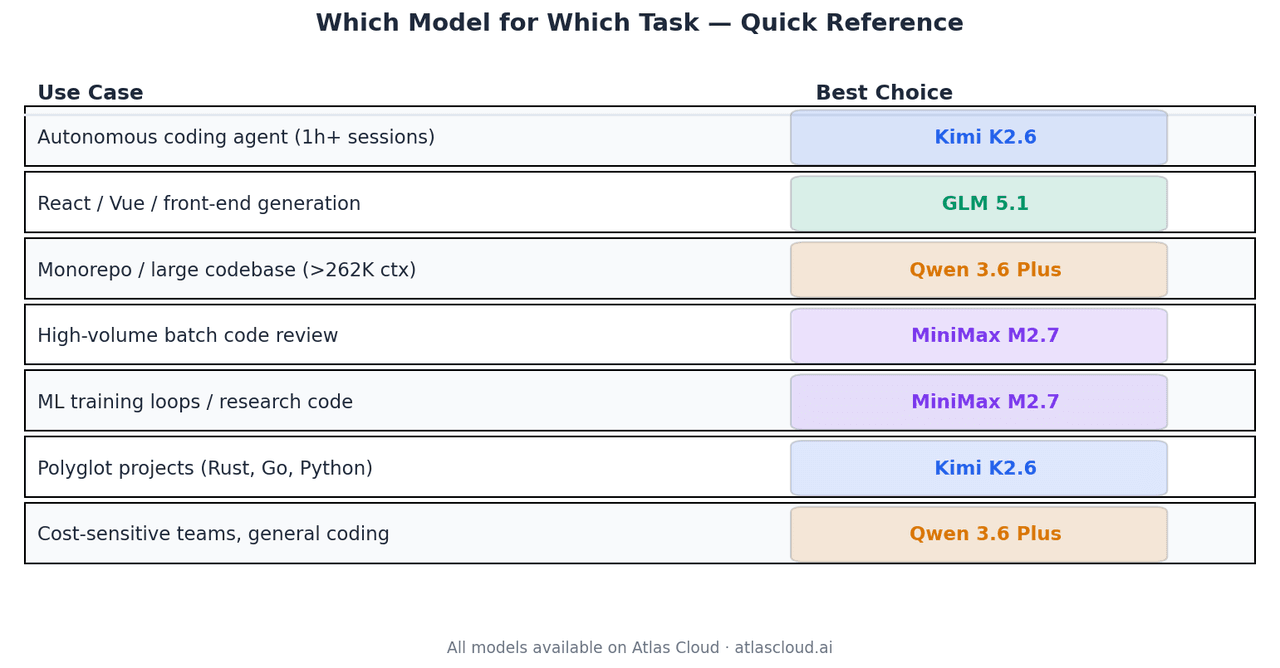
| Caso de Uso | Melhor Escolha | Porquê |
| Agente de programação autônomo, sessões 1+ hora | Kimi K2.6 | 66,7% Terminal-Bench 2.0, estabilidade de 4K+ chamadas de ferramentas |
| Geração React / Vue / front-end | GLM 5.1 | Code Arena Elo 1.530, top-3 em desenvolvimento web agêntico globalmente |
| Análise de monorepo ou base de código grande | Qwen 3.6 Plus | Único modelo aqui com janela de contexto de 1M |
| Revisão de código em lote de alto volume | MiniMax M2.7 | $0,30/M entrada, 94% da qualidade do GLM-5.1 |
| Loops de treinamento ML, código de pesquisa | MiniMax M2.7 | 66,6% de taxa de medalhas no MLE-Bench Lite |
| Projetos multilíngues (Rust, Go, Python) | Kimi K2.6 | Generalização entre linguagens documentada |
| Equipes sensíveis a custo, programação geral | Qwen 3.6 Plus | $0,325/M entrada, forte em todas as categorias |
Resumo
Estes quatro modelos são separados por margens estreitas em benchmarks padrão. As diferenças significativas surgem em condições específicas.
Kimi K2.6 é a resposta certa para agentes autônomos de longa duração. GLM 5.1 lidera para trabalho agêntico de front-end. Qwen 3.6 Plus é a única escolha quando o contexto excede 262K tokens. MiniMax M2.7 é o padrão econômico para equipes que executam modelos de programação em escala.
Todos os quatro estão disponíveis no Atlas Cloud em atlascloud.ai sob uma única chave de API, com preço por token e sem compromisso mínimo.
Dados de benchmark provenientes do blog técnico da Moonshot AI, documentação do desenvolvedor Z.AI, post de lançamento da equipe Qwen da Alibaba, página oficial do modelo MiniMax e avaliações independentes da Arena.ai. Todos os benchmarks são dados de abril de 2026. Preços do Atlas Cloud anotados na data da publicação — verifique as taxas atuais antes da implantação em produção.


