

Um teste de memória útil se parece menos com perguntar, “O que você lembra sobre mim?” e mais com uma verificação sem consulta, com uma correção e algumas distrações. Para executar um teste de Memória Ativa do Muse Wonder, forneça detalhes fictícios ao Muse Wonder em uma conversa, corrija um deles e depois pergunte pelos fatos atuais relevantes em uma conversa nova. Registre o que ele recupera, o que erra e se admite incerteza.
A sequência abaixo leva cerca de 10 minutos para configurar e pontuar. Isso não é prova de memória ao longo de dias, entre contas ou em todas as superfícies de produto da Muse. É uma primeira verificação repetível. Use detalhes inventados em vez de informações privadas.
Principais conclusões
- Teste recuperação, correções, resistência a distratores, incerteza e rastreabilidade separadamente.
- Execute o teste na superfície de produto que você pretende usar, com suas configurações de memória documentadas.
- Uma nova solicitação de API só testa memória persistente se o aplicativo ou serviço fornecê-la.
- O MemoryBench da Meta é uma avaliação interna muito mais longa; esta verificação curta não o reproduz.
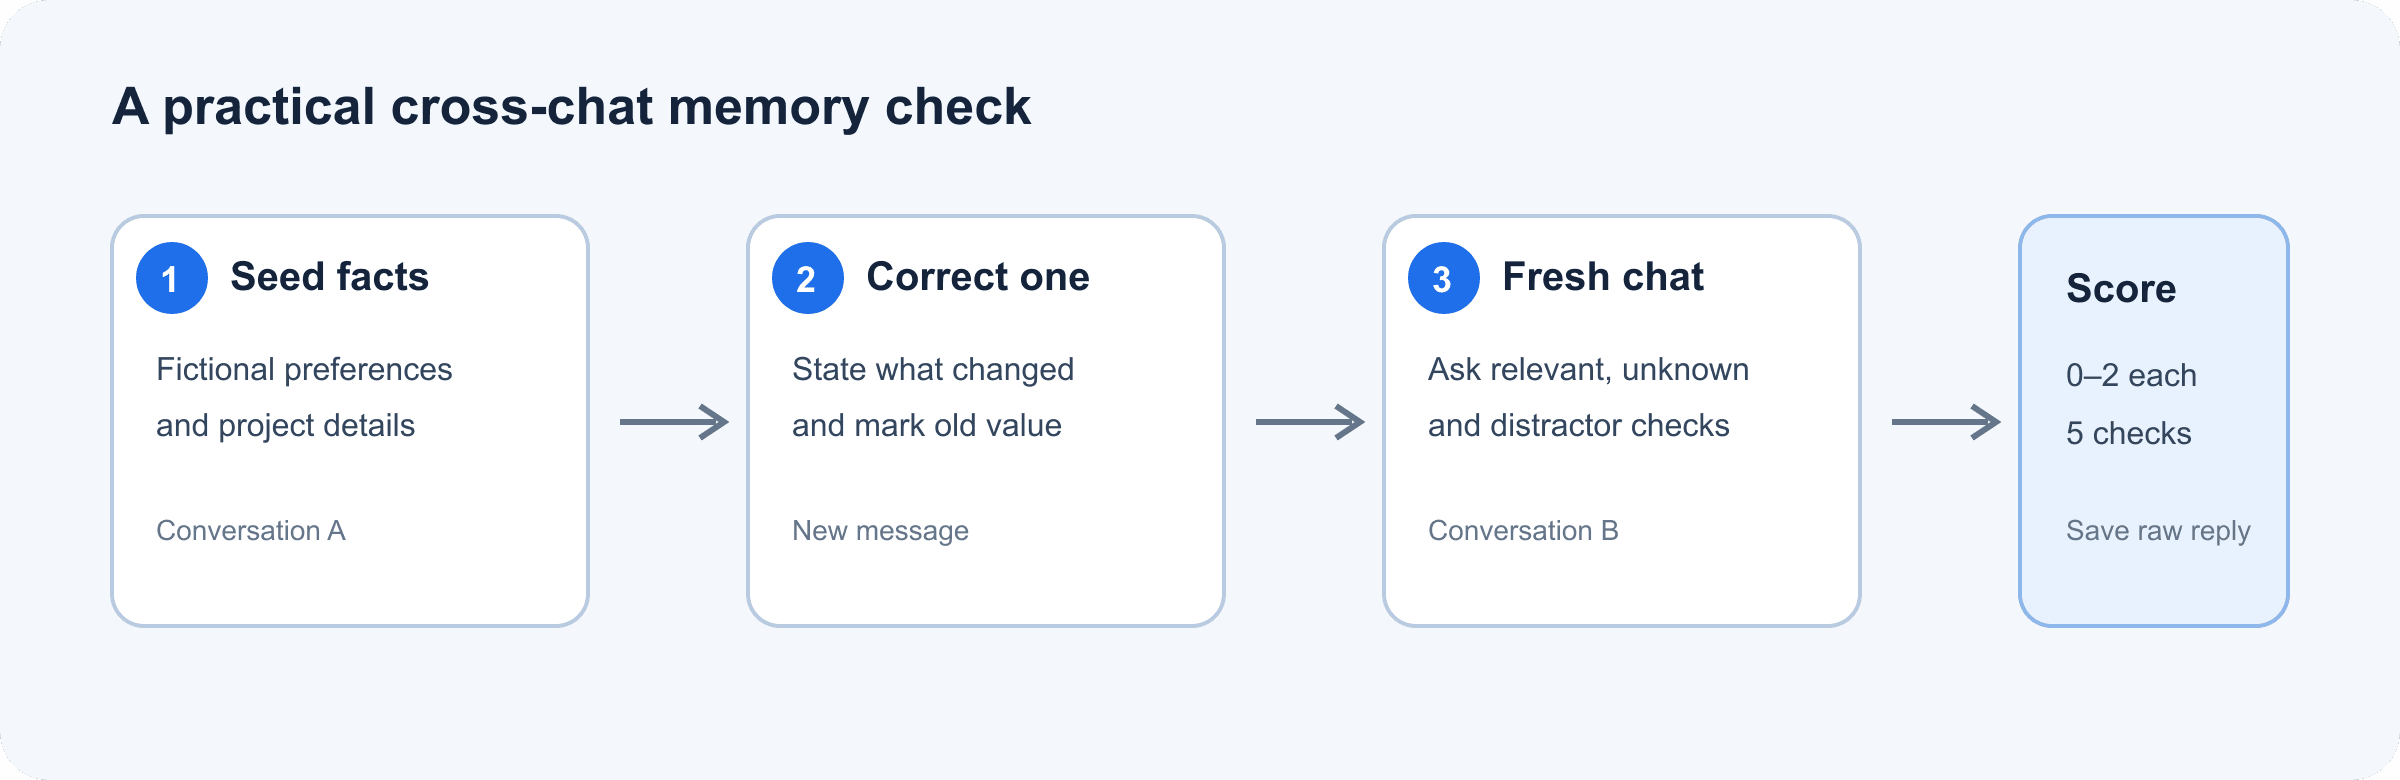
Fluxo do teste de Memória Ativa do Muse Wonder, de detalhes fictícios à correção, recuperação em conversa nova e pontuação
O fluxo de teste separa os fatos iniciais, uma correção explícita e a recuperação em uma nova conversa.
O que a Memória Ativa do Muse Wonder deve fazer
A Meta descreve a Memória Ativa como o carregamento de contexto importante sobre uma pessoa entre conversas e a recuperação de detalhes quando eles importam para uma tarefa posterior. O Foco Ativo refere-se ao trabalho contínuo em direção a um objetivo, incluindo tentar alternativas quando bloqueado e se adaptar a novas informações. Essas ideias estão relacionadas, mas respondem a perguntas diferentes: memória diz respeito a qual contexto é recordado; foco diz respeito a como o trabalho prossegue.
Essa descrição é uma alegação de capacidade do produto, não uma garantia de que toda interface ou chamada de API compartilhe automaticamente o histórico de um usuário. A Meta diz que o Muse Wonder está disponível por meio de sua Model API e do Muse Code. A documentação para desenvolvedores lista uma janela de contexto de 1.048.576 tokens e configurações de raciocínio compatíveis, mas uma janela de contexto é a quantidade de contexto que uma solicitação pode conter, não prova de que solicitações anteriores persistem. Verifique qual histórico ou memória o produto escolhido realmente fornece.
Como executar um teste de memória do Muse Wonder
Use uma única conta e a mesma variante de modelo durante uma execução. Para um produto de chat, ative o recurso de memória que você pretende avaliar e registre sua configuração. Para uma integração de API, observe se seu próprio aplicativo inclui turnos anteriores, um perfil armazenado ou notas recuperadas na solicitação. Sem essa informação, você não pode atribuir a recordação apenas ao modelo.
1. Forneça fatos relevantes
Na primeira conversa, cole este perfil fictício. Peça apenas uma confirmação, para que o modelo não transforme imediatamente os fatos em um plano.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Abra uma conversa genuinamente nova no mesmo produto e depois pergunte:
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Uma boa resposta usa a preferência por atividades ao ar livre tranquilas. Ela não precisa mencionar o orçamento ou frutos do mar, pois nenhum dos dois detalhes é necessário para sugerir uma atividade. Fique atento a preferências inventadas. Se o produto não consegue acessar chats anteriores ou a memória está desativada, registre “memória indisponível nesta superfície” em vez de pontuar o modelo como se ele tivesse recebido os fatos.
2. Corrija um fato desatualizado
Em outra conversa de teste, introduza um compromisso e depois substitua-o explicitamente. Mantenha a correção em uma mensagem separada para que você consiga saber se a atualização posterior prevalece.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Pergunte sobre isso em uma nova conversa:
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Considere aprovado se ele informar quinta-feira às 10h e tratar terça-feira como desatualizada. Uma resposta misturada ou o uso confiante de terça-feira é uma falha significativa, mesmo que ele tenha recordado perfeitamente o detalhe original.
3. Adicione distratores e teste o que é desconhecido
Adicione dois ou três fatos fictícios inofensivos à conversa inicial, como uma cor de projeto inventada ou um número de encomenda fictício. Após um intervalo, inicie uma nova conversa e faça uma pergunta sobre uma preferência relevante, além de uma sobre um fato que você nunca forneceu. Mantenha as perguntas separadas para que cada resposta seja fácil de pontuar.
Um resultado forte usa a preferência relevante, deixa de fora detalhes não relacionados e diz que não sabe o fato ausente. Para um teste de intervalo mais rigoroso, repita o mesmo prompt no dia seguinte. Dez minutos podem verificar o limite de uma nova conversa, mas não podem estabelecer retenção de uma semana.
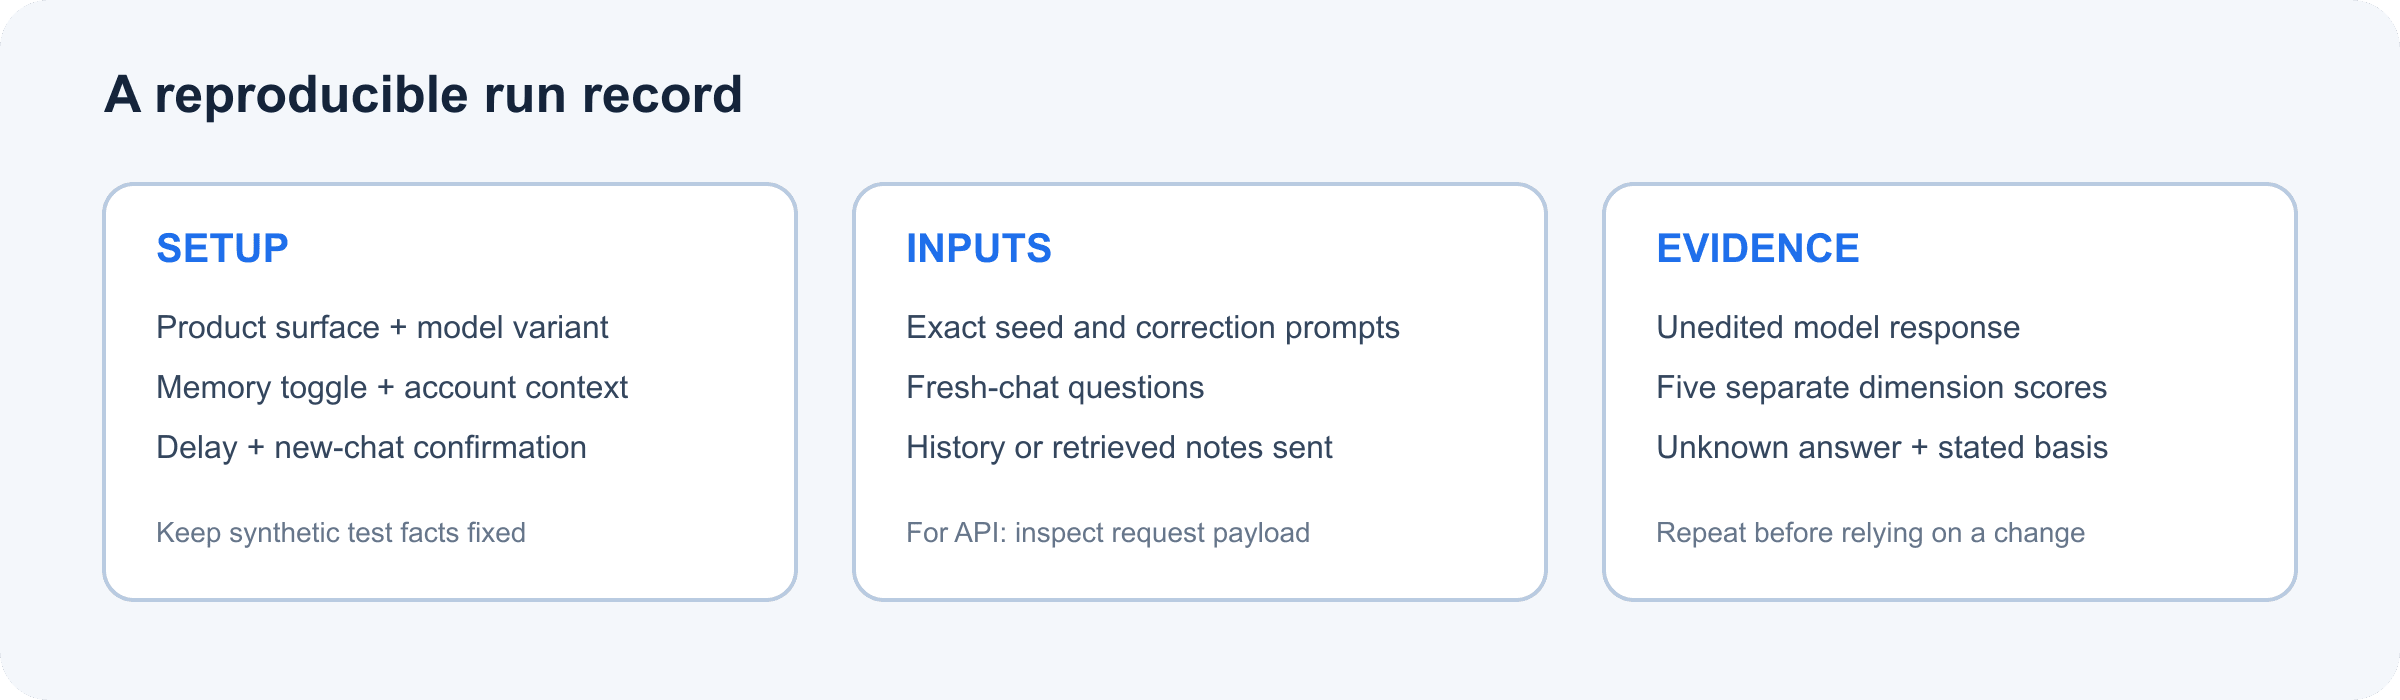
Cartão de teste de Memória Ativa do Muse Wonder mostrando configuração, perguntas em conversa nova e evidências a registrar
Mantenha o prompt, a superfície de produto, a configuração de memória, o intervalo e a resposta bruta juntos para que outro revisor possa reproduzir a verificação.
Como pontuar o teste de Memória Ativa
Pontue cada comportamento de 0 a 2. Use o resultado para comparar execuções em seu próprio fluxo de trabalho, não para classificar modelos de forma universal.
| Dimensão | 0 pontos | 1 ponto | 2 pontos |
|---|---|---|---|
| Recuperação de fatos relevantes | Erra ou inventa o fato necessário | Parcialmente correto | Seleciona o fato certo com precisão |
| Tratamento de correções | Usa o valor antigo | Vago ou mistura os dois | Usa o valor mais recente e identifica o antigo como desatualizado |
| Controle de distratores | É atraído por fatos irrelevantes | Inclui algum detalhe irrelevante | Usa apenas contexto relevante para a pergunta |
| Incerteza | Chuta com confiança | Usa ressalvas, mas ainda chuta | Diz claramente que a resposta não foi fornecida |
| Rastreabilidade | Não dá base | Nomeia apenas parte de sua base | Lista brevemente o contexto em que se baseou |
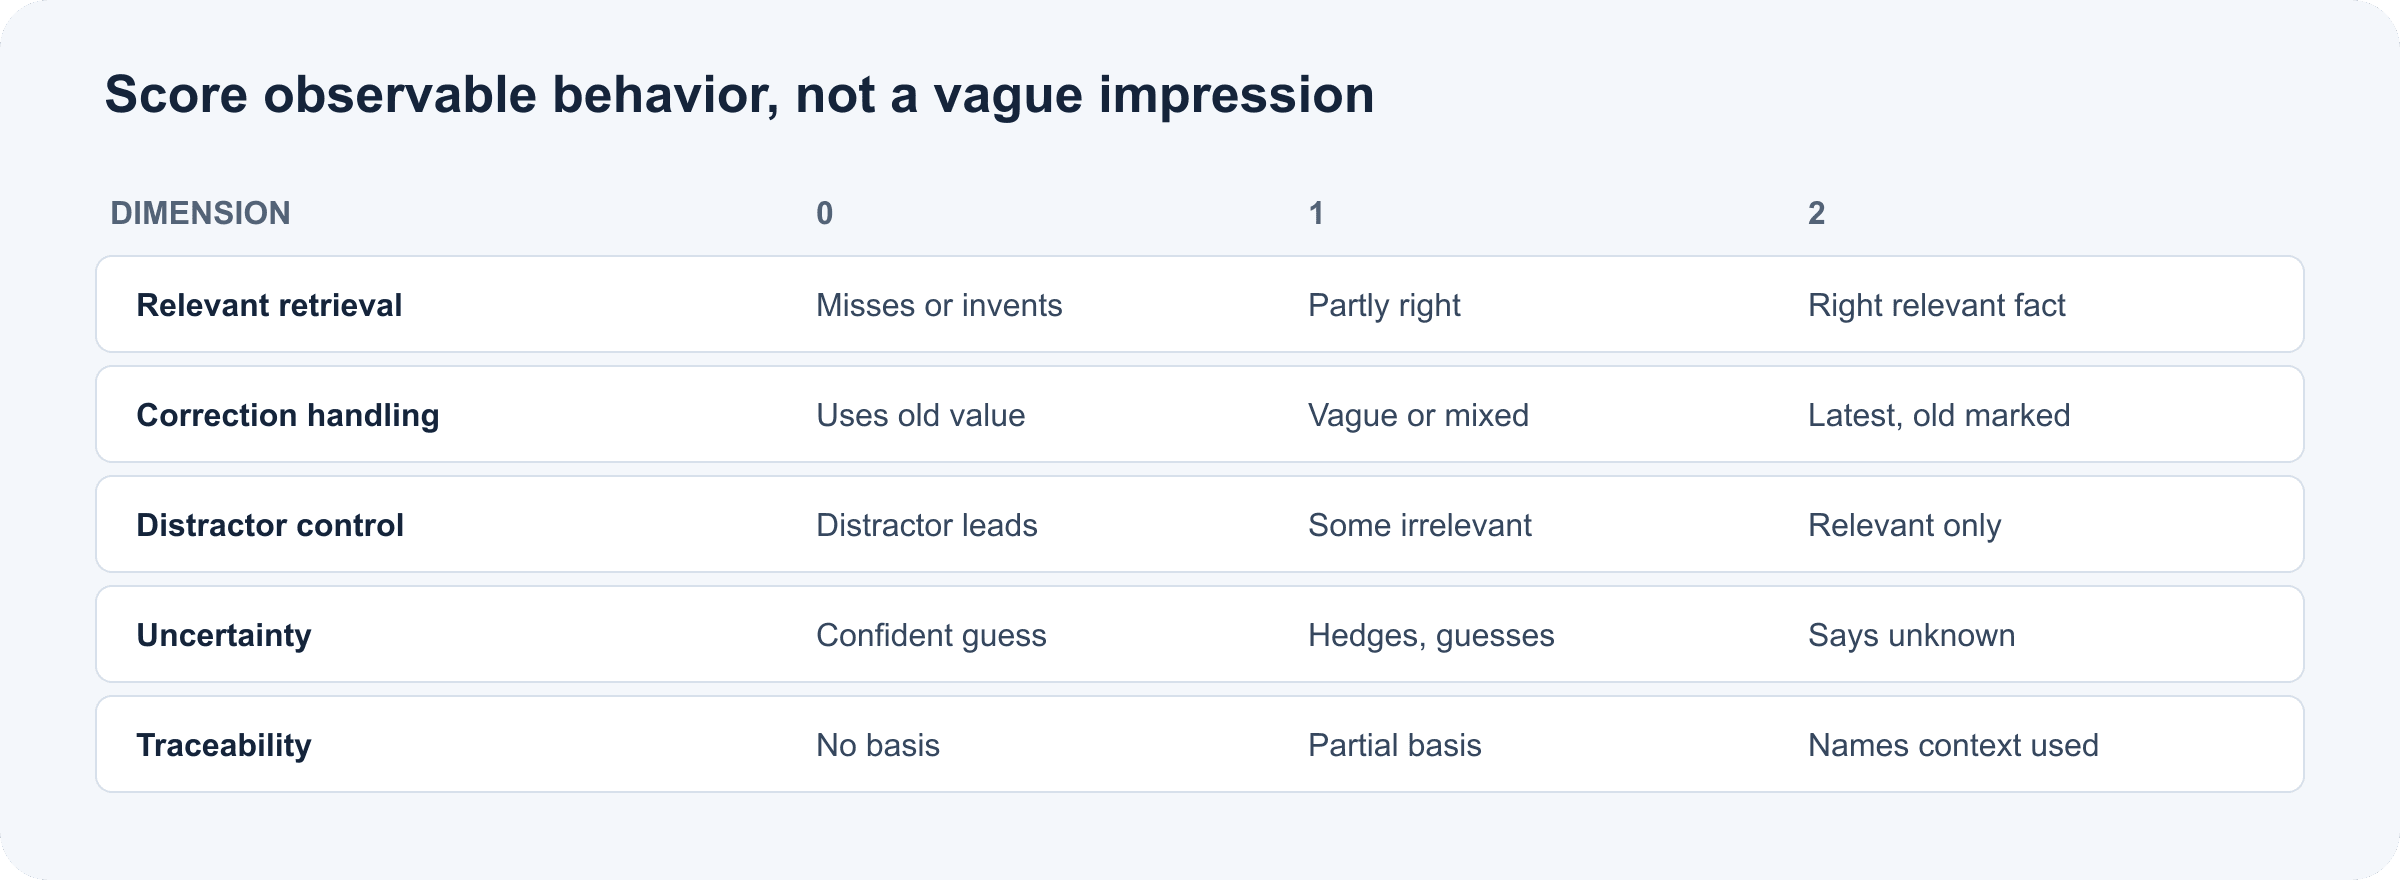
Cinco dimensões de pontuação da Memória Ativa, de zero a dois pontos, com critérios de aprovação observáveis
A rubrica de 0–2 transforma uma impressão subjetiva em cinco verificações observáveis.
Dez pontos é uma pontuação interna conveniente, não um limiar validado. Mantenha as pontuações individuais por dimensão: um total pode esconder uma falha séria de correção atrás de uma boa recordação em outro ponto. Salve os prompts exatos e as saídas não editadas, depois repita a execução antes de mudar sua decisão de implantação.
O que o MemoryBench pode e não pode dizer a você
O model card da Meta descreve o MemoryBench como uma avaliação interna sobre conversas longas e complexas de 64K a 100K tokens. Suas tarefas incluem múltiplos fatos, conversas com distratores e turnos injetados que entram em conflito com detalhes-alvo ou os atualizam depois; um juiz LLM pontua as respostas segundo critérios ponderados e específicos por pergunta. Esse é um contexto útil para entender o escopo do benchmark, mas não é o mesmo que a configuração de memória pessoal de um usuário funcionando entre chats.
O model card explica o design da tarefa; ele não transforma este exercício de 10 minutos em uma replicação. A pontuação publicada pela Meta é evidência sobre a configuração de avaliação relatada. Sua execução responde a uma pergunta operacional mais restrita: esta superfície de produto, configuração e conta específicas recuperam os fatos de que seu fluxo de trabalho precisa? Nenhum dos dois, isoladamente, estabelece memória confiável para todo usuário ou tarefa.
Muse Wonder vs. Muse Wonder Full: onde testar
As duas variantes não têm rotas de acesso idênticas. A documentação atual para desenvolvedores da Meta diz que o Muse Wonder (muse-wonder-1.0) está disponível na Model API e no Muse Code. O Muse Wonder Full está disponível apenas no Muse Code nos planos Power Usage e Maximum Usage. Definir o esforço de raciocínio do Muse Wonder como “max” não o alterna para o Wonder Full.
| Variante | Acesso documentado | O que registrar |
|---|---|---|
| Muse Wonder | Model API e Muse Code | ID do modelo na API ou superfície do Muse Code, além de se o contexto anterior é fornecido |
| Muse Wonder Full | Muse Code nos planos Power Usage e Maximum Usage | Plano, variante selecionada e configuração de memória disponível nessa superfície |
Execute o mesmo perfil fictício separadamente em cada superfície disponível. Não compare um teste do Muse Code que consegue recuperar detalhes de perfil salvos com uma chamada de API sem estado que recebeu apenas o prompt atual. Isso compararia sistemas diferentes, não apenas duas variantes de modelo.
Privacidade e testes repetíveis
Use preferências, datas e detalhes de projeto inventados. Antes de experimentar dados reais, inspecione os controles de memória do produto, o caminho de exclusão, as informações de retenção e a configuração de uso de dados. A documentação da API da Meta diz que o conteúdo no modo Standard não é usado para treinar modelos da Meta; o Muse Code também oferece o modo Contributor, que fica ativado por padrão e pode usar conteúdo para treinamento, a menos que seja desativado. Verifique as configurações e os termos atuais do produto que você usa, em vez de presumir que todas as superfícies tratam os dados da mesma forma.
Para uma API, separe o modelo da camada de memória do seu aplicativo. Um banco de dados, sistema de recuperação ou histórico de prompts que seu software envia pode estar fazendo a recordação. Registre o que o aplicativo recuperou e o que ele passou em cada solicitação, mantendo os registros de teste sintéticos.
As equipes podem transformar as três rodadas em um pequeno conjunto de avaliação versionado. Mantenha fixos o perfil de fatos, a correção, os distratores, a variante do modelo, as configurações do produto, o intervalo e a resposta bruta. Execute novamente após mudanças de configuração ou de modelo e revise as falhas por dimensão. Para equipes que já comparam modelos hospedados em um harness repetível, o Atlas Cloud fornece um catálogo e um guia unificado de API de LLM. Você pode navegar pelo diretório de modelos para uma comparação separada. O diretório atualmente não lista o Muse Wonder, e usar outro modelo ali testaria apenas o contexto explicitamente fornecido a esse modelo, a menos que seu aplicativo adicione uma camada de memória.
Perguntas frequentes
Como testo a Memória Ativa do Muse Wonder entre chats?
Forneça fatos fictícios em uma conversa e depois pergunte sobre detalhes relevantes em uma nova conversa. Inclua uma correção e um fato ausente, e registre a superfície de produto e as configurações de memória.
O Muse Wonder lembra correções ou apenas detalhes anteriores?
A descrição do MemoryBench da Meta inclui turnos que atualizam detalhes anteriores ou entram em conflito com eles. Seu próprio teste de correção verifica se a configuração atual do produto segue a atualização; repita-o, pois um único resultado não estabelece comportamento consistente.
Este teste de histórico de chat é o mesmo que o MemoryBench da Meta?
Não. A Meta descreve o MemoryBench como um benchmark interno de contexto longo que usa conversas de 64K a 100K tokens, distratores, fatos conflitantes ou atualizados e um juiz LLM. Esta verificação curta é um smoke test prático, não uma replicação.
Posso testar a Memória Ativa do Muse Wonder por meio da API?
Você pode testar a recordação do modelo da API em relação ao contexto que chega à solicitação. Para persistência entre solicitações, verifique o que a API ou seu aplicativo armazena e envia. A disponibilidade de uma janela de contexto grande não mostra, por si só, que solicitações separadas compartilham memória.
Como distingo a memória do modelo da memória armazenada pelo aplicativo?
Inspecione a solicitação completa enviada ao modelo. Se seu aplicativo insere um perfil, uma nota recuperada ou uma conversa anterior, essa camada de software forneceu a memória. Compare com uma execução controlada que a omite, quando apropriado.
É seguro usar informações pessoais em um teste de Memória Ativa?
Use informações fictícias para o teste. Se você depois avaliar dados reais, revise primeiro as configurações de memória, exclusão, retenção e uso de dados do produto específico.
Um teste de memória ativa do Muse Wonder é mais útil quando expõe qual etapa falhou: acesso ao contexto anterior, recuperação, correção, filtragem ou incerteza. Salve a execução bruta e depois repita-a na configuração exata em que você pretende confiar.
Fontes: Anúncio do Muse Wonder da Meta (12 de outubro de 2026); Documentação do modelo da Model API da Meta (acessado em 15 de outubro de 2026); Model Card do Muse Wonder (outubro de 2026).





