

Uma vantagem em benchmarks pode parecer decisiva até que o mesmo modelo deixe de atender a um requisito na execução seguinte. Um teste de confiabilidade do Muse Wonder útil faz uma pergunta mais estreita: o modelo conclui sua tarefa, segundo o seu padrão, repetidamente, sob as mesmas condições?
As evidências iniciais são mistas porque os testes medem coisas diferentes. Um conjunto de tarefas do dia de lançamento deu ao Muse Wonder padrão uma pontuação muito alta após uma execução por tarefa. Outra avaliação encontrou pontos fortes em análise de pesquisa, ao lado de fraquezas em design de pesquisa, alegações de vendas e layout de slides. Nenhum dos resultados prova quão consistentemente ele lidará com sua base de código ou fluxo de trabalho de agente.
Principais conclusões
- Trate benchmarks de lançamento como sinais de capacidade, não como garantias de produção.
- Muse Wonder e Muse Wonder Full são variantes separadas. Mantenha os resultados delas separados.
- Meça taxa de aprovação, repetibilidade, conclusão e recuperação como resultados diferentes.
- Comece com 10 a 20 tarefas reais, congele a configuração e repita tarefas importantes pelo menos três vezes.
- Escolha um limite com base no custo de uma resposta errada e no seu processo de revisão humana.
O Muse Wonder é confiável? A resposta curta
As evidências disponíveis em 15 de outubro de 2026 sustentam uma avaliação tarefa por tarefa, não um veredito universal de confiabilidade. O Muse Wonder teve bom desempenho em algumas verificações iniciais, enquanto outras execuções expuseram erros ou trabalho de apresentação que ainda precisava de revisão. Os estudos diferem em prompts, configurações de raciocínio, avaliadores, tamanhos de amostra e número de tentativas.
(Meta, 12 de outubro de 2026) afirma que Muse Wonder e Muse Wonder Full foram criados para tarefas de agente profissionais e pessoais, com recursos que ela chama de Active Memory e Active Focus. Essas são alegações de produto sobre o comportamento pretendido. A alegação de que um modelo consegue se recuperar de erros é um motivo para testar a recuperação no seu próprio fluxo de trabalho, não uma prova de que ele vai se recuperar de forma confiável.
Mantenha o Wonder padrão separado do Wonder Full. A Meta lista o Muse Wonder padrão para sua Model API e o Muse Code, enquanto o Full é oferecido por assinaturas do Muse Code. Executar o Wonder padrão com uma configuração de raciocínio mais alta não o torna o Full.
Para tomar uma decisão defensável, teste a variante e a rota exatas que pretende implantar. Considere uma tarefa bem-sucedida apenas quando ela atender a uma regra de aceitação escrita e seu resultado puder ser verificado.
O que um teste de confiabilidade do Muse Wonder deve medir
Precisão e consistência são diferentes
Uma taxa de aprovação mede quantas tentativas atendem a uma rubrica definida. A consistência mede se execuções repetidas da mesma tarefa produzem resultados aceitáveis a cada vez. Um modelo pode ter uma alta taxa de aprovação e ainda variar de maneiras que importam para o seu fluxo de trabalho.
Acompanhe quatro dimensões separadamente:
| Medida | O que registrar | Exemplo de verificação |
|---|---|---|
| Precisão | Tentativas que passam na rubrica | O total extraído corresponde ao documento de origem? |
| Consistência | Se tentativas repetidas passam e concordam | Três execuções preservam as mesmas restrições exigidas? |
| Qualidade de conclusão | Se todos os entregáveis solicitados estão presentes | Todos os arquivos, citações e campos solicitados estão incluídos? |
| Recuperação | Se a execução é retomada corretamente após uma falha | Ela relata uma falha de ferramenta, tenta novamente com segurança e então verifica o estado final? |
Uma resposta que soa completa não é necessariamente completa. Uma alteração de código precisa de testes; um resumo de pesquisa precisa de fontes rastreáveis; uma execução de agente precisa de evidências de que sua ação final aconteceu.
Separe falhas do modelo de falhas do fluxo de trabalho
Registre contexto suficiente para distinguir um erro do modelo de um problema de serving ou de ferramenta. No mínimo, registre a variante e a versão do modelo, a configuração de raciocínio, o prompt, a configuração de ferramentas, a data, o tempo de execução, o custo de tokens ou da tarefa e a saída bruta.
Classifique as falhas antes de pontuá-las:
- Modelo: fato incorreto, raciocínio ruim ou requisito não atendido.
- Ferramenta: chamada de API com falha, argumentos de ferramenta inválidos ou resultado incorreto de um sistema externo.
- Serving: timeout, interrupção ou endpoint indisponível.
- Avaliação: rubrica pouco clara ou uma verificação que não consegue distinguir trabalho aceitável de inaceitável.
Se você combinar as quatro em uma única taxa de falha, não saberá o que corrigir.
O que os testes atuais do Muse Wonder mostram
As comparações de benchmark publicadas pela Meta são evidências do fornecedor sobre o desempenho em benchmarks. Elas não são o mesmo que uma avaliação de fluxo de trabalho executada de forma independente. Testes independentes também têm limites: um pequeno conjunto de tarefas públicas, uma tentativa, uma rota de modelo específica ou uma avaliação de preferência humana respondem apenas a uma pergunta estreita.
A tabela abaixo separa as evidências por fonte e escopo. Ela é um guia do que cada resultado pode sustentar, não uma pontuação combinada.
| Fonte de evidência | O que testou | Data e configuração | O que pode lhe dizer | Principal limite |
|---|---|---|---|---|
| Anúncio da Meta e materiais do modelo | Benchmarks de capacidade e recursos de agente pretendidos | Anunciado em 12 de outubro de 2026; comparações relatadas pelo fornecedor | Quais capacidades a Meta enfatiza e quais variantes ela lançou | Testes do fornecedor não estabelecem repetibilidade no seu fluxo de trabalho |
| (Spring Prompt, 13 de outubro de 2026) | Pesquisas, listagens de produtos, slides, planejamento de anúncios, xadrez e busca visual | 13 de outubro; modelo padrão de API, geralmente raciocínio médio; tarefas públicas | O desempenho variou por tarefa; algumas avaliações incluíram execuções repetidas de listagens de produtos | A maioria das tarefas era de amostras pequenas; muitos resultados foram de uma execução por tarefa; não é um teste de codificação ou do Muse Code |
| (Quantslant, 12 de outubro de 2026) | 23 tarefas abrangendo agentes, codificação, escrita, raciocínio e um documento longo | 12 de outubro; modelo padrão via OpenRouter, raciocínio baixo; uma execução por tarefa | O modelo passou nesse conjunto de tarefas definido a uma alta taxa sob essa configuração | Uma única execução não consegue medir a consistência entre execuções; resultados próximos de 100% precisam de inspeção no nível da tarefa |
| Publicações da comunidade | Reações individuais a codificação, agentes e benchmarks | Publicações do período de lançamento; usuários e tarefas autosselecionados | Pistas úteis sobre o que testar em seguida | Anedotas e votos não são taxas de aprovação medidas |
O contraste entre as fontes importa. A Quantslant relatou 99,7% em seu conjunto de 23 tarefas, com uma execução por tarefa e uma configuração de raciocínio baixa. Ela também observou um teste de unidade com falha em uma tarefa de codificação de número para palavras. Esse resultado é evidência sobre aquela suíte específica, não evidência de que 99,7% das tarefas cotidianas serão aprovadas ou de que execuções repetidas concordarão.
O Spring Prompt relatou um quadro mais variado para o Wonder padrão com os padrões da API em 13 de outubro. Sua pontuação de análise de pesquisa foi 93,6/100 em nove tarefas públicas, enquanto apenas três de nove planos de pesquisa passaram em todas as verificações. Para listagens de produtos, a proporção considerada confiável e pronta para publicação em três repetições foi de 66,1% para briefings factuais e 51,8% para briefings de vendas. Cinco de seis apresentações de slides precisavam de correções de layout, e uma foi considerada apresentável. Essas são medidas separadas com denominadores separados, não partes de uma pontuação geral.
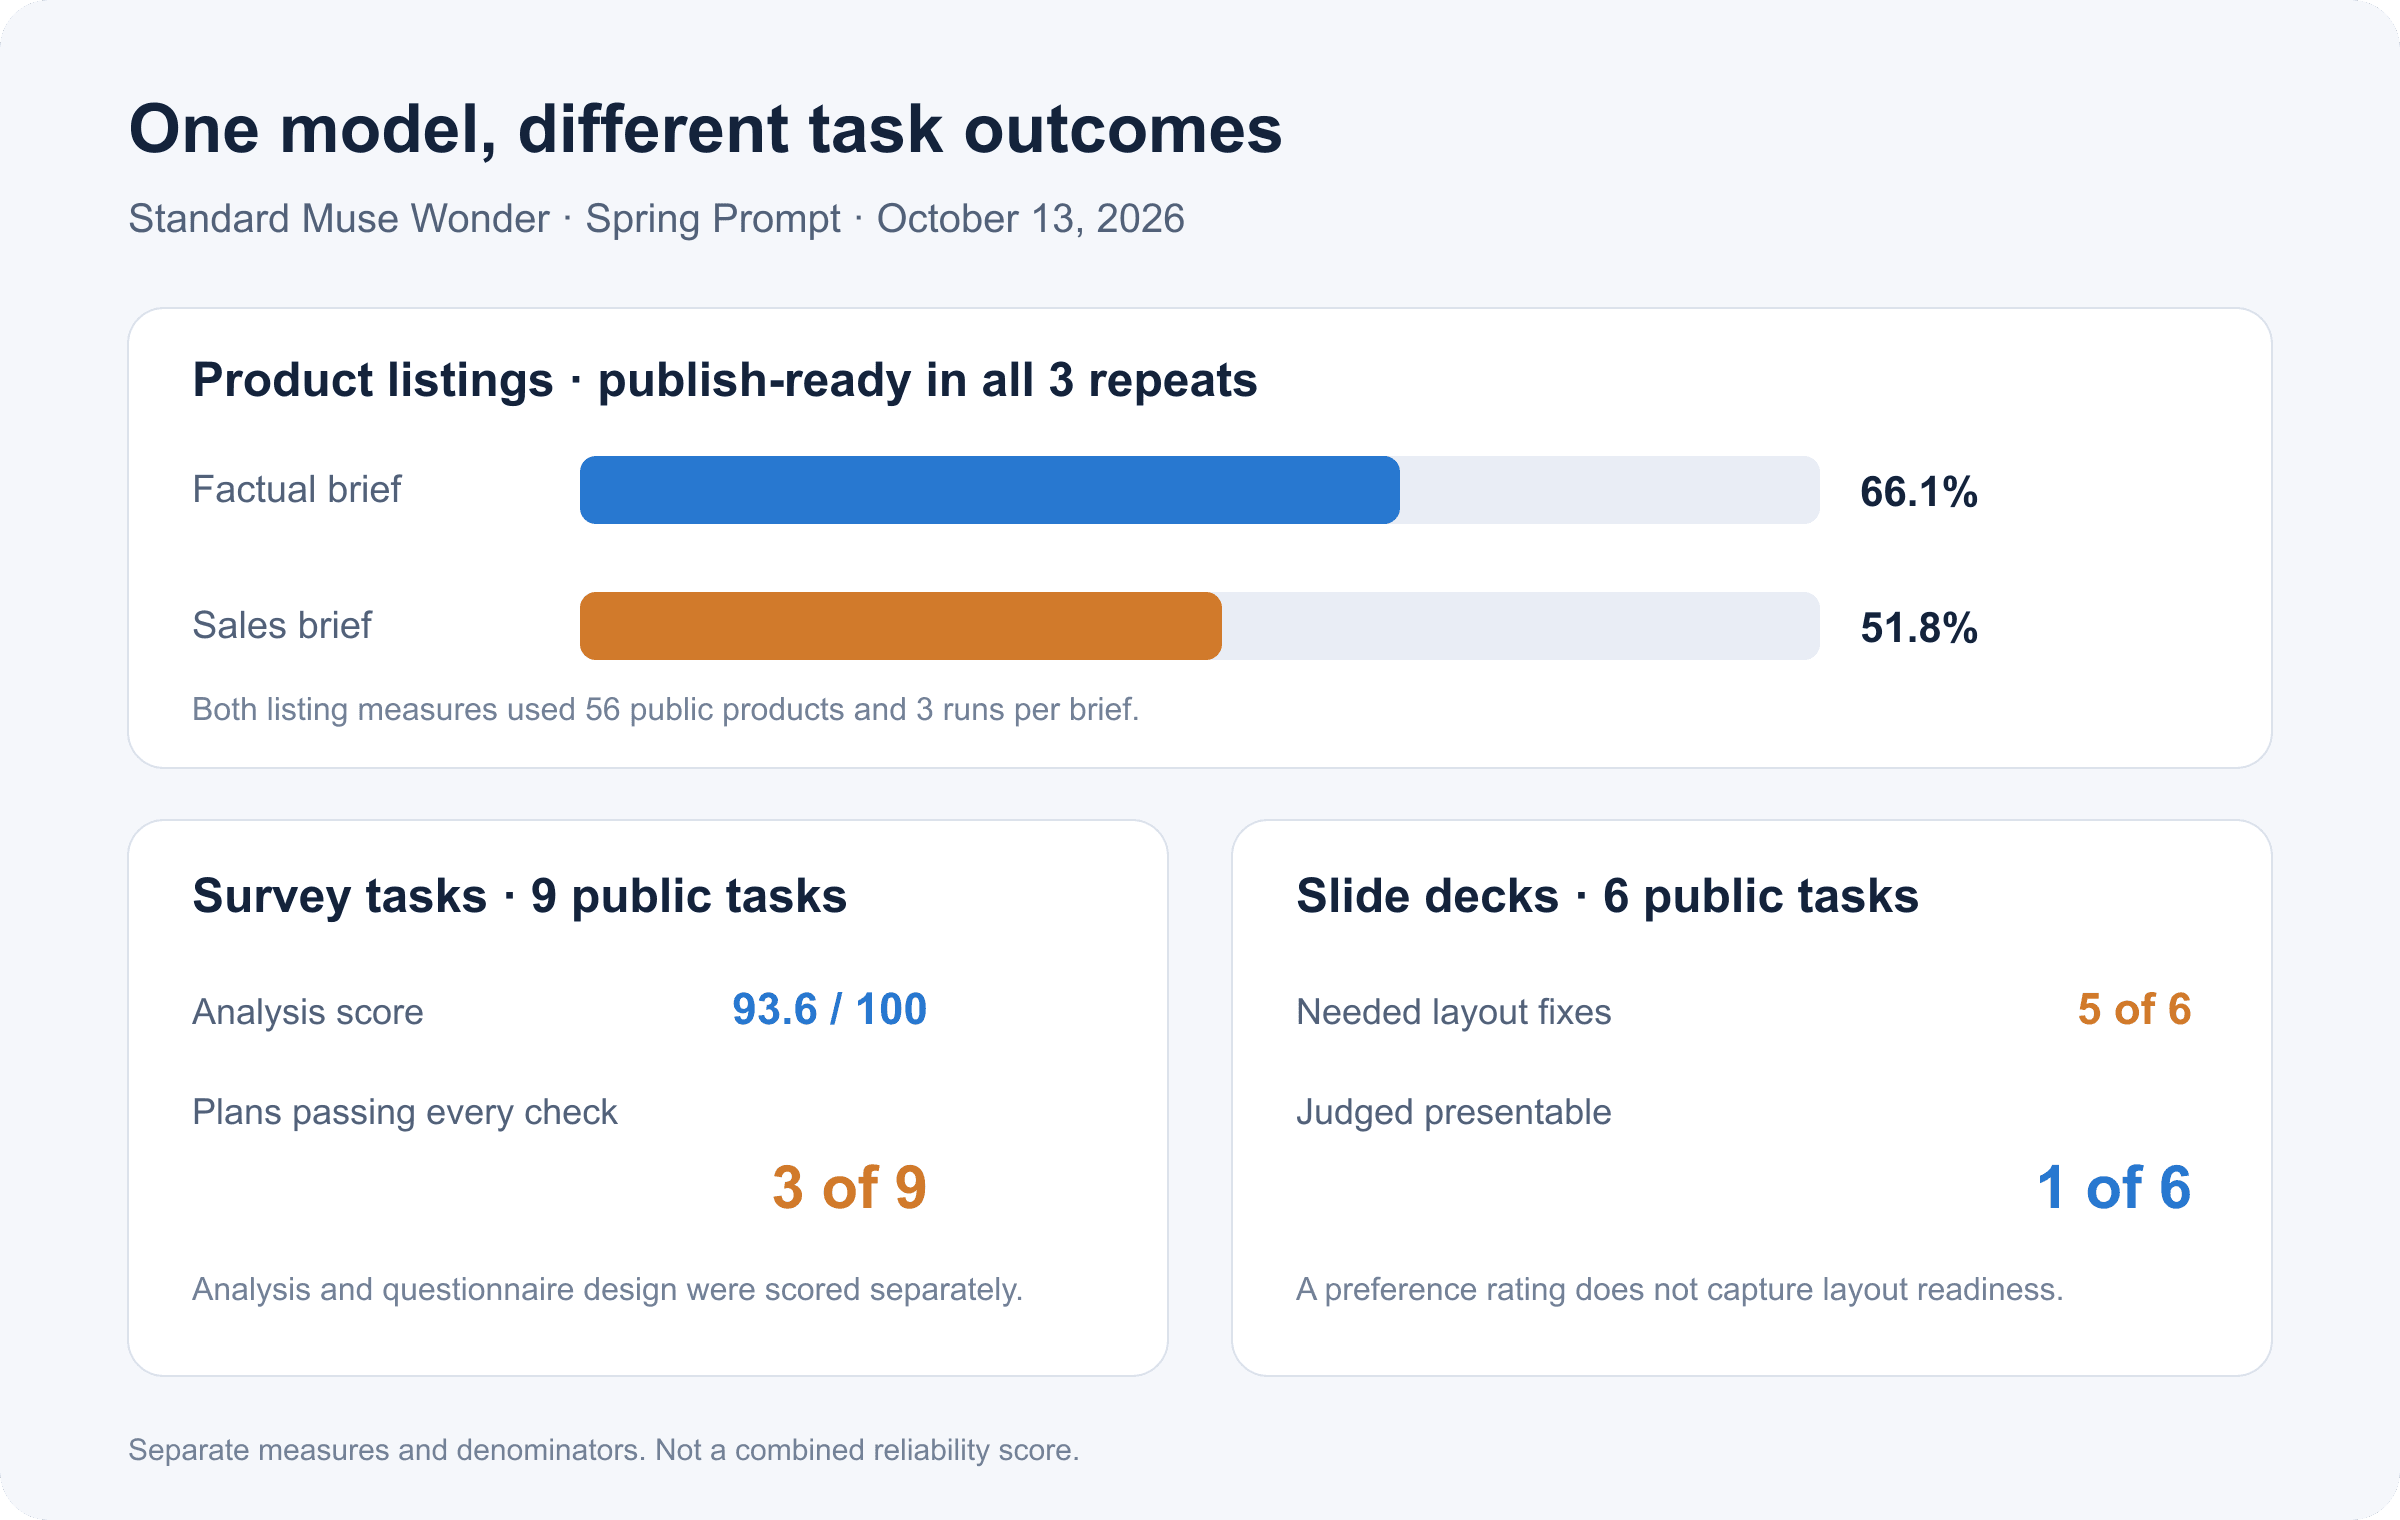
Resultados do Muse Wonder padrão do Spring Prompt em 13 de outubro de 2026: taxas de aprovação de listagens testadas repetidamente, análise de pesquisa e resultados de revisão de apresentações
Resultados de tarefas independentes de uma avaliação. As medidas usam denominadores diferentes e são mostradas separadamente, não combinadas em uma pontuação.
Os testes do Spring Prompt não mediram codificação, memória persistente ou Muse Code. Sua comparação, portanto, não pode resolver se o Wonder é confiável para codificação ou se o Full tem melhor desempenho. Ela mostra por que um único rótulo amplo esconde diferenças importantes entre tarefas.
O artigo de lançamento da Meta diz que o Muse Wonder padrão está disponível por meio da Meta Model API e do Muse Code, enquanto o Wonder Full está disponível para assinantes do Muse Code. Ele descreve Active Memory e Active Focus como recursos para reter detalhes úteis e continuar o trabalho apesar de erros. Essas descrições ajudam a definir casos de teste, mas o artigo de lançamento não é um estudo independente de execuções repetidas.
Para alegações de codificação e construção 3D discutidas em tópicos da comunidade na semana de lançamento, trate as publicações como hipóteses. Transforme uma reclamação específica em uma tarefa reproduzível e verifique a saída. Não converta comentários ou upvotes em uma taxa de sucesso.
Como executar um teste de confiabilidade do Muse Wonder repetível
1. Monte um pequeno conjunto de tarefas a partir de trabalho real
Escolha de 10 a 20 tarefas que sua equipe realmente espera que o modelo execute. Divida-as em categorias como codificação, extração factual, seguimento de instruções, contexto longo e uso de ferramentas. Prefira tarefas com testes objetivos, respostas de referência ou uma rubrica clara.
Inclua casos extremos realistas: entrada ausente, requisitos conflitantes, uma ferramenta indisponível e uma tarefa que deve acionar uma pergunta de esclarecimento. Deixe de fora dados sensíveis ou regulamentados, a menos que seu processo aprovado permita.
2. Congele o prompt, o modelo e as configurações
Anote o prompt exato e as instruções de sistema. Registre o nome e a versão do modelo, o nível de raciocínio, as ferramentas, o contexto fornecido, a data e qualquer limite de tempo. Não compare o Wonder padrão com o Full como se fossem o mesmo modelo.
Um prompt de teste útil pode pedir ao modelo que mostre suas evidências e identifique requisitos não testáveis:
Leia a especificação e a implementação anexadas. Retorne apenas: (1) cada requisito marcado como PASS, FAIL ou NOT TESTABLE; (2) a evidência exata para cada status; (3) qualquer requisito ausente; (4) um teste reproduzível mínimo para cada FAIL. Não afirme que um teste passou a menos que você possa apontar para a saída dele.
Esta é uma entrada de avaliação, não uma garantia de que o modelo a seguirá. Pontue a resposta resultante e verifique de forma independente qualquer saída de teste alegada.
3. Repita tarefas e pontue cada tentativa
Execute cada tarefa de alto impacto pelo menos três vezes com a mesma configuração. Se o orçamento permitir apenas uma tentativa, rotule o resultado como amostra inicial em vez de resultado de consistência. Preserve cada resposta bruta; não relate apenas a melhor.
Use uma linha para cada tentativa. Mantenha a regra de aceitação estável entre as execuções.
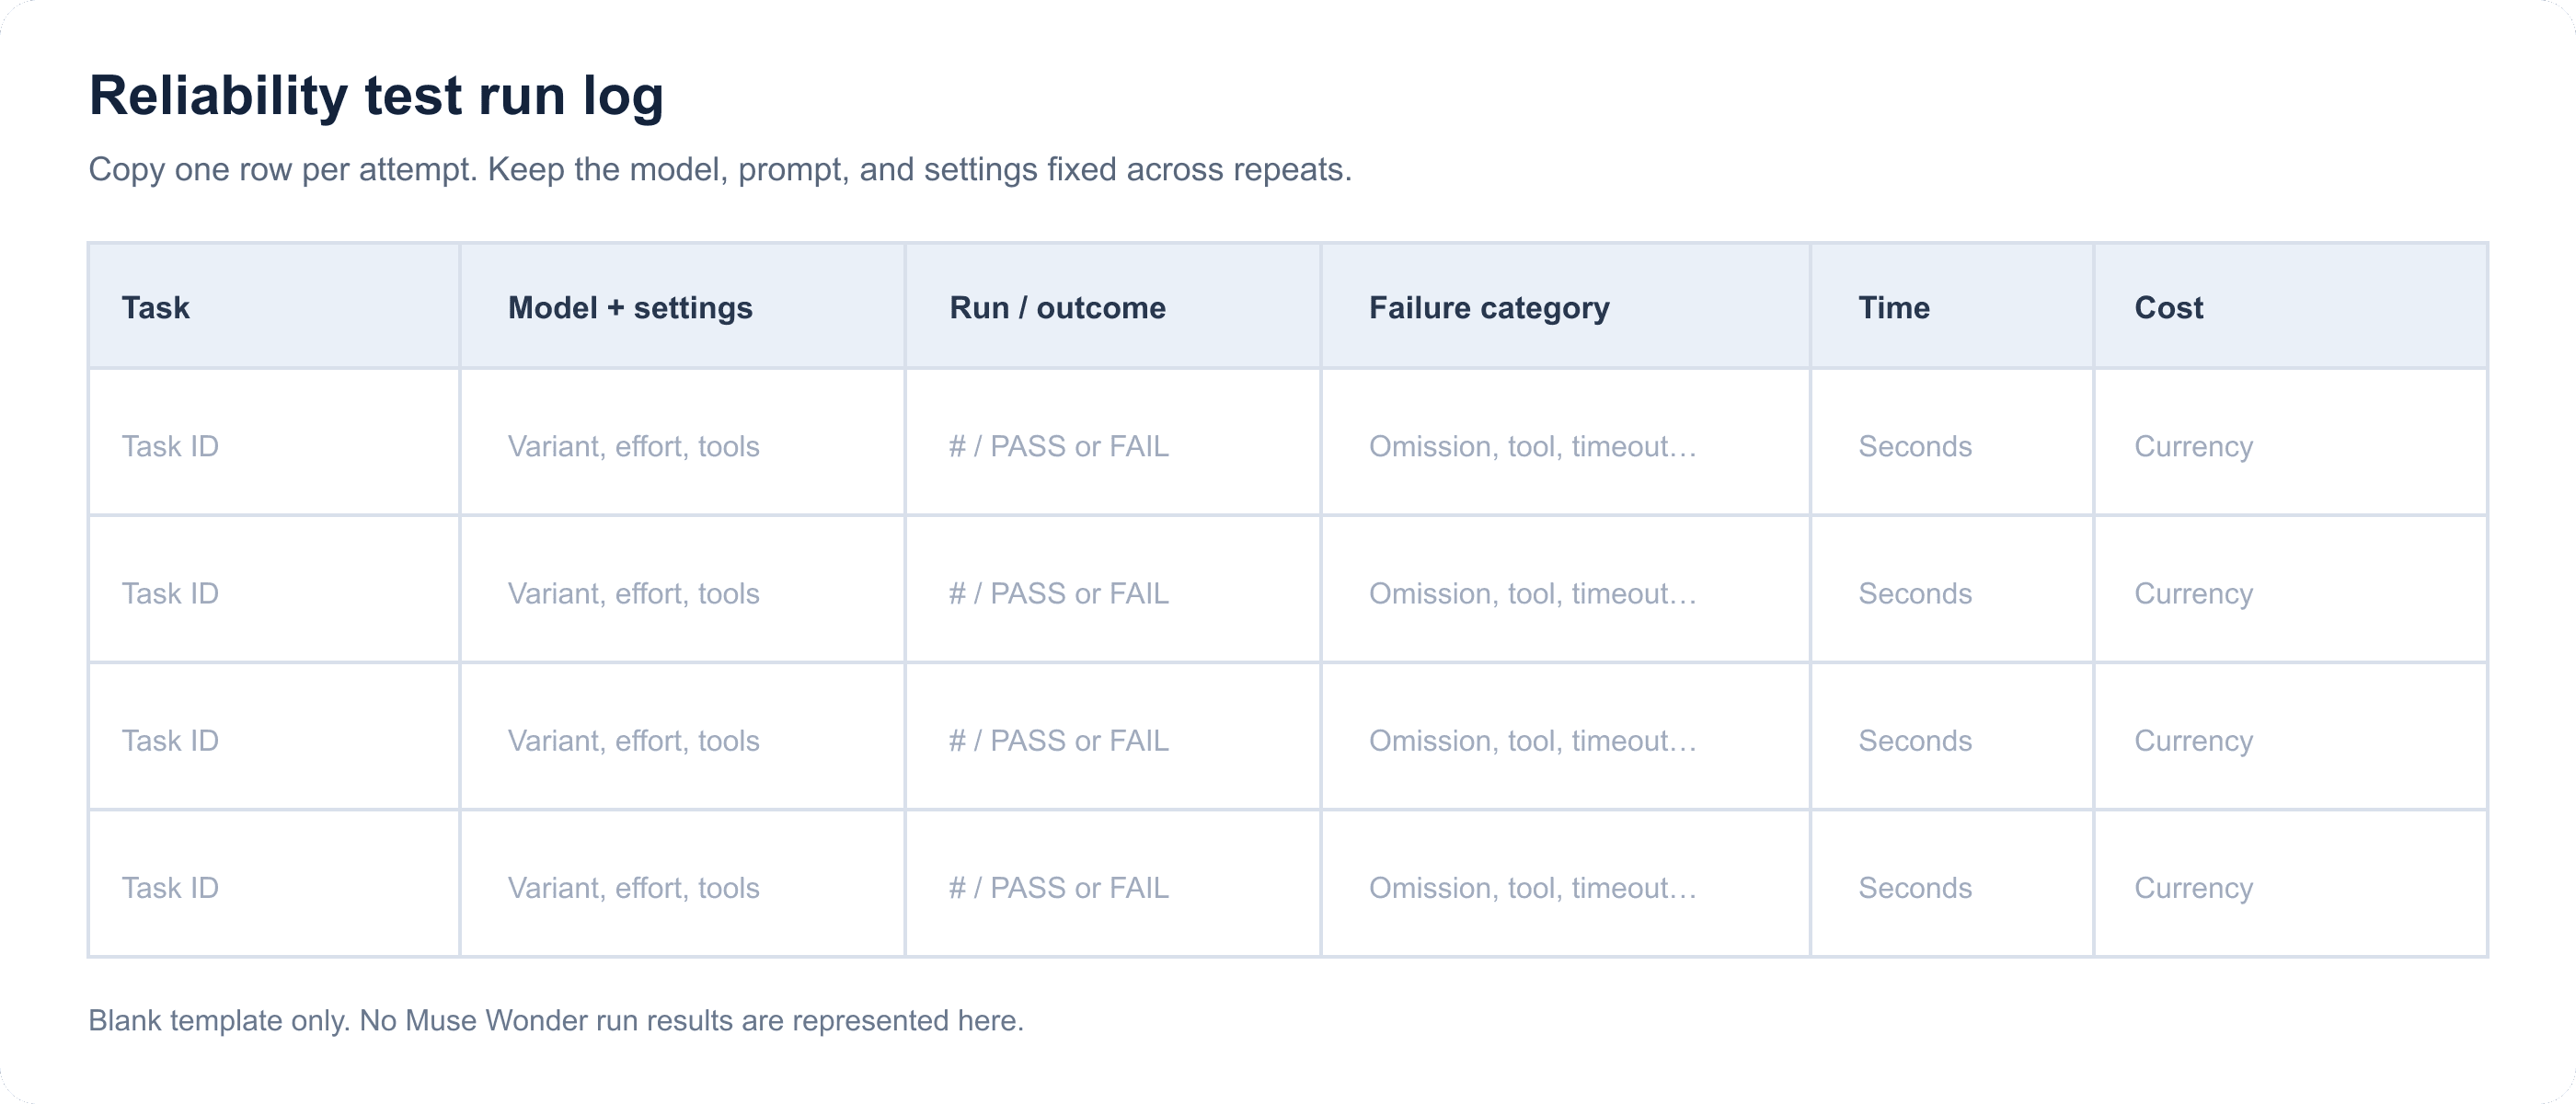
Registro em branco de teste de confiabilidade do Muse Wonder mostrando campos para tarefa, modelo, execução, resultado, erro, tempo e custo
Modelo de registro em branco reutilizável. Preencha uma linha por tentativa; ele não contém resultados medidos do Muse Wonder.
4. Mantenha um registro de falhas e verifique a recuperação
Use categorias específicas: erro factual, omissão, teste de código com falha, erro de ferramenta, timeout, alegação de conclusão sem suporte ou incompatibilidade de formato. Para trabalho em várias etapas, anote onde a execução parou e se uma nova tentativa repetiu ações concluídas ou verificou o estado final.
Um agente que diz “concluído” sem evidências não passou em uma verificação de conclusão. Exija um resultado de teste, arquivo salvo, citação de fonte ou estado verificado que corresponda à tarefa.
5. Defina um limite de decisão em torno do custo da falha
Não há um ponto de corte universal útil para a taxa de aprovação. Um rascunho que uma pessoa verifica linha por linha tem um perfil de risco diferente de uma migração de banco de dados ou de um pagamento automatizado.
Defina o limite a partir de três fatores:
- Quão prejudicial ou caro é um resultado errado?
- Uma pessoa consegue detectar o erro antes que ele afete alguém?
- O fluxo de trabalho falha com segurança, com uma parada clara e trilha de auditoria?
Para rascunhos de baixo risco, a revisão pode ser suficiente. Para alterações de código, finanças, jurídico, saúde ou ações que afetam usuários, use testes mais fortes e verificação independente. Não deixe que uma média alta esconda um modo de falha grave.
Confiabilidade do Muse Wonder por tipo de tarefa
Codificação e construções em várias etapas
Execute a suíte de testes real do repositório e verifique o comportamento solicitado. Pontue a cobertura de requisitos, falhas de regressão e se as alterações alegadas pelo modelo correspondem aos arquivos e à saída dos testes. Uma gravação de tela ou explicação convincente não substitui uma verificação executável.
A suíte inicial da Quantslant incluía quatro tarefas de codificação e relatou 15 de 16 testes de unidade passando em uma tarefa de número para palavras. Esse é um sinal pequeno, de uma única execução. O Spring Prompt explicitamente não testou codificação, então seus achados não devem ser usados para generalizar sobre a confiabilidade de agentes de codificação.
Pesquisa e extração factual
Use um pacote de fontes ou respostas de referência que seu revisor possa inspecionar. Verifique cada alegação factual em uma fonte primária e acompanhe citações inventadas e atribuições incorretas separadamente da qualidade geral da resposta.
A análise de pesquisa do Spring Prompt foi um ponto relativamente forte em sua pequena avaliação, mas o design das perguntas da pesquisa foi mais fraco. Uma pontuação alta de análise não deve certificar silenciosamente o instrumento de pesquisa ou as fontes por trás de uma nova tarefa de pesquisa.
Contexto longo e fluxos de trabalho de agentes
Verifique se o modelo retém todas as restrições, usa cada ferramenta corretamente e verifica o estado final. Teste a recuperação de interrupção de propósito: interrompa uma execução após uma etapa conhecida e veja se ela é retomada a partir de um checkpoint ou repete um efeito colateral.
O anúncio da Meta descreve capacidades de memória e recuperação, mas as avaliações iniciais públicas citadas aqui não estabelecem consistência de longo prazo para memória persistente ou recuperação de agentes. Meça esses comportamentos diretamente antes de depender deles.
Muse Wonder vs. Muse Wonder Full: mantenha as evidências separadas
Muse Wonder e Muse Wonder Full são variantes distintas. As informações de lançamento da Meta descrevem rotas de acesso separadas, e testes independentes de API do Wonder padrão não se tornam resultados do Full só porque a configuração de raciocínio muda.
| Pergunta de comparação | O que as evidências disponíveis sustentam |
|---|---|
| O Full é o mesmo que o Wonder padrão no raciocínio máximo? | Não. Trate-os como variantes distintas e registre o nome exato. |
| A avaliação de API do Spring Prompt citada testou o Full? | Não. Ela testou o Wonder padrão; o Full estava fora dessa comparação. |
| Os números citados da API padrão podem classificar o Full? | Não. Eles não testam o Full. |
| O que tornaria uma comparação justa? | O mesmo conjunto de tarefas, rubrica de pontuação, janela de datas, acesso a ferramentas e configurações documentadas, com repetições para ambas as variantes. |
Uma comparação justa começa com tarefas pareadas e condições correspondentes. Se as rotas de acesso impõem prompts, ferramentas ou cobrança diferentes, documente essas diferenças e chame a comparação de exploratória.
Custo, acesso e onde testar o Muse Wonder
Compare o custo por tarefa aceita, não apenas o preço listado por token. Prompts longos, novas tentativas, tokens de raciocínio, chamadas de ferramentas, timeouts e revisão humana alteram o custo de um resultado utilizável. A Quantslant relatou as tarifas de token do Wonder padrão como $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída em 12 de outubro de 2026, e sua própria execução de 23 tarefas custou $0.64. Essa é uma rota e carga de trabalho relatadas, não um preço universal por tarefa.
O anúncio de lançamento atual da Meta lista o Wonder padrão por meio da Meta Model API e do Muse Code, e o Full por assinaturas do Muse Code. Confirme acesso, elegibilidade regional e cobrança atual na interface oficial antes de orçar.
Comece pela Atlas Cloud para uma visão mais ampla de sua plataforma para desenvolvedores. Em 15 de outubro de 2026, eu não consegui confirmar o Muse Wonder no catálogo de modelos, então este artigo não apresenta a Atlas Cloud como uma rota de execução para este modelo. Se sua equipe está comparando outros modelos já listados lá, a biblioteca de modelos da Atlas Cloud pode ajudar a identificar candidatos para executar no mesmo conjunto de tarefas.
O resultado útil de um teste de confiabilidade do Muse Wonder é uma decisão de implantação atrelada a evidências: qual tarefa passou, com que frequência passou, quanto custou e qual revisão continua necessária.
Perguntas frequentes
O Muse Wonder é confiável para codificação?
Os primeiros testes de lançamento fornecem apenas uma pequena amostra de codificação. A Quantslant relatou quatro tarefas de codificação, com um teste de unidade não aprovado em uma tarefa, enquanto o Spring Prompt não testou codificação. Execute testes do repositório nas suas próprias tarefas e repita as importantes antes de tomar uma decisão sobre o fluxo de trabalho de codificação.
Como testo a confiabilidade do Muse Wonder por conta própria?
Use um conjunto fixo de tarefas reais, preserve as configurações exatas de modelo e prompt, defina critérios de aprovação com antecedência e retenha todas as saídas. Repita tarefas importantes e verifique os resultados com testes ou documentos de origem.
Quantas vezes devo repetir cada tarefa do Muse Wonder?
Use pelo menos três execuções para tarefas de alto impacto como verificação inicial de consistência. Três tentativas continuam sendo uma amostra pequena, então amplie o conjunto quando os erros forem caros ou as saídas variarem.
Qual é a diferença entre Muse Wonder e Muse Wonder Full?
São variantes de modelo separadas com rotas de disponibilidade diferentes. Não trate o Wonder padrão no raciocínio máximo como Full nem transfira resultados entre eles sem um teste correspondente.
Posso confiar nas pontuações de benchmark do Muse Wonder da Meta?
Use-as como evidências de capacidade relatadas pelo fornecedor e leia a configuração do benchmark. Elas não provam desempenho consistente em seus prompts, ferramentas e execuções repetidas.
O Muse Wonder está disponível na Atlas Cloud?
Não consegui verificá-lo no catálogo de modelos da Atlas Cloud em 15 de outubro de 2026. Verifique o catálogo ao vivo antes de escolher um provedor de execução.





