

Uma voz pode soar como se alguém estivesse segurando as lágrimas enquanto o rosto animado permanece neutro. Com a correspondência de voz emocional e expressão facial do OmniHuman 2.0, a primeira correção costuma ser ouvir com mais atenção, não adicionar mais adjetivos. O áudio já carrega palavras, ritmo e ênfase vocal; um prompt curto deve direcionar a performance visível que dá suporte a essas pistas.
Este guia oferece aos criadores uma forma repetível de preparar um retrato e uma faixa, escrever um prompt focado e revisar o resultado em busca de discrepâncias significativas. Ele aborda fala e canto, separando informações documentadas de orientações de terceiros e alegações de produto não verificadas.
Principais conclusões
- Trate o áudio como a base da performance e direcione apenas ações visíveis, enquadramento e detalhes de cena.
- Marque os momentos emocionais antes de criar o prompt e depois verifique esses mesmos momentos com o som mudo e ligado.
- Altere uma variável por tentativa; um prompt não consegue corrigir todos os problemas de áudio de origem ou de geração.
Como o OmniHuman 2.0 conecta áudio, expressão facial e movimento
Uma forma útil de pensar em um modelo de retrato guiado por áudio é atribuir uma função a cada entrada. A imagem ancora o sujeito visível. A gravação fornece a fala ou a música, incluindo seu timing e sua interpretação. A direção de texto opcional pode descrever a performance ou a cena. O comportamento e os controles exatos podem variar conforme a implementação do produto, portanto não trate a pesquisa geral sobre OmniHuman nem as instruções de um estúdio de terceiros como especificações oficiais do OmniHuman 2.0.
A pesquisa original do OmniHuman-1 descreve animação humana condicionada a combinações de imagem, texto, áudio e pose. Esse artigo estabelece o enquadramento mais amplo da família de pesquisa, não a interface, os limites ou a qualidade exatos do OmniHuman 2.0 (ICCV 2025, artigo do OmniHuman-1).
| Entrada | Contribuição provável | O que você pode preparar |
|---|---|---|
| Retrato de referência | Aparência do sujeito e pose inicial | Escolha um rosto nítido e um enquadramento adequado ao movimento pretendido |
| Áudio falado ou cantado | Palavras, cadência, pausas, energia vocal | Use uma faixa limpa com interpretação intencional e corte silêncios irrelevantes |
| Prompt de direção opcional | Ações visíveis, enquadramento, cena ou pistas de humor | Dê algumas direções concretas que estejam de acordo com a gravação |
A sincronização labial e a performance emocional estão relacionadas, mas não são o mesmo tipo de verificação de qualidade. Uma boca pode acompanhar as sílabas enquanto os olhos, a cabeça ou o gesto parecem errados para a fala. Da mesma forma, um rosto pode parecer expressivo enquanto o timing se desvia da voz. Revise os dois.
Guias de terceiros sobre o OmniHuman 2.0 descrevem um fluxo de trabalho de imagem mais áudio com direção de texto opcional, mas essas páginas não são documentação técnica da BytePlus. A documentação pública da Atlas cobre seu próprio modelo Avatar Omni Human 1.5, não o OmniHuman 2.0. A suposição de trabalho mais segura é, portanto, prática e não absoluta: deixe o áudio sugerir do que a performance precisa e use o prompt para solicitar escolhas visíveis que você possa inspecionar.
Escolha um retrato e uma faixa de áudio que tornem a emoção legível
Um modelo não consegue atuar com base em pistas difíceis de ver ou ouvir. Comece com entradas que lhe deem uma tarefa justa e simples, depois mantenha-as fixas enquanto testa a redação do prompt.
| Entrada inicial | Por que pode ajudar | Complicação a observar |
|---|---|---|
| Um rosto nítido e desobstruído, com luz uniforme | Torna os traços faciais fáceis de ler | Sombras fortes, cabelo, mãos ou objetos podem cobrir áreas importantes |
| Pose inicial neutra ou levemente expressiva | Deixa espaço para a performance mudar | Uma expressão fixa forte pode entrar em conflito com um humor vocal diferente |
| Uma voz clara em primeiro plano | Torna fala e pausas mais fáceis de acompanhar | Música, ruído ambiente ou falantes sobrepostos podem mascarar pistas |
| Fraseado deliberado com pausas audíveis | Dá a você momentos para mapear para ações visíveis | Uma entrega monótona pode oferecer menos mudanças emocionais claras |
| Uma música com voz em primeiro plano e frases distintas | Torna palavras cantadas e dinâmica mais fáceis de identificar | Trechos instrumentais fornecem menos pistas vocais para o movimento da boca |
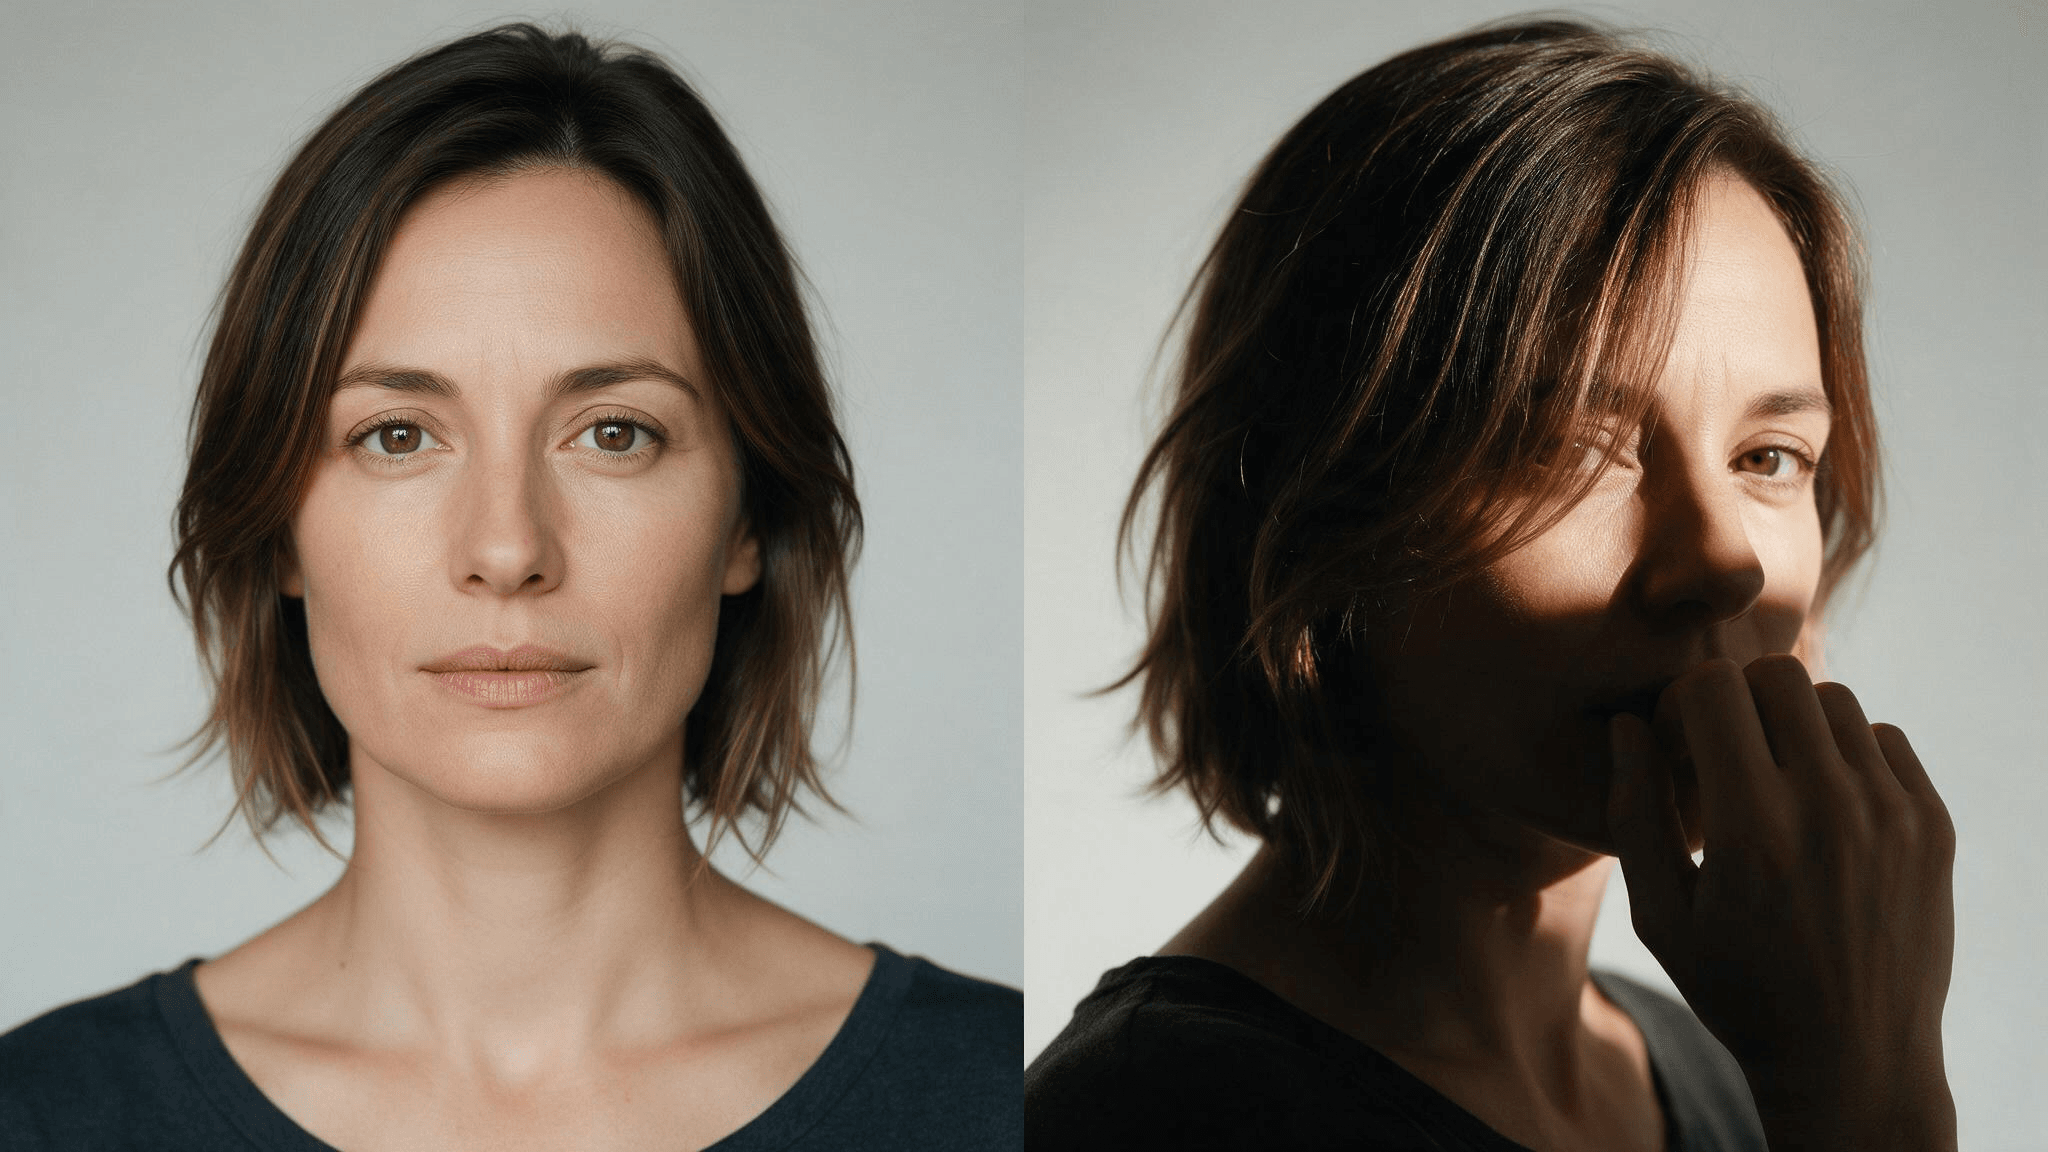 Comparação ilustrativa de retratos: a visão nítida, de frente, torna as pistas faciais mais fáceis de inspecionar do que a visão sombreada e parcialmente obstruída. Esta não é uma comparação de resultados do modelo.
Estas são verificações de produção, não garantias. Uma boa entrada ainda pode produzir uma tomada fraca, e um retrato visualmente expressivo não garante uma animação coerente. Para um primeiro teste, use um retrato, um trecho curto de áudio e um único prompt. Evite mudar ao mesmo tempo o recorte, a gravação e a direção; caso contrário, você não saberá qual ajuste ajudou.
Para canto, ouça os finais de frase, as notas sustentadas e as mudanças de intensidade. O prompt pode direcionar uma inclinação de cabeça ou um movimento de mão em torno de uma batida musical, mas não deve repetir a letra que já está na gravação. Para diálogo falado, marque pausas e palavras de ênfase. Um prompt que pede uma grande mudança de humor durante uma frase calma contínua pode criar uma performance que parece imposta.
Uma estrutura de prompt para combinar voz e expressão facial
Mantenha a direção curta o suficiente para avaliar. Uma estrutura prática é:
Enquadramento + falante e interpretação + emoção consistente com a faixa + uma ou duas ações visíveis + direção de câmera opcional.
Por exemplo, se um falante parece acolhedor e composto, você pode escrever:
Close-up médio estático. A mulher fala calorosamente para a câmera, começando composta e deixando um pequeno sorriso aparecer na última fala. Ela dá um aceno suave após a pausa. Mantenha o enquadramento estável.
Este é um prompt ilustrativo, não uma execução real do OmniHuman 2.0. Seu recurso útil é que cada instrução corresponde a algo visível: o plano permanece estável, a expressão muda perto do final e o aceno tem uma deixa. Você pode comparar o resultado com a faixa em vez de julgar um pedido amplo como “seja emocional”.
Um guia de prompts de terceiros recomenda direção concisa em linguagem natural e correspondência entre a emoção solicitada e a voz. Trate isso como uma heurística prática, não como garantia ou regra oficial do produto (guia de prompts do KreatorFlow).
Antes de usar um prompt, verifique-o em relação à gravação:
- Se a voz é baixa e contida, peça uma expressão sutil em vez de um sorriso amplo.
- Se a interpretação fica mais confiante, coloque a mudança visível depois da mudança audível.
- Se a gravação contém uma risada, pausa ou suspiro, decida se o rosto deve se manter, reagir ou se mover naquele ponto.
- Se o retrato inicial já mostra a expressão desejada, evite descrevê-la novamente, a menos que você queira que a expressão mude.
Use palavras temporais como “primeiro”, “depois” e “por fim” apenas quando o áudio tem marcações claras. Evite empilhar instruções conflitantes como “enquadramento estático” e “câmera orbitando”, ou “calmo” e “furioso”. Um prompt é direção para uma performance existente, não uma faixa de voz substituta.
Três padrões de prompt para fala, mudanças emocionais e canto
Escolha o menor padrão que se encaixa no seu áudio. Estes exemplos são modelos a adaptar, não alegações verificadas sobre resultados.
Explicação calma
Plano médio close estável. O falante explica o ponto com calma, com uma expressão composta e um pequeno gesto de ênfase. Mantenha a câmera imóvel.
Use isto quando a faixa é medida e consistente. Um gesto pode tornar a ênfase visível sem transformar uma explicação direta em uma performance teatral.
Uma mudança de emoção
Close-up estático. O falante começa sério e depois se suaviza em um pequeno sorriso após a pausa antes da frase final. Mantenha o movimento contido.
Use isto apenas quando a gravação contém uma pausa ou mudança audível que sustenta a transição. Se não houver deixa, a transição pode parecer arbitrária.
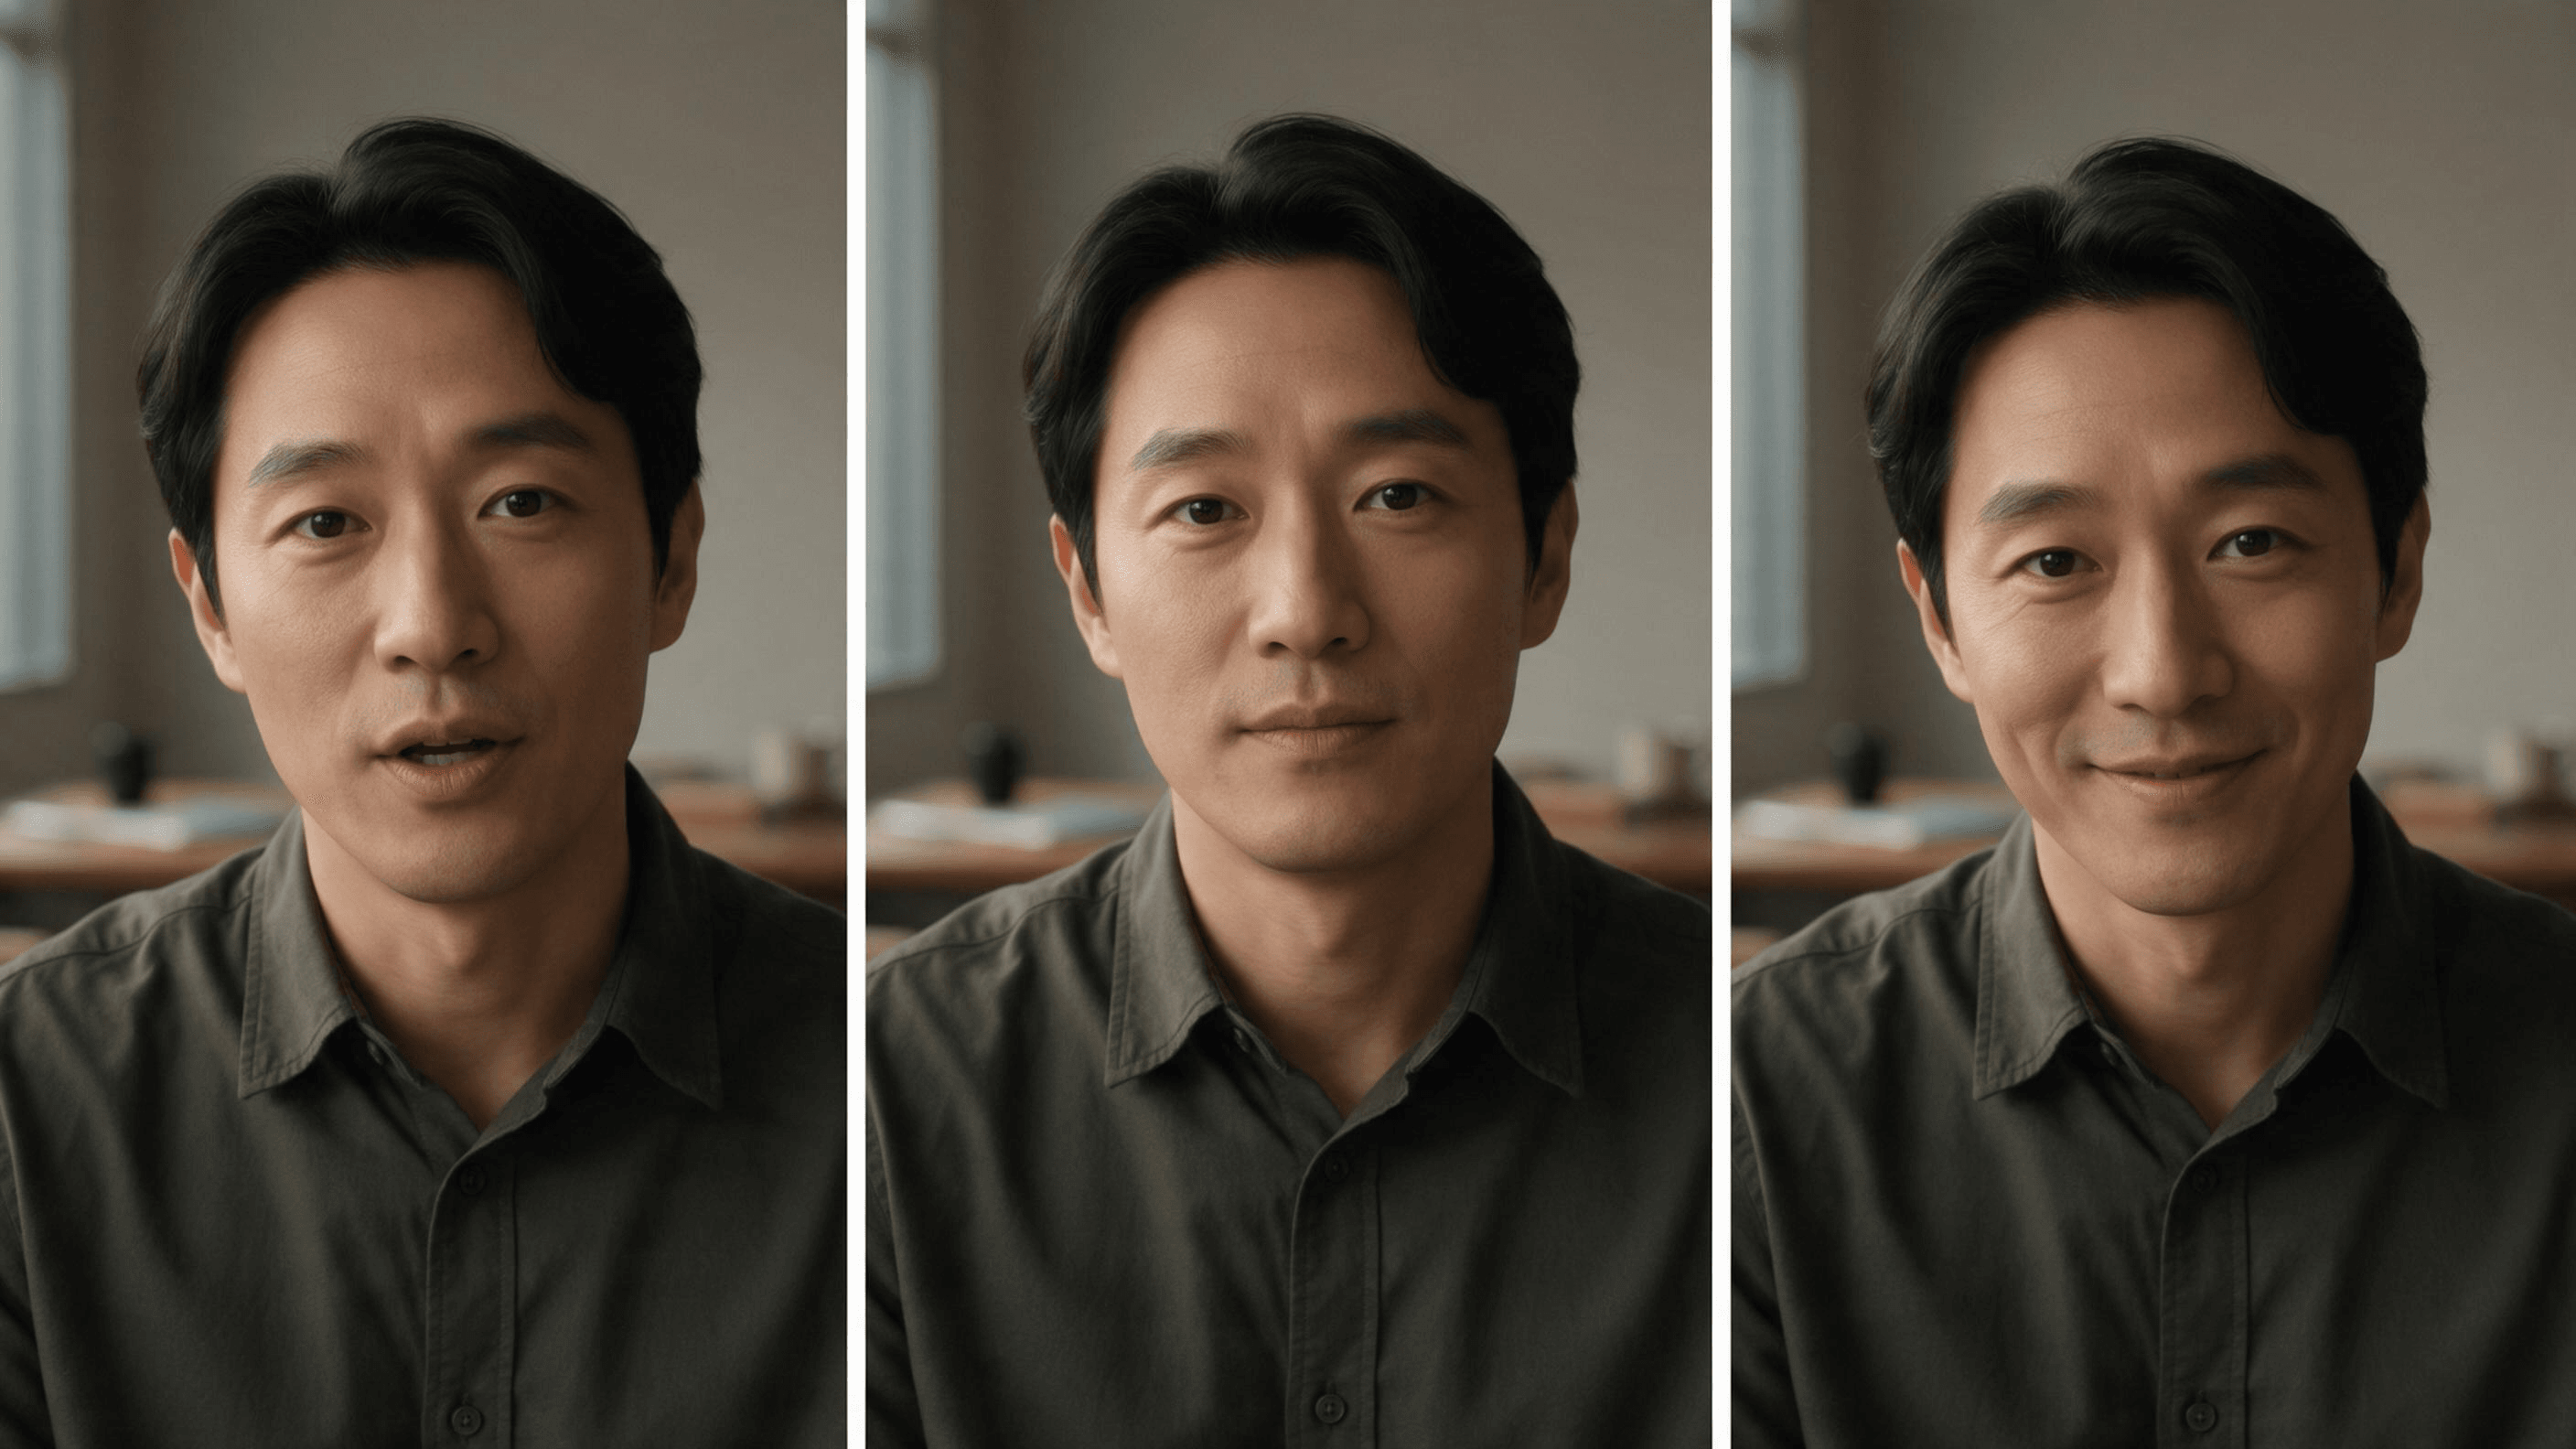 Storyboard conceitual para o prompt de fala: entrega séria, uma pausa e então um sorriso contido. Estes são momentos faciais planejados, não quadros de uma geração do OmniHuman 2.0.
Canto
Plano médio close. A cantora se apresenta com uma expressão focada, fecha os olhos brevemente na nota sustentada e depois abaixa o queixo quando a frase termina. Mantenha o enquadramento estável.
Direcione a performance em torno de eventos musicais em vez de repetir a letra. O prompt pode sugerir ação visível; a faixa fornecida continua sendo a fonte das palavras cantadas e do timing.
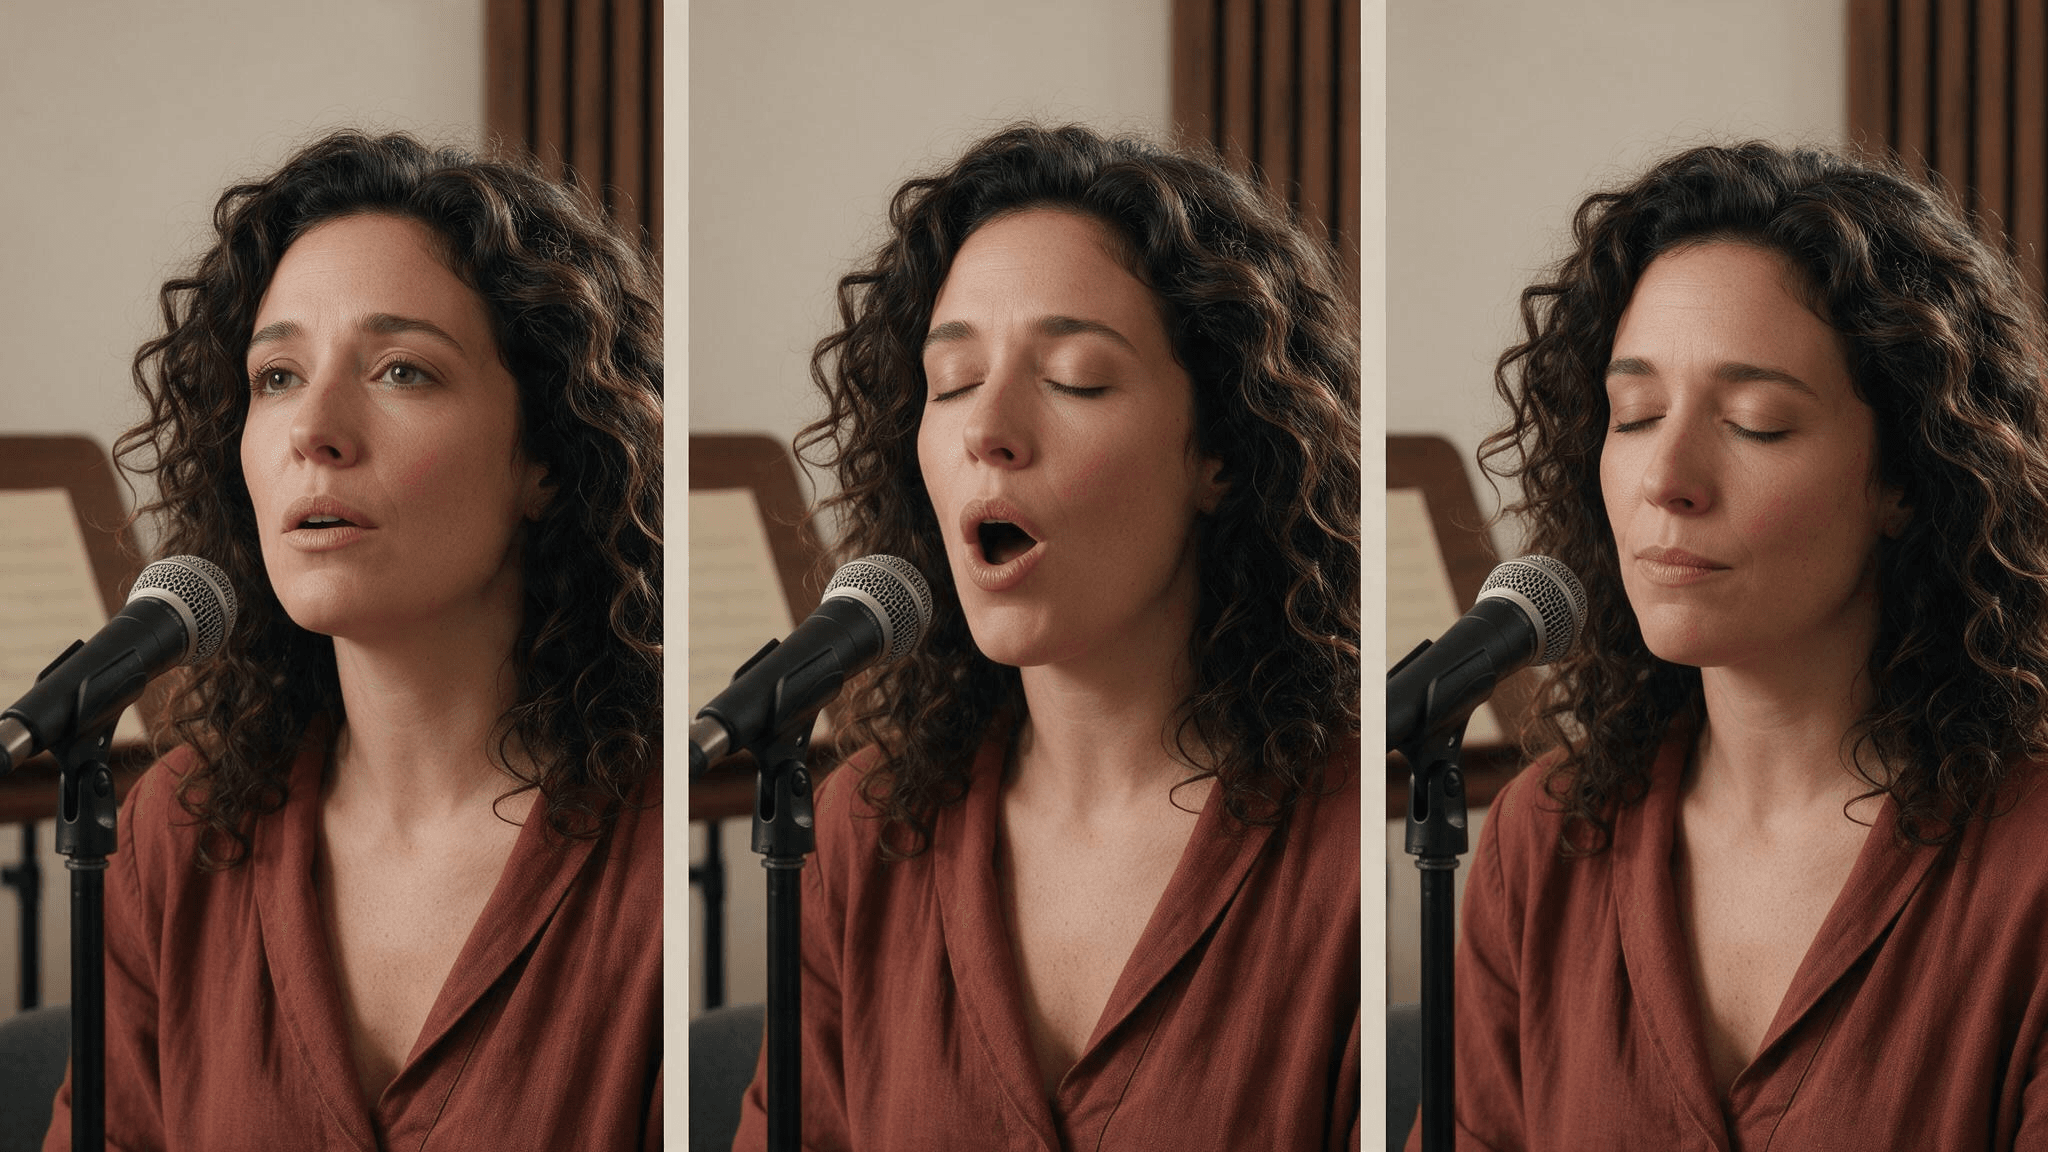 Storyboard conceitual para o prompt de canto: comece a frase, sustente uma nota e então se estabilize no final. Imagens estáticas não demonstram sincronização de áudio.
Compare “seja emocional e cinematográfico” com “fale com calor e depois sorria após a pausa”. O primeiro deixa a emoção, o timing e a ação visível abertos à interpretação. O segundo dá a você um momento específico para inspecionar. Se o resultado perde esse momento, você tem um próximo teste direcionado: mover a deixa, suavizar a expressão ou escolher uma edição de áudio diferente.
Uma verificação em três passagens para alinhamento de voz e rosto
Um método de revisão rápida pode revelar se o problema está no áudio, na direção visual ou na tomada gerada. Use os mesmos timestamps nas três passagens.
O loop silencioso abaixo permite inspecionar a parte visível de uma performance falada: movimento da boca, olhar e mudanças faciais. Use o clipe original com som para a verificação de voz para rosto.
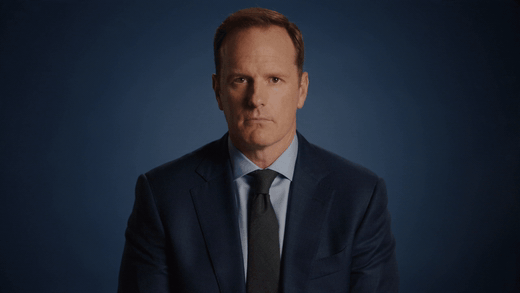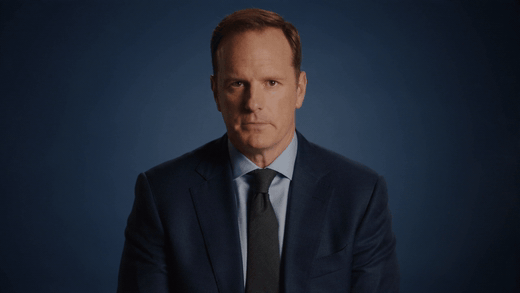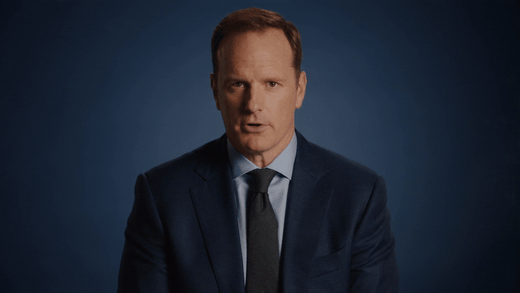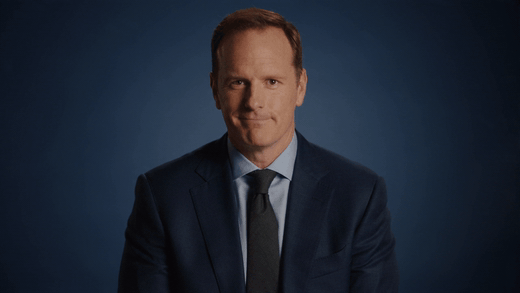
GIF silencioso convertido do vídeo de avatar fornecido. Ele mostra movimento visível, mas não consegue estabelecer sincronização de áudio nem performance do OmniHuman 2.0 por si só.
- Ouça sem assistir. Marque mudanças emocionais, pausas, ênfase, risadas, sussurros e finais de frase. Anote o que um ouvinte poderia inferir apenas pela voz.
- Assista sem som. Nesses timestamps, observe o rosto, o olhar, o movimento da cabeça e os gestos. Registre o que a performance parece comunicar sem som.
- Reproduza os dois juntos. Sinalize apenas discrepâncias que mudam o significado ou distraem da fala. Um pequeno sorriso sob uma frase angustiada pode importar; um piscar leve geralmente não.
Uma tabela de revisão transforma essas observações em uma próxima ação:
| Tempo | Deixa vocal | Deixa visível | Combina? | Menor próximo teste |
|---|---|---|---|---|
| 00:04 | Frase baixa e tensa | Sorriso amplo | Não | Reduza a intensidade do sorriso solicitado |
| 00:09 | Pausa antes de uma fala reconfortante | Rosto permanece imóvel | Talvez | Adicione um aceno sutil após a pausa |
| 00:13 | Risada na gravação | Expressão permanece séria | Não | Verifique se a edição de áudio preserva a risada claramente |
As entradas acima são exemplos hipotéticos de como usar a tabela, não observações de uma execução de modelo. Suas notas de revisão devem se referir ao seu próprio clipe. Mude uma coisa de cada vez: revise o prompt, ajuste a edição de áudio ou tente um retrato diferente. Depois repita as mesmas verificações nos mesmos momentos.
Se a discrepância persistir apesar de uma deixa clara e uma direção focada, trate isso como uma limitação de geração para essa tomada. Mais adjetivos podem adicionar ruído sem resolver o problema de timing ou performance. Decida se vale a pena testar outra entrada ou fluxo de trabalho, ou se a tomada já é adequada para o contexto pretendido.
Solucione problemas de expressões apagadas ou incompatíveis
Use o sintoma para escolher um próximo passo controlado. Estas são hipóteses gerais de solução de problemas, não alegações verificadas de defeitos do OmniHuman 2.0.
| O que você percebe | Causa possível | Um próximo teste |
|---|---|---|
| O rosto parece neutro durante todo o clipe | A voz tem pouco contraste, ou a direção não tem uma deixa visível | Use uma passagem de áudio mais expressiva ou peça uma ação concreta em uma marcação clara |
| O rosto exagera uma fala sutil | O prompt pede uma emoção mais forte do que a faixa sustenta | Remova ações extras e reduza a intensidade emocional |
| A boca parece fora de tempo | A gravação tem ruído, vozes sobrepostas, silêncio longo ou cortes difíceis | Tente uma edição mais limpa com timing mais preciso antes de reescrever o prompt |
| Um ouvinte parece falar em uma imagem de grupo | Os papéis de falante e ouvinte podem ser ambíguos no fluxo de trabalho testado | Identifique cada pessoa pela posição e especifique quem fala, se a interface permitir |
| Identidade ou detalhes finos mudam durante o movimento | O enquadramento de origem ou o movimento solicitado podem tornar a consistência mais difícil de julgar | Simplifique o movimento e compare uma tomada mais curta e estável |
Não presuma uma correção apenas com prompt para um problema de áudio. Primeiro verifique se as palavras estão claras e se silêncios ou edições perturbam o ritmo. Se isso estiver bom, simplifique a direção visível. Uma nova tentativa focada dá a você melhores evidências do que reescrever todas as entradas de uma vez.
O OmniHuman 2.0 está disponível na Atlas Cloud?
As páginas públicas atuais de modelos da Atlas Cloud listam o Avatar Omni Human 1.5 e documentam suas entradas de imagem, áudio e prompt opcional. Não encontrei o OmniHuman 2.0 na listagem de modelos da Atlas durante esta verificação. Isso significa que o modelo 2.0 exato não deve ser apresentado como executável pela Atlas Cloud.
Se você quiser explorar uma tarefa relacionada de avatar guiado por áudio na Atlas, revise a página do modelo Avatar Omni Human 1.5 e suas entradas documentadas. A documentação especifica uma imagem de referência, uma URL de áudio e um prompt opcional; ela descreve áudio de até 60 segundos e recomenda 15 segundos ou menos para melhor qualidade. Esses são detalhes da v1.5, não especificações do OmniHuman 2.0. Verifique o catálogo atual de modelos da Atlas para disponibilidade ao vivo e preços antes de escolher um fluxo de trabalho. Não consegui confirmar um preço público atual para este modelo durante a pesquisa, então este artigo não cita nenhum.
Verifique direitos e contexto antes de publicar
Antes de compartilhar uma pessoa animada, confirme que você tem permissão para usar o retrato e a voz para a finalidade pretendida. Revise também direitos de música, imagem, voz e distribuição para o contexto específico. Os requisitos podem variar conforme o material de origem e o uso; esta lista de verificação é orientação prática, não uma conclusão jurídica.
Rotule mídia sintética ou editada quando os espectadores poderiam razoavelmente confundi-la com filmagens documentais ou com uma declaração atual de uma pessoa real. Mantenha notas do projeto sobre os arquivos de origem e as edições, especialmente para trabalhos de cliente ou campanha. Uma performance tecnicamente alinhada ainda precisa de um contexto de publicação responsável.
Para a correspondência de voz emocional e expressão facial do OmniHuman 2.0, o próximo passo útil é um teste controlado: escolha um retrato nítido, marque os momentos emocionais do áudio, escreva uma direção curta e revise os mesmos timestamps com o som desligado e ligado. Se você está considerando uma opção hospedada na Atlas, verifique o modelo exato e o preço atual primeiro.
Perguntas frequentes
O OmniHuman 2.0 gera a voz?
O fluxo de trabalho descrito por guias de terceiros começa com áudio fornecido e anima um retrato de acordo com ele. Não presuma que o modelo gera uma voz, a menos que a interface específica do produto documente essa capacidade.
O OmniHuman 2.0 consegue animar canto, assim como fala?
Guias de terceiros sobre o OmniHuman 2.0 descrevem uso de áudio tanto falado quanto cantado. Para um teste de canto, use uma seção com voz em primeiro plano e fraseado claro, depois direcione ações visíveis em torno de uma nota sustentada ou do final de uma frase.
O prompt deve repetir o diálogo ou a letra?
Normalmente, não. A gravação já fornece as palavras. Use o prompt para direção visível, como expressão, gesto, enquadramento ou uma deixa de cena, e evite adicionar texto que entre em conflito com a faixa.
O que devo mudar primeiro se a expressão parecer errada?
Use a verificação em três passagens para localizar a discrepância. Se o áudio em si estiver pouco claro ou emocionalmente apagado, teste uma edição de áudio primeiro. Se a deixa estiver clara, mas o rosto não a acompanhar, simplifique e reajuste o timing de uma direção do prompt.
O OmniHuman 2.0 está na Atlas Cloud?
Não encontrei o OmniHuman 2.0 no catálogo público de modelos da Atlas Cloud durante esta pesquisa. A Atlas documenta o Avatar Omni Human 1.5 como uma opção relacionada; verifique a listagem atual antes de escolhê-lo.





