

Você pede que um personagem gesticule pelo quadro, mas sua fonte é um close-up do rosto. Nenhuma frase engenhosa consegue restaurar com certeza os ombros, as mãos ou os detalhes de roupa ausentes. A geração de gestos de corpo inteiro do OmniHuman 2.0 a partir de uma única imagem funciona melhor como uma escolha coordenada: forneça ao modelo um quadro que contenha as partes do corpo que você quer mover, um áudio com uma indicação clara de performance e um prompt curto descrevendo uma ação.
O OmniHuman é um sistema de geração de vídeo humano orientado por áudio. O fluxo de trabalho anunciado combina uma imagem estática e áudio, com direção de texto opcional para movimento ou comportamento de câmera. Trate “corpo inteiro” como o tipo de performance que você deseja, não como garantia de que todo retrato pode produzir uma figura completa e estável. As especificações documentadas publicamente citadas aqui são do OmniHuman 1.5, portanto não se deve presumir que descrevam todas as interfaces ou implantações do OmniHuman 2.0.
Principais conclusões
- A imagem de origem define a área visível do corpo e a composição inicial.
- O áudio fornece a marcação de fala ou canto; um prompt adiciona direção visual.
- Combine o corte com o gesto e mantenha a ação solicitada dentro do quadro visível.
- Verifique a versão, os limites de entrada e o preço na página oficial atual do produto antes de se comprometer.
O que o OmniHuman 2.0 faz para gestos de corpo inteiro
O OmniHuman 2.0 é apresentado como uma forma orientada por imagem e áudio de criar um vídeo de performance humana. A imagem estática estabelece o sujeito e a visão inicial. O áudio dá à performance uma voz, ritmo e referência de tempo. Texto opcional pode descrever a cena, o movimento ou a direção de câmera. O clipe gerado combina essas indicações em um resultado em movimento.
Isso torna a tarefa mais ampla do que fazer uma boca estática se mover. Uma tomada útil pode envolver movimento labial, expressão, movimento de cabeça, postura e gestos com as mãos. Essas partes precisam estar de acordo com a mesma performance. Para um vídeo explicativo narrado, um pequeno gesto de palma aberta em uma frase importante pode parecer mais natural do que movimento contínuo de braço. Para canto, o corpo pode acompanhar o fraseado e a energia ao longo da faixa.
O modelo não recebe um registro 3D completo da pessoa a partir de uma fotografia. Ele precisa inferir o que está fora do corte e como as superfícies ocultas devem parecer conforme o sujeito se move. Uma solicitação de ação de corpo inteiro, portanto, carrega mais incerteza quando a entrada mostra apenas o rosto. O controle prático é escolher a imagem de referência em torno da ação necessária e depois usar texto para refinar o que já é visualmente sustentado.
A página do projeto de pesquisa do OmniHuman 1.5 descreve animação orientada por áudio a partir de uma única imagem e discute controle de movimento e prompt. Esse é um contexto útil para a família de modelos, mas não é prova de que um prompt específico do OmniHuman 2.0 produzirá um gesto específico todas as vezes (página do projeto OmniHuman 1.5).
Antes de escolher as entradas, defina a tomada pretendida em uma frase: “um apresentador da cintura para cima enfatiza um ponto”, “um intérprete de corpo inteiro transfere o peso enquanto canta” ou “um falante em close-up faz uma fala calma”. O quadro e o áudio podem então servir a essa única tarefa.
Escolha uma imagem de origem que deixe espaço para o gesto
Para gestos de corpo inteiro, comece com a imagem de origem mais ampla que ainda seja adequada à composição final. Se o resultado for destinado a um vídeo de cabeça falante em close, um retrato fechado pode ser apropriado. Se o espectador precisar ver uma mão apontar para um objeto ou o sujeito transferir o peso, inclua essas partes na imagem de origem.
| Resultado pretendido | Corte inicial útil | Movimento razoável a solicitar |
|---|---|---|
| Narração em close-up | Cabeça e ombros | Expressão, giros de cabeça, movimento contido de ombros |
| Explicação de produto | Da cintura para cima com as mãos visíveis | Apontar brevemente, apresentar ou ênfase com a palma aberta |
| Performance em pé | Figura inteira com espaço ao redor do corpo | Mudanças de postura, transferências de peso e gestos maiores |
Essas são escolhas de produção, não requisitos publicados da BytePlus nem garantias de sucesso. Para um quadro de corpo inteiro, deixe uma margem de respiro ao redor das mãos, cotovelos e pés. Uma mão que já está encostada na borda pode ser cortada assim que se mover. Mantenha o rosto nítido o suficiente para ser lido, use iluminação uniforme quando possível e evite uma origem com outra pessoa cruzando o sujeito. Um fundo limpo também facilita perceber movimentos indesejados no fundo.
A imagem deve se parecer com a tomada que você planeja publicar. Uma origem retrato colocada em uma saída paisagem pode exigir mais fundo e área corporal inventados. Uma origem enquadrada verticalmente costuma ser mais fácil de avaliar para um personagem em pé destinado a uma postagem social vertical. Estas são diretrizes de composição; verifique os controles atuais da ferramenta de destino para quaisquer limites reais de proporção ou resolução.
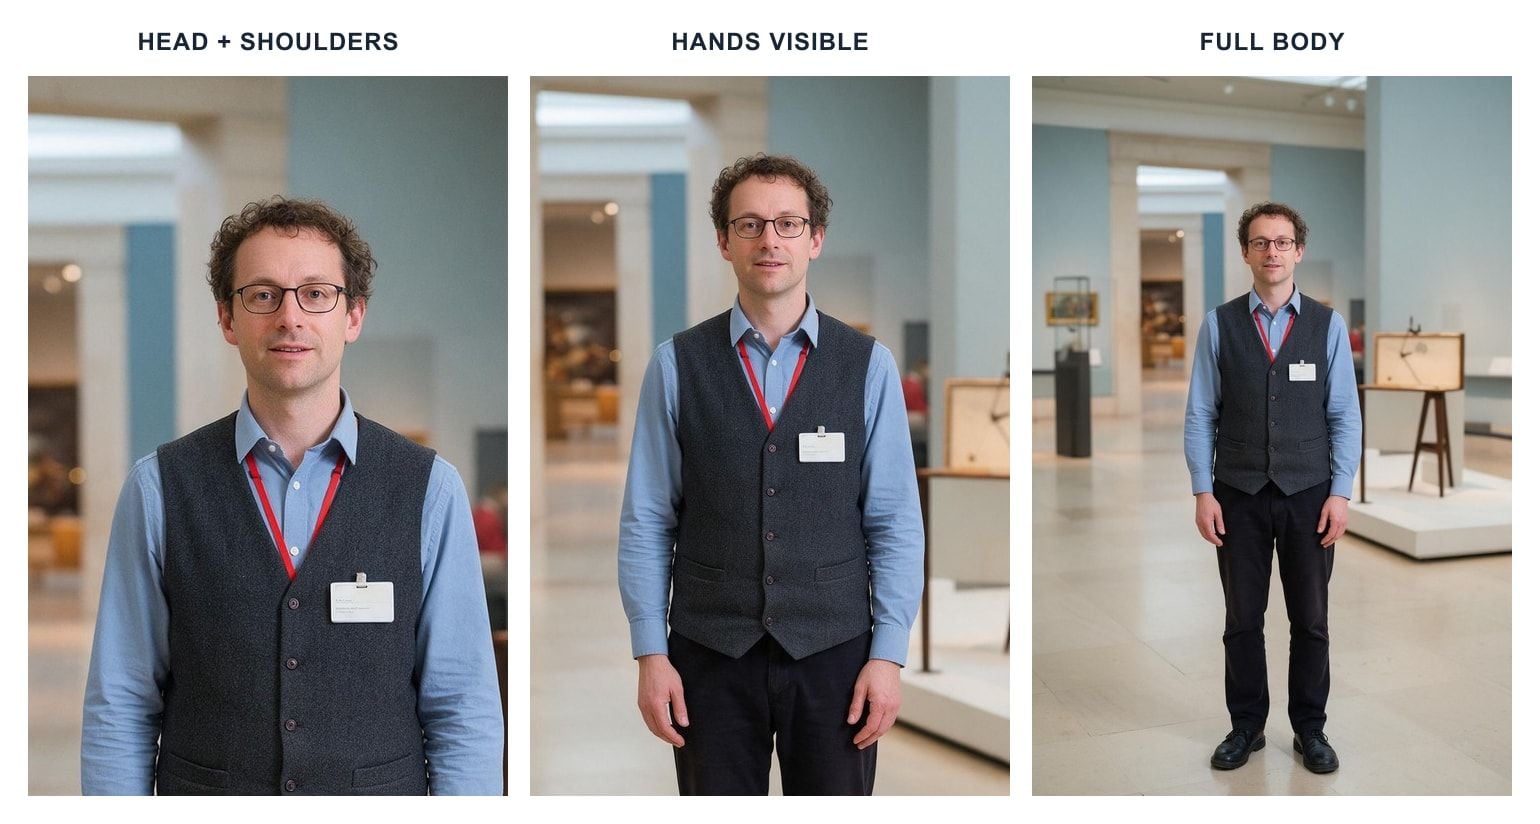
A mesma foto de origem de exemplo em três cortes: um enquadramento fechado favorece a expressão facial, mãos visíveis dão a um apresentador espaço para gesticular, e a figura inteira sustenta uma performance em pé.
Um teste de decisão simples ajuda: aponte para a parte do corpo que precisa se mover na tomada final. Se ela estiver ausente na origem, ou mude a imagem, ou reduza a meta de movimento. Por exemplo, use uma imagem da cintura para cima com as mãos visíveis para um apresentador que enfatizará “três passos práticos”. Um retrato apenas do rosto combina melhor com uma saudação curta ou narração em close.
Construa uma performance de uma imagem a partir de áudio e direção
Pense nas entradas como três funções diferentes. A imagem responde quem está na tela e como a tomada começa. O áudio carrega as palavras reais, as pausas e a energia vocal. A direção de texto pede um comportamento visual que se encaixe nessas indicações. Mantenha as entradas alinhadas; uma voz calma combinada com “dança selvagem e constante” dá ao modelo uma direção conflitante e pode produzir uma performance estranha.
Um fluxo de trabalho útil para a primeira tentativa é:
- Escolha a tomada. Decida se o espectador precisa de um rosto em close, mãos visíveis ou a figura inteira. Selecione uma origem com essa área no quadro.
- Prepare um áudio representativo. Use um trecho curto da narração ou música real, incluindo a frase em que o gesto deve acontecer. O teste deve representar o ritmo e a entrega finais.
- Adicione uma ideia de movimento. Descreva um único gesto e onde ele pertence na performance. Mantenha outras ações e solicitações de câmera contidas.
- Gere e revise. Verifique o rosto, as mãos, o corpo, o fundo e o enquadramento geral. Mude uma entrada por vez na próxima tentativa.
Para um vídeo explicativo de produto, uma fala de teste original pode ser: “Vamos cobrir três passos práticos, e então você pode escolher o que se encaixa na sua equipe.” Grave-a com uma breve pausa antes da frase “três passos práticos”. Use uma imagem da cintura para cima com ambas as mãos visíveis. Isso dá ao gesto pretendido uma indicação semântica clara e uma amplitude de movimento visível.
A documentação oficial da BytePlus que pode ser verificada aqui refere-se ao OmniHuman 1.5, não ao 2.0. Para o 1.5, ela lista uma imagem e áudio como entradas obrigatórias, um prompt opcional, idiomas de prompt aceitos e saída em 720p ou 1080p. Sua visão geral também lista um limite de áudio de 60 segundos e recomenda áudio mais curto para maior qualidade. Esses detalhes ajudam a distinguir o produto 1.5 documentado; verifique a interface 2.0 ou a documentação oficial antes de aplicar qualquer um deles ao 2.0 (documentação de geração de vídeo OmniHuman da BytePlus, atualizada em outubro de 2026).
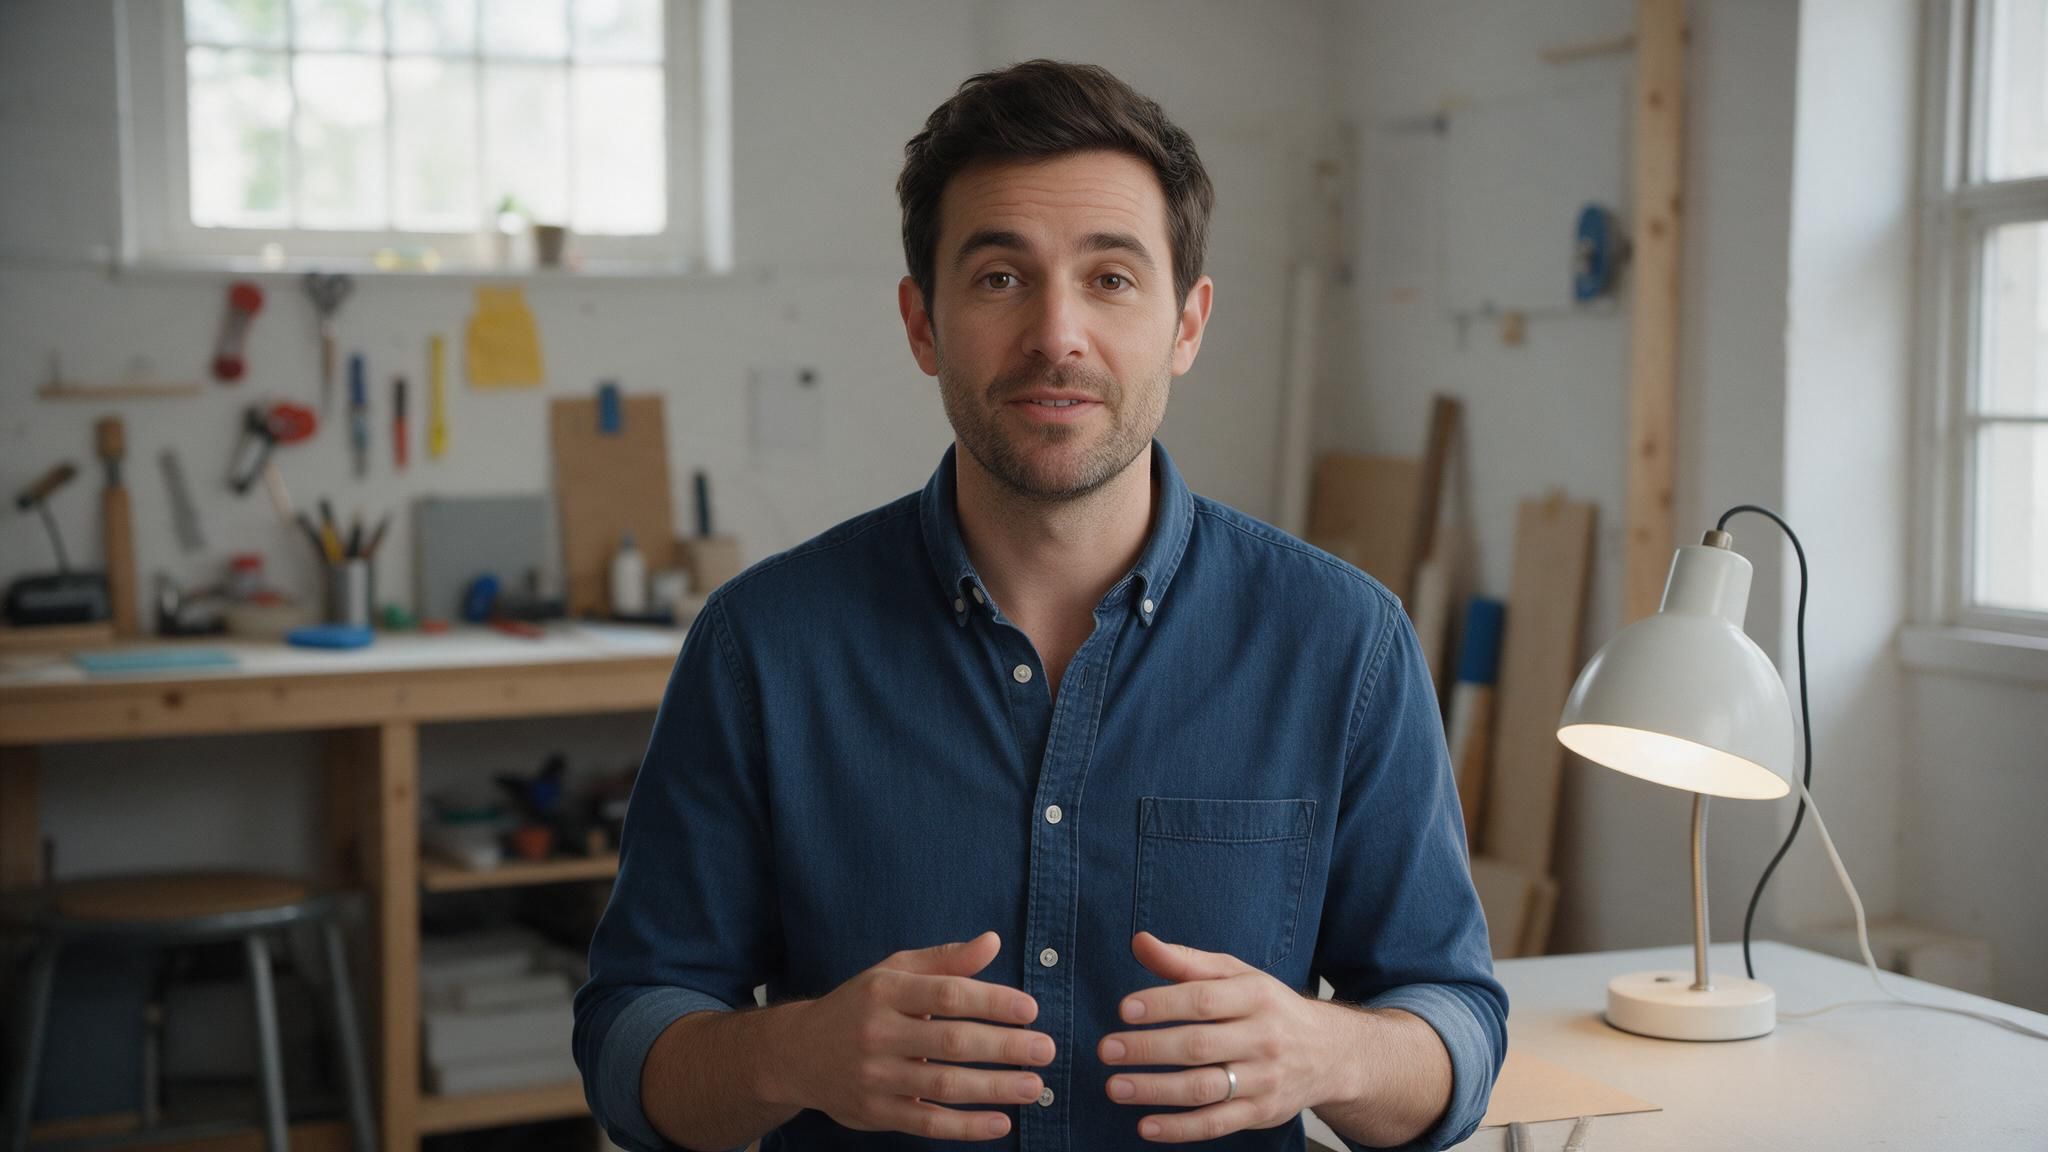
Imagem fixa de origem de exemplo para o vídeo explicativo de produto: o rosto do apresentador, ambas as mãos e o abajur estão visíveis, facilitando avaliar um pequeno gesto de mão cronometrado. Esta é uma foto de entrada, não uma saída do OmniHuman.
Use uma amostra representativa antes de preparar uma gravação longa. Um teste curto torna mais rápido perceber um corte incompatível, uma frase sem indicação de gesto ou um prompt que pede demais. É uma escolha de controle de qualidade, não uma afirmação sobre um limite de duração específico do 2.0.
Escreva prompts de gesto com uma indicação clara
Um prompt se torna mais fácil de avaliar quando nomeia uma ação, sua indicação, seu tamanho ou ritmo e qualquer restrição de enquadramento. Uma instrução ampla como “deixe a pessoa natural e expressiva” deixa várias decisões em aberto. Uma instrução focada diz ao modelo qual ação visível importa e quando ela deve ocorrer.
Experimente este exemplo com a fala de exemplo acima:
O falante profere a fala com um tom calmo e confiante. Mantenha a câmera estável. Quando o falante disser “três passos práticos”, levante brevemente uma mão para enfatizar o ponto e depois abaixe-a naturalmente. Use gestos pequenos e relaxados que permaneçam dentro do quadro visível.
A frase citada conecta a ação a um momento no áudio. “Levante brevemente uma mão” dá um gesto delimitado, e “permaneça dentro do quadro visível” evita pedir movimento além do corte. Este é um modelo de escrita de prompt, não um comando testado ou garantido do OmniHuman 2.0. Se o sistema não seguir palavras ou timing exatos de forma consistente, mantenha a frase como uma indicação ampla e julgue o movimento renderizado em vez de presumir uma coreografia precisa quadro a quadro.
Altere apenas uma variável principal entre tentativas. Se o gesto aparecer cedo demais, ajuste a indicação ou a pausa do áudio. Se o movimento da mão for grande demais, reduza a amplitude solicitada. Se o braço estiver instável ou parcialmente inventado, escolha uma origem em que o braço já esteja visível. Alterar a imagem, o áudio, o movimento e a direção de câmera ao mesmo tempo dificulta saber qual mudança ajudou.
Evite empilhar solicitações não relacionadas: um aceno de mão, um apontar, um giro, uma caminhada, uma órbita de câmera e uma mudança emocional, tudo em uma única frase curta. Cada uma adiciona outra exigência à mesma performance. Comece com um movimento proposital; adicione um segundo somente se o primeiro resultado continuar legível e a cena pedir por isso.
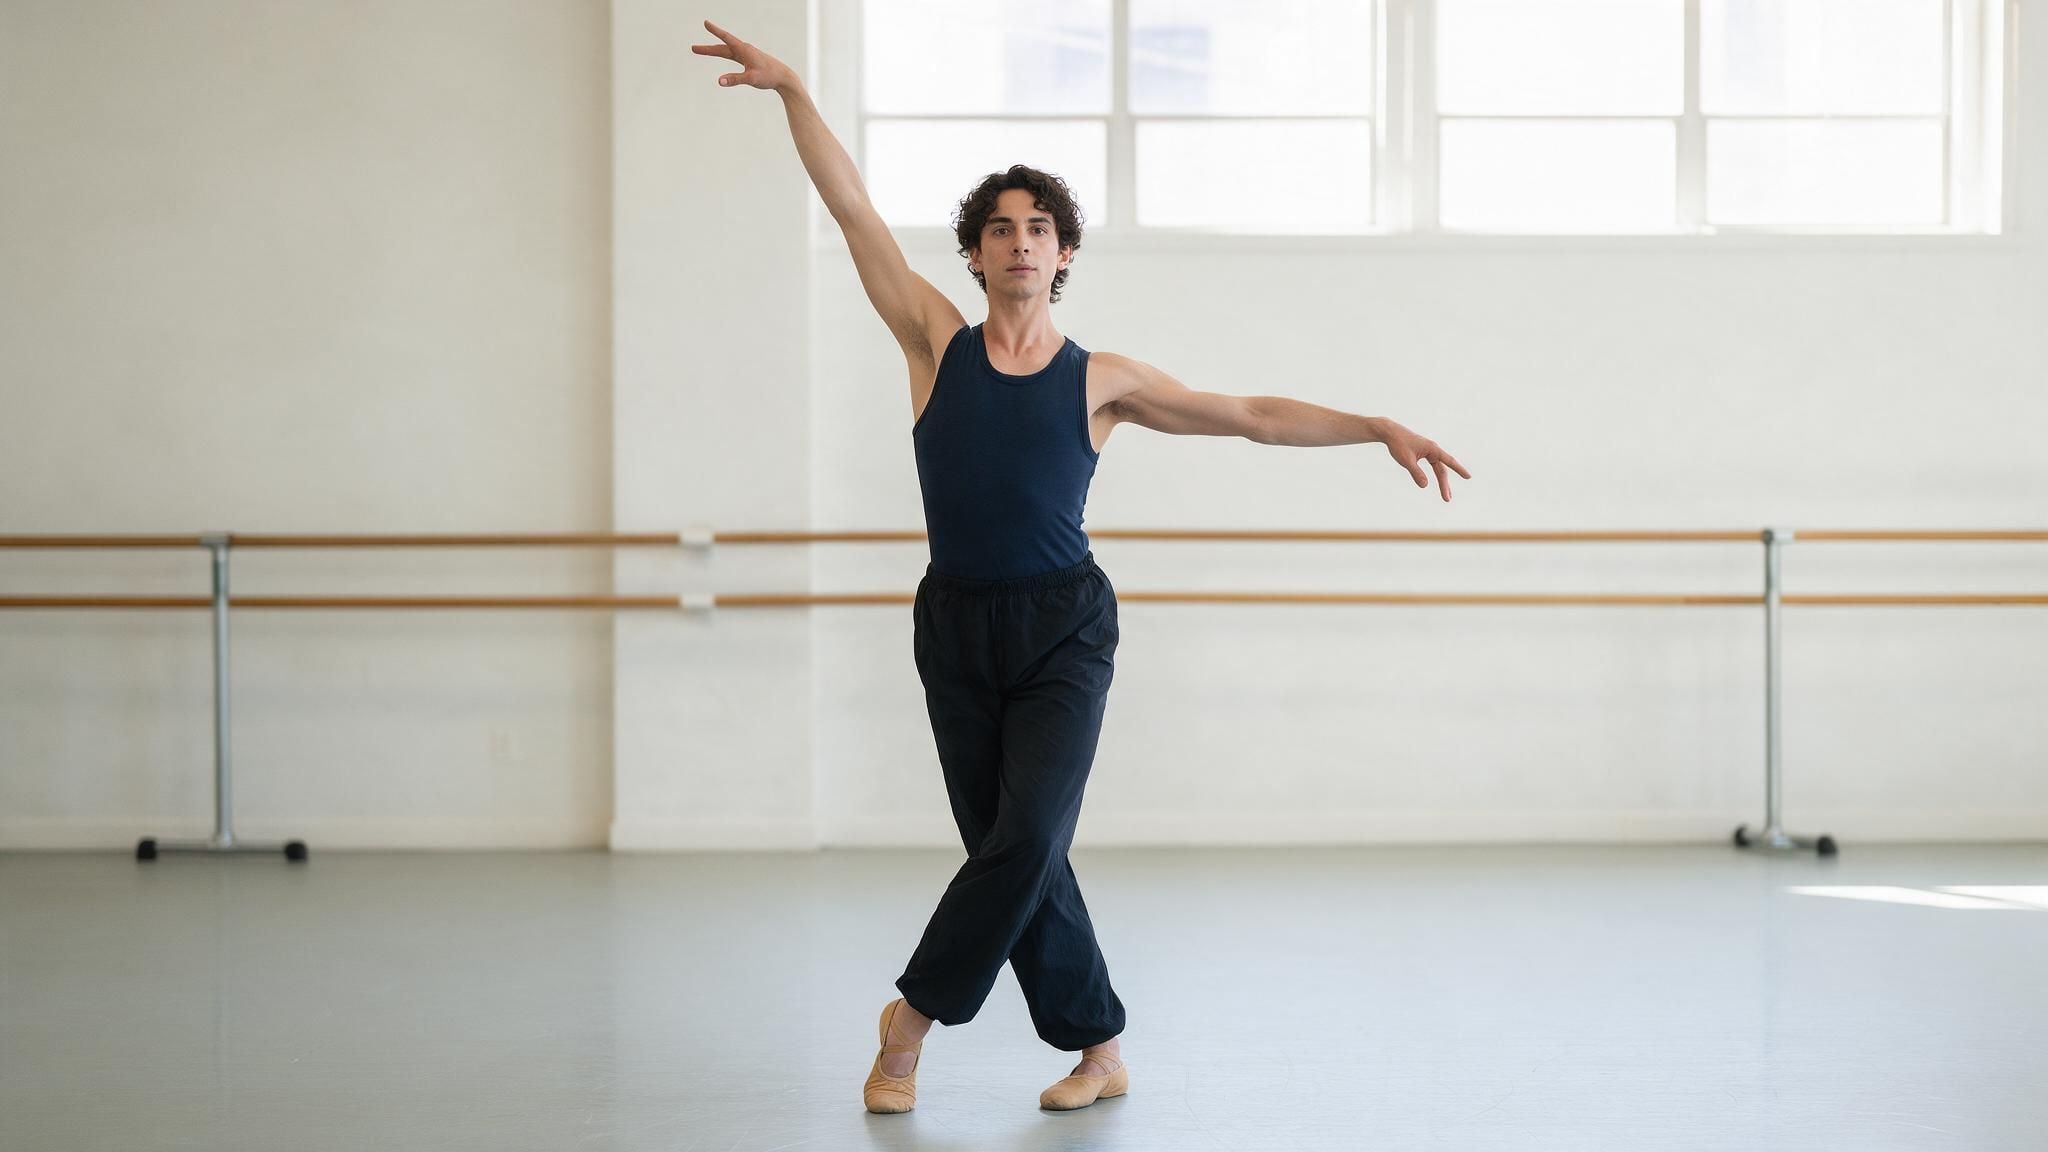
Imagem fixa de origem de exemplo para uma pose coordenada de corpo inteiro: o braço levantado, o braço estendido e os pés em passo permanecem dentro do quadro. Esta é uma imagem de referência para planejar um gesto, não um quadro gerado pelo OmniHuman.
Revise o resultado antes de publicar
Assista ao resultado uma vez para avaliar a performance geral e depois novamente para detalhes específicos. A segunda visualização é útil porque um clipe pode parecer plausível em velocidade normal e, ao ser inspecionado de perto, revelar um problema na mão ou no fundo.
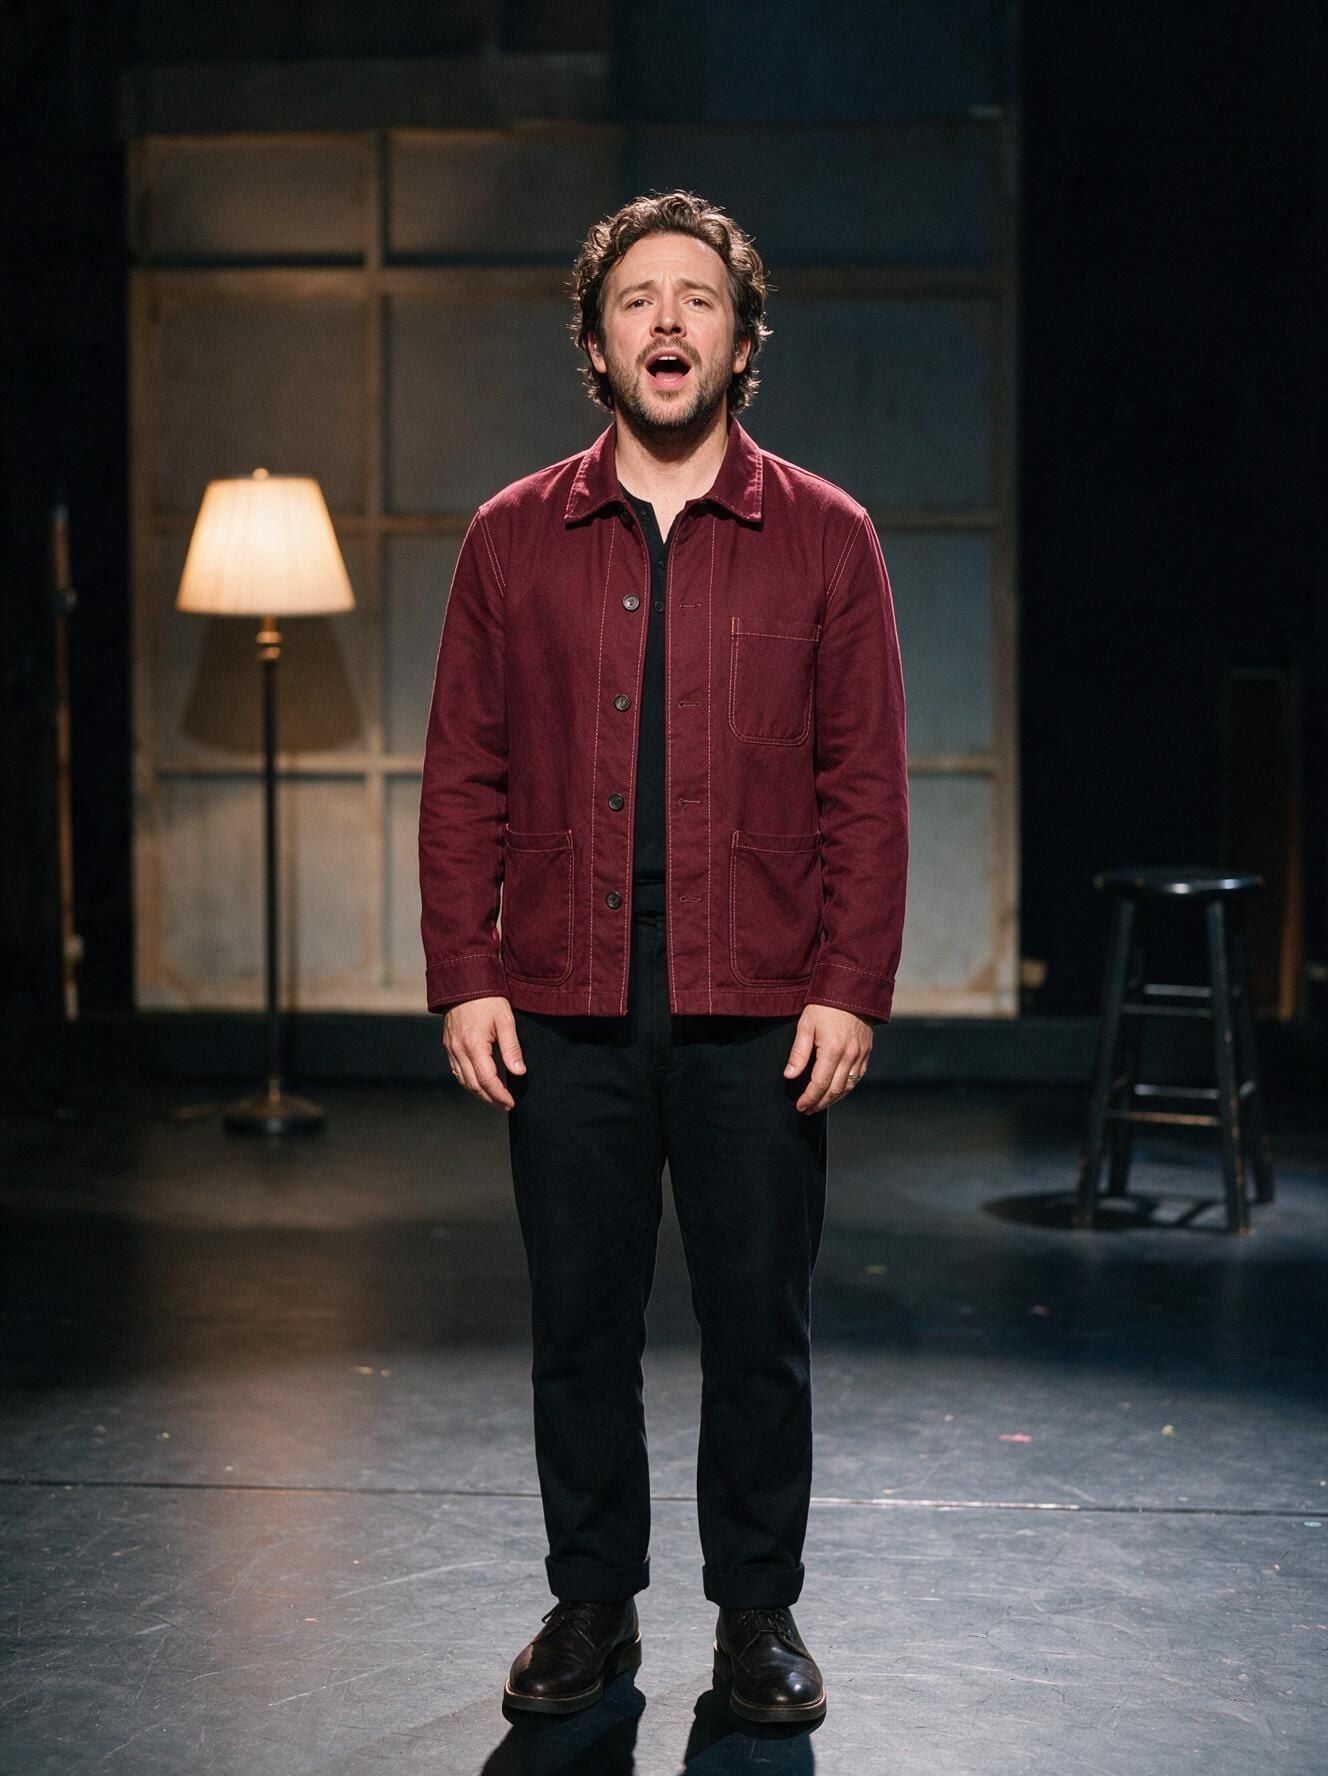
Imagem fixa de origem de exemplo para uma performance em pé: compare qualquer tomada gerada com o rosto, as mãos, a jaqueta, os sapatos, o abajur e o banco visíveis ao verificar identidade e consistência de cena. Esta é uma foto de entrada, não um quadro gerado.
Verifique estas cinco áreas:
- Fala e expressão: A boca acompanha amplamente a frase falada ou cantada? As expressões combinam com a entrega vocal?
- Tempo do gesto: O movimento aparece perto da ideia ou pausa pretendida? Ele para quando a ênfase termina?
- Mãos e corpo: Procure dedos brevemente fundidos, articulações dobradas, mangas que mudam ou proporções corporais que se alteram entre quadros.
- Identidade e cena: O rosto permanece reconhecível? Roupas, objetos de fundo e iluminação permanecem razoavelmente consistentes?
- Enquadramento da entrega: As mãos ou os pés estão cortados? O sujeito permanece nítido na proporção e no corte necessários?
Quando algo falhar, vincule a próxima tentativa à causa observada. Substitua a imagem quando a área corporal necessária estiver faltando ou o corte não deixar espaço para movimento. Substitua ou encurte o áudio quando a frase-chave estiver apressada, pouco clara ou emocionalmente incompatível. Reescreva a direção quando a ação chegar no momento errado ou for ampla demais. Se o clipe for para uma campanha pública, confirme também que você tem permissão para animar a imagem e usar a gravação de voz, e obtenha qualquer consentimento exigido das pessoas representadas.
Um resultado útil não é necessariamente o que tem mais movimento. Para uma introdução de curso ou explicação de produto, um gesto contido que preserva a identidade e mantém o sujeito dentro do quadro pode comunicar melhor do que uma ação elaborada que chama atenção para erros visuais. Mantenha a tomada que sustenta a mensagem e atende ao formato de publicação; depois guarde juntos a imagem de origem, o áudio, o prompt e a saída selecionada para revisões futuras.
Acesso, versões e preços do OmniHuman 2.0
A BytePlus lista o OmniHuman V2.0 em sua documentação de planos de economia para modelos de vídeo. Isso confirma que o nome da versão aparece em materiais da BytePlus, mas não estabelece um playground público da 2.0, limites de entrada detalhados ou um endpoint do Atlas Cloud (BytePlus AI Savings Plans). Verifique a versão exata do modelo antes de construir um fluxo de trabalho com base nisso. O nome “OmniHuman 2.0” não deve ser tratado como intercambiável com “OmniHuman 1.5”. A documentação da BytePlus atualmente trazida para este artigo está rotulada como OmniHuman 1.5. Ela documenta seu próprio esquema de entrada e restrições de serviço, que não devem ser transferidos para a 2.0 sem uma fonte oficial correspondente.
No momento da verificação para este artigo, o diretório público de modelos do Atlas Cloud mostrava um catálogo amplo de modelos, mas nenhuma página de detalhes do OmniHuman 2.0 pôde ser verificada ali. A página específica do modelo Avatar Omni Human identifica a oferta adjacente 1.5. Seu preço inicial exibido foi relatado como $0.12 por segundo nos materiais oficiais, mas preços e descontos podem mudar. Verifique novamente a página de detalhes e o diretório de modelos do Atlas Cloud antes de orçar ou publicar. Não use o preço da 1.5 como estimativa para a 2.0.
Se você precisa especificamente do OmniHuman 2.0, confirme sua rota oficial de acesso, os requisitos atuais de entrada e o preço com a BytePlus antes de preparar os ativos de produção. Se você estiver aberto a uma versão adjacente, o diretório do Atlas Cloud pode ajudar a verificar quais modelos de vídeo e avatar atualmente listados estão disponíveis em um único catálogo. Trate isso como uma escolha de produto separada: uma execução da 1.5 não pode validar um prompt ou resultado da 2.0.
Perguntas frequentes
O OmniHuman 2.0 pode gerar um vídeo de corpo inteiro a partir de uma imagem apenas do rosto?
Uma imagem apenas do rosto não mostra o detalhe corporal necessário para orientar uma performance de corpo inteiro. Um sistema pode inferir áreas ausentes, mas a aparência e o movimento delas se baseiam menos diretamente na origem. Para um gesto com a mão, use uma origem que mostre a mão e braço suficiente. Para uma ação em pé, comece com uma imagem de corpo inteiro.
O OmniHuman 2.0 precisa de áudio, ou um prompt de texto pode animar a imagem sozinho?
O fluxo de trabalho descrito do OmniHuman é orientado por imagem e áudio, com direção de texto opcional. Não presuma que a animação de imagem apenas com texto seja suportada pelo serviço 2.0 exato que você planeja usar. Verifique a página atual do produto desse serviço para saber quais entradas são aceitas.
Qual pode ser a duração de uma entrada de áudio do OmniHuman 2.0?
Não consegui verificar um limite oficial atual de duração de áudio da 2.0. A visão geral publicada da 1.5 pela BytePlus indica um limite inferior a 60 segundos e recomenda entradas mais curtas para qualidade, mas isso é uma especificação da 1.5. Confirme o limite da 2.0 no ponto de acesso oficial antes de gravar ou enviar uma faixa longa.
O OmniHuman 2.0 já está disponível no Atlas Cloud?
Nenhuma listagem pública do OmniHuman 2.0 era verificável no diretório do Atlas Cloud quando este artigo foi checado. A página adjacente do OmniHuman no Atlas Cloud é para a 1.5. Verifique o diretório novamente antes de usar, pois a disponibilidade no catálogo pode mudar.
Antes de iniciar sua próxima tentativa de geração de gestos de corpo inteiro do OmniHuman 2.0 a partir de uma única imagem, tome uma decisão primeiro: identifique a área corporal que a tomada final precisa mostrar e então escolha uma origem que já a contenha. Verifique a versão exata e os limites atuais no serviço que você usará, e teste um trecho de áudio curto e representativo antes de preparar a tomada completa de produção.





