A MiniMax lançou o H3 na sexta-feira. Em vinte e quatro horas, o Seedance 2.5 estava nas mãos das pessoas, e o cronograma colapsou em uma conversa: trinta segundos, 4K nativo, cinquenta entradas de referência. O post de lançamento do H3 ficou abaixo, silenciosamente, com quase ninguém fazendo um teste real nele.
Entendo por quê. Trinta segundos é um número ótimo. Cabe numa manchete.
Mas se você realmente produz novelas curtas verticais, sabe que a coisa que estraga sua noite não é o segundo trinta. É o plano 4. A mandíbula do protagonista masculino desloca meio centímetro, o gravata perde uma dobra, e o espectador desliza para longe antes de o gancho cair. Ninguém desiste porque um clipe tinha quinze segundos em vez de trinta. Eles desistem porque o cara no close-up não é o cara do plano geral.
Então pulei o duelo de especificações. Construí uma ficha de personagem em torno, um quadro de locação de seis painéis, escrevi um prompt de drama curto gótico de 15 segundos, e enviei o pacote idêntico para ambos os lados. Depois, fixei o olhar no rosto.
Principais conclusões
- Apenas o H3 pode ser acessado hoje — a API do Seedance 2.5 está na ByteDance, mas ainda é uma página de Dia 0 nesta plataforma.
- Especificações dividem-se claramente: Seedance 2.5 = 30s em um único take, 4K nativo, até 50 referências; H3 = 5–15s, 2K, áudio estéreo em cada clipe.
- Estabilidade de personagem é um problema de empacotamento — um bom pacote de referências, não um modelo maior, segura o rosto.
- Ambos geram áudio nativo; o H3 também fixa uma voz a partir de até três referências de áudio.
- Julgue pixels por quadro, não segundos — na mesma execução, o H3 retornou 1440p contra 720p do Seedance.
O Resultado Seedance 2.5 vs MiniMax H3, Antes de Qualquer Teoria
Antes de qualquer teoria, aqui está o que o fluxo de trabalho produz. Estes são quatro planos extraídos de um clipe vertical finalizado de 15 segundos e agrupados. É a própria execução de referência H3 da MiniMax, construída exatamente a partir da ficha de personagem e do quadro de locação que você verá nas Etapas 1 e 2, em 1440x2560 nativos. Minhas próprias execuções do mesmo pacote vêm depois, no tutorial, com o estado do playground visível.
Ela alcança a porta esculpida, que é o painel 4 do quadro de locação, depois o confronto no corredor, depois um close-up apertado nele, depois o plano conjunto. A linha do cabelo dele se separa da mesma forma no perfil e no close-up. A coroa trançada meio presa dela sobrevive a um close-up no rosto inteiro, que é exatamente onde a maioria dos modelos reconstrói um rosto silenciosamente. O corpete de renda creme mantém o mesmo decote e punho de manga do primeiro ao último quadro.
Esse é o teste inteiro. Não trinta segundos. Quatro planos e uma mandíbula.
Por que Seedance 2.5 vs MiniMax H3 Quebrou Na Mesma Semana, e Por que a Maioria dos Testes de Personagem São Inúteis
A MiniMax lançou o H3 em 30 de julho, um modelo de vídeo multimodal de uso geral que lê texto, imagens, vídeo e áudio como um único contexto e retorna clipes de 5 a 15 segundos em até 2K com som estéreo nativo. Ele também pode editar filmagens existentes e transferir movimento de um clipe para outro, e a MiniMax disse que os pesos seguiriam em dias (Reuters, julho de 2026).
O Seedance 2.5 chegou na mesma janela com um número mais alto: 30 segundos em uma única geração, 4K nativo e até 50 entradas de referência multimodal em um único trabalho (The Next Web, julho de 2026). Sua API já está nas mãos dos desenvolvedores, com edição localizada que redesenha parte de um quadro enquanto mantém desempenho, iluminação e comportamento de câmera intactos, referência-para-vídeo que aceita telas verdes ou modelos 3D em blocos brancos, onze idiomas e um modo de vídeo longo experimental que atinge 180 segundos (CineD, julho de 2026).
A lacuna de atenção é a parte interessante. Quase todo post que encontrei era um clipe do 2.5. Enquanto isso, os números da arena pública dizem outra coisa: no ranking de imagem-para-vídeo do Artificial Analysis, o Seedance 2.0 a 720p lidera com 1.196 Elo, o Gemini Omni Flash segue com 1.195, e o MiniMax H3 já é terceiro com 1.185, quatro dias após o lançamento. O Seedance 2.5 ainda não tem classificação lá (Artificial Analysis, julho de 2026). O modelo com menos buzz é o que tem a maior proporção de pontuação para atenção.
Agora a parte que realmente decide sua saída, porque quase não tem a ver com qual logotipo você escolhe.
A maioria dos testes de consistência de personagem falha antes mesmo de o modelo ser envolvido. Quatro modos de falha, e todos os quatro são seus para corrigir:
| Modo de falha | O que você vê na saída | A correção |
|---|---|---|
| Referências multivisuais enviadas como arquivos separados | O rosto de cada plano está "quase certo" e nenhum dois concordam | Componha as vistas em uma imagem, depois atribua funções no prompt ("o homem à ESQUERDA", "a mulher à DIREITA") |
| Reescrever a descrição do personagem a cada plano | Guarda-roupa e acessórios derivam de plano para plano | Escreva o bloco de identidade uma vez e reutilize-o textualmente; apenas câmera e ação mudam por plano |
| Deixar a iluminação se mover com a cena | O rosto é estruturalmente reconstruído na nova luz | Construa um quadro de locação separado que trave direção da luz, névoa e reflexo do chão, e alimente-o como referência |
| Tratar a duração máxima como métrica de qualidade | Um desvio dentro de 30 segundos mata todos os 30 | Corte para a granularidade que você pode re-gerar, depois fale sobre comprimento |
Quer colocar Seedance 2.5 e MiniMax H3 na frente do mesmo prompt você mesmo? A comparação de modelos da Atlas Cloud os executa lado a lado em uma única passagem — prompt e configurações idênticas, com o custo estimado antes de você gerar — para que você possa julgar rostos, movimentos e texto na tela sem agendar dois testes separados.
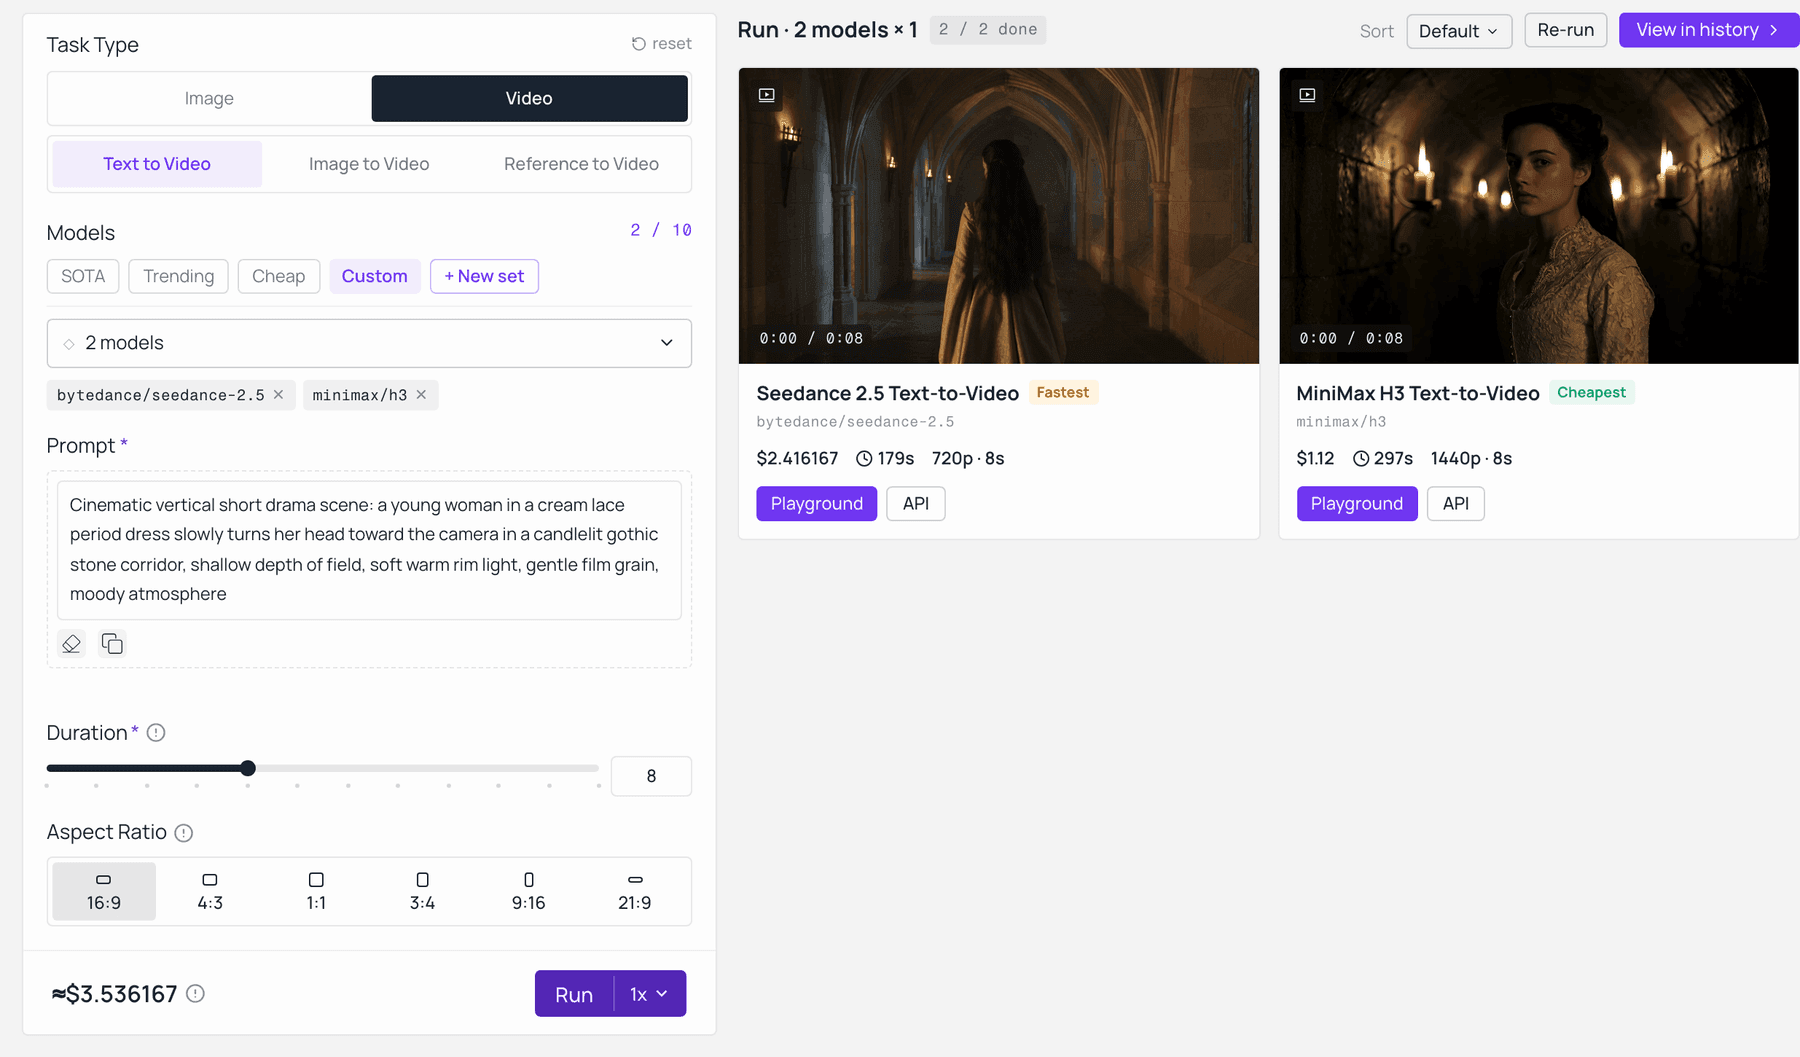
Seedance 2.5 e MiniMax H3 no prompt idêntico na comparação de modelos da Atlas Cloud. Seedance 2.5 retornou 720p a $2,42; MiniMax H3 retornou 1440p por $1,12, e ambos os preços foram estimados antes da execução. Capturado ao vivo no explorador de modelos.
A primeira linha é a que as pessoas mais erram. Envie seis imagens de vista única e o modelo as trata como seis pessoas candidatas e as calcula a média. Envie uma composição limpa e ele a trata como uma pessoa vista de três lados. Mesmos pixels, resultado completamente diferente.
Ficha Técnica Seedance 2.5 vs MiniMax H3, e o que Você Pode Realmente Acessar Hoje
Divida capacidade de disponibilidade e a tensão fica clara. Em capacidade bruta, o Seedance 2.5 lidera em duração, teto de resolução, contagem de referências e granularidade de edição. Em disponibilidade, o H3 é o que tem três endpoints ativos em uma plataforma de modelo de uso geral esta semana. Se você está fazendo comparação de modelos de vídeo de IA para planejamento de 2026, essa segunda coluna importa tanto quanto a primeira.
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 Ref-to-Video (o que executei) | |
|---|---|---|---|
| Duração máxima, uma geração | 5 a 15 s | até 30 s, sem costura (modo beta até 180 s, experimental) | menu de clipes curtos, veja página do modelo |
| Resolução | 2K nativo, lado curto 1440p em 16:9 a 9:16; um nível 768p é listado como futuro | 4K nativo, cor de 10 bits | até 720p neste endpoint |
| Taxa de quadros | 24 fps | não publicado separadamente | não publicado separadamente |
| Entradas de referência | 9 imagens + 3 vídeos + 3 áudios, 12 arquivos no total | até 50 referências multimodais | 9 imagens + 3 vídeos + 3 áudios |
| Áudio nativo | sim, toda saída, estéreo | sim, mais 11 idiomas de legenda e voz | sim |
| Granularidade de edição | edições de instrução de clipe inteiro (trocar personagem, fundo, iluminação, diálogo) | edições em nível de região que redesenham parte de um quadro | edições de instrução de clipe inteiro |
| Limite de prompt | 7.000 caracteres | não publicado | não publicado |
| Pesos abertos | anunciados para dias após o lançamento | não anunciados | não anunciados |
| Elo I2V do Artificial Analysis, 31 jul 2026 | 1.185 (3º) | ainda não avaliado | 1.196 (1º, entrada Dreamina 720p) |
| Acessível na plataforma que testei | sim, 3 endpoints | ainda não, página Dia 0 | sim |
Divulgação completa sobre a configuração do teste. O Seedance 2.5 não estava aberto na minha plataforma quando executei isso, então o lado Seedance é Seedance 2.0 Reference-to-Video, o membro atualmente em envio da mesma família com o mesmo sistema de referência quad-modal. Onde o 2.5 mudaria a resposta, eu digo. A página do Seedance 2.5 é um aviso de Dia 0 por enquanto.
Tudo abaixo roda em uma aba do navegador, em uma chave, três modelos no total:
| Etapa | Modelo | O que produz | Configurações principais | O que determina o custo |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 Text-to-Image | a ficha de personagem em torno | qualidade alta, 16:9 | por imagem, pague conforme usar, taxa atual na página do modelo |
| 2 | mesmo modelo, segunda execução | o quadro de locação e iluminação de seis painéis | qualidade alta, 16:9 | por imagem, pague conforme usar |
| 3 | MiniMax H3 Reference-to-Video | o clipe 9:16 com áudio nativo | 9:16, 2K, duração 5 para teste e 15 para o corte real | segundos x resolução, cobrado por segundo |
| 4 | Seedance 2.0 Reference-to-Video | a execução de controle, entradas idênticas | 9:16, maior resolução disponível, mesma duração | segundos x resolução, cobrado por segundo |
| 5 | H3 Reference-to-Video, clipe como entrada | um plano fixo sem re-gerar tudo | mesma resolução, curta duração | segundos x resolução, cobrado por segundo |
O H3 também tem entradas text-to-video e image-to-video se você quiser uma linha de base de texto puro ou controle de primeiro e último quadro.
Mais uma coisa que vale saber antes de planejar um lote: texto na tela. Esta sequência de título de 15 segundos do H3 mantém créditos em inglês através de oito cortes secos sem um único erro de ortografia, que é uma das coisas mais difíceis de manter estável em vídeo gerado.
O Fluxo de Trabalho de Drama Curto Seedance 2.5 vs MiniMax H3, Passo a Passo
Cinco etapas. Copie os prompts exatamente como escritos, incluindo as partes feias. Não os limpei para o artigo e você não deve limpá-los para o modelo.
Etapa 1: Construa a ficha de personagem com GPT Image 2
Faça o pacote de referência antes de fazer qualquer vídeo. Uma imagem, dois personagens, três vistas cada, fundo branco puro sem costura, iluminação de estúdio uniforme. Isso remove toda ambiguidade exceto a que você se importa: como essa pessoa se parece.
plaintext1Uma folha de referência de rotação de personagem em corpo inteiro em fundo branco puro sem costura, dois personagens lado a lado, seis figuras no total, iluminação de estúdio neutra uniforme, sem sombras no chão, sem texto, sem rótulos, sem marca d'água. 2 3METADE ESQUERDA, protagonista masculino, três vistas em uma fileira: frente, perfil direito, costas. Final dos 20 anos, pele pálida, cabelo escuro ondulado de comprimento médio, mandíbula marcada. Vestindo um sobretudo de veludo preto até o chão com bordados sutis nos lapelas e punhos, um colete de brocado preto, uma gravata de seda preta, calças pretas retas, sapatos Derby de couro preto polido. Braços relaxados ao lado do corpo, expressão neutra. 4 5METADE DIREITA, protagonista feminina, três vistas em uma fileira: frente, perfil direito, costas. Início dos 20 anos, pele clara, cabelo longo ondulado castanho-acaju com uma coroa trançada meio presa. Vestindo um vestido vitoriano de renda de algodão creme, mangas compridas com punhos de renda, corpete ajustado com pequenos botões, saia longa até o tornozelo, sapatos de salto baixo com tira no tornozelo cor creme. Braços relaxados ao lado do corpo, expressão neutra. 6 7Realismo fotográfico, escala consistente entre todas as seis figuras, pés alinhados na mesma linha de base, foco nítido de ponta a ponta.
Configurações: modelo OpenAI GPT Image 2 Text-to-Image, Qualidade alta, Proporção 16:9, todo o resto padrão.
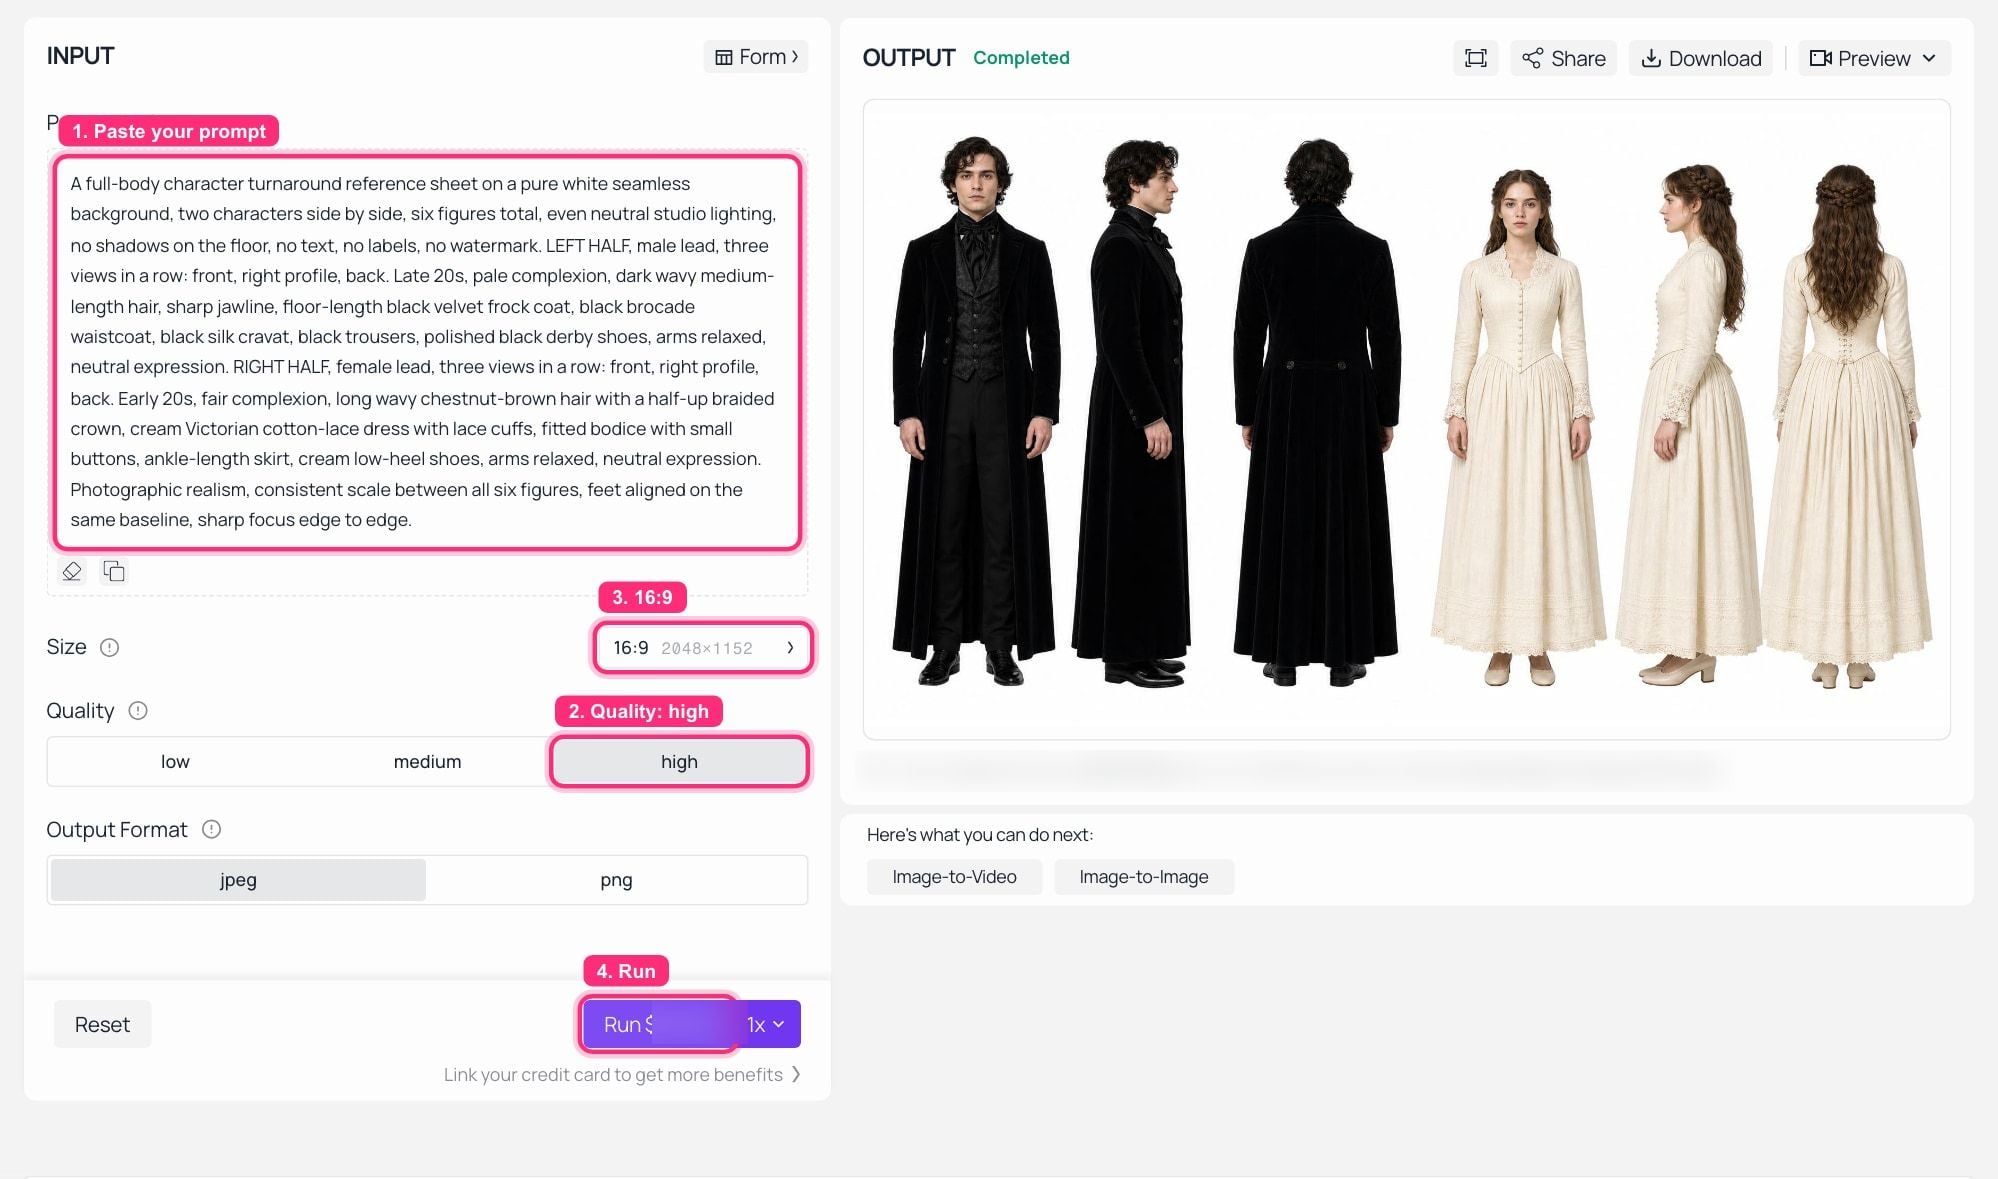 GPT Image 2 Text-to-Image na Atlas Cloud, execução concluída: o prompt de rotação à esquerda, seis figuras em uma folha branca no painel OUTPUT.
Esta é a forma alvo. Seis figuras, uma linha de base, nada no fundo para discutir:
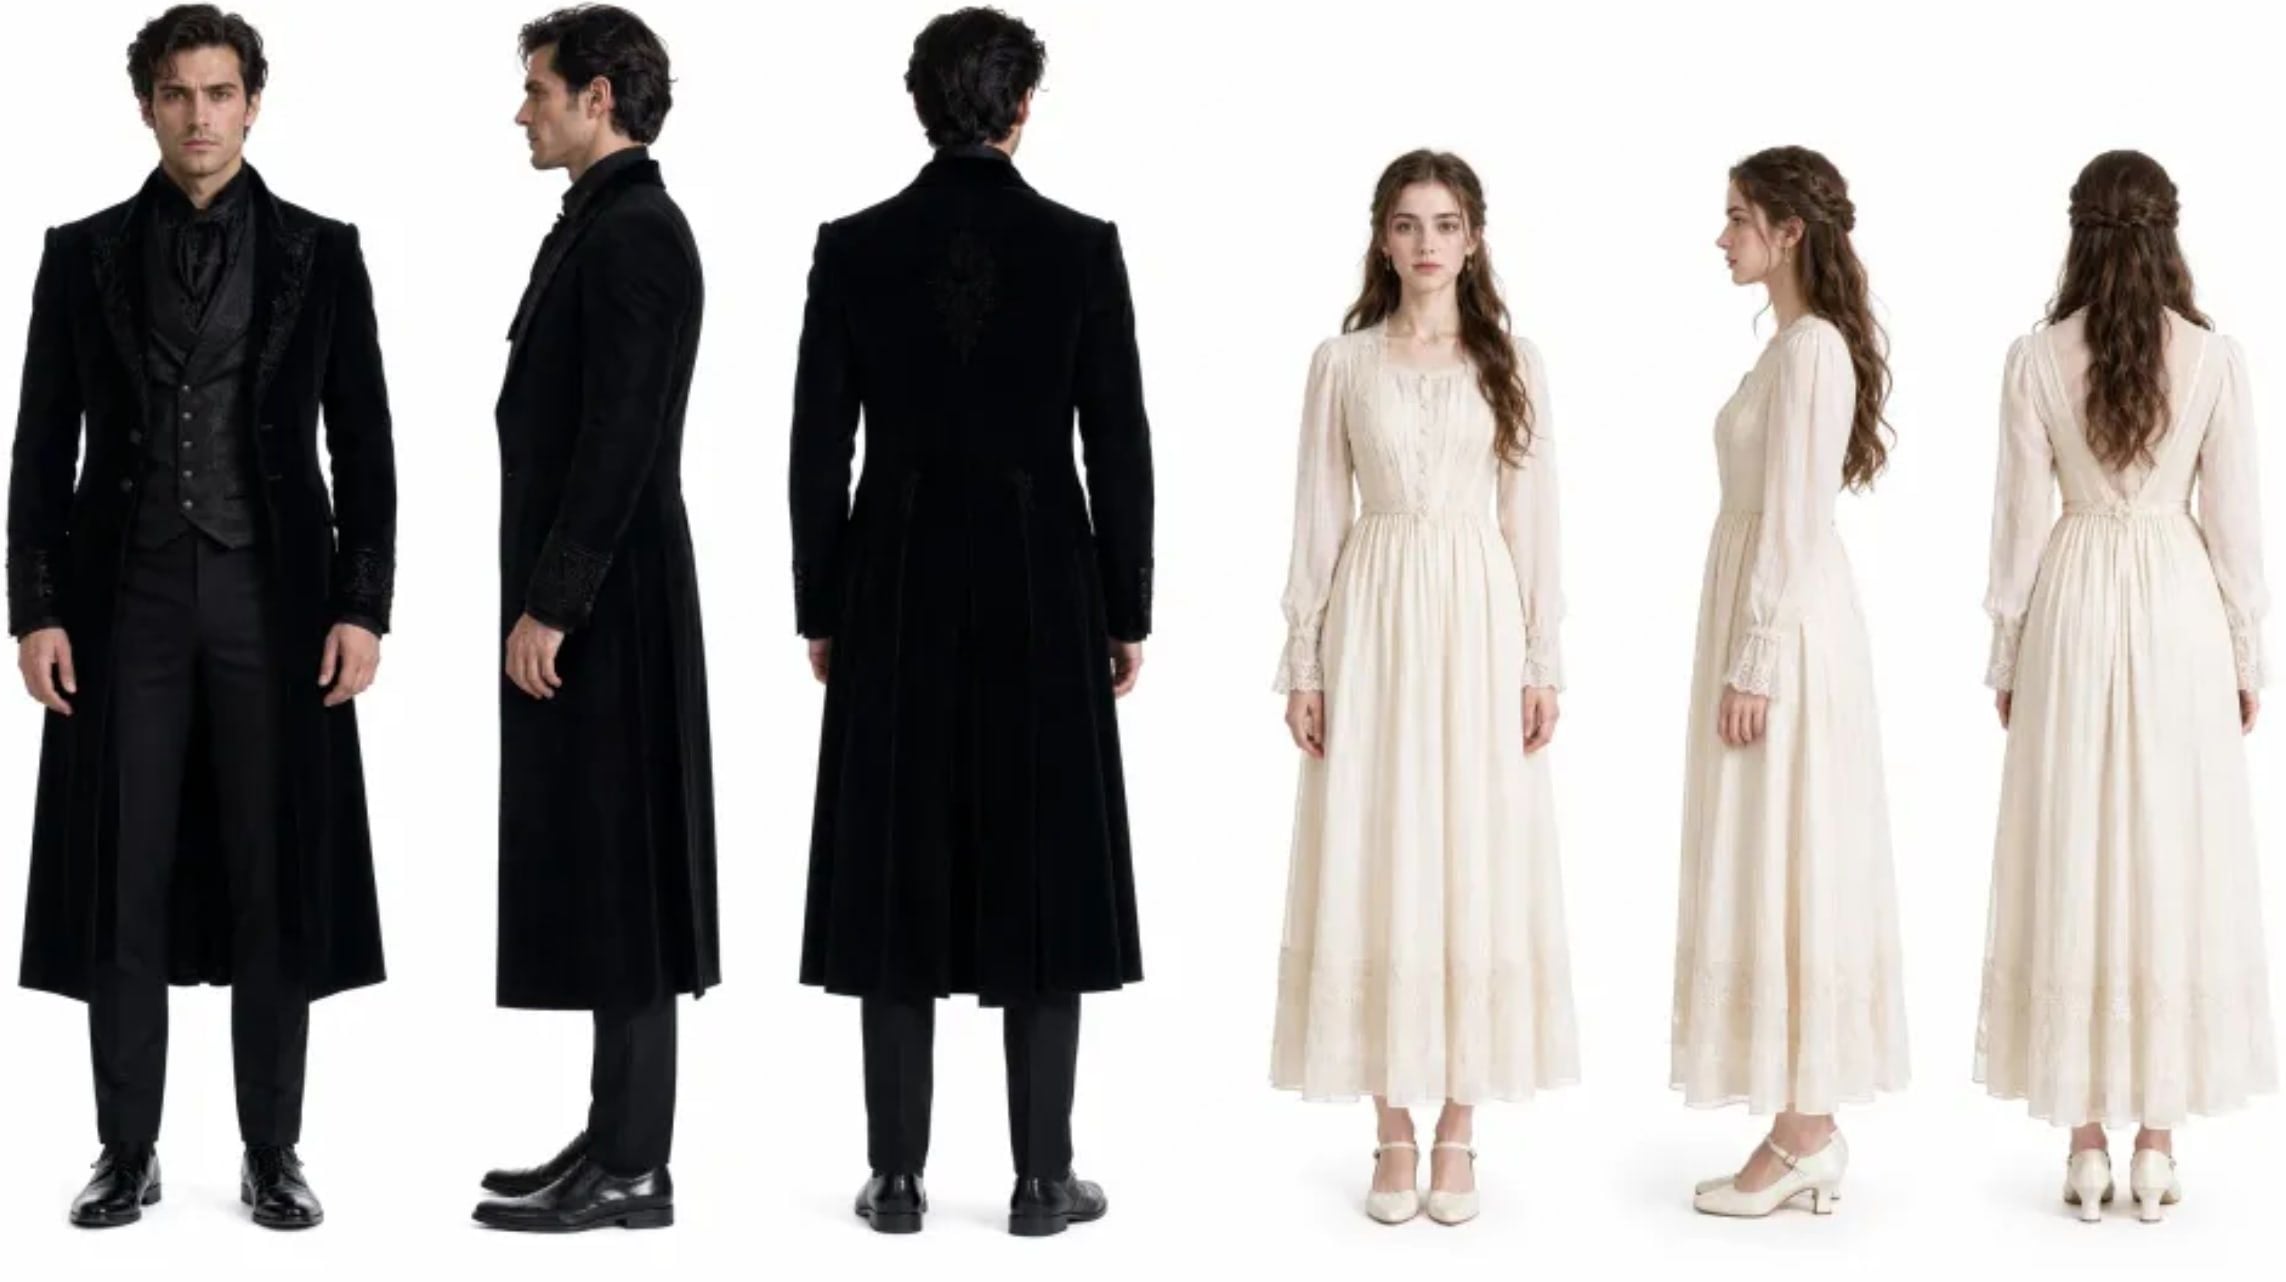 O pacote de referência que gerou o clipe de demonstração: protagonista masculino em veludo preto, protagonista feminina em renda vitoriana creme, três vistas cada, um arquivo.
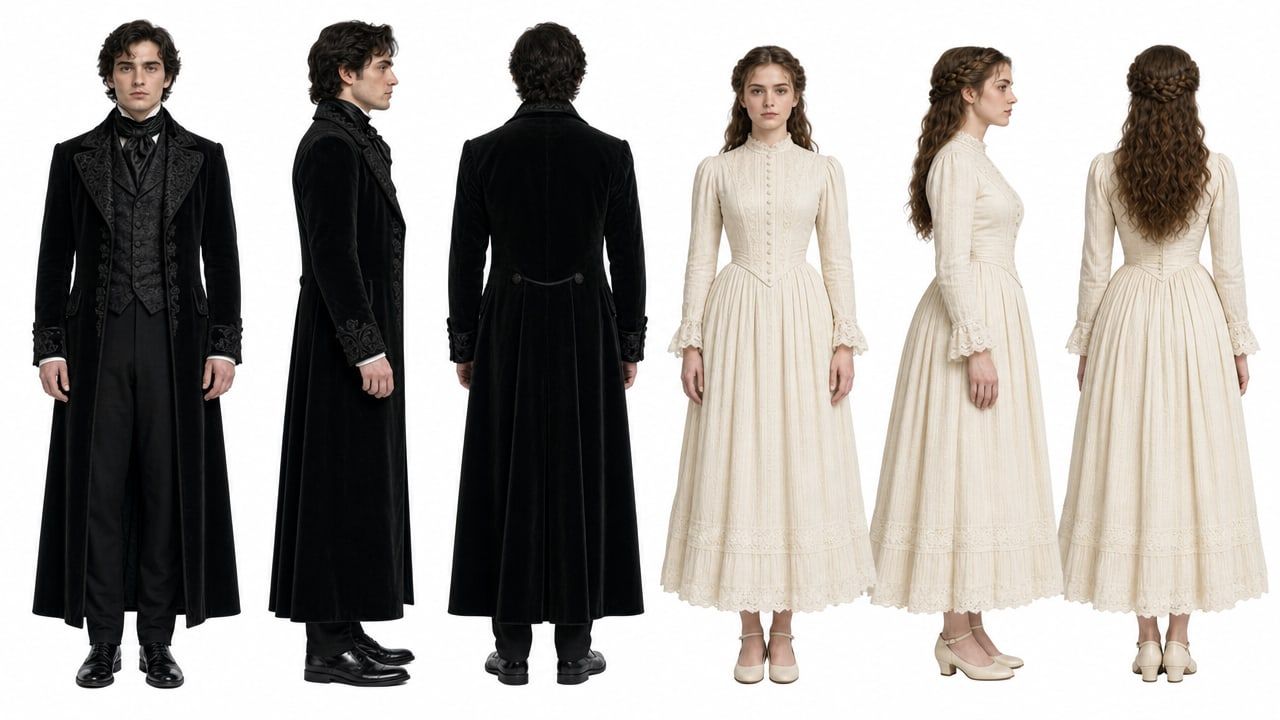 Minha própria execução do GPT Image 2 do prompt da Etapa 1, para comparação com a referência acima.
Etapa 2: Trave a locação com um quadro de cena de seis painéis
Você segurou o rosto. A luz ainda vai te trair. A segunda imagem de referência fixa seis posições de câmera, a direção do luar, quanta névoa está no ar e quão molhado o chão parece. Você está dizendo ao modelo que este filme tem exatamente uma configuração de iluminação.
plaintext1Um quadro de locação cinematográfico de seis painéis, 2 fileiras por 3 colunas, finas separações pretas entre os painéis, cada painel legendado em tipo maiúsculo branco elegante pequeno com espaçamento na parte inferior desse painel. Assunto: o interior de um castelo gótico abandonado à noite. Luar azul frio, névoa baixa flutuante, chão de pedra molhado refletivo, vitrais altos, castiçais de ferro com pequenas chamas quentes, pretos profundos dessaturados, cortinas de veludo pesadas. Nenhuma pessoa em qualquer painel. 2 3Painel 1, legenda "VISTA GERAL ESTABELECEDORA - CORREDOR": um longo corredor com colunas recuando para um vitral iluminado. 4Painel 2, legenda "ÂNGULO BAIXO - LUAR ATRAVESSANDO O CHÃO": câmera baixa, um feixe de luar varrendo pedras molhadas. 5Painel 3, legenda "COMPOSIÇÃO PORTA & ESCADARIA": uma porta em arco emoldurando uma escada de pedra curva. 6Painel 4, legenda "DETALHE PRÓXIMO - PORTA ESCULPIDA": plano fechado de uma porta de madeira pesada esculpida com uma maçaneta de ferro. 7Painel 5, legenda "VISTA AO LADO DA JANELA - NÉVOA E CORTINAS": janela alta, névoa entrando, borda da cortina em primeiro plano. 8Painel 6, legenda "QUADRO FINAL DE PÔSTER - SALÃO VAZIO": salão vazio simétrico, tapete de corredor estampado levando à janela. 9 10Fotográfico, cinematográfico, grão de filme, gradação de cor consistente em todos os seis painéis.
Configurações: mesmo modelo, Qualidade alta, Proporção 16:9.
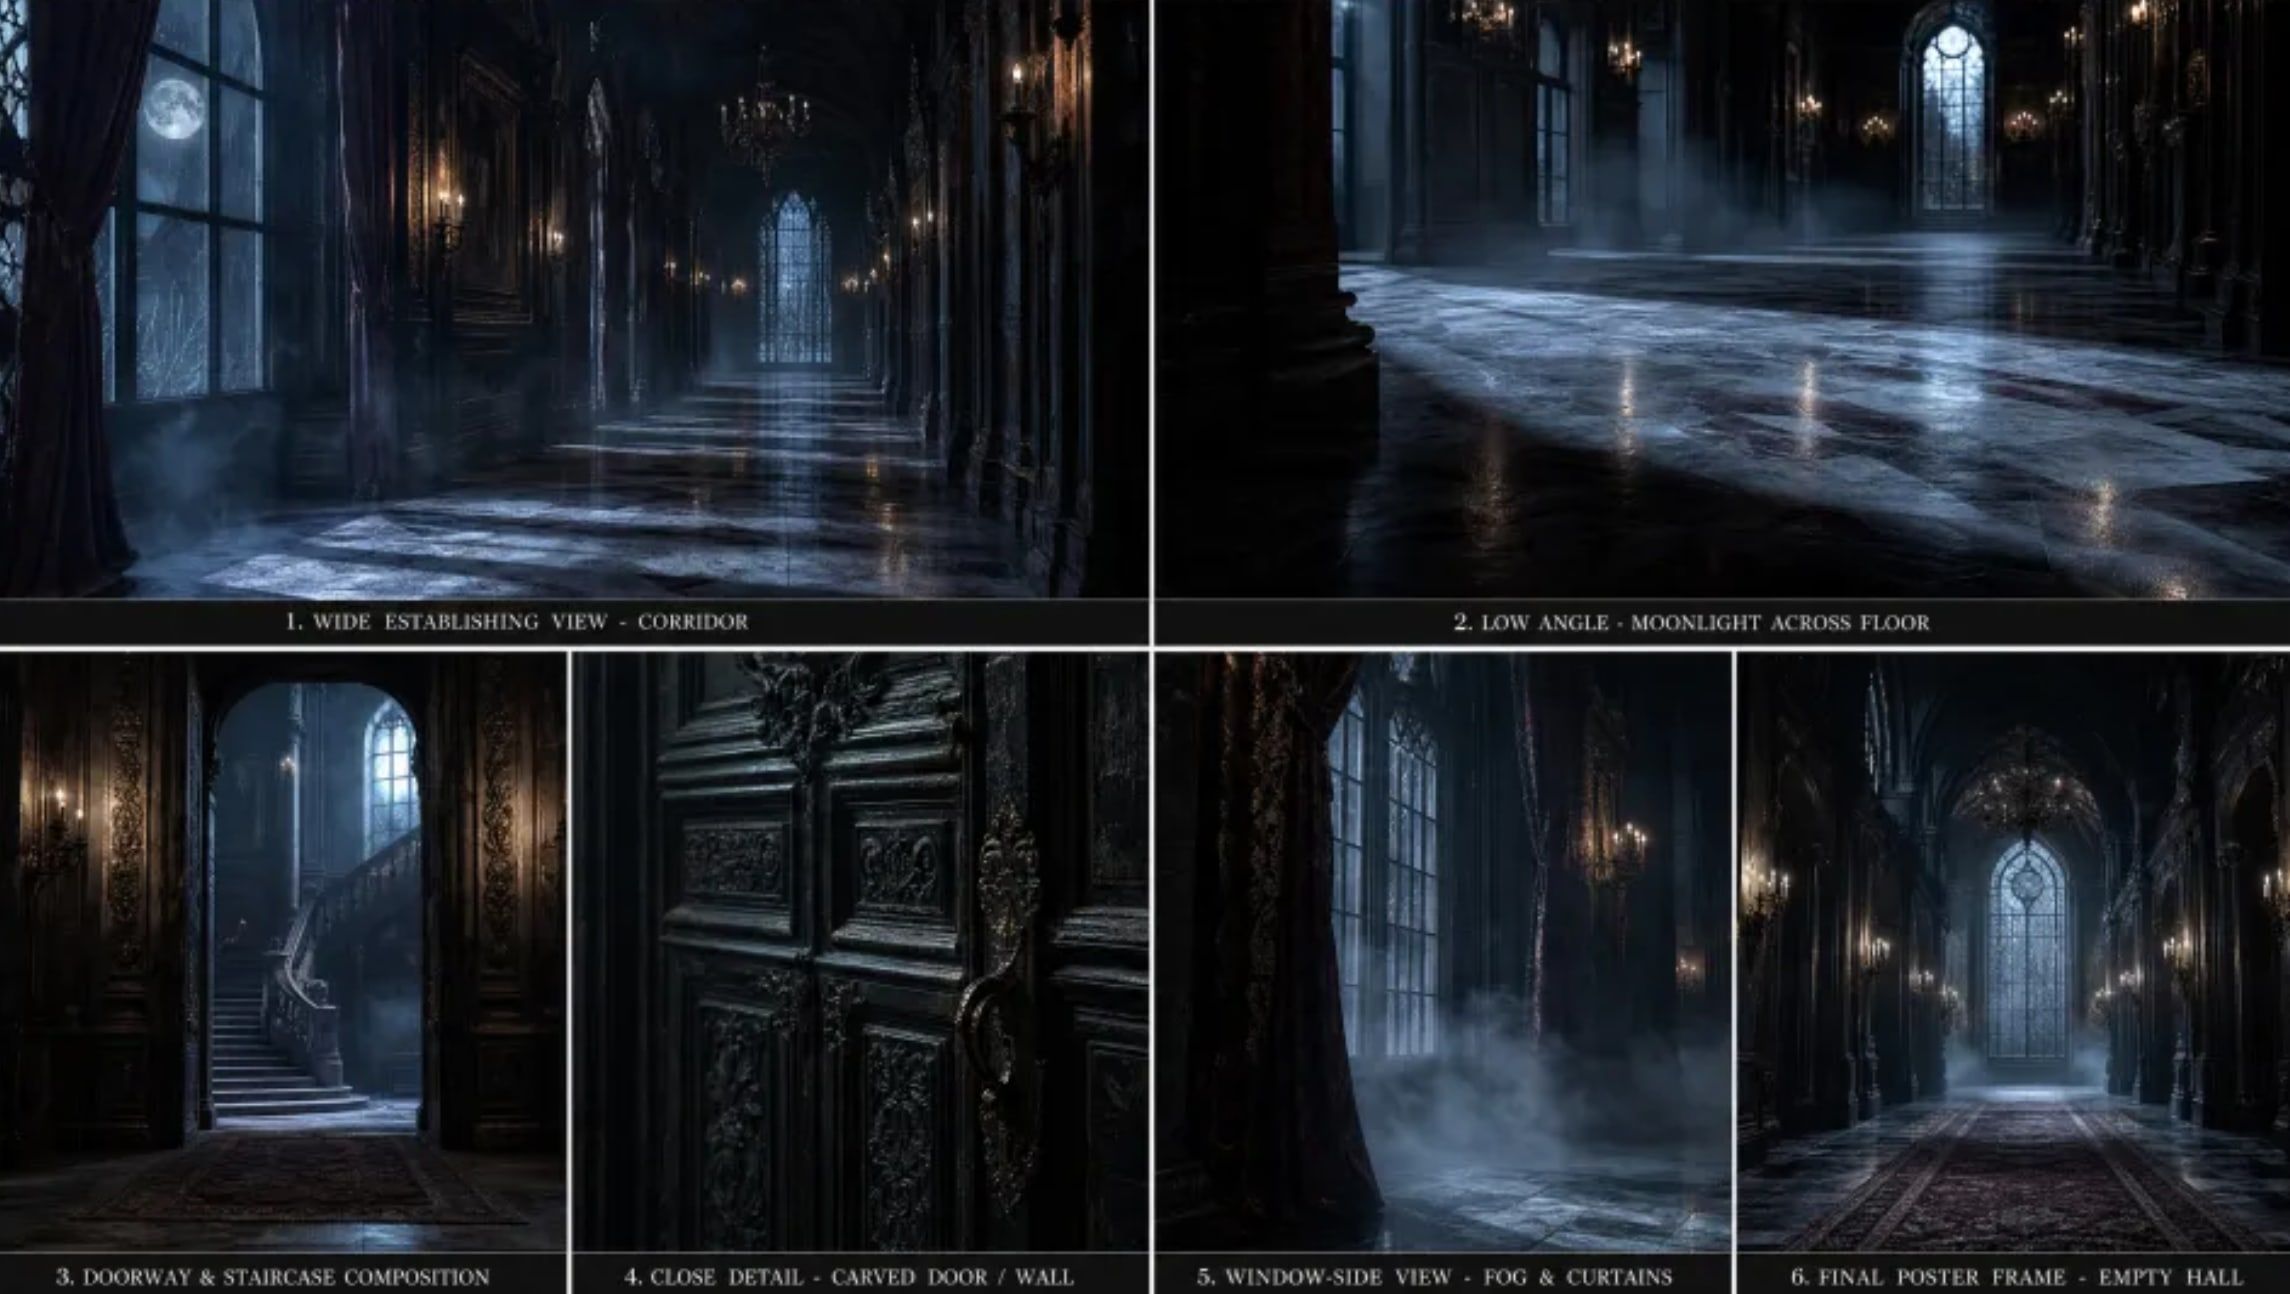 O quadro de locação que gerou o clipe de demonstração: seis interiores de castelo gótico, uma gradação de cor, legendas legíveis.
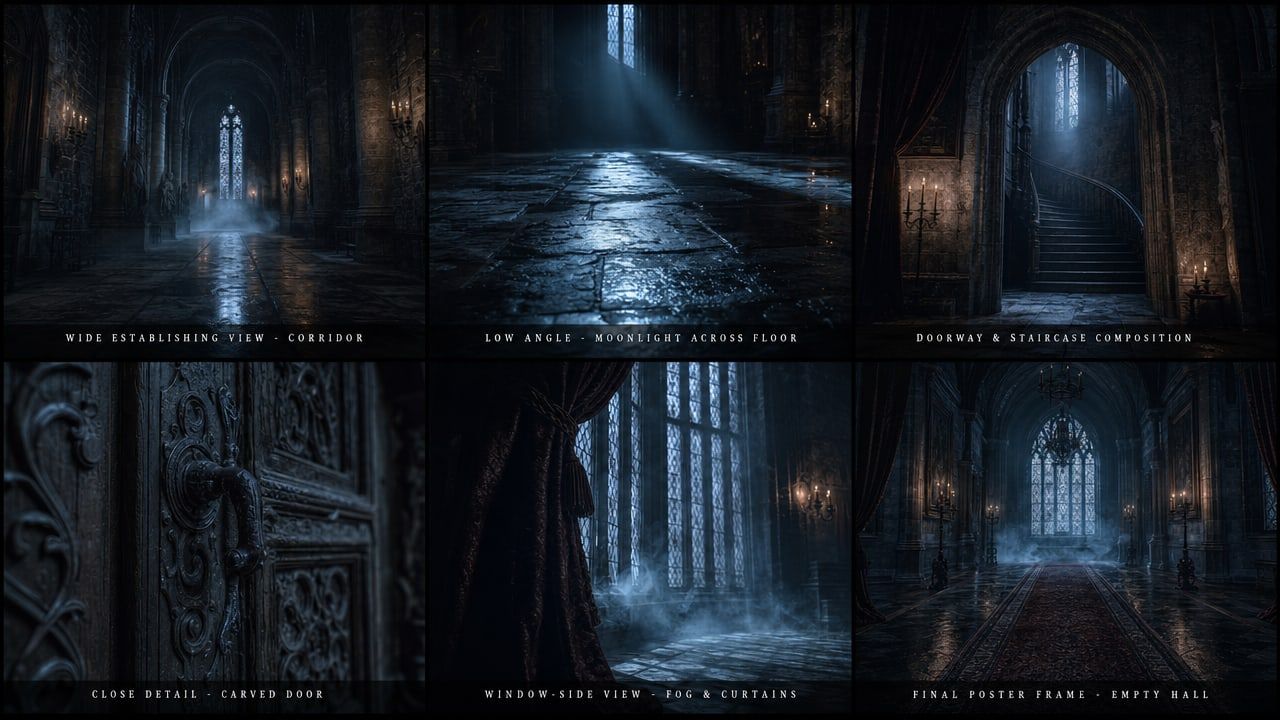 Minha própria execução do GPT Image 2 do prompt do quadro da Etapa 2.
Etapa 3: Gere o plano com MiniMax H3 reference-to-video
Duas imagens de referência mais um prompt carregando posições de câmera e direção de áudio. O som é produzido na mesma passagem, então não há etapa separada de voz ou trilha sonora. Mantenha a duração curta enquanto ajusta, depois aumente para 15 para o corte real.
plaintext1A imagem de referência 1 é a ficha de personagem: o homem à ESQUERDA é o protagonista masculino, a mulher à DIREITA é a protagonista feminina. Mantenha ambas as identidades exatamente como mostrado: a mandíbula dele, cabelo escuro ondulado, sobretudo de veludo preto, colete de brocado preto e gravata de seda preta; o cabelo castanho-acaju meio preso trançado e vestido de renda vitoriana creme dela. A imagem de referência 2 é o quadro de locação e iluminação: combine seu luar azul frio, névoa flutuante, chão de pedra molhado refletivo e tons pretos dessaturados. 2 39:16 vertical, visual premium de drama curto live-action, profundidade de campo rasa, contraste cinematográfico, sem legendas, sem texto na tela, sem marca d'água. 4 5Plano 1: Médio close-up, câmera lentamente avançando. A protagonista feminina está no corredor iluminado pelo luar, respirando superficialmente, olhos fixos em algo fora do quadro à direita. Névoa passa por ela na altura dos joelhos. 6Plano 2: Corte seco. Por cima do ombro por trás dela, o protagonista masculino sai do arco escuro para o luar, o casaco capturando a luz, expressão fria e curiosa. 7Plano 3: Close-up apertado no rosto dele, meio iluminado pela janela, depois um close-up correspondente no dela enquanto ela se recusa a desviar o olhar. 8 9Áudio: zumbido grave sustentado baixo, eco de pedra distante, respiração irregular dela, uma pisada pesada enquanto ele entra na luz, um único acorde suave de cordas no último corte.
Configurações: modelo MiniMax H3 Reference-to-Video, Resolução 2K, Duração 8 (o padrão do controle deslizante; aumente para 15 para o corte real), Proporção adaptativa, e ambos os arquivos em Materiais de Referência. O painel os conta como 2 de 9, então você tem bastante espaço para adicionar placas de guarda-roupa ou adereços depois.
Vale notar o que aconteceu com a proporção. Deixei Proporção em adaptativa e escrevi apenas "9:16 vertical" dentro do prompt. O H3 veio vertical mesmo assim, então ele leu o enquadramento do texto em vez de precisar do campo de formulário.
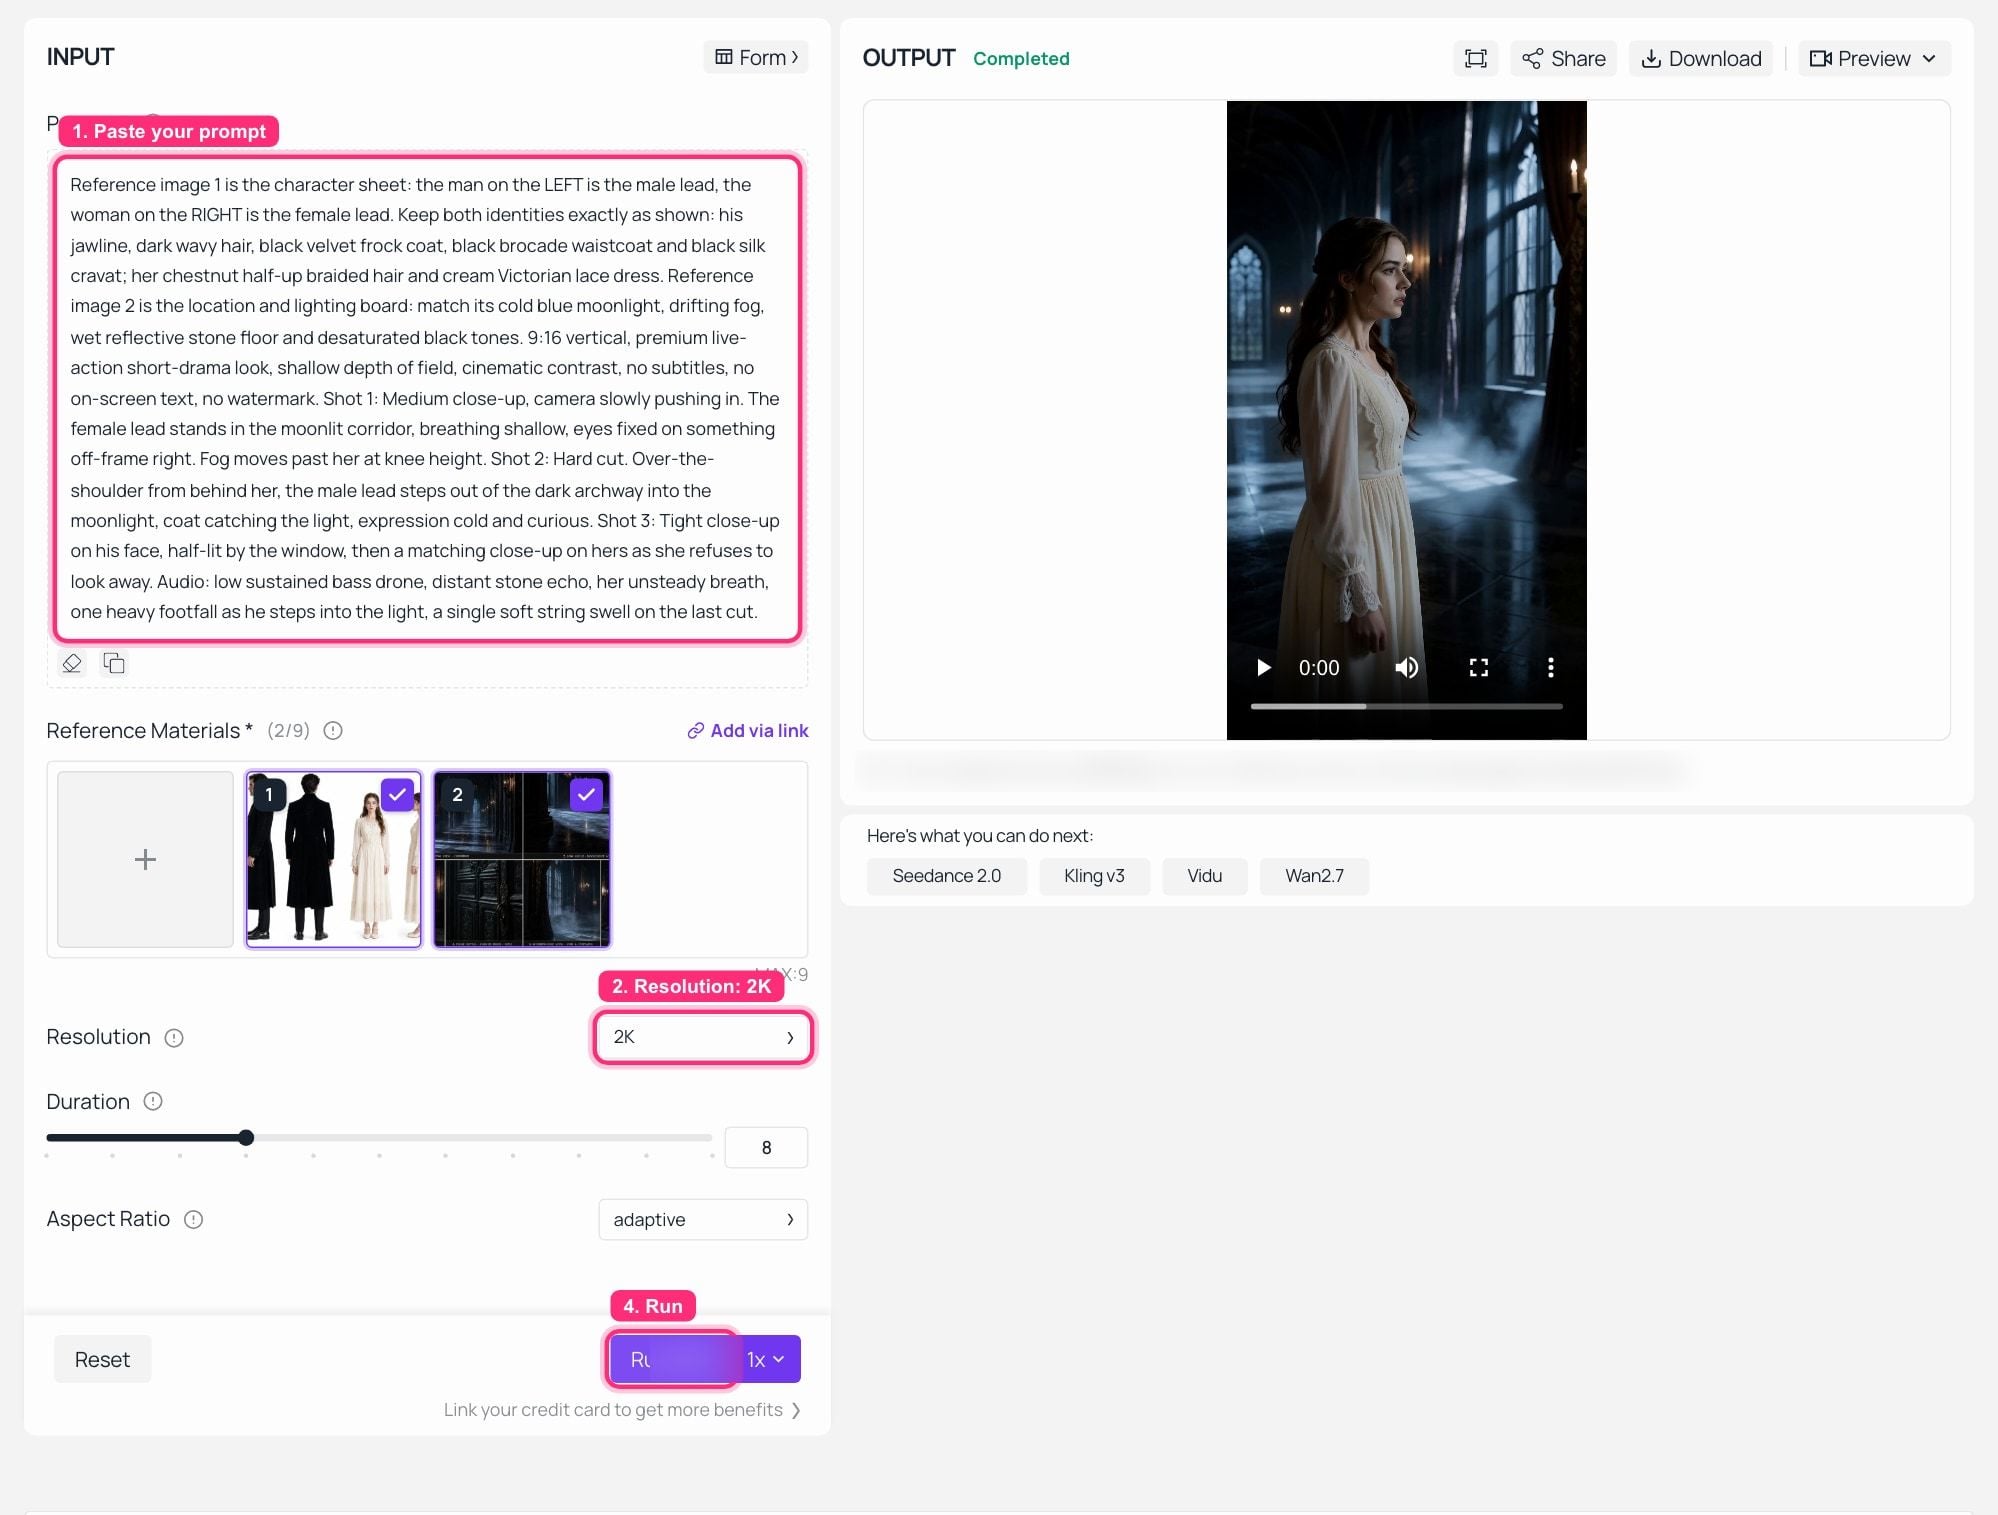 MiniMax H3 Reference-to-Video na Atlas Cloud, execução concluída: ambos os arquivos de referência carregados como 2 de 9, resolução 2K, e o clipe vertical gerado tocando no painel OUTPUT.
O primeiro quadro é a protagonista feminina no corpete de renda creme, em pé no corredor do painel 1 do quadro, com névoa na altura dos joelhos e o luar atingindo o chão molhado exatamente onde o quadro o colocou. Ambas as imagens de referência funcionaram.
Etapa 4: Execute o controle Seedance 2.5 vs MiniMax H3 com o pacote idêntico
Não mude uma palavra. Mesmas duas imagens de referência, mesmo prompt, modelo diferente. Deixei o padrão de duração de cada página sozinho em vez de forçar uma correspondência, e digo o que cada um retornou abaixo. Reformular um prompt "para" o outro modelo é exatamente como as comparações começam a mentir.
plaintext1Mesmo prompt da Etapa 3, textualmente. Não o reformule para o outro modelo.
Configurações: modelo Seedance 2.0 Reference-to-Video, Resolução 720p, mesmas duas imagens de referência em Imagens de Referência (novamente 2 de 9, com slots separados para até 3 vídeos de referência e 3 arquivos de áudio de referência). Duração deixada no padrão da página, que retornou como um clipe de 10 segundos.
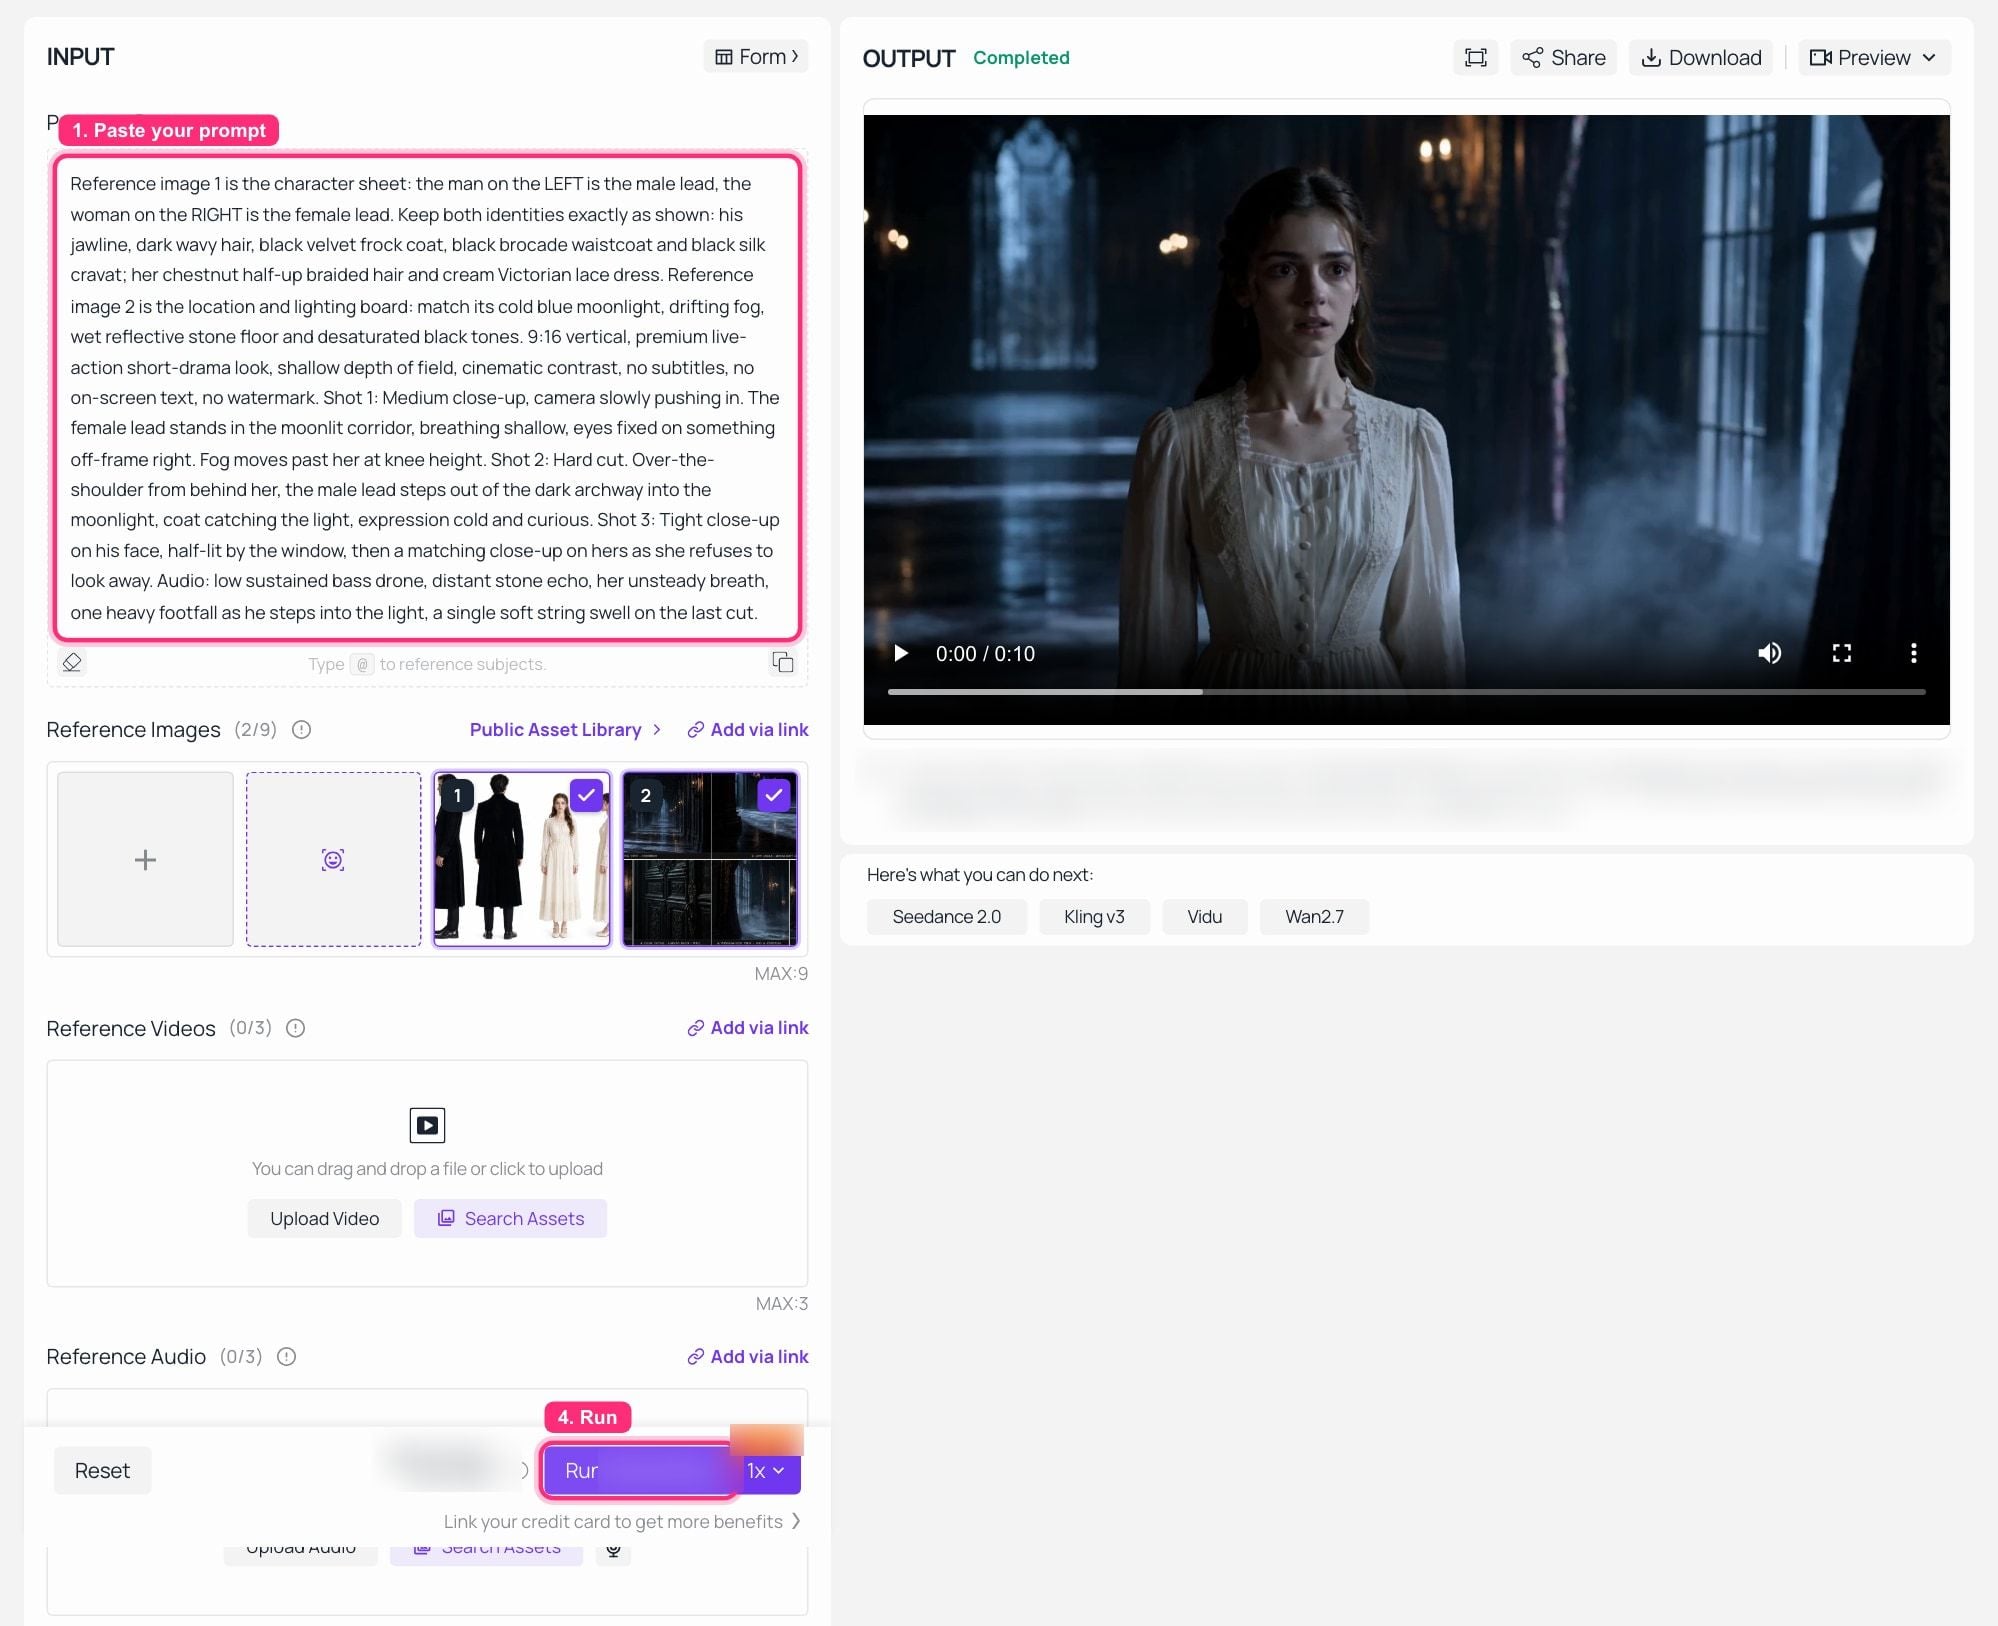 Seedance 2.0 Reference-to-Video na Atlas Cloud, execução concluída com o pacote de referência e prompt idênticos da Etapa 3, e um resultado de 10 segundos no painel OUTPUT.
Aqui está o que os dois painéis OUTPUT realmente mostraram, e estou relatando de forma plana, sem escolher um vencedor.
Ambas as execuções seguraram o personagem. Mesmo vestido de renda creme com o mesmo decote e punhos de manga, mesmo cabelo castanho-acaju, mesmo corredor de névoa e luar extraído do quadro. Nenhuma inventou uma mulher diferente. O pacote de referência fez esse trabalho em ambos os lados, que é a descoberta que mais me importa.
As diferenças foram sobre a forma, não o rosto. Este endpoint Seedance entregou 720p; o H3 entregou 2K com entradas idênticas. E o enquadramento dividiu: o H3 leu "9:16 vertical" diretamente do texto do prompt e retornou vertical, enquanto a execução Seedance veio 16:9 porque essa página carrega seu próprio controle de proporção e o texto do prompt sozinho não o substituiu. Se você está cortando para TikTok, essa diferença vai te custar uma execução na primeira vez que esquecer o campo de formulário. O Seedance 2.5 provavelmente mudaria a metade da resolução disso e adicionaria re-gerações em nível de região, e não vou fingir que medi isso.
Etapa 5: Corrija um plano sem re-gerar o clipe inteiro
O custo real de um drama curto não é a geração um. É a revisão sete. O H3 aceita um clipe existente como entrada e edita contra instruções, mantendo o que você não mencionou. A proposta do Seedance 2.5 aqui é mais fina: redesenhar uma região do quadro e deixar desempenho, iluminação e câmera intactos.
plaintext1Usando o clipe fornecido: mantenha os dois personagens, seus figurinos, os movimentos de câmera e o ritmo de corte exatamente como estão. Mude apenas o ambiente, substitua o corredor de pedra iluminado pelo luar pelo mesmo salão de baile do castelo, janelas altas em arco, um candelabro aceso e luz de velas quente, e re-ilumine ambos os personagens para que a luz principal venha do candelabro no lado esquerdo do quadro em vez da janela. Reescreva a única linha falada dela para "Você nunca esteve dormindo, estava." Mantenha o tempo de atuação dela nos mesmos beats.
Configurações: MiniMax H3 Reference-to-Video com o clipe da Etapa 3 como entrada de referência, Duração 5, Resolução 2K.
Além do Teste Seedance 2.5 vs MiniMax H3: Quatro Maneiras de Impulsionar um Pacote de Referência
Mesmo personagem, próximo episódio. Salve a ficha da Etapa 1 como um ativo e mude apenas a lista de planos e o bloco de história no prompt. A identidade vem de um arquivo, não da sua memória de como você a fraseou na terça-feira passada.
Fixar a voz também. O H3 aceita até três referências de áudio, de 2 a 15 segundos cada, e elas devem acompanhar uma entrada de imagem ou vídeo. Dê a ele uma amostra de voz e o personagem fala naquele timbre, então você não está reescalando um ator de voz entre episódios.
Bloqueie a câmera antes de pagar pelo render. O reference-to-video do Seedance 2.5 aceita modelos 3D em blocos brancos e telas verdes, então você pode travar o enquadramento em geometria cinza e só então se comprometer com um visual finalizado. Este exemplo foi executado no Seedance 2.1, um membro anterior da família, mas a forma do fluxo de trabalho é a mesma.
Localize um corte mestre em vez de refilmá-lo. A substituição em nível de região troca um rosto, um produto ou um idioma falado enquanto câmera, timing e duração dos lábios permanecem. Aqui, um corte mestre de beleza é reescalado e redublado para espanhol, coreano e hindi, com o ambiente, o enquadramento e a duração dos lábios mantidos no lugar.
E porque alguém vai perguntar como fica a transferência de movimento quando você para de ser sensato: três homens de terno, substituídos por três capivaras fotorrealistas, seguindo o caminho de movimento do clipe original batida por batida até se empilharem em uma pirâmide.
Há também a versão simples de tudo isso, a que ninguém posta: um pôster estático se torna um pôster em movimento, e o layout sobrevive.
 O pôster fonte estático. Alimente-o ao reference-to-video com "mantenha o quadro, a paleta e o layout, anime o tipo" e você obtém uma versão em movimento do mesmo design.
Quanto Custa Realmente um Curta-Metragem Seedance 2.5 vs MiniMax H3
Sem números aqui, porque os números mudam e a estrutura não. Ambas as famílias cobram por segundo, pague conforme usar, sem assento e sem assinatura. Isso deixa três variáveis: segundos, nível de resolução e re-gerações.
A terceira é a conta inteira. Um clipe de 15 segundos que acerta na primeira tentativa é uma cobrança. O mesmo clipe na sétima tentativa são sete. Portanto, a jogada de economia de dinheiro não é escolher o modelo mais barato por segundo, é acertar o pacote de referência antes de gerar qualquer coisa. Aquelas duas chamadas de imagem nas Etapas 1 e 2 são a linha mais barata em todo o pipeline e a que decide quantas chamadas de vídeo você fará. Maior retorno sobre o gasto em toda a cadeia, por uma margem.
Depois corrija o instinto de por segundo. Mesmo pacote de referência, mesmo tempo de execução: o reference-to-video do H3 devolve 1440p, este endpoint reference-to-video do Seedance devolve 720p. Por segundo é a unidade errada. Pixels por quadro, e se você então tem que pagar por uma passagem de upscale separada, é a certa.
O áudio também pertence à aritmética. Ambos os lados produzem som sincronizado nativo na mesma passagem. Se seu pipeline atual é modelo de vídeo mais TTS mais um editor alinhando faixas, o que você economiza são duas chamadas de API e uma tarde de uma pessoa, e essa economia não aparece em nenhuma lista de preços em lugar nenhum.
Qual modelo para qual trabalho:
| Trabalho | Escolha | Por que | Ressalva |
|---|---|---|---|
| Drama curto vertical, 9:16, TikTok ou ReelShort | MiniMax H3 | 1440p vertical com estéreo nativo, acessível agora, 15 s é um gancho completo | você corta em 15 s, então planeje os beats de acordo |
| Um filme de marca contínuo de 30 segundos | Seedance 2.5 | geração única, sem costura, 4K nativo | verifique a disponibilidade na sua plataforma primeiro |
| Corrigir um plano dentro de um corte aprovado | Seedance 2.5 | redesenho em nível de região deixa o resto intacto | a edição de clipe inteiro do H3 já te leva até a maior parte do caminho hoje |
| Cortes de produto e e-commerce | qualquer | ambos seguram bem texto na tela e marcas | verifique o texto na resolução que você entrega |
| Demonstrações de jogos ou interface | MiniMax H3 | estabilidade de UI e tipografia em 2K é forte | teto de 15 s para uma única passagem |
| Versões multilíngue de um mestre | Seedance 2.5 | substituição de região mais voz multilíngue | qualidade de localização ainda precisa de uma verificação nativa |
| Enviar esta noite | MiniMax H3 | três endpoints ativos, mais todo o Seedance 2.0 | o acesso ao Seedance 2.5 varia por plataforma |
Antes de enviar. A MiniMax disse que os pesos do H3 seguiriam em dias após o lançamento, e pesos abertos não são a mesma coisa que uma licença comercial, então leia os termos antes de auto-hospedar. A política de marca d'água e uso comercial também difere entre aplicativos de consumo e acesso API em ambos os lados, e não pude confirmar nenhum deles a partir de uma página de termos principal enquanto escrevia isso, então verifique os termos do provedor em vez de aceitar minha palavra. E nada em nenhuma licença de modelo cobre semelhança ou marca registrada. Se uma pessoa real, uma marca real ou IP de outra pessoa estiver no seu pacote de referência, essa é uma questão legal separada e os termos do modelo não a responderão.
Cada modelo nas tabelas acima roda na mesma chave, e as páginas de modelo carregam as taxas atuais mais código para copiar e colar, incluindo quaisquer promoções que estejam acontecendo na linha Seedance esta semana.
Perguntas Frequentes
O Seedance 2.5 é melhor que o MiniMax H3 para consistência de personagem?
No papel, deveria ser, com até 50 referências multimodais contra 12 arquivos do H3, além de re-gerações em nível de região. Mas em 31 de julho de 2026 não há teste público pareado que eu possa apontar, e o Seedance 2.5 ainda não tem classificação em arena. Nas execuções que pude realmente fazer, a variável que decidiu a estabilidade de identidade foi a estrutura do pacote de referência, não a geração do modelo: com uma ficha de rotação composta mais um quadro de iluminação, ambos os lados seguraram o personagem. Acerto o pacote antes de gastar tempo comparando modelos.
Posso usar o Seedance 2.5 agora, ou preciso esperar?
Sua API está ativa na ByteDance. A disponibilidade em plataformas de modelo de terceiros é irregular, e na que testei ainda é um aviso de Dia 0. Se você precisa de saída esta noite, as opções acessíveis são os três endpoints do MiniMax H3 e toda a linha Seedance 2.0 em envio.
O MiniMax H3 realmente faz vídeo de 30 segundos?
Não. A especificação é de 5 a 15 segundos por geração a 24fps. Qualquer coisa mais longa é extensão ou costura, que é uma coisa diferente com risco de deriva diferente. A geração única de 30 segundos pertence ao Seedance 2.5. Não deixe as duas alegações se confundirem.
Ambos os modelos geram áudio, e posso manter uma voz entre episódios?
Ambos produzem áudio sincronizado nativo na mesma passagem, e o H3 produz estéreo em todo resultado. Para uma voz persistente, o H3 aceita até três referências de áudio de 2 a 15 segundos cada, que devem ser enviadas junto com uma entrada de imagem ou vídeo, não sozinhas.
Quantas imagens de referência devo realmente enviar?
Menos do que você pensa, melhor estruturada do que você pensa. Uma composição bem feita geralmente vence seis recortes soltos, porque arquivos separados convidam o modelo a calcular a média deles em uma pessoa que não existe. Dê a ele dois trabalhos claros, identidade e iluminação, e não inclua amostras de estilo que lutam entre si.
Qual modelo devo usar para drama curto vertical estilo TikTok ou ReelShort?
Enviando esta semana, em 9:16, em alta resolução com som já mixado: MiniMax H3. Planejando uma cena contínua de 30 segundos onde você espera re-gerar regiões únicas em vez de clipes inteiros: construa para o Seedance 2.5 e verifique quando sua plataforma o abrir.


